
二叉搜索树(Binary Search Tree)简称 BST,是二叉树的一种特殊形式。它有很多别名,比如排序二叉树、二叉查找树等等。
虽然二叉搜索树多年来一直作为算法面试的“必要考点”存在,但在实际面试中,它的考察频率并不能和常规二叉树相提并论,算不上“大热”的考点,同时考察内容也是相对比较稳定的。对于二叉搜索树,我们只要能够把握好它的限制条件和特性,就足以应对大部分的考题。
# 什么是二叉搜索树
⚡ 30 秒速记
BST= 左子树全部 ≤ 根 ≤ 右子树全部,而且每棵子树都这样,递归定义,空树也算- 约束管的是「整棵子树」,不是只看直接孩子:根
10的左子树里藏个12就不合法 - 等价特征:中序遍历有序(无重复时严格递增)
- 操作都是
O(h):平衡时O(log n),有序插入退化成链就是O(n) - 重复值放哪边是约定问题,插入、查找、验证要用同一套规则
二叉搜索树说白了就是把「二分查找」做成了一棵树:左边都比根小,右边都比根大,而且每一棵子树都守这个规矩。 所以从根往下找,每比一次就能扔掉一半。很多人写验证只比父子,这是错的,比如根是 10,左孩子 5,5 的右孩子是 12,局部看 5 < 12 没毛病,但 12 跑到了 10 的左边,整棵树就不成立了。另外它的快是有条件的,树高才是复杂度,顺序插入 1,2,3,4,5 会长成一条链,查找就退回 O(n)。
树的定义总是以递归的形式出现,二叉搜索树也不例外,它的递归定义如下:
- 是一棵空树
- 是一棵由根结点、左子树、右子树组成的树,同时左子树和右子树都是二叉搜索树,且左子树上所有结点的数据域都小于等于根结点的数据域,右子树上所有结点的数据域都大于等于根结点的数据域
满足以上两个条件之一的二叉树,就是二叉搜索树。
从这个定义我们可以看出,二叉搜索树强调的是数据域的有序性。也就是说,二叉搜索树上的每一棵子树,都应该满足
左孩子 <= 根结点 <= 右孩子这样的大小关系。下图我给出了几个二叉搜索树的示例
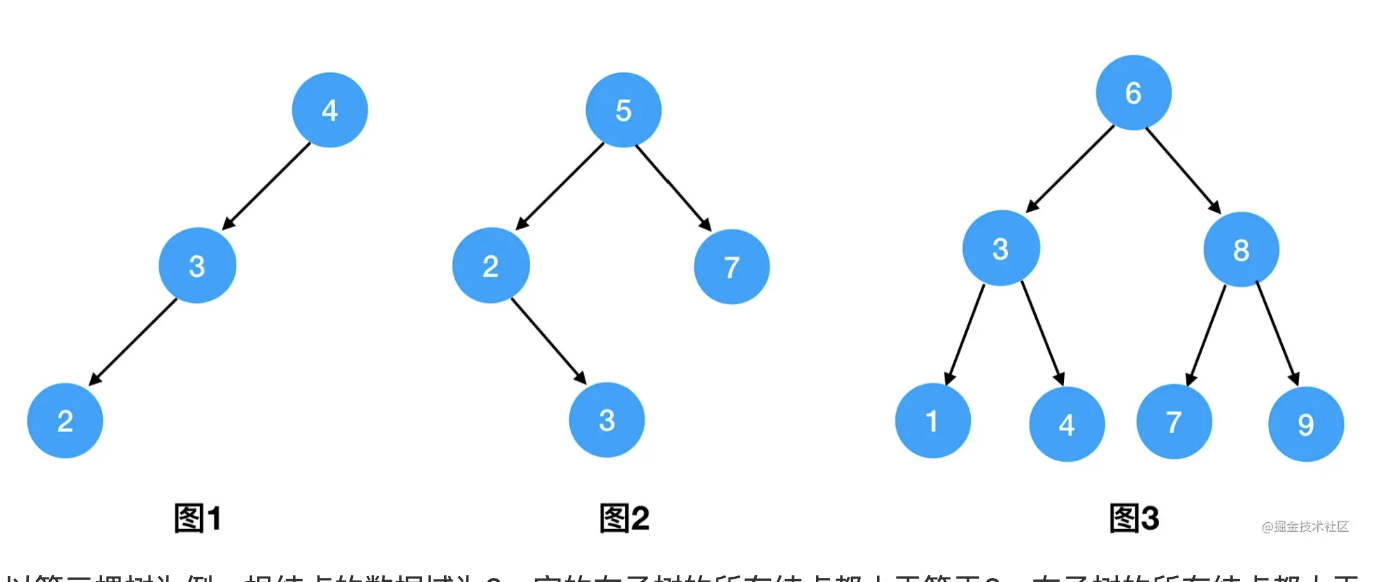
以第三棵树为例,根结点的数据域为6,它的左子树的所有结点都小于等于6、右子树的所有结点都大于等于6。同时在任意子树的内部,也满足这个条件——比如左子树中,根结点值为3,根结点对应左子树的所有结点都小于等于3、右子树的所有结点都大于等于3。
💬 面试官追问
-
根
10、左孩子5、5的右孩子12,这是BST吗?不是。
12在10的左子树里,必须小于10。只比较父子5 < 12会误判,验证时要把祖先给的上下界一路带下去。 -
中序遍历结果是有序的,能反推它就是
BST吗?无重复值时可以,中序严格递增和
BST是等价的,LeetCode 98用中序 + 记录上一个值也能过。有重复值时要看约定,比如规定相等只能放右边,那光看非递减序列就判断不出来。 -
BST查找号称O(log n),为什么有人实测和遍历数组差不多?大概率是数据按顺序插入的,树退化成了单链,高度等于
n。O(log n)只在树平衡时成立,要稳定就上AVL、红黑树这类自平衡结构。 -
数据加载后不再改,只按值查,用
BST还是有序数组?我选有序数组 + 二分。一样是
O(log n),数组内存连续、缓存友好,还能按下标取第k个。BST的优势在于频繁插删不用整体搬元素。 -
允许重复键的话怎么设计比较省心?
最省事的是一个结点存一个
count,重复插入只加计数,树里永远没有相等的结点,查找和删除都不用纠结往哪边走。


