
# 进阶篇
# 一、JS基础
# 1 类型及检测方式
⚡ 30 秒速记
- 8 种类型:7 个原始类型
numberstringbooleannullundefinedsymbolbigint+ 引用类型object - 赋值区别:原始类型复制值,引用类型复制地址,改一个另一个跟着变
typeof:原始类型和函数够用,但null、数组、对象都返回'object'instanceof看原型链,判断不了原始类型,跨iframe会失效;constructor能被改写,不可靠- 最准是
Object.prototype.toString.call(v),数组直接用Array.isArray;typeof null === 'object'是历史遗留问题
JS 有 7 种原始类型加一种 object,检测方法要看场景挑:typeof 判原始类型,Array.isArray 判数组,要精确区分内置对象就用 Object.prototype.toString.call()。 typeof 最大的坑是 typeof null 也是 'object',这是第一版 JS 留下的历史问题,一直没改。instanceof 本质是沿原型链找 Constructor.prototype,所以跨 iframe 传过来的数组会判成 false。toString.call([]) 会返回 '[object Array]',日期、正则、Map 都能分清,我写工具函数一般就封装它。另外「原始值存栈、对象存堆」是个理解模型,引擎实际实现更复杂,面试讲到赋值是复制值还是复制地址就够了。
1. JS内置类型
JavaScript 的数据类型有下图所示
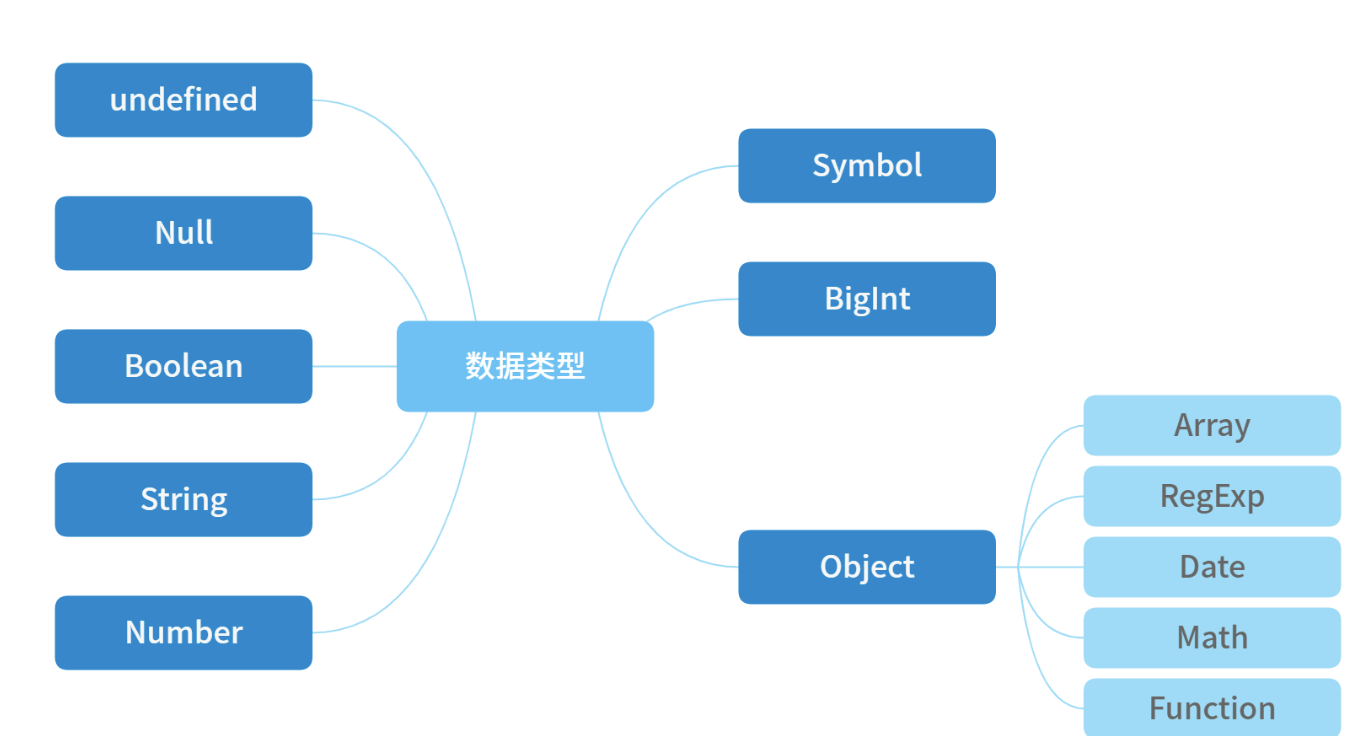
其中,前 7 种类型为基础类型,最后
1 种(Object)为引用类型,也是你需要重点关注的,因为它在日常工作中是使用得最频繁,也是需要关注最多技术细节的数据类型
JavaScript一共有8种数据类型,其中有7种基本数据类型:Undefined、Null、Boolean、Number、String、Symbol(es6新增,表示独一无二的值)和BigInt(es10新增);- 1种引用数据类型——
Object(Object本质上是由一组无序的名值对组成的)。里面包含function、Array、Date等。JavaScript不支持任何创建自定义类型的机制,而所有值最终都将是上述 8 种数据类型之一。- 引用数据类型: 对象
Object(包含普通对象-Object,数组对象-Array,正则对象-RegExp,日期对象-Date,数学函数-Math,函数对象-Function)
- 引用数据类型: 对象
在这里,我想先请你重点了解下面两点,因为各种 JavaScript 的数据类型最后都会在初始化之后放在不同的内存中,因此上面的数据类型大致可以分成两类来进行存储:
- 原始数据类型:基础类型存储在栈内存,被引用或拷贝时,会创建一个完全相等的变量;占据空间小、大小固定,属于被频繁使用数据,所以放入栈中存储。
- 引用数据类型:引用类型存储在堆内存,存储的是地址,多个引用指向同一个地址,这里会涉及一个“共享”的概念;占据空间大、大小不固定。引用数据类型在栈中存储了指针,该指针指向堆中该实体的起始地址。当解释器寻找引用值时,会首先检索其在栈中的地址,取得地址后从堆中获得实体。
JavaScript 中的数据是如何存储在内存中的?
在 JavaScript 中,原始类型的赋值会完整复制变量值,而引用类型的赋值是复制引用地址。
在 JavaScript 的执行过程中, 主要有三种类型内存空间,分别是代码空间、栈空间、堆空间。其中的代码空间主要是存储可执行代码的,原始类型(Number、String、Null、Undefined、Boolean、Symbol、BigInt)的数据值都是直接保存在“栈”中的,引用类型(Object)的值是存放在“堆”中的。因此在栈空间中(执行上下文),原始类型存储的是变量的值,而引用类型存储的是其在"堆空间"中的地址,当 JavaScript 需要访问该数据的时候,是通过栈中的引用地址来访问的,相当于多了一道转手流程。
在编译过程中,如果 JavaScript 引擎判断到一个闭包,也会在堆空间创建换一个“closure(fn)”的对象(这是一个内部对象,JavaScript 是无法访问的),用来保存闭包中的变量。所以闭包中的变量是存储在“堆空间”中的。
JavaScript 引擎需要用栈来维护程序执行期间上下文的状态,如果栈空间大了话,所有的数据都存放在栈空间里面,那么会影响到上下文切换的效率,进而又影响到整个程序的执行效率。通常情况下,栈空间都不会设置太大,主要用来存放一些原始类型的小数据。而引用类型的数据占用的空间都比较大,所以这一类数据会被存放到堆中,堆空间很大,能存放很多大的数据,不过缺点是分配内存和回收内存都会占用一定的时间。因此需要“栈”和“堆”两种空间。
题目一:初出茅庐
let a = {
  name: 'lee',
  age: 18
}
let b = a;
console.log(a.name);  //第一个console
b.name = 'son';
console.log(a.name);  //第二个console
console.log(b.name);  //第三个console
这道题比较简单,我们可以看到第一个 console 打出来 name 是 'lee',这应该没什么疑问;但是在执行了 b.name='son' 之后,结果你会发现 a 和 b 的属性 name 都是 'son',第二个和第三个打印结果是一样的,这里就体现了引用类型的“共享”的特性,即这两个值都存在同一块内存中共享,一个发生了改变,另外一个也随之跟着变化。
你可以直接在 Chrome 控制台敲一遍,深入理解一下这部分概念。下面我们再看一段代码,它是比题目一稍复杂一些的对象属性变化问题。
题目二:渐入佳境
let a = {
  name: 'Julia',
  age: 20
}
function change(o) {
  o.age = 24;
  o = {
    name: 'Kath',
    age: 30
  }
  return o;
}
let b = change(a);     // 注意这里没有new,后面new相关会有专门文章讲解
console.log(b.age);    // 第一个console
console.log(a.age);    // 第二个console
这道题涉及了 function,你通过上述代码可以看到第一个 console 的结果是 30,b 最后打印结果是 {name: "Kath", age: 30};第二个 console 的返回结果是 24,而 a 最后的打印结果是 {name: "Julia", age: 24}。
是不是和你预想的有些区别?你要注意的是,这里的 function 和 return 带来了不一样的东西。
原因在于:函数传参进来的
o,传递的是对象在堆中的内存地址值,通过调用o.age = 24(第 7 行代码)确实改变了a对象的age属性;但是第 12 行代码的return却又把o变成了另一个内存地址,将{name: "Kath", age: 30}存入其中,最后返回b的值就变成了{name: "Kath", age: 30}。而如果把第 12 行去掉,那么b就会返回undefined
2. 数据类型检测
(1)typeof
typeof 对于原始类型来说,除了 null 都可以显示正确的类型
console.log(typeof 2);               // number
console.log(typeof true);            // boolean
console.log(typeof 'str');           // string
console.log(typeof []);              // object     []数组的数据类型在 typeof 中被解释为 object
console.log(typeof function(){});    // function
console.log(typeof {});              // object
console.log(typeof undefined);       // undefined
console.log(typeof null);            // object     null 的数据类型被 typeof 解释为 object
typeof对于对象来说,除了函数都会显示object,所以说typeof并不能准确判断变量到底是什么类型,所以想判断一个对象的正确类型,这时候可以考虑使用instanceof
(2)instanceof
instanceof可以正确的判断对象的类型,因为内部机制是通过判断对象的原型链中是不是能找到类型的prototype
console.log(2 instanceof Number);                    // false
console.log(true instanceof Boolean);                // false
console.log('str' instanceof String);                // false
console.log([] instanceof Array);                    // true
console.log(function(){} instanceof Function);       // true
console.log({} instanceof Object);                   // true
// console.log(undefined instanceof Undefined);
// console.log(null instanceof Null);
instanceof可以准确地判断复杂引用数据类型,但是不能正确判断基础数据类型;- 而
typeof也存在弊端,它虽然可以判断基础数据类型(null除外),但是引用数据类型中,除了function类型以外,其他的也无法判断
// 我们也可以试着实现一下 instanceof
function _instanceof(left, right) {
    // 由于instance要检测的是某对象,需要有一个前置判断条件
    //基本数据类型直接返回false
    if(typeof left !== 'object' || left === null) return false;

    // 获得类型的原型
    let prototype = right.prototype
    // 获得对象的原型
    left = left.__proto__
    // 判断对象的类型是否等于类型的原型
    while (true) {
    	if (left === null)
    		return false
    	if (prototype === left)
    		return true
    	left = left.__proto__
    }
}

console.log('test', _instanceof(null, Array)) // false
console.log('test', _instanceof([], Array)) // true
console.log('test', _instanceof('', Array)) // false
console.log('test', _instanceof({}, Object)) // true
(3)constructor
console.log((2).constructor === Number); // true
console.log((true).constructor === Boolean); // true
console.log(('str').constructor === String); // true
console.log(([]).constructor === Array); // true
console.log((function() {}).constructor === Function); // true
console.log(({}).constructor === Object); // true
这里有一个坑,如果我创建一个对象,更改它的原型,
constructor就会变得不可靠了
function Fn(){};

Fn.prototype=new Array();

var f=new Fn();

console.log(f.constructor===Fn);    // false
console.log(f.constructor===Array); // true
(4)Object.prototype.toString.call()
toString()是Object的原型方法,调用该方法,可以统一返回格式为“[object Xxx]”的字符串,其中Xxx就是对象的类型。对于Object对象,直接调用toString()就能返回[object Object];而对于其他对象,则需要通过call来调用,才能返回正确的类型信息。我们来看一下代码。
Object.prototype.toString({})       // "[object Object]"
Object.prototype.toString.call({})  // 同上结果,加上call也ok
Object.prototype.toString.call(1)    // "[object Number]"
Object.prototype.toString.call('1')  // "[object String]"
Object.prototype.toString.call(true)  // "[object Boolean]"
Object.prototype.toString.call(function(){})  // "[object Function]"
Object.prototype.toString.call(null)   //"[object Null]"
Object.prototype.toString.call(undefined) //"[object Undefined]"
Object.prototype.toString.call(/123/g)    //"[object RegExp]"
Object.prototype.toString.call(new Date()) //"[object Date]"
Object.prototype.toString.call([])       //"[object Array]"
Object.prototype.toString.call(document)  //"[object HTMLDocument]"
Object.prototype.toString.call(window)   //"[object Window]"

// 从上面这段代码可以看出,Object.prototype.toString.call() 可以很好地判断引用类型,甚至可以把 document 和 window 都区分开来。
实现一个全局通用的数据类型判断方法,来加深你的理解,代码如下
function getType(obj){
  let type  = typeof obj;
  if (type !== "object") {    // 先进行typeof判断,如果是基础数据类型,直接返回
    return type;
  }
  // 对于typeof返回结果是object的,再进行如下的判断,正则返回结果
  return Object.prototype.toString.call(obj).replace(/^\[object (\S+)\]$/, '$1');  // 注意正则中间有个空格
}
/* 代码验证,需要注意大小写,哪些是typeof判断,哪些是toString判断?思考下 */
getType([])     // "Array" typeof []是object,因此toString返回
getType('123')  // "string" typeof 直接返回
getType(window) // "Window" toString返回
getType(null)   // "Null"首字母大写,typeof null是object,需toString来判断
getType(undefined)   // "undefined" typeof 直接返回
getType()            // "undefined" typeof 直接返回
getType(function(){}) // "function" typeof能判断,因此首字母小写
getType(/123/g)      //"RegExp" toString返回
小结
typeof- 直接在计算机底层基于数据类型的值(二进制)进行检测
typeof null为object原因是对象存在在计算机中,都是以000开始的二进制存储,所以检测出来的结果是对象typeof普通对象/数组对象/正则对象/日期对象 都是objecttypeof NaN === 'number'
instanceof- 检测当前实例是否属于这个类的
- 底层机制:只要当前类出现在实例的原型上,结果都是true
- 不能检测基本数据类型
constructor- 支持基本类型
- constructor可以随便改,也不准
Object.prototype.toString.call([val])- 返回当前实例所属类信息
判断
Target的类型,单单用typeof并无法完全满足,这其实并不是bug,本质原因是JS的万物皆对象的理论。因此要真正完美判断时,我们需要区分对待:
- 基本类型(
null): 使用String(null) - 基本类型(
string / number / boolean / undefined) +function: - 直接使用typeof即可 - 其余引用类型(
Array / Date / RegExp Error): 调用toString后根据[object XXX]进行判断
3. 数据类型转换
我们先看一段代码,了解下大致的情况。
'123' == 123   // false or true?
'' == null    // false or true?
'' == 0        // false or true?
[] == 0        // false or true?
[] == ''       // false or true?
[] == ![]      // false or true?
null == undefined //  false or true?
Number(null)     // 返回什么?
Number('')      // 返回什么?
parseInt('');    // 返回什么?
{}+10           // 返回什么?
let obj = {
    [Symbol.toPrimitive]() {
        return 200;
    },
    valueOf() {
        return 300;
    },
    toString() {
        return 'Hello';
    }
}
console.log(obj + 200); // 这里打印出来是多少?
首先我们要知道,在
JS中类型转换只有三种情况,分别是:
- 转换为布尔值
- 转换为数字
- 转换为字符串
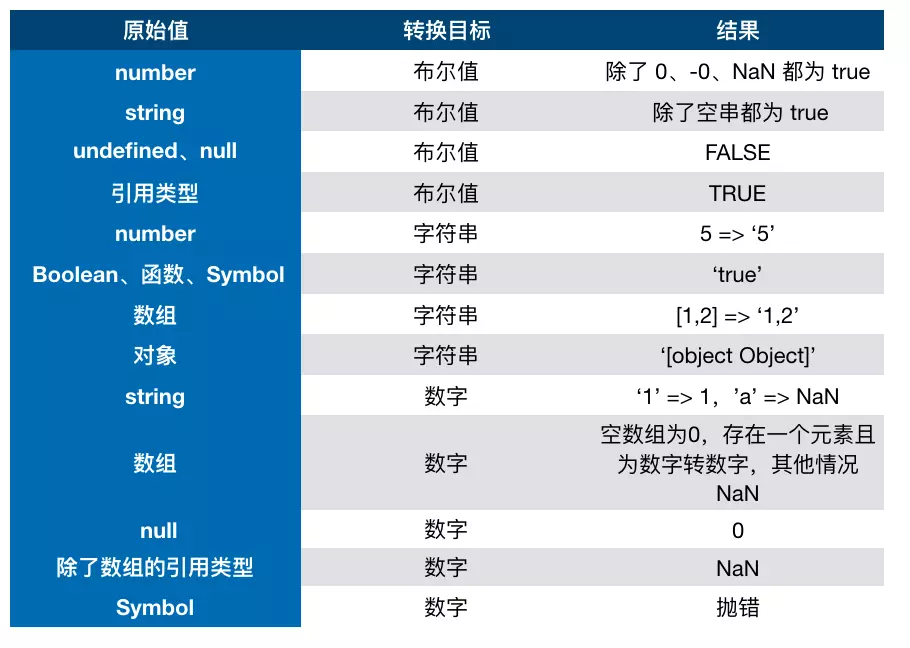
转Boolean
在条件判断时,除了
undefined,null,false,NaN,'',0,-0,其他所有值都转为true,包括所有对象
Boolean(0)          //false
Boolean(null)       //false
Boolean(undefined)  //false
Boolean(NaN)        //false
Boolean(1)          //true
Boolean(13)         //true
Boolean('12')       //true
对象转原始类型
对象在转换类型的时候,会调用内置的
[[ToPrimitive]]函数,对于该函数来说,算法逻辑一般来说如下
- 如果已经是原始类型了,那就不需要转换了
- 调用
x.valueOf(),如果转换为基础类型,就返回转换的值 - 调用
x.toString(),如果转换为基础类型,就返回转换的值 - 如果都没有返回原始类型,就会报错
当然你也可以重写
Symbol.toPrimitive,该方法在转原始类型时调用优先级最高。
let a = {
  valueOf() {
    return 0
  },
  toString() {
    return '1'
  },
  [Symbol.toPrimitive]() {
    return 2
  }
}
1 + a // => 3
四则运算符
它有以下几个特点:
- 运算中其中一方为字符串,那么就会把另一方也转换为字符串
- 如果一方不是字符串或者数字,那么会将它转换为数字或者字符串
1 + '1' // '11'
true + true // 2
4 + [1,2,3] // "41,2,3"
- 对于第一行代码来说,触发特点一,所以将数字
1转换为字符串,得到结果'11' - 对于第二行代码来说,触发特点二,所以将
true转为数字1 - 对于第三行代码来说,触发特点二,所以将数组通过
toString转为字符串1,2,3,得到结果41,2,3
另外对于加法还需要注意这个表达式
'a' + + 'b'
'a' + + 'b' // -> "aNaN"
- 因为
+ 'b'等于NaN,所以结果为"aNaN",你可能也会在一些代码中看到过+ '1'的形式来快速获取number类型。 - 那么对于除了加法的运算符来说,只要其中一方是数字,那么另一方就会被转为数字
4 * '3' // 12
4 * [] // 0
4 * [1, 2] // NaN
比较运算符
- 如果是对象,就通过
toPrimitive转换对象 - 如果是字符串,就通过
unicode字符索引来比较
let a = {
  valueOf() {
    return 0
  },
  toString() {
    return '1'
  }
}
a > -1 // true
在以上代码中,因为
a是对象,所以会通过valueOf转换为原始类型再比较值。
强制类型转换
强制类型转换方式包括
Number()、parseInt()、parseFloat()、toString()、String()、Boolean(),这几种方法都比较类似
Number()方法的强制转换规则- 如果是布尔值,
true和false分别被转换为1和0; - 如果是数字,返回自身;
- 如果是
null,返回0; - 如果是
undefined,返回NaN; - 如果是字符串,遵循以下规则:如果字符串中只包含数字(或者是
0X / 0x开头的十六进制数字字符串,允许包含正负号),则将其转换为十进制;如果字符串中包含有效的浮点格式,将其转换为浮点数值;如果是空字符串,将其转换为0;如果不是以上格式的字符串,均返回 NaN; - 如果是
Symbol,抛出错误; - 如果是对象,并且部署了
[Symbol.toPrimitive],那么调用此方法,否则调用对象的valueOf()方法,然后依据前面的规则转换返回的值;如果转换的结果是NaN,则调用对象的toString()方法,再次依照前面的顺序转换返回对应的值。
Number(true);        // 1
Number(false);       // 0
Number('0111');      //111
Number(null);        //0
Number('');          //0
Number('1a');        //NaN
Number(-0X11);       //-17
Number('0X11')       //17
Object 的转换规则
对象转换的规则,会先调用内置的
[ToPrimitive]函数,其规则逻辑如下:
- 如果部署了
Symbol.toPrimitive方法,优先调用再返回; - 调用
valueOf(),如果转换为基础类型,则返回; - 调用
toString(),如果转换为基础类型,则返回; - 如果都没有返回基础类型,会报错。
var obj = {
  value: 1,
  valueOf() {
    return 2;
  },
  toString() {
    return '3'
  },
  [Symbol.toPrimitive]() {
    return 4
  }
}
console.log(obj + 1); // 输出5
// 因为有Symbol.toPrimitive,就优先执行这个;如果Symbol.toPrimitive这段代码删掉,则执行valueOf打印结果为3;如果valueOf也去掉,则调用toString返回'31'(字符串拼接)
// 再看两个特殊的case:
10 + {}
// "10[object Object]",注意:{}会默认调用valueOf是{},不是基础类型继续转换,调用toString,返回结果"[object Object]",于是和10进行'+'运算,按照字符串拼接规则来,参考'+'的规则C
[1,2,undefined,4,5] + 10
// "1,2,,4,510",注意[1,2,undefined,4,5]会默认先调用valueOf结果还是这个数组,不是基础数据类型继续转换,也还是调用toString,返回"1,2,,4,5",然后再和10进行运算,还是按照字符串拼接规则,参考'+'的第3条规则
'==' 的隐式类型转换规则
- 如果类型相同,无须进行类型转换;
- 如果其中一个操作值是
null或者undefined,那么另一个操作符必须为null或者undefined,才会返回true,否则都返回false; - 如果其中一个是
Symbol类型,那么返回false; - 两个操作值如果为
string和 number 类型,那么就会将字符串转换为number; - 如果一个操作值是
boolean,那么转换成number; - 如果一个操作值为
object且另一方为string、number或者symbol,就会把object转为原始类型再进行判断(调用object的valueOf/toString方法进行转换)。
null == undefined       // true  规则2
null == 0               // false 规则2
'' == null              // false 规则2
'' == 0                 // true  规则4 字符串转隐式转换成Number之后再对比
'123' == 123            // true  规则4 字符串转隐式转换成Number之后再对比
0 == false              // true  e规则 布尔型隐式转换成Number之后再对比
1 == true               // true  e规则 布尔型隐式转换成Number之后再对比
var a = {
  value: 0,
  valueOf: function() {
    this.value++;
    return this.value;
  }
};
// 注意这里a又可以等于1、2、3
console.log(a == 1 && a == 2 && a ==3);  //true f规则 Object隐式转换
// 注:但是执行过3遍之后,再重新执行a==3或之前的数字就是false,因为value已经加上去了,这里需要注意一下
'+' 的隐式类型转换规则
'+' 号操作符,不仅可以用作数字相加,还可以用作字符串拼接。仅当 '+' 号两边都是数字时,进行的是加法运算;如果两边都是字符串,则直接拼接,无须进行隐式类型转换。
- 如果其中有一个是字符串,另外一个是
undefined、null或布尔型,则调用toString()方法进行字符串拼接;如果是纯对象、数组、正则等,则默认调用对象的转换方法会存在优先级,然后再进行拼接。 - 如果其中有一个是数字,另外一个是
undefined、null、布尔型或数字,则会将其转换成数字进行加法运算,对象的情况还是参考上一条规则。 - 如果其中一个是字符串、一个是数字,则按照字符串规则进行拼接
1 + 2        // 3  常规情况
'1' + '2'    // '12' 常规情况
// 下面看一下特殊情况
'1' + undefined   // "1undefined" 规则1,undefined转换字符串
'1' + null        // "1null" 规则1,null转换字符串
'1' + true        // "1true" 规则1,true转换字符串
'1' + 1n          // '11' 比较特殊字符串和BigInt相加,BigInt转换为字符串
1 + undefined     // NaN  规则2,undefined转换数字相加NaN
1 + null          // 1    规则2,null转换为0
1 + true          // 2    规则2,true转换为1,二者相加为2
1 + 1n            // 错误  不能把BigInt和Number类型直接混合相加
'1' + 3           // '13' 规则3,字符串拼接
整体来看,如果数据中有字符串,JavaScript 类型转换还是更倾向于转换成字符串,因为第三条规则中可以看到,在字符串和数字相加的过程中最后返回的还是字符串,这里需要关注一下
null 和 undefined 的区别?
- 首先
Undefined和Null都是基本数据类型,这两个基本数据类型分别都只有一个值,就是undefined和null。 undefined代表的含义是未定义,null代表的含义是空对象(其实不是真的对象,请看下面的注意!)。一般变量声明了但还没有定义的时候会返回undefined,null主要用于赋值给一些可能会返回对象的变量,作为初始化。
其实 null 不是对象,虽然 typeof null 会输出 object,但是这只是 JS 存在的一个悠久 Bug。在 JS 的最初版本中使用的是 32 位系统,为了性能考虑使用低位存储变量的类型信息,000 开头代表是对象,然而 null 表示为全零,所以将它错误的判断为 object 。虽然现在的内部类型判断代码已经改变了,但是对于这个 Bug 却是一直流传下来。
- undefined 在 js 中不是一个保留字,这意味着我们可以使用
undefined来作为一个变量名,这样的做法是非常危险的,它会影响我们对 undefined 值的判断。但是我们可以通过一些方法获得安全的undefined值,比如说void 0。 - 当我们对两种类型使用 typeof 进行判断的时候,Null 类型化会返回 “object”,这是一个历史遗留的问题。当我们使用双等号对两种类型的值进行比较时会返回 true,使用三个等号时会返回 false。
💬 面试官追问
埋点
SDK用typeof payload === 'object'判断,结果Object.keys(payload)报错了,为什么?payload是null,typeof null也是'object',Object.keys(null)就抛TypeError。条件要写成payload !== null && typeof payload === 'object',只接受普通对象的话还得排除数组。[] instanceof Array在iframe传过来的数组上返回false,怎么改?每个
iframe有自己的一套Array构造函数,子页面的数组原型链上是它自己的Array.prototype。改用Array.isArray(v),它不看原型链,跨窗口也准。写一个通用的
getType,返回'array'、'date'这种小写类型名,怎么写?Object.prototype.toString.call(v).slice(8, -1).toLowerCase(),比如getType([])得到'array',getType(null)得到'null'。大小写统一定死,调用方就不会一会儿写Array一会儿写array。字段可能是
0、'0'、null、NaN,只有后两个算异常,能写if (!value)吗?不能,
!0也是true,合法的0会被当成异常。写value === null || Number.isNaN(value),别用全局isNaN,isNaN('abc')也是true,它会先做类型转换。Object.prototype.toString为什么能判得这么准,能被骗吗?它读的是对象内部的类型标签,对象上有
Symbol.toStringTag时会优先用它。所以能骗:给对象设[Symbol.toStringTag]: 'Array',结果就是'[object Array]',这也是判数组还是推荐Array.isArray的原因。
# 2 This
⚡ 30 秒速记
- 普通函数的
this看调用方式,箭头函数的this看写在哪(继承外层) - 四条规则优先级:
new>call/apply/bind>obj.fn()> 直接调用 - 直接调用:非严格模式指向
window/globalThis,严格模式(ES Module、class里默认严格)是undefined - 最常见的丢
this:const f = obj.fn; f()、把方法当回调传出去 - 箭头函数
bind/call都改不了;多次bind只有第一次生效;new能盖过bind
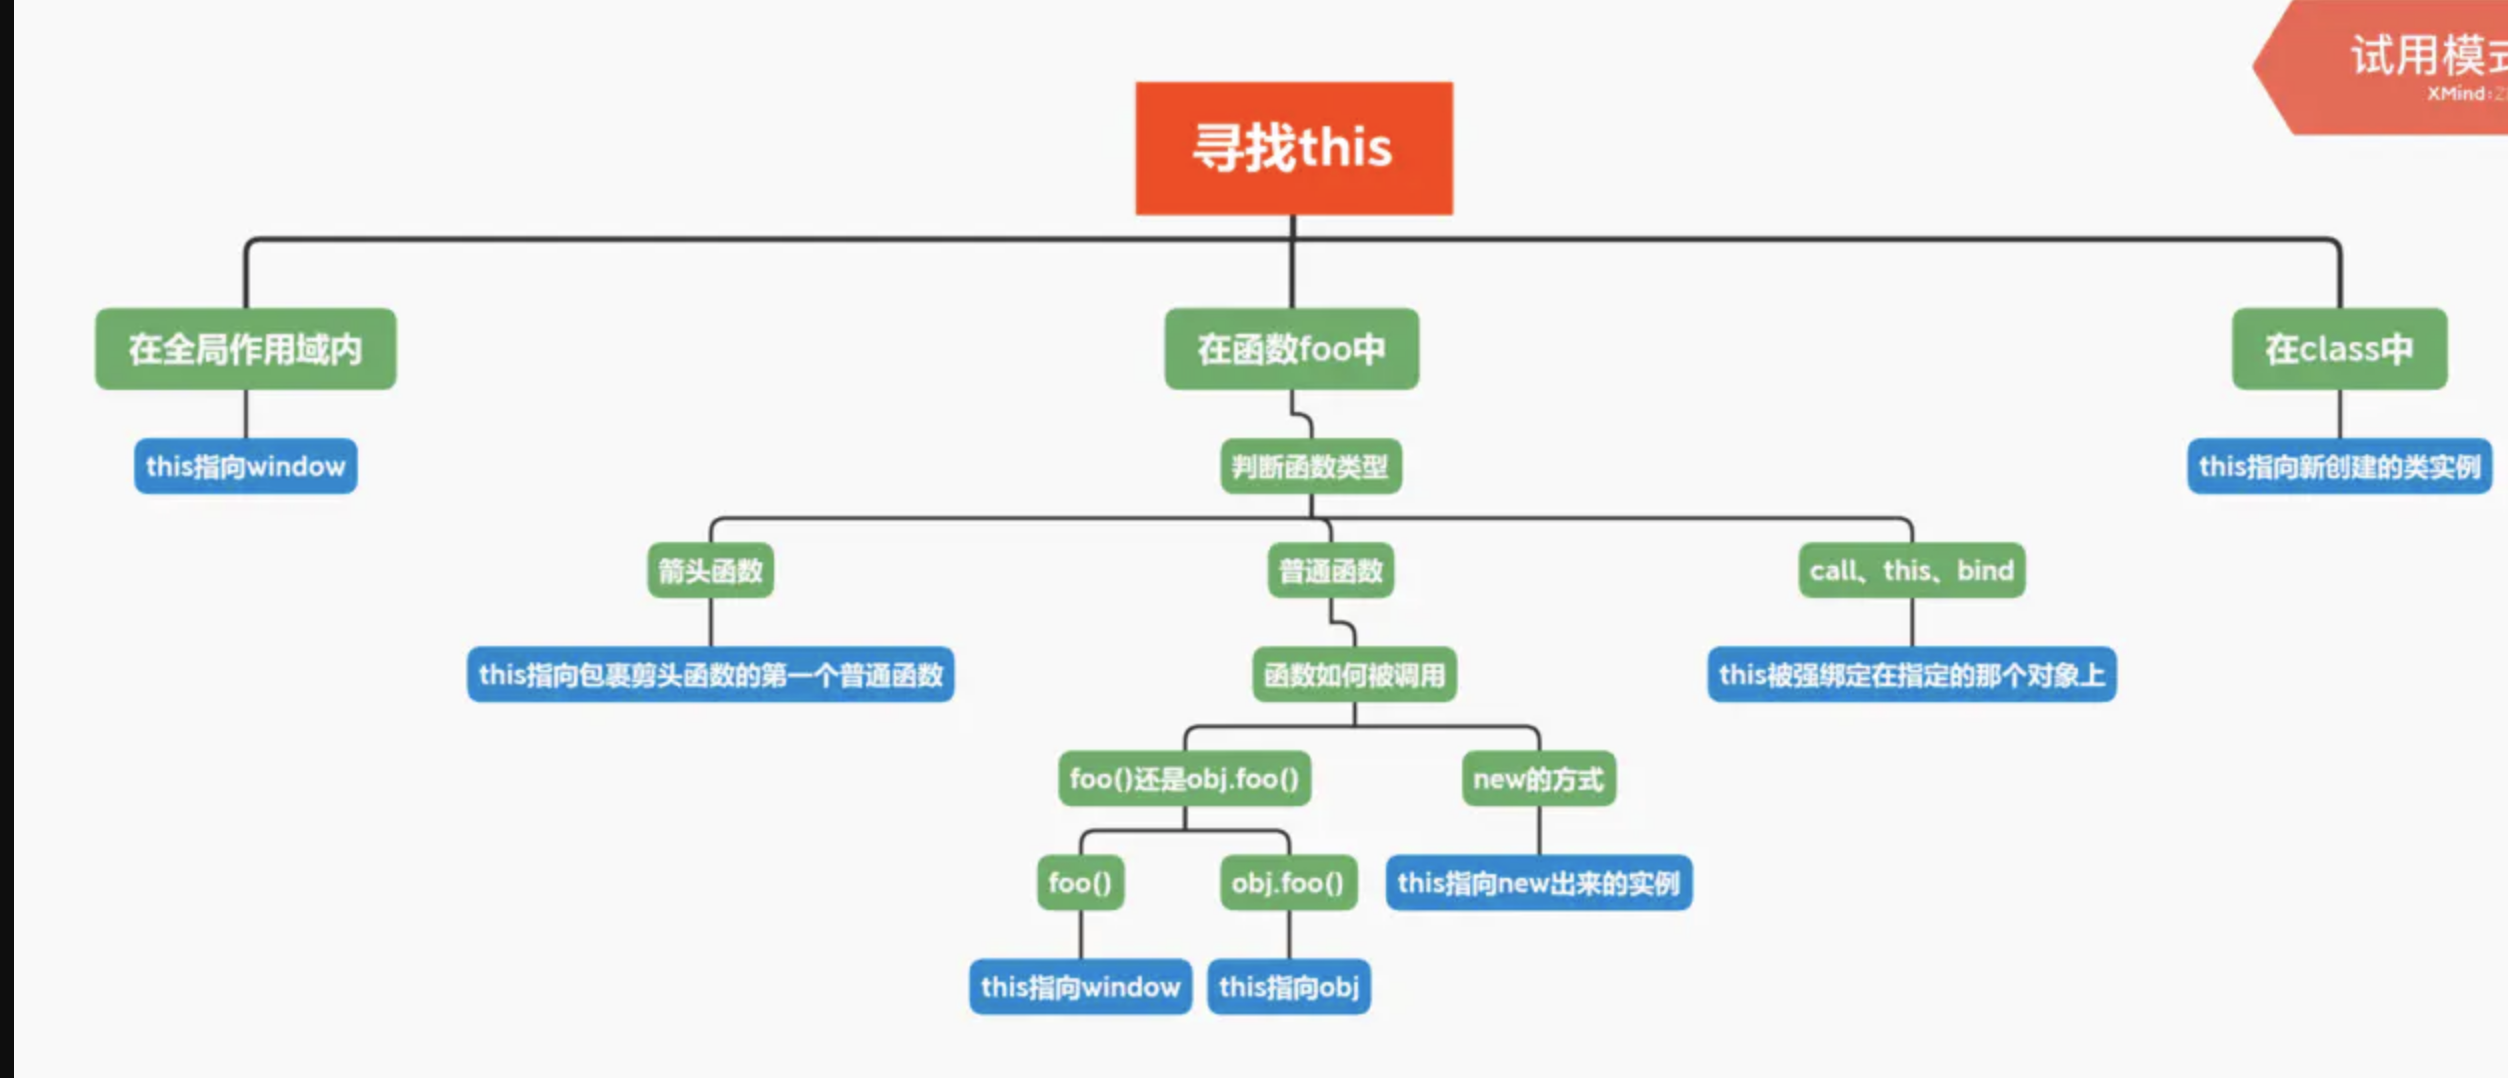
普通函数的 this 不是定义时定的,而是调用时看「谁点出来的」:obj.fn() 就是 obj,直接 fn() 就是全局对象或 undefined,new 调用就是新实例。 几条规则撞在一起时按优先级来:new 最高,然后是 call、apply、bind,再是 obj.fn() 这种隐式绑定,最后是默认绑定。箭头函数没有自己的 this,用的是外层普通函数的 this,所以 bind 对它没用。实际开发里最常踩的是把对象方法当回调传出去,比如 setTimeout(obj.fn),调用时没了 obj.,this 就丢了。
不同情况的调用,
this指向分别如何。顺带可以提一下es6中箭头函数没有this,arguments,super等,这些只依赖包含箭头函数最接近的函数
我们先来看几个函数调用的场景
function foo() {
  console.log(this.a)
}
var a = 1
foo()

const obj = {
  a: 2,
  foo: foo
}
obj.foo()

const c = new foo()
- 对于直接调用
foo来说,不管foo函数被放在了什么地方,this一定是window - 对于
obj.foo()来说,我们只需要记住,谁调用了函数,谁就是this,所以在这个场景下foo函数中的this就是obj对象 - 对于
new的方式来说,this被永远绑定在了c上面,不会被任何方式改变this
说完了以上几种情况,其实很多代码中的
this应该就没什么问题了,下面让我们看看箭头函数中的this
function a() {
  return () => {
    return () => {
      console.log(this)
    }
  }
}
console.log(a()()())
- 首先箭头函数其实是没有
this的,箭头函数中的this只取决包裹箭头函数的第一个普通函数的this。在这个例子中,因为包裹箭头函数的第一个普通函数是a,所以此时的this是window。另外对箭头函数使用bind这类函数是无效的。 - 最后种情况也就是
bind这些改变上下文的API了,对于这些函数来说,this取决于第一个参数,如果第一个参数为空,那么就是window。 - 那么说到
bind,不知道大家是否考虑过,如果对一个函数进行多次bind,那么上下文会是什么呢?
let a = {}
let fn = function () { console.log(this) }
fn.bind().bind(a)() // => ?
如果你认为输出结果是
a,那么你就错了,其实我们可以把上述代码转换成另一种形式
// fn.bind().bind(a) 等于
let fn2 = function fn1() {
  return function() {
    return fn.apply()
  }.apply(a)
}
fn2()
可以从上述代码中发现,不管我们给函数
bind几次,fn中的this永远由第一次bind决定,所以结果永远是window
let a = { name: 'poetries' }
function foo() {
  console.log(this.name)
}
foo.bind(a)() // => 'poetries'
以上就是
this的规则了,但是可能会发生多个规则同时出现的情况,这时候不同的规则之间会根据优先级最高的来决定this最终指向哪里。
首先,
new的方式优先级最高,接下来是bind这些函数,然后是obj.foo()这种调用方式,最后是foo这种调用方式,同时,箭头函数的this一旦被绑定,就不会再被任何方式所改变。
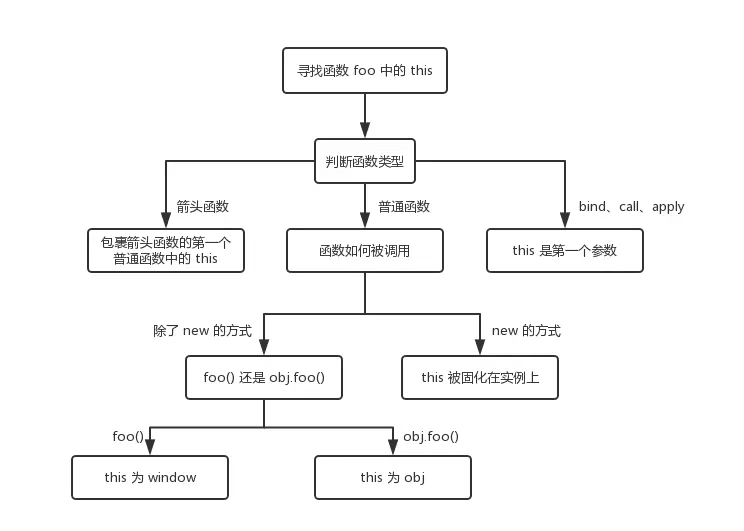
函数执行改变this
- 由于 JS 的设计原理: 在函数中,可以引用运行环境中的变量。因此就需要一个机制来让我们可以在函数体内部获取当前的运行环境,这便是
this。
因此要明白
this指向,其实就是要搞清楚 函数的运行环境,说人话就是,谁调用了函数。例如
obj.fn(),便是obj调用了函数,既函数中的this === objfn(),这里可以看成window.fn(),因此this === window
但这种机制并不完全能满足我们的业务需求,因此提供了三种方式可以手动修改
this的指向:
call: fn.call(target, 1, 2)apply: fn.apply(target, [1, 2])bind: fn.bind(target)(1,2)
💬 面试官追问
setTimeout(user.sayHi, 100)打印出来this.name是undefined,为什么?传进去的只是函数本身,到时候是定时器直接调用它,没有
user.这个前缀,this走默认绑定。改成setTimeout(() => user.sayHi(), 100)或者user.sayHi.bind(user)。fn.bind(a).bind(b)()里的this是谁?是
a。第一次bind返回的函数内部已经写死了用a去调fn,第二次bind只是改了外面那层包装的this,里面根本不看。一个函数先
bind(config),再用new调用,实例上的this是config吗?不是,
new优先级比bind高,this是新创建的实例,config被忽略,但bind预置的参数还在。手写bind要用this instanceof bound判断是不是被new调用的。事件系统用
handler.call(ctx, e)注入上下文,有人把handler改成箭头函数后拿不到ctx了,怎么回事?箭头函数的
this在定义时就从外层继承了,call的第一个参数对它无效。依赖运行时注入this的地方就得用普通函数,或者干脆改成把ctx当参数传。React类组件里onClick={this.handleSave}点了报错,怎么修?传出去的是裸函数,
React调用时this是undefined。在构造器里bind一次,或者写成类字段handleSave = () => {};别在render里写.bind(this),每次渲染都生成新函数,子组件的memo会失效。
# 3 apply/call/bind 原理
⚡ 30 秒速记
- 三个都用来指定
this:call(ctx, a, b)逐个传参、apply(ctx, [a, b])传数组,都立即执行 bind返回新函数,不执行,可以预置参数(偏函数)- 手写
call:把函数临时挂到ctx上执行再删掉,键名用Symbol防止覆盖同名属性 - 手写
bind的考点:被new调用时绑定的this要作废,实例原型要接上原函数的prototype - 典型用法是「借方法」:
Array.prototype.slice.call(arguments)、Object.prototype.toString.call(v)
call、apply、bind 都是给函数指定 this,call 和 apply 立即执行,只是传参一个逐个一个数组;bind 不执行,返回一个绑好 this 的新函数。 手写 call 的思路很朴素:this 本来就看「谁点出来的」,那就把函数临时挂到目标对象上,ctx[key](...args) 调一次再删掉,key 用 Symbol 避免把对象原有的属性冲掉。bind 难一点,要用闭包存住 ctx 和预置参数,还要处理被 new 调用的情况,这时 this 应该是新实例而不是绑定对象。现在有了展开运算符,fn.apply(null, arr) 基本都能写成 fn(...arr)。
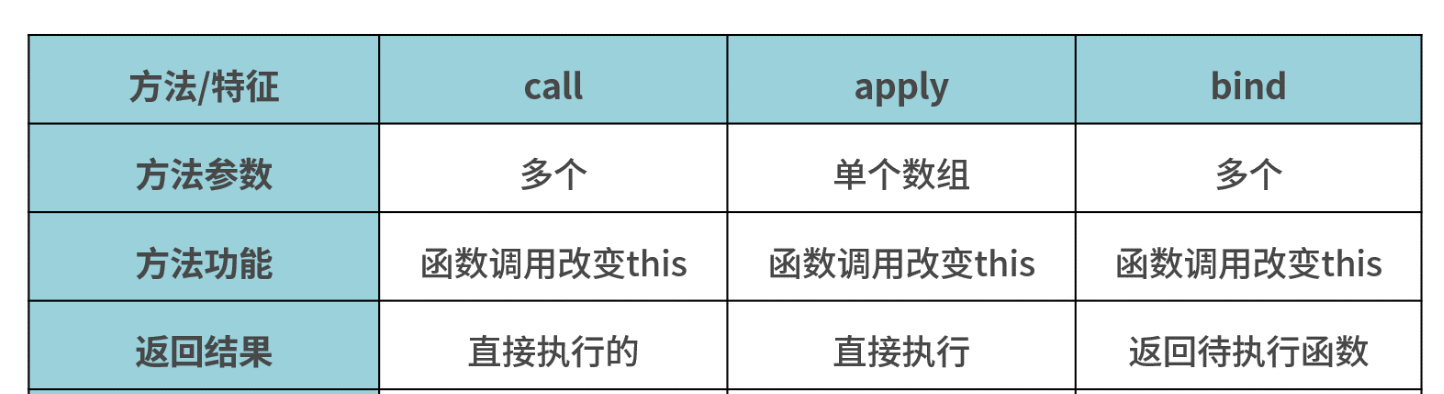
call、apply和bind是挂在Function对象上的三个方法,调用这三个方法的必须是一个函数。
func.call(thisArg, param1, param2, ...)
func.apply(thisArg, [param1,param2,...])
func.bind(thisArg, param1, param2, ...)
- 在浏览器里,在全局范围内this 指向window对象;
- 在函数中,this永远指向最后调用他的那个对象;
- 构造函数中,this指向new出来的那个新的对象;
call、apply、bind中的this被强绑定在指定的那个对象上;- 箭头函数中this比较特殊,箭头函数this为父作用域的this,不是调用时的this.要知道前四种方式,都是调用时确定,也就是动态的,而箭头函数的this指向是静态的,声明的时候就确定了下来;
apply、call、bind都是js给函数内置的一些API,调用他们可以为函数指定this的执行,同时也可以传参。
let a = {
    value: 1
}
function getValue(name, age) {
    console.log(name)
    console.log(age)
    console.log(this.value)
}
getValue.call(a, 'poe', '24')
getValue.apply(a, ['poe', '24'])
bind和其他两个方法作用也是一致的,只是该方法会返回一个函数。并且我们可以通过bind实现柯里化
方法的应用场景
下面几种应用场景,你多加体会就可以发现它们的理念都是“借用”方法的思路。我们来看看都有哪些。
- 判断数据类型
用
Object.prototype.toString来判断类型是最合适的,借用它我们几乎可以判断所有类型的数据
function getType(obj){
  let type  = typeof obj;
  if (type !== "object") {
    return type;
  }
  return Object.prototype.toString.call(obj).replace(/^$/, '$1');
}
- 类数组借用方法
类数组因为不是真正的数组,所有没有数组类型上自带的种种方法,所以我们就可以利用一些方法去借用数组的方法,比如借用数组的
push方法,看下面的一段代码。
var arrayLike = {
  0: 'java',
  1: 'script',
  length: 2
}
Array.prototype.push.call(arrayLike, 'jack', 'lily');
console.log(typeof arrayLike); // 'object'
console.log(arrayLike);
// {0: "java", 1: "script", 2: "jack", 3: "lily", length: 4}
用
call的方法来借用Array 原型链上的 push方法,可以实现一个类数组的 push方法,给arrayLike添加新的元素
- 获取数组的最大 / 最小值
我们可以用 apply 来实现数组中判断最大 / 最小值,
apply直接传递数组作为调用方法的参数,也可以减少一步展开数组,可以直接使用Math.max、Math.min来获取数组的最大值 / 最小值,请看下面这段代码。
let arr = [13, 6, 10, 11, 16];
const max = Math.max.apply(Math, arr);
const min = Math.min.apply(Math, arr);

console.log(max);  // 16
console.log(min);  // 6
实现一个 bind 函数
对于实现以下几个函数,可以从几个方面思考
- 不传入第一个参数,那么默认为
window - 改变了
this指向,让新的对象可以执行该函数。那么思路是否可以变成给新的对象添加一个函数,然后在执行完以后删除?
Function.prototype.myBind = function (context) {
  if (typeof this !== 'function') {
    throw new TypeError('Error')
  }
  var _this = this
  var args = [...arguments].slice(1)
  // 返回一个函数
  return function F() {
    // 因为返回了一个函数,我们可以 new F(),所以需要判断
    if (this instanceof F) {
      return new _this(...args, ...arguments)
    }
    return _this.apply(context, args.concat(...arguments))
  }
}
实现一个 call 函数
Function.prototype.myCall = function (context) {
  var context = context || window
  // 给 context 添加一个属性
  // getValue.call(a, 'pp', '24') => a.fn = getValue
  context.fn = this
  // 将 context 后面的参数取出来
  var args = [...arguments].slice(1)
  // getValue.call(a, 'pp', '24') => a.fn('pp', '24')
  var result = context.fn(...args)
  // 删除 fn
  delete context.fn
  return result
}
实现一个 apply 函数
Function.prototype.myApply = function(context = window, ...args) {
  // this-->func  context--> obj  args--> 传递过来的参数

  // 在context上加一个唯一值不影响context上的属性
  let key = Symbol('key')
  context[key] = this; // context为调用的上下文,this此处为函数,将这个函数作为context的方法
  // let args = [...arguments].slice(1)   //第一个参数为obj所以删除,伪数组转为数组

  let result = context[key](...args);
  delete context[key]; // 不删除会导致context属性越来越多
  return result;
}
// 使用
function f(a,b){
 console.log(a,b)
 console.log(this.name)
}
let obj={
 name:'张三'
}
f.myApply(obj,[1,2])  //arguments[1]
💬 面试官追问
手写的
myCall用context.fn = this,调用完对象原来的fn字段没了,怎么修?固定属性名会覆盖原有字段,后面
delete又把它删了。改成const key = Symbol(),挂上去调完删掉,删除放finally里,函数抛错也能清理干净。context = context || window这行有什么问题?||会把0、''、false都当成没传,fn.myCall(0)的this就跑到window去了。只有null和undefined才该回退,写成context == null ? globalThis : Object(context),Object()顺便把原始值装箱。Math.max.apply(null, bigArr)在数组有几十万项时报错了,为什么?apply会把每一项都当成独立实参传进去,参数个数超过引擎上限就抛RangeError,换成...bigArr也一样。大数组老老实实用reduce或for循环求最大值。手写
bind写成return (...args) => fn.apply(ctx, args),new一下就挂了,缺什么?箭头函数不能
new。要返回普通函数,里面判断this instanceof bound:是的话用this调原函数,否则用ctx;再让bound.prototype = Object.create(fn.prototype),实例才能用上原型方法。function bound(...rest) { const isNew = this instanceof bound return fn.apply(isNew ? this : ctx, [...preset, ...rest]) } bound.prototype = Object.create(fn.prototype)类数组
{0:'a', 1:'b', length:2}想用push,不转数组能做到吗?可以借:
Array.prototype.push.call(obj, 'c'),push只依赖length和数字下标,执行后obj.length变成3。不过新代码里一般直接Array.from(obj)转成真数组再操作,好读得多。
# 4 变量提升
⚡ 30 秒速记
- 提升不是代码被挪到顶部,而是进入作用域时先把声明登记好,再逐行执行
var:登记并初始化成undefined,声明前读到undefinedlet/const/class:也登记了但没初始化,声明前访问抛ReferenceError,这段叫TDZ- 函数声明连函数体一起提升,同名时函数优先于
var,后面的函数声明覆盖前面的 - 函数表达式
var f = function(){}只提升变量,提前调用抛TypeError: f is not a function
变量提升说白了就是:代码执行前,引擎先把当前作用域里的声明扫一遍登记好,所以有些变量能在声明前用。 区别在登记时有没有初始化:var 直接给了 undefined,所以声明前读不报错;let 和 const 只登记不初始化,声明那行执行之前碰它就报 ReferenceError,这段区域叫暂时性死区。函数声明最特殊,整个函数体都提前准备好,所以可以先调用后声明。var 那种「静默拿到 undefined」很容易藏问题,现在我写代码默认 const,要改值才用 let,var 基本不碰。
当执行
JS代码时,会生成执行环境,只要代码不是写在函数中的,就是在全局执行环境中,函数中的代码会产生函数执行环境,只此两种执行环境。
b() // call b
console.log(a) // undefined

var a = 'Hello world'

function b() {
    console.log('call b')
}
想必以上的输出大家肯定都已经明白了,这是因为函数和变量提升的原因。通常提升的解释是说将声明的代码移动到了顶部,这其实没有什么错误,便于大家理解。但是更准确的解释应该是:在生成执行环境时,会有两个阶段。第一个阶段是创建的阶段,
JS解释器会找出需要提升的变量和函数,并且给他们提前在内存中开辟好空间,函数的话会将整个函数存入内存中,变量只声明并且赋值为undefined,所以在第二个阶段,也就是代码执行阶段,我们可以直接提前使用
- 在提升的过程中,相同的函数会覆盖上一个函数,并且函数优先于变量提升
b() // call b second

function b() {
    console.log('call b fist')
}
function b() {
    console.log('call b second')
}
var b = 'Hello world'
var会产生很多错误,所以在 ES6中引入了let。let不能在声明前使用,但是这并不是常说的let不会提升,let提升了,在第一阶段内存也已经为他开辟好了空间,但是因为这个声明的特性导致了并不能在声明前使用
💬 面试官追问
console.log(price); var price = 99打印undefined,同事说引擎把代码搬到了顶部,对吗?当个比喻可以,但不准确。实际是执行前的创建阶段先登记了
price并初始化为undefined,赋值语句还在原地,执行到那行才变成99。下面这段输出什么?
b()
function b() { console.log(1) }
function b() { console.log(2) }
var b = 'x'
输出
2。同名函数声明后面的覆盖前面的,var b这个声明不会把已经登记的函数改成undefined,要等执行到b = 'x'那行才赋值,之后再调b()才会报错。配置读取从
var token改成let token后,启动直接报ReferenceError了,这是改出问题了吗?不是改坏了,是原本就有的初始化顺序问题被暴露出来。以前
var静默给了undefined,错误值一路往下传;现在TDZ让它当场失败,把读取挪到赋值之后就行。let x = 1; { console.log(x); let x = 2 }为什么报错,不是能读外层的x吗?块里的
let x已经在块开始时登记了,把外层的x遮住了,但还没初始化,所以读它就是TDZ报错。很多人以为没声明到就会去外层找,其实不会。TDZ里用typeof x也会报错吗?会。
typeof对完全没声明的变量返回'undefined',但对处在TDZ的let/const变量照样抛ReferenceError,所以「typeof永远安全」这个说法在ES6之后不成立了。
# 5 执行上下文
⚡ 30 秒速记
- 执行上下文 = 运行一段代码需要的环境:变量、作用域链、
this - 三种:全局、函数、
eval;靠调用栈管理,函数调用压栈、返回出栈 - 两个阶段:创建阶段登记声明(这就是提升的来源),执行阶段才赋值、调用
ES5讲VO/AO;ES6规范改叫词法环境(放let/const)和变量环境(放var),面试两套说法都要听得懂- 递归没出口把调用栈压满就是
Maximum call stack size exceeded
执行上下文可以理解成 JS 引擎跑一段代码时开的一个「工作台」,上面放着这段代码能用的变量、往外找变量的作用域链,以及 this。 全局代码一开始就有一个全局上下文,每调用一次函数就新建一个函数上下文压到调用栈顶上,函数返回就弹出。每个上下文都分两步:先创建,把形参、函数声明、变量登记好,var 先给 undefined;再执行,逐行赋值。所以变量提升本质上是创建阶段的副作用。老教材讲 VO、AO,新规范叫词法环境和变量环境,let 和 var 提升表现不同就是因为它们放在不同的环境里。
当执行 JS 代码时,会产生三种执行上下文
- 全局执行上下文
- 函数执行上下文
eval执行上下文
每个执行上下文中都有三个重要的属性
- 变量对象(
VO),包含变量、函数声明和函数的形参,该属性只能在全局上下文中访问 - 作用域链(
JS采用词法作用域,也就是说变量的作用域是在定义时就决定了) this
var a = 10
function foo(i) {
  var b = 20
}
foo()
对于上述代码,执行栈中有两个上下文:全局上下文和函数 foo 上下文。
stack = [
    globalContext,
    fooContext
]
对于全局上下文来说,
VO大概是这样的
globalContext.VO === globe
globalContext.VO = {
    a: undefined,
	foo: <Function>,
}
对于函数
foo来说,VO不能访问,只能访问到活动对象(AO)
fooContext.VO === foo.AO
fooContext.AO {
    i: undefined,
	b: undefined,
    arguments: <>
}
// arguments 是函数独有的对象(箭头函数没有)
// 该对象是一个伪数组,有 `length` 属性且可以通过下标访问元素
// 该对象中的 `callee` 属性代表函数本身
// `caller` 属性代表函数的调用者
对于作用域链,可以把它理解成包含自身变量对象和上级变量对象的列表,通过
[[Scope]]属性查找上级变量
fooContext.[[Scope]] = [
    globalContext.VO
]
fooContext.Scope = fooContext.[[Scope]] + fooContext.VO
fooContext.Scope = [
    fooContext.VO,
    globalContext.VO
]
接下来让我们看一个老生常谈的例子,
var
b() // call b
console.log(a) // undefined

var a = 'Hello world'

function b() {
	console.log('call b')
}
想必以上的输出大家肯定都已经明白了,这是因为函数和变量提升的原因。通常提升的解释是说将声明的代码移动到了顶部,这其实没有什么错误,便于大家理解。但是更准确的解释应该是:在生成执行上下文时,会有两个阶段。第一个阶段是创建的阶段(具体步骤是创建
VO),JS解释器会找出需要提升的变量和函数,并且给他们提前在内存中开辟好空间,函数的话会将整个函数存入内存中,变量只声明并且赋值为undefined,所以在第二个阶段,也就是代码执行阶段,我们可以直接提前使用。
- 在提升的过程中,相同的函数会覆盖上一个函数,并且函数优先于变量提升
b() // call b second

function b() {
	console.log('call b fist')
}
function b() {
	console.log('call b second')
}
var b = 'Hello world'
var会产生很多错误,所以在ES6中引入了let。let不能在声明前使用,但是这并不是常说的let不会提升,let提升了声明但没有赋值,因为临时死区导致了并不能在声明前使用。
- 对于非匿名的立即执行函数需要注意以下一点
var foo = 1
(function foo() {
    foo = 10
    console.log(foo)
}()) // -> ƒ foo() { foo = 10 ; console.log(foo) }
因为当
JS解释器在遇到非匿名的立即执行函数时,会创建一个辅助的特定对象,然后将函数名称作为这个对象的属性,因此函数内部才可以访问到foo,但是这个值又是只读的,所以对它的赋值并不生效,所以打印的结果还是这个函数,并且外部的值也没有发生更改。
specialObject = {};

Scope = specialObject + Scope;

foo = new FunctionExpression;
foo.[[Scope]] = Scope;
specialObject.foo = foo; // {DontDelete}, {ReadOnly}

delete Scope[0]; // remove specialObject from the front of scope chain
总结
执行上下文可以简单理解为一个对象:
它包含三个部分:
- 变量对象(
VO) - 作用域链(词法作用域)
this指向
它的类型:
- 全局执行上下文
- 函数执行上下文
eval执行上下文
代码执行过程:
- 创建 全局上下文 (
global EC) - 全局执行上下文 (
caller) 逐行 自上而下 执行。遇到函数时,函数执行上下文 (callee) 被push到执行栈顶层 - 函数执行上下文被激活,成为
active EC, 开始执行函数中的代码,caller被挂起 - 函数执行完后,
callee被pop移除出执行栈,控制权交还全局上下文 (caller),继续执行
💬 面试官追问
下面这段代码执行到
foo里面时,调用栈里有几个上下文?var a = 10 function foo(i) { var b = 20 } foo(1)两个:栈底是全局上下文,栈顶是
foo的函数上下文,foo返回后它出栈。foo上下文里登记了形参i、局部变量b和arguments。普通函数改成箭头函数之后,
arguments[0]报错了,为什么?箭头函数的上下文里没有自己的
arguments,读到的是外层函数的,外层没有就直接报错。改用剩余参数(...args) => args[0],写法也更清楚。线上报
Maximum call stack size exceeded,调用栈全是renderNode,怎么查?每递归一层就压一个上下文,没出口就压爆了。先看终止条件,再看数据里是不是有环,比如树节点的
children引用了祖先;数据量本来就很深的话改成用数组模拟栈的迭代写法。同一个函数调用两次,两次的局部变量是同一份吗?
不是,每次调用都新建一个执行上下文,局部变量各是各的。闭包能「记住」变量,也是因为某次调用的环境被内部函数引用着,没被回收。
作用域链是在执行上下文创建时才确定的吗?
链是在创建上下文时串起来的,但往外指向哪个环境,是由函数定义的位置决定的,函数创建时就把外层环境记在内部的
[[Environment]]上了。所以在哪调用都不影响它查到哪个变量。
# 6 作用域
⚡ 30 秒速记
- 作用域管「变量在哪能访问」,作用域链管「当前找不到时去哪找」
- 三种:全局、函数、块级(
let/const在{}里形成) JS是词法作用域:链由函数写在哪决定,和在哪调用无关,这点正好和this相反- 查找由内向外,命中最近的同名变量就停;全找不到抛
ReferenceError - 别混:作用域链找变量,原型链找对象的属性
作用域就是变量的可见范围,查变量时从当前作用域一层层往外找,这条路线就叫作用域链,而且它在函数写下的那一刻就定了。 举个例子,一个函数在模块顶层定义,不管把它拿到哪个回调里调用,它查到的都是模块顶层的变量,不会去查调用处的局部变量,这就是词法作用域。块级作用域是 ES6 才有的,let 和 const 只在所在的 {} 里有效,var 会无视块直接挂到函数作用域上。工程上就一条原则:变量的范围越小越好,全局变量越少越好。
- 作用域: 作用域是定义变量的区域,它有一套访问变量的规则,这套规则来管理浏览器引擎如何在当前作用域以及嵌套的作用域中根据变量(标识符)进行变量查找
- 作用域链: 作用域链的作用是保证对执行环境有权访问的所有变量和函数的有序访问,通过作用域链,我们可以访问到外层环境的变量和 函数。
作用域链的本质上是一个指向变量对象的指针列表。变量对象是一个包含了执行环境中所有变量和函数的对象。作用域链的前 端始终都是当前执行上下文的变量对象。全局执行上下文的变量对象(也就是全局对象)始终是作用域链的最后一个对象。
- 当我们查找一个变量时,如果当前执行环境中没有找到,我们可以沿着作用域链向后查找
- 作用域链的创建过程跟执行上下文的建立有关....
作用域可以理解为变量的可访问性,总共分为三种类型,分别为:
- 全局作用域
- 函数作用域
- 块级作用域,ES6 中的
let、const就可以产生该作用域
其实看完前面的闭包、this 这部分内部的话,应该基本能了解作用域的一些应用。
一旦我们将这些作用域嵌套起来,就变成了另外一个重要的知识点「作用域链」,也就是 JS 到底是如何访问需要的变量或者函数的。
- 首先作用域链是在定义时就被确定下来的,和箭头函数里的 this 一样,后续不会改变,JS 会一层层往上寻找需要的内容。
- 其实作用域链这个东西我们在闭包小结中已经看到过它的实体了:
[[Scopes]]
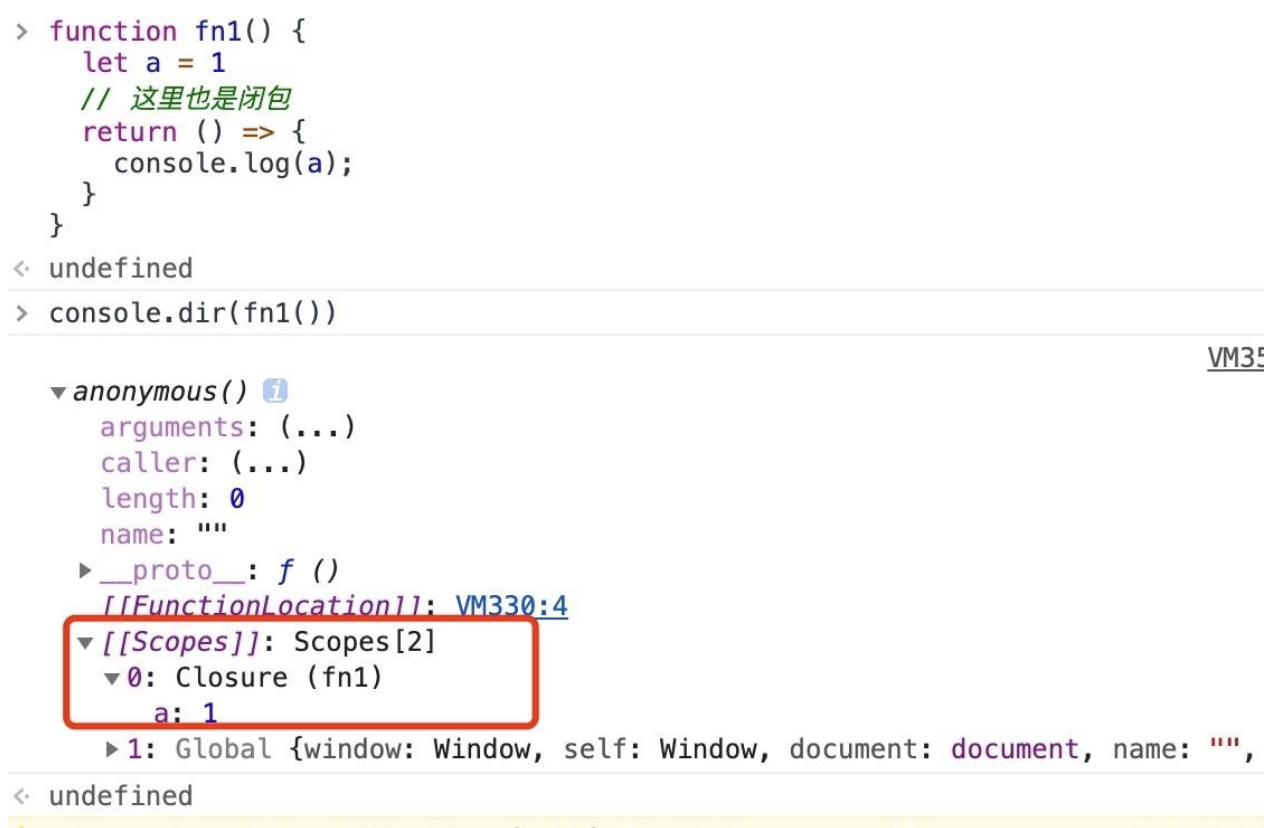
图中的 [[Scopes]] 是个数组,作用域的一层层往上寻找就等同于遍历 [[Scopes]]。
1. 全局作用域
全局变量是挂载在 window 对象下的变量,所以在网页中的任何位置你都可以使用并且访问到这个全局变量
var globalName = 'global';
function getName() {
  console.log(globalName) // global
  var name = 'inner'
  console.log(name) // inner
}
getName();
console.log(name); //
console.log(globalName); //global
function setName(){
  vName = 'setName';
}
setName();
console.log(vName); // setName
- 从这段代码中我们可以看到,globalName 这个变量无论在什么地方都是可以被访问到的,所以它就是全局变量。而在 getName 函数中作为局部变量的 name 变量是不具备这种能力的
- 当然全局作用域有相应的缺点,我们定义很多全局变量的时候,会容易引起变量命名的冲突,所以在定义变量的时候应该注意作用域的问题。
2. 函数作用域
函数中定义的变量叫作函数变量,这个时候只能在函数内部才能访问到它,所以它的作用域也就是函数的内部,称为函数作用域
function getName () {
  var name = 'inner';
  console.log(name); //inner
}
getName();
console.log(name);
除了这个函数内部,其他地方都是不能访问到它的。同时,当这个函数被执行完之后,这个局部变量也相应会被销毁。所以你会看到在 getName 函数外面的 name 是访问不到的
3. 块级作用域
ES6 中新增了块级作用域,最直接的表现就是新增的 let 关键词,使用 let 关键词定义的变量只能在块级作用域中被访问,有“暂时性死区”的特点,也就是说这个变量在定义之前是不能被使用的。
在 JS 编码过程中 if 语句及 for 语句后面 {...} 这里面所包括的,就是块级作用域
console.log(a) //a is not defined
if(true){
  let a = '123';
  console.log(a); // 123
}
console.log(a) //a is not defined
从这段代码可以看出,变量 a 是在
if 语句{...}中由let 关键词进行定义的变量,所以它的作用域是 if 语句括号中的那部分,而在外面进行访问 a 变量是会报错的,因为这里不是它的作用域。所以在 if 代码块的前后输出 a 这个变量的结果,控制台会显示 a 并没有定义
💬 面试官追问
if (ok) { let banner = 'A' }之后console.log(banner)报错,可条件明明是真的啊?能不能访问只看代码写在哪,不看有没有执行过。
banner只活在if那对花括号里,出来就没了;外面要用就在外层声明、块里赋值。下面打印什么?
const theme = 'light'
function show() { console.log(theme) }
function page() { const theme = 'dark'; show() }
page()
打印
'light'。show定义在顶层,它的外层就是顶层,在page里调用也不会去看page的theme,这就是词法作用域。函数里写了
vName = 'x'没加声明,外面居然能读到,为什么?非严格模式下给未声明的变量赋值会隐式创建全局变量,等于挂到了
window上。这是隐患来源,严格模式下直接抛ReferenceError,ES Module默认就是严格模式。老页面两个
<script>组件都声明了顶层var status,互相覆盖,不上模块化怎么隔离?各自包一个
IIFE:(function(){ var status = ... })(),变量就关在函数作用域里了,只把需要的接口挂到一个命名空间上。顺带一提,var status在全局还会撞上window.status这个内置属性。作用域链和原型链都是「一层层往上找」,区别在哪?
作用域链找的是变量名,比如
count,找不到报ReferenceError;原型链找的是对象属性,比如obj.count,找不到返回undefined。一个是写代码时的词法结构,一个是对象之间的引用关系。
# 7 闭包
⚡ 30 秒速记
- 闭包 = 函数 + 它定义时所在的词法环境,函数「记住了自己出生的地方」
- 外层函数返回后,只要内部函数还被引用,它用到的外层变量就不会回收
- 经典题:
for (var i...)+setTimeout打印的全是循环结束后的值;改let(每轮新绑定)或IIFE传参 - 用途:私有变量、函数工厂 / 柯里化、缓存、防抖节流里保存定时器
- 闭包本身不是泄漏,忘了解绑的监听、没清的定时器长期拿着闭包才是
闭包就是函数带着它出生时的环境一起走,所以外层函数执行完了,内部函数还能访问外层的变量。 比如一个 createCounter 里声明 let count = 0,返回一个 () => ++count,外面拿到这个函数一直调,count 就一直在涨,但外部谁也改不了它,这就是私有变量。面试最爱考循环里的 setTimeout:用 var 时五个回调共享同一个 i,等它们执行时循环早跑完了;换成 let,每一轮都是新的 i。工作里闭包无处不在,要注意的是长期存活的回调别引用大对象,组件卸载时记得解绑。
闭包其实就是一个可以访问其他函数内部变量的函数。创建闭包的最常见的方式就是在一个函数内创建另一个函数,创建的函数可以 访问到当前函数的局部变量。
因为通常情况下,函数内部变量是无法在外部访问的(即全局变量和局部变量的区别),因此使用闭包的作用,就具备实现了能在外部访问某个函数内部变量的功能,让这些内部变量的值始终可以保存在内存中。下面我们通过代码先来看一个简单的例子
function fun1() {
	var a = 1;
	return function(){
		console.log(a);
	};
}
fun1();
var result = fun1();
result();  // 1

// 结合闭包的概念,我们把这段代码放到控制台执行一下,就可以发现最后输出的结果是 1(即 a 变量的值)。那么可以很清楚地发现,a 变量作为一个 fun1 函数的内部变量,正常情况下作为函数内的局部变量,是无法被外部访问到的。但是通过闭包,我们最后还是可以拿到 a 变量的值
闭包有两个常用的用途
- 闭包的第一个用途是使我们在函数外部能够访问到函数内部的变量。通过使用闭包,我们可以通过在外部调用闭包函数,从而在外部访问到函数内部的变量,可以使用这种方法来创建私有变量。
- 函数的另一个用途是使已经运行结束的函数上下文中的变量对象继续留在内存中,因为闭包函数保留了这个变量对象的引用,所以这个变量对象不会被回收。
其实闭包的本质就是作用域链的一个特殊的应用,只要了解了作用域链的创建过程,就能够理解闭包的实现原理。
let a = 1
// fn 是闭包
function fn() {
  console.log(a);
}

function fn1() {
  let a = 1
  // 这里也是闭包
  return () => {
    console.log(a);
  }
}
const fn2 = fn1()
fn2()
- 大家都知道闭包其中一个作用是访问私有变量,就比如上述代码中的 fn2 访问到了 fn1 函数中的变量 a。但是此时 fn1 早已销毁,我们是如何访问到变量 a 的呢?不是都说原始类型是存放在栈上的么,为什么此时却没有被销毁掉?
- 接下来笔者会根据浏览器的表现来重新理解关于原始类型存放位置的说法。
- 先来说下数据存放的正确规则是:局部、占用空间确定的数据,一般会存放在栈中,否则就在堆中(也有例外)。 那么接下来我们可以通过 Chrome 来帮助我们验证这个说法说法。
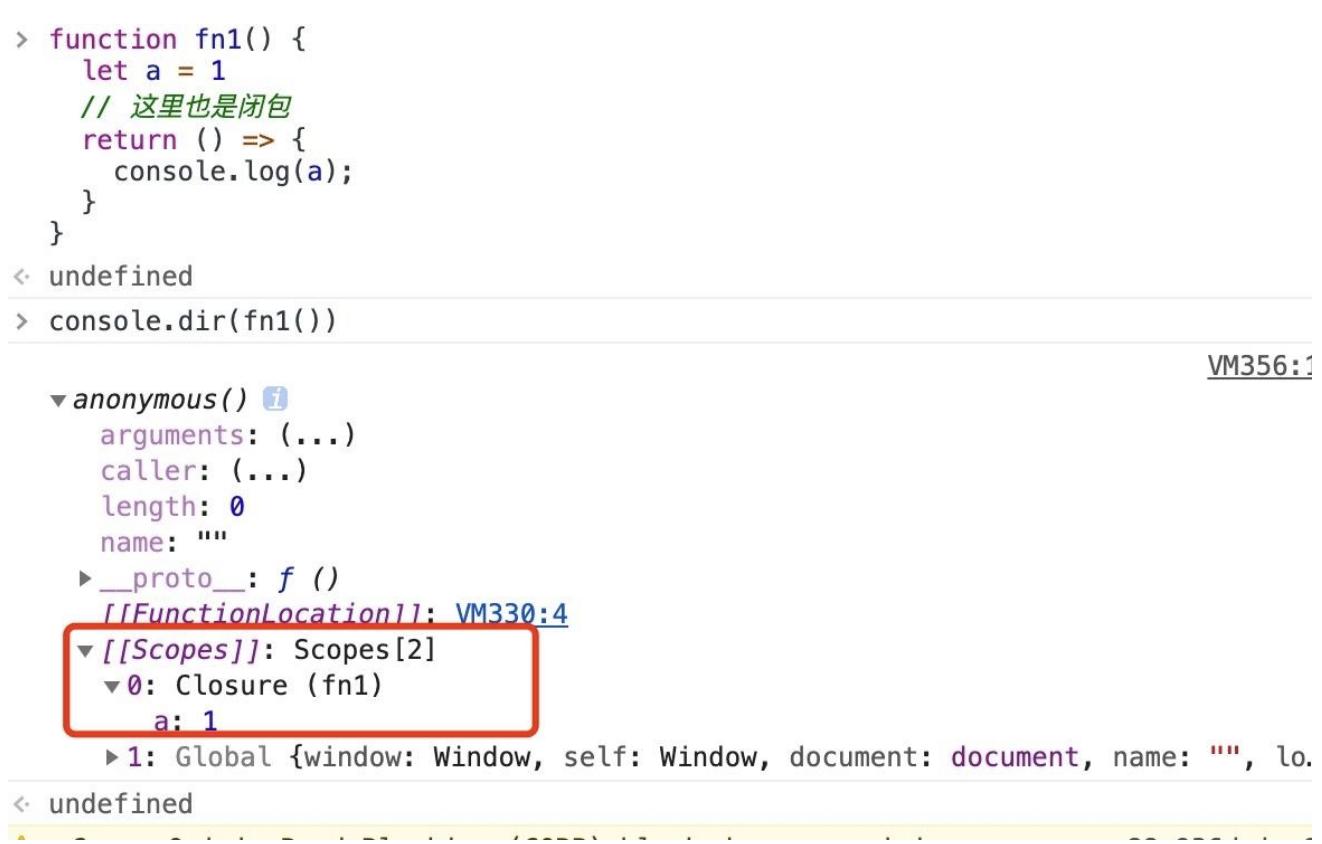
上图中画红框的位置我们能看到一个内部的对象
[[Scopes]],其中存放着变量 a,该对象是被存放在堆上的,其中包含了闭包、全局对象等等内容,因此我们能通过闭包访问到本该销毁的变量。
另外最开始我们对于闭包的定位是:假如一个函数能访问外部的变量,那么这个函数它就是一个闭包,因此接下来我们看看在全局下的表现是怎么样的。
let a = 1
var b = 2
// fn 是闭包
function fn() {
  console.log(a, b);
}
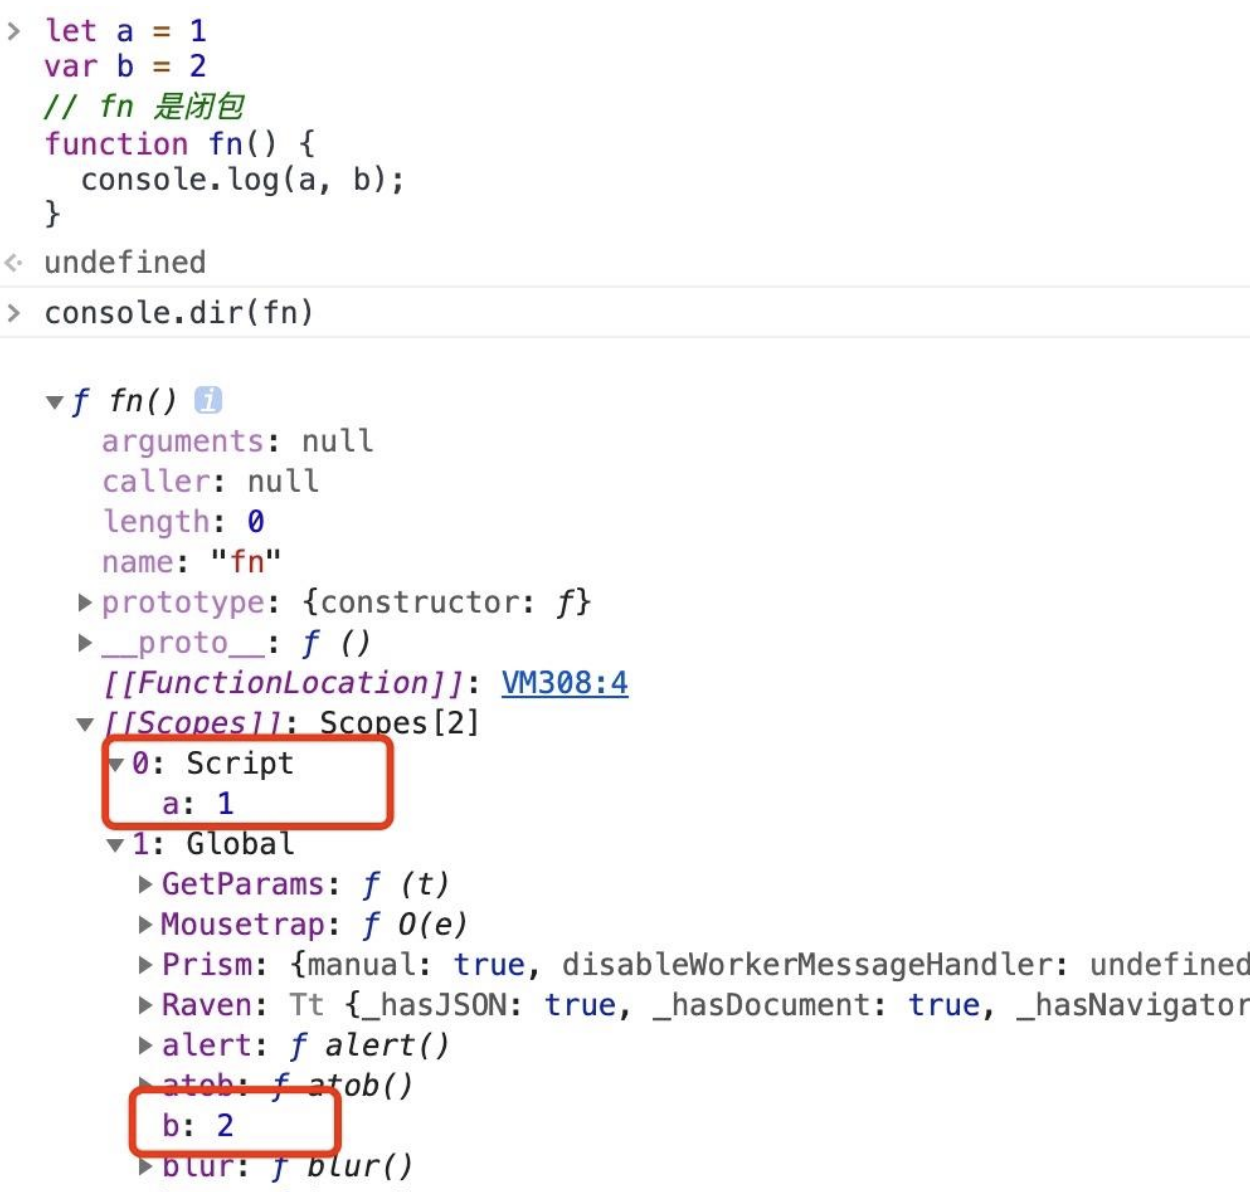
从上图我们能发现全局下声明的变量,如果是 var 的话就直接被挂到 globe 上,如果是其他关键字声明的话就被挂到 Script 上。虽然这些内容同样还是存在 [[Scopes]],但是全局变量应该是存放在静态区域的,因为全局变量无需进行垃圾回收,等需要回收的时候整个应用都没了。
只有在下图的场景中,原始类型才可能是被存储在栈上。
这里为什么要说可能,是因为 JS 是门动态类型语言,一个变量声明时可以是原始类型,马上又可以赋值为对象类型,然后又回到原始类型。这样频繁的在堆栈上切换存储位置,内部引擎是不是也会有什么优化手段,或者干脆全部都丢堆上?只有 const 声明的原始类型才一定存在栈上?当然这只是笔者的一个推测,暂时没有深究,读者可以忽略这段瞎想
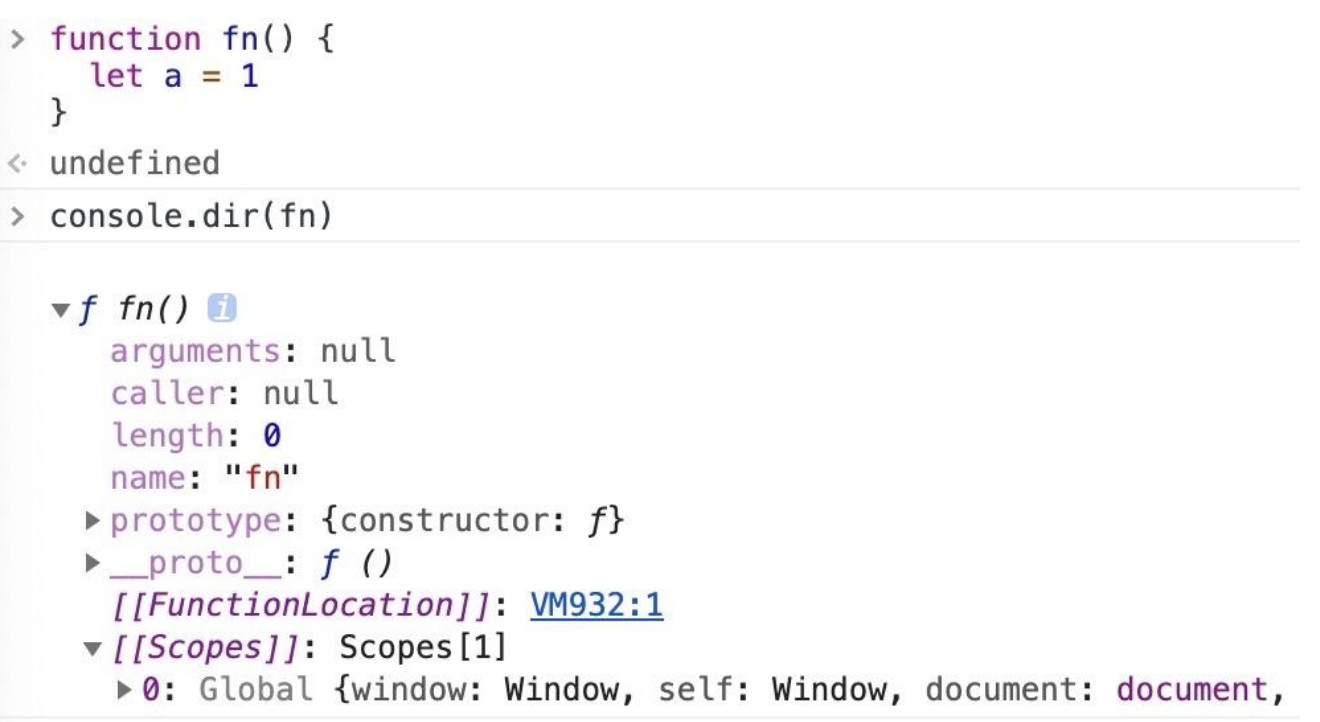
因此笔者对于原始类型存储位置的理解为:局部变量才是被存储在栈上,全局变量存在静态区域上,其它都存储在堆上。
当然这个理解是建立的 Chrome 的表现之上的,在不同的浏览器上因为引擎的不同,可能存储的方式还是有所变化的。
闭包产生的原因
我们在前面介绍了作用域的概念,那么你还需要明白作用域链的基本概念。其实很简单,当访问一个变量时,代码解释器会首先在当前的作用域查找,如果没找到,就去父级作用域去查找,直到找到该变量或者不存在父级作用域中,这样的链路就是作用域链
需要注意的是,每一个子函数都会拷贝上级的作用域,形成一个作用域的链条。那么我们还是通过下面的代码来详细说明一下作用域链
var a = 1;
function fun1() {
  var a = 2
  function fun2() {
    var a = 3;
    console.log(a);//3
  }
}
- 从中可以看出,fun1 函数的作用域指向全局作用域(window)和它自己本身;fun2 函数的作用域指向全局作用域 (window)、fun1 和它本身;而作用域是从最底层向上找,直到找到全局作用域 window 为止,如果全局还没有的话就会报错。
- 那么这就很形象地说明了什么是作用域链,即当前函数一般都会存在上层函数的作用域的引用,那么他们就形成了一条作用域链。
- 由此可见,
闭包产生的本质就是:当前环境中存在指向父级作用域的引用。那么还是拿上的代码举例。
function fun1() {
  var a = 2
  function fun2() {
    console.log(a);  //2
  }
  return fun2;
}
var result = fun1();
result();
- 从上面这段代码可以看出,这里 result 会拿到父级作用域中的变量,输出 2。因为在当前环境中,含有对 fun2 函数的引用,fun2 函数恰恰引用了 window、fun1 和 fun2 的作用域。因此 fun2 函数是可以访问到 fun1 函数的作用域的变量。
- 那是不是只有返回函数才算是产生了闭包呢?其实也不是,回到闭包的本质,我们只需要让父级作用域的引用存在即可,因此还可以这么改代码,如下所示
var fun3;
function fun1() {
  var a = 2
  fun3 = function() {
    console.log(a);
  }
}
fun1();
fun3();
可以看出,其中实现的结果和前一段代码的效果其实是一样的,就是在给 fun3 函数赋值后,fun3 函数就拥有了 window、fun1 和 fun3 本身这几个作用域的访问权限;然后还是从下往上查找,直到找到 fun1 的作用域中存在 a 这个变量;因此输出的结果还是 2,最后产生了闭包,形式变了,本质没有改变。
因此最后返回的不管是不是函数,也都不能说明没有产生闭包
闭包的表现形式
- 返回一个函数
在定时器、事件监听、Ajax 请求、Web Workers 或者任何异步中,只要使用了回调函数,实际上就是在使用闭包。请看下面这段代码,这些都是平常开发中用到的形式
// 定时器
setTimeout(function handler(){
  console.log('1');
},1000);
// 事件监听
$('#app').click(function(){
  console.log('Event Listener');
});
- 作为函数参数传递的形式,比如下面的例子。
var a = 1;
function foo(){
  var a = 2;
  function baz(){
    console.log(a);
  }
  bar(baz);
}
function bar(fn){
  // 这就是闭包
  fn();
}
foo();  // 输出2,而不是1
IIFE(立即执行函数),创建了闭包,保存了全局作用域(window)和当前函数的作用域,因此可以输出全局的变量,如下所示
var a = 2;
(function IIFE(){
  console.log(a);  // 输出2
})();
IIFE 这个函数会稍微有些特殊,算是一种自执行匿名函数,这个匿名函数拥有独立的作用域。这不仅可以避免了外界访问此 IIFE 中的变量,而且又不会污染全局作用域,我们经常能在高级的 JavaScript 编程中看见此类函数。
如何解决循环输出问题?
在互联网大厂的面试中,解决循环输出问题是比较高频的面试题,一般都会给一段这样的代码让你来解释
for(var i = 1; i <= 5; i ++){
  setTimeout(function() {
    console.log(i)
  }, 0)
}
上面这段代码执行之后,从控制台执行的结果可以看出来,结果输出的是 5 个 6,那么一般面试官都会先问为什么都是 6?我想让你实现输出 1、2、3、4、5 的话怎么办呢?
因此结合本讲所学的知识我们来思考一下,应该怎么给面试官一个满意的解释。你可以围绕这两点来回答。
setTimeout为宏任务,由于 JS 中单线程eventLoop 机制,在主线程同步任务执行完后才去执行宏任务,因此循环结束后 setTimeout 中的回调才依次执行- 因为
setTimeout函数也是一种闭包,往上找它的父级作用域链就是 window,变量 i 为 window 上的全局变量,开始执行 setTimeout 之前变量 i 已经就是 6 了,因此最后输出的连续就都是 6。
那么我们再来看看如何按顺序依次输出 1、2、3、4、5 呢?
- 利用 IIFE
可以利用 IIFE(立即执行函数),当每次 for 循环时,把此时的变量 i 传递到定时器中,然后执行,改造之后的代码如下。
for(var i = 1;i <= 5;i++){
  (function(j){
    setTimeout(function timer(){
      console.log(j)
    }, 0)
  })(i)
}
- 使用 ES6 中的 let
ES6 中新增的 let 定义变量的方式,使得 ES6 之后 JS 发生革命性的变化,让 JS 有了块级作用域,代码的作用域以块级为单位进行执行。通过改造后的代码,可以实现上面想要的结果。
for(let i = 1; i <= 5; i++){
  setTimeout(function() {
    console.log(i);
  },0)
}
- 定时器传入第三个参数
setTimeout 作为经常使用的定时器,它是存在第三个参数的,日常工作中我们经常使用的一般是前两个,一个是回调函数,另外一个是时间,而第三个参数用得比较少。那么结合第三个参数,调整完之后的代码如下。
for(var i=1;i<=5;i++){
  setTimeout(function(j) {
    console.log(j)
  }, 0, i)
}
从中可以看到,第三个参数的传递,可以改变 setTimeout 的执行逻辑,从而实现我们想要的结果,这也是一种解决循环输出问题的途径
常见考点
- 闭包能考的很多,概念和笔试题都会考。
- 概念题就是考考闭包是什么了。
- 笔试题的话基本都会结合上异步,比如最常见的:
for (var i = 0; i < 6; i++) {
  setTimeout(() => {
    console.log(i)
  })
}
这道题会问输出什么,有哪几种方式可以得到想要的答案?
💬 面试官追问
下面这段打印什么,怎么改成
1到5?for (var i = 1; i <= 5; i++) { setTimeout(() => console.log(i), 0) }打印五个
6,五个回调共享同一个i,执行时循环已经结束。把var改成let最简单;不能改的话用setTimeout(console.log, 0, i)把当轮值作为参数传进去。工厂函数都返回了,返回的函数还能读到里面的变量,是不是说明父函数还没结束?
父函数早就出栈了,留下来的是内部函数引用着的那块词法环境。只要内部函数还可达,它用到的变量就不会被回收,跟父函数在不在执行没关系。
怎么用闭包做一个外部改不了的重试计数?
function createRetry(max) {
  let n = 0
  return { next: () => n < max && ++n, reset: () => { n = 0 } }
}
外面只能通过
next和reset动它,拿不到n本身。单页应用来回切路由,内存一直涨,堆快照里还能找到旧页面的节点,你怎么查?
在
Memory面板拍两次快照对比,看旧节点的Retainers是谁拿着,通常是没解绑的addEventListener或者没清的setInterval回调,闭包里引用了旧组件。卸载时removeEventListener、clearInterval,或者用AbortController一次性解绑。闭包会把外层所有变量都留在内存里吗?
现代引擎会做优化,一般只保留内部函数实际用到的变量。但同一个外层函数里的多个闭包共享一个环境,其中一个用到了大对象,其他闭包活着时它也可能被拖住,
eval也会让引擎没法优化。
# 8 New的原理
⚡ 30 秒速记
- 四步:建空对象 → 原型指向
Fn.prototype→ 用它当this执行构造函数 → 决定返回什么 - 返回值规则:构造函数
return一个对象(含函数)就用它,返回原始值或null则忽略、照样返回实例 - 手写:
Object.create(Fn.prototype)+Fn.apply(obj, args)+ 判断返回值 - 箭头函数没有
prototype、没有自己的this,不能new;class不用new调用直接抛TypeError - 构造函数里可以用
new.target判断是不是被new调用的
new 帮你干了四件事:建一个空对象,把它的原型接到构造函数的 prototype 上,用这个对象当 this 跑一遍构造函数,最后把它返回。 所以实例自己身上有构造函数里 this.xxx 写的属性,又能沿原型链用到 prototype 上的方法。唯一的例外在最后一步:构造函数如果显式 return 了一个对象,new 的结果就是那个对象,前面建的实例直接丢掉;返回字符串、数字这种原始值会被忽略。手写的时候返回值判断别只写 typeof r === 'object',null 也会混进来,还会漏掉返回函数的情况。
常见考点
new做了那些事?new返回不同的类型时会有什么表现?- 手写 new 的实现过程
new 关键词的
主要作用就是执行一个构造函数、返回一个实例对象,在 new 的过程中,根据构造函数的情况,来确定是否可以接受参数的传递。下面我们通过一段代码来看一个简单的 new 的例子
function Person(){
   this.name = 'Jack';
}
var p = new Person();
console.log(p.name)  // Jack
这段代码比较容易理解,从输出结果可以看出,p 是一个通过 person 这个构造函数生成的一个实例对象,这个应该很容易理解。
new操作符可以帮助我们构建出一个实例,并且绑定上 this,内部执行步骤可大概分为以下几步:
- 创建一个新对象
- 对象连接到构造函数原型上,并绑定
this(this 指向新对象) - 执行构造函数代码(为这个新对象添加属性)
- 返回新对象
在第四步返回新对象这边有一个情况会例外:
那么问题来了,如果不用
new这个关键词,结合上面的代码改造一下,去掉new,会发生什么样的变化呢?我们再来看下面这段代码
function Person(){
  this.name = 'Jack';
}
var p = Person();
console.log(p) // undefined
console.log(name) // Jack
console.log(p.name) // 'name' of undefined
- 从上面的代码中可以看到,我们没有使用
new这个关键词,返回的结果就是undefined。其中由于JavaScript代码在默认情况下this的指向是window,那么name的输出结果就为Jack,这是一种不存在new关键词的情况。 - 那么当构造函数中有
return一个对象的操作,结果又会是什么样子呢?我们再来看一段在上面的基础上改造过的代码。
function Person(){
   this.name = 'Jack';
   return {age: 18}
}
var p = new Person();
console.log(p)  // {age: 18}
console.log(p.name) // undefined
console.log(p.age) // 18
通过这段代码又可以看出,当构造函数最后
return出来的是一个和this无关的对象时,new 命令会直接返回这个新对象,而不是通过 new 执行步骤生成的 this 对象
但是这里要求构造函数必须是返回一个对象,如果返回的不是对象,那么还是会按照 new 的实现步骤,返回新生成的对象。接下来还是在上面这段代码的基础之上稍微改动一下
function Person(){
   this.name = 'Jack';
   return 'tom';
}
var p = new Person();
console.log(p)  // {name: 'Jack'}
console.log(p.name) // Jack
可以看出,当构造函数中 return 的不是一个对象时,那么它还是会根据 new 关键词的执行逻辑,生成一个新的对象(绑定了最新 this),最后返回出来
因此我们总结一下:
new 关键词执行之后总是会返回一个对象,要么是实例对象,要么是 return 语句指定的对象
手工实现New的过程
function create(fn, ...args) {
  if(typeof fn !== 'function') {
    throw 'fn must be a function';
  }
	// 1、用new Object() 的方式新建了一个对象obj
  // var obj = new Object()
	// 2、给该对象的__proto__赋值为fn.prototype,即设置原型链
  // obj.__proto__ = fn.prototype

  // 1、2步骤合并
  // 创建一个空对象,且这个空对象继承构造函数的 prototype 属性
  // 即实现 obj.__proto__ === constructor.prototype
  var obj = Object.create(fn.prototype);

	// 3、执行fn,并将obj作为内部this。使用 apply,改变构造函数 this 的指向到新建的对象,这样 obj 就可以访问到构造函数中的属性
  var res = fn.apply(obj, args);
	// 4、如果fn有返回值,则将其作为new操作返回内容,否则返回obj
	return res instanceof Object ? res : obj;
};
- 使用
Object.create将obj 的proto指向为构造函数的原型; - 使用
apply方法,将构造函数内的this指向为obj; - 在
create返回时,使用三目运算符决定返回结果。
我们知道,构造函数如果有显式返回值,且返回值为对象类型,那么构造函数返回结果不再是目标实例
如下代码:
function Person(name) {
  this.name = name
  return {1: 1}
}
const person = new Person(Person, 'lucas')
console.log(person)
// {1: 1}
测试
//使用create代替new
function Person() {...}
// 使用内置函数new
var person = new Person(1,2)

// 使用手写的new,即create
var person = create(Person, 1,2)
new 被调用后大致做了哪几件事情
- 让实例可以访问到私有属性;
- 让实例可以访问构造函数原型(
constructor.prototype)所在原型链上的属性; - 构造函数返回的最后结果是引用数据类型。
💬 面试官追问
漏写了
new,const p = Person(),会发生什么?p是undefined,构造函数里的this.name = 'Jack'在非严格模式下写到了全局对象上,凭空多了个全局name。严格模式下this是undefined,直接报错;用class写就没这个问题,漏new会抛TypeError。构造函数里写了
this.key = 'A',最后return { key: 'B' },new出来的是什么?是
{ key: 'B' },原来那个实例被丢掉,而且这个对象的原型是Object.prototype,构造函数原型上的方法都用不了。构造函数
return null或者return 'tom',结果是什么?两种都返回新建的实例。
null虽然typeof是'object',但它不是对象,不会替换实例;手写时判断要写成r !== null && (typeof r === 'object' || typeof r === 'function')。手写
new里用obj.__proto__ = Fn.prototype和Object.create(Fn.prototype),选哪个?选
Object.create,创建时就带好原型,__proto__是历史遗留的访问器,而且事后改原型会让引擎的优化失效。完整写法:function myNew(Fn, ...args) { const obj = Object.create(Fn.prototype) const r = Fn.apply(obj, args) return r !== null && (typeof r === 'object' || typeof r === 'function') ? r : obj }怎么让一个普通构造函数漏写
new时也能正常工作?在函数开头判断
if (!new.target) return new Person(...arguments)。老代码会写if (!(this instanceof Person)),效果类似,但new.target更准。
# 9 原型/原型链
⚡ 30 秒速记
- 三个东西:
prototype是函数才有的属性;__proto__是对象指向原型的链接;constructor是原型上指回构造函数的属性 - 一句话串起来:
实例.__proto__ === 构造函数.prototype - 读属性先查自己,没有就沿原型往上找,到
Object.prototype再往上是null,找不到返回undefined - 绕人点:
Function.__proto__ === Function.prototype,Object.__proto__ === Function.prototype - 工程上用
Object.getPrototypeOf/Object.create/Object.hasOwn,别直接读写__proto__
原型链就是对象读属性时的「找爸爸」机制:自己身上没有,就去原型上找,原型上也没有就再往上,直到 Object.prototype 为止。 关系记住一个等式就够了:实例.__proto__ === 构造函数.prototype。所以把方法放在 prototype 上,所有实例共用同一份,这就是 JS 实现继承的方式,class 也只是它的语法糖。比如 [].push 能用,是因为数组的原型是 Array.prototype,({}).toString 能用,是因为一直找到了 Object.prototype。__proto__ 是浏览器历史上的实现,后来才被规范收编成兼容特性,代码里读原型用 Object.getPrototypeOf。
__proto__和prototype关系:__proto__和constructor是对象独有的。2️⃣prototype属性是函数独有的
在 js 中我们是使用构造函数来新建一个对象的,每一个构造函数的内部都有一个 prototype 属性值,这个属性值是一个对象,这个对象包含了可以由该构造函数的所有实例共享的属性和方法。当我们使用构造函数新建一个对象后,在这个对象的内部将包含一个指针,这个指针指向构造函数的 prototype 属性对应的值,在 ES5 中这个指针被称为对象的原型。一般来说我们是不应该能够获取到这个值的,但是现在浏览器中都实现了 proto 属性来让我们访问这个属性,但是我们最好不要使用这个属性,因为它不是规范中规定的。ES5 中新增了一个
Object.getPrototypeOf()方法,我们可以通过这个方法来获取对象的原型。
当我们访问一个对象的属性时,如果这个对象内部不存在这个属性,那么它就会去它的原型对象里找这个属性,这个原型对象又会有自己的原型,于是就这样一直找下去,也就是原型链的概念。原型链的尽头一般来说都是 Object.prototype 所以这就是我们新建的对象为什么能够使用 toString() 等方法的原因。
特点:JavaScript 对象是通过引用来传递的,我们创建的每个新对象实体中并没有一份属于自己的原型副本。当我们修改原型时,与 之相关的对象也会继承这一改变
- 原型(
prototype): 一个简单的对象,用于实现对象的 属性继承。可以简单的理解成对象的爹。在Firefox和Chrome中,每个JavaScript对象中都包含一个__proto__(非标准)的属性指向它爹(该对象的原型),可obj.__proto__进行访问。 - 构造函数: 可以通过
new来 新建一个对象 的函数。 - 实例: 通过构造函数和
new创建出来的对象,便是实例。 实例通过__proto__指向原型,通过constructor指向构造函数。
以
Object为例,我们常用的Object便是一个构造函数,因此我们可以通过它构建实例。
// 实例
const instance = new Object()
则此时, 实例为
instance, 构造函数为Object,我们知道,构造函数拥有一个prototype的属性指向原型,因此原型为:
// 原型
const prototype = Object.prototype
这里我们可以来看出三者的关系:
实例.__proto__ === 原型原型.constructor === 构造函数构造函数.prototype === 原型
// 这条线其实是是基于原型进行获取的,可以理解成一条基于原型的映射线
// 例如:
// const o = new Object()
// o.constructor === Object   --> true
// o.__proto__ = null;
// o.constructor === Object   --> false
实例.constructor === 构造函数
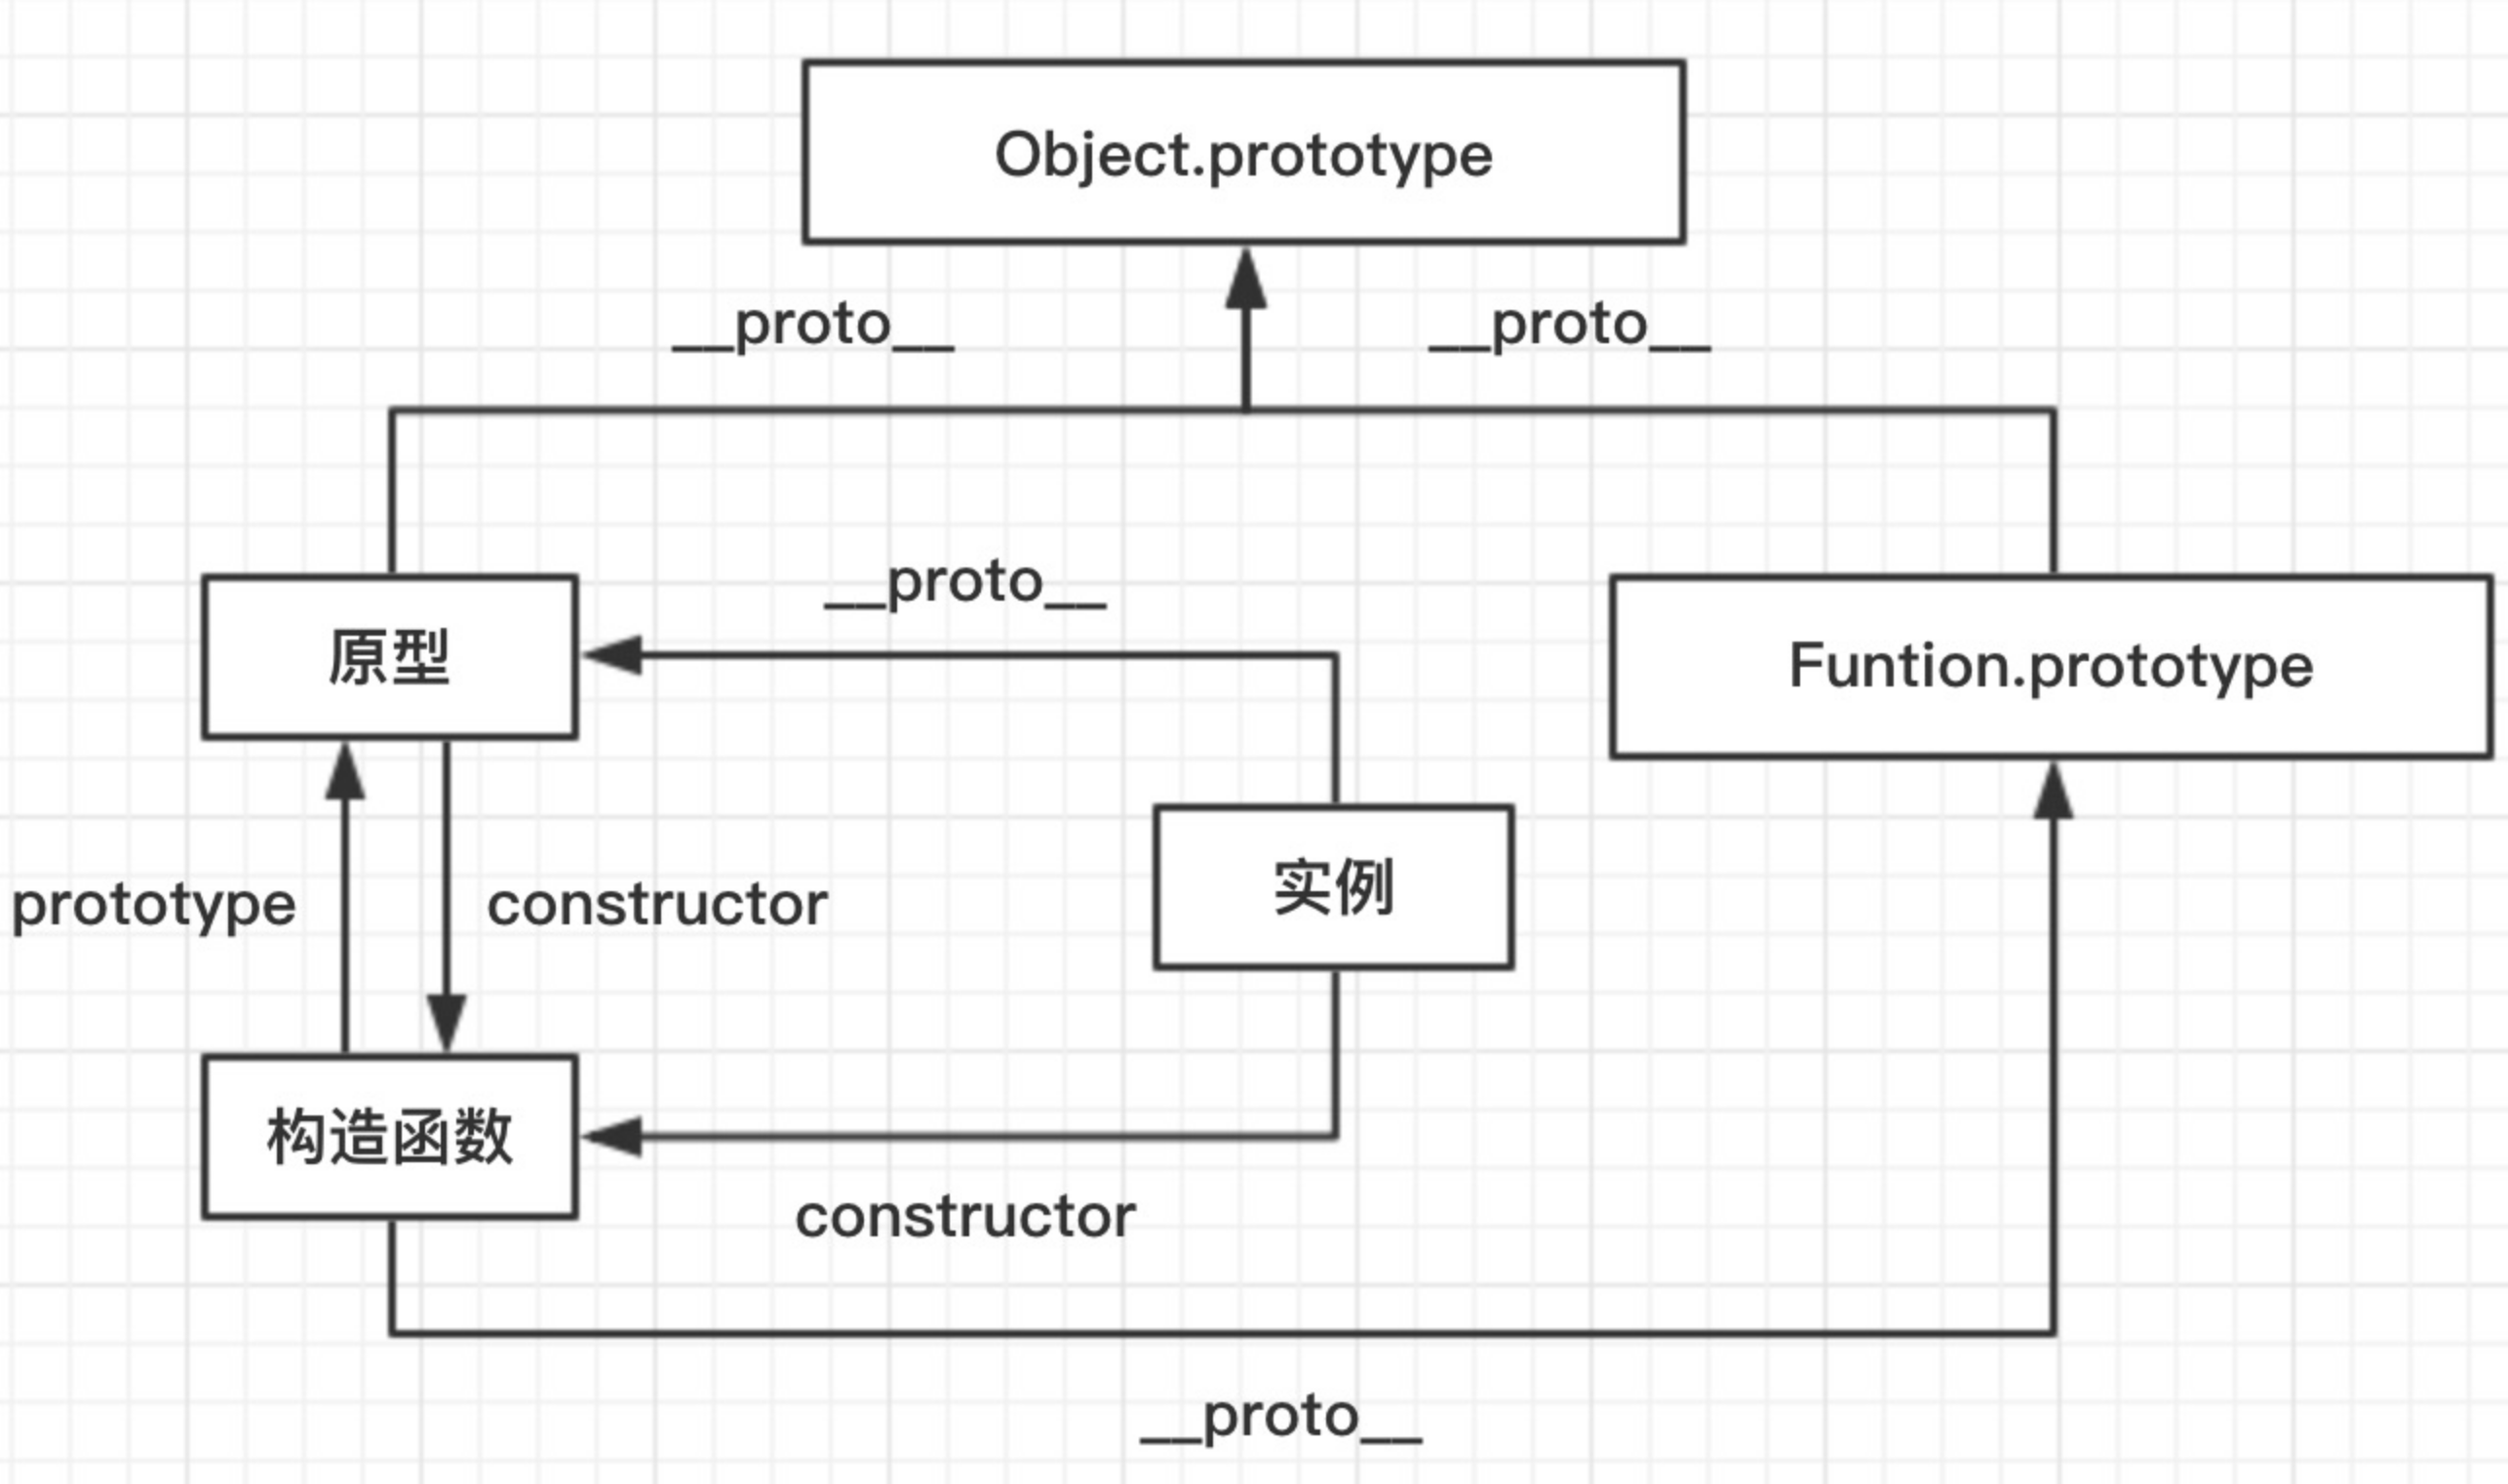
原型链
原型链是由原型对象组成,每个对象都有
__proto__属性,指向了创建该对象的构造函数的原型,__proto__将对象连接起来组成了原型链。是一个用来实现继承和共享属性的有限的对象链
- 属性查找机制: 当查找对象的属性时,如果实例对象自身不存在该属性,则沿着原型链往上一级查找,找到时则输出,不存在时,则继续沿着原型链往上一级查找,直至最顶级的原型对象
Object.prototype,如还是没找到,则输出undefined; - 属性修改机制: 只会修改实例对象本身的属性,如果不存在,则进行添加该属性,如果需要修改原型的属性时,则可以用:
b.prototype.x = 2;但是这样会造成所有继承于该对象的实例的属性发生改变。
js 获取原型的方法
p.protop.constructor.prototypeObject.getPrototypeOf(p)
总结

- 每个函数都有
prototype属性,除了Function.prototype.bind(),该属性指向原型。 - 每个对象都有
__proto__属性,指向了创建该对象的构造函数的原型。其实这个属性指向了[[prototype]],但是[[prototype]]是内部属性,我们并不能访问到,所以使用_proto_来访问。 - 对象可以通过
__proto__来寻找不属于该对象的属性,__proto__将对象连接起来组成了原型链。
💬 面试官追问
user.name能读到值,Object.keys(user)和JSON.stringify里却没有,为什么?name不在user自己身上,是从原型上读到的,这两个方法只看自有属性。用Object.hasOwn(user, 'name')确认一下,返回false就是继承来的。组件的格式化方法,放构造函数里
this.format = ...还是放prototype上?放
prototype。写在构造函数里,一万个实例就有一万个函数;放原型上大家共用一个。只有方法要用到构造函数里的私有闭包变量时才写在里面。线上热修复把
Widget.prototype.render换了,已经创建的实例会用新版吗?会,实例每次调用都是现查原型的。除非某个实例自己身上定义了
render,那它会挡住原型上的版本。item.constructor !== Item,能说明item不是Item的实例吗?不能,
constructor就是原型上一个普通属性,重写Item.prototype = {...}时很容易把它弄丢。判断实例关系用item instanceof Item或Object.getPrototypeOf(item) === Item.prototype。Object.create(null)创建的对象有什么特别?它没有原型,
toString、hasOwnProperty都没有,适合当纯字典用,不怕key叫constructor或__proto__撞上原型属性。判断自有属性就用Object.hasOwn(obj, k)。
# 10 继承
⚡ 30 秒速记
- 按演进讲:原型链继承(引用属性共享)→ 借用构造函数(方法不能复用)→ 组合继承(父构造函数跑两次)→ 寄生组合(
ES5最优) - 寄生组合三行:
Parent.call(this)+Child.prototype = Object.create(Parent.prototype)+ 修正constructor class extends是语法糖,还额外接上了构造函数之间的原型,所以静态方法也能继承- 子类
constructor里要先super()才能用this - 实践里少搞深继承,组合优于继承
JS 继承要解决两件事:把父类的实例属性初始化到子实例上,把父类原型上的方法接到子类原型链上,寄生组合继承和 class extends 都是同时做好这两件事。 最早的原型链继承 Child.prototype = new Parent(),问题是父类里的数组被所有子实例共享;借用构造函数 Parent.call(this) 解决了共享,但拿不到原型方法;两个合起来叫组合继承,代价是父构造函数跑两次。寄生组合继承把 new Parent() 换成 Object.create(Parent.prototype),只接原型不执行构造函数,就是 ES5 下的标准答案。class extends 底层做的是同样的事,还多做了一步 Object.setPrototypeOf(Child, Parent),所以静态方法也能继承。
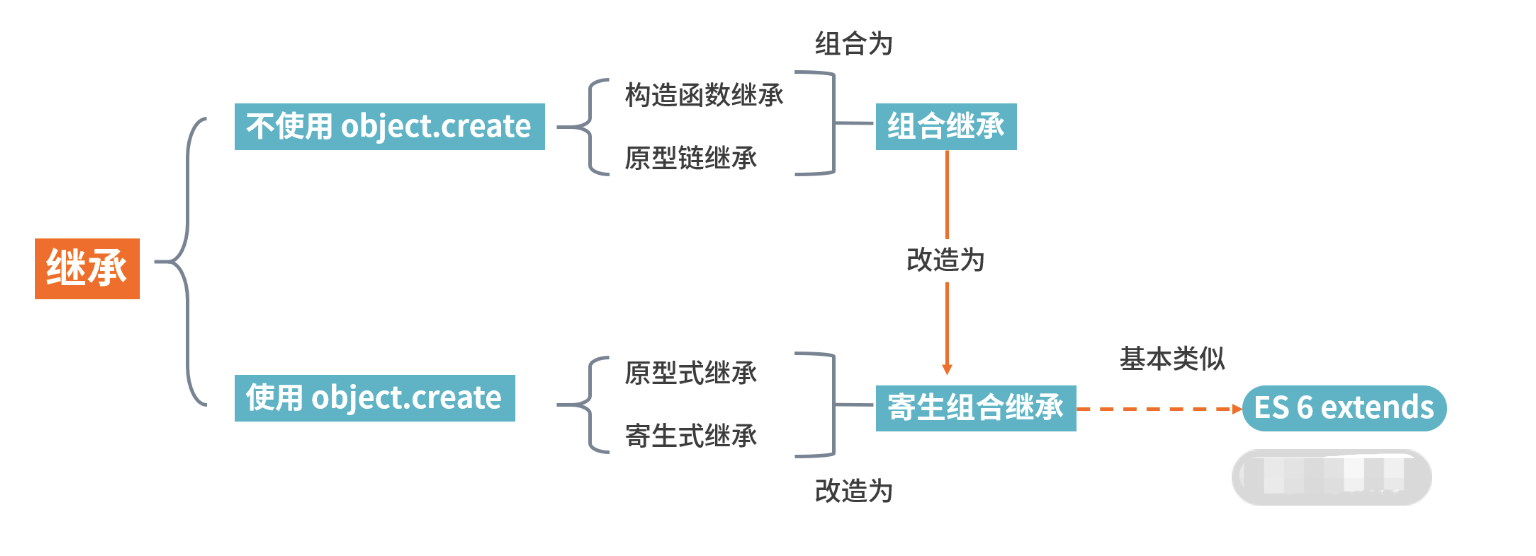
涉及面试题:原型如何实现继承?
Class如何实现继承?Class本质是什么?
首先先来讲下 class,其实在 JS中并不存在类,class 只是语法糖,本质还是函数
class Person {}
Person instanceof Function // true
组合继承
组合继承是最常用的继承方式
function Parent(value) {
  this.val = value
}
Parent.prototype.getValue = function() {
  console.log(this.val)
}
function Child(value) {
  Parent.call(this, value)
}
Child.prototype = new Parent()

const child = new Child(1)

child.getValue() // 1
child instanceof Parent // true
- 以上继承的方式核心是在子类的构造函数中通过
Parent.call(this)继承父类的属性,然后改变子类的原型为new Parent()来继承父类的函数。 - 这种继承方式优点在于构造函数可以传参,不会与父类引用属性共享,可以复用父类的函数,但是也存在一个缺点就是在继承父类函数的时候调用了父类构造函数,导致子类的原型上多了不需要的父类属性,存在内存上的浪费
寄生组合继承
这种继承方式对组合继承进行了优化,组合继承缺点在于继承父类函数时调用了构造函数,我们只需要优化掉这点就行了
function Parent(value) {
  this.val = value
}
Parent.prototype.getValue = function() {
  console.log(this.val)
}

function Child(value) {
  Parent.call(this, value)
}
Child.prototype = Object.create(Parent.prototype, {
  constructor: {
    value: Child,
    enumerable: false,
    writable: true,
    configurable: true
  }
})

const child = new Child(1)

child.getValue() // 1
child instanceof Parent // true
以上继承实现的核心就是将父类的原型赋值给了子类,并且将构造函数设置为子类,这样既解决了无用的父类属性问题,还能正确的找到子类的构造函数。
Class 继承
以上两种继承方式都是通过原型去解决的,在 ES6 中,我们可以使用 class 去实现继承,并且实现起来很简单
class Parent {
  constructor(value) {
    this.val = value
  }
  getValue() {
    console.log(this.val)
  }
}
class Child extends Parent {
  constructor(value) {
    super(value)
    this.val = value
  }
}
let child = new Child(1)
child.getValue() // 1
child instanceof Parent // true
class实现继承的核心在于使用extends表明继承自哪个父类,并且在子类构造函数中必须调用super,因为这段代码可以看成Parent.call(this, value)。
ES5 和 ES6 继承的区别:
- ES6 继承的子类需要调用
super()才能拿到子类,ES5 的话是通过apply这种绑定的方式 - 类声明不会提升,和
let这些一致
function Super() {}
Super.prototype.getNumber = function() {
  return 1
}

function Sub() {}
Sub.prototype = Object.create(Super.prototype, {
  constructor: {
    value: Sub,
    enumerable: false,
    writable: true,
    configurable: true
  }
})
let s = new Sub()
s.getNumber()
以下详细讲解几种常见的继承方式
1. 方式1: 借助call
 function Parent1(){
    this.name = 'parent1';
  }
  function Child1(){
    Parent1.call(this);
    this.type = 'child1'
  }
  console.log(new Child1);
这样写的时候子类虽然能够拿到父类的属性值,但是问题是父类原型对象中一旦存在方法那么子类无法继承。那么引出下面的方法。
2. 方式2: 借助原型链
 function Parent2() {
    this.name = 'parent2';
    this.play = [1, 2, 3]
  }
  function Child2() {
    this.type = 'child2';
  }
  Child2.prototype = new Parent2();

  console.log(new Child2());
看似没有问题,父类的方法和属性都能够访问,但实际上有一个潜在的不足。举个例子:
var s1 = new Child2();
var s2 = new Child2();
s1.play.push(4);
console.log(s1.play, s2.play);
可以看到控制台:

明明我只改变了s1的play属性,为什么s2也跟着变了呢?很简单,因为两个实例使用的是同一个原型对象。
那么还有更好的方式么?
3. 方式3:将前两种组合
  function Parent3 () {
    this.name = 'parent3';
    this.play = [1, 2, 3];
  }
  function Child3() {
    Parent3.call(this);
    this.type = 'child3';
  }
  Child3.prototype = new Parent3();
  var s3 = new Child3();
  var s4 = new Child3();
  s3.play.push(4);
  console.log(s3.play, s4.play);
可以看到控制台:

之前的问题都得以解决。但是这里又徒增了一个新问题,那就是
Parent3的构造函数会多执行了一次(Child3.prototype = new Parent3();)。这是我们不愿看到的。那么如何解决这个问题?
4. 方式4: 组合继承的优化1
  function Parent4 () {
    this.name = 'parent4';
    this.play = [1, 2, 3];
  }
  function Child4() {
    Parent4.call(this);
    this.type = 'child4';
  }
  Child4.prototype = Parent4.prototype;
这里让将父类原型对象直接给到子类,父类构造函数只执行一次,而且父类属性和方法均能访问,但是我们来测试一下:
var s3 = new Child4();
var s4 = new Child4();
console.log(s3)
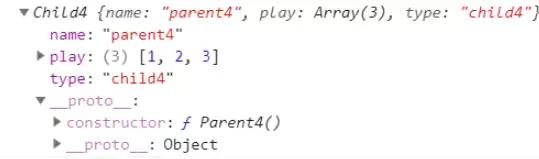
子类实例的构造函数是Parent4,显然这是不对的,应该是Child4。
5. 方式5(最推荐使用): 组合继承的优化2
 function Parent5 () {
    this.name = 'parent5';
    this.play = [1, 2, 3];
  }
  function Child5() {
    Parent5.call(this);
    this.type = 'child5';
  }
  Child5.prototype = Object.create(Parent5.prototype);
  Child5.prototype.constructor = Child5;
这是最推荐的一种方式,接近完美的继承,它的名字也叫做寄生组合继承。
6. ES6的extends被编译后的JavaScript代码
ES6的代码最后都是要在浏览器上能够跑起来的,这中间就利用了babel这个编译工具,将ES6的代码编译成ES5让一些不支持新语法的浏览器也能运行。
那最后编译成了什么样子呢?
function _possibleConstructorReturn(self, call) {
    // ...
    return call && (typeof call === 'object' || typeof call === 'function') ? call : self;
}

function _inherits(subClass, superClass) {
    // ...
    //看到没有
    subClass.prototype = Object.create(superClass && superClass.prototype, {
        constructor: {
            value: subClass,
            enumerable: false,
            writable: true,
            configurable: true
        }
    });
    if (superClass) Object.setPrototypeOf ? Object.setPrototypeOf(subClass, superClass) : subClass.__proto__ = superClass;
}


var Parent = function Parent() {
    // 验证是否是 Parent 构造出来的 this
    _classCallCheck(this, Parent);
};

var Child = (function (_Parent) {
    _inherits(Child, _Parent);

    function Child() {
        _classCallCheck(this, Child);

        return _possibleConstructorReturn(this, (Child.__proto__ || Object.getPrototypeOf(Child)).apply(this, arguments));
    }

    return Child;
}(Parent));
核心是
_inherits函数,可以看到它采用的依然也是第五种方式————寄生组合继承方式,同时证明了这种方式的成功。不过这里加了一个Object.setPrototypeOf(subClass, superClass),这是用来干啥的呢?
答案是用来继承父类的静态方法。这也是原来的继承方式疏忽掉的地方。
追问: 面向对象的设计一定是好的设计吗?
不一定。从继承的角度说,这一设计是存在巨大隐患的。
💬 面试官追问
只在
Child里写了Parent.call(this),实例属性都有,child.getValue()却报错,缺什么?缺原型那条线,
Parent.call只执行了父构造函数,没让Child.prototype连到Parent.prototype。补一句Child.prototype = Object.create(Parent.prototype),再把constructor指回Child。多个子实例改其中一个的
list.push(x),其他实例全跟着变了,查哪里?八成写了
Child.prototype = new Parent(),父类构造函数里的this.list = []落到了共享的原型上。子构造函数里补Parent.call(this),每个实例就有自己的list了。直接写
Child.prototype = Parent.prototype不是更省事吗?两个变成同一个对象了,你改
Child.prototype.constructor或者给子类加方法,父类也被改了。必须用Object.create(Parent.prototype)新建一个以父原型为原型的对象。class子类构造器里先写this.x = 1再super(),为什么报错?class继承里子类的this是父类构造函数创建的,super()之前this还不存在,访问就抛ReferenceError。这和ES5先建子实例再Parent.call(this)的顺序正好相反,也是class能继承Array这类内置对象的原因。为什么
class extends后能调Child.staticCheck(),手写寄生组合却不行?extends除了连实例原型,还把Child.__proto__指向了Parent,静态方法沿这条线找到。手写的话补一句Object.setPrototypeOf(Child, Parent)就行。
# 11 面向对象
⚡ 30 秒速记
- 三大特性:封装(藏实现、只露接口)、继承(复用)、多态(同一个调用不同对象表现不同)
JS是基于原型的,class是语法糖,底层还是原型链- 封装的几种写法:闭包私有变量 →
Symbol键(半私有)→class的#field(ES2022,真私有) - 对象级「继承」有浅拷贝、深拷贝、
Object.create;浅拷贝的嵌套对象是共享的 - 现代前端是混合范式:
UI层偏函数式,领域模型、SDK用OOP;继承层级别超过两层
面向对象就是把数据和操作数据的方法打包成对象,靠封装、继承、多态来组织代码;JS 的特别之处是它没有真正的类,class 底下还是原型。 封装以前靠闭包,现在直接用 #count 这种私有字段,外部访问会报语法错误,比约定俗成的下划线前缀靠谱。多态在 JS 里很自然,不用接口声明,只要几个对象都有 render() 方法,调用方就能一视同仁,这叫鸭子类型。我自己写业务时更倾向组合而不是继承,比如把「可拖拽」「可缩放」做成独立的能力挂上去,比搞一棵继承树好维护得多。
编程思想
- 基本思想是使用对象,类,继承,封装等基本概念来进行程序设计
- 优点
- 易维护
- 采用面向对象思想设计的结构,可读性高,由于继承的存在,即使改变需求,那么维护也只是在局部模块,所以维护起来是非常方便和较低成本的
- 易扩展
- 开发工作的重用性、继承性高,降低重复工作量。
- 缩短了开发周期
- 易维护
一般面向对象包含:继承,封装,多态,抽象
1. 对象形式的继承
浅拷贝
var Person = {
    name: 'poetry',
    age: 18,
    address: {
        home: 'home',
        office: 'office',
    }
    sclools: ['x','z'],
};

var programer = {
    language: 'js',
};

function extend(p, c){
    var c = c || {};
    for( var prop in p){
        c[prop] = p[prop];
    }
}
extend(Person, programer);
programer.name;  // poetry
programer.address.home;  // home
programer.address.home = 'house';  //house
Person.address.home;  // house
从上面的结果看出,浅拷贝的缺陷在于修改了子对象中引用类型的值,会影响到父对象中的值,因为在浅拷贝中对引用类型的拷贝只是拷贝了地址,指向了内存中同一个副本
深拷贝
function extendDeeply(p, c){
    var c = c || {};
    for (var prop in p){
        if(typeof p[prop] === "object"){
            c[prop] = (p[prop].constructor === Array)?[]:{};
            extendDeeply(p[prop], c[prop]);
        }else{
            c[prop] = p[prop];
        }
    }
}
利用递归进行深拷贝,这样子对象的修改就不会影响到父对象
extendDeeply(Person, programer);
programer.address.home = 'poetry';
Person.address.home; // home
利用call和apply继承
function Parent(){
    this.name = "abc";
    this.address = {home: "home"};
}
function Child(){
    Parent.call(this);
    this.language = "js";
}
ES5中的Object.create()
var p = { name : 'poetry'};
var obj = Object.create(p);
obj.name; // poetry
Object.create()作为new操作符的替代方案是ES5之后才出来的。我们也可以自己模拟该方法:
//模拟Object.create()方法
function myCreate(o){
    function F(){};
    F.prototype = o;
    o = new F();
    return o;
}
var p = { name : 'poetry'};
var obj = myCreate(p);
obj.name; // poetry
目前,各大浏览器的最新版本(包括IE9)都部署了这个方法。如果遇到老式浏览器,可以用下面的代码自行部署
 if (!Object.create) {
    Object.create = function (o) {
       function F() {}
      F.prototype = o;
      return new F();
    };
  }
2. 类的继承
Object.create()
function Person(name, age){}
Person.prototype.headCount = 1;
Person.prototype.eat = function(){
    console.log('eating...');
}
function Programmer(name, age, title){}

Programmer.prototype = Object.create(Person.prototype); //建立继承关系
Programmer.prototype.constructor = Programmer;  // 修改constructor的指向
调用父类方法
function Person(name, age){
    this.name = name;
    this.age = age;
}
Person.prototype.headCount = 1;
Person.prototype.eat = function(){
    console.log('eating...');
}

function Programmer(name, age, title){
    Person.apply(this, arguments); // 调用父类的构造器
}


Programmer.prototype = Object.create(Person.prototype);
Programmer.prototype.constructor = Programmer;

Programmer.prototype.language = "js";
Programmer.prototype.work = function(){
    console.log('i am working code in '+ this.language);
    Person.prototype.eat.apply(this, arguments); // 调用父类上的方法
}
3. 封装
- 命名空间
- js是没有命名空间的,因此可以用对象模拟
var app = {};  // 命名空间app
//模块1
app.module1 = {
    name: 'poetry',
    f: function(){
        console.log('hi robot');
    }
};
app.module1.name; // "poetry"
app.module1.f();  // hi robot
对象的属性外界是可读可写 如何来达到封装的额目的?答:可通过
闭包+局部变量来完成
- 在构造函数内部声明局部变量 和普通方法
- 因为作用域的关系 只有构造函数内的方法
- 才能访问局部变量 而方法对于外界是开放的
- 因此可以通过方法来访问 原本外界访问不到的局部变量 达到函数封装的目的
function Girl(name,age){
	var love = '小明';//love 是局部变量 准确说不属于对象 属于这个函数的额激活对象 函数调用时必将产生一个激活对象 love在激活对象身上   激活对象有作用域的关系 有办法访问  加一个函数提供外界访问
	this.name = name;
	this.age = age;
	this.say = function () {
		return love;
	};

	this.movelove = function (){
		love = '小轩'; //35
	}

}

var g = new Girl('yinghong',22);

console.log(g);
console.log(g.say());//小明
console.log(g.movelove());//undefined  因为35行没有返回
console.log(g.say());//小轩


function fn(){
	function t(){
		//var age = 22;//声明age变量 在t的激活对象上
		age = 22;//赋值操作 t的激活对象上找age属性 ,找不到 找fn的激活对象....再找到 最终找到window.age = 22;
				//不加var就是操作window全局属性

	}
	t();
}
console.log(fn());//undefined
4. 静态成员
面向对象中的静态方法-静态属性:没有new对象 也能引用静态方法属性
function Person(name){
    var age = 100;
    this.name = name;
}
//静态成员
Person.walk = function(){
    console.log('static');
};
Person.walk();  // static
5. 私有与公有
function Person(id){
    // 私有属性与方法
    var name = 'poetry';
    var work = function(){
        console.log(this.id);
    };
    //公有属性与方法
    this.id = id;
    this.say = function(){
        console.log('say hello');
        work.call(this);
    };
};
var p1 = new Person(123);
p1.name; // undefined
p1.id;  // 123
p1.say();  // say hello 123
6. 模块化
var moduleA;
moduleA = function() {
    var prop = 1;

    function func() {}

    return {
        func: func,
        prop: prop
    };
}(); // 立即执行匿名函数
7. 多态
多态:同一个父类继承出来的子类各有各的形态
function Cat(){
	this.eat = '肉';
}

function Tiger(){
	this.color = '黑黄相间';
}

function Cheetah(){
	this.color = '报文';
}

function Lion(){
	this.color = '土黄色';
}

Tiger.prototype =  Cheetah.prototype = Lion.prototype = new Cat();//共享一个祖先 Cat

var T = new Tiger();
var C = new Cheetah();
var L = new Lion();

console.log(T.color);
console.log(C.color);
console.log(L.color);


console.log(T.eat);
console.log(C.eat);
console.log(L.eat);
8. 抽象类
在构造器中
throw new Error(''); 抛异常。这样防止这个类被直接调用
function DetectorBase() {
    throw new Error('Abstract class can not be invoked directly!');
}

DetectorBase.prototype.detect = function() {
    console.log('Detection starting...');
};
DetectorBase.prototype.stop = function() {
    console.log('Detection stopped.');
};
DetectorBase.prototype.init = function() {
    throw new Error('Error');
};

// var d = new DetectorBase();
// Uncaught Error: Abstract class can not be invoked directly!

function LinkDetector() {}
LinkDetector.prototype = Object.create(DetectorBase.prototype);
LinkDetector.prototype.constructor = LinkDetector;

var l = new LinkDetector();
console.log(l); //LinkDetector {}__proto__: LinkDetector
l.detect(); //Detection starting...
l.init(); //Uncaught Error: Error
💬 面试官追问
用浅拷贝复制了一个商品模板,改副本的
address.home,原模板也变了,为什么?浅拷贝只复制第一层,
address拷的是引用,两边指向同一个对象。要隔离就深拷贝,现在可以直接用structuredClone(obj),它能处理循环引用、Date、Map,但拷不了函数和DOM节点。插件要求外部只能调
start,不能碰内部token,你怎么封装?现代环境直接用私有字段:
class Plugin { #token; start() { use(this.#token) } },外面写p.#token是语法错误。要兼容ES5就用闭包,把token放构造函数局部变量里,代价是方法没法放原型上共享。页面要创建上万个模型对象,构造函数里给每个实例都定义了
save方法,怎么优化?save不依赖闭包私有变量的话,挪到prototype上或者写成class方法,所有实例共用一个函数。上万个实例各带一份函数,内存差距很明显。说说
JS里多态是怎么体现的?不需要继承也能多态,只要对象有同名方法就行。比如
shapes.forEach(s => s.draw()),圆和方块各自实现draw,调用方完全不用if判断类型,新增一种图形也不用改这段代码。三个检测器只是都要有
detect和stop方法,你会建一个抽象父类吗?没有共享实现的话不建。只是约定接口,用
TypeScript的interface约束就够了,每个类implements它,编译期就能查出漏实现的方法,比在父类里throw new Error('not implemented')等运行时才炸要早。
# 12 事件机制
⚡ 30 秒速记
- 一次点击三个阶段:捕获(
window往下)→ 目标 → 冒泡(往上回到window) addEventListener(type, fn, true)挂在捕获阶段,默认false挂冒泡阶段preventDefault()管默认行为,stopPropagation()管传播,两者互不相干;stopImmediatePropagation()连同节点后面的监听也拦- 事件委托:监听挂父元素,用
e.target.closest('li')找到真正的业务节点 - 第三个参数可以是对象
{ capture, once, passive, signal }:passive: true优化滚动,signal配AbortController批量解绑
DOM 事件会走三段路:先从 window 一路往下传到目标元素,这叫捕获;到了目标本身是目标阶段;然后再一路往上冒回 window,这叫冒泡。 平时 addEventListener 默认挂在冒泡阶段,所以子元素先触发、父元素后触发。事件委托就是利用冒泡,把一百个列表项的点击都交给列表容器处理,新插入的项也自动生效。我常提醒的两个点:preventDefault 和 stopPropagation 是两回事,一个拦默认动作一个拦传播;委托时 e.target 可能是按钮里的图标,要用 closest 往上找。
涉及面试题:事件的触发过程是怎么样的?知道什么是事件代理嘛?
1. 简介
事件流是一个事件沿着特定数据结构传播的过程。冒泡和捕获是事件流在
DOM中两种不同的传播方法
事件流有三个阶段
- 事件捕获阶段
- 处于目标阶段
- 事件冒泡阶段
事件捕获
事件捕获(
event capturing):通俗的理解就是,当鼠标点击或者触发dom事件时,浏览器会从根节点开始由外到内进行事件传播,即点击了子元素,如果父元素通过事件捕获方式注册了对应的事件的话,会先触发父元素绑定的事件
事件冒泡
事件冒泡(dubbed bubbling):与事件捕获恰恰相反,事件冒泡顺序是由内到外进行事件传播,直到根节点
无论是事件捕获还是事件冒泡,它们都有一个共同的行为,就是事件传播

2. 捕获和冒泡
<div id="div1">
  <div id="div2"></div>
</div>

<script>
    let div1 = document.getElementById('div1');
    let div2 = document.getElementById('div2');

    div1.onClick = function(){
        alert('1')
    }

    div2.onClick = function(){
        alert('2');
    }

</script>
当点击
div2时,会弹出两个弹出框。在ie8/9/10、chrome浏览器,会先弹出”2”再弹出“1”,这就是事件冒泡:事件从最底层的节点向上冒泡传播。事件捕获则跟事件冒泡相反
W3C的标准是先捕获再冒泡,
addEventListener的第三个参数决定把事件注册在捕获(true)还是冒泡(false)
3. 事件对象

4. 事件流阻止
在一些情况下需要阻止事件流的传播,阻止默认动作的发生
event.preventDefault():取消事件对象的默认动作以及继续传播。event.stopPropagation()/ event.cancelBubble = true:阻止事件冒泡。
事件的阻止在不同浏览器有不同处理
- 在
IE下使用event.returnValue= false, - 在非
IE下则使用event.preventDefault()进行阻止
preventDefault与stopPropagation的区别
preventDefault告诉浏览器不用执行与事件相关联的默认动作(如表单提交)stopPropagation是停止事件继续冒泡,但是对IE9以下的浏览器无效
5. 事件注册
- 通常我们使用
addEventListener注册事件,该函数的第三个参数可以是布尔值,也可以是对象。对于布尔值useCapture参数来说,该参数默认值为false。useCapture决定了注册的事件是捕获事件还是冒泡事件 - 一般来说,我们只希望事件只触发在目标上,这时候可以使用
stopPropagation来阻止事件的进一步传播。通常我们认为stopPropagation是用来阻止事件冒泡的,其实该函数也可以阻止捕获事件。stopImmediatePropagation(DOM3级新增事件) 同样也能实现阻止事件冒泡和捕获,但是还能阻止该事件目标执行别的注册事件
stopImmediatePropagation() 和 stopPropagation()的区别在哪儿呢?后者只会阻止冒泡或者是捕获。 但是前者除此之外还会阻止该元素的其他事件发生,但是后者就不会阻止其他事件的发生。
node.addEventListener('click',(event) =>{
	event.stopImmediatePropagation()
	console.log('冒泡')
},false);
node.addEventListener('click',(event) => {
	console.log('冒泡2 ')
},false)
6. 事件委托
- 在
js中性能优化的其中一个主要思想是减少dom操作。 - 节省内存
- 不需要给子节点注销事件
假设有
100个li,每个li有相同的点击事件。如果为每个Li都添加事件,则会造成dom访问次数过多,引起浏览器重绘与重排的次数过多,性能则会降低。 使用事件委托则可以解决这样的问题
原理
实现事件委托是利用了事件的冒泡原理实现的。当我们为最外层的节点添加点击事件,那么里面的
ul、li、a的点击事件都会冒泡到最外层节点上,委托它代为执行事件
<ul id="ul">
    <li>1</li>
    <li>2</li>
    <li>3</li>
</ul>
<script>
  window.onload = function(){
    var ulEle = document.getElementById('ul');
    ul.onclick = function(ev){
        //兼容IE
        ev = ev || window.event;
        var target = ev.target || ev.srcElement;

        if(target.nodeName.toLowerCase() == 'li'){
            alert( target.innerHTML);
        }

    }
  }
</script>
💬 面试官追问
弹窗里点了链接,调了
preventDefault(),外层的「点遮罩关闭」还是触发了,为什么?preventDefault()只阻止了跳转,事件照样往上冒泡到遮罩。更好的修法是在外层判断if (e.target === e.currentTarget)才关闭,而不是到处stopPropagation,那会把埋点这类依赖冒泡的逻辑也拦掉。委托写的
if (e.target.nodeName === 'LI'),点到li里的图标就不生效了,怎么改?e.target是实际点中的最深节点,可能是<i>或<span>。改成const li = e.target.closest('li'),再判断list.contains(li),防止匹配到容器外面的li。同一个按钮挂了两个
click,第一个调了stopPropagation(),第二个还是执行了,正常吗?正常,
stopPropagation只拦着不往别的节点传,同一个节点上的其他监听照样执行。要连它们一起拦得用stopImmediatePropagation(),不过这样监听之间就有了顺序依赖,不太推荐。埋点想在子组件
stopPropagation()之后也能收到点击,怎么做?在
document上用捕获阶段监听:document.addEventListener('click', track, true)。捕获比冒泡先发生,子组件在冒泡阶段拦截时埋点已经拿到了。为什么移动端滚动监听推荐加
{ passive: true }?浏览器不知道你会不会在
touchmove里preventDefault,只能等监听执行完再决定要不要滚,滚动就会卡一下。声明passive等于承诺不拦截,浏览器可以直接滚。Chrome对document级别的touchstart/touchmove已经默认passive了。
# 13 模块化
⚡ 30 秒速记
- 演进:全局函数 → 命名空间 →
IIFE→CommonJS/AMD/CMD→UMD→ES Module(语言标准) - 面试主线是
ESM和CJS的区别:编译期静态分析 / 运行时require,实时绑定 / 拿到导出值,能Tree Shaking/ 基本不能 ESM支持顶层await;CJS同步加载,exports只是module.exports的引用,整个重新赋值会断开- 循环依赖:
CJS拿到未执行完的半成品导出;ESM在TDZ里访问会直接报错,更容易发现 Node双格式:package.json的type和exports;Node 22.12+/20.19+已能直接require不含顶层await的ESM
现在聊模块化,重点就是 ES Module 和 CommonJS 的区别,AMD、CMD 当历史背景一笔带过。 最本质的差别是时机:ESM 的 import / export 在代码执行前就能静态分析出依赖关系,所以打包工具能做 Tree Shaking;CJS 的 require 是运行时执行的普通函数,可以写在 if 里,工具没法提前确定你用了什么。第二个差别是 ESM 导入的是实时绑定,源模块改了导入方能看到;CJS 拿到的是 module.exports 上的值,原始值相当于拷了一份,对象则是共享引用。新项目我一律用 ESM,老 Node 项目遇到 CJS 再处理互操作。
版本说明(面试主线):下面列的四种方案里,现在的主线只有两个——浏览器和构建工具用
ES Module(ESM,import/export),Node 端历史上用CommonJS(require/module.exports)、现也全面支持 ESM。AMD(require.js)和 CMD(sea.js)是 ES Module 出现之前、为解决浏览器异步加载模块而生的社区方案,如今已基本退出历史舞台,了解它们主要是为理解「模块化的演进」和偶尔维护老项目。面试回答模块化,应以「ESM vs CommonJS 的区别」为主线(ESM 编译期静态分析、可 Tree Shaking、实时绑定、异步;CJS 运行时加载、值拷贝、同步),把 AMD/CMD 作为历史背景一笔带过即可。
js 中现在比较成熟的有四种模块加载方案:
- 第一种是 CommonJS 方案,它通过 require 来引入模块,通过 module.exports 定义模块的输出接口。这种模块加载方案是服务器端的解决方案,它是以同步的方式来引入模块的,因为在服务端文件都存储在本地磁盘,所以读取非常快,所以以同步的方式加载没有问题。但如果是在浏览器端,由于模块的加载是使用网络请求,因此使用异步加载的方式更加合适。
- 第二种是 AMD 方案,这种方案采用异步加载的方式来加载模块,模块的加载不影响后面语句的执行,所有依赖这个模块的语句都定义在一个回调函数里,等到加载完成后再执行回调函数。require.js 实现了 AMD 规范
- 第三种是 CMD 方案,这种方案和 AMD 方案都是为了解决异步模块加载的问题,sea.js 实现了 CMD 规范。它和require.js的区别在于模块定义时对依赖的处理不同和对依赖模块的执行时机的处理不同。
- 第四种方案是 ES6 提出的方案,使用 import 和 export 的形式来导入导出模块
在有
Babel的情况下,我们可以直接使用ES6的模块化
// file a.js
export function a() {}
export function b() {}
// file b.js
export default function() {}

import {a, b} from './a.js'
import XXX from './b.js'
CommonJS
CommonJs是Node独有的规范,浏览器中使用就需要用到Browserify解析了。
// a.js
module.exports = {
    a: 1
}
// or
exports.a = 1

// b.js
var module = require('./a.js')
module.a // -> log 1
在上述代码中,
module.exports和exports很容易混淆,让我们来看看大致内部实现
var module = require('./a.js')
module.a
// 这里其实就是包装了一层立即执行函数,这样就不会污染全局变量了,
// 重要的是 module 这里,module 是 Node 独有的一个变量
module.exports = {
    a: 1
}
// 基本实现
var module = {
  exports: {} // exports 就是个空对象
}
// 这个是为什么 exports 和 module.exports 用法相似的原因
var exports = module.exports
var load = function (module) {
    // 导出的东西
    var a = 1
    module.exports = a
    return module.exports
};
再来说说
module.exports和exports,用法其实是相似的,但是不能对exports直接赋值,不会有任何效果。
对于
CommonJS和ES6中的模块化的两者区别是:
- 前者支持动态导入,也就是
require(${path}/xx.js),后者目前不支持,但是已有提案,前者是同步导入,因为用于服务端,文件都在本地,同步导入即使卡住主线程影响也不大。 - 而后者是异步导入,因为用于浏览器,需要下载文件,如果也采用同步导入会对渲染有很大影响
- 前者在导出时都是值拷贝,就算导出的值变了,导入的值也不会改变,所以如果想更新值,必须重新导入一次。
- 但是后者采用实时绑定的方式,导入导出的值都指向同一个内存地址,所以导入值会跟随导出值变化
- 后者会编译成
require/exports来执行的
AMD
AMD是由RequireJS提出的
AMD 和 CMD 规范的区别?
- 第一个方面是在模块定义时对依赖的处理不同。AMD推崇依赖前置,在定义模块的时候就要声明其依赖的模块。而 CMD 推崇就近依赖,只有在用到某个模块的时候再去 require。
- 第二个方面是对依赖模块的执行时机处理不同。首先 AMD 和 CMD 对于模块的加载方式都是异步加载,不过它们的区别在于模块的执行时机,AMD 在依赖模块加载完成后就直接执行依赖模块,依赖模块的执行顺序和我们书写的顺序不一定一致。而 CMD在依赖模块加载完成后并不执行,只是下载而已,等到所有的依赖模块都加载好后,进入回调函数逻辑,遇到 require 语句的时候才执行对应的模块,这样模块的执行顺序就和我们书写的顺序保持一致了。
// CMD
define(function(require, exports, module) {
  var a = require("./a");
  a.doSomething();
  // 此处略去 100 行
  var b = require("./b"); // 依赖可以就近书写
  b.doSomething();
  // ...
});

// AMD 默认推荐
define(["./a", "./b"], function(a, b) {
  // 依赖必须一开始就写好
  a.doSomething();
  // 此处略去 100 行
  b.doSomething();
  // ...
})
- AMD:
requirejs在推广过程中对模块定义的规范化产出,提前执行,推崇依赖前置 - CMD:
seajs在推广过程中对模块定义的规范化产出,延迟执行,推崇依赖就近 - CommonJs:模块输出的是一个值的
copy,运行时加载,加载的是一个对象(module.exports属性),该对象只有在脚本运行完才会生成 - ES6 Module:模块输出的是一个值的引用,编译时输出接口,
ES6模块不是对象,它对外接口只是一种静态定义,在代码静态解析阶段就会生成。
谈谈对模块化开发的理解
- 我对模块的理解是,一个模块是实现一个特定功能的一组方法。在最开始的时候,js 只实现一些简单的功能,所以并没有模块的概念,但随着程序越来越复杂,代码的模块化开发变得越来越重要。
- 由于函数具有独立作用域的特点,最原始的写法是使用函数来作为模块,几个函数作为一个模块,但是这种方式容易造成全局变量的污染,并且模块间没有联系。
- 后面提出了对象写法,通过将函数作为一个对象的方法来实现,这样解决了直接使用函数作为模块的一些缺点,但是这种办法会暴露所有的所有的模块成员,外部代码可以修改内部属性的值。
- 现在最常用的是立即执行函数的写法,通过利用闭包来实现模块私有作用域的建立,同时不会对全局作用域造成污染。
💬 面试官追问
下面两种写法,
count自增后两边分别读到多少?// counter.mjs export let count = 0 export const inc = () => { count++ } // main.mjs import { count, inc } from './counter.mjs' inc(); console.log(count) // 1ESM打印1,导入的是绑定本身。同样逻辑用CJS写成const { count } = require('./counter'),inc()之后还是0,因为解构时就把当时的值拷走了。exports.a = 1之后又写exports = { b: 2 },调用方为什么只拿到a?exports只是指向module.exports的一个局部变量,require最后返回的是module.exports。重新给exports赋值只是让局部变量指向了别处,要整体导出必须写module.exports = { b: 2 }。插件路径要根据租户配置运行时决定,静态
import写不了,怎么办?用动态导入
await import(path),返回Promise,构建工具会把它拆成单独的chunk。路径别完全开放,最好是固定目录前缀加变量文件名的模板字符串,比如./plugins/目录下按名字拼,打包工具才能知道要打哪些文件。为什么
CJS写的库Tree Shaking效果很差?require和module.exports都是运行时的,可以条件导出、动态拼属性名,打包工具没法确定哪些导出没被用到,只能整包保留。所以库作者现在都发ESM版本,在package.json里用exports字段分别声明import和require入口。两个
CJS模块互相require,其中一个拿到的是空对象,为什么?a执行到一半去require('b'),b又require('a'),这时a还没执行完,b拿到的是a当时只写了一部分的module.exports。解决办法是把共同依赖抽到第三个模块,或者把require挪到函数里用的时候再调。
# 14 Iterator迭代器
⚡ 30 秒速记
- 迭代器协议:有
next(),每次返回{ value, done } - 可迭代协议:有
[Symbol.iterator]()方法,返回一个迭代器 - 实现了可迭代协议就能用
for...of、展开...、解构、Array.from、Promise.all - 原生可迭代:
Array、String、Map、Set、arguments、NodeList、TypedArray;普通对象不行,类数组也不一定行 - 自己实现最省事是用
Generator;每次调[Symbol.iterator]()都要返回新的迭代器
一个对象能不能被 for...of 遍历,就看它有没有 [Symbol.iterator] 方法;这个方法返回一个带 next() 的迭代器,每次 next() 给出 { value, done },直到 done: true。 可以把迭代器理解成一个只能往前走的指针,for...of、展开运算符、解构这些语法底层都是在反复调 next()。数组、字符串、Map、Set 都内置了这个接口,普通对象没有,因为对象的属性先遍历谁本来就没有统一的约定,需要遍历时用 Object.entries(obj) 转成数组,或者干脆用 Map。自己实现的话,写一个 *[Symbol.iterator]() { yield ... } 的 Generator 最省事。
Iterator(迭代器)是一种接口,也可以说是一种规范。为各种不同的数据结构提供统一的访问机制。任何数据结构只要部署Iterator接口,就可以完成遍历操作(即依次处理该数据结构的所有成员)。
Iterator语法:
const obj = {
    [Symbol.iterator]:function(){}
}
[Symbol.iterator]属性名是固定的写法,只要拥有了该属性的对象,就能够用迭代器的方式进行遍历。
- 迭代器的遍历方法是首先获得一个迭代器的指针,初始时该指针指向第一条数据之前,接着通过调用 next 方法,改变指针的指向,让其指向下一条数据
- 每一次的
next都会返回一个对象,该对象有两个属性value代表想要获取的数据done布尔值,false表示当前指针指向的数据有值,true表示遍历已经结束
Iterator 的作用有三个:
- 创建一个指针对象,指向当前数据结构的起始位置。也就是说,遍历器对象本质上,就是一个指针对象。
- 第一次调用指针对象的next方法,可以将指针指向数据结构的第一个成员。
- 第二次调用指针对象的next方法,指针就指向数据结构的第二个成员。
- 不断调用指针对象的next方法,直到它指向数据结构的结束位置。
每一次调用next方法,都会返回数据结构的当前成员的信息。具体来说,就是返回一个包含value和done两个属性的对象。其中,value属性是当前成员的值,done属性是一个布尔值,表示遍历是否结束。
let arr = [{num:1},2,3]
let it = arr[Symbol.iterator]() // 获取数组中的迭代器
console.log(it.next())  // { value: Object { num: 1 }, done: false }
console.log(it.next())  // { value: 2, done: false }
console.log(it.next())  // { value: 3, done: false }
console.log(it.next())  // { value: undefined, done: true }
对象没有布局Iterator接口,无法使用
for of遍历。下面使得对象具备Iterator接口
- 一个数据结构只要有Symbol.iterator属性,就可以认为是“可遍历的”
- 原型部署了Iterator接口的数据结构有三种,具体包含四种,分别是数组,类似数组的对象,Set和Map结构
为什么对象(Object)没有部署Iterator接口呢?
- 一是因为对象的哪个属性先遍历,哪个属性后遍历是不确定的,需要开发者手动指定。然而遍历遍历器是一种线性处理,对于非线性的数据结构,部署遍历器接口,就等于要部署一种线性转换
- 对对象部署
Iterator接口并不是很必要,因为Map弥补了它的缺陷,又正好有Iteraotr接口
let obj = {
    id: '123',
    name: '张三',
    age: 18,
    gender: '男',
    hobbie: '睡觉'
}

obj[Symbol.iterator] = function () {
    let keyArr = Object.keys(obj)
    let index = 0
    return {
        next() {
            return index < keyArr.length ? {
                value: {
                    key: keyArr[index],
                    val: obj[keyArr[index++]]
                }
            } : {
                done: true
            }
        }
    }
}

for (let key of obj) {
  console.log(key)
}
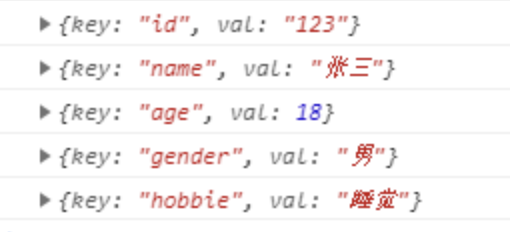
💬 面试官追问
接口返回
{0:'A', 1:'B', length:2},能按下标读,[...data]却报is not iterable,为什么?能按下标读只说明它是类数组,展开语法找的是
data[Symbol.iterator],它没有。转数组用Array.from(data),Array.from对类数组和可迭代对象都认。给一个链表类实现
for...of遍历,怎么写最简单?用
Generator:class List { *[Symbol.iterator]() { for (let n = this.head; n; n = n.next) yield n.value } } console.log([...list]) // [1, 2, 3]Generator返回的对象天然满足迭代器协议,不用手写next。[Symbol.iterator]()每次都返回同一个缓存的迭代器,会出什么问题?两个
for...of嵌套或者先后遍历同一个集合时共用一个指针,第一次遍历完第二次直接就是空的,嵌套时还会互相跳项。每次调用都要新建一个带独立状态的迭代器。自定义迭代器导出时多出一条
undefined,你先看哪?看结束分支是不是返回了
{ value: undefined, done: false }。done: false表示这一项有效,for...of会照常消费;结束必须是done: true,另外检查下标是不是先加后取,多走了一步。for...of里中途break,迭代器能知道吗?能,
break、return或抛错时会调用迭代器的return()方法,可以在里面关文件、释放连接。Generator自动有这个方法,break后它里面的finally块会执行。
# 15 Promise
⚡ 30 秒速记
- 三个状态
pending→fulfilled/rejected,只能变一次,变了就定死 then每次返回新Promise;回调返回普通值就以它resolve,返回Promise就等它落定then/catch回调是微任务,同步代码跑完、下一个宏任务之前执行- 四个组合方法:
all(全成功,一个失败就失败)、allSettled(等全部落定)、race(第一个落定)、any(第一个成功,全失败抛AggregateError) race做超时只是不等了,原请求并没有被取消,真要取消用AbortController
Promise 就是一个装着「将来结果」的盒子,状态从 pending 变成 fulfilled 或 rejected 后就不会再变了。 它解决的不只是回调地狱,还有信任问题:回调写法里第三方库可能不调、调两次,Promise 保证只落定一次。链式调用的关键是 then 永远返回一个新的 Promise,所以能一节一节接下去,中间任何一环抛错都会顺着链找到最近的 catch。并发时按需求挑:全部要成功用 all,成功失败都要看结果用 allSettled,只要最快那个成功的用 any,超时竞速用 race。
这里你谈
promise的时候,除了将他解决的痛点以及常用的API之外,最好进行拓展把eventloop带进来好好讲一下,microtask(微任务)、macrotask(任务) 的执行顺序,如果看过promise源码,最好可以谈一谈 原生Promise是如何实现的。Promise的关键点在于callback的两个参数,一个是resovle,一个是reject。还有就是Promise的链式调用(Promise.then(),每一个then都是一个责任人)
Promise是ES6新增的语法,解决了回调地狱的问题。- 可以把
Promise看成一个状态机。初始是pending状态,可以通过函数resolve和reject,将状态转变为resolved或者rejected状态,状态一旦改变就不能再次变化。 then函数会返回一个Promise实例,并且该返回值是一个新的实例而不是之前的实例。因为Promise规范规定除了pending状态,其他状态是不可以改变的,如果返回的是一个相同实例的话,多个then调用就失去意义了。 对于then来说,本质上可以把它看成是flatMap
1. Promise 的基本情况
简单来说它就是一个容器,里面保存着某个未来才会结束的事件(通常是异步操作)的结果。从语法上说,Promise 是一个对象,从它可以获取异步操作的消息
一般 Promise 在执行过程中,必然会处于以下几种状态之一。
- 待定(
pending):初始状态,既没有被完成,也没有被拒绝。 - 已完成(
fulfilled):操作成功完成。 - 已拒绝(
rejected):操作失败。
待定状态的
Promise对象执行的话,最后要么会通过一个值完成,要么会通过一个原因被拒绝。当其中一种情况发生时,我们用Promise的then方法排列起来的相关处理程序就会被调用。因为最后Promise.prototype.then和Promise.prototype.catch方法返回的是一个Promise, 所以它们可以继续被链式调用
关于 Promise 的状态流转情况,有一点值得注意的是,内部状态改变之后不可逆,你需要在编程过程中加以注意。文字描述比较晦涩,我们直接通过一张图就能很清晰地看出 Promise 内部状态流转的情况
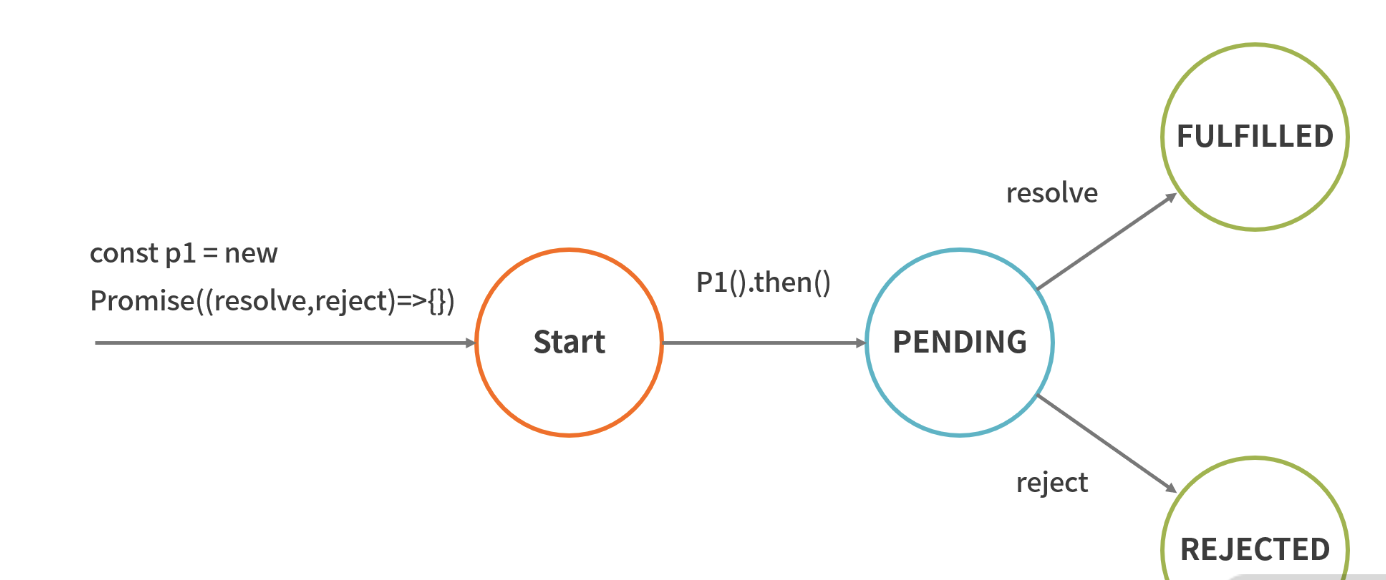
从上图可以看出,我们最开始创建一个新的 Promise 返回给 p1 ,然后开始执行,状态是 pending,当执行 resolve之后状态就切换为 fulfilled,执行 reject 之后就变为 rejected 的状态
2. Promise 的静态方法
all 方法- 语法:
Promise.all(iterable) - 参数: 一个可迭代对象,如
Array。 - 描述: 此方法对于汇总多个
promise的结果很有用,在 ES6 中可以将多个Promise.all异步请求并行操作,返回结果一般有下面两种情况。- 当所有结果成功返回时按照请求顺序返回成功结果。
- 当其中有一个失败方法时,则进入失败方法
- 语法:
- 我们来看下业务的场景,对于下面这个业务场景页面的加载,将多个请求合并到一起,用 all 来实现可能效果会更好,请看代码片段
// 在一个页面中需要加载获取轮播列表、获取店铺列表、获取分类列表这三个操作,页面需要同时发出请求进行页面渲染,这样用 `Promise.all` 来实现,看起来更清晰、一目了然。


//1.获取轮播数据列表
function getBannerList(){
  return new Promise((resolve,reject)=>{
      setTimeout(function(){
        resolve('轮播数据')
      },300)
  })
}
//2.获取店铺列表
function getStoreList(){
  return new Promise((resolve,reject)=>{
    setTimeout(function(){
      resolve('店铺数据')
    },500)
  })
}
//3.获取分类列表
function getCategoryList(){
  return new Promise((resolve,reject)=>{
    setTimeout(function(){
      resolve('分类数据')
    },700)
  })
}
function initLoad(){
  Promise.all([getBannerList(),getStoreList(),getCategoryList()])
  .then(res=>{
    console.log(res)
  }).catch(err=>{
    console.log(err)
  })
}
initLoad()
allSettled方法Promise.allSettled的语法及参数跟Promise.all类似,其参数接受一个Promise的数组,返回一个新的Promise。唯一的不同在于,执行完之后不会失败,也就是说当Promise.allSettled全部处理完成后,我们可以拿到每个Promise的状态,而不管其是否处理成功
- 我们来看一下用
allSettled实现的一段代码
const resolved = Promise.resolve(2);
const rejected = Promise.reject(-1);
const allSettledPromise = Promise.allSettled([resolved, rejected]);
allSettledPromise.then(function (results) {
  console.log(results);
});
// 返回结果:
// [
//    { status: 'fulfilled', value: 2 },
//    { status: 'rejected', reason: -1 }
// ]
从上面代码中可以看到,
Promise.allSettled最后返回的是一个数组,记录传进来的参数中每个 Promise 的返回值,这就是和 all 方法不太一样的地方。
any方法- 语法:
Promise.any(iterable) - 参数:
iterable可迭代的对象,例如Array。 - 描述:
any方法返回一个Promise,只要参数Promise实例有一个变成fulfilled状态,最后any返回的实例就会变成fulfilled状态;如果所有参数Promise实例都变成rejected状态,包装实例就会变成rejected状态。
- 语法:
const resolved = Promise.resolve(2);
const rejected = Promise.reject(-1);
const anyPromise = Promise.any([resolved, rejected]);
anyPromise.then(function (results) {
  console.log(results);
});
// 返回结果:
// 2
从改造后的代码中可以看出,只要其中一个
Promise变成fulfilled状态,那么any最后就返回这个p romise。由于上面resolved这个 Promise 已经是resolve的了,故最后返回结果为2
race方法- 语法:
Promise.race(iterable) - 参数:
iterable可迭代的对象,例如Array。 - 描述:
race方法返回一个Promise,只要参数的Promise之中有一个实例率先改变状态,则race方法的返回状态就跟着改变。那个率先改变的Promise实例的返回值,就传递给race方法的回调函数
- 语法:
- 我们来看一下这个业务场景,对于图片的加载,特别适合用 race 方法来解决,将图片请求和超时判断放到一起,用 race 来实现图片的超时判断。请看代码片段。
//请求某个图片资源
function requestImg(){
  var p = new Promise(function(resolve, reject){
    var img = new Image();
    img.onload = function(){ resolve(img); }
    img.src = 'http://www.baidu.com/img/flexible/logo/pc/result.png';
  });
  return p;
}
//延时函数,用于给请求计时
function timeout(){
  var p = new Promise(function(resolve, reject){
    setTimeout(function(){ reject('图片请求超时'); }, 5000);
  });
  return p;
}
Promise.race([requestImg(), timeout()])
.then(function(results){
  console.log(results);
})
.catch(function(reason){
  console.log(reason);
});


// 从上面的代码中可以看出,采用 Promise 的方式来判断图片是否加载成功,也是针对 Promise.race 方法的一个比较好的业务场景
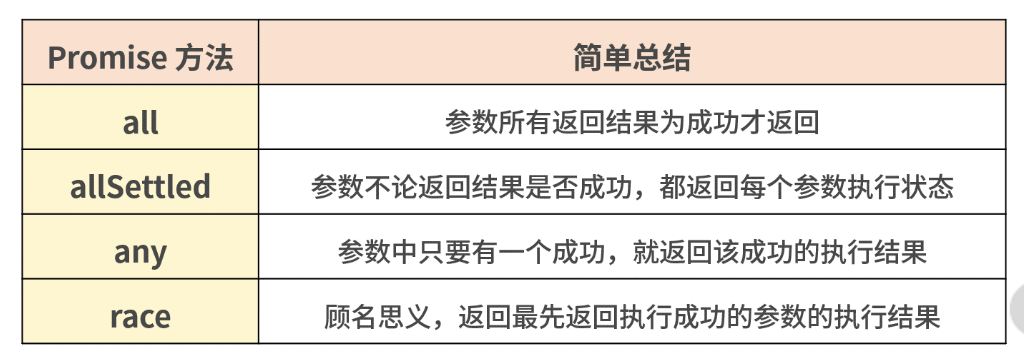
promise手写实现,面试够用版:
function myPromise(constructor){
    let self=this;
    self.status="pending" //定义状态改变前的初始状态
    self.value=undefined;//定义状态为resolved的时候的状态
    self.reason=undefined;//定义状态为rejected的时候的状态
    function resolve(value){
        //两个==="pending",保证了状态的改变是不可逆的
       if(self.status==="pending"){
          self.value=value;
          self.status="resolved";
       }
    }
    function reject(reason){
        //两个==="pending",保证了状态的改变是不可逆的
       if(self.status==="pending"){
          self.reason=reason;
          self.status="rejected";
       }
    }
    //捕获构造异常
    try{
       constructor(resolve,reject);
    }catch(e){
       reject(e);
    }
}
// 定义链式调用的then方法
myPromise.prototype.then=function(onFullfilled,onRejected){
   let self=this;
   switch(self.status){
      case "resolved":
        onFullfilled(self.value);
        break;
      case "rejected":
        onRejected(self.reason);
        break;
      default:
   }
}
💬 面试官追问
下面打印顺序是什么?
console.log(1)
setTimeout(() => console.log(2))
Promise.resolve().then(() => console.log(3))
console.log(4)
1 4 3 2。同步代码先跑完,然后清空微任务队列打印3,最后才轮到setTimeout这个宏任务。Promise里先resolve('ok'),后面又reject(err),监控一直显示成功,是实现有问题吗?不是,状态只能变一次,第一次
resolve之后再reject会被静默忽略。要查的是为什么两个分支都跑到了,一般是异步回调竞争没处理好。批量上传 50 个文件,成功的保留、失败的单独列原因,
Promise.all一失败就进catch了,怎么改?换成
Promise.allSettled,等全部落定后按status分:fulfilled取value,rejected取reason。50 个同时发要是太多,再自己加个并发池,allSettled不管并发数。用
Promise.race([load(), timeout(5000)])做超时,提示失败后图片还是加载出来了,为什么?race只决定外层Promise的结果,输掉的那个任务还在跑。fetch可以传AbortSignal.timeout(5000)真正中止请求,图片的话超时后把img.src清掉。自己实现
Promise,异步resolve之后then的回调从来不执行,缺了什么?缺回调队列。调
then时如果还是pending,要把回调存进数组,等resolve时再遍历执行;只在then里判断「已经成功就执行」,只能覆盖同步resolve的情况。另外回调要用queueMicrotask异步执行,then要返回新Promise。
# 16 Generator
⚡ 30 秒速记
function*声明,调用后不执行函数体,只返回一个迭代器next()跑到下一个yield暂停,返回{ value, done };return的值在done: true那次出来next(x)的x是上一个yield表达式的结果,所以第一次next传参没用- 是
async/await的前身:co这类执行器自动next驱动yield出来的Promise - 现在异步都用
async/await;Generator留在自定义迭代器、惰性序列、redux-saga这类场景
Generator 是能暂停和恢复的函数:调用它不会跑函数体,而是拿到一个迭代器,每调一次 next() 就往下跑到下一个 yield 停住。 最绕的是传参:next(12) 里的 12 会成为上一个 yield 表达式的值,相当于外面往里回话,所以第一次 next 传什么都会被丢掉,因为那时还没有停着的 yield。这种「函数里 yield 一个 Promise,外面等它完成再把结果 next 回去」的模式,就是 async / await 的原型,await 可以看成 Generator 加一个自动执行器。现在写异步我不会再手写 Generator,但实现可迭代对象、无限序列时它还是最顺手的。
Generator是ES6中新增的语法,和Promise一样,都可以用来异步编程。Generator函数可以说是Iterator接口的具体实现方式。Generator 最大的特点就是可以控制函数的执行。
function*用来声明一个函数是生成器函数,它比普通的函数声明多了一个*,*的位置比较随意可以挨着function关键字,也可以挨着函数名yield产出的意思,这个关键字只能出现在生成器函数体内,但是生成器中也可以没有yield关键字,函数遇到yield的时候会暂停,并把yield后面的表达式结果抛出去next作用是将代码的控制权交还给生成器函数
function *foo(x) {
  let y = 2 * (yield (x + 1))
  let z = yield (y / 3)
  return (x + y + z)
}
let it = foo(5)
console.log(it.next())   // => {value: 6, done: false}
console.log(it.next(12)) // => {value: 8, done: false}
console.log(it.next(13)) // => {value: 42, done: true}
上面这个示例就是一个Generator函数,我们来分析其执行过程:
- 首先 Generator 函数调用时它会返回一个迭代器
- 当执行第一次 next 时,传参会被忽略,并且函数暂停在 yield (x + 1) 处,所以返回 5 + 1 = 6
- 当执行第二次 next 时,传入的参数等于上一个 yield 的返回值,如果你不传参,yield 永远返回 undefined。此时 let y = 2 * 12,所以第二个 yield 等于 2 * 12 / 3 = 8
- 当执行第三次 next 时,传入的参数会传递给 z,所以 z = 13, x = 5, y = 24,相加等于 42
yield实际就是暂缓执行的标示,每执行一次next(),相当于指针移动到下一个yield位置
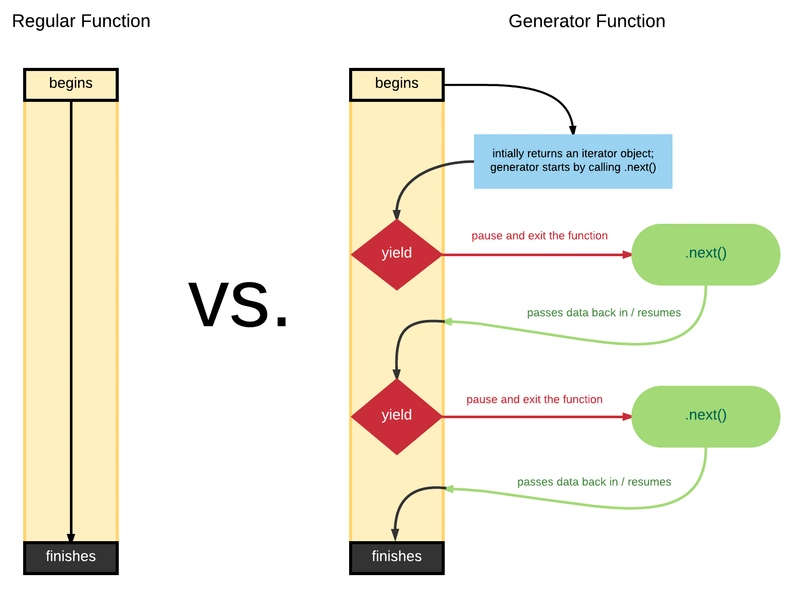
总结一下,
Generator函数是ES6提供的一种异步编程解决方案。通过yield标识位和next()方法调用,实现函数的分段执行
遍历器对象生成函数,最大的特点是可以交出函数的执行权
function关键字与函数名之间有一个星号;- 函数体内部使用
yield表达式,定义不同的内部状态; next指针移向下一个状态
这里你可以说说
Generator的异步编程,以及它的语法糖async和awiat,传统的异步编程。ES6之前,异步编程大致如下
- 回调函数
- 事件监听
- 发布/订阅
传统异步编程方案之一:协程,多个线程互相协作,完成异步任务。
// 使用 * 表示这是一个 Generator 函数
// 内部可以通过 yield 暂停代码
// 通过调用 next 恢复执行
function* test() {
  let a = 1 + 2;
  yield 2;
  yield 3;
}
let b = test();
console.log(b.next()); // >  { value: 2, done: false }
console.log(b.next()); // >  { value: 3, done: false }
console.log(b.next()); // >  { value: undefined, done: true }
从以上代码可以发现,加上
*的函数执行后拥有了next函数,也就是说函数执行后返回了一个对象。每次调用next函数可以继续执行被暂停的代码。以下是Generator函数的简单实现
// cb 也就是编译过的 test 函数
function generator(cb) {
  return (function() {
    var object = {
      next: 0,
      stop: function() {}
    };

    return {
      next: function() {
        var ret = cb(object);
        if (ret === undefined) return { value: undefined, done: true };
        return {
          value: ret,
          done: false
        };
      }
    };
  })();
}
// 如果你使用 babel 编译后可以发现 test 函数变成了这样
function test() {
  var a;
  return generator(function(_context) {
    while (1) {
      switch ((_context.prev = _context.next)) {
        // 可以发现通过 yield 将代码分割成几块
        // 每次执行 next 函数就执行一块代码
        // 并且表明下次需要执行哪块代码
        case 0:
          a = 1 + 2;
          _context.next = 4;
          return 2;
        case 4:
          _context.next = 6;
          return 3;
		// 执行完毕
        case 6:
        case "end":
          return _context.stop();
      }
    }
  });
}
💬 面试官追问
下面三次
next分别返回什么?function* foo(x) { const y = 2 * (yield x + 1) const z = yield y / 3 return x + y + z } const it = foo(5) it.next() // { value: 6, done: false } it.next(12) // { value: 8, done: false } it.next(13) // { value: 42, done: true }第一次停在
yield x + 1得6;next(12)让那个yield等于12,y = 24,停在y / 3得8;next(13)让z = 13,返回5 + 24 + 13 = 42。调用了
buildRows(),里面的console.log一行都没打,为什么?Generator函数调用只返回迭代器,函数体一行都没执行,第一次next()才开始跑。用for...of或展开运算符消费它,或者手动调next()。异步流程第二步依赖第一步的结果,调用方连续
next()没传值,结果算出NaN,为什么?yield表达式的值是下一次next传进来的参数,不传就是undefined,undefined * 2就是NaN。执行器要把上一步Promise的结果作为参数传给it.next(result)。用
Generator实现一个无限的id生成器,会不会死循环卡住?不会,
while (true) { yield id++ }是惰性的,外面要一个才算一个。只是别对它用[...gen()]或Array.from,那会一直取下去把页面卡死。能用
Generator替代async/await写三个串行请求吗?能,但得自己写执行器:拿到
yield出来的Promise,then里调it.next(res),catch里调it.throw(err)。async/await把这些都内置了还返回Promise,除非要像redux-saga那样精细控制、取消、测试流程,否则没必要手写。
# 17 async/await
⚡ 30 秒速记
async函数一定返回Promise:return 1拿到的是Promise<1>,抛错就是rejectedawait= 暂停当前函数、把控制权还给调用方,等结果落定后再接着跑;后半段相当于then回调,走微任务- 原理:
Generator+ 自动执行器,async对应*,await对应yield - 错误处理:
try/catch包住await;不接的话错误沿着返回的Promise往外冒,最后变成unhandledrejection - 最常见的坑:互不依赖的请求逐个
await变成串行,要先发起再await Promise.all([...])
async/await 就是让 Promise 写起来像同步代码的语法糖,底层是 Generator 加一个自动执行器。 函数加了 async 就一定返回 Promise,执行到 await 会先把函数挂起、让外面的同步代码继续跑,等等待的值落定,后面的代码作为微任务恢复执行。所以 const user = await loadUser() 读着像同步,其实中间让出过一次线程。我看代码最常挑的毛病是循环里逐个 await:几个请求没有依赖却串着跑,3 个 200ms 的请求硬是等了 600ms,改成 Promise.all 就是 200ms 左右。
Generator函数的语法糖。有更好的语义、更好的适用性、返回值是Promise。
- await 和 promise 一样,更多的是考笔试题,当然偶尔也会问到和 promise 的一些区别。
- await 相比直接使用 Promise 来说,优势在于处理 then 的调用链,能够更清晰准确的写出代码。缺点在于滥用 await 可能会导致性能问题,因为 await 会阻塞代码,也许之后的异步代码并不依赖于前者,但仍然需要等待前者完成,导致代码失去了并发性,此时更应该使用 Promise.all。
- 一个函数如果加上 async ,那么该函数就会返回一个 Promise
async => *await => yield
// 基本用法

async function timeout (ms) {
  await new Promise((resolve) => {
    setTimeout(resolve, ms)
  })
}
async function asyncConsole (value, ms) {
  await timeout(ms)
  console.log(value)
}
asyncConsole('hello async and await', 1000)
下面来看一个使用 await 的代码。
var a = 0
var b = async () => {
  a = a + await 10
  console.log('2', a) // -> '2' 10
  a = (await 10) + a
  console.log('3', a) // -> '3' 20
}
b()
a++
console.log('1', a) // -> '1' 1
- 首先函数
b先执行,在执行到await 10之前变量a还是0,因为在await内部实现了generators,generators会保留堆栈中东西,所以这时候a = 0被保存了下来 - 因为
await是异步操作,遇到await就会立即返回一个pending状态的Promise对象,暂时返回执行代码的控制权,使得函数外的代码得以继续执行,所以会先执行console.log('1', a) - 这时候同步代码执行完毕,开始执行异步代码,将保存下来的值拿出来使用,这时候
a = 10 - 然后后面就是常规执行代码了
优缺点:
async/await的优势在于处理 then 的调用链,能够更清晰准确的写出代码,并且也能优雅地解决回调地狱问题。当然也存在一些缺点,因为 await 将异步代码改造成了同步代码,如果多个异步代码没有依赖性却使用了 await 会导致性能上的降低。
async原理
async/await语法糖就是使用Generator函数+自动执行器来运作的
// 定义了一个promise,用来模拟异步请求,作用是传入参数++
function getNum(num){
    return new Promise((resolve, reject) => {
        setTimeout(() => {
            resolve(num+1)
        }, 1000)
    })
}

//自动执行器,如果一个Generator函数没有执行完,则递归调用
function asyncFun(func){
  var gen = func();

  function next(data){
    var result = gen.next(data);
    if (result.done) return result.value;
    result.value.then(function(data){
      next(data);
    });
  }

  next();
}

// 所需要执行的Generator函数,内部的数据在执行完成一步的promise之后,再调用下一步
var func = function* (){
  var f1 = yield getNum(1);
  var f2 = yield getNum(f1);
  console.log(f2) ;
};
asyncFun(func);
- 在执行的过程中,判断一个函数的
promise是否完成,如果已经完成,将结果传入下一个函数,继续重复此步骤 - 每一个
next()方法返回值的value属性为一个Promise对象,所以我们为其添加then方法, 在then方法里面接着运行next方法挪移遍历器指针,直到Generator函数运行完成
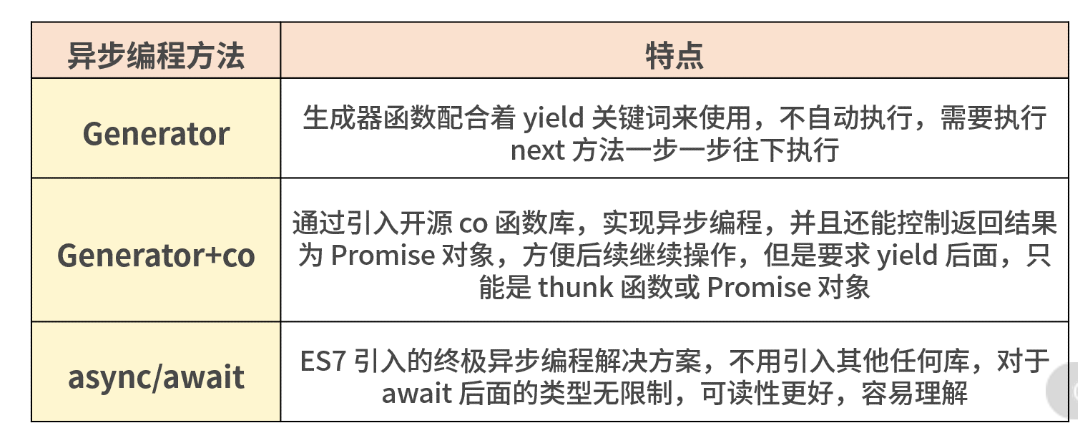
💬 面试官追问
loadUser()里明明return user,打印出来却是个Promise,为什么?async函数的返回值一律被包成Promise,return user只是它的完成值。调用方要写const user = await loadUser()或者loadUser().then(u => ...),直接当对象读拿到的就是Promise {<pending>}。列表页循环
await fetchOne(id)拉20个商品,慢得离谱,怎么改?这
20个请求互不依赖,先全部发出去再一起等:const list = await Promise.all(ids.map(fetchOne))。允许部分失败就换Promise.allSettled,拿到每一项的status自己过滤;真要控并发(比如最多5个)再上个简单的并发池。先查用户、再拿用户
id查优惠券,也要塞进Promise.all吗?不用,第二个请求的参数来自第一个的结果,本来就并行不了,顺序
await才是对的表达。Promise.all只解决「互不依赖」的那一类,别为了显得快硬套。保存按钮点了没反应,日志只打到第一个
await前面,怎么查?八成是
await的那个Promise被reject了,当前函数直接中断,后面的代码一行都不会跑。看控制台有没有Uncaught (in promise),然后在能决定怎么补救的那一层加try/catch,比如提示「保存失败」并恢复按钮状态。下面这段输出什么:
a = a + await 10,函数外面a++后打印?先输出
'1' 1,再输出'2' 10。a + await 10里左边的a在暂停前就已经读成0存起来了,恢复时算的是0 + 10,外面那次a++被覆盖掉。这题考的就是await会把左侧已经求值的部分保存下来。
# 18 事件循环
⚡ 30 秒速记
- 一句话主线:执行一个宏任务 → 清空全部微任务(含途中新加的)→ 有必要就渲染 → 取下一个宏任务
- 整段
script本身就是第一个宏任务,所以同步代码最先跑完 - 宏任务:
setTimeout/setInterval/I/O/ 用户交互事件 /MessageChannel;微任务:Promise.then/queueMicrotask/MutationObserver/await之后的代码 setTimeout(fn, 0)只保证「不早于」,嵌套超过5层才被钳到最小4ms,后台标签页还会被节流到1s左右Node:分timers/poll/check等阶段,process.nextTick比Promise微任务还早;Node 11起每个定时器回调之间也会清微任务,和浏览器对齐
事件循环说白了就是:跑完一个宏任务,把微任务队列清干净,然后看要不要渲染,再去拿下一个宏任务。 整段脚本先作为宏任务执行,途中遇到 Promise.then 登记成微任务,遇到 setTimeout 就等时间到了放进宏任务队列。所以 setTimeout(fn, 0) 写在前面也会输给后面的 Promise.then。容易漏的一点是微任务要清空到底,回调里又产生的微任务也在这一轮跑完,所以递归 then 能把页面卡死。Node 的阶段划分和浏览器不一样,setImmediate、process.nextTick 这类题不能直接套浏览器的顺序。
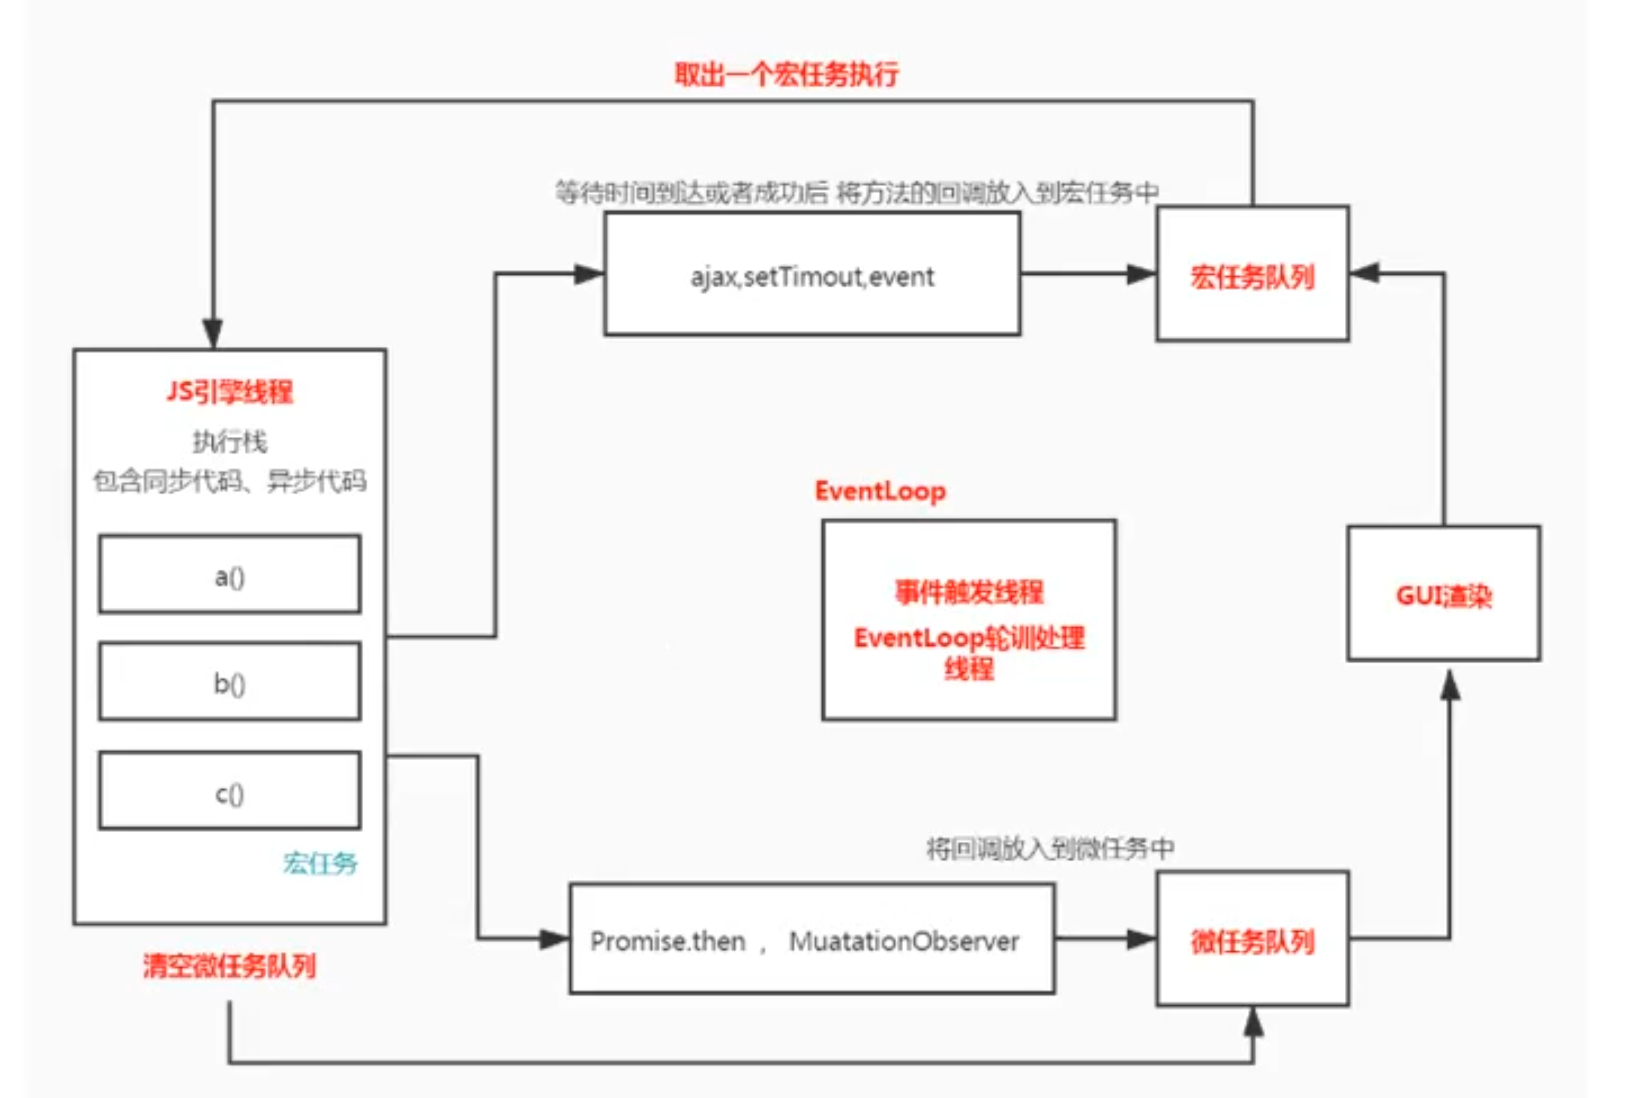
- 默认代码从上到下执行,执行环境通过
script来执行(宏任务) - 在代码执行过程中,调用定时器
promiseclick事件...不会立即执行,需要等待当前代码全部执行完毕 - 给异步方法划分队列,分别存放到微任务(立即存放)和宏任务(时间到了或事情发生了才存放)到队列中
script执行完毕后,会清空所有的微任务- 微任务执行完毕后,会渲染页面(不是每次都调用)
- 再去宏任务队列中看有没有到达时间的,拿出来其中一个执行
- 执行完毕后,按照上述步骤不停的循环
例子
自动执行的情况 会输出 listener1 listener2 task1 task2

如果手动点击click 会一个宏任务取出来一个个执行,先执行click的宏任务,取出微任务去执行。会输出 listener1 task1 listener2 task2
console.log(1)

async function asyncFunc(){
  console.log(2)
  // await xx ==> promise.resolve(()=>{console.log(3)}).then()
  // console.log(3) 放到promise.resolve或立即执行
  await console.log(3)
  // 相当于把console.log(4)放到了then promise.resolve(()=>{console.log(3)}).then(()=>{
  //   console.log(4)
  // })
  // 微任务谁先注册谁先执行
  console.log(4)
}

setTimeout(()=>{console.log(5)})

const promise = new Promise((resolve,reject)=>{
  console.log(6)
  resolve(7)
})

promise.then(d=>{console.log(d)})

asyncFunc()

console.log(8)

// 输出 1 6 2 3 8 7 4 5
1. 浏览器事件循环
涉及面试题:异步代码执行顺序?解释一下什么是
Event Loop?
JavaScript的单线程,与它的用途有关。作为浏览器脚本语言,JavaScript的主要用途是与用户互动,以及操作DOM。这决定了它只能是单线程,否则会带来很复杂的同步问题。比如,假定JavaScript同时有两个线程,一个线程在某个DOM节点上添加内容,另一个线程删除了这个节点,这时浏览器应该以哪个线程为准?所以,为了避免复杂性,从一诞生,JavaScript就是单线程,这已经成了这门语言的核心特征,将来也不会改变
js代码执行过程中会有很多任务,这些任务总的分成两类:
- 同步任务
- 异步任务
当我们打开网站时,网页的渲染过程就是一大堆同步任务,比如页面骨架和页面元素的渲染。而像加载图片音乐之类占用资源大耗时久的任务,就是异步任务。,我们用导图来说明:
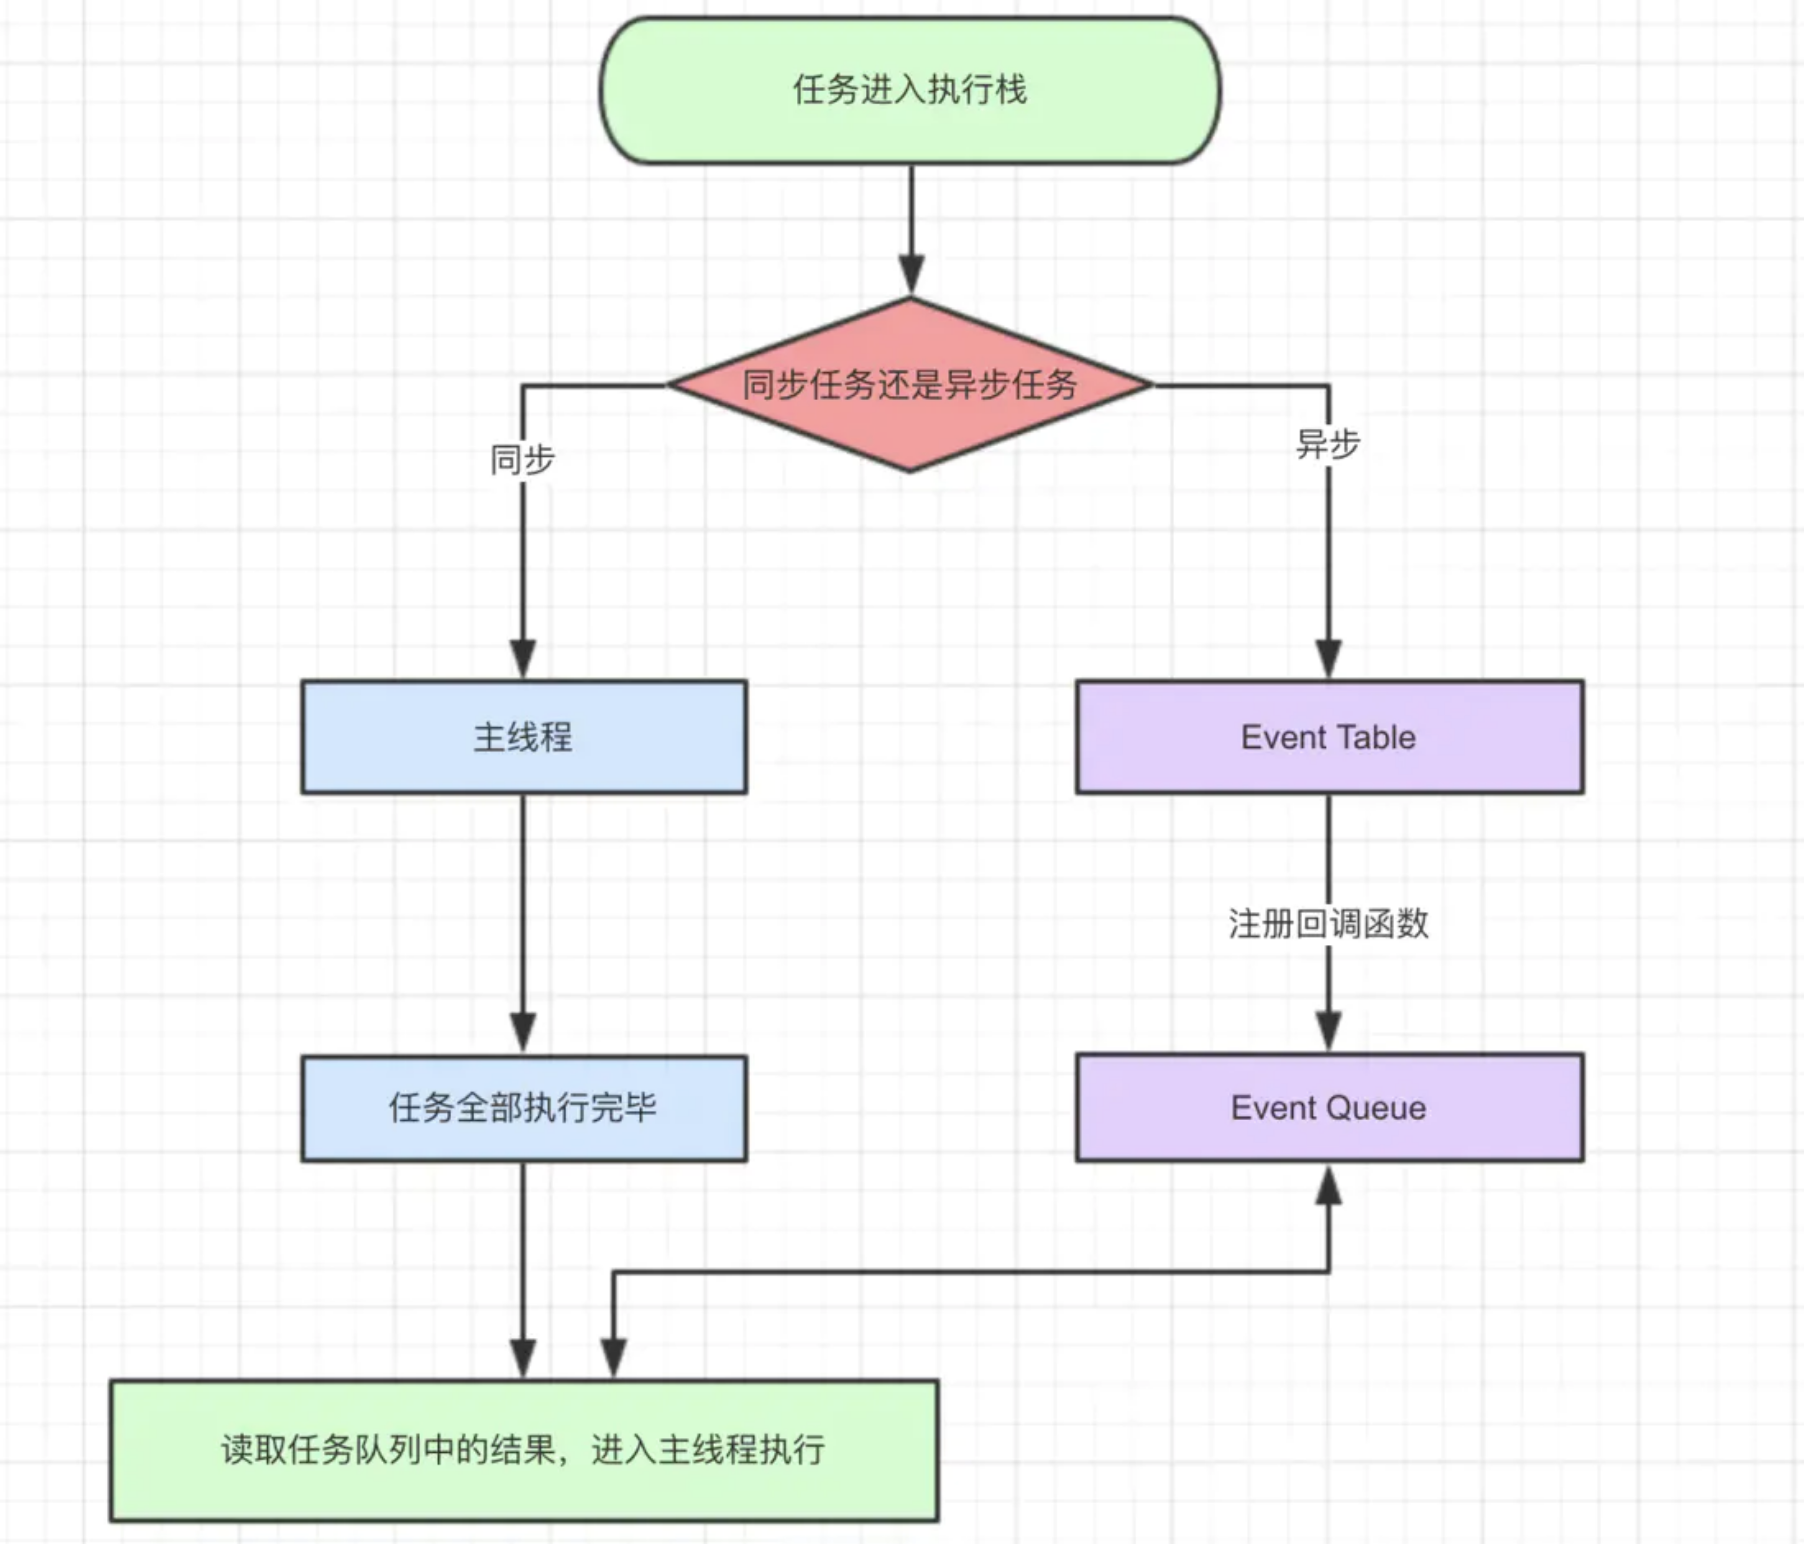
我们解释一下这张图:
- 同步和异步任务分别进入不同的执行"场所",同步的进入主线程,异步的进入Event Table并注册函数。
- 当指定的事情完成时,Event Table会将这个函数移入Event Queue。
- 主线程内的任务执行完毕为空,会去Event Queue读取对应的函数,进入主线程执行。
- 上述过程会不断重复,也就是常说的Event Loop(事件循环)。
那主线程执行栈何时为空呢?js引擎存在monitoring process进程,会持续不断的检查主线程执行栈是否为空,一旦为空,就会去Event Queue那里检查是否有等待被调用的函数
以上就是js运行的整体流程
面试中该如何回答呢? 下面是我个人推荐的回答:
- 首先js 是单线程运行的,在代码执行的时候,通过将不同函数的执行上下文压入执行栈中来保证代码的有序执行
- 在执行同步代码的时候,如果遇到了异步事件,js 引擎并不会一直等待其返回结果,而是会将这个事件挂起,继续执行执行栈中的其他任务
- 当同步事件执行完毕后,再将异步事件对应的回调加入到与当前执行栈中不同的另一个任务队列中等待执行
- 任务队列可以分为宏任务对列和微任务对列,当当前执行栈中的事件执行完毕后,js 引擎首先会判断微任务对列中是否有任务可以执行,如果有就将微任务队首的事件压入栈中执行
- 当微任务对列中的任务都执行完成后再去判断宏任务对列中的任务。
setTimeout(function() {
  console.log(1)
}, 0);
new Promise(function(resolve, reject) {
  console.log(2);
  resolve()
}).then(function() {
  console.log(3)
});
process.nextTick(function () {
  console.log(4)
})
console.log(5)
- 第一轮:主线程开始执行,遇到
setTimeout,将setTimeout的回调函数丢到宏任务队列中,在往下执行new Promise立即执行,输出2,then的回调函数丢到微任务队列中,再继续执行,遇到process.nextTick,同样将回调函数扔到微任务队列,再继续执行,输出5,当所有同步任务执行完成后看有没有可以执行的微任务,发现有then函数和nextTick两个微任务,先执行哪个呢?process.nextTick指定的异步任务总是发生在所有异步任务之前,因此先执行process.nextTick输出4然后执行then函数输出3,第一轮执行结束。 - 第二轮:从宏任务队列开始,发现setTimeout回调,输出1执行完毕,因此结果是25431
JS在执行的过程中会产生执行环境,这些执行环境会被顺序的加入到执行栈中。如果遇到异步的代码,会被挂起并加入到Task(有多种task) 队列中。一旦执行栈为空,EventLoop就会从Task队列中拿出需要执行的代码并放入执行栈中执行,所以本质上来说JS中的异步还是同步行为
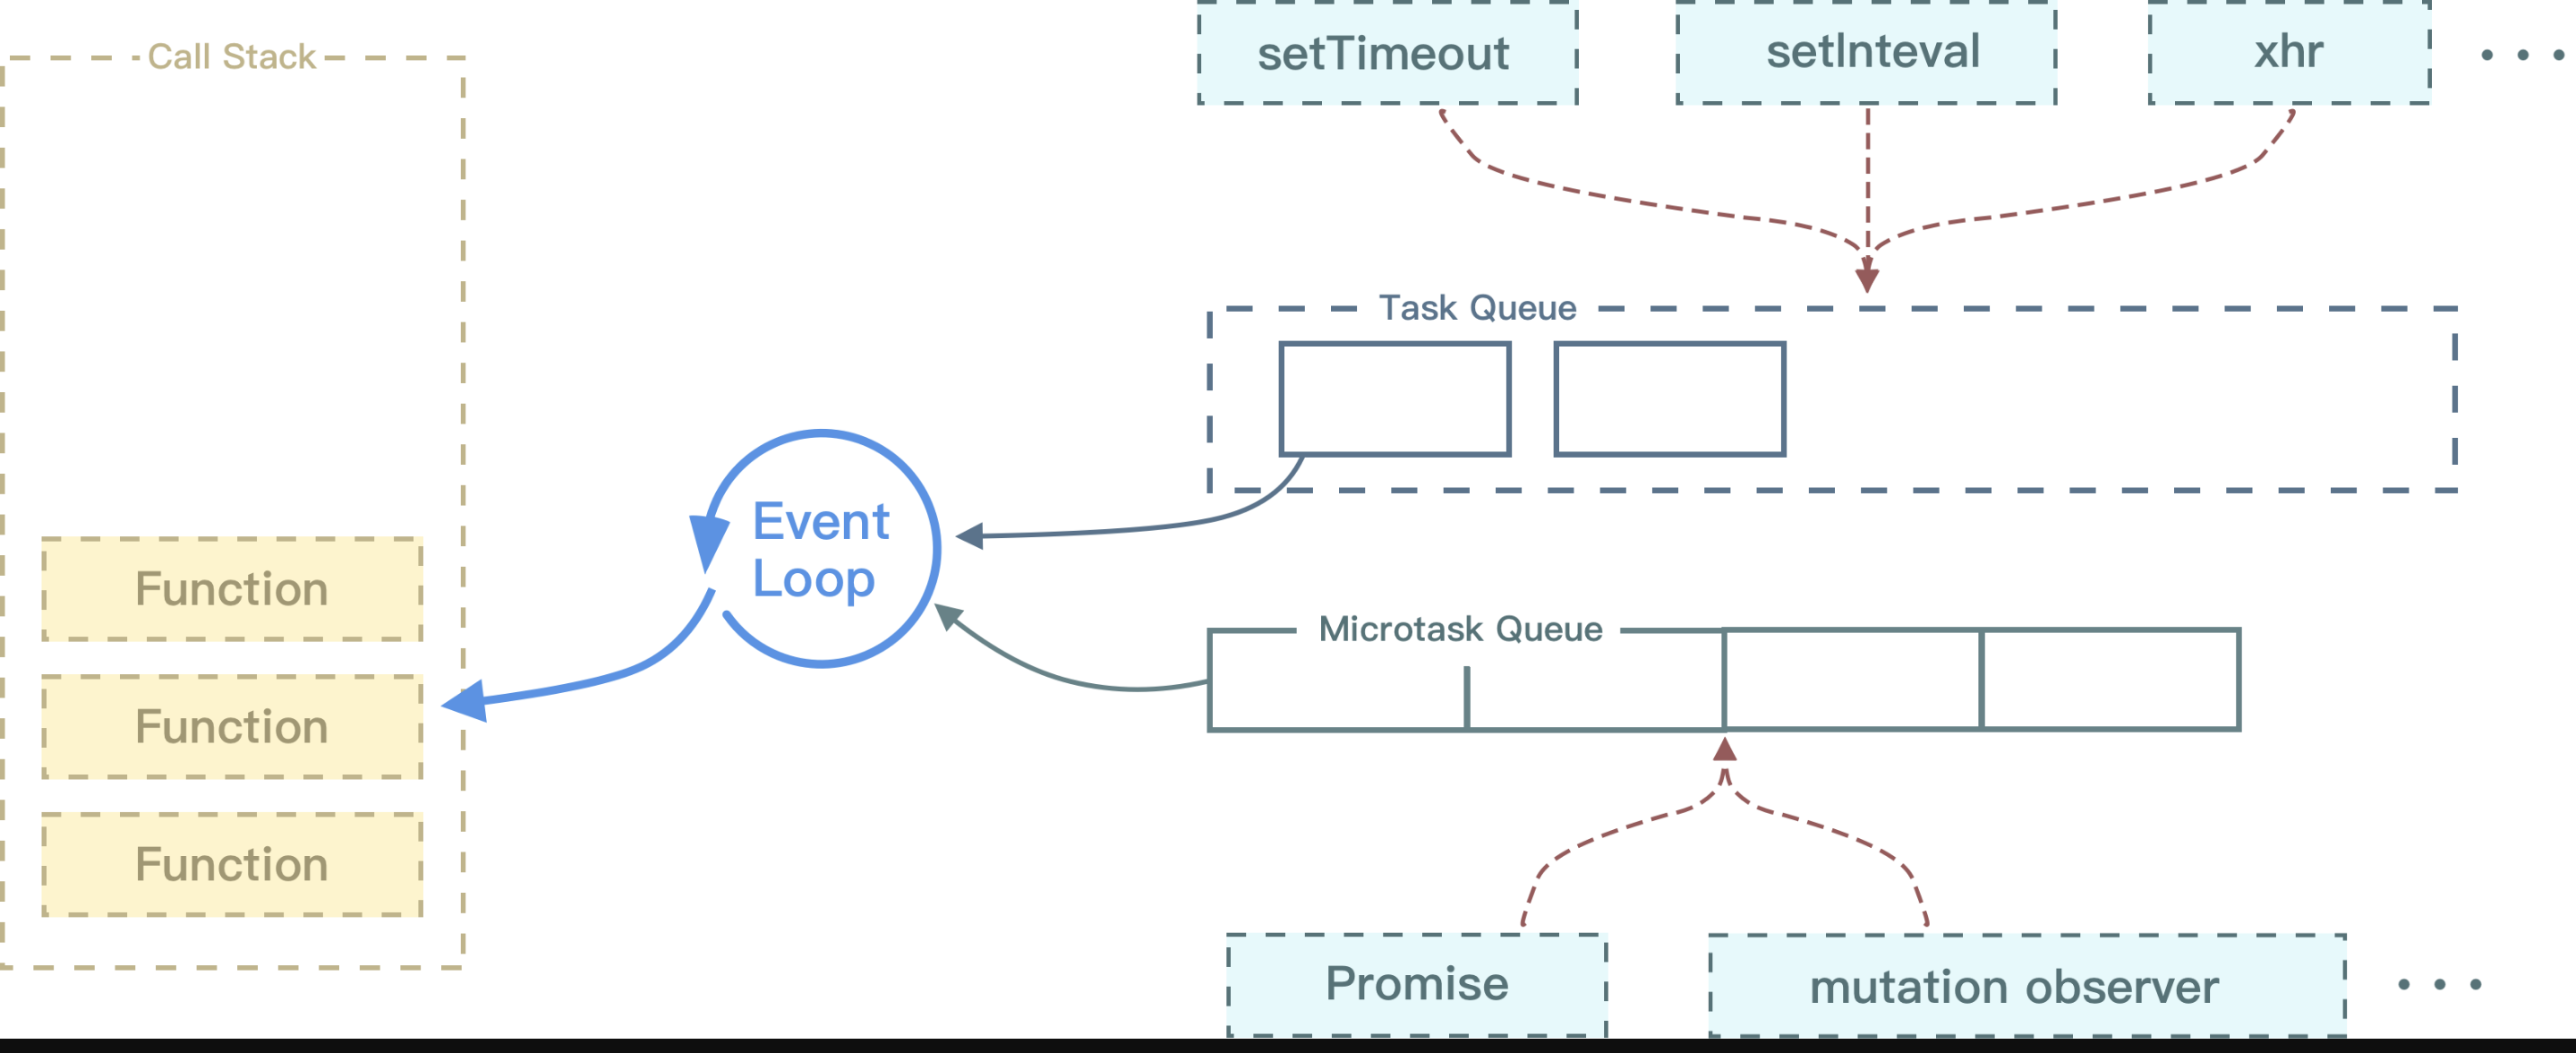
console.log('script start');

setTimeout(function() {
  console.log('setTimeout');
}, 0);

console.log('script end');
不同的任务源会被分配到不同的
Task队列中,任务源可以分为 微任务(microtask) 和 宏任务(macrotask)。在ES6规范中,microtask称为jobs,macrotask称为task
console.log('script start');

setTimeout(function() {
  console.log('setTimeout');
}, 0);

new Promise((resolve) => {
    console.log('Promise')
    resolve()
}).then(function() {
  console.log('promise1');
}).then(function() {
  console.log('promise2');
});

console.log('script end');
// script start => Promise => script end => promise1 => promise2 => setTimeout
以上代码虽然
setTimeout写在Promise之前,但是因为Promise属于微任务而setTimeout属于宏任务
微任务
process.nextTickpromiseObject.observeMutationObserver
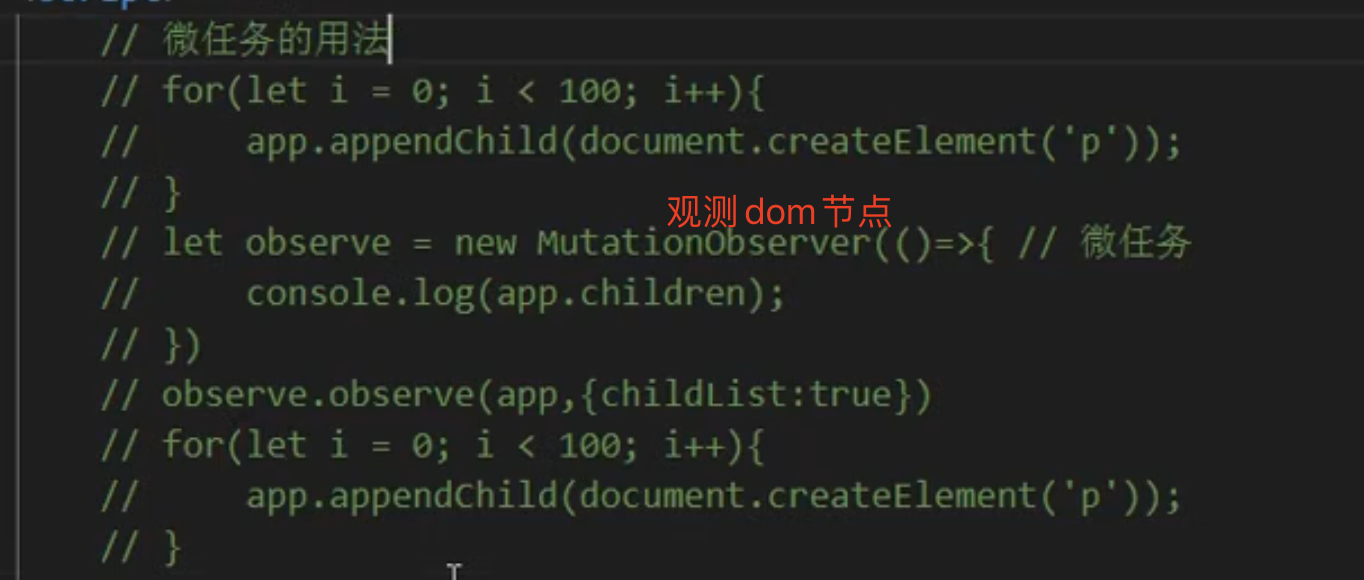
宏任务
scriptsetTimeoutsetIntervalsetImmediateI/O网络请求完成、文件读写完成事件UI rendering- 用户交互事件(比如鼠标点击、滚动页面、放大缩小等)
宏任务中包括了
script,浏览器会先执行一个宏任务,接下来有异步代码的话就先执行微任务
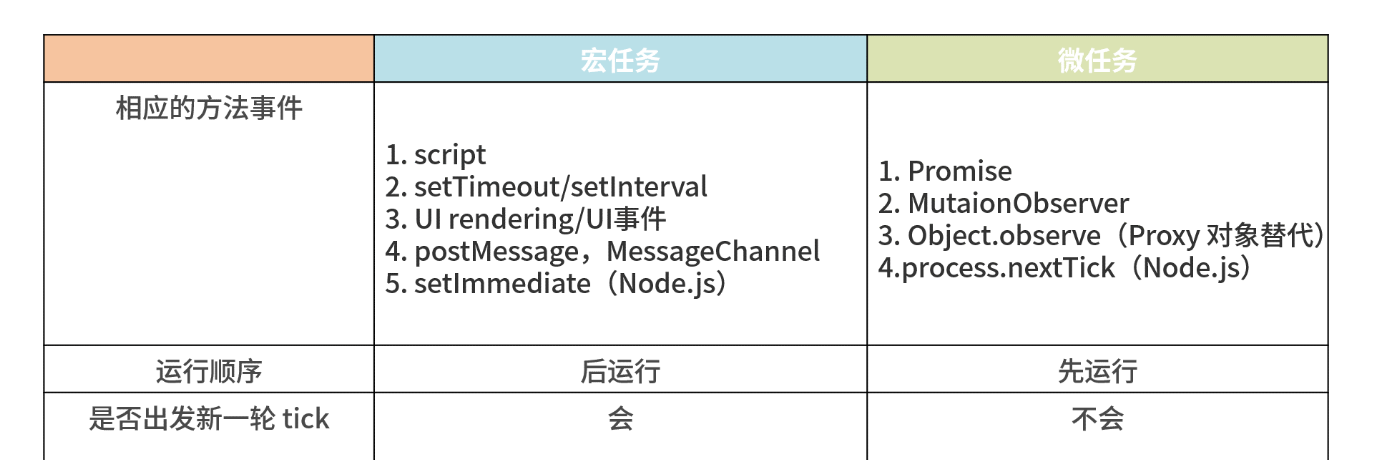
所以正确的一次 Event loop 顺序是这样的
- 执行同步代码,这属于宏任务
- 执行栈为空,查询是否有微任务需要执行
- 执行所有微任务
- 必要的话渲染 UI
- 然后开始下一轮
Event loop,执行宏任务中的异步代码
通过上述的
Event loop顺序可知,如果宏任务中的异步代码有大量的计算并且需要操作DOM的话,为了更快的响应界面响应,我们可以把操作DOM放入微任务中
- JavaScript 引擎首先从宏任务队列(macrotask queue)中取出第一个任务
- 执行完毕后,再将微任务(microtask queue)中的所有任务取出,按照顺序分别全部执行(这里包括不仅指开始执行时队列里的微任务),如果在这一步过程中产生新的微任务,也需要执行;
- 然后再从宏任务队列中取下一个,执行完毕后,再次将 microtask queue 中的全部取出,循环往复,直到两个 queue 中的任务都取完。
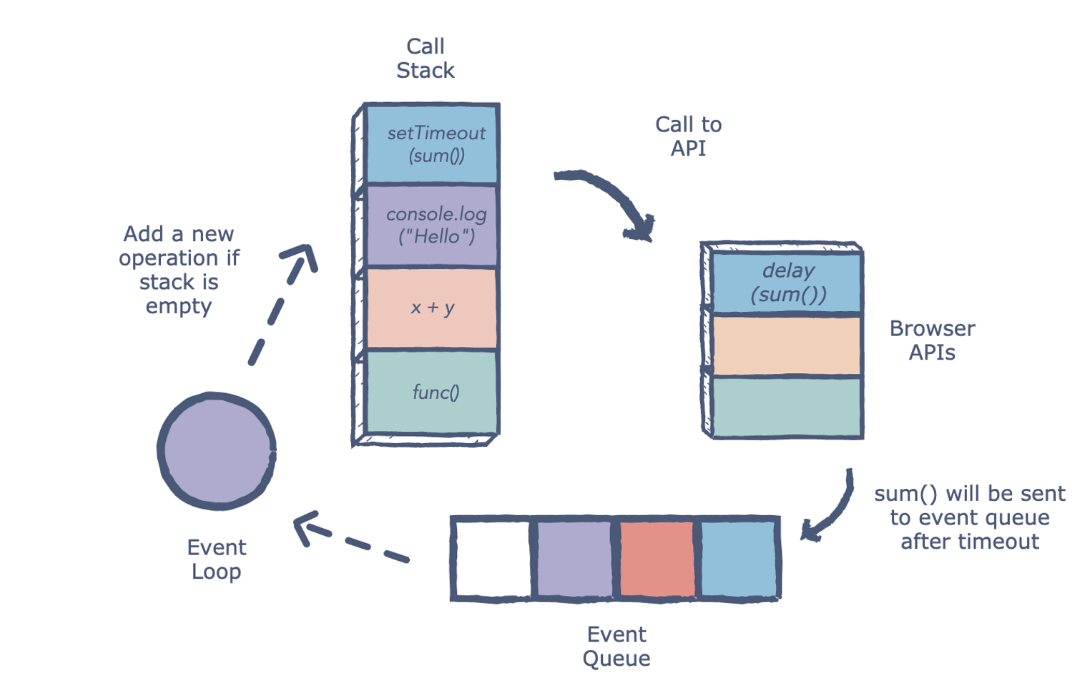
总结起来就是:
一次 Eventloop 循环会处理一个宏任务和所有这次循环中产生的微任务。
2. Node 中的 Event loop
当 Node.js 开始启动时,会初始化一个 Eventloop,处理输入的代码脚本,这些脚本会进行 API 异步调用,
process.nextTick()方法会开始处理事件循环。下面就是 Node.js 官网提供的Eventloop事件循环参考流程
Node中的Event loop和浏览器中的不相同。Node的Event loop分为6个阶段,它们会按照顺序反复运行
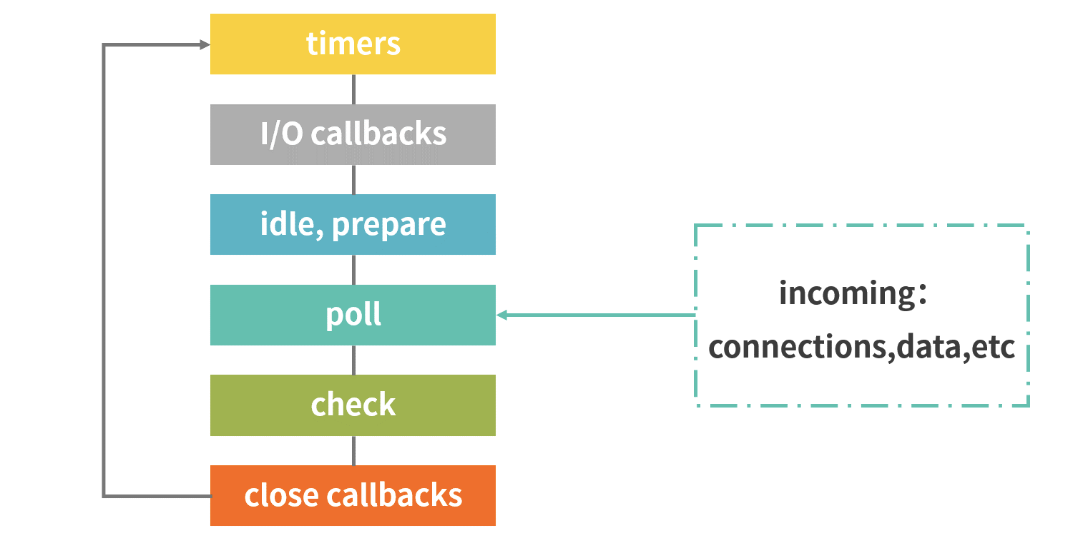
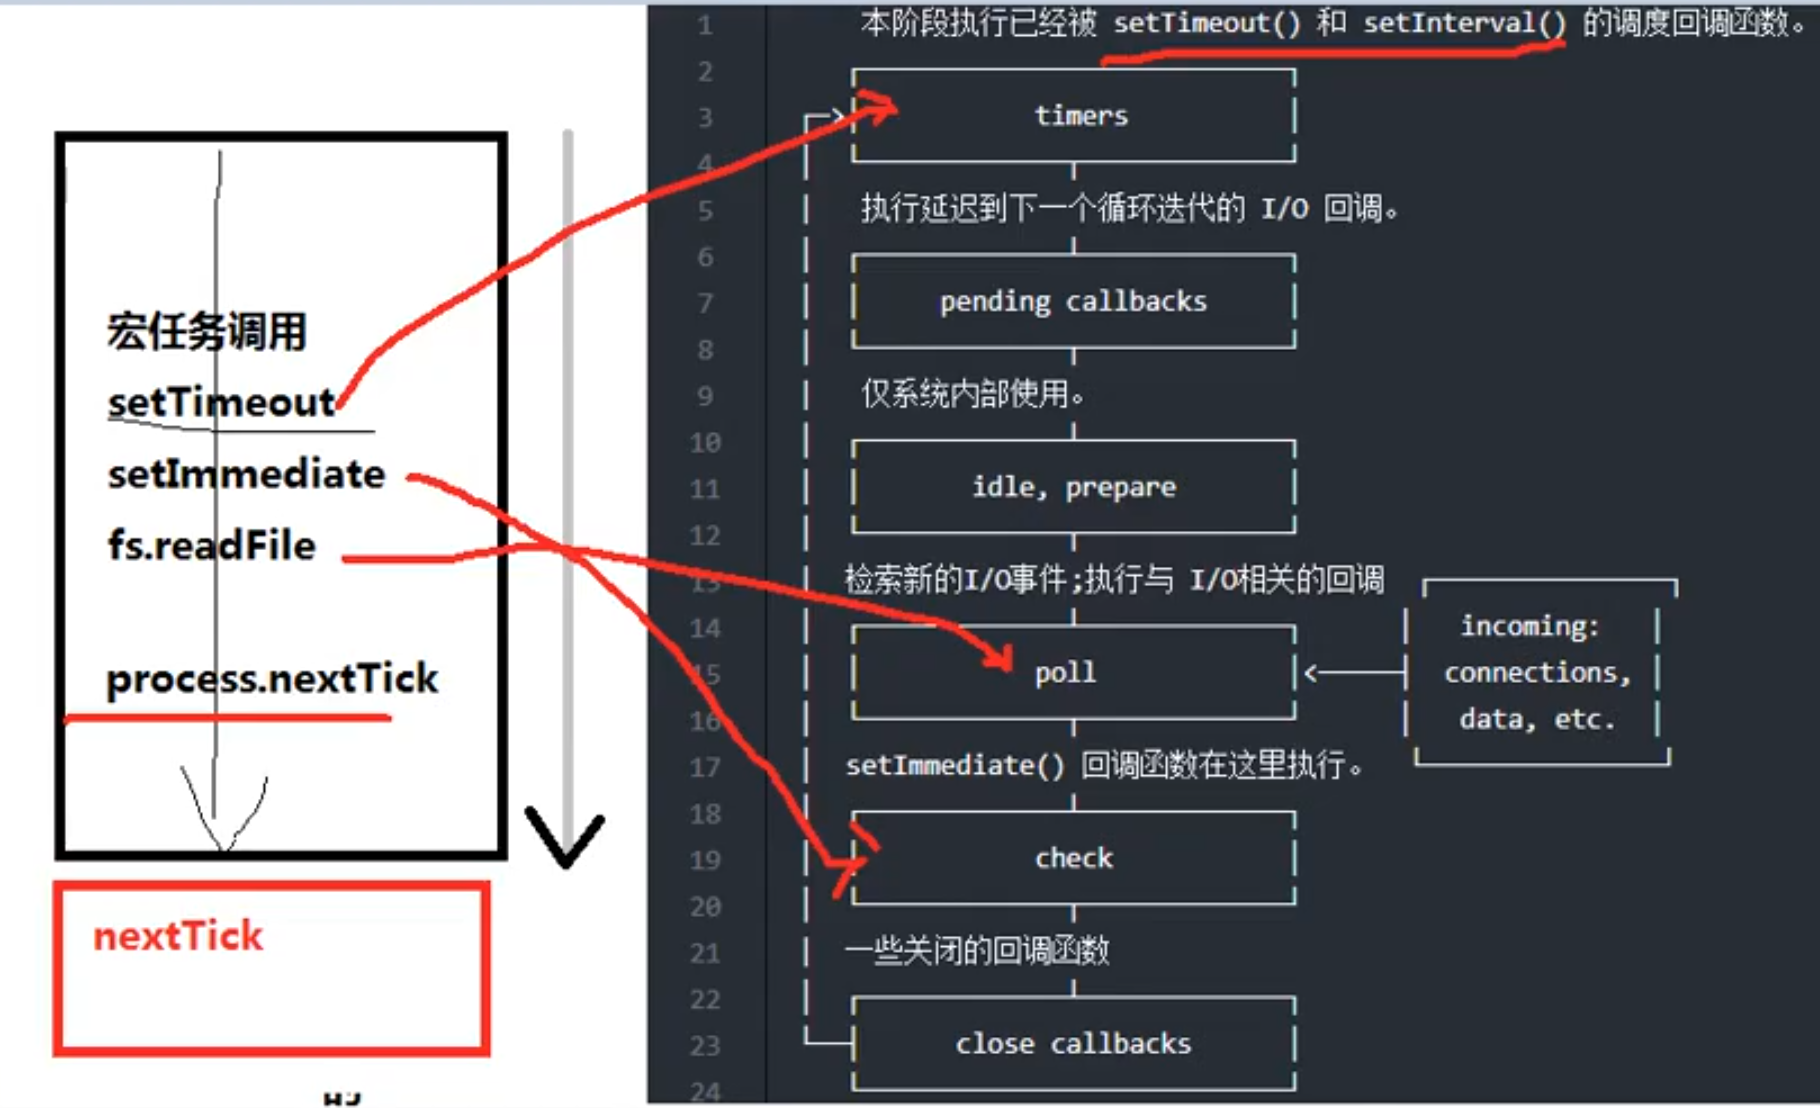

- 每次执行执行一个宏任务后会清空微任务(执行顺序和浏览器一致,在node11版本以上)
process.nextTicknode中的微任务,当前执行栈的底部,优先级比promise要高
整个流程分为六个阶段,当这六个阶段执行完一次之后,才可以算得上执行了一次 Eventloop 的循环过程。我们来分别看下这六个阶段都做了哪些事情。
- Timers 阶段:这个阶段执行
setTimeout和setInterval的回调函数,简单理解就是由这两个函数启动的回调函数。 - I/O callbacks 阶段:这个阶段主要执行系统级别的回调函数,比如 TCP 连接失败的回调。
- idle,prepare 阶段:仅系统内部使用,你只需要知道有这 2 个阶段就可以。
- poll 阶段:
poll阶段是一个重要且复杂的阶段,几乎所有I/O相关的回调,都在这个阶段执行(除了setTimeout、setInterval、setImmediate以及一些因为exception意外关闭产生的回调)。检索新的 I/O 事件,执行与 I/O 相关的回调,其他情况 Node.js 将在适当的时候在此阻塞。这也是最复杂的一个阶段,所有的事件循环以及回调处理都在这个阶段执行。这个阶段的主要流程如下图所示。
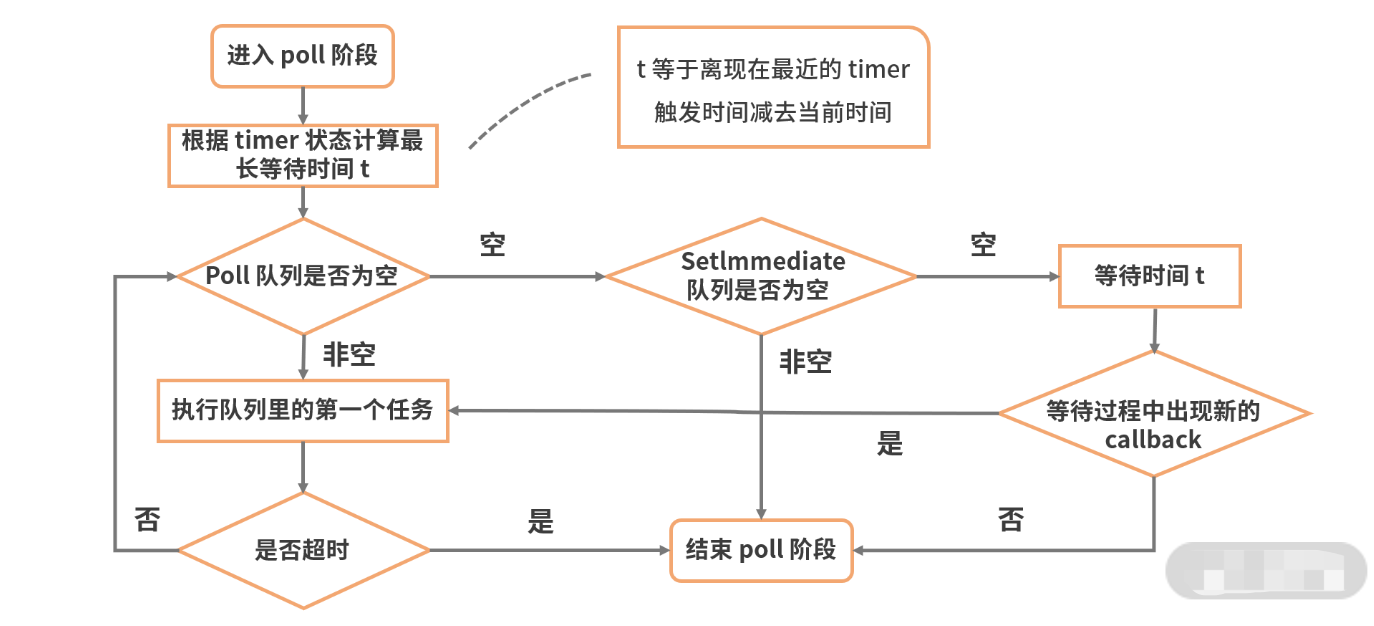
- check 阶段:
setImmediate()回调函数在这里执行,setImmediate并不是立马执行,而是当事件循环poll 中没有新的事件处理时就执行该部分,如下代码所示。
const fs = require('fs');
setTimeout(() => { // 新的事件循环的起点
    console.log('1');
}, 0);
setImmediate( () => {
    console.log('setImmediate 1');
});
/// fs.readFile 将会在 poll 阶段执行
fs.readFile('./test.conf', {encoding: 'utf-8'}, (err, data) => {
    if (err) throw err;
    console.log('read file success');
});
/// 该部分将会在首次事件循环中执行
Promise.resolve().then(()=>{
    console.log('poll callback');
});
// 首次事件循环执行
console.log('2');
在这一代码中有一个非常奇特的地方,就是 setImmediate 会在 setTimeout 之后输出。有以下几点原因:
setTimeout如果不设置时间或者设置时间为0,则会默认为1ms- 主流程执行完成后,超过
1ms时,会将setTimeout回调函数逻辑插入到待执行回调函数poll队列中;- 由于当前
poll队列中存在可执行回调函数,因此需要先执行完,待完全执行完成后,才会执行check:setImmediate。
因此这也验证了这句话,
先执行回调函数,再执行 setImmediate
- close callbacks 阶段:执行一些关闭的回调函数,如
socket.on('close', ...)
除了把 Eventloop 的宏任务细分到不同阶段外。node 还引入了一个新的任务队列
Process.nextTick()
可以认为,Process.nextTick() 会在上述各个阶段结束时,在进入下一个阶段之前立即执行(优先级甚至超过 microtask 队列)
事件循环的主要包含微任务和宏任务。具体是怎么进行循环的呢
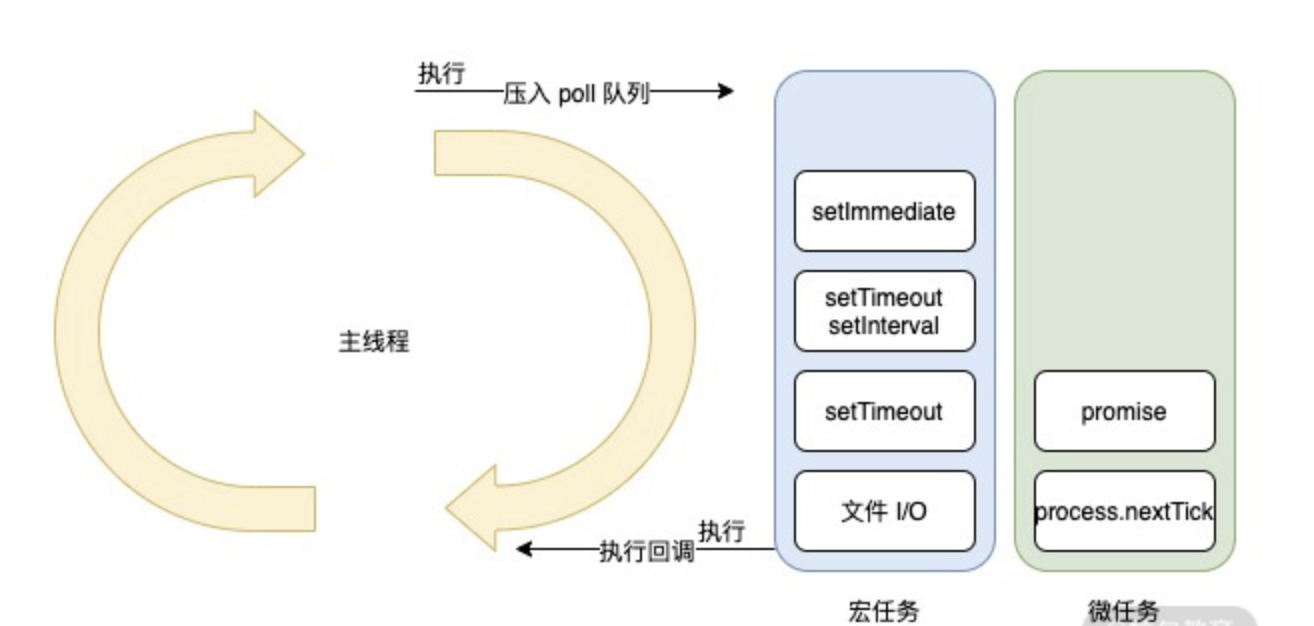
- 微任务:在 Node.js 中微任务包含 2 种——
process.nextTick和Promise。微任务在事件循环中优先级是最高的,因此在同一个事件循环中有其他任务存在时,优先执行微任务队列。并且process.nextTick 和 Promise也存在优先级,process.nextTick高于Promise - 宏任务:在 Node.js 中宏任务包含 4 种——
setTimeout、setInterval、setImmediate和I/O。宏任务在微任务执行之后执行,因此在同一个事件循环周期内,如果既存在微任务队列又存在宏任务队列,那么优先将微任务队列清空,再执行宏任务队列
我们可以看到有一个核心的主线程,它的执行阶段主要处理三个核心逻辑。
- 同步代码。
- 将异步任务插入到微任务队列或者宏任务队列中。
- 执行微任务或者宏任务的回调函数。在主线程处理回调函数的同时,也需要判断是否插入微任务和宏任务。根据优先级,先判断微任务队列是否存在任务,存在则先执行微任务,不存在则判断在宏任务队列是否有任务,有则执行。
const fs = require('fs');
// 首次事件循环执行
console.log('start');
/// 将会在新的事件循环中的阶段执行
fs.readFile('./test.conf', {encoding: 'utf-8'}, (err, data) => {
    if (err) throw err;
    console.log('read file success');
});
setTimeout(() => { // 新的事件循环的起点
    console.log('setTimeout');
}, 0);
/// 该部分将会在首次事件循环中执行
Promise.resolve().then(()=>{
    console.log('Promise callback');
});
/// 执行 process.nextTick
process.nextTick(() => {
    console.log('nextTick callback');
});
// 首次事件循环执行
console.log('end');
分析下上面代码的执行过程
- 第一个事件循环主线程发起,因此先执行同步代码,所以先输出 start,然后输出 end
- 第一个事件循环主线程发起,因此先执行同步代码,所以先输出 start,然后输出 end;
- 再从上往下分析,遇到微任务,插入微任务队列,遇到宏任务,插入宏任务队列,分析完成后,微任务队列包含:
Promise.resolve 和 process.nextTick,宏任务队列包含:fs.readFile 和 setTimeout; - 先执行微任务队列,但是根据优先级,先执行
process.nextTick 再执行 Promise.resolve,所以先输出nextTick callback再输出Promise callback; - 再执行宏任务队列,根据
宏任务插入先后顺序执行 setTimeout 再执行 fs.readFile,这里需要注意,先执行setTimeout由于其回调时间较短,因此回调也先执行,并非是setTimeout先执行所以才先执行回调函数,但是它执行需要时间肯定大于1ms,所以虽然fs.readFile先于setTimeout执行,但是setTimeout执行更快,所以先输出setTimeout,最后输出read file success。
// 输出结果
start
end
nextTick callback
Promise callback
setTimeout
read file success
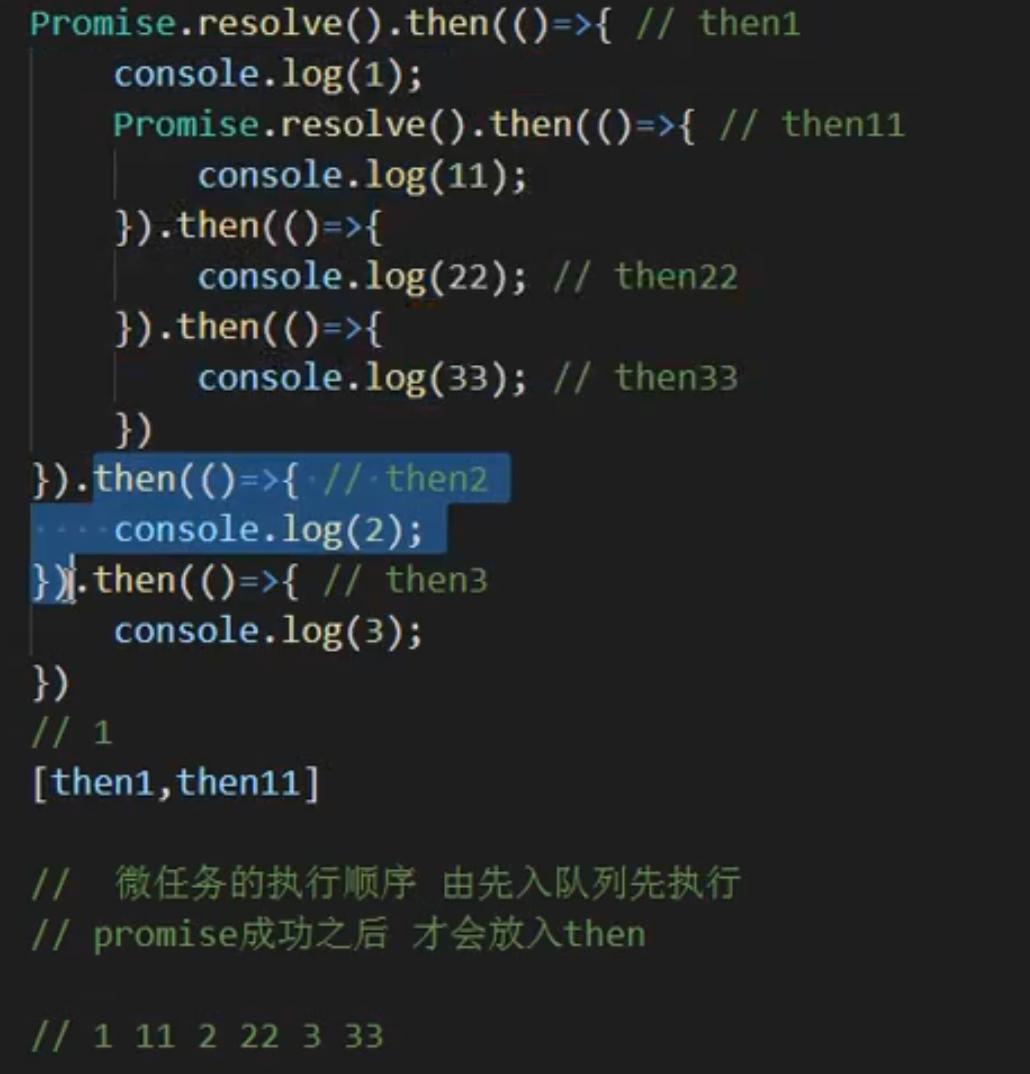
当微任务和宏任务又产生新的微任务和宏任务时,又应该如何处理呢?如下代码所示:
const fs = require('fs');
setTimeout(() => { // 新的事件循环的起点
    console.log('1');
    fs.readFile('./config/test.conf', {encoding: 'utf-8'}, (err, data) => {
        if (err) throw err;
        console.log('read file sync success');
    });
}, 0);
/// 回调将会在新的事件循环之前
fs.readFile('./config/test.conf', {encoding: 'utf-8'}, (err, data) => {
    if (err) throw err;
    console.log('read file success');
});
/// 该部分将会在首次事件循环中执行
Promise.resolve().then(()=>{
    console.log('poll callback');
});
// 首次事件循环执行
console.log('2');
在上面代码中,有 2 个宏任务和 1 个微任务,宏任务是 setTimeout 和 fs.readFile,微任务是 Promise.resolve。
- 整个过程优先执行主线程的第一个事件循环过程,所以先执行同步逻辑,先输出 2。
- 接下来执行微任务,输出
poll callback。 - 再执行宏任务中的
fs.readFile 和 setTimeout,由于fs.readFile优先级高,先执行fs.readFile。但是处理时间长于1ms,因此会先执行setTimeout的回调函数,输出1。这个阶段在执行过程中又会产生新的宏任务fs.readFile,因此又将该fs.readFile 插入宏任务队列 - 最后由于只剩下宏任务了
fs.readFile,因此执行该宏任务,并等待处理完成后的回调,输出read file sync success。
// 结果
2
poll callback
1
read file success
read file sync success
Process.nextick() 和 Vue 的 nextick
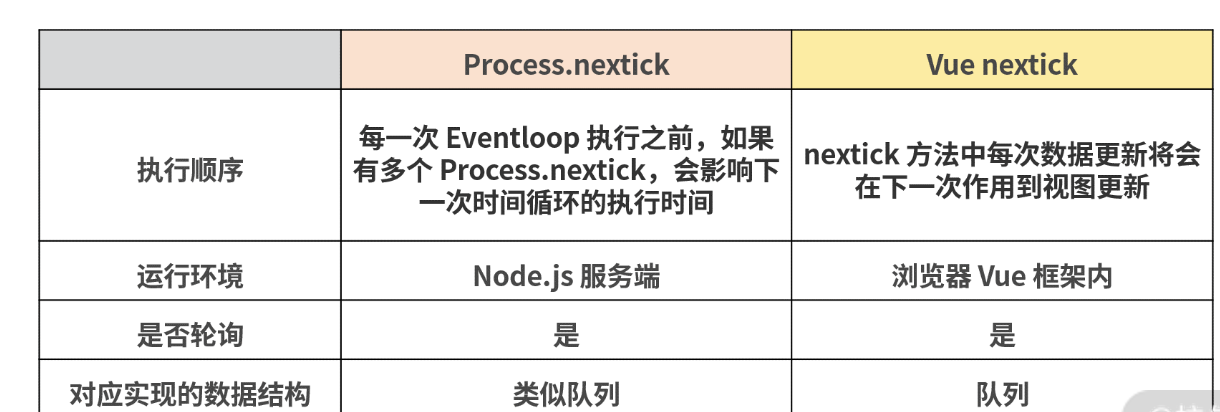
Node.js和浏览器端宏任务队列的另一个很重要的不同点是,浏览器端任务队列每轮事件循环仅出队一个回调函数接着去执行微任务队列;而Node.js端只要轮到执行某个宏任务队列,则会执行完队列中所有的当前任务,但是当前轮次新添加到队尾的任务则会等到下一轮次才会执行。
setTimeout(() => {
    console.log('setTimeout');
}, 0);
setImmediate(() => {
    console.log('setImmediate');
})
// 这里可能会输出 setTimeout,setImmediate
// 可能也会相反的输出,这取决于性能
// 因为可能进入 event loop 用了不到 1 毫秒,这时候会执行 setImmediate
// 否则会执行 setTimeout
上面介绍的都是
macrotask的执行情况,microtask会在以上每个阶段完成后立即执行
setTimeout(()=>{
    console.log('timer1')

    Promise.resolve().then(function() {
        console.log('promise1')
    })
}, 0)

setTimeout(()=>{
    console.log('timer2')

    Promise.resolve().then(function() {
        console.log('promise2')
    })
}, 0)

// 以上代码在浏览器和 node 中打印情况是不同的
// 浏览器中一定打印 timer1, promise1, timer2, promise2
// node 中可能打印 timer1, timer2, promise1, promise2
// 也可能打印 timer1, promise1, timer2, promise2
Node中的process.nextTick会先于其他microtask执行
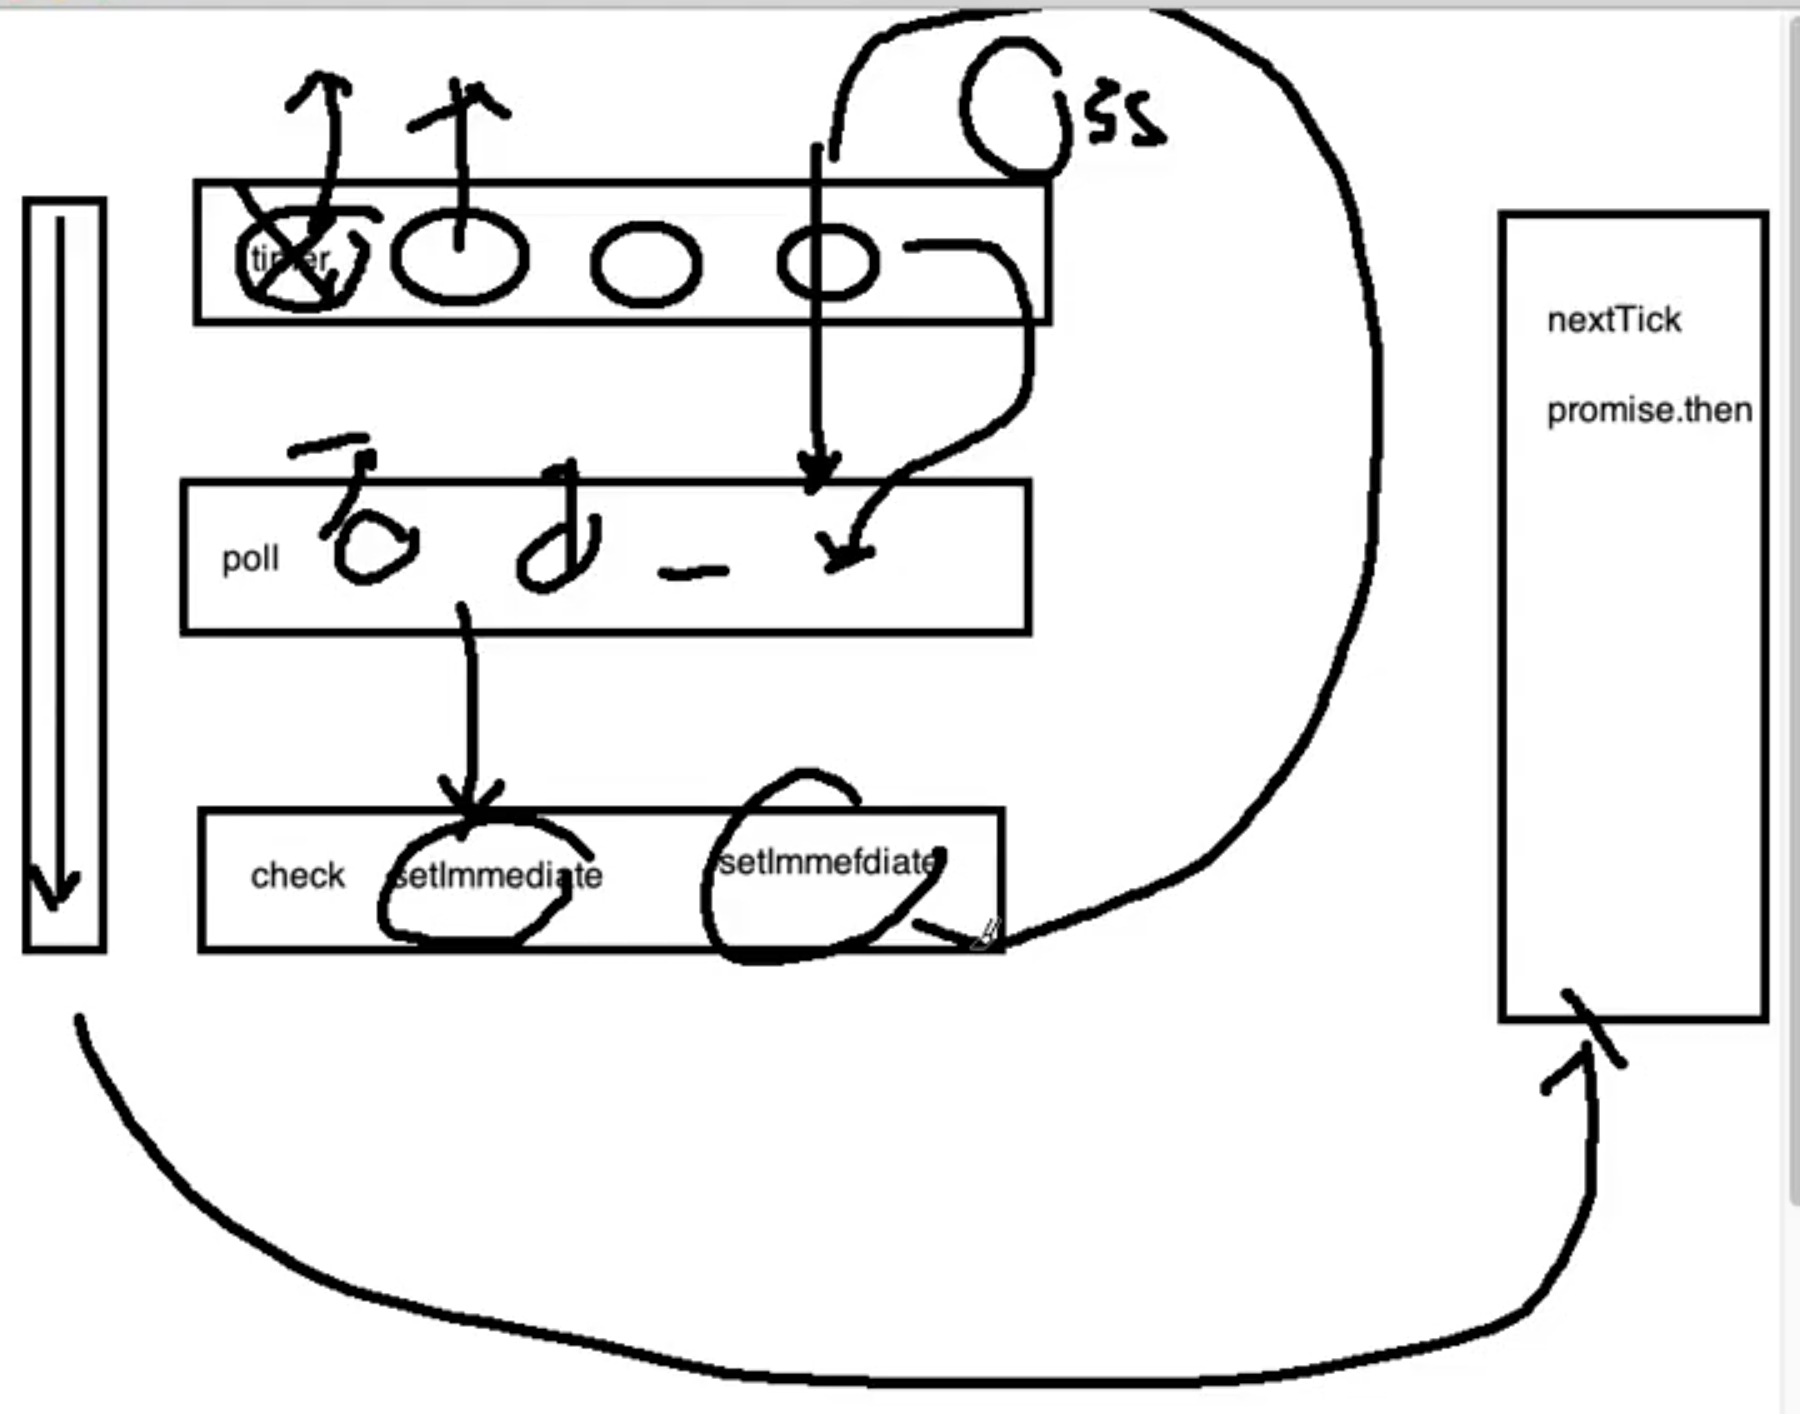
setTimeout(() => {
 console.log("timer1");

 Promise.resolve().then(function() {
   console.log("promise1");
 });
}, 0);

// poll阶段执行
fs.readFile('./test',()=>{
  // 在poll阶段里面 如果有setImmediate优先执行,setTimeout处于事件循环顶端 poll下面就是setImmediate
  setTimeout(()=>console.log('setTimeout'),0)
  setImmediate(()=>console.log('setImmediate'),0)
})

process.nextTick(() => {
 console.log("nextTick");
});
// nextTick, timer1, promise1,setImmediate,setTimeout
对于
microtask来说,它会在以上每个阶段完成前清空microtask队列,下图中的Tick就代表了microtask
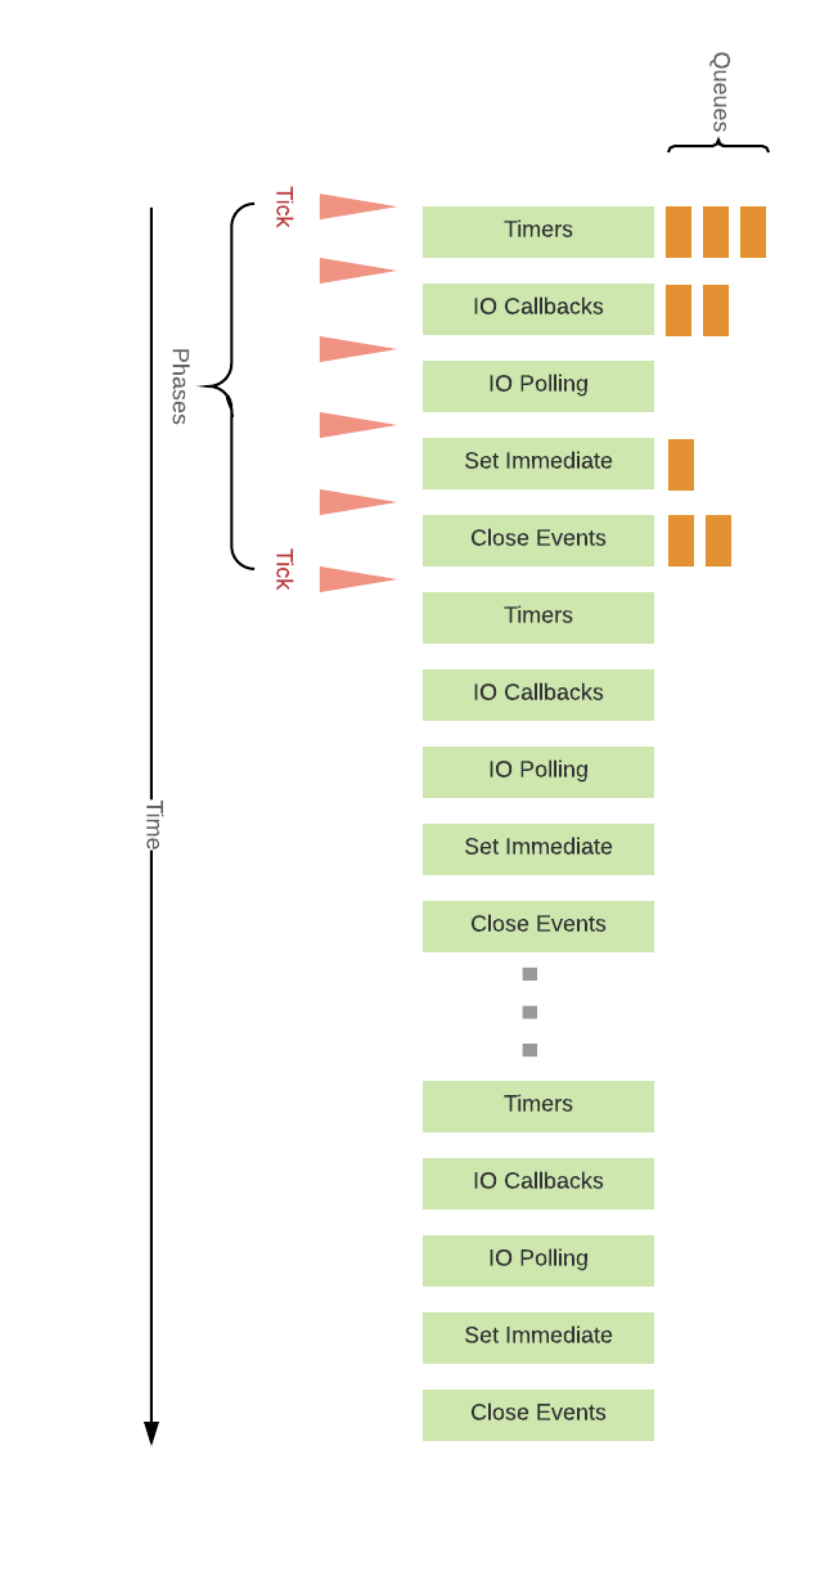
谁来启动这个循环过程,循环条件是什么?
当 Node.js 启动后,会初始化事件循环,处理已提供的输入脚本,它可能会先调用一些异步的 API、调度定时器,或者
process.nextTick(),然后再开始处理事件循环。因此可以这样理解,Node.js 进程启动后,就发起了一个新的事件循环,也就是事件循环的起点。
总结来说,Node.js 事件循环的发起点有 4 个:
Node.js启动后;setTimeout回调函数;setInterval回调函数;- 也可能是一次
I/O后的回调函数。
无限循环有没有终点
当所有的微任务和宏任务都清空的时候,虽然当前没有任务可执行了,但是也并不能代表循环结束了。因为可能存在当前还未回调的异步 I/O,所以这个循环是没有终点的,只要进程在,并且有新的任务存在,就会去执行
Node.js 是单线程的还是多线程的?
主线程是单线程执行的,但是 Node.js存在多线程执行,多线程包括setTimeout 和异步 I/O 事件。其实 Node.js 还存在其他的线程,包括垃圾回收、内存优化等
EventLoop 对渲染的影响
- 想必你之前在业务开发中也遇到过
requestIdlecallback 和 requestAnimationFrame,这两个函数在我们之前的内容中没有讲过,但是当你开始考虑它们在 Eventloop 的生命周期的哪一步触发,或者这两个方法的回调会在微任务队列还是宏任务队列执行的时候,才发现好像没有想象中那么简单。这两个方法其实也并不属于 JS 的原生方法,而是浏览器宿主环境提供的方法,因为它们牵扯到另一个问题:渲染。 - 我们知道浏览器作为一个复杂的应用是多线程工作的,除了运行 JS 的线程外,还有渲染线程、定时器触发线程、HTTP 请求线程,等等。JS 线程可以读取并且修改 DOM,而渲染线程也需要读取 DOM,这是一个典型的多线程竞争临界资源的问题。所以浏览器就把这两个线程设计成互斥的,即同时只能有一个线程在执行
- 渲染原本就不应该出现在 Eventloop 相关的知识体系里,但是因为 Eventloop 显然是在讨论 JS 如何运行的问题,而渲染则是浏览器另外一个线程的工作。但是
requestAnimationFrame的出现却把这两件事情给关联起来 - 通过调用
requestAnimationFrame我们可以在下次渲染之前执行回调函数。那下次渲染具体是哪个时间点呢?渲染和 Eventloop 有什么关系呢?- 简单来说,就是在每一次
Eventloop的末尾,判断当前页面是否处于渲染时机,就是重新渲染
- 简单来说,就是在每一次
- 有屏幕的硬件限制,比如 60Hz 刷新率,简而言之就是 1 秒刷新了 60 次,16.6ms 刷新一次。这个时候浏览器的渲染间隔时间就没必要小于
16.6ms,因为就算渲染了屏幕上也看不到。当然浏览器也不能保证一定会每 16.6ms 会渲染一次,因为还会受到处理器的性能、JavaScript 执行效率等其他因素影响。 - 回到
requestAnimationFrame,这个 API 保证在下次浏览器渲染之前一定会被调用,实际上我们完全可以把它看成是一个高级版的setInterval。它们都是在一段时间后执行回调,但是前者的间隔时间是由浏览器自己不断调整的,而后者只能由用户指定。这样的特性也决定了requestAnimationFrame更适合用来做针对每一帧来修改的动画效果 - 当然
requestAnimationFrame不是Eventloop里的宏任务,或者说它并不在Eventloop的生命周期里,只是浏览器又开放的一个在渲染之前发生的新的 hook。另外需要注意的是微任务的认知概念也需要更新,在执行 animation callback 时也有可能产生微任务(比如 promise 的 callback),会放到 animation queue 处理完后再执行。所以微任务并不是像之前说的那样在每一轮 Eventloop 后处理,而是在 JS 的函数调用栈清空后处理
但是 requestIdlecallback 却是一个更好理解的概念。当宏任务队列中没有任务可以处理时,浏览器可能存在“空闲状态”。这段空闲时间可以被 requestIdlecallback 利用起来执行一些优先级不高、不必立即执行的任务,如下图所示:
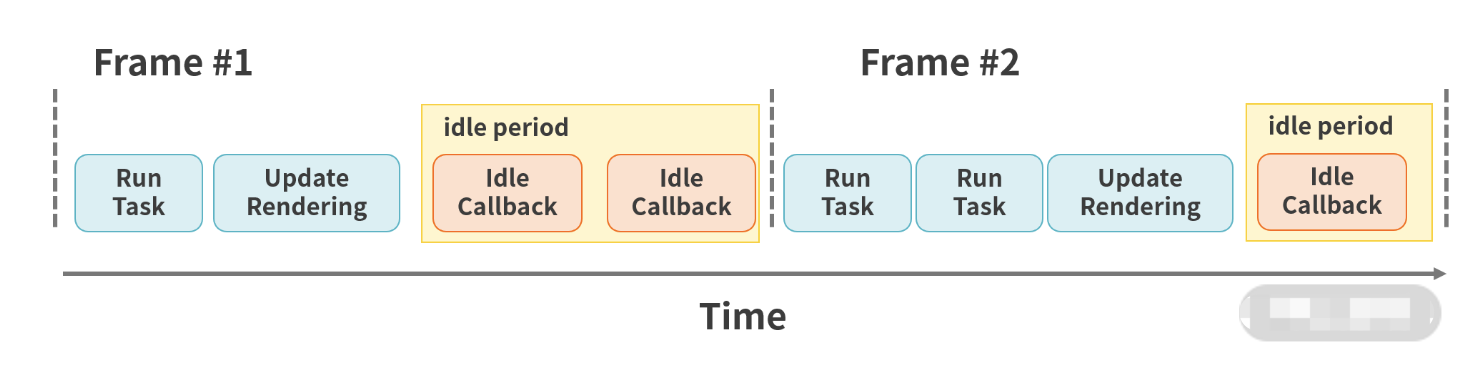
💬 面试官追问
setTimeout(fn, 0)写在Promise.resolve().then(task)前面,为什么还是task先跑?注册顺序只在同一类队列里有意义。当前脚本这个宏任务跑完后要先清空微任务,
task在微任务队列里,fn得等下一轮宏任务才轮得到。点按钮先把状态改成
loading,接着同步算两秒,为什么loading根本没出来?渲染只发生在任务之间,点击回调占着主线程两秒,浏览器没机会画。把重计算拆片,用
setTimeout或scheduler.yield()让出主线程,或者干脆扔进Web Worker。包进Promise.then没用,微任务照样在渲染前跑完。递归
Promise.then每次回调都很短,页面却完全不重绘,问题在哪?微任务队列要清空才会进入渲染,回调里不停加新的微任务,这一轮就永远结束不了,等于一个死循环。分批的活要交给宏任务或
requestAnimationFrame,给浏览器留出渲染的空档。线上日志里
setTimeout(..., 0)偶尔隔了几百毫秒才执行,先查什么?先查主线程上有没有长任务:大段同步计算、一大串微任务、高频事件里的重活,
Performance面板里超过50ms的红角任务就是嫌疑。再看是不是后台标签页,那种情况下定时器会被浏览器主动节流到1s一次。Node里process.nextTick、Promise.then、setTimeout、setImmediate一起写,顺序怎么排?主模块里一般是
nextTick→then→ 后面两个。setTimeout(0)和setImmediate在主模块里谁先不确定,取决于进入事件循环时1ms有没有到;但如果是在I/O回调里注册,setImmediate一定先,因为poll阶段后面紧跟check。
# 19 垃圾回收
⚡ 30 秒速记
- 判断标准是可达性:从全局对象、调用栈这些根出发能摸到的就活着,摸不到的就回收,所以循环引用也能收
- 引用计数是老方案,循环引用永远归不了零,老
IE的DOM泄漏就是这么来的 V8分代:新生代用Scavenge(From/To两块来回复制),活过一次或To空间超25%就晋升老生代- 老生代:标记清除 + 标记整理(解决碎片);增量标记、并发标记、并行回收都是为了缩短停顿
- 前端能做的不是调
GC,而是别留着不该留的引用、热路径少造临时对象
垃圾回收看的是对象还能不能被访问到,不看你业务上还用不用它。 引擎从全局对象和调用栈出发顺着引用走一遍,走不到的就是垃圾,所以两个对象互相引用但外面没人引用它们,照样会被收掉。V8 按「大部分对象死得早」这个假设分了代:新生代空间小,用复制算法很快;活得久的晋升到老生代,用标记清除加标记整理。回收时主线程要停一下,V8 这些年做的增量标记、并发标记,就是把一次长停顿拆碎或挪到后台线程。
- 对于在JavaScript中的字符串,对象,数组是没有固定大小的,只有当对他们进行动态分配存储时,解释器就会分配内存来存储这些数据,当JavaScript的解释器消耗完系统中所有可用的内存时,就会造成系统崩溃。
- 内存泄漏,在某些情况下,不再使用到的变量所占用内存没有及时释放,导致程序运行中,内存越占越大,极端情况下可以导致系统崩溃,服务器宕机。
- JavaScript有自己的一套垃圾回收机制,JavaScript的解释器可以检测到什么时候程序不再使用这个对象了(数据),就会把它所占用的内存释放掉。
- 针对JavaScript的来及回收机制有以下两种方法(常用):标记清除,引用计数
- 标记清除
v8 的垃圾回收机制基于分代回收机制,这个机制又基于世代假说,这个假说有两个特点,一是新生的对象容易早死,另一个是不死的对象会活得更久。基于这个假说,v8 引擎将内存分为了新生代和老生代。
- 新创建的对象或者只经历过一次的垃圾回收的对象被称为新生代。经历过多次垃圾回收的对象被称为老生代。
- 新生代被分为 From 和 To 两个空间,To 一般是闲置的。当 From 空间满了的时候会执行 Scavenge 算法进行垃圾回收。当我们执行垃圾回收算法的时候应用逻辑将会停止,等垃圾回收结束后再继续执行。
这个算法分为三步:
- 首先检查 From 空间的存活对象,如果对象存活则判断对象是否满足晋升到老生代的条件,如果满足条件则晋升到老生代。如果不满足条件则移动 To 空间。
- 如果对象不存活,则释放对象的空间。
- 最后将 From 空间和 To 空间角色进行交换。
新生代对象晋升到老生代有两个条件:
- 第一个是判断是对象否已经经过一次 Scavenge 回收。若经历过,则将对象从 From 空间复制到老生代中;若没有经历,则复制到 To 空间。
- 第二个是 To 空间的内存使用占比是否超过限制。当对象从 From 空间复制到 To 空间时,若 To 空间使用超过 25%,则对象直接晋升到老生代中。设置 25% 的原因主要是因为算法结束后,两个空间结束后会交换位置,如果 To 空间的内存太小,会影响后续的内存分配。
老生代采用了标记清除法和标记压缩法。标记清除法首先会对内存中存活的对象进行标记,标记结束后清除掉那些没有标记的对象。由于标记清除后会造成很多的内存碎片,不便于后面的内存分配。所以了解决内存碎片的问题引入了标记压缩法。
由于在进行垃圾回收的时候会暂停应用的逻辑,对于新生代方法由于内存小,每次停顿的时间不会太长,但对于老生代来说每次垃圾回收的时间长,停顿会造成很大的影响。 为了解决这个问题 V8 引入了增量标记的方法,将一次停顿进行的过程分为了多步,每次执行完一小步就让运行逻辑执行一会,就这样交替运行
💬 面试官追问
滚动时内存呈锯齿状涨了又落,最后都释放了,为什么还会卡?
能落下来说明能回收,但回收本身要花主线程时间。滚动回调里每帧都
map出一堆新数组、新对象,新生代很快就满,Scavenge频繁触发,每次停一下就是掉帧。热路径里尽量复用对象,别每次都新建。把文档对象标记成
closed,全局缓存里还存着它,能被回收吗?不能。
GC只认引用,不认你的业务字段,缓存还指着它它就是活的。要么cache.delete(id),要么一开始就用WeakMap以对象为键存附加数据,对象没人用了条目自动消失。为了少触发
GC,把所有临时对象都缓存起来复用,靠谱吗?多半适得其反。本来活不过一次新生代回收的对象被你一直留着,就会晋升到老生代,老生代回收更慢、停顿更长。对象池只适合那种高频、结构固定的场景,比如游戏里的粒子,普通业务别这么干。
两个对象互相引用,在现代浏览器里会泄漏吗?
不会,标记清除是从根出发找可达对象,两个对象抱团但没有外部引用,一样被判成垃圾。循环引用泄漏是引用计数时代的问题,典型是老
IE里JS对象和DOM节点互相引用。增量标记能保证动画完全不被
GC打断吗?不能保证。增量标记只是把一次长的标记拆成很多小步,跟业务代码交替跑,单次停顿短了但总工作量没少。能做的是降低垃圾产生量,而不是指望
GC零停顿。
# 20 内存泄露
⚡ 30 秒速记
- 本质:对象已经没用了,但还有一条引用链拽着它,
GC收不掉 - 高频来源:意外全局变量、没清的
setInterval/ 事件监听、闭包抓着大对象、删掉的DOM还被变量引用、无限增长的缓存 - 框架里最常见:
useEffect不写清理函数、Vue组件beforeUnmount里没解绑、第三方图表实例没dispose() - 排查:
Memory面板「操作前拍快照 → 反复进出页面 → 再拍」做Comparison,搜Detached看游离节点 - 判断标准:反复操作、手动点垃圾桶强制
GC后,内存基线还在一级级往上抬才算泄漏
内存泄漏就是东西已经不用了,但还有引用拽着它,垃圾回收没法收。 我遇到最多的是生命周期没收尾:组件挂了个 setInterval 或者 window 上的监听,卸载时没清,回调和它闭包里抓的数据就一直活着;还有弹窗节点从页面删了,但某个变量或缓存还指着它,整棵子树都留在堆里。排查我一般用 Memory 面板拍两次堆快照对比,看哪类对象只增不减,再顺着 Retainers 找是谁在引用它。另外注意 console.log 打印的对象在 DevTools 打开时也会被留住,测内存前要把它去掉。
- 意外的全局变量: 无法被回收
- 定时器: 未被正确关闭,导致所引用的外部变量无法被释放
- 事件监听: 没有正确销毁 (低版本浏览器可能出现)
- 闭包
- 第一种情况是我们由于使用未声明的变量,而意外的创建了一个全局变量,而使这个变量一直留在内存中无法被回收。
- 第二种情况是我们设置了setInterval定时器,而忘记取消它,如果循环函数有对外部变量的引用的话,那么这个变量会被一直留在内存中,而无法被回收。
- 第三种情况是我们获取一个DOM元素的引用,而后面这个元素被删除,由于我们一直保留了对这个元素的引用,所以它也无法被回收。
- 第四种情况是不合理的使用闭包,从而导致某些变量一直被留在内存当中。
dom引用:dom元素被删除时,内存中的引用未被正确清空- 控制台
console.log打印的东西
可用
chrome中的timeline进行内存标记,可视化查看内存的变化情况,找出异常点。
常见泄漏写法和改法
// 1. 意外全局变量:非严格模式下没声明直接赋值,挂到了 window 上
function log(res) {
  lastResponse = res // 永远可达
}
// 改:'use strict' 会直接报错,暴露问题;用局部变量或受控的缓存

// 2. 监听不解绑
function mount() {
  const onResize = () => chart.resize()
  window.addEventListener('resize', onResize)
  return () => window.removeEventListener('resize', onResize) // 卸载时调用
}

// 3. 游离 DOM:节点从页面删了,变量还引用着
const cache = { dialog: document.querySelector('#dialog') }
cache.dialog.remove()
// cache.dialog 还在,整棵子树都留在堆里;用完要 cache.dialog = null
排查步骤
- 打开
DevTools的Memory面板,先在空白状态拍一张Heap snapshot。 - 反复执行可疑操作,比如进出某个页面
10次,再拍一张。 - 第二张快照切到
Comparison视图,按# Delta排序,搜Detached看游离节点。 - 选中可疑对象,看下方的
Retainers,那条引用链上第一个你认识的变量名,通常就是罪魁祸首。
想看趋势可以用 Performance 面板勾上 Memory 录一段,旧资料里说的 Timeline 就是它以前的名字。
💬 面试官追问
弹窗关掉后节点已经不在页面上了,堆快照里还有整棵子树,为什么?
从文档里移除只是断了
DOM树那条引用,代码里的变量、缓存或者闭包还指着它就收不掉,快照里会显示成Detached HTMLDivElement。点开看Retainers,找到是哪个变量拽着它,置空或者从缓存删掉。行情组件每次进页面开一个
setInterval,切几次后旧回调还在跑,改哪?卸载时要
clearInterval。React里写成useEffect(() => { const t = setInterval(tick, 1000); return () => clearInterval(t) }, []),Vue就放到onBeforeUnmount。定时器不清,回调和它引用的数据永远可达。页面进出十次,
Performance面板里内存一路涨,怎么确认是泄漏?先点垃圾桶图标强制
GC,看基线是不是回到原来的位置,回不去才算泄漏,单个峰值说明不了问题。然后用Memory面板拍「进页面前」和「进出十次后」两张快照,选Comparison按# Delta排,涨了刚好十倍的那类对象基本就是它。团队想把闭包全改成全局函数来防泄漏,合理吗?
不合理,闭包本身不泄漏,泄漏的是「长寿的东西引用了闭包,闭包又抓着大数据」。改成全局函数反而把状态挂到了全局,活得更久。该做的是缩小闭包抓的范围,监听和定时器用完就解绑。
需要给
DOM节点挂一些附加数据,怎么存才不怕泄漏?用
WeakMap,const meta = new WeakMap(); meta.set(el, data)。键是弱引用,节点被删、没人再引用时条目会跟着被回收;换成普通Map或者对象缓存,节点就被你永远拽住了。
# 21 深浅拷贝
⚡ 30 秒速记
- 浅拷贝只复制第一层,嵌套对象还是同一个引用:
{...obj}、Object.assign、slice、concat、[...arr] - 深拷贝首选原生
structuredClone():支持循环引用、Date、RegExp、Map、Set,Chrome 98/Safari 15.4/Node 17起可用 structuredClone拷不了函数和DOM节点(直接抛错),也不保留原型,类实例会变成普通对象JSON.parse(JSON.stringify())坑多:丢undefined/ 函数 /Symbol、Date变字符串、NaN变null、循环引用直接抛错- 手写深拷贝的得分点:
WeakMap记录已拷贝对象处理循环引用,按类型分别处理数组 /Date/RegExp/Map/Set
浅拷贝只新建最外面一层,里面嵌套的对象还是同一份;深拷贝是每一层都复制一份新的。 比如 const b = {...a} 之后改 b.name 不影响 a,但改 b.address.city 两边一起变,因为 address 指向的是同一个对象。现在要深拷贝我直接用 structuredClone,循环引用、Date、Map 都能处理;JSON 那套只适合纯 JSON 数据。面试让手写的话,重点是两件事:用 WeakMap 存「原对象到副本」的映射防止循环引用无限递归,以及按类型创建对应的实例,别把数组拷成普通对象。
1. 浅拷贝的原理和实现
自己创建一个新的对象,来接受你要重新复制或引用的对象值。如果对象属性是基本的数据类型,复制的就是基本类型的值给新对象;但如果属性是引用数据类型,复制的就是内存中的地址,如果其中一个对象改变了这个内存中的地址,肯定会影响到另一个对象
方法一:object.assign
object.assign是 ES6 中object的一个方法,该方法可以用于 JS 对象的合并等多个用途,其中一个用途就是可以进行浅拷贝。该方法的第一个参数是拷贝的目标对象,后面的参数是拷贝的来源对象(也可以是多个来源)。
object.assign 的语法为:Object.assign(target, ...sources)
object.assign 的示例代码如下:
let target = {};
let source = { a: { b: 1 } };
Object.assign(target, source);
console.log(target); // { a: { b: 1 } };
但是使用 object.assign 方法有几点需要注意
- 它不会拷贝对象的继承属性;
- 它不会拷贝对象的不可枚举的属性;
- 可以拷贝
Symbol类型的属性。
let obj1 = { a:{ b:1 }, sym:Symbol(1)};
Object.defineProperty(obj1, 'innumerable' ,{
    value:'不可枚举属性',
    enumerable:false
});
let obj2 = {};
Object.assign(obj2,obj1)
obj1.a.b = 2;
console.log('obj1',obj1);
console.log('obj2',obj2);
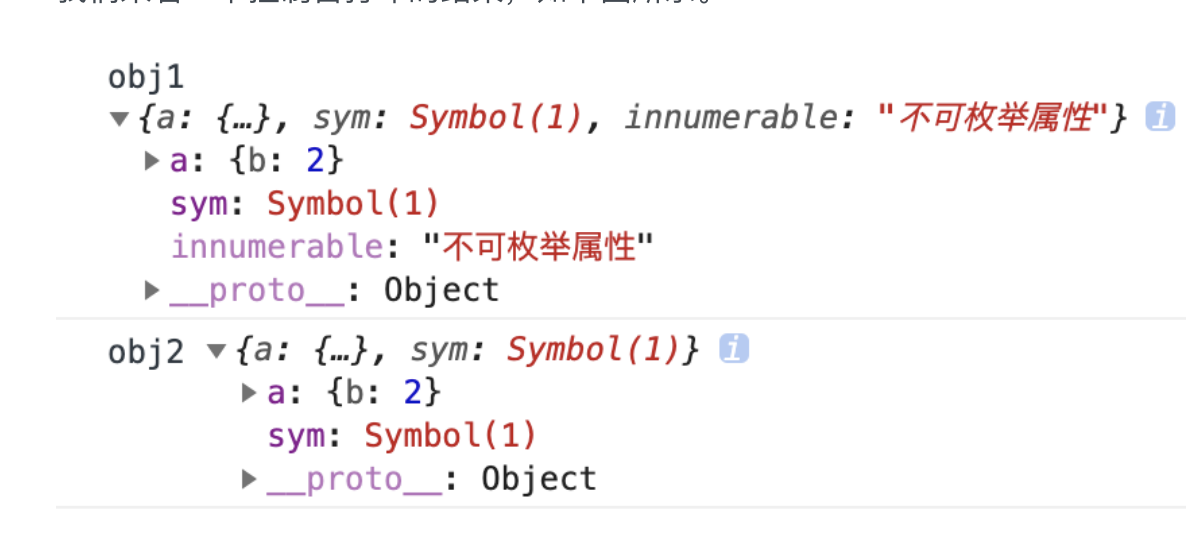
从上面的样例代码中可以看到,利用
object.assign也可以拷贝Symbol类型的对象,但是如果到了对象的第二层属性 obj1.a.b 这里的时候,前者值的改变也会影响后者的第二层属性的值,说明其中依旧存在着访问共同堆内存的问题,也就是说这种方法还不能进一步复制,而只是完成了浅拷贝的功能
方法二:扩展运算符方式
- 我们也可以利用 JS 的扩展运算符,在构造对象的同时完成浅拷贝的功能。
- 扩展运算符的语法为:
let cloneObj = { ...obj };
/* 对象的拷贝 */
let obj = {a:1,b:{c:1}}
let obj2 = {...obj}
obj.a = 2
console.log(obj)  //{a:2,b:{c:1}} console.log(obj2); //{a:1,b:{c:1}}
obj.b.c = 2
console.log(obj)  //{a:2,b:{c:2}} console.log(obj2); //{a:1,b:{c:2}}
/* 数组的拷贝 */
let arr = [1, 2, 3];
let newArr = [...arr]; //跟arr.slice()是一样的效果
扩展运算符 和
object.assign有同样的缺陷,也就是实现的浅拷贝的功能差不多,但是如果属性都是基本类型的值,使用扩展运算符进行浅拷贝会更加方便
方法三:concat 拷贝数组
数组的
concat方法其实也是浅拷贝,所以连接一个含有引用类型的数组时,需要注意修改原数组中的元素的属性,因为它会影响拷贝之后连接的数组。不过concat只能用于数组的浅拷贝,使用场景比较局限。代码如下所示。
let arr = [1, 2, 3];
let newArr = arr.concat();
newArr[1] = 100;
console.log(arr);  // [ 1, 2, 3 ]
console.log(newArr); // [ 1, 100, 3 ]
方法四:slice 拷贝数组
slice方法也比较有局限性,因为它仅仅针对数组类型。slice方法会返回一个新的数组对象,这一对象由该方法的前两个参数来决定原数组截取的开始和结束时间,是不会影响和改变原始数组的。
slice 的语法为:arr.slice(begin, end);
let arr = [1, 2, {val: 4}];
let newArr = arr.slice();
newArr[2].val = 1000;
console.log(arr);  //[ 1, 2, { val: 1000 } ]
从上面的代码中可以看出,这就是
浅拷贝的限制所在了——它只能拷贝一层对象。如果存在对象的嵌套,那么浅拷贝将无能为力。因此深拷贝就是为了解决这个问题而生的,它能解决多层对象嵌套问题,彻底实现拷贝
手工实现一个浅拷贝
根据以上对浅拷贝的理解,如果让你自己实现一个浅拷贝,大致的思路分为两点:
- 对基础类型做一个最基本的一个拷贝;
- 对引用类型开辟一个新的存储,并且拷贝一层对象属性。
const shallowClone = (target) => {
  if (typeof target === 'object' && target !== null) {
    const cloneTarget = Array.isArray(target) ? []: {};
    for (let prop in target) {
      if (target.hasOwnProperty(prop)) {
          cloneTarget[prop] = target[prop];
      }
    }
    return cloneTarget;
  } else {
    return target;
  }
}
利用类型判断,针对引用类型的对象进行 for 循环遍历对象属性赋值给目标对象的属性,基本就可以手工实现一个浅拷贝的代码了
2. 深拷贝的原理和实现
浅拷贝只是创建了一个新的对象,复制了原有对象的基本类型的值,而引用数据类型只拷贝了一层属性,再深层的还是无法进行拷贝。深拷贝则不同,对于复杂引用数据类型,其在堆内存中完全开辟了一块内存地址,并将原有的对象完全复制过来存放。
这两个对象是相互独立、不受影响的,彻底实现了内存上的分离。总的来说,深拷贝的原理可以总结如下:
将一个对象从内存中完整地拷贝出来一份给目标对象,并从堆内存中开辟一个全新的空间存放新对象,且新对象的修改并不会改变原对象,二者实现真正的分离。
方法一:乞丐版(JSON.stringify)
JSON.stringify()是目前开发过程中最简单的深拷贝方法,其实就是把一个对象序列化成为JSON的字符串,并将对象里面的内容转换成字符串,最后再用JSON.parse()的方法将JSON字符串生成一个新的对象
let a = {
    age: 1,
    jobs: {
        first: 'FE'
    }
}
let b = JSON.parse(JSON.stringify(a))
a.jobs.first = 'native'
console.log(b.jobs.first) // FE
但是该方法也是有局限性的:
- 会忽略
undefined - 会忽略
symbol - 不能序列化函数
- 无法拷贝不可枚举的属性
- 无法拷贝对象的原型链
- 拷贝
RegExp引用类型会变成空对象 - 拷贝
Date引用类型会变成字符串 - 对象中含有
NaN、Infinity以及-Infinity,JSON序列化的结果会变成null - 不能解决循环引用的对象,即对象成环 (
obj[key] = obj)。
function Obj() {
  this.func = function () { alert(1) };
  this.obj = {a:1};
  this.arr = [1,2,3];
  this.und = undefined;
  this.reg = /123/;
  this.date = new Date(0);
  this.NaN = NaN;
  this.infinity = Infinity;
  this.sym = Symbol(1);
}
let obj1 = new Obj();
Object.defineProperty(obj1,'innumerable',{
  enumerable:false,
  value:'innumerable'
});
console.log('obj1',obj1);
let str = JSON.stringify(obj1);
let obj2 = JSON.parse(str);
console.log('obj2',obj2);
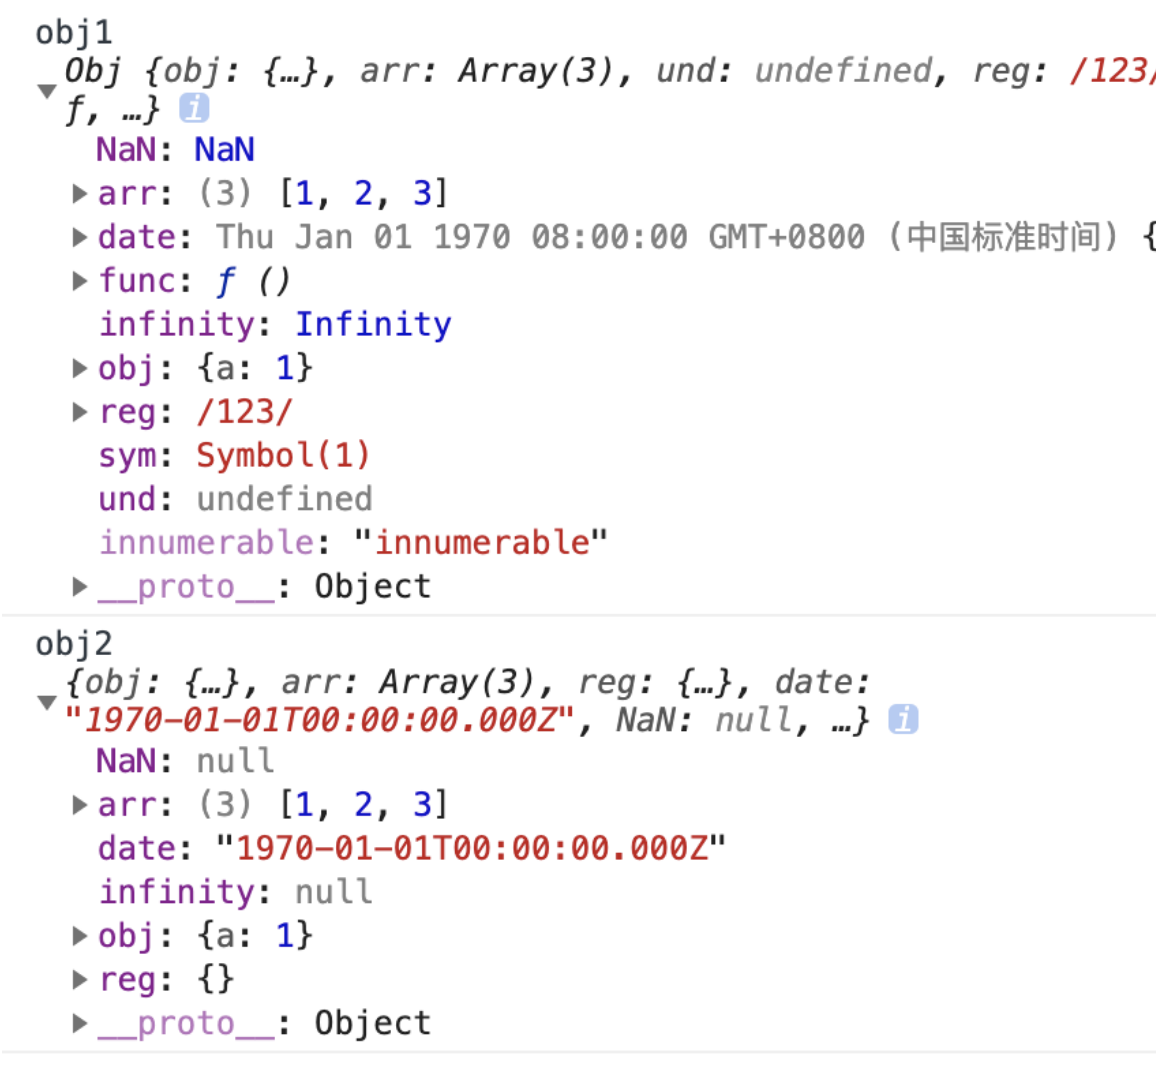
使用
JSON.stringify方法实现深拷贝对象,虽然到目前为止还有很多无法实现的功能,但是这种方法足以满足日常的开发需求,并且是最简单和快捷的。而对于其他的也要实现深拷贝的,比较麻烦的属性对应的数据类型,JSON.stringify暂时还是无法满足的,那么就需要下面的几种方法了
方法二:基础版(手写递归实现)
下面是一个实现 deepClone 函数封装的例子,通过
for in遍历传入参数的属性值,如果值是引用类型则再次递归调用该函数,如果是基础数据类型就直接复制
let obj1 = {
  a:{
    b:1
  }
}
function deepClone(obj) {
  let cloneObj = {}
  for(let key in obj) {                 //遍历
    if(typeof obj[key] ==='object') {
      cloneObj[key] = deepClone(obj[key])  //是对象就再次调用该函数递归
    } else {
      cloneObj[key] = obj[key]  //基本类型的话直接复制值
    }
  }
  return cloneObj
}
let obj2 = deepClone(obj1);
obj1.a.b = 2;
console.log(obj2);   //  {a:{b:1}}
虽然利用递归能实现一个深拷贝,但是同上面的 JSON.stringify 一样,还是有一些问题没有完全解决,例如:
- 这个深拷贝函数并不能复制不可枚举的属性以及
Symbol类型; - 这种方法
只是针对普通的引用类型的值做递归复制,而对于Array、Date、RegExp、Error、Function这样的引用类型并不能正确地拷贝; - 对象的属性里面成环,即
循环引用没有解决。
这种基础版本的写法也比较简单,可以应对大部分的应用情况。但是你在面试的过程中,如果只能写出这样的一个有缺陷的深拷贝方法,有可能不会通过。
所以为了“拯救”这些缺陷,下面我带你一起看看改进的版本,以便于你可以在面试种呈现出更好的深拷贝方法,赢得面试官的青睐。
方法三:改进版(改进后递归实现)
针对上面几个待解决问题,我先通过四点相关的理论告诉你分别应该怎么做。
- 针对能够遍历对象的不可枚举属性以及
Symbol类型,我们可以使用Reflect.ownKeys方法; - 当参数为
Date、RegExp类型,则直接生成一个新的实例返回; - 利用
Object的getOwnPropertyDescriptors方法可以获得对象的所有属性,以及对应的特性,顺便结合Object.create方法创建一个新对象,并继承传入原对象的原型链; - 利用
WeakMap类型作为Hash表,因为WeakMap是弱引用类型,可以有效防止内存泄漏(你可以关注一下Map和weakMap的关键区别,这里要用weakMap),作为检测循环引用很有帮助,如果存在循环,则引用直接返回WeakMap存储的值
如果你在考虑到循环引用的问题之后,还能用 WeakMap 来很好地解决,并且向面试官解释这样做的目的,那么你所展示的代码,以及你对问题思考的全面性,在面试官眼中应该算是合格的了
实现深拷贝
const isComplexDataType = obj => (typeof obj === 'object' || typeof obj === 'function') && (obj !== null)

const deepClone = function (obj, hash = new WeakMap()) {
  if (obj.constructor === Date) {
    return new Date(obj)       // 日期对象直接返回一个新的日期对象
  }

  if (obj.constructor === RegExp){
    return new RegExp(obj)     //正则对象直接返回一个新的正则对象
  }

  //如果循环引用了就用 weakMap 来解决
  if (hash.has(obj)) {
    return hash.get(obj)
  }
  let allDesc = Object.getOwnPropertyDescriptors(obj)

  //遍历传入参数所有键的特性
  let cloneObj = Object.create(Object.getPrototypeOf(obj), allDesc)

  // 把cloneObj原型复制到obj上
  hash.set(obj, cloneObj)

  for (let key of Reflect.ownKeys(obj)) {
    cloneObj[key] = (isComplexDataType(obj[key]) && typeof obj[key] !== 'function') ? deepClone(obj[key], hash) : obj[key]
  }
  return cloneObj
}
// 下面是验证代码
let obj = {
  num: 0,
  str: '',
  boolean: true,
  unf: undefined,
  nul: null,
  obj: { name: '我是一个对象', id: 1 },
  arr: [0, 1, 2],
  func: function () { console.log('我是一个函数') },
  date: new Date(0),
  reg: new RegExp('/我是一个正则/ig'),
  [Symbol('1')]: 1,
};
Object.defineProperty(obj, 'innumerable', {
  enumerable: false, value: '不可枚举属性' }
);
obj = Object.create(obj, Object.getOwnPropertyDescriptors(obj))
obj.loop = obj    // 设置loop成循环引用的属性
let cloneObj = deepClone(obj)
cloneObj.arr.push(4)
console.log('obj', obj)
console.log('cloneObj', cloneObj)
我们看一下结果,cloneObj 在 obj 的基础上进行了一次深拷贝,cloneObj 里的 arr 数组进行了修改,并未影响到 obj.arr 的变化,如下图所示
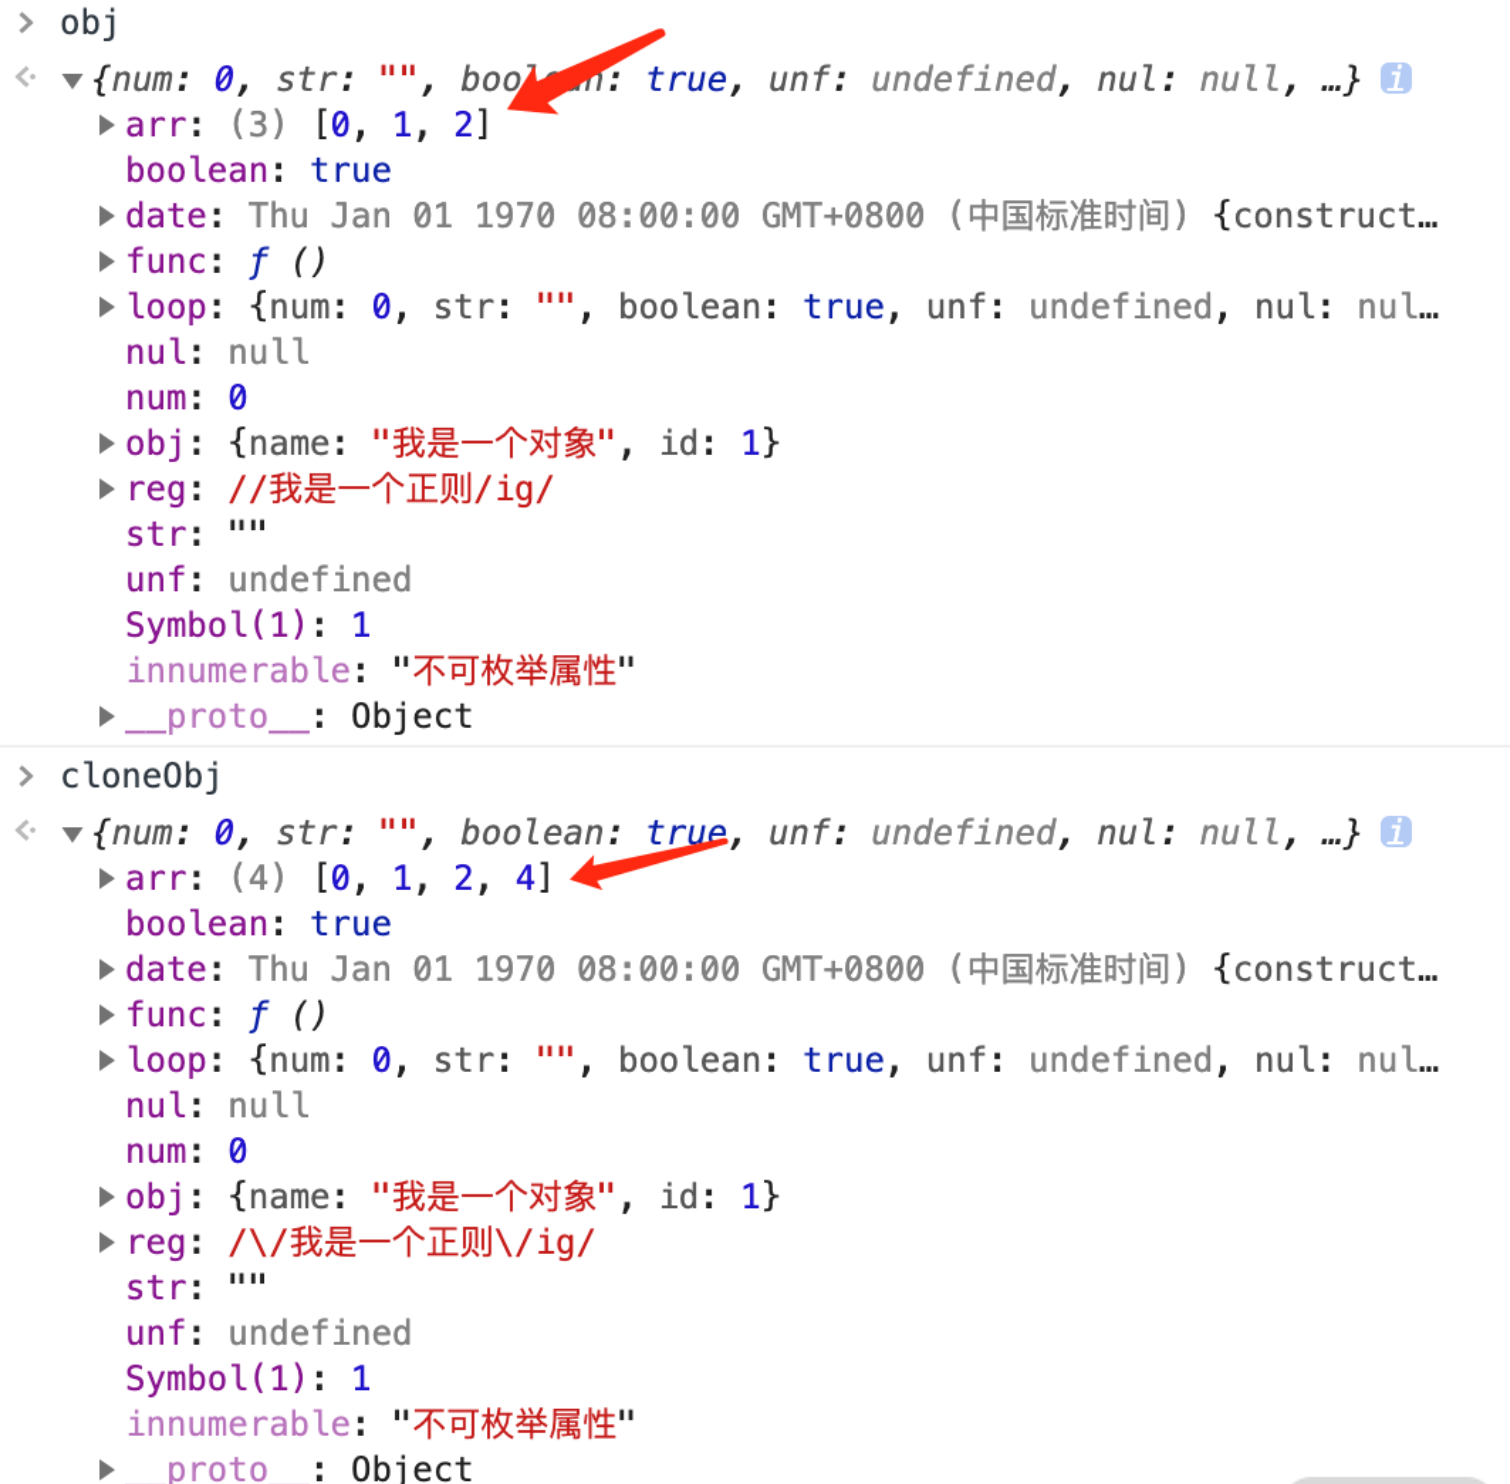
💬 面试官追问
{...state}之后改副本的address.city,原表单也变了,为什么?展开运算符只复制第一层,
address拷过去的是引用,两边指向同一个对象。React里更新嵌套状态要逐层展开:{ ...state, address: { ...state.address, city } },或者用immer省事。日志快照里有
Date和循环引用,用JSON.parse(JSON.stringify(data))行不行?不行,遇到循环引用直接抛
TypeError: Converting circular structure to JSON,Date也会变成字符串。换structuredClone(data),这两种情况它都能处理。手写的深拷贝遇到循环引用就栈溢出,怎么改?
递归前先查一个
WeakMap:if (map.has(obj)) return map.get(obj),没有就创建副本并map.set(obj, copy),然后再递归子属性。这样第二次遇到同一个对象时直接返回已有副本,环就闭上了。structuredClone拷一个class User的实例,方法怎么没了?它只拷数据,不保留原型,拷出来是普通对象,
user.getName()会报不是函数。要保留原型得自己来:Object.create(Object.getPrototypeOf(obj))再复制属性,或者给类写个clone()方法。对象里有函数属性的话,structuredClone会直接抛DataCloneError。接口数据是不是每次拿到都深拷贝一份更保险?
没必要。深拷贝有成本,大对象拷一次可能就是几十毫秒。只有你确实要改嵌套数据、又不想影响源数据时才拷,而且只拷要改的那一层;纯展示的数据直接用。
# 22 节流与防抖
⚡ 30 秒速记
- 防抖:「等你停下来再干」,每次触发都重置计时器,连续触发期间一次不执行
- 节流:「隔一段时间最多干一次」,持续触发期间匀速执行
- 场景:搜索联想、输入校验、
resize结束后重算用防抖;滚动监听、拖拽、mousemove用节流 - 手写得分点:返回普通函数并用
apply透传this和参数、防抖支持immediate、挂cancel()方法 - 节流两种写法:时间戳版首次立即执行但末次可能丢,定时器版首次延迟但末次保留;
lodash默认首尾都执行
防抖是等用户停手一段时间再执行,节流是不管触发多频繁,固定间隔最多执行一次。 打个比方,防抖像电梯门,有人进来就重新计时,没人进了才关门;节流像地铁发车,到点就走,不等人。所以搜索框联想用防抖,用户打完字才发一次请求;滚动加载、拖拽这类要持续反馈的用节流。手写时外层返回的必须是普通函数,里面用 fn.apply(this, args) 把调用时的 this 和参数带过去,另外最好挂一个 cancel,组件卸载时能把没执行的那次取消掉。
- 函数防抖 是指在事件被触发 n 秒后再执行回调,如果在这 n 秒内事件又被触发,则重新计时。这可以使用在一些点击请求的事件上,避免因为用户的多次点击向后端发送多次请求。
- 函数节流 是指规定一个单位时间,在这个单位时间内,只能有一次触发事件的回调函数执行,如果在同一个单位时间内某事件被触发多次,只有一次能生效。节流可以使用在 scroll 函数的事件监听上,通过事件节流来降低事件调用的频率。
// 函数防抖的实现
function debounce(fn, wait) {
  var timer = null;

  return function() {
    var context = this,
      args = arguments;

    // 如果此时存在定时器的话,则取消之前的定时器重新记时
    if (timer) {
      clearTimeout(timer);
      timer = null;
    }

    // 设置定时器,使事件间隔指定事件后执行
    timer = setTimeout(() => {
      fn.apply(context, args);
    }, wait);
  };
}

// 函数节流的实现;
function throttle(fn, delay) {
  var preTime = Date.now();

  return function() {
    var context = this,
      args = arguments,
      nowTime = Date.now();

    // 如果两次时间间隔超过了指定时间,则执行函数。
    if (nowTime - preTime >= delay) {
      preTime = Date.now();
      return fn.apply(context, args);
    }
  };
}
💬 面试官追问
搜索框用了
300ms节流,打一个长单词还是发了好几次请求,该怎么改?这里要的是「停下来只查一次」,应该用防抖,节流在持续输入时会按间隔放行。另外请求本身也要处理竞态:用
AbortController取消上一个,或者只认最后一次请求的结果,否则慢请求返回晚了会把新结果覆盖掉。吸顶判断改成防抖后,滚动过程中一直不更新,为什么?
防抖在持续滚动时会不停重新计时,只有停下来才执行一次,滚动过程中自然没反应。这种要持续反馈的换节流。其实吸顶直接用
position: sticky就行,根本不用监听滚动。支付按钮加了防抖,还能被重复提交吗?
能。防抖只合并了一段时间内的点击,请求还没回来、用户隔了
1秒再点照样发出去。按钮要在请求期间disabled,后端还要做幂等,比如用订单号去重,前端防抖只是第一道。组件卸载后防抖里的定时器还触发了,报了个访问已销毁状态的错,怎么修?
卸载前最后一次输入留了一个待执行的
setTimeout,移除监听不会取消它。封装里暴露cancel()(内部clearTimeout(timer)),在useEffect的清理函数或onBeforeUnmount里调用。拖拽时要实时更新坐标,松手后还要保存位置,用哪个?
两个都用。拖动过程用节流更新坐标,比如
16ms一次对齐帧率,或者直接放进requestAnimationFrame;保存放在pointerup里做,或者再套一层防抖,别在拖动过程中频繁请求接口。
# 23 Proxy代理
⚡ 30 秒速记
Proxy给整个对象套一层拦截,handler里有13种陷阱:get/set/has/deleteProperty/ownKeys/apply/construct等- 比
Object.defineProperty强在:能拦截属性新增和删除、数组下标和length、in和Object.keys,还能懒代理(访问到才递归) - 陷阱里配
Reflect用:Reflect.get(target, key, receiver)保证getter里的this指向代理 - 只有通过代理对象的操作才会被拦截,直接改原
target绕过一切 Vue 3响应式就是靠它换掉了Vue 2的defineProperty;局限是代理不了原始值(所以有ref),也没法完整polyfill
Proxy 就是给对象套一层代理,外面对它的读、写、删除、in 判断这些操作,都会先经过你定义的 handler。 它跟 Object.defineProperty 最大的区别是拦的是整个对象的操作,而不是某个已有属性,所以新增属性、删除属性、改数组下标都能感知到,这正是 Vue 3 用它替换 Vue 2 响应式方案的原因。写陷阱时我习惯配 Reflect,比如 set 里 return Reflect.set(target, key, value, receiver),默认行为和 this 指向都不会乱。还有一点要记住:只有走代理对象的操作才会被拦截,原对象被人直接改了你是不知道的。
proxy在目标对象的外层搭建了一层拦截,外界对目标对象的某些操作,必须通过这层拦截
var proxy = new Proxy(target, handler);
new Proxy()表示生成一个Proxy实例,target参数表示所要拦截的目标对象,handler参数也是一个对象,用来定制拦截行为
var target = {
   name: 'poetries'
 };
 var logHandler = {
   get: function(target, key) {
     console.log(`${key} 被读取`);
     return target[key];
   },
   set: function(target, key, value) {
     console.log(`${key} 被设置为 ${value}`);
     target[key] = value;
   }
 }
 var targetWithLog = new Proxy(target, logHandler);

 targetWithLog.name; // 控制台输出:name 被读取
 targetWithLog.name = 'others'; // 控制台输出:name 被设置为 others

 console.log(target.name); // 控制台输出: others
targetWithLog读取属性的值时,实际上执行的是logHandler.get:在控制台输出信息,并且读取被代理对象target的属性。- 在
targetWithLog设置属性值时,实际上执行的是logHandler.set:在控制台输出信息,并且设置被代理对象target的属性的值
// 由于拦截函数总是返回35,所以访问任何属性都得到35
var proxy = new Proxy({}, {
  get: function(target, property) {
    return 35;
  }
});

proxy.time // 35
proxy.name // 35
proxy.title // 35
Proxy 实例也可以作为其他对象的原型对象
var proxy = new Proxy({}, {
  get: function(target, property) {
    return 35;
  }
});

let obj = Object.create(proxy);
obj.time // 35
proxy对象是obj对象的原型,obj对象本身并没有time属性,所以根据原型链,会在proxy对象上读取该属性,导致被拦截
Proxy的作用
对于代理模式
Proxy的作用主要体现在三个方面
- 拦截和监视外部对对象的访问
- 降低函数或类的复杂度
- 在复杂操作前对操作进行校验或对所需资源进行管理
Proxy所能代理的范围--handler
实际上 handler 本身就是ES6所新设计的一个对象.它的作用就是用来 自定义代理对象的各种可代理操作 。它本身一共有13中方法,每种方法都可以代理一种操作.其13种方法如下
// 在读取代理对象的原型时触发该操作,比如在执行 Object.getPrototypeOf(proxy) 时。
handler.getPrototypeOf()

// 在设置代理对象的原型时触发该操作,比如在执行 Object.setPrototypeOf(proxy, null) 时。
handler.setPrototypeOf()


// 在判断一个代理对象是否是可扩展时触发该操作,比如在执行 Object.isExtensible(proxy) 时。
handler.isExtensible()


// 在让一个代理对象不可扩展时触发该操作,比如在执行 Object.preventExtensions(proxy) 时。
handler.preventExtensions()

// 在获取代理对象某个属性的属性描述时触发该操作,比如在执行 Object.getOwnPropertyDescriptor(proxy, "foo") 时。
handler.getOwnPropertyDescriptor()


// 在定义代理对象某个属性时的属性描述时触发该操作,比如在执行 Object.defineProperty(proxy, "foo", {}) 时。
andler.defineProperty()


// 在判断代理对象是否拥有某个属性时触发该操作,比如在执行 "foo" in proxy 时。
handler.has()

// 在读取代理对象的某个属性时触发该操作,比如在执行 proxy.foo 时。
handler.get()


// 在给代理对象的某个属性赋值时触发该操作,比如在执行 proxy.foo = 1 时。
handler.set()

// 在删除代理对象的某个属性时触发该操作,比如在执行 delete proxy.foo 时。
handler.deleteProperty()

// 在获取代理对象的所有属性键时触发该操作,比如在执行 Object.getOwnPropertyNames(proxy) 时。
handler.ownKeys()

// 在调用一个目标对象为函数的代理对象时触发该操作,比如在执行 proxy() 时。
handler.apply()


// 在给一个目标对象为构造函数的代理对象构造实例时触发该操作,比如在执行new proxy() 时。
handler.construct()
为何Proxy不能被Polyfill
- 如class可以用
function模拟;promise可以用callback模拟 - 但是proxy不能用
Object.defineProperty模拟
目前谷歌的polyfill只能实现部分的功能,如get、set https://github.com/GoogleChrome/proxy-polyfill
// commonJS require
const proxyPolyfill = require('proxy-polyfill/src/proxy')();

// Your environment may also support transparent rewriting of commonJS to ES6:
import ProxyPolyfillBuilder from 'proxy-polyfill/src/proxy';
const proxyPolyfill = ProxyPolyfillBuilder();

// Then use...
const myProxy = new proxyPolyfill(...);
💬 面试官追问
代理套好了,同事直接改原对象
target.role = 'admin',为什么没触发set?拦截只发生在代理对象上,原对象就是个普通对象,改它不经过
handler。要做审计就别把原对象暴露出去,只把proxy交给业务代码。Vue 3里同理,改toRaw()拿到的原对象不会触发更新。Vue 2里this.list[0] = x视图不更新,Vue 3为什么就可以?Vue 2用defineProperty给已有属性装getter/setter,数组下标和新增属性它感知不到,只能用this.$set或者被改写过的push/splice。Vue 3的Proxy拦的是整个对象,下标赋值、新增、删除都会走set/deleteProperty。get陷阱里直接return target[key],有什么问题?对象上有
getter时,getter里的this会指向原对象而不是代理,里面再访问别的属性就不会被追踪。写成Reflect.get(target, key, receiver),this才是代理本身,Vue 3源码就是这么写的。要监控
in判断和Object.keys,只写get/set够吗?不够,每种操作对应自己的陷阱:
in走has,Object.keys和for...in走ownKeys,delete走deleteProperty。没实现的陷阱会直接落到原对象上,不会报错,所以容易以为「拦住了」。项目要支持不支持
Proxy的老环境,能用defineProperty写个完整垫片吗?写不出完整的。
defineProperty只能给已知属性装存取器,删除、新增、in、枚举这些它拦不到,现有的polyfill也只覆盖get/set这类有限场景。真要兼容就降级方案,Vue 3当年也是直接放弃了IE11。
# 24 Ajax
⚡ 30 秒速记
Ajax= 用JS发异步HTTP请求,拿到数据后局部更新页面,不整页刷新XHR四步:new XMLHttpRequest()→open→ 监听onreadystatechange(readyState === 4再判status)→send- 现在主答
fetch:基于Promise,配AbortController可取消,AbortSignal.timeout(5000)做超时 fetch的坑:404/500不会reject,要自己判断res.ok;跨域默认不带cookie,要credentials: 'include';没有上传进度- 要上传进度就还得用
XHR的upload.onprogress,axios在浏览器端默认也是基于XHR
Ajax 就是用 JavaScript 在后台发 HTTP 请求,拿到数据后只更新页面的一部分,用户不用整页刷新。 原生写法是 XMLHttpRequest:open 配置地址,onreadystatechange 里等 readyState 变成 4,再看 status 是不是 2xx,最后 send。面试手写一般会要求封装成 Promise,成功 resolve、失败和网络错误都 reject。不过现在新代码我基本用 fetch,要注意它只有网络断了才 reject,500 也算成功返回,得自己判断 res.ok。
它是一种异步通信的方法,通过直接由 js 脚本向服务器发起 http 通信,然后根据服务器返回的数据,更新网页的相应部分,而不用刷新整个页面的一种方法。
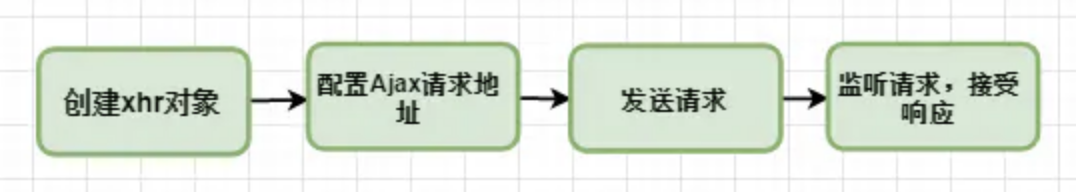
面试手写(原生):
//1:创建Ajax对象
var xhr = window.XMLHttpRequest?new XMLHttpRequest():new ActiveXObject('Microsoft.XMLHTTP');// 兼容IE6及以下版本
//2:配置 Ajax请求地址
xhr.open('get','index.xml',true);
//3:发送请求
xhr.send(null); // 严谨写法
//4:监听请求,接受响应
xhr.onreadysatechange=function(){
     if(xhr.readySate==4&&xhr.status==200 || xhr.status==304 )
          console.log(xhr.responsetXML)
}
jQuery写法
$.ajax({
  type:'post',
  url:'',
  async:ture,//async 异步  sync  同步
  data:data,//针对post请求
  dataType:'jsonp',
  success:function (msg) {

  },
  error:function (error) {

  }
})
promise 封装实现:
// promise 封装实现:

function getJSON(url) {
  // 创建一个 promise 对象
  let promise = new Promise(function(resolve, reject) {
    let xhr = new XMLHttpRequest();

    // 新建一个 http 请求
    xhr.open("GET", url, true);

    // 设置状态的监听函数
    xhr.onreadystatechange = function() {
      if (this.readyState !== 4) return;

      // 当请求成功或失败时,改变 promise 的状态
      if (this.status === 200) {
        resolve(this.response);
      } else {
        reject(new Error(this.statusText));
      }
    };

    // 设置错误监听函数
    xhr.onerror = function() {
      reject(new Error(this.statusText));
    };

    // 设置响应的数据类型
    xhr.responseType = "json";

    // 设置请求头信息
    xhr.setRequestHeader("Accept", "application/json");

    // 发送 http 请求
    xhr.send(null);
  });

  return promise;
}
💬 面试官追问
原生
XHR的回调里写xhr.readyState == 4 && xhr.status == 200 || xhr.status == 304,有什么问题?&&优先级比||高,readyState还没到4时只要status是304就会进来。要加括号:readyState === 4 && (status === 200 || status === 304),更稳的是判status >= 200 && status < 300。fetch请求返回了500,catch里却什么都没捕到,为什么?fetch只有网络层失败(断网、跨域被拦、请求被取消)才reject,拿到任何HTTP响应都算成功。要在then里补一句:if (!res.ok) throw new Error(res.status),一般封装在统一的请求函数里。接口用了协商缓存,
XHR里会拿到304吗?一般拿不到。浏览器自己发的条件请求收到
304后,会用本地缓存拼出响应,XHR看到的还是200。只有你手动设置了If-None-Match这类请求头,才会真看到304,这时响应体是空的,业务要自己处理。大文件上传要显示进度条,用
fetch还是XHR?用
XHR,监听xhr.upload.onprogress,拿e.loaded / e.total算百分比。fetch到现在也没有通用的上传进度事件,下载进度倒是可以读res.body的流自己算。请求要
5秒超时、切页面时还要取消,怎么写?fetch(url, { signal })。只要超时就用AbortSignal.timeout(5000);两个都要可以用AbortSignal.any([controller.signal, AbortSignal.timeout(5000)]),离开页面时controller.abort()。XHR对应的是xhr.timeout和xhr.abort()。
# 25 深入数组
⚡ 30 秒速记
- 先分清改原数组(
push/pop/shift/unshift/splice/sort/reverse/fill)和返回新数组(map/filter/slice/concat/flat) ES2023的不可变版本:toSorted/toReversed/toSpliced/with,专治sort改原数组sort()不传比较函数按字符串排:[1, 10, 2].sort()还是[1, 10, 2],数字要写(a, b) => a - bArray(3)是3个空位,Array.of(3)才是[3];类数组转数组用Array.from或[...nodeList]- 判断数组用
Array.isArray,instanceof Array跨iframe会失效;能中断的遍历是for/for...of/some/every,forEach不行
数组方法我一般按两个问题记:它改不改原数组,它返回什么。 push、splice、sort 会直接改原数组,map、filter、slice 返回新数组。最容易出事的是 sort,它改完原数组还返回同一个引用,const sorted = list.sort() 之后 list 也被排了,现在可以用 ES2023 的 toSorted()。另外 sort 默认按字符串比较,[1, 10, 2] 排完顺序不变,数字一定要传比较函数。类数组比如 arguments、NodeList,用 Array.from 转成真数组再用数组方法。
一、梳理数组 API
1. Array.of
Array.of用于将参数依次转化为数组中的一项,然后返回这个新数组,而不管这个参数是数字还是其他。它基本上与 Array 构造器功能一致,唯一的区别就在单个数字参数的处理上
Array.of(8.0); // [8]
Array(8.0); // [empty × 8]
Array.of(8.0, 5); // [8, 5]
Array(8.0, 5); // [8, 5]
Array.of('8'); // ["8"]
Array('8'); // ["8"]
2. Array.from
从语法上看,Array.from 拥有 3 个参数:
- 类似数组的对象,必选;
- 加工函数,新生成的数组会经过该函数的加工再返回;
this作用域,表示加工函数执行时this的值。
这三个参数里面第一个参数是必选的,后两个参数都是可选的。我们通过一段代码来看看它的用法。
var obj = {0: 'a', 1: 'b', 2:'c', length: 3};
Array.from(obj, function(value, index){
  console.log(value, index, this, arguments.length);
  return value.repeat(3);   //必须指定返回值,否则返回 undefined
}, obj);

// return 的 value 重复了三遍,最后返回的数组为 ["aaa","bbb","ccc"]


// 如果这里不指定 this 的话,加工函数完全可以是一个箭头函数。上述代码可以简写为如下形式。
Array.from(obj, (value) => value.repeat(3));
//  控制台返回 (3) ["aaa", "bbb", "ccc"]
除了上述
obj对象以外,拥有迭代器的对象还包括String、Set、Map等,Array.from统统可以处理,请看下面的代码。
// String
Array.from('abc');         // ["a", "b", "c"]
// Set
Array.from(new Set(['abc', 'def'])); // ["abc", "def"]
// Map
Array.from(new Map([[1, 'ab'], [2, 'de']]));
// [[1, 'ab'], [2, 'de']]
3. Array 的判断
在 ES5 提供该方法之前,我们至少有如下 5 种方式去判断一个变量是否为数组。
var a = [];
// 1.基于instanceof
a instanceof Array;
// 2.基于constructor
a.constructor === Array;
// 3.基于Object.prototype.isPrototypeOf
Array.prototype.isPrototypeOf(a);
// 4.基于getPrototypeOf
Object.getPrototypeOf(a) === Array.prototype;
// 5.基于Object.prototype.toString
Object.prototype.toString.apply(a) === '[object Array]';
ES6 之后新增了一个
Array.isArray方法,能直接判断数据类型是否为数组,但是如果 isArray 不存在,那么Array.isArray的 polyfill 通常可以这样写:
if (!Array.isArray){
  Array.isArray = function(arg){
    return Object.prototype.toString.call(arg) === '[object Array]';
  };
}
4. 改变自身的方法
基于 ES6,会改变自身值的方法一共有
9个,分别为pop、push、reverse、shift、sort、splice、unshift,以及两个 ES6 新增的方法 copyWithin 和 fill
// pop方法
var array = ["cat", "dog", "cow", "chicken", "mouse"];
var item = array.pop();
console.log(array); // ["cat", "dog", "cow", "chicken"]
console.log(item); // mouse
// push方法
var array = ["football", "basketball",  "badminton"];
var i = array.push("golfball");
console.log(array);
// ["football", "basketball", "badminton", "golfball"]
console.log(i); // 4
// reverse方法
var array = [1,2,3,4,5];
var array2 = array.reverse();
console.log(array); // [5,4,3,2,1]
console.log(array2===array); // true
// shift方法
var array = [1,2,3,4,5];
var item = array.shift();
console.log(array); // [2,3,4,5]
console.log(item); // 1
// unshift方法
var array = ["red", "green", "blue"];
var length = array.unshift("yellow");
console.log(array); // ["yellow", "red", "green", "blue"]
console.log(length); // 4
// sort方法
var array = ["apple","Boy","Cat","dog"];
var array2 = array.sort();
console.log(array); // ["Boy", "Cat", "apple", "dog"]
console.log(array2 == array); // true
// splice方法
var array = ["apple","boy"];
var splices = array.splice(1,1);
console.log(array); // ["apple"]
console.log(splices); // ["boy"]
// copyWithin方法
var array = [1,2,3,4,5];
var array2 = array.copyWithin(0,3);
console.log(array===array2,array2);  // true [4, 5, 3, 4, 5]
// fill方法
var array = [1,2,3,4,5];
var array2 = array.fill(10,0,3);
console.log(array===array2,array2);
// true [10, 10, 10, 4, 5], 可见数组区间[0,3]的元素全部替换为10
5. 不改变自身的方法
基于 ES7,不会改变自身的方法也有 9 个,分别为 concat、join、slice、toString、toLocaleString、indexOf、lastIndexOf、未形成标准的 toSource,以及 ES7 新增的方法 includes。
// concat方法
var array = [1, 2, 3];
var array2 = array.concat(4,[5,6],[7,8,9]);
console.log(array2); // [1, 2, 3, 4, 5, 6, 7, 8, 9]
console.log(array); // [1, 2, 3], 可见原数组并未被修改
// join方法
var array = ['We', 'are', 'Chinese'];
console.log(array.join()); // "We,are,Chinese"
console.log(array.join('+')); // "We+are+Chinese"
// slice方法
var array = ["one", "two", "three","four", "five"];
console.log(array.slice()); // ["one", "two", "three","four", "five"]
console.log(array.slice(2,3)); // ["three"]
// toString方法
var array = ['Jan', 'Feb', 'Mar', 'Apr'];
var str = array.toString();
console.log(str); // Jan,Feb,Mar,Apr
// tolocalString方法
var array= [{name:'zz'}, 123, "abc", new Date()];
var str = array.toLocaleString();
console.log(str); // [object Object],123,abc,2016/1/5 下午1:06:23
// indexOf方法
var array = ['abc', 'def', 'ghi','123'];
console.log(array.indexOf('def')); // 1
// includes方法
var array = [-0, 1, 2];
console.log(array.includes(+0)); // true
console.log(array.includes(1)); // true
var array = [NaN];
console.log(array.includes(NaN)); // true
其中 includes 方法需要注意的是,如果元素中有 0,那么在判断过程中不论是 +0 还是 -0 都会判断为 True,这里的
includes 忽略了 +0 和 -0
6. 数组遍历的方法
基于 ES6,不会改变自身的遍历方法一共有 12 个,分别为 forEach、every、some、filter、map、reduce、reduceRight,以及 ES6 新增的方法 entries、find、findIndex、keys、values
// forEach方法
var array = [1, 3, 5];
var obj = {name:'cc'};
var sReturn = array.forEach(function(value, index, array){
  array[index] = value;
  console.log(this.name); // cc被打印了三次, this指向obj
},obj);
console.log(array); // [1, 3, 5]
console.log(sReturn); // undefined, 可见返回值为undefined
// every方法
var o = {0:10, 1:8, 2:25, length:3};
var bool = Array.prototype.every.call(o,function(value, index, obj){
  return value >= 8;
},o);
console.log(bool); // true
// some方法
var array = [18, 9, 10, 35, 80];
var isExist = array.some(function(value, index, array){
  return value > 20;
});
console.log(isExist); // true
// map 方法
var array = [18, 9, 10, 35, 80];
array.map(item => item + 1);
console.log(array);  // [19, 10, 11, 36, 81]
// filter 方法
var array = [18, 9, 10, 35, 80];
var array2 = array.filter(function(value, index, array){
  return value > 20;
});
console.log(array2); // [35, 80]
// reduce方法
var array = [1, 2, 3, 4];
var s = array.reduce(function(previousValue, value, index, array){
  return previousValue * value;
},1);
console.log(s); // 24
// ES6写法更加简洁
array.reduce((p, v) => p * v); // 24
// reduceRight方法 (和reduce的区别就是从后往前累计)
var array = [1, 2, 3, 4];
array.reduceRight((p, v) => p * v); // 24
// entries方法
var array = ["a", "b", "c"];
var iterator = array.entries();
console.log(iterator.next().value); // [0, "a"]
console.log(iterator.next().value); // [1, "b"]
console.log(iterator.next().value); // [2, "c"]
console.log(iterator.next().value); // undefined, 迭代器处于数组末尾时, 再迭代就会返回undefined
// find & findIndex方法
var array = [1, 3, 5, 7, 8, 9, 10];
function f(value, index, array){
  return value%2==0;     // 返回偶数
}
function f2(value, index, array){
  return value > 20;     // 返回大于20的数
}
console.log(array.find(f)); // 8
console.log(array.find(f2)); // undefined
console.log(array.findIndex(f)); // 4
console.log(array.findIndex(f2)); // -1
// keys方法
[...Array(10).keys()];     // [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
[...new Array(10).keys()]; // [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
// values方法
var array = ["abc", "xyz"];
var iterator = array.values();
console.log(iterator.next().value);//abc
console.log(iterator.next().value);//xyz
7. 总结
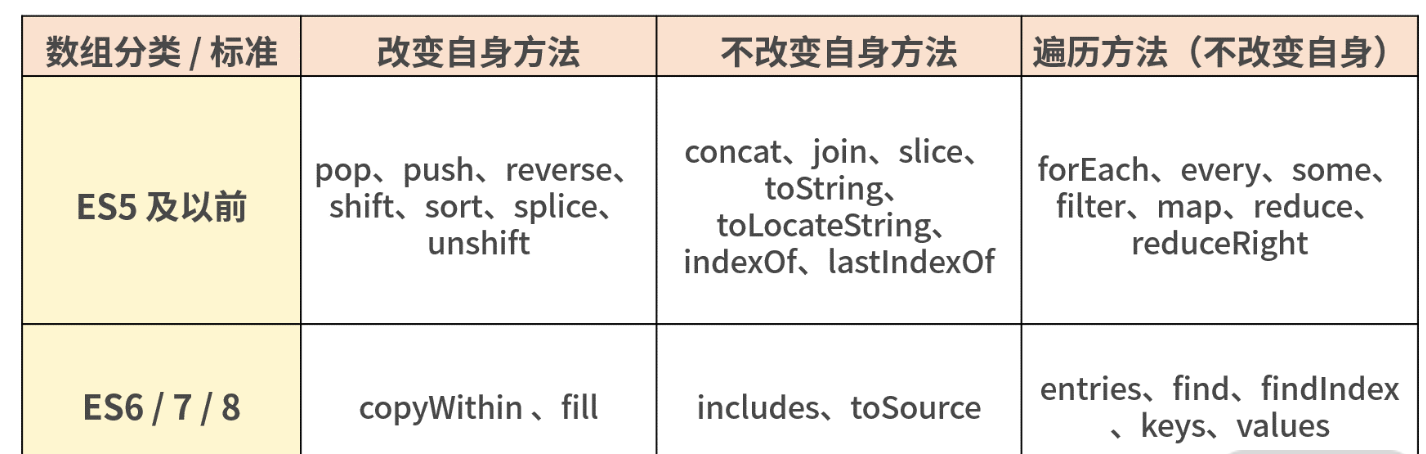
这些方法之间存在很多共性,如下:
- 所有插入元素的方法,比如
push、unshift一律返回数组新的长度; - 所有删除元素的方法,比如
pop、shift、splice一律返回删除的元素,或者返回删除的多个元素组成的数组; - 部分遍历方法,比如
forEach、every、some、filter、map、find、findIndex,它们都包含function(value,index,array){}和thisArg这样两个形参。
数组和字符串方法
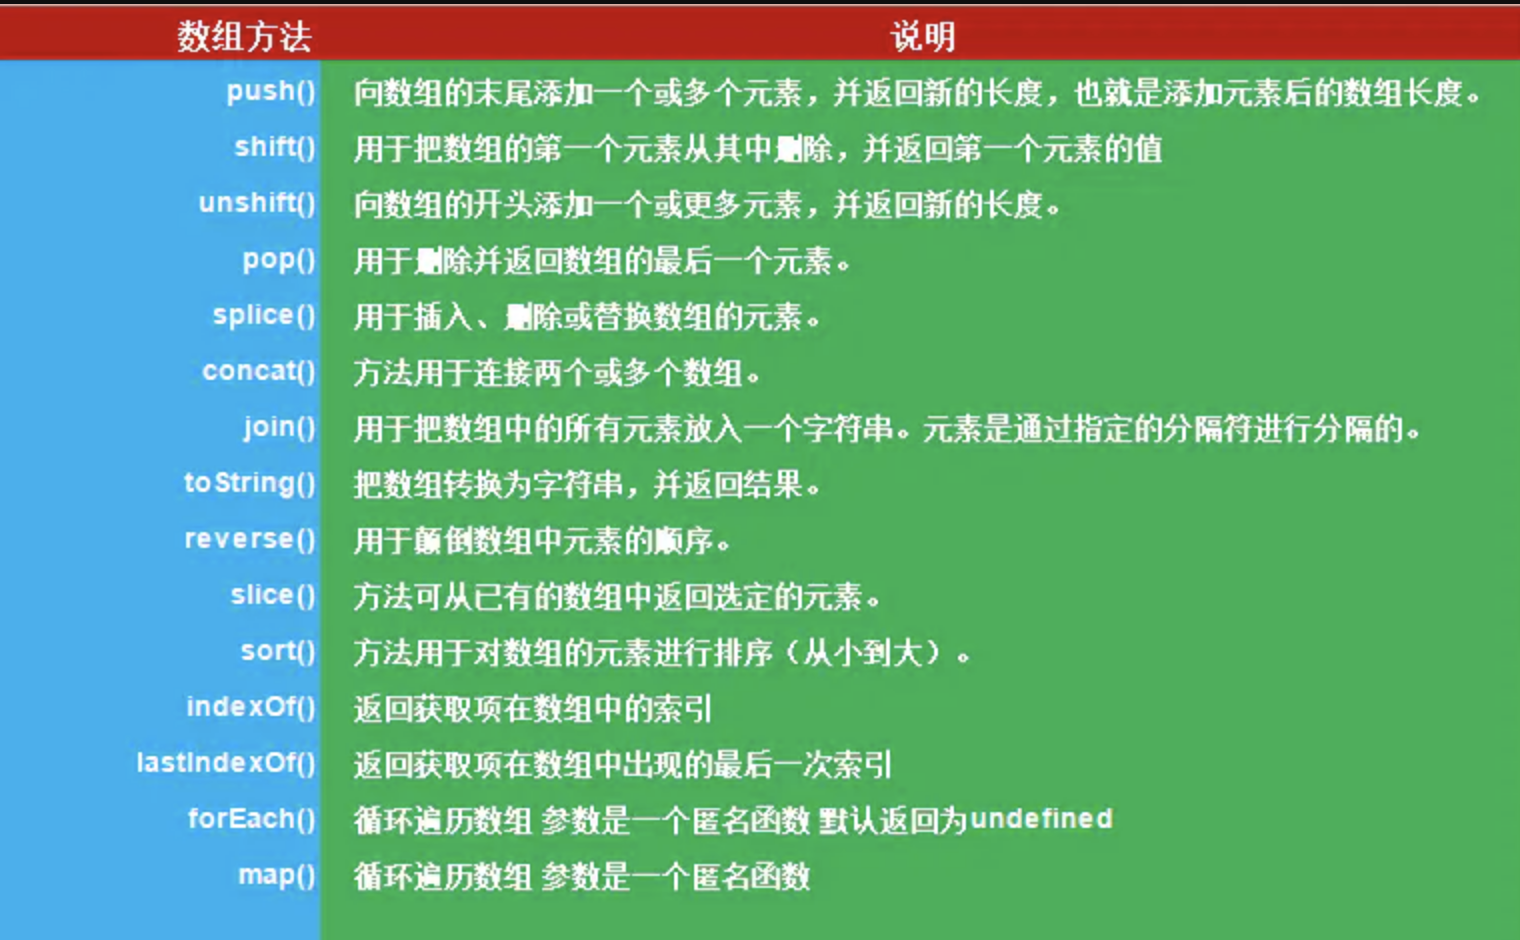
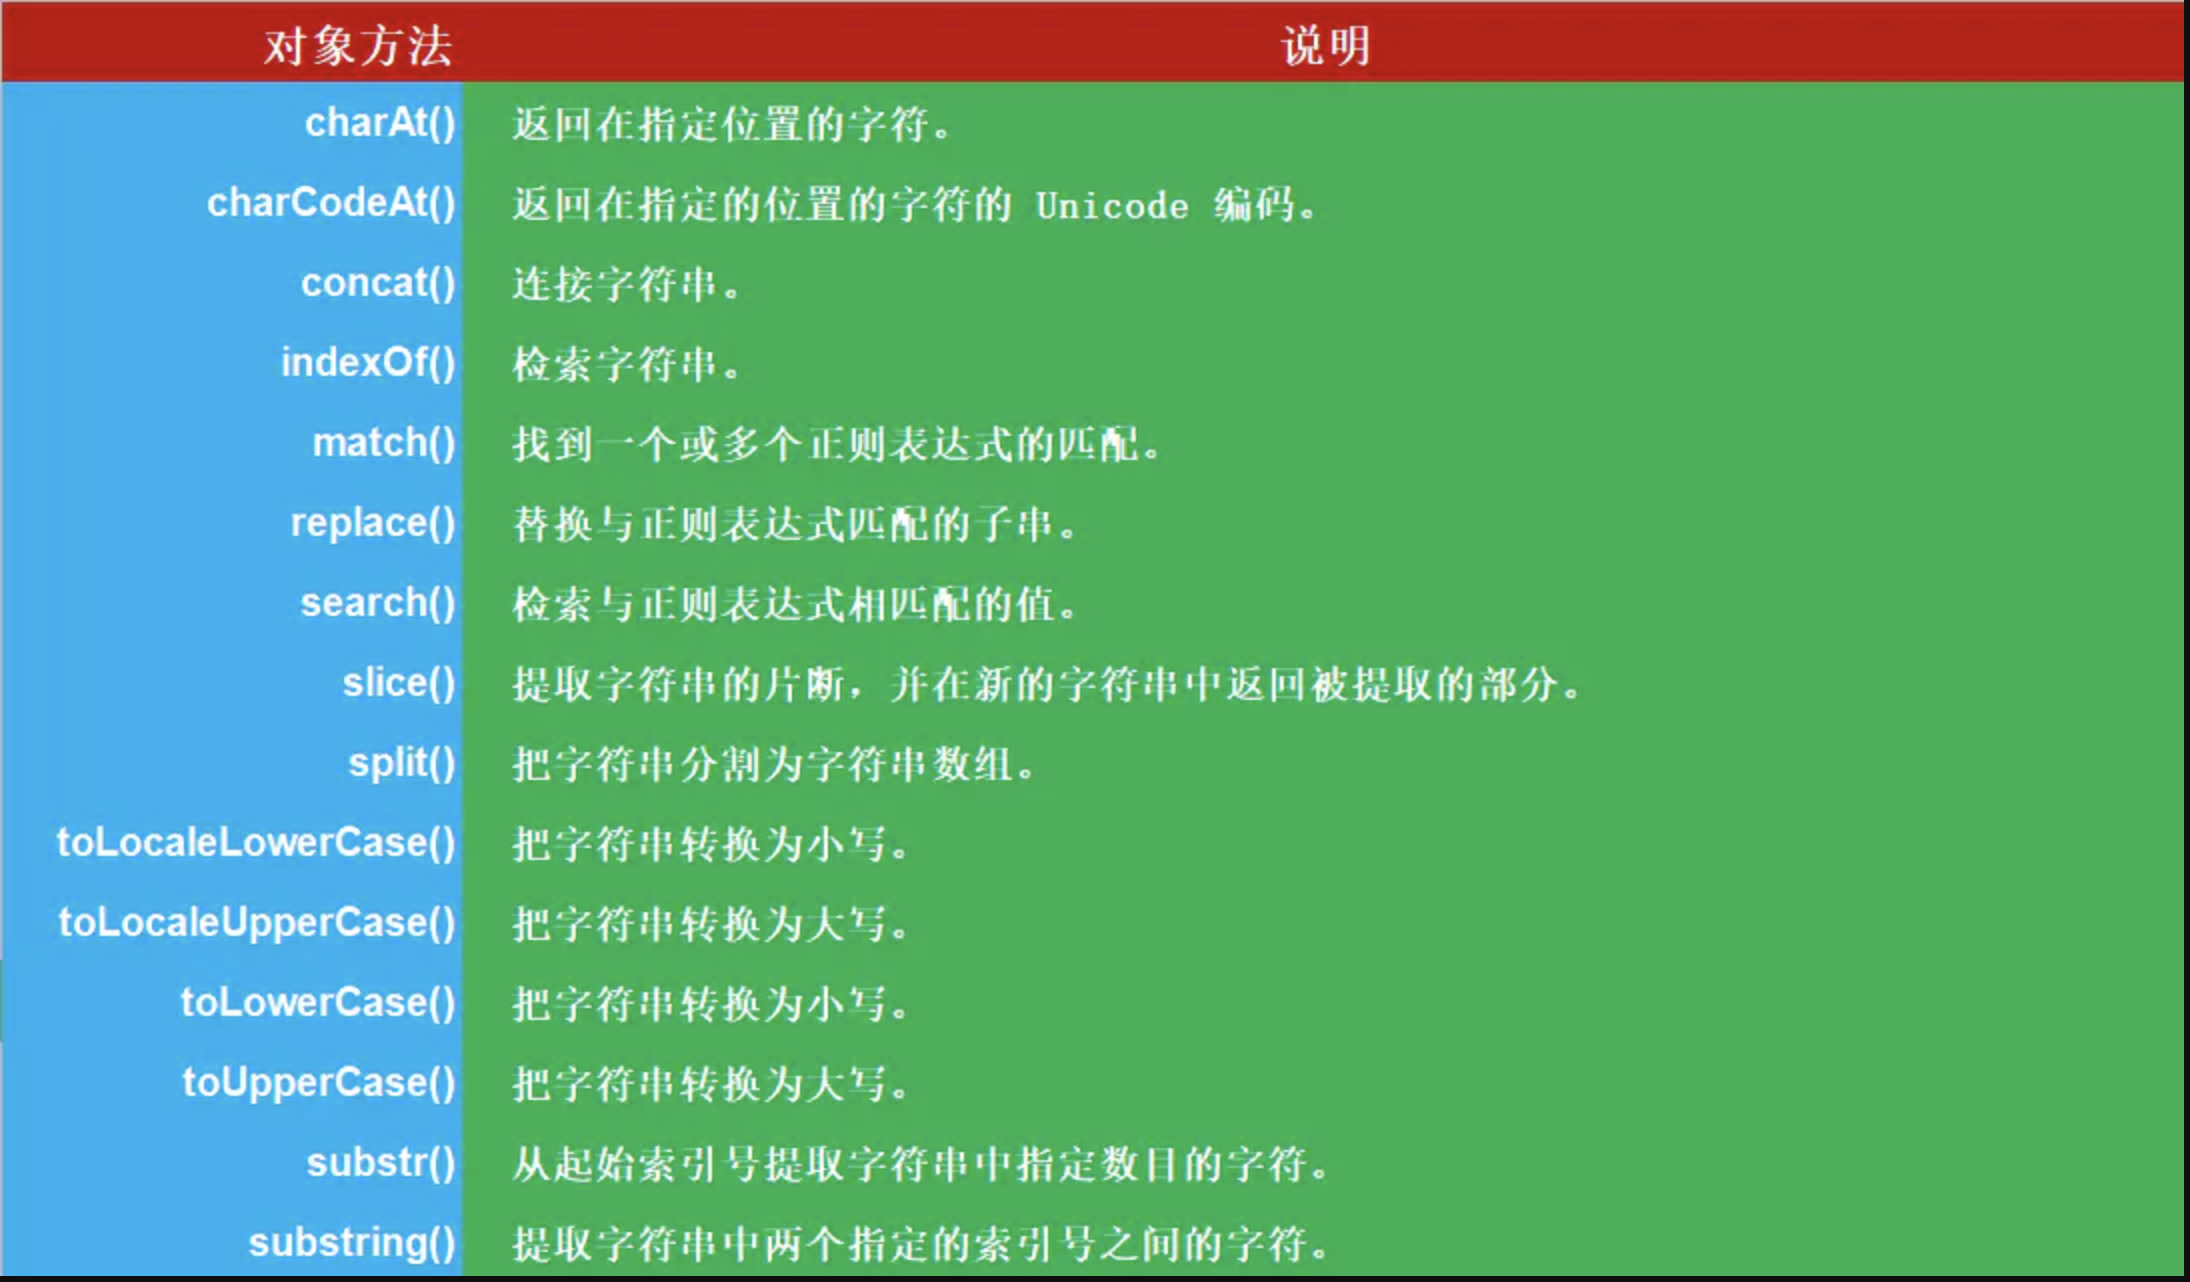
二、理解JS的类数组
在 JavaScript 中有哪些情况下的对象是类数组呢?主要有以下几种
- 函数里面的参数对象
arguments; - 用
getElementsByTagName/ClassName/Name获得的HTMLCollection - 用
querySelector获得的NodeList
1. arguments对象
arguments对象是函数中传递的参数值的集合。它是一个类似数组的对象,因为它有一个
length属性,我们可以使用数组索引表示法arguments[1]来访问单个值,但它没有数组中的内置方法,如:forEach、reduce、filter和map。
function foo(name, age, sex) {
    console.log(arguments);
    console.log(typeof arguments);
    console.log(Object.prototype.toString.call(arguments));
}
foo('jack', '18', 'male');
这段代码比较容易,就是直接将这个函数的 arguments 在函数内部打印出来,那么我们看下这个 arguments 打印出来的结果,请看控制台的这张截图。
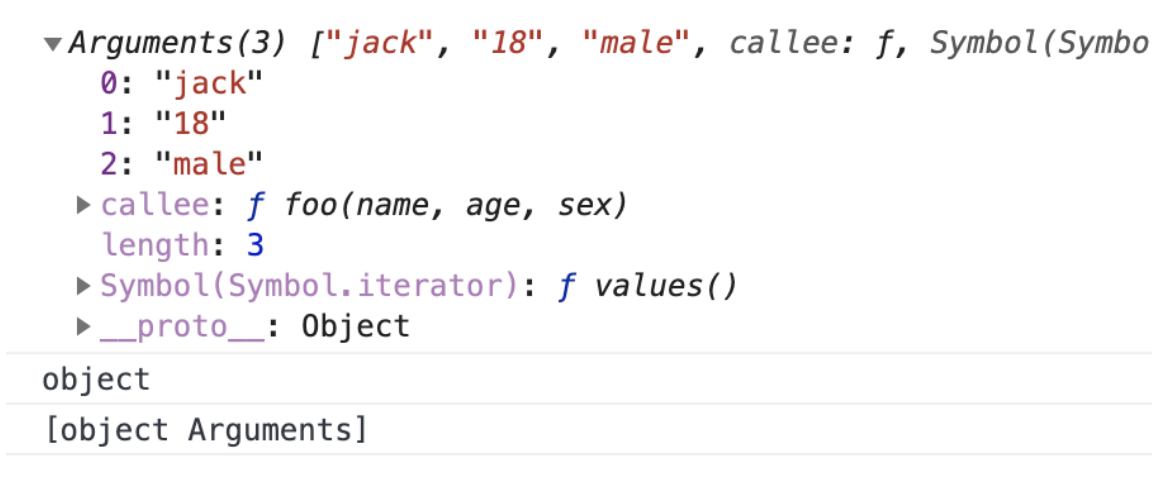
从结果中可以看到,
typeof这个arguments返回的是object,通过Object.prototype.toString.call返回的结果是'[object arguments]',可以看出来返回的不是'[object array]',说明arguments和数组还是有区别的。
我们可以使用Array.prototype.slice将arguments对象转换成一个数组。
function one() {
  return Array.prototype.slice.call(arguments);
}
注意:箭头函数中没有arguments对象。
function one() {
  return arguments;
}
const two = function () {
  return arguments;
}
const three = function three() {
  return arguments;
}

const four = () => arguments;

four(); // Throws an error  - arguments is not defined
当我们调用函数four时,它会抛出一个ReferenceError: arguments is not defined error。使用rest语法,可以解决这个问题。
const four = (...args) => args;
这会自动将所有参数值放入数组中。
arguments 不仅仅有一个 length 属性,还有一个 callee 属性,我们接下来看看这个 callee 是干什么的,代码如下所示
function foo(name, age, sex) {
    console.log(arguments.callee);
}
foo('jack', '18', 'male');
从控制台可以看到,输出的就是函数自身,如果在函数内部直接执行调用
callee的话,那它就会不停地执行当前函数,直到执行到内存溢出
2. HTMLCollection
HTMLCollection 简单来说是 HTML DOM 对象的一个接口,这个接口包含了获取到的 DOM 元素集合,返回的类型是类数组对象,如果用 typeof 来判断的话,它返回的是 'object'。它是及时更新的,当文档中的 DOM 变化时,它也会随之变化。
描述起来比较抽象,还是通过一段代码来看下 HTMLCollection 最后返回的是什么,我们先随便找一个页面中有 form 表单的页面,在控制台中执行下述代码
var elem1, elem2;
// document.forms 是一个 HTMLCollection
elem1 = document.forms[0];
elem2 = document.forms.item(0);
console.log(elem1);
console.log(elem2);
console.log(typeof elem1);
console.log(Object.prototype.toString.call(elem1));
在这个有 form 表单的页面执行上面的代码,得到的结果如下。
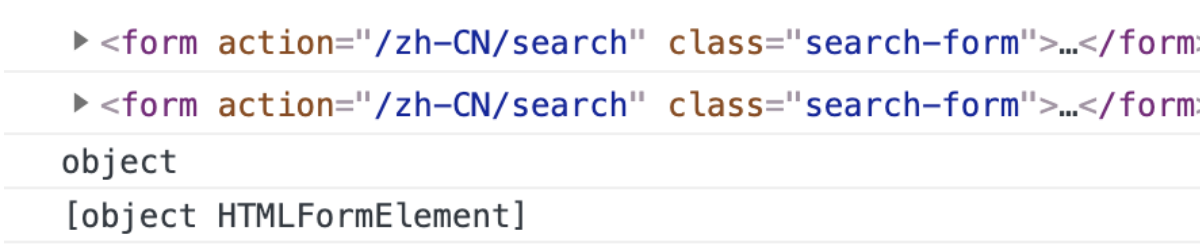
可以看到,这里打印出来了页面第一个 form 表单元素,同时也打印出来了判断类型的结果,说明打印的判断的类型和 arguments 返回的也比较类似,typeof 返回的都是 'object',和上面的类似。
另外需要注意的一点就是 HTML DOM 中的 HTMLCollection 是即时更新的,当其所包含的文档结构发生改变时,它会自动更新。下面我们再看最后一个 NodeList 类数组。
3. NodeList
NodeList 对象是节点的集合,通常是由 querySlector 返回的。NodeList 不是一个数组,也是一种类数组。虽然 NodeList 不是一个数组,但是可以使用 for...of 来迭代。在一些情况下,NodeList 是一个实时集合,也就是说,如果文档中的节点树发生变化,NodeList 也会随之变化。我们还是利用代码来理解一下 Nodelist 这种类数组。
var list = document.querySelectorAll('input[type=checkbox]');
for (var checkbox of list) {
  checkbox.checked = true;
}
console.log(list);
console.log(typeof list);
console.log(Object.prototype.toString.call(list));
从上面的代码执行的结果中可以发现,我们是通过有 CheckBox 的页面执行的代码,在结果可中输出了一个 NodeList 类数组,里面有一个 CheckBox 元素,并且我们判断了它的类型,和上面的 arguments 与 HTMLCollection 其实是类似的,执行结果如下图所示。
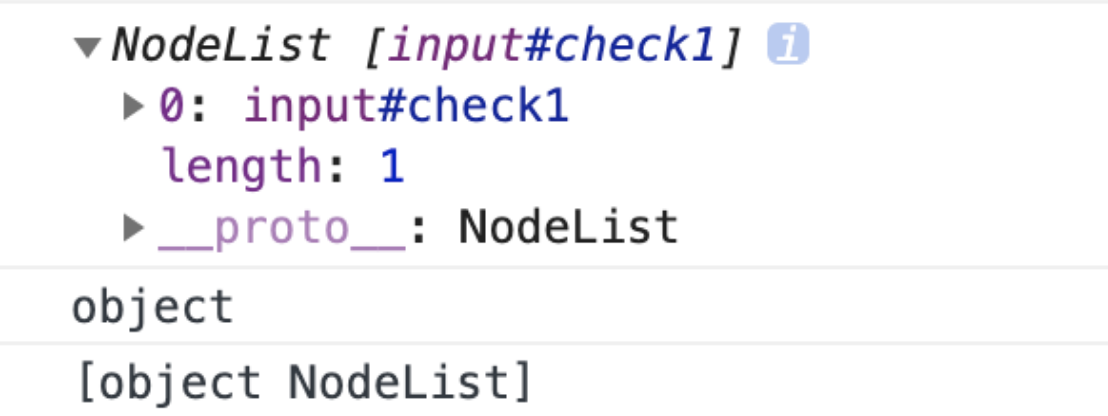
4. 类数组应用场景
- 遍历参数操作
我们在函数内部可以直接获取 arguments 这个类数组的值,那么也可以对于参数进行一些操作,比如下面这段代码,我们可以将函数的参数默认进行求和操作。
function add() {
    var sum =0,
        len = arguments.length;
    for(var i = 0; i < len; i++){
        sum += arguments[i];
    }
    return sum;
}
add()                           // 0
add(1)                          // 1
add(1,2)                       // 3
add(1,2,3,4);                   // 10
- 定义链接字符串函数
我们可以通过 arguments 这个例子定义一个函数来连接字符串。这个函数唯一正式声明了的参数是一个字符串,该参数指定一个字符作为衔接点来连接字符串。该函数定义如下。
// 这段代码说明了,你可以传递任意数量的参数到该函数,并使用每个参数作为列表中的项创建列表进行拼接。从这个例子中也可以看出,我们可以在日常编码中采用这样的代码抽象方式,把需要解决的这一类问题,都抽象成通用的方法,来提升代码的可复用性
function myConcat(separa) {
  var args = Array.prototype.slice.call(arguments, 1);
  return args.join(separa);
}
myConcat(", ", "red", "orange", "blue");
// "red, orange, blue"
myConcat("; ", "elephant", "lion", "snake");
// "elephant; lion; snake"
myConcat(". ", "one", "two", "three", "four", "five");
// "one. two. three. four. five"
- 传递参数使用
// 使用 apply 将 foo 的参数传递给 bar
function foo() {
    bar.apply(this, arguments);
}
function bar(a, b, c) {
   console.log(a, b, c);
}
foo(1, 2, 3)   //1 2 3
5. 如何将类数组转换成数组
- 类数组借用数组方法转数组
function sum(a, b) {
  let args = Array.prototype.slice.call(arguments);
 // let args = [].slice.call(arguments); // 这样写也是一样效果
  console.log(args.reduce((sum, cur) => sum + cur));
}
sum(1, 2);  // 3
function sum(a, b) {
  let args = Array.prototype.concat.apply([], arguments);
  console.log(args.reduce((sum, cur) => sum + cur));
}
sum(1, 2);  // 3
- ES6 的方法转数组
function sum(a, b) {
  let args = Array.from(arguments);
  console.log(args.reduce((sum, cur) => sum + cur));
}
sum(1, 2);    // 3
function sum(a, b) {
  let args = [...arguments];
  console.log(args.reduce((sum, cur) => sum + cur));
}
sum(1, 2);    // 3
function sum(...args) {
  console.log(args.reduce((sum, cur) => sum + cur));
}
sum(1, 2);    // 3
Array.from和ES6 的展开运算符,都可以把arguments这个类数组转换成数组args
类数组和数组的异同点
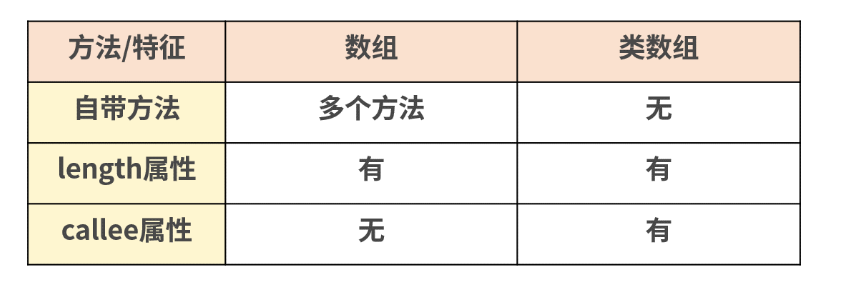
在前端工作中,开发者往往会忽视对类数组的学习,其实在高级 JavaScript 编程中经常需要将类数组向数组转化,尤其是一些比较复杂的开源项目,经常会看到函数中处理参数的写法,例如:
[].slice.call(arguments)这行代码。
三、实现数组扁平化的 6 种方式
1. 方法一:普通的递归实
普通的递归思路很容易理解,就是通过循环递归的方式,一项一项地去遍历,如果每一项还是一个数组,那么就继续往下遍历,利用递归程序的方法,来实现数组的每一项的连接。我们来看下这个方法是如何实现的,如下所示
// 方法1
var a = [1, [2, [3, 4, 5]]];
function flatten(arr) {
  let result = [];

  for(let i = 0; i < arr.length; i++) {
    if(Array.isArray(arr[i])) {
      result = result.concat(flatten(arr[i]));
    } else {
      result.push(arr[i]);
    }
  }
  return result;
}
flatten(a);  //  [1, 2, 3, 4,5]
从上面这段代码可以看出,最后返回的结果是扁平化的结果,这段代码核心就是循环遍历过程中的递归操作,就是在遍历过程中发现数组元素还是数组的时候进行递归操作,把数组的结果通过数组的 concat 方法拼接到最后要返回的 result 数组上,那么最后输出的结果就是扁平化后的数组
2. 方法二:利用 reduce 函数迭代
从上面普通的递归函数中可以看出,其实就是对数组的每一项进行处理,那么我们其实也可以用 reduce 来实现数组的拼接,从而简化第一种方法的代码,改造后的代码如下所示。
// 方法2
var arr = [1, [2, [3, 4]]];
function flatten(arr) {
    return arr.reduce(function(prev, next){
        return prev.concat(Array.isArray(next) ? flatten(next) : next)
    }, [])
}
console.log(flatten(arr));//  [1, 2, 3, 4,5]
3. 方法三:扩展运算符实现
这个方法的实现,采用了扩展运算符和 some 的方法,两者共同使用,达到数组扁平化的目的,还是来看一下代码
// 方法3
var arr = [1, [2, [3, 4]]];
function flatten(arr) {
    while (arr.some(item => Array.isArray(item))) {
        arr = [].concat(...arr);
    }
    return arr;
}
console.log(flatten(arr)); //  [1, 2, 3, 4,5]
从执行的结果中可以发现,我们先用数组的 some 方法把数组中仍然是组数的项过滤出来,然后执行 concat 操作,利用 ES6 的展开运算符,将其拼接到原数组中,最后返回原数组,达到了预期的效果。
前三种实现数组扁平化的方式其实是最基本的思路,都是通过最普通递归思路衍生的方法,尤其是前两种实现方法比较类似。值得注意的是 reduce 方法,它可以在很多应用场景中实现,由于 reduce 这个方法提供的几个参数比较灵活,能解决很多问题,所以是值得熟练使用并且精通的
4. 方法四:split 和 toString 共同处理
我们也可以通过 split 和 toString 两个方法,来共同实现数组扁平化,由于数组会默认带一个 toString 的方法,所以可以把数组直接转换成逗号分隔的字符串,然后再用 split 方法把字符串重新转换为数组,如下面的代码所示。
// 方法4
var arr = [1, [2, [3, 4]]];
function flatten(arr) {
    return arr.toString().split(',');
}
console.log(flatten(arr)); //  [1, 2, 3, 4]
通过这两个方法可以将多维数组直接转换成逗号连接的字符串,然后再重新分隔成数组,你可以在控制台执行一下查看结果。
5. 方法五:调用 ES6 中的 flat
我们还可以直接调用 ES6 中的 flat 方法,可以直接实现数组扁平化。先来看下 flat 方法的语法:
arr.flat([depth])
其中 depth 是 flat 的参数,depth 是可以传递数组的展开深度(默认不填、数值是 1),即展开一层数组。那么如果多层的该怎么处理呢?参数也可以传进 Infinity,代表不论多少层都要展开。那么我们来看下,用 flat 方法怎么实现,请看下面的代码。
// 方法5
var arr = [1, [2, [3, 4]]];
function flatten(arr) {
  return arr.flat(Infinity);
}
console.log(flatten(arr)); //  [1, 2, 3, 4,5]
- 可以看出,一个嵌套了两层的数组,通过将
flat方法的参数设置为Infinity,达到了我们预期的效果。其实同样也可以设置成 2,也能实现这样的效果。 - 因此,你在编程过程中,发现对数组的嵌套层数不确定的时候,最好直接使用
Infinity,可以达到扁平化。下面我们再来看最后一种场景
6. 方法六:正则和 JSON 方法共同处理
我们在第四种方法中已经尝试了用 toString 方法,其中仍然采用了将 JSON.stringify 的方法先转换为字符串,然后通过正则表达式过滤掉字符串中的数组的方括号,最后再利用 JSON.parse 把它转换成数组。请看下面的代码
// 方法 6
let arr = [1, [2, [3, [4, 5]]], 6];
function flatten(arr) {
  let str = JSON.stringify(arr);
  str = str.replace(/(\[|\])/g, '');
  str = '[' + str + ']';
  return JSON.parse(str);
}
console.log(flatten(arr)); //  [1, 2, 3, 4,5]
可以看到,其中先把传入的数组转换成字符串,然后通过正则表达式的方式把括号过滤掉,这部分正则的表达式你不太理解的话,可以看看下面的图片
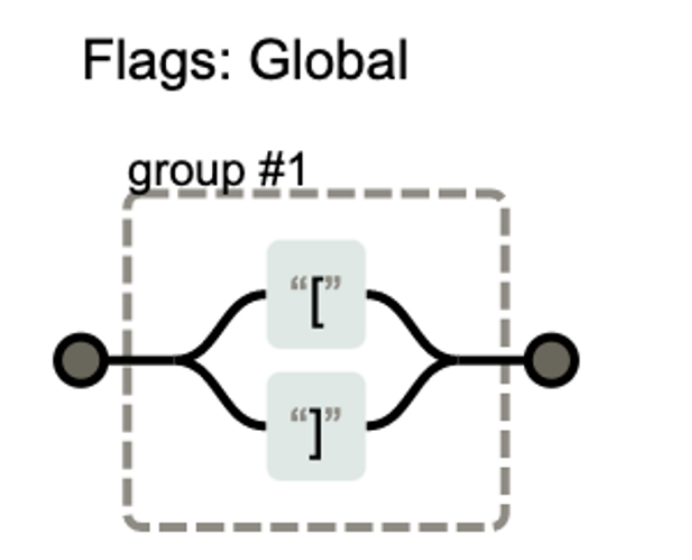
通过这个在线网站 https://regexper.com/ 可以把正则分析成容易理解的可视化的逻辑脑图。其中我们可以看到,匹配规则是:全局匹配(g)左括号或者右括号,将它们替换成空格,最后返回处理后的结果。之后拿着正则处理好的结果重新在外层包裹括号,最后通过 JSON.parse 转换成数组返回。
四、如何用 JS 实现各种数组排序
数据结构算法中排序有很多种,常见的、不常见的,至少包含十种以上。根据它们的特性,可以大致分为两种类型:比较类排序和非比较类排序。
- 比较类排序:通过比较来决定元素间的相对次序,其时间复杂度不能突破
O(nlogn),因此也称为非线性时间比较类排序。 - 非比较类排序:不通过比较来决定元素间的相对次序,它可以突破基于比较排序的时间下界,以线性时间运行,因此也称为线性时间非比较类排序。
我们通过一张图片来看看这两种分类方式分别包括哪些排序方法。
非比较类的排序在实际情况中用的比较少
1. 冒泡排序
冒泡排序是最基础的排序,一般在最开始学习数据结构的时候就会接触它。冒泡排序是一次比较两个元素,如果顺序是错误的就把它们交换过来。走访数列的工作会重复地进行,直到不需要再交换,也就是说该数列已经排序完成。请看下面的代码。
var a = [1, 3, 6, 3, 23, 76, 1, 34, 222, 6, 456, 221];
function bubbleSort(array) {
  const len = array.length
  if (len < 2) return array
  for (let i = 0; i < len; i++) {
    for (let j = 0; j < i; j++) {
      if (array[j] > array[i]) {
        const temp = array[j]
        array[j] = array[i]
        array[i] = temp
      }
    }
  }
  return array
}
bubbleSort(a);  // [1, 1, 3, 3, 6, 6, 23, 34, 76, 221, 222, 456]
从上面这段代码可以看出,最后返回的是排好序的结果。因为冒泡排序实在太基础和简单,这里就不过多赘述了。下面我们来看看快速排序法
2. 快速排序
快速排序的基本思想是通过一趟排序,将待排记录分隔成独立的两部分,其中一部分记录的关键字均比另一部分的关键字小,则可以分别对这两部分记录继续进行排序,以达到整个序列有序。
var a = [1, 3, 6, 3, 23, 76, 1, 34, 222, 6, 456, 221];
function quickSort(array) {
  var quick = function(arr) {
    if (arr.length <= 1) return arr
    const len = arr.length
    const index = Math.floor(len >> 1)
    const pivot = arr.splice(index, 1)[0]
    const left = []
    const right = []
    for (let i = 0; i < len; i++) {
      if (arr[i] > pivot) {
        right.push(arr[i])
      } else if (arr[i] <= pivot) {
        left.push(arr[i])
      }
    }
    return quick(left).concat([pivot], quick(right))
  }
  const result = quick(array)
  return result
}
quickSort(a);//  [1, 1, 3, 3, 6, 6, 23, 34, 76, 221, 222, 456]
上面的代码在控制台执行之后,也可以得到预期的结果。最主要的思路是从数列中挑出一个元素,称为 “基准”(pivot);然后重新排序数列,所有元素比基准值小的摆放在基准前面、比基准值大的摆在基准的后面;在这个区分搞定之后,该基准就处于数列的中间位置;然后把小于基准值元素的子数列(left)和大于基准值元素的子数列(right)递归地调用 quick 方法排序完成,这就是快排的思路。
3. 插入排序
插入排序算法描述的是一种简单直观的排序算法。它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入,从而达到排序的效果。来看一下代码
var a = [1, 3, 6, 3, 23, 76, 1, 34, 222, 6, 456, 221];
function insertSort(array) {
  const len = array.length
  let current
  let prev
  for (let i = 1; i < len; i++) {
    current = array[i]
    prev = i - 1
    while (prev >= 0 && array[prev] > current) {
      array[prev + 1] = array[prev]
      prev--
    }
    array[prev + 1] = current
  }
  return array
}
insertSort(a); // [1, 1, 3, 3, 6, 6, 23, 34, 76, 221, 222, 456]
从执行的结果中可以发现,通过插入排序这种方式实现了排序效果。插入排序的思路是基于数组本身进行调整的,首先循环遍历从 i 等于 1 开始,拿到当前的 current 的值,去和前面的值比较,如果前面的大于当前的值,就把前面的值和当前的那个值进行交换,通过这样不断循环达到了排序的目的
4. 选择排序
选择排序是一种简单直观的排序算法。它的工作原理是,首先将最小的元素存放在序列的起始位置,再从剩余未排序元素中继续寻找最小元素,然后放到已排序的序列后面……以此类推,直到所有元素均排序完毕。请看下面的代码。
var a = [1, 3, 6, 3, 23, 76, 1, 34, 222, 6, 456, 221];
function selectSort(array) {
  const len = array.length
  let temp
  let minIndex
  for (let i = 0; i < len - 1; i++) {
    minIndex = i
    for (let j = i + 1; j < len; j++) {
      if (array[j] <= array[minIndex]) {
        minIndex = j
      }
    }
    temp = array[i]
    array[i] = array[minIndex]
    array[minIndex] = temp
  }
  return array
}
selectSort(a); // [1, 1, 3, 3, 6, 6, 23, 34, 76, 221, 222, 456]
这样,通过选择排序的方法同样也可以实现数组的排序,从上面的代码中可以看出该排序是表现最稳定的排序算法之一,因为无论什么数据进去都是 O(n 平方) 的时间复杂度,所以用到它的时候,数据规模越小越好
5. 堆排序
堆排序是指利用堆这种数据结构所设计的一种排序算法。堆积是一个近似完全二叉树的结构,并同时满足堆积的性质,即子结点的键值或索引总是小于(或者大于)它的父节点。堆的底层实际上就是一棵完全二叉树,可以用数组实现。
根节点最大的堆叫作大根堆,根节点最小的堆叫作小根堆,你可以根据从大到小排序或者从小到大来排序,分别建立对应的堆就可以。请看下面的代码
var a = [1, 3, 6, 3, 23, 76, 1, 34, 222, 6, 456, 221];
function heap_sort(arr) {
  var len = arr.length
  var k = 0
  function swap(i, j) {
    var temp = arr[i]
    arr[i] = arr[j]
    arr[j] = temp
  }
  function max_heapify(start, end) {
    var dad = start
    var son = dad * 2 + 1
    if (son >= end) return
    if (son + 1 < end && arr[son] < arr[son + 1]) {
      son++
    }
    if (arr[dad] <= arr[son]) {
      swap(dad, son)
      max_heapify(son, end)
    }
  }
  for (var i = Math.floor(len / 2) - 1; i >= 0; i--) {
    max_heapify(i, len)
  }

  for (var j = len - 1; j > k; j--) {
    swap(0, j)
    max_heapify(0, j)
  }

  return arr
}
heap_sort(a); // [1, 1, 3, 3, 6, 6, 23, 34, 76, 221, 222, 456]
从代码来看,堆排序相比上面几种排序整体上会复杂一些,不太容易理解。不过你应该知道两点:
- 一是堆排序最核心的点就在于排序前先建堆;
- 二是由于堆其实就是完全二叉树,如果父节点的序号为 n,那么叶子节点的序号就分别是
2n和2n+1。
你理解了这两点,再看代码就比较好理解了。堆排序最后有两个循环:第一个是处理父节点的顺序;第二个循环则是根据父节点和叶子节点的大小对比,进行堆的调整。通过这两轮循环的调整,最后堆排序完成。
6. 归并排序
归并排序是建立在归并操作上的一种有效的排序算法,该算法是采用分治法的一个非常典型的应用。将已有序的子序列合并,得到完全有序的序列;先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为二路归并。我们先看一下代码。
var a = [1, 3, 6, 3, 23, 76, 1, 34, 222, 6, 456, 221];
function mergeSort(array) {
  const merge = (right, left) => {
    const result = []
    let il = 0
    let ir = 0
    while (il < left.length && ir < right.length) {
      if (left[il] < right[ir]) {
        result.push(left[il++])
      } else {
        result.push(right[ir++])
      }
    }
    while (il < left.length) {
      result.push(left[il++])
    }
    while (ir < right.length) {
      result.push(right[ir++])
    }
    return result
  }
  const mergeSort = array => {
    if (array.length === 1) { return array }
    const mid = Math.floor(array.length / 2)
    const left = array.slice(0, mid)
    const right = array.slice(mid, array.length)
    return merge(mergeSort(left), mergeSort(right))
  }
  return mergeSort(array)
}
mergeSort(a); // [1, 1, 3, 3, 6, 6, 23, 34, 76, 221, 222, 456]
从上面这段代码中可以看到,通过归并排序可以得到想要的结果。上面提到了分治的思路,你可以从 mergeSort 方法中看到,通过 mid 可以把该数组分成左右两个数组,分别对这两个进行递归调用排序方法,最后将两个数组按照顺序归并起来。
归并排序是一种稳定的排序方法,和选择排序一样,归并排序的性能不受输入数据的影响,但表现比选择排序好得多,因为始终都是 O(nlogn) 的时间复杂度。而代价是需要额外的内存空间。
其中你可以看到排序相关的时间复杂度和空间复杂度以及稳定性的情况,如果遇到需要自己实现排序的时候,可以根据它们的空间和时间复杂度综合考量,选择最适合的排序方法
💬 面试官追问
const sorted = rows.sort(fn)之后,上游的原始顺序也被改了,为什么?sort是原地排序,返回的就是rows本身,两个变量指向同一个数组。改成rows.toSorted(fn),老环境就[...rows].sort(fn)。注意这只隔离了数组本身,元素对象还是共享的。splice(1, 2)的返回值被当成删除后的数组存了,结果只剩两项,怎么回事?splice返回的是被删掉的那几项,原数组才是删完的结果。要保留剩余列表继续用原变量;想要不改原数组的版本就用arr.toSpliced(1, 2)。Array(8)想得到[8],结果是8个空位,参数还来自用户输入,怎么改?单个数字传给
Array会被当成长度,改用Array.of(value),不管是数字还是字符串都只是一个元素。Array(8)这种空位数组map也会跳过,Array(3).map(() => 0)拿到的还是3个空位,要填充用Array.from({ length: 3 }, () => 0)。微前端子应用传来的数组,
value instanceof Array返回false,为什么?不同
iframe或沙箱里各有一套Array构造器,instanceof比的是原型链上有没有当前环境的那个Array.prototype。换成Array.isArray(value),它不依赖构造器,跨环境也准。forEach里找到目标后想break,怎么办?forEach没法中断,return只是跳过当前这次回调。要中断就用for...of加break,或者用some/find,找到时return true就停。
# 二、HTML
# 1 meta 标签:自动刷新/跳转
⚡ 30 秒速记
- 写法:
<meta http-equiv="refresh" content="5; url=page2.html">,5秒后跳转 content只写数字就是定时刷新当前页:content="60"每分钟刷一次- 适合场景很窄:展厅轮播、监控大屏这种没人操作的页面
- 可访问性差:用户来不及读、读屏器被打断,
WCAG不建议用定时刷新和跳转 - 正式的跳转用服务端
301/302,对SEO最友好;要提示用户再跳的,用setTimeout+location.replace并给个「立即跳转 / 取消」
meta refresh 让页面在指定秒数后自动刷新,或者跳到另一个地址,一行 HTML 就搞定,不用写 JS。 写 content="5; url=page2.html" 就是 5 秒后跳转,只写 content="60" 就是每 60 秒刷新当前页。我觉得它只适合大屏、展厅轮播这种没人操作的页面。普通网站别用它做跳转:用户读到一半被拉走,读屏器也会被打断,搜索引擎对这种跳转也不如服务端的 301 / 302 友好。
假设要实现一个类似 PPT 自动播放的效果,你很可能会想到使用 JavaScript 定时器控制页面跳转来实现。但其实有更加简洁的实现方法,比如通过 meta 标签来实现:
<meta http-equiv="Refresh" content="5; URL=page2.html">
上面的代码会在 5s 之后自动跳转到同域下的 page2.html 页面。我们要实现 PPT 自动播放的功能,只需要在每个页面的 meta 标签内设置好下一个页面的地址即可。
另一种场景,比如每隔一分钟就需要刷新页面的大屏幕监控,也可以通过 meta 标签来实现,只需去掉后面的 URL 即可:
<meta http-equiv="Refresh" content="60">
meta viewport相关
<!DOCTYPE html>  <!--H5标准声明,使用 HTML5 doctype,不区分大小写-->
<head lang=”en”> <!--标准的 lang 属性写法-->
<meta charset=’utf-8′>    <!--声明文档使用的字符编码-->
<meta http-equiv=”X-UA-Compatible” content=”IE=edge,chrome=1″/>   <!--优先使用 IE 最新版本和 Chrome-->
<meta name=”description” content=”不超过150个字符”/>       <!--页面描述-->
<meta name=”keywords” content=””/>     <!-- 页面关键词-->
<meta name=”author” content=”name, email@gmail.com”/>    <!--网页作者-->
<meta name=”robots” content=”index,follow”/>      <!--搜索引擎抓取-->
<meta name=”viewport” content=”initial-scale=1, maximum-scale=3, minimum-scale=1, user-scalable=no”> <!--为移动设备添加 viewport-->
<meta name=”apple-mobile-web-app-title” content=”标题”> <!--iOS 设备 begin-->
<meta name=”apple-mobile-web-app-capable” content=”yes”/>  <!--添加到主屏后的标题(iOS 6 新增)
是否启用 WebApp 全屏模式,删除苹果默认的工具栏和菜单栏-->
<meta name=”apple-itunes-app” content=”app-id=myAppStoreID, affiliate-data=myAffiliateData, app-argument=myURL”>
<!--添加智能 App 广告条 Smart App Banner(iOS 6+ Safari)-->
<meta name=”apple-mobile-web-app-status-bar-style” content=”black”/>
<meta name=”format-detection” content=”telphone=no, email=no”/>  <!--设置苹果工具栏颜色-->
<meta name=”renderer” content=”webkit”> <!-- 启用360浏览器的极速模式(webkit)-->
<meta http-equiv=”X-UA-Compatible” content=”IE=edge”>     <!--避免IE使用兼容模式-->
<meta http-equiv=”Cache-Control” content=”no-siteapp” />    <!--不让百度转码-->
<meta name=”HandheldFriendly” content=”true”>     <!--针对手持设备优化,主要是针对一些老的不识别viewport的浏览器,比如黑莓-->
<meta name=”MobileOptimized” content=”320″>   <!--微软的老式浏览器-->
<meta name=”screen-orientation” content=”portrait”>   <!--uc强制竖屏-->
<meta name=”x5-orientation” content=”portrait”>    <!--QQ强制竖屏-->
<meta name=”full-screen” content=”yes”>              <!--UC强制全屏-->
<meta name=”x5-fullscreen” content=”true”>       <!--QQ强制全屏-->
<meta name=”browsermode” content=”application”>   <!--UC应用模式-->
<meta name=”x5-page-mode” content=”app”>   <!-- QQ应用模式-->
<meta name=”msapplication-tap-highlight” content=”no”>    <!--windows phone 点击无高亮
设置页面不缓存-->
<meta http-equiv=”pragma” content=”no-cache”>
<meta http-equiv=”cache-control” content=”no-cache”>
<meta http-equiv=”expires” content=”0″>
💬 面试官追问
监控大屏要每分钟刷新一次,结果页面一直跳走了,配置哪里错了?
八成是复制了带
url的模板。刷新当前页只写秒数:<meta http-equiv="refresh" content="60">,分号后面带了地址就变成跳转了。大屏整页刷新时会白一下,还会丢筛选条件,有更好的做法吗?
整页刷新会重建页面,白屏和状态丢失避免不了。更好的是页面不动,用
setInterval定时拉接口只更新数据;实在要整页刷新,把筛选条件放到URL参数或localStorage里。旧域名下线要跳到新域名,用
meta refresh行吗?不推荐,这种永久迁移要用服务端
301,搜索引擎会把权重转到新地址,用户也没有等待。meta refresh只能算没有服务器权限时的兜底,content="0"的话搜索引擎通常也能识别成跳转。配了
refresh等了5秒还停在原页,先查什么?先看标签是不是在
<head>里,http-equiv和content有没有拼错,尤其是content里秒数和url之间的分号。再直接访问目标地址,排除相对路径解析错了导致404。一个页面能同时设置刷新和页面描述吗?
能,两个标签各管各的:
http-equiv="refresh"管刷新跳转,name="description"是给搜索引擎的摘要。别指望一个meta同时干两件事。
# 2 viewport
⚡ 30 秒速记
- 移动端标配:
<meta name="viewport" content="width=device-width, initial-scale=1"> - 不写的话移动浏览器默认按
980px宽布局再整体缩小,字小得看不清 - 三个视口:布局视口(
CSS布局按它算)、视觉视口(屏幕上实际看到的那块)、理想视口(设备宽度) - 别写
user-scalable=no/maximum-scale=1:禁止缩放伤可访问性,iOS 10起Safari默认也不理它 - 刘海屏:加
viewport-fit=cover,再用env(safe-area-inset-bottom)给底部留安全区
viewport 告诉移动浏览器页面按多宽来布局、初始缩放多少。 不写的话,手机浏览器会假装自己是 980px 宽的屏幕来排版,再整体缩小塞进屏幕,结果就是字特别小。写上 width=device-width, initial-scale=1,布局宽度就等于设备宽度,CSS 里写的 16px 才真的是正常大小。很多老模板还带着 user-scalable=no,我一般会删掉,视力不好的用户需要放大,而且 iOS 上它早就默认不生效了。
 <meta name="viewport" content="width=device-width,initial-scale=1.0,minimum-scale=1.0,maximum-scale=1.0,user-scalable=no" />
    // width    设置viewport宽度,为一个正整数,或字符串‘device-width’
    // device-width  设备宽度
    // height   设置viewport高度,一般设置了宽度,会自动解析出高度,可以不用设置
    // initial-scale    默认缩放比例(初始缩放比例),为一个数字,可以带小数
    // minimum-scale    允许用户最小缩放比例,为一个数字,可以带小数
    // maximum-scale    允许用户最大缩放比例,为一个数字,可以带小数
    // user-scalable    是否允许手动缩放
- 延伸提问
- 怎样处理 移动端
1px被 渲染成2px问题
- 怎样处理 移动端
局部处理
meta标签中的viewport属性 ,initial-scale设置为1rem按照设计稿标准走,外加利用transform的scale(0.5)缩小一倍即可;
全局处理
mate标签中的viewport属性 ,initial-scale设置为0.5rem按照设计稿标准走即可
💬 面试官追问
viewport的width写成了固定的750,横竖屏布局都不对,怎么改?改成
width=device-width,让布局视口跟着设备走。固定750等于让浏览器按750px布局再缩放,屏幕一换宽度比例就乱了。适配设计稿该交给rem或vw,别在viewport上动手。产品要求禁止双指缩放,你会照做吗?
我会先劝掉,禁止缩放对视力不好的用户很不友好,而且
iOS 10之后Safari默认忽略user-scalable=no,写了也拦不住。如果真正想防的是双击放大或者300ms点击延迟,用touch-action: manipulation就够了。1px边框在高清屏上看起来像2px,只改这个组件怎么处理?用伪元素画线再缩放:
::after写height: 1px加transform: scaleY(0.5),套在@media (min-resolution: 2dppx)里。现在大部分机型也直接支持border-width: 0.5px,可以先试这个。用
initial-scale=0.5一刀切解决全站1px,能直接上吗?不能直接上。改
initial-scale是全局行为,整个页面的尺寸体系都变了,旧页面的rem基准得跟着按dpr重算,这就是当年lib-flexible的做法,它自己后来也不推荐了。已有大量页面时,局部用伪元素处理风险小得多。刘海屏上底部按钮被小黑条挡住了,怎么处理?
viewport里加viewport-fit=cover,按钮容器写padding-bottom: env(safe-area-inset-bottom)。不加viewport-fit=cover的话env()取到的是0,很多人卡在这一步。
# 3 性能优化
⚡ 30 秒速记
- 普通
<script>会卡住HTML解析:下载 + 执行完才继续往下解析 defer:并行下载,HTML解析完按顺序执行(首选);async:下载完立刻执行,顺序不保证,适合统计这类独立脚本;type="module"默认就是defer- 资源提示:
dns-prefetch只解析域名,preconnect再加TCP+TLS,preload本页关键资源高优先级下载,prefetch下一页可能用的、空闲时低优先级下载 preload要配as属性,下载了3秒内没用上Chrome会报警告- 图片写
width/height、首屏图别loading="lazy",不然CLS和LCP都难看
HTML 层面能做的优化,主要就两件事:别让脚本卡住解析,以及把关键资源的连接和下载提前。 普通 script 会让解析停下来等下载和执行,所以我默认都写 defer,它并行下载、等文档解析完再按顺序执行;统计、广告这类不依赖别人的脚本用 async。资源提示按力度从轻到重是 dns-prefetch、preconnect、prefetch、preload:首屏字体在别的 CDN 上就 preconnect,首屏一定要用的字体或大图用 preload。但 preload 别滥用,加多了反而跟真正关键的请求抢带宽。
性能优化是前端开发中避不开的问题,
性能问题无外乎两方面原因:渲染速度慢、请求时间长。性能优化虽然涉及很多复杂的原因和解决方案,但其实只要通过合理地使用标签,就可以在一定程度上提升渲染速度以及减少请求时间
1. script 标签:调整加载顺序提升渲染速度
- 由于浏览器的底层运行机制,
渲染引擎在解析 HTML 时,若遇到 script 标签引用文件,则会暂停解析过程,同时通知网络线程加载文件,文件加载后会切换至 JavaScript 引擎来执行对应代码,代码执行完成之后切换至渲染引擎继续渲染页面。 - 在这一过程中可以看到,
页面渲染过程中包含了请求文件以及执行文件的时间,但页面的首次渲染可能并不依赖这些文件,这些请求和执行文件的动作反而延长了用户看到页面的时间,从而降低了用户体验。
为了减少这些时间损耗,可以借助 script 标签的 3 个属性来实现。
async 属性。立即请求文件,但不阻塞渲染引擎,而是文件加载完毕后阻塞渲染引擎并立即执行文件内容defer 属性。立即请求文件,但不阻塞渲染引擎,等到解析完 HTML 之后再执行文件内容- HTML5 标准 type 属性,对应值为“module”。让浏览器按照 ECMA Script 6 标准将文件当作模块进行解析,默认阻塞效果同 defer,也可以配合 async 在请求完成后立即执行。
绿色的线表示执行解析 HTML ,蓝色的线表示请求文件,红色的线表示执行文件
当渲染引擎解析 HTML 遇到 script 标签引入文件时,会立即进行一次渲染。所以这也就是为什么构建工具会把编译好的引用 JavaScript 代码的 script 标签放入到 body 标签底部,因为当渲染引擎执行到 body 底部时会先将已解析的内容渲染出来,然后再去请求相应的 JavaScript 文件
2. link 标签:通过预处理提升渲染速度
在我们对大型单页应用进行性能优化时,也许会用到按需懒加载的方式,来加载对应的模块,但如果能合理利用 link 标签的 rel 属性值来进行预加载,就能进一步提升渲染速度。
dns-prefetch。当link标签的rel属性值为“dns-prefetch”时,浏览器会对某个域名预先进行 DNS 解析并缓存。这样,当浏览器在请求同域名资源的时候,能省去从域名查询 IP 的过程,从而减少时间损耗。下图是淘宝网设置的 DNS 预解析![]()
preconnect。让浏览器在一个 HTTP 请求正式发给服务器前预先执行一些操作,这包括DNS 解析、TLS 协商、TCP 握手,通过消除往返延迟来为用户节省时间prefetch/preload。两个值都是让浏览器预先下载并缓存某个资源,但不同的是,prefetch 可能会在浏览器忙时被忽略,而preload 则是一定会被预先下载。prerender。浏览器不仅会加载资源,还会解析执行页面,进行预渲染
这几个属性值恰好反映了浏览器获取资源文件的过程,在这里我绘制了一个流程简图,方便你记忆。
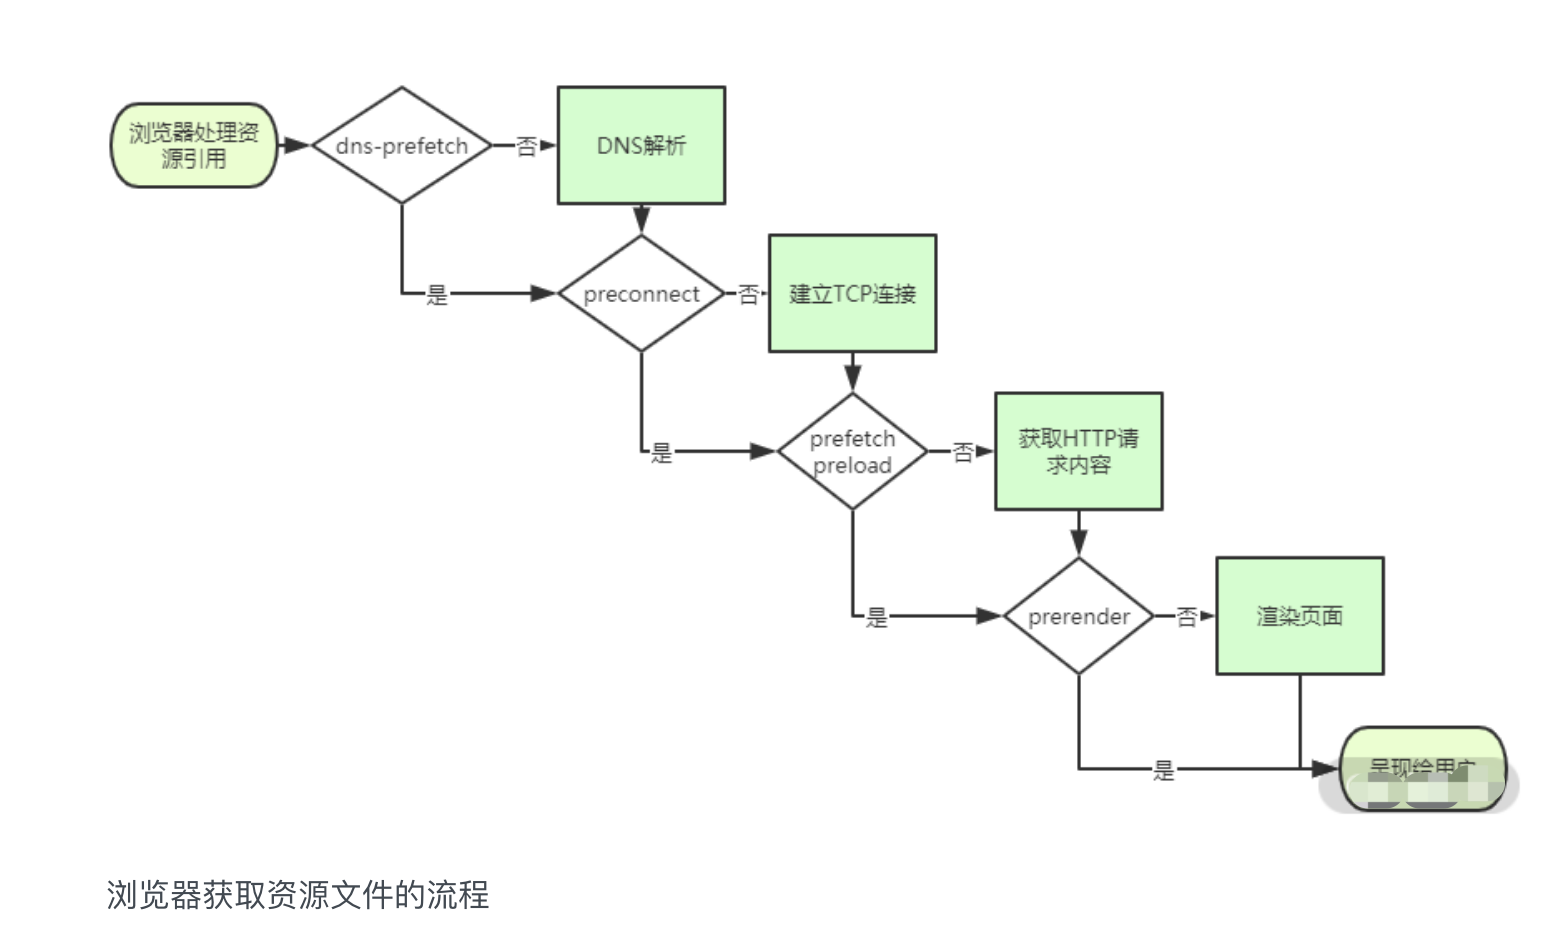
3. 搜索优化
- meta 标签:提取关键信息
- 通过 meta 标签可以设置页面的描述信息,从而让搜索引擎更好地展示搜索结果。
- 示例
<meta name="description" content="全球最大的中文搜索引擎、致力于让网民更便捷地获取信息,找到所求。百度超过千亿的中文网页数据库,可以瞬间找到相关的搜索结果。">
💬 面试官追问
统计脚本放在
<head>里,网络慢时正文半天出不来,为什么?解析器遇到普通外链
script会停下来,等它下载完、执行完才接着解析后面的HTML。统计脚本跟首屏无关,加async就行,或者放到页面加载完再插入。两个有依赖关系的脚本,要不阻塞解析还得按顺序执行,用
async还是defer?defer。它保证按文档里的顺序执行,而且在DOMContentLoaded之前跑完。async谁先下载完谁先执行,依赖关系会偶发出错,而且本地网络快时很难复现。<script type="module">又加了async,结果访问节点报错,为什么?模块脚本默认就是
defer的行为,加了async就变成下载完立刻执行,HTML可能还没解析到那个节点。入口依赖DOM就别加async。首屏字体在单独的
CDN域名,耗时主要卡在建连和TLS,用哪个提示?用
preconnect,它把DNS、TCP握手、TLS协商都提前做了;dns-prefetch只做第一步。字体请求是匿名跨域的,记得写<link rel="preconnect" href="https://cdn.xx.com" crossorigin>,不加crossorigin建的连接用不上。下一页的资源用了
prefetch,有时进页面还是现下载,要不要全改preload?不要。
prefetch是低优先级的,浏览器忙或者省流模式下可能不下,本来就不保证。preload是给本页关键资源用的,拿来预取下一页会跟首屏抢带宽。真想提前准备好,可以在用户hover链接时再去import()对应的代码块。
# 4 如何高效操作DOM
⚡ 30 秒速记
- 慢在两处:
JS调DOM接口要穿过引擎和渲染引擎的绑定层,每次都有开销;改动引发的样式计算、重排、重绘才是大头 - 循环外缓存节点引用,别每轮
document.querySelector一次 - 批量插入用
DocumentFragment,或者拼好字符串一次innerHTML(内容要转义) - 读写分离:先集中读
offsetHeight这类布局属性,再集中写,避免强制同步布局 - 改样式切
class;数量上万的列表上虚拟滚动;事件用委托
DOM 操作慢,一部分是 JS 每次调 DOM 接口都要过一层绑定,更大的部分是改动之后浏览器要重新算样式、布局和绘制。 所以思路就是少碰、批量碰:节点引用在循环外缓存好,一千条数据先拼进 DocumentFragment 再一次 appendChild,样式改动收成切一个 class。最隐蔽的是读写交错,循环里写完 style.height 马上读 offsetHeight,浏览器每次都得立刻重算布局。数据量到几万条时,再怎么批量插入也扛不住,这时候该上虚拟列表,只渲染可视区那几十个节点。
1. 为什么说 DOM 操作耗时
1.1 线程切换
- 浏览器为了避免两个引擎同时修改页面而造成渲染结果不一致的情况,增加了另外一个机制,这
两个引擎具有互斥性,也就是说在某个时刻只有一个引擎在运行,另一个引擎会被阻塞。操作系统在进行线程切换的时候需要保存上一个线程执行时的状态信息并读取下一个线程的状态信息,俗称上下文切换。而这个操作相对而言是比较耗时的 - 每次 DOM 操作就会引发线程的上下文切换——从 JavaScript 引擎切换到渲染引擎执行对应操作,然后再切换回 JavaScript 引擎继续执行,这就带来了性能损耗。单次切换消耗的时间是非常少的,但是如果频繁地大量切换,那么就会产生性能问题
比如下面的测试代码,循环读取一百万次 DOM 中的 body 元素的耗时是读取 JSON 对象耗时的 10 倍。
// 测试次数:一百万次
const times = 1000000
// 缓存body元素
console.time('object')
let body = document.body
// 循环赋值对象作为对照参考
for(let i=0;i<times;i++) {
  let tmp = body
}
console.timeEnd('object')// object: 1.77197265625ms

console.time('dom')
// 循环读取body元素引发线程切换
for(let i=0;i<times;i++) {
  let tmp = document.body
}
console.timeEnd('dom')// dom: 18.302001953125ms
1.2 重新渲染
另一个更加耗时的因素是元素及样式变化引起的再次渲染,在渲染过程中最耗时的两个步骤为重排(Reflow)与重绘(Repaint)。
浏览器在渲染页面时会将 HTML 和 CSS 分别解析成 DOM 树和 CSSOM 树,然后合并进行排布,再绘制成我们可见的页面。如果在操作 DOM 时涉及到元素、样式的修改,就会引起渲染引擎重新计算样式生成 CSSOM 树,同时还有可能触发对元素的重新排布和重新绘制
- 可能会影响到其他元素排布的操作就会引起重排,继而引发重绘
- 修改元素边距、大小
- 添加、删除元素
- 改变窗口大小
- 引起重绘
- 设置背景图片
- 修改字体颜色
- 改变
visibility属性值
了解更多关于重绘和重排的样式属性,可以参看这个网址:https://csstriggers.com/ (opens new window)。
2. 如何高效操作 DOM
明白了 DOM 操作耗时之后,要提升性能就变得很简单了,反其道而行之,减少这些操作即可
2.1 在循环外操作元素
比如下面两段测试代码对比了读取 1000 次 JSON 对象以及访问 1000 次 body 元素的耗时差异,相差一个数量级
const times = 10000;
console.time('switch')
for (let i = 0; i < times; i++) {
  document.body === 1 ? console.log(1) : void 0;
}
console.timeEnd('switch') // 1.873046875ms
var body = JSON.stringify(document.body)
console.time('batch')
for (let i = 0; i < times; i++) {
  body === 1 ? console.log(1) : void 0;
}
console.timeEnd('batch') // 0.846923828125ms
2.2 批量操作元素
比如说要创建 1 万个 div 元素,在循环中直接创建再添加到父元素上耗时会非常多。如果采用字符串拼接的形式,先将 1 万个 div 元素的 html 字符串拼接成一个完整字符串,然后赋值给 body 元素的 innerHTML 属性就可以明显减少耗时
const times = 10000;
console.time('createElement')
for (let i = 0; i < times; i++) {
const div = document.createElement('div')
document.body.appendChild(div)
}
console.timeEnd('createElement')// 54.964111328125ms
console.time('innerHTML')
let html=''
for (let i = 0; i < times; i++) {
html+='<div></div>'
}
document.body.innerHTML += html // 31.919921875ms
console.timeEnd('innerHTML')
💬 面试官追问
循环一万次读
document.body,没改任何东西,为什么比读普通变量慢一个数量级?每次访问
DOM属性都要从JS引擎穿过绑定层调到C++实现,比读一个普通变量的开销大得多。这不是什么线程切换,JS和渲染本来就在同一个主线程上,就是跨层调用的成本。缓存成const body = document.body就好了。一千张卡片,循环里先读
offsetHeight再写style.height,滚动时很卡,怎么改?典型的布局抖动,每一轮的读都逼浏览器把上一轮的写立刻算掉。拆成两个循环:先
const hs = cards.map(c => c.offsetHeight)全部读完,再统一写,写的部分放进requestAnimationFrame。一次追加一万行
<tr>,循环appendChild和拼字符串innerHTML选哪个?都比逐个插到页面上强,关键是只提交一次。纯展示、数据可信就拼字符串;要保留节点引用或者逐行绑东西,就先
appendChild到DocumentFragment再一次挂上去。数据里有用户输入时,拼字符串前一定要转义,不然就是XSS。只改了文字颜色,同事说触发了重排,对吗?
一般不对,颜色只触发重绘,不改几何信息。要确认就看
Performance面板里这次交互有没有紫色的Layout块;如果有,多半是同一段代码里还读了布局属性或者改了尺寸。消息列表涨到十万条,已经批量插入了还是慢,继续优化
innerHTML有用吗?没用了,瓶颈是节点总数,十万个节点样式计算和布局都很重。换虚拟列表,只渲染可视区附近的几十条,比如
react-window、vue-virtual-scroller。代价是高度不固定、滚动定位、页内搜索这些都要额外处理。
# 三、CSS基础
# 1 盒模型
⚡ 30 秒速记
- 四层由内到外:
content→padding→border→margin - 默认
content-box:width只管内容区,占位宽 =width+ 左右padding+ 左右border border-box:width已含padding和border,写多少就是多少(老IE怪异模式就是这种算法)margin两种模式下都在width之外- 项目里基本全局设
border-box:html { box-sizing: border-box } *, *::before, *::after { box-sizing: inherit }
盒模型就是一个元素从里到外的四层:内容、内边距、边框、外边距,box-sizing 决定你写的 width 管到哪一层。 默认的 content-box 里 width 只管内容区,比如 width: 200px 加左右 12px 内边距和 1px 边框,实际占 226px。换成 border-box,width 就包含了内边距和边框,写 200px 就占 200px,加 padding 也不会把布局撑破。所以我建项目时都会全局设成 border-box。不管哪种模式,margin 都在外面另算。
content(元素内容) + padding(内边距) + border(边框) + margin(外边距)
延伸:box-sizing
content-box:默认值,总宽度 =margin+border+padding+widthborder-box:盒子宽度包含padding和border,总宽度 = margin + widthinherit:从父元素继承box-sizing属性
💬 面试官追问
输入框写了
width: 200px; padding: 0 12px; border: 1px solid,量出来226px,为什么?默认
content-box下200px只是内容区,再加左右24px内边距和2px边框就是226px。加一句box-sizing: border-box就回到200px。全局设
border-box时为什么要把::before、::after也写上?*选择器选不到伪元素,伪元素带了padding或border时还是按content-box算,图标、角标会莫名大一圈。用inherit写法还有个好处,某个第三方组件需要content-box时,给它的根节点改一下,整棵子树就跟着变了。侧栏
width: 100%还带着左右margin,切成border-box能不溢出吗?不能,
border-box只把padding和border算进去,margin照样在外面。改成width: calc(100% - 32px),或者干脆去掉width,块级元素默认就会自动填满并扣掉margin。卡片
width: 320px,DevTools里内容区显示只有280px,浏览器算错了?没错,看一下
Computed里的box-sizing,是border-box的话320px是边框盒的宽度,内容区要扣掉左右padding和border。DevTools底部那个盒模型图会把每层都标出来,对一下就清楚了。JS里读宽度,offsetWidth和clientWidth差在哪?offsetWidth包含border和滚动条,clientWidth只有内容加padding,两者都不含margin。要带小数的精确值用getBoundingClientRect().width,它还会算上transform缩放后的结果。
# 2 BFC
⚡ 30 秒速记
BFC= 块级格式化上下文,一块独立的布局区域,里面的布局不影响外面- 三个用途:包住浮动子元素(清浮动)、不和外部浮动元素重叠(自适应两栏)、隔开外边距合并
- 常见触发:根元素、
float非none、position: absolute / fixed、overflow非visible、display: flow-root / inline-block / table-cell flex/grid容器的子项也会建立独立的格式化上下文,所以子项之间外边距不合并- 只想要个干净的
BFC就用display: flow-root,overflow: hidden会顺带裁剪内容
BFC 可以理解成一个隔离的布局小房间,房间里怎么排都不会影响外面。 它有三条规则特别实用:算高度时会把浮动子元素算进去,所以能解决父元素高度塌陷;它的区域不会和外面的浮动元素重叠,所以左边浮动、右边建个 BFC 就是自适应两栏;外边距合并只发生在同一个 BFC 里,分到不同的 BFC 就不合并了。以前大家习惯用 overflow: hidden 触发,但它会把阴影、下拉菜单一起切掉,现在我一般直接写 display: flow-root。
块级格式化上下文,是一个独立的渲染区域,让处于
BFC内部的元素与外部的元素相互隔离,使内外元素的定位不会相互影响。
IE下为
Layout,可通过zoom:1触发
触发条件:
- 根元素
position: absolute/fixeddisplay: inline-block / tablefloat元素ovevflow !== visible
规则:
- 属于同一个
BFC的两个相邻Box垂直排列 - 属于同一个
BFC的两个相邻Box的margin会发生重叠 BFC中子元素的margin box的左边, 与包含块 (BFC)border box的左边相接触 (子元素absolute除外)BFC的区域不会与float的元素区域重叠- 计算
BFC的高度时,浮动子元素也参与计算 - 文字层不会被浮动层覆盖,环绕于周围
应用:
- 阻止
margin重叠 - 可以包含浮动元素 —— 清除内部浮动(清除浮动的原理是两个
div都位于同一个BFC区域之中) - 自适应两栏布局
- 可以阻止元素被浮动元素覆盖
💬 面试官追问
两个卡片一个
margin-bottom: 20px、一个margin-top: 30px,间距只有30px,为什么?同一个
BFC里相邻块的垂直外边距会合并,取大的那个。想要50px最省事的是只让一边负责间距,比如团队约定只写margin-bottom,或者父级用flex加gap,没必要专门造BFC。父容器里全是浮动卡片,高度变成
0,页脚顶上来了,怎么办?给父容器写
display: flow-root,它建立BFC后算高度会把浮动子元素算进去。要兼容很老的浏览器就用::after的clearfix。当然新代码直接用flex或grid布局,就不会有这个问题。左边头像
float: left,右边正文的背景钻到头像底下了,怎么改?给右边正文建
BFC,比如display: flow-root。BFC不和浮动区域重叠,正文会自动缩到剩下的宽度,不用写死margin-left,头像尺寸变了也不用跟着改。下拉菜单被切掉一半,发现祖先为了清浮动写了
overflow: hidden,怎么改?先在
DevTools里把那条overflow关掉,菜单出来了、父容器又塌了,就确认是它。换成display: flow-root,只建BFC不裁剪。父元素里第一个子元素的
margin-top跑到父元素外面去了,为什么?这是父子外边距合并:父元素没有
border、padding,也没建BFC时,子元素的上外边距会和父元素的合到一起,表现在父元素外面。给父元素display: flow-root或者加padding-top: 1px都能隔开。
# 3 层叠上下文
⚡ 30 秒速记
z-index只在同一个层叠上下文里比大小,子元素永远出不了父级上下文- 创建条件:根元素、
position: relative / absolute且z-index非auto、fixed/sticky、flex/grid子项且z-index非auto、opacity < 1、transform、filter、will-change、isolation: isolate - 同一上下文里从下到上:背景边框 → 负
z-index→ 块级 → 浮动 → 行内 →z-index: 0/auto的定位元素 → 正z-index - 高频坑:祖先加了
transform或opacity: 0.99,弹窗z-index: 9999也压不过祖先的兄弟 transform祖先还会让里面的position: fixed改成相对这个祖先定位;弹层最稳的做法是挂到body下
z-index 不是全局排名,只在同一个层叠上下文里比大小。 打个比方,层叠上下文像一个文件夹,文件夹之间先排顺序,里面的文件再怎么编号也跳不出自己的文件夹。所以弹窗写了 z-index: 9999 还被导航盖住,多半是它的某个祖先因为 transform、opacity、filter 之类建了新的上下文,而这个祖先整体排在导航下面。遇到这种问题我先从弹窗往上翻祖先的样式找「是谁建的上下文」,长期方案是用 Portal 把弹层挂到 body 下面。
元素提升为一个比较特殊的图层,在三维空间中 (z轴) 高出普通元素一等。
触发条件
- 根层叠上下文(
html) positioncss3属性flextransformopacityfilterwill-changewebkit-overflow-scrolling
层叠等级:层叠上下文在z轴上的排序
- 在同一层叠上下文中,层叠等级才有意义
z-index的优先级最高
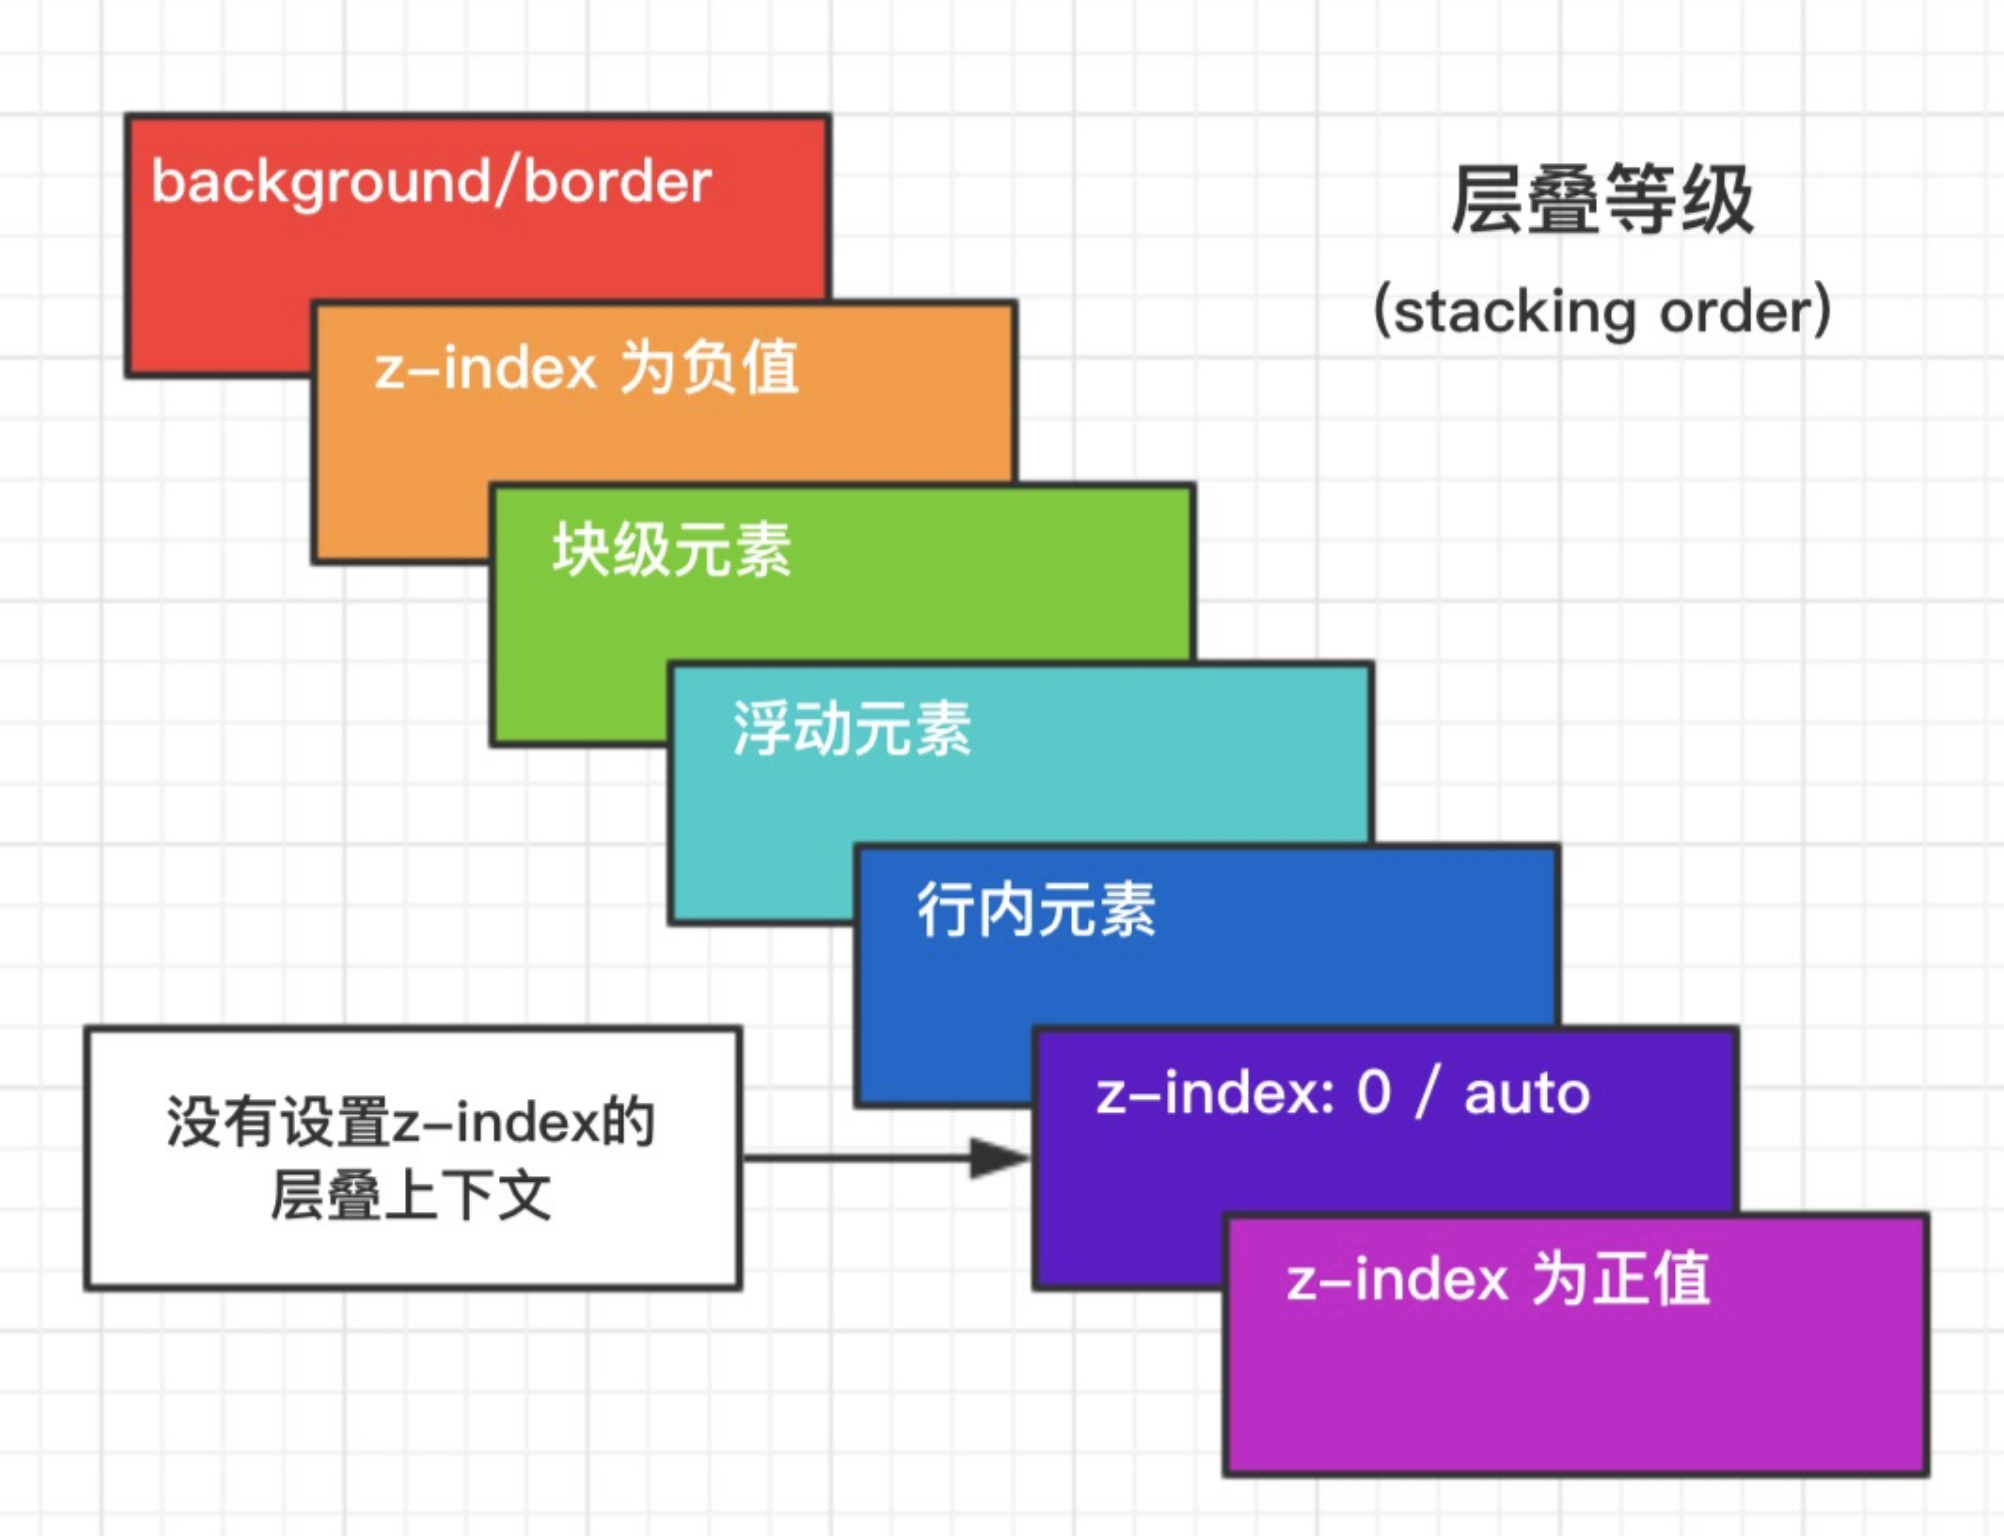
一个最小复现
<style>
.nav { position: relative; z-index: 10; }
.card { transform: translateZ(0); } /* 建了层叠上下文,z-index 相当于 0 */
.modal { position: fixed; inset: 0; z-index: 9999; }
</style>
<div class="nav">导航</div>
<div class="card">
<div class="modal">弹窗</div>
</div>
<!-- 结果:弹窗被导航盖住 -->
.card 因为 transform 自己成了一个层叠上下文,在根上下文里它的层级相当于 0,而 .nav 是 10。.modal 的 9999 只在 .card 内部比较,整体上还是 0 < 10,所以输给了导航。另外 .card 有 transform,.modal 的 position: fixed 也不再相对视口,而是相对 .card 定位,inset: 0 只能铺满卡片。
修法
- 去掉
.card上不必要的transform。 - 把弹窗挂到
body下:React用createPortal(modal, document.body),Vue 3用<Teleport to="body">。 - 只想隔离组件内部层级时用
isolation: isolate,副作用最小。
排查口诀:从被遮挡的元素往上逐级看 Computed 样式,找到第一个建了层叠上下文的祖先,再拿这个祖先去和遮挡它的元素(或者对方所在的上下文)比较。
💬 面试官追问
弹窗
position: fixed; z-index: 9999,还是被z-index: 10的导航盖住,为什么?弹窗的某个祖先建了层叠上下文,而且这个祖先排在导航下面,
9999只在祖先内部有效。往上找带transform、opacity、filter、will-change或者「定位 +z-index」的祖先,最稳的是把弹窗用createPortal挂到body。给外壳加了
transform: translateZ(0)开硬件加速,里面的气泡就被旁边卡片挡住了,怎么办?transform建了新的层叠上下文,气泡被关在里面了。能去掉就去掉,动画结束后移除transform;去不掉就把气泡挂到外层。顺带一提,transform还会让里面fixed的元素改为相对这个外壳定位。半透明容器
opacity: 0.9,里面的下拉层又要盖过顶栏,怎么同时满足?opacity作用在祖先上就一定会建上下文。把半透明效果挪到一个单独的背景层,比如用伪元素或者background: rgba(...),承载下拉层的那个容器本身不加opacity。只是想让组件内部的
z-index不影响外面,最干净的写法是什么?isolation: isolate。它专门用来建层叠上下文,没有transform、opacity那些视觉副作用,组件库里很好用,内部随便写z-index都不会跟外面打架。团队打算建
z-index规范,弹窗统一999999,能根治遮挡吗?不能,数字再大也突破不了祖先上下文。真正有用的是规定挂载位置:遮罩、弹窗、
Toast都挂到body下的统一容器里,再分配几档有限的层级,比如100/200/300。
# 4 左右居中方案
⚡ 30 秒速记
- 行内 / 行内块:父元素
text-align: center - 定宽块级:
margin: 0 auto(宽度没定的块级元素会占满整行,看不出居中) flex:父元素display: flex; justify-content: center,现在的首选grid:父元素display: grid; justify-items: center,或者place-items: center连垂直一起- 绝对定位:
left: 50%; transform: translateX(-50%),不用知道宽度,但会建层叠上下文
左右居中先看元素类型:行内内容用父元素的 text-align: center,定宽块级用 margin: 0 auto,其他情况基本 flex 一把梭。 text-align 要写在父元素上,它管的是里面行内内容怎么对齐。margin: 0 auto 之所以要定宽,是因为块级元素默认占满整行,左右没有剩余空间可分;也可以用 width: fit-content 让它收缩到内容宽度再居中。绝对定位的元素用 left: 50% 加 translateX(-50%),宽度变了也不用改,但别忘了 transform 会建层叠上下文。
- 行内元素:
text-align: center - 定宽块状元素: 左右
margin值为auto - 不定宽块状元素:
table布局,position + transform
/* 方案1 */
.wrap {
text-align: center
}
.center {
display: inline;
/* or */
/* display: inline-block; */
}
/* 方案2 */
.center {
width: 100px;
margin: 0 auto;
}
/* 方案2 */
.wrap {
position: relative;
}
.center {
position: absulote;
left: 50%;
transform: translateX(-50%);
}
💬 面试官追问
给一个
span写了margin: 0 auto,为什么没居中?行内元素的水平
margin: auto不生效,它也没有独立的宽度可言。在父元素上写text-align: center,或者把它改成display: block; width: fit-content再用margin: 0 auto。宽度随文案变化的按钮组,父容器又不能改成
flex,怎么居中?给按钮组
width: fit-content; margin: 0 auto,或者display: table; margin: 0 auto,都会收缩到内容宽度再居中。也可以按钮组设成inline-block,父元素text-align: center。角标写了
position: absolute; left: 50%,总是往右偏一点,为什么?left: 50%是把角标的左边缘放到中线,不是中心,所以偏了半个自身宽度。补上transform: translateX(-50%),这个百分比是按元素自己的宽度算的,宽度变了也不用改。一个
320px的表单要居中,用flex还是margin: 0 auto?只居中这一个块,
margin: 0 auto就够了,不用改父级的布局模式。父级本来就要排多个子项时再上flex。窄屏要防溢出的话写max-width: 320px而不是width。用
transform居中后,内部提示层的z-index压不过隔壁了,怎么办?transform建了层叠上下文,提示层被关在里面了。能用flex或margin: auto居中就别用transform;必须绝对定位时,可以用inset: 0; margin: auto加固定宽度来居中,不会建上下文。
# 5 上下垂直居中方案
⚡ 30 秒速记
flex:父元素display: flex; align-items: center,首选grid:父元素display: grid; place-items: center,水平垂直一行搞定- 绝对定位:
top: 50%; transform: translateY(-50%),不用知道高度;定高时也可以margin-top负一半高度 - 单行文字:
line-height等于容器高度,多行就会溢出 - 居中的前提是父元素有高度,父元素被内容撑开时怎么写都看不出效果
垂直居中现在基本都用 flex 或 grid,父元素 display: flex; align-items: center 就行,不用管子元素多高。 老办法要分定高和不定高:定高可以 top: 50% 再用负 margin 回退一半高度,不定高就用 transform: translateY(-50%),百分比按元素自身高度算。单行文字可以让 line-height 等于容器高度,但文案一换行就崩。踩得最多的坑反而不是写法,而是父元素压根没有高度,高度由内容撑开,自然也就没有「中间」可言。
- 定高:
margin,position + margin(负值) - 不定高:
position+transform,flex,IFC + vertical-align:middle
/* 定高方案1 */
.center {
height: 100px;
margin: 50px 0;
}
/* 定高方案2 */
.center {
height: 100px;
position: absolute;
top: 50%;
margin-top: -25px;
}
/* 不定高方案1 */
.center {
position: absolute;
top: 50%;
transform: translateY(-50%);
}
/* 不定高方案2 */
.wrap {
display: flex;
align-items: center;
}
.center {
width: 100%;
}
/* 不定高方案3 */
/* 设置 inline-block 则会在外层产生 IFC,高度设为 100% 撑开 wrap 的高度 */
.wrap::before {
content: '';
height: 100%;
display: inline-block;
vertical-align: middle;
}
.wrap {
text-align: center;
}
.center {
display: inline-block;
vertical-align: middle;
}
💬 面试官追问
弹窗用
top: 50%; margin-top: -150px居中,内容一长就往上偏,怎么改?负
margin是按300px高写死的,内容高度变了就不对了。改成transform: translate(-50%, -50%)配合top/left都是50%,按实际尺寸算。内容可能超过一屏时,再加max-height: 90vh; overflow: auto。空状态写了
display: flex; align-items: center,还是贴在顶部,为什么?父元素没有高度,被内容撑开,交叉轴上没有剩余空间可分。给它一个明确的高度,比如
min-height: 300px,或者让它被上层flex拉伸占满。也检查一下空状态是不是这个容器的直接子元素。按钮里文字用
line-height居中,运营改成两行后溢出了,怎么改?line-height法只对单行有效,两行就是两倍高度。按钮改成display: inline-flex; align-items: center加min-height,文字几行都能居中。flex子元素写了margin: auto会怎样?在
flex容器里,margin: auto会吃掉所有剩余空间,四个方向都是auto就是水平垂直居中,比justify-content加align-items还短。只写margin-left: auto就是把它推到最右边,导航栏右侧按钮常这么写。只能用老写法、父元素高度固定,怎么让不定高的块垂直居中?
父元素加一个
::before,设成inline-block、height: 100%、vertical-align: middle,子元素也设成inline-block加vertical-align: middle。注意模板里两个inline-block之间的换行会产生一个空格的间隙。
# 6 选择器权重计算方式
⚡ 30 秒速记
- 权重是
(a, b, c)三元组:a=id个数,b= 类 / 属性 / 伪类个数,c= 元素 / 伪元素个数 - 从左往右逐位比,高位赢了就结束,不进位:
20个类也赢不了1个id - 更上层:
!important> 内联style> 普通选择器;继承来的值优先级最低,比*还低 - 权重完全相同时后写的赢;有
@layer时先比层,后声明的层赢(!important时反过来) :is()/:not()/:has()取参数里最高的那个,:where()恒为0;*和>、+、~这些组合符都不算
选择器权重可以记成三位数 (id, 类, 元素),从左往右比,高位大的直接赢。 比如 #nav a 是 (1, 0, 1),.menu .item a 是 (0, 2, 1),前者赢,因为第一位就分出胜负了,类再多也不会进位。在这之上还有两层:内联 style 高于所有选择器,!important 又高于内联。权重相同时才看先后,后写的覆盖先写的。我写组件库时会用 :where() 包住默认样式,权重是 0,业务方写一个类就能覆盖,不用跟它比谁的选择器长。
!important > 内联样式 > ID选择器 > 类选择器 = 伪类选择器 = 属性选择器 > 元素选择器 = 伪元素选择器 > 通配选择器 = 后代选择器 = 兄弟选择器
- 属性后面加
!important会覆盖页面内任何位置定义的元素样式 - 作为
style属性写在元素内的样式 id选择器- 类选择器
- 标签选择器
- 通配符选择器(
*) - 浏览器自定义或继承
同一级别:后写的会覆盖先写的
css选择器的解析原则:选择器定位DOM元素是从右往左的方向,这样可以尽早的过滤掉一些不必要的样式规则和元素
常见写法的权重
| 选择器 | 权重 (a, b, c) |
|---|---|
h2 | (0, 0, 1) |
.title | (0, 1, 0) |
ul li.active | (0, 1, 2) |
a:hover | (0, 1, 1) |
input[type="text"] | (0, 1, 1) |
#nav .item | (1, 1, 0) |
:is(#a, .b) p | (1, 0, 1),取参数里最高的 #a |
:where(#a, .b) p | (0, 0, 1) |
内联 style 高于所有外部或 <style> 里的选择器规则,跟写在哪个文件没关系。<link> 引入的样式和 <style> 标签里的样式是同一级,按出现顺序决定。
完整的比较顺序是:
- 来源和
!important:带!important的声明赢普通声明。 @layer:普通声明里,后声明的层赢,没放进任何层的样式最高;!important时顺序反过来。- 内联
style。 - 选择器权重
(a, b, c)。 - 源码顺序,后写的赢。
继承不参与上面的比较,只要元素有任何直接命中的声明,继承值就不生效。
#nav a { color: red; } /* (1, 0, 1) */
.menu .item a { color: blue; } /* (0, 2, 1) */
/* 结果是红色:第一位 1 > 0,后面不用比了 */
💬 面试官追问
.dialog .title写在前面,后面的h2怎么也盖不住它,不是后写的赢吗?后写的赢只在权重相同时成立。
.dialog .title是(0, 2, 0),h2是(0, 0, 1),第二位就分出胜负了,跟顺序没关系。主题样式盖不住元素上的
style="color:red",再加三个类名行吗?不行,类名加多少都盖不过内联样式,它在选择器权重之上。正解是去掉生成内联样式的那段代码;实在动不了才用
!important,并且写注释说明原因。两条规则都是
.panel .button,一条来自主题包一条来自业务包,谁赢?权重一样就看最终加载顺序,后出现的赢。打包后
CSS的注入顺序可能跟你以为的不一样,尤其是按需加载的组件样式,直接在DevTools的Styles里看哪条被划掉了。想把顺序固定下来可以用@layer显式声明层级。组件库怎么让业务方容易覆盖默认样式,又不用
!important?默认样式用
:where(.btn)包起来,权重为0,业务写一个.my-btn就能覆盖。或者把组件库样式放进@layer components,没进层的业务样式天然比所有层都高。继承来的颜色和
* { color: black },谁的优先级高?*赢。*权重虽然是(0, 0, 0),但它是直接命中这个元素的声明,继承值只在元素没有任何直接声明时才生效。所以全局写* { color }会让父元素设的文字颜色传不下去。
# 7 清除浮动
⚡ 30 秒速记
- 为什么要清:子元素浮动后脱离文档流,父元素算高度时不算它们,高度塌成
0 - 推荐
clearfix:.clearfix::after { content: ''; display: block; clear: both; } - 或者让父元素建
BFC:display: flow-root最干净;overflow: hidden会裁剪阴影和下拉菜单 - 末尾加空
div写clear: both:能用但污染结构;给父元素写死高度只是掩盖问题 - 今天的真实答案:布局用
flex/grid,压根不会有浮动塌陷;float只留给文字环绕图片
清除浮动就是让父元素重新把浮动的子元素包住,不然父元素高度会塌成 0,后面的内容顶上来。 原理有两种:一种是在浮动元素后面放一个 clear: both 的块,clearfix 就是用 ::after 伪元素干这件事,不用加真实标签;另一种是让父元素建 BFC,BFC 算高度时会包含浮动子元素。以前常用 overflow: hidden,但它会把溢出的阴影一起切掉,现在有 display: flow-root 专门干这个。不过说实话,新项目布局都用 flex 和 grid 了,浮动塌陷基本只在老代码里见到。
- 在浮动元素后面添加
clear:both的空div元素
<div class="container">
<div class="left"></div>
<div class="right"></div>
<div style="clear:both"></div>
</div>
- 给父元素添加
overflow:hidden或者auto样式,触发BFC
<div class="container">
<div class="left"></div>
<div class="right"></div>
</div>
.container{
width: 300px;
background-color: #aaa;
overflow:hidden;
zoom:1; /*IE6*/
}
- 使用伪元素,也是在元素末尾添加一个点并带有
clear: both属性的元素实现的。
<div class="container clearfix">
<div class="left"></div>
<div class="right"></div>
</div>
.clearfix{
zoom: 1; /*IE6*/
}
.clearfix:after{
content: ".";
height: 0;
clear: both;
display: block;
visibility: hidden;
}
推荐使用第三种方法,不会在页面新增div,文档结构更加清晰
💬 面试官追问
两栏都
float了,父容器背景没了,同事给父容器写了个固定高度,行吗?不行,内容一变就溢出,只是把问题藏起来了。给父容器加
clearfix或者display: flow-root,高度跟着内容走。.clearfix::after在DevTools里能看到,但父容器还是塌的,查什么?先看有没有
content,没有content伪元素根本不会生成;再看是不是display: block,行内的伪元素clear不生效;最后确认clearfix加在了浮动元素的直接父元素上,加错一层没用。卡片用
overflow: hidden清浮动后,阴影被切掉了,怎么改?overflow: hidden在建BFC的同时也裁剪了溢出内容。换成display: flow-root,或者用clearfix,都不会切阴影。老代码里的
clearfix写着zoom: 1和content: ".",现在还要吗?不用了。
zoom: 1是给IE6/IE7触发hasLayout的,content: "."配height: 0; visibility: hidden是为了兼容更老的浏览器。现在写content: ''; display: block; clear: both三行就够。clear: both加在下一个兄弟元素上,和清除父元素内部浮动是一回事吗?不是。兄弟元素加
clear: both只是让它自己排到浮动元素下面,父元素的高度还是塌的,背景照样没有。要父元素包住浮动,clear的块得在父元素里面的末尾,或者父元素自己建BFC。
# 8 左边定宽,右边自适应方案
⚡ 30 秒速记
- 新项目直接
flex:左flex: 0 0 200px(或width+flex-shrink: 0),右flex: 1; min-width: 0 grid一行搞定:grid-template-columns: 200px 1fr,1fr也有最小内容问题,稳妥写minmax(0, 1fr)- 老页面:左
float: left+ 定宽,右margin-left等于左宽;或者右边display: flow-root建BFC,连margin都不用写 float + calc(100% - 200px)能用,但宽度要写两遍,还得算上padding/border,最容易临界换行- 高频坑:
flex: 1的右栏不写min-width: 0,长表格、长链接会把整个布局撑破
左定宽右自适应,现在我默认用 flex:左边固定宽度不让缩,右边 flex: 1 吃掉剩下的空间。 老项目里还能看到浮动写法,左边 float: left 定宽,右边写同样大小的 margin-left,右栏是普通块级盒子,会自动铺满剩余宽度。另一种是两栏都浮动、右边 calc(100% - 120px),宽度要维护两份,盒模型一算错就掉行,我不太推荐。真正容易出事的是 flex 版右栏忘了 min-width: 0,里面放个宽表格就把页面顶出横向滚动条。
.layout { display: flex; }
.aside { flex: 0 0 200px; } /* 不放大、不缩小、基准 200px */
.main { flex: 1; min-width: 0; } /* 吃剩余空间,允许比内容窄 */
float + margin,float + calc
/* 方案1 */
.left {
width: 120px;
float: left;
}
.right {
margin-left: 120px;
}
/* 方案2 */
.left {
width: 120px;
float: left;
}
.right {
width: calc(100% - 120px);
float: left;
}
💬 面试官追问
右栏也写了
width: 100%,结果整栏掉到左栏下面了,为什么?100%是按父容器的完整宽度算的,不会自动扣掉左边浮动的120px,两栏加起来就超了。右栏去掉width,留着默认的auto,再写margin-left: 120px就行。不想写死
margin-left,侧栏宽度经常改,浮动方案有更省事的吗?给右栏建一个
BFC,比如display: flow-root。BFC区域不会和浮动元素重叠,会自己缩到浮动旁边的剩余空间里,左栏改成多宽右栏都跟着走。用
calc(100% - 120px)的那版,只有带padding的页面会掉行,怎么回事?默认
content-box下width不含padding和border,实际占用比算出来的大几十像素,正好超出一点就换行。给右栏加box-sizing: border-box,或者干脆换成margin-left方案,不用算。flex版右栏里放了一张很宽的表格,左边导航被挤扁了,怎么改?左栏
flex-shrink: 0不让它缩,右栏补min-width: 0,表格外面包一层overflow-x: auto。flex子项默认min-width: auto,不肯缩到内容宽度以下,不写这句右栏就会去挤左栏。grid写200px 1fr,长内容还是把右栏撑宽了,1fr不是自适应吗?1fr的最小值其实是auto,等价于minmax(auto, 1fr),内容有多宽它就至少多宽。改成grid-template-columns: 200px minmax(0, 1fr),道理和flex的min-width: 0一样。
# 9 左右两边定宽,中间自适应
⚡ 30 秒速记
- 新项目首选
flex:两侧flex: 0 0 120px,中间flex: 1; min-width: 0;或者grid-template-columns: 120px 1fr 120px - 浮动版:左
float: left、右float: right,中间margin: 0 120px;中间那个div要写在左右两个后面,否则右栏会掉到下一行 - 左右不对称时
margin-left/margin-right分开写,别套对称值 - 圣杯 / 双飞翼:为了让中间内容在
DOM里最先加载,用负margin把左右拉上来;区别是圣杯靠父容器padding留位,双飞翼靠中间内层div的margin - 这两个布局今天只当历史知识,有
flex/grid就别再手写负margin
左右定宽、中间自适应,新项目我直接 flex:两边固定宽度不缩,中间 flex: 1。 老页面要用浮动的话,左栏左浮、右栏右浮,中间不设宽度,用 margin: 0 120px 把两边让出来。这里有个细节很多人漏掉:浮动元素只会影响它后面的内容,所以中间那块必须写在左右两栏后面,不然右栏会跑到下一行。面试问到圣杯、双飞翼,我会说清它们是为了让主内容在 DOM 里排第一,再补一句现在用 grid 一行就够,order 也能调视觉顺序。
.wrap { display: grid; grid-template-columns: 120px minmax(0, 1fr) 120px; }
float,
float + calc, 圣杯布局(设置BFC,margin负值法),flex
.wrap {
width: 100%;
height: 200px;
}
.wrap > div {
height: 100%;
}
/* 方案1 */
.left {
width: 120px;
float: left;
}
.right {
float: right;
width: 120px;
}
.center {
margin: 0 120px;
}
/* 方案2 */
.left {
width: 120px;
float: left;
}
.right {
float: right;
width: 120px;
}
.center {
width: calc(100% - 240px);
margin-left: 120px;
}
/* 方案3 */
.wrap {
display: flex;
}
.left {
width: 120px;
}
.right {
width: 120px;
}
.center {
flex: 1;
}
💬 面试官追问
浮动三栏,左右都写好了,右栏却掉到中间栏下面,代码顺序是左、中、右,问题在哪?
中间栏是普通块级盒子,会独占一整行,后面的右浮动只能排到它下面去。把
HTML顺序改成左、右、中,让两个浮动先占好位置,中间再用margin让开。右栏改成
160px,左栏还是120px,中间内容被右栏盖住一截,怎么改?中间的
margin: 0 120px是对称值,右边只让了120px。改成margin-left: 120px; margin-right: 160px;用calc的版本也要一起改成扣280px。圣杯布局为什么非要用负
margin,直接按左中右写不行吗?它的出发点是让中间主内容在
DOM里排第一个,先解析先渲染,所以三栏都浮动、中间width: 100%,左右再用负margin拉回同一行。今天用flex或grid配合order就能做到DOM顺序和视觉顺序分开,没必要再写这套。窗口拖到很窄,中间栏宽度变成负数直接没了,怎么兜底?
给容器一个
min-width,比如480px,或者加个媒体查询,窄屏下改成上下堆叠。三栏方案本身没有定义极窄情况,必须自己补一个断点。改成
flex后,中间放了长代码块,右侧固定栏被顶出屏幕,flex: 1不是自适应吗?flex: 1只管分剩余空间,中间项默认min-width: auto,不肯比内容窄。补min-width: 0,代码块自己加overflow-x: auto;两侧再加flex-shrink: 0防止被挤。
# 10 CSS动画和过渡
⚡ 30 秒速记
transition:状态A→B的补间,要有触发(:hover、切class),跑完就停animation+@keyframes:多关键帧、能循环、能自动播放,不需要触发条件- 最容易忘的
animation-fill-mode:forwards停在最后一帧,backwards在delay期间先套第一帧,both两头都管 - 性能:只动
transform和opacity能走合成,跳过布局和绘制;动width/left/top每帧都要重排 - 监听结束用
transitionend/animationend;要尊重prefers-reduced-motion: reduce,给晕动症用户关掉大幅动画
transition 是从一个状态平滑过渡到另一个状态,animation 是按关键帧自己跑的完整动画。 说白了,hover 变色、展开收起这类有明确前后状态的用 transition 就够了;加载转圈、多段弹入、无限循环这种不依赖触发的,用 animation 配 @keyframes。两者都要注意动什么属性,位移用 transform: translateX() 别用 left,显隐用 opacity,这样浏览器可以只做合成。我还踩过一个坑:动画结束后元素跳回原位,就是没写 animation-fill-mode: forwards。
.btn { transition: transform .2s ease; }
.btn:hover { transform: scale(1.05); } /* 有触发才动 */
@keyframes spin { to { transform: rotate(360deg); } }
.loading { animation: spin 1s linear infinite; } /* 自己一直转 */
animation / keyframes
animation-name: 动画名称,对应@keyframesanimation-duration: 间隔animation-timing-function: 曲线animation-delay: 延迟animation-iteration-count: 次数infinite: 循环动画
animation-direction: 方向alternate: 反向播放
animation-fill-mode: 静止模式forwards: 停止时,保留最后一帧backwards: 停止时,回到第一帧both: 同时运用forwards / backwards
- 常用钩子:
animationend
动画属性: 尽量使用动画属性进行动画,能拥有较好的性能表现
translatescalerotateskewopacitycolor
transform
- 位移属性
translate( x , y ) - 旋转属性
rotate() - 缩放属性
scale() - 倾斜属性
skew()
transition
transition-property(过渡的属性的名称)。transition-duration(定义过渡效果花费的时间,默认是0)。transition-timing-function:linear(匀速) ease(慢速开始,然后变快,然后慢速结束)(规定过渡效果的时间曲线,最常用的是这两个)。transition-delay(规定过渡效果何时开始。默认是 0)
般情况下,我们都是写一起的,比如:
transition: width 2s ease 1s
关键帧动画animation
一个关键帧动画,最少包含两部分,animation 属性及属性值(动画的名称和运行方式运行时间等)。@keyframes(规定动画的具体实现过程)
animation 属性可以拆分为
animation-name规定@keyframes 动画的名称。animation-duration规定动画完成一个周期所花费的秒或毫秒。默认是0。animation-timing-function规定动画的速度曲线。默认是 “ease”,常用的还有linear,同transtion。animation-delay规定动画何时开始。默认是 0。animation-iteration-count规定动画被播放的次数。默认是 1,但我们一般用infinite,一直播放
而
@keyframes的使用方法,可以是from->to(等同于0%和100%),也可以是从0%->100%之间任意个的分层设置。我们通过下面一个稍微复杂点的demo来看一下,基本上用到了上面说到的大部分知识
eg:
@keyframes mymove
{
from {top:0px;}
to {top:200px;}
}
/* 等同于: */
@keyframes mymove
{
0% {top:0px;}
25% {top:200px;}
50% {top:100px;}
75% {top:200px;}
100% {top:0px;}
}
用css3动画使一个图片旋转
#loader {
display: block;
position: relative;
-webkit-animation: spin 2s linear infinite;
animation: spin 2s linear infinite;
}
@-webkit-keyframes spin {
0% {
-webkit-transform: rotate(0deg);
-ms-transform: rotate(0deg);
transform: rotate(0deg);
}
100% {
-webkit-transform: rotate(360deg);
-ms-transform: rotate(360deg);
transform: rotate(360deg);
}
}
@keyframes spin {
0% {
-webkit-transform: rotate(0deg);
-ms-transform: rotate(0deg);
transform: rotate(0deg);
}
100% {
-webkit-transform: rotate(360deg);
-ms-transform: rotate(360deg);
transform: rotate(360deg);
}
}
💬 面试官追问
卡片滑入写的是
transition: left 300ms,滚动时一卡一卡的,先改哪?把
left换成transform: translateX(),transition也只过渡transform。改left每一帧都要重新布局,transform一般只在合成阶段处理,主线程忙的时候也不容易掉帧。横幅动画放完突然跳回起点了,
100%那帧明明写的是终点,为什么?animation默认结束后就不再作用,元素回到自己原本的样式。加animation-fill-mode: forwards停在最后一帧;更干净的做法是在animationend里给元素加个终态class。弹窗用
display: none切block加了transition: opacity,淡入完全没效果,为什么?display从none变过来的那一帧元素刚生成,没有「起始状态」可补间。常见做法是一直保留display,用opacity+visibility切换;新一点的浏览器可以用@starting-style配transition-behavior: allow-discrete直接让display参与过渡。加载图标同事用
:hover的transition做旋转,为什么不行?transition要有状态变化才跑,而且只跑一次,没有循环的概念。持续旋转就得@keyframes配animation: spin 1s linear infinite;离开可视区域可以用animation-play-state: paused停掉,省电。想在动画结束后删掉弹窗节点,用
setTimeout(300)还是监听事件?监听
transitionend或animationend,时长改了也不用同步改数字。注意transitionend每个过渡属性都会触发一次,要判断e.propertyName;元素中途被display: none了事件不会来,最好配一个超时兜底。
# 11 CSS3的新特性
⚡ 30 秒速记
- 视觉:
border-radius、box-shadow、text-shadow、渐变、多背景、rgba/hsla - 布局与盒模型:
box-sizing、flex、grid、多列、媒体查询@media(屏幕和print) - 变换与动画:
transform、transition、animation - 文本:
text-overflow、word-break/overflow-wrap、@font-face - 加分:
CSS3是个历史叫法,现在按模块各自演进,没有CSS4;值得提的新东西是变量、:is()/:where()/:has()、@container、aspect-ratio、clamp()
CSS3 新特性我一般按视觉、布局、动画三块来答。 视觉上是圆角、阴影、渐变这些,以前要切图的效果现在几行 CSS 就能写;布局上最重要的是 box-sizing: border-box、flex、grid 和媒体查询;动画就是 transform、transition、animation 三件套。说完我会补一句,CSS3 之后规范拆成了独立模块各自升级,所以没有 CSS4 这个版本,真正拉开差距的是近几年的 CSS 变量、:has()、容器查询这些,能讲清一两个实际用法比背清单有说服力。
transition:过渡transform: 旋转、缩放、移动或倾斜animation: 动画gradient: 渐变box-shadow: 阴影border-radius: 圆角word-break:normal|break-all|keep-all; 文字换行(默认规则|单词也可以换行|只在半角空格或连字符换行)text-overflow: 文字超出部分处理text-shadow: 水平阴影,垂直阴影,模糊的距离,以及阴影的颜色。box-sizing:content-box|border-box盒模型- 媒体查询
@media screen and (max-width: 960px) {}还有打印print
💬 面试官追问
标题只加了
text-overflow: ellipsis,省略号不出来,还缺什么?它只管「溢出了怎么显示」,自己不会制造溢出。单行省略要三件套:
white-space: nowrap; overflow: hidden; text-overflow: ellipsis,元素还得有确定宽度;放在flex子项里再加min-width: 0。一串没空格的订单号把手机端表格撑出屏幕,用
word-break: break-all行吗?能断,但全局用会把普通英文单词拦腰截断。我更倾向
overflow-wrap: anywhere(老浏览器用break-word),平时按单词换,放不下才在任意位置断,只给订单号那一列加。按钮设计稿宽
120px,加了padding和边框后实际变成146px,改哪?默认
content-box下width只算内容区,padding和border往外加。全局写*, *::before, *::after { box-sizing: border-box; },声明的宽度就是最终占位。打印订单页,导航和按钮也被打出来了,要再做一套打印页面吗?
不用,
@media print { .nav, .actions { display: none; } }就行。顺带处理分页:break-inside: avoid防止一行被切到两页;背景色默认不打印,需要的话加print-color-adjust: exact。现在面试还问「
CSS3新特性」,你会主动补哪几个新的?:has()父选择器,比如.card:has(img)给带图的卡片换布局;@container让组件按容器宽度而不是视口响应;clamp()写流式字号font-size: clamp(14px, 2vw, 18px)。这几个主流浏览器都支持了,能直接上生产。
# 12 列举几个css中可继承和不可继承的元素
⚡ 30 秒速记
- 会继承的基本跟文字有关:
font系列、color、line-height、text-align、text-indent、letter-spacing、white-space、visibility、cursor、list-style - 不继承的:盒模型(
width/margin/padding/border)、background、定位、display、float、overflow、z-index、vertical-align - 记法:管「字长什么样」的会继承,管「盒子在哪、多大」的不继承
- 关键字:
inherit强制继承、initial回到规范初始值、unset(可继承属性=inherit,否则=initial)、revert回到浏览器默认样式 - 坑:
a的颜色、表单控件的字体不跟父级走,是因为浏览器默认样式直接给它们设了值,不是不能继承
能继承的基本都是控制文字的属性,控制盒子尺寸和位置的基本都不继承。 比如父元素设了 color、font-size、line-height,里面的文字都会跟着变;但父元素的 padding、border、background 要是也往下传,整页布局就乱套了,所以不继承。visibility 和 cursor 也会继承,这点常被考。实际开发里最常碰到的是「我设了父级字体,按钮怎么不变」,那是浏览器给 button 默认设了字体,写一句 button { font: inherit; } 就好。
.parent { color: red; border: 1px solid; }
/* 子元素:文字是红的(color 继承),但没有边框(border 不继承) */
- 不可继承的:
display、margin、border、padding、background、height、min-height、max-height、width、min-width、max-width、overflow、position、left、right、top、bottom、z-index、float、clear、table-layout、vertical-align - 所有元素可继承:
visibility和cursor。 - 内联元素可继承:
letter-spacing、word-spacing、white-space、line-height、color、font、font-family、font-size、font-style、font-variant、font-weight、text-decoration、text-transform、direction。 - 终端块状元素可继承:
text-indent和text-align。 - 列表元素可继承:
list-style、list-style-type、list-style-position、list-style-image`。
transition和animation的区别
Animation和transition大部分属性是相同的,他们都是随时间改变元素的属性值,他们的主要区别是transition需要触发一个事件才能改变属性,而animation不需要触发任何事件的情况下才会随时间改变属性值,并且transition为2帧,从from .... to,而animation可以一帧一帧的
# 四、浏览器
💬 面试官追问
父级设了
font-family,页面里的input和button字体还是系统默认,为什么?不是它们不能继承,是浏览器默认样式表直接给表单控件设了字体,优先级比继承来的值高。重置样式里加
button, input, select, textarea { font: inherit; }。父元素
visibility: hidden,子元素写visibility: visible,子元素能显示吗?能。
visibility是继承属性,子元素自己声明的值会覆盖继承值,所以子元素会单独显示出来。display: none就不行,整棵子树都不渲染,子元素怎么写都没用。unset、initial、revert有什么区别?initial是规范里的初始值,比如div的display会变成inline;revert回到浏览器默认样式,div还是block。unset看属性:能继承的等于inherit,不能的等于initial。写组件重置我一般用all: revert,比initial安全。子元素
line-height写1.5和150%效果不一样,为什么?150%是父元素先算出一个固定像素值再继承下去,子元素字体变大了行高不变,文字会挤在一起。1.5这种无单位数字继承的是比例,每个子元素按自己的字号重新算,所以行高一般写无单位数字。组件库想让用户在外层设个颜色,图标就自动跟着变,怎么写?
svg里用fill="currentColor",currentColor取的是当前元素的color,而color会继承。外层改color,图标、边框只要用了currentColor都跟着变。
# 1 浏览器架构
⚡ 30 秒速记
- 现代
Chrome是多进程:浏览器主进程、渲染进程(一般按站点分)、GPU进程、网络服务进程,外加扩展进程、各种utility进程 - 主进程管地址栏、标签、导航和权限;渲染进程跑
Blink+V8,在沙箱里;网络进程收发请求;GPU进程负责最终上屏 - 渲染进程的主线程同时跑
JS、样式计算、布局、绘制,所以JS一长页面就卡;合成线程是单独的,transform动画能躲开主线程 - 多进程三个收益:崩溃隔离、沙箱安全、多核并行;代价是内存
- 站点隔离(
Site Isolation):跨站iframe也拆到独立渲染进程,防Spectre读到别的站点内存
现代浏览器是多进程架构,把界面、页面渲染、网络、GPU 这些职责拆到不同进程里互相隔离。 以 Chrome 为例,主进程管地址栏、标签页和子进程调度;每个站点的页面跑在自己的渲染进程里,Blink 和 V8 都在这,而且被关在沙箱里拿不到系统权限;网络和 GPU 各有独立进程。好处是一个页面崩了只是那个标签变成「喔唷,崩溃啦」,不会带走整个浏览器。要补一句的是早年的 NPAPI 插件进程已经没了,Flash 在 2021 年停用,现在说插件一般指扩展,跑在扩展进程里。
单进程浏览器时代
单进程浏览器是指浏览器的所有功能模块都是运行在同一个进程里,这些模块包含了网络、插件、JavaScript运行环境、渲染引擎和页面等。其实早在2007年之前,市面上浏览器都是单进程的
- 缺点
- 不稳定:一个插件的意外崩溃会引起整个浏览器的崩溃
- 不流畅:所有页面的渲染模块、JavaScript执行环境以及插件都是运行在同一个线程中的,这就意味着同一时刻只能有一个模块可以执行
- 不安全:可以通过浏览器的漏洞来获取系统权限,这些脚本获取系统权限之后也可以对你的电脑做一些恶意的事情,同样也会引发安全问题
- 以上这些就是当时浏览器的特点,
不稳定,不流畅,而且不安全
多进程浏览器时代
- 由于
进程是相互隔离的,所以当一个页面或者插件崩溃时,影响到的仅仅是当前的页面进程或者插件进程,并不会影响到浏览器和其他页面,这就完美地解决了页面或者插件的崩溃会导致整个浏览器崩溃,也就是不稳定的问题 - JavaScript也是运行在渲染进程中的,所以即使JavaScript阻塞了渲染进程,影响到的也只是当前的渲染页面,而并不会影响浏览器和其他页面,因为其他页面的脚本是运行在它们自己的渲染进程中的
- Chrome把插件进程和渲染进程锁在沙箱里面,这样即使在渲染进程或者插件进程里面执行了恶意程序,恶意程序也无法突破沙箱去获取系统权限。
最新的Chrome浏览器包括:
1个浏览器(Browser)主进程、1个 GPU 进程、1个网络(NetWork)进程、多个渲染进程和多个插件进程
- 浏览器进程。主要负责界面显示、用户交互、子进程管理,同时提供存储等功能。
- 渲染进程。核心任务是将
HTML、CSS和 JavaScript 转换为用户可以与之交互的网页,排版引擎Blink和JavaScript引擎V8都是运行在该进程中,默认情况下,Chrome会为每个Tab标签创建一个渲染进程。出于安全考虑,渲染进程都是运行在沙箱模式下。 - GPU进程。其实,Chrome刚开始发布的时候是没有GPU进程的。而GPU的使用初衷是为了实现3D CSS的效果,只是随后网页、Chrome的UI界面都选择采用GPU来绘制,这使得GPU成为浏览器普遍的需求。最后,Chrome在其多进程架构上也引入了GPU进程。
- 网络进程。主要负责页面的网络资源加载,之前是作为一个模块运行在浏览器进程里面的,直至最近才独立出来,成为一个单独的进程。
- 插件进程。主要是负责插件的运行,因插件易崩溃,所以需要通过插件进程来隔离,以保证插件进程崩溃不会对浏览器和页面造成影响
💬 面试官追问
一个页面
JS死循环了,地址栏和其他标签还能用,这说明什么?说明死循环卡住的只是这个页面所在渲染进程的主线程,主进程负责的界面和其他站点的渲染进程不受影响。同一站点用
window.open打开的页面可能共用渲染进程,那几个页面会一起卡。都说
GUI渲染线程和JS线程互斥,为什么会互斥?在
Chrome里它们其实就是同一个主线程,JS执行、样式计算、布局、绘制排队轮流跑,谈不上两个线程抢。真正独立的是合成线程,所以只改transform/opacity的动画在JS卡住时还能动。站点隔离具体隔离了什么,对前端有什么影响?
不同站点的文档放进不同渲染进程,跨站
iframe也单独一个进程,即使渲染进程被漏洞攻破,也读不到别的站点的内存。对前端最直接的影响是跨站iframe越多进程越多,还有想用SharedArrayBuffer要配COOP/COEP响应头开启跨源隔离。用户反馈开十几个标签就吃掉几个
GB内存,多进程是不是设计得不好?这是用内存换稳定和安全。
Chrome也会在内存紧张时合并同站点进程、冻结或丢弃后台标签(Memory Saver)。前端能做的是别在后台标签里跑定时器和动画,监听visibilitychange停掉。页面白屏,怎么判断是渲染进程崩了还是
JS报错?渲染进程崩溃一般是「喔唷,崩溃啦」那种错误页,
Chrome任务管理器里那个进程会消失;白屏但没错误页,多半是JS抛错导致没挂载,去Console和监控里找报错。前者常见原因是内存爆了,后者是代码问题。
# 2 JavaScript单线程模型
⚡ 30 秒速记
JS单线程 = 一个页面主线程上只有一个调用栈,同一时刻只跑一段代码- 为什么单线程:要操作
DOM,两个线程一个加节点一个删节点,听谁的?单线程省掉了锁 - 单线程 ≠ 阻塞:网络、定时器交给浏览器其他线程,完成后回调排进任务队列,主线程空了再取,这就是事件循环
- 每轮:跑完一个宏任务 → 清空所有微任务 → 有需要就渲染一帧;
Promise.then是微任务,setTimeout是宏任务 - 真多线程用
Web Worker:不能碰DOM,靠postMessage通信(数据是结构化克隆,大数据用Transferable转移)
JavaScript 单线程说的是页面主线程上只有一个调用栈,同一时间只能执行一段 JS,不是浏览器只有一个线程。 这么设计是因为 JS 要改 DOM,多线程同时改会冲突,单线程最省事。但单线程不代表一直傻等:发请求、定时器这类活交给浏览器的其他线程,做完了把回调放进任务队列,主线程空闲了再一个个取出来执行。代价是任何一段同步代码跑太久都会卡住点击和渲染,所以重计算我会拆成小块,或者丢给 Web Worker。
console.log(1)
setTimeout(() => console.log(2), 0)
Promise.resolve().then(() => console.log(3))
console.log(4)
// 输出:1 4 3 2(同步 → 微任务 → 宏任务)
JavaScript语言的一大特点就是单线程,也就是说,同一时间只能做一件事,前面的任务没做完,后面的任务只能等着。
1. 为什么JavaScript是单线程的呢?
- 这主要与JavaScript用途有关。它的主要用途是与用户互动,以及操作DOM。如果JavaScript是多线程的,会带来很多复杂的问题,假如 JavaScript有A和B两个线程,A线程在DOM节点上添加了内容,B线程删除了这个节点,应该是哪个为准呢? 所以,为了避免复杂性,所以设计成了单线程。
- 虽然 HTML5 提出了Web Worker标准。Web Worker 的作用,就是为 JavaScript 创造多线程环境,允许主线程创建 Worker 线程,将一些任务分配给后者运行。但是子线程完全受主线程控制,且不得操作DOM。所以这个并没有改变JavaScript单线程的本质。一般使用 Web Worker 的场景是代码中有很多计算密集型或高延迟的任务,可以考虑分配给 Worker 线程。
- 但是使用的时候一定要注意,worker 线程是为了让你的程序跑的更快,但是如果 worker 线程和主线程之间通信的时间大于了你不使用worker线程的时间,结果就得不偿失了。
2. 浏览器内核中线程之间的关系
- GUI渲染线程和JS引擎线程互斥
- js是可以操作DOM的,如果在修改这些元素的同时渲染页面(js线程和ui线程同时运行),那么渲染线程前后获得的元素数据可能就不一致了。
- JS阻塞页面加载
- js如果执行时间过长就会阻塞页面
3. 浏览器是多进程的优点
- 默认新开 一个 tab 页面 新建 一个进程,所以单个 tab 页面崩溃不会影响到整个浏览器。
- 第三方插件崩溃也不会影响到整个浏览器。
- 多进程可以充分利用现代 CPU 多核的优势。
- 方便使用沙盒模型隔离插件等进程,提高浏览器的稳定性。
4. 进程和线程又是什么呢
进程(process)和线程(thread)是操作系统的基本概念。
- 进程是 CPU 资源分配的最小单位(是能拥有资源和独立运行的最小单位)。
- 线程是 CPU 调度的最小单位(是建立在进程基础上的一次程序运行单位)。
由于每个进程至少要做一件事,所以一个进程至少有一个线程。系统会给每个进程分配独立的内存,因此进程有它独立的资源。同一进程内的各个线程之间共享该进程的内存空间(包括代码段,数据集,堆等)。
进程可以理解为一个工厂不不同车间,相互独立。线程是车间里的工人,可以自己做自己的事情,也可以相互配合做同一件事情。
5. 任务队列
- 单线程就意味着,所有任务都要排队执行,前一个任务结束,才会执行后一个任务。
- 如果一个任务需要执行,但此时JavaScript引擎正在执行其他任务,那么这个任务就需要放到一个队列中进行等待。等到线程空闲时,就可以从这个队列中取出最早加入的任务进行执行(类似于我们去银行排队办理业务,单线程相当于说这家银行只有一个服务窗口,一次只能为一个人服务,后面到的就需要排队,而任务队列就是排队区,先到的就优先服务)
注意: 如果当前线程空闲,并且队列为空,那每次加入队列的函数将立即执行。
为什么会有任务队列? 由于 JS 是单线程的,同步执行任务会造成浏览器的阻塞,所以我们将 JS 分成一个又一个的任务,通过不停的循环来执行事件队列中的任务。
💬 面试官追问
按钮点了过了一秒才有反应,事件是不是丢了?
大概率没丢,是在排队。主线程正在跑一个长任务,点击回调只能等它跑完。用
Performance面板录一下,找超过50ms带红角标的Long Task,把它拆开就好。一个
10万条数据的排序,放Worker里一定更快吗?不一定。
postMessage传数据要做结构化克隆,数据大的话拷贝本身就要几十毫秒,计算才几毫秒就得不偿失。用ArrayBuffer加Transferable可以零拷贝转移;任务小的话不如在主线程分片做。两个标签页,一个死循环,另一个照样能用,
JS不是单线程吗?单线程是指单个页面的主线程,不同站点的标签页各有自己的渲染进程和主线程,互不影响。这是浏览器多进程隔离的结果,跟
JS语言变成多线程没关系。在
Promise.then里递归调用自己,页面会卡死吗?会。微任务要在本轮全部清空才轮到渲染,
then里不停产生新的微任务,队列永远清不完,页面不渲染也不响应点击。换成setTimeout递归就不会,每轮之间浏览器有机会渲染。长任务想拆开,又不想用
Worker,怎么让出主线程?每处理一批就
await一次让出,老办法是await new Promise(r => setTimeout(r));新Chrome里有scheduler.yield(),让出后续任务优先级更高。每批控制在几毫秒,用户点击就能插队进来。
# 3 Chrome 打开一个页面需要启动多少进程?分别有哪些进程?
⚡ 30 秒速记
- 最少
4个:浏览器主进程、网络进程、GPU进程、渲染进程 - 实际远不止:扩展各占进程,还有存储、音频等
utility进程;跨站iframe在站点隔离下也各占一个渲染进程 - 职责:主进程管界面和导航,网络进程管请求,
GPU进程管上屏,渲染进程管解析、排版、跑JS - 渲染进程大体按站点分,不是严格一个标签一个;同站点互相打开的页面可能共用
- 老资料里的「插件进程」是
NPAPI/Flash时代的,现在基本看不到了
打开一个页面最少要 4 个进程:浏览器主进程、网络进程、GPU 进程和渲染进程。 主进程负责界面、导航和管理其他进程;网络进程负责把资源下载回来;渲染进程把 HTML、CSS、JS 变成页面,Blink 和 V8 都在这里;GPU 进程负责最终画到屏幕上。不过打开 Chrome 任务管理器你会发现远不止 4 个,扩展、存储服务、音频服务都是独立进程,跨站 iframe 也会单独开渲染进程。说「最少四个」是讲核心角色,别说成固定四个。
打开 1 个页面至少需要 1 个网络进程、1 个浏览器进程、1 个 GPU 进程以及 1 个渲染进程,共 4 个;最新的 Chrome 浏览器包括:1 个浏览器(Browser)主进程、1 个 GPU 进程、1 个网络(NetWork)进程、多个渲染进程和多个插件进程。
浏览器进程:主要负责界面显示、用户交互、子进程管理,同时提供存储等功能。渲染进程:核心任务是将 HTML、CSS 和 JavaScript 转换为用户可以与之交互的网页,排版引擎 Blink 和 JavaScript 引擎 V8 都是运行在该进程中,默认情况下,Chrome 会为每个 Tab 标签创建一个渲染进程。出于安全考虑,渲染进程都是运行在沙箱模式下。GPU 进程:其实,Chrome 刚开始发布的时候是没有 GPU 进程的。而 GPU 的使用初衷是为了实现 3D CSS 的效果,只是随后网页、Chrome 的 UI 界面都选择采用 GPU 来绘制,这使得 GPU 成为浏览器普遍的需求。最后,Chrome 在其多进程架构上也引入了 GPU 进程。网络进程:主要负责页面的网络资源加载,之前是作为一个模块运行在浏览器进程里面的,直至最近才独立出来,成为一个单独的进程。插件进程:主要是负责插件的运行,因插件易崩溃,所以需要通过插件进程来隔离,以保证插件进程崩溃不会对浏览器和页面造成影响。
💬 面试官追问
打开一个空白标签页,任务管理器里也有一堆进程,为什么?
主进程、网络、
GPU这些是整个浏览器共用的,开浏览器就在;空白页本身也要一个渲染进程。再加上每个扩展、存储和音频服务各占一个,数量自然不少。页面嵌了三个不同站点的广告
iframe,进程会怎么变?站点隔离开启后,每个跨站
iframe会放进自己的渲染进程,进程数加三。内存会上去,但广告脚本就算崩了也不会把主页面带走。同一个站点开了两个标签,一个卡死另一个也卡,为什么不是各自一个进程?
Chrome会在同站点、互相有引用关系(比如window.open打开且保留了opener)的页面之间复用渲染进程,它们共享主线程。打开新链接时加rel="noopener",能让新页面独立出去。请求都返回了,页面却好几秒才出来,是网络进程的锅吗?
不一定。网络进程只负责把字节拿回来,后面解析、样式、布局、跑
JS都在渲染进程主线程上。去Performance面板看请求结束之后主线程在忙什么,多半是一个大bundle在执行。为什么要把网络从主进程里拆出来单独成一个进程?
一是隔离,网络栈解析的是不可信的外部数据,出问题不至于拖垮主进程;二是服务化,桌面、安卓按内存情况决定是不是合并到别的进程里跑。对前端来说没区别,排查时知道请求是它发的就行。
# 4 渲染机制
⚡ 30 秒速记
- 流水线:
HTML→DOM,CSS→CSSOM→ 合成渲染树 → 布局Layout→ 分层 → 绘制Paint→ 栅格化 → 合成上屏 - 渲染树只有可见节点:
display: none不进树,visibility: hidden进树(还占位) - 阻塞关系:
CSS不挡DOM解析,但挡渲染,也挡它后面的同步JS执行;同步JS挡DOM解析 - 所以「
CSS放head、JS加defer」,关键CSS可以内联 - 改尺寸位置 → 重排 + 重绘;只改颜色 → 重绘;只改
transform/opacity→ 只合成,最便宜
浏览器渲染就是一条流水线:先把 HTML 和 CSS 解析成 DOM、CSSOM,合成渲染树,然后算布局、绘制、分层合成,最后上屏。 理解这条线是为了知道哪步贵:改宽高位置要从布局重新走,改颜色只要重绘,改 transform、opacity 可以直接在合成线程处理。另外阻塞关系常被问,同步脚本会停掉 HTML 解析,因为它可能改 DOM;CSS 不停解析但挡住首次渲染,还会让后面的同步脚本等它下载完,因为脚本可能读样式。我写代码会避免在循环里读 offsetHeight 又改样式,那会反复强制布局。
1. 浏览器如何渲染网页
概述:浏览器渲染一共有五步
- 处理
HTML并构建DOM树。 - 处理
CSS构建CSSOM树。 - 将
DOM与CSSOM合并成一个渲染树。 - 根据渲染树来布局,计算每个节点的位置。
- 调用
GPU绘制,合成图层,显示在屏幕上
第四步和第五步是最耗时的部分,这两步合起来,就是我们通常所说的渲染
具体如下图过程如下图所示

渲染
- 网页生成的时候,至少会渲染一次
- 在用户访问的过程中,还会不断重新渲染
重新渲染需要重复之前的第四步(重新生成布局)+第五步(重新绘制)或者只有第五个步(重新绘制)
- 在构建
CSSOM树时,会阻塞渲染,直至CSSOM树构建完成。并且构建CSSOM树是一个十分消耗性能的过程,所以应该尽量保证层级扁平,减少过度层叠,越是具体的CSS选择器,执行速度越慢 - 当
HTML解析到script标签时,会暂停构建DOM,完成后才会从暂停的地方重新开始。也就是说,如果你想首屏渲染的越快,就越不应该在首屏就加载JS文件。并且CSS也会影响JS的执行,只有当解析完样式表才会执行JS,所以也可以认为这种情况下,CSS也会暂停构建DOM
2. 浏览器渲染五个阶段
2.1 第一步:解析HTML标签,构建DOM树
在这个阶段,引擎开始解析
html,解析出来的结果会成为一棵dom树dom的目的至少有2个
- 作为下个阶段渲染树状图的输入
- 成为网页和脚本的交互界面。(最常用的就是
getElementById等等)
当解析器到达script标签的时候,发生下面四件事情
html解析器停止解析,- 如果是外部脚本,就从外部网络获取脚本代码
- 将控制权交给
js引擎,执行js代码 - 恢复
html解析器的控制权
由此可以得到第一个结论1
- 由于
<script>标签是阻塞解析的,将脚本放在网页尾部会加速代码渲染。 defer和async属性也能有助于加载外部脚本。defer使得脚本会在dom完整构建之后执行;async标签使得脚本只有在完全available才执行,并且是以非阻塞的方式进行的
2.2 第二步:解析CSS标签,构建CSSOM树
- 我们已经看到
html解析器碰到脚本后会做的事情,接下来我们看下html解析器碰到样式表会发生的情况 js会阻塞解析,因为它会修改文档(document)。css不会修改文档的结构,如果这样的话,似乎看起来css样式不会阻塞浏览器html解析。但是事实上css样式表是阻塞的。阻塞是指当cssom树建立好之后才会进行下一步的解析渲染
通过以下手段可以减轻cssom带来的影响
- 将
script脚本放在页面底部 - 尽可能快的加载
css样式表 - 将样式表按照
media type和media query区分,这样有助于我们将css资源标记成非阻塞渲染的资源。 - 非阻塞的资源还是会被浏览器下载,只是优先级较低
2.3 第三步:把DOM和CSSOM组合成渲染树(render tree)

2.4 第四步:在渲染树的基础上进行布局,计算每个节点的几何结构
布局(
layout):定位坐标和大小,是否换行,各种position,overflow,z-index属性
2.5 调用 GPU 绘制,合成图层,显示在屏幕上
将渲染树的各个节点绘制到屏幕上,这一步被称为绘制
painting
3. 渲染优化相关
3.1 Load 和 DOMContentLoaded 区别
Load事件触发代表页面中的DOM,CSS,JS,图片已经全部加载完毕。DOMContentLoaded事件触发代表初始的HTML被完全加载和解析,不需要等待CSS,JS,图片加载
3.2 图层
一般来说,可以把普通文档流看成一个图层。特定的属性可以生成一个新的图层。不同的图层渲染互不影响,所以对于某些频繁需要渲染的建议单独生成一个新图层,提高性能。但也不能生成过多的图层,会引起反作用。
通过以下几个常用属性可以生成新图层
3D变换:translate3d、translateZwill-changevideo、iframe标签- 通过动画实现的
opacity动画转换 position: fixed
3.3 重绘(Repaint)和回流(Reflow)
重绘和回流是渲染步骤中的一小节,但是这两个步骤对于性能影响很大
- 重绘是当节点需要更改外观而不会影响布局的,比如改变
color就叫称为重绘 - 回流是布局或者几何属性需要改变就称为回流。
回流必定会发生重绘,重绘不一定会引发回流。回流所需的成本比重绘高的多,改变深层次的节点很可能导致父节点的一系列回流
以下几个动作可能会导致性能问题
- 改变
window大小 - 改变字体
- 添加或删除样式
- 文字改变
- 定位或者浮动
- 盒模型
很多人不知道的是,重绘和回流其实和 Event loop 有关
- 当
Event loop执行完Microtasks后,会判断document是否需要更新。因为浏览器是60Hz的刷新率,每16ms才会更新一次。 - 然后判断是否有
resize或者scroll,有的话会去触发事件,所以resize和scroll事件也是至少16ms才会触发一次,并且自带节流功能。 - 判断是否触发了
media query - 更新动画并且发送事件
- 判断是否有全屏操作事件
- 执行
requestAnimationFrame回调 - 执行
IntersectionObserver回调,该方法用于判断元素是否可见,可以用于懒加载上,但是兼容性不好 - 更新界面
- 以上就是一帧中可能会做的事情。如果在一帧中有空闲时间,就会去执行
requestIdleCallback回调
常见的引起重绘的属性
colorborder-stylevisibilitybackgroundtext-decorationbackground-imagebackground-positionbackground-repeatoutline-coloroutlineoutline-styleborder-radiusoutline-widthbox-shadowbackground-size
3.4 常见引起回流属性和方法
任何会改变元素几何信息(元素的位置和尺寸大小)的操作,都会触发重排,下面列一些栗子
- 添加或者删除可见的
DOM元素; - 元素尺寸改变——边距、填充、边框、宽度和高度
- 内容变化,比如用户在
input框中输入文字 - 浏览器窗口尺寸改变——
resize事件发生时 - 计算
offsetWidth和offsetHeight属性 - 设置
style属性的值
回流影响的范围
由于浏览器渲染界面是基于流失布局模型的,所以触发重排时会对周围DOM重新排列,影响的范围有两种
- 全局范围:从根节点
html开始对整个渲染树进行重新布局。 - 局部范围:对渲染树的某部分或某一个渲染对象进行重新布局
全局范围回流
<body>
<div class="hello">
<h4>hello</h4>
<p><strong>Name:</strong>BDing</p>
<h5>male</h5>
<ol>
<li>coding</li>
<li>loving</li>
</ol>
</div>
</body>
当
p节点上发生reflow时,hello和body也会重新渲染,甚至h5和ol都会收到影响
局部范围回流
用局部布局来解释这种现象:把一个
dom的宽高之类的几何信息定死,然后在dom内部触发重排,就只会重新渲染该dom内部的元素,而不会影响到外界
3.5 减少重绘和回流
使用
translate替代top
<div class="test"></div>
<style>
.test {
position: absolute;
top: 10px;
width: 100px;
height: 100px;
background: red;
}
</style>
<script>
setTimeout(() => {
// 引起回流
document.querySelector('.test').style.top = '100px'
}, 1000)
</script>
- 使用
visibility替换display: none,因为前者只会引起重绘,后者会引发回流(改变了布局) - 把
DOM离线后修改,比如:先把DOM给display:none(有一次Reflow),然后你修改100次,然后再把它显示出来 - 不要把
DOM结点的属性值放在一个循环里当成循环里的变量
for(let i = 0; i < 1000; i++) {
// 获取 offsetTop 会导致回流,因为需要去获取正确的值
console.log(document.querySelector('.test').style.offsetTop)
}
- 不要使用
table布局,可能很小的一个小改动会造成整个table的重新布局 - 动画实现的速度的选择,动画速度越快,回流次数越多,也可以选择使用
requestAnimationFrame CSS选择符从右往左匹配查找,避免DOM深度过深- 将频繁运行的动画变为图层,图层能够阻止该节点回流影响别的元素。比如对于
video标签,浏览器会自动将该节点变为图层。
💬 面试官追问
只把文字颜色从黑改成红,同事说会重新布局整页,对吗?
不对,
color不改几何,只触发重绘,跳过布局。改font-size、width、padding或往里塞内容才会重排;不过重绘区域大了也照样有成本。CSS文件放在body底部,会有什么问题?页面会先按没样式的样子渲染一次,样式到了再重排重绘,用户看到闪一下(
FOUC)。放head里让浏览器尽早下载,首屏样式能一次到位。一个大列表循环里读
offsetHeight再改style,滚动明显卡,怎么改?每次读几何属性都会逼浏览器把之前的修改立刻算一遍布局,读写交替就是反复强制布局。先一轮把高度都读出来存数组,再一轮统一写;写的部分放进
requestAnimationFrame。要给长列表每一项都加
will-change: transform优化滚动,行吗?不行,每个合成层都要占
GPU内存,几百个层反而更卡,手机上甚至会闪白。只给真正在动的元素临时加,动画结束删掉;滚动容器本身浏览器会自己处理。DOMContentLoaded很早就触发了,首屏还是空白,可能卡在哪?DOMContentLoaded只说明HTML解析完、defer脚本跑完,不代表画出来了。常见是CSS还没下完挡着渲染,或者是SPA要等JS拉数据再挂载;看首屏要用FCP、LCP这类指标。
# 5 缓存机制
⚡ 30 秒速记
- 两层:强缓存(不发请求,
200 (from memory/disk cache))→ 过期后协商缓存(发请求,没变返回304) - 强缓存:
Cache-Control: max-age优先于Expires(绝对时间,怕客户端时钟不准) - 协商缓存:
ETag/If-None-Match优先于Last-Modified/If-Modified-Since(秒级精度、改了内容不变也会误判) - 易错点:
no-cache是「能存但每次用前都要验证」,no-store才是不存;一个缓存头都不写,浏览器会按Last-Modified做启发式缓存 - 实践:
HTML用no-cache,带hash的静态资源用max-age=31536000, immutable;Push Cache随HTTP/2 Server Push被Chrome 106移除,可以不提
强缓存和协商缓存的区别就在于发不发请求:强缓存命中直接用本地的,连请求都不发;过期了才去问服务器「这个资源变了没」,没变就回 304。 强缓存看 Cache-Control 的 max-age,老的 Expires 是绝对时间,两个都有时以 max-age 为准。协商缓存靠 ETag 或 Last-Modified,浏览器把它们分别放进 If-None-Match、If-Modified-Since 带上去。线上我一般这么配:HTML 每次都协商,保证发版能立刻生效;文件名带 hash 的 JS / CSS 缓存一年,内容变了文件名就变,天然不会用到旧的。
location = /index.html { add_header Cache-Control "no-cache"; }
location /assets/ { add_header Cache-Control "public, max-age=31536000, immutable"; }
1. 首先得明确 http 缓存的好处
- 减少了冗余的数据传输,减少网费
- 减少服务器端的压力
Web缓存能够减少延迟与网络阻塞,进而减少显示某个资源所用的时间- 加快客户端加载网页的速度
2. 常见 http 缓存的类型
- 私有缓存(一般为本地浏览器缓存)
- 代理缓存
3. 然后谈谈本地缓存
本地缓存是指浏览器请求资源时命中了浏览器本地的缓存资源,浏览器并不会发送真正的请求给服务器了。它的执行过程是
- 第一次浏览器发送请求给服务器时,此时浏览器还没有本地缓存副本,服务器返回资源给浏览器,响应码是
200 OK,浏览器收到资源后,把资源和对应的响应头一起缓存下来 - 第二次浏览器准备发送请求给服务器时候,浏览器会先检查上一次服务端返回的响应头信息中的
Cache-Control,它的值是一个相对值,单位为秒,表示资源在客户端缓存的最大有效期,过期时间为第一次请求的时间减去Cache-Control的值,过期时间跟当前的请求时间比较,如果本地缓存资源没过期,那么命中缓存,不再请求服务器 - 如果没有命中,浏览器就会把请求发送给服务器,进入缓存协商阶段。
与本地缓存相关的头有:
Cache-Control、Expires,Cache-Control有多个可选值代表不同的意义,而Expires就是一个日期格式的绝对值。
3.1 Cache-Control
Cache-Control是HTPP缓存策略中最重要的头,它是HTTP/1.1中出现的,它由如下几个值
no-cache:不使用本地缓存。需要使用缓存协商,先与服务器确认返回的响应是否被更改,如果之前的响应中存在ETag,那么请求的时候会与服务端验证,如果资源未被更改,则可以避免重新下载no-store:直接禁止游览器缓存数据,每次用户请求该资源,都会向服务器发送一个请求,每次都会下载完整的资源public:可以被所有的用户缓存,包括终端用户和CDN等中间代理服务器。private:只能被终端用户的浏览器缓存,不允许CDN等中继缓存服务器对其缓存。max-age:从当前请求开始,允许获取的响应被重用的最长时间(秒)。must-revalidate,当缓存过期时,需要去服务端校验缓存的有效性。
# 例如:
Cache-Control: public, max-age=1000
# 表示资源可以被所有用户以及代理服务器缓存,最长时间为1000秒。
注意,虽然你可能在其他资料中看到可以使用 meta 标签来设置缓存,比如像下面的形式:
<meta http-equiv="expires" content="Wed, 20 Jun 2021 22:33:00 GMT"
但在 HTML5 规范中,并不支持这种方式,所以尽量不要使用 meta 标签来设置缓存。
3.2 Expires
Expires是HTTP/1.0出现的头信息,同样是用于决定本地缓存策略的头,它是一个绝对时间,时间格式是如Mon, 10 Jun 2015 21:31:12 GMT,只要发送请求时间是在Expires之前,那么本地缓存始终有效,否则就会去服务器发送请求获取新的资源。如果同时出现Cache-Control:max-age和Expires,那么max-age优先级更高。他们可以这样组合使用
Cache-Control: public
Expires: Wed, Jan 10 2018 00:27:04 GMT
3.3 所谓的缓存协商
当第一次请求时服务器返回的响应头中存在以下情况时
- 没有
Cache-Control和Expires Cache-Control和Expires过期了Cache-Control的属性设置为no-cache时
那么浏览器第二次请求时就会与服务器进行协商,询问浏览器中的缓存资源是不是旧版本,需不需要更新,此时,服务器就会做出判断,如果缓存和服务端资源的最新版本是一致的,那么就无需再次下载该资源,服务端直接返回
304 Not Modified状态码,如果服务器发现浏览器中的缓存已经是旧版本了,那么服务器就会把最新资源的完整内容返回给浏览器,状态码就是200 Ok,那么服务端是根据什么来判断浏览器的缓存是不是最新的呢?其实是根据HTTP的另外两组头信息,分别是:Last-Modified/If-Modified-Since与ETag/If-None-Match。
Last-Modified 与 If-Modified-Since
具体工作流程如下:
- 浏览器第一次请求资源时,服务器会把资源的最新修改时间
Last-Modified:Thu, 29 Dec 2011 18:23:55 GMT放在响应头中返回给浏览器 - 第二次请求时,浏览器就会把上一次服务器返回的修改时间放在请求头
If-Modified-Since:Thu, 29 Dec 2011 18:23:55发送给服务器,服务器就会拿这个时间跟服务器上的资源的最新修改时间进行对比 - 服务端再次收到请求,根据请求头
If-Modified-Since的值,判断相关资源是否有变化,如果没有,则返回304 Not Modified,并且不返回资源内容,浏览器使用资源缓存值;否则正常返回资源内容,且更新Last-Modified响应头内容。
如果两者相等或者大于服务器上的最新修改时间,那么表示浏览器的缓存是有效的,此时缓存会命中,服务器就不再返回内容给浏览器了,同时
Last-Modified头也不会返回,因为资源没被修改,返回了也没什么意义。如果没命中缓存则最新修改的资源连同Last-Modified头一起返回
这种方式虽然能判断缓存是否失效,但也存在两个问题:
- 精度问题,
Last-Modified的时间精度为秒,如果在1秒内发生修改,那么缓存判断可能会失效; - 准度问题,考虑这样一种情况,如果一个文件被修改,然后又被还原,内容并没有发生变化,在这种情况下,浏览器的缓存还可以继续使用,但因为修改时间发生变化,也会重新返回重复的内容。
# 第一次请求返回的响应头
Cache-Control:max-age=3600
Expires: Fri, Jan 12 2018 00:27:04 GMT
Last-Modified: Wed, Jan 10 2018 00:27:04 GMT
# 第二次请求的请求头信息
If-Modified-Since: Wed, Jan 10 2018 00:27:04 GMT
这组头信息是基于资源的修改时间来判断资源有没有更新,另一种方式就是根据资源的内容来判断,就是接下来要讨论的
ETag与If-None-Match
ETag与If-None-Match
为了解决精度问题和准度问题,HTTP 提供了另一种不依赖于修改时间,而依赖于文件哈希值的精确判断缓存的方式,那就是响应头部字段 ETag 和请求头部字段 If-None-Match。
ETag/If-None-Match与Last-Modified/If-Modified-Since的流程其实是类似的,唯一的区别是它基于资源的内容的摘要信息(比如MD5 hash)来判断
浏览器发送第二次请求时,会把第一次的响应头信息
ETag的值放在If-None-Match的请求头中发送到服务器,与最新的资源的摘要信息对比,如果相等,取浏览器缓存,否则内容有更新,最新的资源连同最新的摘要信息返回。用ETag的好处是如果因为某种原因到时资源的修改时间没改变,那么用ETag就能区分资源是不是有被更新。
具体工作流程如下:
- 浏览器第一次请求资源,服务端在返响应头中加入
Etag字段,Etag字段值为该资源的哈希值 - 当浏览器再次跟服务端请求这个资源时,在请求头上加上
If-None-Match,值为之前响应头部字段ETag的值; - 服务端再次收到请求,将请求头
If-None-Match字段的值和响应资源的哈希值进行比对,如果两个值相同,则说明资源没有变化,返回304 Not Modified;否则就正常返回资源内容,无论是否发生变化,都会将计算出的哈希值放入响应头部的ETag字段中
这种缓存比较的方式也会存在一些问题,具体表现在以下两个方面。
- 计算成本。生成哈希值相对于读取文件修改时间而言是一个开销比较大的操作,尤其是对于大文件而言。如果要精确计算则需读取完整的文件内容,如果从性能方面考虑,只读取文件部分内容,又容易判断出错。
- 计算误差。HTTP 并没有规定哈希值的计算方法,所以不同服务端可能会采用不同的哈希值计算方式。这样带来的问题是,同一个资源,在两台服务端产生的 Etag 可能是不相同的,所以对于使用服务器集群来处理请求的网站来说,使用 Etag 的缓存命中率会有所降低。
需要注意的是,
强制缓存的优先级高于协商缓存,在协商缓存中,Etag 优先级比 Last-Modified高
# 第一次请求返回的响应头:
Cache-Control: public, max-age=31536000
ETag: "15f0fff99ed5aae4edffdd6496d7131f"
# 第二次请求的请求头信息:
If-None-Match: "15f0fff99ed5aae4edffdd6496d7131f"
缓存位置
浏览器缓存的位置的话,可以分为四种,优先级从高到低排列分别👇
Service WorkerMemory CacheDisk CachePush Cache
Service Worker
这个应用场景比如PWA,它借鉴了Web Worker思路,由于它脱离了浏览器的窗体,因此无法直接访问DOM。它能完成的功能比如:
离线缓存、消息推送和网络代理,其中离线缓存就是Service Worker Cache。
Memory Cache
指的是内存缓存,从效率上讲它是最快的,从存活时间来讲又是最短的,当渲染进程结束后,内存缓存也就不存在了。
Disk Cache
存储在磁盘中的缓存,从存取效率上讲是比内存缓存慢的,优势在于存储容量和存储时长。
Disk Cache VS Memory Cache
两者对比,主要的策略👇
- 内容使用率高的话,文件优先进入磁盘
- 比较大的JS,CSS文件会直接放入磁盘,反之放入内存。
Push Cache
推送缓存,这算是浏览器中最后一道防线吧,它是
HTTP/2的内容
浏览器缓存总结
浏览器缓存分为强缓存和协商缓存。当客户端请求某个资源时,获取缓存的流程如下
- 先根据这个资源的一些 http header 判断它是否命中强缓存,先检查
Cache-Control,如果命中,则直接从本地获取缓存资源,不会发请求到服务器; - 当强缓存没有命中时,客户端会发送请求到服务器,服务器通过另一些request header验证这个资源是否命中协商缓存,称为http再验证,如果命中,服务器将请求返回,但不返回资源,而是返回304告诉客户端直接从缓存中获取,客户端收到返回后就会从缓存中获取资源;(服务器通过请求头中的
If-Modified-Since或者If-None-Match字段检查资源是否更新) - 强缓存和协商缓存共同之处在于,如果命中缓存,服务器都不会返回资源; 区别是,强缓存不对发送请求到服务器,但协商缓存会。
- 当协商缓存也没命中时,服务器就会将资源发送回客户端。
- 当 ctrl+f5 强制刷新网页时,直接从服务器加载,跳过强缓存和协商缓存;
- 当 f5刷新网页时,跳过强缓存,但是会检查协商缓存;
强缓存
- Expires(该字段是 http1.0 时的规范,值为一个绝对时间的 GMT 格式的时间字符串,代表缓存资源的过期时间)
- Cache-Control:max-age(该字段是 http1.1的规范,强缓存利用其 max-age 值来判断缓存资源的最大生命周期,它的值单位为秒)
协商缓
- Last-Modified(值为资源最后更新时间,随服务器response返回,即使文件改回去,日期也会变化)
- If-Modified-Since(通过比较两个时间来判断资源在两次请求期间是否有过修改,如果没有修改,则命中协商缓存)
- ETag(表示资源内容的唯一标识,随服务器response返回,仅根据文件内容是否变化判断)
- If-None-Match(服务器通过比较请求头部的If-None-Match与当前资源的ETag是否一致来判断资源是否在两次请求之间有过修改,如果没有修改,则命中协商缓存)
💬 面试官追问
第二次请求带了
If-None-Match,返回的却是200,是不是缓存没生效?缓存流程是走了的,带
If-None-Match就说明浏览器在拿旧ETag做协商。服务端算出来的ETag对不上才回200和新内容。常见原因是多台机器ETag算法不一样(比如带了inode),负载均衡一切换就对不上。发版后用户还在用旧页面,
HTML啥缓存头都没配,为什么?没配缓存头但有
Last-Modified,浏览器会走启发式缓存,一般按「距上次修改时间的10%」当有效期,一个月没改过的文件能被缓存好几天。HTML一定要显式写Cache-Control: no-cache。普通刷新和
Ctrl+F5有什么区别?普通刷新时主文档会带条件头去协商,可能拿到
304;新版Chrome里子资源只要还在强缓存有效期内照样直接用。Ctrl+F5强制刷新会带Cache-Control: no-cache,所有资源都跳过缓存重新下载。no-cache和max-age=0有区别吗?效果很接近,都是每次使用前要验证。细微区别是
max-age=0在离线或服务器挂了时,有的缓存会给你过期内容兜底,no-cache要求必须验证成功才能用;想要严格就再加must-revalidate。接口响应被
CDN缓存了,不同用户看到了别人的数据,该怎么配?带用户数据的接口要写
Cache-Control: private(只许浏览器存)或者直接no-store。默认没写的话CDN可能按自己的规则缓存;按Cookie区分内容的响应,还要加Vary或让CDN跳过。
# 6 浏览器存储
⚡ 30 秒速记
cookie是给服务端看的:每次请求自动带上,单条约4KB,所以只放登录态这类小东西localStorage/sessionStorage给前端自己用:不上传,每个源约5MB,同步API,只能存字符串- 生命周期:
cookie看Expires/Max-Age(不设就是会话cookie);sessionStorage跟标签页走;localStorage不删就一直在 - 安全:登录态
cookie配HttpOnly(JS读不到)+Secure+SameSite;Chrome 80起不写SameSite默认按Lax - 大数据、离线数据用
IndexedDB:异步、能存对象和Blob、配额按磁盘比例给,能到几百MB以上
选存储先看数据给谁用:要让服务端认的放 cookie,前端自己用的放 Web Storage 或 IndexedDB。 cookie 每个请求都会自动带上,所以只适合放登录凭证这种小数据,塞多了每个请求头都变大。localStorage 关了浏览器还在,适合存用户偏好;sessionStorage 只在当前标签页有效,适合临时的表单草稿和筛选条件。数据量大或者要离线用就上 IndexedDB。登录态我会让后端下发带 HttpOnly、Secure、SameSite 的 cookie,别把 token 放 localStorage,一旦有 XSS 就被直接读走。
localStorage.setItem('user', { id: 1 })
localStorage.getItem('user') // "[object Object]",只能存字符串
localStorage.setItem('user', JSON.stringify({ id: 1 })) // 正确写法
我们经常需要对业务中的一些数据进行存储,通常可以分为 短暂性存储 和 持久性储存。
- 短暂性的时候,我们只需要将数据存在内存中,只在运行时可用
- 持久性存储,可以分为 浏览器端 与 服务器端
- 浏览器:
cookie: 通常用于存储用户身份,登录状态等http中自动携带, 体积上限为4K, 可自行设置过期时间
localStorage / sessionStorage: 长久储存/窗口关闭删除, 体积限制为4~5MindexDB
- 服务器:
- 分布式缓存
redis - 数据库
- 分布式缓存
- 浏览器:
cookie和localSrorage、session、indexDB 的区别
| 特性 | cookie | localStorage | sessionStorage | indexDB |
|---|---|---|---|---|
| 数据生命周期 | 一般由服务器生成,可以设置过期时间 | 除非被清理,否则一直存在 | 页面关闭就清理 | 除非被清理,否则一直存在 |
| 数据存储大小 | 4K | 5M | 5M | 无限 |
| 与服务端通信 | 每次都会携带在 header 中,对于请求性能影响 | 不参与 | 不参与 | 不参与 |
从上表可以看到,
cookie已经不建议用于存储。如果没有大量数据存储需求的话,可以使用localStorage和sessionStorage。对于不怎么改变的数据尽量使用localStorage存储,否则可以用sessionStorage存储。
对于 cookie,我们还需要注意安全性
| 属性 | 作用 |
|---|---|
value | 如果用于保存用户登录态,应该将该值加密,不能使用明文的用户标识 |
http-only | 不能通过 JS访问 Cookie,减少 XSS攻击 |
secure | 只能在协议为 HTTPS 的请求中携带 |
same-site | 规定浏览器不能在跨域请求中携带 Cookie,减少 CSRF 攻击 |
Name,即该Cookie的名称。Cookie一旦创建,名称便不可更改。Value,即该Cookie的值。如果值为Unicode字符,需要为字符编码。如果值为二进制数据,则需要使用BASE64编码。Max Age,即该Cookie失效的时间,单位秒,也常和Expires一起使用,通过它可以计算出其有效时间。Max Age如果为正数,则该Cookie在Max Age秒之后失效。如果为负数,则关闭浏览器时Cookie即失效,浏览器也不会以任何形式保存该Cookie。Path,即该Cookie的使用路径。如果设置为/path/,则只有路径为/path/的页面可以访问该Cookie。如果设置为/,则本域名下的所有页面都可以访问该Cookie。Domain,即可以访问该Cookie的域名。例如如果设置为.zhihu.com,则所有以zhihu.com,结尾的域名都可以访问该Cookie。Size字段,即此Cookie的大小。Http字段,即Cookie的httponly属性。若此属性为true,则只有在HTTP Headers中会带有此 Cookie 的信息,而不能通过document.cookie来访问此 Cookie。Secure,即该Cookie是否仅被使用安全协议传输。安全协议。安全协议有HTTPS、SSL等,在网络上传输数据之前先将数据加密。默认为false。
💬 面试官追问
token放localStorage还是cookie?我倾向
HttpOnly的cookie,JS读不到,XSS偷不走。代价是要防CSRF,配SameSite=Lax加关键接口校验token。放localStorage不用管CSRF,但只要页面有一个XSS就全完了。接口请求头突然变得很大,查下来同域名下塞了二十几个业务
cookie,怎么处理?不需要服务端读的数据全搬到
localStorage或IndexedDB。cookie只要域名和路径匹配就会进请求头,静态资源请求也带,所以静态资源最好放在不带cookie的独立域名上。在新标签页打开同一个页面,
sessionStorage里的数据还在吗?看怎么开的。直接新开标签输入地址是空的;「复制标签页」或者通过链接
target="_blank"打开(带opener)的会拷贝一份当时的数据,之后两边各改各的,互不影响。localStorage.setItem在Safari隐私模式下或者存满了会怎样?会抛
QuotaExceededError,不处理的话后面的代码直接中断。所以写入都要try/catch,失败了降级到内存变量;存大量数据之前可以用navigator.storage.estimate()看看还剩多少配额。多个子域名要共享登录态,
cookie怎么设?Domain设成主域,比如.example.com,子域都能带上;Path设/。范围越大越危险,任何一个子域有XSS或被接管都可能拿到它,所以一定配HttpOnly,非必要别放大范围。
# 7 跨域方案
⚡ 30 秒速记
- 同源 = 协议 + 域名 + 端口都一样;同源策略拦的是浏览器读响应,请求其实已经到服务器了
CORS首选:服务端回Access-Control-Allow-Origin;非简单请求(PUT、自定义头、application/json)先发OPTIONS预检- 带
cookie:前端credentials: 'include',后端Allow-Origin必须是具体域名不能*,再加Allow-Credentials: true - 代理:开发用
devServer.proxy,线上用Nginx反代,页面只请求同域/api,浏览器眼里压根没跨域 JSONP只能GET、有安全风险,已过时;页面间通信用postMessage;WebSocket不受同源策略约束,但服务端要校验Origin
跨域是浏览器同源策略的限制,最正规的解法是 CORS,让服务端在响应头里声明允许哪些源访问。 要知道请求其实是发出去了,服务器也处理了,只是浏览器看响应头没授权,不把结果交给 JS。简单请求直接发;用了 PUT、自定义头或者 JSON 请求体,浏览器会先发 OPTIONS 预检,通过了才发真请求。另一条路是代理,开发环境用 devServer.proxy,线上让 Nginx 把 /api 转到后端,同源了自然没问题。JSONP 只能 GET,现在基本只在老代码里见。
fetch('https://api.example.com/user', { credentials: 'include' })
// 服务端要回:
// Access-Control-Allow-Origin: https://www.example.com (不能是 *)
// Access-Control-Allow-Credentials: true
很多种方法,但万变不离其宗,都是为了搞定同源策略。重用的有
jsonp、iframe、cors、img、HTML5 postMessage等等。其中用到html标签进行跨域的原理就是html不受同源策略影响。但只是接受Get的请求方式,这个得清楚。
延伸1:img iframe script 来发送跨域请求有什么优缺点?
1. iframe
- 优点:跨域完毕之后
DOM操作和互相之间的JavaScript调用都是没有问题的 - 缺点:1.若结果要以
URL参数传递,这就意味着在结果数据量很大的时候需要分割传递,巨烦。2.还有一个是iframe本身带来的,母页面和iframe本身的交互本身就有安全性限制。
2. script
- 优点:可以直接返回
json格式的数据,方便处理 - 缺点:只接受
GET请求方式
3. 图片ping
- 优点:可以访问任何
url,一般用来进行点击追踪,做页面分析常用的方法 - 缺点:不能访问响应文本,只能监听是否响应
延伸2:配合 webpack 进行反向代理?
webpack 在 devServer 选项里面提供了一个 proxy 的参数供开发人员进行反向代理
'/api': {
target: 'http://www.example.com', // your target host
changeOrigin: true, // needed for virtual hosted sites
pathRewrite: {
'^/api': '' // rewrite path
}
},
然后再配合
http-proxy-middleware插件对api请求地址进行代理
const express = require('express');
const proxy = require('http-proxy-middleware');
// proxy api requests
const exampleProxy = proxy(options); // 这里的 options 就是 webpack 里面的 proxy 选项对应的每个选项
// mount `exampleProxy` in web server
const app = express();
app.use('/api', exampleProxy);
app.listen(3000);
然后再用
nginx把允许跨域的源地址添加到报头里面即可
说到
nginx,可以再谈谈CORS配置,大致如下
location / {
if ($request_method = 'OPTIONS') {
add_header 'Access-Control-Allow-Origin' '*';
add_header 'Access-Control-Allow-Methods' 'GET, POST, OPTIONS';
add_header 'Access-Control-Allow-Credentials' 'true';
add_header 'Access-Control-Allow-Headers' 'DNT, X-Mx-ReqToken, Keep-Alive, User-Agent, X-Requested-With, If-Modified-Since, Cache-Control, Content-Type';
add_header 'Access-Control-Max-Age' 86400;
add_header 'Content-Type' 'text/plain charset=UTF-8';
add_header 'Content-Length' 0;
return 200;
}
}
💬 面试官追问
Nginx里写了Allow-Origin: *加Allow-Credentials: true,带cookie的请求还是报跨域,为什么?带凭证的请求不允许
Allow-Origin是*,浏览器直接拒。要回具体的源,一般是读请求的Origin,在白名单里就原样返回,同时加Vary: Origin,免得CDN把一个源的响应缓存给另一个源。每个请求前面都多一个
OPTIONS,接口耗时翻倍,能省吗?能。服务端回
Access-Control-Max-Age: 86400让浏览器缓存预检结果(Chrome上限2小时);或者尽量走简单请求,少加自定义头。最彻底的是走同域代理,根本不跨域。本地
devServer.proxy配好了一切正常,部署到测试环境又跨域了,为什么?devServer.proxy只存在于本地开发服务器,打包产物里没有这段逻辑。测试和线上要在Nginx里配同样的/api转发,或者后端开CORS,各环境保持一致。服务端日志能看到请求进来了,前端还是拿不到数据,怎么回事?
这正是同源策略的行为:请求发到了,服务器也处理了,是浏览器发现响应头没授权,把结果拦下了。所以跨域拦不住
CSRF,有副作用的接口不能指望靠跨域保护。主页面和跨域
iframe要互传状态,怎么做才安全?用
postMessage,发的时候第二个参数写明目标源而不是*;收的时候先判断event.origin在白名单里,再校验消息格式。不校验origin的话,任何页面嵌你都能给你发假消息。
# 8 XSS 和 CSRF
⚡ 30 秒速记
XSS:攻击者的脚本在你的页面里跑起来了,分存储型、反射型、DOM型- 防
XSS:按输出位置转义(HTML、属性、URL各不同)、用textContent不用innerHTML、富文本走白名单净化(DOMPurify)、开CSP、cookie加HttpOnly CSRF:别的网站借你浏览器里的登录cookie发请求,攻击者看不到响应但能触发操作- 防
CSRF:SameSite=Lax/Strict、CSRF Token、校验Origin,有副作用的操作绝不用GET - 一句话区分:
XSS是代码跑进了你的页面,CSRF是冒用你的身份;有XSS时CSRF防护基本失效,能执行脚本就能读到页面里的token
XSS 是攻击者把脚本注入到你的页面里执行,CSRF 是攻击者在别的网站诱导你的浏览器,带着你的登录 cookie 去请求目标站。 XSS 的根子是把用户输入当代码执行了,所以输出时要按位置转义,富文本用白名单净化,再用 CSP 兜底,就算漏了一个注入点外部脚本也跑不起来。CSRF 利用的是浏览器自动带 cookie,攻击者其实读不到 cookie 也看不到响应,所以防法是让请求带上攻击者拿不到的东西,比如 CSRF Token,再配 SameSite。另外老资料说 Chrome 会自动拦反射型 XSS,那个 XSS Auditor 在 Chrome 78 就删了,别指望浏览器。
el.innerHTML = userInput // 危险:<img src=x onerror=alert(1)> 会执行
el.textContent = userInput // 安全:原样当文本显示
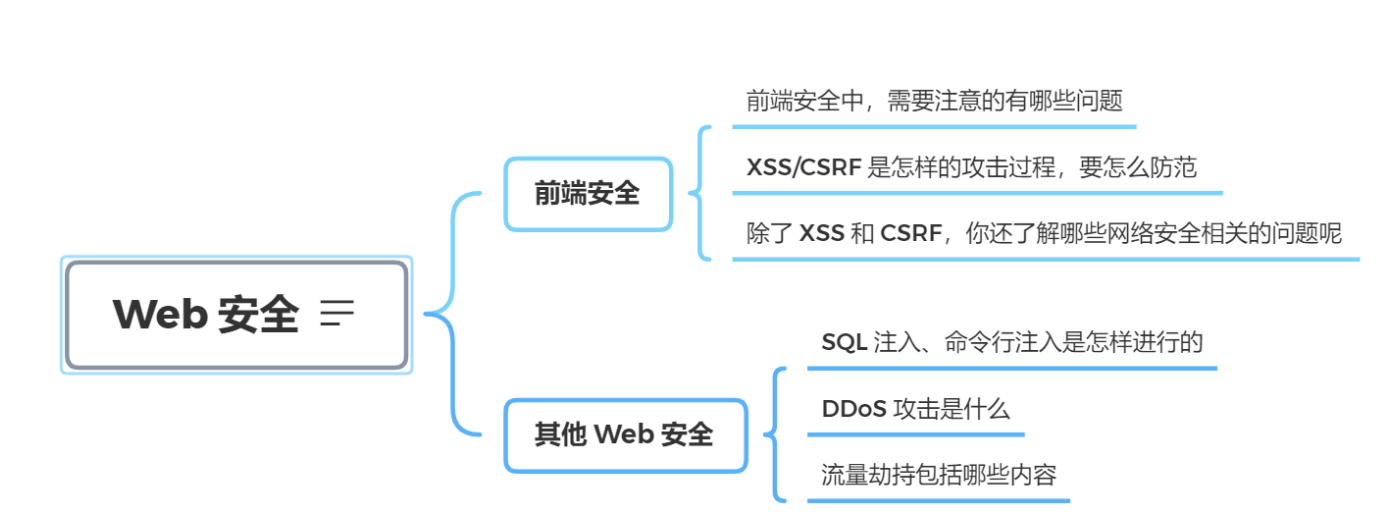
1. XSS
涉及面试题:什么是
XSS攻击?如何防范XSS攻击?什么是CSP?
XSS简单点来说,就是攻击者想尽一切办法将可以执行的代码注入到网页中。XSS可以分为多种类型,但是总体上我认为分为两类:持久型和非持久型。- 持久型也就是攻击的代码被服务端写入进数据库中,这种攻击危害性很大,因为如果网站访问量很大的话,就会导致大量正常访问页面的用户都受到攻击。
举个例子,对于评论功能来说,就得防范持久型
XSS攻击,因为我可以在评论中输入以下内容
- 这种情况如果前后端没有做好防御的话,这段评论就会被存储到数据库中,这样每个打开该页面的用户都会被攻击到。
- 非持久型相比于前者危害就小的多了,一般通过修改
URL参数的方式加入攻击代码,诱导用户访问链接从而进行攻击。
举个例子,如果页面需要从
URL中获取某些参数作为内容的话,不经过过滤就会导致攻击代码被执行
<!-- http://www.domain.com?name=<script>alert(1)</script> -->
<div>{{name}}</div>
但是对于这种攻击方式来说,如果用户使用
Chrome这类浏览器的话,浏览器就能自动帮助用户防御攻击。但是我们不能因此就不防御此类攻击了,因为我不能确保用户都使用了该类浏览器。
对于
XSS攻击来说,通常有两种方式可以用来防御。
- 转义字符
首先,对于用户的输入应该是永远不信任的。最普遍的做法就是转义输入输出的内容,对于引号、尖括号、斜杠进行转义
function escape(str) {
str = str.replace(/&/g, '&')
str = str.replace(/</g, '<')
str = str.replace(/>/g, '>')
str = str.replace(/"/g, '&quto;')
str = str.replace(/'/g, ''')
str = str.replace(/`/g, '`')
str = str.replace(/\//g, '/')
return str
}
通过转义可以将攻击代码
<script>alert(1)</script>变成
// -> <script>alert(1)</script>
escape('<script>alert(1)</script>')
但是对于显示富文本来说,显然不能通过上面的办法来转义所有字符,因为这样会把需要的格式也过滤掉。对于这种情况,通常采用白名单过滤的办法,当然也可以通过黑名单过滤,但是考虑到需要过滤的标签和标签属性实在太多,更加推荐使用白名单的方式
const xss = require('xss')
let html = xss('<h1 id="title">XSS Demo</h1><script>alert("xss");</script>')
// -> <h1>XSS Demo</h1><script>alert("xss");</script>
console.log(html)
以上示例使用了
js-xss来实现,可以看到在输出中保留了h1标签且过滤了script标签
- CSP
CSP本质上就是建立白名单,开发者明确告诉浏览器哪些外部资源可以加载和执行。我们只需要配置规则,如何拦截是由浏览器自己实现的。我们可以通过这种方式来尽量减少XSS攻击。
通常可以通过两种方式来开启 CSP:
- 设置
HTTP Header中的Content-Security-Policy - 设置
meta标签的方式<meta http-equiv="Content-Security-Policy">
这里以设置 HTTP Header 来举例
只允许加载本站资源
Content-Security-Policy: default-src ‘self’
只允许加载 HTTPS 协议图片
Content-Security-Policy: img-src https://*
允许加载任何来源框架
Content-Security-Policy: child-src 'none'
当然可以设置的属性远不止这些,你可以通过查阅 文档 (opens new window) 的方式来学习,这里就不过多赘述其他的属性了。
对于这种方式来说,只要开发者配置了正确的规则,那么即使网站存在漏洞,攻击者也不能执行它的攻击代码,并且
CSP的兼容性也不错。
2 CSRF
跨站请求伪造(英语:
Cross-site request forgery),也被称为one-click attack或者session riding,通常缩写为CSRF或者XSRF, 是一种挟制用户在当前已登录的Web应用程序上执行非本意的操作的攻击方法
CSRF就是利用用户的登录态发起恶意请求
如何攻击
假设网站中有一个通过 Get 请求提交用户评论的接口,那么攻击者就可以在钓鱼网站中加入一个图片,图片的地址就是评论接口
<img src="http://www.domain.com/xxx?comment='attack'"/>
res.setHeader('Set-Cookie', `username=poetry2;sameSite = strict;path=/;httpOnly;expires=${getCookirExpires()}`)
在B网站,危险网站向A网站发起请求
<!DOCTYPE html>
<html>
<body>
<!-- 利用img自动发送请求 -->
<img src="http://localhost:8000/api/user/login" />
</body>
</html>
会带上A网站的cookie
// 在A网站下发cookie的时候,加上sameSite=strict,这样B网站在发送A网站请求,不会自动带上A网站的cookie,保证了安全
// NAME=VALUE 赋予Cookie的名称及对应值
// expires=DATE Cookie 的有效期
// path=PATH 赋予Cookie的名称及对应值
// domain=域名 作为 Cookie 适用对象的域名 (若不指定则默认为创建 Cookie 的服务器的域名) (一般不指定)
// Secure 仅在 HTTPS 安全通信时才会发送 Cookie
// HttpOnly 加以限制,使 Cookie 不能被 JavaScript 脚本访问
// SameSite Lax|Strict|None 它允许您声明该Cookie是否仅限于第一方或者同一站点上下文
res.setHeader('Set-Cookie', `username=poetry;sameSite=strict;path=/;httpOnly;expires=${getCookirExpires()}`)
如何防御
Get请求不对数据进行修改- 不让第三方网站访问到用户
Cookie - 阻止第三方网站请求接口
- 请求时附带验证信息,比如验证码或者
token SameSite Cookies: 只能当前域名的网站发出的http请求,携带这个Cookie。当然,由于这是新的cookie属性,在兼容性上肯定会有问题
CSRF攻击,仅仅是利用了http携带cookie的特性进行攻击的,但是攻击站点还是无法得到被攻击站点的cookie。这个和XSS不同,XSS是直接通过拿到Cookie等信息进行攻击的
在CSRF攻击中,就Cookie相关的特性:
- http请求,会自动携带Cookie。
- 携带的cookie,还是http请求所在域名的cookie。
3 密码安全
加盐
对于密码存储来说,必然是不能明文存储在数据库中的,否则一旦数据库泄露,会对用户造成很大的损失。并且不建议只对密码单纯通过加密算法加密,因为存在彩虹表的关系
- 通常需要对密码加盐,然后进行几次不同加密算法的加密
// 加盐也就是给原密码添加字符串,增加原密码长度
sha256(sha1(md5(salt + password + salt)))
但是加盐并不能阻止别人盗取账号,只能确保即使数据库泄露,也不会暴露用户的真实密码。一旦攻击者得到了用户的账号,可以通过暴力破解的方式破解密码。对于这种情况,通常使用验证码增加延时或者限制尝试次数的方式。并且一旦用户输入了错误的密码,也不能直接提示用户输错密码,而应该提示账号或密码错误
前端加密
虽然前端加密对于安全防护来说意义不大,但是在遇到中间人攻击的情况下,可以避免明文密码被第三方获取
4. 总结
XSS:跨站脚本攻击,是一种网站应用程序的安全漏洞攻击,是代码注入的一种。常见方式是将恶意代码注入合法代码里隐藏起来,再诱发恶意代码,从而进行各种各样的非法活动
防范:记住一点 “所有用户输入都是不可信的”,所以得做输入过滤和转义
CSRF:跨站请求伪造,也称XSRF,是一种挟制用户在当前已登录的Web应用程序上执行非本意的操作的攻击方法。与XSS相比,XSS利用的是用户对指定网站的信任,CSRF利用的是网站对用户网页浏览器的信任。
防范:用户操作验证(验证码),额外验证机制(
token使用)等
💬 面试官追问
评论区已经把
<和>转义了,还是被人通过链接触发了脚本,转义没用吗?转义有用,但要看输出到哪。比如用户输入拼进了
href,javascript:alert(1)里一个尖括号都没有;拼进onclick或者script里也一样。不同位置要不同的转义,URL还要校验协议只允许http/https。前端用正则把
<script>删掉再提交,算不算防住了XSS?不算。前端校验可以直接绕过调接口,而且
<img onerror>、<svg onload>这种根本不需要script标签。富文本要在服务端用成熟的白名单库净化,前端渲染前再过一遍DOMPurify。会话
cookie已经是SameSite=Lax了,还需要CSRF Token吗?看接口。
Lax挡住了跨站的POST和iframe、图片请求,但顶层导航的GET还会带cookie,所以有副作用的GET照样被打。另外SameSite按站点算,兄弟子域被攻破就不算跨站。资金类接口我还是会加Token或二次验证。CSP怎么配才真的有用?核心是
script-src别写'unsafe-inline'和通配域名,内联脚本用nonce,比如script-src 'nonce-随机值' 'strict-dynamic'。上线前先用Content-Security-Policy-Report-Only跑一段时间收报告,不然容易把自己的统计脚本拦掉。攻击者读不到
cookie,那CSRF到底是怎么得手的?它不需要读,只需要让你的浏览器发请求。比如你登录着银行,又打开了一个恶意页面,页面里藏个自动提交的表单指向银行转账接口,浏览器会自动带上银行的
cookie,服务器分不出是不是你本人点的。
# 9 Service Worker
⚡ 30 秒速记
Service Worker是浏览器和网络之间的一层可编程代理,跑在独立线程,能拦截作用域内页面的请求,是PWA离线的基础- 生命周期:
register→install(预缓存)→ 等旧版本释放(waiting)→activate(清旧缓存)→ 处理fetch - 限制:只能
HTTPS或localhost;不能碰DOM,靠postMessage和页面通信;作用域默认是脚本所在目录 - 首次访问的页面不受控,下次加载才被接管;想立刻接管用
self.skipWaiting()+clients.claim() - 缓存策略:带
hash的静态资源cache-first,接口network-first,不太敏感的内容stale-while-revalidate
Service Worker 可以理解成装在浏览器里的一个小代理服务器,页面发出的请求先经过它,由它决定给缓存还是走网络。 典型用法是 install 时把核心资源存进 Cache Storage,fetch 时拦截请求,缓存里有就直接返回,所以断网也能打开页面。它跑在独立线程里,不能操作 DOM,跟页面说话要用 postMessage;而且必须 HTTPS,作用域默认就是脚本所在目录。最容易踩的是更新:新版本装好后会一直 waiting,要等所有旧页面关掉才激活,用户看到的老是旧版。
// sw.js:缓存优先,未命中再走网络(原例里漏了这一步,未命中会直接失败)
self.addEventListener('fetch', e => {
e.respondWith(caches.match(e.request).then(res => res || fetch(e.request)))
})
Service workers本质上充当Web应用程序与浏览器之间的代理服务器,也可以在网络可用时作为浏览器和网络间的代理。它们旨在(除其他之外)使得能够创建有效的离线体验,拦截网络请求并基于网络是否可用以及更新的资源是否驻留在服务器上来采取适当的动作。他们还允许访问推送通知和后台同步API
浏览器对 ServiceWorker 做了很多限制
- 在
ServiceWorker中无法直接访问DOM,但可以通过postMessage接口发送的消息来与其控制的页面进行通信 ServiceWorker只能在本地环境下或HTTPS网站中使用ServiceWorker有作用域的限制,一个ServiceWorker脚本只能作用于当前路径及其子路径;
目前该技术通常用来做缓存文件,提高首屏速度
// index.js
if (navigator.serviceWorker) {
navigator.serviceWorker
.register("sw.js")
.then(function(registration) {
console.log("service worker 注册成功");
})
.catch(function(err) {
console.log("servcie worker 注册失败");
});
}
// sw.js
// 监听 `install` 事件,回调中缓存所需文件
self.addEventListener("install", e => {
e.waitUntil(
caches.open("my-cache").then(function(cache) {
return cache.addAll(["./index.html", "./index.js"]);
})
);
});
// 拦截所有请求事件
// 如果缓存中已经有请求的数据就直接用缓存,否则去请求数据
self.addEventListener("fetch", e => {
e.respondWith(
caches.match(e.request).then(function(response) {
if (response) {
return response;
}
console.log("fetch source");
})
);
});
打开页面,可以在开发者工具中的
Application看到Service Worker已经启动了
在 Cache 中也可以发现我们所需的文件已被缓存
当我们重新刷新页面可以发现我们缓存的数据是从
ServiceWorker中读取的
💬 面试官追问
资源都写进
Cache Storage了,断网刷新还是白屏,缺了什么?缓存只是存着,得在
fetch事件里用respondWith把它返回出去才算命中。再查两件事:入口index.html有没有缓存,当前页面是不是已经被Service Worker控制(第一次访问不受控)。发了新版本,用户刷新好几次还是旧页面,为什么?
新的
Service Worker装好后在waiting,要等这个作用域下所有标签页都关掉才激活,刷新不算关闭。可以在install里调self.skipWaiting(),或者页面上提示「有新版本,点击刷新」,点了再发消息让它skipWaiting。sw.js从根目录挪到/shop/下面,首页不被拦截了,是缓存坏了吗?不是,是作用域变了,默认只能控制
/shop/及其子路径。要么把脚本放回根目录,要么服务端给sw.js加Service-Worker-Allowed: /响应头,再在register时传scope: '/'。sw.js自己被CDN缓存了一天,会不会导致一天都更新不了?现在不会太久。浏览器检查更新时默认绕过
HTTP缓存去拿sw.js(updateViaCache默认imports),而且最多每24小时强制检查一次。保险起见,sw.js本身还是配no-cache。想在断网时保存表单,能不能在
Service Worker里直接读表单内容?读不了,它没有
DOM。页面自己采集数据,存进IndexedDB或postMessage给它;联网后用Background Sync重发(目前只有Chromium系支持,要做降级)。
# 10 DOM 节点操作
⚡ 30 秒速记
- 创建:
createElement、createTextNode、createDocumentFragment、cloneNode(true)(不会复制addEventListener绑的事件) - 插入删除:老接口
appendChild/insertBefore/removeChild/replaceChild;新接口append/prepend/before/after/remove()/replaceWith(),能直接传字符串 - 查找:
getElementById最快,querySelector(All)最通用,closest()往上找祖先 - 坑:
querySelectorAll返回静态NodeList;getElementsBy*和children返回动态HTMLCollection,边遍历边删会漏 - 把已在页面里的节点
append到别处是移动不是复制;批量插入用DocumentFragment或拼好再一次挂上去
DOM 操作就是增删改查四类,面试时我会顺带说清哪些是老接口、哪些是新接口,还有静态集合和动态集合的区别。 老的 appendChild、removeChild 要通过父节点调用,新的 el.remove()、el.replaceWith()、el.before() 直接在节点自己身上调,写起来短很多。查找用 querySelector 最灵活,但它返回的是快照;getElementsByClassName 返回的是活的集合,文档一变它就跟着变,在循环里边遍历边删经常删一半漏一半。批量插入我会先放进 DocumentFragment,最后一次挂上去。
const list = document.getElementsByClassName('item') // 动态集合
for (let i = 0; i < list.length; i++) list[i].remove()
// 只删掉一半:每删一个,list 立刻少一项,下标跳过了下一个
document.querySelectorAll('.item').forEach(el => el.remove()) // 静态快照,全删干净
(1)创建新节点
createDocumentFragment() //创建一个DOM片段
createElement() //创建一个具体的元素
createTextNode() //创建一个文本节点
(2)添加、移除、替换、插入
appendChild(node)
removeChild(node)
replaceChild(new,old)
insertBefore(new,old)
(3)查找
getElementById();
getElementsByName();
getElementsByTagName();
getElementsByClassName();
querySelector();
querySelectorAll();
(4)属性操作
getAttribute(key);
setAttribute(key, value);
hasAttribute(key);
removeAttribute(key);
💬 面试官追问
一次往列表插入
300条,循环里逐个appendChild,怎么优化?先建个
DocumentFragment,300个节点都塞进去,最后list.append(frag)一次挂上。其实浏览器会把连续写操作攒到一起布局,真正慢的往往是循环里还读了offsetHeight;数量再大就该上虚拟列表了。想把占位节点换成真实卡片,位置不能变,怎么写?
placeholder.replaceWith(card)一句就行,老写法是parent.replaceChild(card, placeholder)。别用先删再appendChild,那样卡片会跑到父容器末尾。removeChild偶尔报「要删除的节点不是它的子节点」,什么原因?一般是拿着旧引用:列表整块重新渲染后,旧节点已经不在这个父节点下了,或者被别的逻辑先删了。直接用
el.remove(),节点不在文档里调用也不会报错;或者删之前判断el.parentNode === parent。cloneNode(true)克隆了一个按钮,点了没反应,为什么?cloneNode只复制节点和属性,不复制addEventListener绑的监听器(写在onclick属性上的会跟着复制)。要么克隆后重新绑,要么把事件委托到父容器上,新节点自然生效。判断按钮有没有
disabled,用getAttribute还是el.disabled?用属性
el.disabled,它返回布尔值。getAttribute('disabled')在disabled=""时返回空字符串,if判断是假,容易写错;只关心有没有这个特性就用hasAttribute('disabled')。
# 11 掌握页面的加载过程
⚡ 30 秒速记
- 顺序:拿到
HTML→ 边下边解析 → 遇到外部资源并行下载 → 解析完触发DOMContentLoaded→ 图片等全部加载完触发load - 普通
script暂停解析,等下载执行完再继续;CSS不暂停解析,但挡渲染,也挡它后面的同步脚本 defer:并行下载,解析完按顺序执行,在DOMContentLoaded之前;async:下载完立刻执行,顺序不定;type="module"默认就是deferDOMContentLoaded不等图片和async脚本,但要等defer脚本;load要等全部资源- 采集用
performance.getEntriesByType('navigation')(老的performance.timing已废弃);首屏看FCP/LCP
页面加载就是浏览器边下载边从上往下解析 HTML,碰到资源就并行去拿,碰到普通脚本就停下来等它执行完。 所以 head 里放一个慢的同步脚本,body 就迟迟出不来。解决办法是脚本加 defer 或 async:defer 不挡解析,等文档解析完再按顺序执行,适合有依赖关系的业务代码;async 下载完立刻跑,谁先到谁先执行,适合统计这种独立脚本。判断加载阶段看两个事件,DOMContentLoaded 是 HTML 解析完、defer 脚本跑完,load 是图片、样式这些全部到齐。
<script defer src="vendor.js"></script>
<script defer src="app.js"></script> <!-- 一定在 vendor.js 之后执行 -->
<script async src="analytics.js"></script> <!-- 什么时候到什么时候跑 -->
网页加载流程
- 当我们打开网址的时候,浏览器会从服务器中获取到 HTML 内容
- 浏览器获取到 HTML 内容后,就开始从上到下解析 HTML 的元素
<head>元素内容会先被解析,此时浏览器还没开始渲染页面- 我们看到
<head>元素里有用于描述页面元数据的<meta>元素,还有一些<link>元素涉及外部资源(如图片、CSS 样式等),此时浏览器会去获取这些外部资源。除此之外,我们还能看到<head>元素中还包含着不少的<script>元素,这些<script>元素通过src属性指向外部资源
- 我们看到
- 当浏览器解析到这里时(步骤 3),会暂停解析并下载 JavaScript 脚本
- 当 JavaScript 脚本下载完成后,浏览器的控制权转交给 JavaScript 引擎。当脚本执行完成后,控制权会交回给渲染引擎,渲染引擎继续往下解析
HTML页面 - 此时
<body>元素内容开始被解析,浏览器开始渲染页面
- 在这个过程中,我们看到
<head>中放置的<script>元素会阻塞页面的渲染过程:把 JavaScript 放在<head>里,意味着必须把所有 JavaScript 代码都下载、解析和解释完成后,才能开始渲染页面。- 如果外部脚本加载时间很长(比如一直无法完成下载),就会造成网页长时间失去响应,浏览器就会呈现“假死”状态,用户体验会变得很糟糕
- 因此,对于对性能要求较高、需要快速将内容呈现给用户的网页,常常会将 JavaScript 脚本放在
<body>的最后面。这样可以避免资源阻塞,页面得以迅速展示。我们还可以使用defer/async/preload等属性来标记<script>标签,来控制 JavaScript 的加载顺序
延迟加载的方式有哪些
js 的加载、解析和执行会阻塞页面的渲染过程,因此我们希望 js 脚本能够尽可能的延迟加载,提高页面的渲染速度。
几种方式是:
- 将 js 脚本放在文档的底部,来使 js 脚本尽可能的在最后来加载执行
- 给 js 脚本添加
defer属性,这个属性会让脚本的加载与文档的解析同步解析,然后在文档解析完成后再执行这个脚本文件,这样的话就能使页面的渲染不被阻塞。多个设置了defer属性的脚本按规范来说最后是顺序执行的,但是在一些浏览器中可能不是这样 - 给 js 脚本添加
async属性,这个属性会使脚本异步加载,不会阻塞页面的解析过程,但是当脚本加载完成后立即执行 js脚本,这个时候如果文档没有解析完成的话同样会阻塞。多个async属性的脚本的执行顺序是不可预测的,一般不会按照代码的顺序依次执行 - 动态创建
DOM标签的方式,我们可以对文档的加载事件进行监听,当文档加载完成后再动态的创建script标签来引入 js 脚本
怎么判断页面是否加载完成
Load事件触发代表页面中的DOM,CSS,JS,图片已经全部加载完毕。DOMContentLoaded事件触发代表初始的HTML被完全加载和解析,不需要等待CSS,JS,图片加载
💬 面试官追问
HTML早就返回了,页面还是白屏好几秒,后端说不是他们的问题,你怎么解释?head里有同步script,解析器停在那等它下载和执行,后面的body根本还没解析。改成defer,或者看看是不是CSS太大挡着首次渲染。三个有依赖顺序的脚本,用
async还是defer?defer。它保证按书写顺序执行,而且是在解析完成后;async谁先下载完谁先跑,app.js可能比vendor.js先执行,直接报错。DOMContentLoaded要不要等CSS?本身不等,但如果样式表后面跟着同步脚本,脚本要等样式表下载完才执行,而
DOMContentLoaded要等脚本,间接就被CSS拖住了。defer脚本同理,执行前也要等前面的样式表。统计脚本要尽早上报,又不能拖慢首屏,怎么加载?
async就行,它不挡解析,下载完执行的那一下很短。更讲究的是把SDK动态插入,先在页面里放个队列缓存事件,SDK加载完再把队列里的事件补发,这样早期点击也不会丢。老项目脚本都放
body底部,有人要全改成async,你同意吗?不同意全改。底部脚本是按顺序执行的,全改
async顺序就乱了,有依赖的会报错。有依赖的改defer放回head让它早点下载,独立的第三方脚本再用async。
# 12 从输入URL到页面展示过程
⚡ 30 秒速记
- 主线:浏览器主进程处理输入 → 查缓存(
HSTS、Service Worker、HTTP缓存)→DNS→TCP握手 →TLS握手 → 发请求 → 收响应 → 渲染进程解析渲染 DNS:浏览器缓存 → 系统缓存 /hosts→ 本地DNS(递归)→ 根、顶级域、权威服务器(迭代)- 握手:
TCP1个RTT;TLS 1.2再2个,TLS 1.3只要1个;HTTP/3基于QUIC把两者合成1个 - 响应:
301/302重定向再走一遍;304用本地缓存;Content-Type是text/html才交给渲染进程 - 渲染:
DOM+CSSOM→ 布局 → 分层 → 绘制 → 合成线程分块栅格化 → 上屏;答题时挑一环深入讲更加分
输入 URL 到页面出来,大致是:解析地址、查缓存、DNS 拿 IP、建 TCP 和 TLS 连接、发请求拿响应,最后渲染进程把 HTML 变成像素。 我会先把主线讲完,再挑一两个点深入。比如连接这块,老资料讲的 SSL 四阶段握手已经过时了,现在主流是 TLS 1.3,握手只要一个往返,HTTP/3 更是把 TCP 和 TLS 合成了一次 QUIC 握手。缓存也要穿插着讲:强缓存命中连请求都不发,协商缓存才会拿到 304。渲染阶段重点说清 JS 挡解析、CSS 挡渲染这两点。
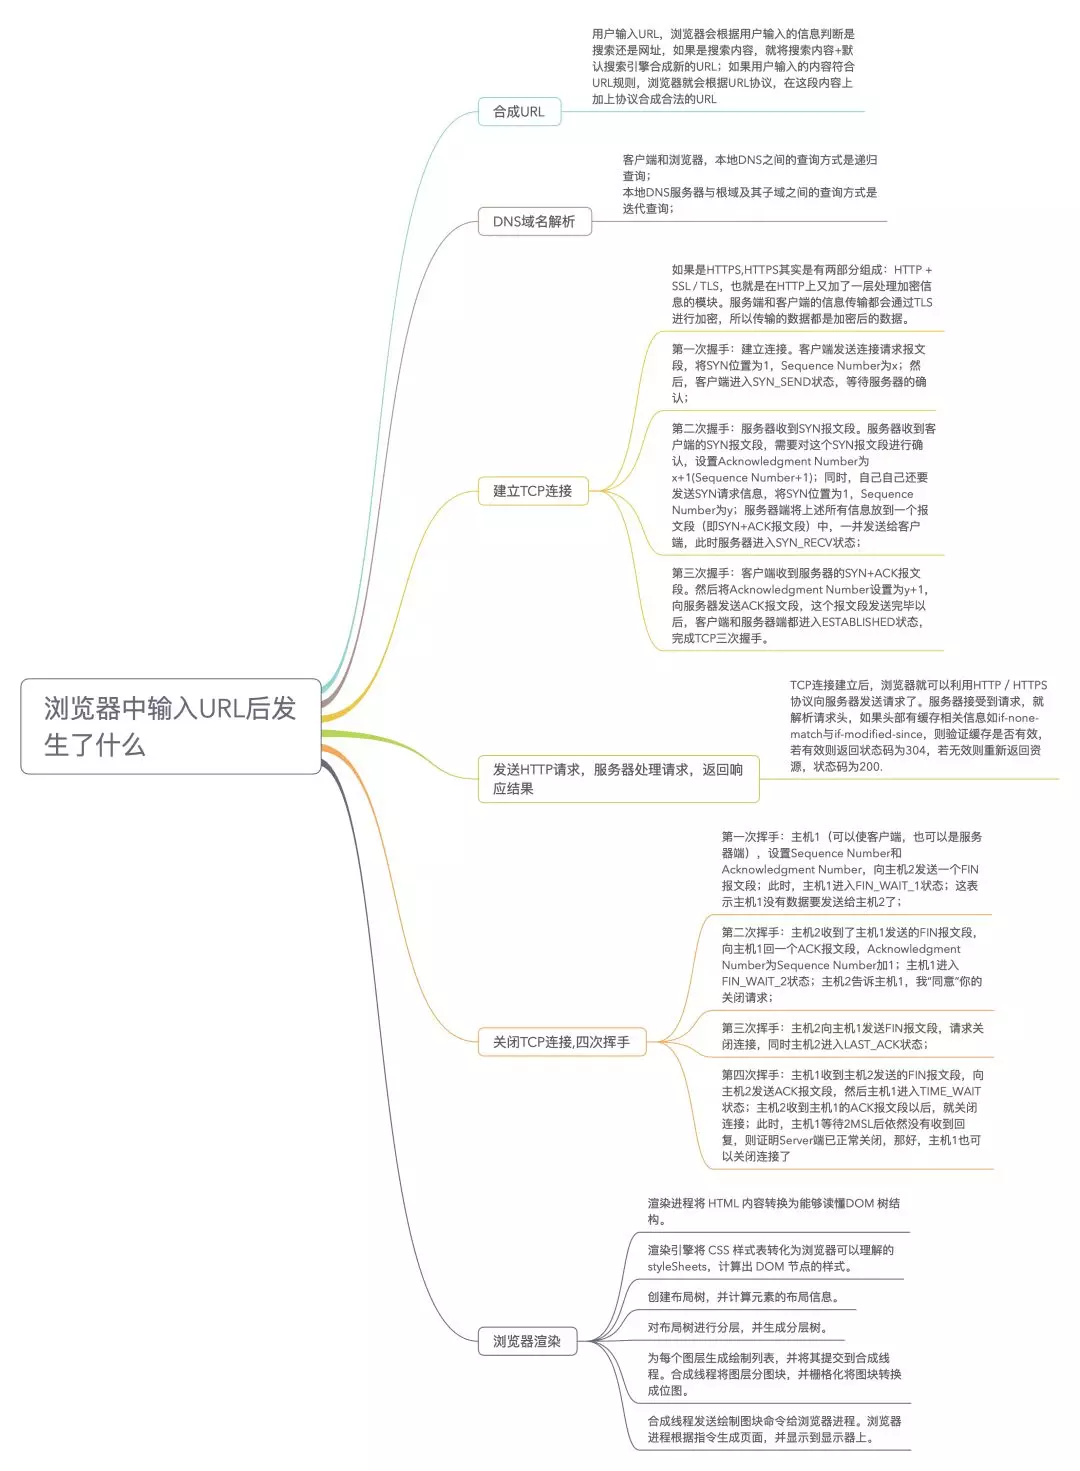
1. DNS域名解析
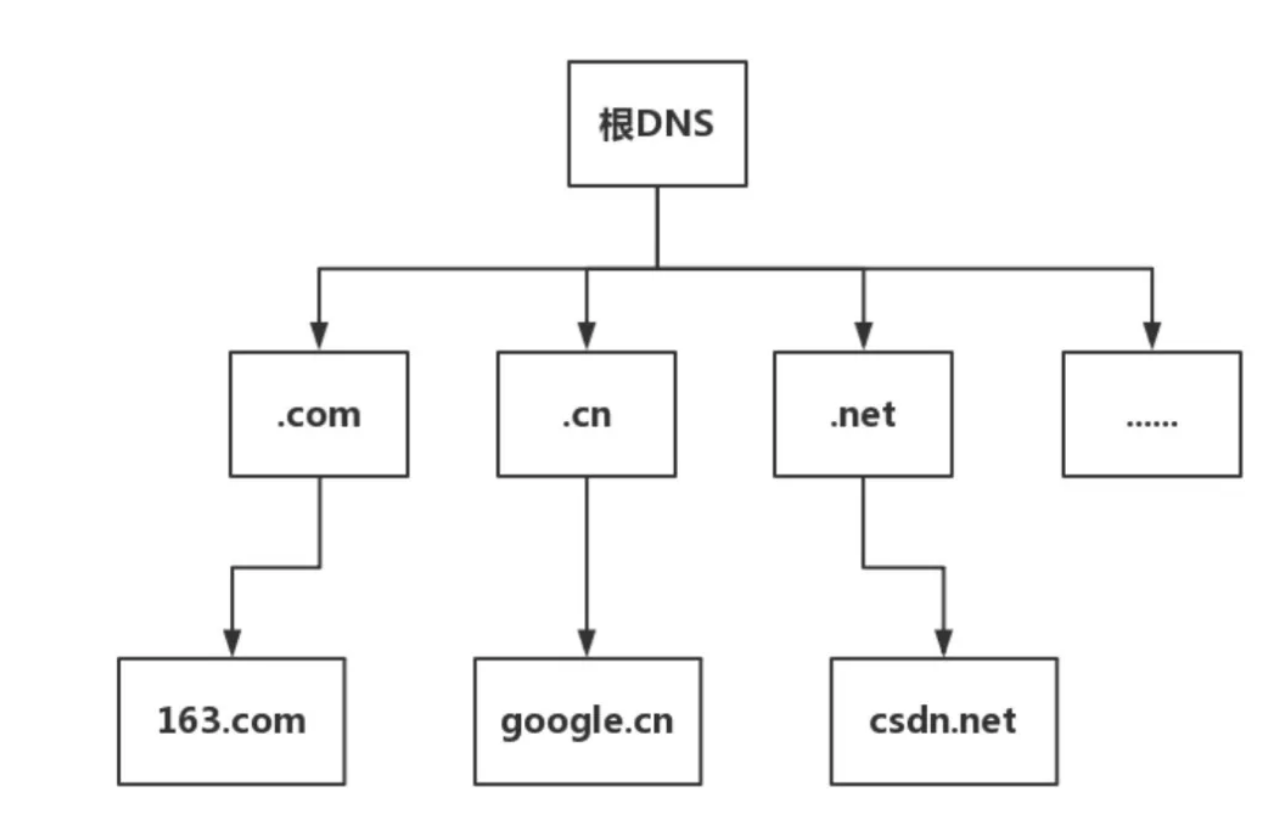
- 根 DNS 服务器 :返回顶级域 DNS 服务器的 IP 地址
- 顶级域 DNS 服务器:返回权威 DNS 服务器的 IP 地址
- 权威 DNS 服务器 :返回相应主机的 IP 地址
DNS的域名查找,在客户端和浏览器,本地DNS之间的查询方式是递归查询;在本地DNS服务器与根域及其子域之间的查询方式是迭代查询;
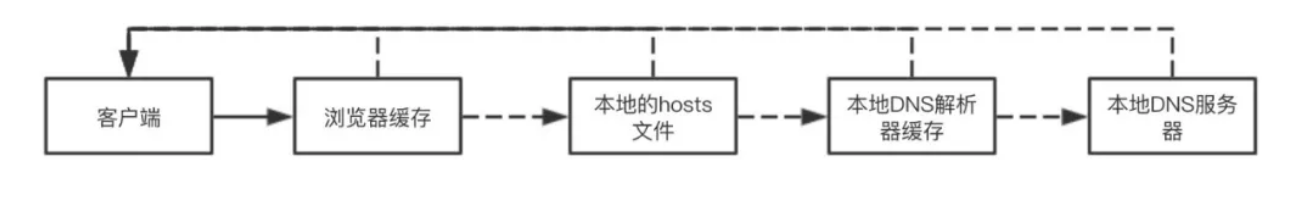
在客户端输入 URL 后,会有一个递归查找的过程,从浏览器缓存中查找->本地的hosts文件查找->找本地DNS解析器缓存查找->本地DNS服务器查找,这个过程中任何一步找到了都会结束查找流程。
如果本地DNS服务器无法查询到,则根据本地DNS服务器设置的转发器进行查询。若未用转发模式,则迭代查找过程如下图:
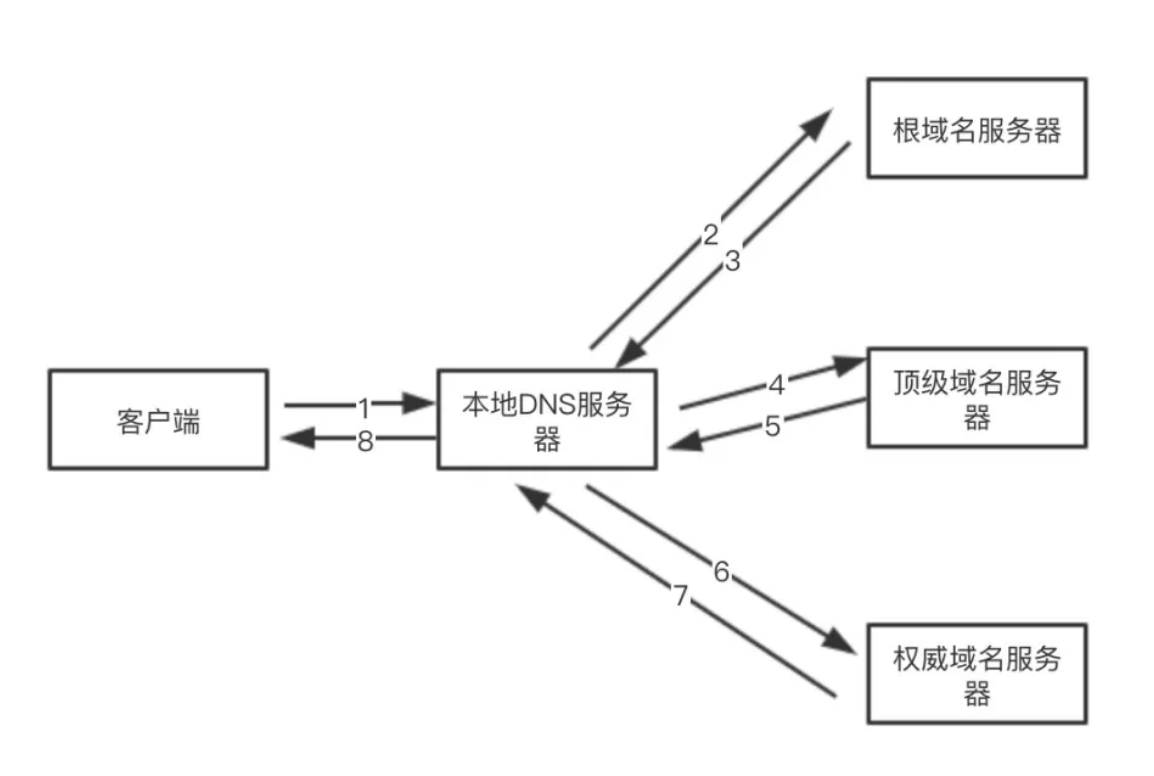
结合起来的过程,可以用一个图表示:
在查找过程中,有以下优化点:
- DNS存在着多级缓存,从离浏览器的距离排序的话,有以下几种:
浏览器缓存,系统缓存,路由器缓存,IPS服务器缓存,根域名服务器缓存,顶级域名服务器缓存,主域名服务器缓存。 - 在域名和 IP 的映射过程中,给了应用基于域名做负载均衡的机会,可以是简单的负载均衡,也可以根据地址和运营商做全局的负载均衡。
2. 建立TCP连接
首先,判断是不是https的,如果是,则HTTPS其实是HTTP + SSL / TLS 两部分组成,也就是在HTTP上又加了一层处理加密信息的模块。服务端和客户端的信息传输都会通过TLS进行加密,所以传输的数据都是加密后的数据
进行三次握手,建立TCP连接。
- 第一次握手:建立连接。客户端发送连接请求报文段
- 第二次握手:服务器收到SYN报文段。服务器收到客户端的SYN报文段,需要对这个SYN报文段进行确认
- 第三次握手:客户端收到服务器的SYN+ACK报文段,向服务器发送ACK报文段
SSL握手过程
- 第一阶段 建立安全能力 包括协议版本 会话Id 密码构件 压缩方法和初始随机数
- 第二阶段 服务器发送证书 密钥交换数据和证书请求,最后发送请求-相应阶段的结束信号
- 第三阶段 如果有证书请求客户端发送此证书 之后客户端发送密钥交换数据 也可以发送证书验证消息
- 第四阶段 变更密码构件和结束握手协议
完成了之后,客户端和服务器端就可以开始传送数据
发送HTTP请求,服务器处理请求,返回响应结果
TCP连接建立后,浏览器就可以利用
HTTP/HTTPS协议向服务器发送请求了。服务器接受到请求,就解析请求头,如果头部有缓存相关信息如if-none-match与if-modified-since,则验证缓存是否有效,若有效则返回状态码为304,若无效则重新返回资源,状态码为200
这里有发生的一个过程是HTTP缓存,是一个常考的考点,大致过程如图:
3. 关闭TCP连接
4. 浏览器渲染
按照渲染的时间顺序,流水线可分为如下几个子阶段:构建 DOM 树、样式计算、布局阶段、分层、栅格化和显示。如图:
- 渲染进程将 HTML 内容转换为能够读懂DOM 树结构。
- 渲染引擎将 CSS 样式表转化为浏览器可以理解的
styleSheets,计算出DOM节点的样式。 - 创建布局树,并计算元素的布局信息。
- 对布局树进行分层,并生成分层树。
- 为每个图层生成绘制列表,并将其提交到合成线程。合成线程将图层分图块,并栅格化将图块转换成位图。
- 合成线程发送绘制图块命令给浏览器进程。浏览器进程根据指令生成页面,并显示到显示器上。
构建 DOM 树
- 转码(Bytes -> Characters)—— 读取接收到的 HTML 二进制数据,按指定编码格式将字节转换为 HTML 字符串
- Tokens 化(Characters -> Tokens)—— 解析 HTML,将 HTML 字符串转换为结构清晰的 Tokens,每个 Token 都有特殊的含义同时有自己的一套规则
- 构建 Nodes(Tokens -> Nodes)—— 每个 Node 都添加特定的属性(或属性访问器),通过指针能够确定 Node 的父、子、兄弟关系和所属 treeScope(例如:iframe 的 treeScope 与外层页面的 treeScope 不同)
- 构建 DOM 树(Nodes -> DOM Tree)—— 最重要的工作是建立起每个结点的父子兄弟关系
样式计算
渲染引擎将 CSS 样式表转化为浏览器可以理解的 styleSheets,计算出 DOM 节点的样式。
CSS 样式来源主要有 3 种,分别是通过 link 引用的外部 CSS 文件、style标签内的 CSS、元素的 style 属性内嵌的 CSS。
页面布局
布局过程,即
排除 script、meta 等功能化、非视觉节点,排除display: none的节点,计算元素的位置信息,确定元素的位置,构建一棵只包含可见元素布局树。如图:
其中,这个过程需要注意的是回流和重绘
生成分层树
页面中有很多复杂的效果,如一些复杂的 3D 变换、页面滚动,或者使用 z-indexing 做 z 轴排序等,为了更加方便地实现这些效果,渲染引擎还需要为特定的节点生成专用的图层,并生成一棵对应的图层树(LayerTree)
栅格化
合成线程会按照视口附近的图块来优先生成位图,实际生成位图的操作是由栅格化来执行的。所谓栅格化,是指将图块转换为位图
通常一个页面可能很大,但是用户只能看到其中的一部分,我们把用户可以看到的这个部分叫做视口(viewport)。在有些情况下,有的图层可以很大,比如有的页面你使用滚动条要滚动好久才能滚动到底部,但是通过视口,用户只能看到页面的很小一部分,所以在这种情况下,要绘制出所有图层内容的话,就会产生太大的开销,而且也没有必要。
显示
最后,合成线程发送绘制图块命令给浏览器进程。浏览器进程根据指令生成页面,并显示到显示器上,渲染过程完成。
💬 面试官追问
DNS很快拿到了IP,是不是马上就能发HTTP请求了?还不行,
HTTPS要先TCP三次握手,再TLS握手协商密钥,才能发加密的请求。有连接复用(keep-alive、HTTP/2多路复用)的话,第二个请求就省掉这些了。首屏优化里,网络连接这一段前端能做什么?
对第三方域名加
<link rel="preconnect" href="https://cdn.example.com">提前握手,或者dns-prefetch只提前解析;尽量减少域名数量,HTTP/2下一个连接就能并发。服务端上TLS 1.3和HTTP/3也能各省一个往返。用户输入
http://的地址,为什么有的站会直接走https,连重定向都没有?那是
HSTS。站点之前回过Strict-Transport-Security头,浏览器记住了,之后在本地直接把http改成https(307 Internal Redirect),不发明文请求。上了preload列表的站点第一次访问就生效。接口很快返回了,页面却还白屏,时间都花在布局之后,往哪查?
请求结束后还有解析、样式计算、布局、绘制、栅格化。
Performance面板看主线程是不是被大段JS或者超大DOM的样式计算占满;如果是图片很多,可能是解码和栅格化慢。页面某种编码下出现乱码,问题出在渲染流程的哪一步?
在构建
DOM的第一步:字节按编码转成字符。响应头Content-Type没写charset,HTML里的<meta charset>又不在前1024字节内,浏览器就只能猜。响应头里明确写charset=utf-8最稳。
# 13 渲染引擎什么情况下才会为特定的节点创建新的图层
⚡ 30 秒速记
- 先分清两个概念:层叠上下文是
CSS规范里决定绘制顺序的;合成层(Compositing Layer)是Chrome交给GPU单独处理的图层,两者有交集但不是一回事 - 常见会提升成合成层的:
3D transform/translateZ(0)、will-change: transform或opacity、正在跑transform/opacity动画、video/canvas/iframe、可滚动区域 - 隐式合成:一个元素叠在合成层上面,浏览器为了保证顺序正确,会把它也提成合成层,这是「层爆炸」的主因
- 收益:位移、缩放、透明度交给合成线程,跳过布局和绘制;代价:每层都占显存,层太多反而更卡
- 排查:
DevTools的Layers面板看每层的提升原因,Rendering里勾Layer borders
渲染引擎会在元素需要独立参与合成的时候给它单独建图层,比如 3D 变换、will-change、正在做 transform 或 opacity 动画、video 和 canvas,还有需要滚动裁剪的区域。 这里要先纠正一个常见误区:position: relative 加 z-index: 1 会创建层叠上下文,但一般不会变成合成层,层叠上下文管的是谁盖住谁,合成层管的是要不要交给 GPU 单独合成。合成层的好处是动画时只要移动这一层,不用重新布局和绘制。但每层都吃显存,还有隐式合成会让压在上面的元素被迫跟着提层,所以我只给真正在动的元素加,用完就撤。
层叠上下文是HTML元素的三维概念,这些HTML元素在一条假想的相对于面向(电脑屏幕的)视窗或者网页的用户的z轴上延伸,HTML元素依据其自身属性按照优先级顺序占用层叠上下文的空间。
- 拥有层叠上下文属性的元素会被提升为单独的一层。
拥有层叠上下文属性:
- 根元素 (HTML),
- z-index 值不为 "auto"的 绝对/相对定位元素,
- position,固定(fixed) / 沾滞(sticky)定位(沾滞定位适配所有移动设备上的浏览器,但老的桌面浏览器不支持)
- z-index值不为 "auto"的 flex 子项 (flex item),即:父元素 display: flex|inline-flex,
- z-index值不为"auto"的grid子项,即:父元素display:grid
- opacity 属性值小于 1 的元素(参考 the specification for opacity),
- transform 属性值不为 "none"的元素,
- mix-blend-mode 属性值不为 "normal"的元素,
- filter值不为"none"的元素,
- perspective值不为"none"的元素,
- clip-path值不为"none"的元素
- mask / mask-image / mask-border不为"none"的元素
- isolation 属性被设置为 "isolate"的元素
- 在 will-change 中指定了任意CSS属性(参考 这篇文章)
- -webkit-overflow-scrolling 属性被设置 "touch"的元素
- contain属性值为"layout","paint",或者综合值比如"strict","content"
- 需要剪裁(clip)的地方也会被创建为图层。
这里的剪裁指的是,假如我们把 div 的大小限定为 200 * 200 像素,而 div 里面的文字内容比较多,文字所显示的区域肯定会超出 200 * 200 的面积,这时候就产生了剪裁,渲染引擎会把裁剪文字内容的一部分用于显示在 div 区域。出现这种裁剪情况的时候,渲染引擎会为文字部分单独创建一个层,如果出现滚动条,滚动条也会被提升为单独的层。
💬 面试官追问
卡片设了
position: relative; z-index: 1,它会单独成一个合成层吗?一般不会。它建立了层叠上下文,影响的是绘制顺序;要不要单独合成看的是有没有
3D transform、will-change、动画这类原因。打开Layers面板一看就清楚,它多半和父级画在同一层里。列表
500张卡片都加了will-change: transform,内存反而涨了,怎么改?每个都提层,
GPU要为每张卡片存一份位图,手机上很快就吃满。改成只在hover或动画开始前给那一张加,transitionend后去掉。一个提了层的动画元素,导致它上面一堆元素也变成了合成层,为什么?
这是隐式合成。后面的元素在层叠顺序上压在合成层之上,如果它们还留在底层就画不对了,浏览器只好把它们也提上来。给动画元素设一个更高的
z-index,让它在最上面,就不会连累别人。老代码里到处写
transform: translateZ(0),说是开GPU加速,要保留吗?不是动画元素的建议删掉。它是早年强制提层的技巧,现在有
will-change可以表达意图;静止元素硬提层只会多占显存,还可能让文字因为不在整数像素上变模糊。滚动容器里文字有残影、滚动掉帧,和分层有什么关系?
能滚动的区域通常会被提成单独的合成层,滚动时直接移动这层不用重绘。如果容器里有
position: fixed或者背景background-attachment: fixed,浏览器就没法只挪层,只能每帧重绘,容易卡和残影。去Rendering勾Paint flashing看看滚动时是不是在大面积闪绿。
# 14 定时器与requestAnimationFrame、requestIdleCallback
⚡ 30 秒速记
setTimeout到点只是把回调放进任务队列,主线程忙就得等,所以只保证「不早于」;嵌套超过5层会被压到最少4ms- 后台标签页定时器会被节流到至少
1s一次,Chrome 88起隐藏超过5分钟可能1分钟才执行一次 requestAnimationFrame:每帧渲染前调用,跟屏幕刷新率走(60Hz约16.7ms,120Hz约8.3ms),页面隐藏就暂停,动画首选requestIdleCallback:帧末尾有空闲才执行,单次最多给50ms,可传timeout兜底;适合上报、预加载这类低优先级活,Safari支持晚,要降级React没直接用原生rIC,嫌它触发太不稳定,自己基于MessageChannel写了调度器
一句话:定时任务用 setTimeout,动画用 requestAnimationFrame,可以晚点做的杂活用 requestIdleCallback。 setTimeout(fn, 100) 的意思是 100ms 后把回调放进队列,不是 100ms 后执行,主线程在忙就会更晚。requestAnimationFrame 是浏览器每次准备画下一帧之前调你,跟刷新率对齐,用它做动画不会出现一帧改两次或者跳帧,切到后台还会自动停。requestIdleCallback 是浏览器忙完一帧还有空闲才叫你,回调里用 deadline.timeRemaining() 看还剩多少时间,做不完就留到下次。
function step(ts) { // ts 是这一帧的时间戳
box.style.transform = `translateX(${(ts / 10) % 300}px)`
requestAnimationFrame(step) // 每帧一次,后台自动暂停
}
requestAnimationFrame(step)
requestIdleCallback(deadline => {
while (deadline.timeRemaining() > 1 && tasks.length) report(tasks.shift())
}, { timeout: 2000 }) // 2 秒内一直没空也强制执行
1. setTimeout
setTimeout的运行机制:执行该语句时,是立即把当前定时器代码推入事件队列,当定时器在事件列表中满足设置的时间值时将传入的函数加入任务队列,之后的执行就交给任务队列负责。但是如果此时任务队列不为空,则需等待,所以执行定时器内代码的时间可能会大于设置的时间
setTimeout(() => {
console.log(1);
}, 0)
console.log(2);
输出 2, 1;
setTimeout的第二个参数表示在执行代码前等待的毫秒数。上面代码中,设置为0,表面意思为 执行代码前等待的毫秒数为0,即立即执行。但实际上的运行结果我们也看到了,并不是表面上看起来的样子,千万不要被欺骗了。
实际上,上面的代码并不是立即执行的,这是因为setTimeout有一个最小执行时间,HTML5标准规定了setTimeout()的第二个参数的最小值(最短间隔)不得低于4毫秒。 当指定的时间低于该时间时,浏览器会用最小允许的时间作为setTimeout的时间间隔,也就是说即使我们把setTimeout的延迟时间设置为0,实际上可能为 4毫秒后才事件推入任务队列。
定时器代码在被推送到任务队列前,会先被推入到事件列表中,当定时器在事件列表中满足设置的时间值时会被推到任务队列,但是如果此时任务队列不为空,则需等待,所以执行定时器内代码的时间可能会大于设置的时间
setTimeout(() => {
console.log(111);
}, 100);
上面代码表示100ms后执行console.log(111),但实际上实行的时间肯定是大于100ms后的, 100ms 只是表示 100ms 后将任务加入到"任务队列"中,必须等到当前代码(执行栈)执行完,主线程才会去执行它指定的回调函数。要是当前代码耗时很长,有可能要等很久,所以并没有办法保证,回调函数一定会在setTimeout()指定的时间执行。
2. setTimeout 和 setInterval区别
setTimeout: 指定延期后调用函数,每次setTimeout计时到后就会去执行,然后执行一段时间后才继续setTimeout,中间就多了误差,(误差多少与代码的执行时间有关)。setInterval:以指定周期调用函数,而setInterval则是每次都精确的隔一段时间推入一个事件(但是,事件的执行时间不一定就不准确,还有可能是这个事件还没执行完毕,下一个事件就来了).
btn.onclick = function(){
setTimeout(function(){
console.log(1);
},250);
}
击该按钮后,首先将
onclick事件处理程序加入队列。该程序执行后才设置定时器,再有250ms后,指定的代码才被添加到队列中等待执行。 如果上面代码中的onclick事件处理程序执行了300ms,那么定时器的代码至少要在定时器设置之后的300ms后才会被执行。队列中所有的代码都要等到javascript进程空闲之后才能执行,而不管它们是如何添加到队列中的。
如图所示,尽管在255ms处添加了定时器代码,但这时候还不能执行,因为onclick事件处理程序仍在运行。定时器代码最早能执行的时机是在300ms处,即onclick事件处理程序结束之后。
3. setInterval存在的一些问题:
JavaScript中使用 setInterval 开启轮询。定时器代码可能在代码再次被添加到队列之前还没有完成执行,结果导致定时器代码连续运行好几次,而之间没有任何停顿。而javascript引擎对这个问题的解决是:当使用setInterval()时,仅当没有该定时器的任何其他代码实例时,才将定时器代码添加到队列中。这确保了定时器代码加入到队列中的最小时间间隔为指定间隔。
但是,这样会导致两个问题:
- 某些间隔被跳过;
- 多个定时器的代码执行之间的间隔可能比预期的小
假设,某个onclick事件处理程序使用setInterval()设置了200ms间隔的定时器。如果事件处理程序花了300ms多一点时间完成,同时定时器代码也花了差不多的时间,就会同时出现跳过某间隔的情况
例子中的第一个定时器是在205ms处添加到队列中的,但是直到过了300ms处才能执行。当执行这个定时器代码时,在405ms处又给队列添加了另一个副本。在下一个间隔,即605ms处,第一个定时器代码仍在运行,同时在队列中已经有了一个定时器代码的实例。结果是,在这个时间点上的定时器代码不会被添加到队列中
使用setTimeout构造轮询能保证每次轮询的间隔。
setTimeout(function () {
console.log('我被调用了');
setTimeout(arguments.callee, 100);
}, 100);
callee是arguments对象的一个属性。它可以用于引用该函数的函数体内当前正在执行的函数。在严格模式下,第5版 ECMAScript (ES5) 禁止使用arguments.callee()。当一个函数必须调用自身的时候, 避免使用arguments.callee(), 通过要么给函数表达式一个名字,要么使用一个函数声明.
setTimeout(function fn(){
console.log('我被调用了');
setTimeout(fn, 100);
},100);
这个模式链式调用了setTimeout(),每次函数执行的时候都会创建一个新的定时器。第二个setTimeout()调用当前执行的函数,并为其设置另外一个定时器。这样做的好处是,在前一个定时器代码执行完之前,不会向队列插入新的定时器代码,确保不会有任何缺失的间隔。而且,它可以保证在下一次定时器代码执行之前,至少要等待指定的间隔,避免了连续的运行。
4. requestAnimationFrame
4.1 60fps与设备刷新率
目前大多数设备的屏幕刷新率为60次/秒,如果在页面中有一个动画或者渐变效果,或者用户正在滚动页面,那么浏览器渲染动画或页面的每一帧的速率也需要跟设备屏幕的刷新率保持一致。
卡顿:其中每个帧的预算时间仅比16毫秒多一点(1秒/ 60 = 16.6毫秒)。但实际上,浏览器有整理工作要做,因此您的所有工作是需要在10毫秒内完成。如果无法符合此预算,帧率将下降,并且内容会在屏幕上抖动。此现象通常称为卡顿,会对用户体验产生负面影响。
跳帧: 假如动画切换在 16ms, 32ms, 48ms时分别切换,跳帧就是假如到了32ms,其他任务还未执行完成,没有去执行动画切帧,等到开始进行动画的切帧,已经到了该执行48ms的切帧。就好比你玩游戏的时候卡了,过了一会,你再看画面,它不会停留你卡的地方,或者这时你的角色已经挂掉了。必须在下一帧开始之前就已经绘制完毕;
Chrome devtool 查看实时 FPS, 打开 More tools => Rendering, 勾选 FPS meter
4.2 requestAnimationFrame实现动画
requestAnimationFrame是浏览器用于定时循环操作的一个接口,类似于setTimeout,主要用途是按帧对网页进行重绘。
在 requestAnimationFrame 之前,主要借助 setTimeout/ setInterval 来编写 JS 动画,而动画的关键在于动画帧之间的时间间隔设置,这个时间间隔的设置有讲究,一方面要足够小,这样动画帧之间才有连贯性,动画效果才显得平滑流畅;另一方面要足够大,确保浏览器有足够的时间及时完成渲染。
显示器有固定的刷新频率(60Hz或75Hz),也就是说,每秒最多只能重绘60次或75次,requestAnimationFrame的基本思想就是与这个刷新频率保持同步,利用这个刷新频率进行页面重绘。此外,使用这个API,一旦页面不处于浏览器的当前标签,就会自动停止刷新。这就节省了CPU、GPU和电力。
requestAnimationFrame 是在主线程上完成。这意味着,如果主线程非常繁忙,requestAnimationFrame的动画效果会大打折扣。
requestAnimationFrame 使用一个回调函数作为参数。这个回调函数会在浏览器重绘之前调用。
requestID = window.requestAnimationFrame(callback);
window.requestAnimFrame = (function(){
return window.requestAnimationFrame ||
window.webkitRequestAnimationFrame ||
window.mozRequestAnimationFrame ||
window.oRequestAnimationFrame ||
window.msRequestAnimationFrame ||
function( callback ){
window.setTimeout(callback, 1000 / 60);
};
})();
上面的代码按照1秒钟60次(大约每16.7毫秒一次),来模拟requestAnimationFrame。
5. requestIdleCallback()
MDN上的解释:
requestIdleCallback()方法将在浏览器的空闲时段内调用的函数排队。这使开发者能够在主事件循环上执行后台和低优先级工作,而不会影响延迟关键事件,如动画和输入响应。函数一般会按先进先调用的顺序执行,然而,如果回调函数指定了执行超时时间timeout,则有可能为了在超时前执行函数而打乱执行顺序。
requestAnimationFrame会在每次屏幕刷新的时候被调用,而requestIdleCallback则会在每次屏幕刷新时,判断当前帧是否还有多余的时间,如果有,则会调用requestIdleCallback的回调函数,
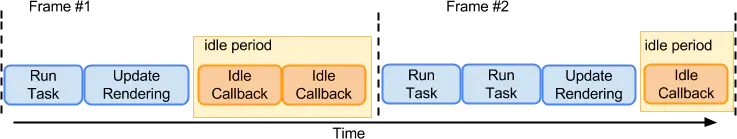
图片中是两个连续的执行帧,大致可以理解为两个帧的持续时间大概为16.67,图中黄色部分就是空闲时间。所以,requestIdleCallback 中的回调函数仅会在每次屏幕刷新并且有空闲时间时才会被调用.
利用这个特性,我们可以在动画执行的期间,利用每帧的空闲时间来进行数据发送的操作,或者一些优先级比较低的操作,此时不会使影响到动画的性能,或者和requestAnimationFrame搭配,可以实现一些页面性能方面的的优化,
react 的
fiber架构也是基于requestIdleCallback实现的, 并且在不支持的浏览器中提供了polyfill
总结
- 从
单线程模型和任务队列出发理解setTimeout(fn, 0),并不是立即执行。 - JS 动画, 用
requestAnimationFrame会比setInterval效果更好 requestIdleCallback()常用来切割长任务,利用空闲时间执行,避免主线程长时间阻塞
# 五、框架通识
💬 面试官追问
倒计时用
setInterval(fn, 1000)每秒减一,跑久了就不准,切后台更离谱,怎么改?每次回调不靠累加,而是用
Date.now()和目标时间算剩余秒数,定时器只负责「提醒你去重新算」。切回前台时监听visibilitychange立刻校准一次;要求更准的以服务端时间为准。setTimeout(fn, 0)真的是0毫秒后执行吗?不是。它要等当前同步代码和所有微任务跑完,排到下一轮宏任务;嵌套超过
5层后浏览器会强制至少4ms。想在当前任务后尽快执行,用queueMicrotask或Promise.then,但它们会在渲染前全部跑完,跑太多会卡渲染。用
setTimeout(fn, 16)做动画,和requestAnimationFrame差在哪?16ms和屏幕刷新对不齐,有时一帧里执行两次,有时一次都没有,看起来就是抖;120Hz屏上更明显。rAF由浏览器在每帧渲染前调用,天然对齐,后台还自动暂停省电。requestIdleCallback里能不能改DOM?不建议。它在一帧末尾执行,这时布局已经算完,改
DOM会让下一帧重新布局,而且执行时间不可控。要改DOM就在回调里算好数据,再用requestAnimationFrame去写。埋点上报想用
requestIdleCallback,用户直接关页面会不会丢?会,页面一卸载空闲回调就没机会执行了。在
visibilitychange变成hidden时把队列里剩下的用navigator.sendBeacon一次性发出去,它在页面关闭后也能可靠送达。
# 六、Vue
# 1 Vue 响应式原理
⚡ 30 秒速记
- 核心就一句:读数据时记下「谁用了我」(依赖收集),改数据时通知这些人更新(派发更新)
Vue 2:Object.defineProperty递归改写每个属性的getter/setter,Dep收集Watcher;更新放进异步队列,nextTick后统一渲染Vue 2的盲区:新增 / 删除属性要this.$set/this.$delete;数组下标赋值和改length不触发,靠重写push、splice等七个方法Vue 3:Proxy代理整个对象,能拦截新增、删除、in、数组下标;嵌套对象访问到才代理(懒代理),初始化更快- 依赖结构
WeakMap<target, Map<key, Dep>>,track收集、trigger派发;ref包原始值,reactive包对象,解构reactive会丢响应性要用toRefs
Vue 响应式就是在读写数据时做拦截:读的时候记下谁依赖了这个数据,写的时候通知它们重新执行。 Vue 2 用 Object.defineProperty 在初始化时把 data 里每个属性都改成 getter / setter,组件渲染时读到哪个属性,就把自己的渲染 Watcher 记到那个属性的 Dep 里,改值时 Dep 通知 Watcher,再走虚拟 DOM 对比做局部更新。它的毛病是只能拦截已存在的属性,新增删除和数组下标都感知不到。Vue 3 换成 Proxy 拦截整个对象,这些问题都没了,嵌套对象也是用到才代理,大对象初始化快很多。
// Vue 2
this.form.newKey = 1 // 视图不更新:newKey 没有 setter
this.$set(this.form, 'newKey', 1) // 正确
// Vue 3
state.form.newKey = 1 // 直接生效,Proxy 能拦截新增属性
Vue 的响应式原理是核心是通过 ES5 的保护对象的
Object.defindeProperty中的访问器属性中的 get 和 set 方法,data 中声明的属性都被添加了访问器属性,当读取 data 中的数据时自动调用 get 方法,当修改 data 中的数据时,自动调用 set 方法,检测到数据的变化,会通知观察者 Wacher,观察者 Wacher自动触发重新render 当前组件(子组件不会重新渲染),生成新的虚拟 DOM 树,Vue 框架会遍历并对比新虚拟 DOM 树和旧虚拟 DOM 树中每个节点的差别,并记录下来,最后,加载操作,将所有记录的不同点,局部修改到真实 DOM树上。
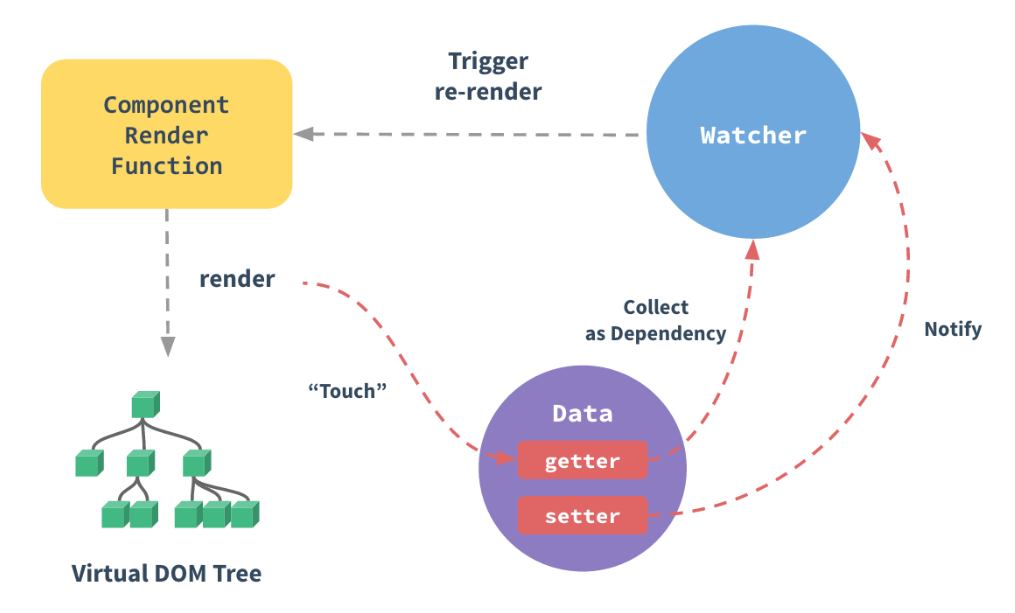
- 虚拟DOM (Virtaul DOM): 用 js 对象模拟的,保存当前视图内所有 DOM 节点对象基本描述属性和节点间关系的树结构。用 js 对象,描述每个节点,及其父子关系,形成虚拟 DOM 对象树结构。
- 因为只要在
data中声明的基本数据类型的数据,基本不存在数据不响应问题,所以重点介绍数组和对象在vue中的数据响应问题,vue可以检测对象属性的修改,但无法监听数组的所有变动及对象的新增和删除,只能使用数组变异方法及$set方法。
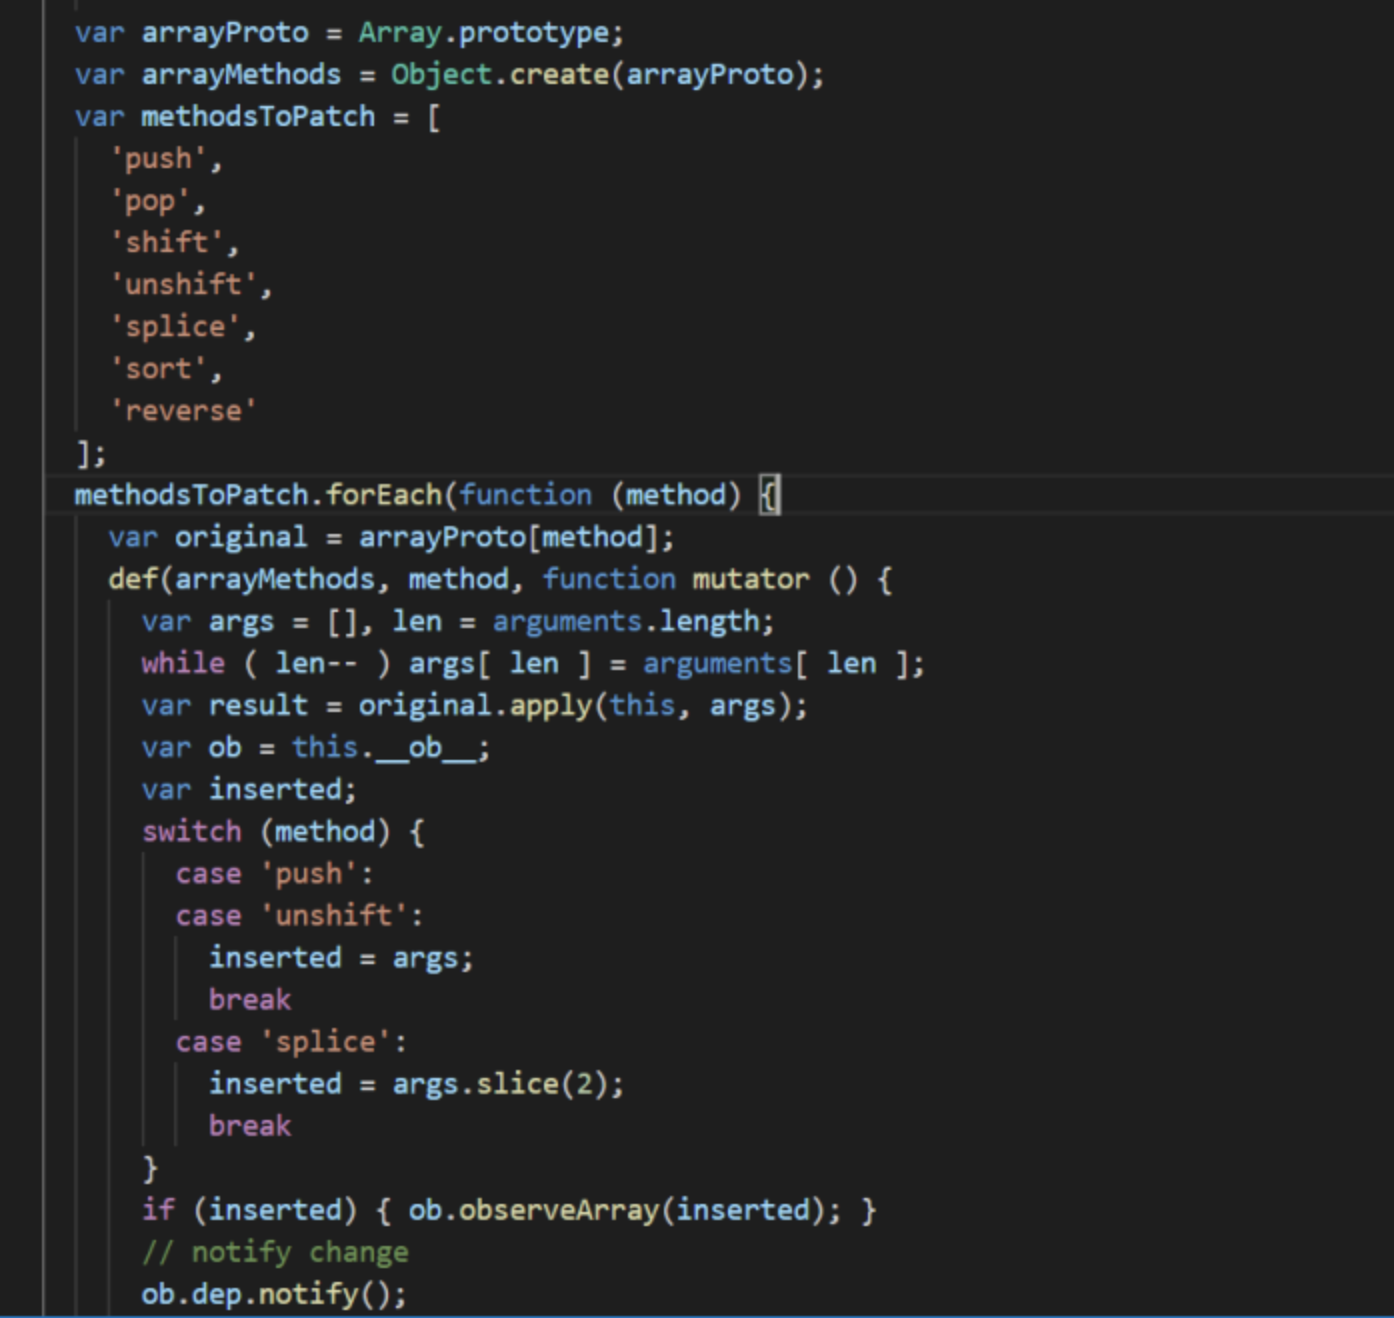
可以看到,
arrayMethods首先继承了Array,然后对数组中所有能改变数组自身的方法,如push、pop等这些方法进行重写。重写后的方法会先执行它们本身原有的逻辑,并对能增加数组长度的 3 个方法push、unshift、splice方法做了判断,获取到插入的值,然后把新添加的值变成一个响应式对象,并且再调用ob.dep.notify()手动触发依赖通知,这就很好地解释了用vm.items.splice(newLength) 方法可以检测到变化
总结:Vue 采用数据劫持结合发布—订阅模式的方法,通过
Object.defineProperty()来劫持各个属性的 setter,getter,在数据变动时发布消息给订阅者,触发相应的监听回调。
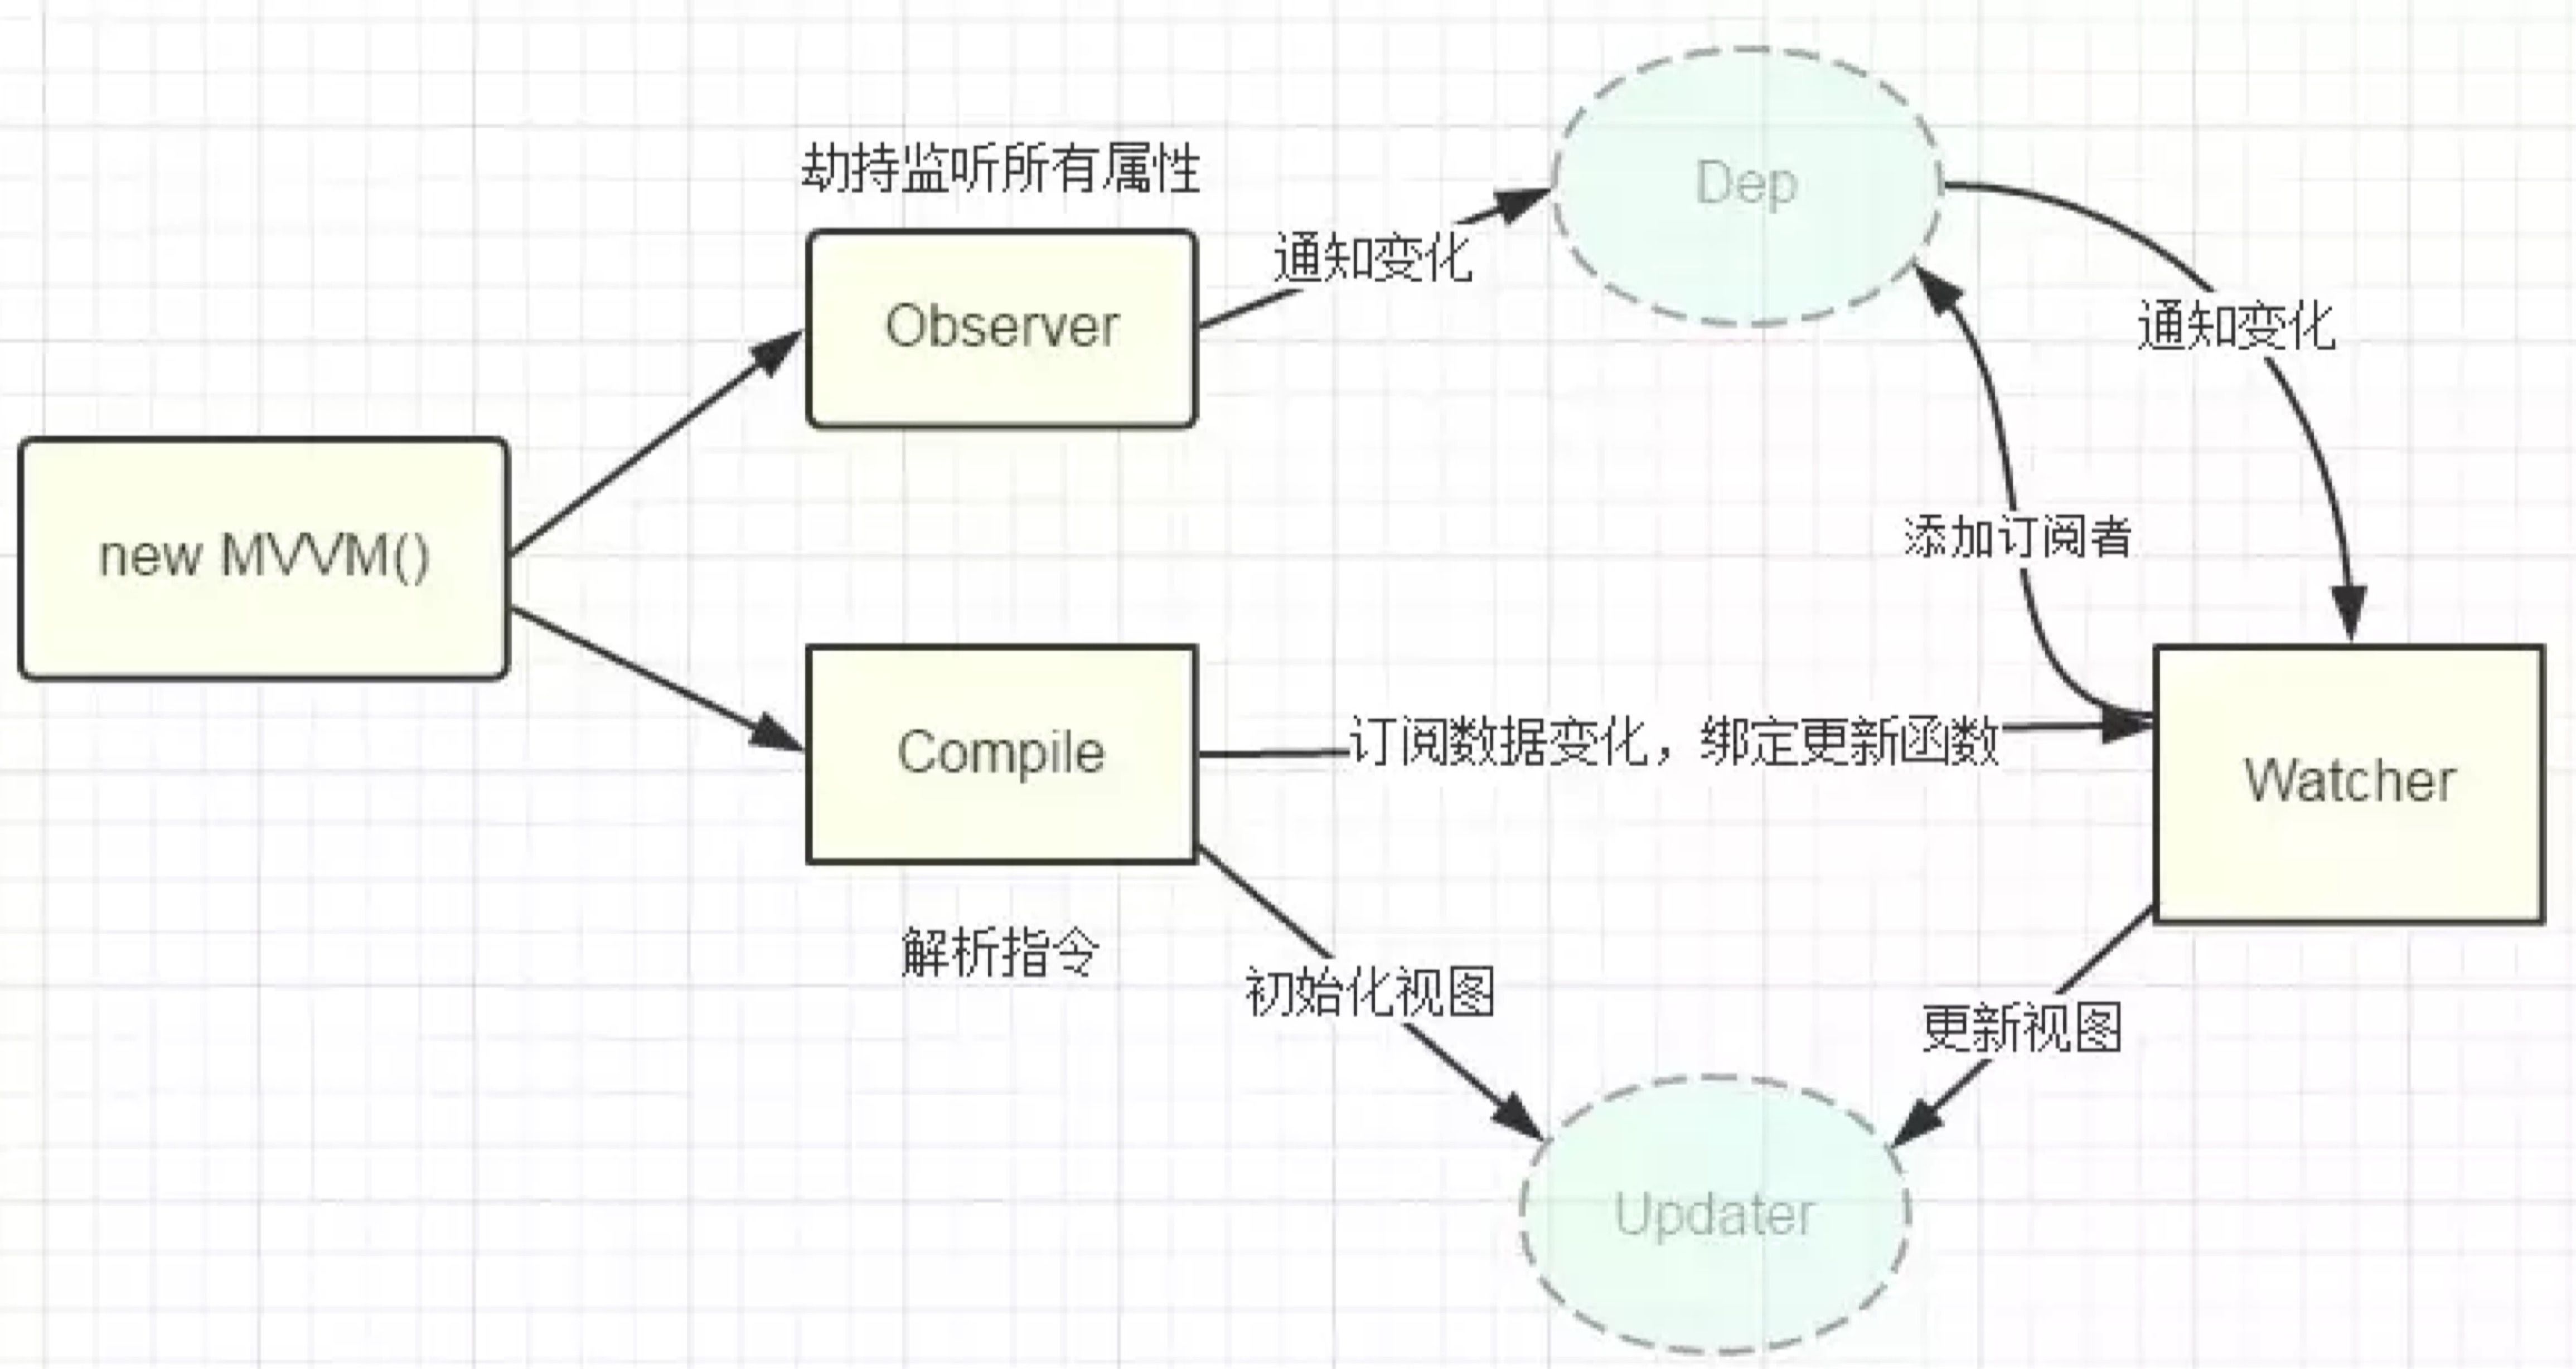
Observer遍历数据对象,给所有属性加上setter和getter,监听数据的变化compile解析模板指令,将模板中的变量替换成数据,然后初始化渲染页面视图,并将每个指令对应的节点绑定更新函数,添加监听数据的订阅者,一旦数据有变动,收到通知,更新视图
Watcher订阅者是Observer和Compile之间通信的桥梁,主要做的事情
- 在自身实例化时往属性订阅器 (
dep) 里面添加自己 - 待属性变动
dep.notice()通知时,调用自身的update()方法,并触发Compile中绑定的回调
Object.defineProperty(),那么它的用法是什么,以及优缺点是什么呢?
- 可以检测对象中数据发生的修改
- 对于复杂的对象,层级很深的话,是不友好的,需要经行深度监听,这样子就需要递归到底,这也是它的缺点。
- 对于一个对象中,如果你新增加属性,删除属性,**Object.defineProperty()**是不能观测到的,那么应该如何解决呢?可以通过
Vue.set()和Vue.delete()来实现。
// 模拟 Vue 中的 data 选项
let data = {
msg: 'hello'
}
// 模拟 Vue 的实例
let vm = {}
// 数据劫持:当访问或者设置 vm 中的成员的时候,做一些干预操作
Object.defineProperty(vm, 'msg', {
// 可枚举(可遍历)
enumerable: true,
// 可配置(可以使用 delete 删除,可以通过 defineProperty 重新定义)
configurable: true,
// 当获取值的时候执行
get () {
console.log('get: ', data.msg)
return data.msg
},
// 当设置值的时候执行
set (newValue) {
console.log('set: ', newValue)
if (newValue === data.msg) {
return
}
data.msg = newValue
// 数据更改,更新 DOM 的值
document.querySelector('#app').textContent = data.msg
}
})
// 测试
vm.msg = 'Hello World'
console.log(vm.msg)
Vue3.x响应式数据原理
Vue3.x改用Proxy替代Object.defineProperty。因为Proxy可以直接监听对象和数组的变化,并且有多达13种拦截方法。并且作为新标准将受到浏览器厂商重点持续的性能优化。
Proxy只会代理对象的第一层,那么Vue3又是怎样处理这个问题的呢?
判断当前
Reflect.get的返回值是否为Object,如果是则再通过reactive方法做代理, 这样就实现了深度观测。
监测数组的时候可能触发多次get/set,那么如何防止触发多次呢?
我们可以判断
key是否为当前被代理对象target自身属性,也可以判断旧值与新值是否相等,只有满足以上两个条件之一时,才有可能执行trigger
// 模拟 Vue 中的 data 选项
let data = {
msg: 'hello',
count: 0
}
// 模拟 Vue 实例
let vm = new Proxy(data, {
// 当访问 vm 的成员会执行
get (target, key) {
console.log('get, key: ', key, target[key])
return target[key]
},
// 当设置 vm 的成员会执行
set (target, key, newValue) {
console.log('set, key: ', key, newValue)
if (target[key] === newValue) {
return
}
target[key] = newValue
document.querySelector('#app').textContent = target[key]
}
})
// 测试
vm.msg = 'Hello World'
console.log(vm.msg)
Proxy 相比于 defineProperty 的优势
- 数组变化也能监听到
- 不需要深度遍历监听
Proxy是ES6中新增的功能,可以用来自定义对象中的操作
let p = new Proxy(target, handler);
// `target` 代表需要添加代理的对象
// `handler` 用来自定义对象中的操作
// 可以很方便的使用 Proxy 来实现一个数据绑定和监听
let onWatch = (obj, setBind, getLogger) => {
let handler = {
get(target, property, receiver) {
getLogger(target, property)
return Reflect.get(target, property, receiver);
},
set(target, property, value, receiver) {
setBind(value);
return Reflect.set(target, property, value);
}
};
return new Proxy(obj, handler);
};
let obj = { a: 1 }
let value
let p = onWatch(obj, (v) => {
value = v
}, (target, property) => {
console.log(`Get '${property}' = ${target[property]}`);
})
p.a = 2 // bind `value` to `2`
p.a // -> Get 'a' = 2
总结
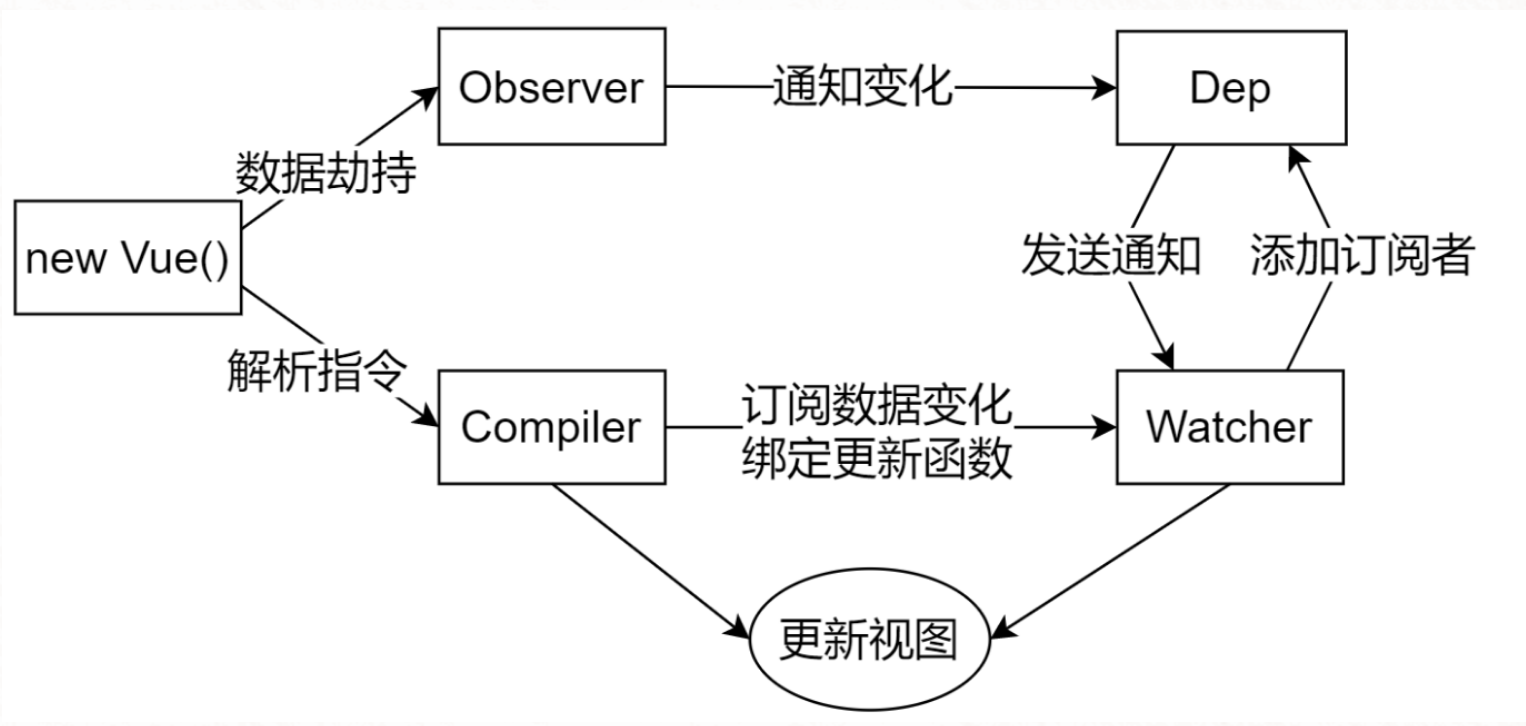
- Vue
- 记录传入的选项,设置
$data/$el - 把
data的成员注入到Vue实例 - 负责调用
Observer实现数据响应式处理(数据劫持) - 负责调用
Compiler编译指令/插值表达式等
- 记录传入的选项,设置
Observer- 数据劫持
- 负责把
data中的成员转换成getter/setter - 负责把多层属性转换成
getter/setter - 如果给属性赋值为新对象,把新对象的成员设置为
getter/setter
- 负责把
- 添加
Dep和Watcher的依赖关系 - 数据变化发送通知
- 数据劫持
Compiler- 负责编译模板,解析指令/插值表达式
- 负责页面的首次渲染过程
- 当数据变化后重新渲染
Dep- 收集依赖,添加订阅者(
watcher) - 通知所有订阅者
- 收集依赖,添加订阅者(
Watcher- 自身实例化的时候往
dep对象中添加自己 - 当数据变化
dep通知所有的Watcher实例更新视图
- 自身实例化的时候往
💬 面试官追问
Vue 2里this.items[3] = row,数据变了视图不动,为什么改成splice就好了?Vue 2出于性能没给数组下标加getter/setter,下标赋值和改length它感知不到。splice是Vue重写过的方法,里面会手动dep.notify()。所以用this.items.splice(3, 1, row)或this.$set(this.items, 3, row)。连续改了三次数据,组件会渲染三次吗?
不会。
Watcher被放进异步队列并去重,同一轮里改多少次都只在下一个微任务里渲染一次。所以改完数据马上读DOM拿不到新值,要await this.$nextTick()(Vue 3是nextTick())。Vue 3里const { count } = reactive({ count: 0 }),后面改count页面不变,为什么?解构出来的
count只是一个普通数字,跟Proxy断了联系,读写都不经过拦截。用toRefs(state)解构,或者直接state.count;原始值用ref包起来,模板里会自动解包。Proxy只代理第一层,那深层对象还是响应式的吗?是。
get拦截里如果发现取到的值是对象,会顺手reactive()一下再返回,所以是「访问到哪层代理到哪层」。好处是初始化不用递归整个对象;不想要深层响应可以用shallowReactive或shallowRef。一个几万条数据的只读大列表放进
data,页面初始化很慢,怎么处理?这种数据根本不需要响应式。
Vue 2用Object.freeze(list),Vue会跳过它;Vue 3用markRaw或shallowRef,整体替换时才触发更新。
# 2 发布订阅模式和观察者模式
⚡ 30 秒速记
- 观察者:
Subject自己存着Observer列表,变了就挨个调update()→ 双方直接认识 - 发布订阅:中间多一个事件中心,发布者只管
emit,订阅者只管on→ 双方互不认识 - 大白话:观察者是「我有你电话,直接打给你」,发布订阅是「我们都在一个群里,我在群里喊一声」
Vue 2响应式里Dep直接持有Watcher= 观察者;EventBus、Node的EventEmitter= 发布订阅- 发布订阅解耦更彻底,代价是调用链断了不好追,订阅忘了
off就会重复执行和泄漏
两者的分水岭就一个:有没有独立的事件中心。 观察者模式里目标对象自己维护观察者列表,状态一变直接调它们的 update(),双方是知道彼此存在的。发布订阅多了一层调度中心,发布者 emit('add-todo') 的时候根本不知道谁在听,订阅者也不关心是谁发的。所以兄弟组件用 eventBus 传话是发布订阅,Vue 的 Dep 收集 Watcher 再 notify() 是观察者。工程上我会提醒一句:发布订阅好用但难排查,事件名要集中管,组件销毁时一定要解绑。
1. 发布/订阅模式
- 发布/订阅模式
- 订阅者
- 发布者
- 信号中心
我们假定,存在一个"信号中心",某个任务执行完成,就向信号中心"发布"(publish)一个信 号,其他任务可以向信号中心"订阅"(subscribe)这个信号,从而知道什么时候自己可以开始执 行。这就叫做"发布/订阅模式"(publish-subscribe pattern)
Vue 的自定义事件
let vm = new Vue()
vm.$on('dataChange', () => { console.log('dataChange')})
vm.$on('dataChange', () => {
console.log('dataChange1')
})
vm.$emit('dataChange')
兄弟组件通信过程
// eventBus.js
// 事件中心
let eventHub = new Vue()
// ComponentA.vue
// 发布者
addTodo: function () {
// 发布消息(事件)
eventHub.$emit('add-todo', { text: this.newTodoText })
this.newTodoText = ''
}
// ComponentB.vue
// 订阅者
created: function () {
// 订阅消息(事件)
eventHub.$on('add-todo', this.addTodo)
}
模拟 Vue 自定义事件的实现
class EventEmitter {
constructor(){
// { eventType: [ handler1, handler2 ] }
this.subs = {}
}
// 订阅通知
$on(eventType, fn) {
this.subs[eventType] = this.subs[eventType] || []
this.subs[eventType].push(fn)
}
// 发布通知
$emit(eventType) {
if(this.subs[eventType]) {
this.subs[eventType].forEach(v=>v())
}
}
}
// 测试
var bus = new EventEmitter()
// 注册事件
bus.$on('click', function () {
console.log('click')
})
bus.$on('click', function () {
console.log('click1')
})
// 触发事件
bus.$emit('click')
2. 观察者模式
- 观察者(订阅者) --
Watcherupdate():当事件发生时,具体要做的事情
- 目标(发布者) --
Depsubs数组:存储所有的观察者addSub():添加观察者notify():当事件发生,调用所有观察者的update()方法
- 没有事件中心
// 目标(发布者)
// Dependency
class Dep {
constructor () {
// 存储所有的观察者
this.subs = []
}
// 添加观察者
addSub (sub) {
if (sub && sub.update) {
this.subs.push(sub)
}
}
// 通知所有观察者
notify () {
this.subs.forEach(sub => sub.update())
}
}
// 观察者(订阅者)
class Watcher {
update () {
console.log('update')
}
}
// 测试
let dep = new Dep()
let watcher = new Watcher()
dep.addSub(watcher)
dep.notify()
3. 总结
- 观察者模式是由具体目标调度,比如当事件触发,
Dep就会去调用观察者的方法,所以观察者模 式的订阅者与发布者之间是存在依赖的 - 发布/订阅模式由统一调度中心调用,因此发布者和订阅者不需要知道对方的存在

💬 面试官追问
OrderStore里存了三个视图,变化时挨个调update(),这算发布订阅吗?不算,这是观察者。判断标准就是有没有独立的中间人,
OrderStore直接持有视图引用、直接调用,双方是耦合的。叫它发布订阅只是名字混用了。一次点击打印了三遍
click,代码里只有一个$emit,先查什么?先查是不是
$on注册了三次。最常见的是组件反复创建,created里每次都$on,销毁时没$off,旧的回调还挂在事件中心上。修法是beforeDestroy里bus.$off('click', this.handler),别在触发端加防抖掩盖。Vue 3里还能用new Vue()做eventBus吗?不能,
Vue 3把实例上的$on、$off、$once都删了。要么换mitt这类小库,要么直接用Pinia或provide/inject共享状态,大部分eventBus场景其实用状态管理更清楚。手写
EventEmitter,once怎么实现?包一层函数:
const wrap = (...args) => { fn(...args); this.off(type, wrap) },注册的是wrap。注意off(type, fn)时要能找到这个包装函数,一般给wrap.raw = fn,删除时比对h === fn || h.raw === fn。那什么时候该选观察者,不用事件中心?
参与者固定、关系紧密的时候,比如一个
store通知几个已知视图,直接观察更直观,调试时调用栈一路能跟下去。只有发布方和订阅方确实需要独立演进、互相不该知道对方时,才值得加事件中心。
# 3 为什么使用 Virtual DOM
⚡ 30 秒速记
- 首要动机不是「快」,是声明式(
UI = f(state))和跨平台(同一份描述能渲染到浏览器、SSR、原生、小程序) - 演进脉络:手写
DOM太乱 → 模板引擎能生成但不会跟踪变化 → 虚拟DOM记住上一次,算差异再更新 - 性能真相:精准手写
DOM永远更快,虚拟DOM保的是下限,避免整片重刷 - 代价:多一份对象树的内存 + 每次更新的
diff计算 - 也不是唯一解:
Svelte、Solid走编译期细粒度更新,Vue 3.6的Vapor Mode(实验性)也在走这条路
用虚拟 DOM,主要是为了让开发者只描述「界面应该长什么样」,具体怎么改 DOM 交给框架。 打个比方,你给装修队一张新图纸,他们对照旧图纸只改不一样的地方,而不是把房子拆了重建。模板引擎也能根据数据拼出 HTML,但它不记得上一次长什么样,数据一变只能整块替换,输入框焦点、滚动位置全丢。虚拟 DOM 保留了上一棵树,能算出最小改动。至于性能,它保证的是不会太差,真要比,精准的手写 DOM 操作肯定更快。
- 手动操作
DOM比较麻烦,还需要考虑浏览器兼容性问题,虽然有jQuery等库简化DOM操作,但是随着项目的复杂 DOM 操作复杂提升 - 为了简化
DOM的复杂操作于是出现了各种MVVM框架,MVVM框架解决了视图和状态的同步问题 - 为了简化视图的操作我们可以使用模板引擎,但是模板引擎没有解决跟踪状态变化的问题,于是
Virtual DOM出现了 Virtual DOM的好处是当状态改变时不需要立即更新 DOM,只需要创建一个虚拟树来描述DOM,Virtual DOM内部将弄清楚如何有效(diff)的更新DOM- 虚拟
DOM可以维护程序的状态,跟踪上一次的状态 - 通过比较前后两次状态的差异更新真实
DOM
虚拟 DOM 的作用
- 维护视图和状态的关系
- 复杂视图情况下提升渲染性能
- 除了渲染
DOM以外,还可以实现SSR(Nuxt.js/Next.js)、原生应用(Weex/React Native)、小程序(mpvue/uni-app)等
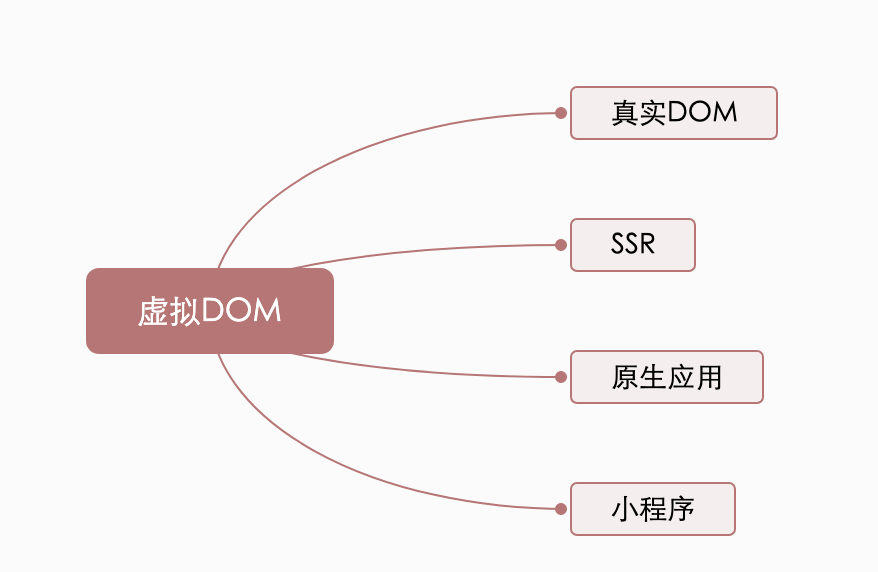
💬 面试官追问
页面就一个计数器,直接改
textContent不比虚拟DOM快吗?快,而且快很多,少了建对象和
diff两步。但这个比较不公平,虚拟DOM对比的对象是「状态变了整块重新渲染」,它的价值在复杂界面里你不用自己记每个节点该怎么改。模板引擎也能根据数据生成
HTML,为什么还要虚拟DOM?模板引擎每次都是生成一整段新字符串再
innerHTML,旧节点全扔,绑定的事件、输入框里没提交的内容都没了。虚拟DOM记得上一次的结构,只改变化的那个文本节点,旧节点能复用。列表更新后出现旧行残留,你怎么一层层查?
先看状态对不对,再看新生成的虚拟树对不对,最后看
patch有没有落到DOM上。最常见的两个坑:key用了index导致复用错位,或者有人用jQuery直接改了框架管的节点,框架的旧树和真实DOM对不上了。大屏每帧更新几千个点,也全交给虚拟
DOM吗?一般不这么干。这种高频、更新路径固定的区域直接上
Canvas或者手动更新,框架只管外层的布局和配置面板。混用时要划清边界,框架管的节点别手动改,手动管的节点别让框架渲染。Svelte没有虚拟DOM也能做声明式,那虚拟DOM是不是过时了?不是过时,是路线不同。
Svelte在编译期就知道哪个变量影响哪个节点,直接生成更新代码;虚拟DOM在运行时算差异,换来的是render函数可以写任意JS,灵活度更高。Vue现在两条路都在支持。
# 4 VDOM:三个 part
⚡ 30 秒速记
- 三步:创建
VNode(模板编译出的render/h函数)→diff新旧树找差异 →patch把差异落到真实DOM VNode就是普通对象:{ type, props, children, key, el },比真实DOM节点轻得多diff靠三个假设把O(n³)降到O(n):只比同层、类型不同直接替换、靠key认身份- 它像一层缓冲:一次数据变动引起的修改先在
JS里算完,再集中改DOM Vue 3编译期加了静态提升、PatchFlag、Block Tree,diff只看动态节点
VDOM 拆开看就是三件事:用 VNode 描述界面、diff 找出新旧差异、patch 把差异更新到页面。 VNode 是个普通 JS 对象,比如 { type: 'div', props: { class: 'a' }, children: 'hi' },比一个真实 DOM 节点身上几百个属性轻多了。数据变了先生成新树,和旧树比完再一次性改 DOM,零散的修改被收拢了。不过 Vue 引入它更重要的原因是解耦 HTML:模板可以在构建期预编译成 render,同一份 VNode 还能交给 SSR 或其他平台的渲染器。
- 虚拟节点类,将真实
DOM节点用js对象的形式进行展示,并提供render方法,将虚拟节点渲染成真实DOM - 节点
diff比较:对虚拟节点进行js层面的计算,并将不同的操作都记录到patch对象 re-render:解析patch对象,进行re-render
补充1��VDOM 的必要性?
- 创建真实DOM的代价高:真实的
DOM节点node实现的属性很多,而vnode仅仅实现一些必要的属性,相比起来,创建一个vnode的成本比较低。 - 触发多次浏览器重绘及回流:使用
vnode,相当于加了一个缓冲,让一次数据变动所带来的所有node变化,先在vnode中进行修改,然后diff之后对所有产生差异的节点集中一次对DOM tree进行修改,以减少浏览器的重绘及回流。
补充2:vue 为什么采用 vdom?
引入
Virtual DOM在性能方面的考量仅仅是一方面。
- 性能受场景的影响是非常大的,不同的场景可能造成不同实现方案之间成倍的性能差距,所以依赖细粒度绑定及
Virtual DOM哪个的性能更好还真不是一个容易下定论的问题。 Vue之所以引入了Virtual DOM,更重要的原因是为了解耦HTML依赖,这带来两个非常重要的好处是:
- 不再依赖
HTML解析器进行模版解析,可以进行更多的AOT工作提高运行时效率:通过模版AOT编译,Vue的运行时体积可以进一步压缩,运行时效率可以进一步提升;- 可以渲染到
DOM以外的平台,实现SSR、同构渲染这些高级特性,Weex等框架应用的就是这一特性。
综上,
Virtual DOM在性能上的收益并不是最主要的,更重要的是它使得Vue具备了现代框架应有的高级特性。
💬 面试官追问
同事说
VDOM就是缓存起来的HTML字符串,对吗?不对,它是对象树,不是字符串。字符串只能整段替换,对象树能逐个属性比较,
diff才有意义。用console.log(h('div', 'hi'))打出来看就知道了。patch时怎么知道新VNode对应页面上哪个真实节点?靠
vnode.el。首次挂载时创建的真实节点会存在VNode的el上,更新时判定是同一个节点就把el交给新VNode,然后直接在这个el上改属性和子节点。为什么类型不同就直接整棵替换,不往下比?
div变成p,或者组件A变成组件B,下面的结构基本不可能一样,硬比只是浪费时间。这是用少数情况的不最优,换绝大多数情况下的线性复杂度。Vue 3的PatchFlag解决的是哪一步的问题?解决
diff那一步的浪费。编译时给动态节点打标记,比如1表示只有文本是动态的,运行时只比文本,class、style都跳过;纯静态节点直接提升到render外面,根本不参与比较。状态变了但局部视图没更新,沿这三步怎么查?
先看新
VNode里有没有新值,没有就是响应式依赖没收集上;有的话看diff有没有把它判成同一个节点、有没有标记成动态;最后看patch后el上的值。前两步问题最多。
# 5 vue 和 react技术选型
⚡ 30 秒速记
- 心智模型不同:
Vue是响应式追踪(改数据自动知道谁要更新),React是不可变数据 + 重新执行组件(UI = f(state)) Vue:模板 + 单文件组件、编译期优化多、官方全家桶(Vue Router、Pinia)一条龙,上手快React:JSX就是JS、TS类型推导更顺、生态最大、React Native跨端更成熟- 两者都是单向数据流,
v-model只是:value+@update:modelValue的语法糖 - 选型先看团队和招聘,再看项目:已有技术栈、跨端需求、生态依赖比框架本身优劣更重要
两个框架都能做好大项目,选型我更看团队熟不熟、项目有没有特殊需求,而不是谁更快。 核心差别在更新模型:Vue 改 this.count++ 它自己知道哪个组件依赖了 count;React 要 setCount 触发组件重新执行,再靠 memo、useMemo 或者 React Compiler 去避免多余渲染。至于「大规模数据 React 更快」这种说法,是很多年前的旧结论,现在两边性能差距基本不会成为瓶颈。我的经验是团队全是 Vue 背景就别硬切 React,要做 RN 跨端或者重度依赖 React 生态库,再优先考虑 React。
相同点:
- 数据驱动页面,提供响应式的视图组件
- 都有virtual DOM,组件化的开发,通过props参数进行父子之间组件传递数据,都实现了webComponents规范
- 数据流动单向,都支持服务器的渲染SSR
- 都有支持native的方法,react有React native, vue有wexx
不同点:
- 数据绑定:Vue实现了双向的数据绑定v-model,底层本质上还是单向数据流(v-model 隐藏了背后 :value 和 @input 的细节)
- 数据渲染:大规模的数据渲染,react更快
- 使用场景:React配合Redux架构适合大规模多人协作复杂项目,Vue适合小快的项目
- 开发风格:react推荐做法jsx + inline style把html和css都写在js了
vue是采用webpack +vue-loader单文件组件格式,html, js, css同一个文件
💬 面试官追问
用了
v-model是不是说明Vue是双向数据流?不是,
v-model是双向绑定的语法糖。<Child v-model="name" />编译后就是传一个modelValue下去,再监听update:modelValue改回来,数据还是父组件持有,子组件只能通过事件申请修改。都说大规模数据渲染
React更快,看板要不要因此迁移?不迁。这是
Vue 2时代的老说法,现在Vue 3靠编译期优化,更新粒度反而更细。真卡就先用性能面板找瓶颈,大概率是一次渲染了几万个节点,该上虚拟列表就上虚拟列表,换框架解决不了。同一个父组件状态变了,
Vue和React子组件的行为有什么不同?React默认父组件重新渲染,子组件全部跟着重新执行,要React.memo才能跳过;Vue子组件只有用到的props真变了才更新。所以React项目里性能优化代码会多一些,React 19配合React Compiler才把这部分自动化。新项目半年后可能要做原生
App,怎么选?如果原生端要求高、想复用组件写法,
React+React Native更稳,生态和招聘都成熟。如果原生只是简单页面,Vue配uni-app或者直接用WebView也够。跨端是加分项,不是唯一决定因素。Vue的响应式和React的setState,各自容易踩什么坑?Vue 3最常见的是解构reactive丢响应性,const { count } = state之后count就是个普通数字,要用toRefs。React常见的是直接改对象state.list.push(x)再setState(state),引用没变不触发渲染,要返回新数组。
# 6 nextTick
⚡ 30 秒速记
- 为什么需要:
Vue的DOM更新是异步批量的,改完数据马上读DOM还是旧的 - 机制:数据变化 →
watcher/job去重推进队列 → 把「刷新队列」作为微任务排上 → 同一轮同步代码里改十次也只渲染一次 nextTick(cb)就是把cb排在这次刷新之后,所以能拿到新DOM- 版本差异:
Vue 2.6依次降级Promise.then→MutationObserver→setImmediate→setTimeout;Vue 3只用Promise.resolve().then - 用法:
this.$nextTick(cb)或await nextTick();顺序很重要,要在改数据之后调
nextTick 就是让你的回调等 Vue 这一轮 DOM 更新完再执行。 Vue 不会每改一次数据就刷一次 DOM,而是把要更新的组件放进队列、去重,然后用一个微任务统一刷新。比如 this.list.push(x) 之后马上去滚动到底部,这时候新的那一行还没渲染出来,scrollHeight 是旧的,放进 await nextTick() 后面才对。Vue 2 为了兼容老浏览器有一串降级方案,Vue 3 直接用 Promise。还有个细节,nextTick 要在改数据之后调用,先调后改的话回调可能排在刷新前面。
nextTick可以让我们在下次DOM更新循环结束之后执行延迟回调,用于获得更新后的DOM
nextTick主要使用了宏任务和微任务。根据执行环境分别尝试采用
PromiseMutationObserversetImmediate- 如果以上都不行则采用
setTimeout
定义了一个异步方法,多次调用
nextTick会将方法存入队列中,通过这个异步方法清空当前队列
💬 面试官追问
this.count++之后立刻读文本还是旧值,是响应式坏了吗?没坏,数据已经变了,只是
DOM还没刷新。读DOM的代码放进this.$nextTick(() => {...})里就行,或者Vue 3写await nextTick()。先调
nextTick再改数据,回调里能拿到新DOM吗?Vue 2里不一定。nextTick先注册的回调排在队列前面,后改数据时刷新任务排在它后面,回调执行时DOM还是旧的。养成习惯:先改数据,再nextTick。一个同步循环里调了 20 次
nextTick,会触发 20 次异步任务吗?不会。
Vue 2用一个pending标记,第一次调用时才排一个微任务,后面的回调都进同一个callbacks数组,微任务执行时一次清空。Vue 3也是挂在同一个Promise上。把
nextTick都换成setTimeout(fn, 0)行不行?大多数时候能跑,但语义变了。
setTimeout是宏任务,会晚一个渲染周期,可能先闪一下旧画面;而且最小延迟在嵌套时会被浏览器拉到4ms。要等DOM更新就用nextTick,别绕。弹窗
v-if打开后nextTick里还是拿不到输入框,为什么?多半是弹窗内容依赖接口数据,或者用了异步组件、
Transition,一次nextTick只等这一轮刷新,等不了未来那次。要么在数据回来之后再nextTick,要么直接在弹窗子组件的mounted里聚焦。
# 7 生命周期
⚡ 30 秒速记
- 四个阶段:创建(
beforeCreate/created)→ 挂载(beforeMount/mounted)→ 更新(beforeUpdate/updated)→ 销毁 created有数据没DOM,mounted才能拿$refs:请求可以放created,操作DOM、初始化图表放mounted- 父子顺序:父
created→ 父beforeMount→ 子created→ 子mounted→ 父mounted,子先挂载完父才算完 Vue 3:setup替代beforeCreate/created,销毁改名onBeforeUnmount/onUnmounted,没有onCreatedkeep-alive里的组件切走只触发deactivated,回来触发activated,不走销毁
生命周期就是组件从出生、挂到页面、更新、到被移除这一路上 Vue 留给你的回调点。 最常用的判断是:created 时 data、methods 都好了,但还没渲染,this.$refs 是空的;到 mounted 才有真实节点,ECharts 这种要容器的东西必须放这。父子组件挂载时,父组件先开始渲染,渲染到子组件时把子组件整个创建挂载完,最后父组件才触发 mounted。Vue 3 里 setup 本身就相当于 created 那个时机,其余钩子加 on 前缀,destroyed 改叫 onUnmounted。
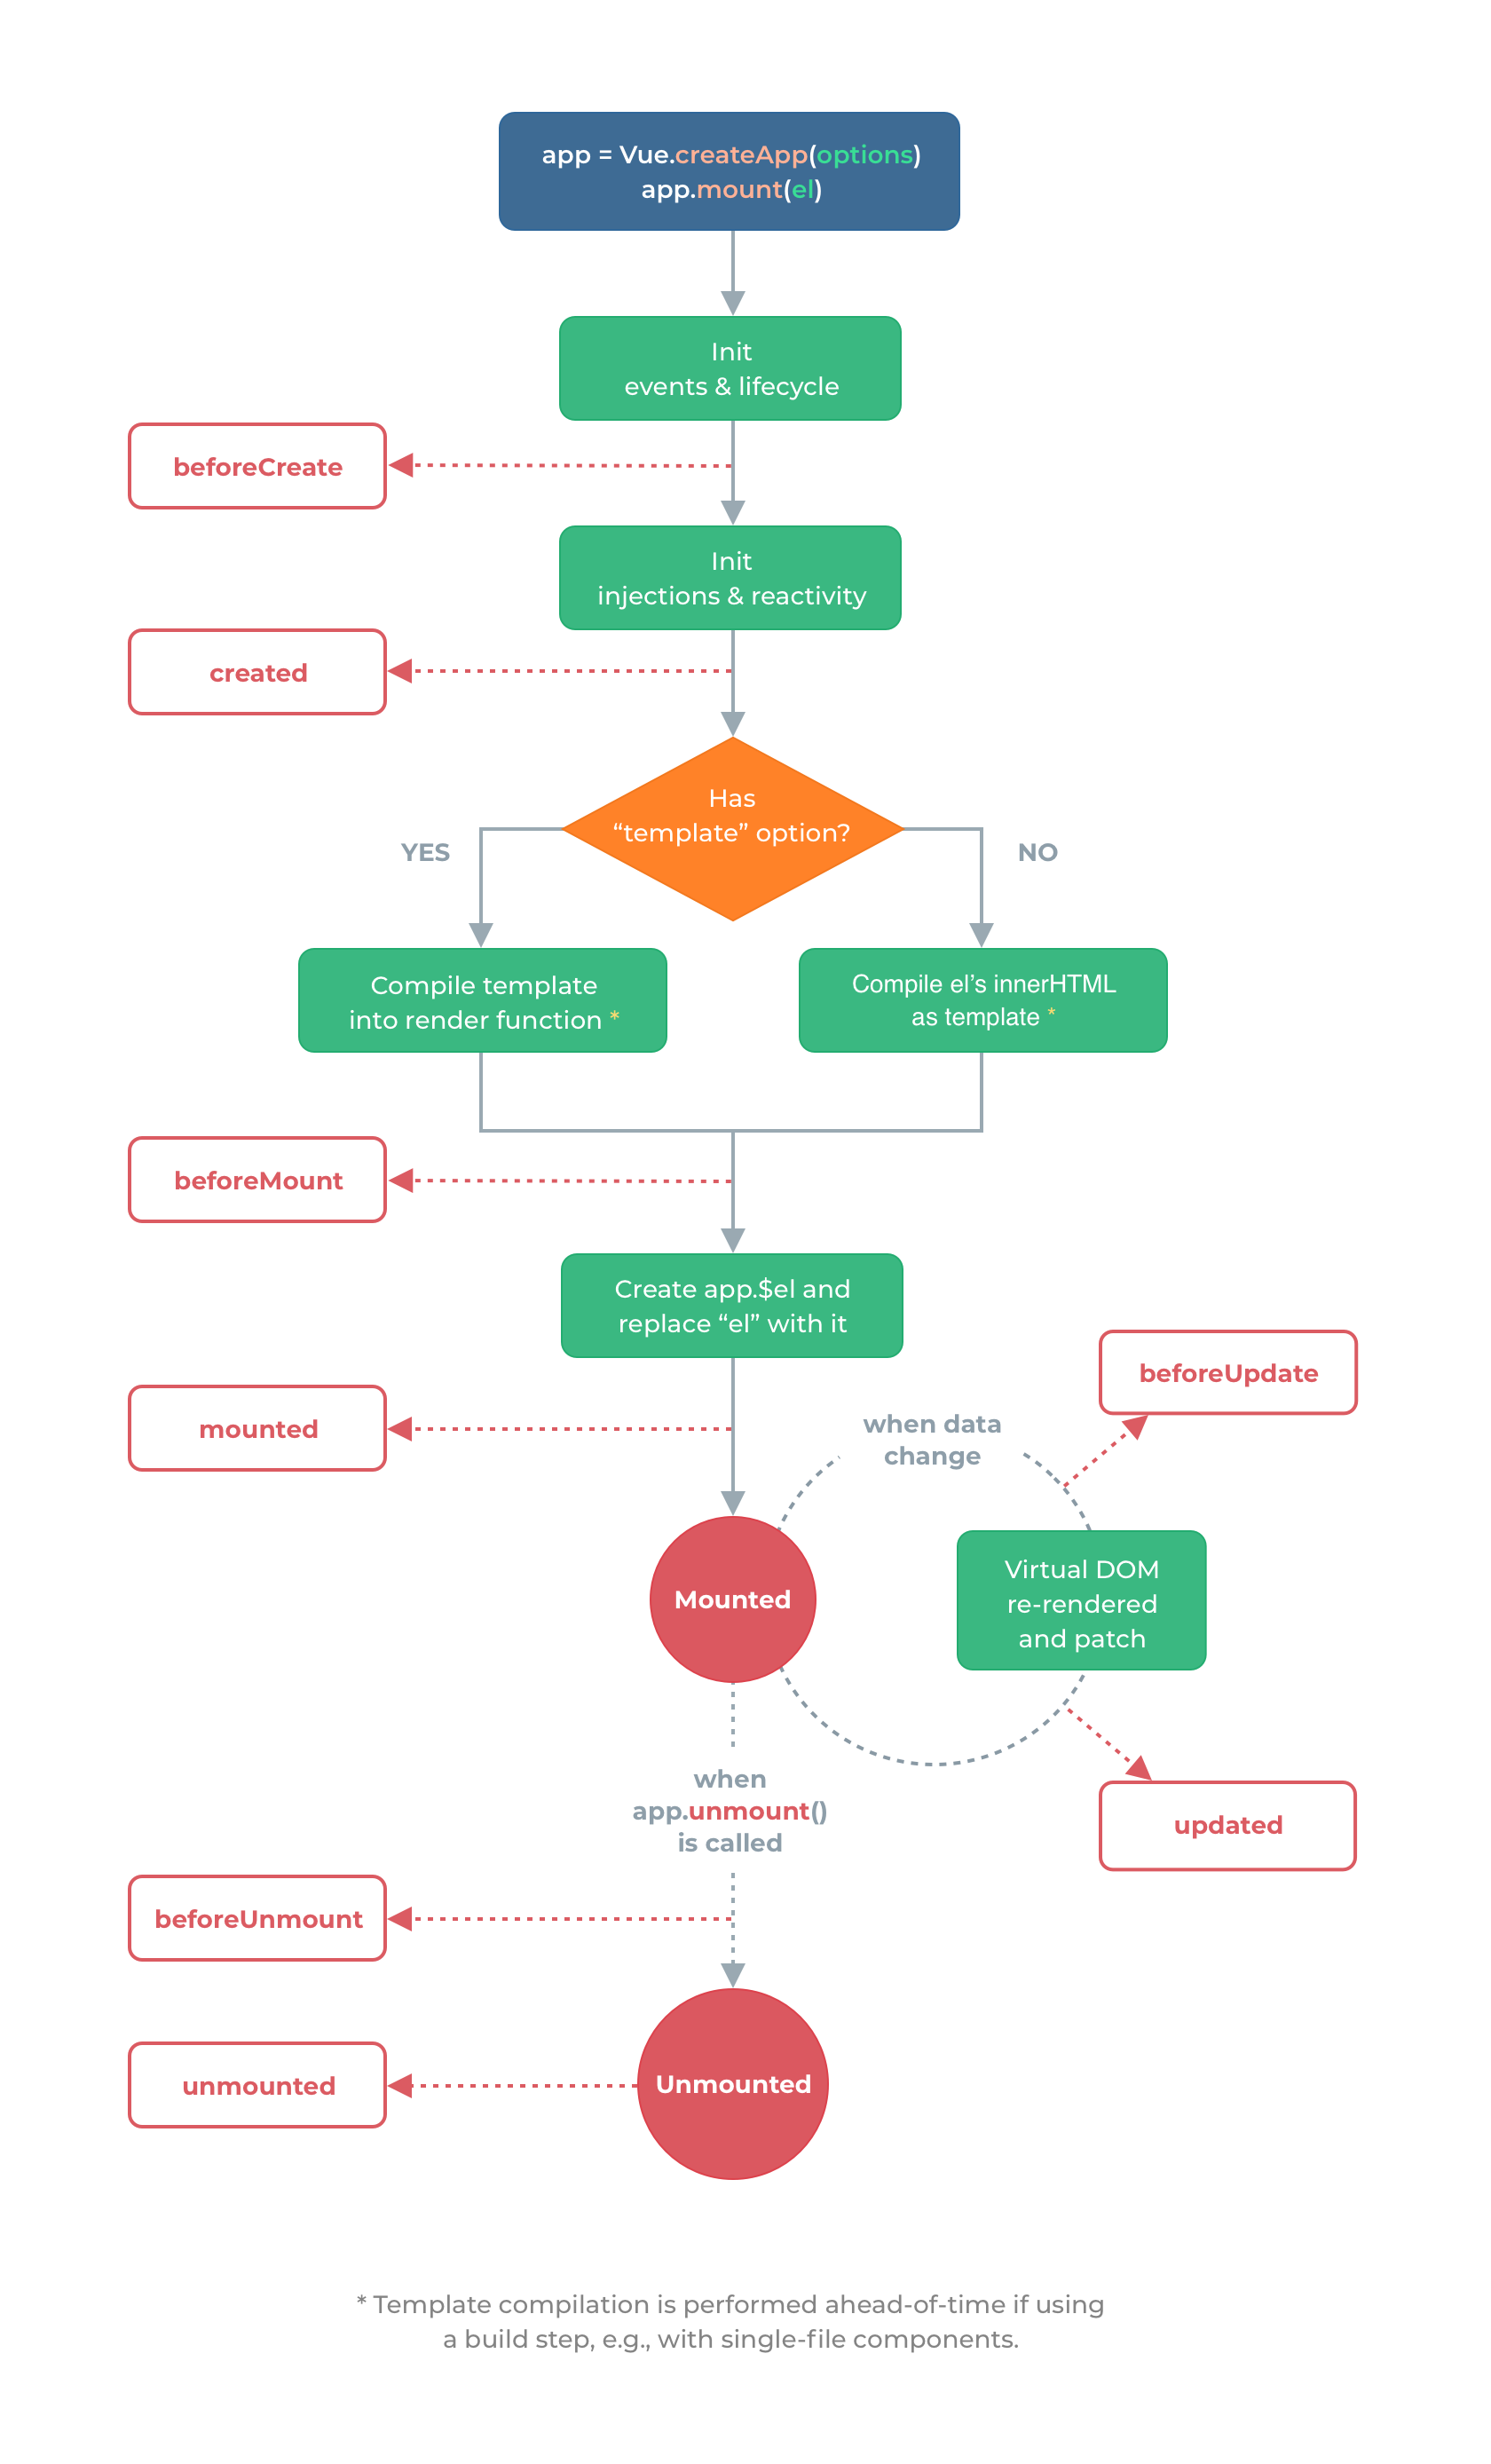
init
initLifecycle/Event,往vm上挂载各种属性callHook: beforeCreated: 实例刚创建initInjection/initState: 初始化注入和data响应性created: 创建完成,属性已经绑定, 但还未生成真实dom`- 进行元素的挂载:
$el / vm.$mount() - 是否有
template: 解析成render function*.vue文件:vue-loader会将<template>编译成render function
beforeMount: 模板编译/挂载之前- 执行
render function,生成真实的dom,并替换到dom tree中 mounted: 组件已挂载
update
- 执行
diff算法,比对改变是否需要触发UI更新 flushScheduleQueuewatcher.before: 触发beforeUpdate钩子 -watcher.run(): 执行watcher中的notify,通知所有依赖项更新UI- 触发
updated钩子: 组件已更新 actived / deactivated(keep-alive): 不销毁,缓存,组件激活与失活destroybeforeDestroy: 销毁开始- 销毁自身且递归销毁子组件以及事件监听
remove(): 删除节点watcher.teardown(): 清空依赖vm.$off(): 解绑监听
destroyed: 完成后触发钩子
| Vue2 | Vue3 |
|---|---|
beforeCreate | ❌setup(替代) |
created | ❌setup(替代) |
beforeMount | onBeforeMount |
mounted | onMounted |
beforeUpdate | onBeforeUpdate |
updated | nUpdated |
beforeDestroy | onBeforeUnmount |
destroyed | onUnmounted |
errorCaptured | onErrorCaptured |
| - | 🎉onRenderTracked |
| - | 🎉onRenderTriggered |
上面是vue的声明周期的简单梳理,接下来我们直接以代码的形式来完成vue的初始化
new Vue({})
// 初始化Vue实例
function _init() {
// 挂载属性
initLifeCycle(vm)
// 初始化事件系统,钩子函数等
initEvent(vm)
// 编译slot、vnode
initRender(vm)
// 触发钩子
callHook(vm, 'beforeCreate')
// 添加inject功能
initInjection(vm)
// 完成数据响应性 props/data/watch/computed/methods
initState(vm)
// 添加 provide 功能
initProvide(vm)
// 触发钩子
callHook(vm, 'created')
// 挂载节点
if (vm.$options.el) {
vm.$mount(vm.$options.el)
}
}
// 挂载节点实现
function mountComponent(vm) {
// 获取 render function
if (!this.options.render) {
// template to render
// Vue.compile = compileToFunctions
let { render } = compileToFunctions()
this.options.render = render
}
// 触发钩子
callHook('beforeMounte')
// 初始化观察者
// render 渲染 vdom,
vdom = vm.render()
// update: 根据 diff 出的 patchs 挂载成真实的 dom
vm._update(vdom)
// 触发钩子
callHook(vm, 'mounted')
}
// 更新节点实现
funtion queueWatcher(watcher) {
nextTick(flushScheduleQueue)
}
// 清空队列
function flushScheduleQueue() {
// 遍历队列中所有修改
for(){
// beforeUpdate
watcher.before()
// 依赖局部更新节点
watcher.update()
callHook('updated')
}
}
// 销毁实例实现
Vue.prototype.$destory = function() {
// 触发钩子
callHook(vm, 'beforeDestory')
// 自身及子节点
remove()
// 删除依赖
watcher.teardown()
// 删除监听
vm.$off()
// 触发钩子
callHook(vm, 'destoryed')
}
💬 面试官追问
在
created里读this.$refs.chart是undefined,但接口请求正常,为什么?created时实例的数据和方法都初始化好了,所以能发请求;但模板还没渲染,ref指向的节点不存在。图表初始化挪到mounted,卸载时记得chart.dispose()。父组件
mounted里想调子组件的方法,能调到吗?能。子组件的
mounted先于父组件,父mounted时子组件已经挂好了,this.$refs.child.init()没问题。反过来子组件mounted里访问父组件的DOM就可能还没挂到页面上。一个方法里连改三个数据,
updated会触发三次吗?只触发一次。更新是进队列批量刷的,同一轮同步代码里的修改合成一次渲染。另外别在
updated里无条件改状态,很容易死循环。带
keep-alive的页面切走后定时器还在跑,清理写在哪?写在
deactivated,回来时在activated里重启。被缓存的组件切走不会走beforeDestroy/onBeforeUnmount,那里只做真正销毁时的兜底清理。Vue 2迁Vue 3,有人要把created全改成onCreated,你怎么说?Vue 3根本没有onCreated,created里的逻辑直接写在setup顶层就行。要注意onMounted这类钩子必须在setup里同步调用,写在await之后会注册不上(<script setup>编译器会帮你处理这一点)。
# 8 vue-router
⚡ 30 秒速记
- 本质三步:监听
URL变化 → 匹配路由表 → 把对应组件渲染进<router-view> hash模式:#后面的内容不发给服务器,刷新不会404;history模式靠pushState,URL干净,但刷新会真去请求这个路径,服务端要配回退到index.html- 版本差异:
Vue Router 3的hash模式监听hashchange;Vue Router 4两种模式都基于History API,统一听popstate - 守卫顺序:
beforeRouteLeave→ 全局beforeEach→beforeRouteUpdate→beforeEnter→ 解析异步组件 →beforeRouteEnter→beforeResolve→afterEach - 懒加载:
component: () => import('./Detail.vue'),打包工具自动拆包
vue-router 说白了就是监听地址变化,查路由表找到组件,再让 <router-view> 渲染它。 简化实现里会把当前路径存成一个响应式的 current,router-view 的 render 读了它,地址一变就自动重新渲染。hash 和 history 的区别主要在部署:history 模式下用户刷新 /detail/1,服务器真会去找这个文件,Nginx 不配 try_files $uri /index.html 就是 404。另外导航守卫的执行顺序面试常考,beforeRouteEnter 里拿不到 this,因为这时候组件还没创建,要用 next(vm => {}) 拿实例。
mode
hashhistory
跳转
this.$router.push()<router-link to=""></router-link>
占位
<router-view></router-view>
vue-router源码实现
- 作为一个插件存在:实现
VueRouter类和install方法 - 实现两个全局组件:
router-view用于显示匹配组件内容,router-link用于跳转 - 监控
url变化:监听hashchange或popstate事件 - 响应最新
url:创建一个响应式的属性current,当它改变时获取对应组件并显示
// 我们的插件:
// 1.实现一个Router类并挂载期实例
// 2.实现两个全局组件router-link和router-view
let Vue;
class VueRouter {
// 核心任务:
// 1.监听url变化
constructor(options) {
this.$options = options;
// 缓存path和route映射关系
// 这样找组件更快
this.routeMap = {}
this.$options.routes.forEach(route => {
this.routeMap[route.path] = route
})
// 数据响应式
// 定义一个响应式的current,则如果他变了,那么使用它的组件会rerender
Vue.util.defineReactive(this, 'current', '')
// 请确保onHashChange中this指向当前实例
window.addEventListener('hashchange', this.onHashChange.bind(this))
window.addEventListener('load', this.onHashChange.bind(this))
}
onHashChange() {
// console.log(window.location.hash);
this.current = window.location.hash.slice(1) || '/'
}
}
// 插件需要实现install方法
// 接收一个参数,Vue构造函数,主要用于数据响应式
VueRouter.install = function (_Vue) {
// 保存Vue构造函数在VueRouter中使用
Vue = _Vue
// 任务1:使用混入来做router挂载这件事情
Vue.mixin({
beforeCreate() {
// 只有根实例才有router选项
if (this.$options.router) {
Vue.prototype.$router = this.$options.router
}
}
})
// 任务2:实现两个全局组件
// router-link: 生成一个a标签,在url后面添加#
// <a href="#/about">aaaa</a>
// <router-link to="/about">aaa</router-link>
Vue.component('router-link', {
props: {
to: {
type: String,
required: true
},
},
render(h) {
// h(tag, props, children)
return h('a',
{ attrs: { href: '#' + this.to } },
this.$slots.default
)
// 使用jsx
// return <a href={'#'+this.to}>{this.$slots.default}</a>
}
})
Vue.component('router-view', {
render(h) {
// 根据current获取组件并render
// current怎么获取?
// console.log('render',this.$router.current);
// 获取要渲染的组件
let component = null
const { routeMap, current } = this.$router
if (routeMap[current]) {
component = routeMap[current].component
}
return h(component)
}
})
}
export default VueRouter
💬 面试官追问
改成
history模式后,本地好好的,上线刷新就404,为什么?history模式的路径是真实路径,刷新时浏览器会向服务器要/detail/1,服务器上没这个文件。Nginx加try_files $uri $uri/ /index.html;,把找不到的路径都交给前端路由。pushState会触发popstate吗?那路由怎么知道地址变了?不会,
pushState/replaceState不触发popstate,只有前进后退才触发。所以router.push是自己改完URL后主动更新current,popstate只负责处理浏览器前进后退。beforeRouteEnter里this是undefined,怎么拿组件实例?这时候组件还没创建。用
next(vm => { vm.load() }),回调会在导航确认、组件挂载后执行。Vue 3组合式写法里没有对应的onBeforeRouteEnter,一般改在setup里直接请求。/user/1跳到/user/2,页面数据没变,为什么?同一个路由组件被复用了,
created/mounted不会再走。监听$route.params.id,或者用beforeRouteUpdate重新拉数据;偷懒的做法是<router-view :key="$route.fullPath" />强制重建,代价是组件状态全丢。登录拦截写在全局
beforeEach里,有什么要注意的?别死循环:未登录跳
/login时要放行/login本身。Vue Router 4推荐直接return '/login'或return false,不再强制调next;Router 3里next必须且只能调一次。
# 9 vuex
⚡ 30 秒速记
- 五个概念:
state数据源、getters派生值、mutations同步改状态(唯一入口)、actions放异步再commit、modules按业务拆 - 数据流:组件
dispatch→action请求接口 →commit→mutation改state→ 视图更新 mutation必须同步:devtools要在每次mutation前后拍快照,异步改状态就对不上号了- 原理:借一个
Vue实例让state变响应式,commit/dispatch就是按type查表执行 - 现状:
Vue 3官方推荐Pinia,去掉了mutation、TS推导好;Vuex 4只在维护,别在新项目用
Vuex 是把多个组件共享的状态集中放一个地方,并且规定只能通过固定的路子修改。 读用 state 和 getters,改只能 commit 一个 mutation,异步的事放在 action 里,请求完再 commit。为什么要这么啰嗦?因为所有修改都过 mutation 这一个口子,devtools 就能记下每一次变化,出问题能回放。原理上它就是用一个 Vue 实例的 data 托管 state 让它变响应式,再把 $store 注入到每个组件。现在新项目我直接用 Pinia,写法更像普通的组合函数。
Vuex 集中式存储管理应用的所有组件的状态,并以相应的规则保证状态以可预测的方式发生变化
核心概念
state: 状态中心mutations: 更改状态actions: 异步更改状态getters: 获取状态modules: 将state分成多个modules,便于管理
- 状态 - state
state保存应用状态
export default new Vuex.Store({ state: { counter:0 },})
- 状态变更 - mutations
mutations用于修改状态,store.js
export default new Vuex.Store({
mutations:
{
add(state) {
state.counter++
}
}
})
- 派生状态 - getters
从state派生出新状态,类似计算属性
export default new Vuex.Store({
getters:
{
doubleCounter(state) { // 计算剩余数量 return state.counter * 2;
}
}
})
- 动作 - actions
加业务逻辑,类似于controller
export default new Vuex.Store({
actions:
{
add({
commit
}) {
setTimeout(() = >{}
}
})
测试代码:
<p @click="$store.commit('add')">counter: {{$store.state.counter}}</p>
<p @click="$store.dispatch('add')">async counter: {{$store.state.counter}}</p>
<p>double:{{$store.getters.doubleCounter}}</p>
vuex原理解析
- 实现一个插件:声明
Store类,挂载$store Store具体实现:- 创建响应式的
state,保存mutations、actions和getters - 实现
commit根据用户传入type执行对应mutation - 实现
dispatch根据用户传入type执行对应action,同时传递上下文 - 实现
getters,按照getters定义对state做派生
- 创建响应式的
// 目标1:实现Store类,管理state(响应式的),commit方法和dispatch方法
// 目标2:封装一个插件,使用更容易使用
let Vue;
class Store {
constructor(options) {
// 定义响应式的state
// this.$store.state.xx
// 借鸡生蛋
this._vm = new Vue({
data: {
$$state: options.state
}
})
this._mutations = options.mutations
this._actions = options.actions
// 绑定this指向
this.commit = this.commit.bind(this)
this.dispatch = this.dispatch.bind(this)
}
// 只读
get state() {
return this._vm._data.$$state
}
set state(val) {
console.error('不能直接赋值呀,请换别的方式!!天王盖地虎!!');
}
// 实现commit方法,可以修改state
commit(type, payload) {
// 拿出mutations中的处理函数执行它
const entry = this._mutations[type]
if (!entry) {
console.error('未知mutaion类型');
return
}
entry(this.state, payload)
}
dispatch(type, payload) {
const entry = this._actions[type]
if (!entry) {
console.error('未知action类型');
return
}
// 上下文可以传递当前store实例进去即可
entry(this, payload)
}
}
function install(_Vue){
Vue = _Vue
// 混入store实例
Vue.mixin({
beforeCreate() {
if (this.$options.store) {
Vue.prototype.$store = this.$options.store
}
}
})
}
// { Store, install }相当于Vuex
// 它必须实现install方法
export default { Store, install }
💬 面试官追问
把接口请求直接写进
mutation里,反正最后都是改state,行不行?不行。
devtools记录的是mutation执行完那一刻的快照,请求还没回来状态就被记下了,时间旅行和状态追踪全乱。请求放action,拿到结果再commit。dispatch报unknown action type,但同步按钮正常,查哪里?先看
type写对没有,模块开了namespaced: true的话要写成'cart/addAsync'。再看这个action是不是真注册进了对应模块,最后确认它内部commit的名字也带上了正确的命名空间。页面一刷新
Vuex里的登录状态就没了,怎么办?Vuex就是内存里的对象,刷新必丢。需要持久化的字段自己写到localStorage,启动时读回来,或者用vuex-persistedstate/pinia-plugin-persistedstate。token这种别全量持久化整个store。从
Vuex迁到Pinia,最大的写法变化是什么?没有
mutation了,action里直接this.count++,同步异步都写在actions。也没有嵌套modules,每个defineStore就是一个独立store,用到哪个import哪个,TS类型自动推导出来。什么状态不该放进
store?只有一个组件用的、或者离开页面就该清掉的状态,比如某个弹窗开关、表单草稿,放组件里就好。全塞
store会导致切页面回来还是上次的数据,还得手动重置。
# 10 vue3带来的新特性/亮点
⚡ 30 秒速记
- 响应式换
Proxy:能感知属性增删、数组下标修改,嵌套对象访问时才代理(懒代理),不用Vue.set了 Composition API+<script setup>:按功能组织代码,组合函数替代mixin- 编译期优化:静态提升、
PatchFlag、Block Tree,更新成本只和动态节点数量有关 - 工程:源码
TS重写,API支持tree-shaking,不用的功能不进包 - 新内置能力:
Fragment多根节点、Teleport渲染到别处、Suspense等异步(Suspense至今仍标为实验性)
Vue 3 的亮点可以分三块记:响应式换成 Proxy、多了 Composition API、编译器做了大量优化。 Proxy 代理的是整个对象,给对象加新字段、改数组下标都能被拦截到,Vue 2 时代那堆 this.$set 基本不用写了。编译器会在模板里标出哪些节点是动态的,diff 时直接跳过静态部分,模板再大,更新成本也只取决于动态内容的多少。再加上 Teleport 解决弹窗被父级 overflow 裁切、Fragment 允许多个根节点,日常开发体验提升挺明显。
1. 压缩包体积更小
当前最小化并被压缩的 Vue 运行时大小约为 20kB(2.6.10 版为 22.8kB)。Vue 3.0捆绑包的大小大约会减少一半,即只有10kB!
2. Object.defineProperty -> Proxy
Object.defineProperty是一个相对比较昂贵的操作,因为它直接操作对象的属性,颗粒度比较小。将它替换为es6的Proxy,在目标对象之上架了一层拦截,代理的是对象而不是对象的属性。这样可以将原本对对象属性的操作变为对整个对象的操作,颗粒度变大。- javascript引擎在解析的时候希望对象的结构越稳定越好,如果对象一直在变,可优化性降低,proxy不需要对原始对象做太多操作。
3. Virtual DOM 重构
vdom的本质是一个抽象层,用javascript描述界面渲染成什么样子。react用jsx,没办法检测出可以优化的动态代码,所以做时间分片,vue中足够快的话可以不用时间分片
传统vdom的性能瓶颈:
- 虽然 Vue 能够保证触发更新的组件最小化,但在单个组件内部依然需要遍历该组件的整个 vdom 树。
- 传统 vdom 的性能跟模版大小正相关,跟动态节点的数量无关。在一些组件整个模版内只有少量动态节点的情况下,这些遍历都是性能的浪费。
- JSX 和手写的 render function 是完全动态的,过度的灵活性导致运行时可以用于优化的信息不足
那为什么不直接抛弃vdom呢?
- 高级场景下手写
render function获得更强的表达力 - 生成的代码更简洁
- 兼容2.x
- 高级场景下手写
vue的特点是底层为Virtual DOM,上层包含有大量静态信息的模版。为了兼容手写 render function,最大化利用模版静态信息,
vue3.0采用了动静结合的解决方案,将vdom的操作颗粒度变小,每次触发更新不再以组件为单位进行遍历,主要更改如下
- 将模版基于动态节点指令切割为嵌套的区块
- 每个区块内部的节点结构是固定的
- 每个区块只需要以一个
Array追踪自身包含的动态节点
vue3.0将 vdom 更新性能由与模版整体大小相关提升为与动态内容的数量相关
Vue 3.0 动静结合的 Dom diff
- Vue3.0 提出动静结合的 DOM diff 思想,动静结合的 DOM diff其实是在预编译阶段进行了优化。之所以能够做到预编译优化,是因为 Vue core 可以静态分析 template,在解析模版时,整个 parse 的过程是利用正则表达式顺序解析模板,当解析到开始标签、闭合标签和文本的时候都会分别执行对应的回调函数,来达到构造 AST 树的目的。
- 借助预编译过程,Vue 可以做到的预编译优化就很强大了。比如在预编译时标记出模版中可能变化的组件节点,再次进行渲染前 diff 时就可以跳过“永远不会变化的节点”,而只需要对比“可能会变化的动态节点”。这也就是动静结合的 DOM diff 将 diff 成本与模版大小正相关优化到与动态节点正相关的理论依据。
4. Performance
vue3在性能方面比vue2快了2倍。
- 重写了虚拟DOM的实现
- 运行时编译
- update性能提高
- SSR速度提高
5. Tree-shaking support
vue3中的核心api都支持了tree-shaking,这些api都是通过包引入的方式而不是直接在实例化时就注入,只会对使用到的功能或特性进行打包(按需打包),这意味着更多的功能和更小的体积。
6. Composition API
vue2中,我们一般会采用mixin来复用逻辑代码,用倒是挺好用的,不过也存在一些问题:例如代码来源不清晰、方法属性等冲突。基于此在vue3中引入了Composition API(组合API),使用纯函数分隔复用代码。和React中的
hooks的概念很相似
- 更好的逻辑复用和代码组织
- 更好的类型推导
<template>
<div>X: {{ x }}</div>
<div>Y: {{ y }}</div>
</template>
<script>
import { defineComponent, onMounted, onUnmounted, ref } from "vue";
const useMouseMove = () => {
const x = ref(0);
const y = ref(0);
function move(e) {
x.value = e.clientX;
y.value = e.clientY;
}
onMounted(() => {
window.addEventListener("mousemove", move);
});
onUnmounted(() => {
window.removeEventListener("mousemove", move);
});
return { x, y };
};
export default defineComponent({
setup() {
const { x, y } = useMouseMove();
return { x, y };
}
});
</script>
7. 新增的三个组件Fragment、Teleport、Suspense
Fragment
在书写vue2时,由于组件必须只有一个根节点,很多时候会添加一些没有意义的节点用于包裹。Fragment组件就是用于解决这个问题的(这和React中的Fragment组件是一样的)。
这意味着现在可以这样写组件了。
/* App.vue */
<template>
<header>...</header>
<main v-bind="$attrs">...</main>
<footer>...</footer>
</template>
<script>
export default {};
</script>
或者这样
// app.js
import { defineComponent, h, Fragment } from 'vue';
export default defineComponent({
render() {
return h(Fragment, {}, [
h('header', {}, ['...']),
h('main', {}, ['...']),
h('footer', {}, ['...']),
]);
}
});
Teleport
Teleport其实就是React中的Portal。Portal 提供了一种将子节点渲染到存在于父组件以外的 DOM 节点的优秀的方案。
一个 portal 的典型用例是当父组件有 overflow: hidden 或 z-index 样式时,但你需要子组件能够在视觉上“跳出”其容器。例如,对话框、悬浮卡以及提示框。
/* App.vue */
<template>
<div>123</div>
<Teleport to="#container">
Teleport
</Teleport>
</template>
<script>
import { defineComponent } from "vue";
export default defineComponent({
setup() {}
});
</script>
/* index.html */
<div id="app"></div>
<div id="container"></div>
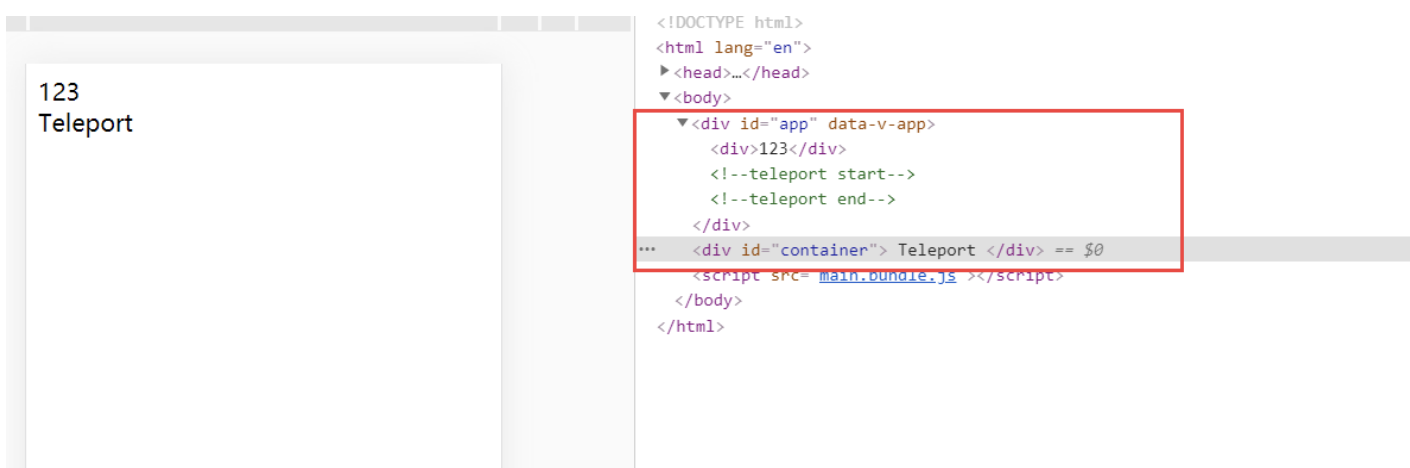
Suspense
同样的,这和React中的Supense是一样的。
Suspense让你的组件在渲染之前进行“等待”,并在等待时显示 fallback 的内容
// App.vue
<template>
<Suspense>
<template #default>
<AsyncComponent />
</template>
<template #fallback>
Loading...
</template>
</Suspense>
</template>
<script lang="ts">
import { defineComponent } from "vue";
import AsyncComponent from './AsyncComponent.vue';
export default defineComponent({
name: "App",
components: {
AsyncComponent
}
});
</script>
// AsyncComponent.vue
<template>
<div>Async Component</div>
</template>
<script lang="ts">
import { defineComponent } from "vue";
const sleep = () => {
return new Promise(resolve => setTimeout(resolve, 1000));
};
export default defineComponent({
async setup() {
await sleep();
}
});
</script>
8. Better TypeScript support
在vue2中使用过TypesScript的童鞋应该有过体会,写起来实在是有点难受。vue3则是使用ts进行了重写,开发者使用vue3时拥有更好的类型支持和更好的编写体验。
💬 面试官追问
模板里上百个静态节点只有标题会变,
Vue 3更新时还要比整棵树吗?不用。编译时静态节点被提升成常量,动态节点被收集到所在
Block的dynamicChildren数组里,更新时只遍历这个数组,比对标题那一个节点。Vue 3给对象加新属性能响应了,那Vue.set彻底没用了吗?Vue 3里确实不需要了,全局Vue.set也被移除了。但如果你在维护Vue 2.7项目,新增属性和数组下标赋值还是得用this.$set,这个差别迁移时容易忽略。弹窗放在
overflow: hidden的卡片里被裁掉,逻辑又想留在卡片组件里,怎么做?用
<Teleport to="body">包住弹窗,DOM渲染到body下,组件归属、props和事件还在卡片里。目标节点要在挂载前就存在,Vue 3.5起也可以加defer等同一轮渲染里的目标。组件库功能很多,业务只用了一部分,
Vue 3会把没用的也打进去吗?Vue 3自身的API都是具名导出,Transition、KeepAlive这类没import就会被摇掉。但组件库要看它自己支不支持按需引入,全量app.use(Lib)还是会全打进来。Suspense能直接拿来替代所有loading状态吗?我不会这么干。它到现在还是实验性特性,而且只管等待展示,错误和重试还得配
onErrorCaptured自己处理。简单的请求写个loading变量更直白。
# 11 Compositon api
⚡ 30 秒速记
- 解决的问题:
Options API一个功能被拆到data/computed/methods/watch四处,组件大了改一处跳四处 - 做法:同一功能的状态、计算、监听、生命周期写在一起,再抽成
useXxx组合函数复用 - 比
mixin强在:来源清楚(显式解构)、没有同名覆盖、TS推导友好 - 和
React Hooks的区别:setup每个实例只跑一次,依赖自动收集,不靠调用顺序,可以写在条件里 - 坑:
ref在JS里要.value;解构reactive会丢响应性(用toRefs);onMounted这类钩子要在setup里同步调用
Composition API 让你按「功能」而不是按「选项类型」组织组件代码。 比如一个搜索功能,关键词、结果、防抖请求、卸载时取消请求,以前要散在四个选项里,现在可以写成一个 useSearch(),返回 { keyword, list },组件里一眼能看出来源。mixin 最大的问题就是来源不明和同名覆盖,五个 mixin 混进来你根本不知道 this.load 是谁的。跟 React Hooks 看着像,但底层不一样:setup 只执行一次,依赖靠响应式自动收集,没有依赖数组,也不怕写在 if 里。
Composition API也叫组合式API,是Vue3.x的新特性。
通过创建 Vue 组件,我们可以将接口的可重复部分及其功能提取到可重用的代码段中。仅此一项就可以使我们的应用程序在可维护性和灵活性方面走得更远。然而,我们的经验已经证明,光靠这一点可能是不够的,尤其是当你的应用程序变得非常大的时候——想想几百个组件。在处理如此大的应用程序时,共享和重用代码变得尤为重要
- Vue2.0中,随着功能的增加,组件变得越来越复杂,越来越难维护,而难以维护的根本原因是Vue的API设计迫使开发者使用
watch,computed,methods选项组织代码,而不是实际的业务逻辑。 - 另外Vue2.0缺少一种较为简洁的低成本的机制来完成逻辑复用,虽然可以
minxis完成逻辑复用,但是当mixin变多的时候,会使得难以找到对应的data、computed或者method来源于哪个mixin,使得类型推断难以进行。 - 所以
Composition API的出现,主要是也是为了解决Option API带来的问题,第一个是代码组织问题,Compostion API可以让开发者根据业务逻辑组织自己的代码,让代码具备更好的可读性和可扩展性,也就是说当下一个开发者接触这一段不是他自己写的代码时,他可以更好的利用代码的组织反推出实际的业务逻辑,或者根据业务逻辑更好的理解代码。 - 第二个是实现代码的逻辑提取与复用,当然
mixin也可以实现逻辑提取与复用,但是像前面所说的,多个mixin作用在同一个组件时,很难看出property是来源于哪个mixin,来源不清楚,另外,多个mixin的property存在变量命名冲突的风险。而Composition API刚好解决了这两个问题。
通俗的讲:
没有Composition API之前vue相关业务的代码需要配置到option的特定的区域,中小型项目是没有问题的,但是在大型项目中会导致后期的维护性比较复杂,同时代码可复用性不高。Vue3.x中的composition-api就是为了解决这个问题而生的
compositon api提供了以下几个函数:
setuprefreactivewatchEffectwatchcomputedtoRefs- 生命周期的
hooks
都说Composition API与React Hook很像,说说区别
从React Hook的实现角度看,React Hook是根据useState调用的顺序来确定下一次重渲染时的state是来源于哪个useState,所以出现了以下限制
- 不能在循环、条件、嵌套函数中调用Hook
- 必须确保总是在你的React函数的顶层调用Hook
useEffect、useMemo等函数必须手动确定依赖关系
而Composition API是基于Vue的响应式系统实现的,与React Hook的相比
- 声明在
setup函数内,一次组件实例化只调用一次setup,而React Hook每次重渲染都需要调用Hook,使得React的GC比Vue更有压力,性能也相对于Vue来说也较慢 Compositon API的调用不需要顾虑调用顺序,也可以在循环、条件、嵌套函数中使用- 响应式系统自动实现了依赖收集,进而组件的部分的性能优化由Vue内部自己完成,而
React Hook需要手动传入依赖,而且必须必须保证依赖的顺序,让useEffect、useMemo等函数正确的捕获依赖变量,否则会由于依赖不正确使得组件性能下降。
虽然
Compositon API看起来比React Hook好用,但是其设计思想也是借鉴React Hook的。
💬 面试官追问
组件混了五个
mixin,模板里的rows找不到出处,怎么改?每个
mixin改成一个组合函数,组件里写const { rows, load } = useTable(),出处一目了然。两个函数返回同名值时解构改个名就行:const { load: loadUser } = useUser()。React规定Hook不能写在if里,Vue的组合函数也一样吗?不一样。
React靠调用顺序对应状态,所以必须顺序固定;Vue的状态就是ref对象本身,setup只跑一次,写在条件里没问题。唯一要注意的是内部调了onMounted的组合函数,必须在setup同步阶段调用,await之后调会丢失当前实例。const { count } = reactive({ count: 0 }),之后改count页面不变,为什么?解构出来的
count就是个普通数字0,和代理对象断开了。要么const { count } = toRefs(state),拿到的是ref,要么直接用ref声明。风控页要明确监听账户和金额,还要拿到新旧值,
watch还是watchEffect?用
watch([account, amount], ([a, m], [oldA, oldM]) => {...})。watchEffect自动收集依赖,拿不到旧值,依赖边界也不显眼,审计类逻辑我会要求显式写出来。ref和reactive到底用哪个?我现在基本统一用
ref。reactive不能整体替换、解构会丢响应性,ref什么类型都能装,多写一个.value换来行为一致;官方文档现在也推荐ref作为主力。
# 12 computed 的实现原理
⚡ 30 秒速记
- 本质:带缓存的惰性
watcher/effect,靠dirty标记决定要不要重算 - 依赖变了只把
dirty置true,不立即计算;下次读取才重新求值,没人读就永远不算 - 和
methods:methods每次渲染都执行;computed依赖不变就直接返回缓存 - 和
watch:computed派生值(要有返回值、别写副作用),watch处理副作用 - 版本差异:
Vue 2.6依赖一变渲染watcher就会更新;Vue 3.4+会比较新旧计算结果,结果没变就不触发下游
computed 可以理解成一个会记账的 getter:依赖没变就直接给上次的结果,依赖变了也先不算,等有人读的时候才算。 实现上它是一个 lazy 的观察者,内部有个 dirty 标记,依赖变化时只把 dirty 设成 true,读取时发现脏了才重新执行函数并缓存。所以模板里十个地方用 totalPrice,一次渲染只算一次,换成方法就是算十次。还有个版本细节:Vue 2.6 里渲染 watcher 会直接订阅 computed 的底层依赖,依赖一变组件就重新渲染;Vue 3.4 起才做到计算结果没变就不通知下游。
computed本质是一个惰性求值的观察者computed watcher。其内部通过this.dirty属性标记计算属性是否需要重新求值。
- 当 computed 的依赖状态发生改变时,就会通知这个惰性的 watcher,
computed watcher通过this.dep.subs.length判断有没有订阅者, - 有的话,会重新计算,然后对比新旧值,如果变化了,会重新渲染。 (Vue 想确保不仅仅是计算属性依赖的值发生变化,而是当计算属性
最终计算的值发生变化时才会触发渲染 watcher重新渲染,本质上是一种优化。) - 没有的话,仅仅把
this.dirty = true(当计算属性依赖于其他数据时,属性并不会立即重新计算,只有之后其他地方需要读取属性的时候,它才会真正计算,即具备 lazy(懒计算)特性。)
💬 面试官追问
模板里
totalPrice()调了十几次,改成computed为什么能快?方法每次渲染每处都执行,遍历十几遍订单;
computed第一次读时算一次缓存起来,后面直接返回。依赖的订单没变,下一次渲染连一次都不用算。一个昂贵的
computed,折叠面板关着没人读,源数据变了会马上算吗?不会,只把
dirty置成true。等面板展开模板读到它时才真正计算,这就是惰性,没人用就零成本。computed依赖Date.now(),为什么时间一直不更新?Date.now()不是响应式数据,computed收集不到依赖,第一次算完就永远用缓存。要么用一个ref存当前时间、定时器每秒更新它,要么就用方法。源字段变了但结果没变,依赖它的组件会重新渲染吗?
看版本。
Vue 3.4+不会,computed会比较新旧值,一样就不触发;Vue 2.6和Vue 3.4之前,渲染层会跟着依赖变化重新执行render,只是diff发现没差异不改DOM。能在
computed里发请求、写日志吗?别这么干。
computed什么时候执行取决于有没有人读,请求时机就不可控了,有缓存时还可能根本不发。副作用放watch或者事件处理函数里。
# 13 watch 的理解
⚡ 30 秒速记
- 用途:数据变了去做副作用(发请求、写缓存、改
DOM),本身没有缓存、没有返回值 - 常用选项:
immediate立即执行一次、deep深度监听、flush: 'post'等DOM更新后再回调 - 监听对象某个属性:
Vue 2写字符串路径'form.phone',Vue 3写getter:watch(() => form.phone, cb) deep会递归遍历整个对象,大对象慎用;Vue 3直接watch一个reactive对象默认就是深度的- 三种
watcher(Vue 2):渲染watcher、计算属性watcher、用户watcher,watch选项就是用户那种
watch 就是「这个值一变,我要去做点什么」,比如关键词变了去搜索、id 变了重新拉详情。 它和 computed 的分工很清楚:要算一个新值用 computed,要执行动作用 watch。监听对象内部字段时,有人图省事直接 deep: true,但深度监听要把整个对象递归读一遍收集依赖,对象大了很费;能明确知道看哪个字段,就精确监听那个字段。Vue 3 里还要注意,watch(state.count, cb) 这样传的是个数字,是监听不到的,得写成 () => state.count。
watch没有缓存性,更多的是观察的作用,可以监听某些数据执行回调。当我们需要深度监听对象中的属性时,可以打开deep:true选项,这样便会对对象中的每一项进行监听。这样会带来性能问题,优化的话可以使用字符串形式监听
注意:Watcher : 观察者对象 , 实例分为
渲染 watcher(render watcher),计算属性 watcher(computed watcher),侦听器 watcher(user watcher)三种
Vue 3 里 watch 有几种写法,区别很容易搞混:
import { ref, reactive, watch } from 'vue'
const count = ref(0)
const form = reactive({ phone: '', addr: { city: '' } })
watch(count, (v, old) => console.log(v, old)) // ref 直接传,OK
watch(() => form.phone, (v) => console.log(v)) // 监听 reactive 的某个字段要写 getter
watch(form, () => console.log('任意字段变了')) // 直接传 reactive 对象,默认就是 deep
watch(() => form.addr, () => {}, { deep: true }) // getter 返回对象时,要深度就得显式写 deep
// watch(form.phone, cb) 错误:传进去的是字符串 '',没有响应性,Vue 会警告
watch(() => form.addr.city, (city) => {
// flush: 'post' 让回调在 DOM 更新之后执行,适合在回调里读 DOM
}, { immediate: true, flush: 'post' })
watch 返回一个停止函数。在 setup 里同步创建的 watch 会跟着组件卸载自动停止;如果是在 setTimeout 或 await 之后创建的,就不会绑定到组件上,要自己保存返回值并在卸载时调用。
Vue 2 的对应写法是 watch: { 'form.phone': handler } 或 this.$watch('form.phone', handler, { deep, immediate })。底层是 user watcher,和渲染 watcher、计算属性 watcher 是同一个 Watcher 类,只是配置不同。
💬 面试官追问
只为姓名变了打个埋点,同事写了个
computed,合适吗?不合适。埋点是副作用,应该
watch(() => user.name, track)。放computed里的话没人读就不触发,有缓存时也不触发,埋点数会对不上。改了
profile.contact.phone,watch(profile, cb)没触发,换整个对象才触发,为什么?这是
Vue 2的表现,默认只看引用有没有换。改成监听'profile.contact.phone'这个路径,或者开deep: true。Vue 3里如果profile是reactive对象,直接watch(profile, cb)默认就是深度的。监听路由
id拉详情,第一次进页面没请求,漏了什么?漏了
immediate: true。watch默认只在变化时执行,初始值不会触发,加上之后首次也会跑一遍,就不用在created里再写一次了。搜索框每输入一个字就发请求,旧请求回来覆盖了新结果,怎么处理?
在回调里登记清理函数,新一轮触发前取消上一轮:
watch(keyword, (v, old, onCleanup) => { const c = new AbortController(); onCleanup(() => c.abort()); search(v, c.signal) })。Vue 3.5也可以用onWatcherCleanup。表单有几十个嵌套字段,任意改动都自动保存,直接
deep: true有什么问题?每次变化都要重新遍历整个对象收集依赖,对象大了很卡,回调也会被无关字段触发得很频繁。可以只监听参与保存的字段,回调再加防抖;
Vue 3.5起deep还可以传数字限制遍历层数。
# 14 vue 渲染过程
⚡ 30 秒速记
- 主线:
template→ 编译成render函数 → 执行得到VNode树 →patch成真实DOM - 编译三步:
parse(模板转AST,最耗时)→optimize/transform(标静态节点,Vue 3还生成PatchFlag)→generate(生成render代码) - 更新:数据变化 → 组件的渲染
watcher(Vue 3叫渲染effect)进队列 → 重新render出新VNode→ 和旧的diff→ 最小化patch - 编译时机:
.vue文件构建期就编译好,只有运行时传template字符串才需要带编译器的完整版 - 更新粒度是组件级:
Vue只重新渲染依赖变了的组件,子组件props没变就跳过
Vue 渲染就是一条流水线:模板先编译成 render 函数,render 跑出 VNode,patch 再把 VNode 变成真实 DOM。 编译这一步一般在打包时由 vue-loader 或 @vitejs/plugin-vue 做掉了,浏览器里拿到的已经是 render 函数。首次渲染时,组件会建一个渲染 watcher,执行 render 的过程中读到哪些响应式数据就订阅哪些。之后数据一变,这个组件进更新队列,在微任务里重新执行 render,新旧 VNode 一比,只改变化的真实节点。所以改个购物车数量,不会重建整页 DOM。
- 调用
compile函数,生成 render 函数字符串 ,编译过程如下:- parse 使用大量的正则表达式对template字符串进行解析,将标签、指令、属性等转化为抽象语法树AST。
模板 -> AST (最消耗性能) - optimize 遍历AST,找到其中的一些静态节点并进行标记,方便在页面重渲染的时候进行diff比较时,直接跳过这一些静态节点,
优化runtime的性能 - generate 将最终的AST转化为render函数字符串
- parse 使用大量的正则表达式对template字符串进行解析,将标签、指令、属性等转化为抽象语法树AST。
- 调用
new Watcher函数,监听数据的变化,当数据发生变化时,Render 函数执行生成 vnode 对象 - 调用
patch方法,对比新旧 vnode 对象,通过 DOM diff 算法,添加、修改、删除真正的 DOM 元素
💬 面试官追问
只改了购物车数量,
Vue会重新创建整棵真实DOM吗?不会。依赖
count的那个组件重新执行render,生成新VNode,和旧的比完发现只有一个文本节点不同,就只改那一个textContent。3000 行表格,每输入一个筛选字符就卡,耗时会在哪几段?
用
Performance面板看:脚本里render和patch那段是生成和比较VNode的成本,后面紫色的Layout和绿色的Paint是真实DOM的成本。3000 行两边都重,一般直接上虚拟列表,再给输入加防抖。运营后台允许在线改
template,和普通组件的渲染流程有什么不同?在线模板要在浏览器里走一遍
parse、transform、generate,所以必须引入带编译器的完整版vue,包更大,首次也更慢。普通.vue组件构建期已经编好,直接从执行render开始。父组件更新了,没改子组件的
props,子组件会重新render吗?一般不会。
Vue在patch到子组件时会比较props,没变就跳过子组件的更新,这是和React默认行为不一样的地方。例外是传了每次都新建的对象或者插槽内容变化。控制台能看到数据是新值,页面还是旧的,怎么查?
先确认这个值是不是在
render期间被读过,比如Vue 2里新增的属性没用$set就没响应性。再看是不是直接改了DOM或者用了v-once。最后看key有没有导致节点复用错位。
# 15 说一说keep-alive实现原理
⚡ 30 秒速记
- 作用:组件切走时不销毁,把实例和
VNode缓存起来,切回来直接复用,状态和滚动内容都还在 - 实现:
Vue 2用cache对象 +keys数组,Vue 3用Map+Set,缓存的是组件VNode(上面挂着实例) LRU淘汰:命中时把key挪到最后;超过max就删最前面那个,也就是最久没用的include/exclude按组件name匹配,支持字符串、正则、数组;名字不对就永远不缓存- 钩子:被缓存的组件不走销毁,切走触发
deactivated,回来触发activated
keep-alive 就是给组件开了个「后台挂起」:切走时不销毁,存起来,切回来直接拿出来接着用。 它本身是个抽象组件,不渲染任何 DOM,只在 render 里拿到默认插槽的第一个子组件,按组件 id 和标签算一个 key 去缓存里找。命中就复用缓存里的组件实例,并把 key 挪到最新位置;没命中就存进去,超过 max 就把最久没访问的那个销毁。最容易踩的坑是 include 匹配的是组件 name,Vue 3 的 <script setup> 在 3.2.34 之后才会从文件名推断 name,不然要用 defineOptions({ name }) 写上。
keep-alive
组件接受三个属性参数:include、exclude、max
include指定需要缓存的组件name集合,参数格式支持String, RegExp, Array。当为字符串的时候,多个组件名称以逗号隔开。exclude指定不需要缓存的组件name集合,参数格式和include一样。max指定最多可缓存组件的数量,超过数量删除第一个。参数格式支持String、Number。
原理
keep-alive实例会缓存对应组件的VNode,如果命中缓存,直接从缓存对象返回对应VNode
LRU(Least recently used) 算法根据数据的历史访问记录来进行淘汰数据,其核心思想是“如果数据最近被访问过,那么将来被访问的几率也更高”。(墨菲定律:越担心的事情越会发生)
keep-alive 的核心逻辑不复杂,下面是按 Vue 2 源码精简后的伪代码,Vue 3 思路一样,只是容器换成了 Map 和 Set:
export default {
name: 'keep-alive',
abstract: true, // 抽象组件:不渲染 DOM,也不进父组件链
props: { include: [String, RegExp, Array], exclude: [String, RegExp, Array], max: [String, Number] },
created() {
this.cache = Object.create(null) // key -> vnode
this.keys = [] // 记录访问顺序,越靠后越新
},
render() {
const vnode = getFirstComponentChild(this.$slots.default)
const name = getComponentName(vnode.componentOptions)
// 不在 include 里,或者命中 exclude:直接返回,不缓存
if ((this.include && !matches(this.include, name)) ||
(this.exclude && matches(this.exclude, name))) return vnode
const key = vnode.key ?? vnode.componentOptions.Ctor.cid + (vnode.componentOptions.tag || '')
if (this.cache[key]) {
vnode.componentInstance = this.cache[key].componentInstance // 复用旧实例
remove(this.keys, key); this.keys.push(key) // LRU:挪到最新
} else {
this.cache[key] = vnode; this.keys.push(key)
if (this.max && this.keys.length > parseInt(this.max)) {
pruneCacheEntry(this.cache, this.keys[0], this.keys) // 删最久没用的,会调 $destroy
}
}
vnode.data.keepAlive = true // 告诉 patch:不要销毁,改走 activated/deactivated
return vnode
}
}
关键在最后那个 keepAlive 标记:patch 遇到带这个标记的组件,挂载时如果已有实例就直接把它的 DOM 插回去并调用 activated,卸载时不调 destroy,而是把 DOM 移出去并调用 deactivated。include / exclude 变化时,组件内部还会 watch 它们,把不再匹配的缓存清掉。
💬 面试官追问
从详情页返回,列表的筛选条件还在,是把页面
DOM存成快照了吗?不是快照。缓存的是组件
VNode,它上面挂着组件实例,实例里的data和它对应的真实DOM都还活着,只是从页面上移到一个隐藏容器里。回来时把这块DOM挪回去,所以状态都在。配了
include="OrderList",可列表页还是每次都重新加载,查哪?先看组件的
name是不是真叫OrderList,这里匹配的是组件name不是路由名。<script setup>组件要么靠文件名推断,要么defineOptions({ name: 'OrderList' });再确认keep-alive包的是<component :is>或router-view渲染出的那个组件本身。设了
max="10",缓存满了怎么淘汰?按
LRU:每次命中都把这个key挪到队尾,满了就删队头那个,也就是最久没被访问的,并且会真正销毁它的实例。缓存的列表页回来后想刷新一下数据,写在
mounted里为什么不执行?缓存命中时组件不会重新挂载,
mounted只走第一次。刷新逻辑放在activated/onActivated里,它首次挂载和每次切回来都会触发。中后台 30 个路由,要不要全部套
keep-alive?不建议。全缓存意味着 30 个实例和它们的
DOM都常驻内存,还会出现「明明改了数据回来还是旧的」的问题。只缓存需要保留编辑状态的页面,用include列清楚,再配个max兜底。
# 16 为什么访问data属性不需要带data
⚡ 30 秒速记
- 原因是代理:初始化时遍历
data的每个key,在实例上用Object.defineProperty定义同名的get/set - 读
this.msg实际转发到this._data.msg,写也一样,数据只有一份,不是复制 props、computed、methods也都挂到实例上,所以它们之间不能重名,Vue开发环境会报警告- 以
_或$开头的data字段不会被代理,要用this.$data._xxx访问 Vue 3:Options API的this是组件实例的Proxy,get时按setupState→data→props→ctx的顺序查找
能直接写 this.msg,是因为 Vue 在实例上给每个 data 字段都装了一个「转接口」。 Vue 2 初始化 data 时会循环所有 key,调用一个 proxy(vm, '_data', key),在 vm 上用 Object.defineProperty 定义 get 返回 this._data[key]、set 写回 this._data[key]。所以 this.msg 和 this._data.msg 是同一个值,不存在两份。这也解释了为什么 data 和 methods 不能重名,大家都往同一个 this 上挂。Vue 3 换了实现,组件的 this 本身就是一个 Proxy,访问时去各个状态容器里依次找。
vue中访问属性代理
this.data.xxx转换this.xxx的实现
/** 将 某一个对象的属性 访问 映射到 对象的某一个属性成员上 */
function proxy( target, prop, key ) {
Object.defineProperty( target, key, {
enumerable: true,
configurable: true,
get () {
return target[ prop ][ key ];
},
set ( newVal ) {
target[ prop ][ key ] = newVal;
}
} );
}
💬 面试官追问
this.count能访问,是不是count被复制到实例上了?不是复制,实例上的
count只是个访问器。Object.getOwnPropertyDescriptor(vm, 'count')打出来能看到get和set,真正的值在vm._data.count里。data里写了_page: 1,模板里{<span class="vp-brace-split" aria-hidden="true"></span>{ _page }<span class="vp-brace-split" aria-hidden="true"></span>}为什么是undefined?Vue不会代理以_和$开头的字段,怕和内部属性冲突。它还是响应式的,但要写$data._page访问,最好直接改个名字。data里有status,methods里也有status,会怎样?开发环境会警告
Method "status" has already been defined as a data property,因为两者都挂在this上。初始化顺序是props→methods→data→computed,冲突后的行为不可靠,直接改名。用
this.count = this._data.count一次性赋值代替代理行不行?不行,那就变成两份独立的值了。之后改
this.count,_data.count不变,也就没有响应式更新。代理的意义就是让每次读写都落到同一个底层字段。Vue 3的setup里返回的变量,模板为什么也能直接用?setup返回的对象会变成setupState,组件的渲染上下文是个Proxy,模板访问count时它先去setupState找,再找data、props。返回的ref在这层还会自动解包,所以模板里不用写.value。
# 17 template预编译是什么
⚡ 30 秒速记
- 定义:构建期就把
template编译成render函数,浏览器里不再做模板编译 - 收益:不用带编译器,包更小(
Vue 2运行时版比完整版小约30%);启动时省掉parse这一步 .vue单文件由vue-loader/@vitejs/plugin-vue预编译;Vue 3的静态提升、PatchFlag也是这一步生成的- 什么时候还得运行时编译:
template写成JS字符串、直接用DOM里的HTML当模板、低代码动态下发模板 - 报错
You are using the runtime-only build就是用了字符串模板却引的运行时版
模板预编译就是在打包的时候把 template 提前翻译成 render 函数,浏览器拿到的直接是可执行的 JS。 模板编译要用正则和状态机把字符串解析成 AST,再生成代码,这活儿放在用户浏览器里做,就是白白多下载一个编译器、多花一段启动时间。放在构建期做,运行时只需要 runtime 版本。我们平时写 .vue 文件其实已经默认在用预编译了。真正要注意的是,如果某处用了 template: '<div>{<span class="vp-brace-split" aria-hidden="true"></span>{ msg }<span class="vp-brace-split" aria-hidden="true"></span>}</div>' 这种字符串,就得把 vue 的别名指到带编译器的完整版,不然页面直接空白。
对于 Vue 组件来说,模板编译只会在组件实例化的时候编译一次,生成渲染函数之后在也不会进行编译。因此,编译对组件的 runtime 是一种性能损耗。
而模板编译的目的仅仅是将template转化为render function,这个过程,正好可以在项目构建的过程中完成,这样可以让实际组件在 runtime 时直接跳过模板渲染,进而提升性能,这个在项目构建的编译template的过程,就是预编译。
预编译前后对比一下,就能看出它到底省了什么:
<!-- 源码 -->
<template>
<div class="box">
<h1>标题</h1>
<p>{{ msg }}</p>
</div>
</template>
// Vue 3 构建后的大致产物(简化)
import { createElementVNode as _el, toDisplayString as _s, openBlock, createElementBlock } from 'vue'
const _hoisted_1 = { class: 'box' }
const _hoisted_2 = /*#__PURE__*/ _el('h1', null, '标题', -1) // 静态节点提升到 render 外,只创建一次
export function render(_ctx) {
return (openBlock(), createElementBlock('div', _hoisted_1, [
_hoisted_2,
_el('p', null, _s(_ctx.msg), 1 /* TEXT:只有文本是动态的 */)
]))
}
浏览器拿到的就是这个 render,没有任何模板字符串,也就不需要编译器。同时能看到预编译顺便做了两件运行时做不了的事:静态节点 _hoisted_2 被提升,每次渲染都复用同一个对象;动态节点带了 PatchFlag(这里的 1),diff 时只比文本。
包体方面,Vue 2 官方给的数据是运行时版比完整版小约 30%。Vue 3 默认 import { createApp } from 'vue' 在打包工具里就解析到不带编译器的 vue.runtime.esm-bundler.js,需要运行时编译时才手动指到 vue.esm-bundler.js。
💬 面试官追问
组件只实例化一次,运行时编译模板是不是就没成本?
有成本。每个组件定义第一次渲染前都要编译一次,页面上几十个组件就是几十次
parse;还要多下载编译器那几十KB。实例少只是没那么明显。页面空白,控制台提示
runtime-only build,怎么回事?代码里有字符串形式的
template,但打包用的是不带编译器的运行时版。要么把那段改成.vue文件或render函数,要么在构建配置里把vue别名指向vue/dist/vue.esm-bundler.js(Vue 3)或vue/dist/vue.esm.js(Vue 2)。低代码平台的模板是运营发布后才有的,能预编译吗?
构建期拿不到,没法预编译。可以把固定外壳正常预编译,动态部分要么在服务端编译成
render代码下发,要么前端引完整版运行时编译,并且把编译结果按模板版本缓存起来,别每次都编。怎么确认线上产物确实是预编译过的?
搜构建产物里有没有原始
template字符串,正常应该只看到_createElementVNode(Vue 3)或_c((Vue 2)这类调用。再看包里有没有compile相关的大段代码,有的话说明引入了完整版。JSX写的Vue组件需要预编译吗?JSX本身就不是模板,Babel插件在构建期把它转成h()调用,本质已经是render函数。代价是拿不到模板那套静态分析,PatchFlag这类优化就享受不到了。
# 18 介绍一下Vue中的Diff算法
⚡ 30 秒速记
- 三个假设把
O(n³)降到O(n):只比同层、类型或key不同直接替换、同层子节点靠key认身份 - 流程:
sameVnode判断是不是同一个 → 不是就删旧建新;是就patchVnode改属性,再看子节点 - 子节点:一方有一方没有就直接增删;双方都是数组才进
updateChildren(核心diff) Vue 2双端比较:新旧头尾四个指针,头头、尾尾、旧头新尾、旧尾新头四种比法,都不中再用key查表Vue 3:先掐头去尾,中间乱序段求最长递增子序列,不在序列里的才移动,DOM移动最少;列表会重排时别用index当key
Vue 的 diff 就是拿新旧两棵 VNode 树逐层对比,找出最少的 DOM 改动。 先看两个节点是不是同一个,判断标准是 key 和标签类型都一样;不是就直接把旧的整棵删掉换新的,是的话复用真实节点,更新属性后再处理子节点。子节点两边都是列表时才进核心算法:Vue 2 用头尾双指针来回比,专门照顾头部插入、尾部追加、整体反转这些常见操作;Vue 3 先把两头相同的部分处理掉,中间乱序的那段算最长递增子序列,保证移动次数最少。跨层级的移动它不管,直接删了重建。
在新老虚拟DOM对比时
- 首先,对比节点本身,判断是否为同一节点,如果不为相同节点,则删除该节点重新创建节点进行替换
- 如果为相同节点,进行patchVnode,判断如何对该节点的子节点进行处理,先判断一方有子节点一方没有子节点的情况(如果新的children没有子节点,将旧的子节点移除)
- 比较如果都有子节点,则进行updateChildren,判断如何对这些新老节点的子节点进行操作(diff核心)。 匹配时,找到相同的子节点,递归比较子节点
在diff中,只对同层的子节点进行比较,放弃跨级的节点比较,使得时间复杂从O(n^3)降低值O(n),也就是说,只有当新旧children都为多个子节点时才需要用核心的Diff算法进行同层级比较。
💬 面试官追问
列表用
index做key,在头部插一条数据会怎样?所有项的
index都往后错一位,diff会认为每一项都还是原来那个、只是内容变了,结果每行都更新文本。更糟的是行里有输入框或子组件状态的话,状态会跟着位置走,串到别的数据上。用后端id做key就只插一个节点。把卡片从一个容器拖到另一个容器,
diff能识别成移动吗?不能,它只比同层,跨父节点就是旧位置删除、新位置新建,组件状态也会重置。真要保留状态,要么让业务层自己维护数据,要么用
Teleport一类的方式让节点不换父级。为什么
Vue 3要用最长递增子序列?中间乱序那段,相对顺序没变的节点构成递增序列,它们原地不动就行,只需要移动剩下的。求最长的那个序列,移动的节点就最少,
DOM操作也最少。更新一条记录后整行的输入状态丢了,怎么查?
基本是这一行被判成了不同节点、整个重建了。检查
key是不是每次渲染都变,比如写了:key="Math.random()"或者用了会变的拼接字段;再看外层标签是不是在v-if两个分支里换了类型。新列表为空、旧列表有 20 条,也会走
updateChildren吗?不会。
patchVnode先判断子节点形态,新的没有子节点就直接把旧的全移除,旧的没有就直接全部插入,只有两边都是数组才进入核心比较。
# 19 说说Vue2.0和Vue3.0有什么区别
⚡ 30 秒速记
- 响应式:
Object.defineProperty→Proxy,属性增删、数组下标都能拦截,嵌套对象用到才代理 - 写法:
Options API之外多了Composition API和<script setup>;mixin改用组合函数 - 性能:编译期静态提升、
PatchFlag、Block Tree、事件处理函数缓存;diff从双端比较换成最长递增子序列 - 工程:源码从
Flow换成TypeScript,API可tree-shaking;new Vue()改成createApp(),全局配置不再互相污染 - 破坏性变化:生命周期改名(
destroyed→unmounted)、filters和$on被移除、v-model默认改用modelValue;Vue 2已于2023年底停止维护
Vue 3 和 Vue 2 的差别我会分三层说:响应式底层、代码组织方式、编译和运行效率。 响应式换成 Proxy 之后,直接给对象加字段、改 arr[0] 都能触发更新,不用再写 this.$set。代码组织上多了 Composition API,同一个功能的逻辑可以写在一起,复用也不用靠 mixin。编译器会标记动态节点、缓存事件处理函数,diff 只看会变的部分。迁移时真正花时间的是那些破坏性变化,比如 $on 没了,eventBus 得换,filters 要改成方法,v-model 在组件上的 prop 和事件名也变了。
- 重构响应式系统,使用
Proxy替换Object.defineProperty,使用Proxy优势:- 可直接监听数组类型的数据变化
- 监听的目标为对象本身,不需要像
Object.defineProperty一样遍历每个属性,有一定的性能提升 - 可拦截
apply、ownKeys、has等13种方法,而Object.defineProperty不行 - 直接实现对象属性的新增/删除
- 新增
Composition API,更好的逻辑复用和代码组织 - 重构
Virtual DOM- 模板编译时的优化,将一些静态节点编译成常量
slot优化,将slot编译为lazy函数,将slot的渲染的决定权交给子组件- 模板中内联事件的提取并重用(原本每次渲染都重新生成内联函数)
- 代码结构调整,更便于Tree shaking,使得体积更小
- 使用Typescript替换Flow
💬 面试官追问
给对象动态加
discount字段,Vue 2不更新、Vue 3正常,为什么?Vue 2在初始化时用defineProperty给已有的属性一个个装getter/setter,后加的字段没装,所以感知不到,得this.$set(obj, 'discount', 0.8)。Vue 3的Proxy拦的是整个对象的set操作,新字段也能拦到。Vue 2项目迁Vue 3,哪些代码最容易漏改?$on/$off做的eventBus、filters、组件上的v-model(value+input改成了modelValue+update:modelValue)、$listeners合并进了$attrs。可以先用@vue/compat跑起来,按警告逐个改。只想用
Composition API,但项目暂时升不了Vue 3,有办法吗?升到
Vue 2.7,它内置了Composition API和<script setup>。不过Vue 2.7也已经停止维护,只能当过渡,响应式底层还是defineProperty,新增属性照样要$set。Vue 3的Proxy是一上来就把整个深层对象都代理一遍吗?不是,是懒代理。只有访问到
obj.a并且a是对象时,才给a创建代理并缓存起来。Vue 2是初始化时递归把所有层级都defineProperty一遍,大对象初始化会慢。老板问升级值不值,你会怎么说收益?
分三块讲:开发效率上
TS支持和组合函数复用明显更好;性能上编译优化让更新更快、包更小;维护上Vue 2已经不再出安全补丁,生态库新版本也基本只支持Vue 3。成本主要在破坏性变化的改造和依赖库的替换。
# 七、React
# 0 对虚拟DOM的理解
⚡ 30 秒速记
- 虚拟
DOM就是用普通JS对象描述界面:{ type, props, children, key } - 它从来不是拿来和「精准手写
DOM」比的,对照组是「状态变了整块重新渲染」 - 真正价值:让
UI = f(state)这种声明式写法可行(有了它才能低成本diff),以及把视图抽象出来,方便跨平台 - 性能定位:保下限,不保上限;手写精准操作永远省掉了比较这一步
- 代价是建对象和
diff的开销;Svelte、Solid证明了编译期细粒度更新也能做声明式
虚拟 DOM 的价值不在性能,而在于让声明式开发变得可行。 声明式的意思是你只写「状态是什么时界面长什么样」,不写「怎么改 DOM」。可状态一变总得算出要改哪里,直接拿真实 DOM 对象去比太重了,所以用轻量的 JS 对象描述一份,比起来才划算。它是局部更新链路里的一环,比的是整块重刷,不是比你手写 el.textContent = x,后者连 diff 都省了当然更快。另一个价值是抽象:同一棵 VNode 树,浏览器渲染器变成 DOM,React Native 变成原生控件,服务端变成字符串。
虚拟dom从来不是用来和直接操作dom对比的,它们俩最终殊途同归。虚拟dom只不过是局部更新的一个环节而已,整个环节的对比对象是全量更新。虚拟dom对于state=UI的意义是,虚拟dom使diff成为可能(理论上也可以直接用dom对象diff,但是太臃肿),促进了新的开发思想,又不至于性能太差。但是性能再好也不可能好过直接操作dom,人脑连diff都省了。还有一个很重要的意义是,对视图抽象,为跨平台助力
其实我最终希望你明白的事情只有一件:虚拟 DOM 的价值不在性能,而在别处。因此想要从性能角度来把握虚拟 DOM 的优势,无异于南辕北辙。偏偏在面试场景下,10 个人里面有 9 个都走这条歧路,最后9个人里面自然没有一个能自圆其说,实在让人惋惜。
💬 面试官追问
一个计数器直接改
textContent肯定更快,那虚拟DOM还有什么用?对,这种场景手写更快。但真实页面里几十个状态交叉影响几百个节点,靠手写去记每个状态改哪些节点,很快就维护不动了。虚拟
DOM用一点运行时开销,换你不用管这些。为什么不直接拿真实
DOM做diff?理论上能,但真实
DOM节点身上有几百个属性和方法,遍历、读取都慢,读某些属性还会触发布局计算。VNode只保留需要比较的几个字段,比较便宜得多。筛选只改了几个单元格,却整张表重新生成
VNode,虚拟DOM没解决什么?它解决了「最后只改那几个单元格」,但没解决「每次都生成和比较整棵树」的成本。这要靠组件拆分让更新范围变小,
Vue 3还有编译期的动态节点标记,React要靠memo或React Compiler跳过没变的子树。长列表滚动卡,团队说是
diff慢,要不要换掉虚拟DOM?先别。
Performance录一段看耗时到底在render、diff还是Layout/Paint,长列表多半是节点太多,上虚拟滚动只渲染可视区域,比换渲染模型有效得多。跨平台为什么要靠虚拟
DOM?因为它只是个描述,不绑定任何平台。框架把「怎么创建节点、插入、改属性」抽成渲染器接口,浏览器用
document.createElement,原生用对应的原生控件,SSR直接拼字符串,上层组件代码不用变。
# 1 谈谈你对React的理解
⚡ 30 秒速记
- 一句话:
React是组件化的声明式UI库,核心公式UI = f(state) - 三个设计:声明式(写结果不写步骤)、组件化(拆分复用)、通用性(靠虚拟
DOM抽象,一次学习到处写,比如React Native) - 更新机制:
setState→ 组件函数重新执行 → 新元素树 →diff(reconcile)→commit到DOM - 演进:
Stack→Fiber可中断(16)→ 自动批处理和并发特性(18)→Actions、use、Server Components稳定(19) - 短板:只管视图层,路由、数据请求、状态管理要自己拼生态;默认父更新子全跑,要靠
memo或React Compiler优化
React 说白了就是一个用组件写界面的库,你描述每种状态下界面长什么样,更新 DOM 的事它来做。 它最核心的设计是声明式和组件化:界面拆成一个个函数组件,输入 props 和 state,输出 JSX。状态一变组件重新执行,生成新的元素树,和旧的比完只提交差异。它的定位只是视图层,所以大项目要自己选路由、数据请求、状态管理,这是自由也是成本,现在很多团队直接用 Next.js 这类框架把这些定下来。版本上可以顺带说说 Fiber 让渲染可中断、React 18 的自动批处理和 useTransition、React 19 的 Server Components。
React 是一个网页 UI 框架,通过组件化的方式解决视图层开发复用的问题,本质是一个组件化框架。
- 它的核心设计思路有三点,分别是
声明式、组件化与 通用性。 - 声明式的优势在于直观与组合。
- 组件化的优势在于视图的拆分与模块复用,可以更容易做到高内聚低耦合。
- 通用性在于一次学习,随处编写。比如 React Native,React 360 等, 这里主要靠虚拟 DOM 来保证实现。
- 这使得 React 的适用范围变得足够广,无论是 Web、Native、VR,甚至 Shell 应用都可以进行开发。这也是 React 的优势。
- 但作为一个视图层的框架,React 的劣势也十分明显。它并没有提供完整的一揽子解决方 案,在开发大型前端应用时,需要向社区寻找并整合解决方案。虽然一定程度上促进了社区的繁荣,但也为开发者在技术选型和学习适用上造成了一定的成本。
- 承接在优势后,可以再谈一下自己对于 React 优化的看法、对虚拟 DOM 的看法
💬 面试官追问
营销页就几个按钮,有人说用
React写才先进,你怎么看?没必要。页面结构简单、几乎没有状态变化,原生
JS或者静态生成就够了,引入React运行时反而拖慢首屏。React的收益在状态复杂、组件要复用的场景。父组件
setState,没改子组件的props,子组件会重新执行吗?默认会,
React父组件渲染时整棵子树都跟着重新执行。想跳过要包React.memo,并且传下去的对象和函数用useMemo/useCallback保持引用稳定;用了React Compiler的话这些它会自动加。React 18前后,setTimeout里连续两次setState有什么区别?React 17及以前只有React事件处理函数里会批处理,setTimeout和Promise回调里两次setState会渲染两次。React 18用createRoot之后全部自动批处理,只渲染一次;想强制同步渲染用flushSync。React Native是不是意味着Web页面能直接搬到App上?不能。能复用的是组件写法、状态逻辑和部分业务代码,但
RN里没有div、没有CSS文件,要用View、Text和StyleSheet。「一次学习,到处编写」不是「写一次,到处运行」。Fiber到底解决了什么问题?React 15的递归渲染一旦开始就停不下来,组件树大了会长时间占着主线程,输入就卡。Fiber把渲染拆成一个个小单元,可以暂停、让出主线程、按优先级继续,这是后来并发特性的基础。
# 2 如何避免React生命周期中的坑
⚡ 30 秒速记
- 原则一句话:
render阶段要纯,副作用和清理都放提交阶段 componentWillMount/componentWillReceiveProps/componentWillUpdate从16.3起标为不安全,17起只有UNSAFE_前缀能静默用,新代码别碰- 请求、订阅放
componentDidMount;更新前读DOM用getSnapshotBeforeUpdate,结果交给componentDidUpdate componentDidUpdate里setState必须比较前后值,否则死循环componentWillUnmount对称清理定时器、监听、订阅、未完成请求;再补一层错误边界防白屏Hooks版的同类坑:useEffect漏依赖拿旧闭包、不返回清理函数就泄漏
生命周期的坑说白了就两类:在不该调的地方调了副作用,在该清理的地方忘了清理。 Fiber 之后渲染阶段可能被打断重来,StrictMode 开发环境还会故意执行两遍,所以带 Will 的那三个旧钩子里发请求、绑事件,重复执行是迟早的事。我一般这么分:请求和订阅放 componentDidMount,更新前要量旧 DOM 就用 getSnapshotBeforeUpdate,卸载时一一解绑。最后在页面级别包一个错误边界,单个组件渲染挂了也只坏一块,不至于整页白屏。
16.3版本
>=16.4版本
在线查看:https://projects.wojtekmaj.pl/react-lifecycle-methods-diagram (opens new window)
- 避免生命周期中的坑需要做好两件事:不在恰当的时候调用了不该调用的代码;在需要调用时,不要忘了调用。
- 那么主要有这么 7 种情况容易造成生命周期的坑
getDerivedStateFromProps容易编写反模式代码,使受控组件与非受控组件区分模糊componentWillMount在 React 16.3 起被标记弃用、React 19 已移除(仅存UNSAFE_componentWillMount),不要在新代码中使用,主要原因是新的异步渲染架构会导致它被多次调用。所以网络请求及事件绑定代码应移至componentDidMount中。componentWillReceiveProps同样被标记弃用、React 19 已移除,被getDerivedStateFromProps所取代,主要原因是性能问题shouldComponentUpdate通过返回true或者false来确定是否需要触发新的渲染。主要用于性能优化componentWillUpdate同样是由于新的异步渲染机制而被标记废弃、React 19 已移除,不要在新代码中使用,原先的逻辑可结合getSnapshotBeforeUpdate与componentDidUpdate改造使用。- 如果在
componentWillUnmount函数中忘记解除事件绑定,取消定时器等清理操作,容易引发 bug - 如果没有添加错误边界处理,当渲染发生异常时,用户将会看到一个无法操作的白屏,所以一定要添加
“React 的请求应该放在哪里,为什么?” 这也是经常会被追问的问题。你可以这样回答。
对于异步请求,应该放在 componentDidMount 中去操作。从时间顺序来看,除了 componentDidMount 还可以有以下选择:
- constructor:可以放,但从设计上而言不推荐。constructor 主要用于初始化 state 与函数绑定,并不承载业务逻辑。而且随着类属性的流行,constructor 已经很少使用了
- componentWillMount:已被标记废弃、React 19 已移除,在新的异步渲染架构下会触发多次渲染,容易引发 Bug,不利于未来 React 升级后的代码维护。
- 所以React 的请求放在
componentDidMount 里是最好的选择。
透过现象看本质:React 16 缘何两次求变?
Fiber 架构简析
Fiber 是 React 16 对 React 核心算法的一次重写。你只需要 get 到这一个点:
Fiber 会使原本同步的渲染过程变成异步的。
在 React 16 之前,每当我们触发一次组件的更新,React 都会构建一棵新的虚拟 DOM 树,通过与上一次的虚拟 DOM 树进行 diff,实现对 DOM 的定向更新。这个过程,是一个递归的过程。下面这张图形象地展示了这个过程的特征:
如图所示,同步渲染的递归调用栈是非常深的,只有最底层的调用返回了,整个渲染过程才会开始逐层返回。这个漫长且不可打断的更新过程,将会带来用户体验层面的巨大风险:同步渲染一旦开始,便会牢牢抓住主线程不放,直到递归彻底完成。在这个过程中,浏览器没有办法处理任何渲染之外的事情,会进入一种无法处理用户交互的状态。因此若渲染时间稍微长一点,页面就会面临卡顿甚至卡死的风险。
而 React 16 引入的 Fiber 架构,恰好能够解决掉这个风险:Fiber 会将一个大的更新任务拆解为许多个小任务。每当执行完一个小任务时,渲染线程都会把主线程交回去,看看有没有优先级更高的工作要处理,确保不会出现其他任务被“饿死”的情况,进而避免同步渲染带来的卡顿。在这个过程中,渲染线程不再“一去不回头”,而是可以被打断的,这就是所谓的“异步渲染”,它的执行过程如下图所示:
换个角度看生命周期工作流
Fiber 架构的重要特征就是可以被打断的异步渲染模式。但这个“打断”是有原则的,根据“能否被打断”这一标准,React 16 的生命周期被划分为了 render 和 commit 两个阶段,而 commit 阶段又被细分为了 pre-commit 和 commit。每个阶段所涵盖的生命周期如下图所示:
我们先来看下三个阶段各自有哪些特征
render 阶段:纯净且没有副作用,可能会被 React 暂停、终止或重新启动。pre-commit 阶段:可以读取 DOM。commit 阶段:可以使用 DOM,运行副作用,安排更新。
总的来说,render 阶段在执行过程中允许被打断,而 commit 阶段则总是同步执行的。
为什么这样设计呢?简单来说,
由于 render 阶段的操作对用户来说其实是“不可见”的,所以就算打断再重启,对用户来说也是零感知。而commit 阶段的操作则涉及真实 DOM 的渲染,所以这个过程必须用同步渲染来求稳。
为什么 React 16 要更改组件的生命周期详解
💬 面试官追问
componentWillMount里发的请求,开发环境偶尔发两次,加个去重标志行不行?治标。旧钩子在可中断渲染和
StrictMode下本来就可能执行多次,去重只是压住了现象。把请求挪到componentDidMount,它每次挂载只执行一次;真担心重复提交,接口层做幂等。用
getDerivedStateFromProps同步表单,用户刚输入的内容老被冲掉,为什么?它在每次渲染前都会执行,父组件任何一次重渲染都会把
props覆盖回state。要么做成完全受控,要么只在userId变了才重置,最省事是给表单加key={userId},换人直接重新挂载。聊天页离开后还在弹新消息提示,内存一路涨,先看哪?
先看
componentWillUnmount有没有解绑,再看解绑用的是不是同一个函数引用。addEventListener时传箭头函数、解绑时又写一个新箭头函数,等于没解,组件反复进出监听器就越攒越多。列表追加数据后想保持滚动位置,读高度和写
scrollTop都放componentDidUpdate可以吗?不行,到
componentDidUpdate时DOM已经是新的了,旧高度拿不到。在getSnapshotBeforeUpdate里返回scrollHeight - scrollTop,componentDidUpdate第三个参数拿到它,再算回新的scrollTop。加了错误边界,为什么接口报错和点击回调里的异常还是没被接住?
错误边界只管渲染、生命周期和构造函数里抛的错。事件回调、
setTimeout、Promise里的异常它看不到,要自己try/catch或者在请求层统一处理。
# 3 React Fiber架构
⚡ 30 秒速记
- 要解决的问题:
React 15的Stack Reconciler递归不能停,大树一更新就占满主线程掉帧 Fiber把递归改成链表 + 循环,每个节点是一个工作单元,靠child/sibling/return遍历render阶段可中断(构建workInProgress、打标记),commit阶段同步一口气提交- 双缓存:
current和workInProgress两棵树,提交时切换根指针 - 调度靠
React自己的Scheduler(MessageChannel,约5ms一片),不是requestIdleCallback - 能不能被打断看优先级:
React 18里只有startTransition这类并发更新才会切片,普通点击更新照样同步跑完
Fiber 把原来一口气递归到底的协调过程,拆成一个个可以暂停、恢复、丢弃的小任务。 打个比方,以前是一次性把一千道题做完才抬头,现在每做几道就看看有没有更急的事。每个 Fiber 节点用 child、sibling、return 串起来,所以不用靠调用栈也能遍历,停下来再接着走。它不会让总计算量变少,价值是让输入、动画这类高优先级任务能插队。要注意 commit 阶段还是同步的,而且 React 18 里也只有并发更新才真的会切片。
最主要的思想就是将任务拆分。
- DOM需要渲染时暂停,空闲时恢复。
window.requestIdleCallback- React内部实现的机制
React 追求的是 “快速响应”,那么,“快速响应“的制约因素都有什么呢
CPU的瓶颈:当项目变得庞大、组件数量繁多、遇到大计算量的操作或者设备性能不足使得页面掉帧,导致卡顿。IO的瓶颈:发送网络请求后,由于需要等待数据返回才能进一步操作导致不能快速响应。
fiber架构主要就是用来解决CPU和网络的问题,这两个问题一直也是最影响前端开发体验的地方,一个会造成卡顿,一个会造成白屏。为此 react 为前端引入了两个新概念:Time Slicing时间分片和Suspense。
1. React 都做过哪些优化
- React渲染页面的两个阶段
- 调度阶段(reconciliation):在这个阶段 React 会更新数据生成新的
Virtual DOM,然后通过Diff算法,快速找出需要更新的元素,放到更新队列中去,得到新的更新队列。 - 渲染阶段(commit):这个阶段 React 会遍历更新队列,将其所有的变更一次性更新到DOM上
- 调度阶段(reconciliation):在这个阶段 React 会更新数据生成新的
- React 15 架构
- React15架构可以分为两层
- Reconciler(协调器)—— 负责找出变化的组件;
- Renderer(渲染器)—— 负责将变化的组件渲染到页面上;
- React15架构可以分为两层
- 在React15及以前,Reconciler采用递归的方式创建虚拟DOM,递归过程是不能中断的。如果组件树的层级很深,递归会占用线程很多时间,递归更新时间超过了16ms,用户交互就会卡顿。
- 为了解决这个问题,React16将递归的无法中断的更新重构为异步的可中断更新,由于曾经用于递归的虚拟DOM数据结构已经无法满足需要。于是,全新的Fiber架构应运而生。
React 16 架构
- 为了解决同步更新长时间占用线程导致页面卡顿的问题,也为了探索运行时优化的更多可能,React开始重构并一直持续至今。重构的目标是实现Concurrent Mode(并发模式)。
- 从v15到v16,React团队花了两年时间将源码架构中的Stack Reconciler重构为Fiber Reconciler
React16架构可以分为三层:- Scheduler(调度器)—— 调度任务的优先级,高优任务优先进入Reconciler;
- Reconciler(协调器)—— 负责找出变化的组件:更新工作从递归变成了可以中断的循环过程。Reconciler内部采用了Fiber的架构;
- Renderer(渲染器)—— 负责将变化的组件渲染到页面上。
React 17 优化
- 使用Lane来管理任务的优先级。Lane用二进制位表示任务的优先级,方便优先级的计算(位运算),不同优先级占用不同位置的“赛道”,而且存在批的概念,优先级越低,“赛道”越多。高优先级打断低优先级,新建的任务需要赋予什么优先级等问题都是Lane所要解决的问题。
- Concurrent Mode的目的是实现一套可中断/恢复的更新机制。其由两部分组成:
- 一套协程架构:Fiber Reconciler
- 基于协程架构的启发式更新算法:控制协程架构工作方式的算法
2. 浏览器一帧都会干些什么以及requestIdleCallback的启示
我们都知道,页面的内容都是一帧一帧绘制出来的,浏览器刷新率代表浏览器一秒绘制多少帧。原则上说 1s 内绘制的帧数也多,画面表现就也细腻。目前浏览器大多是 60Hz(60帧/s),每一帧耗时也就是在 16.6ms 左右。那么在这一帧的(16.6ms) 过程中浏览器又干了些什么呢
通过上面这张图可以清楚的知道,浏览器一帧会经过下面这几个过程:
- 接受输入事件
- 执行事件回调
- 开始一帧
- 执行 RAF (RequestAnimationFrame)
- 页面布局,样式计算
- 绘制渲染
- 执行 RIC (RequestIdelCallback)
第七步的 RIC 事件不是每一帧结束都会执行,只有在一帧的 16.6ms 中做完了前面 6 件事儿且还有剩余时间,才会执行。如果一帧执行结束后还有时间执行 RIC 事件,那么下一帧需要在事件执行结束才能继续渲染,所以 RIC 执行不要超过 30ms,如果长时间不将控制权交还给浏览器,会影响下一帧的渲染,导致页面出现卡顿和事件响应不及时。
requestIdleCallback 的启示:我们以浏览器是否有剩余时间作微任务中断的标准,那么我们需要一种机制,当浏览器有剩余时间时通知我们。
requestIdleCallback((deadline) => {
// deadline 有两个参数
// timeRemaining(): 当前帧还剩下多少时间
// didTimeout: 是否超时
// 另外 requestIdleCallback 后如果跟上第二个参数 {timeout: ...} 则会强制浏览器在当前帧执行完后执行。
if (deadline.timeRemaining() > 0) {
// TODO
} else {
requestIdleCallback(otherTasks);
}
});
// 用法示例
var tasksNum = 10000
requestIdleCallback(unImportWork)
function unImportWork(deadline) {
while (deadline.timeRemaining() && tasksNum > 0) {
console.log(`执行了${10000 - tasksNum + 1}个任务`)
tasksNum--
}
if (tasksNum > 0) { // 在未来的帧中继续执行
requestIdleCallback(unImportWork)
}
}
其实部分浏览器已经实现了这个API,这就是requestIdleCallback。但是由于以下因素,Facebook 抛弃了
requestIdleCallback的原生 API:
- 浏览器兼容性;
- 触发频率不稳定,受很多因素影响。比如当我们的浏览器切换tab后,之前tab注册的
requestIdleCallback触发的频率会变得很低。
基于以上原因,在React中实现了功能更完备的
requestIdleCallbackpolyfill,这就是Scheduler。除了在空闲时触发回调的功能外,Scheduler还提供了多种调度优先级供任务设置
3. React Fiber是什么
React Fiber是对核心算法的一次重新实现。React Fiber把更新过程碎片化,把一个耗时长的任务分成很多小片,每一个小片的运行时间很短,虽然总时间依然很长,但是在每个小片执行完之后,都给其他任务一个执行的机会,这样唯一的线程就不会被独占,其他任务依然有运行的机会
- 在
React Fiber中,一次更新过程会分成多个分片完成,所以完全有可能一个更新任务还没有完成,就被另一个更高优先级的更新过程打断,这时候,优先级高的更新任务会优先处理完,而低优先级更新任务所做的工作则会完全作废,然后等待机会重头再来 - 因为一个更新过程可能被打断,所以
React Fiber一个更新过程被分为两个阶段(Phase):第一个阶段Reconciliation Phase和第二阶段Commit Phase - 在第一阶段
Reconciliation Phase,React Fiber会找出需要更新哪些DOM,这个阶段是可以被打断的;但是到了第二阶段Commit Phase,那就一鼓作气把DOM更新完,绝不会被打断 - 这两个阶段大部分工作都是
React Fiber做,和我们相关的也就是生命周期函数
React Fiber改变了之前react的组件渲染机制,新的架构使原来同步渲染的组件现在可以异步化,可中途中断渲染,执行更高优先级的任务。释放浏览器主线程
关键特性
- 增量渲染(把渲染任务拆分成块,匀到多帧)
- 更新时能够暂停,终止,复用渲染任务
- 给不同类型的更新赋予优先级
- 并发方面新的基础能力
增量渲染用来解决掉帧的问题,渲染任务拆分之后,每次只做一小段,做完一段就把时间控制权交还给主线程,而不像之前长时间占用
4. 组件的渲染顺序
假如有A,B,C,D组件,层级结构为:
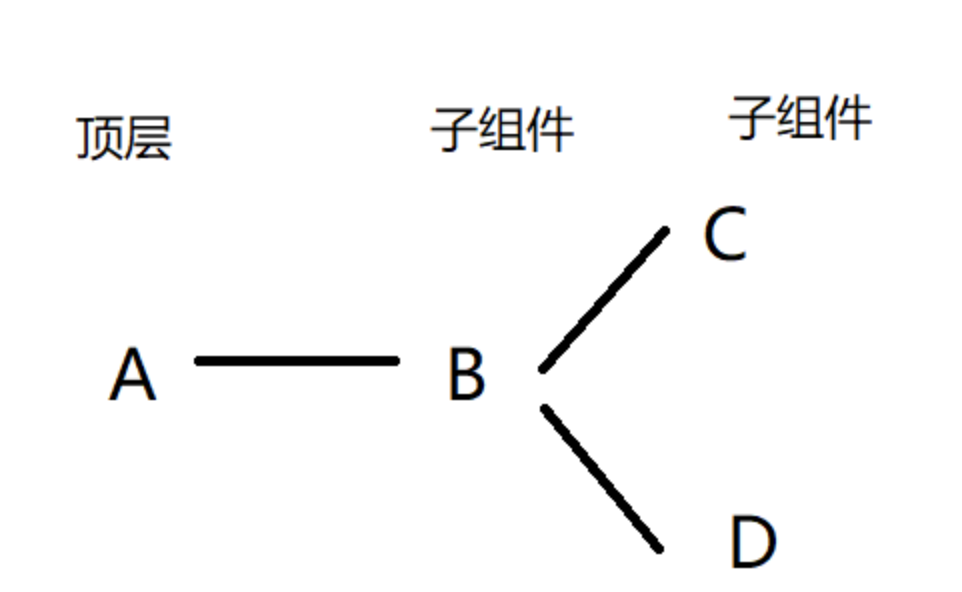
我们知道组件的生命周期为:
下面列的是 React 16 之前的生命周期(历史对照)。
componentWillMount、componentWillReceiveProps、componentWillUpdate在 React 16.3 起被标记废弃,React 19 已移除,仅保留UNSAFE_前缀版本供存量迁移;对应替代分别是constructor/componentDidMount、getDerivedStateFromProps、getSnapshotBeforeUpdate。
挂载阶段:
constructor()componentWillMount()(React 19 已移除)render()componentDidMount()
更新阶段为:
componentWillReceiveProps()(React 19 已移除)shouldComponentUpdate()componentWillUpdate()(React 19 已移除)render()componentDidUpdate
那么在挂载阶段,
A,B,C,D的生命周期渲染顺序是如何的呢?
那么在挂载阶段,A,B,C,D的生命周期渲染顺序是如何的呢?
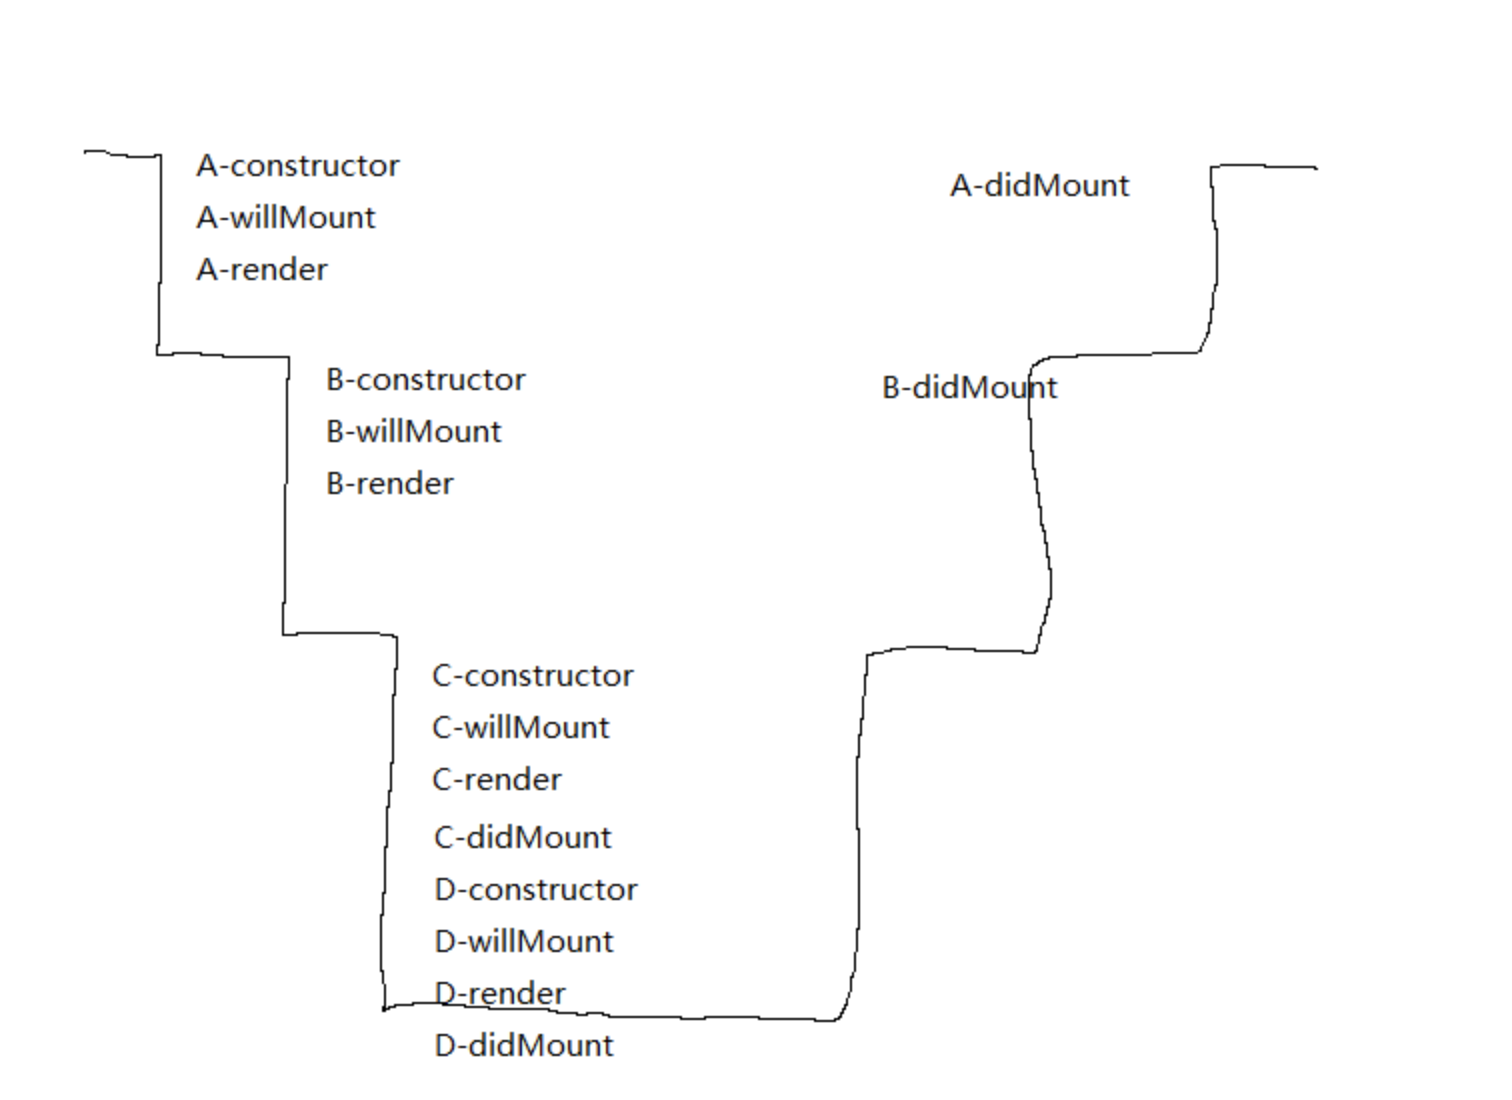
以
render()函数为分界线。从顶层组件开始,一直往下,直至最底层子组件。然后再往上
组件update阶段同理
前面是react16以前的组建渲染方式。这就存在一个问题
如果这是一个很大,层级很深的组件,
react渲染它需要几十甚至几百毫秒,在这期间,react会一直占用浏览器主线程,任何其他的操作(包括用户的点击,鼠标移动等操作)都无法执行
Fiber架构就是为了解决这个问题
看一下fiber架构 组建的渲染顺序
加入
fiber的react将组件更新分为两个时期
这两个时期以render为分界
render前的生命周期为phase1,render后的生命周期为phase2
phase1的生命周期是可以被打断的,每隔一段时间它会跳出当前渲染进程,去确定是否有其他更重要的任务。此过程,React在workingProgressTree(并不是真实的virtualDomTree)上复用current上的Fiber数据结构来一步地(通过requestIdleCallback)来构建新的 tree,标记处需要更新的节点,放入队列中phase2的生命周期是不可被打断的,React将其所有的变更一次性更新到DOM上
这里最重要的是phase1这是时期所做的事。因此我们需要具体了解phase1的机制
- 如果不被打断,那么
phase1执行完会直接进入render函数,构建真实的virtualDomTree - 如果组件再
phase1过程中被打断,即当前组件只渲染到一半(也许是在willMount,也许是willUpdate~反正是在render之前的生命周期),那么react会怎么干呢?react会放弃当前组件所有干到一半的事情,去做更高优先级更重要的任务(当然,也可能是用户鼠标移动,或者其他react监听之外的任务),当所有高优先级任务执行完之后,react通过callback回到之前渲染到一半的组件,从头开始渲染。(看起来放弃已经渲染完的生命周期,会有点不合理,反而会增加渲染时长,但是react确实是这么干的)
所有phase1的生命周期函数都可能被执行多次,因为可能会被打断重来
这样的话,就和
react16版本之前有很大区别了,因为可能会被执行多次,那么我们最好就得保证phase1的生命周期每一次执行的结果都是一样的,否则就会有问题,因此,最好都是纯函数
- 如果高优先级的任务一直存在,那么低优先级的任务则永远无法进行,组件永远无法继续渲染。这个问题facebook目前好像还没解决
- 所以,facebook在
react16增加fiber结构,其实并不是为了减少组件的渲染时间,事实上也并不会减少,最重要的是现在可以使得一些更高优先级的任务,如用户的操作能够优先执行,提高用户的体验,至少用户不会感觉到卡顿
5 React Fiber架构总结
React Fiber如何性能优化
- 更新的两个阶段
- 调度算法阶段-执行diff算法,纯js计算
- Commit阶段-将diff结果渲染dom
- 可能会有性能问题
- JS是单线程的,且和DOM渲染公用一个线程
- 当组件足够复杂,组件更新时计算和渲染压力都大
- 同时再有DOM操作需求(动画、鼠标拖拽等),将卡顿
- 解决方案fiber
- 将调度算法阶段阶段任务拆分(Commit无法拆分)
- DOM需要渲染时暂停,空闲时恢复
- 分散执行: 任务分割后,就可以把小任务单元分散到浏览器的空闲期间去排队执行,而实现的关键是两个新API:
requestIdleCallback与requestAnimationFrame- 低优先级的任务交给
requestIdleCallback处理,这是个浏览器提供的事件循环空闲期的回调函数,需要pollyfill,而且拥有deadline参数,限制执行事件,以继续切分任务; - 高优先级的任务交给
requestAnimationFrame处理;
- 低优先级的任务交给
React 的核心流程可以分为两个部分:
reconciliation(调度算法,也可称为render)- 更新
state与props; - 调用生命周期钩子;
- 生成
virtual dom- 这里应该称为
Fiber Tree更为符合;
- 这里应该称为
- 通过新旧 vdom 进行 diff 算法,获取 vdom change
- 确定是否需要重新渲染
- 更新
commit- 如需要,则操作
dom节点更新
- 如需要,则操作
要了解 Fiber,我们首先来看为什么需要它
- 问题: 随着应用变得越来越庞大,整个更新渲染的过程开始变得吃力,大量的组件渲染会导致主进程长时间被占用,导致一些动画或高频操作出现卡顿和掉帧的情况。而关键点,便是 同步阻塞。在之前的调度算法中,React 需要实例化每个类组件,生成一颗组件树,使用 同步递归 的方式进行遍历渲染,而这个过程最大的问题就是无法 暂停和恢复。
- 解决方案: 解决同步阻塞的方法,通常有两种: 异步 与 任务分割。而 React Fiber 便是为了实现任务分割而诞生的
- 简述
- 在
React V16将调度算法进行了重构, 将之前的stack reconciler重构成新版的 fiberreconciler,变成了具有链表和指针的 单链表树遍历算法。通过指针映射,每个单元都记录着遍历当下的上一步与下一步,从而使遍历变得可以被暂停和重启 - 这里我理解为是一种 任务分割调度算法,主要是 将原先同步更新渲染的任务分割成一个个独立的 小任务单位,根据不同的优先级,将小任务分散到浏览器的空闲时间执行,充分利用主进程的事件循环机制
- 在
- 核心
Fiber这里可以具象为一个 数据结构
class Fiber {
constructor(instance) {
this.instance = instance
// 指向第一个 child 节点
this.child = child
// 指向父节点
this.return = parent
// 指向第一个兄弟节点
this.sibling = previous
}
}
- 链表树遍历算法: 通过 节点保存与映射,便能够随时地进行 停止和重启,这样便能达到实现任务分割的基本前提
- 首先通过不断遍历子节点,到树末尾;
- 开始通过
sibling遍历兄弟节点; - return 返回父节点,继续执行2;
- 直到 root 节点后,跳出遍历;
- 任务分割,React 中的渲染更新可以分成两个阶段
- reconciliation 阶段: vdom 的数据对比,是个适合拆分的阶段,比如对比一部分树后,先暂停执行个动画调用,待完成后再回来继续比对
- Commit 阶段: 将 change list 更新到 dom 上,并不适合拆分,才能保持数据与 UI 的同步。否则可能由于阻塞 UI 更新,而导致数据更新和 UI 不一致的情况
- 分散执行: 任务分割后,就可以把小任务单元分散到浏览器的空闲期间去排队执行,而实现的关键是两个新API:
requestIdleCallback与requestAnimationFrame- 低优先级的任务交给
requestIdleCallback处理,这是个浏览器提供的事件循环空闲期的回调函数,需要pollyfill,而且拥有deadline参数,限制执行事件,以继续切分任务; - 高优先级的任务交给
requestAnimationFrame处理;
- 低优先级的任务交给
// 类似于这样的方式
requestIdleCallback((deadline) => {
// 当有空闲时间时,我们执行一个组件渲染;
// 把任务塞到一个个碎片时间中去;
while ((deadline.timeRemaining() > 0 || deadline.didTimeout) && nextComponent) {
nextComponent = performWork(nextComponent);
}
});
- 优先级策略: 文本框输入 > 本次调度结束需完成的任务 > 动画过渡 > 交互反馈 > 数据更新 > 不会显示但以防将来会显示的任务
- Fiber 其实可以算是一种编程思想,在其它语言中也有许多应用(Ruby Fiber)。
- 核心思想是 任务拆分和协同,主动把执行权交给主线程,使主线程有时间空挡处理其他高优先级任务。
- 当遇到进程阻塞的问题时,任务分割、异步调用 和 缓存策略 是三个显著的解决思路。
💬 面试官追问
接入
Fiber之后总渲染耗时没降,是不是白改了?没白改,
Fiber本来就不是为了减少总工作量,而是把长任务切碎,让输入能在中间插进来。看的指标应该是交互延迟,不是总耗时。升到
React 18了,输入框联动大列表还是卡,Fiber怎么没切片?默认的点击、输入更新走同步优先级,不会被打断。要把列表更新包进
startTransition,或者用useDeferredValue拿一个延后的值,这部分才会按时间片跑、被输入打断。低优先级渲染被打断后,前面算了一半的结果去哪了?
直接丢掉,之后从头重算。用户从没看到过这半棵树,所以不会出现界面撕裂,但这也是
render阶段必须纯的原因:里面的副作用可能执行好几次。拖拽时
Performance里一个commit就40ms,Fiber为什么不把它拆开?commit要保证DOM一次性变到位,拆开就会让用户看到改了一半的界面,所以设计上就是同步的。只能减少这次提交的节点数,比如虚拟列表、拆分组件、把不急的部分延后。React为什么不直接用requestIdleCallback做调度?兼容性差,
Safari长期不支持,触发频率也不稳定,后台标签页里可能很久才回调一次。React自己用MessageChannel实现了Scheduler,按5ms左右切片,还能表达多级优先级。
# 4 createElement过程
⚡ 30 秒速记
JSX编译成React.createElement(type, config, ...children);React 17新转换改成jsx(),不用手动import React- 内部三件事:抽出
key/ref、剩下的属性合成props(类组件补defaultProps)、把children放进props.children - 返回普通对象:
{ $$typeof, type, key, ref, props },只是描述,不是DOM也不是实例 type是字符串走原生标签,是函数 / 类走组件- 版本差异:
React 19里ref变成普通prop,函数组件的defaultProps被移除
createElement 做的事很朴素:把类型、属性、子节点整理成一个普通对象,告诉 React「这里要画个什么」。 它不碰 DOM,你在控制台打印 <div /> 只能看到一个带 type、props 的对象。真正挂到页面要交给根节点,React 18 起是 createRoot(container).render(element)。面试时我会顺手补一句:key 和 ref 不会出现在组件拿到的 props 里,所以子组件里读 props.key 永远是 undefined。
React.createElement(): 根据指定的第一个参数创建一个React元素
React.createElement(
type,
[props],
[...children]
)
- 第一个参数是必填,传入的是似HTML标签名称,eg: ul, li
- 第二个参数是选填,表示的是属性,eg: className
- 第三个参数是选填, 子节点,eg: 要显示的文本内容
下面示例里的
ReactDOM.render是历史写法:React 18 起改用ReactDOM.createRoot(container).render(element),React 19 已移除ReactDOM.render。示例本身讲的是createElement的参数形式,挂载 API 换成createRoot后结论不变。
//写法一:
var child1 = React.createElement('li', null, 'one');
var child2 = React.createElement('li', null, 'two');
var content = React.createElement('ul', { className: 'teststyle' }, child1, child2); // 第三个参数可以分开也可以写成一个数组
ReactDOM.render(
content,
document.getElementById('example')
);
//写法二:
var child1 = React.createElement('li', null, 'one');
var child2 = React.createElement('li', null, 'two');
var content = React.createElement('ul', { className: 'teststyle' }, [child1, child2]);
ReactDOM.render(
content,
document.getElementById('example')
);
💬 面试官追问
调用完
createElement('li', { className: 'item' })马上querySelector('.item'),为什么找不到?它只返回一个描述对象,根本没挂到页面上。要经过
root.render(element),等React走完协调和提交,节点才会出现在DOM里。子节点传数组和展开成多个参数,有什么区别?
渲染结果一样,但传数组时
React会把它当列表,要求每项有key,否则开发环境报警告;逐个参数传就是静态子节点,不需要key。JSX里{list.map(...)}对应的就是数组那种。写了
createElement('ul', { classname: 'list' }),结构正常就是没样式?拼写问题,
React认的是className。小写的classname会被当成未知属性原样输出到DOM,CSS的类选择器当然匹配不上,开发环境控制台会有警告。子组件里打印
props.key,为什么是undefined?createElement会把key和(19之前的)ref从配置里拿出来单独放,不进props。子组件真需要这个id就另外传一个id={item.id}。低代码平台把
{ tag: 'li', text: 'one' }这样的配置直接当子节点传进去,行不行?不行,普通对象不是合法的
React子节点,会直接报Objects are not valid as a React child。要先写一层映射,把配置转成createElement(cfg.tag, null, cfg.text)再传。
# 5 调和阶段 setState内部干了什么
⚡ 30 秒速记
setState不直接改state:创建一个update对象,挂到组件Fiber的updateQueue上- 从这个
Fiber往上标记到根(记lane),然后ensureRootIsScheduled交给调度器排队 render阶段从根往下走,到这个组件时按顺序处理updateQueue算出新state,再执行render和子节点diffcommit阶段把变更写进DOM,再调componentDidUpdate和setState的回调- 类组件
setState默认一定重渲染,想跳过靠shouldComponentUpdate/PureComponent
调用 setState 只是往队列里塞了一张「待办」,真正算新状态、比对、改 DOM 都在后面。 具体是:先生成一个 update 挂到组件的 Fiber 上,然后从这个节点一路标记到根,告诉调度器「这棵树有活」。轮到它时进入 render 阶段,处理队列算出新 state,重新 render 拿到新的子元素,跟旧的比出差异;最后在 commit 阶段一次性改 DOM,跑 componentDidUpdate 和回调。所以 setState 下一行读 this.state,大多数时候还是旧值。
- 当调用 setState 时,React会做的第一件事情是将传递给 setState 的对象合并到组件的当前状态
- 这将启动一个称为和解(
reconciliation)的过程。和解(reconciliation)的最终目标是以最有效的方式,根据这个新的状态来更新UI。 为此,React将构建一个新的React元素树(您可以将其视为UI的对象表示) - 一旦有了这个树,为了弄清 UI 如何响应新的状态而改变,React 会将这个新树与上一个元素树相比较( diff )
通过这样做, React 将会知道发生的确切变化,并且通过了解发生什么变化,只需在绝对必要的情况下进行更新即可最小化 UI 的占用空间
💬 面试官追问
setState({ status: 'paid' })之后,React是直接去改按钮文字吗?不是。它只是登记一次更新,之后重新执行
render生成新的元素树,跟旧树比出「这个文本节点变了」,最后才改那一个文本节点。中间任何一步都没有你手写的那种DOM操作。类组件
setState传一个和原来一样的值,会重渲染吗?会。类组件的
setState不比较新旧值,默认就重新render,想跳过得写shouldComponentUpdate或继承PureComponent。函数组件的useState不一样,Object.is相等时会尽量跳过。库存已经变成
0了,页面还显示「有货」,怎么一层层查?先在
render里打印确认新state进来了;进来了就看展示分支的判断条件,比如if (stock)碰上字符串'0'就是真值。state没进来再往上查是不是被别的setState覆盖了。为什么
setState要先从组件一路标记到根节点?因为调度和
render都是从根开始往下走的,React需要知道这条路径上有活,路过的父节点没变化可以直接复用跳过。标记到根之后,根节点再根据lane决定什么时候开工。仪表盘更新太频繁,想绕过
setState直接改DOM,可以吗?只有这块
DOM完全不归React管时可以,比如用ref拿到一个canvas自己画。否则下次重渲染会把你手改的结果覆盖掉,状态和页面就对不上了。
# 6 setState
⚡ 30 秒速记
setState不是「异步函数」,是排队 + 批量合并,所以下一行读到的还是旧值- 依赖旧值就用函数式:
setState(prev => ({ count: prev.count + 1 })),对象写法同字段会互相覆盖 - 要在更新完成后读:第二个参数回调或
componentDidUpdate React 17及以前 /18的ReactDOM.render:只有React事件和生命周期里批处理,setTimeout、原生事件里同步刷新React 18的createRoot和React 19:所有场景自动批处理,真要同步用flushSync
setState 的本质是排队和批量合并,「异步」只是看起来像。 一次点击里调三次 setState({ count: this.state.count + 1 }),三次读的都是同一个旧值,合并后只加了 1;改成函数式写法才会一个接一个算。版本差异一定要说清:React 17 以前在 setTimeout 里 setState 会立刻同步刷新,React 18 换成 createRoot 之后也一样批处理了。真有「改完马上量 DOM」的需求,就用 flushSync 包住那一次更新。
先看版本结论(React 17 / 18 / 19 三档)
版本与根节点 React 事件 / 生命周期内 setTimeout/ 原生事件 /Promise.then内强制同步的出口 React 17 及以前( ReactDOM.render)批量合并 逐次同步刷新,能立刻读到新值 本来就是同步的 React 18( ReactDOM.render兼容模式)批量合并 逐次同步刷新(与 17 一致) 本来就是同步的 React 18( createRoot)批量合并 同样批量合并(automatic batching) flushSyncReact 19 批量合并 批量合并( ReactDOM.render已移除,无法退回旧行为)flushSync本节余下的
Transaction(事务)与isBatchingUpdates分析描述的是 React 16 / 17 的内部实现,属于历史对照:现在 Fiber 走的是 lane 优先级调度,不再依赖单个全局布尔标志。这些内容仍然值得读——它解释了「为什么当年定时器里会变成同步」——但不要当作 React 18 及以后的现状。下面凡是出现「在原生事件和 setTimeout 中 setState 是同步的」这类表述,都请补上前提:React 17 及以前,或 React 18 的
ReactDOM.render兼容模式。
在了解setState之前,我们先来简单了解下 React 一个包装结构: Transaction:
事务 (Transaction)
是 React 中的一个调用结构,用于包装一个方法,结构为: initialize - perform(method) - close。通过事务,可以统一管理一个方法的开始与结束;处于事务流中,表示进程正在执行一些操作
- setState: React 中用于修改状态,更新视图。它具有以下特点:
异步与同步: setState并不是单纯的异步或同步,这其实与调用时的环境相关:
- 在合成事件 和 生命周期钩子(除 componentDidUpdate) 中,setState是"异步"的;
- 原因: 因为在setState的实现中,有一个判断: 当更新策略正在事务流的执行中时,该组件更新会被推入dirtyComponents队列中等待执行;否则,开始执行batchedUpdates队列更新;
- 在生命周期钩子调用中,更新策略都处于更新之前,组件仍处于事务流中,而componentDidUpdate是在更新之后,此时组件已经不在事务流中了,因此则会同步执行;
- 在合成事件中,React 是基于 事务流完成的事件委托机制 实现,也是处于事务流中;
- 问题: 无法在setState后马上从this.state上获取更新后的值。
- 解决: 如果需要马上同步去获取新值,setState其实是可以传入第二个参数的。setState(updater, callback),在回调中即可获取最新值;
- 原因: 因为在setState的实现中,有一个判断: 当更新策略正在事务流的执行中时,该组件更新会被推入dirtyComponents队列中等待执行;否则,开始执行batchedUpdates队列更新;
- 在 原生事件 和 setTimeout 中,setState是同步的,可以马上获取更新后的值(仅限 React 17 及以前 / React 18 兼容模式;React 18
createRoot起这些场景同样批量合并);- 原因: 原生事件是浏览器本身的实现,与事务流无关,自然是同步;而setTimeout是放置于定时器线程中延后执行,此时事务流已结束,因此也是同步;
- 批量更新: 在 合成事件 和 生命周期钩子 中,setState更新队列时,存储的是 合并状态(Object.assign)。因此前面设置的 key 值会被后面所覆盖,最终只会执行一次更新;
- 函数式: 由于 Fiber 及 合并 的问题,官方推荐可以传入 函数 的形式。setState(fn),在fn中返回新的state对象即可,例如this.setState((state, props) => newState);
- 使用函数式,可以用于避免setState的批量更新的逻辑,传入的函数将会被 顺序调用;
注意事项:
- setState 合并,在 合成事件 和 生命周期钩子 中多次连续调用会被优化为一次;
- 当组件已被销毁,如果再次调用setState,React 会报错警告,通常有两种解决办法
- 将数据挂载到外部,通过 props 传入,如放到 Redux 或 父级中;
- 在组件内部维护一个状态量 (isUnmounted),componentWillUnmount中标记为 true,在setState前进行判断;
总结
setState 并非真异步,只是看上去像异步。在源码中,通过
isBatchingUpdates来判断
setState是先存进state队列还是直接更新,如果值为 true 则执行异步操作,为 false 则直接更新。- 那么什么情况下
isBatchingUpdates会为true呢?在 React 可以控制的地方,就为 true,比如在 React 生命周期事件和合成事件中,都会走合并操作,延迟更新的策略。 - 但在 React 无法控制的地方,比如原生事件,具体就是在
addEventListener、setTimeout、setInterval等事件中,就只能同步更新。这一条到 React 18createRoot为止:automatic batching 之后 React 不再依赖「是否在自己的调用栈里」来决定批处理,上述场景也会合并。
一般认为,
做异步设计是为了性能优化、减少渲染次数,React 团队还补充了两点。
- 保持内部一致性。如果将 state 改为同步更新,那尽管 state 的更新是同步的,但是 props不是。
- 启用并发更新,完成异步渲染。
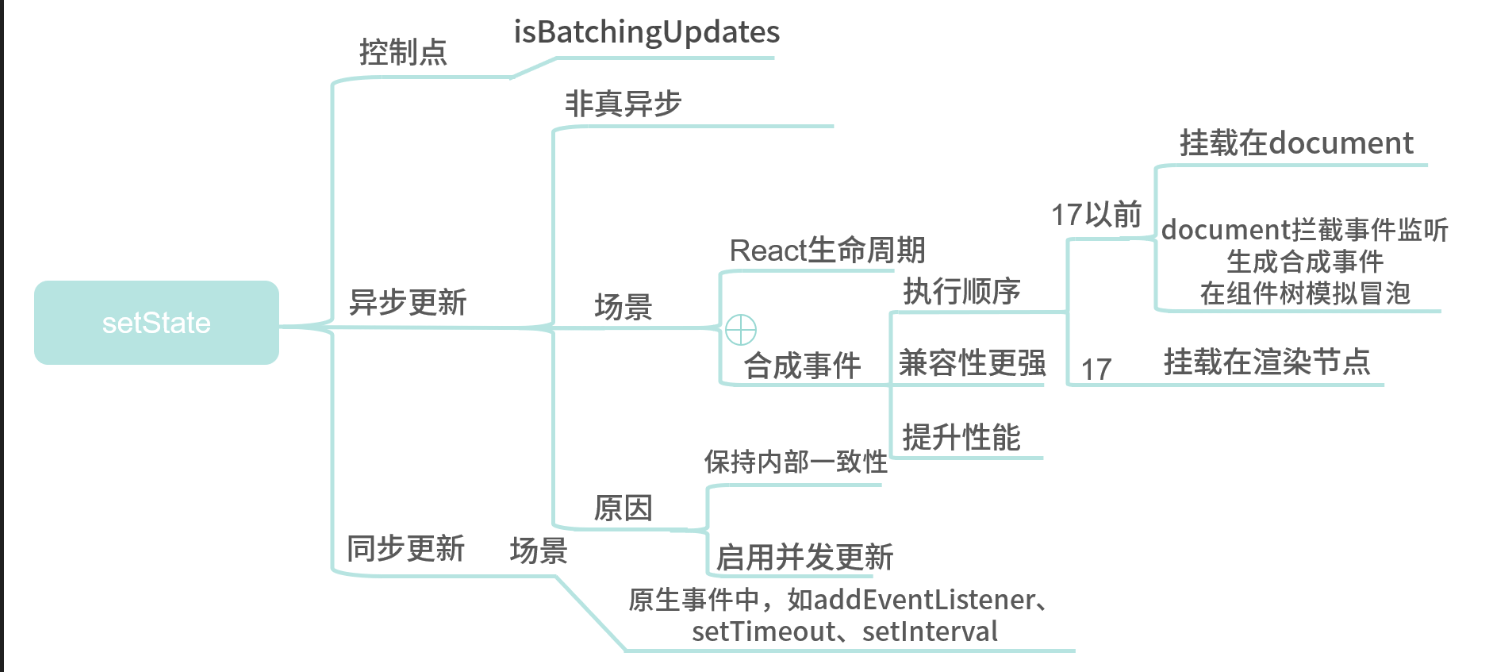
setState只有在 React 自身的合成事件和钩子函数中是异步的,在原生事件和 setTimeout 中都是同步的——这是 React 17 及以前的结论;React 18createRoot与 React 19 里全部场景都是批处理的异步更新setState的异步并不是说内部由异步代码实现,其实本身执行的过程和代码都是同步的,只是合成事件和钩子函数中没法立马拿到更新后的值,形成了所谓的异步。当然可以通过 setState 的第二个参数中的 callback 拿到更新后的结果setState的批量更新优化也是建立在异步(合成事件、钩子函数)之上的,在原生事件和 setTimeout 中不会批量更新,在异步中如果对同一个值进行多次 setState,setState 的批量更新策略会对其进行覆盖,去最后一次的执行,如果是同时 setState 多个不同的值,在更新时会对其进行合并批量更新
React 17 及以前:
- 合成事件中是异步
- 钩子函数中的是异步
- 原生事件中是同步
- setTimeout中是同步
React 18 createRoot 与 React 19:上面四条统一为「都是批处理的异步更新」,只有 flushSync 能强制同步。
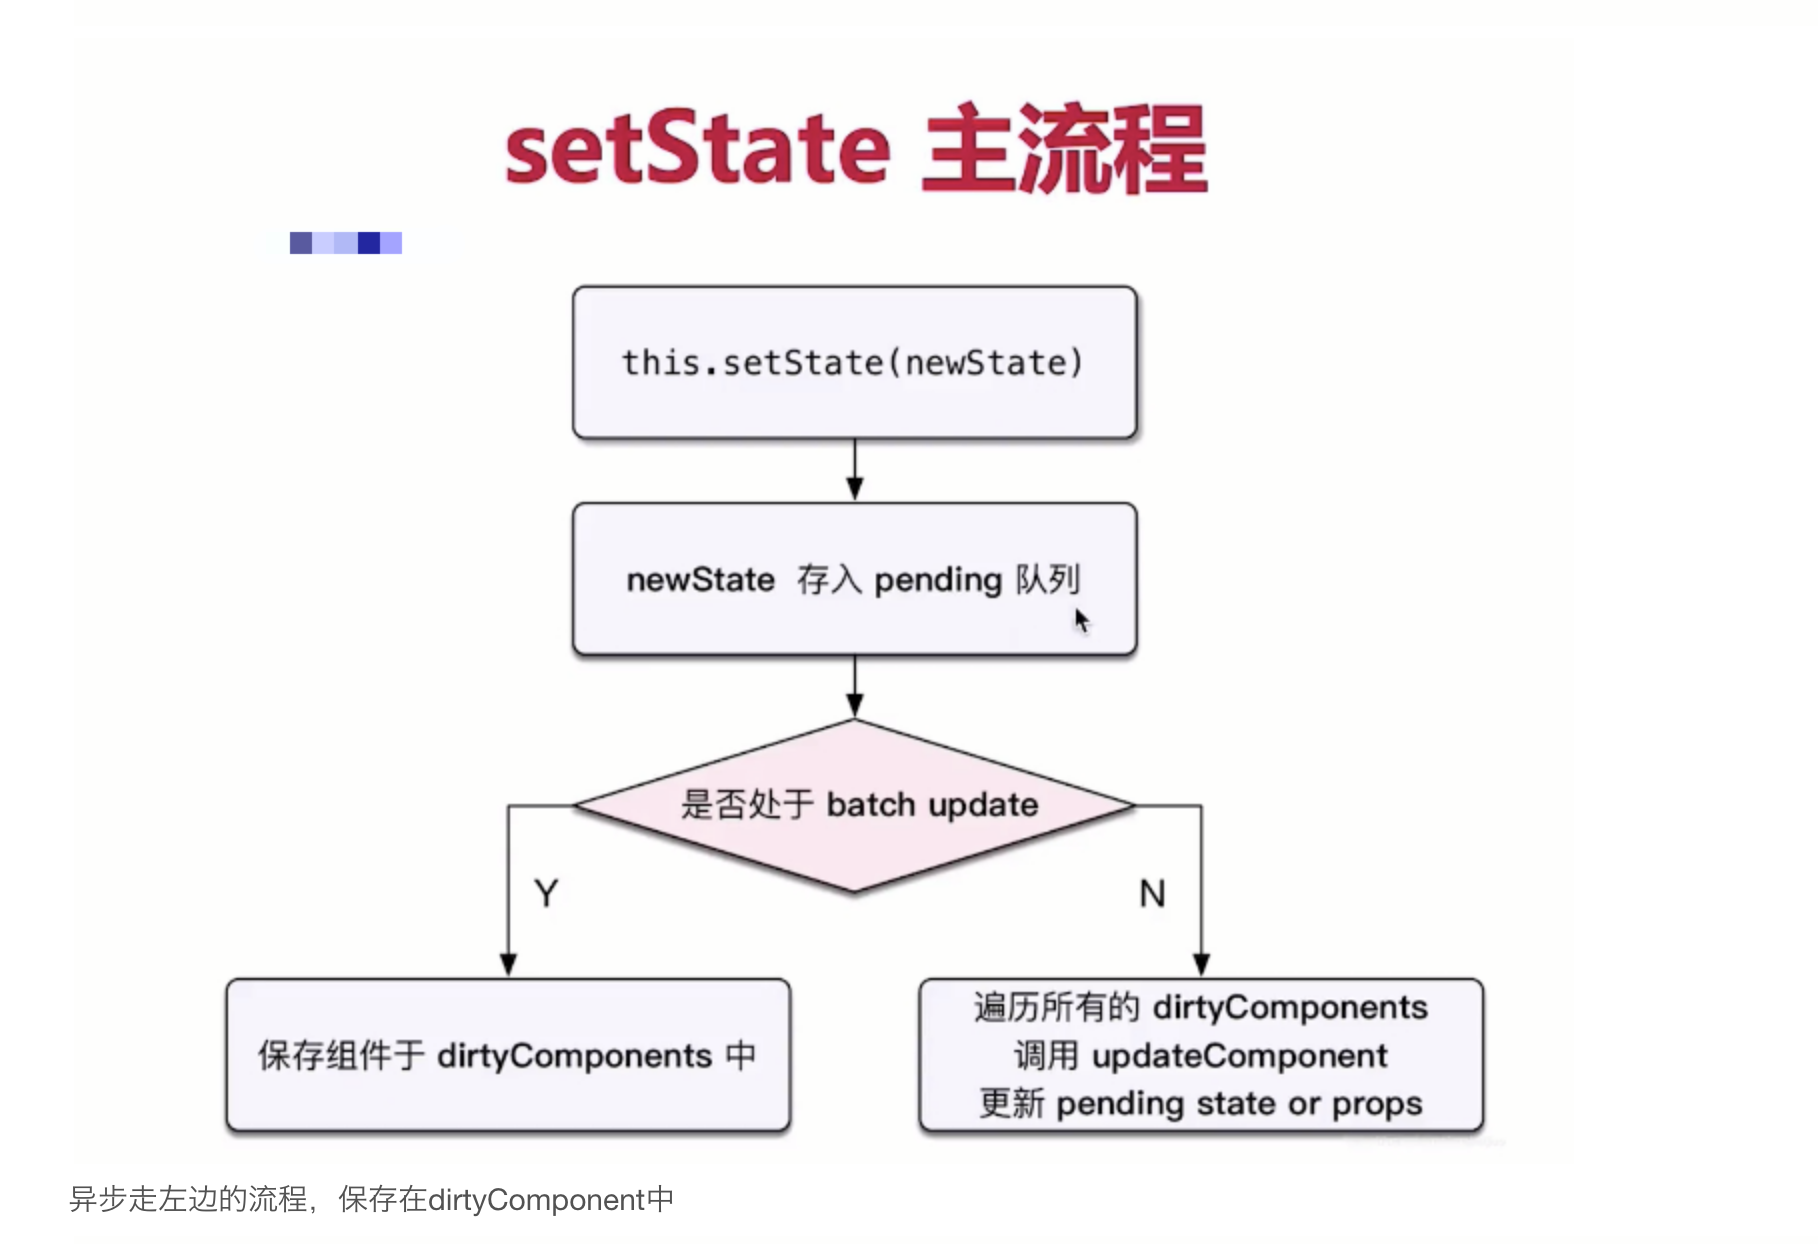
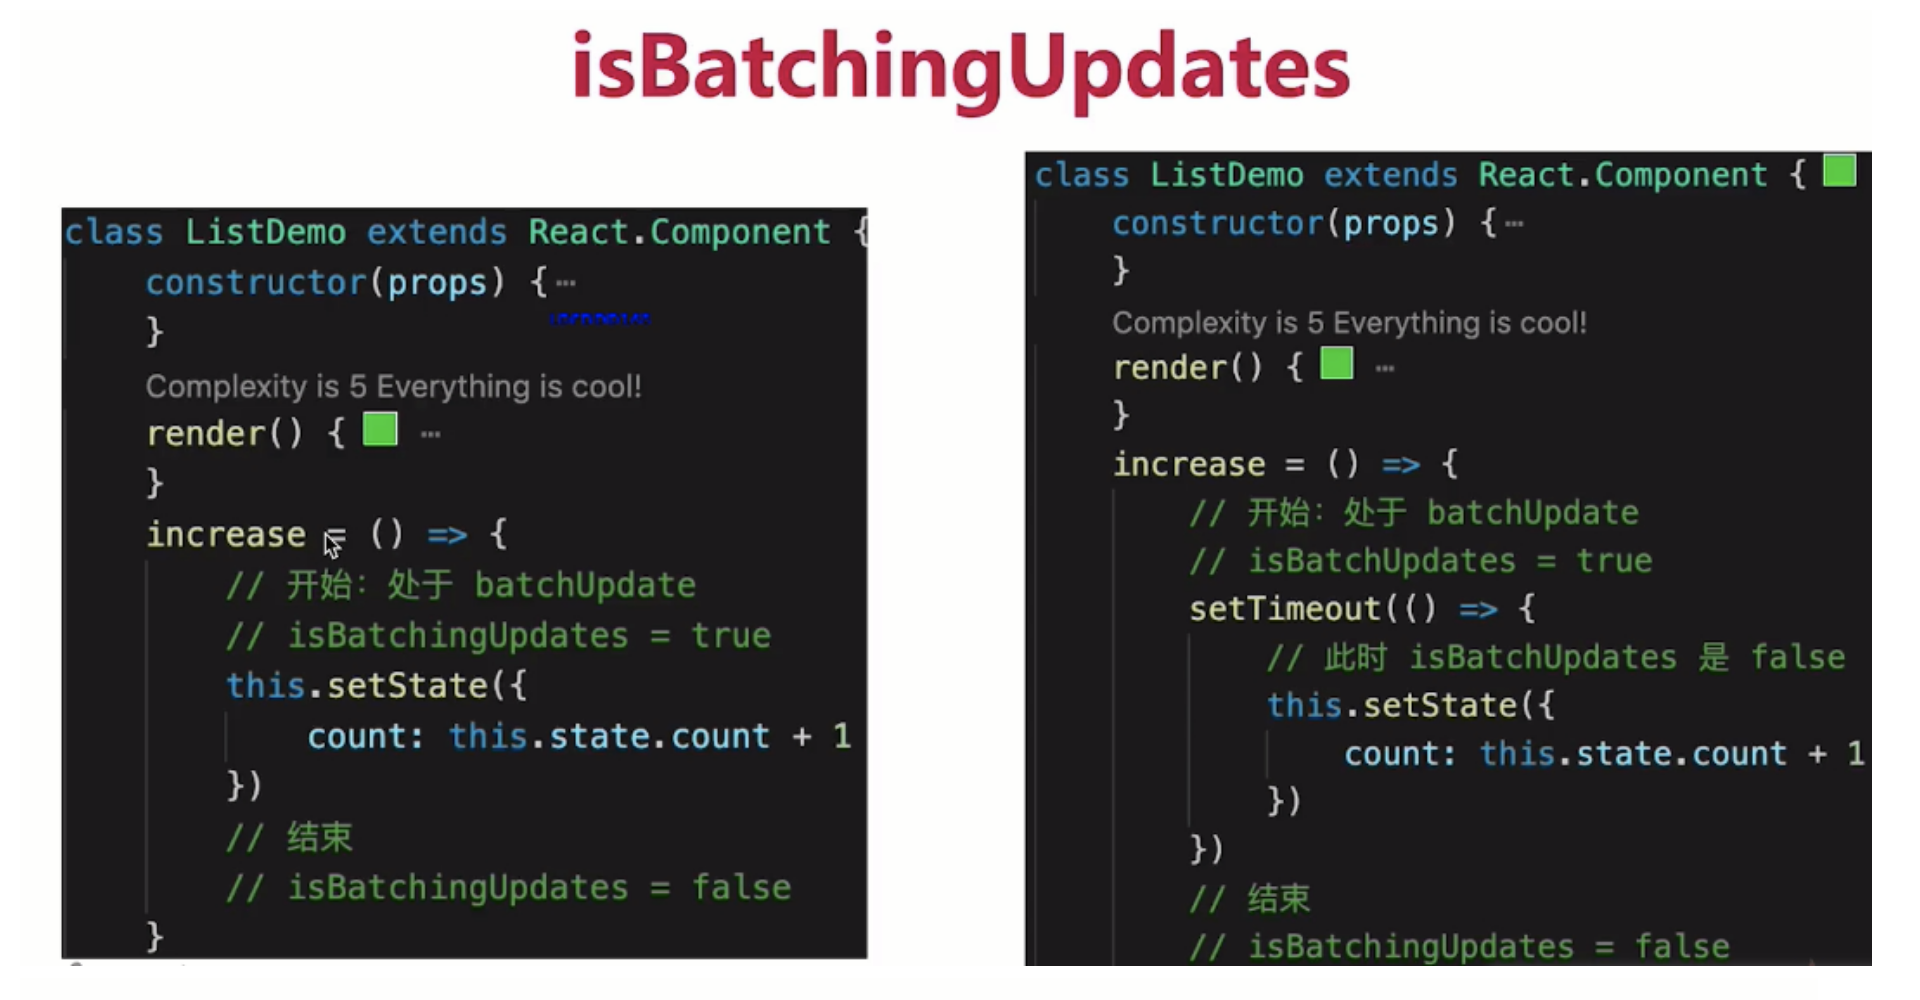
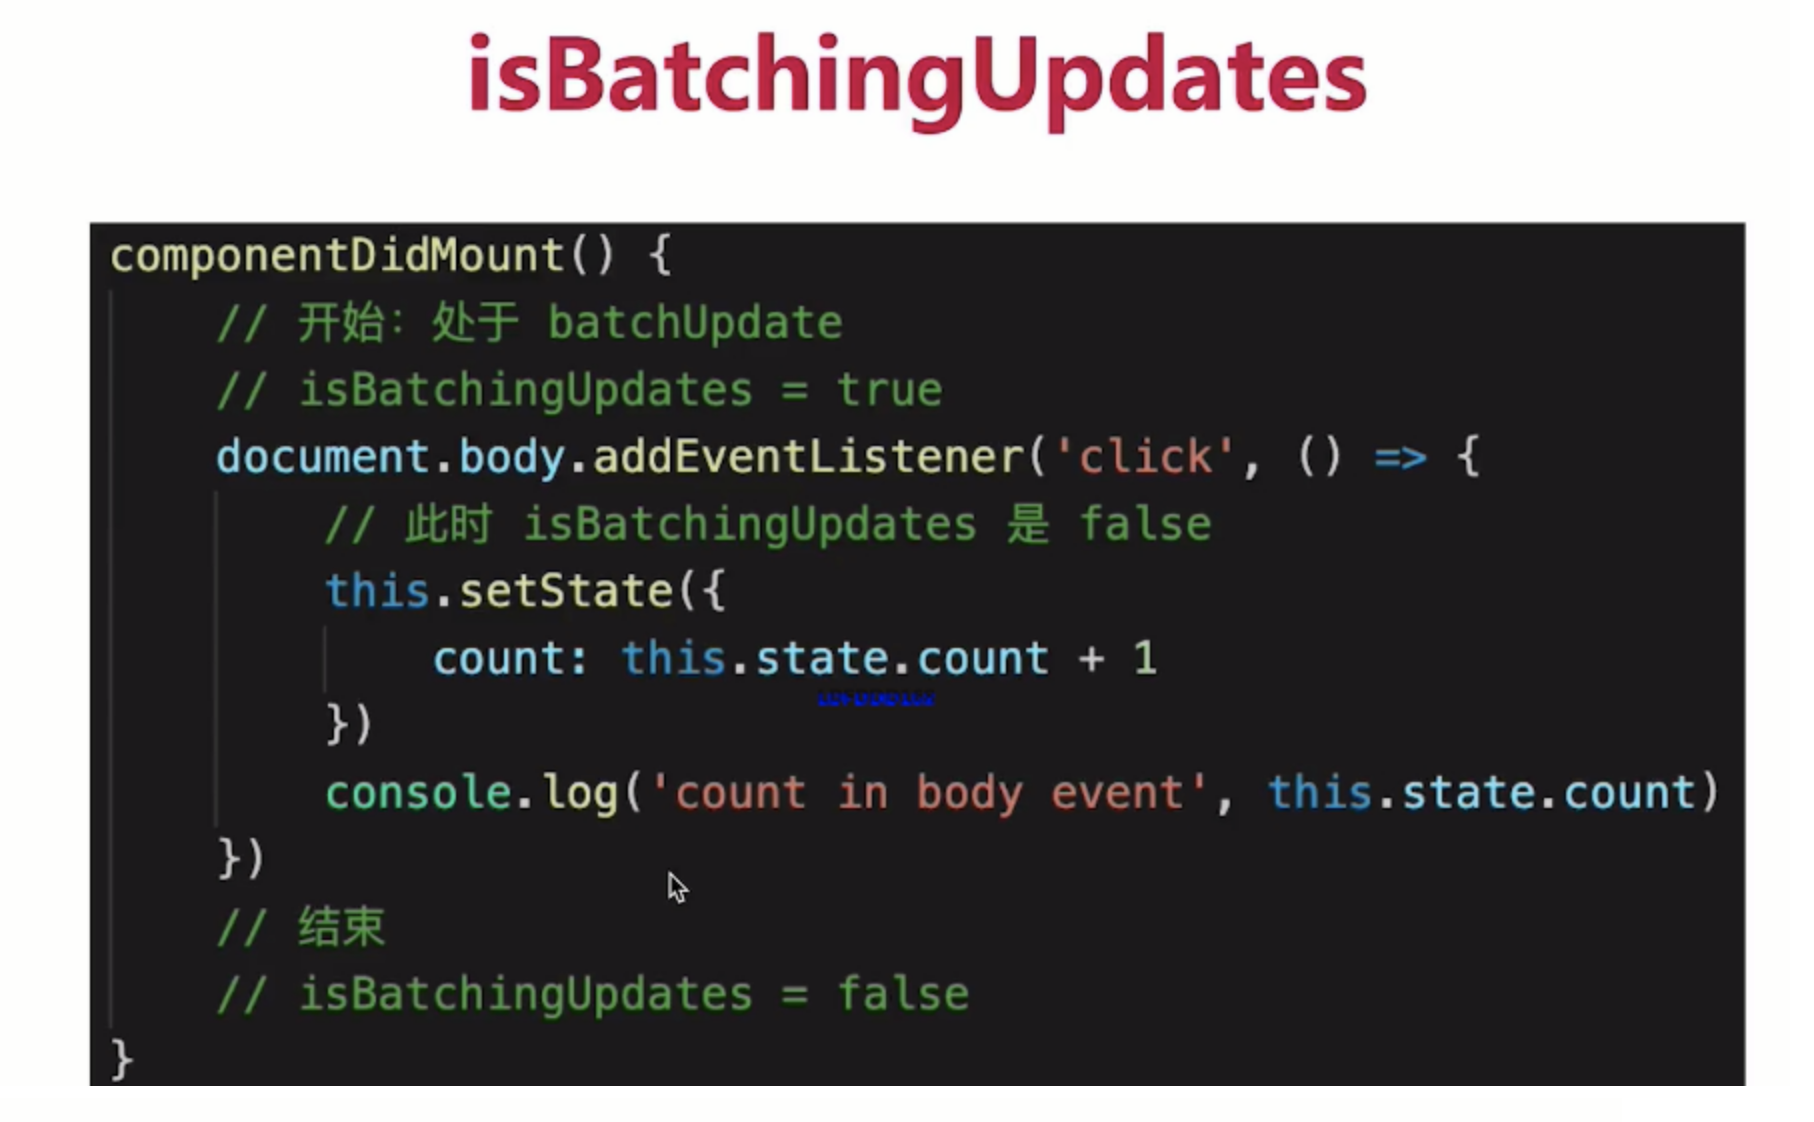

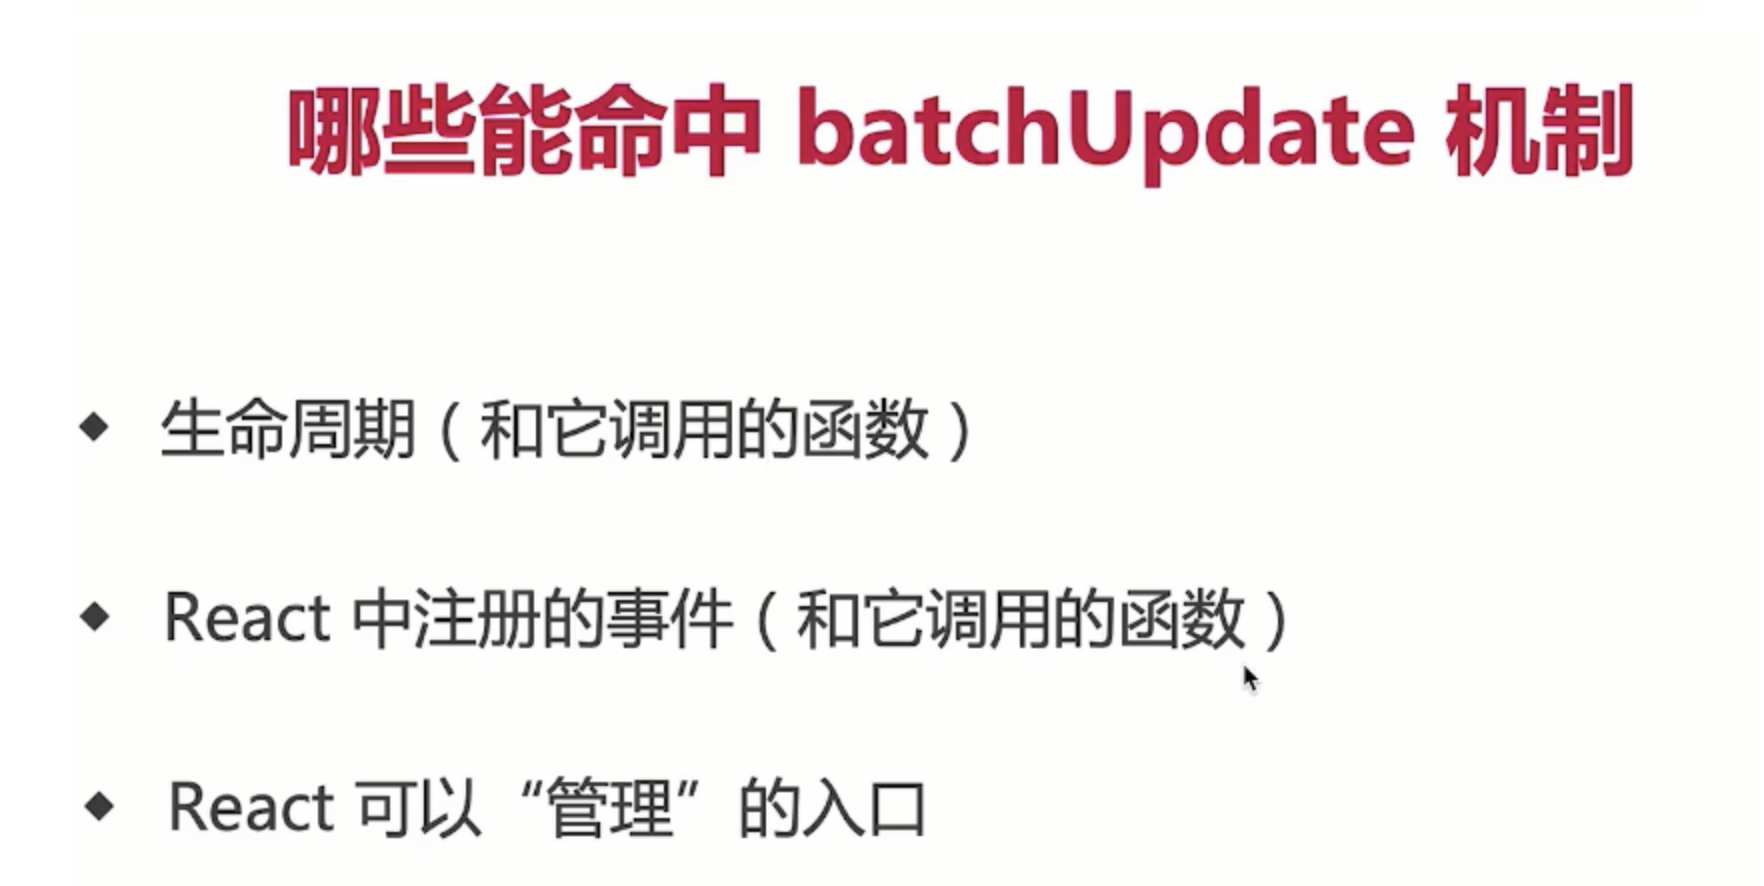
这是一道经常会出现的 React setState 笔试题:下面的代码输出什么呢?
class Test extends React.Component {
state = {
count: 0
};
componentDidMount() {
this.setState({count: this.state.count + 1});
console.log(this.state.count);
this.setState({count: this.state.count + 1});
console.log(this.state.count);
setTimeout(() => {
this.setState({count: this.state.count + 1});
console.log(this.state.count);
this.setState({count: this.state.count + 1});
console.log(this.state.count);
}, 0);
}
render() {
return null;
}
};
我们可以进行如下的分析:
- 首先第一次和第二次的
console.log,都在 React 的生命周期事件中,所以是异步的处理方式,则输出都为0; - 而在
setTimeout中的console.log处于原生事件中,所以会同步的处理再输出结果,但需要注意,虽然count在前面经过了两次的this.state.count + 1,但是每次获取的this.state.count都是初始化时的值,也就是0; - 所以此时
count是1,那么后续在setTimeout中的输出则是2和3。
所以完整答案是 0,0,2,3。
版本提醒:这个
0,0,2,3只在 React 17 及以前(或 React 18 兼容模式)成立。在 React 18createRoot与 React 19 下,setTimeout里两次setState也会被批处理并互相覆盖,输出变成0,0,1,1,最终count为2。
同步场景
异步场景中的案例使我们建立了这样一个认知:setState 是异步的,但下面这个案例又会颠覆你的认知。如果我们将 setState 放在 setTimeout 事件中,那情况就完全不同了。
class Test extends Component {
state = {
count: 0
}
componentDidMount(){
this.setState({ count: this.state.count + 1 });
console.log(this.state.count);
setTimeout(() => {
this.setState({ count: this.state.count + 1 });
console.log("setTimeout: " + this.state.count);
}, 0);
}
render(){
...
}
}
那这时输出的应该是什么呢?如果你认为是 0,0,那么又错了。
在 React 17 及以前,正确的结果是 0,2:setState 并不是真正的异步函数,它通过队列延迟执行,源码里用 isBatchingUpdates 判断是先入队还是直接更新——值为 true 走延迟合并,false 直接同步更新。
在 React 18 createRoot 与 React 19 下,结果是 0,1:定时器里的更新也被批处理,console.log 读到的是提交前的 1(第一次 setState 已在 componentDidMount 的批次里提交),而不是 2。
接下来这个案例的答案是什么呢
class Test extends Component {
state = {
count: 0
}
componentDidMount(){
this.setState({
count: this.state.count + 1
}, () => {
console.log(this.state.count)
})
this.setState({
count: this.state.count + 1
}, () => {
console.log(this.state.count)
})
}
render(){
...
}
}
如果你觉得答案是 1,2,那肯定就错了。这种迷惑性极强的考题在面试中非常常见,因为它反直觉。
如果重新仔细思考,你会发现当前拿到的 this.state.count 的值并没有变化,都是 0,所以输出结果应该是 1,1。
当然,也可以在 setState 函数中获取修改后的 state 值进行修改。
class Test extends Component {
state = {
count: 0
}
componentDidMount(){
this.setState(
preState=> ({
count:preState.count + 1
}),()=>{
console.log(this.state.count)
})
this.setState(
preState=>({
count:preState.count + 1
}),()=>{
console.log(this.state.count)
})
}
render(){
...
}
}
这些通通是异步的回调,如果你以为输出结果是 1,2,那就又错了,实际上是 2,2。
为什么会这样呢?当调用 setState 函数时,就会把当前的操作放入队列中。React 根据队列内容,合并 state 数据,完成后再逐一执行回调,根据结果更新虚拟 DOM,触发渲染。所以回调时,state 已经合并计算完成了,输出的结果就是 2,2 了。
💬 面试官追问
一次点击里连续两次
this.setState({ count: this.state.count + 1 }),结果只加了1,是丢了一次更新吗?没丢,两次读的都是同一个
this.state.count,合并后后一次覆盖前一次。换成this.setState(s => ({ count: s.count + 1 })),每次拿到的是上一次的结果,才会加2。同样在
setTimeout里调两次setState,老页面渲染两次,新页面只渲染一次,为什么?先看根节点怎么创建的。老页面用
ReactDOM.render,走的是17的行为,定时器里逐次同步刷新;新页面用createRoot,开了自动批处理。所以不能只看package.json里的React版本。setState后马上读this.state.open是旧值,有人想包一层setTimeout再读,行吗?别这么干,
createRoot下定时器里同样批处理,时机全靠碰运气。用setState(updater, () => console.log(this.state.open)),或者在componentDidUpdate里比较前后值再处理。展开面板后要立刻量新高度做动画,怎么写?
用
flushSync(() => setOpen(true)),它返回时DOM已经更新,下一行就能读offsetHeight。只包这一处,到处用会把批处理的好处全丢掉。请求回来时组件已经卸载了,还调了
setState,要不要每个组件都加isUnmounted?不用。
React 18已经去掉了这条警告,卸载后的setState本身是空操作。真正该做的是在卸载时用AbortController取消请求,别让无用的回调继续跑。
# 7 setState原理分析
⚡ 30 秒速记
- 每个类组件
Fiber有一个updateQueue,setState往里追加update,待处理部分是环形链表 16/17旧说法:isBatchingUpdates为true就只入队、把组件放进dirtyComponents,事务结束再统一刷18起不再看全局开关:同一时间段同优先级(lane)的更新自然合到一次渲染里- 算新
state时按顺序走队列:对象写法浅合并、后者覆盖前者,函数写法拿上一步结果继续算 - 直接改
this.state不进队列,不会触发渲染,下次合并时还可能被冲掉
setState 的原理就是一个更新队列:调用时只入队,轮到渲染时再按顺序把队列「折叠」成新的 state。 React 16、17 用 isBatchingUpdates 这个开关决定要不要立即刷新,在 React 管控的事件里开关是开的,所以先攒着;定时器里开关已经关了,就逐次同步刷新。React 18 之后改成按 lane 优先级调度,同一段时间里的更新自然被合并,跟在不在 React 调用栈里没关系了。还有个细节:低优先级的 update 被跳过时不会丢,会留在基础队列里,下次按原顺序重算。
本节是 React 16 / 17 内部实现的历史对照:下面的
pre/post钩子、isBatchingUpdates、dirtyComponents属于旧的 Transaction 批处理实现。React 18 起改为 Fiber 的 lane 优先级调度 + automatic batching,「是否在 React 调用栈里」不再决定批处理与否。版本结论见上一节开头的三档对照表。
1. setState异步更新
- 我们都知道,
React通过this.state来访问state,通过this.setState()方法来更新state。当this.setState()方法被调用的时候,React会重新调用render方法来重新渲染UI - 首先如果直接在
setState后面获取state的值是获取不到的。在React内部机制能检测到的地方,setState就是异步的;在React检测不到的地方,例如setInterval,setTimeout,setState就是同步更新的(React 17 及以前;React 18createRoot起这些场景同样批量合并,React 19 无法退回旧行为)

因为
setState是可以接受两个参数的,一个state,一个回调函数。因此我们可以在回调函数里面获取值

setState方法通过一个队列机制实现state更新,当执行setState的时候,会将需要更新的state合并之后放入状态队列,而不会立即更新this.state- 如果我们不使用
setState而是使用this.state.key来修改,将不会触发组件的re-render。 - 如果将
this.state赋值给一个新的对象引用,那么其他不在对象上的state将不会被放入状态队列中,当下次调用setState并对状态队列进行合并时,直接造成了state丢失
1.1 setState批量更新的过程
在
react生命周期和合成事件执行前后都有相应的钩子,分别是pre钩子和post钩子,pre钩子会调用batchedUpdate方法将isBatchingUpdates变量置为true,开启批量更新,而post钩子会将isBatchingUpdates置为false
isBatchingUpdates变量置为true,则会走批量更新分支,setState的更新会被存入队列中,待同步代码执行完后,再执行队列中的state更新。isBatchingUpdates为true,则把当前组件(即调用了setState的组件)放入dirtyComponents数组中;否则batchUpdate所有队列中的更新- 而在原生事件和异步操作中,不会执行
pre钩子,或者生命周期的中的异步操作之前执行了pre钩子,但是pos钩子也在异步操作之前执行完了,isBatchingUpdates必定为false,也就不会进行批量更新
enqueueUpdate包含了React避免重复render的逻辑。mountComponent和updateComponent方法在执行的最开始,会调用到batchedUpdates进行批处理更新,此时会将isBatchingUpdates设置为true,也就是将状态标记为现在正处于更新阶段了。isBatchingUpdates为true,则把当前组件(即调用了setState的组件)放入dirtyComponents数组中;否则batchUpdate所有队列中的更新
1.2 为什么直接修改this.state无效
- 要知道
setState本质是通过一个队列机制实现state更新的。 执行setState时,会将需要更新的state合并后放入状态队列,而不会立刻更新state,队列机制可以批量更新state。 - 如果不通过
setState而直接修改this.state,那么这个state不会放入状态队列中,下次调用setState时对状态队列进行合并时,会忽略之前直接被修改的state,这样我们就无法合并了,而且实际也没有把你想要的state更新上去
1.3 什么是批量更新 Batch Update
在一些
mv*框架中,,就是将一段时间内对model的修改批量更新到view的机制。比如那前端比较火的React、vue(nextTick机制,视图的更新以及实现)
1.4 setState之后发生的事情
setState操作并不保证是同步的,也可以认为是异步的React在setState之后,会经对state进行diff,判断是否有改变,然后去diff dom决定是否要更新UI。如果这一系列过程立刻发生在每一个setState之后,就可能会有性能问题- 在短时间内频繁
setState。React会将state的改变压入栈中,在合适的时机,批量更新state和视图,达到提高性能的效果
1.5 如何知道state已经被更新
传入回调函数
setState({
index: 1
}}, function(){
console.log(this.state.index);
})
在钩子函数中体现
componentDidUpdate(){
console.log(this.state.index);
}
2. setState循环调用风险
- 当调用
setState时,实际上会执行enqueueSetState方法,并对partialState以及_pending-StateQueue更新队列进行合并操作,最终通过enqueueUpdate执行state更新 - 而
performUpdateIfNecessary方法会获取_pendingElement,_pendingStateQueue,_pending-ForceUpdate,并调用receiveComponent和updateComponent方法进行组件更新 - 如果在
shouldComponentUpdate或者componentWillUpdate方法中调用setState,此时this._pending-StateQueue != null,就会造成循环调用,使得浏览器内存占满后崩溃
3 事务
- 事务就是将需要执行的方法使用
wrapper封装起来,再通过事务提供的perform方法执行,先执行wrapper中的initialize方法,执行完perform之后,在执行所有的close方法,一组initialize及close方法称为一个wrapper。 - 那么事务和
setState方法的不同表现有什么关系,首先我们把4次setState简单归类,前两次属于一类,因为它们在同一调用栈中执行,setTimeout中的两次setState属于另一类 - 在
setState调用之前,已经处在batchedUpdates执行的事务中了。那么这次batchedUpdates方法是谁调用的呢,原来是ReactMount.js中的_renderNewRootComponent方法。也就是说,整个将React组件渲染到DOM中的过程就是处于一个大的事务中。而在componentDidMount中调用setState时,batchingStrategy的isBatchingUpdates已经被设为了true,所以两次setState的结果没有立即生效 - 再反观
setTimeout中的两次setState,因为没有前置的batchedUpdates调用,所以导致了新的state马上生效
4. 总结
- 通过
setState去更新this.state,不要直接操作this.state,请把它当成不可变的 - 调用
setState更新this.state不是马上生效的,它是异步的,所以不要天真以为执行完setState后this.state就是最新的值了 - 多个顺序执行的
setState不是同步地一个一个执行滴,会一个一个加入队列,然后最后一起执行,即批处理
💬 面试官追问
直接写
this.state.profile.name = value,调试器里值变了但页面不动,是diff坏了吗?跟
diff没关系,这次修改根本没进更新队列,React不知道要重新render。而且下次别的setState合并时,基于的可能是另一份数据,这次私改说没就没了。对象式
setState和函数式setState在队列里处理有什么不同?处理时都按入队顺序来。对象式是把对象浅合并到当前结果上,所以连续写
count: this.state.count + 1是同一个值覆盖几次;函数式是把上一步的结果传进去算,所以能累加。拿
isBatchingUpdates解释React 19的批处理,对吗?不对,那是
16、17的Transaction实现,18起已经没有这个开关了。现在是按lane调度,同优先级的更新在一个任务里一起处理,定时器、Promise里也照样合并。在
shouldComponentUpdate里调setState修数据,页面一直在刷,为什么?它本身就在处理一次更新,里面再
setState又入队一次新的更新,处理完又触发一次判断,就转起来了。数据修正放到事件处理里,或者改成getDerivedStateFromProps这种纯计算。价格更新完要上报埋点,放
render里还是setState回调里?不能放
render,它可能因为别的原因执行很多次。针对这一次更新用setState的第二个参数;只要价格变了就上报,就放componentDidUpdate里比较prevState.price !== this.state.price。
# 8 React事务机制
⚡ 30 秒速记
- 事务(
Transaction)是React 15/16早期Stack时代的内部结构:initialize→ 执行方法 →close - 批处理就靠它:
initialize把isBatchingUpdates设为true,close时刷新dirtyComponents再设回false - 这解释了老版本里
setTimeout中的setState为什么同步:它跑在事务外面 Fiber重写之后事务已经拆掉,18起由lane调度 + 自动批处理接替- 答这题的重点:说清它解决什么问题、现在被谁取代,不用背
wrapper细节
事务就是给一个方法前后各包一层钩子,进门前开批处理,出门时统一刷新。 当年 React 的合成事件和生命周期都跑在事务里,所以里面的多次 setState 只是入队,close 的时候一起处理;而 setTimeout 回调执行时事务早就结束了,setState 只能立刻刷新,这就是「有时同步有时异步」的来源。这套东西现在已经是历史了,React 18 改成按优先级调度,在哪里调 setState 都会合并。面试时把这段来龙去脉讲清就够了。
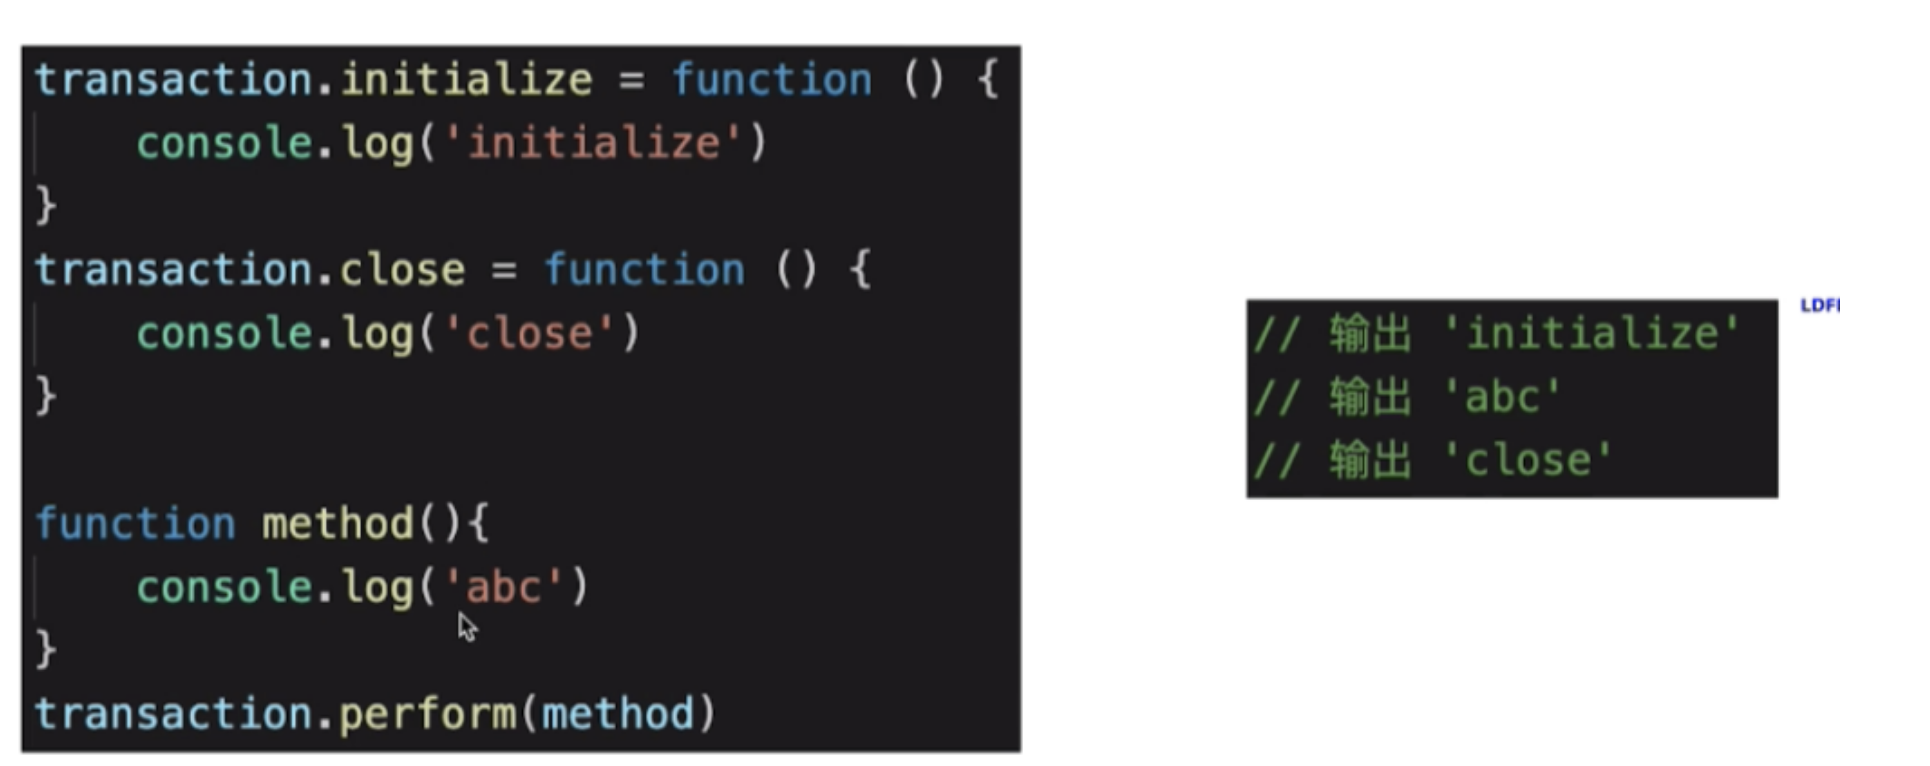
图里那套机制用代码写出来大概是这样,方便理解它为什么能做批处理:
// 简化版的 Transaction
function perform(method) {
// initialize:进门开批处理
isBatchingUpdates = true
try {
method() // 事件处理函数,里面的 setState 只入队
} finally {
// close:出门统一刷新
isBatchingUpdates = false
flushDirtyComponents() // 合并 state、重新 render,只渲染一次
}
}
function setState(component, partial) {
component.pending.push(partial)
if (isBatchingUpdates) {
dirtyComponents.add(component) // 在事务里:先攒着
} else {
flushComponent(component) // 不在事务里:立刻渲染
}
}
perform(() => {
setState(a, { n: 1 })
setState(a, { n: 2 }) // 两次只渲染一次
setTimeout(() => {
setState(a, { n: 3 }) // 事务早结束了,这里立刻同步渲染
})
})
React 15 里的 ReactDefaultBatchingStrategy 就是这么一个事务,合成事件分发、组件挂载都套在它里面。React 16 的 Fiber 重写把这套东西逐步拆掉了,17 里虽然还有 batchedUpdates 这个函数,但已经是基于执行上下文标志位的实现。React 18 的 createRoot 不再区分「在不在 React 调用栈里」,同一个任务里同优先级的更新全部合并,这才有了自动批处理。
💬 面试官追问
老项目里一次合成事件调三次
setState,只渲染了一次,用事务怎么解释?事件处理函数被事务包着,
initialize打开批处理,三次setState只是把组件放进dirtyComponents。等处理函数跑完、close时才统一渲染一次。有人把事务那张图写进
React 19的排障文档,说定时器里一定逃离批处理,你怎么看?直接打回。那是旧实现,
18的createRoot起定时器里也自动批处理,19更是没法退回旧行为。文档要么删掉,要么明确标「17及以前」。能不能找到内部开关,手动关掉批处理让更新立刻生效?
别碰内部变量,它不是公开
API,升级就没了。官方出口是flushSync,只包需要立刻读DOM的那一次更新。事务、自动批处理、
reconciliation是一回事吗?不是。事务是旧版怎么圈出一批更新,自动批处理是新版怎么合并更新,这两个管的都是「什么时候开始渲染」。
reconciliation是开始渲染之后,比对新旧树找差异的过程,合并更新并不会跳过它。
# 9 React组件和渲染更新过程
⚡ 30 秒速记
- 首次挂载:
JSX→createElement得到元素树 → 构建Fiber树 →commit生成真实DOM - 更新:
setState入队 → 调度 → 重新render得到新元素 → 和旧Fiber比对、打标记 →commit提交 - 组件重新
render≠ 改DOM,DOM只动比对出来的那部分 commit三小步:before mutation(读旧DOM)→mutation(改DOM)→layout(componentDidMount/componentDidUpdate、useLayoutEffect)useEffect一般在浏览器绘制之后执行,不挡首帧
渲染分两段:先算出界面应该长什么样,再把差异一次性写进页面。 首次挂载时没有旧树可比,React 照着元素树把 DOM 全建出来;更新时 setState 让组件重新 render,新元素和旧 Fiber 比对,只给变了的节点打标记,最后在 commit 阶段统一改。很多人看到子组件 render 执行了就以为页面重画了,其实大部分时候真实 DOM 一点没动,浪费的只是 JS 计算。生命周期也挂在 commit 里:componentDidMount 在 DOM 改完、浏览器绘制前同步执行,useEffect 通常排到绘制之后。
渲染和更新过程
- jsx如何渲染为页面
- setState之后如何更新页面
- 面试考察全流程
JSX本质和vdom
- JSX即
createElement函数 - 执行生成vnode
patch(elem,vnode)和patch(vnode,newNode)
组件渲染过程
props staterender()生成vnodepatch(elem, vnode)
组件更新过程
setState-->dirtyComponents(可能有子组件)render生成newVnodepatch(vnode, newVnode)
用一段代码看清挂载和更新时各个钩子的执行顺序:
class Child extends React.Component {
componentDidMount() { console.log('child didMount') }
componentDidUpdate() { console.log('child didUpdate') }
render() { console.log('child render'); return <span>{this.props.n}</span> }
}
class Parent extends React.Component {
state = { n: 0 }
componentDidMount() { console.log('parent didMount') }
componentDidUpdate() { console.log('parent didUpdate') }
render() {
console.log('parent render')
return <button onClick={() => this.setState({ n: this.state.n + 1 })}>
<Child n={this.state.n} />
</button>
}
}
// 首次挂载输出:
// parent render -> child render -> child didMount -> parent didMount
// 点一次按钮输出:
// parent render -> child render -> child didUpdate -> parent didUpdate
规律是:render 阶段从上往下走,所以父先子后;commit 阶段按节点「完成」的顺序处理副作用,子节点先完成,所以 didMount / didUpdate 是子先父后。
更新时真实 DOM 只改了 <span> 里那个文本节点,按钮本身没有被重建。这就是「重新 render」和「重新绘制」的区别:render 是 JS 计算,DOM 只按比对结果改最小的一块。如果 Child 的 props 没变还想省掉 render,类组件用 PureComponent,函数组件用 React.memo。
💬 面试官追问
只改了购物车数量,父组件和推荐列表的
render都跑了,这算整页重绘吗?不算。
render跑了只是重新算了一遍元素,比对后发现推荐列表没变,DOM不会动。真嫌浪费就给推荐列表包React.memo,连render都省掉。首次挂载和
setState更新,走的流程差在哪?首次没有旧树,所有节点都是新增,
commit时整块插进容器;更新时有current树做对照,只给变化的节点打标记。另外挂载调componentDidMount,更新调componentDidUpdate。父子组件的
componentDidMount谁先执行?子先父后。
commit阶段按完成顺序处理,子节点先完成,所以子组件的componentDidMount先跑,父组件的最后跑;render则是父先子后。金额
state已经变了,界面还是旧金额,怎么定位?先在
render里打印,看新值有没有进来;进来了就看是不是渲染的是别的字段,或者被shouldComponentUpdate、memo拦住了。render里就是旧值,问题在状态传递,跟DOM没关系。useEffect和componentDidMount执行时机一样吗?不完全一样。
componentDidMount在DOM改完、浏览器绘制前同步执行,和useLayoutEffect同一时机;useEffect一般等绘制之后再跑,所以在里面改样式可能看到一下闪烁。
# 10 如何解释 React 的渲染流程
⚡ 30 秒速记
- 四步:触发更新 → 调度 →
render(协调)→commit React 16是分界线:之前Stack Reconciler递归 + 事务,之后Fiber Reconciler循环 + 优先级render阶段基于current树构建workInProgress树、打flags,可中断,所以必须纯commit同步执行:改DOM、挂ref、调生命周期,不能停- 调度早期设想过
requestIdleCallback,实际用的是自研Scheduler;普通后台感知不大,动画、手势、大列表才明显
我会把 React 渲染讲成四步:触发、调度、render、commit。 触发就是首次挂载或者 setState;调度按优先级决定什么时候干;render 阶段从根往下,对照 current 树逐个处理 Fiber,构建出 workInProgress 树并标记哪些节点要改,这段可以被高优先级任务打断;commit 阶段拿着标记一次性改 DOM、绑 ref、跑 componentDidMount 这类回调,最后把 current 指针切到新树。commit 不能停,所以 componentDidMount 里塞重计算,Fiber 也救不了。
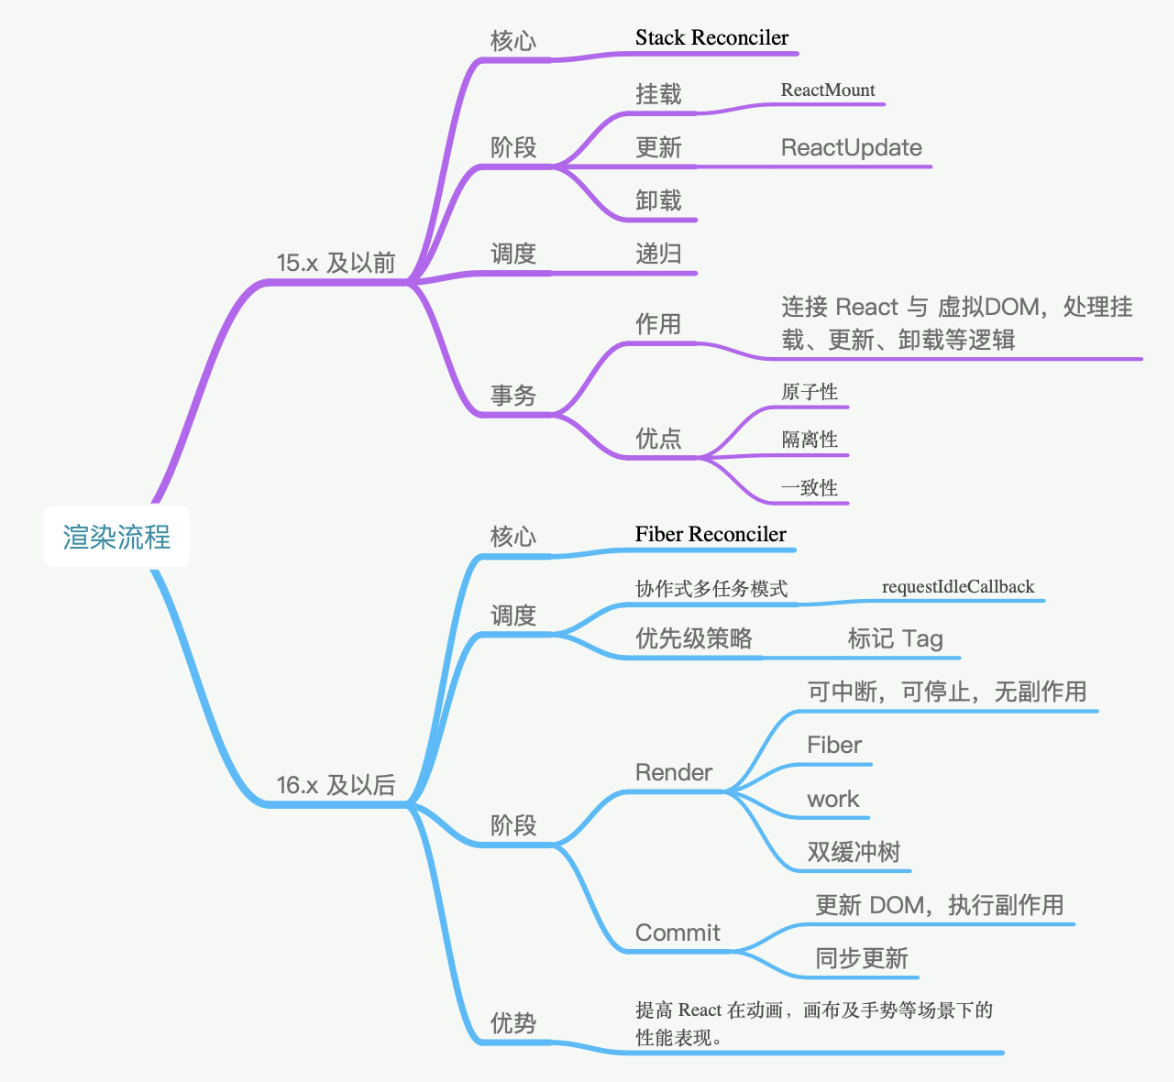
- React 的渲染过程大致一致,但协调并不相同,以
React 16为分界线,分为Stack Reconciler和Fiber Reconciler。这里的协调从狭义上来讲,特指 React 的 diff 算法,广义上来讲,有时候也指 React 的reconciler模块,它通常包含了diff算法和一些公共逻辑。 - 回到
Stack Reconciler中,Stack Reconciler的核心调度方式是递归。调度的基本处理单位是事务,它的事务基类是Transaction,这里的事务是 React 团队从后端开发中加入的概念。在 React 16 以前,挂载主要通过 ReactMount 模块完成,更新通过ReactUpdate模块完成,模块之间相互分离,落脚执行点也是事务。 - 在
React 16及以后,协调改为了Fiber Reconciler。它的调度方式主要有两个特点,第一个是协作式多任务模式,在这个模式下,线程会定时放弃自己的运行权利,交还给主线程,通过requestIdleCallback实现。第二个特点是策略优先级,调度任务通过标记tag的方式分优先级执行,比如动画,或者标记为high的任务可以优先执行。Fiber Reconciler的基本单位是Fiber,Fiber基于过去的React Element提供了二次封装,提供了指向父、子、兄弟节点的引用,为diff工作的双链表实现提供了基础。 - 在新的架构下,整个生命周期被划分为
Render 和 Commit 两个阶段。Render 阶段的执行特点是可中断、可停止、无副作用,主要是通过构造workInProgress树计算出diff。以current树为基础,将每个Fiber作为一个基本单位,自下而上逐个节点检查并构造 workInProgress 树。这个过程不再是递归,而是基于循环来完成 - 在执行上通过
requestIdleCallback来调度执行每组任务,每组中的每个计算任务被称为work,每个work完成后确认是否有优先级更高的work需要插入,如果有就让位,没有就继续。优先级通常是标记为动画或者high的会先处理。每完成一组后,将调度权交回主线程,直到下一次requestIdleCallback调用,再继续构建workInProgress树 - 在
commit阶段需要处理effect列表,这里的effect列表包含了根据diff 更新 DOM 树、回调生命周期、响应 ref等。 - 但一定要注意,这个阶段是同步执行的,不可中断暂停,所以不要在
componentDidMount、componentDidUpdate、componentWiilUnmount中去执行重度消耗算力的任务 - 如果只是一般的应用场景,比如管理后台、H5 展示页等,两者性能差距并不大,但在动画、画布及手势等场景下,
Stack Reconciler的设计会占用占主线程,造成卡顿,而fiber reconciler的设计则能带来高性能的表现
💬 面试官追问
同事说
React更新就是递归整棵组件树,放到React 16之后哪里不准?16之后是循环处理Fiber链表,每处理一个节点都可以检查要不要让出主线程,不再依赖调用栈。而且没变化的子树会被直接跳过复用,不是整棵都走一遍。拖拽和低优先级列表刷新同时来,哪一层决定先处理拖拽?
调度层。每个更新带着
lane优先级,用户输入是高优先级,startTransition包的是低优先级;高优先级到了会打断正在进行的低优先级render。普通管理后台从
React 15升到18,会明显变快吗?一般感觉不出来,表单和小列表的渲染本来就在几毫秒内。收益主要在大计算量、动画、手势这类场景,而且得用
startTransition之类的并发特性才能体现。弹窗打开时页面卡了一秒,日志显示
diff早算完了,问题在哪个阶段?在
commit阶段,大概率是componentDidMount或useLayoutEffect里做了重计算,这段是同步的,会一直卡到算完。把重活挪到useEffect或者拆到Web Worker里。current树和workInProgress树最后是怎么切换的?render阶段构建的是workInProgress,commit完成后根节点的current指针直接指向它,新树变成当前树,旧树留着下次更新复用节点。这就是双缓存。
# 11 diff算法是怎么运作
⚡ 30 秒速记
- 三个假设把
O(n³)降到O(n):只比同层、类型不同直接整棵重建、同层用key认身份 - 单节点:
key和type都相同才复用,否则删旧建新 - 多节点两轮:第一轮从头按位置比,遇到
key不同就停;第二轮把剩下的旧节点放进Map,按key找,用lastPlacedIndex判断要不要移动 React只会把节点往右移:abcd→dabc会移动a、b、c三个,而不是只移d- 列表会增删排序就别用
index当key,状态会错位
React 的 diff 靠三条假设把复杂度压到 O(n):只比同一层、类型变了直接重建、列表靠 key 认人。 跨层移动它不认,div 换成 p 整棵子树都会销毁重建,里面的组件状态也跟着没了。列表比较分两轮:先从头按位置比,能复用就继续;碰到对不上的,就把剩下的旧节点按 key 放进 Map 慢慢找。key 一定要稳定唯一,用 index 在头部插一条,后面每一项的 key 都变了,输入框内容就会串行。
每一种节点类型有自己的属性,也就是prop,每次进行diff的时候,react会先比较该节点类型,假如节点类型不一样,那么react会直接删除该节点,然后直接创建新的节点插入到其中,假如节点类型一样,那么会比较prop是否有更新,假如有prop不一样,那么react会判定该节点有更新,那么重渲染该节点,然后在对其子节点进行比较,一层一层往下,直到没有子节点
- 把树形结构按照层级分解,只比较同级元素。
- 给列表结构的每个单元添加唯一的
key属性,方便比较。 React只会匹配相同class的component(这里面的class指的是组件的名字)- 合并操作,调用
component的setState方法的时候,React将其标记为 -dirty.到每一个事件循环结束,React检查所有标记dirty的component重新绘制. - 选择性子树渲染。开发人员可以重写
shouldComponentUpdate提高diff的性能
优化⬇️
为了降低算法复杂度,
React的diff会预设三个限制:
- 只对同级元素进行
Diff。如果一个DOM节点在前后两次更新中跨越了层级,那么React不会尝试复用他。 - 两个不同类型的元素会产生出不同的树。如果元素由
div变为p,React会销毁div及其子孙节点,并新建p及其子孙节点。 - 开发者可以通过
key prop来暗示哪些子元素在不同的渲染下能保持稳定。考虑如下例子:
Diff的思路
该如何设计算法呢?如果让我设计一个Diff算法,我首先想到的方案是:
- 判断当前节点的更新属于哪种情况
- 如果是
新增,执行新增逻辑 - 如果是
删除,执行删除逻辑 - 如果是
更新,执行更新逻辑
- 按这个方案,其实有个隐含的前提——不同操作的优先级是相同的
- 但是
React团队发现,在日常开发中,相较于新增和删除,更新组件发生的频率更高。所以Diff会优先判断当前节点是否属于更新。
基于以上原因,Diff算法的整体逻辑会经历两轮遍历:
- 第一轮遍历:处理
更新的节点。 - 第二轮遍历:处理剩下的不属于
更新的节点。

diff算法的作用
计算出Virtual DOM中真正变化的部分,并只针对该部分进行原生DOM操作,而非重新渲染整个页面。
传统diff算法
通过循环递归对节点进行依次对比,算法复杂度达到
O(n^3),n是树的节点数,这个有多可怕呢?——如果要展示1000个节点,得执行上亿次比较。。即便是CPU快能执行30亿条命令,也很难在一秒内计算出差异。
React的diff算法
- 什么是调和?
将Virtual DOM树转换成actual DOM树的最少操作的过程 称为 调和 。
- 什么是React diff算法?
diff算法是调和的具体实现。
diff策略
React用 三大策略 将O(n^3)复杂度 转化为 O(n)复杂度
策略一(tree diff):
- Web UI中DOM节点跨层级的移动操作特别少,可以忽略不计。
策略二(component diff):
- 拥有相同类的两个组件 生成相似的树形结构,
- 拥有不同类的两个组件 生成不同的树形结构。
策略三(element diff):
对于同一层级的一组子节点,通过唯一id区分。
tree diff
- React通过updateDepth对Virtual DOM树进行层级控制。
- 对树分层比较,两棵树 只对同一层次节点 进行比较。如果该节点不存在时,则该节点及其子节点会被完全删除,不会再进一步比较。
- 只需遍历一次,就能完成整棵DOM树的比较。
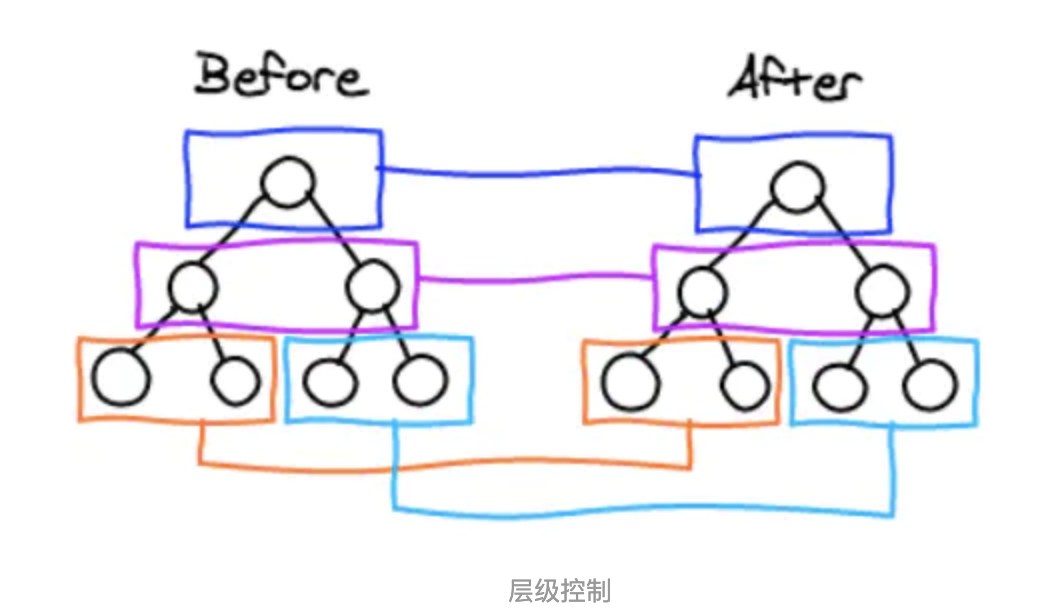
那么问题来了,如果DOM节点出现了跨层级操作,diff会咋办呢?
答:diff只简单考虑同层级的节点位置变换,如果是跨层级的话,只有创建节点和删除节点的操作。
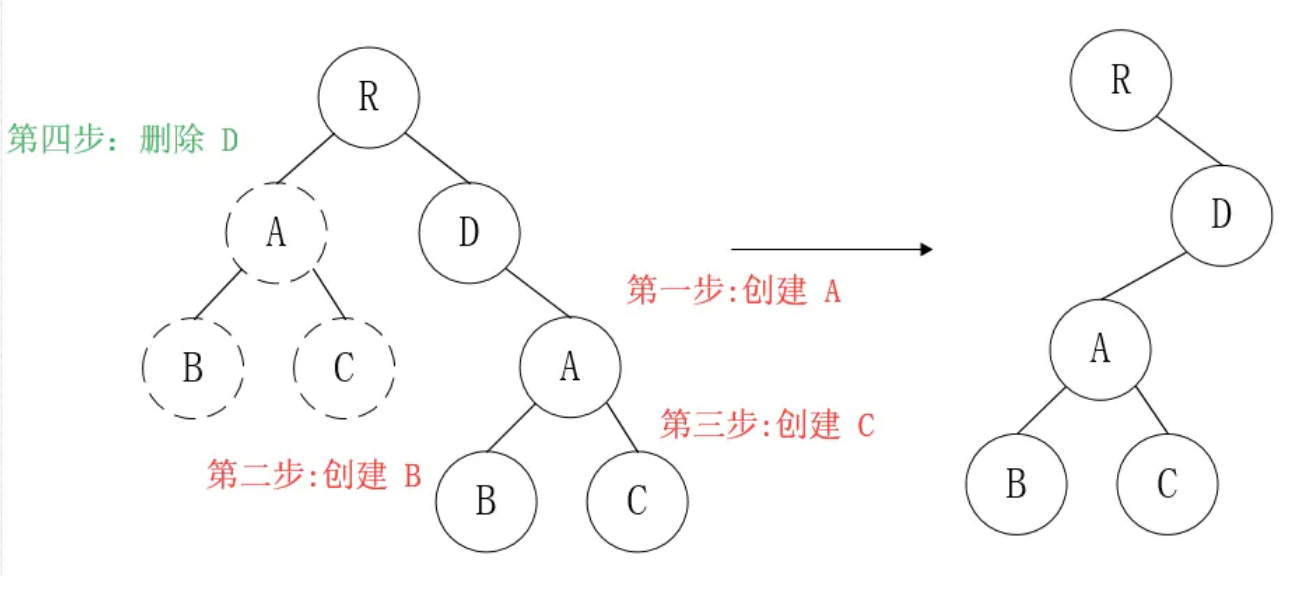
如上图所示,以A为根节点的整棵树会被重新创建,而不是移动,因此 官方建议不要进行DOM节点跨层级操作,可以通过CSS隐藏、显示节点,而不是真正地移除、添加DOM节点
component diff
React对不同的组件间的比较,有三种策略
- 同一类型的两个组件,按原策略(层级比较)继续比较Virtual DOM树即可。
- 同一类型的两个组件,组件A变化为组件B时,可能Virtual DOM没有任何变化,如果知道这点(变换的过程中,Virtual DOM没有改变),可节省大量计算时间,所以 用户 可以通过
shouldComponentUpdate()来判断是否需要 判断计算。 - 不同类型的组件,将一个(将被改变的)组件判断为
dirty component(脏组件),从而替换 整个组件的所有节点。
注意:如果组件D和组件G的结构相似,但是 React判断是 不同类型的组件,则不会比较其结构,而是删除 组件D及其子节点,创建组件G及其子节点。
element diff
当节点处于同一层级时,diff提供三种节点操作:删除、插入、移动。
- 插入:组件 C 不在集合(A,B)中,需要插入
- 删除:
- 组件 D 在集合(A,B,D)中,但 D的节点已经更改,不能复用和更新,所以需要删除 旧的 D ,再创建新的。
- 组件 D 之前在 集合(A,B,D)中,但集合变成新的集合(A,B)了,D 就需要被删除。
- 移动:组件D已经在集合(A,B,C,D)里了,且集合更新时,D没有发生更新,只是位置改变,如新集合(A,D,B,C),D在第二个,无须像传统diff,让旧集合的第二个B和新集合的第二个D 比较,并且删除第二个位置的B,再在第二个位置插入D,而是 (对同一层级的同组子节点) 添加唯一key进行区分,移动即��。
总结
tree diff:只对比同一层的 dom 节点,忽略 dom 节点的跨层级移动
如下图,react 只会对相同颜色方框内的 DOM 节点进行比较,即同一个父节点下的所有子节点。当发现节点不存在时,则该节点及其子节点会被完全删除掉,不会用于进一步的比较。
这样只需要对树进行一次遍历,便能完成整个 DOM 树的比较。
这就意味着,如果 dom 节点发生了跨层级移动,react 会删除旧的节点,生成新的节点,而不会复用。
component diff:如果不是同一类型的组件,会删除旧的组件,创建新的组件
element diff:对于同一层级的一组子节点,需要通过唯一 id 进行来区分
- 如果没有 id 来进行区分,一旦有插入动作,会导致插入位置之后的列表全部重新渲染
- 这也是为什么渲染列表时为什么要使用唯一的 key。
diff的不足与待优化的地方
尽量减少类似将最后一个节点移动到列表首部的操作,当节点数量过大或更新操作过于频繁时,会影响React的渲染性能
与其他框架相比,React 的 diff 算法有何不同?
diff 算法探讨的就是虚拟 DOM 树发生变化后,生成 DOM 树更新补丁的方式。它通过对比新旧两株虚拟 DOM 树的变更差异,将更新补丁作用于真实 DOM,以最小成本完成视图更新
具体的流程是这样的:
- 真实 DOM 与虚拟 DOM 之间存在一个映射关系。这个映射关系依靠初始化时的 JSX 建立完成;
- 当虚拟 DOM 发生变化后,就会根据差距计算生成 patch,这个 patch 是一个结构化的数据,内容包含了增加、更新、移除等;
- 最后再根据 patch 去更新真实的 DOM,反馈到用户的界面上。
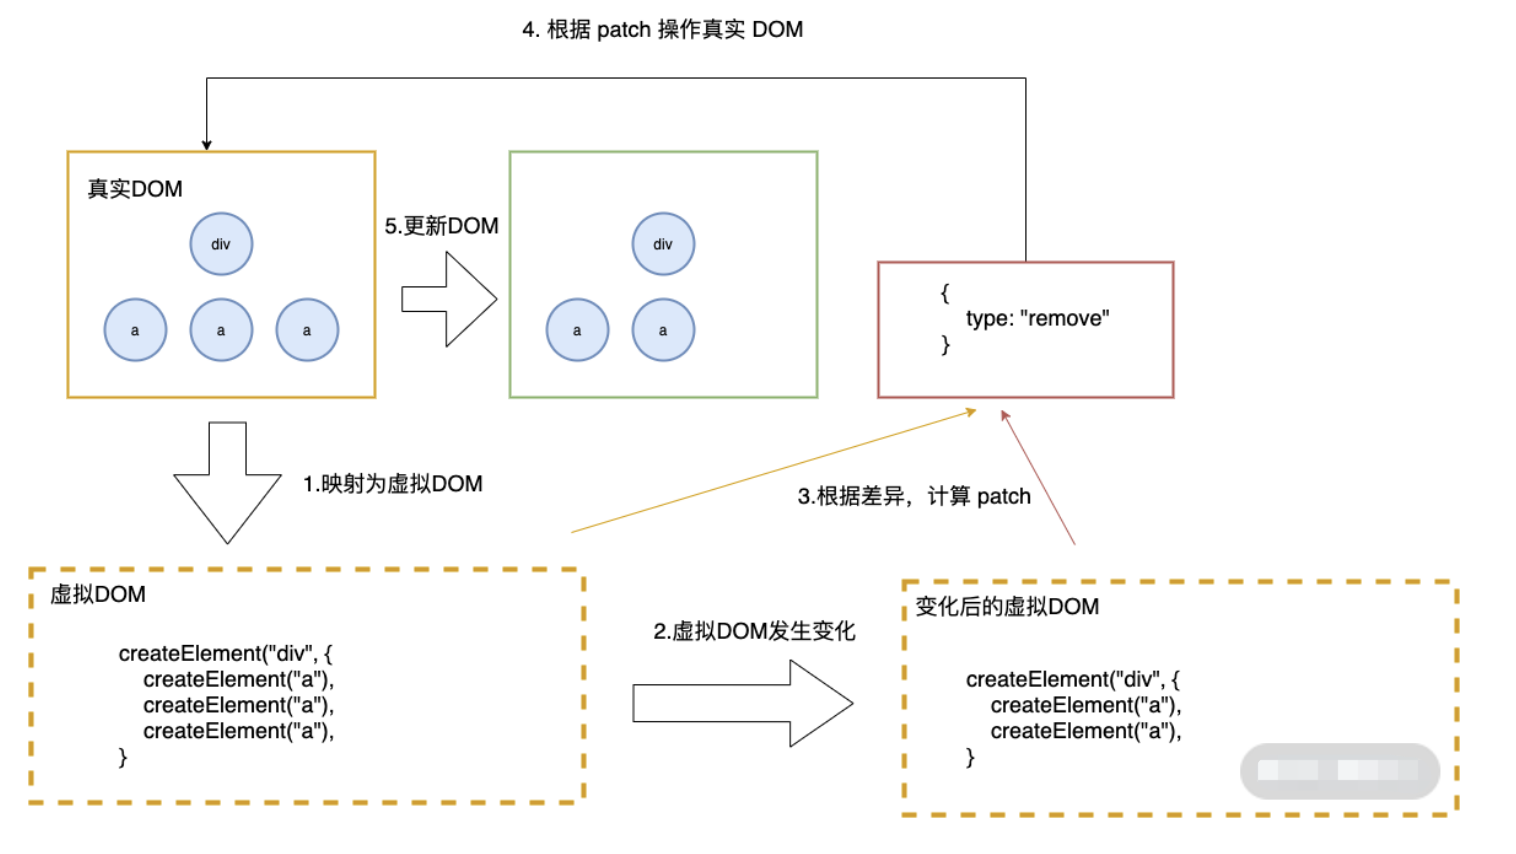
在回答有何不同之前,首先需要说明下什么是 diff 算法。
diff 算法是指生成更新补丁的方式,主要应用于虚拟 DOM 树变化后,更新真实 DOM。所以 diff 算法一定存在这样一个过程:触发更新 → 生成补丁 → 应用补丁- React 的 diff 算法,触发更新的时机主要在 state 变化与 hooks 调用之后。此时触发虚拟 DOM 树变更遍历,采用了深度优先遍历算法。但传统的遍历方式,效率较低。为了优化效率,使用了分治的方式。
将单一节点比对转化为了 3 种类型节点的比对,分别是树、组件及元素,以此提升效率。树比对:由于网页视图中较少有跨层级节点移动,两株虚拟 DOM 树只对同一层次的节点进行比较。组件比对:如果组件是同一类型,则进行树比对,如果不是,则直接放入到补丁中。元素比对:主要发生在同层级中,通过标记节点操作生成补丁,节点操作对应真实的 DOM 剪裁操作。同一层级的子节点,可以通过标记 key 的方式进行列表对比。
- 以上是经典的 React diff 算法内容。
自 React 16 起,引入了 Fiber 架构。为了使整个更新过程可随时暂停恢复,节点与树分别采用了FiberNode 与 FiberTree 进行重构。fiberNode 使用了双链表的结构,可以直接找到兄弟节点与子节点 - 然后拿 Vue 和 Preact 与 React 的 diff 算法进行对比
Preact的Diff算法相较于React,整体设计思路相似,但最底层的元素采用了真实DOM对比操作,也没有采用Fiber设计。Vue 的Diff算法整体也与React相似,同样未实现Fiber设计
- 然后进行横向比较,
React 拥有完整的 Diff 算法策略,且拥有随时中断更新的时间切片能力,在大批量节点更新的极端情况下,拥有更友好的交互体验。 - Preact 可以在一些对性能要求不高,仅需要渲染框架的简单场景下应用。
- Vue 的整体
diff 策略与 React 对齐,虽然缺乏时间切片能力,但这并不意味着 Vue 的性能更差,因为在 Vue 3 初期引入过,后期因为收益不高移除掉了。除了高帧率动画,在 Vue 中其他的场景几乎都可以使用防抖和节流去提高响应性能。
**学习原理的目的就是应用。那如何根据 React diff 算法原理优化代码呢?**这个问题其实按优化方式逆向回答即可。
- 根据
diff算法的设计原则,应尽量避免跨层级节点移动。 - 通过设置唯一
key进行优化,尽量减少组件层级深度。因为过深的层级会加深遍历深度,带来性能问题。 - 设置
shouldComponentUpdate或者React.pureComponet减少diff次数。
💬 面试官追问
列表头部插一条消息,没给
key,为什么后面每一行都被更新了?没
key就按位置对应,头部一插,原来第1条现在对着第2条,每个位置的内容都变了。用消息id当key,React就能认出只是多了一个新节点。abcd变成dabc,React会移动几个节点?三个。它记录
lastPlacedIndex,d在旧列表里位置最大,先被确定不动,后面a、b、c的旧位置都比它小,只能一个个往后挪。所以把最后一个挪到最前面,反而是性能最差的情况。卡片从
A列拖到B列,key不变,里面的输入状态能保住吗?保不住,
key只在同一个父节点的兄弟之间起作用,换了父节点就是删旧建新。要么把状态提到外面按卡片id存,要么让卡片始终渲染在同一层,用样式改位置。列表项根节点从
div改成section,上线后表单输入全丢了,为什么?type变了,React直接认为是另一棵树,把旧子树整个卸载、新建一棵,里面所有组件状态都重置。改根节点标签前要想到这一点,尤其是条件渲染里两个分支外层标签不一样的情况。为什么不做完整的跨层树比对,那样能复用更多节点?
完整的树编辑距离是
O(n³),1000个节点就是上亿次比较,比直接重建慢得多。实际页面里跨层移动非常少,React用这点代价换了线性复杂度,真需要跨层保留状态就自己调整结构。
# 12 合成事件原理
⚡ 30 秒速记
React不给每个元素绑监听,而是在根上统一监听再分发:React 17起挂在root容器,16及以前挂document- 原生事件到根上后,
React找到目标Fiber,沿树收集onClick等处理函数,包一个SyntheticEvent模拟捕获和冒泡 - 好处:抹平浏览器差异、监听器少、能给不同事件分优先级
- 和原生事件混用:元素上的原生监听先触发;
React里e.stopPropagation()拦不住已经执行过的原生监听 17起去掉事件池,异步里读e.target不用再e.persist();onScroll也不再冒泡
合成事件就是 React 自己搞的一套事件代理:只在根节点上监听,事件冒到根上再按组件树分发给你写的 onClick。 好处一是兼容性,你拿到的 SyntheticEvent 在各浏览器表现一致;二是不用给一千个按钮各绑一个监听。版本差异要说:16 绑在 document 上,页面里嵌两个 React 应用就会互相打架,17 改成绑在各自的 root 容器上。混用原生监听时要清楚,原生事件冒泡是真实发生的,React 的那一套是到了根上才模拟出来的。
为了解决跨浏览器兼容性问题,
React会将浏览器原生事件(Browser Native Event)封装为合成事件(SyntheticEvent)传入设置的事件处理器中。这里的合成事件提供了与原生事件相同的接口,不过它们屏蔽了底层浏览器的细节差异,保证了行为的一致性。另外有意思的是,React并没有直接将事件附着到子元素上,而是以单一事件监听器的方式将所有的事件发送到顶层进行处理。这样React在更新DOM的时候就不需要考虑如何去处理附着在DOM上的事件监听器,最终达到优化性能的目的
- 所有的事件挂在document上,DOM 事件触发后冒泡到 document;React 找到对应的组件,造出一个合成事件出来;并按组件树模拟一遍事件冒泡。
- event不是原生的,是SyntheticEvent合成事件对象
- 和Vue事件不同,和DOM事件也不同
React 17 之前的事件冒泡流程图
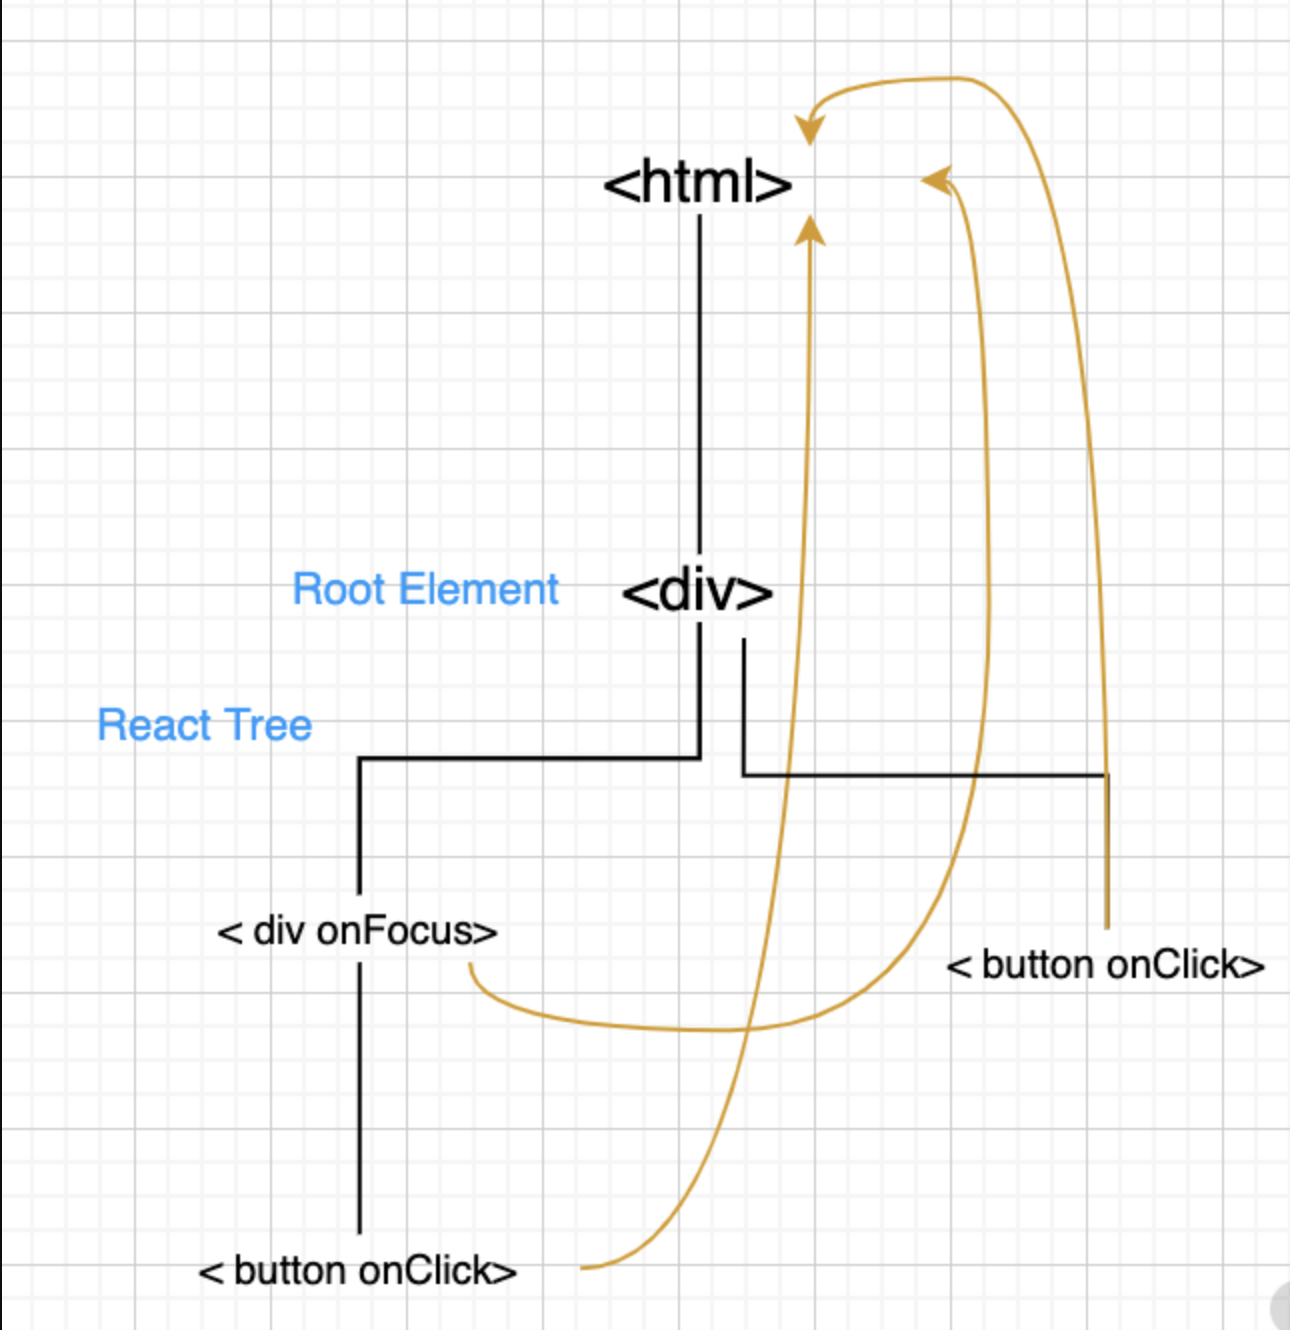
所以这就造成了,在一个页面中,只能有一个版本的 React。如果有多个版本,事件就乱套了。值得一提的是,这个问题在 React 17 中得到了解决,事件委托不再挂在 document 上,而是挂在 DOM 容器上,也就是
ReactDom.Render所调用的节点上。
React 17 后的事件冒泡流程图
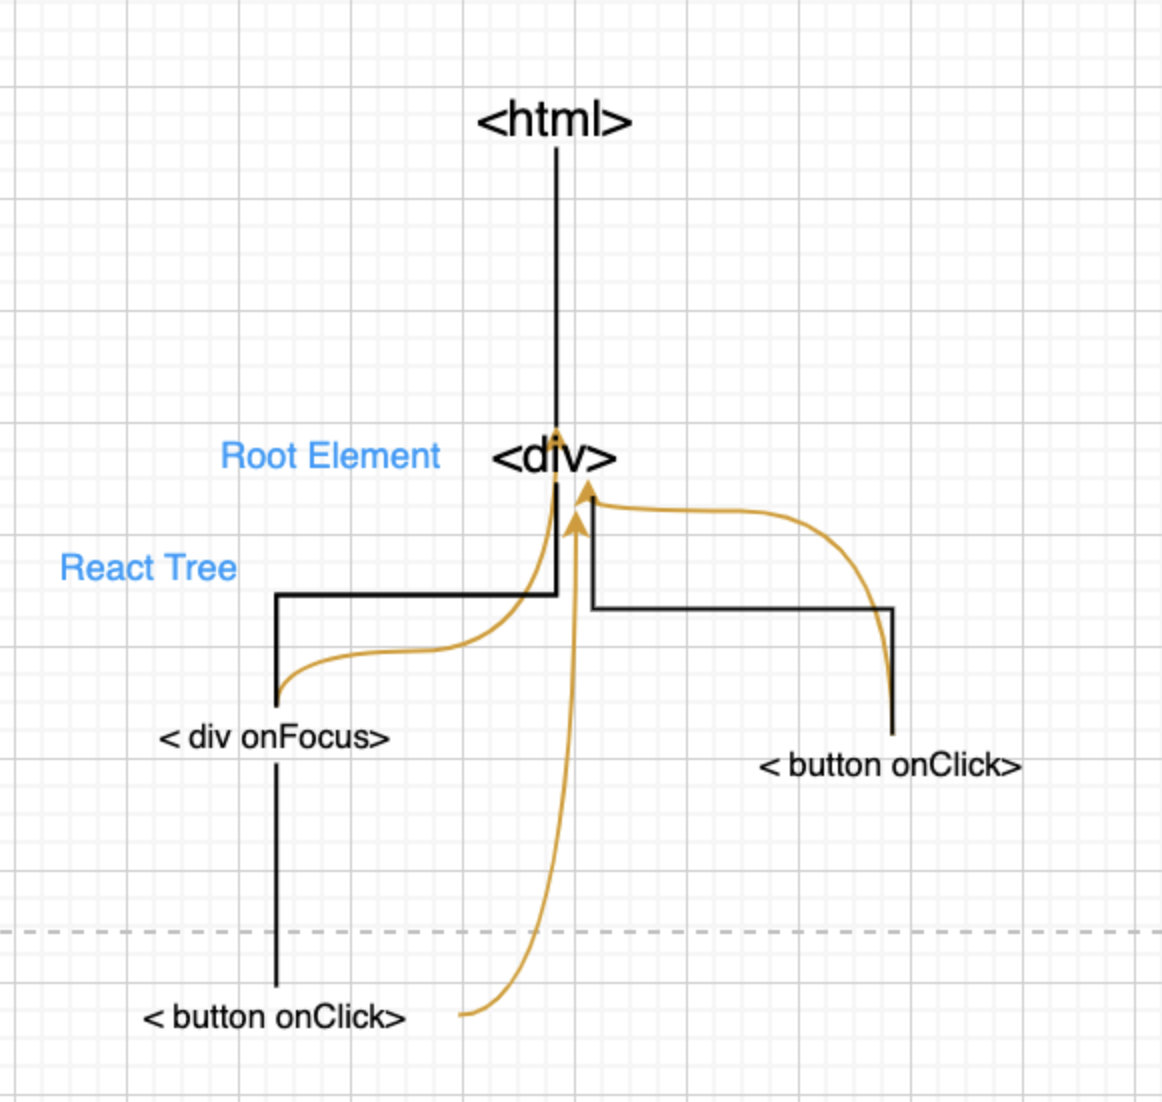
那到底哪些事件会被捕获生成合成事件呢?可以从 React 的源码测试文件中一探究竟。下面的测试快照中罗列了大量的事件名,也只有在这份快照中的事件,才会被捕获生成合成事件。
// react/packages/react-dom/src/__tests__/__snapshots__/ReactTestUtils-test.js.snap
Array [
"abort",
"animationEnd",
"animationIteration",
"animationStart",
"auxClick",
"beforeInput",
"blur",
"canPlay",
"canPlayThrough",
"cancel",
"change",
"click",
"close",
"compositionEnd",
"compositionStart",
"compositionUpdate",
"contextMenu",
"copy",
"cut",
"doubleClick",
"drag",
"dragEnd",
"dragEnter",
"dragExit",
"dragLeave",
"dragOver",
"dragStart",
"drop",
"durationChange",
"emptied",
"encrypted",
"ended",
"error",
"focus",
"gotPointerCapture",
"input",
"invalid",
"keyDown",
"keyPress",
"keyUp",
"load",
"loadStart",
"loadedData",
"loadedMetadata",
"lostPointerCapture",
"mouseDown",
"mouseEnter",
"mouseLeave",
"mouseMove",
"mouseOut",
"mouseOver",
"mouseUp",
"paste",
"pause",
"play",
"playing",
"pointerCancel",
"pointerDown",
"pointerEnter",
"pointerLeave",
"pointerMove",
"pointerOut",
"pointerOver",
"pointerUp",
"progress",
"rateChange",
"reset",
"scroll",
"seeked",
"seeking",
"select",
"stalled",
"submit",
"suspend",
"timeUpdate",
"toggle",
"touchCancel",
"touchEnd",
"touchMove",
"touchStart",
"transitionEnd",
"volumeChange",
"waiting",
"wheel",
]
如果DOM上绑定了过多的事件处理函数,整个页面响应以及内存占用可能都会受到影响。React为了避免这类DOM事件滥用,同时屏蔽底层不同浏览器之间的事件系统的差异,实现了一个中间层 - SyntheticEvent
- 当用户在为onClick添加函数时,React并没有将Click绑定到DOM上面
- 而是在document处监听所有支持的事件,当事件发生并冒泡至document处时,React将事件内容封装交给中间层 SyntheticEvent (负责所有事件合成)
- 所以当事件触发的时候, 对使用统一的分发函数 dispatchEvent 将指定函数执行
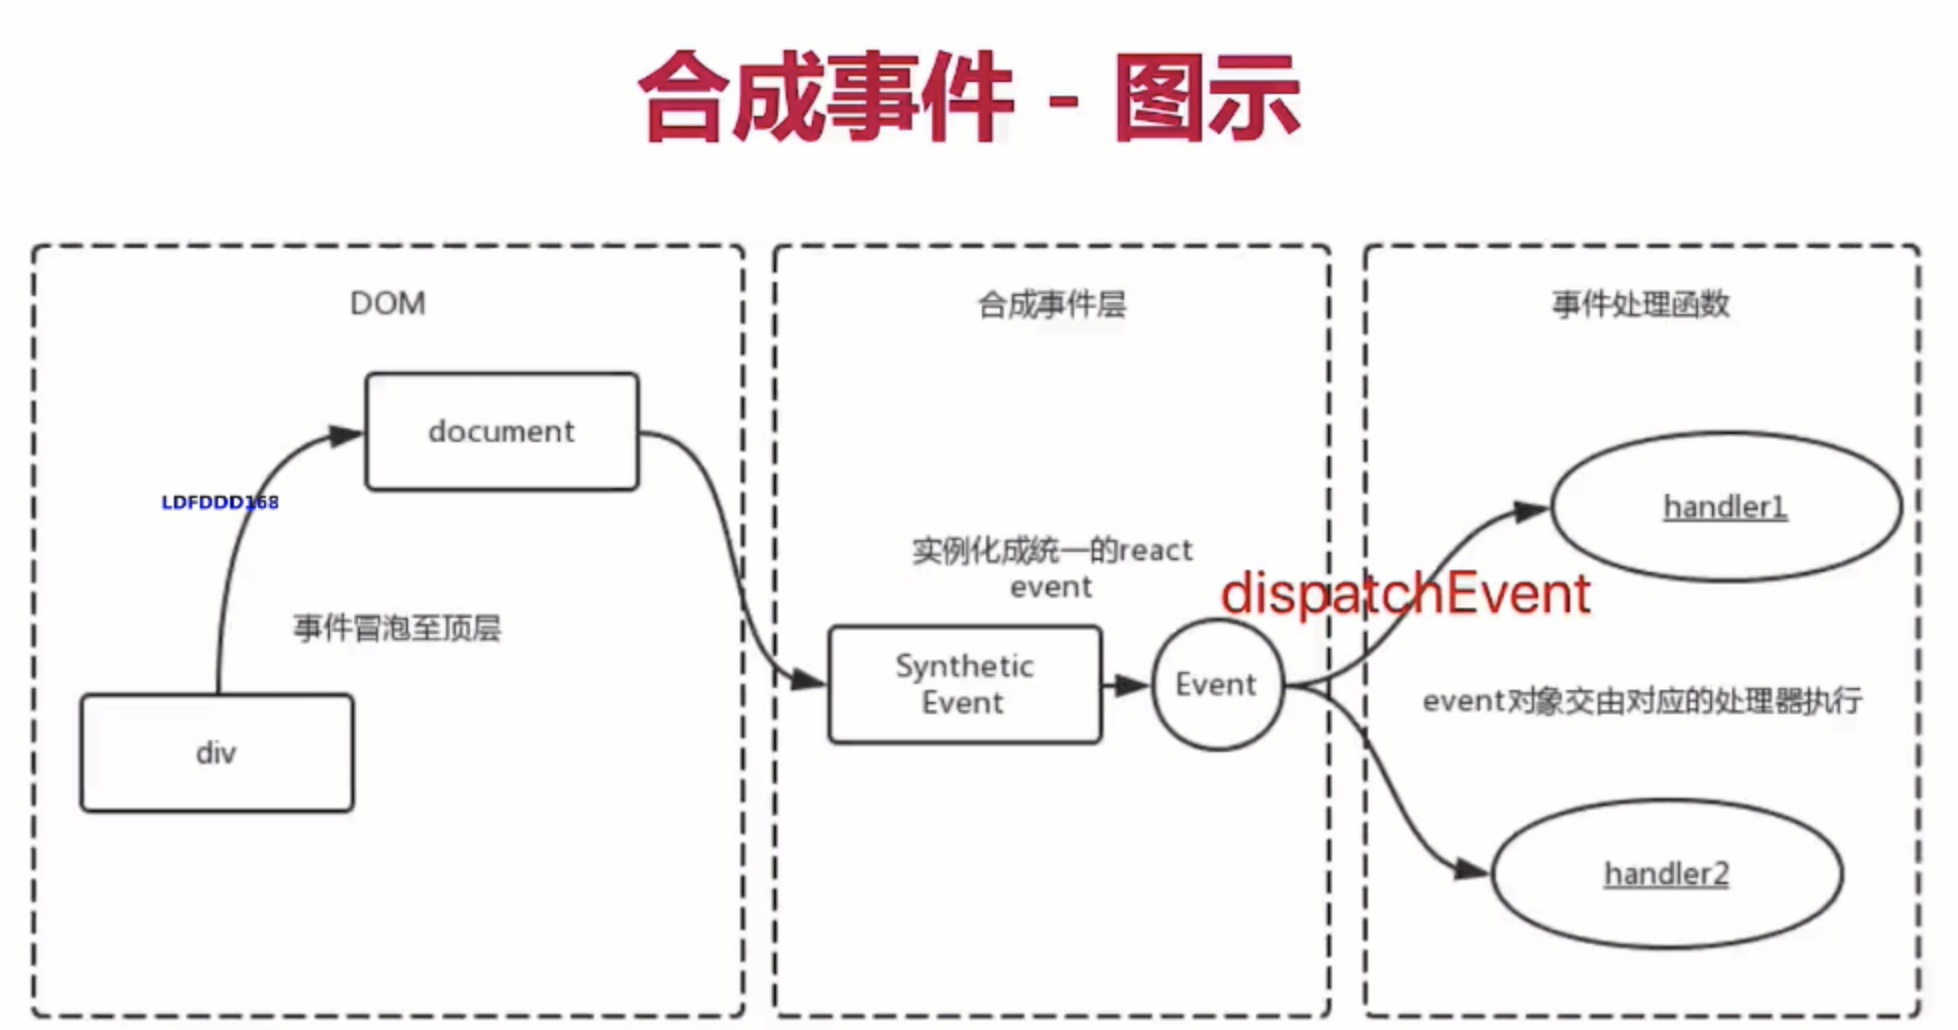
为何要合成事件
- 兼容性和跨平台
- 挂在统一的document上,减少内存消耗,避免频繁解绑
- 方便事件的统一管理(事务机制)
- dispatchEvent事件机制
💬 面试官追问
一千个按钮各写了
onClick,页面上有一千个原生监听吗?没有。
React在根容器上每种事件只绑一次,点击冒泡到根时,它从event.target对应的Fiber往上收集处理函数挨个调用。React 17把事件从document挪到root,解决了什么问题?解决了多个
React应用或多个版本共存时的冲突,比如微前端。以前大家都挂document,一个应用stopPropagation会影响另一个;现在各管各的容器,也方便和外部jQuery代码共处。React里点了e.stopPropagation(),document上的原生监听还会触发吗?17起不会,因为React在root上就调用了原生的stopPropagation,事件到不了document。16里会,因为React本身就绑在document上,事件早就冒到了。组件里自己
addEventListener('click'),和onClick谁先执行?绑在元素上的原生监听先执行,因为
React要等事件冒泡到root才开始分发。在原生监听里stopPropagation,React的onClick就收不到了。setTimeout里读e.target是null,这是什么问题?React 16及以前的事件池问题:处理函数跑完,事件对象会被清空复用。当时要先e.persist()或者先把值存到变量里;17起去掉了事件池,就不会再遇到了。
# 13 JSX语法糖本质
⚡ 30 秒速记
JSX不是模板,是JS的语法扩展,编译期就变成函数调用- 旧转换:
<div />→React.createElement('div'),所以文件里必须import React React 17起新转换:编译成jsx()/jsxs(),自动从react/jsx-runtime引入- 大写开头当组件变量,小写开头当原生标签字符串,这是编译器约定
- 结果是一个普通对象(
ReactElement),条件、循环直接用JS,不需要v-if/v-for
JSX 是语法糖,Babel 或 TypeScript 在编译时把它变成函数调用,浏览器从来没见过 JSX。 <UserCard name="Ada" /> 编译后就是 jsx(UserCard, { name: 'Ada' }),老的转换是 React.createElement,执行结果是个描述节点的普通对象。这也解释了为什么组件名必须大写:小写会被编译成字符串 'usercard',当成原生标签处理。React 17 之后用新转换,不用每个文件都 import React,旧项目删掉那行之前要确认构建配置开了 runtime: 'automatic'。
JSX是语法糖,通过babel转成
React.createElement函数,在babel官网上可以在线把JSX转成React的JS语法
- 首先解析出来的话,就是一个
createElement函数 - 然后这个函数执行完后,会返回一个
vnode - 通过vdom的patch或者是其他的一个方法,最后渲染一个页面

script标签中不添加
text/babel解析jsx语法的情况下
<script>
const ele = React.createElement("h2", null, "Hello React!");
// 历史写法:React 18 起用 ReactDOM.createRoot(...).render(ele),React 19 已移除 ReactDOM.render
ReactDOM.render(ele, document.getElementById("app"));
</script>
JSX的本质是React.createElement()函数
createElement函数返回的对象是ReactEelement对象。
createElement的写法如下
class App extends React.Component {
constructor() {
super()
this.state = {}
}
render() {
return React.createElement("div", null,
/*第一个子元素,header*/
React.createElement("div", { className: "header" },
React.createElement("h1", { title: "\u6807\u9898" }, "\u6211\u662F\u6807\u9898")
),
/*第二个子元素,content*/
React.createElement("div", { className: "content" },
React.createElement("h2", null, "\u6211\u662F\u9875\u9762\u7684\u5185\u5BB9"),
React.createElement("button", null, "\u6309\u94AE"),
React.createElement("button", null, "+1"),
React.createElement("a", { href: "http://www.baidu.com" },
"\u767E\u5EA6\u4E00\u4E0B")
),
/*第三个子元素,footer*/
React.createElement("div", { className: "footer" },
React.createElement("p", null, "\u6211\u662F\u5C3E\u90E8\u7684\u5185\u5BB9")
)
);
}
}
// 历史写法:React 18 起用 ReactDOM.createRoot(document.getElementById("app")).render(<App />)
ReactDOM.render(<App />, document.getElementById("app"));
实际开发中不会使用createElement来创建ReactElement的,一般都是使用JSX的形式开发。
ReactElement在程序中打印一下
render() {
let ele = (
<div>
<div className="header">
<h1 title="标题">我是标题</h1>
</div>
<div className="content">
<h2>我是页面的内容</h2>
<button>按钮</button>
<button>+1</button>
<a href="http://www.baidu.com">百度一下</a>
</div>
<div className="footer">
<p>我是尾部的内容</p>
</div>
</div>
)
console.log(ele);
return ele;
}
react通过babel把JSX转成
createElement函数,生成ReactElement对象,然后通过ReactDOM.render函数把ReactElement渲染成真实的DOM元素
为什么 React 使用 JSX
- 在回答问题之前,我首先解释下什么是 JSX 吧。JSX 是一个
JavaScript的语法扩展,结构类似 XML。 - JSX 主要用于声明
React元素,但 React 中并不强制使用JSX。即使使用了JSX,也会在构建过程中,通过 Babel 插件编译为React.createElement。所以 JSX 更像是React.createElement的一种语法糖 - 接下来与 JSX 以外的三种技术方案进行对比
- 首先是模板,React 团队认为模板不应该是开发过程中的关注点,因为引入了模板语法、模板指令等概念,是一种不佳的实现方案
- 其次是模板字符串,模板字符串编写的结构会造成多次内部嵌套,使整个结构变得复杂,并且优化代码提示也会变得困难重重
- 所以 React 最后选用了 JSX,因为 JSX 与其设计思想贴合,不需要引入过多新的概念,对编辑器的代码提示也极为友好。
Babel 插件如何实现 JSX 到 JS 的编译? 在 React 面试中,这个问题很容易被追问,也经常被要求手写。
它的实现原理是这样的。Babel 读取代码并解析,生成 AST,再将 AST 传入插件层进行转换,在转换时就可以将 JSX 的结构转换为 React.createElement 的函数。如下代码所示:
module.exports = function (babel) {
var t = babel.types;
return {
name: "custom-jsx-plugin",
visitor: {
JSXElement(path) {
var openingElement = path.node.openingElement;
var tagName = openingElement.name.name;
var args = [];
args.push(t.stringLiteral(tagName));
var attribs = t.nullLiteral();
args.push(attribs);
var reactIdentifier = t.identifier("React"); //object
var createElementIdentifier = t.identifier("createElement");
var callee = t.memberExpression(reactIdentifier, createElementIdentifier)
var callExpression = t.callExpression(callee, args);
callExpression.arguments = callExpression.arguments.concat(path.node.children);
path.replaceWith(callExpression, path.node);
},
},
};
};
React.createElement源码分析
/**
101. React的创建元素方法
*/
export function createElement(type, config, children) {
// propName 变量用于储存后面需要用到的元素属性
let propName;
// props 变量用于储存元素属性的键值对集合
const props = {};
// key、ref、self、source 均为 React 元素的属性,此处不必深究
let key = null;
let ref = null;
let self = null;
let source = null;
// config 对象中存储的是元素的属性
if (config != null) {
// 进来之后做的第一件事,是依次对 ref、key、self 和 source 属性赋值
if (hasValidRef(config)) {
ref = config.ref;
}
// 此处将 key 值字符串化
if (hasValidKey(config)) {
key = '' + config.key;
}
self = config.__self === undefined ? null : config.__self;
source = config.__source === undefined ? null : config.__source;
// 接着就是要把 config 里面的属性都一个一个挪到 props 这个之前声明好的对象里面
for (propName in config) {
if (
// 筛选出可以提进 props 对象里的属性
hasOwnProperty.call(config, propName) &&
!RESERVED_PROPS.hasOwnProperty(propName)
) {
props[propName] = config[propName];
}
}
}
// childrenLength 指的是当前元素的子元素的个数,减去的 2 是 type 和 config 两个参数占用的长度
const childrenLength = arguments.length - 2;
// 如果抛去type和config,就只剩下一个参数,一般意味着文本节点出现了
if (childrenLength === 1) {
// 直接把这个参数的值赋给props.children
props.children = children;
// 处理嵌套多个子元素的情况
} else if (childrenLength > 1) {
// 声明一个子元素数组
const childArray = Array(childrenLength);
// 把子元素推进数组里
for (let i = 0; i < childrenLength; i++) {
childArray[i] = arguments[i + 2];
}
// 最后把这个数组赋值给props.children
props.children = childArray;
}
// 处理 defaultProps(React 16/17 源码逻辑,属历史对照)
// React 19 已移除函数组件的 defaultProps,改用函数默认参数;类组件的 defaultProps 仍可用
if (type && type.defaultProps) {
const defaultProps = type.defaultProps;
for (propName in defaultProps) {
if (props[propName] === undefined) {
props[propName] = defaultProps[propName];
}
}
}
// 最后返回一个调用ReactElement执行方法,并传入刚才处理过的参数
return ReactElement(
type,
key,
ref,
self,
source,
ReactCurrentOwner.current,
props,
);
}
入参解读:创造一个元素需要知道哪些信息
export function createElement(type, config, children)
createElement 有 3 个入参,这 3 个入参囊括了 React 创建一个元素所需要知道的全部信息。
type:用于标识节点的类型。它可以是类似“h1”“div”这样的标准 HTML 标签字符串,也可以是 React 组件类型或React fragment类型。config:以对象形式传入,组件所有的属性都会以键值对的形式存储在 config 对象中。children:以对象形式传入,它记录的是组件标签之间嵌套的内容,也就是所谓的“子节点”“子元素”
React.createElement("ul", {
// 传入属性键值对
className: "list"
// 从第三个入参开始往后,传入的参数都是 children
}, React.createElement("li", {
key: "1"
}, "1"), React.createElement("li", {
key: "2"
}, "2"));
这个调用对应的 DOM 结构如下:
<ul className="list">
<li key="1">1</li>
<li key="2">2</li>
</ul>
createElement 函数体拆解
createElement 中并没有十分复杂的涉及算法或真实 DOM 的逻辑,它的每一个步骤几乎都是在格式化数据。
现在看来,
createElement原来只是个“参数中介”。此时我们的注意力自然而然地就聚焦在了ReactElement上
出参解读:初识虚拟 DOM
createElement执行到最后会 return 一个针对 ReactElement 的调用。这里关于 ReactElement,我依然先给出源码 + 注释形式的解析
const ReactElement = function(type, key, ref, self, source, owner, props) {
const element = {
// REACT_ELEMENT_TYPE是一个常量,用来标识该对象是一个ReactElement
$$typeof: REACT_ELEMENT_TYPE,
// 内置属性赋值
type: type,
key: key,
ref: ref,
props: props,
// 记录创造该元素的组件
_owner: owner,
};
//
if (__DEV__) {
// 这里是一些针对 __DEV__ 环境下的处理,对于大家理解主要逻辑意义不大,此处我直接省略掉,以免混淆视听
}
return element;
};
ReactElement其实只做了一件事情,那就是“创建”,说得更精确一点,是“组装”:ReactElement把传入的参数按照一定的规范,“组装”进了element对象里,并把它返回给了eact.createElement,最终React.createElement又把它交回到了开发者手中
const AppJSX = (<div className="App">
<h1 className="title">I am the title</h1>
<p className="content">I am the content</p>
</div>)
console.log(AppJSX)
你会发现它确实是一个标准的 ReactElement 对象实例
这个 ReactElement 对象实例,本质上是以 JavaScript 对象形式存在的对 DOM 的描述,也就是老生常谈的“虚拟 DOM”(准确地说,是虚拟 DOM 中的一个节点)
💬 面试官追问
有人说
<UserCard />会在浏览器里创建一个UserCard标签,怎么反驳?看编译产物就知道了:
jsx(UserCard, {}),第一个参数是组件函数本身,不是字符串。React渲染时会调用这个函数,拿到它返回的元素继续往下展开,最终只有原生标签进DOM。组件名写成小写
<userCard />,会发生什么?编译器会把它当原生标签,生成
jsx('userCard', {}),页面上出现一个不认识的<usercard>标签,开发环境还会报警告。组件名必须大写开头。删掉文件顶部的
import React之后报React is not defined,为什么?构建还在用旧的
classic转换,编译结果里有React.createElement,自然要React这个变量。把Babel的preset-react配成runtime: 'automatic',或者tsconfig里设"jsx": "react-jsx"。JSX里为什么不能直接写if,只能用三元或&&?JSX的大括号里只能放表达式,因为它会变成函数参数,而if是语句。复杂条件就在return之前用if算好一个变量再塞进去。{count && <Badge />}在count为0时页面上显示了一个0,为什么?0 && x的结果是0,而React会把数字0当文本渲染出来,false、null、undefined才会被忽略。改成{count > 0 && <Badge />}。
# 14 为什么 React 元素有一个 $$typeof 属性
⚡ 30 秒速记
$$typeof是一个Symbol(Symbol.for('react.element'),React 19起是react.transitional.element),标记「这是React自己创建的元素」- 目的是防
XSS:防止后端返回的JSON被当成元素渲染 - 关键点:
Symbol不能被JSON序列化,接口里来的对象不可能带上真的$$typeof - 老版本在不支持
Symbol的环境里降级成数字0xeac7 - 它只防「伪造元素」,
dangerouslySetInnerHTML、javascript:链接这些照样要自己管
$$typeof 是元素的身份证,用来防止一个普通 JSON 对象冒充 React 元素。 场景是这样的:后端本该返回一段文本,结果被攻击者存进了一个 { type: 'div', props: { dangerouslySetInnerHTML: ... } },你写 {message.text},老版本的 React 会把它当元素渲染,脚本就进页面了。加了 $$typeof 之后,因为 Symbol 没法通过 JSON 传输,接口来的对象一定没有这个标记,React 会直接报错不渲染。答出「Symbol 不能被序列化」这点是关键。
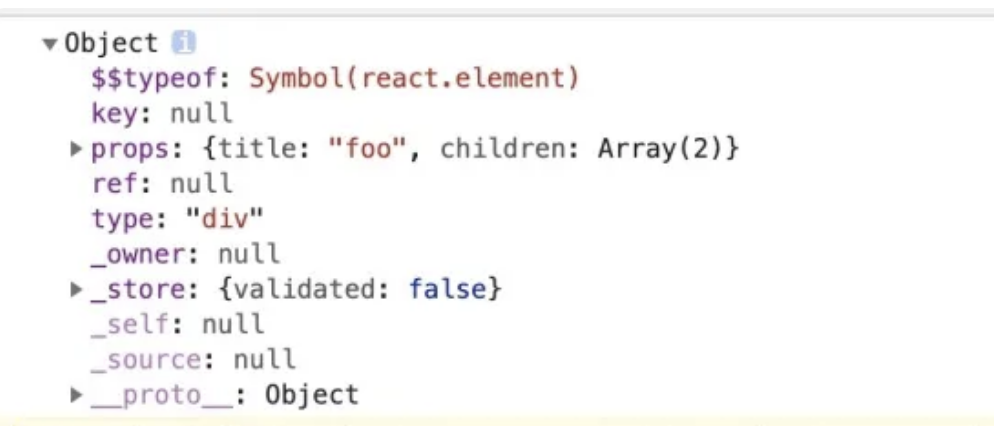
目的是为了防止 XSS 攻击。因为 Synbol 无法被序列化,所以 React 可以通过有没有 $$typeof 属性来断出当前的 element 对象是从数据库来的还是自己生成的。
- 如果没有 $$typeof 这个属性,react 会拒绝处理该元素。
- 在 React 的古老版本中,下面的写法会出现 XSS 攻击:
// 服务端允许用户存储 JSON
let expectedTextButGotJSON = {
type: 'div',
props: {
dangerouslySetInnerHTML: {
__html: '/* 把你想的搁着 */'
},
},
// ...
};
let message = { text: expectedTextButGotJSON };
// React 0.13 中有风险
<p>
{message.text}
</p>
💬 面试官追问
接口本该返回字符串,结果返回了一个带
type、props的对象,塞进{message.text}会怎样?现在的
React会报Objects are not valid as a React child,不会渲染,因为它没有合法的$$typeof。React 0.13那种老版本就真会把它当元素渲染,这正是这个字段要防的。后端在
JSON里放一个字符串"$$typeof"字段,能骗过检查吗?不能,
React比的是Symbol引用,字符串永远不相等。除非前端自己反序列化时把它转成真的Symbol,那就是自己把门打开了,千万别这么写。有
$$typeof了,富文本页面还是被注入了脚本,从哪查起?先搜
dangerouslySetInnerHTML,它会原样插入HTML,$$typeof管不到;再看<a href={url}>有没有放过javascript:协议。富文本要用DOMPurify这类库净化后再插。为什么不用检查对象有没有
type、props字段来判断是不是元素?形状谁都能伪造,攻击者完全可以构造出字段一模一样的
JSON。Symbol的特点是只能在JS运行时里创建,网络上传不过来,这才能区分「前端自己造的」和「外面传进来的」。
# 15 Virtual DOM 的工作原理是什么
⚡ 30 秒速记
- 三步:用
JS对象描述界面 → 状态变了生成新树,和旧树diff→ 把差异patch到真实DOM - 节点就是普通对象:
{ type, props, children },diff只比同层、靠key认身份 - 真正的价值是声明式:你只描述结果,
DOM操作交给框架,不容易写出低级错误 - 抽象层顺带带来跨端能力:
SSR输出字符串、React Native调原生组件 - 它不保证比手写
DOM快,节点极多、更新极频繁时,创建和比对对象本身就是开销
虚拟 DOM 就是用普通 JS 对象描述一份界面,状态变了就重新描述一份,比出差异再去改真实 DOM。 好比装修前先画两张图纸对比,只拆改不一样的地方,而不是整屋推倒重来。很多人说它「比 DOM 快」,这话不准确:手写精确的 DOM 操作一定更快,它保证的是你不用手写也不会太慢。它真正的价值在两点:一是写代码只管声明状态,二是描述和平台解耦,同一套组件能在服务端渲染成 HTML,也能交给 React Native 变成原生控件。
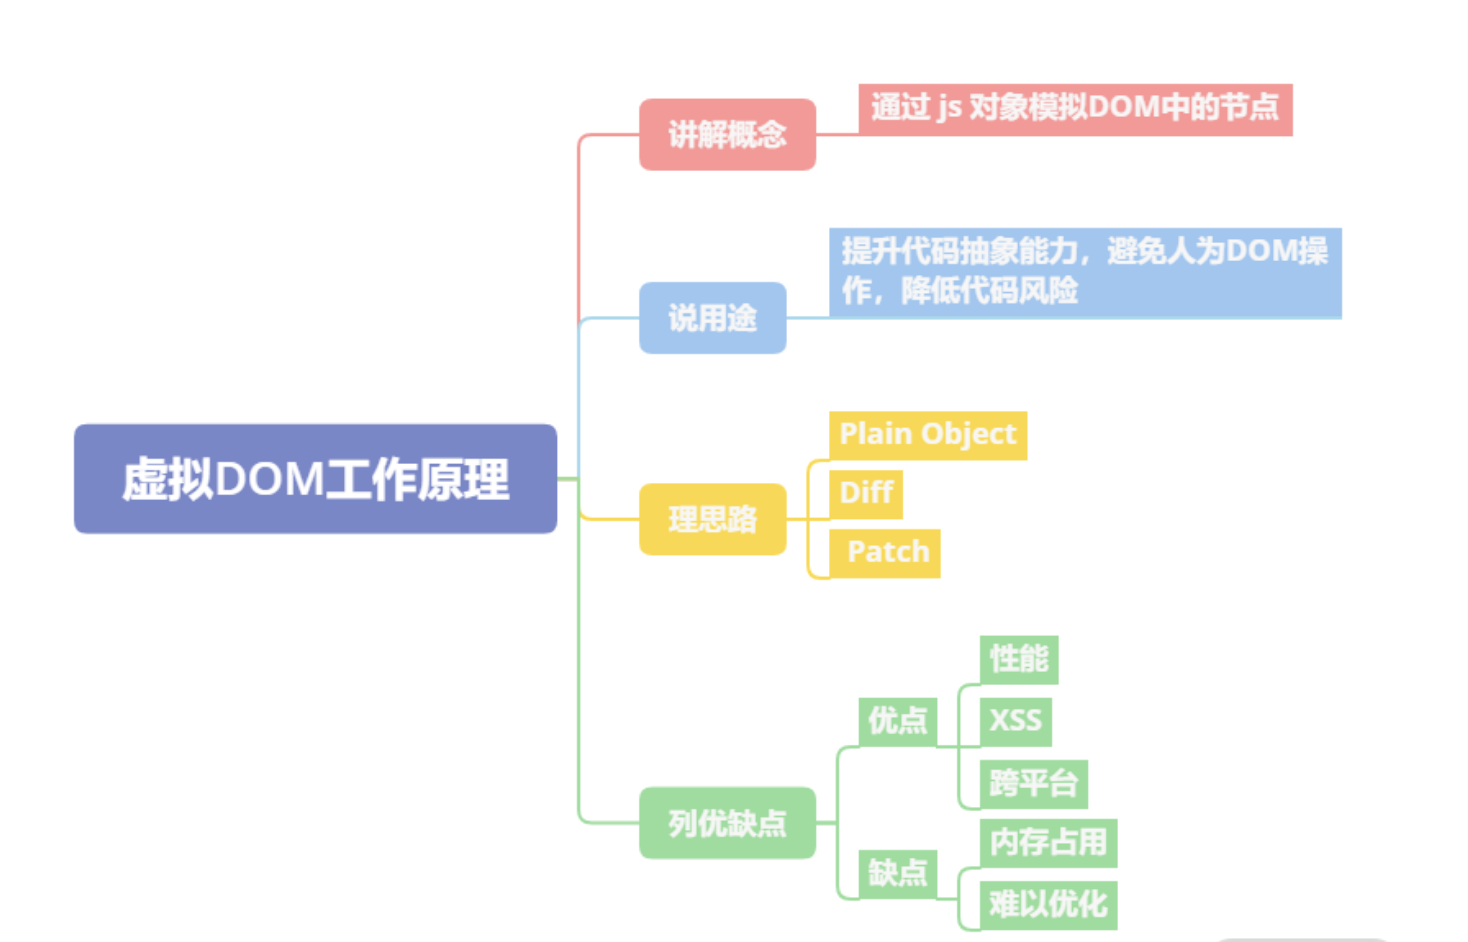
- 虚拟 DOM 的工作原理是
通过 JS 对象模拟 DOM 的节点。在 Facebook 构建 React 初期时,考虑到要提升代码抽象能力、避免人为的 DOM 操作、降低代码整体风险等因素,所以引入了虚拟 DOM - 虚拟 DOM 在实现上通常是
Plain Object,以 React 为例,在render函数中写的JSX会在Babel插件的作用下,编译为React.createElement执行JSX中的属性参数 React.createElement执行后会返回一个Plain Object,它会描述自己的tag类型、props属性以及children情况等。这些Plain Object通过树形结构组成一棵虚拟DOM树。当状态发生变更时,将变更前后的虚拟DOM树进行差异比较,这个过程称为diff,生成的结果称为patch。计算之后,会渲染Patch完成对真实DOM的操作。- 虚拟 DOM 的优点主要有三点:
改善大规模DOM操作的性能、规避 XSS 风险、能以较低的成本实现跨平台开发。 - 虚拟 DOM 的缺点在社区中主要有两点
- 内存占用较高,因为需要模拟整个网页的真实
DOM - 高性能应用场景存在难以优化的情况,类似像 Google Earth 一类的高性能前端应用在技术选型上往往不会选择 React
- 内存占用较高,因为需要模拟整个网页的真实
除了渲染页面,虚拟 DOM 还有哪些应用场景?
这个问题考验面试者的想象力。通常而言,我们只是将虚拟 DOM 与渲染绑定在一起,但实际上虚拟 DOM 的应用更为广阔。比如,只要你记录了真实 DOM 变更,它甚至可以应用于埋点统计与数据记录等。
SSR原理
借助虚拟dom,服务器中没有dom概念的,react巧妙的借助虚拟dom,然后可以在服务器中nodejs可以运行起来react代码。
💬 面试官追问
只更新购物车角标,有人说虚拟
DOM会把整页重建一遍,对吗?不对。重新生成的是一份
JS对象描述,比对之后只有角标那个文本节点会被真正修改。整页重建的是对象,不是DOM。虚拟
DOM一定比直接操作DOM快吗?不一定。它多了一层「生成对象 + 比对」,单论一次精确更新肯定比
el.textContent = x慢。它省的是你手写一堆零散DOM操作时引发的反复回流,和维护成本。地图页面节点几万个,
Profiler里比对很重、DOM改得却不多,怎么办?瓶颈在虚拟
DOM本身。先缩小参与更新的范围,用memo跳过不变的部分;还不行就把这块交给canvas或WebGL直接画,React只管外围控件。服务端没有
DOM,为什么还能跑React生成首屏?组件产出的是和平台无关的对象,服务端用
renderToString或流式的renderToPipeableStream把对象拼成HTML字符串就行。到了浏览器再用hydrateRoot接管,绑定事件。Svelte、Solid不用虚拟DOM,那它还有必要吗?它们走编译期分析和细粒度响应式,状态变了直接定位到要改的节点,确实省掉了比对。虚拟
DOM的优势在运行时灵活和跨平台,React选它是取舍,不是因为没别的路。
# 16 React有哪些优化性能的手段
⚡ 30 秒速记
- 先定位再优化:
React DevTools的Profiler看谁在重渲染、花了多久 - 少渲染:
React.memo/PureComponent跳组件,useMemo缓存值,useCallback稳定函数引用,三者配合才生效 - 结构优先:状态下沉到用的地方、不变的部分当
children传进来,比加memo更治本 - 列表:稳定的业务
id当key,长列表上虚拟滚动;路由和低频模块用lazy+Suspense拆包 React 18并发特性:useTransition/useDeferredValue让大列表更新不挡输入;React Compiler能自动做记忆化
React 优化就两件事:让不该渲染的组件别渲染,让暂时用不到的代码晚点加载。 我一般先开 Profiler 看是谁在重渲染,而不是一上来全套 memo。很多问题从结构上就能解决,比如输入框的 state 放在大组件顶层,每敲一个字整页都 render,把它挪到一个小组件里就好了。React.memo 要配合稳定的 props 才有用,父组件每次传新数组、新函数,包了等于没包。大列表输入卡顿用 useDeferredValue,首屏包大就路由级 lazy 拆包。
类组件中的优化手段
- 使用纯组件
PureComponent作为基类。 - 使用
shouldComponentUpdate生命周期函数来自定义渲染逻辑。
方法组件中的优化手段
- 使用
React.memo高阶函数包装组件,React.memo可以实现类似于shouldComponentUpdate或者PureComponent的效果 - 使用
useMemo- 使用
React.useMemo精细化的管控,useMemo 控制的则是是否需要重复执行某一段逻辑,而React.memo 控制是否需要重渲染一个组件
- 使用
- 使用
useCallBack。
其他方式
- 在列表需要频繁变动时,使用唯一 id 作为 key,而不是数组下标。
- 必要时通过改变 CSS 样式隐藏显示组件,而不是通过条件判断显示隐藏组件。
- 使用
Suspense和 lazy 进行懒加载,例如:
import React, { lazy, Suspense } from "react";
export default class CallingLazyComponents extends React.Component {
render() {
var ComponentToLazyLoad = null;
if (this.props.name == "Mayank") {
ComponentToLazyLoad = lazy(() => import("./mayankComponent"));
} else if (this.props.name == "Anshul") {
ComponentToLazyLoad = lazy(() => import("./anshulComponent"));
}
return (
<div>
<h1>This is the Base User: {this.state.name}</h1>
<Suspense fallback={<div>Loading...</div>}>
<ComponentToLazyLoad />
</Suspense>
</div>
)
}
}
💬 面试官追问
给所有子组件都包了
React.memo,渲染次数一点没降,为什么?父组件每次渲染都传了新数组或新的箭头函数,浅比较永远不相等。传给
memo组件的对象用useMemo包,函数用useCallback包,三个得配套用。几千行可编辑表格,改一个单元格整表都在渲染,怎么改?
行组件包
React.memo,每行只拿自己那条数据,key用行id;回调用useCallback且只接收行id。行数再多就上react-window这类虚拟列表,只渲染可见的几十行。标签页切走再切回来,要保留里面的输入和滚动位置,怎么做?
别条件卸载,用
CSS隐藏,比如display: none,组件实例和状态都还在。代价是隐藏的组件还占内存、还会跟着状态更新,标签多了要考虑只保留最近几个。React 19.2的<Activity mode="hidden">就是干这个的。key从id改成index后,排序时输入框内容跟着错行了,为什么?排序后
index没变但对应的数据变了,React按key复用了原位置的组件,输入框的内部状态还留在原位置。改回业务id。lazy加载的模块在弱网下失败了,页面直接白屏,漏了什么?漏了错误边界。
Suspense只管加载中的占位,加载失败抛出的错要靠外层错误边界接住,给一个「重新加载」按钮。
# 17 Redux实现原理解析
⚡ 30 秒速记
- 三原则:单一数据源、
state只读、只能通过纯函数reducer改 - 单向数据流:
dispatch(action)→reducer(state, action)返回新state→ 通知所有订阅者 createStore就是一个闭包:存currentState和监听数组,暴露getState/dispatch/subscribe- 中间件 = 包装
dispatch,签名store => next => action,用compose串成洋葱 reducer必须返回新对象,原地改了react-redux的浅比较发现不了;现在官方推荐Redux Toolkit,内置Immer
Redux 的核心就是一个闭包:存着当前 state 和一组监听函数,改数据只有 dispatch 一条路。 dispatch 做的事很简单,调 reducer(state, action) 拿到新 state,再挨个通知订阅者,react-redux 就是订阅者之一。异步请求不能写进 reducer,所以有了中间件:它把 dispatch 一层层包起来,比如 redux-thunk 判断 action 是函数就先执行它。现在新项目我会直接用 Redux Toolkit 的 configureStore 和 createSlice,createStore 已经被官方标成不推荐了。
在 Redux 的整个工作过程中,数据流是严格单向的。这一点一定一定要背下来,面试的时候也一定一定要记得说
为什么要用redux
在
React中,数据在组件中是单向流动的,数据从一个方向父组件流向子组件(通过props),所以,两个非父子组件之间通信就相对麻烦,redux的出现就是为了解决state里面的数据问题
Redux设计理念
Redux是将整个应用状态存储到一个地方上称为store,里面保存着一个状态树store tree,组件可以派发(dispatch)行为(action)给store,而不是直接通知其他组件,组件内部通过订阅store中的状态state来刷新自己的视图
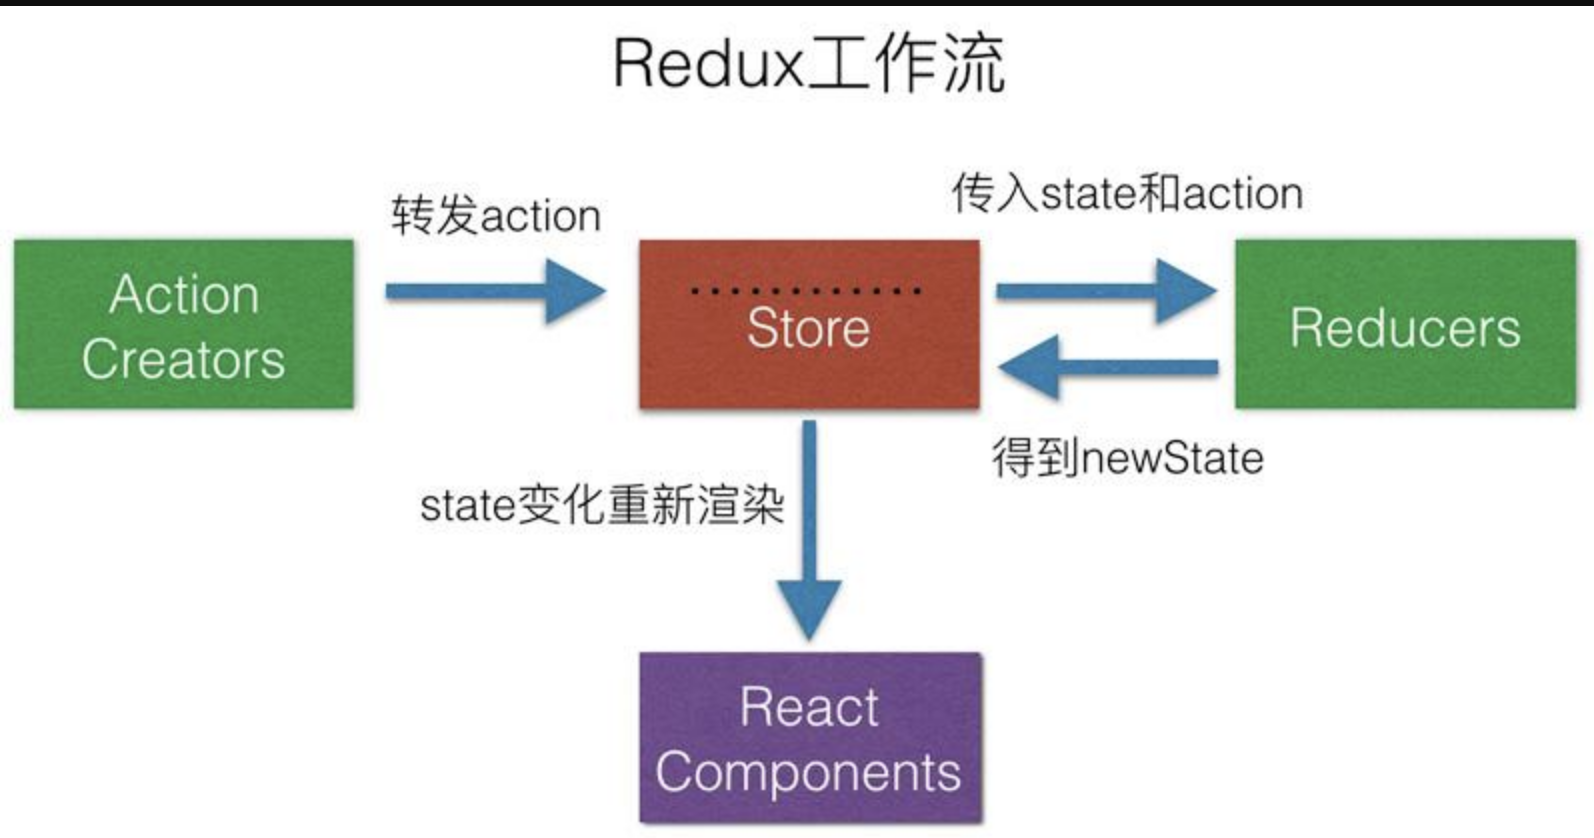
如果你想对数据进行修改,
只有一种途径:派发 action。action 会被 reducer 读取,进而根据 action 内容的不同对数据进行修改、生成新的 state(状态),这个新的 state 会更新到 store 对象里,进而驱动视图层面做出对应的改变。
Redux三大原则
- 唯一数据源
整个应用的state都被存储到一个状态树里面,并且这个状态树,只存在于唯一的store中
- 保持只读状态
state是只读的,唯一改变state的方法就是触发action,action是一个用于描述以发生时间的普通对象
- 数据改变只能通过纯函数来执行
使用纯函数来执行修改,为了描述
action如何改变state的,你需要编写reducers
从编码的角度理解 Redux 工作流
- 使用
createStore 来完成 store 对象的创建
// 引入 redux
import { createStore } from 'redux'
// 创建 store
const store = createStore(
reducer,
initial_state,
applyMiddleware(middleware1, middleware2, ...)
);
createStore 方法是一切的开始,它接收三个入参:
- reducer;
- 初始状态内容;
- 指定中间件
reducer 的作用是将新的 state 返回给 store
一个 reducer 一定是一个纯函数,它可以有各种各样的内在逻辑,但它最终一定要返回一个 state:
const reducer = (state, action) => {
// 此处是各种样的 state处理逻辑
return new_state
}
当我们基于某个 reducer 去创建 store 的时候,其实就是给这个 store 指定了一套更新规则:
// 更新规则全都写在 reducer 里
const store = createStore(reducer)
- action 的作用是通知 reducer “让改变发生”
要想让 state 发生改变,就必须用正确的 action 来驱动这个改变。
const action = {
type: "ADD_ITEM",
payload: '<li>text</li>'
}
action 对象中允许传入的属性有多个,但只有 type 是必传的。type 是 action 的唯一标识,reducer 正是通过不同的 type 来识别出需要更新的不同的 state,由此才能够实现精准的“定向更新”。
- 派发 action,靠的是 dispatch
action 本身只是一个对象,要想让 reducer 感知到 action,还需要“派发 action”这个动作,这个动作是由 store.dispatch 完成的。这里我简单地示范一下:
import { createStore } from 'redux'
// 创建 reducer
const reducer = (state, action) => {
// 此处是各种样的 state处理逻辑
return new_state
}
// 基于 reducer 创建 state
const store = createStore(reducer)
// 创建一个 action,这个 action 用 “ADD_ITEM” 来标识
const action = {
type: "ADD_ITEM",
payload: '<li>text</li>'
}
// 使用 dispatch 派发 action,action 会进入到 reducer 里触发对应的更新
store.dispatch(action)
以上这段代码,是从编码角度对 Redux 主要工作流的概括,这里我同样为你总结了一张对应的流程图:
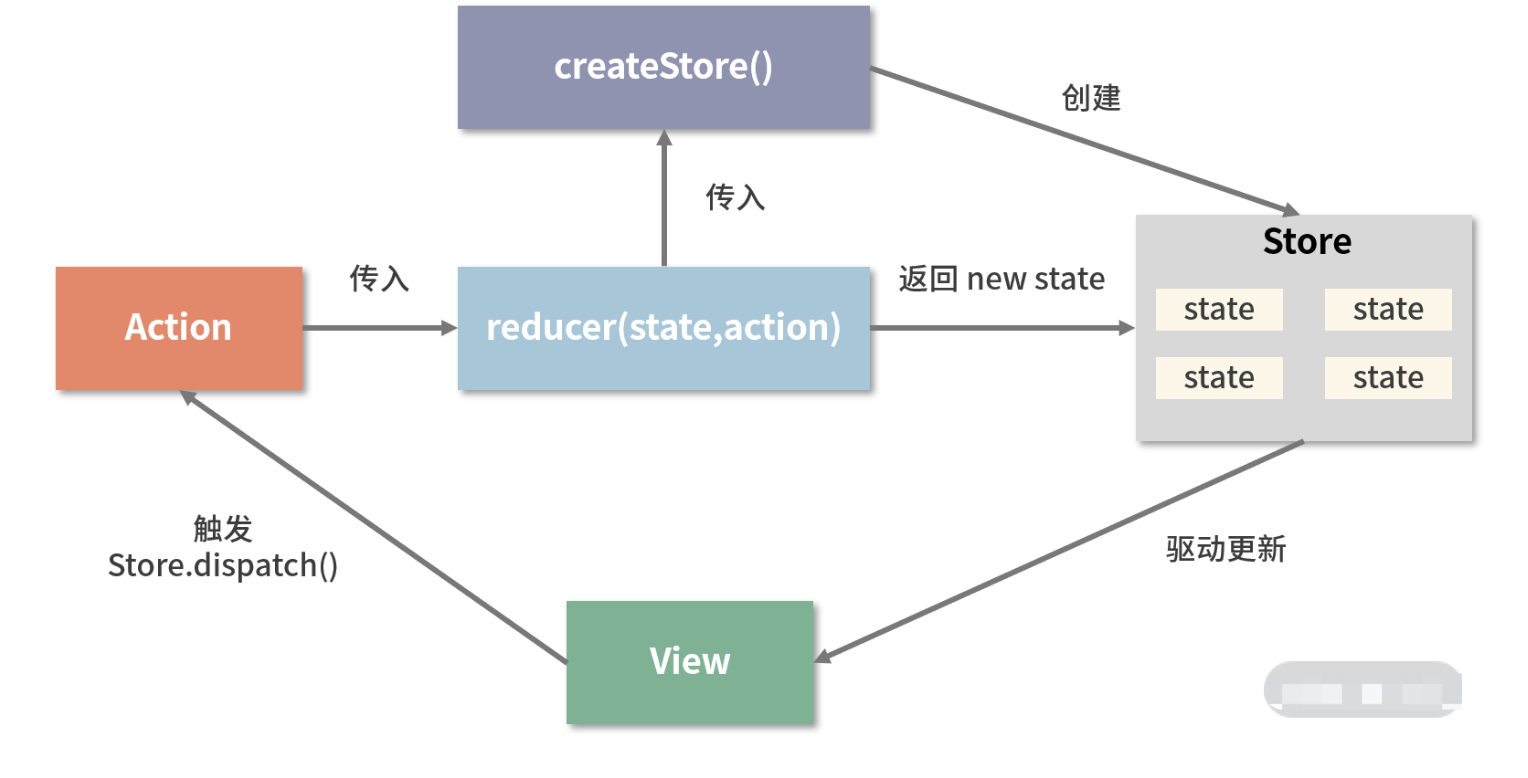
Redux源码
let createStore = (reducer) => {
let state;
//获取状态对象
//存放所有的监听函数
let listeners = [];
let getState = () => state;
//提供一个方法供外部调用派发action
let dispath = (action) => {
//调用管理员reducer得到新的state
state = reducer(state, action);
//执行所有的监听函数
listeners.forEach((l) => l())
}
//订阅状态变化事件,当状态改变发生之后执行监听函数
let subscribe = (listener) => {
listeners.push(listener);
}
dispath();
return {
getState,
dispath,
subscribe
}
}
let combineReducers=(renducers)=>{
//传入一个renducers管理组,返回的是一个renducer
return function(state={},action={}){
let newState={};
for(var attr in renducers){
newState[attr]=renducers[attr](state[attr],action)
}
return newState;
}
}
export {createStore,combineReducers};
聊聊 Redux 和 Vuex 的设计思想
- 共同点
首先两者都是处理全局状态的工具库,大致实现思想都是:全局
state保存状态---->dispatch(action)------>reducer(vuex里的mutation)----> 生成newState; 整个状态为同步操作;
- 区别
最大的区别在于处理异步的不同,vuex里面多了一步
commit操作,在action之后commit(mutation)之前处理异步,而redux里面则是通过中间件处理
redux 中间件
中间件提供第三方插件的模式,自定义拦截 action -> reducer 的过程。变为 action -> middlewares -> reducer 。这种机制可以让我们改变数据流,实现如异步 action ,action 过 滤,日志输出,异常报告等功能
常见的中间件:
redux-logger:提供日志输出;redux-thunk:处理异步操作;redux-promise: 处理异步操作;actionCreator的返回值是promise
redux中间件的原理是什么
applyMiddleware
为什么会出现中间件?
- 它只是一个用来加工dispatch的工厂,而要加工什么样的dispatch出来,则需要我们传入对应的中间件函数
- 让每一个中间件函数,接收一个dispatch,然后返回一个改造后的dispatch,来作为下一个中间件函数的next,以此类推。
function applyMiddleware(middlewares) {
middlewares = middlewares.slice()
middlewares.reverse()
let dispatch = store.dispatch
middlewares.forEach(middleware =>
dispatch = middleware(store)(dispatch)
)
return Object.assign({}, store, { dispatch })
}
上面的
middleware(store)(dispatch)就相当于是const logger = store => next => {},这就是构造后的dispatch,继续向下传递。这里middlewares.reverse(),进行数组反转的原因,是最后构造的dispatch,实际上是最先执行的。因为在applyMiddleware串联的时候,每个中间件只是返回一个新的dispatch函数给下一个中间件,实际上这个dispatch并不会执行。只有当我们在程序中通过store.dispatch(action),真正派发的时候,才会执行。而此时的dispatch是最后一个中间件返回的包装函数。然后依次向前递推执行。
action、store、reducer分析
redux的核心概念就是store、action、reducer,从调用关系来看如下所示
store.dispatch(action) --> reducer(state, action) --> final state
// reducer方法, 传入的参数有两个
// state: 当前的state
// action: 当前触发的行为, {type: 'xx'}
// 返回值: 新的state
var reducer = function(state, action){
switch (action.type) {
case 'add_todo':
return state.concat(action.text);
default:
return state;
}
};
// 创建store, 传入两个参数
// 参数1: reducer 用来修改state
// 参数2(可选): [], 默认的state值,如果不传, 则为undefined
var store = redux.createStore(reducer, []);
// 通过 store.getState() 可以获取当前store的状态(state)
// 默认的值是 createStore 传入的第二个参数
console.log('state is: ' + store.getState()); // state is:
// 通过 store.dispatch(action) 来达到修改 state 的目的
// 注意: 在redux里,唯一能够修改state的方法,就是通过 store.dispatch(action)
store.dispatch({type: 'add_todo', text: '读书'});
// 打印出修改后的state
console.log('state is: ' + store.getState()); // state is: 读书
store.dispatch({type: 'add_todo', text: '写作'});
console.log('state is: ' + store.getState()); // state is: 读书,写作
- store、reducer、action关联
store
store在这里代表的是数据模型,内部维护了一个state变量store有两个核心方法,分别是getState、dispatch。前者用来获取store的状态(state),后者用来修改store的状态
// 创建store, 传入两个参数
// 参数1: reducer 用来修改state
// 参数2(可选): [], 默认的state值,如果不传, 则为undefined
var store = redux.createStore(reducer, []);
// 通过 store.getState() 可以获取当前store的状态(state)
// 默认的值是 createStore 传入的第二个参数
console.log('state is: ' + store.getState()); // state is:
// 通过 store.dispatch(action) 来达到修改 state 的目的
// 注意: 在redux里,唯一能够修改state的方法,就是通过 store.dispatch(action)
store.dispatch({type: 'add_todo', text: '读书'});
action
- 对行为(如用户行为)的抽象,在
redux里是一个普通的js对象 action必须有一个type字段来标识这个行为的类型
{type:'add_todo', text:'读书'}
{type:'add_todo', text:'写作'}
{type:'add_todo', text:'睡觉', time:'晚上'}
reducer
- 一个普通的函数,用来修改
store的状态。传入两个参数state、action - 其中,
state为当前的状态(可通过store.getState()获得),而action为当前触发的行为(通过store.dispatch(action)调用触发) reducer(state, action)返回的值,就是store最新的state值
// reducer方法, 传入的参数有两个
// state: 当前的state
// action: 当前触发的行为, {type: 'xx'}
// 返回值: 新的state
var reducer = function(state, action){
switch (action.type) {
case 'add_todo':
return state.concat(action.text);
default:
return state;
}
};
- 关于
actionCreator
actionCreator(args) => action
var addTodo = function(text){
return {
type: 'add_todo',
text: text
};
};
addTodo('睡觉'); // 返回:{type: 'add_todo', text: '睡觉'}
异步Action及操作
- 创建同步Action
Action是数据从应用传递到store/state的载体,也是开启一次完成数据流的开始
普通的action对象
const action = {
type:'ADD_TODO',
name:'poetries'
}
dispatch(action)
封装action creator
function actionCreator(data){
return {
type:'ADD_TODO',
data:data
}
}
dispatch(actionCreator('poetries'))
bindActionCreators合并
function a(name,id){
reurn {
type:'a',
name,
id
}
}
function b(name,id){
reurn {
type:'b',
name,
id
}
}
let actions = Redux.bindActionCreators({a,b},store.dispatch)
//调用
actions.a('poetries','id001')
actions.b('jing','id002')
action创建的标准
在Flux的架构中,一个Action要符合 FSA(Flux Standard Action) 规范,需要满足如下条件
- 是一个纯文本对象
- 只具备
type、payload、error和meta中的一个或者多个属性。type字段不可缺省,其它字段可缺省 - 若
Action报错,error字段不可缺省,切必须为true
payload是一个对象,用作Action携带数据的载体
标准action示例
- A basic Flux Standard Action:
{
type: 'ADD_TODO',
payload: {
text: 'Do something.'
}
}
- An FSA that represents an error, analogous to a rejected Promise
{
type: 'ADD_TODO',
payload: new Error(),
error: true
}
https://github.com/acdlite/flux-standard-action
- 可以采用如下一个简单的方式检验一个
Action是否符合FSA标准
// every有一个匹配不到返回false
let isFSA = Object.keys(action).every((item)=>{
return ['payload','type','error','meta'].indexOf(item) > -1
})
- 创建异步action的多种方式
最简单的方式就是使用同步的方式来异步,将原来同步时一个
action拆分成多个异步的action的,在异步开始前、异步请求中、异步正常返回(异常)操作分别使用同步的操作,从而模拟出一个异步操作了。这样的方式是比较麻烦的,现在已经有redux-saga等插件来解决这些问题了
异步action的实现方式一:setTimeout
redux-thunk中间处理解析
function thunkAction(data) {
reutrn (dispatch)=>{
setTimeout(function(){
dispatch({
type:'ADD_TODO',
data
})
},3000)
}
}
异步action的实现方式二:promise实现异步action
redux-promise中间处理这种action
function promiseAction(name){
return new Promise((resolve,reject) => {
setTimeout((param)=>{
resolve({
type:'ADD_TODO',
name
})
},3000)
}).then((param)=>{
dispatch(action("action2"))
return;
}).then((param)=>{
dispatch(action("action3"))
})
}
- redux异步流程
- 首先发起一个action,然后通过中间件,这里为什么要用中间件呢,因为这样
dispatch的返回值才能是一个函数。 - 通过
store.dispatch,将状态的的改变传给store的小弟reducer,reducer根据action的改变,传递新的状态state。 - 最后将所有的改变告诉给它的大哥,
store。store保存着所有的数据,并将数据注入到组件的顶部,这样组件就可以获得它需要的数据了
- Redux异步方案选型
redux-thunk
Redux本身只能处理同步的Action,但可以通过中间件来拦截处理其它类型的action,比如函数(Thunk),再用回调触发普通Action,从而实现异步处理
- 发送异步的
action其实是被中间件捕获的,函数类型的action就被middleware捕获。至于怎么定义异步的action要看你用哪个中间件,根据他们的实例来定义,这样才会正确解析action
Redux本身不处理异步行为,需要依赖中间件。结合redux-actions使用,Redux有两个推荐的异步中间件
redux-thunkredux-promise
redux-thunk的源码如下
function createThunkMiddleware(extraArgument) {
return ({ dispatch, getState }) => next => action => {
if (typeof action === 'function') {
return action(dispatch, getState, extraArgument);
}
return next(action);
};
}
const thunk = createThunkMiddleware();
thunk.withExtraArgument = createThunkMiddleware;
export default thunk;
源码可知,
action creator需要返回一个函数给redux-thunk进行调用,示例如下
export let addTodoWithThunk = (val) => async (dispatch, getState)=>{
//请求之前的一些处理
let value = await Promise.resolve(val + ' thunk');
dispatch({
type:CONSTANT.ADD_TO_DO_THUNK,
payload:{
value
}
});
};
- 而它使用起来最大的问题,就是重复的模板代码太多
//action types
const GET_DATA = 'GET_DATA',
GET_DATA_SUCCESS = 'GET_DATA_SUCCESS',
GET_DATA_FAILED = 'GET_DATA_FAILED';
//action creator
const getDataAction = (id) => (dispatch, getState) => {
dispatch({
type: GET_DATA,
payload: id
})
api.getData(id) //注:本文所有示例的api.getData都返回promise对象
.then(response => {
dispatch({
type: GET_DATA_SUCCESS,
payload: response
})
})
.catch(error => {
dispatch({
type: GET_DATA_FAILED,
payload: error
})
})
}
}
//reducer
const reducer = (oldState, action) => {
switch(action.type) {
case GET_DATA :
return oldState;
case GET_DATA_SUCCESS :
return successState;
case GET_DATA_FAILED :
return errorState;
}
}
这已经是最简单的场景了,请注意:我们甚至还没写一行业务逻辑,如果每个异步处理都像这样,重复且无意义的工作会变成明显的阻碍
- 另一方面,像
GET_DATA_SUCCESS、GET_DATA_FAILED这样的字符串声明也非常无趣且易错 上例中,GET_DATA这个action并不是多数场景需要的
redux-promise
由于
redux-thunk写起来实在是太麻烦了,社区当然会有其它轮子出现。redux-promise则是其中比较知名的
- 它自定义了一个
middleware,当检测到有action的payload属性是Promise对象时,就会- 若
resolve,触发一个此action的拷贝,但payload为promise的value,并设status属性为"success" - 若
reject,触发一个此action的拷贝,但payload为promise的reason,并设status属性为"error"
- 若
//action types
const GET_DATA = 'GET_DATA';
//action creator
const getData = function(id) {
return {
type: GET_DATA,
payload: api.getData(id) //payload为promise对象
}
}
//reducer
function reducer(oldState, action) {
switch(action.type) {
case GET_DATA:
if (action.status === 'success') {
return successState
} else {
return errorState
}
}
}
redux-promise为了精简而做出的妥协非常明显:无法处理乐观更新
场景解析之:乐观更新
多数异步场景都是悲观更新的,即等到请求成功才渲染数据。而与之相对的乐观更新,则是不等待请求成功,在发送请求的同时立即渲染数据
- 由于乐观更新发生在用户操作时,要处理它,意味着必须有action表示用户的初始动作
- 在上面
redux-thunk的例子中,我们看到了GET_DATA,GET_DATA_SUCCESS、GET_DATA_FAILED三个action,分别表示初始动作、异步成功和异步失败,其中第一个action使得redux-thunk具备乐观更新的能力 - 而在
redux-promise中,最初触发的action被中间件拦截然后过滤掉了。原因很简单,redux认可的action对象是plain JavaScript objects,即简单对象,而在redux-promise中,初始action的payload是个Promise
redux-promise-middleware
redux-promise-middleware相比redux-promise,采取了更为温和和渐进式的思路,保留了和redux-thunk类似的三个action
//action types
const GET_DATA = 'GET_DATA',
GET_DATA_PENDING = 'GET_DATA_PENDING',
GET_DATA_FULFILLED = 'GET_DATA_FULFILLED',
GET_DATA_REJECTED = 'GET_DATA_REJECTED';
//action creator
const getData = function(id) {
return {
type: GET_DATA,
payload: {
promise: api.getData(id),
data: id
}
}
}
//reducer
const reducer = function(oldState, action) {
switch(action.type) {
case GET_DATA_PENDING :
return oldState; // 可通过action.payload.data获取id
case GET_DATA_FULFILLED :
return successState;
case GET_DATA_REJECTED :
return errorState;
}
}
- redux异步操作代码演示
- 根据官网的async例子分析 https://github.com/lewis617/react-redux-tutorial/tree/master/redux-examples/async
action/index.js
import fetch from 'isomorphic-fetch'
export const RECEIVE_POSTS = 'RECEIVE_POSTS'
//获取新闻成功的action
function receivePosts(reddit, json) {
return {
type: RECEIVE_POSTS,
reddit: reddit,
posts: json.data.children.map(child =>child.data)
}
}
function fetchPosts(subreddit) {
return function (dispatch) {
return fetch(`http://www.subreddit.com/r/${subreddit}.json`)
.then(response => response.json())
.then(json =>
dispatch(receivePosts(subreddit, json))
)
}
}
//如果需要则开始获取文章
export function fetchPostsIfNeeded(subreddit) {
return (dispatch, getState) => {
return dispatch(fetchPosts(subreddit))
}
}
fetchPostsIfNeeded这里就是一个中间件。redux-thunk会拦截fetchPostsIfNeeded这个action,会先发起数据请求,如果成功,就将数据传给action从而到达reducer那里
reducers/index.js
import { combineReducers } from 'redux'
import {
RECEIVE_POSTS
} from '../actions'
function posts(state = {
items: []
}, action) {
switch (action.type) {
case RECEIVE_POSTS:
// Object.assign是ES6的一个语法。合并对象,将对象合并为一个,前后相同的话,后者覆盖强者。详情可以看这里
// https://developer.mozilla.org/en-US/docs/Web/JavaScript/Reference/Global_Objects/Object/assign
return Object.assign({}, state, {
items: action.posts //数据都存在了这里
})
default:
return state
}
}
// 将所有的reducer结合为一个,传给store
const rootReducer = combineReducers({
postsByReddit
})
export default rootReducer
这个跟正常的
reducer差不多。判断action的类型,从而根据action的不同类型,返回不同的数据。这里将数据存储在了items这里。这里的reducer只有一个。最后结合成rootReducer,传给store
store/configureStore.js
import { createStore, applyMiddleware } from 'redux'
import thunkMiddleware from 'redux-thunk'
import createLogger from 'redux-logger'
import rootReducer from '../reducers'
const createStoreWithMiddleware = applyMiddleware(
thunkMiddleware,
createLogger()
)(createStore)
export default function configureStore(initialState) {
const store = createStoreWithMiddleware(rootReducer, initialState)
if (module.hot) {
// Enable Webpack hot module replacement for reducers
module.hot.accept('../reducers', () => {
const nextRootReducer = require('../reducers')
store.replaceReducer(nextRootReducer)
})
}
return store
}
- 我们是如何在
dispatch机制中引入Redux Thunk middleware的呢? 我们使用了applyMiddleware() - 通过使用指定的
middleware,action creator除了返回action对象外还可以返回函数 - 这时,这个
action creator就成为了thunk
界面上的调用:在containers/App.js
//初始化渲染后触发
componentDidMount() {
const { dispatch} = this.props
// 这里可以传两个值,一个是 reactjs 一个是 frontend
dispatch(fetchPostsIfNeeded('frontend'))
}
改变状态的时候也是需要通过
dispatch来传递的
- 数据的获取是通过
provider,将store里面的数据注入给组件。让顶级组件提供给他们的子孙组件调用。代码如下:
import 'babel-core/polyfill'
import React from 'react'
import { render } from 'react-dom'
import { Provider } from 'react-redux'
import App from './containers/App'
import configureStore from './store/configureStore'
const store = configureStore()
render(
<Provider store={store}>
<App />
</Provider>,
document.getElementById('root')
)
这样就完成了
redux的异步操作。其实最主要的区别还是action里面还有中间件的调用,其他的地方基本跟同步的redux差不多的。搞懂了中间件,就基本搞懂了redux的异步操作
💬 面试官追问
有人直接改
store.getState()拿到的数组,页面偶尔更新、DevTools里却没记录,为什么?绕过了
dispatch,reducer没跑、订阅者没被通知,偶尔更新是因为别的action碰巧触发了渲染。而且原地修改让新旧state是同一个引用,时间旅行和浅比较全失效。手写一个最小的
createStore,dispatch里的顺序是什么?先
state = reducer(state, action),再遍历listeners逐个调用。另外createStore最后要自己dispatch一个初始化action,让reducer返回默认state。想让
dispatch能接收函数去发请求,改哪里?加中间件,不动
reducer。redux-thunk核心就几行:action是函数就action(dispatch, getState),否则next(action)。请求结束后再dispatch普通对象给reducer。两个中间件,某个没调
next(action)会怎样?后面的中间件和
reducer全都收不到这个action,state不变,也不报错。排查时在每层打日志,看action断在哪一层。拆成多个
reducer后,每个都返回完整状态树,有什么问题?combineReducers会把state.user交给userReducer、state.cart交给cartReducer,每个只该管自己那片。返回整棵树会被套到错误的层级上,也让模块互相耦合。
# 18 谈谈你对状态管理的理解
⚡ 30 秒速记
- 先分类:服务端状态(接口数据,要缓存、去重、失效重取)和客户端状态(
UI、表单、主题) - 服务端状态交给
TanStack Query/SWR,别手写一堆loading、error塞进全局store - 客户端状态按范围选:组件内
useState,跨几层用Context,真全局用Zustand/Redux Toolkit/Jotai - 历史脉络:
Flux立了单向数据流 →Redux简化成单一store+ 纯reducer→MobX走响应式自动追踪 Context的坑:value一变所有消费者都重渲染,高频数据别放进去
我理解的状态管理,第一步不是选库,是先把状态分清楚。 接口数据其实是服务端状态的缓存,要考虑过期、去重、重试,交给 TanStack Query 这类库最省心;剩下的才是真正的客户端状态,大部分放组件里就够了,只有跨多个页面共享的才提到全局。再讲演进:Flux 用单向数据流解决了 MVC 里数据到处乱飞的问题,Redux 用纯函数 reducer 让每次变化可回放,代价是样板多;MobX 像 Vue 那样自动追踪依赖,写着爽但变化来源不那么显式。
- 首先介绍 Flux,Flux 是一种使用单向数据流的形式来组合 React 组件的应用架构。
- Flux 包含了 4 个部分,分别是
Dispatcher、Store、View、Action。Store存储了视图层所有的数据,当Store变化后会引起 View 层的更新。如果在视图层触发一个Action,就会使当前的页面数据值发生变化。Action 会被 Dispatcher 进行统一的收发处理,传递给 Store 层,Store 层已经注册过相关 Action 的处理逻辑,处理对应的内部状态变化后,触发 View 层更新。 Flux 的优点是单向数据流,解决了 MVC 中数据流向不清的问题,使开发者可以快速了解应用行为。从项目结构上简化了视图层设计,明确了分工,数据与业务逻辑也统一存放管理,使在大型架构的项目中更容易管理、维护代码。其次是 Redux,Redux 本身是一个 JavaScript 状态容器,提供可预测化状态的管理。社区通常认为 Redux 是 Flux 的一个简化设计版本,它提供的状态管理,简化了一些高级特性的实现成本,比如撤销、重做、实时编辑、时间旅行、服务端同构等。- Redux 的核心设计包含了三大原则:
单一数据源、纯函数 Reducer、State 是只读的。 - Redux 中整个数据流的方案与 Flux 大同小异
- Redux 中的另一大核心点是处理“副作用”,AJAX 请求等异步工作,或不是纯函数产生的第三方的交互都被认为是 “副作用”。这就造成在纯函数设计的 Redux 中,处理副作用变成了一件至关重要的事情。社区通常有两种解决方案:
- 第一类是在
Dispatch的时候会有一个middleware 中间件层,拦截分发的Action 并添加额外的复杂行为,还可以添加副作用。第一类方案的流行框架有Redux-thunk、Redux-Promise、Redux-Observable、Redux-Saga等。 - 第二类是允许
Reducer层中直接处理副作用,采取该方案的有React Loop,React Loop在实现中采用了 Elm 中分形的思想,使代码具备更强的组合能力。 - 除此以外,社区还提供了更为工程化的方案,比如
rematch 或 dva,提供了更详细的模块架构能力,提供了拓展插件以支持更多功能。
- 第一类是在
- Redux 的优点很多:
- 结果可预测;
- 代码结构严格易维护;
- 模块分离清晰且小函数结构容易编写单元测试;
Action触发的方式,可以在调试器中使用时间回溯,定位问题更简单快捷;- 单一数据源使服务端同构变得更为容易;社区方案多,生态也更为繁荣。
最后是 Mobx,Mobx 通过监听数据的属性变化,可以直接在数据上更改触发UI 的渲染。在使用上更接近 Vue,比起Flux 与 Redux的手动挡的体验,更像开自动挡的汽车。Mobx 的响应式实现原理与 Vue 相同,以Mobx 5为分界点,5 以前采用Object.defineProperty的方案,5 及以后使用Proxy的方案。它的优点是样板代码少、简单粗暴、用户学习快、响应式自动更新数据让开发者的心智负担更低。- Mobx 在开发项目时简单快速,但应用 Mobx 的场景 ,其实完全可以用 Vue 取代。如果纯用 Vue,体积还会更小巧
💬 面试官追问
一个只有父子传值的小页面,架构师要求全部走全局
store,你怎么看?过度设计。状态只在两三个组件之间用,
useState加props就够了,全局化只会让人改个输入框要跳三个文件。等真出现跨页面共享再提上去不迟。接口数据放
Redux还是React Query?新项目我选
React Query,缓存、去重、后台刷新、失效重取都是现成的,放Redux得自己写一遍。Redux留给真正的客户端全局状态,比如编辑器的撤销栈。同一个
action重放两次结果不一样,reducer里读了Date.now(),怎么改?reducer必须是纯函数,时间、随机数、请求都不能在里面产生。在dispatch之前就把时间算好放进action.payload,reducer只管拿来用。把用户信息、主题、购物车都放一个
Context,改购物车数量时整个页面都在渲染,怎么办?Context没有选择性订阅,value一变所有消费者都渲染。按变化频率拆成几个Context,高频的购物车换成Zustand这种可以用selector只订阅一部分的库。MobX和Redux怎么选?要审计每次变更、要时间旅行、团队人多,选
Redux Toolkit,变化都走显式的action。追求开发快、团队熟悉响应式,MobX更顺手,它5以后用Proxy做拦截,新增属性也能追踪。
# 19 connect组件原理分析
⚡ 30 秒速记
connect(mapStateToProps, mapDispatchToProps)(Comp)是高阶组件,返回一个包装组件Provider用Context往下传store本身(不是state),connect拿到后订阅变化store一变就跑mapStateToProps,结果和上次浅比较,变了才重渲染被包的组件- 所以
mapStateToProps里别每次filter/map出新数组,否则永远「变了」,用reselect缓存 - 卸载要取消订阅;现在推荐
useSelector/useDispatch,v8起内部基于useSyncExternalStore
connect 是一个高阶组件,它干了三件事:从 Context 拿到 store 并订阅、把 state 映射成 props、判断要不要让被包的组件重渲染。 Provider 传下去的是 store 对象,不是 state,这样 store 内容变了 Context 本身不变,不会触发全树渲染。每次 dispatch 后 connect 重新跑 mapStateToProps,和上次结果逐个字段浅比较,有变化才渲染。最常见的坑就是在 mapStateToProps 里 filter 出新数组,每次都是新引用,等于没有优化。现在写函数组件我直接用 useSelector,原理一样。
1. connect用法
作用:连接
React组件与Redux store
connect([mapStateToProps], [mapDispatchToProps], [mergeProps],[options])
// 这个函数允许我们将 store 中的数据作为 props 绑定到组件上
const mapStateToProps = (state) => {
return {
count: state.count
}
}
- 这个函数的第一个参数就是
Redux的store,我们从中摘取了count属性。你不必将state中的数据原封不动地传入组件,可以根据state中的数据,动态地输出组件需要的(最小)属性 - 函数的第二个参数
ownProps,是组件自己的props
当
state变化,或者ownProps变化的时候,mapStateToProps都会被调用,计算出一个新的stateProps,(在与ownProps merge后)更新给组件
mapDispatchToProps(dispatch, ownProps): dispatchProps
connect的第二个参数是mapDispatchToProps,它的功能是,将action作为props绑定到组件上,也会成为MyComp的 `props
2. 原理解析
首先
connect之所以会成功,是因为Provider组件
- 在原应用组件上包裹一层,使原来整个应用成为
Provider的子组件 - 接收
Redux的store作为props,通过context对象传递给子孙组件上的connect
connect做了些什么
它真正连接
Redux和React,它包在我们的容器组件的外一层,它接收上面Provider提供的store里面的state和dispatch,传给一个构造函数,返回一个对象,以属性形式传给我们的容器组件
3. 源码
connect是一个高阶函数,首先传入mapStateToProps、mapDispatchToProps,然后返回一个生产Component的函数(wrapWithConnect),然后再将真正的Component作为参数传入wrapWithConnect,这样就生产出一个经过包裹的Connect组件,该组件具有如下特点
- 通过
props.store获取祖先Component的store props包括stateProps、dispatchProps、parentProps,合并在一起得到nextState,作为props传给真正的Component componentDidMount时,添加事件this.store.subscribe(this.handleChange),实现页面交互shouldComponentUpdate时判断是否有避免进行渲染,提升页面性能,并得到nextStatecomponentWillUnmount时移除注册的事件this.handleChange
// 主要逻辑
export default function connect(mapStateToProps, mapDispatchToProps, mergeProps, options = {}) {
return function wrapWithConnect(WrappedComponent) {
class Connect extends Component {
constructor(props, context) {
// 从祖先Component处获得store
this.store = props.store || context.store
this.stateProps = computeStateProps(this.store, props)
this.dispatchProps = computeDispatchProps(this.store, props)
this.state = { storeState: null }
// 对stateProps、dispatchProps、parentProps进行合并
this.updateState()
}
shouldComponentUpdate(nextProps, nextState) {
// 进行判断,当数据发生改变时,Component重新渲染
if (propsChanged || mapStateProducedChange || dispatchPropsChanged) {
this.updateState(nextProps)
return true
}
}
componentDidMount() {
// 改变Component的state
this.store.subscribe(() = {
this.setState({
storeState: this.store.getState()
})
})
}
render() {
// 生成包裹组件Connect
return (
<WrappedComponent {...this.nextState} />
)
}
}
Connect.contextTypes = {
store: storeShape
}
return Connect;
}
}
💬 面试官追问
为了省事,把整个
state都映射给组件,有什么问题?登录状态、弹窗开关这些无关字段一变,浅比较就不相等,组件跟着重渲染。
mapStateToProps只返回组件真正用到的那几个字段。mapStateToProps里写了state.orders.filter(...),组件为什么每次都重渲染?filter每次都返回新数组,浅比较永远判定为变化。用reselect的createSelector包一层,输入没变就返回上一次的同一个数组。DevTools里state已经变了,被connect的组件没刷新,怎么查?先看
reducer是不是原地改了对象,引用没变浅比较就认为没变化,这是九成的原因。再看Provider包的是不是同一个store,有没有被memo或shouldComponentUpdate拦住。Provider为什么传store而不是直接传state?传
state的话每次变化Context的value都变,所有消费者全部重渲染,没法做精细的比较。react-redux v6试过传state,性能出了问题,v7又改回了传store加订阅。新项目用
connect还是useSelector?函数组件就用
useSelector,少一层包装,类型推导也简单。注意它默认用===比较返回值,返回对象时要么拆成多次调用,要么传shallowEqual作为第二个参数。
# 20 React Hooks
⚡ 30 秒速记
- 解决的问题:类组件逻辑被生命周期拆得七零八落,复用只能靠
HOC/render props套娃 - 两条规则:只在顶层调用、只在函数组件或自定义
Hook里调用,因为状态按调用顺序存在Fiber的链表上 useEffect依赖数组最容易出事:漏依赖拿旧闭包,没返回清理函数就泄漏useLayoutEffect在DOM改完、绘制前同步跑,量布局防闪烁用;useEffect一般在绘制后跑useMemo缓存值、useCallback缓存函数、useRef存不触发渲染的可变值,别混用
Hooks 让函数组件也能有状态和副作用,最大的好处是相关逻辑能写在一起,还能抽成自定义 Hook 复用。 以前一个订阅要在 componentDidMount 绑、componentDidUpdate 换、componentWillUnmount 解,分散在三处;现在一个 useEffect 加一个清理函数就写完了。规则为什么严格?因为 React 不知道你的 useState 叫什么,只认第几个调用,放进 if 里顺序一乱,状态就对不上号了。实际开发里出问题最多的是 useEffect 依赖,我会开 eslint-plugin-react-hooks 让它帮着查。
- 代码逻辑聚合,逻辑复用
- HOC嵌套地狱
- 代替class
React 中通常使用 类定义 或者 函数定义 创建组件:
在类定义中,我们可以使用到许多 React 特性,例如 state、 各种组件生命周期钩子等,但是在函数定义中,我们却无能为力,因此 React 16.8 版本推出了一个新功能 (React Hooks),通过它,可以更好的在函数定义组件中使用 React 特性。
函数组件与类组件的对比:无关“优劣”,只谈“不同”
- 类组件需要继承 class,函数组件不需要;
- 类组件可以访问生命周期方法,函数组件不能;
- 类组件中可以获取到实例化后的 this,并基于这个 this 做各种各样的事情,而函数组件不可以;
- 类组件中可以定义并维护 state(状态),而函数组件不可以;
但是类组件它太重了,对于解决许多问题来说,编写一个类组件实在是一个过于复杂的姿势。复杂的姿势必然带来高昂的理解成本,这也是我们所不想看到的
react hooks的好处:
- 跨组件复用: 其实 render props / HOC 也是为了复用,相比于它们,Hooks 作为官方的底层 API,最为轻量,而且改造成本小,不会影响原来的组件层次结构和传说中的嵌套地狱;
- 类定义更为复杂
- 不同的生命周期会使逻辑变得分散且混乱,不易维护和管理;
- 时刻需要关注this的指向问题;
- 代码复用代价高,高阶组件的使用经常会使整个组件树变得臃肿;
- 状态与UI隔离: 正是由于 Hooks 的特性,状态逻辑会变成更小的粒度,并且极容易被抽象成一个自定义 Hooks,组件中的状态和 UI 变得更为清晰和隔离。
注意:
- 避免在 循环/条件判断/嵌套函数 中调用 hooks,保证调用顺序的稳定;
- 只有 函数定义组件 和 hooks 可以调用 hooks,避免在 类组件 或者 普通函数 中调用;
- 不能在useEffect中使用useState,React 会报错提示;
- 类组件不会被替换或废弃,不需要强制改造类组件,两种方式能并存;
重要钩子
- 状态钩子 (useState): 用于定义组件的 State,其到类定义中this.state的功能;
// useState 只接受一个参数: 初始状态
// 返回的是组件名和更改该组件对应的函数
const [flag, setFlag] = useState(true);
// 修改状态
setFlag(false)
// 上面的代码映射到类定义中:
this.state = {
flag: true
}
const flag = this.state.flag
const setFlag = (bool) => {
this.setState({
flag: bool,
})
}
- 生命周期钩子 (useEffect):
类定义中有许多生命周期函数,而在 React Hooks 中也提供了一个相应的函数 (useEffect),这里可以看做componentDidMount、componentDidUpdate和componentWillUnmount的结合。
useEffect(callback, [source])接受两个参数
- callback: 钩子回调函数;
- source: 设置触发条件,仅当 source 发生改变时才会触发;
- useEffect钩子在没有传入[source]参数时,默认在每次 render 时都会优先调用上次保存的回调中返回的函数,后再重新调用回调;
useEffect(() => {
// 组件挂载后执行事件绑定
console.log('on')
addEventListener()
// 组件 update 时会执行事件解绑
return () => {
console.log('off')
removeEventListener()
}
}, [source]);
// 每次 source 发生改变时,执行结果(以类定义的生命周期,便于大家理解):
// --- DidMount ---
// 'on'
// --- DidUpdate ---
// 'off'
// 'on'
// --- DidUpdate ---
// 'off'
// 'on'
// --- WillUnmount ---
// 'off'
通过第二个参数,我们便可模拟出几个常用的生命周期:
- componentDidMount: 传入[]时,就只会在初始化时调用一次
const useMount = (fn) => useEffect(fn, [])
- componentWillUnmount: 传入[],回调中的返回的函数也只会被最终执行一次
const useUnmount = (fn) => useEffect(() => fn, [])
- mounted: 可以使用 useState 封装成一个高度可复用的 mounted 状态;
const useMounted = () => {
const [mounted, setMounted] = useState(false);
useEffect(() => {
!mounted && setMounted(true);
return () => setMounted(false);
}, []);
return mounted;
}
- componentDidUpdate: useEffect每次均会执行,其实就是排除了 DidMount 后即可;
const mounted = useMounted()
useEffect(() => {
mounted && fn()
})
- 其它内置钩子:
useContext: 获取 context 对象useReducer: 类似于 Redux 思想的实现,但其并不足以替代 Redux,可以理解成一个组件内部的 redux:- 并不是持久化存储,会随着组件被销毁而销毁;
- 属于组件内部,各个组件是相互隔离的,单纯用它并无法共享数据;
- 配合useContext`的全局性,可以完成一个轻量级的 Redux;(easy-peasy)
useCallback: 缓存回调函数,避免传入的回调每次都是新的函数实例而导致依赖组件重新渲染,具有性能优化的效果;useMemo: 用于缓存传入的 props,避免依赖的组件每次都重新渲染;useRef: 获取组件的真实节点;useLayoutEffect- DOM更新同步钩子。用法与useEffect类似,只是区别于执行时间点的不同
- useEffect属于异步执行,并不会等待 DOM 真正渲染后执行,而useLayoutEffect则会真正渲染后才触发;
- 可以获取更新后的 state;
- 自定义钩子(useXxxxx): 基于 Hooks 可以引用其它 Hooks 这个特性,我们可以编写自定义钩子,如上面的useMounted。又例如,我们需要每个页面自定义标题:
function useTitle(title) {
useEffect(
() => {
document.title = title;
});
}
// 使用:
function Home() {
const title = '我是首页'
useTitle(title)
return (
<div>{title}</div>
)
}
React Hooks 的限制
- 不要在
循环、条件或嵌套函数中调用 Hook; - 在 React 的函数组件中调用
Hook
那为什么会有这样的限制呢?就得从 Hooks 的设计说起。Hooks 的设计初衷是为了改进 React 组件的开发模式。在旧有的开发模式下遇到了三个问题。
- 组件之间难以复用状态逻辑。过去常见的解决方案是高阶组件、
render props及状态管理框架。 - 复杂的组件变得难以理解。生命周期函数与业务逻辑耦合太深,导致关联部分难以拆分。
- 常见的有 this 的问题,但在 React 团队中还有类难以优化的问题,他们希望在编译优化层面做出一些改进。
这三个问题在一定程度上阻碍了 React 的后续发展,所以为了解决这三个问题,Hooks 基于函数组件开始设计。然而第三个问题决定了 Hooks 只支持函数组件。
那为什么不要在循环、条件或嵌套函数中调用 Hook 呢?因为 Hooks 的设计是基于数组实现。在调用时按顺序加入数组中,如果使用循环、条件或嵌套函数很有可能导致数组取值错位,执行错误的 Hook。当然,实质上 React 的源码里不是数组,是链表。
这些限制会在编码上造成一定程度的心智负担,新手可能会写错,为了避免这样的情况,可以引入 ESLint 的 Hooks 检查插件进行预防。
useEffect 与 useLayoutEffect 区别在哪里
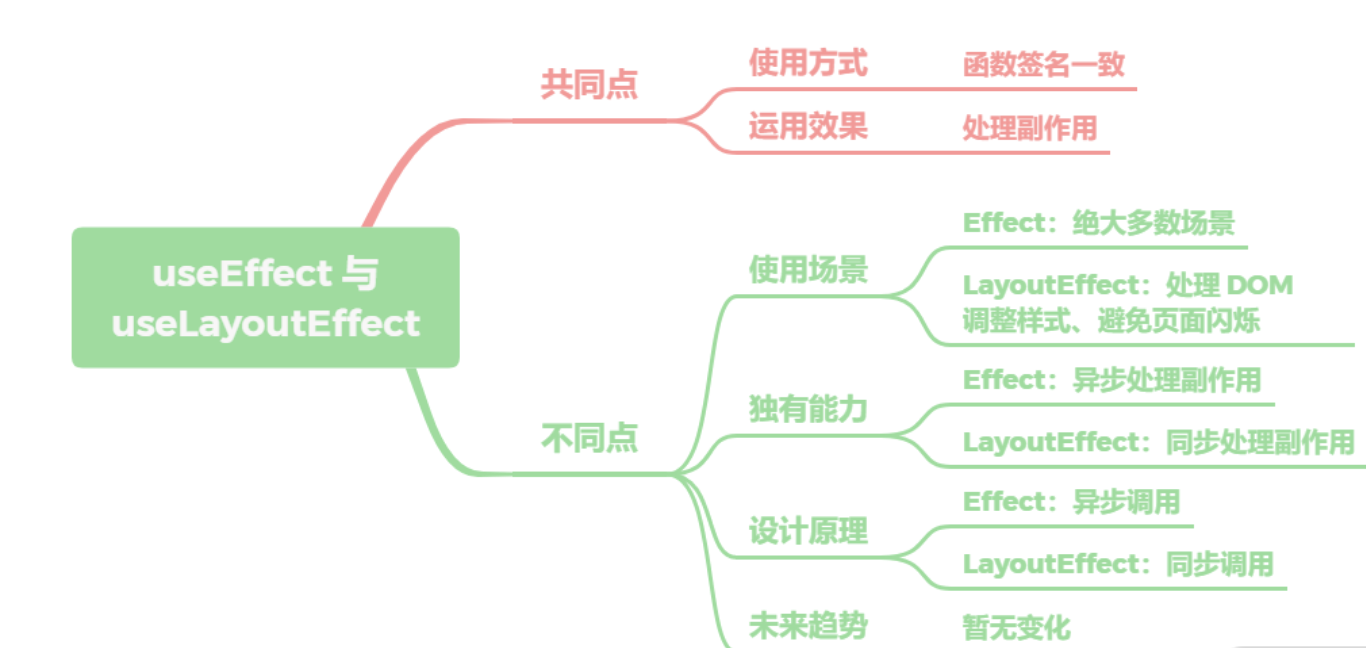
- 它们的共同点很简单,底层的函数签名是完全一致的,都是调用的
mountEffectImpl,在使用上也没什么差异,基本可以直接替换,也都是用于处理副作用。 - 那不同点就很大了,
useEffect在 React 的渲染过程中是被异步调用的,用于绝大多数场景,而LayoutEffect会在所有的 DOM 变更之后同步调用,主要用于处理 DOM 操作、调整样式、避免页面闪烁等问题。也正因为是同步处理,所以需要避免在LayoutEffect做计算量较大的耗时任务从而造成阻塞。 - 在未来的趋势上,两个 API 是会长期共存的,暂时没有删减合并的计划,需要开发者根据场景去自行选择。React 团队的建议非常实用,如果实在分不清,先用
useEffect,一般问题不大;如果页面有异常,再直接替换为useLayoutEffect即可。
💬 面试官追问
把
useEffect放进if (open)里,后面的useState读到别的值,为什么?Hook按调用顺序存在链表里,open从true变false那次少调了一个,后面每个都错位一格。条件写到useEffect内部,或者把这块拆成单独组件按条件渲染。聊天室
useEffect依赖从[roomId]改成[],切换房间还收到旧房间消息,为什么?[]只在挂载时执行一次,换房间不会重新订阅,旧订阅也一直没退。依赖写回[roomId],每次变化React会先执行上一次的清理函数退订,再订阅新房间。定时器里打印
count,永远是0,怎么回事?useEffect依赖写了[],回调闭包抓住的是第一次渲染的count。改成setCount(c => c + 1)不依赖外部值,或者用useRef存最新值。测量
DOM后调整位置会闪一下,全部换成useLayoutEffect行不行?只换需要量布局的那一个,比如
tooltip定位。useLayoutEffect会阻塞绘制,请求、日志、订阅这些放进去只会拖慢首屏,还在SSR里报警告。useCallback(fn, deps)和useMemo(() => fn, deps)有区别吗?效果完全一样,
useCallback就是缓存函数的简写。要注意的是单独用它没意义,接收这个函数的子组件得包React.memo,或者函数被放进了别的Hook依赖里,缓存才有价值。
# 21 受控组件和非受控组件
⚡ 30 秒速记
- 受控:值存在
React的state里,value+onChange成对出现,React是唯一数据源 - 非受控:值留在
DOM里,用defaultValue给初值,用ref或FormData读 - 受控适合实时校验、格式化、联动禁用;非受控适合提交时才读的简单表单、接第三方库
<input type="file">只能非受控,value是只读的- 别中途切换:
value从undefined变成字符串会报警告,受控就从一开始给''
受控和非受控的区别就一句话:输入框的值谁说了算,是 React 的 state 还是 DOM 自己。 受控组件每敲一个字都走一遍 onChange 改 state、再渲染回来,所以能做实时校验、自动格式化、按钮联动。非受控组件只给一个初值,之后让浏览器自己管,提交时再去读,代码少、渲染少。以前有说法把非受控当反模式,这不对,React 官方文档把两种都当正常用法,React 19 的表单 action 直接拿 FormData,本身就是非受控思路。选哪个看你需不需要在输入过程中做事。
<FInput value = {x} onChange = {fn} />
// 上面的是受控组件 下面的是非受控组件
<FInput defaultValue = {x} />
- 当你一个组件同时传递一个value以及onChange事件时,它就是一个受控组件,收入输出都是我来控制的。
- 第二个只是传递了默认的初时值,并没有传onchange事件,
- 非受控组件是一种反模式,它的值不受组件自身的state或props控制
受控和非受控用代码对照一下最清楚:
// 受控:值在 state 里,每次输入都走一遍 setState
function Controlled() {
const [name, setName] = useState('')
return (
<>
<input value={name} onChange={e => setName(e.target.value.trim())} />
<button disabled={!name}>保存</button> {/* 能实时联动 */}
</>
)
}
// 非受控:值留在 DOM 里,用到时再读
function Uncontrolled() {
const inputRef = useRef(null)
const submit = () => console.log(inputRef.current.value) // 提交时读
return (
<>
<input defaultValue="张三" ref={inputRef} />
<button onClick={submit}>保存</button>
</>
)
}
// React 19:表单 action 直接拿 FormData,也是非受控
function Form19() {
async function save(formData) {
console.log(formData.get('name'))
}
return <form action={save}><input name="name" /><button>保存</button></form>
}
有一种老说法是「非受控组件是一种反模式」,这已经过时了。早年社区确实偏向全部受控,但 React 官方文档一直把两种当正常写法,只要求同一个输入框别在两种模式之间来回切。判断标准很简单:输入过程中要不要做事。要实时校验、格式化、联动,就受控;只在提交时取值,非受控更省事,性能也更好。
两个固定结论:<input type="file"> 的 value 是只读的,只能非受控;受控组件的 value 别给 undefined 或 null,否则 React 会当成非受控,等数据回来再赋值就会报「从非受控切到受控」的警告。
💬 面试官追问
给输入框传了
value={name}但没写onChange,怎么打字都没反应,删掉value算修好吗?删掉就变非受控了,父组件以后拿不到实时值、也没法重置。该补的是
onChange={e => setName(e.target.value)};只想要初值才改成defaultValue。保存按钮要根据三个字段实时启用禁用,用哪种?
受控。三个字段的值都在父组件的
state里,每次变化重新算canSave,一行就写完。非受控得自己监听每个输入再同步,绕远了。搜索框用
defaultValue={keyword},路由参数变了输入框却不变,为什么?defaultValue只在挂载时生效一次,之后改了也没用。要么改成受控value={keyword},要么给输入框加key={keyword},参数一变就重新挂载。控制台报
A component is changing an uncontrolled input to be controlled,怎么查?首次渲染时
value是undefined,接口回来后变成字符串,组件从非受控切成了受控。初始值给'',或者写value={name ?? ''}。几十个字段的长表单,每敲一个字整个表单都在渲染,怎么办?
这是受控的代价。字段多了可以用非受控为主的方案,比如
react-hook-form靠ref注册字段,只在校验或提交时读;用antd的Form也行,它内部按字段订阅,改一个只渲染那一项。
# 22 如何避免ajax数据请求重新获取
⚡ 30 秒速记
- 主线:缓存结果 + 合并进行中的请求,服务端数据优先交给
React Query/SWR - 只缓存结果挡不住首屏并发:要按
key缓存「进行中的Promise」,后来者复用同一个 - 重复请求先查
useEffect依赖:每次渲染都新建的对象 / 函数会让副作用反复跑 - 开发环境请求两次多半是
React 18的StrictMode故意挂载两次,生产不会 - 不同参数之间是竞态不是重复:用
AbortController取消旧请求,别指望去重解决 HTTP缓存(Cache-Control/ETag)和应用层缓存是两层,时效要对齐
避免重复请求,说白了就是两件事:拿过的数据先别扔,正在拿的请求别再发一遍。 现在我基本直接上 React Query 或 SWR,它们按 key 缓存结果,几个组件同时要同一份数据只发一次,过期了再后台静默刷新。自己写的话,关键是用 Map 存进行中的 Promise,不是存结果,否则首屏三个组件同时发起时缓存还是空的。另外排查重复请求时先看 useEffect 依赖,十有八九是依赖里放了每次都新建的对象。
核心思路是缓存 + 请求去重——把已经拿到的数据缓存起来,相同的请求不重复发。
- 用数据请求库管理缓存(现代主线):React Query / SWR 内置了缓存、请求去重(同一时刻多个组件请求同一 key 只发一次)、后台重新验证(stale-while-revalidate)、失效控制。这是现在处理「服务端状态」的标准做法——避免重复请求本就是它们的核心能力,不用自己造轮子。
- 放全局状态(旧做法):把数据存进 Redux/Zustand,组件先读缓存、没有再请求。这是过去常见的做法,但要自己处理缓存失效、去重、更新,样板多——现在更推荐用 React Query 管服务端状态、全局 store 只放真正的客户端状态。
- 请求去重(in-flight dedup):对「正在进行中」的相同请求做去重——用一个 Map 缓存进行中的 Promise,相同 key 直接返回同一个 Promise,避免并发的重复请求。
- HTTP 缓存:对可缓存的接口配
Cache-Control/ETag,让浏览器层面命中缓存(适合不常变的数据)。 - 组件层面:用
useEffect的依赖数组控制只在必要时请求、用AbortController取消过期请求避免竞态。
一句话:优先用 React Query/SWR(自带缓存 + 去重 + 重验证),它们专门解决「服务端状态」的重复获取;全局 store 只放客户端状态;再配合请求去重和 HTTP 缓存。
💬 面试官追问
详情页三个区块同时请求
/product?id=42,抓包看到发了三次,怎么合并?缓存进行中的
Promise,不是缓存结果:const p = inflight.get(key) ?? fetch(url).finally(() => inflight.delete(key)); inflight.set(key, p)。三个调用拿到同一个p,只发一次;finally里删掉,失败了下次还能重试。本地开发每个接口都打两次,上线又正常,是不是代码写错了?
大概率是
React 18的StrictMode,开发环境会故意把组件挂载、卸载、再挂载一遍,专门逼你检查副作用有没有清理。别为了这个去掉StrictMode,在useEffect里返回清理函数(比如abort掉请求),或者干脆交给React Query。用户快速切换筛选,慢的旧请求最后返回把新结果覆盖了,怎么办?
这是竞态,去重管不了,因为参数不同
key就不同。每次发请求前abort掉上一个:useEffect里const c = new AbortController(),清理函数里c.abort()。用React Query的话key带上筛选条件,它只认最新那个key的结果。接口有
ETag,前端又用了SWR,是不是重复了?不重复,管的是两层。
SWR决定要不要发请求、先给页面什么数据;ETag是请求真发出去之后,服务器说「没变」就回304,省掉响应体。注意一点:SWR命中缓存不发请求时,ETag根本没机会工作。订单列表、主题色、侧栏开关,全放
Redux里行不行?能跑,但订单是服务端状态,要缓存、过期、重试、去重,放
Redux得自己全写一遍。我会把订单交给React Query,主题和侧栏这种纯客户端状态放Zustand或Context,分工清楚样板也少。
# 23 组件之间通信
⚡ 30 秒速记
- 按关系远近选:父子
props+ 回调 → 跨多层Context→ 跨树复杂状态上Zustand/Redux - 子传父 = 父把回调传下去;兄弟 = 状态提升到共同父级
ref+useImperativeHandle只给命令式场景用(聚焦、打开弹窗),别拿来传业务数据Context值一变,所有消费者都重渲染;高频变化的数据放Context会拖慢页面- 全局事件总线能用但难追踪,卸载时不解绑就是内存泄漏 + 幽灵回调
组件通信就看两个组件隔多远:近的用 props,远的用 Context,又远又复杂的再上状态库。 父传子靠 props,子传父是父组件把回调函数传下去,子组件调用它把数据交回来;兄弟组件就把状态提到共同的父级。主题、语言这种跨很多层、又不常变的信息适合 Context。我的原则是能用 props 就不上 Context,能用 Context 就不上全局库,越往后越难追踪数据从哪来。
- 父子组件通信
- 自定义事件
- redux和context
context如何运用
- 父组件向其下所有子孙组件传递信息
- 如一些简单的信息:主题、语言
- 复杂的公共信息用redux
在跨层级通信中,主要分为一层或多层的情况
- 如果只有一层,那么按照 React 的树形结构进行分类的话,主要有以下三种情况:
父组件向子组件通信,子组件向父组件通信以及平级的兄弟组件间互相通信。 - 在父与子的情况下,因为 React 的设计实际上就是传递
Props即可。那么场景体现在容器组件与展示组件之间,通过Props传递state,让展示组件受控。 - 在子与父的情况下,有两种方式,分别是回调函数与实例函数。回调函数,比如输入框向父级组件返回输入内容,按钮向父级组件传递点击事件等。实例函数的情况有些特别,主要是在父组件中
通过 React 的 ref API 获取子组件的实例,然后是通过实例调用子组件的实例函数。这种方式在过去常见于 Modal 框的显示与隐藏 - 多层级间的数据通信,有两种情况。第一种是一个容器中包含了多层子组件,需要最底部的子组件与顶部组件进行通信。在这种情况下,如果不断透传 Props 或回调函数,不仅代码层级太深,后续也很不好维护。第二种是两个组件不相关,在整个 React 的组件树的两侧,完全不相交。那么基于多层级间的通信一般有三个方案。
- 第一个是使用 React 的
Context API,最常见的用途是做语言包国际化 - 第二个是使用全局变量与事件。
- 第三个是使用状态管理框架,比如 Flux、Redux 及 Mobx。优点是由于引入了状态管理,使得项目的开发模式与代码结构得以约束,缺点是学习成本相对较高
- 第一个是使用 React 的
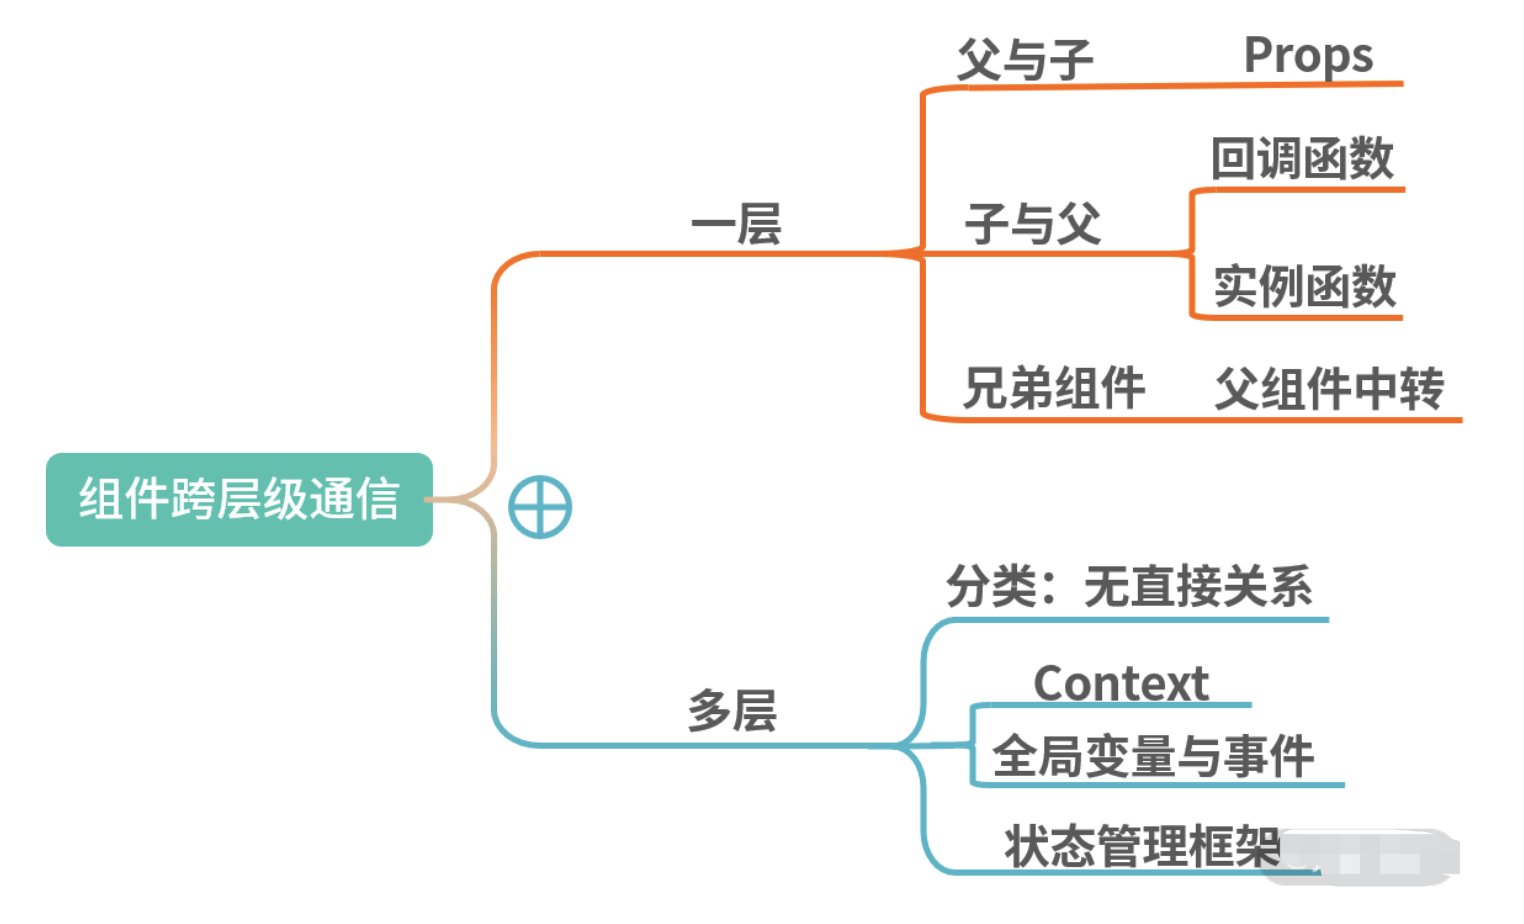
💬 面试官追问
收藏按钮点完要通知父列表更新计数,同事想用
ref拿子组件实例去取值,行吗?不建议。一层的子传父就是回调:父传
onToggle,子点击时onToggle(id, liked)。ref是命令式通道,用来传业务数据会让父组件依赖子组件内部实现,改一次两边一起崩。主题放进
Context后,切一下主题整页卡了半秒,为什么?Context的值一变,所有useContext了它的组件都会重渲染,跳不过去。如果value还是每次渲染新建的对象{ theme, setTheme },连父组件随便一次渲染都会触发。先用useMemo稳住value,再把高频变化的东西拆到单独的Context或状态库里。两个不相干的面板用全局事件同步筛选,页面切走后监听还在执行,查哪里?
看
useEffect里订阅后有没有在清理函数里off掉,以及同一组件是不是注册了多次。这种跨树共享的状态我更倾向换成Zustand这样的store,订阅和卸载由库管,数据从哪改的也能追。父组件要控制一个只暴露
open()/close()方法的第三方弹窗,怎么写?这就是
ref该出场的时候:const r = useRef(); r.current.open()。如果是自己封装的组件,用forwardRef+useImperativeHandle只暴露这两个方法,别把整个实例露出去。小后台只有语言和主题两个全局值,要不要一开始就上
Redux?不用,两个
Context就够了。Redux的收益在多人协作、状态复杂、需要可追溯的场景,两个低频值引进来只有样板没有收益,真复杂了再迁也不迟。
# 24 类组件与函数组件有什么区别呢?
⚡ 30 秒速记
- 用起来和性能上差别不大,真正的差别是心智模型:类 = 实例 + 生命周期,函数 = 每次渲染一份快照
- 函数组件捕获渲染时的
props/state;类组件this.props永远读最新的,异步回调里行为不同 - 逻辑复用:函数组件靠自定义
Hook,类组件靠HOC/render props,前者干净得多 - 性能优化:类用
shouldComponentUpdate/PureComponent,函数用React.memo+useMemo/useCallback - 错误边界目前还只能写类组件(
getDerivedStateFromError/componentDidCatch),React 19也一样
类组件和函数组件渲染出来的东西没区别,差的是写代码时的思路。 类组件围绕实例和生命周期组织代码,同一块业务常常被拆到 componentDidMount、componentDidUpdate、componentWillUnmount 三个地方;函数组件用 Hooks 按功能聚合,一个 useEffect 连订阅带清理写在一起。还有个容易被问到的点:函数组件每次渲染都是一次独立的闭包,异步回调里读到的是当时那次渲染的值,类组件读 this.props 拿的永远是最新值。现在新代码我都写函数组件,只有错误边界还得用类。
- 作为组件而言,类组件与函数组件在使用与呈现上没有任何不同,性能上在现代浏览器中也不会有明显差异
- 它们在开发时的心智模型上却存在巨大的差异。类组件是基于面向对象编程的,它主打的是继承、生命周期等核心概念;而函数组件内核是函数式编程,主打的是 immutable、没有副作用、引用透明等特点。
- 之前,在使用场景上,如果存在需要使用生命周期的组件,那么主推类组件;设计模式上,如果需要使用继承,那么主推类组件。
- 但现在由于 React Hooks 的推出,生命周期概念的淡出,函数组件可以完全取代类组件。
- 其次继承并不是组件最佳的设计模式,官方更推崇“组合优于继承”的设计概念,所以类组件在这方面的优势也在淡出。
- 性能优化上,类组件主要依靠
shouldComponentUpdate阻断渲染来提升性能,而函数组件依靠React.memo缓存渲染结果来提升性能。 - 从上手程度而言,类组件更容易上手,从未来趋势上看,由于React Hooks 的推出,函数组件成了社区未来主推的方案。
- 类组件在未来时间切片与并发模式中,由于生命周期带来的复杂度,并不易于优化。而函数组件本身轻量简单,且在 Hooks 的基础上提供了比原先更细粒度的逻辑组织与复用,更能适应 React 的未来发展。
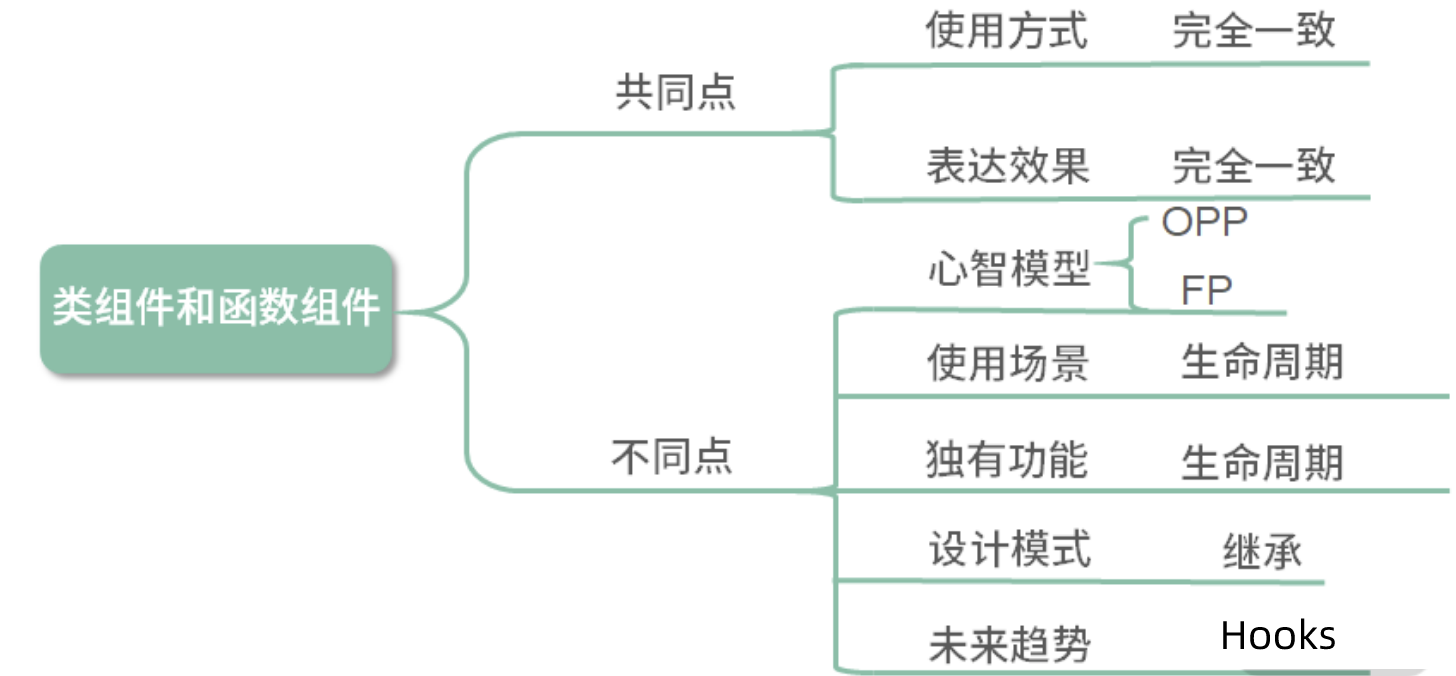
💬 面试官追问
点「关注」后
3秒弹出用户名,期间切到了别的用户,类组件和函数组件弹出的名字一样吗?不一样。类组件
setTimeout(() => alert(this.props.user))读的是最新的props,会弹切换后的人;函数组件闭包里的user是点击那次渲染的值,弹的是原来那个。函数组件的行为才是对的。把类组件改写成函数组件,页面会变快吗?
一般不会,组件形态本身没什么性能差距。改写的价值是逻辑能拆成自定义
Hook复用、副作用更好管,别把重写包装成性能优化去汇报。迁移时有人把每个生命周期都翻译成一个
useEffect,有什么问题?只是换了语法,逻辑还是按时机散着。应该按关注点拆:请求一个
useEffect,订阅一个,各自带依赖和清理。componentDidUpdate里那些if (prev.id !== this.props.id)判断,换成依赖数组[id]就自然消失了。函数组件接实时行情后,每次渲染订阅数都加一,类组件版本没这问题,查哪里?
看订阅是不是写在了渲染函数体里,或者
useEffect没返回取消订阅的函数。还要看依赖:依赖里有每次新建的对象,就会每次渲染都退订再订阅。现在还有什么场景必须写类组件?
错误边界。
getDerivedStateFromError和componentDidCatch至今没有Hook版本,一般项目里写一个类组件包一层,或者直接用react-error-boundary。
# 25 如何设计React组件
⚡ 30 秒速记
- 先分层:基础 / 展示组件(只管长什么样)→ 业务 / 容器组件(管数据和状态)→ 页面
- 单一职责 + 接口最小化:
props语义化、给默认值,受控和非受控都支持 - 组合优于配置:多用
children/ 复合组件,别无限加showXxx开关 - 第三方组件包一层代理组件(比如自己的
Button),埋点、换库都只改一处 - 只服务一个页面的组件留在页面目录,稳定了再往公共
components提 - 基础组件配
TypeScript类型、Storybook、单测,别漏无障碍和暗色模式
设计组件我先想清楚它属于哪一层:只管展示的,还是要管数据的。 展示组件只接 props 渲染,不发请求、不碰全局状态,这样才能复用和单独测;请求、权限这类逻辑留给容器组件或页面。接口上宁可少暴露,多用 children 组合,一个组件加到十几个开关参数基本就该拆了。引第三方组件库时我会包一层代理组件,后面统一加埋点或者换库,业务代码一行都不用动。还有别过早公共化,只有一个页面用的组件就放页面目录里。
React 组件应从设计与工程实践两个方向进行探讨
从设计上而言,社区主流分类的方案是展示组件与灵巧组件
展示组件内部没有状态管理,仅仅用于最简单的展示表达。展示组件中最基础的一类组件称作代理组件。代理组件常用于封装常用属性、减少重复代码。很经典的场景就是引入 Antd 的 Button 时,你再自己封一层。如果未来需要替换掉 Antd 或者需要在所有的 Button 上添加一个属性,都会非常方便。基于代理组件的思想还可以继续分类,分为样式组件与布局组件两种,分别是将样式与布局内聚在自己组件内部。- 从工程实践而言,通过文件夹划分的方式切分代码。我初步常用的分割方式是将页面单独建立一个目录,将复用性略高的 components 建立一个目录,在下面分别建立 basic、container 和 hoc 三类。这样可以保证无法复用的业务逻辑代码尽量留在 Page 中,而可以抽象复用的部分放入 components 中。其中 basic 文件夹放展示组件,由于展示组件本身与业务关联性较低,所以可以使用 Storybook 进行组件的开发管理,提升项目的工程化管理能力
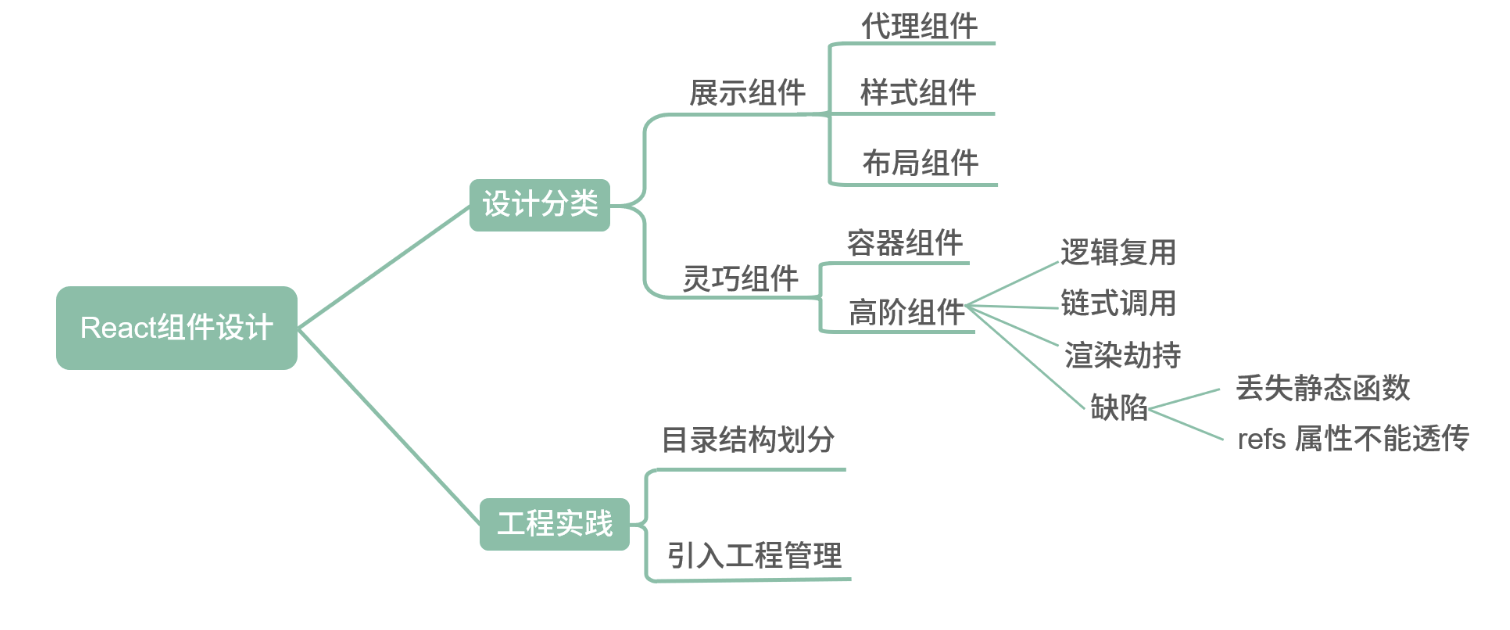
💬 面试官追问
一个「展示组件」里写了请求、权限判断和几十行表格,有什么问题?
它已经不是展示组件了。请求和权限挪到容器层,展示组件只接
data、columns这类props,这样它能在Storybook里单独看,也能拿假数据测。六个页面直接用
antd的Button,现在要统一加埋点,怎么改?加一层自己的
Button:const Button = (p) => <AntButton {...p} onClick={(e) => { track(p.trackId); p.onClick?.(e) }} />,页面全部改引这个。以后换组件库也只改这一个文件,前提是别把底层专有属性全透出去。一个卡片组件已经有
showHeader、showFooter、compact等十几个开关,下一步怎么办?换成组合:
<Card><Card.Header /><Card.Body /></Card>,要什么放什么,开关自然就不需要了。开关一多,组合情况指数级增长,根本测不过来。组件拆成了三十个文件,看一次交互要跳五六层
props,还要继续拆吗?不拆了,拆分看职责和复用,不看行数。只在一个地方用、跟父组件高度耦合的小块,合回去反而好读;
props透传太深说明边界划错了,考虑把状态下放或用Context。团队规定所有组件都放公共
components目录,有什么问题?一次性业务组件进公共目录后,谁都不敢改,改了怕影响别人,接口就僵死了。我会按
basic、业务组件、页面私有分开,页面私有的放pages/xxx/components,被第二个页面用到再提出来。
# 26 组件的协同及(不)可控组件
⚡ 30 秒速记
- 受控:值由
value+onChange决定,状态在React里;非受控:值在DOM里,用defaultValue初始化、ref取值 defaultValue只在挂载时生效,之后再改不会同步到界面- 只写
value不写onChange→ 输入框改不动(React会报只读警告) - 好的组件两种都支持:传了
value走受控,没传用内部state(ahooks的useControllableValue就是这个模式) - 组件协同:父组件嵌套组合、复合组件(
Tabs+Tab,靠Context共享状态);Mixin已废弃,复用逻辑用自定义Hook
受控和非受控的区别就一句话:输入框的值到底听谁的。 受控组件的值存在 state 里,每次输入走 onChange 更新,再通过 value 渲染回去,所以联动、校验、格式化都好做;非受控组件让 DOM 自己存值,只用 defaultValue 给个初始值,提交时用 ref 去读。写组件库时我一般两种都支持,外面传了 value 就听外面的,没传就自己管。至于组件协同,老教程里的 Mixin 早就被 React 废弃了,现在复用逻辑就是自定义 Hook,结构协作用组合和复合组件。
为什么要进行组件的协同
- 我们在实际的开发项目的时候,不会只用几个组件,有时候遇到大型的项目,可能会有成千上百的组件,难免会遇到有功能重复的组件。要进行修改,就会修改大部分的文件。所以我们需要进行组件的协同开发。
什么是组件的协同使用?
- 组件的协同本质上是对组件的一种组织、管理的方式。
- 目的:
- 逻辑清晰:这是组件与组件之间的逻辑
- 代码模块化
- 封装细节:像面向对象一样将常用的方法以及数据封装起来
- 提高代码的复用性:因为是组件,相当于一个封装好的东西,用的时候直接调用
如何实现组件的协同使用
- 第一种:增加一个父组件,将其他的组件进行嵌套,更多的是实现代码的封装
- 第二种:通过一些操作从后台获取数据,
React中的Mixin,更多的是实现代码的复用
组件嵌套的含义
- 组件嵌套的本质是父子关系
组件嵌套的优缺点
- 优点:
- 逻辑清晰:父子关系类似于人类中的父子关系
- 模块化开发:每个模块对应一个功能,不同的模块可以同步开发
- 封装细节:开发者必须要关注组件的功能,不需要了解细节
- 缺点:
- 编写难度高:父子组件的关系需要经过深思熟虑,贸然编写可能导致关系混乱,代码难以维护
- 无法掌握所有细节:使用者只知道组件的用法,不知道实现细节,遇到问题难以修复
Mixin
Mixin的含义
Mixin=一组方法。- 他的目的是横向抽离出组件的相似代码,把组件的共同作用以及效果的代码提出来
Mixin的优缺点
- 优点
- 代码复用:抽离出通用的代码,减少开发成本,提高开发效率
- 即插即用:可以使用许多现有的
Mixin来开发自己的代码 - 适应性强:改动一次代码,影响多个组件
- 缺点
- 编写难度高:
Mixin可能被用在各种环境中,想要兼容多种环境就需要更多的 - 码与逻辑,通用的代价是提高复杂度 - 降低代码的可读性:组件的优势在于将逻辑与是界面直接结合在一起,
Mixin本质上会分散逻辑,理解起来难度大
- 编写难度高:
不可控组件

- 上图:
defaultValue的值是固定的,这就是一个不可控组件 - 如果要获取
input的value值,只有使用ref获取节点来获取值
可控组件

defaultValue的值是根据状态确定了,只需要拿到this.state.value的值就可以了- 这里需要注意一下:使用
value的值是不可修改的,defaultValue的值是可以修改的
可控组件的优点
- 符合
React的数据流 - 数据存储在
state中,便于获取 - 便于处理数据
💬 面试官追问
输入框传了
defaultValue,父组件后来改了这个值,界面没变,为什么?defaultValue只在挂载那一刻用一次,之后值归DOM管。要么改成受控value+onChange;要么给组件换个key(比如key={userId}),强制重新挂载拿新的初始值,切换编辑对象时这招很常用。控制台警告
A component is changing an uncontrolled input to be controlled,怎么来的?多半是
value一开始是undefined,后来变成了字符串,React就认为它从非受控切成了受控。初始值给'':useState(''),别用useState()。文件上传框能做成受控组件吗?
不能,
<input type="file">的值出于安全原因只能用户选,JS只能读不能设,所以它天生是非受控的,用ref或onChange里的e.target.files取。筛选框显示的值和提交出去的参数偶尔不一致,代码里
state和ref各存了一份,怎么改?两个数据源迟早对不上,只留一个。要联动就全走
state;只在提交时读一次就全走ref,别一边value渲染一边又从DOM读。十几个组件要复用请求和日志逻辑,老代码在用
Mixin,新代码怎么写?Mixin从createClass时代就被官方判了死刑,命名冲突、来源不清。新代码写成useRequest、useLogger这种自定义Hook,调用处一眼能看出状态从哪来;老的Mixin别急着全推翻,碰到再改。
# 27 React-Router 的实现原理及工作方式分别是什么
⚡ 30 秒速记
- 原理三步:监听
URL变化 → 匹配路由表 → 渲染对应组件 Hash模式:改location.hash,监听hashchange,#后面不发给服务器,刷新不会404History模式:pushState/replaceState改地址,监听popstate;pushState本身不触发popstate,路由库要自己通知更新History模式刷新或直接打开深层地址会真请求服务器,必须配回退到index.html- 路由状态靠
Context往下传,useLocation/useNavigate在任意层都能拿 - 版本:
v6用Routes替代Switch、useNavigate替代useHistory;v6.4加了loader/action;v7合并进react-router包
React Router 说白了就是监听地址变化,再根据地址决定渲染哪个组件,整个过程不刷新页面。 地址怎么变有两种:Hash 模式改 # 后面的部分,浏览器不会发请求,监听 hashchange 就行;History 模式用 pushState 改真实路径,地址好看,但 pushState 不会触发任何事件,所以 Link 点击时是路由库自己通知订阅者重新匹配,只有浏览器前进后退才触发 popstate。History 模式还有个必踩的坑:用户直接打开 /orders/1001,请求是真打到服务器的,nginx 得配 try_files 回退到 index.html。
React Router路由的基础实现原理分为两种,如果是切换 Hash的方式,那么依靠浏览器Hash变化即可;如果是切换网址中的Path,就要用到HTML5 History API中的pushState、replaceState等。在使用这个方式时,还需要在服务端完成historyApiFallback配置- 在
React Router内部主要依靠history库完成,这是由React Router自己封装的库,为了实现跨平台运行的特性,内部提供两套基础history,一套是直接使用浏览器的History API,用于支持react-router-dom;另一套是基于内存实现的版本,这是自己做的一个数组,用于支持react-router-native。 React Router的工作方式可以分为设计模式与关键模块两个部分。从设计模式的角度出发,在架构上通过Monorepo进行库的管理。Monorepo具有团队间透明、迭代便利的优点。其次在整体的数据通信上使用了 Context API 完成上下文传递。- 在关键模块上,主要分为三类组件:
第一类是 Context 容器,比如 Router 与 MemoryRouter;第二类是消费者组件,用以匹配路由,主要有 Route、Redirect、Switch 等;第三类是与平台关联的功能组件,比如Link、NavLink、DeepLinking等。
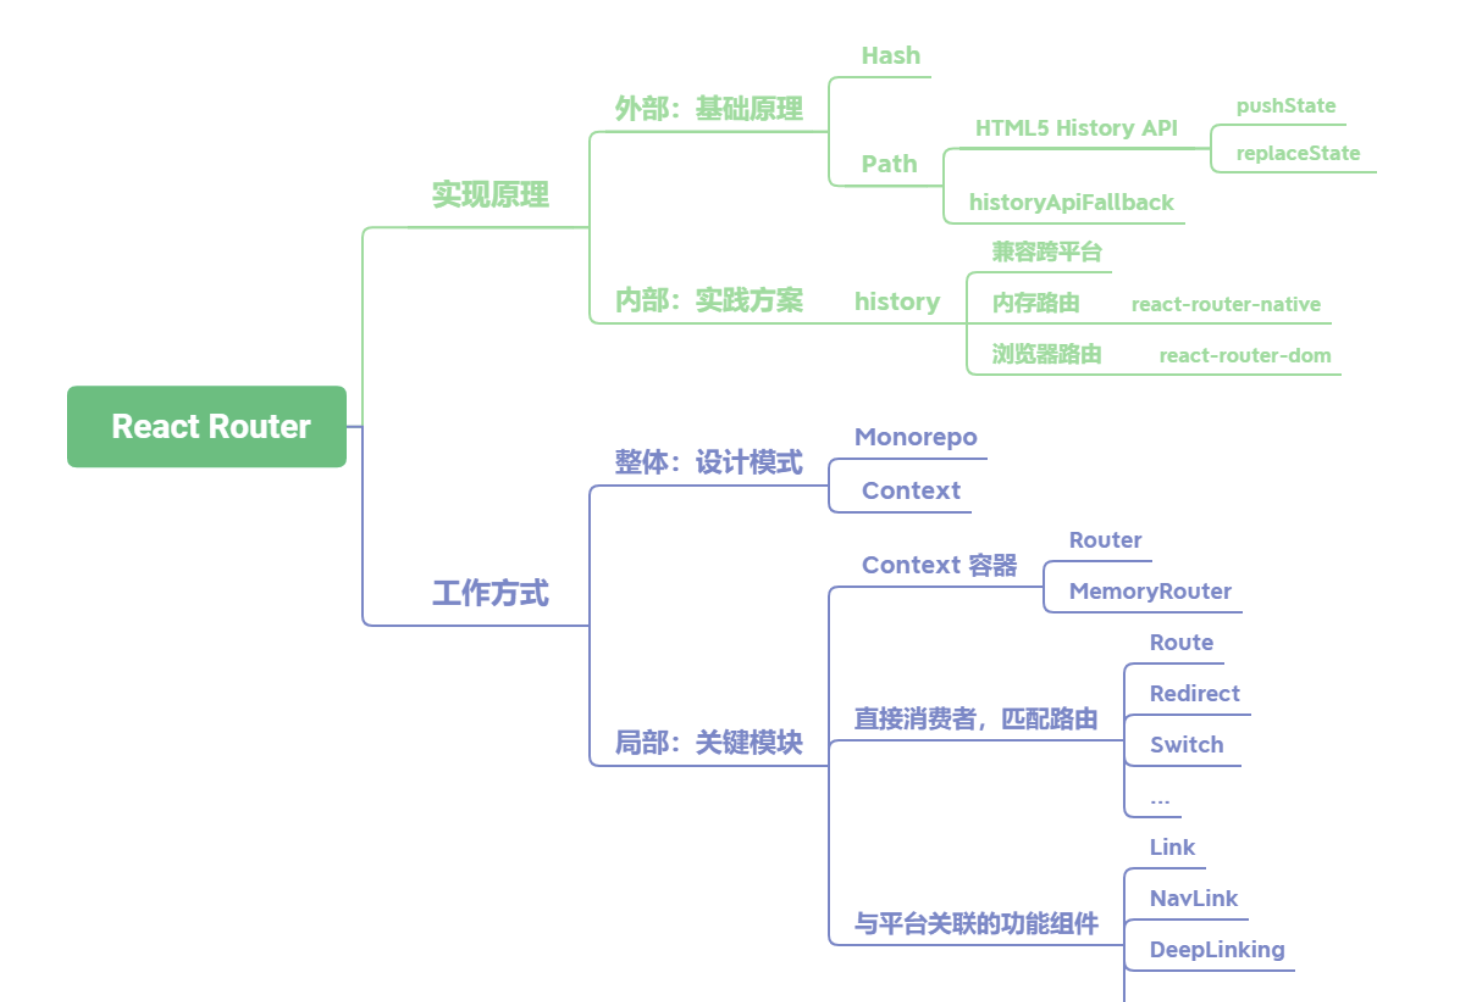
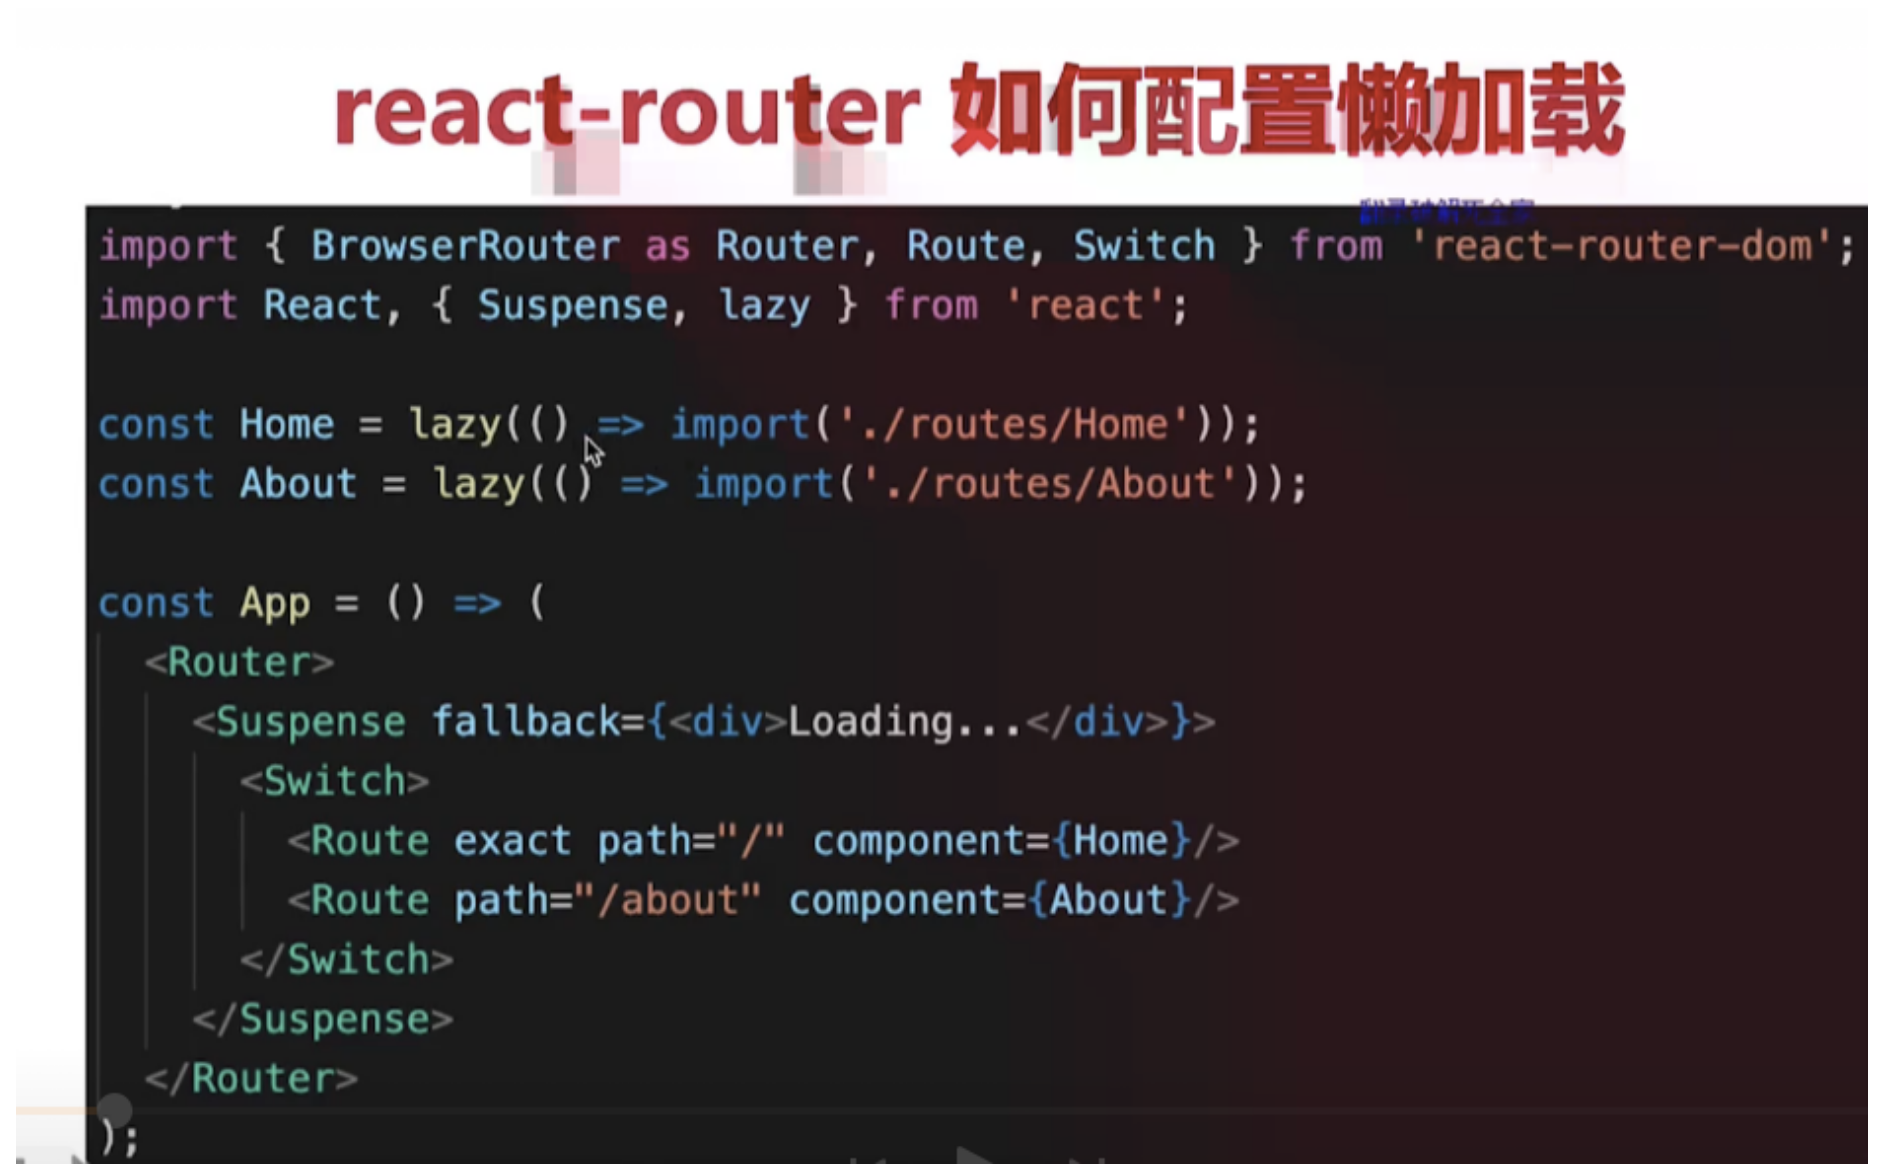
React router原理分析 (opens new window)
💬 面试官追问
直接打开
/orders/1001是404,从首页点Link进去却正常,为什么?点
Link是pushState改地址,没发请求;直接打开是真请求服务器,服务器上没这个文件。nginx加try_files $uri $uri/ /index.html;,静态资源和/api要排在前面匹配,别全回退成HTML。自己实现一个
History路由,调完pushState页面没反应,缺了什么?pushState只改地址不发事件,popstate只在前进后退时触发。要自己封一个push:history.pushState(null, '', url); listeners.forEach(fn => fn(url)),再监听popstate处理前进后退。HashRouter和BrowserRouter怎么选?有服务器配置权限、要
SEO、要好看的地址,就用BrowserRouter。部署在只能放静态文件、改不了回退规则的地方(比如某些静态托管、内嵌WebView的本地文件),用HashRouter最省事。单测里没有浏览器地址栏,路由组件怎么测?
用
MemoryRouter,它用数组在内存里维护历史记录:<MemoryRouter initialEntries={['/orders/1']}>。它不碰真实地址栏,所以测的是匹配和渲染逻辑,不是浏览器导航本身。从
v5升到v6,最常改的是哪几处?Switch换Routes,component={X}换element={<X />},useHistory().push换useNavigate(),嵌套路由用<Outlet />占位。路径匹配也变了,v6默认就是精确匹配,exact没了。
# 28 React 17 带来了哪些改变
⚡ 30 秒速记
- 定位:「没有新特性」的过渡版本,主要为渐进升级铺路,允许一个页面跑多个
React版本 - 事件委托从
document挪到root容器,微前端、多版本共存不再互相干扰 - 去掉事件池:异步里读
e.target不用再e.persist() - 新
JSX转换:编译器自动引入react/jsx-runtime,不用手写import React(也回补到了16.14) useEffect清理函数改成异步执行;onScroll不再冒泡,onFocus/onBlur改用focusin/focusout- 内部调度换成
Lane模型(二进制位表示优先级),给React 18并发更新打基础
React 17 是个过渡版本,没加什么新 API,主要是把以后升级的路铺平。 对业务影响最大的是事件系统:以前所有事件都委托在 document 上,现在挂在 createRoot / render 的那个容器节点上,一个页面里嵌两个不同版本的 React 也不会互相拦截事件,微前端受益最大。顺手还去掉了事件池,异步回调里读事件对象不用再 e.persist()。另外就是新的 JSX 转换,编译器自动引入 react/jsx-runtime,文件里不写 import React 也能编译。源码层面引入了 Lane 模型,用位运算表示优先级,这是 React 18 并发特性的地基。
最重要的是以下三点:
- 新的
JSX转换逻辑 - 事件系统重构
Lane 模型的引入
1. 重构 JSX 转换逻辑
在过去,如果我们在 React 项目中写入下面这样的代码:
function MyComponent() {
return <p>这是我的组件</p>
}
React 是会报错的,原因是 React 中对 JSX 代码的转换依赖的是 React.createElement 这个函数。因此但凡我们在代码中包含了 JSX,那么就必须在文件中引入 React,像下面这样:
import React from 'react';
function MyComponent() {
return <p>这是我的组件</p>
}
而 React 17 则允许我们在不引入 React 的情况下直接使用 JSX。这是因为在 React 17 中,编译器会自动帮我们引入 JSX 的解析器,也就是说像下面这样一段逻辑:
function MyComponent() {
return <p>这是我的组件</p>
}
会被编译器转换成这个样子:
import {jsx as _jsx} from 'react/jsx-runtime';
function MyComponent() {
return _jsx('p', { children: '这是我的组件' });
}
react/jsx-runtime 中的 JSX 解析器将取代 React.createElement 完成 JSX 的编译工作,这个过程对开发者而言是自动化、无感知的。因此,新的 JSX 转换逻辑带来的最显著的改变就是降低了开发者的学习成本。
react/jsx-runtime 中的 JSX 解析器看上去似乎在调用姿势上和 React.createElement 区别不大,那么它是否只是 React.createElement 换了个马甲呢?当然不是,它在内部实现了 React.createElement 无法做到的性能优化和简化。在一定情况下,它可能会略微改善编译输出内容的大小
2. 事件系统重构
事件系统在 React 17 中的重构要从以下两个方面来看:
- 卸掉历史包袱
- 拥抱新的潮流
2.1 卸掉历史包袱:放弃利用 document 来做事件的中心化管控
React 16.13.x 版本中的事件系统会通过将所有事件冒泡到 document 来实现对事件的中心化管控
这样的做法虽然看上去已经足够巧妙,但仍然有它不聪明的地方——document 是整个文档树的根节点,操作 document 带来的影响范围实在是太大了,这将会使事情变得更加不可控
在 React 17 中,React 团队终于正面解决了这个问题:事件的中心化管控不会再全部依赖
document,管控相关的逻辑被转移到了每个 React 组件自己的容器 DOM 节点中。比如说我们在 ID 为 root 的 DOM 节点下挂载了一个 React 组件,像下面代码这样:
const rootElement = document.getElementById("root");
// 这里沿用 React 17 的写法说明事件挂载位置的变化;React 18 起写作
// ReactDOM.createRoot(rootElement).render(<App />),事件同样挂在这个容器节点上
ReactDOM.render(<App />, rootElement);
那么事件管控相关的逻辑就会被安装到 root 节点上去。这样一来, React 组件就能够自己玩自己的,再也无法对全局的事件流构成威胁了
2.2 拥抱新的潮流:放弃事件池
在 React 17 之前,合成事件对象会被放进一个叫作“事件池”的地方统一管理。这样做的目的是能够实现事件对象的复用,进而提高性能:每当事件处理函数执行完毕后,其对应的合成事件对象内部的所有属性都会被置空,意在为下一次被复用做准备。这也就意味着事件逻辑一旦执行完毕,我们就拿不到事件对象了,React 官方给出的这个例子就很能说明问题,请看下面这个代码
function handleChange(e) {
// This won't work because the event object gets reused.
setTimeout(() => {
console.log(e.target.value); // Too late!
}, 100);
}
异步执行的
setTimeout回调会在handleChange这个事件处理函数执行完毕后执行,因此它拿不到想要的那个事件对象e。
要想拿到目标事件对象,必须显式地告诉 React——我永远需要它,也就是调用 e.persist() 函数,像下面这样:
function handleChange(e) {
// Prevents React from resetting its properties:
e.persist();
setTimeout(() => {
console.log(e.target.value); // Works
}, 100);
}
在 React 17 中,我们不需要 e.persist(),也可以随时随地访问我们想要的事件对象。
3. Lane 模型的引入
初学 React 源码的同学由此可能会很自然地认为:优先级就应该是用 Lane 来处理的。但事实上,React 16 中处理优先级采用的是 expirationTime 模型。
expirationTime模型使用expirationTime(一个时间长度) 来描述任务的优先级;而Lane 模型则使用二进制数来表示任务的优先级:
lane 模型通过将不同优先级赋值给一个位,通过 31 位的位运算来操作优先级。
Lane 模型提供了一个新的优先级排序的思路,相对于 expirationTime 来说,它对优先级的处理会更细腻,能够覆盖更多的边界条件。
💬 面试官追问
删掉
import React后还能编译,是浏览器支持JSX了吗?不是,是
Babel/TS用了新的JSX转换,自动在文件顶部插入import { jsx as _jsx } from 'react/jsx-runtime'。要求@babel/preset-react配runtime: 'automatic',或者tsconfig里"jsx": "react-jsx",没配的话删了照样报错。页面上老代码在
document上监听click并e.stopPropagation(),升级17后有什么变化?16时React事件也挂在document上,你在原生监听里阻止冒泡可能拦不住React;17挂在root上,原生事件冒泡到root时React已经处理完了,document上的监听拿不到被React里stopPropagation掉的事件。反过来,以前靠document监听做「点击外部关闭」的代码可能失效,要重测。setTimeout里读e.target.value,在16里拿到null,17呢?17正常。16有事件池,回调结束后事件对象会被清空复用,所以要e.persist();17去掉了事件池,persist()还在但什么也不做,可以删。升级
17后,组件卸载时的useEffect清理顺序有什么变化?清理函数改成异步执行,在屏幕更新之后才跑,不再阻塞卸载。所以清理里别再去读
ref.current指向的DOM,可能已经是null了,先在effect里存一份局部变量再用。Lane模型对业务代码有什么影响?几乎没有直接影响,它是调度器内部用位掩码表示优先级,比原来的
expirationTime能表达「一批更新」这种关系。它的意义在于给React 18的startTransition、自动批处理打了底子,面试说清这层关系就够了。
# 八、性能
# 1 DNS 预解析
⚡ 30 秒速记
- 作用:提前把域名解析成
IP,真正请求时省掉一次DNS查询(几十到上百毫秒) - 写法:
<link rel="dns-prefetch" href="//cdn.example.com">,放head越前越好 - 更进一步用
preconnect:连TCP握手和TLS一起提前做,跨域资源要加crossorigin - 只给首屏确定会用的
2~4个第三方域名加;同域名和写死IP的请求没收益 HTTPS页面里<a>链接的自动预解析默认关闭,显式写的dns-prefetch不受影响
DNS 预解析就是趁浏览器空闲,提前把后面要用的域名解析成 IP,等真正请求时直接用。 比如首屏图片在 img.example.com,浏览器得先查 DNS 才能连,加一行 <link rel="dns-prefetch" href="//img.example.com"> 就能把这一步提前。现在我更常用 preconnect,它连 TCP 和 TLS 握手都提前做完,收益更大,但每个预连接都占资源,只给最关键的两三个域名,其他的用 dns-prefetch 兜底。别全站域名都塞进去,用户不会访问的域名就是白查。
DNS解析也是需要时间的,可以通过预解析的方式来预先获得域名所对应的IP
<link rel="dns-prefetch" href="//blog.poetries.top">
预解析只是第一步,看清一次请求前的准备工作
浏览器请求一个新域名的资源,真正发请求之前要走三步:DNS 解析拿到 IP、TCP 三次握手、HTTPS 的话再来一轮 TLS 握手。移动网络下这三步加起来动不动就是几百毫秒。资源提示就是让浏览器把这些步骤提前做:
<!-- 只做 DNS 解析,成本最低,可以多写几个 -->
<link rel="dns-prefetch" href="//static.example.com">
<!-- DNS + TCP + TLS 全做完,收益最大,只给关键的 2~4 个域名 -->
<link rel="preconnect" href="https://img.example.com" crossorigin>
几个容易忽略的点:
- 同域资源不需要加,主站域名在请求
HTML时已经解析过了。 HTTPS页面上,浏览器对页面里<a href>的自动预解析默认是关的,可以用<meta http-equiv="x-dns-prefetch-control" content="on">打开;但手写的<link rel="dns-prefetch">不受这个开关影响。- 效果怎么验:
DevTools的Network面板点开请求看Timing,DNS Lookup和Initial connection变成0或消失,就说明提前做掉了。
💬 面试官追问
商品页有地图、客服、埋点、两个
CDN共五个第三方域名,全加dns-prefetch吗?不会。只加首屏确定会请求的,比如图片
CDN;客服、地图这种点了才加载的不加。DNS查询本身不贵,但列一堆没用的就是噪音,也说明没梳理过请求链路。dns-prefetch和preconnect怎么选?preconnect把DNS、TCP、TLS全提前,收益大但会占一条连接,浏览器大约10秒没用就关掉,只给马上要用的关键域名。两个可以叠着写:<link rel="preconnect" href="https://cdn.x.com" crossorigin><link rel="dns-prefetch" href="https://cdn.x.com">,不支持preconnect的浏览器至少能拿到DNS。加了
dns-prefetch,瀑布图里接口还是等很久,是不是没生效?先看
Timing里慢在哪一段。DNS Lookup接近0说明已经生效了,慢在Waiting (TTFB)那是服务端的事,预解析管不了。还要确认href写的主机名和实际请求的完全一致,api.x.com和x.com是两个域名。字体文件用了
preconnect,结果还是重新建了一次连接,为什么?字体请求是匿名跨域模式,
preconnect不加crossorigin建的是带凭证的连接,两种连接不能复用。给preconnect补上crossorigin就好。
# 2 缓存
⚡ 30 秒速记
- 两层:强缓存(不发请求直接用)→ 过期了走协商缓存(发请求,没变就回
304) - 强缓存看
Cache-Control: max-age,优先级高于Expires(Expires是绝对时间,受本地时钟影响) - 协商缓存:
ETag/If-None-Match(内容指纹,更准)优先于Last-Modified/If-Modified-Since(秒级) - 标准配法:
HTML用no-cache;带hash的JS/CSS用max-age=31536000, immutable - 易错:
no-cache是「能存但每次要问」,no-store才是真不存;强缓存命中显示200 (from disk cache)
浏览器缓存分两层:强缓存期间连请求都不发,过期了再带着标识去问服务器内容变没变。 强缓存靠 Cache-Control: max-age,命中时 Network 里显示 200 加 from memory cache 或 from disk cache;过期后浏览器带上 If-None-Match 去问,服务器发现 ETag 没变就回 304,不传响应体。实际项目我的配法很固定:HTML 入口用 no-cache,保证每次都能拿到最新的资源引用;打包出来带内容 hash 的文件直接缓存一年,内容一变文件名就变,天然不会读到旧的。
- 缓存对于前端性能优化来说是个很重要的点,良好的缓存策略可以降低资源的重复加载提高网页的整体加载速度
- 通常浏览器缓存策略分为两种:强缓存和协商缓存
强缓存
实现强缓存可以通过两种响应头实现:
Expires和Cache-Control。强缓存表示在缓存期间不需要请求,state code为200
Expires: Wed, 22 Oct 2018 08:41:00 GMT
Expires是HTTP / 1.0的产物,表示资源会在Wed, 22 Oct 2018 08:41:00 GMT后过期,需要再次请求。并且Expires受限于本地时间,如果修改了本地时间,可能会造成缓存失效
Cache-control: max-age=30
Cache-Control出现于HTTP / 1.1,优先级高于Expires。该属性表示资源会在30秒后过期,需要再次请求
协商缓存
- 如果缓存过期了,我们就可以使用协商缓存来解决问题。协商缓存需要请求,如果缓存有效会返回 304
- 协商缓存需要客户端和服务端共同实现,和强缓存一样,也有两种实现方式
Last-Modified 和 If-Modified-Since
Last-Modified表示本地文件最后修改日期,If-Modified-Since会将Last-Modified的值发送给服务器,询问服务器在该日期后资源是否有更新,有更新的话就会将新的资源发送回来- 但是如果在本地打开缓存文件,就会造成
Last-Modified被修改,所以在HTTP / 1.1出现了ETag
ETag 和 If-None-Match
ETag类似于文件指纹,If-None-Match会将当前ETag发送给服务器,询问该资源 ETag 是否变动,有变动的话就将新的资源发送回来。并且ETag优先级比Last-Modified高
选择合适的缓存策略
对于大部分的场景都可以使用强缓存配合协商缓存解决,但是在一些特殊的地方可能需要选择特殊的缓存策略
- 对于某些不需要缓存的资源,可以使用
Cache-control: no-store,表示该资源不需要缓存 - 对于频繁变动的资源,可以使用
Cache-Control: no-cache并配合ETag使用,表示该资源已被缓存,但是每次都会发送请求询问资源是否更新。 - 对于代码文件来说,通常使用
Cache-Control: max-age=31536000并配合策略缓存使用,然后对文件进行指纹处理,一旦文件名变动就会立刻下载新的文件
💬 面试官追问
配置接口一天改好几次,后端给了一年
max-age,前端说加个ETag就能实时,对吗?不对。强缓存有效期内浏览器根本不发请求,
ETag没机会出场。这种接口要改成Cache-Control: no-cache配ETag,每次都问一下,没变就304。刚发版,用户反馈
app.js还是旧的,Network显示200没走服务器,怎么回事?命中了强缓存。问题出在用固定文件名配了长
max-age,浏览器没理由去更新。正确做法是文件名带contenthash,比如app.3f9a1c.js,HTML用no-cache,发版后HTML引用新文件名,旧缓存自然作废。登录后的个人信息接口,安全要求不能缓存,用
no-cache行吗?不行,
no-cache照样会存到本地,只是用之前要验证。敏感数据要Cache-Control: no-store;如果中间有CDN,再加private防止被共享缓存存下来。为什么有了
Last-Modified还要ETag?Last-Modified只精确到秒,一秒内改两次识别不出来;文件内容没变但被重新部署、修改时间变了,又会白白返回完整内容。ETag是内容指纹,变没变一比就知道,代价是服务端要算。HTML也配了max-age=3600,会出什么问题?发版后一小时内用户拿到的还是旧
HTML,引用的是旧的hash文件。如果旧文件已经从服务器删了,页面直接白屏。所以HTML一律no-cache,旧版本的静态资源也要保留一段时间再删。
# 3 使用 HTTP / 2.0
⚡ 30 秒速记
- 核心改进:二进制分帧 + 多路复用,一个域名一条
TCP连接并发跑所有请求 - 头部压缩
HPACK:重复的Cookie、User-Agent不用每次都传全量 - 服务端推送基本已死:
Chrome 106起默认移除,用preload/103 Early Hints代替 - 浏览器只在
HTTPS上用HTTP/2;老优化要重新评估:域名分片、雪碧图、过度合并文件可能变成负优化 - 没解决
TCP层队头阻塞:丢一个包整条连接都等,HTTP/3换成基于UDP的QUIC解决
HTTP/2 最核心的是多路复用:同一个域名只开一条 TCP 连接,所有请求切成帧交错着传,谁也不用排队等谁。 HTTP/1.1 下浏览器对同一域名最多开 6 条连接,第七个请求只能排队,所以以前才有域名分片、雪碧图、合并文件这些技巧;到了 HTTP/2,这些技巧反而会多建连接、让缓存粒度变粗。它还有头部压缩,Cookie 这种每次都带的大头部能省不少。但它没解决 TCP 本身丢包时的队头阻塞,弱网下丢一个包所有请求一起卡,这也是 HTTP/3 改用 QUIC 的原因。
- 因为浏览器会有并发请求限制,在
HTTP / 1.1时代,每个请求都需要建立和断开,消耗了好几个RTT时间,并且由于TCP慢启动的原因,加载体积大的文件会需要更多的时间 - 在
HTTP / 2.0中引入了多路复用,能够让多个请求使用同一个TCP链接,极大的加快了网页的加载速度。并且还支持Header压缩,进一步的减少了请求的数据大小
为什么 HTTP/1.1 慢,HTTP/2 到底改了什么
HTTP/1.1 一条连接同时只能处理一个请求,响应没回来下一个就得等(管线化理论上可以,但浏览器基本都没开)。浏览器为了并发,对同一个域名最多开 6 条连接,第 7 个请求就在 Network 面板里显示为 Stalled / Queueing。
HTTP/2 把每个请求、响应拆成带编号的二进制帧,在一条连接上交错发送,接收方按编号重新组装。效果是:
HTTP/1.1:连接1 [a.js 等待........] [d.js ...]
连接2 [b.css ...] [e.png ...] 最多 6 条,多了排队
HTTP/2: 连接1 a b c a d b e a c ... 一条连接,帧交错传输
对前端优化的影响:
- 域名分片不再需要,反而增加握手成本,收敛到一两个静态域名。
- 小图标合成雪碧图的收益变小,改一个图标整张图缓存失效,
SVG图标单独请求更合适。 - 打包要按「变化频率」拆分
chunk,第三方库单独一个包长期缓存,业务代码一个包。
前提是 HTTPS:浏览器都只支持基于 TLS 的 HTTP/2,nginx 上 listen 443 ssl http2;(新版本写 http2 on;)即可开启。
💬 面试官追问
网关说已经开了
HTTP/2,怎么确认页面真用上了?Network面板右键表头勾上Protocol列,看是不是h2。再看Connection ID列,同一域名的请求共用一个ID才说明复用上了。中间有一层代理只支持HTTP/1.1的话,会悄悄降级。迁到
HTTP/2后,以前拆的static1、static2、static3三个域名要不要合并?要合并。多域名就是多条连接,每条都要握手和慢启动,还用不上同一个连接的多路复用和头部压缩。如果几个域名解析到同一
IP且证书都覆盖,浏览器其实也会合并连接,但别指望这个。都
HTTP/2了,是不是可以不打包,几百个小文件直接请求?不建议走极端。请求多了,每个请求的头部、服务端处理和浏览器调度都有成本,压缩率也比大文件差。合理做法是按路由和变化频率拆成几十个
chunk,既不是一个大包也不是几百个碎文件。弱网下
HTTP/2有时比HTTP/1.1还慢,为什么?HTTP/2所有请求挤在一条TCP连接里,丢一个包整条连接都要等重传;HTTP/1.1有6条连接,丢包只卡其中一条。这就是TCP层的队头阻塞,HTTP/3在QUIC里按流独立重传才解决。服务端推送现在还能用吗?
基本不能用了,
Chrome 106起默认关掉,推过去的资源经常和浏览器缓存重复,收益很差。想让浏览器早点拿关键资源,用<link rel="preload">,或者服务端返回103 Early Hints。
# 4 预加载
⚡ 30 秒速记
<link rel="preload">= 告诉浏览器「本页马上要用这个」,提前以高优先级下载,下载完不执行- 必须写
as(script/style/font/image),不写会以错误优先级下载,后面可能再下一次 - 字体预加载必须加
crossorigin,同域也要加,否则请求两次 - 适合「发现得晚」的关键资源:
CSS里引用的字体、JS里才插入的首屏大图、LCP图片 - 和
prefetch的区别:preload管当前页、高优先级;prefetch管下一页、空闲时低优先级下 - 别滥用:标太多会抢关键资源的带宽,
3秒没用上Chrome会在控制台警告
preload 是让浏览器提前下载当前页面一定会用、但它自己发现得很晚的资源。 典型例子是字体:浏览器要先下载 CSS、解析完才知道需要哪个字体文件,这时候再请求就晚了,用 preload 可以在解析 HTML 时就开始下载。写的时候有两个坑:as 必须写对,否则优先级不对还可能重复下载;字体还必须加 crossorigin。原来说「它不阻塞 onload、兼容性不好」已经过时了,现在主流浏览器都支持,真正要注意的是别把不确定会用的资源也标上,它会抢首屏带宽。
- 在开发中,可能会遇到这样的情况。有些资源不需要马上用到,但是希望尽早获取,这时候就可以使用预加载
- 预加载其实是声明式的
fetch,强制浏览器以高优先级请求资源,下载完不执行。as属性必须写,用来告诉浏览器资源类型;不写的话优先级和请求模式都不对,真正使用时往往还会再请求一次
<!-- 字体:as + type + crossorigin 三件套,缺 crossorigin 必然下两次 -->
<link rel="preload" href="/fonts/inter.woff2" as="font" type="font/woff2" crossorigin>
<!-- 首屏 LCP 大图:配合 fetchpriority 提到最高 -->
<link rel="preload" href="/hero.webp" as="image" fetchpriority="high">
<!-- 关键 CSS -->
<link rel="preload" href="/critical.css" as="style">
预加载可以把首屏一定会用、但浏览器发现得晚的关键资源提前下载,从而降低首屏加载时间,主流浏览器都已支持
什么资源值得 preload?判断标准是「当前页一定会用 + 浏览器发现得晚」:
CSS里@font-face引用的字体,要等CSS下载解析完才发现。CSS背景图或JS动态插入的首屏大图。- 被另一个
JS动态import的关键模块。
直接写在 HTML 里的 <img>、<script> 本来就会被预加载扫描器提前发现,再 preload 没意义。
验证方法:Network 面板看资源的 Priority 列是否变成 High、请求开始时间有没有提前;如果控制台出现「preloaded but not used within a few seconds」警告,说明这个资源标错了,要么没用上,要么 as 写错了。
💬 面试官追问
网络面板里同一个字体文件下了两次,页面明明加了
preload,为什么?大概率是少了
crossorigin。字体是匿名跨域模式请求的,preload不加crossorigin就按带凭证模式下,两个请求匹配不上,只能再下一次。正确写法:<link rel="preload" href="/f.woff2" as="font" type="font/woff2" crossorigin>。详情页的视频用户点了才播放,产品要求首屏
preload一下,你同意吗?不同意。
preload是高优先级下载,会和首屏图片、CSS抢带宽,视频体积又大,用户不点就白下了。真想提前可以用<video preload="metadata">只拿元信息,或者鼠标悬停时再加载。LCP图片是CSS背景图,加载很晚,怎么优化?浏览器得等
CSS解析完才发现这张图。加<link rel="preload" as="image" href="hero.webp" fetchpriority="high">,或者干脆改成<img>标签让预加载扫描器一开始就能看到。下一页才会用的模块,有人全标成
preload,对吗?不对,那是
prefetch的活。preload是当前页高优先级,标了会挤占首屏;prefetch是空闲时低优先级下载放进缓存,下一页直接用。路由懒加载可以写import(/* webpackPrefetch: true */ './Detail')。preload和script的defer/async是一回事吗?不是。
preload只管「早点下载」,下完不执行;defer/async管的是脚本下载后什么时候执行。可以组合:preload让关键脚本提前开始下,真正执行还是由<script defer>控制。
# 5 预渲染
⚡ 30 秒速记
- 两种「预渲染」别混:构建期生成静态
HTML(SSG)和浏览器后台提前渲染下一页 <link rel="prerender">已过时:Chrome早把它降级成只预取不渲染(NoState Prefetch)- 现在的方案是
Speculation Rules API:<script type="speculationrules">声明prerender/prefetch,目前只有Chromium系支持 - 只给几乎必达的下一页用,否则白耗流量、
CPU和内存;低端机和省流模式下浏览器会自己跳过 - 被预渲染的页面要防副作用:埋点、计数要等
document.prerendering变false再上报
浏览器预渲染就是在后台把用户下一步大概率要打开的页面整个渲染好,点过去瞬间显示。 原来常写的 <link rel="prerender"> 已经过时了,Chrome 早就把它降级成只预取资源不渲染,现在要用 Speculation Rules API,在页面里写一段 JSON 规则声明哪些链接要预渲染。它代价很重,等于后台多开了一个页面,所以只给几乎确定会去的页面用,比如搜索结果第一条、支付成功后的订单页。还要注意被预渲染的页面里埋点会提前执行,统计会虚高。另外面试官说「预渲染」也可能指构建时生成 HTML 的 SSG,要先问清楚。
可以通过预渲染将下载的文件预先在后台渲染,可以使用以下代码开启预渲染
<link rel="prerender" href="http://poetries.com">
- 预渲染虽然可以提高页面的加载速度,但是要确保该页面百分百会被用户在之后打开,否则就白白浪费资源去渲染
总结
defer和async在网络读取的过程中都是异步解析defer是有顺序依赖的,async只要脚本加载完后就会执行preload可以对当前页面所需的脚本、样式等资源进行预加载prefetch加载的资源一般不是用于当前页面的,是未来很可能用到的这样一些资源
浏览器预渲染的现代写法:Speculation Rules API
<link rel="prerender"> 是早期规范,Chrome 63 起已经把它降级为 NoState Prefetch(只下载资源,不执行脚本、不渲染)。现在 Chromium 系浏览器推荐用投机规则:
<script type="speculationrules">
{
"prerender": [
{ "source": "list", "urls": ["/order/detail"] }
],
"prefetch": [
{
"source": "document",
"where": { "href_matches": "/product/*" },
"eagerness": "moderate"
}
]
}
</script>
eagerness 决定触发时机:immediate 立刻、moderate 鼠标悬停一会儿、conservative 按下鼠标时。不确定的链接用 moderate 比较稳。
被预渲染的页面要处理副作用:
function whenActivated(cb) {
if (document.prerendering) {
document.addEventListener('prerenderingchange', cb, { once: true })
} else {
cb()
}
}
whenActivated(() => track('page_view')) // 真正被打开才上报
不支持的浏览器会直接忽略这段 script,不影响正常访问,所以可以放心渐进增强。
💬 面试官追问
首页一百个商品链接,运营要求全部预渲染,你批吗?
不批。每个预渲染都相当于后台开一个完整页面,一百个直接把用户内存和流量打爆,
Chrome本身也对数量有上限。用Speculation Rules的eagerness: "moderate",鼠标悬停200ms左右才触发,命中率高还不浪费。预渲染上线后,详情页
PV涨了三成,但成交没涨,可能是什么原因?被预渲染但用户没打开的页面也执行了埋点。上报前检查
document.prerendering,为true时监听prerenderingchange事件,真正被激活再上报。<link rel="prerender">现在还有用吗?基本没用了。
Chrome里它只会预取资源、不执行渲染,Safari、Firefox不支持。要真正的预渲染换成<script type="speculationrules">{"prerender":[{"urls":["/order"]}]}</script>。prefetch和prerender怎么选?prefetch只下载下一页的HTML或资源,便宜;prerender连JS执行和渲染都做了,最快也最贵。下一页去不去不确定就prefetch,几乎必达而且首屏重才prerender。面试官说「我们做了预渲染优化
SEO」,指的是同一个东西吗?不是,那是构建期预渲染:用
SSG或prerender-spa-plugin这类工具在打包时把路由渲染成静态HTML,爬虫拿到的就是有内容的页面。和浏览器后台预渲染下一页完全是两回事。
# 6 懒执行与懒加载
⚡ 30 秒速记
- 懒加载 = 用到时才下载(图片、视频、路由代码);懒执行 = 已经下载了但推迟运行(非关键计算)
- 图片懒加载现在首选原生
loading="lazy",要自定义提前量才用IntersectionObserver+rootMargin - 首屏图片反过来:不能懒加载,
LCP图加fetchpriority="high" - 必须预留尺寸(
width/height或aspect-ratio),否则图片加载完把下面内容顶下去,CLS变差 - 代码层面:路由
import()/React.lazy分包;非关键逻辑放requestIdleCallback或交互触发时执行
懒加载是推迟下载,懒执行是推迟运行,目的一样:别让首屏用不到的东西挡在前面。 图片懒加载以前是 data-src 加滚动监听,现在直接写 <img loading="lazy"> 浏览器就帮你做了,要控制提前多少距离再用 IntersectionObserver。懒执行比如一段统计计算只有展开面板才用,那就点了再算,或者丢到 requestIdleCallback 里空闲时跑。踩得最多的坑是把首屏主图也懒加载了,LCP 直接变差;还有图片没留尺寸,加载完页面一跳,CLS 超标。
懒执行
- 懒执行就是将某些逻辑延迟到使用时再计算。该技术可以用于首屏优化,对于某些耗时逻辑并不需要在首屏就使用的,就可以使用懒执行。懒执行需要唤醒,一般可以通过定时器或者事件的调用来唤醒
懒加载
- 懒加载就是将不关键的资源延后加载
懒加载的原理就是只加载自定义区域(通常是可视区域,但也可以是即将进入可视区域)内需要加载的东西。对于图片来说,先设置图片标签的
src属性为一张占位图,将真实的图片资源放入一个自定义属性中,当进入自定义区域时,就将自定义属性替换为src属性,这样图片就会去下载资源,实现了图片懒加载
- 懒加载不仅可以用于图片,也可以使用在别的资源上。比如进入可视区域才开始播放视频等
💬 面试官追问
把首屏主图也加了
loading="lazy",LCP反而变差,为什么?懒加载的图要等布局算完、判断在视口内才开始下载,比正常加载晚一拍。首屏图去掉
lazy,主图再加fetchpriority="high",只给首屏以下的图懒加载。500张商品图的长列表,怎么做懒加载又不让页面跳动?<img loading="lazy" width="300" height="300">写死尺寸或者容器加aspect-ratio: 1,先占好位。原生懒加载足够;要更早触发就用IntersectionObserver,rootMargin: '200px'提前200px开始加载,加载完unobserve。自己写的懒加载,列表加载更多后新图片一直是占位图,查哪里?
多半是只在初始化时
observe了第一批节点,新渲染的没被观察。新节点挂载时也要observe,在React里放到每个图片组件自己的useEffect里最省心;还要检查滚动容器不是window时root有没有设对。弱网下下一个视频滑到眼前才开始加载,总是黑屏,怎么改?
把触发点提前:
rootMargin设成一两屏的高度,进入「快要可见」就开始加载,但只播放真正可见的那个。提前量别太大,否则退化成一次加载全部。路由懒加载后,第一次点进某个页面会白一下,怎么处理?
加载
chunk需要时间,Suspense给个骨架屏兜底:<Suspense fallback={<Skeleton />}>。再在用户悬停菜单时预取:onMouseEnter={() => import('./Detail')},点进去基本就是秒开。
# 7 文件优化
⚡ 30 秒速记
- 图片收益最大:按展示尺寸裁剪 +
srcset、格式选AVIF/WebP、图标用SVG base64只给几KB的小图,大图内联会撑大CSS阻塞渲染,还没法单独缓存JS:代码分割、Tree Shaking、按需引入(别整包import _ from 'lodash'),脚本用deferCSS放head、关键CSS内联;字体用woff2+ 子集化 +font-display: swap- 传输:服务端开
gzip/brotli;静态资源走CDN,用独立域名避免带主站Cookie
文件优化就三件事:让文件变小、让关键文件先到、让不关键的别挡路。 收益最大的通常是图片,移动端拿 1920px 的原图去显示 375px 宽的位置,最常见也最浪费,按尺寸裁剪再换 WebP 或 AVIF 能省一大半。JS 那边靠代码分割和 Tree Shaking,脚本加 defer 不阻塞解析。传输层开 brotli,静态资源走 CDN。老资料里说「WebP 兼容性不好」已经过时了,现在主流浏览器都支持,用 <picture> 兜底就行。
图片优化
对于如何优化图片,有 2 个思路
- 减少像素点
- 减少每个像素点能够显示的颜色
图片加载优化
- 不用图片。很多时候会使用到很多修饰类图片,其实这类修饰图片完全可以用
CSS去代替。 - 对于移动端来说,屏幕宽度就那么点,完全没有必要去加载原图浪费带宽。一般图片都用 CDN 加载,可以计算出适配屏幕的宽度,然后去请求相应裁剪好的图片
- 小图使用
base64格式 - 将多个图标文件整合到一张图片中(雪碧图)
- 选择正确的图片格式:
- 对于能够显示
WebP格式的浏览器尽量使用WebP格式。因为WebP格式具有更好的图像数据压缩算法,能带来更小的图片体积,而且拥有肉眼识别无差异的图像质量,缺点就是兼容性并不好 - 小图使用
PNG,其实对于大部分图标这类图片,完全可以使用SVG代替 - 照片使用
JPEG
- 对于能够显示
其他文件优化
CSS文件放在head中- 服务端开启文件压缩功能
- 将
script标签放在body底部,因为JS文件执行会阻塞渲染。当然也可以把script标签放在任意位置然后加上defer,表示该文件会并行下载,但是会放到HTML解析完成后顺序执行。对于没有任何依赖的JS文件可以加上async,表示加载和渲染后续文档元素的过程将和JS文件的加载与执行并行无序进行。 执行JS代码过长会卡住渲染,对于需要很多时间计算的代码 - 可以考虑使用
Webworker。Webworker可以让我们另开一个线程执行脚本而不影响渲染。
CDN
静态资源尽量使用
CDN加载,由于浏览器对于单个域名有并发请求上限,可以考虑使用多个CDN域名。对于CDN加载静态资源需要注意CDN域名要与主站不同,否则每次请求都会带上主站的Cookie
💬 面试官追问
活动页把一张
2MB的图转base64塞进CSS,请求少了一个,首屏却更慢,为什么?CSS是阻塞渲染的,它变大2MB多(base64还会膨胀约三分之一),整个页面都得等它下完。而且图跟着CSS走,改一行样式图片缓存也失效。base64只用于几KB的小图标。移动端商品图拿的是
1920px原图,怎么改?让图片服务按宽度出图,前端用
srcset让浏览器自己挑:<img srcset="a-375.webp 375w, a-750.webp 750w" sizes="100vw">。2x屏选750w,别给它1920。想用
AVIF又怕老浏览器不支持,怎么写?<picture><source srcset="a.avif" type="image/avif"><source srcset="a.webp" type="image/webp"><img src="a.jpg"></picture>,浏览器从上往下挑第一个支持的,不支持的最后落到jpg。静态资源为什么要用和主站不同的域名?
主站登录后
Cookie可能有几KB,同域名下每个图片、JS请求都会带上,纯浪费。独立的cookie-free域名就没这负担。不过HTTP/2下也别拆太多域名,一两个就够。中文
Web字体5MB,页面加载很慢,怎么办?做子集化,只保留页面实际用到的字,用
fonttools或font-spider这类工具能压到几十KB;格式用woff2,再加font-display: swap,字体没到先用系统字体显示,别让文字一直空白。
# 8 其他
⚡ 30 秒速记
- 构建:
webpack 4+用mode: 'production'自动压缩;ESM才能Tree Shaking;按路由分包 +contenthash长缓存 - 监控三件套:
window.onerror抓同步错误、unhandledrejection抓没catch的Promise、try/catch包async/await Script error= 跨域脚本报错被浏览器隐藏:<script crossorigin>+ 资源响应Access-Control-Allow-Origin两边都要sourceMap生成但别公开部署,上传到监控平台(比如Sentry)按版本解析- 上报用
navigator.sendBeacon,页面关闭时也能发出去;arguments.callee.caller这种老写法严格模式直接报错,别用
这一节讲的是性能之外的两块收尾:构建产物怎么打得更好,线上错误怎么抓得全。 构建上 production 模式会自动压缩,但 Tree Shaking 要求源码是 ESM,还要配合按路由分包和 contenthash 文件名才算完整。监控这块,window.onerror 只能抓同步错误,Promise 没 catch 的要靠 unhandledrejection 事件。线上只看到 Script error 的话,是跨域脚本被浏览器隐藏了错误详情,要 script 标签加 crossorigin、资源服务器回 CORS 头。压缩后的代码看不懂,所以 sourceMap 要生成,但上传给监控平台就好,别放到公网上。
使用 Webpack 优化项目
- 对于
Webpack4,打包项目使用production模式,这样会自动开启代码压缩 - 使用
ES6模块来开启tree shaking,这个技术可以移除没有使用的代码 - 优化图片,对于小图可以使用
base64的方式写入文件中 - 按照路由拆分代码,实现按需加载
- 给打包出来的文件名添加哈希,实现浏览器缓存文件
监控
对于代码运行错误,通常的办法是使用
window.onerror拦截报错。该方法能拦截到大部分的详细报错信息,但是也有例外
- 对于跨域的代码运行错误会显示
Script error. 对于这种情况我们需要给script标签添加crossorigin属性 - 对于某些浏览器可能不会显示调用栈信息,这种情况可以通过
arguments.callee.caller来做栈递归 - 对于异步代码来说,可以使用
catch的方式捕获错误。比如Promise可以直接使用 catch 函数,async await可以使用try catch - 但是要注意线上运行的代码都是压缩过的,需要在打包时生成
sourceMap文件便于debug。 - 对于捕获的错误需要上传给服务器,通常可以通过
img标签的src发起一个请求
💬 面试官追问
线上监控只收到一堆
Script error.,没有堆栈,怎么拿到详情?脚本在
CDN上跨域了,浏览器出于安全把错误详情抹掉。两边都要改:<script src="..." crossorigin="anonymous">,CDN响应头加Access-Control-Allow-Origin。少一边都不行,只加属性不配头的话脚本会直接加载失败。window.onerror能抓到fetch失败后没catch的Promise吗?抓不到。要另外监听
window.addEventListener('unhandledrejection', e => report(e.reason))。资源加载失败(图片、脚本404)也不冒泡到onerror,得在捕获阶段监听error事件。安全不允许公网部署
sourceMap,那线上报错怎么还原?构建照样生成,但不发到静态服务器,而是上传到
Sentry这类监控平台,平台按release版本号解析堆栈。webpack里可以用devtool: 'hidden-source-map',生成文件但产物里不带引用注释。切到
production模式后,lodash还是整包打进来了,Tree Shaking为什么没生效?lodash是CommonJS包,Tree Shaking只对ESM有效。换成lodash-es,或者按路径引入import debounce from 'lodash/debounce'。另外Babel别把import转成require,preset-env的modules要设false。错误上报为什么推荐
sendBeacon而不是img打点?img打点在页面关闭时可能还没发出去就被取消了;navigator.sendBeacon(url, data)由浏览器保证在页面卸载后继续发送,还能带POST数据,不受URL长度限制。
# 9 如何根据chrome的timing优化
⚡ 30 秒速记
Network里点请求看Timing:Queueing/Stalled→DNS Lookup→Initial connection/SSL→Waiting (TTFB)→Content DownloadQueueing/Stalled长:同域并发占满(HTTP/1.1最多6条)→ 升HTTP/2、减少首屏请求DNS/ 连接 /SSL长:dns-prefetch/preconnect、连接复用TTFB长是服务端:接口慢、没缓存、没走CDN;Content Download长是文件大:压缩、拆包、换图片格式performance.timing已废弃,代码采集用performance.getEntriesByType('navigation'),阶段耗时用performance.now()
看 Chrome 的 Timing,就是把一个请求拆成排队、建连、等服务器、下载几段,哪段最长就优化哪段。 排队时间长,一般是同域名请求太多、HTTP/1.1 的 6 条连接被占满了;DNS 和连接时间长,就上 preconnect;TTFB 长那是后端的事,接口慢或者没缓存;下载时间长就是文件太大。代码里做性能采集,老资料用的 performance.timing 已经废弃了,换成 performance.getEntriesByType('navigation')[0],字段名差不多,时间是相对页面开始的高精度值。
性能优化API
Performance。performance.now()与new Date()区别,它是高精度的,且是相对时间,相对于页面加载的那一刻。但是不一定适合单页面场景window.addEventListener("load", "");window.addEventListener("domContentLoaded", "");Img的onload事件,监听首屏内的图片是否加载完成,判断首屏事件RequestFrameAnmation和RequestIdleCallbackIntersectionObserver、MutationObserver,PostMessageWeb Worker,耗时任务放在里面执行
检测工具
Chrome Dev ToolsPage SpeedJspref
前端指标
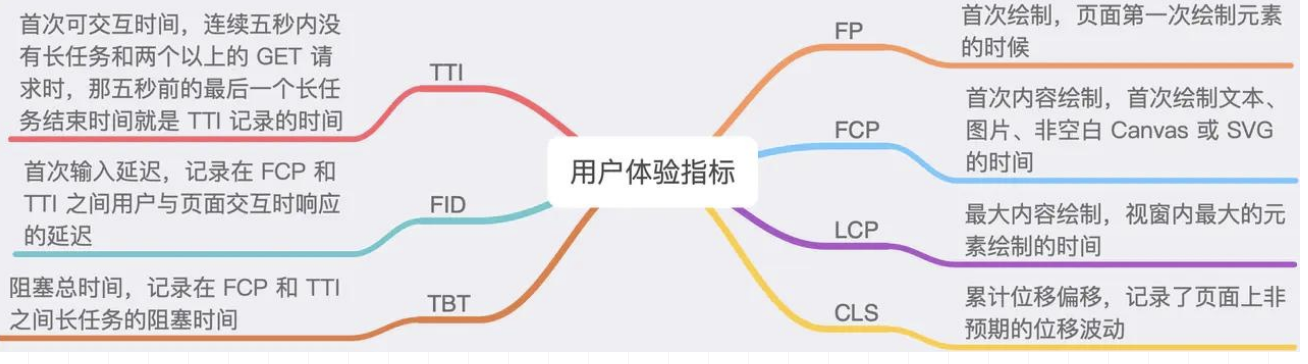
window.onload = function(){
setTimeout(function(){
let t = performance.timing
console.log('DNS查询耗时 :' + (t.domainLookupEnd - t.domainLookupStart).toFixed(0))
console.log('TCP链接耗时 :' + (t.connectEnd - t.connectStart).toFixed(0))
console.log('request请求耗时 :' + (t.responseEnd - t.responseStart).toFixed(0))
console.log('解析dom树耗时 :' + (t.domComplete - t.domInteractive).toFixed(0))
console.log('白屏时间 :' + (t.responseStart - t.navigationStart).toFixed(0))
console.log('domready时间 :' + (t.domContentLoadedEventEnd - t.navigationStart).toFixed(0))
console.log('onload时间 :' + (t.loadEventEnd - t.navigationStart).toFixed(0))
if(t = performance.memory){
console.log('js内存使用占比 :' + (t.usedJSHeapSize / t.totalJSHeapSize * 100).toFixed(2) + '%')
}
})
}
DNS预解析优化
dns解析是很耗时的,因此如果解析域名过多,会让首屏加载变得过慢,可以考虑dns-prefetch优化
DNS Prefetch 应该尽量的放在网页的前面,推荐放在 后面。具体使用方法如下:
<meta http-equiv="x-dns-prefetch-control" content="on">
<link rel="dns-prefetch" href="//www.zhix.net">
<link rel="dns-prefetch" href="//api.share.zhix.net">
<link rel="dns-prefetch" href="//bdimg.share.zhix.net">
request请求耗时
- 不请求,用cache(最好的方式就是尽量引用公共资源,同时设置缓存,不去重新请求资源,也可以运用PWA的离线缓存技术,可以帮助wep实现离线使用)
- 前端打包时压缩
- 服务器上的zip压缩
- 图片压缩(比如tiny),使用webp等高压缩比格式
- 把过大的包,拆分成多个较少的包,防止单个资源耗时过大
- 同一时间针对同一域名下的请求有一定数量限制,超过限制数目的请求会被阻塞。如果资源来自于多个域下,可以增大并行请求和下载速度
- 延迟、异步、预加载、懒加载
- 对于非首屏的资源,可以使用 defer 或 async 的方式引入
- 也可以按需加载,在逻辑中,只有执行到时才做请求
- 对于多屏页面,滚动时才动态载入图片
💬 面试官追问
一个首屏
JS的Content Download占了2秒,TTFB才50ms,先做什么?文件太大,先看有没有开
gzip/brotli,看响应头Content-Encoding。再用webpack-bundle-analyzer看包里有什么,把非首屏的路由和大依赖拆成异步chunk。很多图片请求的
Stalled都有几百毫秒,是什么原因?多半是同一个域名在
HTTP/1.1下排队,6条连接都在忙。看Protocol列,是http/1.1就推动升HTTP/2;同时把首屏以下的图片懒加载,减少首屏同时发起的请求。TTFB有1.5秒,前端能做什么?前端能做的不多,主要是推后端查慢查询、加缓存。前端侧可以让
HTML走CDN或SSR缓存,接口能并行的别串行,首屏数据考虑在HTML里直出,少一次往返。监控代码在
onload里直接读loadEventEnd,有时拿到0,为什么?onload回调执行时load事件还没结束,loadEventEnd还没写。包一层setTimeout(() => {...}, 0)再读;更好的是用PerformanceObserver监听navigation条目,浏览器填好了才回调。单页应用切路由,
navigation那套指标还有用吗?基本没用,它只记录首次文档加载。路由切换要自己打点:切换开始
performance.mark('route-start'),渲染完performance.mark('route-end'),再performance.measure算差值。
# 10 移动端优化
⚡ 30 秒速记
- 移动端的两个瓶颈:网络(高延迟、弱网)+ 设备(
CPU弱,同样的JS执行慢好几倍) - 加载:长缓存 + 压缩、首屏资源控体积、非首屏按需加载、第三方脚本异步、图片按
DPR给尺寸 - 渲染:动画只动
transform/opacity,长列表虚拟滚动,scroll/touchmove用requestAnimationFrame合帧 +passive: true - 别全局开
GPU加速:每个合成层都吃内存,低端机反而更卡 - 适配:
viewport必写、安全区env(safe-area-inset-bottom)、100vh换100dvh、点击区域至少44px
移动端优化比 PC 多两个麻烦:网络更慢、手机更弱,所以不光要让资源早点到,还要让 JS 少干活。 加载上还是那一套:缓存、压缩、首屏资源控制体积,图片按设备像素比给尺寸,统计这类第三方脚本一律异步。渲染上低端机 CPU 弱,长任务的代价被放大好几倍,动画只用 transform 和 opacity,滚动监听用 requestAnimationFrame 合并到每帧一次。老资料里「首屏 3 秒、资源不超过 1014KB」是 3G 时代按带宽算出来的,现在更常用 LCP 小于 2.5 秒这类 Web Vitals 指标来衡量。

1. 概述
PC优化手段在Mobile侧同样适用- 在
Mobile侧我们提出三秒种渲染完成首屏指标 - 基于第二点,首屏加载
3秒完成或使用Loading - 基于联通3G网络平均
338KB/s(2.71Mb/s),所以首屏资源不应超过1014KB Mobile侧因手机配置原因,除加载外渲染速度也是优化重点- 基于第五点,要合理处理代码减少渲染损耗
- 基于第二、第五点,所有影响首屏加载和渲染的代码应在处理逻辑中后置
- 加载完成后用户交互使用时也需注意性能
2. 加载优化
加载过程是最为耗时的过程,可能会占到总耗时的
80%时间,因此是优化的重点
2.1 缓存
使用缓存可以减少向服务器的请求数,节省加载时间,所以所有静态资源都要在服务器端设置缓存,并且尽量使用长
Cache(长Cache资源的更新可使用时间戳)
2.2 压缩HTML、CSS、JavaScript
减少资源大小可以加快网页显示速度,所以要对
HTML、CSS、JavaScript等进行代码压缩,并在服务器端设置GZip
- a) 压缩(例如,多余的空格、换行符和缩进)
- b) 启用
GZip
2.3 无阻塞
写在
HTML头部的JavaScript(无异步),和写在HTML标签中的Style会阻塞页面的渲染,因此CSS放在页面头部并使用Link方式引入,避免在HTML标签中写Style,JavaScript放在页面尾部或使用异步方式加载
2.4 使用首屏加载
首屏的快速显示,可以大大提升用户对页面速度的感知,因此应尽量针对首屏的快速显示做优化。
2.5 按需加载
将不影响首屏的资源和当前屏幕资源不用的资源放到用户需要时才加载,可以大大提升重要资源的显示速度和降低总体流量。
PS:按需加载会导致大量重绘,影响渲染性能
- a)
LazyLoad - b) 滚屏加载
- c) 通过
Media Query加载
2.6 预加载
大型重资源页面(如游戏)可使用增加
Loading的方法,资源加载完成后再显示页面。但Loading时间过长,会造成用户流失。
对用户行为分析,可以在当前页加载下一页资源,提升速度。
- a)可感知
Loading - b)不可感知的
Loading(如提前加载下一页)
2.7 压缩图片
图片是最占流量的资源,因此尽量避免使用他,使用时选择最合适的格式(实现需求的前提下,以大小判断),合适的大小,然后使用智图压缩,同时在代码中用
Srcset来按需显示
PS:过度压缩图片大小影响图片显示效果
- a)使用智图( http://zhitu.tencent.com/ )
- b)使用其它方式代替图片(1. 使用
CSS32. 使用SVG3. 使用IconFont) - c)使用
Srcset - d)选择合适的图片(1.
webP优于JPG2.PNG8优于GIF) - e)选择合适的大小(1. 首次加载不大于
1014KB2. 不宽于640(基于手机屏幕一般宽度))
2.8 减少Cookie
Cookie会影响加载速度,所以静态资源域名不使用Cookie。
2.9 避免重定向
重定向会影响加载速度,所以在服务器正确设置避免重定向。
2.10 异步加载第三方资源
第三方资源不可控会影响页面的加载和显示,因此要异步加载第三方资源
2.11 减少HTTP请求
因为手机浏览器同时响应请求为4个请求(
Android支持4个,iOS5后可支持6个),所以要尽量减少页面的请求数,首次加载同时请求数不能超过4个
- a)合并
CSS、JavaScript - b)合并小图片,使用雪碧图
3. 三、脚本执行优化
脚本处理不当会阻塞页面加载、渲染,因此在使用时需当注意
CSS写在头部,JavaScript写在尾部或异步- 避免图片和
iFrame等的空Src,空Src会重新加载当前页面,影响速度和效率。 - 尽量避免重设图片大小
- 重设图片大小是指在页面、
CSS、JavaScript等中多次重置图片大小,多次重设图片大小会引发图片的多次重绘,影响性能 - 图片尽量避免使用
DataURL,DataURL图片没有使用图片的压缩算法文件会变大,并且要解码后再渲染,加载慢耗时长
4. CSS优化
尽量避免写在HTML标签中写
Style属性
4.1 css3过渡动画开启硬件加速
.translate3d{
-webkit-transform: translate3d(0, 0, 0);
-moz-transform: translate3d(0, 0, 0);
-ms-transform: translate3d(0, 0, 0);
transform: translate3d(0, 0, 0);
}
4.2 避免CSS表达式
CSS表达式的执行需跳出CSS树的渲染,因此请避免CSS表达式。
4.3 不滥用Float
Float在渲染时计算量比较大,尽量减少使用
4.4 值为0时不需要任何单位
为了浏览器的兼容性和性能,值为0时不要带单位
5. JavaScript执行优化
5.1 减少重绘和回流
- 避免不必要的Dom操作
- 尽量改变
Class而不是Style,使用classList代替className - 避免使用
document.write - 减少
drawImage
5.2 TOUCH事件优化
使用
touchstart、touchend代替click,因快影响速度快。但应注意Touch响应过快,易引发误操作
6. 渲染优化
6.1 HTML使用Viewport
Viewport可以加速页面的渲染,请使用以下代码
<meta name=”viewport” content=”width=device-width, initial-scale=1″>
6.2 动画优化
- 尽量使用
CSS3动画 - 合理使用
requestAnimationFrame动画代替setTimeout - 适当使用
Canvas动画5个元素以内使用css动画,5个以上使用Canvas动画(iOS8可使用webGL)
6.3 高频事件优化
Touchmove、Scroll事件可导致多次渲染
- 使用
requestAnimationFrame监听帧变化,使得在正确的时间进行渲染 - 增加响应变化的时间间隔,减少重绘次数
6.4 GPU加速
CSS中以下属性(CSS3 transitions、CSS3 3D transforms、Opacity、Canvas、WebGL、Video)来触发GPU渲染,请合理使用
💬 面试官追问
弱网用户一直看到全屏
Loading,等很久才有内容,怎么改?Loading只是让等待看得见,不能当优化。先把首屏结构和骨架屏随HTML直出,关键数据先回先渲染,非首屏模块延后。只有游戏这类资源必须齐了才能玩的页面才值得整页Loading。商品列表滚动掉帧,
scroll回调里在改好几个元素的style,先改哪?把更新挪到
requestAnimationFrame里,一帧最多执行一次;读布局的代码集中在前面,写样式集中在后面,避免强制同步布局。监听时加{ passive: true },告诉浏览器不会preventDefault,滚动不用等JS。有人给所有卡片加
translate3d(0,0,0)强开GPU,低端机反而更卡,为什么?每个提升的元素都是一个合成层,要单独占显存,几百张卡片就是几百个层,内存一紧张就掉帧甚至崩溃。只给正在做动画的元素临时加
will-change: transform,动画结束去掉。iPhone上底部固定按钮被小黑条挡住,怎么处理?viewport加viewport-fit=cover,按钮加padding-bottom: env(safe-area-inset-bottom)。别写死34px,不同机型和横竖屏都不一样。移动端页面用
100vh,Safari里底部内容被地址栏挡住,怎么办?100vh在移动浏览器里按地址栏收起时的高度算,地址栏展开时就超出了一截。换成100dvh,会跟着地址栏实时变化;老浏览器兜底先写一行height: 100vh再写height: 100dvh。
# 九、工程化
# 1 介绍一下 webpack 的构建流程
⚡ 30 秒速记
- 流程:合并配置 → 创建
Compiler、注册插件 →run→ 从entry开始编译 → 输出资源 → 写盘 - 编译模块阶段:每个文件先过匹配的
loader转成JS,再解析成AST找出import/require,递归处理依赖 - 所有模块处理完得到依赖图,
seal阶段按入口和分包规则组装chunk,每个chunk生成一个输出文件 Compiler全程唯一;Compilation每次编译新建一个,watch模式下每改一次文件就新建一个loader管单个文件的转换,plugin通过Tapable钩子在任意阶段插手
webpack 的构建可以概括成一句话:从入口出发,把所有依赖文件转换、收集成一张依赖图,再切成 chunk 写到硬盘。 启动时先合并配置文件和命令行参数,创建全局唯一的 Compiler,把所有插件的 apply 调一遍让它们挂上钩子。然后从 entry 开始,每个文件先交给匹配的 loader 转成 JS,再解析 AST 找出它依赖了谁,递归下去直到全部处理完。最后按入口和 splitChunks 规则组装成 chunk,生成文件写到 output.path。整个过程中 webpack 会在各个节点触发钩子,插件就是靠这些钩子介入的。
核心概念
entry:入口。webpack是基于模块的,使用webpack首先需要指定模块解析入口(entry),webpack从入口开始根据模块间依赖关系递归解析和处理所有资源文件。output:输出。源代码经过webpack处理之后的最终产物。loader:模块转换器。本质就是一个函数,在该函数中对接收到的内容进行转换,返回转换后的结果。因为 Webpack 只认识 JavaScript,所以 Loader 就成了翻译官,对其他类型的资源进行转译的预处理工作。plugin:扩展插件。基于事件流框架Tapable,插件可以扩展 Webpack 的功能,在 Webpack 运行的生命周期中会广播出许多事件,Plugin 可以监听这些事件,在合适的时机通过 Webpack 提供的 API 改变输出结果。module:模块。除了js范畴内的es module、commonJs、AMD等,css @import、url(...)、图片、字体等在webpack中都被视为模块。
解释几个 webpack 中的术语
module:指在模块化编程中我们把应用程序分割成的独立功能的代码模块chunk:指模块间按照引用关系组合成的代码块,一个chunk中可以包含多个modulechunk group:指通过配置入口点(entry point)区分的块组,一个chunk group中可包含一到多个 chunkbundling:webpack 打包的过程asset/bundle:打包产物
webpack 的打包思想可以简化为 3 点:
- 一切源代码文件均可通过各种
Loader转换为 JS 模块 (module),模块之间可以互相引用。 - webpack 通过入口点(
entry point)递归处理各模块引用关系,最后输出为一个或多个产物包js(bundle)文件。 - 每一个入口点都是一个块组(
chunk group),在不考虑分包的情况下,一个chunk group中只有一个chunk,该 chunk 包含递归分析后的所有模块。每一个chunk都有对应的一个打包后的输出文件(asset/bundle)
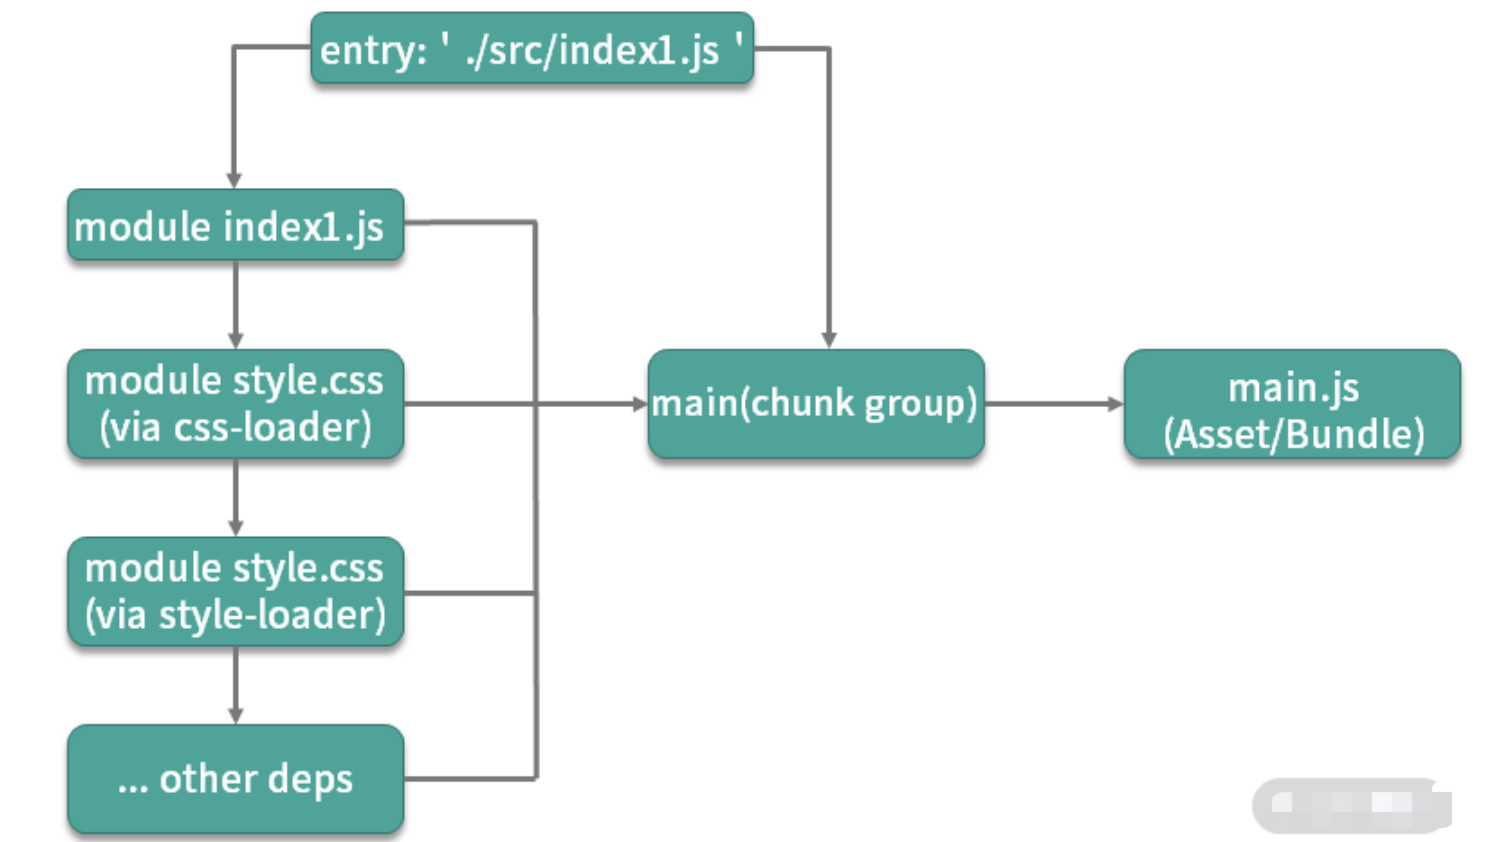
打包流程
- 初始化参数:从配置文件和 Shell 语句中读取并合并参数,得出最终的配置参数。
- 开始编译:从上一步得到的参数初始化
Compiler对象,加载所有配置的插件,执行对象的run方法开始执行编译。 - 确定入口:根据配置中的
entry找出所有的入口文件。 - 编译模块:从入口文件出发,调用所有配置的
loader对模块进行翻译,再找出该模块依赖的模块,这个步骤是递归执行的,直至所有入口依赖的模块文件都经过本步骤的处理。 - 完成模块编译:经过第 4 步使用 loader 翻译完所有模块后,得到了每个模块被翻译后的最终内容以及它们之间的依赖关系。
- 输出资源:根据入口和模块之间的依赖关系,组装成一个个包含多个模块的
chunk,再把每个chunk转换成一个单独的文件加入到输出列表,这一步是可以修改输出内容的最后机会。 - 输出完成:在确定好输出内容后,根据配置确定输出的路径和文件名,把文件内容写入到文件系统。
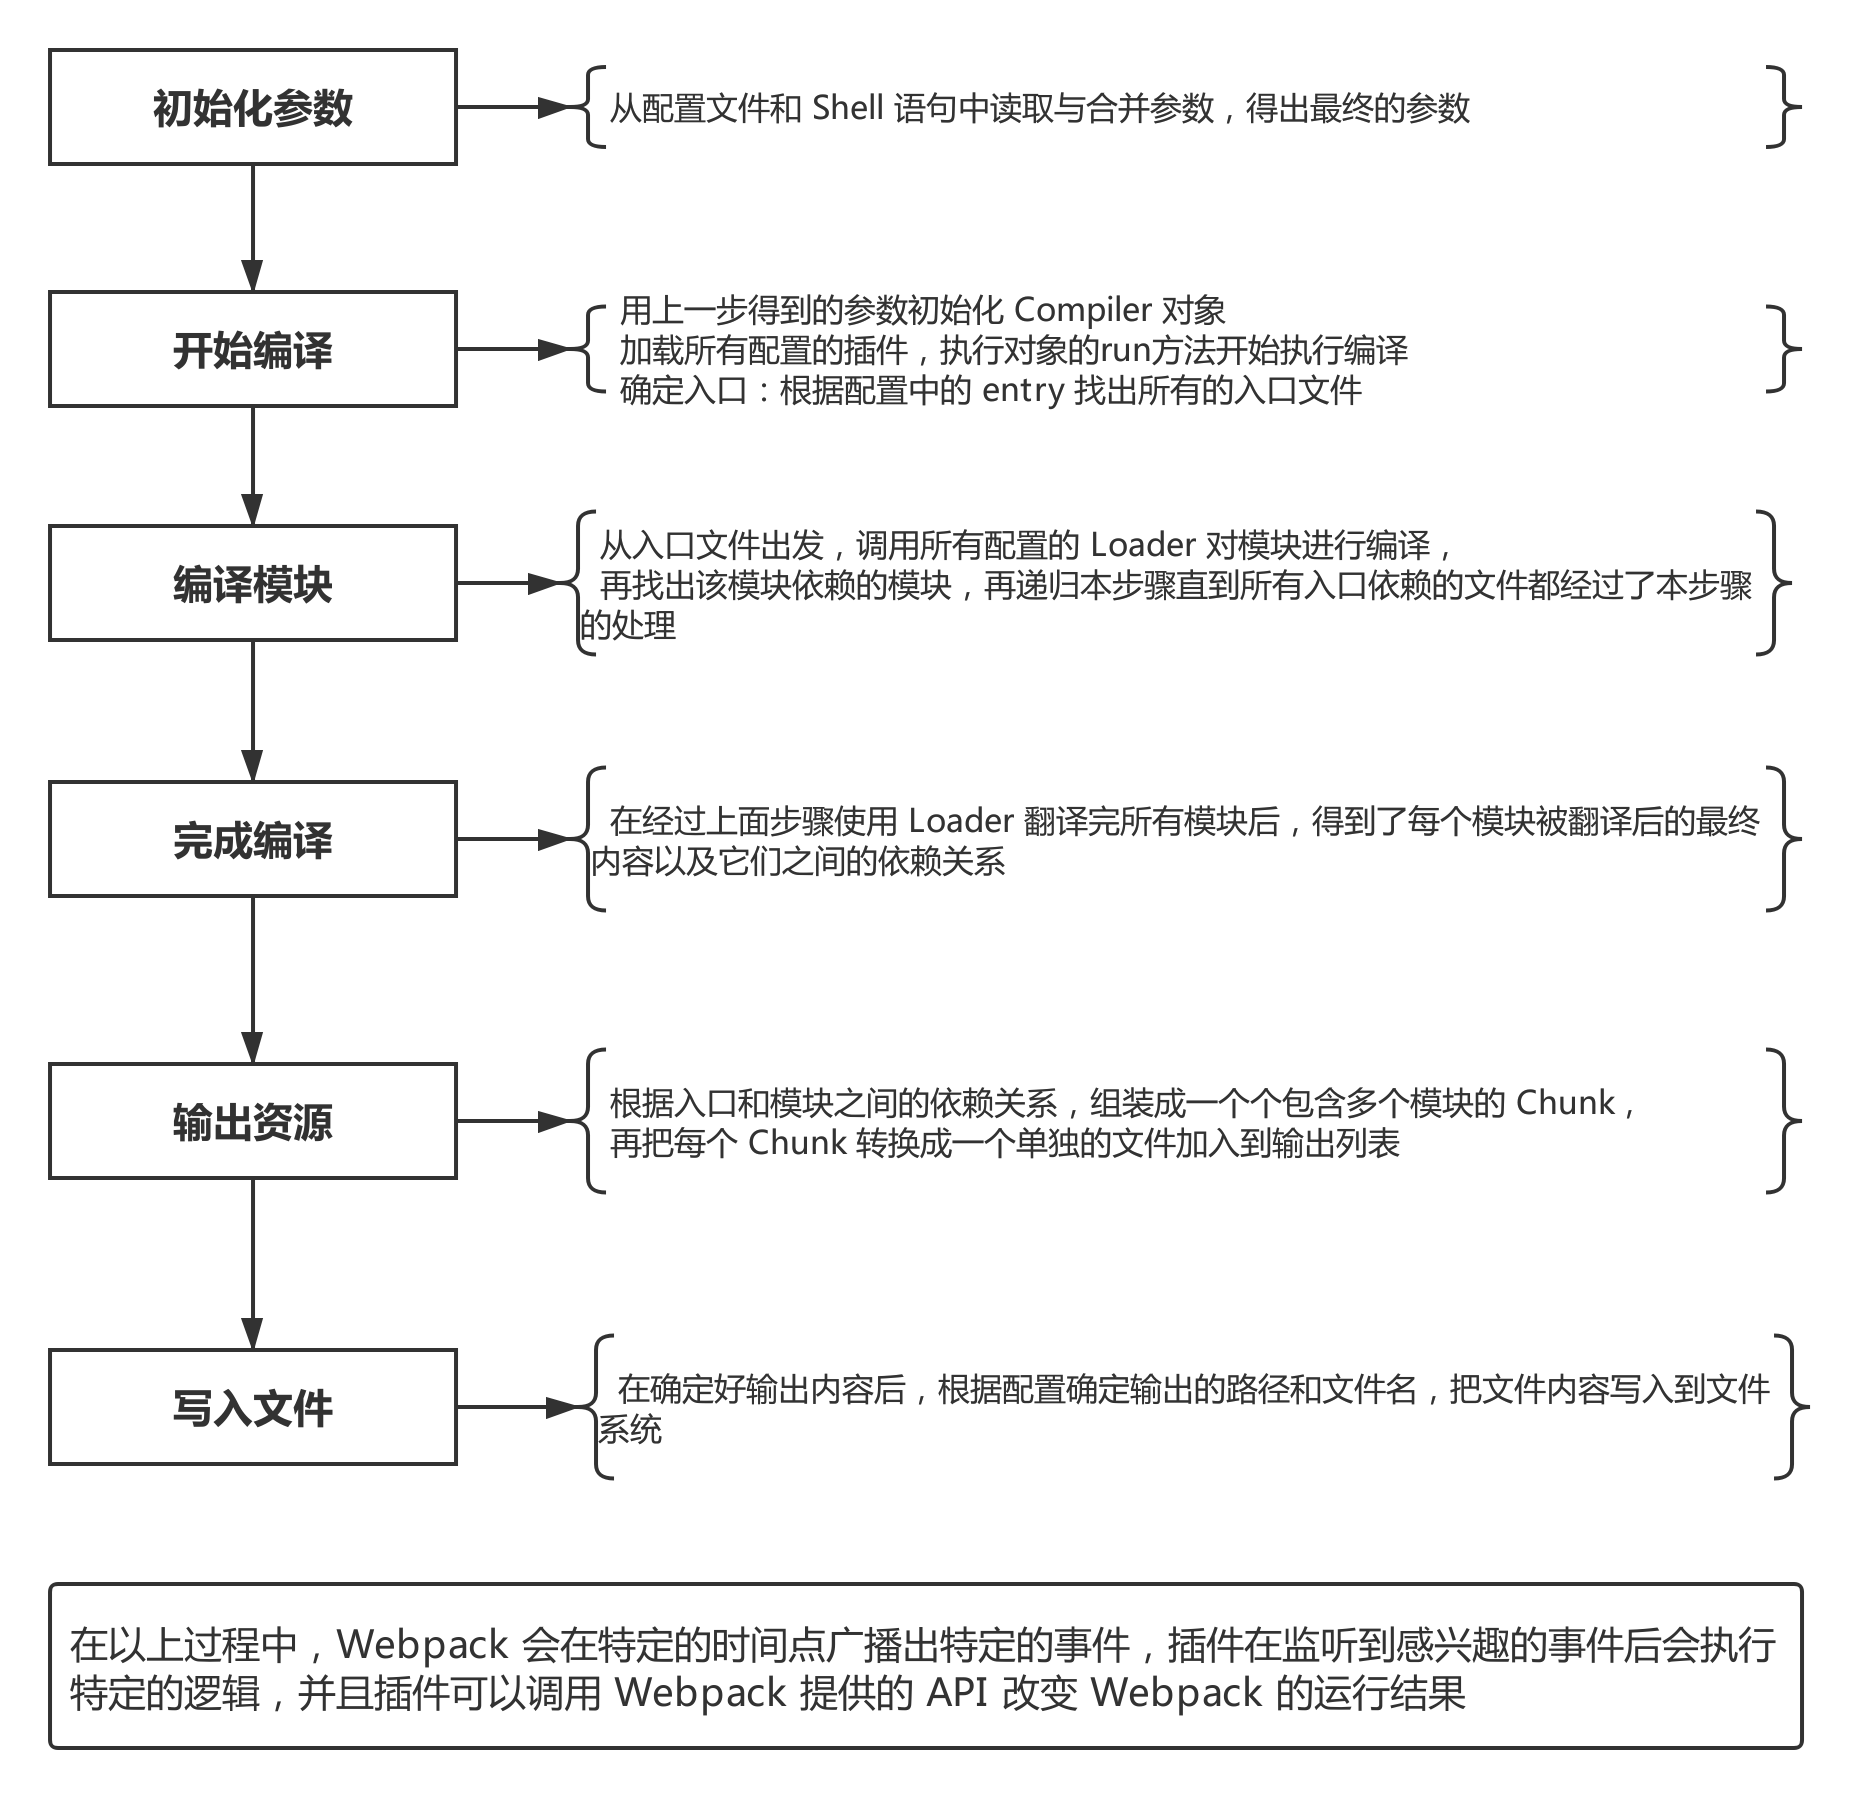
简版
- Webpack CLI 启动打包流程;
- 载入 Webpack 核心模块,创建
Compiler对象; - 使用
Compiler对象开始编译整个项目; - 从入口文件开始,解析模块依赖,形成依赖关系树;
- 递归依赖树,将每个模块交给对应的 Loader 处理;
- 合并 Loader 处理完的结果,将打包结果输出到 dist 目录。
在以上过程中,
Webpack 会在特定的时间点广播出特定的事件,插件在监听到相关事件后会执行特定的逻辑,并且插件可以调用 Webpack 提供的 API 改变 Webpack 的运行结果
构建流程核心概念:
Tapable:一个基于发布订阅的事件流工具类,Compiler和Compilation对象都继承于TapableCompiler:compiler对象是一个全局单例,他负责把控整个webpack打包的构建流程。在编译初始化阶段被创建的全局单例,包含完整配置信息、loaders、plugins以及各种工具方法Compilation:代表一次 webpack 构建和生成编译资源的的过程,在watch模式下每一次文件变更触发的重新编译都会生成新的Compilation对象,包含了当前编译的模块module, 编译生成的资源,变化的文件, 依赖的状态等- 而每个模块间的依赖关系,则依赖于
AST语法树。每个模块文件在通过Loader解析完成之后,会通过acorn库生成模块代码的AST语法树,通过语法树就可以分析这个模块是否还有依赖的模块,进而继续循环执行下一个模块的编译解析。
最终Webpack打包出来的bundle文件是一个IIFE的执行函数。
// webpack 5 打包的bundle文件内容
(() => { // webpackBootstrap
var __webpack_modules__ = ({
'file-A-path': ((modules) => { // ... })
'index-file-path': ((__unused_webpack_module, __unused_webpack_exports, __webpack_require__) => { // ... })
})
// The module cache
var __webpack_module_cache__ = {};
// The require function
function __webpack_require__(moduleId) {
// Check if module is in cache
var cachedModule = __webpack_module_cache__[moduleId];
if (cachedModule !== undefined) {
return cachedModule.exports;
}
// Create a new module (and put it into the cache)
var module = __webpack_module_cache__[moduleId] = {
// no module.id needed
// no module.loaded needed
exports: {}
};
// Execute the module function
__webpack_modules__[moduleId](module, module.exports, __webpack_require__);
// Return the exports of the module
return module.exports;
}
// startup
// Load entry module and return exports
// This entry module can't be inlined because the eval devtool is used.
var __webpack_exports__ = __webpack_require__("./src/index.js");
})
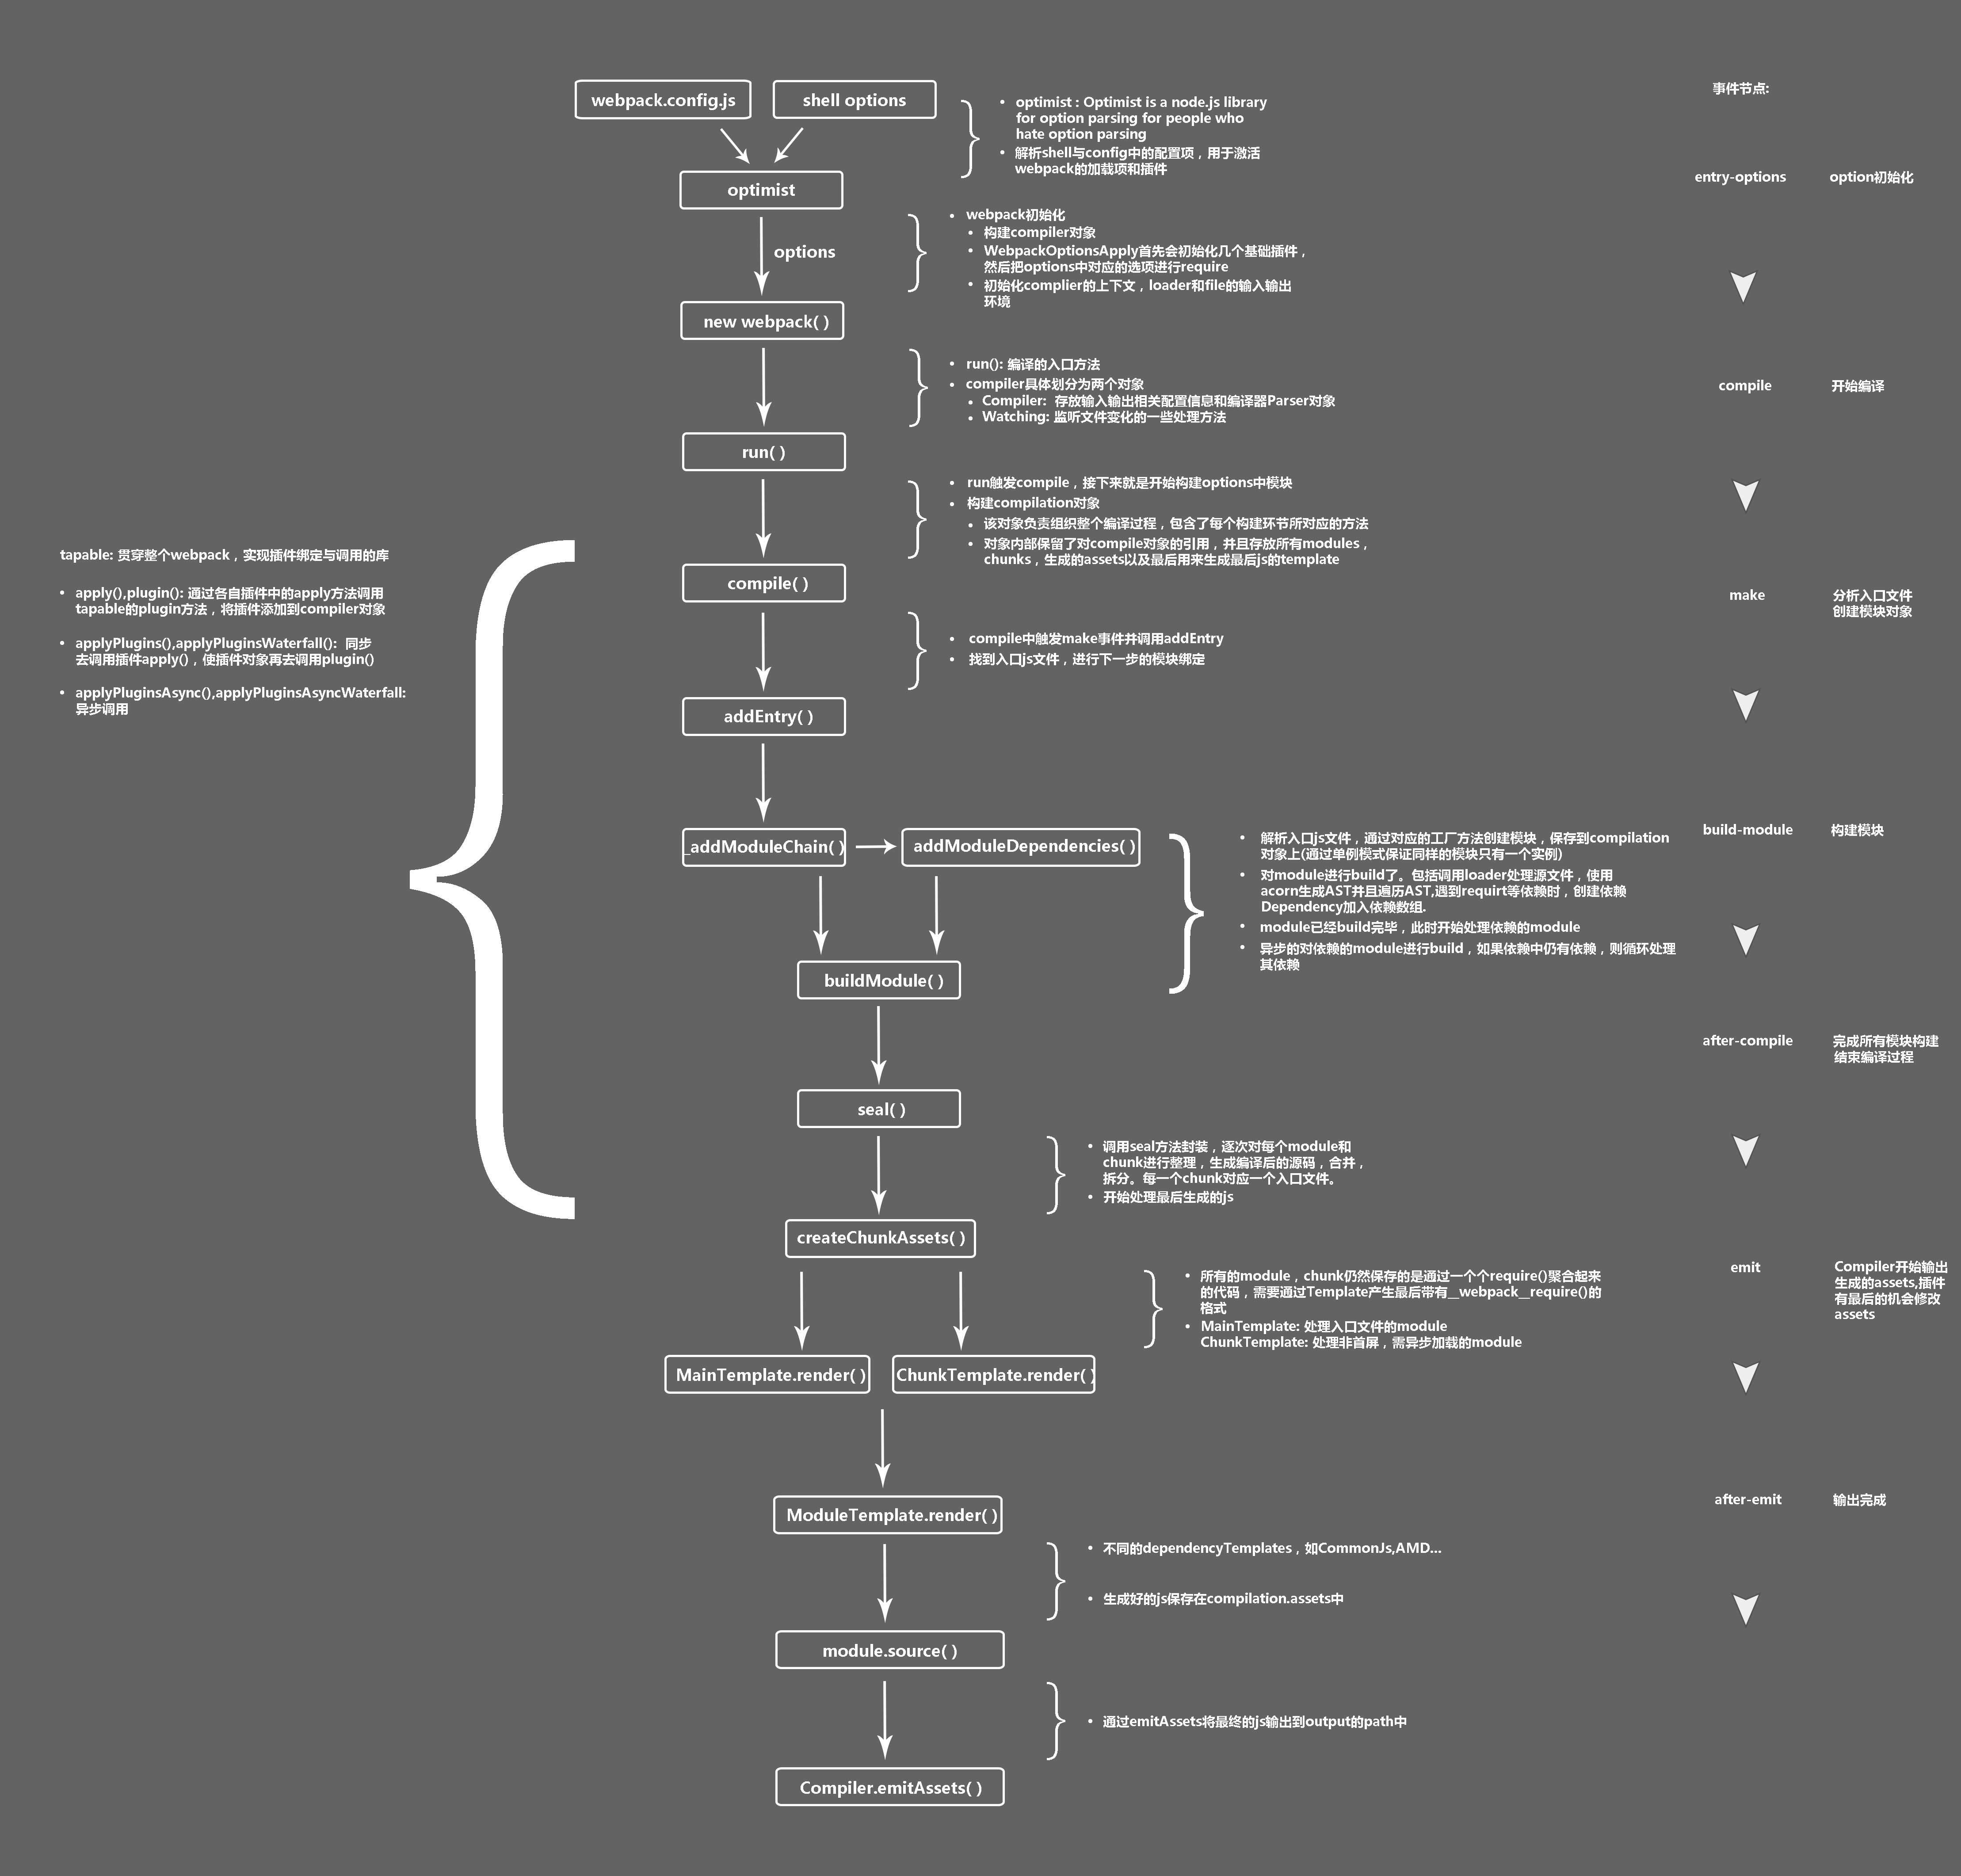
webpack详细工作流程
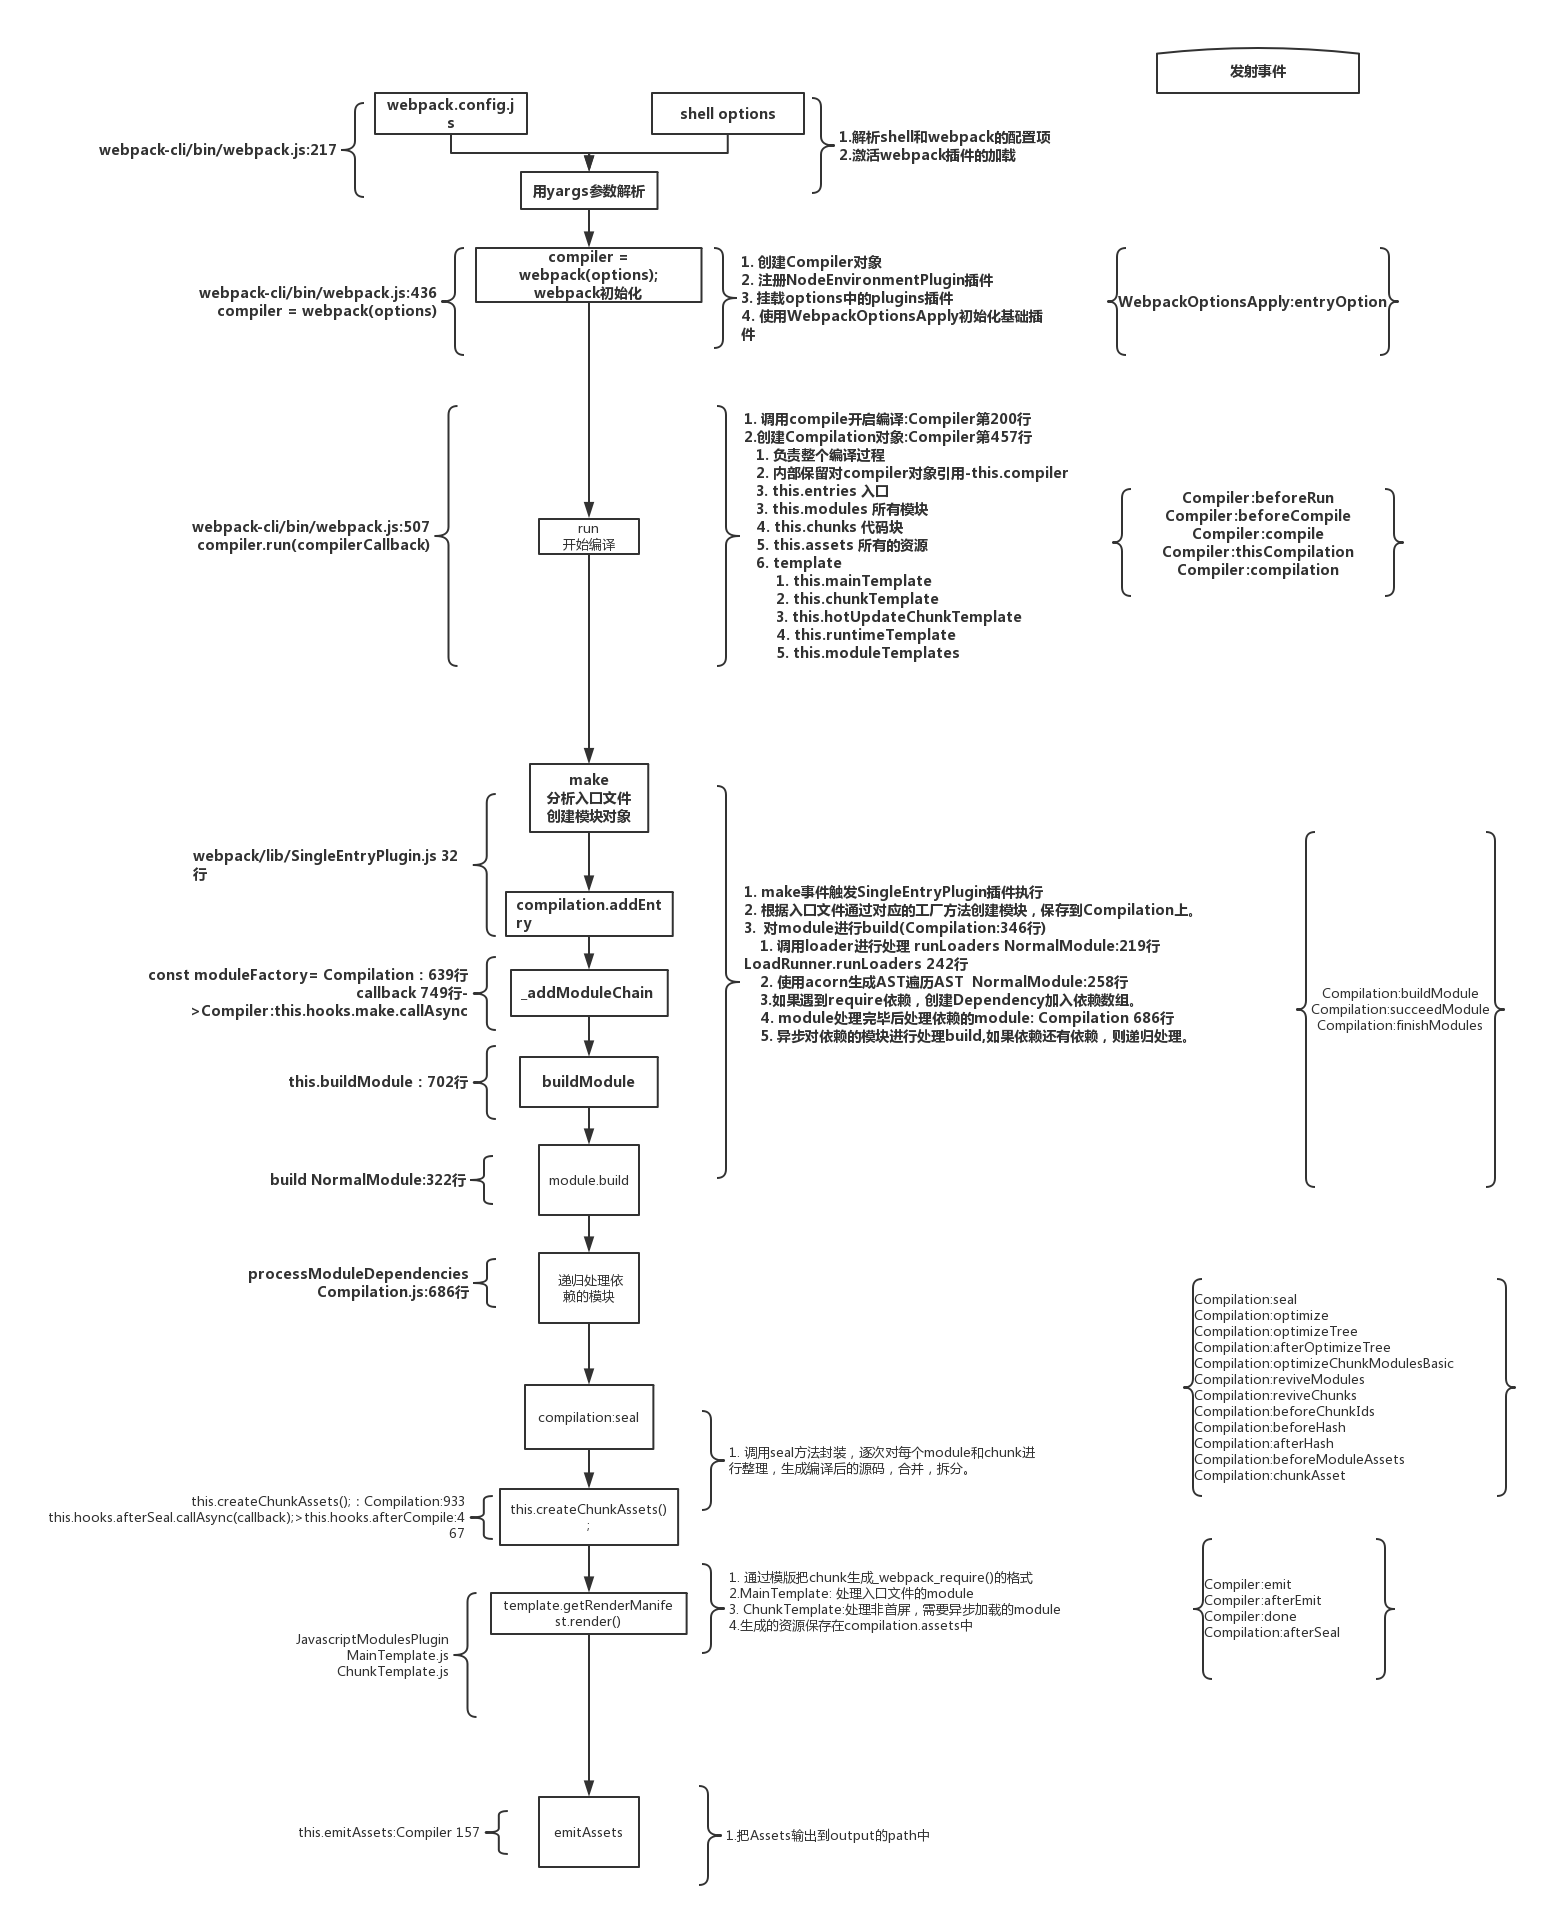
💬 面试官追问
只配了一个
entry,却打出了三个JS文件,为什么?entry对应的是chunk group,不是一个文件。代码里的import()会拆出异步chunk,splitChunks会把node_modules拆成vendors,runtimeChunk还会单独拆出运行时,每个chunk一个文件。watch模式下连续改三个文件,Compiler和Compilation各有几个?Compiler始终一个,从启动活到进程退出;Compilation每次重新编译新建一个,改三次就新建三个。所以插件里每轮编译的数据要挂在compilation上,挂compiler上会跨轮串数据。一个模块里写了
require('./locale/' + lang),打包结果里多了整个locale目录,为什么?webpack是静态分析AST,变量拼接的路径它算不出来,只能把这个目录下所有可能的文件都打进去(context module)。用webpackInclude魔法注释限制范围,或者moment这类场景用IgnorePlugin过滤掉。想在写入
dist之前给所有文件名统一加前缀,用loader还是plugin?plugin。loader只看得到单个模块,看不到最终产物。webpack 5里在compilation.hooks.processAssets钩子操作compilation.assets,别再用emit去改资源,webpack 5已经不推荐了。webpack构建越来越慢,从流程上看能在哪几步提速?编译模块阶段最耗时:
loader用include缩小范围、babel-loader开cacheDirectory,webpack 5直接开cache: { type: 'filesystem' }做持久化缓存。解析阶段配好resolve.extensions减少尝试;压缩阶段TerserPlugin开并行,或者换esbuild/swc的压缩器。
# 2 介绍 Loader
⚡ 30 秒速记
- 本质是一个函数:接收源码(字符串或
Buffer),返回转换后的内容,把非JS资源翻译成webpack能处理的模块 - 执行顺序:
use数组从右到左(从下到上);之前还有一轮从左到右的pitch阶段 - 关键
API:this.callback(err, code, map)返回多个值、this.async()写异步、this.getOptions()(webpack 5)取配置 - 单一职责、可链式组合:
less-loader→css-loader→style-loader各干一件事 - 版本变化:
webpack 5用内置asset modules(type: 'asset')替代file-loader/url-loader/raw-loader
loader 就是 webpack 的翻译官:webpack 本身只认识 JS 和 JSON,其他文件都得靠 loader 翻译成 JS 模块。 它本质是一个函数,进来源码,出去转换后的代码,多个 loader 按 use 数组从右往左串起来,前一个的输出就是后一个的输入。比如 Less 文件先由 less-loader 编成 CSS,css-loader 处理 @import 和 url() 变成 JS 模块,最后 style-loader 生成往页面插 <style> 的代码。另外老资料里的 file-loader、url-loader 在 webpack 5 里已经被内置的 asset modules 取代了。
常用 Loader:
file-loader: 加载文件资源,如 字体 / 图片 等,具有移动/复制/命名等功能;url-loader: 通常用于加载图片,可以将小图片直接转换为 Data Url,减少请求;babel-loader: 加载 js / jsx 文件, 将 ES6 / ES7 代码转换成 ES5,抹平兼容性问题;ts-loader: 加载 ts / tsx 文件,编译 TypeScript;style-loader: 将 css 代码以<style>标签的形式插入到 html 中;css-loader: 分析@import和url(),引用 css 文件与对应的资源;postcss-loader: 用于 css 的兼容性处理,具有众多功能,例如 添加前缀,单位转换 等;less-loader / sass-loader: css预处理器,在 css 中新增了许多语法,提高了开发效率;
编写原则:
- 单一原则: 每个 Loader 只做一件事;
- 链式调用: Webpack 会按顺序链式调用每个 Loader;
- 统一原则: 遵循 Webpack制定的设计规则和结构,输入与输出均为字符串,各个 Loader 完全独立,即插即用;
💬 面试官追问
use: ['style-loader', 'css-loader', 'less-loader'],执行顺序是什么,能反过来写吗?从右往左:
less-loader先把Less编成CSS,css-loader再处理依赖,style-loader最后注入。不能反,css-loader看不懂Less语法,顺序错了直接报错。webpack 5里小图内联、大图输出文件,还要装url-loader吗?不用,内置的
asset modules就行:{ test: /\.png$/, type: 'asset', parser: { dataUrlCondition: { maxSize: 8 * 1024 } } },小于8KB转base64,大于就输出文件。和旧loader混用反而会打出两份。手写一个把
console.log删掉的loader,怎么写?module.exports = function (source) { return source.replace(/console\.log\(.*?\);?/g, '') }。正则只是演示,真实项目用Babel插件按AST删才可靠,否则字符串里的console.log也会被误删。loader里要读文件或调接口,同步return不了,怎么办?const cb = this.async(),异步完成后cb(null, result, map)。要返回sourceMap也是用this.callback,直接return只能返回一个值。babel-loader把node_modules也转了一遍,构建很慢,怎么配?include: path.resolve(__dirname, 'src')只转业务代码,再开cacheDirectory: true。个别依赖发布了ES2020语法要转,就用include单独把那几个包放进来,别整个node_modules一起转。
# 3 介绍 plugin
⚡ 30 秒速记
- 本质是一个带
apply(compiler)方法的类,webpack启动时调用apply,插件在里面订阅钩子 - 钩子基于
Tapable:同步用tap,异步用tapAsync/tapPromise;写法是compiler.hooks.xxx.tap(name, fn) compiler.plugin('xxx')是webpack 3的老写法,webpack 4废弃、webpack 5移除- 常用钩子:
compile、compilation、make、emit、done;webpack 5改产物用compilation.hooks.processAssets - 常用插件新旧对照:
UglifyJsPlugin→TerserPlugin、CommonsChunkPlugin→splitChunks、extract-text-webpack-plugin→mini-css-extract-plugin
plugin 是在 webpack 构建流程的各个节点上挂回调,去做 loader 做不了的事,比如生成 HTML、抽离 CSS、分析产物。 它就是一个有 apply 方法的类,webpack 启动时把 compiler 传进来,插件通过 compiler.hooks.done.tap(...) 这样的写法订阅事件,底层是 Tapable 实现的发布订阅。区分 Compiler 和 Compilation 很关键:Compiler 全程一个,Compilation 每次编译都新建,处理产物要拿当轮的 compilation。老资料里 compiler.plugin(...)、UglifyJsPlugin、CommonsChunkPlugin 这些在 webpack 5 里都已经不能用了。
插件系统是 Webpack 成功的一个关键性因素。在编译的整个生命周期中,Webpack 会触发许多事件钩子,Plugin 可以监听这些事件,根据需求在相应的时间点对打包内容进行定向的修改。
一个最简单的 plugin 是这样的:
class Plugin{
// 注册插件时,会调用 apply 方法
// apply 方法接收 compiler 对象
// 通过 compiler 上提供的 Api,可以对事件进行监听,执行相应的操作
apply(compiler){
// compilation 是监听每次编译循环
// 每次文件变化,都会生成新的 compilation 对象并触发该事件
compiler.plugin('compilation',function(compilation) {})
}
}
注册插件:
// webpack.config.js
module.export = {
plugins:[
new Plugin(options),
]
}
事件流机制:
Webpack 就像工厂中的一条产品流水线。原材料经过 Loader 与 Plugin 的一道道处理,最后输出结果。
- 通过链式调用,按顺序串起一个个 Loader;
- 通过事件流机制,让 Plugin 可以插入到整个生产过程中的每个步骤中;
Webpack 事件流编程范式的核心是基础类 Tapable,是一种 观察者模式 的实现事件的订阅与广播:
const { SyncHook } = require("tapable")
const hook = new SyncHook(['arg'])
// 订阅
hook.tap('event', (arg) => {
// 'event-hook'
console.log(arg)
})
// 广播
hook.call('event-hook')
Webpack中两个最重要的类Compiler与Compilation便是继承于Tapable,也拥有这样的事件流机制。
Compiler: 可以简单的理解为 Webpack 实例,它包含了当前 Webpack 中的所有配置信息,如 options, loaders, plugins 等信息,全局唯一,只在启动时完成初始化创建,随着生命周期逐一传递;
Compilation: 可以称为 编译实例。当监听到文件发生改变时,Webpack 会创建一个新的 Compilation 对象,开始一次新的编译。它包含了当前的输入资源,输出资源,变化的文件等,同时通过它提供的 api,可以监听每次编译过程中触发的事件钩子;区别:
Compiler全局唯一,且从启动生存到结束;Compilation对应每次编译,每轮编译循环均会重新创建;
常用 Plugin:
- UglifyJsPlugin: 压缩、混淆代码;
- CommonsChunkPlugin: 代码分割;
- ProvidePlugin: 自动加载模块;
- html-webpack-plugin: 加载 html 文件,并引入 css / js 文件;
- extract-text-webpack-plugin / mini-css-extract-plugin: 抽离样式,生成 css 文件; DefinePlugin: 定义全局变量;
- optimize-css-assets-webpack-plugin: CSS 代码去重;
- webpack-bundle-analyzer: 代码分析;
- compression-webpack-plugin: 使用 gzip 压缩 js 和 css;
- happypack: 使用多进程,加速代码构建;
- EnvironmentPlugin: 定义环境变量;
调用插件
apply函数传入compiler对象通过
compiler对象监听事件
loader和plugin有什么区别?
webapck默认只能打包JS和JOSN模块,要打包其它模块,需要借助loader,loader就可以让模块中的内容转化成webpack或其它loader可以识别的内容。
loader就是模块转换化,或叫加载器。不同的文件,需要不同的loader来处理。plugin是插件,可以参与到整个webpack打包的流程中,不同的插件,在合适的时机,可以做不同的事件。
webpack中都有哪些插件,这些插件有什么作用?
html-webpack-plugin自动创建一个HTML文件,并把打包好的JS插入到HTML文件中clean-webpack-plugin在每一次打包之前,删除整个输出文件夹下所有的内容mini-css-extrcat-plugin抽离CSS代码,放到一个单独的文件中optimize-css-assets-plugin压缩css
💬 面试官追问
写一个插件,构建完在
dist里输出一份所有文件名的清单,怎么写?compiler.hooks.thisCompilation.tap('M', (c) => { c.hooks.processAssets.tap({ name: 'M', stage: Compilation.PROCESS_ASSETS_STAGE_REPORT }, (assets) => { c.emitAsset('manifest.json', new RawSource(JSON.stringify(Object.keys(assets)))) }) })。RawSource从compiler.webpack.sources里拿,别自己装webpack-sources防止版本不一致。插件首次构建正常,每改一次文件输出就多一份重复内容,查哪里?
看是不是在
compilation回调里又去compiler.hooks.xxx.tap,每轮编译都新注册一次,监听越叠越多。compiler上的钩子只在apply里注册一次;轮次数据放在当轮compilation上,别累计在插件实例里不清。异步钩子里用了
tap写异步逻辑,结果没等异步完成就往下走了,为什么?tap注册的是同步回调,webpack不会等你的Promise。异步钩子(比如emit)要用tapPromise返回Promise,或者tapAsync最后调callback()。升级
webpack 5后,老项目的UglifyJsPlugin和CommonsChunkPlugin报错,怎么替换?压缩换
TerserPlugin,production模式默认就开了,通常不用自己配;CommonsChunkPlugin在webpack 4就被删了,换成optimization.splitChunks。抽CSS的extract-text-webpack-plugin换mini-css-extract-plugin。只是删掉源码里的调试代码,同事想写个插件,你怎么看?
这是单文件转换,
loader或Babel插件更合适,处理每个模块时顺手就做了。插件适合需要看到整轮编译、所有产物的事,比如生成清单、注入HTML、上传sourceMap。
# 4 webpack 热更新实现原理
⚡ 30 秒速记
- 四个角色:
webpack监听编译 →webpack-dev-server起服务 →WebSocket推通知 → 浏览器里的HMR runtime换模块 WebSocket只推「有新hash了」,代码本身走HTTP:先拉[hash].hot-update.json清单,再拉.hot-update.js补丁- 换模块时沿依赖往上冒泡,碰到写了
module.hot.accept的模块就停;冒到入口都没人接 → 整页刷新 React Fast Refresh、vue-loader、style-loader就是替你写好了accept,所以能保留组件状态- 易错:以为代码是从
WebSocket推过来的;WebSocket被代理拦了,表现是改了文件页面毫无反应
热更新说白了就是:只重新编译改动的模块,再让浏览器里的一段运行时代码把旧模块原地换掉,不刷新页面。 改完文件,webpack 增量编译出新的 hash 和补丁文件,dev-server 通过 WebSocket 告诉浏览器「有更新了」。浏览器里的 HMR runtime 收到后,用 HTTP 去拉更新清单和补丁 chunk,然后执行替换。能不能换成功,要看这个模块或它的上游有没有 module.hot.accept 接住;没人接就退化成整页刷新。平时感觉不到这一层,是因为 React Fast Refresh、vue-loader 已经帮你把 accept 写好了。
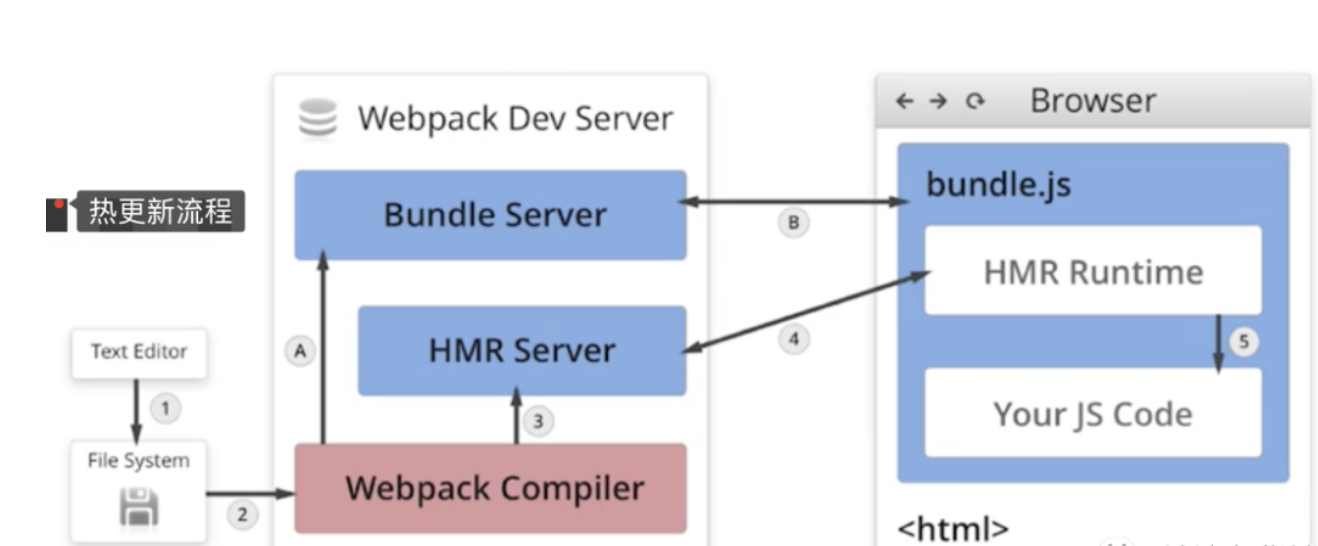
HMR 的基本流程图
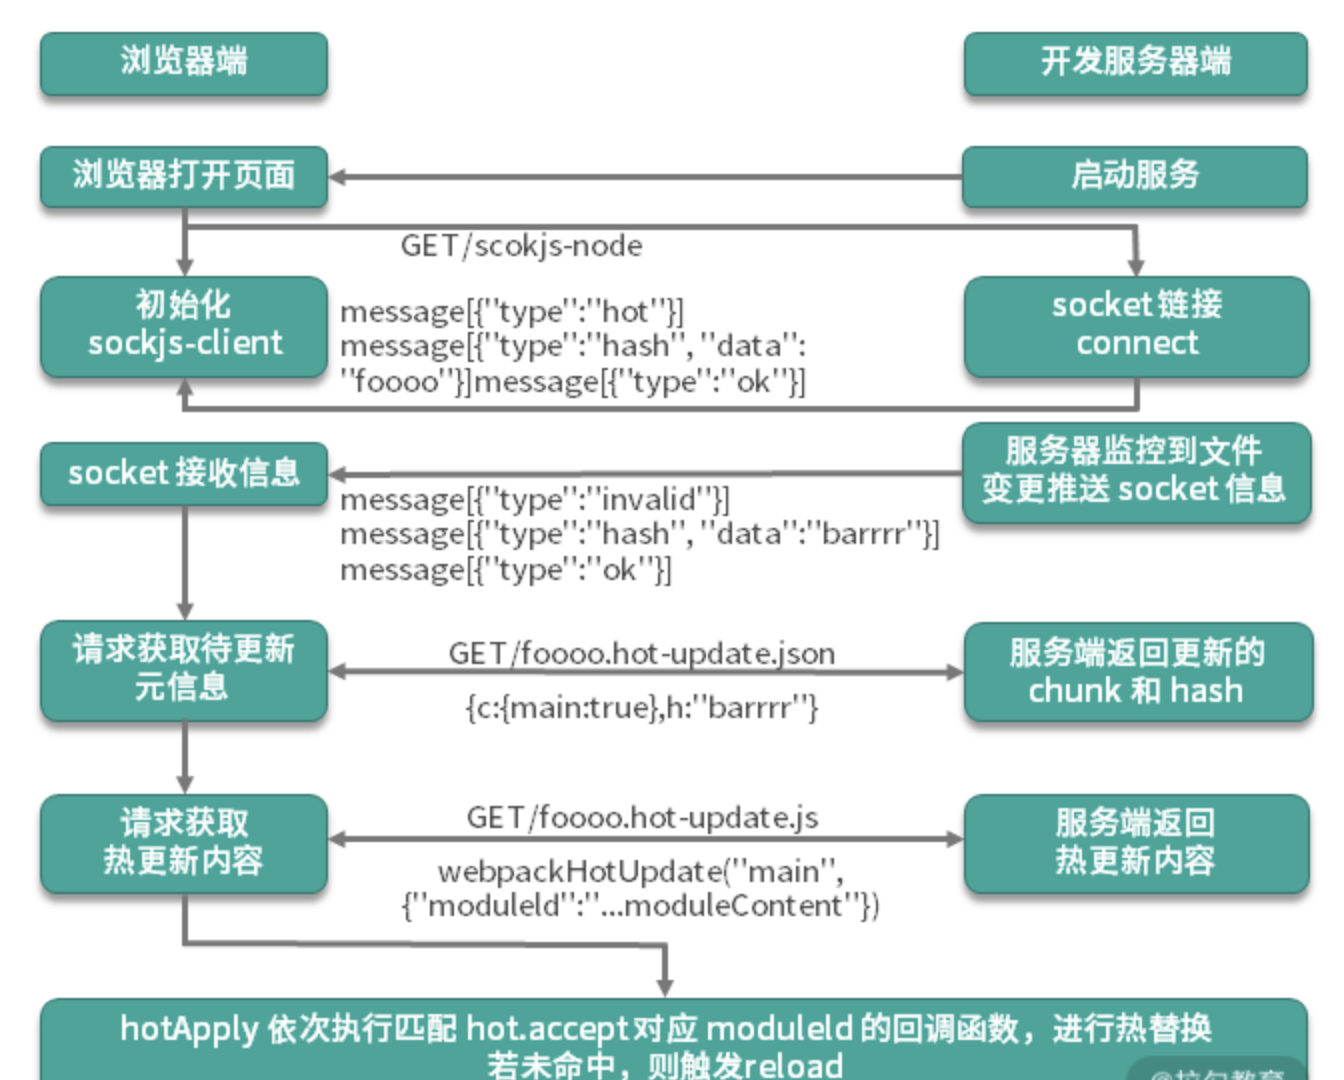
- 当修改了一个或多个文件;
- 文件系统接收更改并通知
webpack; webpack重新编译构建一个或多个模块,并通知 HMR 服务器进行更新;HMR Server使用webSocket通知HMR runtime需要更新,HMR运行时通过HTTP请求更新jsonpHMR运行时替换更新中的模块,如果确定这些模块无法更新,则触发整个页面刷新
💬 面试官追问
浏览器收到了
WebSocket消息,那新代码是不是也走WebSocket过来的?不是。
WebSocket里只有一条很短的消息,带着新的hash。真正的代码是HMR runtime拿着hash去请求xxx.hot-update.json和xxx.hot-update.js,在Network面板里能看到这两个普通请求。公司代理拦了
WebSocket,页面能打开,但改了文件一点反应都没有,为什么?通知链路断了。浏览器不知道有更新,就不会去拉补丁,哪怕补丁文件已经编译好、手动访问也能拿到。先看
Network里ws那一栏连没连上,再查代理有没有放行Upgrade请求,或者在devServer.client.webSocketURL里改成能通的地址。改一个工具函数文件,页面每次都整页刷新,改组件文件就没事,怎么回事?
工具文件被很多地方引用,往上冒泡的路径里没有模块写
accept,一路冒到入口就只能刷新。组件文件能热更,是因为框架插件给组件加了accept。要么接受刷新,要么在合适的上游手动写module.hot.accept('./utils', cb)。复杂表单页改个样式,填了一半的数据还在吗?
改的是
CSS一般在,style-loader替换的只是<style>标签内容。改组件代码也大多能保留,React Fast Refresh会尽量保useState的值,但改了hooks的顺序或者文件里导出了非组件的东西,它会重新挂载,状态就没了。Vite的热更新和webpack的有什么不一样?思路一样,都是
WebSocket通知加运行时替换,差别在「编译什么」。Vite开发时不打包,改了哪个文件就只重新转换那一个,浏览器用原生ESM重新import它,所以项目越大差距越明显。
# 5 webpack 层面如何做性能优化
⚡ 30 秒速记
- 先量再改:
speed-measure-webpack-plugin看哪步慢,webpack-bundle-analyzer看谁占体积;构建速度和产物体积是两条线,别混着谈 - 提速:
webpack 5的cache: { type: 'filesystem' }收益最大;loader加include只处理src;resolve少配几个extensions - 换编译器:
swc-loader/esbuild-loader替掉babel-loader,转译通常快好几倍 - 减体积:动态
import()拆懒加载、splitChunks抽稳定的第三方库、Tree Shaking、按需引入、contenthash吃长期缓存 - 版本差异:
DllPlugin是webpack 4时代的提速手段,webpack 5有持久化缓存后基本不用了;新项目直接看Rspack/Vite
webpack 优化我会先拆成两件事:构建慢还是包太大,然后用工具拿数据,不凭感觉动手。 构建慢就看 speed-measure-webpack-plugin 的输出,大头通常是 babel-loader 在转 node_modules,开 webpack 5 的文件系统缓存、收窄 include、换 swc-loader 这三招下去基本立竿见影。包太大就开 webpack-bundle-analyzer,常见的是整包引了 lodash、moment 带了全部语言包、大组件没懒加载。拆包要适度,第三方库单独一个 chunk 吃缓存就够了,拆成几十个小文件反而增加请求调度成本。
优化前的准备工作
- 准备基于时间的分析工具:我们需要一类插件,来帮助我们统计项目构建过程中在编译阶段的耗时情况。
speed-measure-webpack-plugin分析插件加载的时间 - 使用
webpack-bundle-analyzer分析产物内容
代码优化:
无用代码消除,是许多编程语言都具有的优化手段,这个过程称为 DCE (dead code elimination),即 删除不可能执行的代码;
例如我们的 UglifyJs,它就会帮我们在生产环境中删除不可能被执行的代码,例如:
var fn = function() {
return 1;
// 下面代码便属于 不可能执行的代码;
// 通过 UglifyJs (Webpack4+ 已内置) 便会进行 DCE;
var a = 1;
return a;
}
摇树优化 (Tree-shaking),这是一种形象比喻。我们把打包后的代码比喻成一棵树,这里其实表示的就是,通过工具 "摇" 我们打包后的 js 代码,将没有使用到的无用代码 "摇" 下来 (删除)。即 消除那些被 引用了但未被使用 的模块代码。
- 原理: 由于是在编译时优化,因此最基本的前提就是语法的静态分析,ES6的模块机制 提供了这种可能性。不需要运行时,便可进行代码字面上的静态分析,确定相应的依赖关系。
- 问题: 具有 副作用 的函数无法被
tree-shaking- 在引用一些第三方库,需要去观察其引入的代码量是不是符合预期;
- 尽量写纯函数,减少函数的副作用;
- 可使用
webpack-deep-scope-plugin,可以进行作用域分析,减少此类情况的发生,但仍需要注意;
code-spliting: 代码分割技术,将代码分割成多份进行 懒加载 或 异步加载,避免打包成一份后导致体积过大,影响页面的首屏加载;
Webpack中使用SplitChunksPlugin进行拆分;- 按 页面 拆分: 不同页面打包成不同的文件;
- 按 功能 拆分:
- 将类似于播放器,计算库等大模块进行拆分后再懒加载引入;
- 提取复用的业务代码,减少冗余代码;
- 按 文件修改频率 拆分: 将第三方库等不常修改的代码单独打包,而且不改变其文件 hash 值,能最大化运用浏览器的缓存;
scope hoisting: 作用域提升,将分散的模块划分到同一个作用域中,避免了代码的重复引入,有效减少打包后的代码体积和运行时的内存损耗;
编译性能优化:
- 升级至 最新 版本的
webpack,能有效提升编译性能; - 使用
dev-server/ 模块热替换 (HMR) 提升开发体验;- 监听文件变动 忽略 node_modules 目录能有效提高监听时的编译效率;
- 缩小编译范围
modules: 指定模块路径,减少递归搜索;mainFields: 指定入口文件描述字段,减少搜索;noParse: 避免对非模块化文件的加载;includes/exclude: 指定搜索范围/排除不必要的搜索范围;alias: 缓存目录,避免重复寻址;
babel-loader- 忽略
node_moudles,避免编译第三方库中已经被编译过的代码 - 使用
cacheDirectory,可以缓存编译结果,避免多次重复编译
- 忽略
- 多进程并发
webpack-parallel-uglify-plugin: 可多进程并发压缩 js 文件,提高压缩速度;HappyPack: 多进程并发文件的Loader解析;
- 第三方库模块缓存:
DLLPlugin和DLLReferencePlugin可以提前进行打包并缓存,避免每次都重新编译;
- 使用分析
Webpack Analyse / webpack-bundle-analyzer对打包后的文件进行分析,寻找可优化的地方- 配置profile:true,对各个编译阶段耗时进行监控,寻找耗时最多的地方
source-map:- 开发:
cheap-module-eval-source-map - 生产:
hidden-source-map;
- 开发:
优化webpack打包速度
- 减少文件搜索范围
- 比如通过别名
loader的test,include & exclude
Webpack4默认压缩并行Happypack并发调用babel也可以缓存编译Resolve在构建时指定查找模块文件的规则- 使用
DllPlugin,不用每次都重新构建 externals和DllPlugin解决的是同一类问题:将依赖的框架等模块从构建过程中移除。它们的区别在于- 在 Webpack 的配置方面,
externals更简单,而DllPlugin需要独立的配置文件。 DllPlugin包含了依赖包的独立构建流程,而externals配置中不包含依赖框架的生成方式,通常使用已传入 CDN 的依赖包externals配置的依赖包需要单独指定依赖模块的加载方式:全局对象、CommonJS、AMD 等- 在引用依赖包的子模块时,
DllPlugin无须更改,而externals则会将子模块打入项目包中
- 在 Webpack 的配置方面,
优化打包体积
- 提取第三方库或通过引用外部文件的方式引入第三方库
- 代码压缩插件
UglifyJsPlugin - 服务器启用
gzip压缩 - 按需加载资源文件
require.ensure - 优化
devtool中的source-map - 剥离
css文件,单独打包 - 去除不必要插件,通常就是开发环境与生产环境用同一套配置文件导致
Tree Shaking在构建打包过程中,移除那些引入但未被使用的无效代码- 开启
scope hosting- 体积更小
- 创建函数作用域更小
- 代码可读性更好
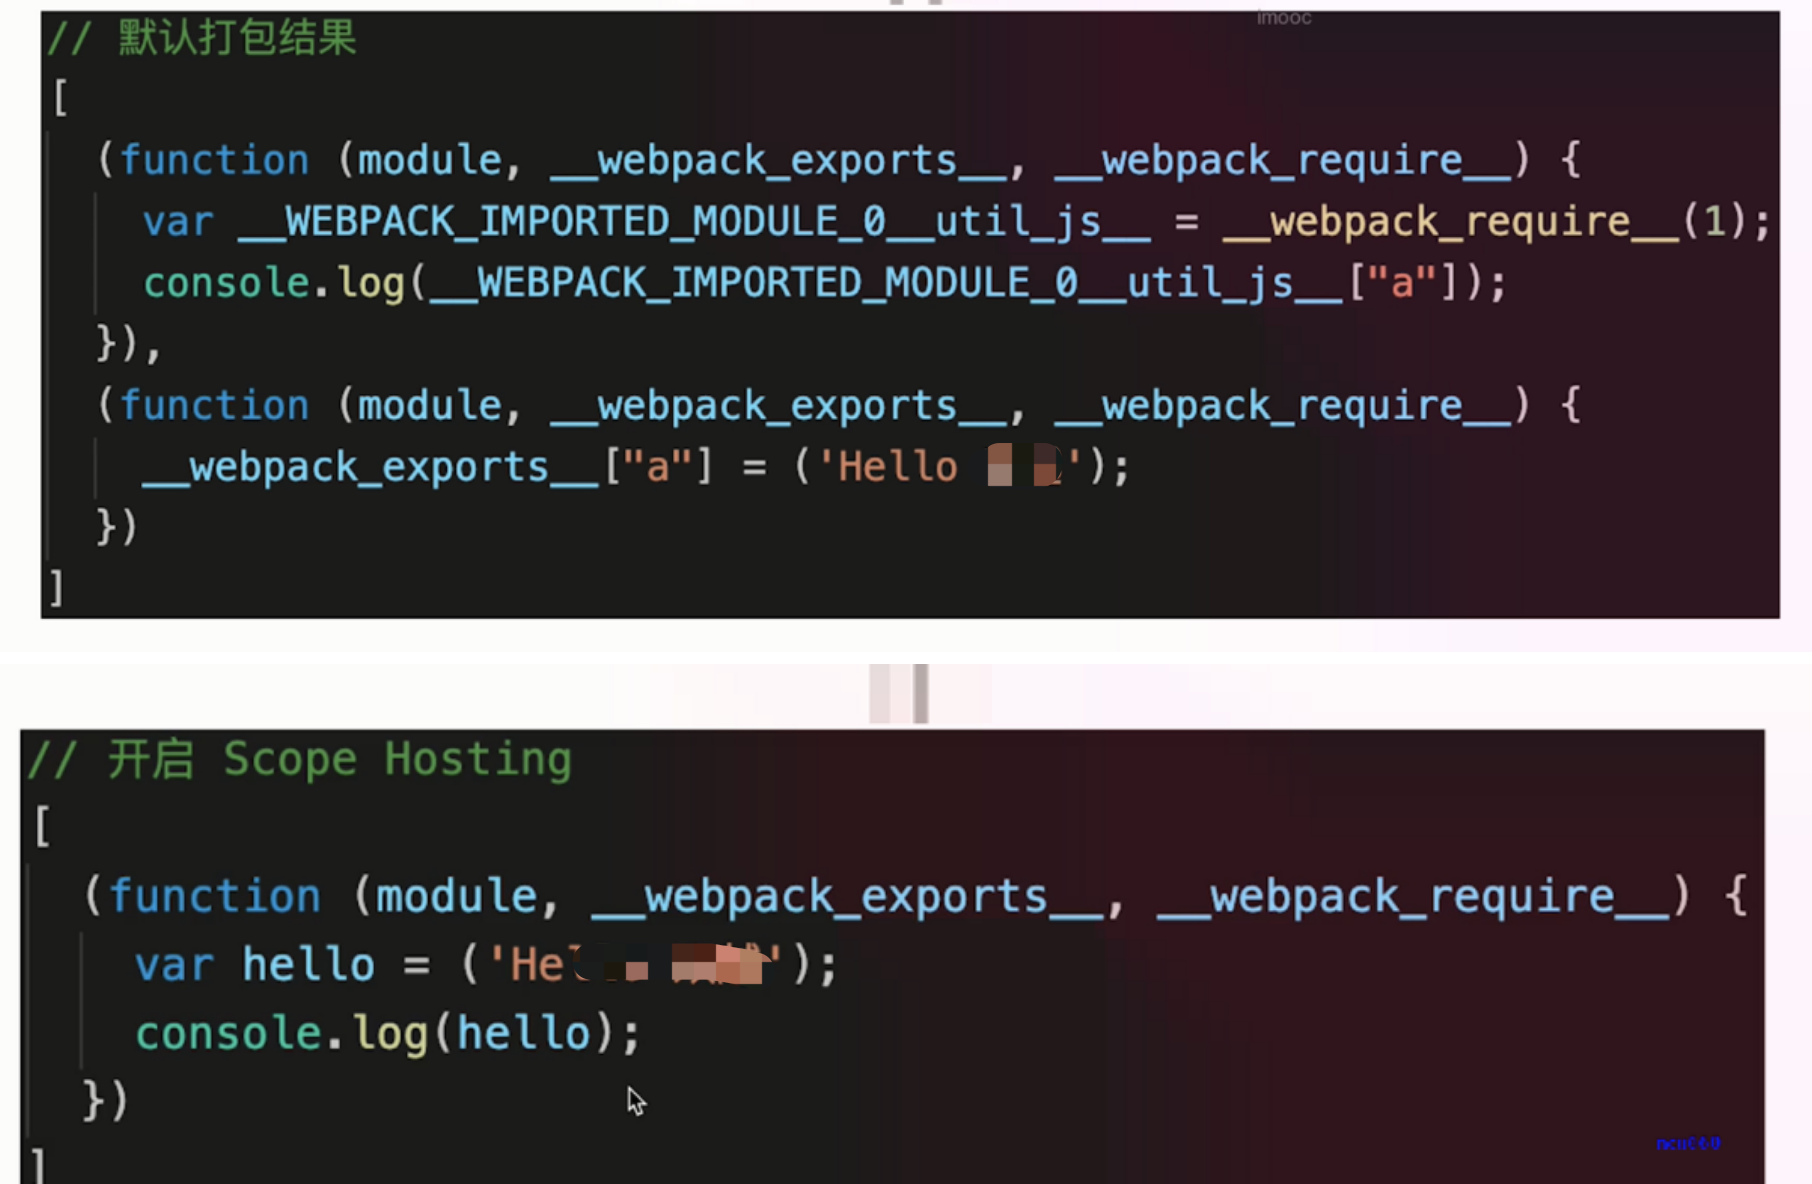
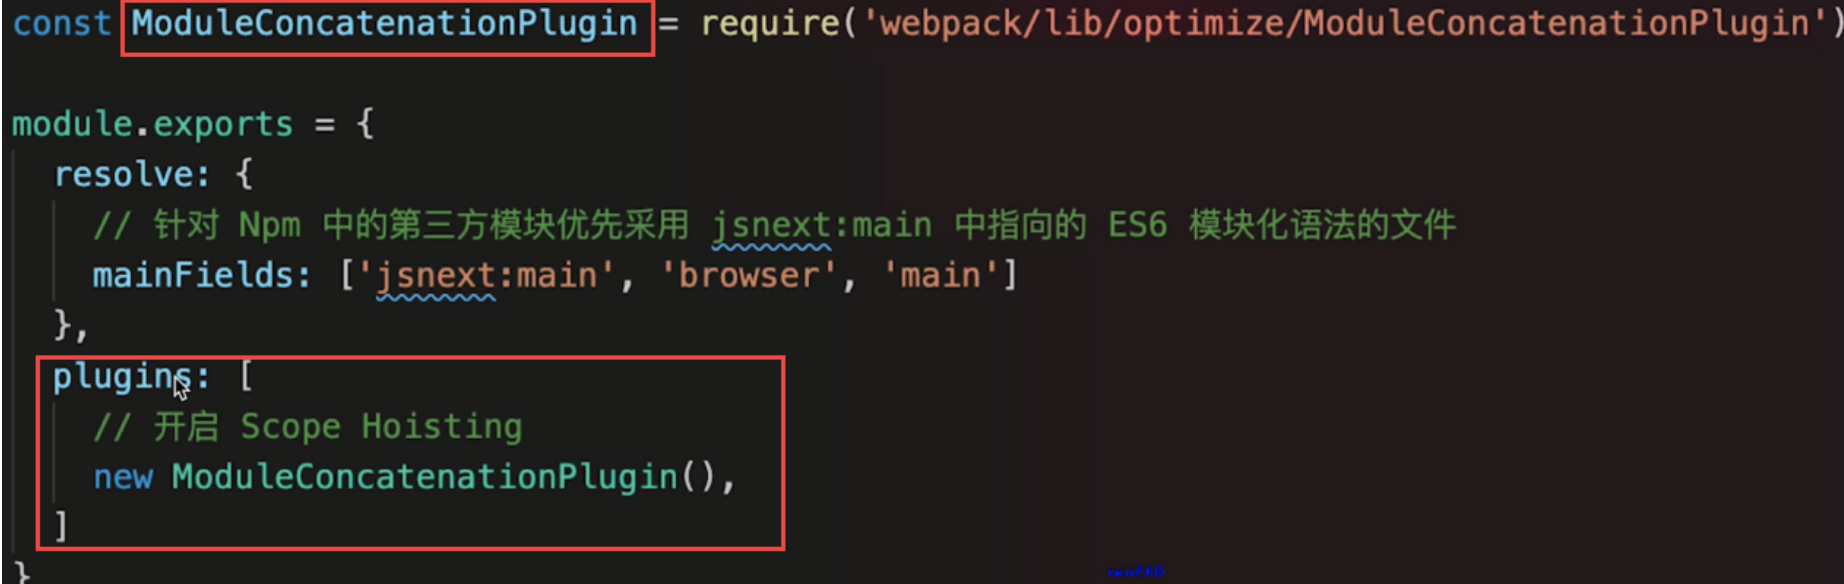
💬 面试官追问
开了
Tree Shaking,可lodash还是整个被打进来了,为什么?lodash本身是CommonJS产物,打包器没法静态分析,只能整包保留。换成lodash-es并写import { debounce } from 'lodash-es',或者直接import debounce from 'lodash/debounce'。构建从 1 分钟涨到 4 分钟,你第一步干什么?
先跑一遍
speed-measure-webpack-plugin,看是哪个loader或插件吃时间,别上来就加thread-loader。多进程本身有启动开销,小项目加了反而更慢。大部分情况是babel-loader在处理node_modules,加include: path.resolve('src')就降下来了。视频播放器只在点击后才需要,怎么不让它进首屏包?
点击时再
import('./Player'),webpack会自动把它拆成单独的chunk。可以配合/* webpackPrefetch: true */,让浏览器空闲时预取,点的时候基本秒开。第三方库没改过,可每次发版
vendor的文件名都变了,缓存全废,怎么回事?多半是用了
[hash]而不是[contenthash],或者runtime代码混在vendor里,业务一改模块id跟着变。改用[contenthash],加optimization.runtimeChunk: 'single',webpack 5默认的moduleIds: 'deterministic'也能保证id稳定。都做了代码分割,还有必要让运维开
gzip吗?有,两件事不在一层。代码分割决定什么时候加载哪些代码,
gzip/br决定传输时压多小,叠加使用。一个压缩后的JS文件再gzip一般还能小60%~70%。
# 6 介绍一下 Tree Shaking
⚡ 30 秒速记
- 一句话:打包时把「导出了但没人用」的代码删掉
- 前提是
ESM的静态结构:import/export只能写在顶层,不运行就能看出谁用了谁;require可以写在if里,分析不了 webpack分两步:先标记没用的导出(usedExports),再由Terser压缩时真正删掉;production模式默认开sideEffects告诉打包器「这些文件删了也没事」;CSS、polyfill这类只import不取值的文件要列进数组,不然会被误删- 常见失效:
Babel把ESM转成了CommonJS(modules别设成commonjs)、库只发CJS产物、顶层有改原型或注册全局的副作用
Tree Shaking 就是打包时把引进来但没用到的代码摇掉。 它能做,是因为 ESM 的 import / export 写死在顶层,打包器不运行代码就能画出完整的引用关系,CommonJS 的 require 可以动态拼路径,就做不到。webpack 里是先标记未使用的导出,再在压缩阶段删掉。实际最常失效的原因有两个:一是 Babel 把模块转成了 CommonJS,二是代码有副作用,打包器不敢删,这时候要靠 package.json 的 sideEffects 明确告诉它。
对tree-shaking的了解
作用:
它表示在打包的时候会去除一些无用的代码
原理:
ES6的模块引入是静态分析的,所以在编译时能正确判断到底加载了哪些模块- 分析程序流,判断哪些变量未被使用、引用,进而删除此代码
特点:
- 在生产模式下它是默认开启的,但是由于经过
babel编译全部模块被封装成IIFE,它存在副作用无法被tree-shaking掉 - 可以在
package.json中配置sideEffects来指定哪些文件是有副作用的。它有两种值,一个是布尔类型,如果是false则表示所有文件都没有副作用;如果是一个数组的话,数组里的文件路径表示改文件有副作用 rollup和webpack中对tree-shaking的层度不同,例如对babel转译后的class,如果babel的转译是宽松模式下的话(也就是loose为true),webpack依旧会认为它有副作用不会tree-shaking掉,而rollup会。这是因为rollup有程序流分析的功能,可以更好的判断代码是否真正会产生副作用。
原理
ES6 Module引入进行静态分析,故而编译的时候正确判断到底加载了那些模块- 静态分析程序流,判断那些模块和变量未被使用或者引用,进而删除对应代码
依赖于
import/export
通过导入所有的包后再进行条件获取。如下:
import foo from "foo";
import bar from "bar";
if(condition) {
// foo.xxxx
} else {
// bar.xxx
}
ES6的import语法完美可以使用tree shaking,因为可以在代码不运行的情况下就能分析出不需要的代码
CommonJS的动态特性模块意味着tree shaking不适用。因为它是不可能确定哪些模块实际运行之前是需要的或者是不需要的。在ES6中,进入了完全静态的导入语法:import。这也意味着下面的导入是不可行的:
// 不可行,ES6 的import是完全静态的
if(condition) {
myDynamicModule = require("foo");
} else {
myDynamicModule = require("bar");
}
💬 面试官追问
只引了
formatPrice,同文件的formatDate还在产物里,为什么?先看是不是
development模式,那里只标记不删。再看那个文件顶层有没有副作用,比如const cache = initCache(),打包器不确定删了会不会出问题,就整块留着。给函数调用加/*#__PURE__*/注释,或者把副作用拆出去。发一个工具函数包,
package.json里sideEffects怎么写?确认所有文件都是纯导出,就写
"sideEffects": false。如果有样式文件,写成"sideEffects": ["*.css"],否则业务方import 'your-lib/style.css'会被当成没用的直接删掉,样式就丢了。代码交给
webpack能摇,过了一遍Babel就全保留了,先查哪?查
@babel/preset-env的modules配置。设成了commonjs,import全变成require,静态分析就失效了。走babel-loader时它默认会保留ESM,手动改过才会出这个问题。按条件
require('foo')或require('bar'),构建时能把用不到的那个删掉吗?删不了,构建时不知道条件是真是假,两个都得打进去。如果条件是环境变量这种构建期就确定的值,用
DefinePlugin把它替换成常量,Terser会把死分支删掉,这是DCE不是Tree Shaking。同一份
class代码,Rollup能删掉,webpack删不掉,为什么?Babel宽松模式转出来的class会往原型上赋值,webpack保守地当成副作用保留,Rollup做了更细的程序流分析,能判断出这些赋值不影响外部。这也是打库常用Rollup的原因之一。
# 7 介绍一下 webpack scope hosting
⚡ 30 秒速记
Scope Hoisting= 作用域提升:把多个模块的代码拼进同一个函数作用域,常被写成hosting,正确拼写是Hoisting- 解决什么:默认每个模块包一层函数,靠
__webpack_require__互相调用,模块一多函数和闭包就多 - 收益:产物更小,运行时少了大量函数调用;对应
ModuleConcatenationPlugin/optimization.concatenateModules webpack 4+在production下默认开,开发模式默认关- 合并不了的情况:
CommonJS模块、被多个chunk共用的模块、用了eval的模块,webpack会自动退回独立包装
Scope Hoisting 就是把本来各包一层函数的模块,尽量拼到同一个作用域里,少一堆包装函数和 require 调用。 默认打包后每个模块都是一个函数,比如 a 引 b,运行时要先调 __webpack_require__('b') 再拿导出。开了之后,b 的代码直接内联到 a 前面,变量改个名避免冲突就行。它和 Tree Shaking 一样依赖 ESM 的静态结构,webpack 4 以后生产模式默认开,一般不用手动配。想知道哪些模块没合并,可以加 --stats-optimization-bailout 看原因。
作用域提升(Scope Hoisting),将分散的模块划分到同一个作用域中,避免了代码的重复引入,有效减少打包后的代码体积和运行时的内存损耗。
原理:webpack 默认会把每个模块包裹进一个独立的函数((function(module, exports, require){...})),模块越多,这类包裹函数和 __webpack_require__ 调用越多,产物体积和运行时开销都变大。Scope Hoisting 会分析模块间的依赖关系,把可以合并的模块「提升」到同一个函数作用域里,减少函数包裹和模块间的 require 调用。
要点:
- 依赖 ESM 的静态结构:Scope Hoisting 只能对 ES Module(
import/export)生效——因为它需要在编译期静态分析模块的导入导出关系;CommonJS 的动态require无法静态分析,不能提升。这也是「用 ESM 才能享受更好的打包优化」的又一个理由(同 Tree Shaking)。 - 生产模式默认开启:webpack 4+ 在
mode: 'production'下默认启用(对应optimization.concatenateModules),开发模式默认关闭。 - 收益:更小的产物、更少的闭包和函数调用、更快的运行时。
一句话:Scope Hoisting 把多个 ESM 模块合并到同一作用域,减少函数包裹和 require 调用,从而减小体积、提升运行时性能;它依赖 ESM 的静态结构,生产模式默认开启。
💬 面试官追问
开了
Tree Shaking,为什么产物里还有一堆__webpack_require__?两件事管的不一样。
Tree Shaking删的是没用的代码,留下来的模块照样各包一层函数。把这些包装拍平是Scope Hoisting的活,生产模式下它是开的,还剩的那些通常是没满足合并条件的模块。生产模式下入口附近还是很多独立模块,怎么查是哪里没合并?
打包时加
--stats-optimization-bailout,webpack会逐个写出放弃合并的理由,比如「模块不是ESM」「被多个chunk引用」。最常见的是Babel已经把代码转成了CommonJS。组件库全是
module.exports,开concatenateModules能合并吗?不能,
CommonJS的导出是运行时赋值的对象,编译期确定不了,webpack只能保留独立包装。想吃到这个优化,库要发ESM产物,package.json里配module或exports字段指过去。开发环境要不要也打开?
一般不开。合并后模块边界没了,调试和热更新都受影响,增量编译也更慢。它是生产包的优化,开发环境追求的是改得快、看得清。
# 8 Webpack Proxy工作原理?为什么能解决跨域
⚡ 30 秒速记
- 原理:
devServer起了个本地Node服务,浏览器请求同源的它,它再转发给真实后端,响应原路返回 - 为什么能绕开跨域:同源策略是浏览器的限制,服务器之间发请求没这个约束
- 底层是
http-proxy-middleware;关键配置target、changeOrigin(把Host改成目标域名)、pathRewrite(去掉/api前缀)、secure: false(放行自签证书) - 只在本地开发存在,打完包就没这台服务了;线上靠
Nginx反代或后端配CORS webpack-dev-server 5的proxy改成了数组写法,老的对象写法要迁移
webpack 的代理就是本地开发服务器帮你转发请求:浏览器只跟同源的 dev-server 说话,dev-server 再去请求真正的后端。 跨域是浏览器拦的,服务器之间通信根本不受同源策略管,所以绕过去了。配置上常用的就几个:target 写后端地址,changeOrigin: true 把请求头的 Host 改成后端域名,很多网关按 Host 路由,不改会 404;pathRewrite 去掉前端加的 /api 前缀。它只是开发期的工具,上线后没有这台服务,要换成 Nginx 反代或者后端开 CORS。
1. 是什么
webpack proxy,即webpack提供的代理服务
基本行为就是接收客户端发送的请求后转发给其他服务器
其目的是为了便于开发者在开发模式下解决跨域问题(浏览器安全策略限制)
想要实现代理首先需要一个中间服务器,webpack中提供服务器的工具为webpack-dev-server
2. webpack-dev-server
webpack-dev-server是 webpack 官方推出的一款开发工具,将自动编译和自动刷新浏览器等一系列对开发友好的功能全部集成在了一起
目的是为了提高开发者日常的开发效率,「只适用在开发阶段」
关于配置方面,在webpack配置对象属性中通过devServer属性提供,如下:
// ./webpack.config.js
const path = require('path')
module.exports = {
// ...
devServer: {
contentBase: path.join(__dirname, 'dist'),
compress: true,
port: 9000,
proxy: {
'/api': {
target: 'https://api.github.com'
}
}
// ...
}
}
devServetr里面proxy则是关于代理的配置,该属性为对象的形式,对象中每一个属性就是一个代理的规则匹配
属性的名称是需要被代理的请求路径前缀,一般为了辨别都会设置前缀为/api,值为对应的代理匹配规则,对应如下:
target:表示的是代理到的目标地址pathRewrite:默认情况下,我们的/api-hy也会被写入到URL中,如果希望删除,可以使用pathRewritesecure:默认情况下不接收转发到https的服务器上,如果希望支持,可以设置为falsechangeOrigin:它表示是否更新代理后请求的headers中host地址
2. 工作原理
proxy工作原理实质上是利用http-proxy-middleware这个http代理中间件,实现请求转发给其他服务器
举个例子:
在开发阶段,本地地址为http://localhost:3000,该浏览器发送一个前缀带有/api标识的请求到服务端获取数据,但响应这个请求的服务器只是将请求转发到另一台服务器中
const express = require('express');
const proxy = require('http-proxy-middleware');
const app = express();
app.use('/api', proxy({target: 'http://www.example.org', changeOrigin: true}));
app.listen(3000);
// http://localhost:3000/api/foo/bar -> http://www.example.org/api/foo/bar
3. 跨域
在开发阶段,
webpack-dev-server会启动一个本地开发服务器,所以我们的应用在开发阶段是独立运行在localhost的一个端口上,而后端服务又是运行在另外一个地址上
所以在开发阶段中,由于浏览器同源策略的原因,当本地访问后端就会出现跨域请求的问题
通过设置webpack proxy实现代理请求后,相当于浏览器与服务端中添加一个代理者
当本地发送请求的时候,代理服务器响应该请求,并将请求转发到目标服务器,目标服务器响应数据后再将数据返回给代理服务器,最终再由代理服务器将数据响应给本地
在代理服务器传递数据给本地浏览器的过程中,两者同源,并不存在跨域行为,这时候浏览器就能正常接收数据
注意:
「服务器与服务器之间请求数据并不会存在跨域行为,跨域行为是浏览器安全策略限制」
💬 面试官追问
前端请求
/api/users,后端只认/users,代理怎么配?加
pathRewrite: { '^/api': '' }。target只决定发到哪台机器,不会帮你改路径,没改的话后端会回404,看着像代理没生效,其实是路由不对。代理通了,后端网关却回了个错误页,日志里
Host是localhost:8080,缺什么?缺
changeOrigin: true。不开的话转发请求里的Host还是本地地址,按域名路由的网关找不到对应站点。测试环境是自签
https证书,代理报证书错误,怎么办?本地配
secure: false跳过校验就行。这只是开发配置,正式环境该用正规证书还是要用,别把这个习惯带到线上网关去。有人说上线也用
devServer.proxy解决跨域,行吗?不行,
devServer只在npm run dev时存在,构建产物是一堆静态文件,没有这台服务。线上要么Nginx配location /api/ { proxy_pass ...; },要么后端返回Access-Control-Allow-Origin。代理配好了,浏览器
Network里看到的请求地址为什么还是localhost?这是对的,浏览器只知道自己请求的是
dev-server,转发发生在服务端,浏览器看不到。想确认转发到哪了,在代理里加logLevel: 'debug'或者看后端日志。
# 9 介绍一下 babel原理
⚡ 30 秒速记
- 三步:解析
parse→ 转换transform→ 生成generate,中间产物是AST - 解析:
@babel/parser(以前叫babylon)先词法分析出token,再语法分析成树 - 转换:
@babel/traverse遍历AST,插件用visitor按节点类型改树,Babel本身不改代码,全靠插件 - 生成:
@babel/generator把新树打印成代码,顺带出source map - 易混:
Babel只转语法(箭头函数、可选链),Promise、Array.prototype.includes这类API要core-js补;preset-env配useBuiltIns: 'usage'按需引
Babel 就是一个编译器:先把代码读成一棵语法树,让插件改这棵树,再把树重新写成代码。 解析阶段 @babel/parser 把源码变成 AST,比如箭头函数会变成一个 ArrowFunctionExpression 节点。转换阶段是核心,插件通过 visitor 声明「我关心哪类节点」,遍历到了就改,比如把 ArrowFunctionExpression 换成普通函数。最后 @babel/generator 把改完的树打印出来。面试里我会顺带讲清楚一点:Babel 只管语法,新 API 得靠 core-js 这类 polyfill,很多人以为配了 Babel 就能在老浏览器跑 Promise。
babel的编译过程分为三个阶段:parsing、transforming、generating,以 ES6 编译为 ES5 作为例子:
ES6代码输入;babylon进行解析得到 AST;plugin用babel-traverse对AST树进行遍历编译,得到新的AST树;- 用
babel-generator通过AST树生成ES5代码。
Babel原理及其使用 (opens new window)
用一个最小插件看清三个阶段
假设要把代码里所有 console.log 调用删掉,插件只需要关心「转换」这一步:
// babel-plugin-remove-log.js
module.exports = function ({ types: t }) {
return {
visitor: {
// 遍历到每个函数调用节点时都会进来
CallExpression(path) {
const callee = path.get('callee')
// 匹配 console.log(...)
if (callee.matchesPattern('console.log')) {
path.remove()
}
},
},
}
}
const babel = require('@babel/core')
const out = babel.transformSync('console.log(1); foo();', {
plugins: ['./babel-plugin-remove-log.js'],
})
console.log(out.code) // 输出:foo();
transformSync 内部做的就是三件事:@babel/parser 把字符串读成 AST,@babel/traverse 带着所有插件的 visitor 深度优先遍历这棵树,最后 @babel/generator 把树打印回代码。多个插件的 visitor 会合并成一次遍历,不是每个插件各跑一遍,这也是 Babel 插件顺序有讲究的原因:plugins 从前往后执行,presets 从后往前执行。
另外要分清语法和 API:箭头函数、class、可选链这些是语法,Babel 能改写;Promise、Map、Array.prototype.flat 这些是运行时对象和方法,改写不了,只能靠 core-js 在老环境里补实现。
💬 面试官追问
有人说
Babel转箭头函数就是字符串替换,怎么反驳?字符串替换处理不了
this。箭头函数的this要外提成var _this = this,还要分清哪层作用域,只有在AST上按语法结构改才做得对。随便丢个嵌套箭头函数进AST Explorer看看节点就清楚了。要写个插件把所有
console.log删掉,逻辑写在哪个阶段?转换阶段,写一个
visitor匹配CallExpression,判断callee是console.log就path.remove()。解析和生成不用你管,Babel自己做。配了
@babel/preset-env,IE 11还是报Promise is undefined,为什么?preset-env默认只转语法,不补API。要加useBuiltIns: 'usage'加corejs: 3,并安装core-js,它才会按用到的API自动插入polyfill。插件跑完产物有语法错误,源码本身没问题,怎么查?
基本是插件把树改坏了,比如在只能放语句的地方塞了表达式。用
@babel/types的构造函数建节点,它会校验字段;再把插件前后的AST打印出来对比,定位是哪个visitor改出来的。现在
swc、esbuild这么快,Babel还有用吗?转译速度上它们完胜,所以构建链路里越来越多被替掉。但
Babel插件生态最全,自定义代码改写、一些实验性语法、React Compiler这类基于Babel插件的工具,还是离不开它。
# 10 介绍一下Rollup
⚡ 30 秒速记
- 定位:以
ESM为核心的打包器,产物扁平、可读,Tree Shaking做得比webpack细 - 强项是打库:一份源码输出
esm/cjs/umd多种格式,Vue、React这些都用过它打包 Vite生产构建就是Rollup(Vite新版本在换成Rust写的Rolldown,接口兼容Rollup)- 插件就是一组钩子函数(
resolveId、load、transform),没有loader/plugin之分;吃CommonJS依赖要靠@rollup/plugin-commonjs - 纠正旧说法:
Rollup 1.0起就支持动态import()代码分割,不需要Require.js;它自己没有dev-server和HMR,这块交给Vite
Rollup 是一个专注 ESM 的打包器,产物干净扁平,所以打库特别合适。 它把模块尽量拼进一个作用域,不像 webpack 带一层模块运行时,打出来的代码几乎和手写的一样,Tree Shaking 也更彻底。一份源码可以同时输出 esm、cjs、umd,发 npm 包很方便。短板是生态和开发体验,CommonJS 依赖要插件转,自己不带 dev-server 和 HMR。不过现在大家用它基本都是通过 Vite:开发时 Vite 走原生 ESM,打包时交给 Rollup,两边优点都拿到了。
Rollup 是一款 ES Modules 打包器。它也可以将项目中散落的细小模块打包为整块代码,从而使得这些划分的模块可以更好地运行在浏览器环境或者 Node.js 环境。
Rollup优势:
- 输出结果更加扁平,执行效率更高;
- 自动移除未引用代码;
- 打包结果依然完全可读。
缺点
- 加载非 ESM 的第三方模块比较复杂;
- 因为模块最终都被打包到全局中,所以无法实现
HMR; - 浏览器环境中,代码拆分功能必须使用
Require.js这样的AMD库
- 我们发现如果我们开发的是一个应用程序,需要大量引用第三方模块,同时还需要 HMR 提升开发体验,而且应用过大就必须要分包。那这些需求 Rollup 都无法满足。
- 如果我们是开发一个 JavaScript 框架或者库,那这些优点就特别有必要,而缺点呢几乎也都可以忽略,所以在很多像 React 或者 Vue 之类的框架中都是使用的 Rollup 作为模块打包器,而并非 Webpack
总结一下:Webpack 大而全,Rollup 小而美。
在对它们的选择上,我的基本原则是:应用开发使用 Webpack,类库或者框架开发使用 Rollup。
不过这并不是绝对的标准,只是经验法则。因为 Rollup 也可用于构建绝大多数应用程序,而 Webpack 同样也可以构建类库或者框架。
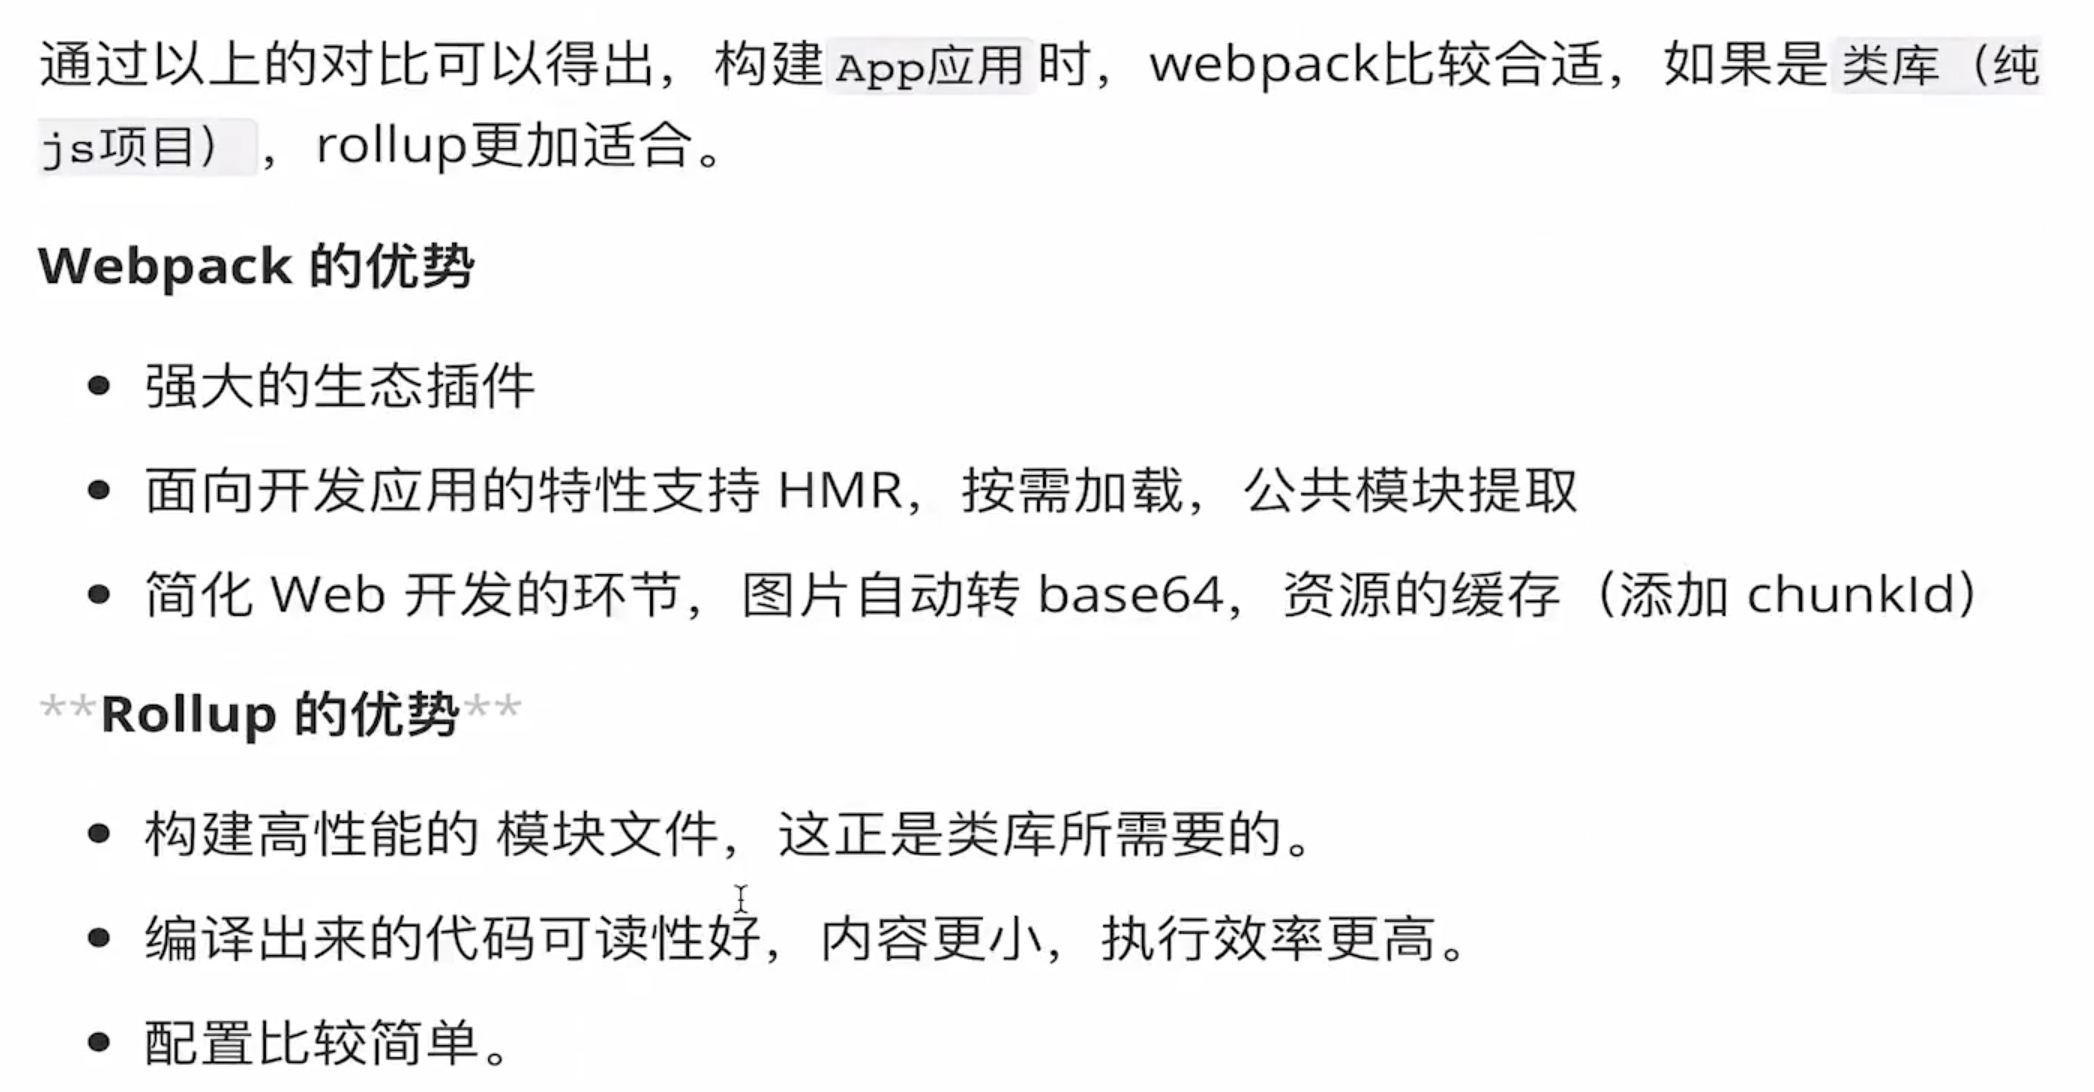
💬 面试官追问
网上说
Rollup不支持代码分割,对吗?过时了。
Rollup 1.0起支持多入口和动态import(),输出esm格式时会自动拆chunk,浏览器原生加载,不需要Require.js。只有输出iife/umd这种单文件格式时才拆不了。迁到
Rollup后有个CommonJS的包报default is not exported,怎么办?Rollup默认只认ESM,要加@rollup/plugin-commonjs把它转一下,通常还要配@rollup/plugin-node-resolve才能找到node_modules里的包。转出来的默认导出有时和预期不一样,要看库的导出方式调defaultIsModuleExports。发一个组件库,
react要不要打进产物?不要,配
external: ['react', 'react-dom'],并在package.json写成peerDependencies。打进去的话业务里会有两份React,hooks直接报错。公司新做一个后台应用,用
Rollup还是webpack?应用一般不直接用
Rollup,开发体验差。要轻快就上Vite,底层打包还是Rollup;老项目或者依赖webpack生态(Module Federation之类)就留在webpack或换Rspack。「应用用webpack、库用Rollup」只是经验,不是规定。
# 十、HTTP
# HTTP状态码
⚡ 30 秒速记
- 五类:
1xx信息(如101协议升级)、2xx成功、3xx重定向、4xx客户端错、5xx服务端错 200正常、204成功但无body、206范围请求(断点续传、视频拖进度条)301永久会被浏览器缓存、302临时;要保证POST不变成GET用307/308,明确要转GET用303304是协商缓存命中,不是错误;401没登录,403登录了没权限502网关拿到上游坏响应、503服务暂不可用、504等上游超时;停服维护返503别返404
状态码我不会按表背,而是讲清楚每个码会让客户端做什么。 比如 301 浏览器会缓存,下次直接跳,配错了用户那边很难清掉;302 不缓存。304 告诉浏览器「你手里那份还能用」,是缓存协商的一环,不是失败。401 和 403 前端处理完全不同,一个跳登录,一个提示没权限。5xx 里 502、504 一般是网关和上游之间出事了,500 才是应用自己抛错,排查方向不一样。
- 1xx 信息性状态码 websocket upgrade
- 2xx 成功状态码
- 200 服务器已成功处理了请求
- 204(没有响应体)
- 206(范围请求 暂停继续下载)
- 3xx 重定向状态码
- 301(永久) :请求的页面已永久跳转到新的url
- 302(临时) :允许各种各样的重定向,一般情况下都会实现为到
GET的重定向,但是不能确保POST会重定向为POST - 303 只允许任意请求到
GET的重定向 - 304 未修改:自从上次请求后,请求的网页未修改过
- 307:
307和302一样,除了不允许POST到GET的重定向
- 4xx 客户端错误状态码
- 400 客户端参数错误
- 401 没有登录
- 403 登录了没权限 比如管理系统
- 404 页面不存在
- 405 禁用请求中指定的方法
- 5xx 服务端错误状态码
- 500 服务器错误:服务器内部错误,无法完成请求
- 502 错误网关:服务器作为网关或代理出现错误
- 503 服务不可用:服务器目前无法使用
- 504 网关超时:网关或代理服务器,未及时获取请求
💬 面试官追问
后端所有接口都返回
200,错误放在body的code里,你接受吗?不太接受。监控、网关、
CDN只看状态码,这样成功率永远100%,出了问题报不上来。我的做法是HTTP状态码表达大类,400、401、500该给就给,业务细分原因再放code。把
/old用301跳到了错的地址,改回来了用户还是跳错,为什么?301会被浏览器缓存,有的能缓存很久,服务端改了浏览器根本不再请求。用户那边只能清缓存。所以新上的跳转我会先用302跑一段时间,确认没问题再切301。POST提交后需要跳转,下一跳还得是POST,用302行吗?不行,大多数浏览器遇到
302会把POST改成GET。要保留方法用307(临时)或308(永久)。表单提交后跳结果页这种明确要变GET的,用303。登录态过期,接口一会儿
401一会儿403,前端怎么区分处理?401说明身份没认出来,清token跳登录页;403说明认出来了但没权限,提示「无权限」停在当前页。混着处理很容易出现「登录了又跳登录」的死循环。线上一直报
504,后端说他们日志里请求都成功了,问题在哪?504是网关等上游超时,后端成功不代表在网关超时时间内成功。看后端日志里的耗时是不是超过了Nginx的proxy_read_timeout(默认60s),慢接口要么优化,要么单独调大超时。
# 1 HTTP前生今世
⚡ 30 秒速记
- 主线:每一代都在解决上一代的性能瓶颈,尤其是「排队」问题
HTTP/0.9(1991):只有GET,只能传HTML,没有头部;HTTP/1.0(1996,RFC 1945)加了头部、状态码、Content-Type,每个请求一条连接HTTP/1.1(1997):默认长连接、Host头、Range、缓存控制,用了将近20年HTTP/2(2015,脱胎于Google的SPDY):二进制分帧、多路复用、HPACK头部压缩HTTP/3(2022发布RFC 9114,基于QUIC):传输层换成UDP上的QUIC;现在主流浏览器和CDN都已支持,不是「将来」了
HTTP 的演进可以一句话概括:功能在 1.1 基本定型,之后两代都在解决性能,特别是排队。 0.9 只能拿一个 HTML;1.0 加了头部和状态码,能传图片了,但每个请求都要重新握手;1.1 默认长连接、加了 Host 头支持一台机器多个站点,这套用了快 20 年。HTTP/2 来自 SPDY,用多路复用在一条连接上并发跑多个请求;HTTP/3 更进一步,把 TCP 换成基于 UDP 的 QUIC,解决丢包时整条连接一起等的问题。以前常说 HTTP/2 还没普及、HTTP/3 是将来,这个说法已经过时了,现在两者都是主流。
HTTP协议始于三十年前蒂姆·伯纳斯 - 李的一篇论文HTTP/0.9是个简单的文本协议,只能获取文本资源;HTTP/1.0确立了大部分现在使用的技术,但它不是正式标准;HTTP/1.1是目前互联网上使用最广泛的协议,功能也非常完善;HTTP/2基于 Google 的SPDY协议,注重性能改善,但还未普及;HTTP/3基于 Google 的QUIC协议,是将来的发展方向
💬 面试官追问
HTTP/1.1最重要的改进是什么?我会说长连接和
Host头。长连接让多个请求复用一条TCP,不用每次都三次握手;Host头让一个IP能挂多个域名,虚拟主机才做得起来,这是那个年代建站成本降下来的关键。网站升级到
HTTP/2了还是慢,可能是什么原因?先在
Network面板的Protocol列确认真的是h2,有时只有CDN到浏览器是h2,回源还是1.1。确认了还慢,就要看是不是资源本身太大、接口慢,协议只解决排队,解决不了后端耗时。HTTP/2和HTTP/3都是Google搞的,是不是一回事?不是。
HTTP/2基于SPDY,还跑在TCP上;HTTP/3基于QUIC,跑在UDP上。语义层(方法、状态码、头部)没变,变的是底下怎么传。现在要不要所有服务都切
HTTP/3?一般在
CDN或网关上开就行,客户端不支持或者UDP被企业网络封了会自动回落到HTTP/2。浏览器靠响应头Alt-Svc发现服务端支持h3,所以首个请求通常还是h2。
# 2 HTTP世界全览
⚡ 30 秒速记
HTTP是应用层协议,跑在TCP/IP上,请求-响应模式,本身无状态- 请求方叫
User Agent:浏览器、爬虫、App里的网络库都是;应答方是Nginx、Node这类服务器 - 中间节点:
CDN做缓存加速,代理做转发和负载均衡,链路越长越要会分段排查 - 周边:
DNS把域名翻成IP,URI定位资源,HTTPS=HTTP+TLS+TCP/IP,给HTTP套了层加密壳 - 规范由
IETF用RFC发布,W3C/WHATWG管的是HTML、DOM那一层
HTTP 世界里可以分成三类角色:发请求的、回应答的、站在中间转手的。 发请求的统称 User Agent,浏览器是,爬虫也是;回应答的是 Nginx、Node 这类服务器;中间有 CDN 和各种代理,负责缓存、转发、负载均衡。一次访问之前,DNS 先把域名翻译成 IP,URI 说明要哪个资源。普通 HTTP 直接跑在 TCP 上,HTTPS 是在中间插了一层 TLS 加密,不是另起一套协议。把这张图记住,线上出问题时就知道该一段一段往哪查。
- 互联网上绝大部分资源都使用
HTTP协议传输; - 浏览器是 HTTP 协议里的请求方,即
User Agent; - 服务器是 HTTP 协议里的应答方,常用的有
Apache和Nginx; CDN位于浏览器和服务器之间,主要起到缓存加速的作用;- 爬虫是另一类
User Agent,是自动访问网络资源的程序。 TCP/IP是网络世界最常用的协议,HTTP通常运行在TCP/IP提供的可靠传输基础上DNS域名是IP地址的等价替代,需要用域名解析实现到IP地址的映射;URI是用来标记互联网上资源的一个名字,由“协议名 + 主机名 + 路径”构成,俗称 URL;HTTPS相当于“HTTP+SSL/TLS+TCP/IP”,为HTTP套了一个安全的外壳;- 代理是
HTTP传输过程中的“中转站”,可以实现缓存加速、负载均衡等功能
💬 面试官追问
页面打不开,应用日志里一条请求都没有,你从哪查?
请求还没到应用,就按链路往前查:
dig看域名解析到哪个IP,curl -v看TCP连没连上、TLS握手有没有报证书错,再看CDN或网关的日志。别一上来就改业务代码。爬虫也算
HTTP客户端吗?要不要区别对待?算,它也是
User Agent,只是不由人操作。SEO爬虫要让它能抓到内容,恶意爬虫要限流,服务端一般结合User-Agent头、IP段和访问频率区分,单看User-Agent很容易被伪造。静态图片接了
CDN,改了图片用户看到的还是旧的,为什么?CDN节点缓存了旧文件,还没过期。最稳的办法是文件名带contenthash,改了内容就是新地址;临时救急就在CDN后台刷新那个URL。HTTPS是不是把HTTP和TCP都换掉了?没有,
HTTP报文格式一点没变,只是在HTTP和TCP之间加了TLS,发出去前加密、收到后解密。所以证书问题、握手问题和接口本身的问题要分开排查。
# 3 HTTP分层
⚡ 30 秒速记
TCP/IP四层:链路层 → 网络层(IP)→ 传输层(TCP/UDP)→ 应用层(HTTP/DNS),从下往上数HTTP在第四层OSI七层是理论模型:TCP在第四层、HTTP在第七层;OSI的会话、表示、应用三层在TCP/IP里合并成一个应用层- 日常说的「四层负载均衡」「七层网关」用的是
OSI编号:四层只看IP+ 端口,七层能看URL、Header - 发数据逐层加头封装,收数据逐层拆,上层看不见下层细节
- 分层的好处:可替换,
HTTP/3把TCP换成QUIC而HTTP语义不用改;TLS插在应用层和传输层之间
分层的意义是各管各的:HTTP 只管报文内容,可靠传输交给 TCP,寻址交给 IP,上层不用关心下层怎么做。 有两套编号容易混:TCP/IP 是四层,HTTP 在最上面的应用层;OSI 是七层,TCP 在第四层,HTTP 在第七层。工程里聊「四层」「七层」基本都按 OSI 来,比如四层负载均衡只按 IP 和端口转发,七层网关能按路径、Cookie 分流。一个粗略的判断办法是:操作系统内核处理的是四层及以下,需要应用自己解析的是七层,但这只是经验,不是定义。
- 第一层:物理层,
TCP/IP里无对应; - 第二层:数据链路层,对应
TCP/IP的链接层; - 第三层:网络层,对应
TCP/IP的网际层; - 第四层:传输层,对应
TCP/IP的传输层; - 第五、六、七层:统一对应到
TCP/IP的应用层
总结
TCP/IP分为四层,核心是二层的IP和三层的TCP,HTTP在第四层;OSI分为七层,基本对应TCP/IP,TCP在第四层,HTTP在第七层;OSI可以映射到TCP/IP,但这期间一、五、六层消失了;- 日常交流的时候我们通常使用
OSI模型,用四层、七层等术语; HTTP利用TCP/IP协议栈逐层打包再拆包,实现了数据传输,但下面的细节并不可见
有一个辨别四层和七层比较好的(但不是绝对的)小窍门,“两个凡是”:凡是由操作系统负责处理的就是四层或四层以下,否则,凡是需要由应用程序(也就是你自己写代码)负责处理的就是七层
💬 面试官追问
有人说
HTTP在第四层,有人说第七层,谁对?都对,看用哪个模型。
TCP/IP四层模型里应用层就是第四层,OSI七层里它在第七层。工程上说「七层」默认指OSI,交流时先说清用的是哪套。网关只能按端口转发,业务要按
/api和/static分到不同服务,需要什么?需要七层能力,也就是网关要解析
HTTP报文才能看到路径,比如Nginx的location。四层负载均衡只看IP和端口,看不到URL。代价是七层要解包,性能开销比四层大。HTTPS的TLS算哪一层?TCP/IP里没有专门一层给它,它夹在TCP和HTTP中间。硬套OSI的话常被归到表示层或会话层,面试时说清它的位置比争编号有用。HTTP/3换了传输层,前端代码要改吗?基本不用。
fetch、XMLHttpRequest用的方法、状态码、头部都一样,协议协商是浏览器和服务器自己做的。这就是分层的好处,下层换了上层无感。
# 4 HTTP报文是什么样子的
⚡ 30 秒速记
- 结构:起始行 + 头部字段 + 空行 + 正文,请求和响应长得几乎一样
- 请求行 = 方法 + 路径 + 版本(
GET /index.html HTTP/1.1);状态行 = 版本 + 状态码 + 原因短语(HTTP/1.1 200 OK) - 头部是
key: value,每行用\r\n结束;HTTP/1.1里Host是必填的 - 空行(单独一个
\r\n)是头部和正文的分界,正文可以没有,比如GET请求、204响应 - 这套文本格式是
HTTP/1.x的;HTTP/2起改成二进制帧,头部用HPACK压缩,DevTools里看到的是还原后的样子
HTTP 报文就是一段有固定格式的文本:第一行说干什么,接着几行头部补充信息,空一行,后面是正文。 请求的第一行是「方法 + 路径 + 版本」,响应的第一行是「版本 + 状态码 + 短语」,这是两者唯一明显的区别。头部全是 key: value,正文可以是 JSON、图片、视频,也可以压根没有。那个空行很关键,解析器就是靠它知道头部结束了。另外要说明一句,这是 HTTP/1.1 的样子,HTTP/2 以后在线上传的是二进制帧,只是 DevTools 给你还原成了这种可读格式。
HTTP 协议的请求报文和响应报文的结构基本相同,由三大部分组成
- 起始行(start line):描述请求或响应的基本信息;
- 头部字段集合(header):使用
key-value形式更详细地说明报文; - 消息正文(entity):实际传输的数据,它不一定是纯文本,可以是图片、视频等二进制数据
这其中前两部分起始行和头部字段经常又合称为“请求头”或“响应头”,消息正文又称为“实体”,但与“header”对应,很多时候就直接称为“body”。
一个完整的 HTTP 报文就像是下图的这个样子,注意在 header 和 body 之间有一个“空行”
💬 面试官追问
一个
GET请求只有请求行和头部,没有正文,算完整报文吗?算,正文本来就是可选的。头部结束后那个空行在就行,
GET、HEAD请求和204、304响应都没有正文。手写一个最简单的
HTTP请求报文?GET /index.html HTTP/1.1\r\nHost: example.com\r\n\r\n。最后那两个\r\n,一个结束Host这一行,一个是空行。用nc example.com 80敲进去就能拿到响应。埋点想把事件数据塞进自定义头部,不放正文,行不行?
不建议。头部是用来描述报文的元信息,很多服务器和代理对单个头部和总头部大小有限制,
Nginx默认缓冲区是8KB左右,超了直接400。业务数据放正文,用POST或navigator.sendBeacon发。在
HTTP/2的页面里看DevTools,请求头里怎么多了:method、:path这种字段?那是
HTTP/2的伪头部。HTTP/2没有请求行了,方法、路径、协议、主机都拆成以冒号开头的字段放进头部帧,:authority就相当于以前的Host。
# 5 HTTP之URL
⚡ 30 秒速记
- 结构:
scheme://user@host:port/path?query#fragment,常用的就是协议、主机端口、路径、查询串、片段 URI是统称,URL是用位置标识资源的那种,日常基本混着叫#后面的片段不会发给服务器,hash路由就是靠这个- 编码:拼参数值用
encodeURIComponent,encodeURI不编码& = / ? #,用它处理参数值会把边界搞乱 - 别手拼:用
new URL()和URLSearchParams,同名多值用append;看到%25说明被重复编码了
URL 就是资源的地址,按顺序是协议、主机端口、路径、查询参数和 # 片段。 协议决定怎么访问,主机端口找到服务器,路径找到资源,query 附加条件,# 后面的片段只留在浏览器里,不会发给服务器。最容易出问题的是编码,参数值里有 &、=、中文,不编码就会把参数切错。我写代码基本不手拼,用 URLSearchParams 帮我编码,它会把每个值单独处理好。
URI是用来唯一标记服务器上资源的一个字符串,通常也称为 URL;URI通常由scheme、host:port、path和query四个部分组成,有的可以省略;scheme叫“方案名”或者“协议名”,表示资源应该使用哪种协议来访问;- “
host:port”表示资源所在的主机名和端口号; path标记资源所在的位置;query表示对资源附加的额外要求;- 在
URI里对“@&/”等特殊字符和汉字必须要做编码,否则服务器收到HTTP报文后会无法正确处理
💬 面试官追问
搜索词是「手机&配件」,后端只收到「手机」,怎么回事?
&没编码,被当成参数分隔符了,后端看到的是keyword=手机加一个叫「配件」的空参数。用new URLSearchParams({ keyword: '手机&配件' }).toString(),得到keyword=%E6%89%8B%E6%9C%BA%26%E9%85%8D%E4%BB%B6。encodeURI和encodeURIComponent什么时候用哪个?编码一个完整
URL用encodeURI,它保留: / ? & #这些结构字符;编码参数值用encodeURIComponent,它把这些也编码掉。拿encodeURI处理参数值,值里的&照样会把参数切断。日志里参数出现了
%252F,原值只是/docs,问题在哪?编码了两次。第一次
/变成%2F,第二次%又变成%25。顺着链路找是谁对已经编码过的值又编了一遍,常见是自己encodeURIComponent了,又交给axios的params再编一次。/page#section刷新时服务器收到的路径是什么?只有
/page,#section不会出现在请求里。所以hash路由不需要服务端配置,而history路由刷新时服务器会收到真实路径,要配兜底返回index.html。筛选条件很多,产品要求链接可分享,全塞
query里行吗?少量稳定的条件放
query没问题。条件多到几KB就不合适了,浏览器和服务器对URL长度有各自的限制,Nginx默认请求行超过8KB就报414。可以把条件存服务端,链接里只放一个短id。
# 6 HTTP实体数据
⚡ 30 秒速记
Accept系列是客户端说「我要什么」,Content-系列是服务端说「我给的是什么」,这就是内容协商- 类型:
Accept↔Content-Type,MIME格式如text/html、application/json、multipart/form-data;不知道是什么就用application/octet-stream - 压缩:
Accept-Encoding↔Content-Encoding,常见gzip、br,br对文本通常比gzip再小15%~20% - 语言和字符集:
Accept-Language↔Content-Language;字符集写在Content-Type: text/html; charset=utf-8里 - 多个候选用
q值排优先级;同一个URL返回不同版本时,要加Vary告诉缓存按哪个头区分
实体数据靠一组成对的头字段说清楚:客户端用 Accept 系列说能接收什么,服务端用 Content- 系列说实际给了什么。 最常用的是类型和压缩两对,比如浏览器带 Accept-Encoding: gzip, br,服务端挑一个支持的压缩,回 Content-Encoding: br,浏览器按这个解压。候选项可以带 q 值,例如 text/html,application/xml;q=0.9。工程里最容易翻车的是缓存:同一个 URL 按语言或压缩返回不同内容,又没加 Vary,CDN 就会把英文版发给中文用户。
1. 数据类型与编码
- text:即文本格式的可读数据,我们最熟悉的应该就是
text/html了,表示超文本文档,此外还有纯文本text/plain、样式表text/css等。 image:即图像文件,有image/gif、image/jpeg、image/png等。audio/video:音频和视频数据,例如audio/mpeg、video/mp4等。application:数据格式不固定,可能是文本也可能是二进制,必须由上层应用程序来解释。常见的有application/json,application/javascript、application/pdf等,另外,如果实在是不知道数据是什么类型,像刚才说的“黑盒”,就会是application/octet-stream,即不透明的二进制数据
但仅有
MIME type还不够,因为HTTP在传输时为了节约带宽,有时候还会压缩数据,为了不要让浏览器继续“猜”,还需要有一个“Encoding type”,告诉数据是用的什么编码格式,这样对方才能正确解压缩,还原出原始的数据。
比起 MIME type 来说,Encoding type 就少了很多,常用的只有下面三种
gzip:GNU zip压缩格式,也是互联网上最流行的压缩格式;deflate:zlib(deflate)压缩格式,流行程度仅次于gzip;br:一种专门为HTTP优化的新压缩算法(Brotli)
2. 数据类型使用的头字段
有了 MIME type 和 Encoding type,无论是浏览器还是服务器就都可以轻松识别出 body 的类型,也就能够正确处理数据了。
HTTP 协议为此定义了两个 Accept 请求头字段和两个 Content 实体头字段,用于客户端和服务器进行“内容协商”。也就是说,客户端用 Accept 头告诉服务器希望接收什么样的数据,而服务器用 Content 头告诉客户端实际发送了什么样的数据
Accept字段标记的是客户端可理解的MIMEtype,可以用“,”做分隔符列出多个类型,让服务器有更多的选择余地,例如下面的这个头:
Accept: text/html,application/xml,image/webp,image/png
这就是告诉服务器:“我能够看懂 HTML、XML 的文本,还有 webp 和 png 的图片,请给我这四类格式的数据”。
相应的,服务器会在响应报文里用头字段Content-Type告诉实体数据的真实类型:
Content-Type: text/html
Content-Type: image/png
这样浏览器看到报文里的类型是“text/html”就知道是 HTML 文件,会调用排版引擎渲染出页面,看到“image/png”就知道是一个 PNG 文件,就会在页面上显示出图像。
Accept-Encoding字段标记的是客户端支持的压缩格式,例如上面说的 gzip、deflate 等,同样也可以用“,”列出多个,服务器可以选择其中一种来压缩数据,实际使用的压缩格式放在响应头字段Content-Encoding里
Accept-Encoding: gzip, deflate, br
Content-Encoding: gzip
不过这两个字段是可以省略的,如果请求报文里没有 Accept-Encoding 字段,就表示客户端不支持压缩数据;如果响应报文里没有 Content-Encoding 字段,就表示响应数据没有被压缩
3. 语言类型使用的头字段
同样的,HTTP 协议也使用 Accept 请求头字段和 Content 实体头字段,用于客户端和服务器就语言与编码进行“内容协商”。
Accept-Language字段标记了客户端可理解的自然语言,也允许用“,”做分隔符列出多个类型,例如:
Accept-Language: zh-CN, zh, en
这个请求头会告诉服务器:“最好给我 zh-CN 的汉语文字,如果没有就用其他的汉语方言,如果还没有就给英文”。
相应的,服务器应该在响应报文里用头字段Content-Language告诉客户端实体数据使用的实际语言类型
Content-Language: zh-CN
- 字符集在
HTTP里使用的请求头字段是Accept-Charset,但响应头里却没有对应的Content-Charset,而是在Content-Type字段的数据类型后面用“charset=xxx”来表示,这点需要特别注意。 - 例如,浏览器请求
GBK或UTF-8的字符集,然后服务器返回的是UTF-8编码,就是下面这样
Accept-Charset: gbk, utf-8
Content-Type: text/html; charset=utf-8
不过现在的浏览器都支持多种字符集,通常不会发送 Accept-Charset,而服务器也不会发送 Content-Language,因为使用的语言完全可以由字符集推断出来,所以在请求头里一般只会有 Accept-Language 字段,响应头里只会有 Content-Type字段
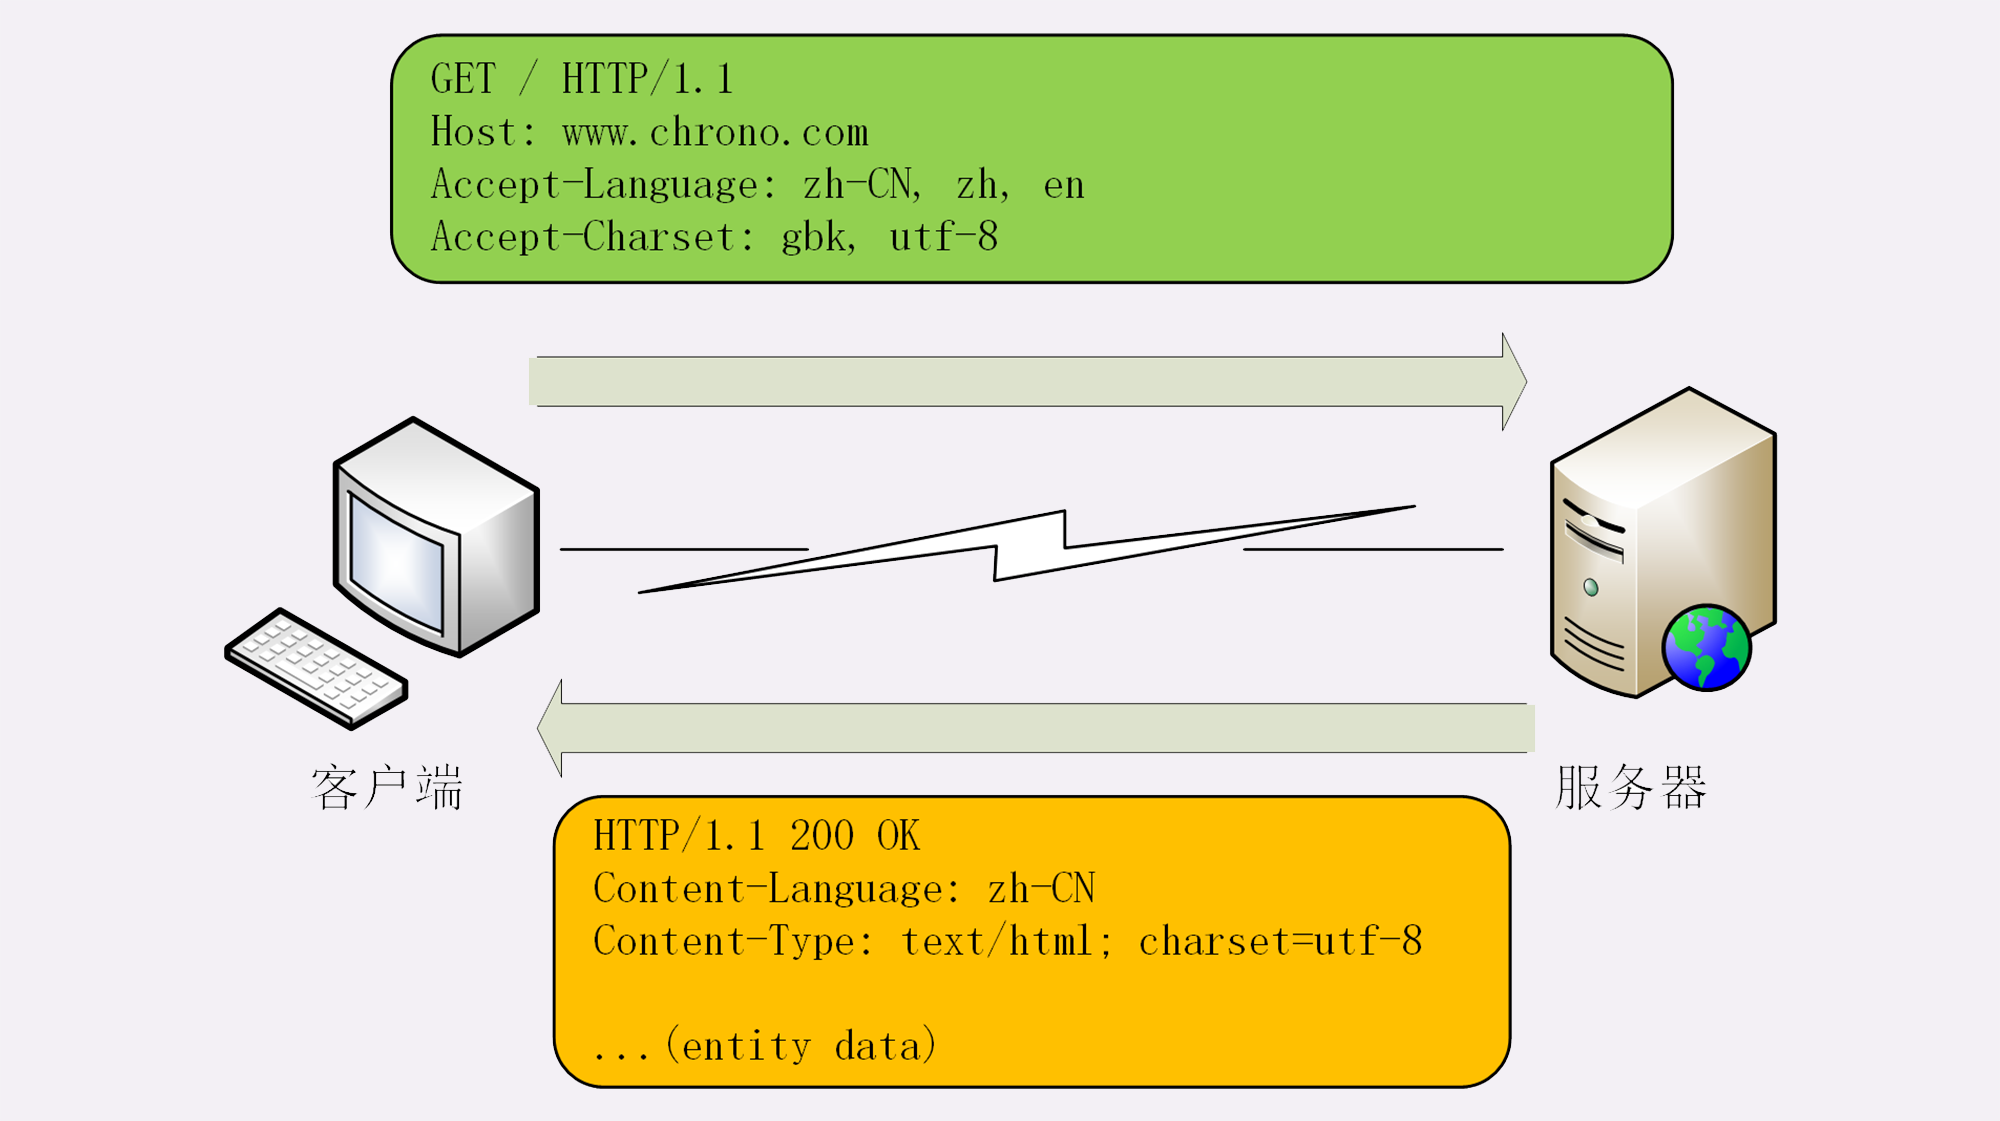
4. 内容协商的质量值
在 HTTP 协议里用 Accept、Accept-Encoding、Accept-Language 等请求头字段进行内容协商的时候,还可以用一种特殊的“q”参数表示权重来设定优先级,这里的“q”是“quality factor”的意思。
权重的最大值是 1,最小值是 0.01,默认值是 1,如果值是 0 就表示拒绝。具体的形式是在数据类型或语言代码后面加一个“;”,然后是“q=value”。
这里要提醒的是“;”的用法,在大多数编程语言里“;”的断句语气要强于“,”,而在 HTTP 的内容协商里却恰好反了过来,“;”的意义是小于“,”的。
例如下面的 Accept 字段:
Accept: text/html,application/xml;q=0.9,*/*;q=0.8
它表示浏览器最希望使用的是 HTML 文件,权重是 1,其次是 XML 文件,权重是 0.9,最后是任意数据类型,权重是0.8。服务器收到请求头后,就会计算权重,再根据自己的实际情况优先输出 HTML 或者 XML
5. 内容协商的结果
内容协商的过程是不透明的,每个 Web 服务器使用的算法都不一样。但有的时候,服务器会在响应头里多加一个Vary字段,记录服务器在内容协商时参考的请求头字段,给出一点信息,例如:
Vary: Accept-Encoding,User-Agent,Accept
这个 Vary 字段表示服务器依据了 Accept-Encoding、User-Agent 和 Accept 这三个头字段,然后决定了发回的响应报文。
Vary 字段可以认为是响应报文的一个特殊的“版本标记”。每当 Accept 等请求头变化时,Vary 也会随着响应报文一起变化。也就是说,同一个 URI 可能会有多个不同的“版本”,主要用在传输链路中间的代理服务器实现缓存服务,这个之后讲“HTTP 缓存”时还会再提到
6. 小结
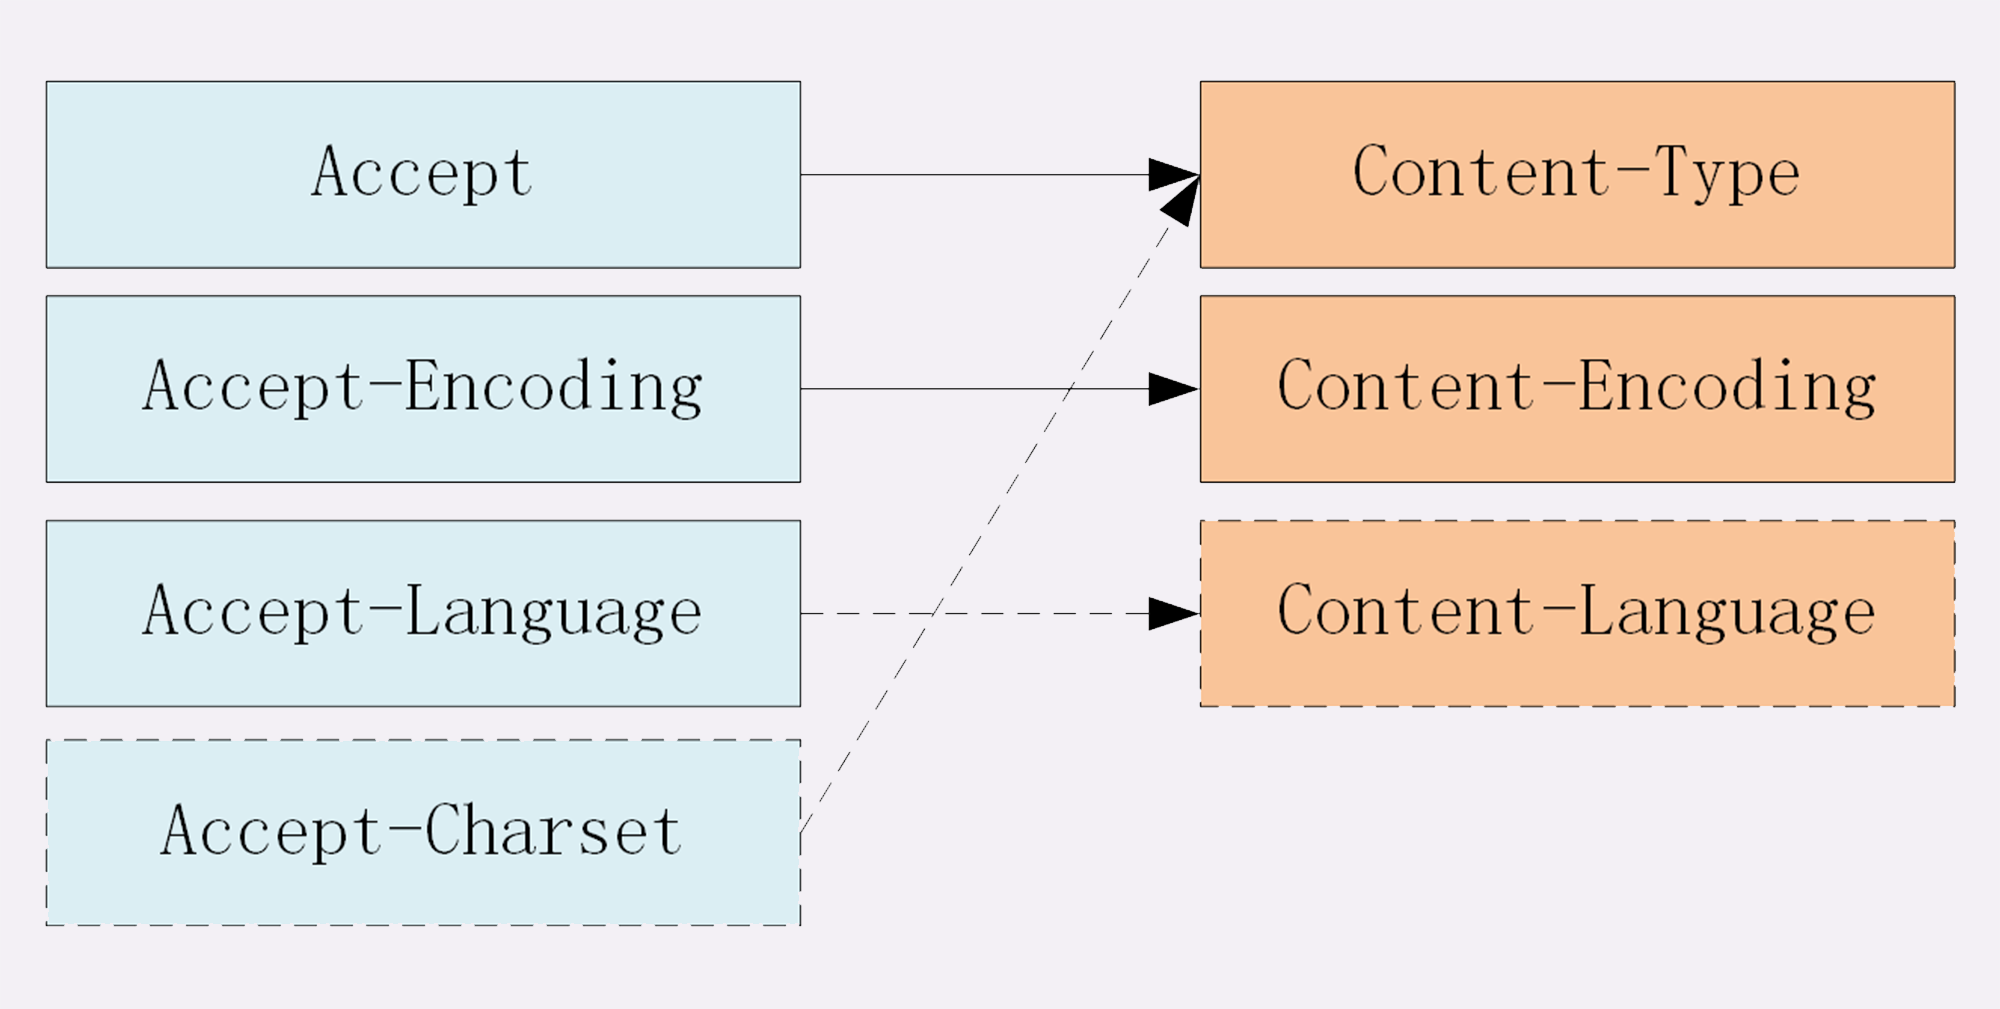
- 数据类型表示实体数据的内容是什么,使用的是
MIME type,相关的头字段是Accept和Content-Type; - 数据编码表示实体数据的压缩方式,相关的头字段是
Accept-Encoding和Content-Encoding; - 语言类型表示实体数据的自然语言,相关的头字段是
Accept-Language和Content-Language; - 字符集表示实体数据的编码方式,相关的头字段是
Accept-Charset和 Content-Type; - 客户端需要在请求头里使用
Accept等头字段与服务器进行“内容协商”,要求服务器返回最合适的数据;Accept等头字段可以用“,”顺序列出多个可能的选项,还可以用“;q=”参数来精确指定权重
💬 面试官追问
网关把
PDF接口的Content-Type统一改成了text/plain,字节没变,会有什么问题?浏览器是按
Content-Type决定怎么处理的,text/plain会被当文本显示,一屏乱码,不会调PDF预览。这种接口要如实返回application/pdf,想强制下载就再加Content-Disposition: attachment。前端
axios.post传对象,后端说收不到参数,可能是什么原因?axios传对象默认发application/json,后端如果按application/x-www-form-urlencoded解析就是空的。要么后端改成解析JSON,要么前端用URLSearchParams包一下,axios会自动换成表单类型。国际化首页偶尔把英文页发给中文用户,
CDN命中率很高,查什么?先看源站响应有没有
Vary: Accept-Language。没有的话CDN只按URL缓存,谁先访问就缓存谁的语言版本。加了Vary命中率会降,很多站干脆把语言放进路径,比如/zh/、/en/。上传文件为什么用
multipart/form-data,不用JSON?JSON只能放文本,文件要先转base64,体积涨三分之一。multipart/form-data用分隔符把每个字段隔开,文件按原始二进制传。前端用FormData时别手动设Content-Type,让浏览器自己带上boundary。
# 7 谈一谈HTTP协议优缺点
⚡ 30 秒速记
- 优点:简单(文本报文,人能直接读)、灵活可扩展(头部随便加,什么数据都能传)、请求-应答模式、靠
TCP保证可靠 - 无状态是双刃剑:服务器不记上下文,好扩容;但登录、购物车要靠
Cookie、Session、Token补 - 明文:
HTTP/1.x报文谁都能抓、能改,必须上HTTPS - 队头阻塞:
HTTP/1.1一条连接上请求要排队,慢的堵住后面的,HTTP/2、HTTP/3逐步解决 - 头部冗余:每个请求都带一遍
Cookie、User-Agent,HTTP/2用HPACK压缩
HTTP 的优点是简单灵活,缺点是无状态、明文和队头阻塞,其中无状态要分场景看。 简单是因为报文就是文本,人能直接读,加个头部就能扩展功能。无状态意味着每个请求互不认识,好处是任何一台服务器都能处理任何请求,扩容很容易;坏处是登录这种需要记住你是谁的场景,要额外用 Cookie 或 Token 带上身份。明文的问题靠 HTTPS 解决,队头阻塞是 HTTP/1.1 长连接上请求排队造成的,HTTP/2 的多路复用缓解了大部分。
超文本传输协议,HTTP 是一个在计算机世界里专门在两点之间传输文字、图片、音频、视频等超文本数据的约定和规范。
- HTTP 特点
- 灵活可扩展。一个是语法上只规定了基本格式,空格分隔单词,换行分隔字段等。另外一个就是传输形式上不仅可以传输文本,还可以传输图片,视频等任意数据。
- 请求-应答模式,通常而言,就是一方发送消息,另外一方要接受消息,或者是做出相应等。
- 可靠传输,HTTP是基于TCP/IP,因此把这一特性继承了下来。
- 无状态,这个分场景回答即可。
- HTTP 缺点
- 无状态,有时候,需要保存信息,比如像购物系统,需要保留下顾客信息等等,另外一方面,有时候,无状态也会减少网络开销,比如类似直播行业这样子等,这个还是分场景来说。
- 明文传输,即协议里的报文(主要指的是头部)不使用二进制数据,而是文本形式。这让HTTP的报文信息暴露给了外界,给攻击者带来了便利。
- 队头阻塞,当http开启长连接时,共用一个
TCP连接,当某个请求时间过长时,其他的请求只能处于阻塞状态,这就是队头阻塞问题。
http 无状态无连接
http协议对于事务处理没有记忆能力- 对同一个
url请求没有上下文关系 - 每次的请求都是独立的,它的执行情况和结果与前面的请求和之后的请求是无直接关系的,它不会受前面的请求应答情况直接影响,也不会直接影响后面的请求应答情况
- 服务器中没有保存客户端的状态,客户端必须每次带上自己的状态去请求服务器
- 人生若只如初见,请求过的资源下一次会继续进行请求
http协议无状态中的 状态 到底指的是什么?!
- 【状态】的含义就是:客户端和服务器在某次会话中产生的数据
- 那么对应的【无状态】就意味着:这些数据不会被保留
- 通过增加
cookie和session机制,现在的网络请求其实是有状态的 - 在没有状态的
http协议下,服务器也一定会保留你每次网络请求对数据的修改,但这跟保留每次访问的数据是不一样的,保留的只是会话产生的结果,而没有保留会话
💬 面试官追问
购物车接口第二次请求不知道第一次选了啥,产品说
HTTP不可靠,怎么解释?这是无状态,不是不可靠。数据都送到了,只是服务器默认不记得上一次。状态要么客户端每次带上(
Cookie里的sessionId、Authorization头),要么存在服务端用标识去查。无状态有什么好处?为什么不设计成有状态?
好扩容。请求不依赖某台机器上的上下文,负载均衡可以随便分发,挂一台换一台也不影响。真要状态的场景就单独补,比直接设计成有状态协议灵活得多。
单机改成多台后,用户偶尔被踢下线,怎么回事?
session存在单机内存里,请求被分到另一台就找不到了。把session放Redis集中存,或者网关按Cookie做会话保持;更彻底的是改用JWT这类自包含的Token。内网管理后台用
HTTP明文,负责人说内网没风险,你怎么看?不同意,内网也有被渗透、被同网段抓包的风险,管理后台的
Cookie一旦泄露就是全站权限。现在证书基本零成本,内网用自建CA也能上HTTPS。
# 8 说一说HTTP 的请求方法
⚡ 30 秒速记
- 先背两个词:安全 = 不改服务端状态;幂等 = 调
1次和调N次,服务端最终状态一样 GET取资源,安全、幂等、可缓存;HEAD是只要响应头的GET,探文件在不在、多大POST新建或提交,不幂等,连点两下可能两笔订单;PUT整体替换,幂等;DELETE幂等PATCH局部改,规范不保证幂等;OPTIONS查支持哪些方法,也是CORS预检用的方法TRACE回显请求做诊断,线上一般禁掉;CONNECT让代理建隧道,HTTPS走代理时用- 工程价值:只有幂等方法,网关和客户端才敢自动重试
请求方法表达的是「你想对资源干什么」,面试里关键是讲清楚安全和幂等这两个属性。 GET 只读,安全也幂等,所以能缓存、能随便重试;POST 会产生新数据,重试一次可能多一笔订单,所以浏览器刷新 POST 结果页会弹窗确认。PUT 是整体覆盖,同样的内容发十次结果也一样,所以幂等;DELETE 删一次和删十次最终都是没了。OPTIONS 平时最常见的身份是 CORS 预检。这些语义不只是规范,网关决定能不能自动重试、CDN 决定能不能缓存,都看它。
- HTTP1.0定义了三种请求方法: GET, POST 和 HEAD方法
- HTTP1.1新增了五种请求方法:OPTIONS, PUT, DELETE, TRACE 和 CONNECT
http/1.1规定了以下请求方法(注意,都是大写):
- GET: 请求获取Request-URI所标识的资源
- POST: 在Request-URI所标识的资源后附加新的数据
- HEAD: 请求获取由Request-URI所标识的资源的响应消息报头
- PUT: 请求服务器存储一个资源,并用Request-URI作为其标识(修改数据)
- DELETE: 请求服务器删除对应所标识的资源
- TRACE: 请求服务器回送收到的请求信息,主要用于测试或诊断
- CONNECT: 建立连接隧道,用于代理服务器
- OPTIONS: 列出可对资源实行的请求方法,用来跨域请求
从应用场景角度来看,Get 多用于无副作用,幂等的场景,例如搜索关键字。Post 多用于副作用,不幂等的场景,例如注册。
options 方法有什么用
- OPTIONS 请求与 HEAD 类似,一般也是用于客户端查看服务器的性能。
- 这个方法会请求服务器返回该资源所支持的所有 HTTP 请求方法,该方法会用'*'来代替资源名称,向服务器发送 OPTIONS 请求,可以测试服务器功能是否正常。
- JS 的 XMLHttpRequest对象进行 CORS 跨域资源共享时,对于复杂请求,就是使用 OPTIONS 方法发送嗅探请求,以判断是否有对指定资源的访问权限。
💬 面试官追问
搜索接口用
POST /search,后端说能返回数据就行,你怎么看?能用,但丢了
GET的好处:不能缓存、链接不能分享、刷新会弹重复提交确认。查询条件简单就用GET;条件是复杂嵌套对象、放URL太长时,用POST查询是可以接受的折中。PUT超时了,客户端能直接重试吗?方法语义上可以,
PUT是幂等的,同样内容再发一次结果不变。前提是后端实现也真的幂等,如果更新时顺带发了一条通知,重试就会发两条,这种副作用要后端自己去重。跨域上传在浏览器里失败,
OPTIONS返回405,用curl调POST却正常,怎么回事?浏览器发了预检,服务端或网关没放行
OPTIONS。curl不走CORS,所以正常。让服务端对OPTIONS返回204,并带上Access-Control-Allow-Methods、Access-Control-Allow-Headers。怎么判断一个大文件存不存在、有多大,又不想下载它?
发
HEAD,只回响应头,看状态码和Content-Length。前提是服务端正确实现了HEAD,有些框架默认不支持,会回405。PATCH为什么不保证幂等?看你怎么写请求体。
{ "name": "a" }这种设成某个值是幂等的;{ "op": "increment", "path": "/count" }这种每次加一,调几次结果就不一样。规范不能替你保证,所以网关一般不自动重试PATCH。
# 9 谈一谈GET 和 POST 的区别
⚡ 30 秒速记
- 本质是语义:
GET取数据,安全、幂等;POST提交数据,有副作用、不幂等 - 参数:
GET在URL里,会进浏览器历史、服务器日志、Referer;POST在请求体 - 缓存:
GET能被浏览器和CDN缓存、能收藏;POST默认不缓存 - 两个流传很广的误区:
GET长度限制是浏览器和服务器的实现限制,不是协议规定;POST也不比GET安全,不上HTTPS都是明文 - 「
POST发两个TCP包」也不对:只有客户端带了Expect: 100-continue才会先发头再等100,浏览器基本不这么干,curl传大于1MB的数据时会
GET 和 POST 最根本的区别是语义:GET 用来取,POST 用来交。 其他区别都是从语义派生出来的:GET 不改数据,所以能缓存、能重试、能收藏;POST 会改数据,所以浏览器不缓存,刷新时还会提示你是否重复提交。参数位置也是习惯,GET 放 URL 方便分享,但会被历史记录和日志记下来,敏感信息不要放。网上常说的「POST 更安全」「GET 只能 2KB」「POST 分两个包发」都不准确,面试时能指出来是加分的。
本质上,只是语义上的区别,GET 用于获取资源,POST 用于提交资源。
具体差别👇
- 从缓存角度看,GET 请求后浏览器会主动缓存,POST 默认情况下不能。
- 从参数角度来看,GET请求一般放在URL中,因此不安全,POST请求放在请求体中,相对而言较为安全,但是在抓包的情况下都是一样的。
- 从编码角度看,GET请求只能经行URL编码,只能接受ASCII码,而POST支持更多的编码类型且不对数据类型限值。
- GET请求幂等,POST请求不幂等,幂等指发送 M 和 N 次请求(两者不相同且都大于1),服务器上资源的状态一致。
- GET请求会一次性发送请求报文,POST请求通常分为两个TCP数据包,首先发 header 部分,如果服务器响应 100(continue), 然后发 body 部分。
💬 面试官追问
登录接口把密码从
GET改成POST就安全了吗?只是不出现在地址栏和访问日志里了,抓包照样能看到明文。真正保证传输安全的是
HTTPS。另外服务端别在日志里打印请求体,不然POST也一样泄露。GET请求能带请求体吗?协议没禁止,但语义未定义,很多服务器、代理和缓存会直接丢掉它,浏览器的
fetch更是直接报错。所以别这么用,复杂查询条件要么编码进query,要么改用POST。支付接口超时后客户端自动重试,结果扣了两次款,怎么防?
POST不幂等,超时只说明客户端没收到响应,服务端可能已经扣过了。客户端生成一个幂等键(比如订单号)随请求带上,服务端先查这个键处理过没有,处理过就直接返回上次的结果。抓包发现小
POST请求头和请求体一起发出去了,是不是不符合规范?符合。
POST并不规定分两次发,只有请求头里带Expect: 100-continue时,客户端才会先发头、等服务器回100 Continue再发体。浏览器的fetch基本不会带这个头。URL长度到底限制多少?协议没有规定,看实现。老
IE是2083个字符,现代浏览器能到几十KB以上,真正先卡住的往往是服务器,比如Nginx默认请求行超过8KB返回414。
# 10 谈一谈队头阻塞问题
⚡ 30 秒速记
- 队头阻塞:队列最前面那个慢了,后面全部干等
HTTP/1.1一条连接上请求要按顺序响应,管线化也救不了,所以浏览器基本没开管线化- 当年的绕法:同域名开多条连接(
Chrome是6条)、域名分片、雪碧图、合并文件,本质都是多开队列 HTTP/2多路复用:一条连接上多个流交错传输,解决了HTTP层的阻塞,但TCP丢一个包,所有流一起等重传HTTP/3用QUIC,每个流独立重传,TCP层的阻塞也没了;升级HTTP/2后域名分片反而是负优化
队头阻塞就是排队时队首卡住了,后面的全被拖住。 在 HTTP/1.1 里,一条连接同一时间只能处理一个请求,响应必须按顺序回来,所以浏览器给每个域名开 6 条连接,大家还搞域名分片,本质都是多开几条队伍。HTTP/2 把请求拆成帧在一条连接上交错发,HTTP 层不排队了,但底下还是一条 TCP,丢一个包整条连接都要等重传,弱网下反而可能比 1.1 的多连接更慢。HTTP/3 换成 QUIC,每个流单独重传,才算把这个问题彻底解决。
什么是队头阻塞?
对于每一个HTTP请求而言,这些任务是会被放入一个任务队列中串行执行的,一旦队首任务请求太慢时,就会阻塞后面的请求处理,这就是HTTP队头阻塞问题。
有什么解决办法吗👇
并发连接
我们知道对于一个域名而言,是允许分配多个长连接的,那么可以理解成增加了任务队列,也就是说不会导致一个任务阻塞了该任务队列的其他任务,在
RFC规范中规定客户端最多并发2个连接,不过实际情况就是要比这个还要多,举个例子,Chrome中是6个。
域名分片
- 顾名思义,我们可以在一个域名下分出多个二级域名出来,而它们最终指向的还是同一个服务器,这样子的话就可以并发处理的任务队列更多,也更好的解决了队头阻塞的问题。
- 举个例子,比如
TianTian.com,可以分出很多二级域名,比如Day1.TianTian.com,Day2.TianTian.com,Day3.TianTian.com,这样子就可以有效解决队头阻塞问题。
从 HTTP/1.1 到 HTTP/3:队头阻塞是怎么一层层被解决的
上面讲的「并发连接」和「域名分片」,是 HTTP/1.1 时代的绕行办法,它们并没有让单条连接不排队,只是多开了几条队伍。补充两点:
上面提到「
RFC规范规定客户端最多并发2个连接」,那是1999年RFC 2616的建议,2014年的RFC 7230已经删掉了这个数字。现在主流浏览器对同一个域名一般是6条。真正改变局面的是协议升级:
| 协议 | 一条连接能否并发 | 丢包影响 |
|---|---|---|
HTTP/1.1 | 不能,响应按顺序回 | 只影响这一条连接 |
HTTP/2 | 能,多个流交错传输 | 整条 TCP 上所有流一起等重传 |
HTTP/3 | 能,基于 QUIC | 只影响丢包的那个流 |
可以在控制台快速确认当前页面资源用的协议:
performance.getEntriesByType('resource')
.map(e => [e.name.split('/').pop(), e.nextHopProtocol])
// 例如:[['app.js', 'h2'], ['logo.png', 'h3'], ...]
所以今天的优化顺序是:先确认站点开了 HTTP/2(最好再开 HTTP/3),然后撤掉域名分片,把静态资源收敛到同一个域名,让一条连接复用起来。雪碧图、合并文件这些手段在 HTTP/2 下收益也小了很多,反而会让缓存粒度变粗。
💬 面试官追问
都
HTTP/2了,还要做域名分片吗?不要,反而有害。
HTTP/2想要的是一个域名一条连接把所有请求复用起来,分片会多开连接、多做DNS和TLS握手,还让HPACK的头部压缩字典没法共享。HTTP/2号称解决了队头阻塞,为什么弱网下还会卡?它解决的是
HTTP层的。所有流都在同一条TCP上,TCP要求字节按序交付,丢一个包,后面已经到了的数据也得等它重传。丢包率高的时候,这个问题比HTTP/1.1开6条连接还明显。瀑布图里一堆请求长时间处于
Queueing/Stalled,是什么原因?先看
Protocol列。如果是http/1.1,大概率是同域名6条连接用满了在排队,开HTTP/2最直接。如果已经是h2还在排,再看是不是浏览器的优先级调度,或者某个巨大的资源在占带宽。HTTP/1.1的管线化为什么没能解决这个问题?管线化只是允许连发多个请求不等响应,但响应还是得按请求顺序回来,第一个慢后面照样等。再加上很多代理实现有问题,主流浏览器默认都没开。
HTTP/3要求服务端做什么?服务端或
CDN要支持QUIC,开放UDP 443,再在响应头里加Alt-Svc: h3=":443"告诉浏览器。浏览器之后的请求才会尝试h3,UDP被封了就自动回落h2。
# 11 谈一谈HTTP数据传输
⚡ 30 秒速记
- 定长:
Content-Length写字节数,接收方读够就算结束;写小了截断,写大了客户端一直等到超时 - 不定长:
Transfer-Encoding: chunked,每块前面写十六进制长度,最后一个0长度的块表示结束 - 两个同时出现时以
chunked为准,Content-Length被忽略;规范上服务端不该两个都发 - 开了
gzip,Content-Length是压缩后的长度 - 范围请求:
Range: bytes=0-1023→206 Partial Content,断点续传、视频拖进度条靠它;chunked是HTTP/1.1专属,HTTP/2有自己的帧,不用它
HTTP/1.1 传正文要让对方知道「到哪结束」,长度确定就用 Content-Length,不确定就用 chunked 分块。 以前短连接可以靠服务器关连接表示结束,长连接要复用就不行了。Content-Length 必须和实际字节数一致,否则要么截断要么卡住。动态生成的内容,比如流式返回的 AI 回答、边查边导的报表,事先不知道多长,就用 Transfer-Encoding: chunked,每块带长度,最后发一个空块收尾。两种头同时出现时以 chunked 为准,不过这种响应本身就有风险,可能被利用做请求走私。
大概遇到的情况就分为定长数据 与 不定长数据的处理吧。
定长数据
对于定长的数据包而言,发送端在发送数据的过程中,需要设置Content-Length,来指明发送数据的长度。
当然了如果采用了Gzip压缩的话,Content-Length设置的就是压缩后的传输长度。
我们还需要知道的是👇
Content-Length如果存在并且有效的话,则必须和消息内容的传输长度完全一致,也就是说,如果过短就会截断,过长的话,就会导致超时。- 如果采用短链接的话,直接可以通过服务器关闭连接来确定消息的传输长度。
- 那么在HTTP/1.0之前的版本中,Content-Length字段可有可无,因为一旦服务器关闭连接,我们就可以获取到传输数据的长度了。
- 在HTTP/1.1版本中,如果是Keep-alive的话,chunked优先级高于
Content-Length,若是非Keep-alive,跟前面情况一样,Content-Length可有可无。
那怎么来设置Content-Length
举个例子来看看👇
const server = require('http').createServer();
server.on('request', (req, res) => {
if(req.url === '/index') {
// 设置数据类型
res.setHeader('Content-Type', 'text/plain');
res.setHeader('Content-Length', 10);
res.write("你好,使用的是Content-Length设置传输数据形式");
}
})
server.listen(3000, () => {
console.log("成功启动--TinaTian");
})
不定长数据
现在采用最多的就是HTTP/1.1版本,来完成传输数据,在保存Keep-alive状态下,当数据是不定长的时候,我们需要设置新的头部字段👇
Transfer-Encoding: chunked
通过chunked机制,可以完成对不定长数据的处理,当然了,你需要知道的是
- 如果头部信息中有
Transfer-Encoding,优先采用Transfer-Encoding里面的方法来找到对应的长度。 - 如果设置了Transfer-Encoding,那么Content-Length将被忽视。
- 使用长连接的话,会持续的推送动态内容。
那我们来模拟一下吧👇
const server = require('http').createServer();
server.on('request', (req, res) => {
if(req.url === '/index') {
// 设置数据类型
res.setHeader('Content-Type', 'text/html; charset=utf8');
res.setHeader('Content-Length', 10);
res.setHeader('Transfer-Encoding', 'chunked');
res.write("你好,使用的是Transfer-Encoding设置传输数据形式");
setTimeout(() => {
res.write("第一次传输数据给您<br/>");
}, 1000);
res.write("骚等一下");
setTimeout(() => {
res.write("第一次传输数据给您");
res.end()
}, 3000);
}
})
server.listen(3000, () => {
console.log("成功启动--TinaTian");
})
上面使用的是nodejs中
http模块,有兴趣的小伙伴可以去试一试,以上就是HTTP对定长数据和不定长数据传输过程中的处理手段。
💬 面试官追问
响应头写了
Content-Length: 10,实际写了更多内容,会怎样?客户端读满
10个字节就认为这个响应结束了,后面多出来的会被当成下一个响应的开头,长连接上的解析就乱了。Node里遇到这种情况会直接抛错拒绝写入。文件开了
gzip,进度条按Content-Length算还准吗?按传输进度算是准的,因为
Content-Length是压缩后的大小。但如果你拿解压后的字节数去除它,进度会超过100%。要显示原始文件大小,得让服务端另外给个头。流式返回
AI回答,后端怎么让浏览器边收边显示?不设
Content-Length,Node里直接多次res.write(),HTTP/1.1下会自动走chunked。前端用fetch拿response.body.getReader()一块块读。注意中间的Nginx要关proxy_buffering,不然它会攒齐了再发。同时返回
Content-Length和chunked有什么风险?前后两个服务对哪个头优先理解不一致时,就会把一个请求拆成两个,这就是请求走私攻击的原理。规范要求两个都有时按
chunked处理,但更稳的是从源头上只发一个。视频拖进度条为什么能直接从中间播?
播放器发
Range: bytes=5000000-,服务端支持的话回206和对应那段数据,响应头带Content-Range。服务端不支持就只能回200整个文件,拖动会很慢。
# 12 cookie 和 session
⚡ 30 秒速记
cookie存在浏览器,是HTTP头里的一个机制;session存在服务端,是会话状态;两者靠sessionId关联- 流程:登录 → 服务端建
session→Set-Cookie: sid=xxx→ 浏览器之后每次自动带上 → 服务端用sid查数据 cookie关键属性:HttpOnly(JS读不到,防XSS偷)、Secure(只走HTTPS)、SameSite(防CSRF,Chrome默认Lax)cookie单个约4KB,每个请求都带,别往里塞大数据- 多机部署
session要集中存(Redis);替代方案JWT服务端不存状态,但签发后没法主动作废,要配短过期加refresh token
cookie 是浏览器帮你存、每次请求自动带上的一小段数据;session 是服务端为每个用户存的会话状态,两者通过 cookie 里的 sessionId 对上号。 可以理解成去健身房办卡:会员信息存在前台电脑里,这是 session;你手里只拿一张卡号,这是 cookie。登录成功后服务端建一条会话记录,用 Set-Cookie 把 sid 发给浏览器,之后浏览器每次请求都自动带上,服务端拿 sid 去查。工程上要注意两点:sid 这种 cookie 一定要 HttpOnly,别让 JS 读到;多台服务器时 session 要放 Redis 这类共享存储,不然请求落到另一台就掉登录。
session: 是一个抽象概念,开发者为了实现中断和继续等操作,将user agent和server之间一对一的交互,抽象为“会话”,进而衍生出“会话状态”,也就是session的概念cookie:它是一个世纪存在的东西,http协议中定义在header中的字段,可以认为是session的一种后端无状态实现
现在我们常说的
session,是为了绕开cookie的各种限制,通常借助cookie本身和后端存储实现的,一种更高级的会话状态实现
session 的常见实现要借助cookie来发送 sessionID
💬 面试官追问
登录接口返回了
Set-Cookie,下一个请求却还是未登录,怎么查?三段一段段看:
Application面板里cookie有没有真的存下来;下一个请求的Cookie头里有没有带上;服务端拿这个sid能不能查到记录。前两段常见原因是Secure但页面是http、Domain或Path不匹配、跨站请求SameSite不对。前后端不同域名,
fetch请求怎么带上cookie?前端要写
credentials: 'include'(axios是withCredentials: true),后端要回Access-Control-Allow-Credentials: true,而且Access-Control-Allow-Origin不能是*,必须写具体域名。跨站的话cookie还得是SameSite=None; Secure。session和JWT怎么选?要能随时踢人下线、改权限立即生效,用
session,删掉服务端记录就完事。服务多、想省掉集中存储,用JWT,但它签发后在过期前一直有效,所以access token设短一点,配refresh token续期。用户能不能自己改
cookie里的值冒充别人?能改,所以
cookie里只放随机的sessionId,不放userId=123这种明文身份。sid要足够长且随机,猜不出来;真要在cookie里放数据,就得签名防篡改。App内嵌的WebView不保存cookie,现有session方案怎么办?sid带不上,会话就断了。可以让原生层把token注入WebView,前端改成放在Authorization头里发;或者让原生在WebView里同步写入cookie。本质都是换一种方式把标识带回服务端。
# 13 介绍一下HTTPS和HTTP区别
⚡ 30 秒速记
HTTPS=HTTP+TLS,协议本身没变,只是在HTTP和TCP之间垫了一层加密TLS管三件事:加密(防偷看)、完整性(防篡改)、身份认证(证书防冒充)- 默认端口
80和443;但端口只是约定,监听443不等于有HTTPS - 代价:证书(
Let's Encrypt免费,注意自动续期)、多一轮握手、一点CPU,现在基本可以忽略 - 不上
HTTPS的代价更大:浏览器标「不安全」,HTTP/2、Service Worker、摄像头定位这些能力都要求安全上下文
HTTPS 不是新协议,就是 HTTP 外面套了一层 TLS,报文内容还是那套 HTTP。 打个比方,HTTP 是寄明信片,路上谁都能看、还能改;HTTPS 是装进带锁的信封,而且信封上有官方盖章证明寄件人是真的。所以它解决三件事:加密、防篡改、证明服务器身份。成本方面现在已经很低了,证书免费,TLS 1.3 握手只要一个往返,反倒是不上 HTTPS 会被浏览器标成不安全,很多新 API 也直接用不了。
HTTPS 要比 HTTPS 多了 secure 安全性这个概念,实际上, HTTPS 并不是一个新的应用层协议,它其实就是 HTTP + TLS/SSL 协议组合而成,而安全性的保证正是 SSL/TLS 所做的工作。
SSL
安全套接层(Secure Sockets Layer)
TLS
(传输层安全,Transport Layer Security)
现在主流的版本是 TLS/1.2, 之前的 TLS1.0、TLS1.1 都被认为是不安全的,在不久的将来会被完全淘汰。
HTTPS 就是身披了一层 SSL 的 HTTP。
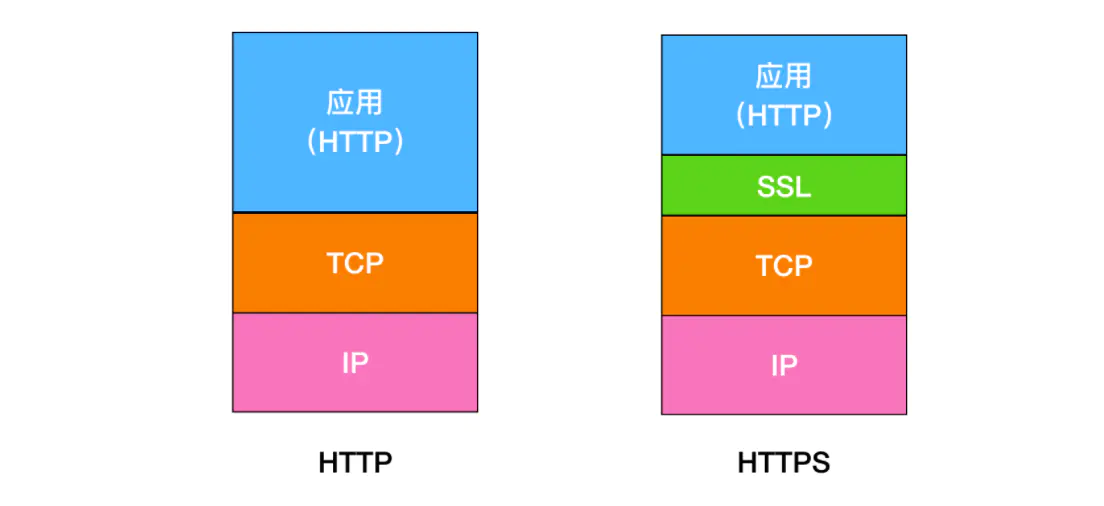
那么区别有哪些呢👇
- HTTP 是明文传输协议,HTTPS 协议是由 SSL+HTTP 协议构建的可进行加密传输、身份认证的网络协议,比 HTTP 协议安全。
- HTTPS比HTTP更加安全,对搜索引擎更友好,利于SEO,谷歌、百度优先索引HTTPS网页。
- HTTPS标准端口443,HTTP标准端口80。
- HTTPS需要用到SSL证书,而HTTP不用。
我觉得记住以下两点HTTPS主要作用就行👇
- 对数据进行加密,并建立一个信息安全通道,来保证传输过程中的数据安全;
- 对网站服务器进行真实身份认证。
HTTPS的缺点
- 证书费用以及更新维护。
- HTTPS 降低一定用户访问速度(实际上优化好就不是缺点了)。
- HTTPS 消耗 CPU 资源,需要增加大量机器。
💬 面试官追问
运维把端口从
80改成443就说上了HTTPS,对吗?不对。
443只是个默认端口号,真正干活的是TLS:要有证书、私钥,服务端开启TLS监听。浏览器地址栏有锁、证书能点开看,才算数。内网后台不传密码,用
HTTP有什么问题?业务数据照样明文跑,同网段的人抓包就能看到,还能被插广告、改返回值。而且
HTTP页面里用不了Service Worker、剪贴板这些要求安全上下文的API,内网也建议用内部CA签证书。全站切
HTTPS后,页面锁变成了感叹号,什么原因?多半是混合内容:页面里还有
http://的图片、脚本。脚本、iframe这类主动内容会被直接拦掉,图片会被自动升级或者告警。全局搜一下http://,或者加个Content-Security-Policy: upgrade-insecure-requests兜底。用户第一次输入
example.com还是走了HTTP,怎么避免?服务端先
301跳到https://,再加Strict-Transport-Security: max-age=31536000响应头,浏览器之后就直接走HTTPS。第一次访问那一下要彻底堵上,得把域名提交到HSTS preload列表。HTTPS了是不是就不怕XSS、不怕接口被刷了?不是。
HTTPS只保护传输这一段,数据到了浏览器或服务端就跟它没关系了。XSS靠转义和CSP,接口防刷靠鉴权和限流。
# 14 HTTPS握手过程
⚡ 30 秒速记
- 一句话:先用非对称加密 + 证书把「对称密钥」安全地商量出来,之后全用对称加密传数据
TLS 1.2(RSA密钥交换):ClientHello带客户端随机数 →ServerHello+ 证书 + 服务端随机数 → 客户端验证书,生成预主密钥用公钥加密发过去 → 三个随机数算出会话密钥- 证书校验看四样:签发链能追到受信任根、域名匹配、没过期、没吊销
- 现在主流是
ECDHE:预主密钥靠双方交换DH参数算出来,不再用公钥加密传输,私钥泄露也解不开历史流量(前向安全) TLS 1.3删掉了RSA密钥交换,握手1-RTT,恢复会话可0-RTT
握手说白了就两件事:确认对面真是这个网站,然后两边商量出一把只有彼此知道的对称密钥。 教科书版是 TLS 1.2 的 RSA 流程:两边各出一个随机数,客户端验完证书再生成一个预主密钥,用证书里的公钥加密发给服务端,服务端用私钥解开,三个数一起算出会话密钥。不过面试我会补一句,现在线上基本都是 ECDHE,预主密钥是双方用 DH 算法各自算出来的,从没在网上传过,所以有前向安全;TLS 1.3 干脆把 RSA 交换删了,一个往返就完事。
- 第一步,客户端给出协议版本号、一个客户端生成的随机数(Client random),以及客户端支持的加密方法
- 第二步,服务端确认双方使用的加密方法,并给出数字证书、以及一个服务器生成的随机数
- 第三步,客户端确认数字证书有效,然后生成一个新的随机数(Premaster secret),并使用数字证书中的公钥,加密这个随机数,发给服务端
- 第四步,服务端使用自己的私钥,获取客户端发来的随机数(即Premaster secret)。
- 第五步,客户端和服务端根据约定的加密方法,使用前面的三个随机数,生成"对话密钥"(session key),用来加密接下来的整个对话过程
总结
- 客户端发起 HTTPS 请求,服务端返回证书,客户端对证书进行验证,验证通过后本地生成用于构造对称加密算法的随机数
- 通过证书中的公钥对随机数进行加密传输到服务端(随机对称密钥),服务端接收后通过私钥解密得到随机对称密钥,之后的数据交互通过对称加密算法进行加解密。(既有对称加密,也有非对称加密)
💬 面试官追问
为什么不让客户端直接生成对称密钥明文发过去?
明文发等于把钥匙挂在门口,中间人抓到它后面全能解。所以要么用服务器公钥加密后传(
RSA交换),要么干脆不传、两边用DH各自算(ECDHE)。既然有了公钥,为什么不全程用公钥加密数据?
非对称加密比对称加密慢好几个数量级,一个页面几十个资源全用它,
CPU扛不住。所以只在握手时用它交换密钥,数据阶段换AES-GCM这类对称算法。服务器私钥哪天泄露了,之前抓的包能解开吗?
看密钥交换方式。
RSA交换能解,因为预主密钥就是用公钥加密传的;ECDHE解不开,每次会话的临时密钥用完就扔,这就是前向安全,也是TLS 1.3只留(EC)DHE的原因。为什么非要三个随机数,只用预主密钥不行吗?
客户端和服务端随机数是明文的,作用是让每次会话的密钥都不一样,防止重放。真正保密的是预主密钥,三个混在一起算,哪一方的随机数质量差,另一方也能兜住。
集群里只有一台机器握手失败,其他都正常,先查什么?
先比对这台机器的证书和私钥是否配对,
openssl x509 -noout -modulus和openssl rsa -noout -modulus的结果对一下。再看证书链有没有配全、支持的TLS版本和加密套件是不是和别的节点一致。
# 15 介绍一个HTTPS工作原理
⚡ 30 秒速记
- 三板斧:非对称加密做密钥交换、对称加密传数据、散列(
MAC/AEAD)保完整性 - 为什么混用:对称快但钥匙送不过去,非对称能送钥匙但太慢
- 证书解决的是「这把公钥真是这个网站的吗」,靠
CA用私钥签名,浏览器用内置根证书的公钥验签 - 中间人想换公钥就得伪造签名,伪造不了 → 证书报错,所以代码里千万别关证书校验
- 公司代理能「合法」解密
HTTPS,前提是员工电脑装了代理的根证书
HTTPS 的原理可以拆成三层:非对称加密送钥匙,对称加密传数据,证书证明钥匙是网站本人的。 只用对称加密,密钥怎么安全交给对方是个死结;只用非对称又太慢。所以握手阶段用非对称把对称密钥送过去,之后全走对称加密。剩下一个坑是中间人把服务器公钥换成自己的,这就靠证书:CA 用自己的私钥给「域名 + 公钥」签名,浏览器内置了 CA 的公钥,验签对不上就直接报错。另外每条记录都带完整性校验,被改一个字节也能发现。
我们可以把HTTPS理解成HTTPS = HTTP + SSL/TLS
TLS/SSL 的功能实现主要依赖于三类基本算法:
散列函数、对称加密和非对称加密,其利用非对称加密实现身份认证和密钥协商,对称加密算法采用协商的密钥对数据加密,基于散列函数验证信息的完整性。
1. 对称加密
加密和解密用同一个秘钥的加密方式叫做对称加密。Client客户端和Server端共用一套密钥,这样子的加密过程似乎很让人理解,但是随之会产生一些问题。
问题一: WWW万维网有许许多多的客户端,不可能都用秘钥A进行信息加密,这样子很不合理,所以解决办法就是使用一个客户端使用一个密钥进行加密。
问题二:既然不同的客户端使用不同的密钥,那么对称加密的密钥如何传输? 那么解决的办法只能是一端生成一个秘钥,然后通过HTTP传输给另一端,那么这样子又会产生新的问题。
问题三: 这个传输密钥的过程,又如何保证加密?如果被中间人拦截,密钥也会被获取, 那么你会说对密钥再进行加密,那又怎么保存对密钥加密的过程,是加密的过程?
到这里,我们似乎想明白了,使用对称加密的方式,行不通,所以我们需要采用非对称加密👇
2. 非对称加密
通过上面的分析,对称加密的方式行不通,那么我们来梳理一下非对称加密。采用的算法是RSA,所以在一些文章中也会看见传统RSA握手,基于现在TLS主流版本是1.2,所以接下来梳理的是TLS/1.2握手过程。
非对称加密中,我们需要明确的点是👇
- 有一对秘钥,公钥和私钥。
- 公钥加密的内容,只有私钥可以解开,私钥加密的内容,所有的公钥都可以解开,这里说的公钥都可以解开,指的是一对秘钥。
- 公钥可以发送给所有的客户端,私钥只保存在服务器端。
3. 主要工作流程
梳理起来,可以把TLS 1.2 握手过程分为主要的五步👇
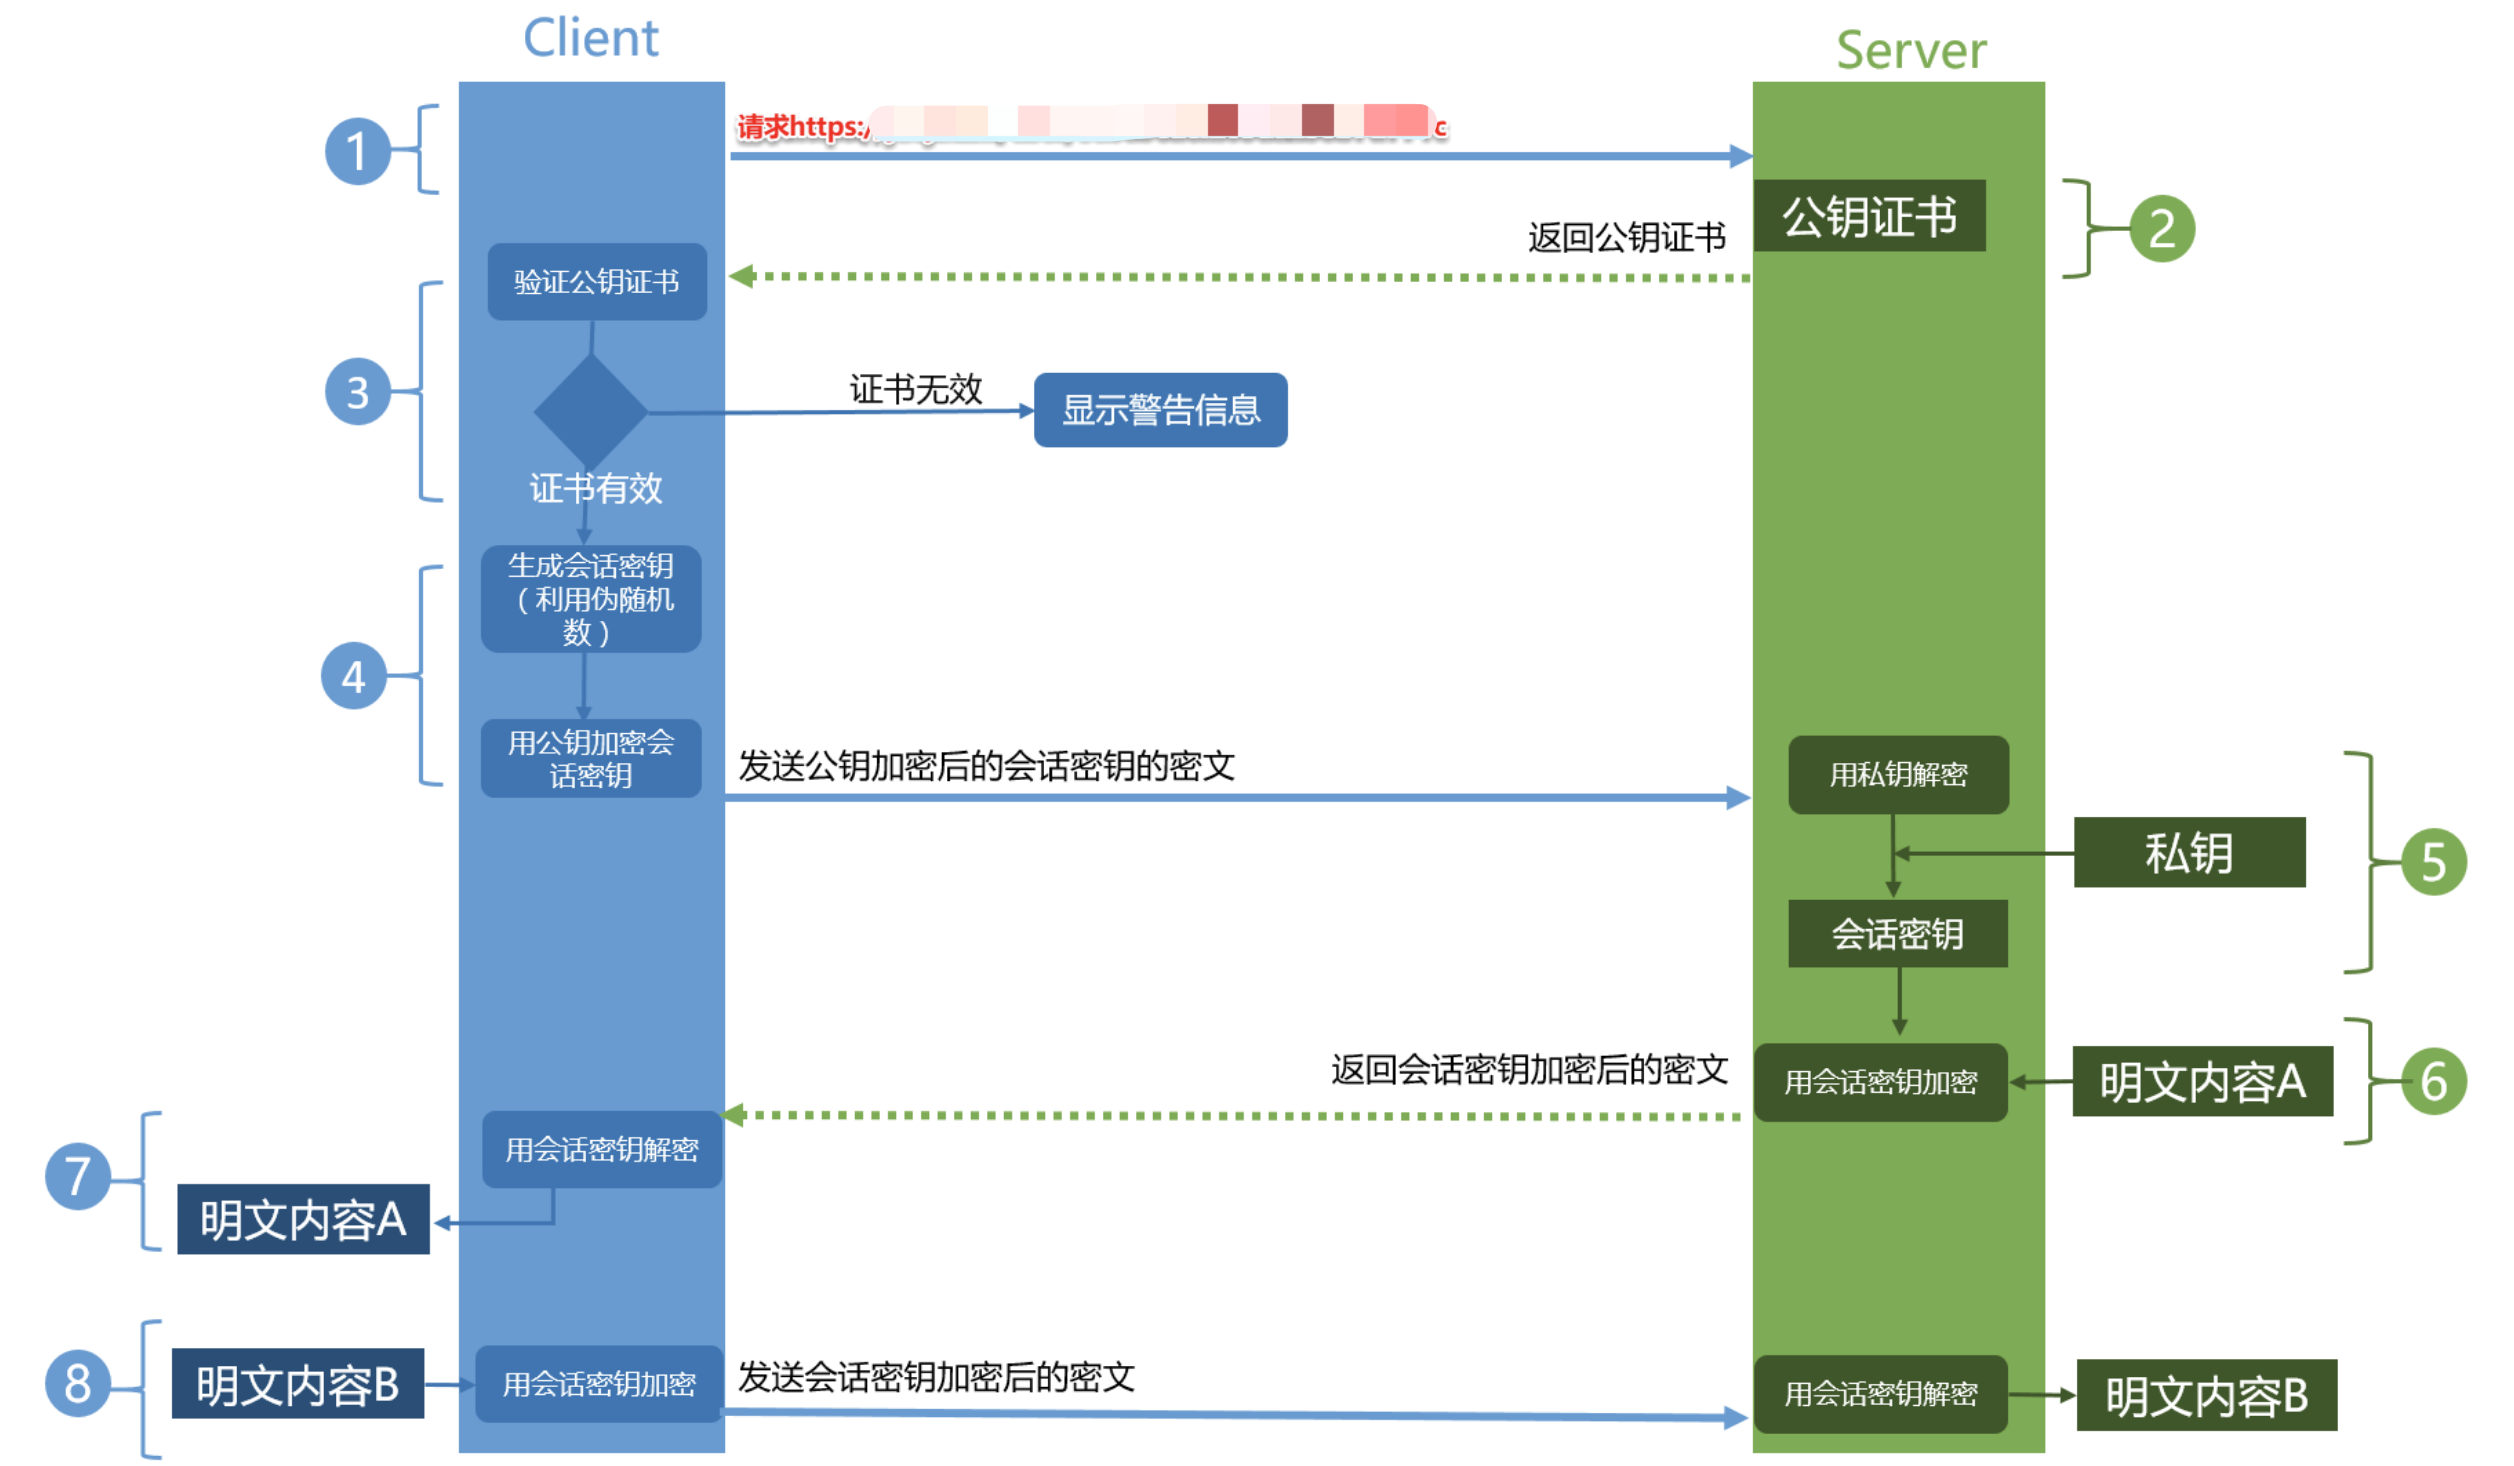
- 步骤一:Client发起一个HTTPS请求,连接443端口。这个过程可以理解成是请求公钥的过程。
- 步骤二:Server端收到请求后,通过第三方机构私钥加密,会把数字证书(也可以认为是公钥证书)发送给Client。
- 步骤三:
- 浏览器安装后会自动带一些权威第三方机构公钥,使用匹配的公钥对数字签名进行解密。
- 根据签名生成的规则对网站信息进行本地签名生成,然后两者比对。
- 通过比对两者签名,匹配则说明认证通过,不匹配则获取证书失败。
- 步骤四:在安全拿到服务器公钥后,客户端Client随机生成一个对称密钥,使用服务器公钥(证书的公钥)加密这个对称密钥,发送给Server(服务器)。
- 步骤五:Server(服务器)通过自己的私钥,对信息解密,至此得到了对称密钥,此时两者都拥有了相同的对称密钥。
接下来,就可以通过该对称密钥对传输的信息加密/解密啦,从上面图举个例子👇
- Client用户使用该对称密钥加密'明文内容B',发送给Server(服务器)
- Server使用该对称密钥进行解密消息,得到明文内容B。
接下来考虑一个问题,如果公钥被中间人拿到纂改怎么办呢?
客户端可能拿到的公钥是假的,解决办法是什么呢?
3. 第三方认证
客户端无法识别传回公钥是中间人的,还是服务器的,这是问题的根本,我们是不是可以通过某种规范可以让客户端和服务器都遵循某种约定呢?那就是通过第三方认证的方式
在HTTPS中,通过 证书 + 数字签名来解决这个问题。
这里唯一不同的是,假设对网站信息加密的算法是MD5,通过MD5加密后,然后通过第三方机构的私钥再次对其加密,生成数字签名。
这样子的话,数字证书包含有两个特别重要的信息👉某网站公钥+数字签名
我们再次假设中间人截取到服务器的公钥后,去替换成自己的公钥,因为有数字签名的存在,这样子客户端验证发现数字签名不匹配,这样子就防止中间人替换公钥的问题。
那么客户端是如何去对比两者数字签名的呢?
- 浏览器会去安装一些比较权威的第三方认证机构的公钥,比如VeriSign、Symantec以及GlobalSign等等。
- 验证数字签名的时候,会直接从本地拿到相应的第三方的公钥,对私钥加密后的数字签名进行解密得到真正的签名。
- 然后客户端利用签名生成规则进行签名生成,看两个签名是否匹配,如果匹配认证通过,不匹配则获取证书失败。
4. 数字签名作用
数字签名:将网站的信息,通过特定的算法加密,比如MD5,加密之后,再通过服务器的私钥进行加密,形成加密后的数字签名。
第三方认证机构是一个公开的平台,中间人可以去获取。
如果没有数字签名的话,这样子可以就会有下面情况👇
从上面我们知道,如果只是对网站信息进行第三方机构私钥加密的话,还是会受到欺骗。
因为没有认证,所以中间人也向第三方认证机构进行申请,然后拦截后把所有的信息都替换成自己的,客户端仍然可以解密,并且无法判断这是服务器的还是中间人的,最后造成数据泄露。
5. 总结
- HTTPS就是使用SSL/TLS协议进行加密传输
- 大致流程:客户端拿到服务器的公钥(是正确的),然后客户端随机生成一个对称加密的秘钥,使用该公钥加密,传输给服务端,服务端再通过解密拿到该对称秘钥,后续的所有信息都通过该对称秘钥进行加密解密,完成整个HTTPS的流程。
- 第三方认证,最重要的是数字签名,避免了获取的公钥是中间人的。
💬 面试官追问
拿到证书里的公钥,能不能解密用户的请求?
不能。公钥本来就是公开的,谁都能拿到。数据是用握手后的对称会话密钥加密的,而且
ECDHE下会话密钥根本不经过公钥,拿到公钥一点用没有。公司代理把网站证书换掉了,浏览器还显示安全锁,校验失效了?
没失效。这是公司在你电脑上装了自己的根证书,代理用它给每个域名现签证书,浏览器顺着链能追到「受信任」的根,所以照样有锁。换台没装根证书的手机连同一个代理,立马报错。
换了新证书,电脑浏览器正常,部分安卓老机型报不可信,查什么?
先查服务端有没有把中间证书一起发出来,用
openssl s_client -showcerts看链。桌面Chrome会自己去补中间证书,老安卓不会;另外老机型的根证书库可能太旧,不认新的根。支付页图省事用自签名证书行不行?
不行。自签名证书没有受信任的
CA背书,浏览器一律报警,用户点「继续访问」就等于放弃了防中间人。自签名只适合内网、测试这种能自己分发根证书的场景。加密了不就够了,为什么还要完整性校验?
加密只保证看不懂,不保证没被改。攻击者可以盲改密文里的某些位,没有校验的话接收方解出来的就是被篡改的数据。现在
TLS用AES-GCM这种AEAD算法,加密和校验一步做完。
# 16 SSL 连接断开后如何恢复
⚡ 30 秒速记
- 目的:断线重连时跳过完整握手,少一轮往返、省掉非对称运算
Session ID:服务端存会话,客户端带ID来认领 → 集群里换台机器就找不到,要共享缓存或做会话粘滞Session Ticket:服务端把会话状态加密成票据交给客户端存,自己不存 → 天然适合集群,但所有节点要共用票据密钥TLS 1.3把两者统一成PSK,用NewSessionTicket下发,可做0-RTT0-RTT早期数据能被重放,只能放幂等请求,下单支付别用
会话恢复就是「上次已经商量好密钥了,这次直接接着用」,省掉一整套证书校验和密钥交换。 Session ID 像寄存柜的号码牌,东西存在服务端,你拿号去取,问题是负载均衡把你分到另一台机器,柜子里就没你的东西了。Session Ticket 是把东西加密后直接让你自己揣着,任何一台持有同一把票据密钥的服务器都能解开,所以集群场景基本都用它。TLS 1.3 里这俩合并成了 PSK 模式,还能 0-RTT 直接带数据,但早期数据有重放风险。
一共有两种方法来恢复断开的 SSL 连接,一种是使用 session ID,一种是 session ticket。
通过session ID
使用 session ID 的方式,每一次的会话都有一个编号,当对话中断后,下一次重新连接时,只要客户端给出这个编号,服务器如果有这个编号的记录,那么双方就可以继续使用以前的秘钥,而不用重新生成一把。目前所有的浏览器都支持这一种方法。但是这种方法有一个缺点是,session ID 只能够存在一台服务器上,如果我们的请求通过负载平衡被转移到了其他的服务器上,那么就无法恢复对话。
通过session ticket
另一种方式是 session ticket 的方式,session ticket 是服务器在上一次对话中发送给客户的,这个 ticket 是加密的,只有服务器能够解密,里面包含了本次会话的信息,比如对话秘钥和加密方法等。这样不管我们的请求是否转移到其他的服务器上,当服务器将 ticket 解密以后,就能够获取上次对话的信息,就不用重新生成对话秘钥了。
💬 面试官追问
客户端带着旧
Session ID来了,服务端还是走了完整握手,为什么?Session ID只是个编号,会话内容在服务端缓存里。缓存过期被清了,或者这次请求落到了另一台没这条记录的机器,都只能重新握手,不会报错,只是慢一点。网关从
1台扩到20台,会话复用率暴跌,怎么修?改用
Session Ticket,并且所有节点配同一把票据密钥,比如Nginx的ssl_session_ticket_key从同一个文件读。继续用Session ID的话就得上共享缓存,比Ticket麻烦。安全要求每天轮换票据密钥,复用率会不会掉?
会掉一点,但可以平滑:新密钥用来加密,旧密钥保留一段时间只用来解密。
Nginx支持配多个ssl_session_ticket_key,第一个加密,其余只解密。TLS 1.3的0-RTT能用在提交订单接口上吗?不建议。
0-RTT的数据没有握手保护,攻击者截下来可以原样重发一遍,下单就变成下两单。一般只放GET这类幂等请求,服务端用425 Too Early拒掉不安全的早期数据。前端加了
preconnect,和会话恢复是一回事吗?不是。
preconnect是把DNS、TCP、TLS提前做掉,握手成本没少只是挪前了;会话恢复是让握手本身变短。两个可以叠加用。
# 17 谈一谈你对HTTP/2理解
⚡ 30 秒速记
- 核心是二进制分帧 + 多路复用:一条
TCP连接上跑多个流,帧带Stream ID,可以交错发 - 解决的是
HTTP/1.1应用层的队头阻塞,和每域名6个连接的限制 HPACK头部压缩:静态表 + 动态表 + 哈夫曼编码,重复头只传索引- 服务端推送基本凉了:
Chrome 106起默认关闭,Firefox 132也移除了,改用103 Early Hints+preload - 没解决
TCP层队头阻塞:一个包丢了,整条连接上的流一起等 →HTTP/3换QUIC
HTTP/2 最核心的变化是把报文拆成带编号的二进制帧,让多个请求在一条连接上交错传输。 以前 HTTP/1.1 一条连接同一时间只能等一个响应,浏览器只好对每个域名开 6 条连接硬扛;HTTP/2 一条连接就够了,各个请求的帧穿插着发,接收端按 Stream ID 拼回去。所以域名分片、雪碧图这些老优化反而成了负担。要补两点:服务端推送已经被主流浏览器废掉了;底层还是 TCP,弱网丢包时所有流一起卡,这是 HTTP/3 要解决的。
首先补充一下,http 和 https 的区别,相比于 http,https 是基于 ssl 加密的 http 协议
简要概括:http2.0 是基于 1999 年发布的 http1.0 之后的首次更新
- 提升访问速度(可以对于,请求资源所需时间更少,访问速度更快,相比 http1.0)
- 允许多路复用:多路复用允许同时通过单一的 HTTP/2 连接发送多重请求-响应信息。改 善了:在
http1.1中,浏览器客户端在同一时间,针对同一域名下的请求有一定数量限 制(连接数量),超过限制会被阻塞 - 二进制分帧:HTTP2.0 会将所有的传输信息分割为更小的信息或者帧,并对他们进行二 进制编码
- 首部压缩
- 服务器端推送
头部压缩
HTTP 1.1版本会出现 User-Agent、Cookie、Accept、Server、Range 等字段可能会占用几百甚至几千字节,而 Body 却经常只有几十字节,所以导致头部偏重。
HTTP 2.0 使用 HPACK 算法进行压缩。
多路复用
- HTTP 1.x 中,如果想并发多个请求,必须使用多个 TCP 链接,且浏览器为了控制资源,还会对单个域名有 6-8个的TCP链接请求限制。
HTTP2中:
- 同域名下所有通信都在单个连接上完成。
- 单个连接可以承载任意数量的双向数据流。
- 数据流以消息的形式发送,而消息又由一个或多个帧组成,多个帧之间可以乱序发送,因为根据帧首部的流标识可以重新组装,也就是
Stream ID,流标识符,有了它,接收方就能从乱序的二进制帧中选择ID相同的帧,按照顺序组装成请求/响应报文。
服务器推送
浏览器发送一个请求,服务器主动向浏览器推送与这个请求相关的资源,这样浏览器就不用发起后续请求。
相比较http/1.1的优势👇
- 推送资源可以由不同页面共享
- 服务器可以按照优先级推送资源
- 客户端可以缓存推送的资源
- 客户端可以拒收推送过来的资源
二进制分帧
之前是明文传输,不方便计算机解析,对于回车换行符来说到底是内容还是分隔符,都需要内部状态机去识别,这样子效率低,HTTP/2采用二进制格式,全部传输01串,便于机器解码。
这样子一个报文格式就被拆分为一个个二进制帧,用Headers帧存放头部字段,Data帧存放请求体数据。这样子的话,就是一堆乱序的二进制帧,它们不存在先后关系,因此不需要排队等待,解决了HTTP队头阻塞问题。
在客户端与服务器之间,双方都可以互相发送二进制帧,这样子双向传输的序列,称为流,所以HTTP/2中以流来表示一个TCP连接上进行多个数据帧的通信,这就是多路复用概念。
那乱序的二进制帧,是如何组装成对于的报文呢?
- 所谓的乱序,值的是不同ID的Stream是乱序的,对于同一个Stream ID的帧是按顺序传输的。
- 接收方收到二进制帧后,将相同的Stream ID组装成完整的请求报文和响应报文。
- 二进制帧中有一些字段,控制着
优先级和流量控制等功能,这样子的话,就可以设置数据帧的优先级,让服务器处理重要资源,优化用户体验。
HTTP2的缺点
- TCP 以及 TCP+TLS建立连接的延时,HTTP/2使用TCP协议来传输的,而如果使用HTTPS的话,还需要使用TLS协议进行安全传输,而使用TLS也需要一个握手过程,在传输数据之前,导致我们需要花掉 3~4 个 RTT。
- TCP的队头阻塞并没有彻底解决。在HTTP/2中,多个请求是跑在一个TCP管道中的。但当HTTP/2出现丢包时,整个 TCP 都要开始等待重传,那么就会阻塞该TCP连接中的所有请求。
💬 面试官追问
都上
HTTP/2了,弱网下首页资源还是一起卡住,为什么?因为所有流共用一条
TCP连接,TCP要保证字节有序,丢一个包,后面已经到了的数据也得等重传。HTTP/2只解决了应用层排队,TCP层的队头阻塞还在。上了
HTTP/2,静态资源还要拆到4个域名吗?不要了,反而有害。每多一个域名就多一次
DNS、TCP、TLS,还把多路复用和HPACK的压缩上下文拆散了。同一套证书覆盖的域名浏览器会做连接合并,收益更多来自收敛域名。那打包是不是也可以拆得越碎越好?
别走极端。请求开销确实小了,但几百个小文件压缩率更差,模块间还有加载瀑布。现在一般是按路由和变更频率适度分包,比如
vendor单独一包吃长缓存。团队还想用
HTTP/2 Server Push推首屏脚本,你怎么看?不建议。推送不知道浏览器有没有缓存,经常推了白推,
Chrome 106起已经默认关掉了。想要类似效果用103 Early Hints或者<link rel="preload">,让浏览器自己决定要不要。本地
Network面板里Protocol一列显示h2,后端说服务没配HTTP/2,怎么回事?浏览器和最外层终止
TLS的节点谈的是h2,比如CDN或Nginx,它到后端服务可能还是HTTP/1.1。浏览器的HTTP/2也只走TLS,明文的h2c浏览器不支持。
# 18 HTTP3
⚡ 30 秒速记
HTTP/3=HTTP跑在QUIC上,QUIC基于UDP,自己实现了可靠传输、拥塞控制- 流在传输层就是独立的:一个流丢包只卡自己,彻底解决
TCP层队头阻塞 QUIC内置TLS 1.3:新连接1-RTT,恢复连接可0-RTT(有重放风险)- 连接迁移:靠
Connection ID认连接,不靠IP+ 端口,WiFi切4G不用重连 - 落地坑:首次访问一般先走
h2,看到Alt-Svc才升级;公司防火墙常封UDP 443,会自动回退
HTTP/3 就是把底层从 TCP 换成了基于 UDP 的 QUIC,目的是根治 TCP 的队头阻塞。 很多人听到 UDP 就以为不可靠,其实 QUIC 在用户态把确认、重传、拥塞控制全做了一遍,只是每个流各管各的,一个流丢包不会拖累别的流。它还把 TLS 1.3 揉进了握手,建连更快;连接用 Connection ID 标识,手机切网络连接不断,这对移动端特别有用。部署时要知道浏览器是先走 HTTP/2,看到 Alt-Svc 响应头才切过来的。
Google 在推SPDY的时候就已经意识到了这些问题,于是就另起炉灶搞了一个基于 UDP 协议的“QUIC”协议,让HTTP跑在QUIC上而不是TCP上。主要特性如下:
- 实现了类似TCP的流量控制、传输可靠性的功能。虽然UDP不提供可靠性的传输,但QUIC在UDP的基础之上增加了一层来保证数据可靠性传输。它提供了数据包重传、拥塞控制以及其他一些TCP中存在的特性
- 实现了快速握手功能。由于QUIC是基于UDP的,所以QUIC可以实现使用0-RTT或者1-RTT来建立连接,这意味着QUIC可以用最快的速度来发送和接收数据。
- 集成了TLS加密功能。目前QUIC使用的是TLS1.3,相较于早期版本TLS1.3有更多的优点,其中最重要的一点是减少了握手所花费的RTT个数。
- 多路复用,彻底解决TCP中队头阻塞的问题。
💬 面试官追问
抓包看到
UDP丢包了,测试说视频数据会丢,对吗?不对。
QUIC自己有确认和重传,丢的包会补发,应用层拿到的数据是完整的。丢包影响的是延迟和吞吐,不是数据完整性。灰度
HTTP/3后,公司网络的用户全回退到h2,查哪里?先查出口防火墙是不是封了
UDP 443,很多企业网只放TCP。浏览器发现QUIC连不上就静默回退,业务不会报错,所以要看Protocol列或者服务端h3的占比。为什么第一次打开网站,
Protocol显示的是h2不是h3?浏览器一开始不知道服务端支持
HTTP/3,先走TCP连上,响应头里看到Alt-Svc: h3=":443"才在后续请求切过去。想首访就用h3,可以配DNS的HTTPS记录提前告诉浏览器。用户在地铁里
WiFi切4G,HTTP/2和HTTP/3表现有什么不同?TCP连接靠四元组识别,IP一变连接就废了,要重新握手。QUIC靠Connection ID,IP变了服务端照样认得,传输接着走。上了
HTTP/3,图片和JS体积还需要优化吗?当然要。协议只改善了丢包和建连,字节数一个没少,
1MB的图在弱网下照样慢,JS还得解析执行。压缩、缓存、懒加载一样不能少。
# 19 HTTP/1.0 HTTP1.1 HTTP2.0版本之间的差异
⚡ 30 秒速记
1.0→1.1:默认长连接、Host头(一个IP托管多站点)、Range断点续传、ETag/Cache-Control缓存、新增PUT/DELETE/OPTIONS等方法1.1的管线化浏览器基本没开,一条连接还是一问一答排队1.1→2:二进制分帧、多路复用、HPACK,一条连接并发多个请求2还剩TCP层队头阻塞,3换成QUIC解决- 版本升级不等于加密,
HTTP/2能跑明文;只是浏览器要求h2必须走TLS
这几个版本一路在解决三个问题:每次都重新建连、请求排队、头部冗余。 HTTP/1.0 默认一次请求一条连接,用完就断;1.1 默认长连接,还加了 Host 头让一台机器能放多个站点,加了 Range 支持断点续传,缓存也从 Expires 进化到 Cache-Control 和 ETag。但 1.1 一条连接还是一个请求一个响应地排队,浏览器只能多开连接。HTTP/2 用二进制帧和多路复用解决了这个,再配上 HPACK 压缩头部。底层 TCP 的队头阻塞留给了 HTTP/3。
- HTTP 0.9:1991年,原型版本,功能简陋,只有一个命令GET,只支持纯文本内容,该版本已过时。
- HTTP 1.0
- 任何格式的内容都可以发送,这使得互联网不仅可以传输文字,还能传输图像、视频、二进制等文件。
- 除了GET命令,还引入了POST命令和HEAD命令。
- http请求和回应的格式改变,除了数据部分,每次通信都必须包括头信息(HTTP header),用来描述一些元数据。
- 只使用 header 中的 If-Modified-Since 和 Expires 作为缓存失效的标准。
- 不支持断点续传,也就是说,每次都会传送全部的页面和数据。
- 通常每台计算机只能绑定一个 IP,所以请求消息中的 URL 并没有传递主机名(hostname)
- HTTP 1.1 http1.1是目前最为主流的http协议版本,从1999年发布至今,仍是主流的http协议版本。
- 引入了持久连接( persistent connection),即TCP连接默认不关闭,可以被多个请求复用,不用声明Connection: keep-alive。长连接的连接时长可以通过请求头中的
keep-alive来设置 - 引入了管道机制( pipelining),即在同一个TCP连接里,客户端可以同时发送多个 请求,进一步改进了HTTP协议的效率。
- HTTP 1.1 中新增加了 E-tag,If-Unmodified-Since, If-Match, If-None-Match 等缓存控制标头来控制缓存失效。
- 支持断点续传,通过使用请求头中的
Range来实现。 - 使用了虚拟网络,在一台物理服务器上可以存在多个虚拟主机(Multi-homed Web Servers),并且它们共享一个IP地址。
- 新增方法:PUT、 PATCH、 OPTIONS、 DELETE。
- 引入了持久连接( persistent connection),即TCP连接默认不关闭,可以被多个请求复用,不用声明Connection: keep-alive。长连接的连接时长可以通过请求头中的
- http1.x版本问题
- 在传输数据过程中,所有内容都是明文,客户端和服务器端都无法验证对方的身份,无法保证数据的安全性。
- HTTP/1.1 版本默认允许复用TCP连接,但是在同一个TCP连接里,所有数据通信是按次序进行的,服务器通常在处理完一个回应后,才会继续去处理下一个,这样子就会造成队头阻塞。
- http/1.x 版本支持Keep-alive,用此方案来弥补创建多次连接产生的延迟,但是同样会给服务器带来压力,并且的话,对于单文件被不断请求的服务,Keep-alive会极大影响性能,因为它在文件被请求之后还保持了不必要的连接很长时间。
- HTTP 2.0
二进制分帧这是一次彻底的二进制协议,头信息和数据体都是二进制,并且统称为"帧":头信息帧和数据帧。头部压缩HTTP 1.1版本会出现 User-Agent、Cookie、Accept、Server、Range 等字段可能会占用几百甚至几千字节,而 Body 却经常只有几十字节,所以导致头部偏重。HTTP 2.0 使用HPACK算法进行压缩。多路复用复用TCP连接,在一个连接里,客户端和浏览器都可以同时发送多个请求或回应,且不用按顺序一一对应,这样子解决了队头阻塞的问题。服务器推送允许服务器未经请求,主动向客户端发送资源,即服务器推送。请求优先级可以设置数据帧的优先级,让服务端先处理重要资源,优化用户体验。
💬 面试官追问
下载中断后,
HTTP/1.1为什么能续传?客户端带
Range: bytes=1048576-请求剩下的部分,服务端支持的话返回206 Partial Content。前提是服务端实现了范围请求,并且最好带ETag配合If-Range,防止文件中途被换了。开了
keep-alive是不是就等于有了多路复用?不是。
keep-alive只是连接用完不关,下一个请求接着用,但同一时间一条连接上只有一个请求在跑。多路复用是多个请求的帧交错同时传,这是HTTP/2才有的。HTTP/1.1不是有管线化吗,为什么还说它有队头阻塞?管线化允许连发请求,但响应必须按顺序回,前面一个慢后面全堵着,再加上代理兼容问题,主流浏览器都没默认开启。所以实际效果等于没有。
一台服务器同一个
IP上挂了十个站点,靠什么区分?HTTP层靠Host头,1.1起是必填的。HTTPS还要更早一步,TLS握手时还没有Host,所以靠ClientHello里的SNI字段决定返回哪张证书。从
HTTP/1.1升到HTTP/2,安全性提升了吗?协议本身没有。
HTTP/2规范允许明文h2c,只是浏览器只在TLS上支持h2,所以大家感觉「升h2就有加密」,加密其实是TLS给的。
# 20 DNS如何工作的
⚡ 30 秒速记
- 查找顺序:浏览器缓存 → 系统缓存 /
hosts→ 本地DNS(运营商或8.8.8.8)→ 根 → 顶级域(.com)→ 权威DNS - 客户端到本地
DNS是递归(帮我查到底),本地DNS往上是迭代(一层层问) - 结果按
TTL缓存,改了解析不会立刻全网生效 - 常用记录:
A/AAAA/CNAME(CDN接入常用)/MX/TXT - 默认
UDP 53,响应太大或区域传送走TCP;明文可被劫持,DoH/DoT加密
DNS 就是互联网的电话簿,把域名翻译成 IP,查的时候先翻自己的小本子,没有再一级级往上问。 浏览器先看自己的缓存,再看操作系统缓存和 hosts,都没有就问本地 DNS 服务器,通常是运营商的。本地 DNS 帮你查到底,这段对你来说是递归;它自己则从根服务器问到 .com 服务器,再问到这个域名的权威服务器,这段是迭代。每条结果都带 TTL,各级都会缓存,所以改解析之后旧 IP 还会被用一阵子,切换前我一般先把 TTL 调小。
DNS 的作用就是通过域名查询到具体的 IP。DNS 协议提供的是一种主机名到 IP 地址的转换服务,就是我们常说的域名系统。是应用层协议,通常该协议运行在UDP协议之上,使用的是53端口号。
因为 IP 存在数字和英文的组合(IPv6),很不利于人类记忆,所以就出现了域名。你可以把域名看成是某个 IP 的别名,DNS 就是去查询这个别名的真正名称是什么。
当你在浏览器中想访问 www.google.com 时,会通过进行以下操作:
- 本地客户端向服务器发起请求查询 IP 地址
- 查看浏览器有没有该域名的 IP 缓存
- 查看操作系统有没有该域名的 IP 缓存
- 查看 Host 文件有没有该域名的解析配置
- 如果这时候还没得话,会通过直接去 DNS 根服务器查询,这一步查询会找出负责
com这个一级域名的服务器 - 然后去该服务器查询
google.com这个二级域名 - 接下来查询
www.google.com这个三级域名的地址 - 返回给 DNS 客户端并缓存起来
我们通过一张图来看看它的查询过程吧👇
这张图很生动的展示了DNS在本地DNS服务器是如何查询的,一般向本地DNS服务器发送请求是递归查询的
本地 DNS 服务器向其他域名服务器请求的过程是迭代查询的过程👇
递归查询和迭代查询
- 递归查询指的是查询请求发出后,域名服务器代为向下一级域名服务器发出请求,最后向用户返回查询的最终结果。使用递归 查询,用户只需要发出一次查询请求。
- 迭代查询指的是查询请求后,域名服务器返回单次查询的结果。下一级的查询由用户自己请求。使用迭代查询,用户需要发出 多次的查询请求。
所以一般而言,本地服务器查询是递归查询,而本地 DNS 服务器向其他域名服务器请求的过程是迭代查询的过程
DNS缓存
缓存也很好理解,在一个请求中,当某个DNS服务器收到一个DNS回答后,它能够回答中的信息缓存在本地存储器中。返回的资源记录中的 TTL 代表了该条记录的缓存的时间。
DNS实现负载平衡
它是如何实现负载均衡的呢?首先我们得清楚DNS 是可以用于在冗余的服务器上实现负载平衡。
原因: 这是因为一般的大型网站使用多台服务器提供服务,因此一个域名可能会对应 多个服务器地址。
举个例子来说👇
- 当用户发起网站域名的 DNS 请求的时候,DNS 服务器返回这个域名所对应的服务器 IP 地址的集合
- 在每个回答中,会循环这些 IP 地址的顺序,用户一般会选择排在前面的地址发送请求。
- 以此将用户的请求均衡的分配到各个不同的服务器上,这样来实现负载均衡。
DNS 为什么使用 UDP 协议作为传输层协议?
DNS 使用 UDP 协议作为传输层协议的主要原因是为了避免使用 TCP 协议时造成的连接时延
- 为了得到一个域名的 IP 地址,往往会向多个域名服务器查询,如果使用 TCP 协议,那么每次请求都会存在连接时延,这样使 DNS 服务变得很慢。
- 大多数的地址查询请求,都是浏览器请求页面时发出的,这样会造成网页的等待时间过长。
总结
- DNS域名系统,是应用层协议,运行UDP协议之上,使用端口43。
- 查询过程,本地查询是递归查询,依次通过浏览器缓存
—>>本地hosts文件—>>本地DNS解析器—>>本地DNS服务器—>>其他域名服务器请求。 接下来的过程就是迭代过程。 - 递归查询一般而言,发送一次请求就够,迭代过程需要用户发送多次请求。
💬 面试官追问
用
IP能打开站点,用域名打不开,就是权威DNS配错了吗?不一定。先
nslookup或dig看本机拿到的是什么,再查hosts有没有写死,然后dig @8.8.8.8换个解析器对比。只有直接问权威服务器dig +trace也拿不到,才是权威配错了。改了解析记录,有的地区一小时后还在访问旧服务器,正常吗?
正常,大概率是旧记录的
TTL还没到期,或者某些运营商DNS不按TTL来,缓存得更久。迁移前应该提前把TTL调到60秒左右,等旧缓存过期再切。能不能只靠
DNS轮询多个IP做负载均衡和故障摘除?分流可以,摘除做不到「立即」。各级缓存会继续返回挂掉的
IP,客户端也不一定重试别的地址。要秒级摘除得在入口放负载均衡做健康检查。页面里引了五六个第三方域名,
DNS这块怎么优化?关键的几个加
<link rel="preconnect">,次要的用<link rel="dns-prefetch">只做解析。根本办法是少用域名,能收敛到自家CDN的就收敛。DNS为什么主要用UDP?一问一答、报文小,用
UDP不用三次握手,快。但响应超过512字节(没开EDNS时)会截断改用TCP重查,主从之间区域传送也走TCP。
# 21 短轮询、长轮询和 WebSocket 间的区别
⚡ 30 秒速记
- 短轮询:定时问「有新的吗」,不管有没有都立刻回 → 简单,但空请求多、延迟取决于间隔
- 长轮询:服务端把请求挂住,有数据或超时才回,客户端收到马上再发 → 延迟低、空请求少,但占连接
WebSocket:一次握手升级成全双工长连接,双方随时发,帧头2~14字节- 只需要服务端单向推(通知、
AI流式输出)优先SSE,自带断线重连,走普通HTTP - 选型看三点:更新频率、能忍多大延迟、是不是双向
三者的区别在于「谁主动、连接留多久」:短轮询是客户端一直问,长轮询是问了之后服务端憋着等有货再答,WebSocket 是建一条管道两边随时说话。 短轮询最简单,但大部分请求都是白跑;长轮询把空请求压下来了,代价是每个在线用户都挂着一个请求,服务端连接数会涨。WebSocket 最实时,但要处理心跳、重连、鉴权,网关也要支持升级。实际项目里我会先问是不是双向:只是服务端推消息,用 SSE 就够了,比 WebSocket 省心很多。
1. 短轮询
短轮询的基本思路:
- 浏览器每隔一段时间向浏览器发送 http 请求,服务器端在收到请求后,不论是否有数据更新,都直接进行 响应。
- 这种方式实现的即时通信,本质上还是浏览器发送请求,服务器接受请求的一个过程,通过让客户端不断的进行请求,使得客户端能够模拟实时地收到服务器端的数据的变化。
优缺点👇
- 优点是比较简单,易于理解。
- 缺点是这种方式由于需要不断的建立 http 连接,严重浪费了服务器端和客户端的资源。当用户增加时,服务器端的压力就会变大,这是很不合理的。
2. 长轮询
长轮询的基本思路:
- 首先由客户端向服务器发起请求,当服务器收到客户端发来的请求后,服务器端不会直接进行响应,而是先将 这个请求挂起,然后判断服务器端数据是否有更新。
- 如果有更新,则进行响应,如果一直没有数据,则到达一定的时间限制才返回。客户端 JavaScript 响应处理函数会在处理完服务器返回的信息后,再次发出请求,重新建立连接。
优缺点👇
- 长轮询和短轮询比起来,它的优点是明显减少了很多不必要的 http 请求次数,相比之下节约了资源。
- 长轮询的缺点在于,连接挂起也会导致资源的浪费
3. WebSocket
- WebSocket 是 Html5 定义的一个新协议,与传统的 http 协议不同,该协议允许由服务器主动的向客户端推送信息。
- 使用 WebSocket 协议的缺点是在服务器端的配置比较复杂。WebSocket 是一个全双工的协议,也就是通信双方是平等的,可以相互发送消息。
💬 面试官追问
订单状态一分钟刷一次就行,有人坚持要上
WebSocket,你怎么看?分钟级延迟用短轮询完全够,
setInterval加一个接口就搞定。为这个上WebSocket要多维护心跳、重连和网关配置,收益对不上成本。短轮询怎么改成长轮询?
服务端收到请求先不回,有更新就立即返回,没有就等到比如
30秒超时回个空。客户端拿到响应后马上发下一个:while (true) { const res = await fetch('/poll'); handle(res) },注意超时要比网关的超时短。长轮询上线后服务端连接数一直涨,先看什么?
先看客户端是不是在响应回来前又发了新请求,比如组件重复挂载开了好几个循环。再看服务端有没有设超时、网关超时是不是比挂起时间还短,导致客户端不停报错重连。
大模型的打字机效果,用
WebSocket还是SSE?一般用
SSE。数据只从服务端往下流,SSE走普通HTTP,网关、鉴权、日志都不用特殊处理,EventSource断了还会自动重连。要带POST请求体的话用fetch读流也行。协同编辑文档,为什么长轮询不合适?
协同编辑两边都要高频发操作,长轮询只能服务端借挂起的请求回数据,客户端发消息还得另起请求,延迟和开销都大。这种双向高频场景就是
WebSocket的主场。
# 22 说一说正向代理和反向代理
⚡ 30 秒速记
- 正向代理替客户端干活:服务器只看到代理 → 公司出口代理、科学上网、抓包工具
- 反向代理替服务端干活:客户端只看到入口 →
Nginx、CDN、API网关 - 一句话:正向藏客户端,反向藏服务端;看代理是谁配置、为谁服务
- 反向代理常干的活:负载均衡、
TLS卸载、缓存静态资源、同域转发解决跨域、WAF - 前端日常接触的
devServer.proxy、Nginx的proxy_pass都是反向代理
区分两者就看代理站在哪一边:站在客户端这边替你出去访问的是正向代理,站在服务端那边替网站接客的是反向代理。 比如公司电脑配了出口代理,外网网站只看到代理的 IP,不知道是哪个员工,这是正向。访问一个网站,请求先到 Nginx,它再转给后面某台应用服务器,你根本不知道是哪台,这是反向。前端最常用的就是反向代理,开发时 devServer.proxy 把 /api 转给后端,线上 Nginx 同域转发,跨域问题就没了。
正向代理
我们常说的代理也就是指正向代理,正向代理的过程,它隐藏了真实的请求客户端,服务端不知道真实的客户端是谁,客户端请求的服务都被代理服务器代替来请求。
反向代理
这种代理模式下,它隐藏了真实的服务端,当我们向一个网站发起请求的时候,背后可能有成千上万台服务器为我们服务,具体是哪一台,我们不清楚,我们只需要知道反向代理服务器是谁就行,而且反向代理服务器会帮我们把请求转发到真实的服务器那里去,一般而言反向代理服务器一般用来实现负载平衡。
负载平衡的两种实现方式?
- 一种是使用反向代理的方式,用户的请求都发送到反向代理服务上,然后由反向代理服务器来转发请求到真实的服务器上,以此来实现集群的负载平衡。
- 另一种是 DNS 的方式,DNS 可以用于在冗余的服务器上实现负载平衡。因为现在一般的大型网站使用多台服务器提供服务,因此一个域名可能会对应多个服务器地址。当用户向网站域名请求的时候,DNS 服务器返回这个域名所对应的服务器 IP 地址的集合,但在每个回答中,会循环这些 IP 地址的顺序,用户一般会选择排在前面的地址发送请求。以此将用户的请求均衡的分配到各个不同的服务器上,这样来实现负载均衡。这种方式有一个缺点就是,由于 DNS 服务器中存在缓存,所以有可能一个服务器出现故障后,域名解析仍然返回的是那个 IP 地址,就会造成访问的问题。
💬 面试官追问
浏览器配了公司代理访问外网,服务端日志只有代理
IP,这是哪种代理?正向代理。代理是客户端这边配的,替员工出去访问,目标服务器不知道真实用户。想拿真实
IP就得代理主动加X-Forwarded-For。devServer.proxy为什么能解决跨域?浏览器请求的是同源的
localhost:3000/api,没有跨域;开发服务器再用Node转发到后端,服务器之间不受同源策略管。线上要保持效果,就得在Nginx里配同样的转发,或者后端开CORS。经过
Nginx反向代理后,后端拿到的客户端IP全是127.0.0.1,怎么办?Nginx里加proxy_set_header X-Real-IP $remote_addr和X-Forwarded-For,后端从这两个头取。注意只信任自家代理加的头,否则用户可以伪造。扩缩容时不想让用户感知,负载均衡放
DNS还是反向代理?放反向代理。节点增减只改
upstream,健康检查能秒级摘除坏节点。DNS有缓存,删了记录用户还会打到旧机器上。Charles抓HTTPS包属于哪种代理?正向代理,手机或电脑把代理指向
Charles。抓HTTPS需要在设备上信任Charles的根证书,它才能现签证书解密,这也是中间人的原理。
# 23 介绍一下Connection:keep-alive
⚡ 30 秒速记
- 作用:一条
TCP连接处理多个HTTP请求,省掉重复的三次握手、TLS握手和慢启动 HTTP/1.0默认关,要发Connection: keep-alive;HTTP/1.1默认开,要关发Connection: close- 复用≠并发:同一时间一条连接上还是只跑一个请求,浏览器靠每域名约
6条连接并发 - 服务端要配空闲超时和单连接最大请求数(
Nginx的keepalive_timeout、keepalive_requests) HTTP/2/HTTP/3禁止Connection头,连接本来就是持久的
keep-alive 就是连接用完先别挂,下一个请求接着用。 HTTP/1.0 每个请求都要新建 TCP 连接,HTTPS 还要再握一次 TLS,资源一多光建连就耗掉不少时间。HTTP/1.1 把持久连接设成默认,不需要再显式写这个头,想关才发 Connection: close。要注意它只是复用,不是并发,同一条连接上请求还是排队。另外服务端不会永远留着空闲连接,超时会主动关,这个超时设多长要看并发量和内存。
什么是keep-alive
我们知道HTTP协议采用“请求-应答”模式,当使用普通模式,即非KeepAlive模式时,每个请求/应答客户和服务器都要新建一个连接,完成 之后立即断开连接(HTTP协议为无连接的协议);
当使用Keep-Alive模式(又称持久连接、连接重用)时,Keep-Alive功能使客户端到服 务器端的连接持续有效,当出现对服务器的后继请求时,Keep-Alive功能避免了建立或者重新建立连接。
为什么要使用keep-alive
keep-alive技术的创建目的,能在多次HTTP之前重用同一个TCP连接,从而减少创建/关闭多个 TCP 连接的开销(包括响应时间、CPU 资源、减少拥堵等),参考如下示意图
客户端如何开启
在HTTP/1.0协议中,默认是关闭的,需要在http头加入"Connection: Keep-Alive”,才能启用Keep-Alive;
Connection: keep-alive
http 1.1中默认启用Keep-Alive,如果加入"Connection: close “,才关闭。
Connection: close
目前大部分浏览器都是用http1.1协议,也就是说默认都会发起Keep-Alive的连接请求了,所以是否能完成一个完整的Keep- Alive连接就看服务器设置情况。
💬 面试官追问
开了
keep-alive,十个请求会合并成一个响应返回吗?不会。请求和响应还是一对一,只是共用同一条
TCP连接,省的是建连和关连的开销。瀑布图里每个请求前面都有
Initial connection,连接没复用,查什么?先看响应头有没有
Connection: close,有的话就是服务端或中间代理主动关的。再查Nginx的keepalive_timeout是不是被设成了0,以及到上游有没有配keepalive连接池。HTTP/1.1的服务,代码里还在手动加Connection: keep-alive,有必要吗?没必要,
1.1默认就是持久连接。浏览器里这个头也是受保护的,fetch设置它会被忽略。运维想把空闲连接永久保留,省得反复建连,可以吗?
不行。每条空闲连接都占文件描述符和内存,几万个用户挂着不走,服务器很快就扛不住。
Nginx默认keepalive_timeout是75秒,按流量调,一般几十秒够用。Nginx做反向代理时,和后端之间也能keep-alive吗?能,但默认不开。要在
upstream里写keepalive 32,location里配proxy_http_version 1.1和proxy_set_header Connection "",否则每个请求都和后端新建一次连接。
# 24 http/https 协议总结
⚡ 30 秒速记
HTTP:应用层、无状态、明文、默认80;HTTPS=HTTP+TLS,默认443- 版本:
1.1长连接 +Host→2多路复用 +HPACK→3换QUIC - 强缓存:
Cache-Control: max-age优先于Expires,命中不发请求 - 协商缓存:
ETag/If-None-Match优先于Last-Modified/If-Modified-Since,没变返回304 Last-Modified两个坑:秒级精度、内容没变但时间变了也算改
这一节可以串成一条线:传输靠 TCP,应用层是 HTTP,加密靠 TLS,性能靠版本升级和缓存。 版本上 1.1 解决重复建连,2 解决请求排队,3 解决 TCP 丢包拖累。缓存是前端最常落地的部分:先看强缓存,Cache-Control 的 max-age 没过期直接用本地副本,连请求都不发;过期了带上 If-None-Match 或 If-Modified-Since 去问服务端,没变就回 304。实际项目里我一般是 HTML 走协商缓存,带 hash 的静态资源设一年强缓存。
1.0 协议缺陷:
- 无法复用链接,完成即断开,重新慢启动和
TCP 3次握手 head of line blocking: 线头阻塞,导致请求之间互相影响
1.1 改进:
- 长连接(默认
keep-alive),复用 host字段指定对应的虚拟站点- 新增功能:
- 断点续传
- 身份认证
- 状态管理
cache缓存Cache-ControlExpiresLast-ModifiedEtag
2.0:
- 多路复用
- 二进制分帧层: 应用层和传输层之间
- 首部压缩
- 服务端推送
https: 较为安全的网络传输协议
- 证书(公钥)
SSL加密- 端口
443
TCP:
- 三次握手
- 四次挥手
- 滑动窗口: 流量控制
- 拥塞处理
- 慢开始
- 拥塞避免
- 快速重传
- 快速恢复
缓存策略: 可分为 强缓存 和 协商缓存
Cache-Control/Expires: 浏览器判断缓存是否过期,未过期时,直接使用强缓存,Cache-Control的max-age优先级高于Expires- 当缓存已经过期时,使用协商缓存
- 唯一标识方案:
Etag(response携带) &If-None-Match(request携带,上一次返回的Etag): 服务器判断资源是否被修改 - 最后一次修改时间:
Last-Modified(response) & If-Modified-Since(request,上一次返回的Last-Modified)- 如果一致,则直接返回 304 通知浏览器使用缓存
- 如不一致,则服务端返回新的资源
- 唯一标识方案:
Last-Modified缺点:- 周期性修改,但内容未变时,会导致缓存失效
- 最小粒度只到
s,s以内的改动无法检测到
Etag的优先级高于Last-Modified
💬 面试官追问
同时配了
Expires和Cache-Control: max-age,以谁为准?以
max-age为准。Expires是绝对时间,依赖客户端时钟,用户电脑时间不准就乱了;max-age是相对秒数,更可靠。图片改了,请求带
If-Modified-Since却还是304,怎么回事?Last-Modified只精确到秒,同一秒内改了文件服务端分辨不出来。改用ETag按内容算标识,它的优先级也比Last-Modified高。每次发版构建都会改文件时间,内容没变也被重新下载,怎么优化?
别依赖
Last-Modified。静态资源文件名带内容hash,内容不变文件名就不变,配Cache-Control: max-age=31536000, immutable,根本不发请求。HTML也设成一年强缓存会怎样?发版后用户还在用旧
HTML,引用的是旧hash的JS,新功能出不来,旧文件被删了还会白屏。HTML应该no-cache,每次都去协商。no-cache和no-store有什么区别?no-cache是可以缓存,但每次用之前都要去服务端确认;no-store是压根不准存。名字很容易让人搞反,HTML一般用no-cache,敏感数据才用no-store。
# 25 TCP为什么要三次握手
⚡ 30 秒速记
- 三次握手 =
SYN→SYN+ACK→ACK,目的是确认双方收发都正常,并交换初始序列号ISN - 两次不够:服务端不知道自己发的包客户端收没收到
- 另一个原因:防止网络里滞留的旧
SYN晚到,服务端白白建连等数据 - 第三次握手可以带数据,前两次不行(
TCP Fast Open例外) - 挥手四次:收到
FIN只代表对方不发了,自己可能还有数据,所以ACK和FIN通常分开发;主动关闭方要等2MSL的TIME_WAIT
三次握手的核心是让双方都确认「我能发、你能收;你能发、我能收」,同时把各自的起始序号告诉对方。 像打电话:「喂听得到吗」「听得到,你听得到我吗」「听得到」,三句之后两边才都放心。只握两次的话,服务端不知道客户端能不能收到它的回复。还有个经典场景:客户端早先发的 SYN 在网络里堵了很久才到,如果两次就建连,服务端会为一个早已没人要的连接一直分配资源;有了第三次,客户端不回 ACK,服务端就知道这是个无效请求。
客户端和服务端都需要直到各自可收发,因此需要三次握手
- 第一次握手成功让服务端知道了客户端具有发送能力
- 第二次握手成功让客户端知道了服务端具有接收和发送能力,但此时服务端并不知道客户端是否接收到了自己发送的消息
- 为了防止出现失效的连接请求报文段被服务端接收的情况,从而产生错误。所以第三次握手就起到了这个作用
你可以能会问,2 次握手就足够了?。但其实不是,因为服务端还没有确定客户端是否准备好了。比如步骤 3 之后,服务端马上给客户端发送数据,这个时候客户端可能还没有准备好接收数据。因此还需要增加一个过程
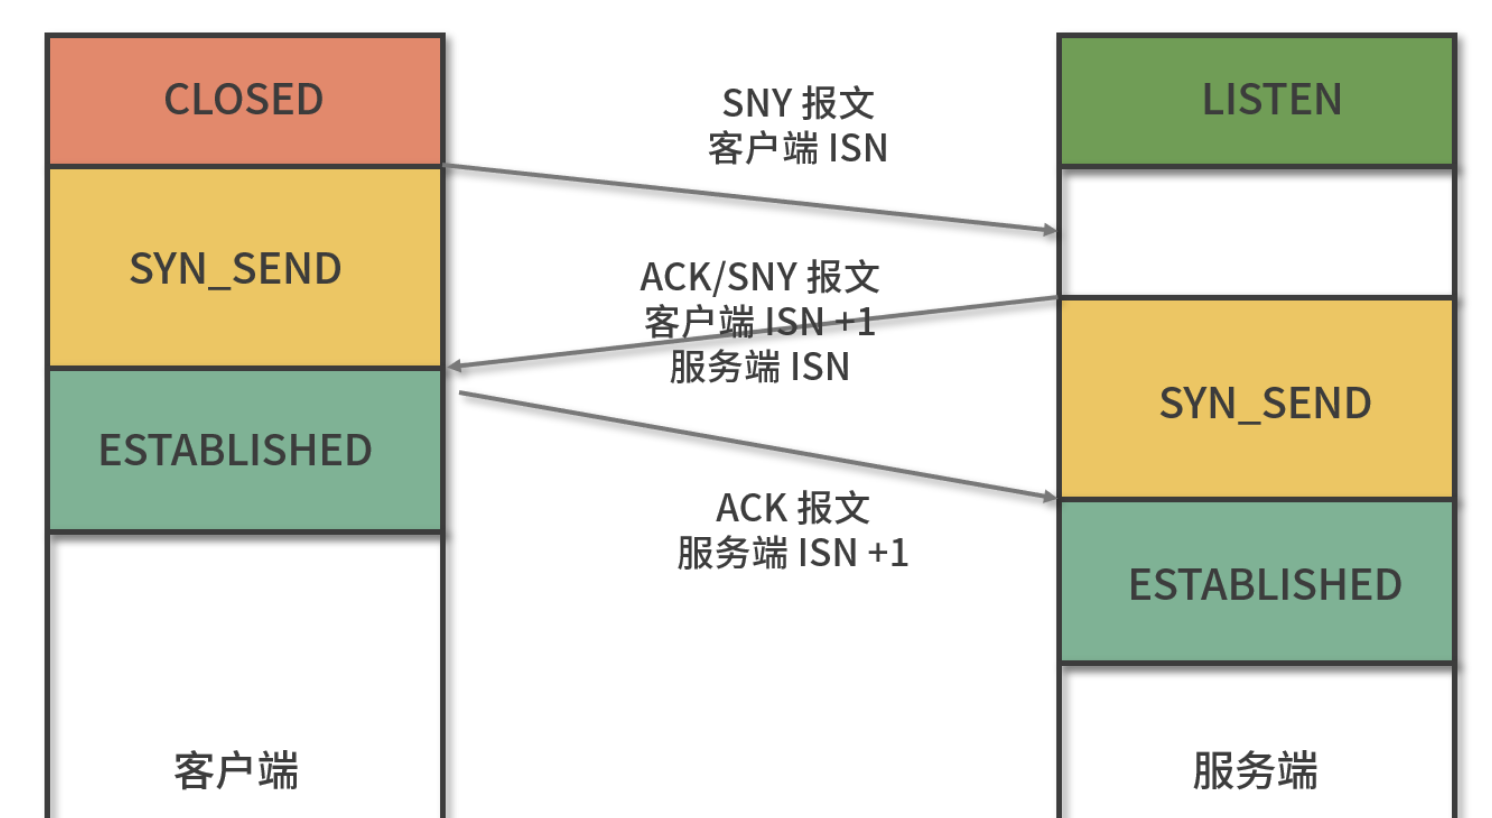

TCP有6种标示:SYN(建立联机) ACK(确认) PSH(传送) FIN(结束) RST(重置) URG(紧急)
举例:已失效的连接请求报文段
client发送了第一个连接的请求报文,但是由于网络不好,这个请求没有立即到达服务端,而是在某个网络节点中滞留了,直到某个时间才到达server- 本来这已经是一个失效的报文,但是
server端接收到这个请求报文后,还是向client发出确认的报文,表示同意连接。 - 假如不采用三次握手,那么只要
server发出确认,新的建立就连接了,但其实这个请求是失效的请求,client是不会理睬server的确认信息,也不会向服务端发送确认的请求 - 但是
server认为新的连接已经建立起来了,并一直等待client发来数据,这样,server的很多资源就没白白浪费掉了 - 采用三次握手就是为了防止这种情况的发生,server会因为收不到确认的报文,就知道
client并没有建立连接。这就是三次握手的作用
三次握手过程中可以携带数据吗
- 第一次、第二次握手不可以携带数据,因为一握二握时还没有建立连接,会让服务器容易受到攻击
- 而第三次握手,此时客户端已经处于
ESTABLISHED (已建立连接状态),对于客户端来说,已经建立起连接了,并且也已经知道服务器的接收、发送能力是正常的了,所以能携带数据也是没问题的。
为什么建立连接只通信了三次,而断开连接却用了四次?
- 客户端要求断开连接,发送一个断开的请求,这个叫作(FIN)。
- 服务端收到请求,然后给客户端一个 ACK,作为 FIN 的响应。
- 这里你需要思考一个问题,可不可以像握手那样马上传 FIN 回去?
- 其实这个时候服务端不能马上传 FIN,因为断开连接要处理的问题比较多,比如说服务端可能还有发送出去的消息没有得到 ACK;也有可能服务端自己有资源要释放。因此断开连接不能像握手那样操作——将两条消息合并。所以,
服务端经过一个等待,确定可以关闭连接了,再发一条 FIN 给客户端。 - 客户端收到服务端的 FIN,同时客户端也可能有自己的事情需要处理完,比如客户端有发送给服务端没有收到 ACK 的请求,客户端自己处理完成后,再给服务端发送一个 ACK。
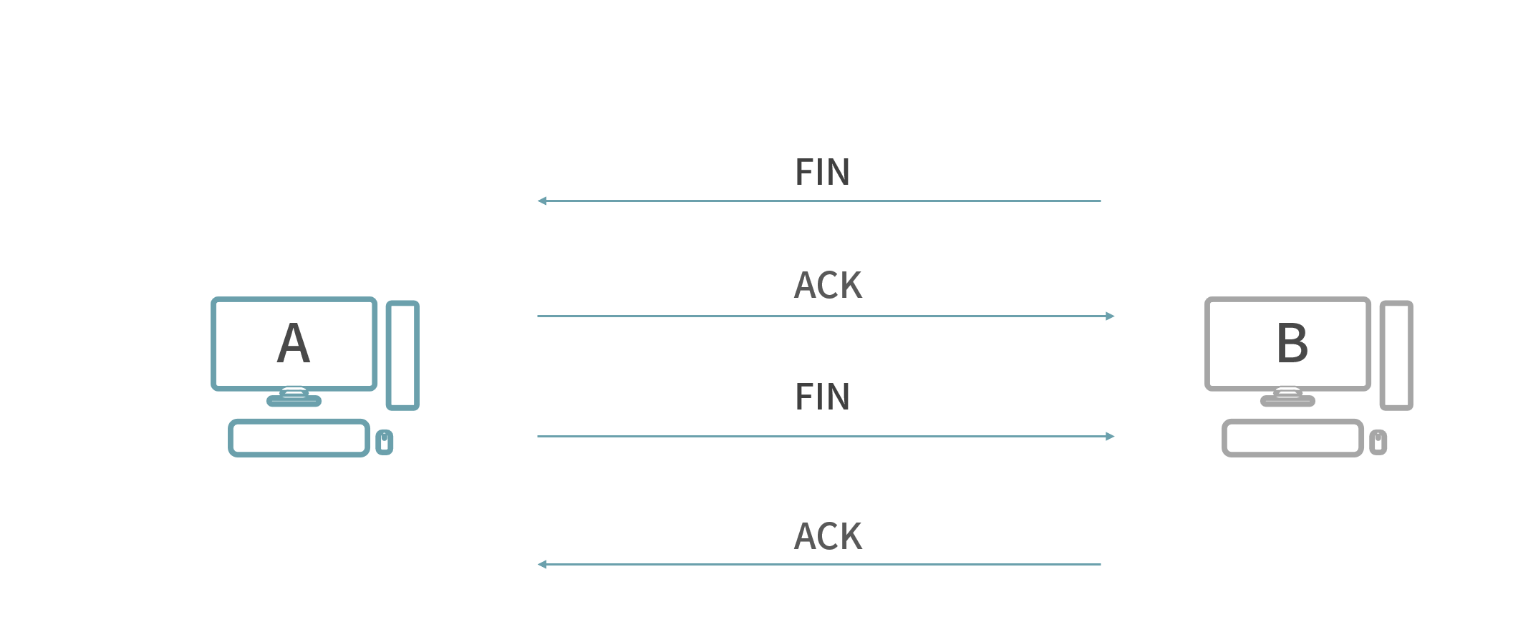
为了确保数据能够完成传输。因为当服务端收到客户端的 FIN 报文后,发送的 ACK 报文只是用来应答的,并不表示服务端也希望立即关闭连接。
当只有服务端把所有的报文都发送完了,才会发送 FIN 报文,告诉客户端可以断开连接了,因此在断开连接时需要四次挥手。
- 关闭连接时,当收到对方的FIN报文通知时,它仅仅表示对方没有数据发送给你了;但未必你所有的数据都全部发送给对方了
- 所以你未必会马上关闭
SOCKET,也即你可能还需要发送一些数据给对方之后,再发送FIN报文给对方来表示你同意现在可以关闭连接了,所以它这里的ACK报文和FIN报文多数情况下都是分开发送的。
💬 面试官追问
服务端已经回了
SYN+ACK,为什么还不能算连接建好?这时客户端确认了服务端能收能发,但服务端只知道客户端能发,不知道自己的回复客户端收没收到。等第三个
ACK回来,两边才都确认完。为什么一定要交换序列号,从
0开始不行吗?序列号是
TCP保证有序、去重、重传的基础。ISN随机生成,一是防止旧连接的残留报文混进新连接,二是防止攻击者猜出序列号伪造报文。线上大量连接停在
SYN_RECV,迟迟不进ESTABLISHED,怎么排查?SYN_RECV是服务端回了SYN+ACK在等第三个ACK。要么是防火墙或链路把回包丢了,要么是SYN Flood攻击,伪造源IP发SYN不回ACK。看netstat -s的半连接溢出计数,开tcp_syncookies兜底。关闭连接为什么是四次,不能像握手一样合并成三次?
收到对方的
FIN只说明对方不再发了,自己这边可能还有数据没发完,所以先回ACK,发完了再发自己的FIN。如果正好没数据要发,ACK和FIN也能合并,抓包看到三次挥手也正常。服务器上一堆
TIME_WAIT,是出问题了吗?不是,主动关连接的一方都会进
TIME_WAIT等2MSL,确保最后一个ACK能到、旧报文消失。太多一般是服务端在主动关短连接,改成长连接复用最有效,也可以开tcp_tw_reuse给出站连接复用。
# 26 为什么要有 WebSocket
⚡ 30 秒速记
- 根本原因:
HTTP是请求-响应模式,服务端没法在客户端没问的时候主动推 - 轮询的代价:空请求多、每次都带完整头部、延迟受间隔限制
- 握手:
GET+Upgrade: websocket+Sec-WebSocket-Key→101 Switching Protocols+Sec-WebSocket-Accept,之后换成二进制帧 - 用
80/443和ws:///wss://,好穿防火墙;但代理要放行Upgrade头 - 工程三件套:心跳、断线重连(指数退避)、鉴权(不受同源策略限制,要校验
Origin)
WebSocket 是为了解决 HTTP 只能「客户端问、服务端答」的问题,让服务端也能随时开口。 在它之前,聊天、行情这类实时场景只能靠轮询硬凑,大量请求是空的,头部还比数据大。WebSocket 借 HTTP 的协议升级完成握手,服务端回 101 之后,这条 TCP 连接就变成双方随时发消息的通道,每帧只有几个字节的头。代价是连接要自己管:心跳、重连、鉴权都得写,Nginx 也要专门配升级头。
已经有了被广泛应用的 HTTP 协议,为什么要再出一个 WebSocket 呢?它有哪些好处呢?
其实 WebSocket 与 HTTP/2 一样,都是为了解决 HTTP 某方面的缺陷而诞生的。HTTP/2 针对的是“队头阻塞”,而
WebSocket 针对的是“请求 - 应答”通信模式。
那么,“请求 - 应答”有什么不好的地方呢?
- “请求 - 应答”是一种“半双工”的通信模式,虽然可以双向收发数据,但同一时刻只能一个方向上有动作,传输效率低。更关键的一点,它是一种“被动”通信模式,服务器只能“被动”响应客户端的请求,无法主动向客户端发送数据。
- 虽然后来的 HTTP/2、HTTP/3 新增了 Stream、Server Push 等特性,但“请求 - 应答”依然是主要的工作方式。这就导致 HTTP 难以应用在动态页面、即时消息、网络游戏等要求“实时通信”的领域。
- 在 WebSocket 出现之前,在浏览器环境里用 JavaScript 开发实时 Web 应用很麻烦。因为浏览器是一个“受限的沙盒”,不能用 TCP,只有 HTTP 协议可用,所以就出现了很多“变通”的技术,“轮询”(polling)就是比较常用的的一种。
- 简单地说,轮询就是不停地向服务器发送 HTTP 请求,问有没有数据,有数据的话服务器就用响应报文回应。如果轮询的频率比较高,那么就可以近似地实现“实时通信”的效果。
- 但轮询的缺点也很明显,反复发送无效查询请求耗费了大量的带宽和 CPU 资源,非常不经济。
- 所以,为了克服 HTTP“请求 - 应答”模式的缺点,WebSocket 就“应运而生”了
WebSocket 的特点
- WebSocket 是一个真正“全双工”的通信协议,与 TCP 一样,客户端和服务器都可以随时向对方发送数据
- WebSocket
采用了二进制帧结构,语法、语义与 HTTP 完全不兼容,但因为它的主要运行环境是浏览器,为了便于推广和应用,就不得不“搭便车”,在使用习惯上尽量向 HTTP 靠拢,这就是它名字里“Web”的含义。 - 服务发现方面,WebSocket 没有使用 TCP 的“IP 地址 + 端口号”,而是延用了 HTTP 的 URI 格式,但开头的协议名不是“http”,引入的是两个新的名字:“ws”和“wss”,分别表示明文和加密的 WebSocket 协议。
WebSocket 的默认端口也选择了 80 和 443,因为现在互联网上的防火墙屏蔽了绝大多数的端口,只对 HTTP 的 80、443 端口“放行”,所以 WebSocket 就可以“伪装”成 HTTP 协议,比较容易地“穿透”防火墙,与服务器建立连接
ws://www.chrono.com
ws://www.chrono.com:8080/srv
wss://www.chrono.com:445/im?user_id=xxx
WebSocket 的握手
和 TCP、TLS 一样,WebSocket 也要有一个握手过程,然后才能正式收发数据。
这里它还是搭上了 HTTP 的“便车”,利用了 HTTP 本身的“协议升级”特性,“伪装”成 HTTP,这样就能绕过浏览器沙盒、网络防火墙等等限制,这也是 WebSocket 与 HTTP 的另一个重要关联点。
WebSocket 的握手是一个标准的 HTTP GET 请求,但要带上两个协议升级的专用头字段:
- “Connection: Upgrade”,表示要求协议“升级”;
- “Upgrade: websocket”,表示要“升级”成 WebSocket 协议。
另外,为了防止普通的 HTTP 消息被“意外”识别成 WebSocket,握手消息还增加了两个额外的认证用头字段(所谓的“挑战”,Challenge):
Sec-WebSocket-Key:一个 Base64 编码的 16 字节随机数,作为简单的认证密钥;Sec-WebSocket-Version:协议的版本号,当前必须是 13。
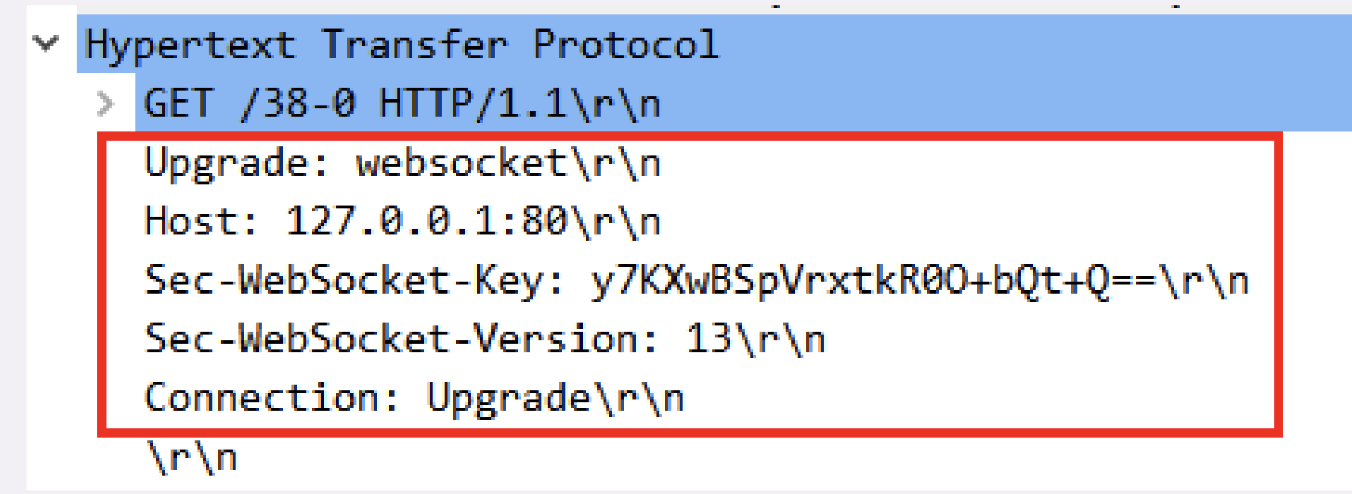
服务器收到 HTTP 请求报文,看到上面的四个字段,就知道这不是一个普通的 GET 请求,而是 WebSocket 的升级请求,于是就不走普通的 HTTP 处理流程,而是构造一个特殊的“101 Switching Protocols”响应报文,通知客户端,接下来就不用 HTTP 了,全改用 WebSocket 协议通信
小结
浏览器是一个“沙盒”环境,有很多的限制,不允许建立 TCP 连接收发数据,而有了 WebSocket,我们就可以在浏览器里与服务器直接建立“TCP 连接”,获得更多的自由。
不过自由也是有代价的,WebSocket 虽然是在应用层,但使用方式却与“TCP Socket”差不多,过于“原始”,用户必须自己管理连接、缓存、状态,开发上比 HTTP 复杂的多,所以是否要在项目中引入 WebSocket 必须慎重考虑。
HTTP的“请求 - 应答”模式不适合开发“实时通信”应用,效率低,难以实现动态页面,所以出现了 WebSocket;WebSocket是一个“全双工”的通信协议,相当于对 TCP 做了一层“薄薄的包装”,让它运行在浏览器环境里;WebSocket使用兼容 HTTP 的 URI 来发现服务,但定义了新的协议名“ws”和“wss”,端口号也沿用了80 和 443;WebSocket使用二进制帧,结构比较简单,特殊的地方是有个“掩码”操作,客户端发数据必须掩码,服务器则不用;WebSocket利用 HTTP 协议实现连接握手,发送 GET 请求要求“协议升级”,握手过程中有个非常简单的认证机制,目的是防止误连接。
💬 面试官追问
HTTP也能双向传数据,为什么还需要WebSocket?HTTP的双向是「一问一答」,服务端只能在响应里带数据,没有请求就没法开口。聊天这种服务端随时要推的场景,只能靠轮询凑,而WebSocket建连后服务端想发就发。线上
WebSocket连接拿到的是200,不是101,问题在哪?请求被当成了普通
HTTP,九成是中间的Nginx没转发升级头。要加proxy_http_version 1.1、proxy_set_header Upgrade $http_upgrade和proxy_set_header Connection "upgrade"。连接没报错,但空闲一分钟左右就断了,为什么?
通常是代理的读超时,
Nginx的proxy_read_timeout默认就是60s,没数据就关连接。客户端每30秒发一个ping,服务端回pong,顺便还能检测假死连接。Sec-WebSocket-Key能当鉴权用吗?不能。它只是个随机值,服务端拼上固定
GUID做SHA-1再base64回给你,用来证明对方真懂WebSocket协议,跟用户是谁没关系。鉴权要在握手时校验Cookie或URL里的token,建连后再验一次也行。浏览器的
new WebSocket()能加Authorization头吗?不能,浏览器
API不允许自定义请求头。常见做法是把token放URL参数,或者同域时直接带Cookie,再或者建连后第一条消息发token,服务端没收到就断开。
# 27 UDP和TCP有什么区别
⚡ 30 秒速记
TCP:面向连接、可靠(确认 + 重传 + 排序)、有流量控制和拥塞控制、字节流UDP:无连接、不保证到达和顺序、数据报(保留消息边界),头部8字节,TCP至少20字节- 选型:要完整有序用
TCP(HTTP/1.1、HTTP/2、文件传输);要低延迟、能丢旧数据用UDP(音视频、游戏、DNS) UDP不是「不能可靠」,而是可靠性交给上层自己做,QUIC就是例子- 前端要知道:
HTTP/3跑在UDP上,WebRTC媒体流也是UDP
TCP 像打电话,先接通、说的每句都确认对方听清了;UDP 像发短信,发了就不管,到没到、先后顺序都不保证。 TCP 靠序列号、确认、重传、滑动窗口保证数据完整有序,还会根据网络情况自动降速,代价是建连慢、头部大、一个包丢了后面都得等。UDP 就是在 IP 上加了端口和校验和,没有连接也没有重传,所以延迟低。直播、游戏宁可丢一帧也不要卡住,适合 UDP;要一个字节都不能错的,用 TCP。
- TCP协议在传送数据段的时候要给段标号;UDP协议不
- TCP协议可靠;UDP协议不可靠
- TCP协议是面向连接;UDP协议采用无连接
- TCP协议负载较高,采用虚电路;UDP采用无连接
- TCP协议的发送方要确认接收方是否收到数据段(3次握手协议)
- TCP协议采用窗口技术和流控制
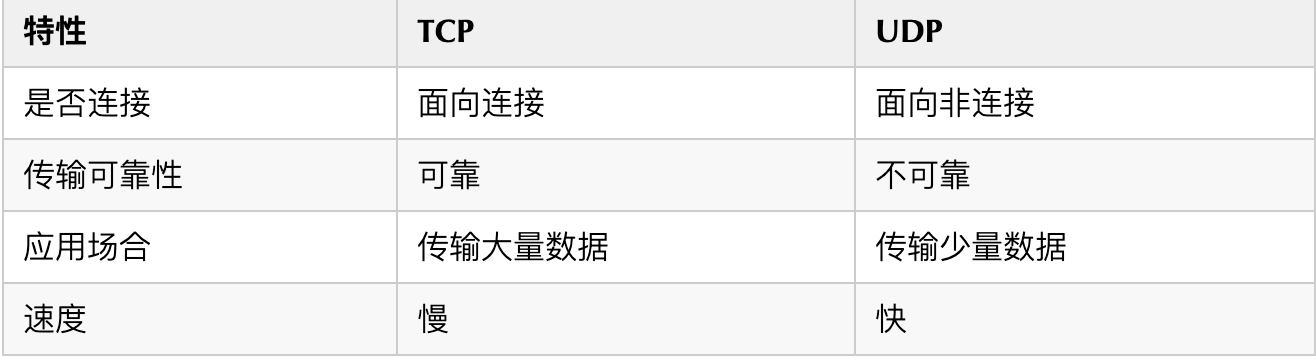
💬 面试官追问
文件上传有人说用
UDP更快,丢了重传整个文件就行,靠谱吗?不靠谱。大文件几乎肯定会丢几个包,整个重传等于永远传不完。要么用
TCP,要么在UDP上自己实现分片确认和重传,那就是在重新造TCP。用
UDP发数据,发送端返回成功,接收端却少了几条,是接收端漏处理了吗?不一定。
UDP的发送成功只代表交给了网卡,不代表对方收到。链路丢包、接收缓冲区满都会丢,要么业务上加确认,要么换可靠协议。TCP是字节流、UDP是数据报,这个区别会带来什么实际问题?TCP没有消息边界,发两次100字节,对方可能一次读到200字节,这就是常说的「粘包」,要自己加长度头分隔。UDP发一次就是一个完整的包,收的时候也是一个。HTTP/3为什么选UDP,不在TCP上改?TCP实现在操作系统内核和中间设备里,改一点要等全世界升级,几乎不可能。UDP足够简单,QUIC在用户态实现可靠传输和多路复用,浏览器和服务端升级就能用。视频会议为什么用
UDP,丢包了画面怎么办?实时音视频里迟到的数据就是没用的数据,
TCP为了等一个重传包把后面全卡住,体验更差。UDP丢了就丢了,靠编码层的前向纠错、丢帧插值兜底,最多花屏一下。
# 十一、9种前端常见的设计模式
# 1. 外观模式
⚡ 30 秒速记
- 外观模式 = 给一堆复杂子系统开一个简单的总入口,调用方只跟入口打交道
- 典型:
jQuery封装原生DOM、自家的request()包住axios的鉴权 / 超时 / 报错 / 重试 - 兼容封装:一个
on()里藏addEventListener/attachEvent的分支 - 好处:调用方少依赖、底层换实现不影响业务
- 坑:外观接口设计窄了,大家开始绕过它直连底层;什么都往里塞,又变成新的大泥球
外观模式就是在一堆复杂接口前面放一个前台,调用方只说「我要办什么」,具体找哪几个部门由前台去协调。 前端最常见的就是封装请求:业务页面只调 request.get('/user'),token 注入、超时、错误提示、401 跳登录全在里面,哪天把 axios 换成 fetch,页面一行不用改。jQuery 也是典型,抹平了浏览器差异。用的时候要注意边界,入口太死板了别人会绕过去直接用底层,等于白做;什么都往里加,它又成了一个新的复杂系统。
外观模式是最常见的设计模式之一,它为子系统中的一组接口提供一个统一的高层接口,使子系统更容易使用。简而言之外观设计模式就是把多个子系统中复杂逻辑进行抽象,从而提供一个更统一、更简洁、更易用的API。很多我们常用的框架和库基本都遵循了外观设计模式,比如JQuery就把复杂的原生DOM操作进行了抽象和封装,并消除了浏览器之间的兼容问题,从而提供了一个更高级更易用的版本。其实在平时工作中我们也会经常用到外观模式进行开发,只是我们不自知而已
兼容浏览器事件绑定
let addMyEvent = function (el, ev, fn) {
if (el.addEventListener) {
el.addEventListener(ev, fn, false)
} else if (el.attachEvent) {
el.attachEvent('on' + ev, fn)
} else {
el['on' + ev] = fn
}
};
封装接口
let myEvent = {
// ...
stop: e => {
e.stopPropagation();
e.preventDefault();
}
};
场景
- 设计初期,应该要有意识地将不同的两个层分离,比如经典的三层结构,在数据访问层和业务逻辑层、业务逻辑层和表示层之间建立外观Facade
- 在开发阶段,子系统往往因为不断的重构演化而变得越来越复杂,增加外观Facade可以提供一个简单的接口,减少他们之间的依赖。
- 在维护一个遗留的大型系统时,可能这个系统已经很难维护了,这时候使用外观Facade也是非常合适的,为系系统开发一个外观Facade类,为设计粗糙和高度复杂的遗留代码提供比较清晰的接口,让新系统和Facade对象交互,Facade与遗留代码交互所有的复杂工作。
优点
- 减少系统相互依赖。
- 提高灵活性。
- 提高了安全性
缺点
不符合开闭原则,如果要改东西很麻烦,继承重写都不合适。
💬 面试官追问
二十个组件里都复制了一份事件绑定的兼容判断,你会怎么处理?
收成一个函数,组件只调它:
const on = (el, ev, fn) => el.addEventListener ? el.addEventListener(ev, fn) : el.attachEvent('on' + ev, fn)这就是最小的外观。兼容逻辑以后要改,只改这一处。
封装的
request不支持上传进度,大家开始直接用axios,说明什么?说明外观没覆盖真实场景,变成了限制。补一个受控的扩展口,比如允许透传
onUploadProgress,而不是让大家各自绕过;但也别把axios所有配置原样透出去,那封装就没意义了。对接一个命名混乱的老系统,新页面只想「查用户并展示」,怎么做?
给老系统包一层
userFacade.getUserProfile(id),里面去调那几个乱七八糟的旧接口、做字段转换。新代码只认这个干净的接口,老系统以后下线也只改这一层。外观模式和代理模式都是「包一层」,怎么区分?
看包的是几个东西、接口变没变。外观面对一组子系统,重新设计了一个更简单的接口;代理只包一个对象,接口和原对象保持一致,目的是控制访问。
有人提议所有能力都只通过一个巨大的
Facade暴露,你同意吗?不同意。一个入口管所有东西,改一处影响全部调用方,也违反开闭原则。按业务领域拆成几个小外观,比如
userApi、orderApi,各自稳定演进。
# 2. 代理模式
⚡ 30 秒速记
- 代理模式 = 给对象找个替身,调用方以为在用原对象,替身来决定什么时候、能不能真的访问
- 接口和目标对象保持一致,这是它和外观、适配器的区别
- 常见变体:虚拟代理(图片懒加载、延迟创建)、缓存代理(结果记忆化)、保护代理(权限校验)
- 语言级支持:
ES6的Proxy有13种拦截器,Vue 3响应式就靠它拦截读写 - 和装饰器的区别:代理重在控制访问,装饰器重在叠加功能;事件委托常被举作例子,但严格说更像「委托」
代理模式就是给目标对象安排一个替身,外面的人跟替身打交道,替身决定要不要、什么时候把请求转给本人。 书里送花的例子就是这样:小明不直接送,交给了解女孩心情的朋友,由朋友挑合适的时机再转交。前端更常见的是图片懒加载,先显示占位图,真图加载完再替换;还有接口缓存代理,同样的参数直接返回上次的结果。ES6 的 Proxy 把这个模式做进了语言里,Vue 3 的 reactive 就是用它拦截 get / set 做依赖收集和触发更新。
是为一个对象提供一个代用品或占位符,以便控制对它的访问
假设当A 在心情好的时候收到花,小明表白成功的几率有60%,而当A 在心情差的时候收到花,小明表白的成功率无限趋近于0。小明跟A 刚刚认识两天,还无法辨别A 什么时候心情好。如果不合时宜地把花送给A,花被直接扔掉的可能性很大,这束花可是小明吃了7 天泡面换来的。但是A 的朋友B 却很了解A,所以小明只管把花交给B,B 会监听A 的心情变化,然后选择A 心情好的时候把花转交给A,代码如下:
let Flower = function() {}
let xiaoming = {
sendFlower: function(target) {
let flower = new Flower()
target.receiveFlower(flower)
}
}
let B = {
receiveFlower: function(flower) {
A.listenGoodMood(function() {
A.receiveFlower(flower)
})
}
}
let A = {
receiveFlower: function(flower) {
console.log('收到花'+ flower)
},
listenGoodMood: function(fn) {
setTimeout(function() {
fn()
}, 1000)
}
}
xiaoming.sendFlower(B)
场景
HTML元 素事件代理
<ul id="ul">
<li>1</li>
<li>2</li>
<li>3</li>
</ul>
<script>
let ul = document.querySelector('#ul');
ul.addEventListener('click', event => {
console.log(event.target);
});
</script>
优点
- 代理模式能将代理对象与被调用对象分离,降低了系统的耦合度。代理模式在客户端和目标对象之间起到一个中介作用,这样可以起到保护目标对象的作用
- 代理对象可以扩展目标对象的功能;通过修改代理对象就可以了,符合开闭原则;
缺点
处理请求速度可能有差别,非直接访问存在开销
💬 面试官追问
中间层只是把原方法改了个名字,算代理模式吗?
不算。代理的意义在于控制访问,延迟、缓存、校验至少占一样,而且接口要和原对象一致。只改名既不控制也不保持接口,就是普通封装。
用
Proxy写一个缓存代理,大概怎么写?拦截函数调用,按参数缓存结果:
const cached = fn => { const m = new Map(); return new Proxy(fn, { apply: (t, ctx, args) => { const k = JSON.stringify(args); if (!m.has(k)) m.set(k, t(...args)); return m.get(k) } }) }调用方式不变,第二次同参调用直接走缓存。
Vue 3为什么用Proxy替换了Vue 2的Object.defineProperty?defineProperty只能劫持已有属性,新增、删除属性和数组下标改值都监听不到,Vue 2只能靠$set补。Proxy代理整个对象,这些操作都能拦到,而且是访问到才递归代理,初始化更快。事件委托点列表项,偶尔会触发父容器空白处的逻辑,怎么修?
别直接用
event.target,它可能是li里的span,也可能是ul本身。用const li = e.target.closest('li'),再判断li && ul.contains(li),不满足就直接return。权限校验写在每个服务方法里,还是放在保护代理里?
我倾向放代理,校验逻辑集中一处,服务对象保持干净,加新服务也不用重复写。代价是多一层转发,排查时调用栈会深一点。
# 3. 工厂模式
⚡ 30 秒速记
- 工厂模式 = 把
new收起来,调用方只说要什么,不关心怎么造、具体是哪个类 - 简单工厂:一个函数按参数返回不同对象(最常用)
- 工厂方法:创建逻辑交给子类决定;抽象工厂:一次造一整套相关对象,比如一套主题组件
- 前端例子:
document.createElement、axios.create()、低代码按type渲染不同控件 - 别过度设计:只有一种产品、构造很简单时,直接
new就好
工厂模式就是把「造对象」这件事集中到一个地方,调用方说个名字就能拿到成品,不用知道具体是哪个类、要传什么参数。 前端最典型的是低代码表单,配置里写 type: 'select',工厂返回对应的组件,渲染层不用写一长串 if/else。axios.create() 也是工厂,按配置造出不同的请求实例。它的价值在创建逻辑复杂或者类型会不断增加的时候;如果就一种对象,构造函数也简单,硬套工厂只会多一层抽象,读代码的人还得多跳一次。
工厂模式定义一个用于创建对象的接口,这个接口由子类决定实例化哪一个类。该模式使一个类的实例化延迟到了子类。而子类可以重写接口方法以便创建的时候指定自己的对象类型。
class Product {
constructor(name) {
this.name = name
}
init() {
console.log('init')
}
fun() {
console.log('fun')
}
}
class Factory {
create(name) {
return new Product(name)
}
}
// use
let factory = new Factory()
let p = factory.create('p1')
p.init()
p.fun()
场景
- 如果你不想让某个子系统与较大的那个对象之间形成强耦合,而是想运行时从许多子系统中进行挑选的话,那么工厂模式是一个理想的选择
- 将new操作简单封装,遇到new的时候就应该考虑是否用工厂模式;
- 需要依赖具体环境创建不同实例,这些实例都有相同的行为,这时候我们可以使用工厂模式,简化实现的过程,同时也可以减少每种对象所需的代码量,有利于消除对象间的耦合,提供更大的灵活性
优点
- 创建对象的过程可能很复杂,但我们只需要关心创建结果。
- 构造函数和创建者分离, 符合“开闭原则”
- 一个调用者想创建一个对象,只要知道其名称就可以了。
- 扩展性高,如果想增加一个产品,只要扩展一个工厂类就可以。
缺点
- 添加新产品时,需要编写新的具体产品类,一定程度上增加了系统的复杂度
- 考虑到系统的可扩展性,需要引入抽象层,在客户端代码中均使用抽象层进行定义,增加了系统的抽象性和理解难度
什么时候不用
当被应用到错误的问题类型上时,这一模式会给应用程序引入大量不必要的复杂性.除非为创建对象提供一个接口是我们编写的库或者框架的一个设计上目标,否则我会建议使用明确的构造器,以避免不必要的开销。
由于对象的创建过程被高效的抽象在一个接口后面的事实,这也会给依赖于这个过程可能会有多复杂的单元测试带来问题。
💬 面试官追问
只有一个
Product类,同事坚持先抽AbstractFactory,你同意吗?不同意。只有一种产品、构造也没分支,工厂带来的只是多一层跳转。等真的出现第二、第三种产品再抽也不晚。
低代码表单渲染层堆了十几个
if/else创建控件,怎么改?换成注册表式的工厂:
const registry = { input: Input, select: Select, date: DatePicker } const create = (cfg) => { const C = registry[cfg.type]; if (!C) throw new Error(`未知控件 ${cfg.type}`); return new C(cfg) }新增控件只往表里加一行。
新增了
video类型,页面报Cannot read properties of undefined (reading 'init'),查哪?工厂没认出
video,返回了undefined,调用方一调init就炸。先看注册表里有没有这一项、配置里的type拼写对不对;工厂本身应该对未知类型直接抛错,而不是静默返回空。浏览器用
WebUploader,桌面端用NativeUploader,环境判断放哪?放工厂里,业务只调
createUploader().upload(file)。前提是两个实现的upload()签名和返回值真的一致,否则判断只是从工厂挪到了调用处。插件平台让第三方加控件,中心化
switch和插件自己注册怎么选?控件只由核心团队维护就用
switch,一目了然;要开放给第三方就用注册式,比如registerControl('rate', Rate)。注册式要额外处理重名覆盖和接口校验。
# 4. 单例模式
⚡ 30 秒速记
- 单例 = 一个类全局只有一个实例,大家拿到的都是同一个
JS里最简单的单例就是ES module:export default new Store(),模块只执行一次- 经典写法:闭包里缓存实例,
getInstance()没有就创建、有就直接返回(惰性单例) - 适合:全局弹窗、登录框、
store、日志上报、WebSocket连接 - 代价:本质是全局状态,测试难隔离、依赖关系藏起来;
SSR下模块单例会被所有请求共享,容易串数据
单例就是保证某个东西全局只有一份,谁来要都给同一个。 在 JS 里用闭包缓存实例,getInstance() 第一次调用时创建,之后直接返回,这叫惰性单例,登录框、全局 Toast 很适合。其实现在更常见的写法是 ES module,模块只会执行一次,export 出去的实例天然就是单例。但我对单例一直比较谨慎,它本质是全局状态,单元测试很难隔离;Next.js 这类 SSR 场景更要小心,模块级单例会被所有用户的请求共享,store 放在里面会把甲用户的数据渲染给乙用户。
顾名思义,单例模式中Class的实例个数最多为1。当需要一个对象去贯穿整个系统执行某些任务时,单例模式就派上了用场。而除此之外的场景尽量避免单例模式的使用,因为单例模式会引入全局状态,而一个健康的系统应该避免引入过多的全局状态。
实现单例模式需要解决以下几个问题:
- 如何确定Class只有一个实例?
- 如何简便的访问Class的唯一实例?
- Class如何控制实例化的过程?
- 如何将Class的实例个数限制为1?
我们一般通过实现以下两点来解决上述问题:
- 隐藏Class的构造函数,避免多次实例化
- 通过暴露一个
getInstance()方法来创建/获取唯一实例
Javascript中单例模式可以通过以下方式实现:
// 单例构造器
const FooServiceSingleton = (function () {
// 隐藏的Class的构造函数
function FooService() {}
// 未初始化的单例对象
let fooService;
return {
// 创建/获取单例对象的函数
getInstance: function () {
if (!fooService) {
fooService = new FooService();
}
return fooService;
}
}
})();
实现的关键点有:
- 使用 IIFE创建局部作用域并即时执行;
- getInstance() 为一个 闭包 ,使用闭包保存局部作用域中的单例对象并返回。
我们可以验证下单例对象是否创建成功:
const fooService1 = FooServiceSingleton.getInstance();
const fooService2 = FooServiceSingleton.getInstance();
console.log(fooService1 === fooService2); // true
场景例子
- 定义命名空间和实现分支型方法
- 登录框
- vuex 和 redux中的store
优点
- 划分命名空间,减少全局变量
- 增强模块性,把自己的代码组织在一个全局变量名下,放在单一位置,便于维护
- 且只会实例化一次。简化了代码的调试和维护
缺点
- 由于单例模式提供的是一种单点访问,所以它有可能导致模块间的强耦合
- 从而不利于单元测试。无法单独测试一个调用了来自单例的方法的类,而只能把它与那个单例作为一 个单元一起测试。
💬 面试官追问
每个筛选面板都有自己的
FilterModel,评审说改成单例省内存,同意吗?不同意。每个面板的筛选状态本来就该独立,改成单例两个面板会互相覆盖。单例是给「天然只该有一份」的东西用的,不是用来省实例的。
登录框多个入口都能打开,但只能有一个,怎么写?
惰性单例:
const getLoginModal = (() => { let modal; return () => modal || (modal = createModal()) })()所有入口都调
getLoginModal()。记得关闭时重置表单,不然下次打开还残留上次输的内容。store是模块级单例,单测想每个用例用不同初始状态,怎么办?导出一个
createStore(initialState)工厂,生产入口调一次得到全局store,测试里每个用例自己调一个新的。业务代码通过Provider拿store,而不是直接import那个实例。Next.js项目里把用户信息存在模块级变量里,会有什么问题?服务端进程是所有请求共享的,模块只加载一次,甲用户请求写进去的数据,乙用户的请求可能读到。服务端的请求级数据要放在请求作用域里,比如每次请求新建
store。页面上同时出现两个弹窗,日志里
getInstance()调了两次,单例失效了吗?先打印两次的返回值
===比一下。相等的话单例没问题,是展示状态没控制住,比如被挂载了两次。不相等就看缓存变量是不是写在了函数里面,每次调用都重新初始化了。
# 5. 策略模式
⚡ 30 秒速记
- 策略模式 = 一类行为的多种算法各自封装,放进一张表里按名字取用、随时替换
- 最直接的收益:用
strategies[type](...)替换大段if/else/switch - 前端例子:表单校验规则、不同会员等级的优惠计算、动画缓动函数、支付方式
- 加新规则只加一项,不动主流程,每个策略能单独测
- 坑:规则只有一两条时属于过度设计;策略表别和工厂混在一张表里,一个管「算」一个管「造」
策略模式就是把「同一件事的不同做法」分别装进盒子里,用的时候按名字挑一个。 表单校验最典型:非空、最小长度、手机号各写成一个函数放进 strategies 对象,校验器读配置 'minLength:6',拆出名字和参数,调对应的函数就行。主流程不再有一堆 if,产品加新规则时只往表里加一项,每个规则还能单独写单测。不过如果业务只有一条固定规则,直接写个函数就好,没必要为了还没出现的变化搭一整套。
策略模式简单描述就是:对象有某个行为,但是在不同的场景中,该行为有不同的实现算法。把它们一个个封装起来,并且使它们可以互相替换
<html>
<head>
<title>策略模式-校验表单</title>
<meta content="text/html; charset=utf-8" http-equiv="Content-Type">
</head>
<body>
<form id = "registerForm" method="post" action="http://xxxx.com/api/register">
用户名:<input type="text" name="userName">
密码:<input type="text" name="password">
手机号码:<input type="text" name="phoneNumber">
<button type="submit">提交</button>
</form>
<script type="text/javascript">
// 策略对象
const strategies = {
isNoEmpty: function (value, errorMsg) {
if (value === '') {
return errorMsg;
}
},
isNoSpace: function (value, errorMsg) {
if (value.trim() === '') {
return errorMsg;
}
},
minLength: function (value, length, errorMsg) {
if (value.trim().length < length) {
return errorMsg;
}
},
maxLength: function (value, length, errorMsg) {
if (value.length > length) {
return errorMsg;
}
},
isMobile: function (value, errorMsg) {
if (!/^(13[0-9]|14[5|7]|15[0|1|2|3|5|6|7|8|9]|17[7]|18[0|1|2|3|5|6|7|8|9])\d{8}$/.test(value)) {
return errorMsg;
}
}
}
// 验证类
class Validator {
constructor() {
this.cache = []
}
add(dom, rules) {
for(let i = 0, rule; rule = rules[i++];) {
let strategyAry = rule.strategy.split(':')
let errorMsg = rule.errorMsg
this.cache.push(() => {
let strategy = strategyAry.shift()
strategyAry.unshift(dom.value)
strategyAry.push(errorMsg)
return strategies[strategy].apply(dom, strategyAry)
})
}
}
start() {
for(let i = 0, validatorFunc; validatorFunc = this.cache[i++];) {
let errorMsg = validatorFunc()
if (errorMsg) {
return errorMsg
}
}
}
}
// 调用代码
let registerForm = document.getElementById('registerForm')
let validataFunc = function() {
let validator = new Validator()
validator.add(registerForm.userName, [{
strategy: 'isNoEmpty',
errorMsg: '用户名不可为空'
}, {
strategy: 'isNoSpace',
errorMsg: '不允许以空白字符命名'
}, {
strategy: 'minLength:2',
errorMsg: '用户名长度不能小于2位'
}])
validator.add(registerForm.password, [ {
strategy: 'minLength:6',
errorMsg: '密码长度不能小于6位'
}])
validator.add(registerForm.phoneNumber, [{
strategy: 'isMobile',
errorMsg: '请输入正确的手机号码格式'
}])
return validator.start()
}
registerForm.onsubmit = function() {
let errorMsg = validataFunc()
if (errorMsg) {
alert(errorMsg)
return false
}
}
</script>
</body>
</html>
场景例子
- 如果在一个系统里面有许多类,它们之间的区别仅在于它们的'行为',那么使用策略模式可以动态地让一个对象在许多行为中选择一种行为。
- 一个系统需要动态地在几种算法中选择一种。
- 表单验证
优点
- 利用组合、委托、多态等技术和思想,可以有效的避免多重条件选择语句
- 提供了对开放-封闭原则的完美支持,将算法封装在独立的strategy中,使得它们易于切换,理解,易于扩展
- 利用组合和委托来让Context拥有执行算法的能力,这也是继承的一种更轻便的代替方案
缺点
- 会在程序中增加许多策略类或者策略对象
- 要使用策略模式,必须了解所有的strategy,必须了解各个strategy之间的不同点,这样才能选择一个合适的strategy
💬 面试官追问
结算页只有一条「满
100减10」,同事拆了Context加三个占位策略,合理吗?不合理。现在只有一种算法,搭框架只会让人多跳几个文件。真有第二种规则时再抽,改动成本很小。
注册表单的校验全堆在
submit里,十几段if,怎么重构?拆成策略表,规则写成配置:
const strategies = { required: v => v !== '' || '必填', minLength: (v, n) => v.length >= n || `至少 ${n} 位` } const rules = [['required'], ['minLength', 6]] const errs = rules.map(([k, ...a]) => strategies[k](pwd, ...a)).filter(r => r !== true) // pwd 为 '123' 时输出 ['至少 6 位']submit只负责跑规则、收集错误。表单第一次校验正常,第二次提示「规则不存在」,可能是什么原因?
多半是解析规则时用
split后对共享数组做了shift(),第一次把策略名从原数组里拿掉了,第二次就取不到。解析时先拷贝一份,或者用解构const [name, ...args] = rule.split(':'),不改原数据。会员等级不同优惠算法不同,策略由谁来选?
由上下文选,比如
calcPrice(order, user.level)内部用等级去表里取策略。具体策略只管算钱,不关心自己什么时候被选中;表里取不到要有默认策略或者直接报错。策略模式和工厂模式都是一张映射表,有什么区别?
意图不同。工厂表返回的是一个对象,关心「造哪个」;策略表返回的是要执行的算法,关心「怎么算」。混在一张表里,生命周期和报错处理会搅在一起。
# 6. 迭代器模式
⚡ 30 秒速记
- 迭代器模式 = 按顺序一个个取元素,但不让调用方知道底层是数组、链表还是树
JS已内置:对象有[Symbol.iterator]()就能被for...of、展开...、解构、Array.from消费- 协议很小:
next()返回{ value, done },done: true时那一项不会进for...of - 自定义遍历优先写
function*,Generator对象既是迭代器又可迭代,省掉手写状态 - 简单数组别包一层迭代器类;结构会变、遍历规则有讲究时才值得
迭代器模式说白了就是「给我下一个」:调用方只管要下一个元素,不管容器内部怎么存。 传统写法是 hasNext() + next(),ES6 把它做进了语言:对象实现 [Symbol.iterator],返回一个有 next() 的对象,next() 每次给 { value, done },for...of、展开运算符就都能用了。我自己写一般直接用 Generator,比如 *[Symbol.iterator]() { for (let i = this.start; i < this.end; i++) yield i },三行搞定区间遍历。它真正的价值在容器结构会变的时候,比如数据从数组改成树,调用方的循环一行都不用动。
如果你看到这,ES6中的迭代器 Iterator 相信你还是有点印象的,上面第60条已经做过简单的介绍。迭代器模式简单的说就是提供一种方法顺序一个聚合对象中各个元素,而又不暴露该对象的内部表示。
迭代器模式解决了以下问题:
- 提供一致的遍历各种数据结构的方式,而不用了解数据的内部结构
- 提供遍历容器(集合)的能力而无需改变容器的接口
一个迭代器通常需要实现以下接口:
- hasNext():判断迭代是否结束,返回Boolean
- next():查找并返回下一个元素
为Javascript的数组实现一个迭代器可以这么写:
const item = [1, 'red', false, 3.14];
function Iterator(items) {
this.items = items;
this.index = 0;
}
Iterator.prototype = {
hasNext: function () {
return this.index < this.items.length;
},
next: function () {
return this.items[this.index++];
}
}
验证一下迭代器是否工作:
const iterator = new Iterator(item);
while(iterator.hasNext()){
console.log(iterator.next());
}
//输出:1, red, false, 3.14
ES6提供了更简单的迭代循环语法 for...of,使用该语法的前提是操作对象需要实现 可迭代协议(The iterable protocol),简单说就是该对象有个Key为 Symbol.iterator 的方法,该方法返回一个iterator对象。
比如我们实现一个 Range 类用于在某个数字区间进行迭代:
function Range(start, end) {
return {
[Symbol.iterator]: function () {
return {
next() {
if (start < end) {
return { value: start++, done: false };
}
return { done: true, value: end };
}
}
}
}
}
验证一下:
for (num of Range(1, 5)) {
console.log(num);
}
// 输出:1, 2, 3, 4
💬 面试官追问
报表页就固定三项数组,同事写了个带
hasNext()的迭代器类,你会留着吗?不留。数组本身就可迭代,
for...of直接用,多一个类就多一份要维护的状态。迭代器是给「结构会变、遍历规则复杂」的容器准备的,三项定长数组用不上。自定义
Range(1, 5)结果for...of打出了5,需求是只到4,查哪里?查
next()里边界判断和自增的顺序。正确写法是if (cur < end) return { value: cur++, done: false }; return { value: undefined, done: true },先判断再自增;done: true那一项for...of本来就不会消费,打出5说明是done: false时就把5返回了。分页数据内部按批次存成二维数组,业务方想直接
for...of拿到每一条,怎么暴露?在容器上写
*[Symbol.iterator]() { for (const batch of this.batches) yield* batch },批次细节全藏在里面。哪天改成链表存,只改这个生成器,业务代码不动。那异步分页呢,每页要请求一次接口?
用异步迭代器:
async *[Symbol.asyncIterator]()里await fetch每页然后yield*出去,调用方写for await (const item of list)。拉到哪页才请求哪页,天然懒加载。同一个迭代器对象能
for...of两次吗?手写的那种通常不行,第一遍跑完
index已经到头了,第二遍直接done。Generator对象也一样是一次性的。想反复遍历,就让[Symbol.iterator]()每次调用都返回一个新的迭代器,数组就是这么做的。
# 7. 观察者模式
⚡ 30 秒速记
- 观察者 = 被观察对象(
Subject)手里有一份观察者名单,状态一变挨个通知 - 三件套:
subscribe/unsubscribe/notify(有的叫fire) - 和发布订阅的差别:观察者里
Subject直接持有观察者;发布订阅中间多个事件中心,双方互不认识 - 前端例子:
Vue响应式(Dep收集Watcher)、MutationObserver、IntersectionObserver - 最常见的坑:组件卸载不取消订阅 → 回调还在跑、内存泄漏;通知时遍历快照,防止边遍历边删
观察者模式就像公众号推送:你关注了,它一更新就推给你,你取关就不推了。 落到代码就是 Subject 维护一个观察者数组,subscribe 往里加,unsubscribe 往外删,状态变化时 notify 遍历调用。好处是状态源不用知道谁在听,加一个新模块只要多订阅一次。严格说它和发布订阅不完全一样,发布订阅中间有个事件中心,发布方和订阅方完全不认识,Vue 2 的 EventBus 就是那种。实际踩得最多的坑是忘了取消订阅,页面卸载了回调还在执行,所以我写订阅一般让 subscribe 直接返回一个取消函数,在 useEffect 的清理里调用。
观察者模式又称发布-订阅模式(Publish/Subscribe Pattern),是我们经常接触到的设计模式,日常生活中的应用也比比皆是,比如你订阅了某个博主的频道,当有内容更新时会收到推送;又比如JavaScript中的事件订阅响应机制。观察者模式的思想用一句话描述就是:被观察对象(subject)维护一组观察者(observer),当被观察对象状态改变时,通过调用观察者的某个方法将这些变化通知到观察者。
观察者模式中Subject对象一般需要实现以下API:
- subscribe(): 接收一个观察者observer对象,使其订阅自己
- unsubscribe(): 接收一个观察者observer对象,使其取消订阅自己
- fire(): 触发事件,通知到所有观察者
用JavaScript手动实现观察者模式:
// 被观察者
function Subject() {
this.observers = [];
}
Subject.prototype = {
// 订阅
subscribe: function (observer) {
this.observers.push(observer);
},
// 取消订阅
unsubscribe: function (observerToRemove) {
this.observers = this.observers.filter(observer => {
return observer !== observerToRemove;
})
},
// 事件触发
fire: function () {
this.observers.forEach(observer => {
observer.call();
});
}
}
验证一下订阅是否成功:
const subject = new Subject();
function observer1() {
console.log('Observer 1 Firing!');
}
function observer2() {
console.log('Observer 2 Firing!');
}
subject.subscribe(observer1);
subject.subscribe(observer2);
subject.fire();
//输出:
Observer 1 Firing!
Observer 2 Firing!
验证一下取消订阅是否成功:
subject.unsubscribe(observer2);
subject.fire();
//输出:
Observer 1 Firing!
场景
- DOM事件
document.body.addEventListener('click', function() {
console.log('hello world!');
});
document.body.click()
- vue 响应式
优点
- 支持简单的广播通信,自动通知所有已经订阅过的对象
- 目标对象与观察者之间的抽象耦合关系能单独扩展以及重用
- 增加了灵活性
- 观察者模式所做的工作就是在解耦,让耦合的双方都依赖于抽象,而不是依赖于具体。从而使得各自的变化都不会影响到另一边的变化。
缺点
过度使用会导致对象与对象之间的联系弱化,会导致程序难以跟踪维护和理解
💬 面试官追问
单页应用跑了几个小时越来越卡,已卸载页面的回调还在执行,怎么查?
先在
subscribe和unsubscribe里打日志看观察者数组长度,一直涨就是漏取消了。最常见的原因是取消时传的不是同一个函数引用,比如订阅用了箭头函数,取消时又新建了一个。让subscribe返回取消函数就能根治:const off = store.subscribe(fn); return off。通知过程中某个观察者把自己取消了,下一个观察者被跳过了,为什么?
forEach遍历的同时数组被splice了,索引往前挪了一位。通知前先拷一份快照[...this.observers].forEach(fn => fn()),本轮照常通知,删除下一轮生效。父子两个组件同步一个标题,同事上了全局事件总线,你同意吗?
不同意。父子关系用
props加回调就够了,数据从哪来一眼能看到。全局事件把调用链藏起来了,排查时只能全局搜事件名。观察者适合一个状态源要广播给多个互不相关的模块。登录状态变了,导航栏、个人中心、权限面板都要刷新,怎么设计?
做一个登录状态的
store,各模块subscribe自己的回调,组件卸载时取消。这其实就是zustand、Redux的subscribe干的事,自己手写也就二十行。某个观察者回调里抛了异常,后面的观察者还会收到通知吗?
朴素的
forEach实现不会,异常直接中断循环。要互不影响就在循环里给每个回调包try/catch,把错误上报,接着通知下一个。
# 8. 中介者模式
⚡ 30 秒速记
- 中介者 = 一群同级对象不再互相调用,都跟中介打交道,网状依赖变星型
N个对象两两通信最多N(N-1)/2条连线,有了中介就只剩N条- 前端例子:表单联动控制器、聊天室服务端、
Redux/Vuex的store(组件之间不直接通信) - 和观察者的区别:观察者只是广播通知;中介者手里有「谁变了该怎么联动」的协作规则
- 代价:规则全堆在中介里,
switch越写越长就成了上帝对象,要按业务拆
中介者模式就像婚介所:相亲双方不直接联系,都通过中介牵线。 前端最典型的就是商品规格选择:颜色、容量、数量三个控件,如果颜色变了直接去改容量,容量又去改数量,控件之间就缠成一团。改成每个控件只上报「我变了」,由中介者拿到完整选择,查一下比如 goods['red|32G'] 的库存,统一决定哪些选项可选、数量上限多少、按钮能不能点。这样加一个「套餐」控件,只改中介,不用碰其他控件。问题是交互越多中介越胖,我一般看到它超过十来个分支就按业务拆成几个子协调器。
- 在中介者模式中,中介者(Mediator)包装了一系列对象相互作用的方式,使得这些对象不必直接相互作用,而是由中介者协调它们之间的交互,从而使它们可以松散偶合。当某些对象之间的作用发生改变时,不会立即影响其他的一些对象之间的作用,保证这些作用可以彼此独立的变化。
- 中介者模式和观察者模式有一定的相似性,都是一对多的关系,也都是集中式通信,不同的是中介者模式是处理同级对象之间的交互,而观察者模式是处理Observer和Subject之间的交互。中介者模式有些像婚恋中介,相亲对象刚开始并不能直接交流,而是要通过中介去筛选匹配再决定谁和谁见面。
场景
例如购物车需求,存在商品选择表单、颜色选择表单、购买数量表单等等,都会触发change事件,那么可以通过中介者来转发处理这些事件,实现各个事件间的解耦,仅仅维护中介者对象即可。
var goods = { //手机库存
'red|32G': 3,
'red|64G': 1,
'blue|32G': 7,
'blue|32G': 6,
};
//中介者
var mediator = (function() {
var colorSelect = document.getElementById('colorSelect');
var memorySelect = document.getElementById('memorySelect');
var numSelect = document.getElementById('numSelect');
return {
changed: function(obj) {
switch(obj){
case colorSelect:
//TODO
break;
case memorySelect:
//TODO
break;
case numSelect:
//TODO
break;
}
}
}
})();
colorSelect.onchange = function() {
mediator.changed(this);
};
memorySelect.onchange = function() {
mediator.changed(this);
};
numSelect.onchange = function() {
mediator.changed(this);
};
- 聊天室里
聊天室成员类:
function Member(name) {
this.name = name;
this.chatroom = null;
}
Member.prototype = {
// 发送消息
send: function (message, toMember) {
this.chatroom.send(message, this, toMember);
},
// 接收消息
receive: function (message, fromMember) {
console.log(`${fromMember.name} to ${this.name}: ${message}`);
}
}
聊天室类:
function Chatroom() {
this.members = {};
}
Chatroom.prototype = {
// 增加成员
addMember: function (member) {
this.members[member.name] = member;
member.chatroom = this;
},
// 发送消息
send: function (message, fromMember, toMember) {
toMember.receive(message, fromMember);
}
}
测试一下:
const chatroom = new Chatroom();
const bruce = new Member('bruce');
const frank = new Member('frank');
chatroom.addMember(bruce);
chatroom.addMember(frank);
bruce.send('Hey frank', frank);
//输出:bruce to frank: hello frank
优点
- 使各对象之间耦合松散,而且可以独立地改变它们之间的交互
- 中介者和对象一对多的关系取代了对象之间的网状多对多的关系
- 如果对象之间的复杂耦合度导致维护很困难,而且耦合度随项目变化增速很快,就需要中介者重构代码
缺点
系统中会新增一个中介者对象,因为对象之间交互的复杂性,转移成了中介者对象的复杂性,使得中介者对象经常是巨大的。中介 者对象自身往往就是一个难以维护的对象。
💬 面试官追问
只有颜色、容量两个下拉,互相改一下就行,有必要上中介者吗?
两个控件、关系固定的话直接写没问题,强上中介反而多一层。等到第三、第四个控件加进来,联动规则开始交叉,再收进中介也来得及。
切换成蓝色后购买按钮还能点,但这个规格库存是
0,顺着哪条链查?先确认颜色控件的
change有没有调到mediator.changed,再看中介里拼出来的库存键对不对,最后看更新按钮那个分支有没有被执行。还要检查库存键是否重复;同一个对象里重复声明'blue|32G',后一个值会覆盖前一个。中介里的
changed(obj)已经有十几个case了,继续加还是拆?拆。按库存、促销、配送这类业务边界拆成几个协调器,各管各的控件,上面再有一层编排。但别拆得太碎,几个中介之间互相调用又变回网状了。
Redux的store算不算中介者?可以这么理解:组件之间不直接通信,都通过
dispatch和subscribe跟store打交道。不过reducer只算状态,不直接操作别的组件,它更像「中介者 + 观察者」的组合。聊天室里成员
A给B发消息,为什么不让A直接拿着B的引用调receive?成员一多,每个人都要持有所有人的引用,有人进出房间就得全员更新。让
chatroom当中介,A.send(msg, 'B')交给房间转发,房间顺便做鉴权、过滤和日志,成员只认识房间。
# 9. 访问者模式
⚡ 30 秒速记
- 访问者 = 把「对数据结构做的操作」拆出去,结构不动也能加新操作
- 双分派:元素
accept(visitor)把自己交出去,访问者按元素类型调对应的visitXxx - 适合「结构稳定、操作常加」:最真实的例子是
Babel插件visitor: { Identifier(path) {} }、ESLint规则、PostCSS插件 - 擅长加操作,不擅长加类型:新增一种节点,所有访问者都要补分支
- 只有一个类、一种操作时别用,直接写方法更清楚
访问者模式的意思是:数据结构固定,但要对它做的事一直在加,那就把这些「事」单独装进访问者里。 前端最熟的就是 Babel 插件:AST 的节点类型基本不变,但每个插件都想对它做点什么,于是写成 visitor: { CallExpression(path) { ... } },遍历器走到哪种节点就调对应的方法,加插件不用改 AST 定义。经典写法里元素有 accept(visitor),内部调 visitor.visit(this),这样同一个员工对象可以被「调薪」「统计」「导出」不同访问者处理。反过来它最怕节点类型频繁变化,每加一种节点,所有访问者都得补一遍。
访问者模式 是一种将算法与对象结构分离的设计模式,通俗点讲就是:访问者模式让我们能够在不改变一个对象结构的前提下能够给该对象增加新的逻辑,新增的逻辑保存在一个独立的访问者对象中。访问者模式常用于拓展一些第三方的库和工具。
// 访问者
class Visitor {
constructor() {}
visitConcreteElement(ConcreteElement) {
ConcreteElement.operation()
}
}
// 元素类
class ConcreteElement{
constructor() {
}
operation() {
console.log("ConcreteElement.operation invoked");
}
accept(visitor) {
visitor.visitConcreteElement(this)
}
}
// client
let visitor = new Visitor()
let element = new ConcreteElement()
elementA.accept(visitor)
访问者模式的实现有以下几个要素:
- Visitor Object:访问者对象,拥有一个visit()方法
- Receiving Object:接收对象,拥有一个 accept() 方法
- visit(receivingObj):用于Visitor接收一个Receiving Object
- accept(visitor):用于Receving Object接收一个Visitor,并通过调用Visitor的 visit() 为其提供获取Receiving Object数据的能力
简单的代码实现如下:
Receiving Object:
function Employee(name, salary) {
this.name = name;
this.salary = salary;
}
Employee.prototype = {
getSalary: function () {
return this.salary;
},
setSalary: function (salary) {
this.salary = salary;
},
accept: function (visitor) {
visitor.visit(this);
}
}
Visitor Object:
function Visitor() { }
Visitor.prototype = {
visit: function (employee) {
employee.setSalary(employee.getSalary() * 2);
}
}
验证一下:
const employee = new Employee('bruce', 1000);
const visitor = new Visitor();
employee.accept(visitor);
console.log(employee.getSalary());//输出:2000
场景
对象结构中对象对应的类很少改变,但经常需要在此对象结构上定义新的操作
需要对一个对象结构中的对象进行很多不同的并且不相关的操作,而需要避免让这些操作"污染"这些对象的类,也不希望在增加新操作时修改这些类。
优点
- 符合单一职责原则
- 优秀的扩展性
- 灵活性
缺点
- 具体元素对访问者公布细节,违反了迪米特原则
- 违反了依赖倒置原则,依赖了具体类,没有依赖抽象。
- 具体元素变更比较困难
💬 面试官追问
工资系统只有一个
Employee类、一个「薪资翻倍」操作,也要上访问者?不用,直接写个
employee.setSalary(employee.getSalary() * 2)就完了。访问者的成本是多一套accept/visit的分派,只有操作会持续增加的时候才划算。编辑器新增了
VideoNode,HTML导出正常,但字数统计漏掉了视频,先查哪?先看统计访问者有没有实现
visitVideoNode,再看VideoNode.accept调的是不是对应方法。这正是访问者的软肋,加类型容易漏某个访问者;用TS把访问者定义成接口,每种节点一个必填方法,漏写编译就报错。写个
Babel插件把所有console.log删掉,访问者怎么写?visitor: { CallExpression(path) { if (path.get('callee').matchesPattern('console.log')) path.remove() } }。你只声明关心哪种节点,遍历由@babel/traverse负责,这就是访问者模式最直观的样子。一个团队节点类型半年不变但导出格式年年加,另一个团队每周加新节点,谁适合访问者?
前者。导出格式就是不断新增的操作,一种格式一个访问者,互不影响。后者每加一种节点就要改全部访问者,用访问者是给自己找事。
为什么说访问者会破坏封装?
访问者要读写元素的数据,元素就得把
getSalary、setSalary这类内部细节暴露出来。操作和节点核心职责关系很紧、数量也不多的时候,放回节点类里反而更好维护。
# 十二、综合问题
# 前端常见面试流程
⚡ 30 秒速记
- 常见流程:简历筛选 → 笔试或机试(不一定有)→ 技术一面 → 技术二面 → 交叉面或主管面 →
HR面 - 一面看基础:
JS、CSS、浏览器原理、网络、手写题 - 二面看项目:为什么这么选型、难点怎么解决、你本人做了什么、结果有没有数字
- 主管面看潜力和协作;
HR面看稳定性、动机和薪资预期 - 轮次因公司而异,小公司可能两轮就结束,大厂可能加一轮交叉面
前端面试一般是「基础 → 项目 → 综合 → HR」一路往上走,每轮问的东西不一样,准备也要分开。 一面基本是八股和手写题,答准、答清楚就行;二面会顺着你的简历挖项目,最怕的是说不清自己到底做了什么;主管面更像聊天,看你怎么想问题、能不能带人或者被带;HR 面主要确认动机和稳定性,顺带谈薪。流程不是固定的,有的公司笔试放最前面,有的直接视频面,投之前问一下 HR 或内推人,心里有数。
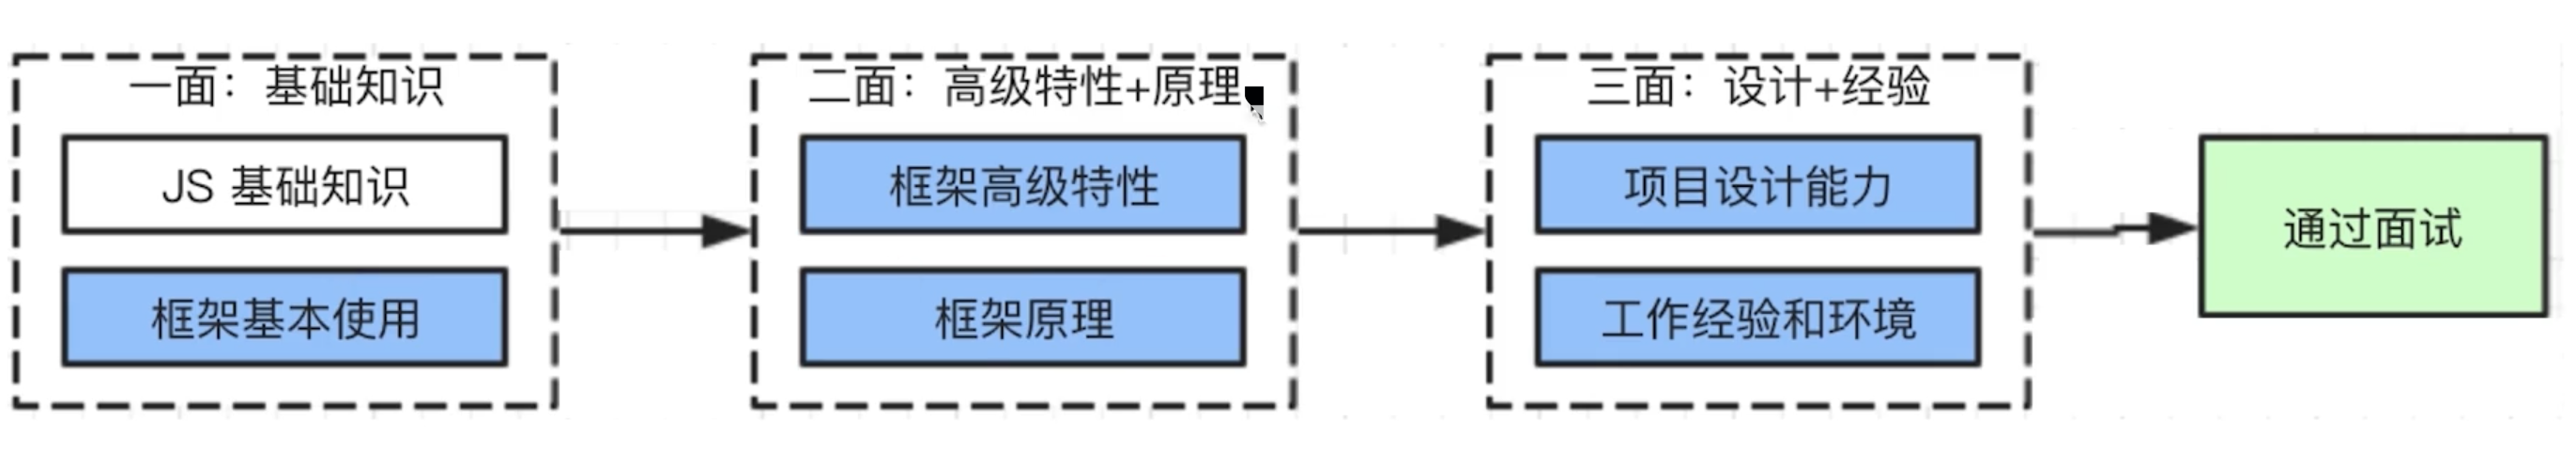
一般的前端社招流程大致是下面这样,不同公司会有增减:
| 轮次 | 谁来面 | 主要看什么 |
|---|---|---|
| 简历筛选 | HR 或用人团队 | 年限、技术栈、项目和岗位是否对口 |
| 笔试 / 机试 | 线上系统 | 手写题、算法,不少公司会跳过 |
| 技术一面 | 一线同事 | JS / CSS / 浏览器 / 网络基础,手写代码 |
| 技术二面 | 组长或资深工程师 | 项目深挖、方案设计、工程化 |
| 交叉面 / 主管面 | 其他组负责人或部门负责人 | 思考方式、协作、成长性 |
HR 面 | HR | 动机、稳定性、薪资预期 |
准备的时候按轮次分开:一面靠平时积累和刷题;二面靠提前把两三个项目梳理清楚,每个项目准备「背景、我的职责、难点、方案对比、结果数字」;主管面准备几个真实的协作和成长故事;HR 面提前想好离职原因和期望薪资区间。每轮结束后当天把被问倒的题记下来,下一场之前补上,这一步比多投几家更有用。
💬 面试官追问
一面基础都答上来了,二面被项目问挂了,一般是哪里出问题?
多半是讲不清自己做了什么。说「我们做了性能优化」,面试官一追问「哪个指标、你改了哪段代码、怎么验证的」就答不上。项目要按「背景、我的动作、结果数字」准备好,每个点能经得起追问两层。
主管面和技术面的区别是什么,怎么准备?
技术面看你会不会,主管面看你怎么想、怎么协作。会问「方案和同事冲突怎么办」「最近在学什么」「三年后想做什么」,准备两三个真实例子比背答案管用。
每一轮最后让你提问,问什么比较好?
技术面问团队技术栈和这个岗位最近要解决的问题;主管面问团队规划和对新人的期望;
HR面问流程和入职时间。别问能在官网查到的东西,也别第一轮就问加班多不多。面完一轮迟迟没消息,要不要追问?
可以,一般等三到五个工作日没动静,礼貌地问一下
HR进度就行。有的公司要等同岗位候选人都面完才统一推进,没消息不一定是挂了。笔试或机试一般考什么,怎么准备?
常见的是手写题(防抖节流、
Promise、深拷贝)加一两道算法,难度大多在LeetCode简单到中等。平时把常见手写题自己从零敲一遍,别只看答案。
# 面试一定要问这几个问题
⚡ 30 秒速记
- 反问是面试的一部分,也是你筛公司的机会,别说「没有问题了」
- 业务:做什么产品、用户规模多大 → 判断是不是核心业务
- 团队:前端几个人、怎么分工、我进去是什么角色 → 判断协作是否规范
- 技术:技术栈、历史包袱、有没有组件库 / 监控 /
CI→ 判断技术是否老旧 - 岗位:这个位置最急着解决的是什么、试用期怎么评估
- 警惕信号:业务说不清、回避问题、反复强调「要能吃苦」
面试最后让你提问,一定要问,而且要问能帮你判断这份工作值不值得去的问题。 我一般问三类:业务是什么、多少人在用,这决定是不是核心部门;前端团队几个人、怎么分工,这能看出协作规不规范;技术栈和对接哪些团队,能看出项目新旧和历史包袱。再加一句「这个岗位进去最先要解决什么问题」,对方的回答基本就是你入职后的头三个月。对方答得含糊可以追问一句日常工作,但别凭一句话就下结论。
最后一个问题:面试官问,你想了解什么(面试一定要问这几个问题)
- 部门所做的产品和业务(赛道),产品的用量和规模(看产品是否核心)
- 部门有多少人,有什么角色(看部门是否规范)
- 项目的技术栈,以及对接的其他技术团队(看技术栈是否老旧)
反问环节可以按「业务、团队、技术、岗位」准备一份清单,面试时挑三四个问:
- 业务:这个部门做什么产品?日活或用户规模大概多少?在公司里是核心业务还是探索业务?
- 团队:前端几个人,怎么分工?有没有专人做基建?对接哪些团队(后端、客户端、设计)?
- 技术:主要技术栈是什么?有没有组件库、监控、自动化测试和
CI流程?有没有比较重的历史包袱? - 岗位:这个岗位最急着解决的问题是什么?试用期怎么评估?
听回答的时候注意两点:一是具体程度,说得出项目名、人数、数字的,说明团队状态清楚;二是有没有回避,问到技术债或流程时一直绕开,往往说明问题不小。反问不是为了显得自己积极,是为了拿到判断要不要去的信息,问完记在本子上,几家对比时很有用。
💬 面试官追问
面试官说「我们业务挺多的,都会接触」,这算好回答吗?
不算,太含糊了。可以接着问「那最近一个季度前端主要在做哪个项目」,说得出具体项目和目标的,团队通常方向比较清楚。
问「加班多不多」合适吗?
直接问容易显得在意错地方。换个问法:「项目一般怎么排期,上线节奏是怎样的」,从迭代频率和发布方式里就能听出强度。
前端只有一个人,你会怎么看这个岗位?
要看是什么阶段。新业务的话成长快、什么都要扛,但没人带、没人
Code Review;如果是老业务只有一个人维护,就得问清楚历史代码情况。我会接着问后续有没有扩招计划。技术面和
HR面,反问的问题一样吗?不一样。技术面问技术栈、项目挑战、团队技术氛围;
HR面问流程、试用期考核、调薪和晋升机制。跟技术面试官聊薪资福利,对方大多也答不上来。对方说技术栈是
jQuery加Vue 2,你会直接放弃吗?不一定。先问有没有迁移计划、给不给时间做。老项目重构做好了是很好的项目经历;最怕的是明确说「不打算改,也不给时间」,那就只剩维护了。
# 经历
⚡ 30 秒速记
- 讲经历按时间线串,但重点不是时间点,是每次选择背后的原因
- 准备三件事:最骄傲的一件、最难的一件、最挫败的一件,各讲清原因和收获
- 用
STAR讲:背景 → 任务 → 我做了什么 → 结果,重点放在「我做了什么」和结果 - 结果尽量带数字,比如「首屏从
4s降到1.5s」比「优化了性能」有说服力得多 - 未来规划要和这个岗位能对上,别编,也别说得太虚
讲经历不是报流水账,而是让面试官看懂你每一步为什么这么走、现在走到了哪。 可以从怎么接触前端讲起,但很快就要落到几件关键的事上:最骄傲的事说清楚你具体做了什么、结果怎样;最难或最挫败的事要讲当时怎么判断、后来怎么调整的,挫败经历讲好了其实很加分,因为能看出你会复盘。最后说规划,和你要应聘的岗位挂上钩,比如「接下来想在工程化方向深入,这也是我投这个岗位的原因」。全程别背稿,留出让对方追问的口子。
- 整个经历自我介绍,越详细越好,什么时候接触计算机,什么时候接触前端。
- 整个经历中,你认为最值得骄傲的事情,最难的事情是什么。
- 什么事情让你自豪,什么事情让你有挫败感。
- 未来的发展,自己的规划。
讲个人经历可以参考这个结构,整体控制在三到五分钟:
- 一两句交代起点:什么时候开始做前端,现在几年经验,主要做哪类业务。
- 一到两段关键经历,每段按
STAR讲:背景是什么,你负责什么,你具体做了哪些事,结果怎样(尽量有数字)。 - 一件难事或挫败的事:当时卡在哪,你怎么判断的,后来怎么解决或者怎么复盘的。
- 一两句规划:接下来想往哪个方向深入,为什么这个岗位能帮你走这条路。
几个容易扣分的地方:把团队成果说成个人成果,一追问就答不上;只有形容词没有事实,比如「我很能抗压」;挫败经历讲成变相夸自己。经历本身不用多耀眼,讲得清楚、真实、经得起追问,比堆名词强很多。
💬 面试官追问
你说最骄傲的是做了性能优化,具体是你做的还是团队做的?
要分清楚说。比如「方案是组里一起定的,图片懒加载和接口合并这两块是我写的,
LCP从3.8s降到2.1s」,范围说清楚比全揽在自己身上可信得多。讲一件让你挫败的事,别讲那种「其实是优点」的。
就讲真实的失误,比如「评估排期太乐观,上线前一周才发现兼容问题,最后延期了两天」。重点放在之后改了什么,比如现在排期会预留兼容测试时间。
你一年换了两份工作,怎么解释?
如实说原因,但落到自己的选择上,比如「第一家业务调整整个组解散了,第二家是想找更偏工程化的方向」。别抱怨前公司,也别临时编理由,背调一查就露馅。
三年后你想做什么?
给一个和岗位有关的具体方向,比如「先把业务和工程化做扎实,往能独立负责一个模块的方向走」。别说「想当架构师」这种没有路径的话,也别说「还没想好」。
你的经历里没有大厂背景,怎么讲出亮点?
讲深度而不是规模。比如在小团队里独立搭了组件库、做了监控接入,把「从零到一」的过程和取舍讲清楚,一样有说服力。
# 项目相关
⚡ 30 秒速记
- 介绍项目四件事:做什么的 / 你负责哪块 / 为什么这么选型 / 最难的地方怎么解决
- 先给规模:多少用户、多少页面、几个人做,面试官才有参照
- 选型讲取舍:为什么选
A不选B、付出了什么代价,只说优点显得没想过 - 常被追问:优化思路、代码规范方案、怎么测试、为什么引入
TS、从零搭项目考虑什么 - 别夸大参与度,追两层就露馅
介绍项目我一般按「背景规模 → 我的职责 → 技术选型 → 难点和结果」四步讲,两三分钟说完,细节留给面试官追问。 背景要有数字,比如「一个日活几万的后台,40 多个页面,前端三个人」;职责要具体到模块,不要说「参与了开发」。选型重点是讲为什么,比如引入 TS 是因为接口字段经常变、联调老出问题,引入后类型不对编译就报错。难点按「怎么发现、怎么分析、怎么解决、效果怎样」讲。被问到从零搭项目,就说目录规范、ESLint 和 Prettier、CI 检查、监控这些,按项目规模来,不要为了显得专业过度设计。
- 项目难点。(如何发现问题,解决思路,最后结果)
- 项目考虑过优化吗,你是如何优化的,思路是什么。
- 项目的组织架构,你对它的现有架构的理解,哪些优点值得借鉴,哪些缺点需要改进。
- 如果让你从0到1建一个项目,你考虑的点是什么,有哪些流程需要注意的。
- 如何进行技术选型,需要考虑哪些点。
- 项目中代码规范,你们项目有方案吗,你了解的代码规范有哪些方案。
- 说一说项目中你们是如何测试的,有哪些单元测试方案,能不能说一说。
- 项目中引入TS的原因,为什么这么做。
💬 面试官追问
你们为什么用
React不用Vue?如实说决策原因,比如团队已有的技术积累、组件库生态、招人成本。如果是入职前就定了,就直说「是之前定的」,然后说说你用下来觉得它的优缺点,别硬编一套选型理由。
项目里引入
TS带来了什么,有没有代价?好处是接口字段改了编译期就报错,重构敢动,编辑器提示也全。代价是初期写类型慢一些,第三方库类型不全时要自己补
.d.ts。我会说一个具体例子,比如后端改了字段名,tsc直接列出所有要改的地方。你们项目怎么做代码规范的?
ESLint管代码质量,Prettier管格式,husky加lint-staged在提交前只检查改动的文件,commitlint管提交信息。光有工具不够,还要放进CI,不过就不能合并。项目有单元测试吗,测了什么?
如实回答。有的话说清楚用
Vitest或Jest测了哪些东西,比如工具函数、核心的表单校验逻辑;没有就说没有,再说说你觉得哪部分最值得先补测试,别装作覆盖率很高。如果让你从零搭一个中后台项目,你先做哪几件事?
先定技术栈和目录规范,接上代码规范和提交检查,封装请求层和权限,再接监控和
CI部署。组件库、微前端这类看规模再说,先把能跑、能协作的骨架搭起来。
# 项目难点问题分析
⚡ 30 秒速记
- 难点 ≠ 工作量大:加班写完
20个页面不叫难点,有分析、有取舍的才算 - 讲法:现象和影响 → 排查过程 → 根因 → 方案对比 → 结果 → 以后怎么避免
- 排查过程最能体现能力,别一句「后来发现是某某问题」带过
- 平时遇到问题就写复盘;没积累的话,回想半年内最头疼的一个问题现在就写下来
- 例子:编辑器只认
JSON,老数据是HTML→ 写一层反解析把旧数据转成JSON,老用户无感
项目难点不一定要多罕见,关键是讲清楚你怎么分析、怎么选方案、最后效果怎样。 我一般用「问题、解决、成长」三段讲:先说背景和现象,以及它造成了什么影响;再讲怎么定位到原因、考虑过哪几种方案、为什么选了这个;最后说学到了什么、以后怎么避免。比如编辑器升级后只能回显 JSON,老版本存的是 HTML,打开旧文档就是空白;方案可以是批量迁移数据,也可以加载时反解析,后者不用动库、风险小,就选了它。复盘的收获是设计数据格式时一开始就要考虑版本兼容。
遇到问题要注意积累
- 每个人都会遇到问题,总有几个问题让你头疼
- 日常要注意积累,解决了问题要自己写文章复盘
如果之前没有积累
- 回顾一下半年之内遇到的难题
- 思考当时解决方案,以及解决之后的效果
- 写一篇文章记录一下,答案就有了
答案模板
- 描述问题:背景 + 现象 + 造成的影响
- 问题如何被解决:分析 + 解决
- 自己的成长:学到了什么 + 以后如何避免
一个示例
- 问题:编辑器只能回显JSON格式的数据,而不支持老版本的HTML格式
- 解决:将老版本的HTML反解析成JSON格式即可解决
- 成长:要考虑完整的输入输出 + 考虑旧版本用户 + 参考其他产品
💬 面试官追问
你说的难点听起来就是工作量大,技术上难在哪?
这时候要补出判断和取舍。比如「表面是改了很多页面,真正难的是新旧两套状态管理要共存三个月,我设计了一层适配让两边数据同步」。讲不出取舍,那确实就不算难点。
编辑器那个例子,为什么不直接把库里的旧数据批量转成
JSON?批量迁移要动线上数据,一旦转换规则有漏洞就不好回滚。加载时反解析不改原数据,出问题改代码就行;等反解析稳定一段时间后,再考虑后台慢慢迁移。
怎么证明你的方案有效?
给可以复现的指标,比如「旧文档打开失败率从约
5%降到接近0」「页面加载从3s到1.2s」,说清楚是用什么工具、在什么条件下测的。没有监控数据就说是怎么验证的,别编数字。如果再来一次,你会怎么做得更好?
这题是在看复盘能力。说一个具体改进,比如「当时没加埋点,上线后才知道还有一类旧格式没覆盖,下次会先统计线上数据格式分布再写转换规则」。
想不出项目难点怎么办?
回想最近半年让你最头疼、花时间最多的那个问题,把现象、排查、方案、结果写成一篇复盘。难点不一定高大上,排查过程讲得细、能经得起追问就行。
# 项目流程相关面试题
⚡ 30 秒速记
- 流程:需求评审 → 技术方案 → 排期 → 开发 → 联调 → 提测 → 上线 → 回归和复盘
- 需求阶段:了解背景、质疑是否合理、看需求闭环和依赖,别当场给排期
- 方案阶段:求简不过度设计,出文档,组内评审,和后端、客户端对齐接口
- 开发阶段:排期留缓冲,
Mock先行,写单测,Code Review - 中途加需求走变更流程重估排期;上线后通知
QA回归,出问题先回滚止损再排查
一个项目从需求到上线,前端要做的远不止写代码,核心是每个环节都提前对齐、控制风险。 需求评审时我会先问背景和目标,看需求有没有闭环、依赖谁,排期不当场给,回去评估完再说。方案阶段出一份简单的技术文档,跟后端先把接口字段定下来,前端用 Mock 并行开发。联调时让后端、设计、产品各自确认自己那部分。提测别跟 QA 说「我电脑上没问题」,上线后通知回归、同步项目组,真出问题先回滚再查。中途加需求不硬拒,走变更流程,让 leader 一起重估排期。
和前端开发相关的项目角色有哪些
PM产品经理UE视觉设计师FE前端开发RD后端开发CRD移动端开发QA测试人员
一个完整的项目要分哪些阶段
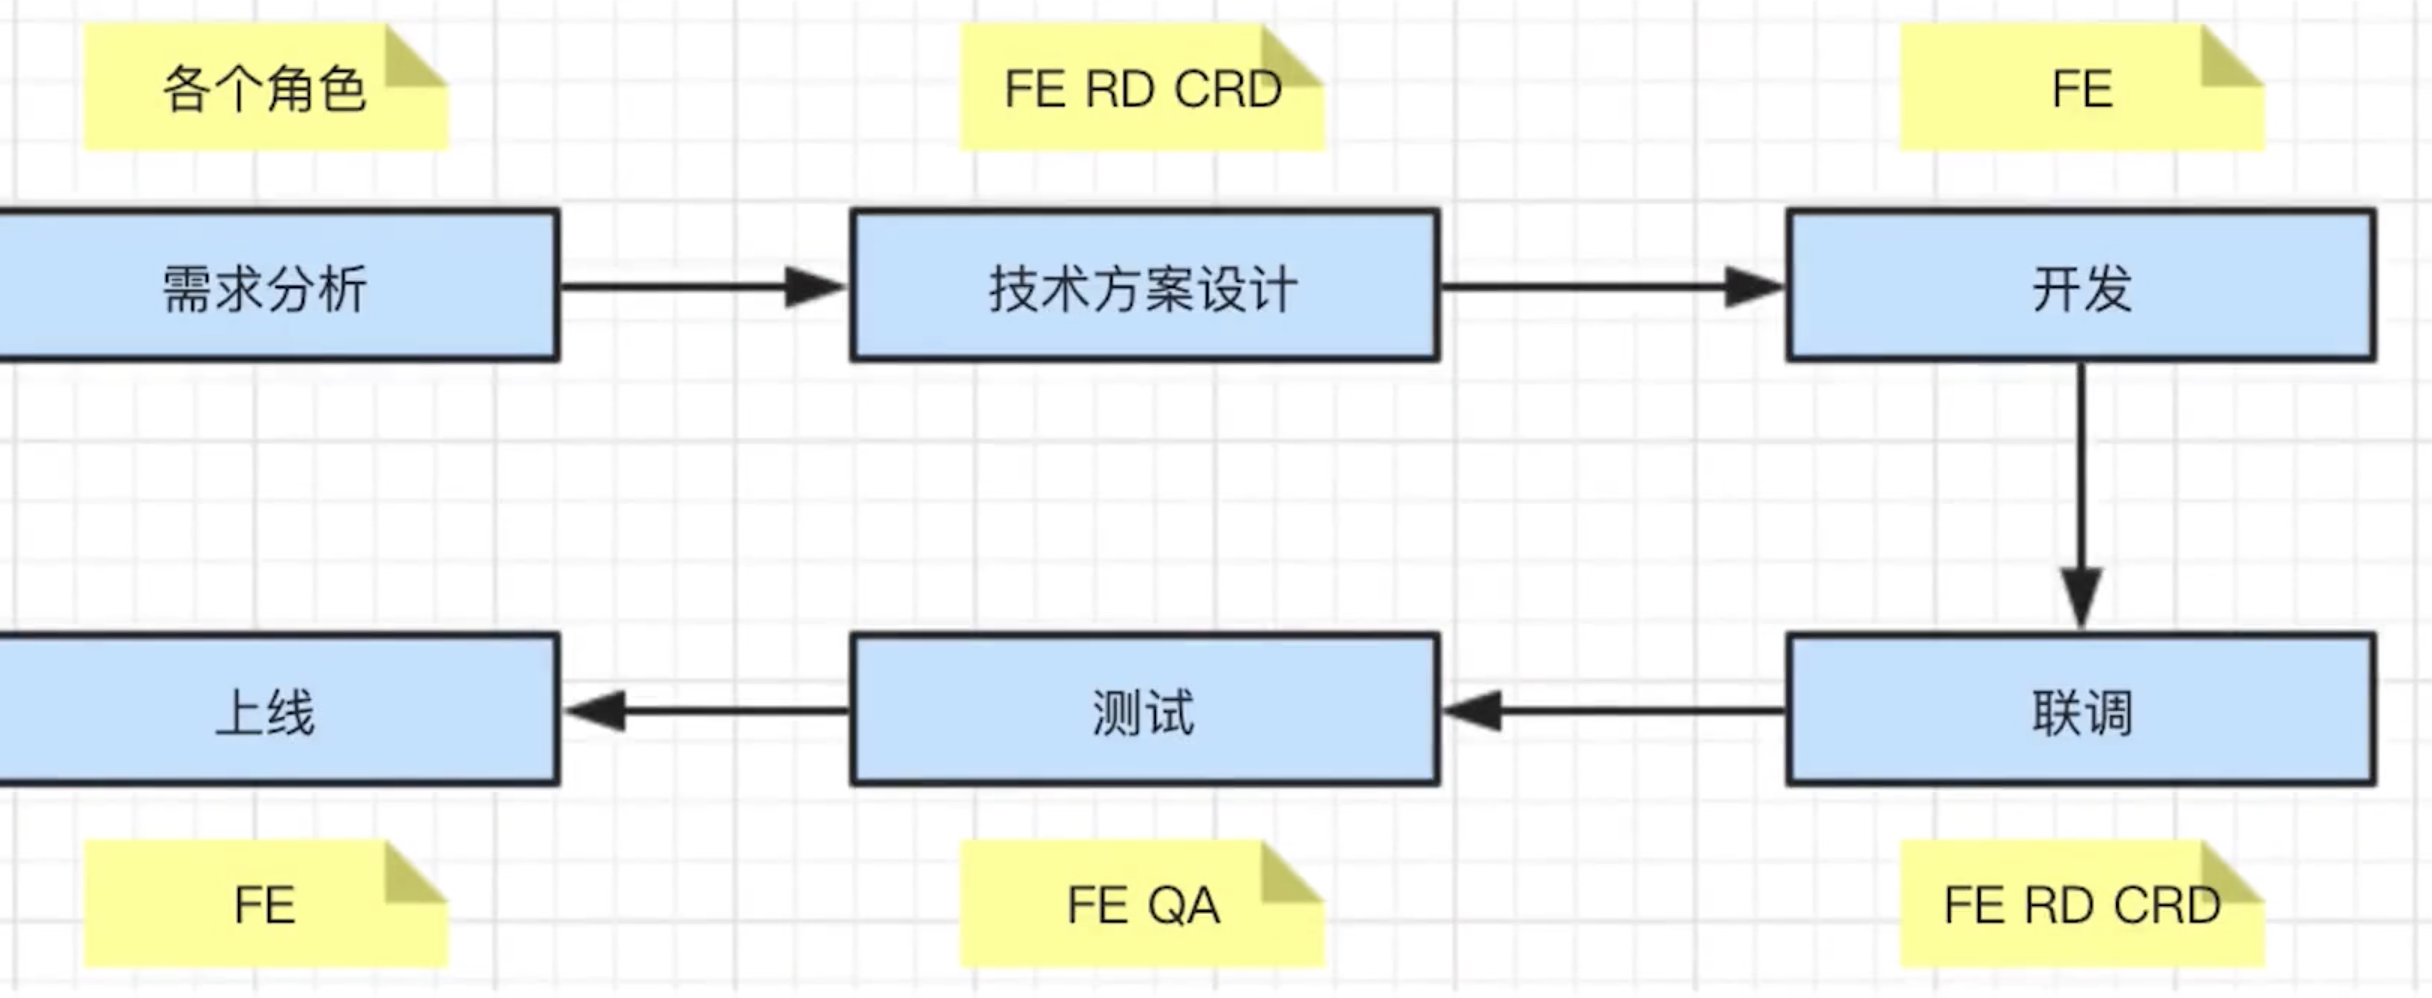
- 阶段1 需求分析 评审项目需求时需要注意哪些事项
- 了解背景
- 质疑需求是否合理
- 需求是否闭环
- 开发难度是否如何
- 是否需要其他支持
- 不要急于给排期
- 阶段2 技术方案设计 如何做好技术方案设计
- 求简,不过渡设计
- 产出文档
- 找准设计重点
- 组内评审
- 和
RD、CRD沟通
- 阶段3 开发 如何保证代码质量
- 如何反馈排期,预留缓冲时间
- 符合开发规范
- 写出开发文档
- 及时单元测试
Mock APICode Review
- 阶段3 联调
- 和
RD、CRD技术联调 - 让
UE确定视觉效果 - 让
PM确定产品功能
- 和
- 阶段4 加需求 项目过程中PM加需求怎么办
- 不能拒绝,走需求变更流程即可
- 如果公司有固定,按规定走
- 否则发起项目组和leader的评审,重新评估排期
- 阶段5 测试 测试不要对QA说:我电脑没问题
- 提测发邮件,抄送项目组
- 测试问题要详细记录
- 有问题及时沟通
- 阶段6 项目上线
- 上线之后及时通知AQ回归测试
- 上线之后及时同步给PM和项目组
- 如有问题及时回滚。先止损,在排查问题
- 项目沟通的重要性
- 多人协作,沟通是最重要的事
- 每日一沟通(如站会)
- 及时识别风险,及时汇报(如设计图没出来)
💬 面试官追问
需求评审会上产品让你当场给排期,你怎么办?
给一个大概的范围,说清楚「细排期评估完明天给」。当场拍的数字往往会成为承诺,后面发现依赖或难点就很被动。
开发到一半产品要加一个功能,说就一点点,你怎么处理?
不直接拒,也不默默加。先评估工作量和影响,走变更流程,跟产品和
leader一起决定是延期、砍掉别的,还是放到下一期。口头答应的需求出了问题,锅一般在开发身上。后端接口还没好,前端怎么不被卡住?
先一起把接口文档定下来,字段、类型、错误码都写清楚,前端用
MSW或Mock服务按文档开发。联调时只需要切一下环境变量,字段对不上的话以文档为准找人改。上线后用户反馈页面白屏,第一反应做什么?
先看影响面,影响大就立刻回滚,止住损失再查原因。回滚后看监控里的报错和发布记录,定位是哪次改动,修好后走正常流程重新上线,最后写复盘。
QA提了个问题单,你本地复现不了,怎么沟通?让
QA给出环境、账号、浏览器版本和操作步骤,最好有录屏,必要时一起看。别回一句「我这边没问题」就关单,大多数复现不了都是环境或数据不一样。
# 把握投递简历的黄金时间段
⚡ 30 秒速记
- 大周期:春招
3~4月、秋招9~10月岗位最多;年底和年中是淡季,但竞争也少 - 一天内:
HR看简历高峰大约在11~12点、16~17点,候选人投递高峰恰好在11点和16点 - 所以提前一小时投:上午
10~11点、下午3~4点,赶在筛选高峰前进入列表 - 数据来自招聘平台的统计,只能提高被看到的概率,决定性因素还是简历匹配度
- 有内推先走内推,比卡时间点有用得多
投简历可以挑上午 10~11 点或下午 3~4 点,赶在 HR 集中看简历之前排到列表前面。 这是招聘平台统计出来的规律:HR 一般在上午 11 点到 12 点、下午 4 点到 5 点筛简历最活跃,而候选人恰好也爱在 11 点和 4 点投,扎堆投进去很容易被淹没。提前一小时投,HR 一打开列表就能先看到你。不过这只是锦上添花,真正决定能不能约面的是简历和岗位对不对得上,有内推渠道的话,内推比挑时间点有效得多。
大家从事不同种类的工作,每天也在不断地制定自己的工作时间表。每个月总结的时候会发现有些事情总是在一个固定的时间去做,也可能在这个时间段发起同一件事情的几率非常的大,而且不止自己这样做,做同样工作的小伙伴亦如此。这就是工作种类作息时间的安排,招聘人员也一样,他们也有固定看简历和电话沟通的时间段。如果抓住这个“黄金投递点”,就等于抓住了招聘人员的视线,进而获得更多关注的可能性会更大。
HR 工作作息时间表
每个公司特别是互联网公司都有大量的招聘需求,而面对这么多的需求,公司 HR 是如何应对的?每天的工作作息时间是否有规律可循呢?
下面通过曲线图的形式来展示拉勾网 HR 的工作作息表:
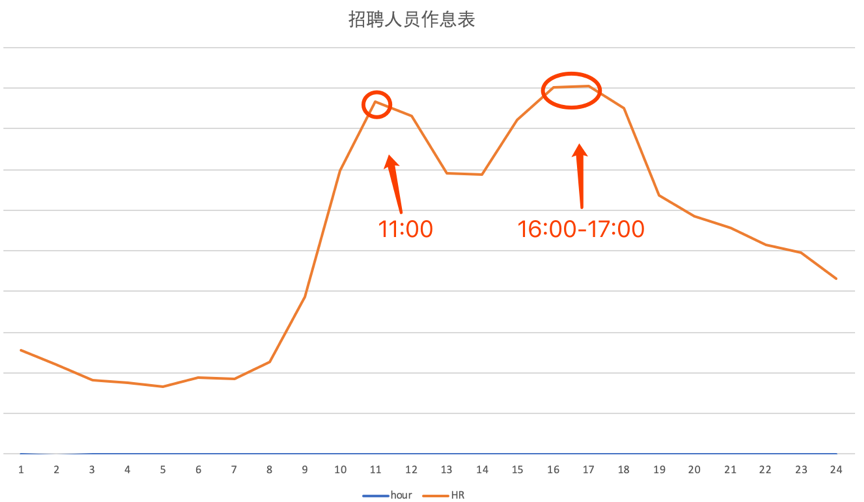
由上图可知,每天 HR 最活跃的时间段为上午 11 ~ 12 点、下午 4 点 ~ 5 点。也就是说在这两个时间段里,我们的招聘小伙伴在疯狂的筛选简历,即在招聘平台上筛选来自不同候选人的简历。
如果面试者投递简历的时间为上午的 10 ~ 11 点 或者下午的 3 ~ 4 点,那么简历有可能会被优先处理。相信你也有过体验:一天当中,上午的工作心情以及认真度普遍是最高的,也就是说投递的简历是最容易被招聘人员筛选出来的。
候选人投递时间表
上面分析了 HR 最活跃的时间段,那求职者是不是也有个投递简历的高峰期?如何错开高峰期呢?调取了拉勾网投递简历的数据。
下面通过曲线图的形式来展示候选人投递简历的时间表:
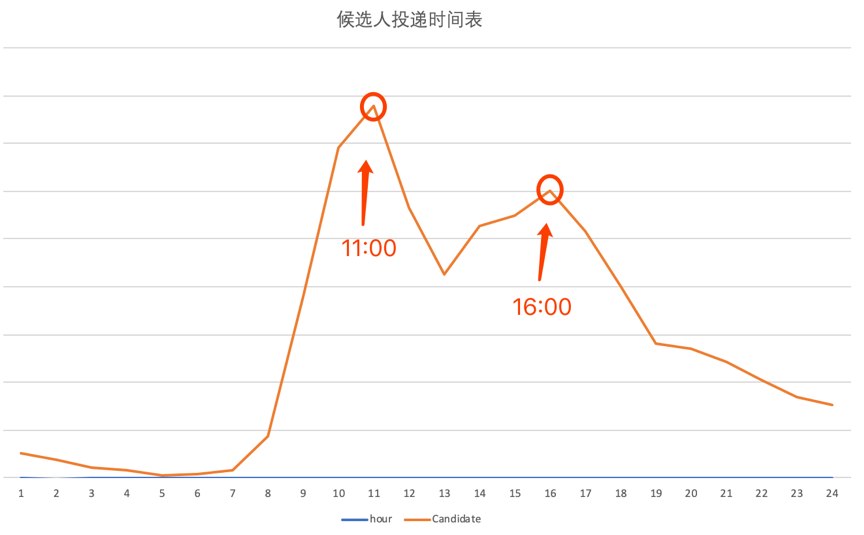
由上图可知,候选人投递简历的高峰期是在
上午 11 点和下午 4 点这两个时间段,也就是说和 HR 筛选简历的时间段完全重合。相信你也有过类似的体验:当专心做某一件事情的时候,肯定不会注意到投递来的新简历,这就是为什么简历石沉大海的原因。
通过上面两个数据的分析,相信你也应该知道了 HR 筛选简历的时间段,由此可知,投递简历的“黄金时间段”在上午的 10 ~ 11 点 或者下午的 3 ~ 4 点。因此,从现在起,调整投递简历的时间吧,在更好的时间段将自己的简历呈现到 HR 的面前。
💬 面试官追问
周末晚上投简历会不会就石沉大海了?
不至于,但周一早上
HR打开的时候,周末积攒的简历会一大堆。工作日上午投更容易被及时看到,没必要特意熬到某个时间点。金三银四一定比淡季好找吗?
岗位多,但竞争者也多。淡季岗位少,可能是急招的,流程快、也好谈。手上项目刚收尾、简历准备好了,什么时候投都可以。
同一家公司投了几个岗位都没回音,可以重复投吗?
别短时间内连投好几个岗,系统里能看到,会显得没有方向。挑最匹配的一个投,等一两周没消息,再换渠道,比如找内推。
内推和官网投递差别大吗?
通常差别不小。内推一般能直接进用人团队手里,跳过一部分初筛,还能请内推人问进度、问团队情况,比卡时间点有用。
投了很多都没回音,先查什么?
先看简历本身:技术栈和岗位要求是否对口、项目有没有结果和数字、第一屏能不能看出亮点。时间点只是小因素,简历匹配度才是大头。
# 把握面试时的关键点
⚡ 30 秒速记
- 着装干净得体,简洁纯色就够,别浓妆、别香水太重
- 自我介绍
3~5分钟,别超过10分钟:基本情况 + 工作经历 + 最有价值的一段经历 - 要突出三点:做过什么、做出了什么结果、和这个岗位匹配的优势
- 被追问先确认对方想听什么;不会就说到自己知道的那一步,别硬编
- 离职原因和规划讲成长,不抱怨前公司;面完当天记下答得不好的题
面试的关键是让对方很快看清你做过什么、做得怎样、为什么适合这个岗位。 自我介绍控制在 3~5 分钟,按「基本情况、工作经历、最有价值的那段经历」讲,面试官一是拿它对一下简历,二是看你的总结能力,太短说不清,太长会被打断。讲经历时突出具体业绩,不会的问题坦白说「这块我了解到哪一步」,然后讲思路,比硬编强很多。着装不用多讲究,干净整洁就行。离职原因说「想要更好的成长」,别借机吐槽前东家。
面试前的准备工作
先说说面试前的准备吧。常规的准备相信你一定知道,比如制作一份吸引 HR 的简历、穿一身体面的衣服、整理一下自己的发型等。简历相关的准备前面已经详细讲过,这里就不多介绍了。
下面说说穿着相关的准备,很多小伙伴认为面试时的穿着并不是很重要,面试官肯定更看重个人魅力和知识的储备。当然这么说是没错的,但如果你和面试官首次见面,在还没有开始正式聊天之前,他是无法感知你的个人魅力或者知识储备的。
假如第一次见面就看到邋遢的外表或者奇怪的着装,面试官会怎么给你贴标签呢?首先他一定会认为你并不尊重这次面试,给他造成一种没有礼貌的印象;然后就是被你身上的味道熏倒无法和你多交流;最后根本来不及了解你的个人魅力和知识储备就草草地结束了这次面试。相信这个结果一定不是你想碰到的吧?所以,干净得体的着装是面试非常重要的一个环节。
面试官也会通过你的着装去判断你的性格,以及判断与公司的文化、团队的气氛是否匹配。这时可能你会问:我也没有进入到这家公司和团队,该如何判断面试当天穿什么衣服才符合这个公司的文化或者符合这个团队的气氛呢?当然,我们没有办法做到“把面试官的感受照顾到很细”的层面。
但是不同的穿着一定会表现出你的性格,有些表现出来的性格可能不会被大众所接受的,希望可以回避一下。下面简单说说几种可以表现性格的穿着:
喜欢穿简单朴素衣服的人,往往给人的印象是性格比较沉着稳重、为人比较真诚和随和,无论是在工作或学习上,还是在生活中,会给人一种勤奋好学、诚实肯干的感觉;
喜欢穿样式繁杂、颜色多样、花里胡哨的衣服的人,多是虚荣心比较强,爱表现自己而且又是乐于炫耀的人,会给人一种性格有些飞扬跋扈的感觉;
喜欢穿浅色衣服的人,性格比较活泼好动,十分健谈,会给人一种喜欢交朋友的感觉;
喜欢穿深色衣服的人,性格比较稳重,显得城府很深,会给人一种比较沉默,做人做事深谋远虑的感觉。
如果你希望在面试中表现的不是那么具有攻击力或者给人比较亲和、稳重性格的话,建议穿简单、朴素、纯色的衣服,会显得整个人比较清爽,且比较容易亲近,相信面试官也愿意和你多聊几句。当然不仅穿着干净,而且一定要注意个人卫生,最好不要让自己身上的体味过重或者使用太重味道的香水。化妆时,不建议浓妆艳抹,自然的淡妆让自己看起来很精神就可以。
如何全面的介绍自己
接下来就是面试的过程了,首先面试官会说:“请简单介绍一下自己。”
面试官有两个目的:(1)希望通过你的简单描述可以和简历上的经历做校对;(2)通过简单地介绍来看看你的逻辑和总结能力如何。所以自我介绍也是非常重要的一个环节,好的自我介绍一定要做到以下几点。
- 面试时的自我介绍
一定要把握住时间。面试时的自我介绍一般
控制3~5分钟最合适,尽量不要超过10分钟。时间过短说明你根本没有清晰的介绍自己,这时面试官很难了解你到底做了什么;时间过长可能很多内容不是面试官需要的信息,这时大部分的面试官会主动打断你,从而留下了不太好的印象。
那如何把握好时间呢?建议在介绍时包含以下几个部分就好:(1)情况介绍,包括教育经历;(2)工作经验的介绍;(3)介绍最有价值的经历。这样的一个自我介绍应该可以很好的控制在5分钟左右了,既可以让面试官清晰的了解你的情况,也能表现出你的优势。
- 面试过程中需突出的几个点
在面试过程中一定要突出以下几个点:做过什么、有哪些工作业绩、优势是什么,这样可以很好的突出自己。
做过什么:介绍自己,把自己曾经做过的事情说清楚,每段工作对应时间节点的公司名称、担任职务、工作内容等,尤其是对最近两份工作做过的事情要重点说说,较早之前的工作经验,或者学习的经验可以一带而过,要把握“重点突出”的原则。
有哪些工作业绩:把自己在不同阶段做成的有代表性的项目经验介绍清楚,但是一定要注意:(1) 应与应聘岗位需要的能力相关的业绩多介绍,不相关的一笔带过或不介绍,因为面试官关注的是对用人单位有用的业绩;(2)要注意介绍你个人的业绩而不是团队业绩,要把自己最精彩的一两段业绩加以重点呈现。当然也要做好充足的准备,可以迎接面试官的提问。
突出自己的优势:注意介绍自己的优势一定要与应聘的岗位密切相关,主要是围绕自己专业特长来介绍。除专业特长以外的特长,特别突出可以介绍,但要点到为止。
举个例子:你好,我是某某,2018年3月加入XXX公司,担任产品经理一职,主要负责公司核心产品的规划和设计工作;在这段期间,我独立完成过XX项目的产品跟进和上线的工作,将产品的数据提升了30%,业绩突出,获得了公司的认可。在项目中,我通过学习和与外部专家的沟通,获许了XXX新策略的信息,并积极尝试,达成了我的目标。
- 每段工作的离职原因
在面试的过程中一定要突出自己职业规划的逻辑性,也就是说需要让面试官感受到你的每次工作变动都是为了个人成长以及有规划的进行变动。所以在表述的时候最好可以清晰地说出你在每段工作中的收获和成长点,当然如果在陈述这些内容时可以体现出你的个人思考,就更是画龙点睛了。
如何回答面试中的问题
相信你经常会碰到面试官问以下的问题,这些问题也是面试官给你的一些考验,如果更好地回答这些问题可能会成为你入职心仪公司的敲门砖。
- 你为什么选择我们公司?
这个问题相信不少小伙伴遇到过,可能你的原因是随便投递、公司离自己住的地方近、工资给的高、公司不加班、公司有各种补助等。如果这些答案出现在你的面试回答中,那 HR 会重新考虑是否要录用你了。
所以在回答这个问题时需要有一些准备:
- 可以先描述一下自己的能力与岗位要求的契合度,表现出在公司提供的岗位上有机会可以一展所长;
- 说出几个被企业所吸引的优点,这些优点能为以后的工作带来什么好处;
- 自己的职业发展与公司前景作出总结。
相信这些回答可以很容易抓住面试官的心,不过前期也是需要你对这家企业,以及所招聘的岗位做了一定的功课。
- 你为什么从上家公司离职?
也许你在前公司受到了委屈、也许前公司人事关系复杂所以离职,但无论前公司有多么的糟糕,都千万不能在面试时说出来。因为你在上家公司离职的原因,会使面试官联想到你会不会因为在新公司受到委屈而轻易离职?再者,面试官其实并不关心你为什么要离职,所以面试时只需要给在场所有的人一个都可以接受的答案就可以了。
例如,可以这样回答:为了更好的发展,所以选择离职。切记在回答这个问题的时候,不能贬低前公司、不要损害前领导的形象。
- 你的优点和缺点是什么?
相信很多小伙伴对这个问题都很头疼,自己的优点说的太多会让面试官感觉过于自大,可在面试的过程中又有谁愿意说自己的缺点呢?下面列举几个简单的方向,希望可以帮助你解决这个尴尬的困境。
- 优点:可以
结合过往的工作经历和工作业绩等讲述一下自己的优势。例如,我曾经参加过某某项目,相信我的这个工作经验可以很好的帮助到公司解决什么方面的问题等。当然也可以通过一些例子说明自己的人品或性格方面的优势,哪家企业可以拒绝一位性格和能力都很好的候选人呢? - 缺点:金无足赤、人无完人,要勇敢的面对自己的缺点,可以向面试官说明,你针对自己的缺点做了哪些改变,以此来说明你正在积极地改变自己去成为更优秀的人。
- 比如你是做前端的,你可以说你对运维那块的部署相关不熟悉,经验还不足等等。你是做后端的,你可以说你对那些炫酷的页面交互不太熟悉。
- 优秀案例:突出你好学的心态
- 以前因为工作的关系不常用xxx技术栈,在业余时间略有接触,但是理解还不够深。
- 但是自从xxx后,我就买了有关的书籍和一些视频教学深度学习。
- 每天都会下班后用一个小时的时间在掘金,CSDN等论坛活跃,阅读网友的文章。同时我也会把我自己的疑惑跟大家交流,大家一起进步,让我在这方面越来越熟
- 未来 3 年或 5 年,你的职业规划是什么?
当面试官问到这个问题时,是希望看到你的自我学习力和未来牵引你的职业动力是什么。对职业规划不清晰的人,很难获得成功,也不会在一个岗位上待很久,所以也不是公司最合适的人选。
当被问到你的职业规划是什么的时候,此时可以设定一个短期就能实现的规划和一个未来希望实现的目标。
例如,我希望可以在未来的 1 ~ 2 年内,梳理和参与到几个完整的项目中,从中学习和看到整个项目进度是什么样的,从而提升自己的工作能力和项目经验。在未来的 3 ~ 5 年内我希望可以独立承担项目,做一个可以让大家都能使用并且体验良好的产品出来。
这样的回答,在短期规划上会让面试官认为你是一个脚踏实地,希望可以通过学习而成长的人,而且也在积极的改变自己;在长期规划上也能让面试官感受到你对这份工作的热情,具有很强的成就动机。
- 在选工作中更看重的是什么?
很多小伙伴反馈,这个问题很难回答,其实也能想到面试官肯定更看重你的是个人成长和发展空间。当然也许你的内心想的是涨薪或者培训,虽然薪资是一定的,但是如果让面试官认为你是一个物质的人,并没有长久的培养空间,那面试的结果就可想而知了。
- 你还有什么问题吗?
这是面试结束前的最后一个问题,也可以认为是个形式问题或走个流程,此时可根据前面面试过程中的表现程度来适当的提问,比如公司福利、上下班时间、团队氛围、个人岗位发展等,但尽量不要问从网上就能查到公司信息的问题。
💬 面试官追问
自我介绍讲了八分钟被面试官打断了,问题出在哪?
一般是讲成了简历朗读,每段经历都平铺。只挑和岗位最相关的一两段讲细,其他一句带过,控制在五分钟内,留时间给面试官追问。
面试官问了个完全不会的问题,怎么回答?
直说「这个我没深入研究过」,然后讲讲你知道的相关部分,或者你会怎么去查、怎么验证。硬编被识破,前面的好印象都会打折扣。
面试官追问「你确定吗」,要不要马上改口?
先别急着改。想一下自己的依据,有把握就把依据讲出来;确实想错了就大方承认再修正。很多时候追问只是在看你对答案有没有把握。
为什么从上一家离职,怎么说比较好?
落到你要的东西上,比如「想做更偏工程化的事,现在的业务里机会比较少」。不抱怨领导和同事,也别编「家里有事」这种以后可能穿帮的理由。
线上视频面试要注意什么?
提前测试摄像头、麦克风和网络,背景整洁,光线别背光。共享屏幕写代码前把无关窗口和消息通知关掉。
# 工作交接流程 & 福利衔接
⚡ 30 秒速记
- 提离职:转正员工一般提前
30天书面提出,试用期提前3天 - 方式:邮件或当面找直属
leader,先感谢,原因落到「想要更好的发展」,别抱怨 - 交接:确定交接人 → 整理文档分类发出 → 带着熟悉在途项目 → 通知对接人 → 文档抄送
leader - 一定拿到离职证明(解除或终止劳动合同证明),新公司入职要用
- 社保公积金尽量别断缴,入离职日期和两边
HR对好;竞业协议看清范围、期限和补偿
离职这件事最重要的是好聚好散:工作交接清楚,手续材料拿全,社保别断。 我会先跟直属 leader 当面或发邮件说,表示感谢,原因说成想要更好的发展,不吐槽,也别拿 offer 去谈涨薪。交接时请 leader 定一个交接人,把项目文档分类整理发过去,在途的项目带着一起收尾,再通知对接的同事以后找谁,文档转出时抄送 leader,免得以后说不清。最后一天一定要拿到离职证明。社保公积金政策各地不一样,入离职日期提前跟两边 HR 确认,尽量无缝衔接。
工作交接流程
如何不伤和气的提出辞呈
终于拿到了自己心仪公司的 Offer 了,可能有很多小伙伴又开始发愁了:如何与领导顺利提出辞呈,又不伤和气呢?这个时候一定要做好最坏的打算,你要明白,心软拖着不说会更伤害自己与前公司的关系,不如直截了当、当机立断。
一般提出离职的方式分为两种:
- 通过邮件的形式提出辞呈;
- 直接找直属 leader 沟通。
具体采用哪种方式,可根据自己的个性来判断,比如不太擅长沟通、偏内向的可以通过邮件的方式;如果已经想好了怎么和上级沟通,也可以直接找 leader 阐明心意。那在写邮件或直接沟通时需要注意哪些呢?
- 首先,可以先表达出对公司和领导在工作中的指导和帮助的感激,以及这段时间在公司的工作和成长的开心,同时说明一下做出辞职的决定对自己来说是多么难的一次选择。相信这样的表达可以让领导对你有个不错的印象。
- 其次,
不论你的离职原因是不满意薪资、不适应团队的管理风格还是发展空间到达了上限等,都不要在这里抱怨出来,因为每个公司的 leader 都清楚公司里的问题,与其这样,不如直接告诉 leader,辞职的原因是希望可以有更好的发展,或者是让自己有更好的学习成长的空间。相信你的决心加上这样的理由,leader 一定会领会里面的意思。
如果这时 leader 突然问:找到下家了么?该怎么回答?建议这样委婉地回答:手里有好几个 Offer,还没确定好去哪家
最不建议的离职理由:经常会有小伙伴为了避免双方尴尬,会选择“家人生病需要较长的时间照顾”、“家人要求我回老家工作”等类似这样的理由,如果是真实的当然不会有问题,如果是虚构的,以后万一被发现,则会给前公司留下一个不诚信的印象,以后再相见时会更尴尬。
当然也有小伙伴提出离职是为了通过拿到的 Offer 要求涨薪,这样的“小聪明”玩不好可能就把自己“玩”进去了,不但在拿到 Offer 的公司名声坏了,也不会被现在的公司重用的。
最后,可以和前司表示一下,自己一定会负责任地把手里的工作交接清楚,站好最后一班岗,这样也可以给前司 leader 留下一个让人踏实的印象。毕竟你的面试背调还在人家手里,总不希望闹得不可开交,拿不到一个好的背调反馈吧。
合理安排交接工作
一般来说,如果你是一位已经转正的全职员工,那么交接的时间为一个月,所以公司也会要求你在这一个月里正常工作,那么,如何清晰地在这一个月里合理安排交接工作呢?
- 先和直属 leader 协商找到一个靠谱的工作交接人;
- 把自己以往的项目文档整理好,分类发给交接人;
- 如果你手里还有未结束的项目,可以带着交接人熟悉一下,一起对这个项目做收尾工作;
- 通知同事或者项目对接人自己已经离职,接下来的项目由被交接人负责;
- 空出两周的时间,协助交接人熟悉你手里的工作内容,在旁做好支持工作。
- 如果新的公司期望你能尽快入职的话,多数情况下会担心你拒绝入职,此时建议你诚恳地向新公司解释,并和新公司同步交接工作的进度。
交接文档有以下注意事项,比如:
- 清晰的文档归类,发现问题可以马上与你沟通;
- 尽可能将相关的文档都涉及到,让你的交接文档更容易查找;
- 记得文档转出时抄送给领导,这个很重要,一定要记得;
我相信这样的交接流程不会让自己手忙脚乱,也可以给前司留下不错的印象。
离职最后一天走的时候,记得和同事们一一打招呼,感谢大家以往的照顾和帮助,以后要常保持联系。更重要的一点是,一定要拿到“离职证明”文件或“解除 / 终止劳动合同报告书”。
福利衔接
交接工作都做完了,很多小伙伴会问:我的社保、公积金怎么办?下面来讲讲 3 种常用的福利交接事项。
社保公积金
- 各个公司的社保、公积金都是以
每个月的 15 日作为分界点,如果你是在15 号前入职的新公司,那么就会帮你交当月的社保和公积金,如果你是在15 号后从前公司离职,社保、公积金会由前公司承担。当然也会有特殊情况,要看人才局的具体安排。 - 如果你正好是
15 号前离职,中间休息了一段时间,15 号后入职新公司的,可能需要你自己找第三方保险代缴公司自行缴纳社保公积金了。
年假
通常,公司会按照你出勤的月份帮你做年假的换算,然后与你协商安排延后几天离职,或结算成工资,或者按照公司的规定有其他操作。
# 十三、人事面
💬 面试官追问
leader问你是不是找好下家了,怎么回答?可以委婉一点,比如「有几个机会在看,还没最终定」。不用透露公司名,也不用撒谎。
新公司催你一周内入职,但老公司要求交接一个月,怎么办?
跟新公司如实说明交接进度,大多数公司能理解,也能看出你做事负责。同时跟老公司商量能不能压缩交接时间,比如加快交接、用年假抵一部分。
交接文档里该写哪些东西?
项目仓库和部署方式、账号和权限清单、在途需求的进度和风险、各对接人联系方式、常见问题处理方法。写完发给交接人并抄送
leader,留个记录。拿着新
offer去跟现在的公司谈涨薪,可行吗?风险很大。就算留下来,公司也会觉得你随时可能走;新公司知道了也会有想法。真想留就直接谈涨薪,别拿
offer当筹码。离职时公司让签竞业协议,要注意什么?
看清竞业范围、期限和补偿标准。按现行司法解释,公司不支付补偿超过三个月,员工可以请求解除竞业限制。拿不准的地方先问清楚或咨询专业人士,别随手就签。
# 第一个要点: 你是否胜任这份工作?
⚡ 30 秒速记
- 这一问本质是匹配度:你的经历能不能直接解决这个岗位的问题
- 对着
JD逐条准备:每条要求配一个自己的例子,挑最贴合的两三个讲 - 常见变体:最感兴趣什么、工作能带来什么、上份工作喜欢和讨厌什么、管过几个人、最大成就
- 讲成就用
STAR,落到可量化的结果;团队成果和个人贡献分开说 - 有短板就承认,说清已经在怎么补、有什么进展
回答「能不能胜任」,就是把岗位要求和自己做过的事一一对上。 我会先把 JD 里的要求挑出最核心的两三条,每条配一个自己真做过的例子,比如岗位要求性能优化经验,就讲一次具体的优化:问题是什么、我做了什么、指标变化多少。「对什么最感兴趣」「最大成就」这类变体,本质也是在问匹配度,答案要往岗位上靠。缺的能力别硬撑,可以说「这块经验还少,最近在通过某个项目补」,比假装都会更让人放心。
1. 对于这份工作,你最感兴趣的是什么?
- 能充分发挥我的工作热情,知识和技术。
- 是我过去_____年从事_____(职业)的延续。
- 工作任务有挑战性,有战略性和有价值感。
- 短期项目和长期项目有很好的平衡。
- 热爱并有能力完成这份工作。
- 我将全身心的投入到工作中,能够很好的完成工作项目如:_____(可以根据招聘信息上对该岗位工作内容的描述填写)
2. 你认为这份工作能给你带来什么?
- 有机会接触更多的客户。
- 能发挥我的特长:_____。
- 赋予我责任包括:_____(岗位责任)。
- 有吸引我的企业文化,如贵司的_____(可以适当夸赞下公司的企业文化、特色等)。
- 能更好的锻炼我的_____(能力)。
- 提供与人交流沟通并互相帮助的工作环境。
3. 对于上一份工作,你最喜欢和最讨厌的是什么?
- 喜欢在团队会议上开展头脑风暴。
- 喜欢富有挑战性,比如:_____。
- 讨厌按部就班的工作,更追求能体现自我价值的工作,比如:_____。
- 喜欢富有创造性,比如:_____。
- 讨厌重复的工作,但是愿意在机械性的工作中寻求新的方法,提高工作效率。
- 处理大量的邮件是比较有挑战性的,但我喜欢及时的回复,看着待处理邮件越来越少带给我很大满足感。
4. 你管理过多少人的团队?
- 我现在正管理一个_____人的团队。
- 负责项目的大小决定团队人员的数量。
- 有过管理团队和小组的经验。
- 目前没有管理团队的经验,但我对做管理有充分的准备。
- 我经常志愿参加团体活动,一般都有_____到_____人参加,我在其中担任负责人。
- 我负责过_____人的项目,虽然并不是日常管理,但是作为项目经理,我主持的项目都会提前完成,并控制预算在_____元以内。
5. 你承担过哪些经济责任?
- 在上份工作中,我负责过预算为_____的项目。
- 经过前三份工作,我负责的项目预算越来越多,经济责任也越来越大,从第一份工作的_____到最近_____的项目。
- 我是从负责技术转为负责财务。随着公司的发展,我不仅负责部门的技术工作,还负责采购和执行方面的财务工作。
- 在我之前的工作中,我并未涉及过财务方面的事务,但我相信我全面了解自己的工作,能够处理好。
- 我虽然没有直接负责财务问题,但是我负责管理过一个_____的项目。
- 我负责过一个大型的项目,对公司尤为重要,能够带来_____的利润。虽然我没有直接负责财务,但我的领导对项目的成功起着举足轻重的作用。
- 我设法使销售额在18个月的时间里翻了三倍,从_____到_____。
6. 过去一年中,你做过的最艰难的决定是什么?
- 可以说一个你遇到并成功解决的问题。
- 是否进行裁员。
- 是继续呆在老公司还是寻找新的工作机会。
- 是否暂缓部门扩大计划。
- 是否减少自己和手下员工的薪酬,以免裁员。
- 是否接受晋升继续在原公司工作还是回学校深造。我选择_____,因为_____。
7. 带给你最大满足感的成就有哪些?
- 描述一个让你感到骄傲又做的非常专业的事情,并解释下为什么这件事带给你满足感。
- 设法在降低40%成本的基础上,将产能提高了一倍。
- 解决了同事无法解决的问题。
- 提前在预算内完成任务。
- 在面对巨大困难_____时,也能圆满达成目标_____。
- 可以描述一个与你现在正在面试的岗位要求类似,你又成功完成的项目。
- 在大学期间,获得_____,使我得到了_____的实习机会。
8. 你能否胜任这份工作?
- 列举两到三个你能胜任的原因。
- 愿意参加额外的培训以满足岗位要求。
- 列举两到三个相关技能。
- 列举自己的特长。
- 将在_____领域的持续深造,积累经验和学识。
9. 你是否愿意接受心理测试?
- 可以,能否告知这个测试在面试中起多少决定作用?
- 可以,对能够定义我工作能力的任何方式我都接受。
- 可以,也希望贵司告知测试结果。
- 可以,请问你们怎样测试?
- 我很愿意你们对我的专业能力做出评估,并回答任何相关问题。
- 注意如果你表现出对心理测试的反感,很可能给面试官不好的映像
10. 从上份工作中你学到了什么?
- 学会了如何同时处理多个任务和管理复杂的计划。
- 学会了如何根据优先级处理多项工作。
- 学会了认真做好每一件事(即使只是一些日常小事),并从中体会到工作的乐趣。
- 学会了在开放和真诚的工作环境中与同事互相帮助,互相成就。
- 学会了如何在大/小公司工作,如:_____。
- 学会了如何高效地处理重要事务。比如:_____。
- 学会了不论工作环境怎样复杂,都有值得学习和使人成长的地方,比如_____。
11. 在上份工作中,你是否有发现前任所遗留的问题?
- 是的,我发现了一个问题并开发了一项新的技术,比如_____。
- 是的,我在简历上有写明我在上份工作中所解决的问题,包括:_____。
- 没有,我的上司很有能力,把工作做的很好。为我后续开展工作打下了良好的基础。
- 没有,但是因为我处理问题的能力受到领导的赏识,我被赋予了比前任更多的权限和责任,比如:_____。
- 老实说,我不能说有什么特别的问题是我的前任造成或遗留的。对我来说,最重要的是共同解决问题,而不是考虑这是谁的责任。
12. 哪种岗位更适合你:基层或管理?
- 在我的上份工作中,我同时扮演两种角色,无论是作为员工还是经理,我处理起来都得心应手。
- 两种岗位我都可以,但是我更倾向于_____,因为_____。
- 我认为我更适合做一名普通员工,因为我更擅长执行领导指派的任务。
- 我认为管理岗更适合我,因为我是一名天然的领导者,无论何时,都愿意担任领导的任务。
13. 这个领域,你认为将来的主要趋势是什么?
- 在参加面试前,我曾做过调查,发现了多个趋势:_____。
- 我发现_____有巨大的潜力,这也是我选择这个行业的原因。
- 据我所知,_____正发生着细微的变化。我将关注这一变化在市场中的运用和对我们行业的影响。
- 我认为我们这个领域的技术正在变得越来越先进,在未来,拥有先进的技术是必不可少的。
14. 你适合这份工作的原因是什么?
- 我认为我可以在两个方面增加公司的价值:比如_____(举两个实例)。
- 列举几个自己最突出的优点。
- 结合今天与您的会面所了解到的信息,我可以说,我具备贵公司期望员工所具有的潜力、热情和毅力。
- 我有类似的岗位经验,比如:_____。
15. 你是否认为对这份工作来说,你的资历过高?
- 也许,但是我希望能在贵司长期发展。我相信贵司能及时发现我对公司的其他帮助,并与公司共同成长。
- 我在_____的丰富的经历,可以使我比那些慢慢成长起来的人更快的开展工作。
- 我过往的经历和能力都很适合这份工作,我有信心在岗位上有优秀的表现。
- 你是否对我简历上所写的能力有疑问,我很愿意为你解答。
- 如果是,我相信这部分资历也能为您和您的公司所用。
- 也许是这样,在我的职业生涯中有幸获得过很多好的工作机会,使我更注重工作给我的满足感,并更乐于_____(表述岗位职责)。
16. 对于你申请的这份工作,你如何理解?
- 列举一个你觉得该岗位的关键任务。
- 这是一份具有挑战性的工作。
- 这是一份需要注重客户满意度的工作。
- 这是我理想中的工作,为了这份工作,我做过各种调研,努力提高自我能力,比如:_____。
- 这份工作注重_____,需要很高的职业素养,如:_____,我很愿意提高自身水平达到贵司的要求。
17. 你将如何职业性的提升自己?
- 通过三种途径提升自己:阅读专业杂志、参加会议、研修继续教育课程。
- 紧跟行业潮流,学习技术,不断突破。
- 尝试新事物,学习新技能,开发新兴趣,比如:_____。
- 接受行业导师的指导,提高自身能力。
- 在成人大学参加课程,扩大视野,增加知识储备。
- 在岗位上学习,了解同事的工作、技能、兴趣,学会多角度看待问题。
18. 你最大的成就是什么?
- 详细叙述几项自己的成就,比如:上线产品、重组部门、质量管控等。
- 我是个非常善于交际的人,经常致力于改善部门同事之间的关系。
- 在工作中,我能避免犯错,降低成本,达成目标。
- 在我23岁时便升任经理,尽管有很多资历和年纪都比我老的员工,但我领导还是因为我的潜力冒着风险提拔了我,最终她没有后悔自己的决定。
- 我完成了一个项目,给公司带来了巨大的利益。(可以详细说明)
- 在我的职业生涯中,我经常被任命完成各种艰巨的项目,被赋予了更多的责任。
- 我以优异的成绩大学毕业,后被留任为两个教授的助教。
19. 你理想的工作状态是怎样的?
- 举两到三个在工作中能让你感到快乐的事情,比如同事、工作环境等。
- 开放而轻松的工作环境。
- 团队之间互相协作,又能互相体谅的工作环境。
- 相对自由的环境(我是个自律的人,做事主动,不太喜欢日常工作被过多的监管)。
- 能独立工作的环境。
- 有适当压力的工作,因为压力便是动力。
20. 你希望签署固定期限还是无固定期限合同?
- 贵司提供哪一种合同?
- 固定期限合同更适合我,因为:_____。
- 在签署合同前,我想先明确岗位职责。
- 比起我对该工作的热情,合同是次要的。
- 两种形式我都可以接受。
21. 如果你被指派过多的任务并无法在期限内完成,你将如何处理?
- 类似的事我碰到过两次,第一次我_____,第二次我_____。
- 如果我发现自己无法按时完成任务,我会第一时间告知我的领导,并明确难点,看是否能通过合作尽量减少延误带来的损失。
- 尽快通知相关人员,告知我的进度与交期。
- 寻求帮助,看是否能按时完成。
- 考虑是否能先将重要的部分提前完成。
22. 你更喜欢单独作业还是团队合作?
- 任何环境我都可以适应,团队合作有利于创造,独立工作则能让我更专注。
- 各有优点,团队合作有利于创造,独立工作则有利于自我反馈。
- 在我看来,最理想的是将工作分为两部分,一部份专注于自我完成,一部分于小组协作完成。
- 过去我更专注于独立工作,以后我会注意团队沟通。
- 过去我更专注于团队协作,以后我会注意独立工作。
23. 如何最有效的学习?
- 在工作中学习。
- 多看,多听,多读,多应用。
- 制定学习计划,稳固提升。
- 创造性,逻辑性,记忆性相结合的学习。
- 多阅读,多尝试。结合指导,运用于实际。
24. 你认为铁饭碗还存在吗?
- 如今市场变化如此之快,很难说哪些工作还是铁饭碗。
- 努力的话还是有可能存在的。保持工作的热情,不断学习,有责任心是维持工作竞争力的关键。
- 有稳定的工作,比如提供终身聘用制的岗位。而那些日新月异的新兴技术行业相对而言则风险更大。
- 我不认为岗位的稳定性是首要的,我更关心的是我能否在岗位上习得技能,能否从中有所获利。
- 随着全球市场化的推进,曾经的铁饭碗逐渐消失。相反,因为科技的进步,不断产生新的工作岗位。不稳定有时也意味着机遇。
- 随着经济下行和失业率的攀升,铁饭碗越来越少。要想获得工作就必须向雇主展现你的价值。
25. 包括你在内,现有三名候选人,你认为我决定录用的标准是什么?
- 是否热爱这份工作。
- 是否拥有担任这个岗位的能力。
- 是否符合公司的价值观。
- 是否能够融入公司的企业文化。
- 是否真诚,忠于公司利益。
26. 在你全面投入工作前,你觉得你需要多久的适应期?
- 很快,我相信我对工作和责任已经有了很好的理解;等我接触了我的同事,熟悉了环境,稳定下来,我就会在这个职位上做出成绩。
- 在我回答这个问题前,有两个问题请教:这份工作的首要任务是什么?有什么项目是需要我马上负责处理的?
- 我适应环境很快,大概需要_____周。
- 我可以马上开始着手日常事务的处理。对于特定的项目,我需要详细了解项目内容,熟悉公司流程,了解客户背景后才能处理。
27. 作为一名企业员工,将如何彰显自己的社会责任?这是否会困扰你?
- 企业需要关心的不仅仅是利润。作为一个国际企业,应该在解决全球重大问题上体现自身的价值。
- 我想在一家绿色环保的公司工作。我认为企业应当注重环境保护,尽其所能阻止全球变暖。
- 企业应当有企业良心,保护环境,承担社会责任。
- 每一个企业,无论大小,都应该做一些事情来解决我们今天所面临的社会问题。这可能是简单的用纸杯替换塑料杯,也可能是复杂的,如提供货车方便拼车。
- 我认为理想的企业应该尊重他人,不仅仅局限于那些对他产品感兴趣的群体,而是尊重企业所在地,所在国,乃至全球所有人。
- 有社会责任感的企业定能增加员工的忠诚度和满意度,吸引相同价值观的人才一起为企业为社会做贡献。
- 这对我不重要,我认为企业的首要任务便是为自己的员工提供好的福利。
💬 面试官追问
JD要求带过团队,你没带过,怎么回答?如实说没有正式带过,然后讲接近的经历,比如带过实习生、牵头过一个跨组项目、主持过技术方案评审,说清楚你在里面具体做了什么。
你最大的成就是什么?
挑一件和这个岗位相关的,按
STAR讲,结果带数字,比如「把组件库接入五个业务线,新页面开发时间大约省了三成」。说清楚哪部分是你做的。上份工作你最不喜欢什么?
说一个跟工作内容有关、而且你想改变的点,比如「重复性的维护工作比较多,所以我做了个脚手架把一部分流程自动化了」。别拿人和公司开刀。
这份工作最吸引你的是什么?
说具体的,比如「你们在做低代码平台,我之前做过表单引擎,正好能接上」。「平台大」「前景好」这种对哪家都能说的话,等于没说。
过去一年你做过最难的决定是什么?
讲一个真实的取舍,比如「项目要不要重构」「要不要换方向」,重点讲你怎么权衡、最后结果如何。别讲太私人的事。
# 第二个要点:你是怎样的人?
⚡ 30 秒速记
HR想知道两件事:好不好共事、会不会很快离职- 性格别只堆形容词,落到工作里的具体习惯和例子
- 方案被否:先弄清原因,再决定调整还是有理有据地坚持
- 犯错:先承认、同步影响、补救,再复盘怎么避免
- 抗压题和沉默测试:别慌,开口就要有内容;业余爱好挑正常健康的说
这类题是在看你这个人好不好合作、靠不靠谱,所以别背形容词,要用具体的工作习惯说话。 比如别说「我很细心」,说「我提测前会自己把边界情况过一遍,组里后来也照着用了这份清单」。方案被否了,先问清楚原因,确实有问题就改,觉得自己是对的就拿数据再争取一次。犯了错就是承认、同步风险、先补救、再复盘。谈缺点要真实,同时说已经在怎么改,别说「我太追求完美」这种明显的套话。
28. 开场白。 当你和面试官打完招呼后,有可能会出现短暂的沉默,面试官以此测试你的反应和主动性。你可以用以下方式开场:
- 请问我能坐这吗?
- 感谢您安排这次的面试。我很期待我们的谈话。
- 您希望从什么问题开始?
- 您希望我先自我介绍下还是您先介绍下工作岗位情况?
- 在我们开始前,是否需要我再详细介绍下我的简历?
- 请问看了我的简历,哪点最打动您?
29. 请做自我介绍。
- 这是个很宽泛的要求,你可以适当的提问面试官,然后再介绍面试官关心的信息。例如:_____。
- 您最想了解哪方面的信息:工作经历还是工作风格。
- 您是想了解我过去的经历还是最近的成就?
- 您希望我粗略介绍下还是详细叙述我的经历?
- 自我介绍下与现岗位有关的工作经历。
- 自我介绍下性格、理想、优点、成就等。
30. 你的特点是什么?
- 列举与应聘岗位契合的性格优点和技能优势。
- 对雇主而言,我的综合优势明显:有良好的技术背景、参加过管理培训和拥有跨国公司经历。
- 我过去的雇主大多认可我的优点:注重细节、守时、善于整合信息。
- 我有胜任这份工作的技术,热情和学识。
- 我是个很好的倾听者,善于处理人际关系。在工作中,我发现我的同行们很多都技术精湛,精力充沛,乐于奉献,但是都不善沟通,不会协作,不懂互惠互谅。
31. 当你的想法被驳斥你将如何处理?
- 迅速重新组织语言,反省被拒原因。一旦找出问题所在,马上解决,寻求新的方案。
- 不轻言放弃,同时寻求其他方案。
- 举例说明自己曾经方案被拒,调整后被重新启用,并且获得了成功。
- 我希望贵司能有一个开明的环境,鼓励员工多提方案,互相交流。
- 说实话,我不介意我的提议偶尔不被采纳。我明白并不是每一个提议都是合理的。我更愿意求同存异,与时俱进,博采众长。
- 反思己见,细心揣摩。
- 如果我认为我的提案非常优秀,对公司非常有利,我会适当的坚持。
32. 有哪些事将导致你对一个项目失去兴趣?
- 像大多数人一样,对按部就班,机械重复的工作缺少兴趣。赋予我更多的责任,能使我在工作中保持热情和专注的工作更吸引我。
- 很多时候,相处的同事如果刻薄而严肃,比如固执己见,墨守成规,甚至打压异己都会让我对这份工作失去兴趣。
- 过于清闲,自己的能力无法得到充分的发挥。
- 缺少正向反馈,上层处事不公,不够赏罚分明。
- 看不到前途,没有挑战。
33. 下班时间你喜欢做什么?
- 多提体育和文化相关的活动,少提会引起面试官反感的项目。
- 阅读。
- 音乐。
- 健身。
- 球类运动。
- 志愿者。
- 看电影。
- 看展览(可以是跟行业有关)。
34. 当你意识到自己犯错时将如何处理?
- 分析当下的处境再采取下一步行动。
- 对涉事人员道歉,保证不再犯。
- 反省原因,确保不再犯。
- 承担责任,继续工作,确保不再犯。
35. 抗压能力。
- 有时,面试官会保持适当的沉默,以此测试你的抗压能力。不要被吓倒,更不要因为害怕沉默而被迫开口。开口必言之有物。
- 你可以在心理默数,一般数到8时,面试官都会开口打破沉默。
- 询问面试官感兴趣的问题。
- 询问岗位内容和岗位职责。
- 询问公司情况,部门组成。
- 也可以主动询问面试官是否对录用自己还有什么其他问题?
36. 当你感到生气时你会如何表现?
- 当我被排除在项目之外,但我又认为自己有能力参加这个项目的时候,我会感到生气。但我不会任由情绪控制自己,会主动询问决策人缘由,冷静处理。
- 我是一个性情平和、积极向上的人,这有助于我在遇事不顺时保持冷静。我认为沟通可以防止引起愤怒和沮丧,也是处理事情的关键。
- 我会冷静下来,整理思绪,不冲动行事。愤怒往往使人口不择言。
- 我会直言不讳,不会用沉默对抗使我感到生气的人或事。
- 只要不触碰我的底线(比如缺乏责任心、不作为等),一般我不会轻易生气。
- 我会先将自己置身事外,将真正激怒我的缘由记录下来,我往往会发现,那些让我感到愤怒的事情并没有我想的那样对我造成伤害。
37. 处于压力下,你将如何工作?
- 压力就是动力,压力使我做事更有效率。我自认能在任何环境下都专注于完成任务的人。
- 总的来说,我是个有计划的人,很少让自己处于压力之下,但对于意料之外的事也能很好的处理。如果压力无法避免,我也会尽量克服压力。
- 我抗压能力很强。在上份工作中,我就在非常紧急的期限内顺利完成项目。
- 如果压力来自于同事,我会努力解决它。我明白人与人之间的误会和矛盾都会打压士气,我想我应该是个不错的调停者。
- 遇到压力的时候,我会努力让自己吃好,睡好,锻炼好身体,以此来应对工作中的挑战。
38. 对于你的职业生涯,你有哪些遗憾?
- 我希望我能在将来找到一份理想的工作(描述下自己的职业目标)。
- 老实说,我目前为止没有遗憾。我很清楚自己的目标,也努力得到了我想得到的成就。
- 作为一名职场新人,暂时还不好说有什么遗憾。
- 我很遗憾在我过去的职业生涯中没有发挥我最大的潜力。
- 我后悔没有更早的投入到自己的事业中,认为做什么都是一样的。随着我的成熟,我开始明白做自己真正喜欢的事情才是职业生涯中最重要的。
39. 你不相信我们会履行达成的协议吗?
- 这个问题往往在你与面试官达成某项口头协议但是你提出需要书面协议之后。
- 我只是希望能把协议规范化,保证我们的沟通没有问题。
- 我当然相信贵司,但是我只是建议把我们的沟通内容记录下来,以免产生误解。
- 只是防止以后贵司其他部门,如人事需要了解我们的协议时,我可以有所凭证。
- 我当然相信贵司,记录下来只是方便我更仔细的研读。
- 这无关信任。书面协议更加专业,更加有效,以免将来产生不必要的问题。
40. 你有哪些优缺点?
- 充满热情,精力旺盛,工作努力。
- 工作专注,效率高。
- 能保持长时间工作的状态。
- 其他。
41. 在未来的一年中,你最想得到哪方面的提升?
- 提高自身能力的同时,提高自己组员的水平,共同成长。
- 更好的了解_____的市场需求。
- 工作方面,想参加一个_____培训提高自己的技能。私人生活上,想练习下_____(这里可以提一些对社交有帮助的活动或是兴趣爱好)。
- 对公司来说,想提高市场份额,维护好关键客户。
42. 能否举例说明你在工作中的创新?
- 去年,我策划组织并举办了一场贸易展,取得了巨大的成功。这得益于我在摊位的设计和实施上的创新。
- 我非常善于分析并多角度的观察事物。能欣赏不同的思维方式,接受不同的观点。
- 我善于倾听,能够为同事提供思路,帮助他们更好的完成工作。
- 在我看来,创新便是能从不同的或者时全新的角度去思考并发现各种可能性的一种能力。我在上一份工作中,曾经:_____。
- 我会思考,并将所思化为行动。纸上谈兵不过是空中楼阁,创意必须能在实际中运用。
43. 你如何形容自己的个性?
- 思考下自己的真实个性,而不是你认为面试官想要你展现的个性。
- 乐于迎接挑战,喜欢处理问题,不会被困难所吓倒。
- 执行力高。
- 善于学习。
- 善于分析,对数字敏感。
- 处事高效,可靠。
- 善于交际,开朗。
44. 当被告知你的方案不奏效时你将如何处理?
- 在修改我的方案前,我会听取建议,看是否合理。
- 我非常乐于接受他们的真诚的建议。
- 最初,很难接受自己的方案被否绝,但事实上,这也是个激励自己重新思考,提高自己的机会。
- 只要能完成任务,我很乐意接受新的思路新的方案。
- 我会弄明缘由,只要新的方案能更快更好的完成任务,我会欣然接受。
45. 你如何定义成功?
- 我认为成功是应该被量化的。比如,我决定让手下员工接受培训,尽管竞争激烈,但在半年间,减少了9%的流转率。
- 我认为成功就是超既定的目标不断前进。
- 成功就像是一段旅程,会随着时间而改变。对现在的我而言,找一份能发挥我的潜力,让我变得与众不同的工作便是成功。
- 成功是是拥有不断学习的能力。并让学识丰富我的人生。
- 成功就是不畏艰难,遇到问题不放弃。
- 成功便是不忘初心。始终保持真诚。很多人为了成功放弃了自己的原则,但是往往时间会让他们付出代价。
46. 你的领导风格时怎样的?
- 平易近人。
- 以身作则。
- 有福同享,有难同当。
- 照章办事,有据可依。
- 开明,自由。
- 富有激情,感染力。
47. 你最喜欢的网站是哪个?为什么?
- 可以选择一个与你工作有关的,充满学术性和知识性的网页。
48. 在你的职业生涯中对你鼓舞最大的人是谁?为什么?
- 第一份工作的领导。一个好的领导能丰富员工的人生。我从他身上学会了尊重和欣赏他人。
- 我的父亲。他让我明白工作不分贵贱。每一份工作都有他的价值。
- 我的导师。他一直支持鼓励我尝试新的事物,不畏惧失败。我希望我能将这种精神传递下去。
- 我六年级时的一位任课老师。他能发现每个学生身上的闪光点,告知学生每一个个体都是独一无二的。这份独特的礼物我倍感珍惜,在我的职业生涯中,不断的鼓舞着我。
- 其他,可举例说明。
49. 你的工作风格是怎样的?
- 我更倾向于团队工作。我认可他人的贡献,努力培养团队精神,给团队中的每一位成员树立正确的价值观。
- 我是个实干派。我喜欢直面核心,并解决问题,喜欢接受新的挑战。
- 我做事有条理,有计划。喜欢确保细节万无一失。
- 我做事有计划性,有头有尾。成功完成项目会给我带来很大的成就感。
- 能独立完成指派的任务,无需太多的指导。
- 目标导向型。
50. 你未来的目标是什么?
- 扩大视野,增加知识储备,学习_____。
- 举例与自身职业发展有关的目标。
- 岗位(指明一个你感兴趣的部门领导岗,并说明原由)。
- 学习外语(对岗位有利的)。
51. 你如何看待我的面试风格?如果让你来主持面试,你会有哪些不同?
- 我认为您的提问恰到好处,完全能判断谁是合适的候选人。我希望你能发现我非常合适。
- 你的面试安排非常合理,所提的问题直接而全面。过程有条不紊,我相信完全能为这岗位寻找到合适的候选人。
- 您非常友善,提问也非常翔实。最初,我有一些紧张,但是您平复了我的情绪并提供了很多信息,使我确定我很适合这个工作。
- 感谢您给我足够的机会展示自己。
52. 当你面临失业的时候,你将如何处理负面影响?
- 一开始会非常困难,但是我会克服失业的迷茫,坚持寻找新的工作。
- 一开始会感到绝望,但是后来慢慢发现这也是开始一份新工作的机会。
- 持续学习,保持自身的竞争力,以此保持自己的自信心。
- 先多花时间陪伴家人朋友。然后重新审视自身,开始寻找新的工作。
53. 你最大的失败是什么?你从中吸取了哪些教训?
- 尽量减少对失败细节的描述,特别是不要情绪化。侧重于描述你从失败的经历中学到的东西。
- 学会两手准备。当计划失败时,能马上启动第二套备选方案。
- 在我目前的职业生涯中还没有可以回答这个问题的经历,我可以说说我在学校时期遇到的类似的事情。没能按时完成论文以至没能取得好的成绩。让我加深了对时间的敏感,让我明白必须按时完成任务。
- 失败并不可耻,只要你能从中有所得。如果你没有失败过,只能说明你不曾尝试。
- 我曾在一个快速发展的行业工作,一下扩招了很多员工,当经济下行时,我不得不解雇其中一部分人。使我明白眼光必须放长远,不要轻易做出判断。
- 我在职业生涯的早期,就职前没有做好充分的调查,入职后不久便离职。自此,我学会在做决定前先做仔细的调查。
54. 你的缺点和局限是什么?
- 提一些与你的工作无关的缺点。并且着重讨论你如何客服他们。最重要的是真诚。不要自以为是的编造。
- 不懂拒绝。后来我发现把我的安排和截止日等标注在日历上非常有帮助。当我被求助时,我可以给出合理的理由去拒绝。
- 非常讨厌浪费时间,这也使我对他人表现的非常不耐烦。为了克服这一点,我强迫自己理清思路,提前告知他人自己的项目流程,有效避免无意义的解释,浪费时间。
- 当我超负荷工作时,我往往会忽略一些常规性的任务。我意识到这个问题后,我会每天花一刻钟的时间更新我的安排,整理文件,把第二天重要的事情记录下来。
- 头天工作太晚影响第二天的工作。强迫自己定时睡觉,养精蓄锐开始第二天的工作。
- 不会在众人面前表达自己的观点。最近,我跟我的领导也讨论了这个问题,并且跟他分享了我的观点,也得到了他的鼓励,使我更有自信大声的说出我的想法。
55. 请描述下你的理想职业和理想领导。
- 理想的工作:
- 不断学习,不断成长,不断变强;
- 学有所用,能够体现自身价值
- 理想的公司:
- 尊重下属的价值,贡献,给予成长的机会。
- 中型公司,互相熟识。
56. 你的长期目标是什么?
- 在一个能长期发展的岗位上工作。帮助公司拓展业务。
- 在一个能让我发挥能力和潜力的公司工作。
- 回学校继续进修。增强自己技能,与时俱进。以便能胜任管理岗。
57. 如果你被告知今天的表现不是很理想,你将如何处理?
- 不要表现的过分抗拒和对立,也不要感到内疚和歉意。保持积极,自信的态度,尊重对方,听取建议和指导。
- 请告知我今天哪里表现的不理想?
- 请问我哪里还需要改进?
- 感谢您的反馈,如果你给我一些建议,我会努力改进,对这份工作我还是很感兴趣的。
- 我很渴望得到这份工作,我也认为自己是适合的人选。大概是太紧张了,没有发挥好。
58. 什么样的情况,让你无法做出决定?
- 有些不受欢迎但又必须要做的决定。
- 解雇员工。
- 当某一职位空出时,在两个同样热情和富有竞争力的候选人中做选择。
- 很难拒绝别人的请求。
- 在决定是启用老人还是新人完成项目时会两难。老人富有经验,但是不给新人机会则永远无法发现他们的潜力。
- 当我的意见和大家相左的时候,很难决定是尊崇大家的意见还是坚持自己的看法。
59. 请描述下你过的最糟糕的一天,又是如何度过的?
- 遇到裁员,部门被裁撤一半的员工。当时就算是被留下的也很难保持好的心态。我只能加倍努力的工作以避免过多沉浸于裁员的阴影中。
- 我的直系上司辞职的时候。工作中,我跟她配合非常默契,他的离开让我非常不舍。后来,新领导的风格完全不同,但是我也试着与他建立良好的工作关系。
- 曾经在一个项目中估算错误,不得不重组人员,纠正错误。幸好,最终结果没有受影响,但是给其他人造成了很多额外的工作量。
- 我最糟糕的经历是曾经有人在公司传播关于我的谣言。这些流言不但不真实还恶意中伤我。我与散步谣言的人对峙,让他停止对我的中伤。
- 当我意识到我无法按时完成所有的项目时,我感到很沮丧。如今,我学会了给自己的计划预留一些时间,以免出现意外情况而无法按时完成。
60. 你是否言行一致?
- 是的,我的价值观指导我的行为,比如:
- 热爱工作。
- 尽职尽责。
- 富有创造性。
- 勤奋。
- 单纯诚信。
61. 在你的下一份工作中,你最满意的一点将是什么?
- 能实现我以下三个目标:_____(跟工作有关的)。
- 能负责大型项目:_____。
- 好的团队,自由的环境。
- 能展现自身才华,帮助公司解决问题:_____。
💬 面试官追问
你的缺点是什么?别说追求完美。
说一个真实但不致命的,比如「以前不太会拒绝,手上事情多了会延期,现在会先排优先级,跟需求方确认哪些可以往后放」。缺点加改进动作,一起说。
你和同事在技术方案上有分歧,怎么处理?
对事不对人,先把双方方案的优缺点列出来,能用数据说话就写个小原型或测一下。还定不下来就请
leader或更有经验的同事一起评估,定了就按决定执行。线上出了个问题是你导致的,你怎么处理?
第一时间说出来、评估影响、能回滚先回滚,补救完再复盘是哪个环节没卡住,补上检查手段,比如加测试用例或上线检查清单。藏着不说是最扣分的。
面试官突然不说话了,你该怎么办?
别慌着瞎补充。可以问「这块我需要再展开一下吗」,或者顺势问岗位的情况。沉默有时就是在看你稳不稳。
下班时间你一般做什么?
真实说就行,运动、阅读、写博客都可以。如果有写技术博客或参与开源,可以顺带一提,但别说「下班也一直在学习」这种让人觉得不真实的话。
# 第三个要点:你是否适合这个企业?
⚡ 30 秒速记
- 看的是文化契合度和求职动机,以及会不会待得久
- 先做功课:公司业务、主力产品、近期动态、技术博客,回答里引用具体细节
- 「为什么选我们」给具体理由:业务方向、技术挑战、团队做事方式,别说「平台大」
- 评价前领导、前同事、离职原因:不批评,讲学到了什么、为什么想换环境
- 「能待多久」要真诚,说清你希望长期发展的前提
判断适不适合一家公司,面试官看的是你的目标和他们的岗位能不能长期对上。 所以答「为什么来我们这」之前一定要做功课:看看公司的产品、技术博客、最近在做的事,回答里能说出具体细节,比如「看到你们在做跨端方案的迁移,我之前正好做过类似的事」。问到前领导、前同事、为什么离职,原则是不批评,讲讲学到了什么、想换什么样的环境。不了解的信息就坦白说,并借机问一下团队对这个岗位的期望。
62. 你将与我们一起相处多久?
- 我希望能长期任职,至少_____年。
- 只要我对公司有贡献,关系融洽,我愿意长期服务。
- 我更喜欢稳定的工作。
- 只要有进步的空间,有前途,并且公司也满意我的表现,我就能一直工作下去。
63. 如何形容你的上一任领导?
- 不要批评你的上任领导。即使关系不融洽,也可以说说他带给你的积极影响或者你从他身上学到的东西。
- 在这行经验丰富,知识渊博的人才。
- 有自信,有竞争力。
- 平易近人。
- 我从他身上学到了很多,比如:_____(如何与人相处,如何开展谈判,如何据理力争等)。
64. 你将如何对团队合作做出贡献?
- 我喜欢通过团队协作来完成项目。这有利于加强个体间的联系,培养合作意识。我很愿意在下一份工作中为加强团队凝聚感做贡献。
- 我很喜欢以一明成员的身份进行团队合作。我欣赏每一个人的观点、能力以及对团队的贡献。互相交换观点,并鼓励每一个人发挥自己的特长,以此加强团队精神。
- 我乐于倾听别人的意见并分享我的观点。我相信用我的才智提出我的方案便是给整个团队做出贡献。
- 我相信每个人的意见和建议都应该被听取和尊重,人人都是平等的。让所有人都感受到他的价值被认可,全面加强团队合作精神。
65. 为什么放弃上一份工作?
- 我所在的部门经历了重组,而我还是希望能从事原来的工作。
- 我的专业和原岗位不够匹配,我的领导也无法提供更合适的岗位给我。
- 我负责的项目结束了。我希望能有更广阔的平台和发展空间。
- 我所在的部门因预算等原因被裁撤。
- 我被调离到与我的专业不匹配的岗位上,跟上司谈判后觉得应该找一份更适合我的工作。
- 我和我的上司在_____意见无法达成一致。经过考虑,换一份工作更好。
66. 你如何看待你的下属对你的看法?
- 有条理,注重细节。
- 自由,公平,开放。
- 平易近人,好相处。
- 敬业,认真。
- 严于律己,宽以待人。
- 良师益友。
67. 请形容下在你工作中遇到的最难相处的人。
- 某一任领导:咄咄逼人,缺乏耐心。但是我从他那也学到了很多。比如学会了如何有理有据地坚持自己的观点。
- 前任领导:很难相处,言行不一。
- 工作中的同事:充满负能量。
- 工作中的同事:逻辑混乱,目标模糊,难以沟通。
- 很难说我的工作生涯中遇到过多难相处的人。也许是我工作时间还太短。但是我相信面对难相处的人,我会努力去理解他的动机,再去处理。
68. 你愿意在我的位置上坐一天吗?
- 当然,在我能力与之相匹配那天。
- 当然,但是是等您等到升职后。
- 现在不愿意,以后吧。
- 当然,等您发现更舒服的位置后。老实说,我渴望将来能达到您的位置。
69. 如何形容你和同事的关系?
- 非常好,他们非常支持我的工作,也非常信任我。
- 大家互相尊重,非常和谐。
- 彼此了解,对对方的贡献也非常欣赏。
- 非常好,合作非常愉快。能彼此学习,进步。
- 我的工作相对独立,没有太多的常规接触。但我认为,我与人相处非常有礼,处事也很专业。
70. 哪类人是你最难相处的?
- 我处事灵活,与人为善,能跟大多数人很好的相处。但是,对固执己见的人敬谢不敏。
- 我更喜欢与真诚开朗的人共事。
- 通常,我在与人相处上很少遇到问题,除了不太喜欢与总为自己的错误找借口和懒散的人相处。
- 我和那些死板、专制的人相处得不像我和那些直接、互相鼓励合作的人相处得那么好。
- 我更喜欢和那些对他人的出色工作表示认可和赞扬的人一起工作,而不是那些做什么都只想邀功的人。
71. 描述下你与上司发生争执的情况。
- 我们会就公司一些战略层面的观点展开讨论,但是一旦我们考虑了关键因素和可能的结果,我们通常就会达成一致。
- 我们从未发生过争执,但是如果有意见相左,也会试着去理解对方的想法。
- 我记得有一次我们对一个问题的解决方法发生了分歧。但是最终我们没有使用对方的方法,而且用共同讨论得出的第三种方案成功的解决了问题。
- 在过去,我们很少发生分歧,一旦发生,往往是因为看待事物不够全面,当我们了解了各方面后,就会达成共识。
- 在是否聘请顾问解决项目中,我和领导产生了争执,最终我说服了他,并被证实是非常正确的决定。
- 当我无法说服我的领导时,我会接受他的决定,尊重领导的权威。
72. 请形容下你最满意的一个领导。
- 在我过去的三份工作中,我都从与我领导的共事中学到了很多,比如:_____。
- 我的上一任领导乐于跟我们分享各种主意。并且如果得到他的认可,也很乐意实施运用,给予我们认可。
- 我毕业后的第一位领导。他不断鼓励和支持我追逐自己的目标。当我进步时从不吝啬赞扬。当我沮丧时总能给我建议帮助我。
- 我最喜欢的一任领导总是待我非常真诚,虽然有时候过于直白,但是我知道他给我的反馈都是真心实意的。
- 我最喜欢的一位领导总能看到我的成功,而不是只看到我的错误。所以我工作非常努力。
- 我最喜欢的一位领导总是鞭策我不断前进,不断学习,不断成功,不会放任我自暴自弃。
- 我最喜欢的一位领导会不断的让我接受挑战,促使我越来越强大。
73. 如果你领导提出的计划或者制定的政策与你的想法南辕北辙,你将如果处理?
- 我会让领导了解我的想法,而不是与领导对抗。我相信交流是非常重要的。
- 我认可领导的方案或者计划,但是也会提出建议反复测试,以求更加完善。
- 在提出我的计划前我会先开展全面的调查,确保自己的方案有建设性,并有策略的提出自己的建议。
- 曾经当我和领导意见相左的时候我会感到非常的羞耻,但后来我意识到这是一种不成熟的心态,这意味着我跟领导没有建立坚实的关系。自从想明白以后,我会努力和每一任领导建立良好的关系,能自信的表达不同的观点。
- 我会私下表达我的不同观点,不会当面反驳领导。
74. 如何评价你的上家单位?
- 尽量回答积极的一面,即使上家单位有让你不满意的地方,也着重说下你从中学到的经验。
- 我的上家雇主非常专业。日常运营有序,奖罚得当。在那里,我学会了高效的、及时的、以目标为导向的工作。
- 我在上家单位的时间很短,但是同事都非常的友善,离职的时候也非常的友好。
75. 如何处理办公室政治?
- 我尽量专注于自身的工作,不让自己卷入这些斗争。也会详细的记录自己的工作,以免出现权责不清的纠纷。
- 我不喜欢说闲话,如果我不小心听到也会无视。流言蜚语是有害无益的,传播流言蜚语是惹上麻烦的主要原因,也是不尊重同事的表现。
- 当事情出错并且影响到我,我会合理的提出意见。不会浑水摸鱼,制造矛盾。
- 我尊重同事,以诚待人,无论对方是谁,处于哪个阶层。如果出现问题,我会指出并提出解决方案。由于我是个值得信赖的人,所以同事也很愿意严肃的对待我的提案。
- 我认为了解自己的盲点很重要。我会小心地注意任何小集团或派系的形成,并了解他们的动机。这样我就不会有意无意地疏远办公室里的其他人。
76. 请讨论一个你在职业生涯中做过的有争议的决定。
- 我向领导提出离职后被挽留,并且得到很多许诺,但是我还是决定重新找工作,因为:_____。
- 同事劝我放弃在某一项目中的利益,因为:。 但是我坚持我的做法,因为:。
- 我坚持推进一项计划,但领导有所顾虑,我从各方面说服了他,项目得以顺利进行。
- 做我领导,我往往是最终的决策者。为了让下属更好的执行,我决定让他们参与其中,这样能让他们得到相关的信息,能更好的理解我的选择,能明白我为什么做这样的决定,能有更宏观的视角。
77. 你为何认为在工作中沟通是十分重要的?
- 交流是成功的一个关键因素。一个人是否能够更好的完成任务往往取决于他的沟通能力。
- 频繁的沟通可以有效的分享信息。能将消息传递给所有人,给人更多的参与感,也更容易互相理解。
- 真诚的沟通——说我所想,想我所说,是一个企业的血脉。当人们不愿意表达并掩饰自己的真实想法时,误会就会随之产生。
- 同事相处中,清楚明细的表达是首要的,特别是在传递关键信息和下达指令时。
78. 你团队的合作风格是什么?
- 我是一个有团队精神的人,经常主动领导一个团队,积极性高、专注力强,对自己的领导能力有信心。我会提出很多问题,以确保每个人都能跟上,而且我会非常注意,从不让自己显得专横或排斥新想法。
- 我非常专注于手头的项目,如果我们偏离了既定轨道,我会引导团队成员回到正轨,确保工作尽可能完全和有效地完成。
- 我重视团队合作,喜欢合作,愿意聆听大家的意见和建议,在工作中达成共识。
- 我是个有想法的人,喜欢挑战。我鼓励其他人接受新的不同项目,并不断寻找新的方法去克服问题。
- 我做事很有条理,喜欢让团队保持稳定的步调前进。我重视逻辑和系统性的思维。
- 我发现,当我定期与我的团队联系时——通过电子邮件、会议或去公司拜访——我的效率最高。
79. 你上次的绩效考核成绩如何?
- 非常出色。这是领导跟我之间积极又建设性的交流。我明确达到了目标:_____。
- 总体不错。是一次对我来说非常有帮助的反馈。我意识到在_____我需要在未来的工作中加强训练。
- 不是很满意。我应该多跟领导沟通。对他的期许我还有很多沟通不到位的地方。
- 非常好。(提下自己优异的表现)
80. 你为什么要找工作?
- 我在上一家公司已经工作了X年,我相信我的工作技能和能力都在此期间得到了提高,但是没有进一步的发展空间。我想找一份与我能力更匹配的工作。
- 我希望我的职业生涯有所改变,能服务于更好的公司,比如:_____。
- 行业发展趋势使得更多的公司向海外转移,目睹很多同事被辞退,我意识到我需要寻找新的工作。
- 和无数其他人一样,我也因为最近的经济萧条而被解雇了。尽管我们有许多有能力和有成就的员工,但还是由于我们无法控制的财务原因,整个部门团队被解散。
81. 你为什么长时间没有就职?
- 完善自己的知识体系,比如:_____。
- 对自己进行全面的评估,更好的认识自己,以最大的热情投入到新的工作中。
- 对已收到的offer进行研究,仔细考虑。只接受有意义、有质量的工作岗位。
- 对自己的职业生涯进行反思,我现在很很确定贵司便是我寻求的发展平台。
- 找份工作不难,但是找到一份合适的工作却需要时间和坚持。
- 当下的求职市场不景气,需要更多的努力和毅力去寻找一份合适的工作。
82. 你为什么辞去上份工作?
- 我的专业知识得不到发挥。我相信贵司的岗位能提供更多的机会,以及更好的施展空间。
- 在我从事上一份工作之前,我一直处在一个能激励我成长的工作环境中,在那里我可以全身心地投入工作。我最终意识到,如果我继续留在那个岗位,我的主动性将会磨灭,也将得不到成长。
- 我所在的部门因为战略和财务状况被裁撤。
- 得不到与我能力匹配的晋升机会。
- 我所在的公司在走下坡路,但我知道我必须不断进步,不断磨砺自己的技能。
- 前一份工作不能提供我进步的机会。
- 企业文化和我个人的工作风格不匹配。
83. 你为什么要来我们公司应聘?
- 岗位和公司都符合我的目标。比如:_____。
- 贵公司以卓越著称,我相信我能在未来为贵公司的成功做出积极的贡献。
- 贵司提供的岗位符合我之前的工作经验,我相信我能为公司做出贡献。
- 我关注贵司很久,贵司最吸引我的地方是:_____。
84. 你目前的求职状态如何?
- 诚实告知你目前的状态。除非你真的收到offer,否则不要杜撰。即使你没有拿到offer, 你仍要在面试官面前表现的积极乐观。
- 我有自信。我已经完成了第一阶段:收集信息和分析信息。现在只需要展开第二阶段:联系公司和参加面试。
- 感觉不错,我已经参加了四次面试,包括跟您的面试。正在和其中两家公司洽谈,但我仍未做出承诺,追求更具有吸引力的岗位,对我来说是明智的。
- 收到两家公司的邀请,如果算上贵司,我将考虑加入哪个团队。
- 我每天都在忙着找工作,已经得到了一些好的offer。我希望能在六周内找到一份工作。
85. 是否应聘其他公司?
- 没有,贵司提供的岗位正合我意。在得到结果前我将专注于此次的机会。
- 没有,我刚开始找工作,这里是我认为最适合的工作。
- 是的,面过两家。都是很有意思的公司,但是贵司仍是我的首选。
86. 我们为什么要聘用你而不是其他人?
- 这个岗位非常有吸引力,我相信会有很多候选人跟我一样对这个岗位有兴趣。列举两个特长:_____。
- 我对这份工作非常有兴趣,并且也符合岗位的要求。
- 我的性格、能力和经验都很符合贵司的要求。
87. 如果同意聘用你,你将如何答复?
- 我需要时间考虑。
- 我很高兴,能否告知岗位职责、工作环境等信息。
- 非常感谢您的赏识,我会接受。
88. 有收到其他的入职通知吗?
- 上个月,我参加了三次面试,都是我感兴趣的公司,我对结果很乐观。
- 没有,仍在等之前面试公司的答复。
- 猎头有联系我并提供可能的岗位。
- 我只接触了很少的公司,因为我要确保他们符合我的要求,不想草率做决定。
- 是的,但是贵司仍是我的首选。
- 没有,我刚开始找工作,我想先从最感兴趣的开始。
89. 包括我们公司在内,你将决定接受哪家的offer?
- 我会接受贵司提供的岗位。我相信这是适合我的工作。
- 我会比较公司的优缺点,考虑我的技能和哪家公司更匹配。我的理想是找一家能开展我职业生涯的公司而不仅仅是找一份工作。
- 总的来说我倾向于选择贵司,能否给我一天时间考虑下?
- 很高兴能取得您的认同,我还想就几点细节跟你确认下,看你是否能考虑?
90. 到此为止,你还有什么问题吗?
- 至少提出一个问题;这样能让面试官感觉你对面试是上心的,并且显示你是好问有求知欲的。但不要问的过于深入,也不要问你已经知道的事情。
- 可以提问一些关于工作和公司的事情。
- 提问面试官是否对自己今天的表现满意,是否还会安排后续面试?
- 贵司希望找一个怎样的候选人?
- 可以请面试官做个自我介绍,包括一些公司的介绍。
- 请问前任是离职还是升迁?
- 请问您个人觉得这个岗位最重要最富挑战的点是什么?
💬 面试官追问
你能在我们这干多久?
别随口说「一直干下去」。可以说「希望长期发展,只要能持续成长、做出成绩,没有理由频繁换」,再结合你过往的稳定性。
说说你上一任领导?
讲他的优点和你从他那学到的东西,比如「在方案评审上要求很严,我学会了先写清楚再动手」。就算关系一般,也别在面试里吐槽。
你最难相处的是哪类人?
可以说一类做事方式,比如「出了问题不面对、只找借口的人」,再说你通常怎么和这类人合作。别说具体某个人,也别说「我和谁都处得来」,太假。
你为什么想离开上一家公司?
说客观原因加自己的诉求,比如「项目进入维护期,想做更有挑战的事」。别抱怨薪资低、领导差,这些面试官都会担心在自己这重演。
你对我们公司有什么了解?
说出具体的:主力产品是什么、最近有什么动态、技术博客写过什么。完全没做功课的话,对方会直接认为你只是海投。
# 第四个要点:聘用你,公司需付出多少?
⚡ 30 秒速记
- 本质是谈薪:先查清目标城市、目标级别的市场行情
- 尽量让对方先给预算:「方便先说一下这个岗位的薪资范围吗」
- 必须先报就报区间,下限是你真能接受的数字,别随口说死
- 看总包:月薪 × 发薪月数、年终、股票期权、公积金比例、补贴、调薪和晋升机制
- 上份薪资如实说,可以说清构成;所有承诺写进书面
offer
谈薪时我会先了解岗位职责和对方预算,再给一个有依据的区间,而且谈的是整体回报,不只是月薪。 对方问期望薪资,可以先问「这个岗位的预算范围大概是多少」;非要先报的话,结合市场行情和自己的经验报一个区间,别给一个死数字。只盯月薪容易吃亏,发几个月、年终怎么算、公积金按什么比例交、有没有股票和调薪机制,这些加起来差别很大。年终、股票这类口头说的东西,一定要确认写进书面 offer,免得入职后对不上。
91. 你的上份薪资是多少?
- 直接回答薪水。
- 委婉拒绝,因为和前公司签过保密协议,不对外讨论自己的薪资。如果贵司认为我是合适的人选,我相信工资我们可以协商。
- 如果贵司决定聘用我,我很乐意讨论下我的薪资报酬问题。
92. 你是否愿意降薪?
- 这取决于您希望我降低多少。
- 可以(但是请思考一分钟后再答复,这样可以迫使面试官说出自己的目标薪水)。
- 可以,只要公司能够定期调薪。
- 可以,如果我还可以得到其他非工资福利的话。
- 可以,如果公司环境良好,有晋升机会的话。
- 可以,但是岗位职责还需要重新讨论,在岗位职责和项目上我希望有更多的选择权。
- 考虑到我个人的财务情况,我不接受降薪。
93. 你如何评价你上一份工作的薪资?
- 很简单,我遵循一个准则:多劳多得。
- 总的来说,我的付出超过我所得X倍。
94. 在你现阶段的职业生涯中,为什么没有得到高薪?
- 我以前的工作与我们现在讨论的工作完全不同;受行业限制,薪资水平是比较低的。这是一个非常新的领域,所以大多数员工都认为在经济上所有牺牲是值得的,但我现在意识到,我需要寻求更多的经济保障。
- 薪水不是我最看重的。我最看重的在我喜欢的公司做一份喜欢的工作。
- 我之前的工资并不能完全反应我的所得,公司还提供很多额外的福利。
- 我认为我值得更多,这也是我跳槽的原因。
- 我很幸运在我接受一个岗位的时候,最首要的原因不是薪资。
- 我还会分出额外的时间在工作以外的兴趣上,所以导致工资不是很高,这是我个人的选择。
95. 你认为你值多少?
- 我更看重我的职业前途而不是薪资。也许在我们进一步讨论了我的资历和经验之后,再来看这个问题会比较合适。
- 非常感谢你们能坦言这个问题。在此之前,我们能否再详述下岗位职责,让我也能对这个工作有更全面的了解。
- 我对薪资的要求为:。因为:。
- 我很自信我能达到岗位的要求,所以我的薪资也应该是在最高档。
- 我在这个领域已经工作了X年,我也对这个行业的薪资有所了解。在此基础上,我想我可以基于这个岗位,要求¥_____。
96. 你心目中的薪资水平是多少?
- 我希望得到一份与我的潜力和未来贡献值相匹配的薪水。
- 在3-5年间能达到:_____。
- 在_____到_____之间,等我对岗位有了更具体的了解,我们可以把工资的范围再缩小。
- 根据我的调查,在_____和_____之间。另外我认为我的能力和经验可以拿最高档
- 如果能告诉我贵司对该岗位的薪资预算,对我们讨论这个问题会很有帮助。
97. 在为期6个月培训期中,你是否能接受降低工资?
- 培训期减薪是每个新员工的标准要求,还是有什么特别的原因。
- 对提升自我学习新技能我非常感兴趣,能详细说说关于培训的事吗。
- 我对这份工作非常感兴趣,能等我了解该工作所有的岗位责任后再来谈这个问题吧。
- 完成这次内部培训后,我还有什么额外的责任吗?
- 可以考虑,但是我想知道这个培训为期多久?考虑到我学东西很快,培训时间是取决个人的学习进度吗?
- 不接受,我认为我的能力可以拿全薪。
98. 你寻求哪些福利?
- 医疗保险。
- 岗位培训,技能培训等。
- 据我了解,贵司的福利非常全面。我对贵司在这方面很满意。
- 考虑到这份工作会有很多出差,想了解差旅费的报销问题。
99. 薪资对你有多重要?
- 薪资当然是我选择工作很重要的一个因素。但是我更想在我的工作中有所作为,与志同道合的人一起做喜欢的工作。对我来说,这比钱更重要。
- 薪资是很重要的,并且在我的职业生涯中,我的薪水一直与我的贡献相当。我希望以后也是如此。
- 我认为高工资是对工作价值的肯定。
- 工资很重要,但是实现自我价值更重要。我想要的工作是能展现我的能力和技术,而不仅仅是能提供一份高工资。
100. 你对加班怎么看?
- 如果是任务需要,我可以安排加班。
- 合理的加班我没问题。有加班费吗?
- 我愿意加班直到把工作做完。
- 公司支持在家办加班吗?
- 也许我们可以想法避免加班。
- 这要看加班的时常和频率。理论上我都可以接受,但是实际上,我希望公司能平衡好工作时间和私人时间。
- 只要有合理的理由都可以。
101. 你预期在未来5年内,薪资水平达到多少?
- 增长15-20%。
- 我希望能在未来5年内,磨练自己的能力,在职位和薪水上都有增长。
- 大概_____-_____。
- 由于我的职业生涯才刚刚开始,所以我有理由相信在五年内我会赚得更多,但我无法预测一个具体的数字。
- 这行变化很大,我认为我可以增长50%甚至更多。
💬 面试官追问
你上一份工作的薪资是多少?
如实说,可以拆开讲构成:月薪多少、发几个月、年终情况。虚报很容易在背调或要流水的时候露馅,那就不是谈薪的问题了。
你期望多少?我们预算有限。
先确认对方的范围,看看和你的区间差多少。差得不多可以谈总包里的其他部分,比如签字费、调薪周期;差太多就直说,这样双方都不浪费时间。
能接受降薪吗?
别马上答应也别马上拒绝,先问降多少、什么原因。真的有吸引你的地方(方向、成长、稳定),可以谈条件,比如试用期后调薪写进
offer。手上有另一家的
offer,要拿出来谈吗?可以提,但语气要平和,说清是在比较整体情况,而不是威胁。前提是这个
offer是真的,被识破的话前面的面试都白谈了。口头说的年终奖和股票,要怎么确认?
让
HR写进书面offer,至少要写清楚发放规则和条件。只是口头承诺,入职后真不发也很难追。


