
# 面试高频手写题
建议优先掌握:
instanceof- 考察对原型链的理解new- 对创建对象实例过程的理解call/apply/bind- 对this指向的理解- 手写
promise- 对异步的理解 - 手写原生
ajax- 对ajax原理和http请求方式的理解,重点是get和post请求的实现
# 1 实现防抖函数(debounce)
⚡ 30 秒速记
- 防抖 = 电梯关门:有人进来就重新等,停止触发
wait毫秒后才执行最后一次 - 核心三步:
clearTimeout(timer)→timer = setTimeout(...)→ 到点fn.apply(this, args) - 返回普通函数(不是箭头函数)才能拿到调用时的
this;参数用...args传最后一次的 - 进阶:
immediate首次立即执行、cancel()取消、flush()立刻执行挂起的那次 - 场景:搜索联想、输入校验、
resize结束后重算;React里要用useMemo/useRef保持同一个防抖实例
防抖就是事件连续触发时一直重新计时,停下来超过 wait 才执行一次。 像电梯关门,只要还有人进来就重新等。实现就是闭包里存一个 timer,每次调用先 clearTimeout,再开新的 setTimeout,到点用 fn.apply(this, args) 执行,这样 this 和最后一次的参数都对。和节流的区别是:防抖只要最后一次,持续触发就一直不执行;节流是按固定间隔执行。React 里有个常见坑,每次渲染都 debounce(fn) 出一个新函数,计时器各自独立,等于没防。
防抖函数原理:把触发非常频繁的事件合并成一次去执行 在指定时间内只执行一次回调函数,如果在指定的时间内又触发了该事件,则回调函数的执行时间会基于此刻重新开始计算
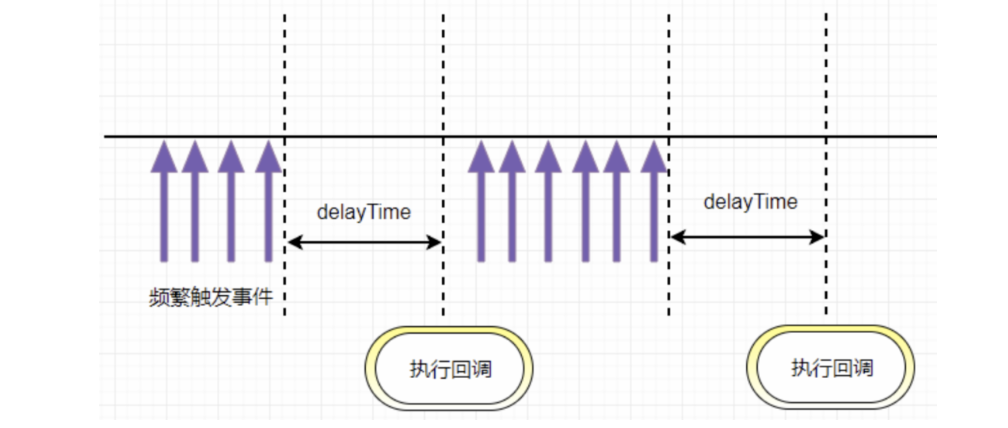
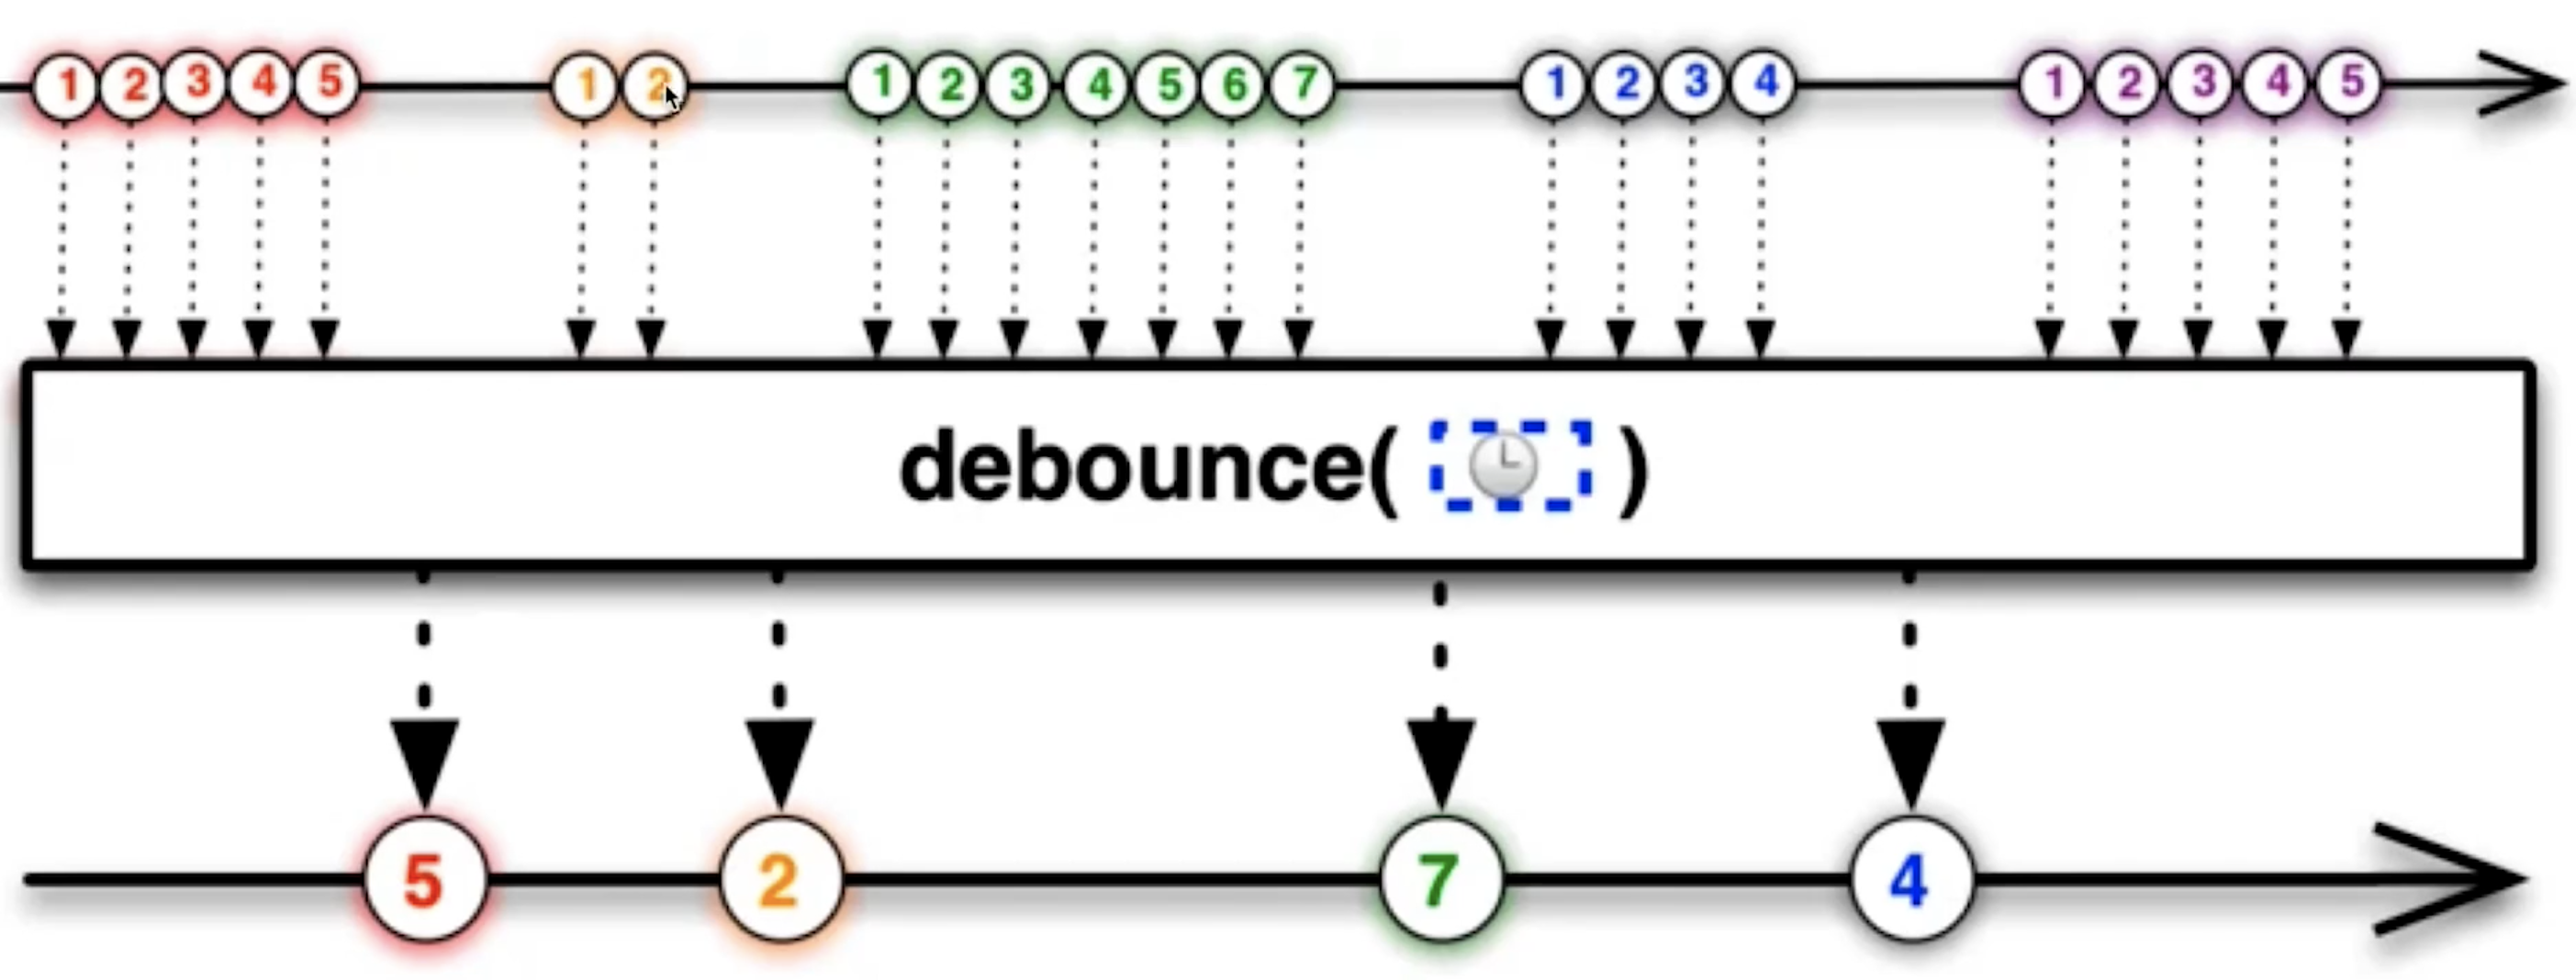
防抖动和节流本质是不一样的。防抖动是将多次执行变为最后一次执行,节流是将多次执行变成每隔一段时间执行
eg. 像百度搜索,就应该用防抖,当我连续不断输入时,不会发送请求;当我一段时间内不输入了,才会发送一次请求;如果小于这段时间继续输入的话,时间会重新计算,也不会发送请求。
手写简化版:
// func是用户传入需要防抖的函数
// wait是等待时间
const debounce = (func, wait = 50) => {
  // 缓存一个定时器id
  let timer = 0
  // 这里返回的函数是每次用户实际调用的防抖函数
  // 如果已经设定过定时器了就清空上一次的定时器
  // 开始一个新的定时器,延迟执行用户传入的方法
  return function(...args) {
    if (timer) clearTimeout(timer)
    timer = setTimeout(() => {
      func.apply(this, args)
    }, wait)
  }
}
适用场景:
- 文本输入的验证,连续输入文字后发送 AJAX 请求进行验证,验证一次就好
- 按钮提交场景:防止多次提交按钮,只执行最后提交的一次
- 服务端验证场景:表单验证需要服务端配合,只执行一段连续的输入事件的最后一次,还有搜索联想词功能类似
面试时写出基础版之后,面试官多半会追问「第一次能不能立刻执行」「能不能取消」。下面这版把两点都补上,代码不长,建议能默写:
function debounce(fn, wait = 300, immediate = false) {
  let timer = null

  function debounced(...args) {
    // 立即执行版:当前没有计时器,说明是一串触发里的第一次
    const callNow = immediate && !timer
    clearTimeout(timer)
    timer = setTimeout(() => {
      timer = null
      // 非立即版在这里执行最后一次
      if (!immediate) fn.apply(this, args)
    }, wait)
    if (callNow) return fn.apply(this, args)
  }

  debounced.cancel = () => {
    clearTimeout(timer)
    timer = null
  }

  return debounced
}

const log = debounce((v) => console.log('search', v), 300)
log('a'); log('ab'); log('abc')
// 300ms 后只输出一次:search abc

const submit = debounce(() => console.log('submit'), 1000, true)
submit(); submit(); submit()
// 立刻输出一次 submit,1 秒内后面两次被吞掉
几个容易丢分的点:返回的 debounced 必须是普通函数,箭头函数拿不到调用时的 this;定时器回调用箭头函数,才能沿用外层的 this 和 args;立即执行版要在定时器到点时把 timer 置空,否则下一轮第一次触发不会立即执行。在 React 里使用时,防抖实例要用 useMemo 或 useRef 固定住,组件卸载时调用 cancel(),避免卸载后还去 setState。
💬 面试官追问
搜索框为什么用防抖不用节流?
产品要的是用户停下来后只查最后一次。节流在输入过程中每隔一段时间就会发一次,中间那些请求都是浪费。防抖的代价是停顿前看不到中间结果,一般
300ms左右体感就可以。组件里写
const onSearch = debounce(fetchList, 300),结果每个字都发了请求,为什么?每次渲染都创建一个新的防抖函数,新函数清不掉旧函数的
timer,等于没防。用useMemo(() => debounce(fetchList, 300), [])或useRef保持同一个实例,卸载时调cancel()。提交按钮想防重复点击,但第一次点击要立刻有反应,怎么改?
尾部防抖会让第一次点击延迟
wait才执行。要用立即执行版:timer为空时直接执行,然后开计时器,wait内的点击只重置计时。不过防重复提交更靠谱的是请求期间禁用按钮,再加服务端幂等。防抖后的函数有返回值,调用方拿得到吗?
尾部执行版拿不到,原函数是在定时器里执行的,调用时它还没跑。立即执行版可以同步返回;要拿尾部那次的结果,就让防抖函数返回一个
Promise,到点后resolve。搜索联想加了防抖,偶尔还是显示上一个关键词的结果,为什么?
防抖只减少请求数,管不了返回顺序。前一个请求慢、后一个快,旧结果后到就把新结果盖了。每次请求带上序号,返回时不是最新的就丢弃,或者用
AbortController取消上一个请求。
# 2 实现节流函数(throttle)
⚡ 30 秒速记
- 节流 = 水龙头限流:持续触发时每隔
wait最多执行一次,不会一直拖着不执行 - 时间戳版:
now - last >= wait才执行,首次立即执行,但停止前的最后一次可能丢 - 定时器版:没有挂起任务时才开
setTimeout,首次要等wait,停止后还会补一次 - 完整版两者结合:首次立即、末尾补一次(
lodash的leading/trailing) - 场景:滚动加载、拖拽、
resize、埋点上报;和视觉动画相关的优先考虑requestAnimationFrame
节流是不管事件触发多频繁,每隔一段时间最多只执行一次。 有两种写法:时间戳版记录上次执行时间,间隔够了就执行,所以第一次立刻响应,但停止触发前最后那次如果没到间隔就丢了;定时器版是没有挂起任务时才开一个 setTimeout,第一次要等,停下后还会补执行一次。拖拽这种既要跟手又要落到终点的场景,单用哪种都不完整,得把两种结合起来。和防抖比,节流能在持续触发的过程中有节奏地给反馈,滚动加载、拖拽就该用它。
节流函数原理:指频繁触发事件时,只会在指定的时间段内执行事件回调,即触发事件间隔大于等于指定的时间才会执行回调函数。总结起来就是:事件,按照一段时间的间隔来进行触发。


像dom的拖拽,如果用消抖的话,就会出现卡顿的感觉,因为只在停止的时候执行了一次,这个时候就应该用节流,在一定时间内多次执行,会流畅很多
手写简版
使用时间戳的节流函数会在第一次触发事件时立即执行,以后每过 wait 秒之后才执行一次,并且最后一次触发事件不会被执行
时间戳方式:
// func是用户传入需要防抖的函数
// wait是等待时间
const throttle = (func, wait = 50) => {
  // 上一次执行该函数的时间
  let lastTime = 0
  return function(...args) {
    // 当前时间
    let now = +new Date()
    // 将当前时间和上一次执行函数时间对比
    // 如果差值大于设置的等待时间就执行函数
    if (now - lastTime > wait) {
      lastTime = now
      func.apply(this, args)
    }
  }
}

setInterval(
  throttle(() => {
    console.log(1)
  }, 500),
  1
)
定时器方式:
使用定时器的节流函数在第一次触发时不会执行,而是在 delay 秒之后才执行,当最后一次停止触发后,还会再执行一次函数
function throttle(func, delay){
  var timer = 0;
  return function(){
    var context = this;
    var args = arguments;
    if(timer) return // 当前有任务了,直接返回
    timer = setTimeout(function(){
      func.apply(context, args);
      timer = 0;
    },delay);
  }
}
适用场景:
- 拖拽场景:固定时间内只执行一次,防止超高频次触发位置变动。
DOM元素的拖拽功能实现(mousemove) - 缩放场景:监控浏览器
resize - 滚动场景:监听滚动
scroll事件判断是否到页面底部自动加载更多 - 动画场景:避免短时间内多次触发动画引起性能问题
总结
- 函数防抖:
限制执行次数,多次密集的触发只执行一次- 将几次操作合并为一次操作进行。原理是维护一个计时器,规定在
delay时间后触发函数,但是在delay时间内再次触发的话,就会取消之前的计时器而重新设置。这样一来,只有最后一次操作能被触发。
- 将几次操作合并为一次操作进行。原理是维护一个计时器,规定在
- 函数节流:
限制执行的频率,按照一定的时间间隔有节奏的执行- 使得一定时间内只触发一次函数。原理是通过判断是否到达一定时间来触发函数。
时间戳版丢尾、定时器版首次要等,面试官经常让你把两者合起来,也就是「首次立即执行,停止后再补最后一次」:
function throttle(fn, wait = 200) {
  let last = 0
  let timer = null
  let lastArgs, lastThis

  return function (...args) {
    const now = Date.now()
    const remaining = wait - (now - last)
    lastArgs = args
    lastThis = this

    if (remaining <= 0) {
      // 间隔够了:立即执行,顺手清掉挂起的尾调用
      if (timer) { clearTimeout(timer); timer = null }
      last = now
      fn.apply(this, args)
    } else if (!timer) {
      // 间隔不够:挂一个尾调用,用最新的参数
      timer = setTimeout(() => {
        last = Date.now()
        timer = null
        fn.apply(lastThis, lastArgs)
      }, remaining)
    }
  }
}

const onMove = throttle((x) => console.log('move', x), 100)
// 0ms 调 onMove(1) → 立刻输出 move 1
// 30ms 调 onMove(2)、60ms 调 onMove(3) → 挂起
// 100ms 左右输出 move 3(用的是最后一次参数)
关键是 remaining 这个变量:它决定这次是立即执行还是挂尾调用,而且尾调用的延迟是剩余时间而不是整段 wait,这样两次执行之间始终接近 wait。尾调用要用最后一次保存的参数,拖拽的终点位置才不会丢。真实项目里没必要自己维护这套,lodash 的 throttle 还支持 cancel()、flush(),边界处理更完整。
💬 面试官追问
滚动触底加载用了防抖,用户一直滚就一直不加载,为什么?
防抖每次触发都重新计时,持续滚动时回调一直被推迟。触底检测要用节流,比如每
200ms检查一次。更好的做法是在列表底部放个哨兵元素,用IntersectionObserver监听,根本不用监听scroll。拖拽用时间戳版节流,松手后元素没停在最终位置,为什么?
时间戳版里,最后一次触发如果离上次执行不够
wait,就被直接丢了,最终位置没写进去。要么用带尾调用的版本,要么在mouseup里再手动更新一次最终位置。定时器版节流里回调抛了错,之后事件全失效了,为什么?
func.apply抛错后,后面的timer = 0没执行,if (timer) return永远成立。把复位放进finally:try { func.apply(ctx, args) } finally { timer = 0 },错误照常往外抛去上报。resize既要开始时立刻算一次,又要结束后校正一次,怎么写?时间戳加定时器结合:间隔够了就立即执行并清掉挂起的定时器;不够就挂一个定时器在剩余时间后执行,并记住最新参数。
lodash的throttle默认leading: true, trailing: true就是这个行为,项目里直接用它省事。滚动时更新进度条,节流间隔设多少合适?
跟视觉有关的更新,与其猜间隔,不如用
requestAnimationFrame,每帧最多一次,和屏幕刷新率对齐,切到后台标签页还会自动暂停。埋点上报这类纯数据的才用throttle配200ms到1000ms。
# 3 实现instanceOf
⚡ 30 秒速记
- 本质:沿左边对象的原型链往上找,看有没有一层等于右边的
prototype - 循环
proto = Object.getPrototypeOf(proto),等于Ctor.prototype返回true,走到null返回false - 基本类型直接
false;但函数也是对象,只判断typeof x !== 'object'会把函数漏掉 - 规范行为会先看右边的
Symbol.hasInstance;右边不可调用时原生会抛TypeError - 跨
iframe的数组instanceof Array是false,判断数组用Array.isArray
instanceof 就是沿着左边对象的原型链往上找,看能不能碰到右边构造函数的 prototype。 实现就是一个循环:先拿 Object.getPrototypeOf(obj),每层和 Ctor.prototype 比,相等返回 true,一直到 null 都没找到就返回 false。前置判断要注意,基本类型直接返回 false,但函数也是对象,(() => {}) instanceof Function 是 true,只判断 typeof === 'object' 会漏掉。另外用 Object.getPrototypeOf 别用 __proto__,后者是历史遗留的访问器,Object.create(null) 创建的对象上就没有它。
思路:
- 步骤1:先取得当前类的原型,当前实例对象的原型链
- 步骤2:一直循环(执行原型链的查找机制)
- 取得当前实例对象原型链的原型链(
proto = proto.__proto__,沿着原型链一直向上查找) - 如果 当前实例的原型链
__proto__上找到了当前类的原型prototype,则返回true - 如果 一直找到
Object.prototype.__proto__ == null,Object的基类(null)上面都没找到,则返回false
- 取得当前实例对象原型链的原型链(
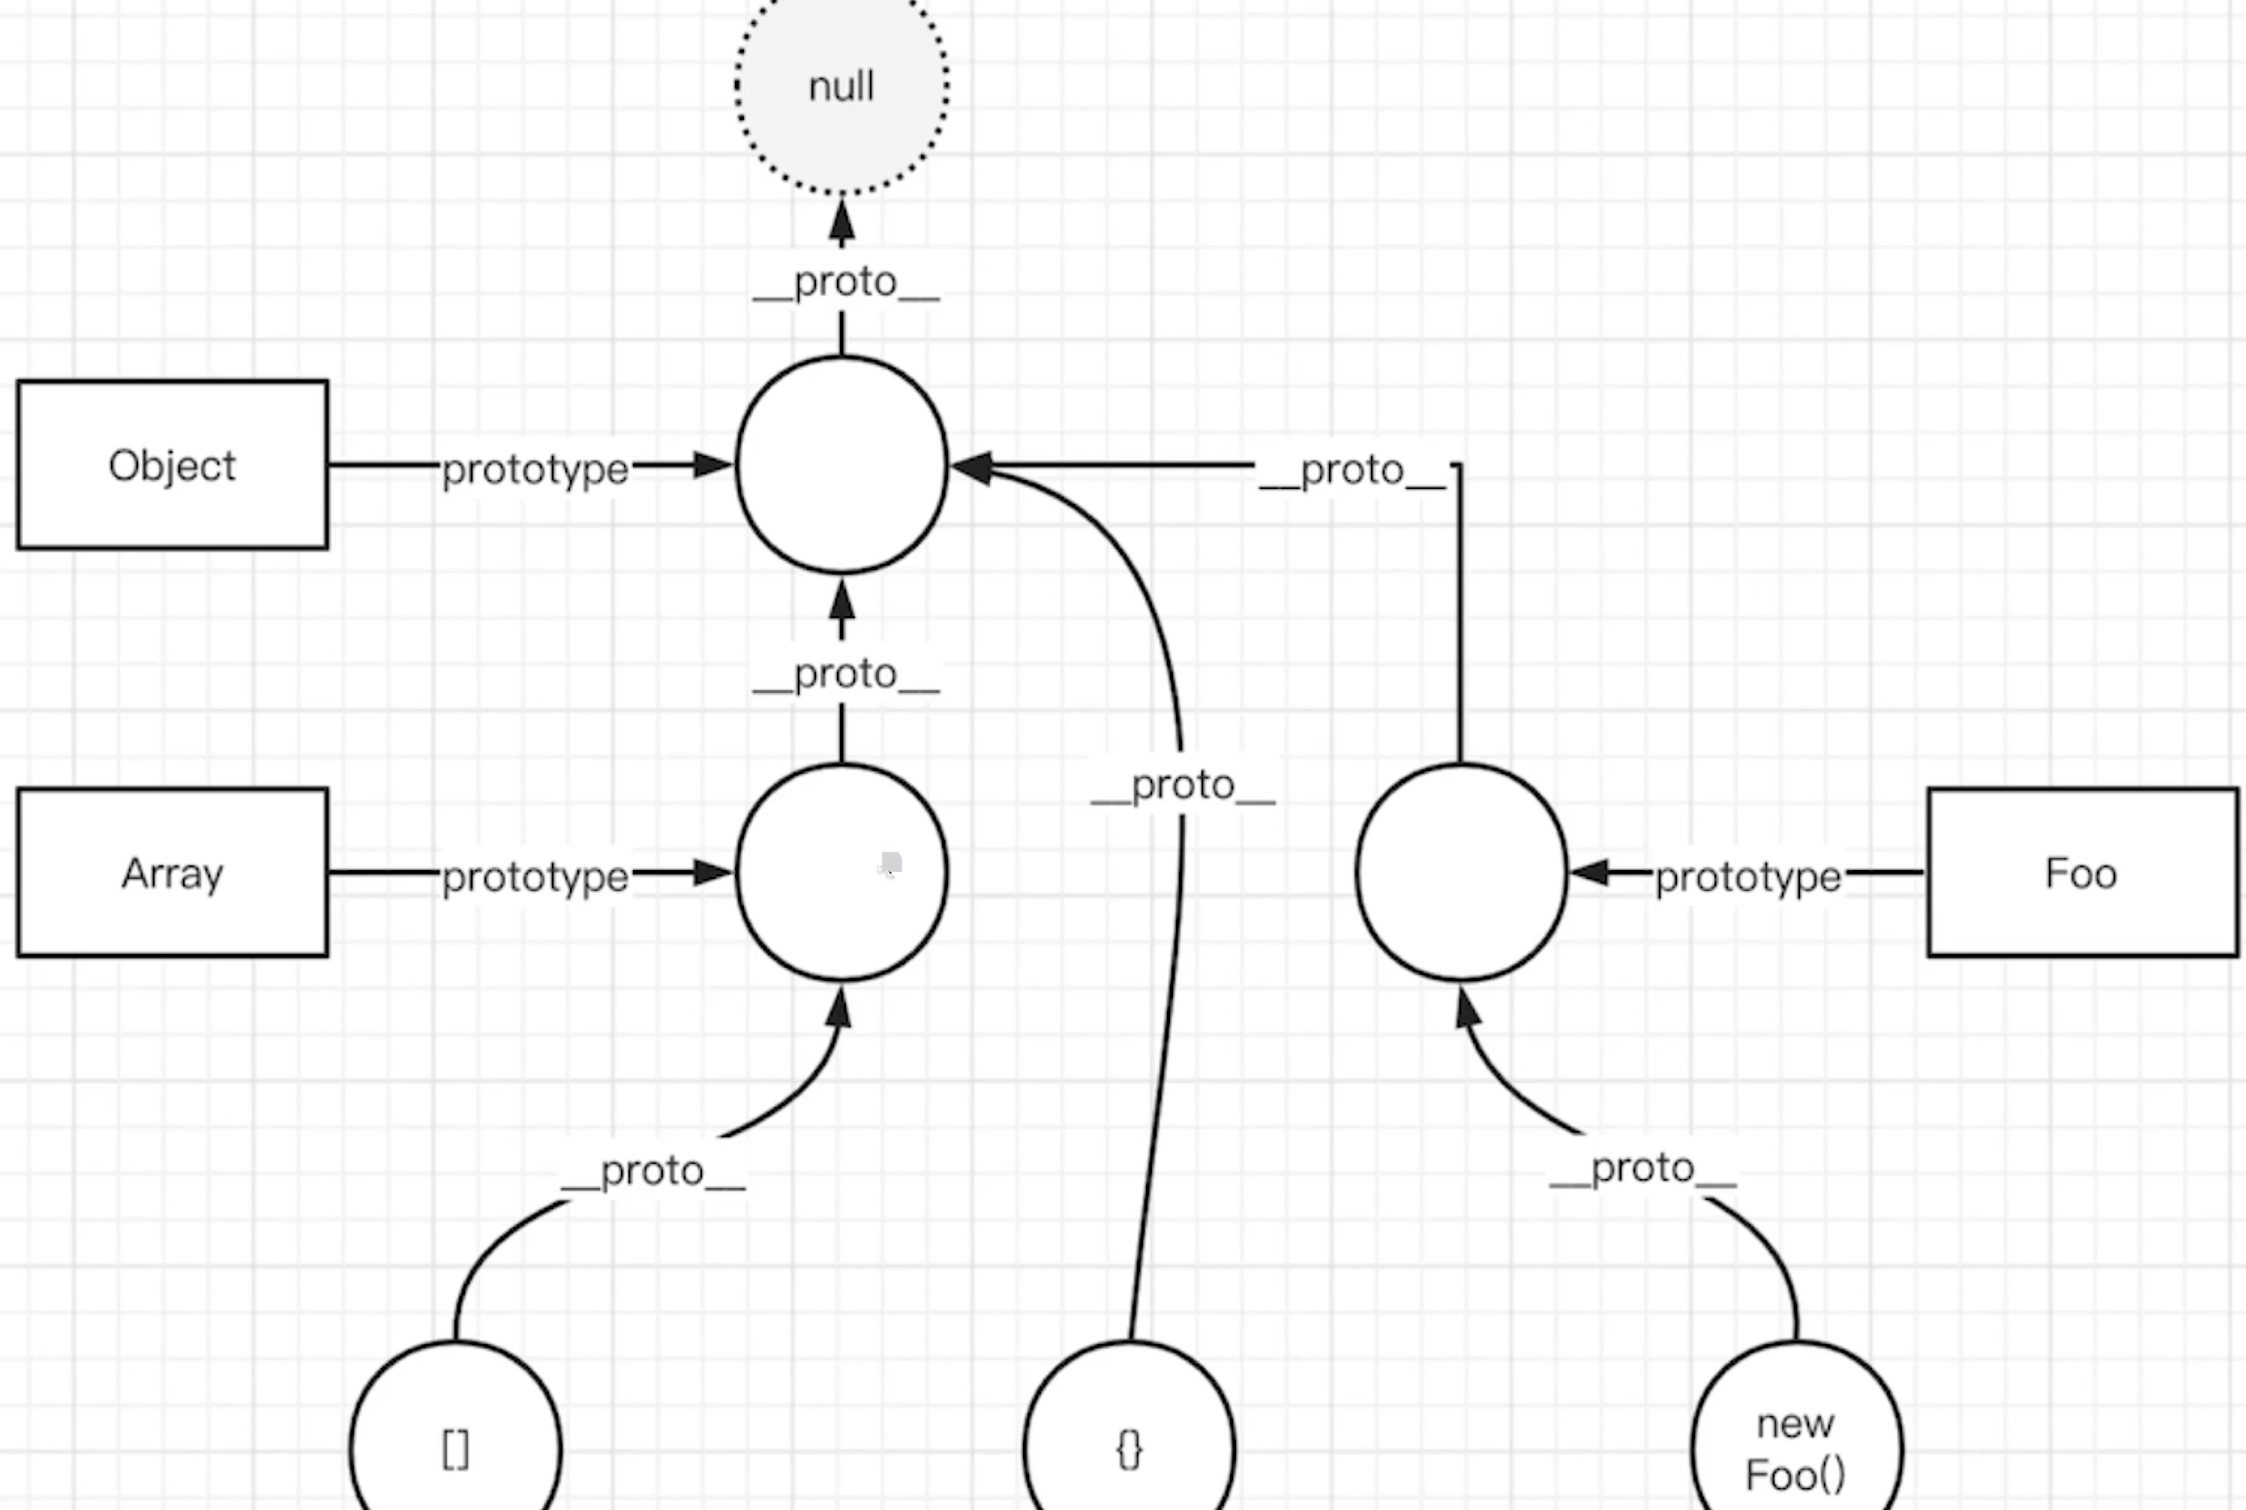
// 实例.__ptoto__ === 构造函数.prototype
function _instanceof(instance, classOrFunc) {
    // 由于instance要检测的是某对象,需要有一个前置判断条件
    //基本数据类型直接返回false
    // 函数也是对象,要放行,否则 _instanceof(() => {}, Function) 会误判为 false
    if(instance == null || (typeof instance !== 'object' && typeof instance !== 'function')) return false;

    let proto = Object.getPrototypeOf(instance); // 等价于 instance.__ptoto__
    while(proto) { // 当proto == null时,说明已经找到了Object的基类null 退出循环
        // 实例的原型等于当前构造函数的原型
        if(proto == classOrFunc.prototype) return true;
        // 沿着原型链__ptoto__一层一层向上查
        proto = Object.getPrototypeOf(proto); // 等价于 proto.__ptoto__
    }

    return false
}

console.log('test', _instanceof(null, Array)) // false
console.log('test', _instanceof([], Array)) // true
console.log('test', _instanceof('', Array)) // false
console.log('test', _instanceof({}, Object)) // true
console.log('test', _instanceof([], Object)) // true,要往上走两层
console.log('test', _instanceof(() => {}, Function)) // true
💬 面试官追问
_instanceof(() => {}, Function)返回了false,你的实现哪里有问题?前置判断写成了
typeof instance !== 'object'就返回false,函数的typeof是'function',被误杀了。改成if (instance === null || (typeof instance !== 'object' && typeof instance !== 'function')) return false。为什么推荐
Object.getPrototypeOf,不用__proto__?__proto__是挂在Object.prototype上的访问器,Object.create(null)出来的对象没有它,读出来是undefined。Object.getPrototypeOf是标准API,对任何对象都可靠。iframe里传来的数组,arr instanceof Array是false,为什么?每个
iframe有自己的全局环境和自己的Array构造函数,数组原型链上是那个窗口的Array.prototype,和当前页的不是同一个对象。判断数组用Array.isArray(arr),其他内建类型用Object.prototype.toString.call(x)。类上定义了
static [Symbol.hasInstance](n) { return n % 2 === 0 },2 instanceof Even是什么?true。规范里instanceof先查右边有没有Symbol.hasInstance,有就直接用它的返回值,基本类型也能返回true。手写版要对齐规范,就得先处理这一步。手写版右边传个普通对象
{}会怎样?原生的呢?原生
x instanceof {}直接抛TypeError,因为右边必须可调用。手写版里({}).prototype是undefined,循环跑完返回false,属于静默出错,最好加一句if (typeof Ctor !== 'function') throw new TypeError()。
# 4 实现new的过程
⚡ 30 秒速记
new四步:建空对象 → 原型指向Ctor.prototype→ 以它为this执行构造函数 → 看返回值- 构造函数返回对象或函数就用返回值;返回基本类型或不写
return,就用新建的对象 - 判断返回值写
res !== null && (typeof res === 'object' || typeof res === 'function'),只写typeof res === 'object'会误收null、漏掉函数 - 箭头函数和
class手写版都处理不了:前者没有prototype,后者用apply调直接报错;要完整模拟用Reflect.construct
手写 new 就三件事:连原型、绑 this 执行、按返回值决定交出谁。 我一般写 const obj = Object.create(Ctor.prototype),再 const res = Ctor.apply(obj, args),最后返回值是对象或函数就用它,否则返回 obj。返回值判断只写 typeof res === 'object' 有两个坑:null 也是 'object',会把 null 交出去;构造函数返回函数时又漏判了。说白了这是理解题,业务里没人会替换原生 new。
new操作符做了这些事:
- 创建一个全新的对象
obj,继承构造函数的原型:这个对象的__proto__要指向构造函数的原型prototype - 执行构造函数,使用
call/apply改变this的指向(将obj作为this) - 返回值为
object类型则作为new方法的返回值返回,否则返回上述全新对象obj
function myNew(constructor, ...args) {
  // 1. 基于原型链 创建一个新对象,继承构造函数constructor的原型对象(Person.prototype)上的属性
  let newObj = Object.create(constructor.prototype);
  // 添加属性到新对象上 并获取obj函数的结果
  // 调用构造函数,将this调换为新对象,通过强行赋值的方式为新对象添加属性
  // 2. 将newObj作为this,执行 constructor ,传入参数
  let res = constructor.apply(newObj, args); // 改变this指向新创建的对象

  // 3. 如果函数的执行结果有返回值并且是一个对象, 返回执行的结果, 否则, 返回新创建的对象地址
  return typeof res === 'object' ? res: newObj;
}
// 用法
function Person(name, age) {
  this.name = name;
  this.age = age;

 // 如果构造函数内部,return 一个引用类型的对象,则整个构造函数失效,而是返回这个引用类型的对象,而不是返回this
  // 在实例中就没法获取Person原型上的getName方法
}
Person.prototype.say = function() {
  console.log(this.age);
};
let p1 = myNew(Person, "poety", 18);
console.log(p1.name);
console.log(p1);
p1.say();
💬 面试官追问
构造函数里
return null,你的myNew也返回了null,哪错了?typeof null === 'object',判断没排除它。原生new遇到return null会忽略,照样返回新对象。改成res !== null && (typeof res === 'object' || typeof res === 'function') ? res : obj。Person里写了return { a: 1 },实例上的say方法没了,为什么?返回对象会顶掉新建的那个
this,你拿到的是一个对象字面量,原型是Object.prototype,不是Person.prototype。这时p instanceof Person也是false。拿
myNew去创建一个class的实例,会怎样?直接抛
TypeError: Class constructor Person cannot be invoked without 'new'。class不允许被apply调用,想模拟得用Reflect.construct(Ctor, args),它还能正确设置new.target。传一个箭头函数进去呢?
箭头函数没有
prototype,Object.create(undefined)先抛错。原生new (() => {})也会报is not a constructor,所以手写版开头校验一下typeof Ctor === 'function' && Ctor.prototype就够了。为什么用
Object.create,不直接写obj.__proto__ = Ctor.prototype?效果一样,但
__proto__是历史遗留的访问器,标准里放在附录;创建之后再改原型,还会让引擎的隐藏类优化失效。Object.create一步建好,更干净。
# 5 实现call方法
⚡ 30 秒速记
- 原理:
obj.fn()里this就是obj→ 把函数临时挂到context上调一次再删掉 - 临时键用
Symbol(),不会覆盖对象原有属性 - 基本类型上下文要包装:
Object('abc');null/undefined在非严格模式下指向globalThis - 默认参数
context = window只拦得住undefined,拦不住null,而且SSR里根本没有window - 调用和删除放进
try...finally,函数抛错也不留脏属性
call 的手写思路是借「谁调用,this 就指向谁」这条规则:把函数挂成 context 的一个临时方法,调完删掉。 键名用 Symbol() 防撞名,参数用 ...args 透传,返回值原样交回去。边界有两个最容易漏:默认参数拦不住 null,typeof null 又是 'object',跳过包装后直接对 null 赋值报错;函数里一抛异常,delete 那行就跑不到了。我会写成 context = context == null ? globalThis : Object(context),再加一层 try...finally。
call做了什么:
- 将函数设为对象的属性
- 执行和删除这个函数
- 指定
this到函数并传入给定参数执行函数 - 如果不传入参数,默认指向
window
分析:如何在函数执行时绑定this
- 如
var obj = {x:100,fn() { this.x }} - 执行
obj.fn(),此时fn内部的this就指向了obj - 可借此来实现函数绑定
this
原生
call、apply传入的this如果是值类型,会被new Object(如fn.call('abc'))
//实现call方法

// 相当于在obj上调用fn方法,this指向obj
// var obj = {fn: function(){console.log(this)}}
// obj.fn() fn内部的this指向obj
// call就是模拟了这个过程
// context 相当于obj

Function.prototype.myCall = function(context = window, ...args) {
  if (typeof context !== 'object') context = new Object(context) // 值类型,变为对象

  // args 传递过来的参数
  // this 表示调用call的函数fn
  // context 是call传入的this

  // 在context上加一个唯一值,不会出现属性名称的覆盖
  let fnKey = Symbol()
  // 相等于 obj[fnKey] = fn
  context[fnKey] = this; // this 就是当前的函数

  // 绑定了this
  let result = context[fnKey](...args);// 相当于 obj.fn()执行 fn内部this指向context(obj)

  // 清理掉 fn ,防止污染(即清掉obj上的fnKey属性)
  delete context[fnKey];

  // 返回结果
  return result;
};
//用法:f.call(this,arg1)

function f(a,b){
 console.log(a+b)
 console.log(this.name)
}
let obj={
 name:1
}
f.myCall(obj,1,2) // 不传obj,this指向window
💬 面试官追问
fn.myCall(null)直接报Cannot set properties of null,为什么?默认参数只在值是
undefined时生效,null原样进来;typeof null又是'object',跳过了包装,最后执行的是null[fnKey] = this。统一用context == null ? globalThis : Object(context)处理。函数执行时抛了错,宿主对象上会留下什么?
会留一个
Symbol键的属性,因为delete在抛错之后没机会执行。改成try { return context[key](...args) } finally { delete context[key] },错误照常往外抛,对象也干净。严格模式下
fn.call('abc'),原生和你的手写版结果一样吗?不一样。严格模式下原生
call不包装,this就是字符串'abc',typeof this === 'string';手写版永远包成String对象。只有非严格模式两边才一致。对象被
Object.freeze冻住了,myCall还能用吗?不能。冻结对象加不了属性,严格模式下赋值直接抛错,非严格模式静默失败,接着
context[key]是undefined,调用报not a function。这是挂属性方案天生的边界,原生call没这问题。临时键为什么不用固定的
'__fn__'?对象万一本来就有
__fn__,先被覆盖,调完又被delete,原数据就丢了。Symbol()每次都是新值,不可能撞上。
# 6 实现apply方法
⚡ 30 秒速记
- 和
call一个套路,只差参数:apply(ctx, [a, b])收数组,call(ctx, a, b)逐个传 - 第二个参数可能不传或是
null,要兜底成[],否则...undefined直接报错 - 原生
apply接受类数组(arguments、{ length: 2, 0: 'a' }),手写版用Array.from转一下更稳 - 有了
myCall可以直接return this.myCall(ctx, ...(args ?? [])),少维护一份挂属性逻辑 ES6之后fn.apply(null, arr)大多能用fn(...arr)代替
apply 就是参数收成数组的 call,挂临时属性、调用、删除这三步完全一样。 区别全在参数处理:上面的代码写的是 context[fnKey](...args),args 不传就成了 ...undefined,直接抛 TypeError,所以要先 args = args == null ? [] : Array.from(args)。原生 apply 本来就接受 arguments 这种类数组,用 Array.from 顺手也兼容了。现在写业务基本用展开运算符 fn(...arr),apply 主要出现在老代码和这类手写题里。
思路: 利用
this的上下文特性。apply其实就是改一下参数的问题
Function.prototype.myApply = function(context = window, args) {  // 这里传参和call传参不一样
  if (typeof context !== 'object') context = new Object(context) // 值类型,变为对象

  // args 传递过来的参数
  // this 表示调用call的函数
  // context 是apply传入的this

  // 在context上加一个唯一值,不会出现属性名称的覆盖
  let fnKey = Symbol()
  context[fnKey] = this; // this 就是当前的函数

  // 绑定了this
  let result = context[fnKey](...args);

  // 清理掉 fn ,防止污染
  delete context[fnKey];

  // 返回结果
  return result;
}
// 使用
function f(a,b){
 console.log(a,b)
 console.log(this.name)
}
let obj={
 name:'张三'
}
f.myApply(obj,[1,2])
💬 面试官追问
fn.myApply(obj)没传第二个参数就报错了,怎么改?...undefined不可迭代,会抛TypeError。原生apply第二个参数是null或undefined时当空参数处理,手写版加一句const list = args == null ? [] : Array.from(args)。Math.max.apply(null, arr)和Math.max(...arr)有区别吗?结果一样,展开写法更直观。两者都会把元素逐个当参数压栈,数组到几十万量级都可能报
Maximum call stack size exceeded,这种量级老老实实用reduce循环。传个类数组
{ length: 2, 0: 'a', 1: 'b' }进去,原生和手写版表现一样吗?原生可以,等价于传
('a', 'b')。手写版直接...args会报不可迭代,因为普通对象没有Symbol.iterator;用Array.from(args)转一下就和原生一致了。已经写好了
myCall,myApply还要再写一遍挂属性吗?没必要,
Function.prototype.myApply = function (ctx, args) { return this.myCall(ctx, ...(args ?? [])) }就完事,null处理、异常清理都复用myCall里那份。面试官要看你分别手写也行,说清楚两者只差在参数这一步。
# 7 实现bind方法
⚡ 30 秒速记
bind返回新函数、不立即执行;绑定时和调用时的参数要拼起来(f.bind(o, 1)(2)→f(1, 2))- 被
new调用时this让给新实例,绑定的context作废,靠this instanceof fBound判断 fBound.prototype = Object.create(self.prototype),让new出来的实例还能用原函数的原型方法- 多次
bind只有第一次的this生效,后面只能继续追加参数 - 箭头函数没有
prototype,设原型前要判断;每次bind都是新函数,解绑事件要存引用
bind 是「先把 this 和一部分参数存起来,返回一个新函数,以后再调」。 普通调用时走 self.apply(context, [...args, ...innerArgs]);被 new 调用时 this instanceof fBound 为真,就把 this 换成新实例,因为 new 的优先级比 bind 高。再给 fBound.prototype 接上原函数的原型,实例才拿得到原型方法。上面讲解里说「箭头函数底层是 bind」不对,箭头函数是词法 this,压根没有自己的 this,只是效果看着像绑定。
bind的实现对比其他两个函数略微地复杂了一点,涉及到参数合并(类似函数柯里化),因为bind需要返回一个函数,需要判断一些边界问题,以下是bind的实现
bind返回了一个函数,对于函数来说有两种方式调用,一种是直接调用,一种是通过new的方式,我们先来说直接调用的方式- 对于直接调用来说,这里选择了
apply的方式实现,但是对于参数需要注意以下情况:因为bind可以实现类似这样的代码f.bind(obj, 1)(2),所以我们需要将两边的参数拼接起来 - 最后来说通过
new的方式,对于new的情况来说,不会被任何方式改变this,所以对于这种情况我们需要忽略传入的this - 箭头函数的底层是
bind,无法改变this,只能改变参数
简洁版本
- 对于普通函数,绑定
this指向 - 对于构造函数,要保证原函数的原型对象上的属性不能丢失
Function.prototype.myBind = function(context = window, ...args) {
  // context 是 bind 传入的 this
  // args 是 bind 传入的各个参数
  // this表示调用bind的函数
  let self = this; // fn.bind(obj) self就是fn

  //返回了一个函数,...innerArgs为实际调用时传入的参数
  let fBound = function(...innerArgs) {
      //this instanceof fBound为true表示构造函数的情况。如new func.bind(obj)
      // 当作为构造函数时,this 指向实例,此时 this instanceof fBound 结果为 true,可以让实例获得来自绑定函数的值
      // 当作为普通函数时,this 默认指向 window,此时结果为 false,将绑定函数的 this 指向 context
      return self.apply( // 函数执行
        this instanceof fBound ? this : context,
        args.concat(innerArgs) // 拼接参数
      );
  }

  // 如果绑定的是构造函数,那么需要继承构造函数原型属性和方法:保证原函数的原型对象上的属性不丢失
  // 实现继承的方式: 使用Object.create
  fBound.prototype = Object.create(this.prototype);
  return fBound;
}
// 测试用例

function Person(name, age) {
  console.log('Person name:', name);
  console.log('Person age:', age);
  console.log('Person this:', this); // 构造函数this指向实例对象
}

// 构造函数原型的方法
Person.prototype.say = function() {
  console.log('person say');
}

// 普通函数
function normalFun(name, age) {
  console.log('普通函数 name:', name);
  console.log('普通函数 age:', age);
  console.log('普通函数 this:', this);  // 普通函数this指向绑定bind的第一个参数 也就是例子中的obj
}


var obj = {
  name: 'poetries',
  age: 18
}

// 先测试作为构造函数调用
var bindFun = Person.myBind(obj, 'poetry1') // undefined
var a = new bindFun(10) // Person name: poetry1、Person age: 10、Person this: fBound {}
a.say() // person say

// 再测试作为普通函数调用
var bindNormalFun = normalFun.myBind(obj, 'poetry2') // undefined
bindNormalFun(12)
// 普通函数name: poetry2
// 普通函数 age: 12
// 普通函数 this: {name: 'poetries', age: 18}
注意:
bind之后不能再次修改this的指向(箭头函数的底层实现原理依赖bind绑定this后不能再次修改this的特性),bind多次后执行,函数this还是指向第一次bind的对象
💬 面试官追问
fn.bind(a).bind(b)()里的this是谁?是
a。第一次bind返回的函数内部写死了apply(a, ...),第二次bind改的只是外层包装的this,内层根本不看。参数倒是会一层层往前拼。addEventListener时写了this.onClick.bind(this),移除时同样写法移不掉,为什么?每次
bind都返回新函数,两次引用不相等。在构造函数里存一份this.handleClick = this.onClick.bind(this),注册和移除都用它;React类组件里用箭头函数写类字段也是这个道理。new (Person.bind(obj, 'Tom'))()出来的实例,name挂在谁身上?挂在新实例上,
obj不会被改。new调用时this instanceof fBound为真,apply用的是新实例,预置参数'Tom'照样生效。对箭头函数调用
myBind,为什么在设置原型那一行就报错了?箭头函数的
prototype是undefined,Object.create(undefined)会抛TypeError。加个判断:if (self.prototype) fBound.prototype = Object.create(self.prototype)。顺带一提,原生bind返回的函数本身没有prototype,手写版加它是为了让instanceof判断走得通。bind返回的函数,length和name跟原生一样吗?不一样。原生
bound.name是'bound fn',length是原函数形参数减去预置参数个数;手写版length是0、name是'fBound'。要对齐可以用Object.defineProperty改,面试提一句就够。
# 8 实现深拷贝
⚡ 30 秒速记
- 先问清范围:只有普通对象和数组?有没有循环引用、
Date/Map/Set、原型和Symbol键? - 主线:基本类型直接返回,对象递归复制;
WeakMap存「源对象 → 副本」,再碰到就返回副本 JSON.parse(JSON.stringify())会丢undefined/ 函数 /Symbol,Date变字符串,循环引用直接抛错- 生产代码先看
structuredClone(Chrome 98+、Node 17+):支持循环引用和Map/Set/Date,但拷不了函数和DOM节点,也不保留原型
深拷贝先别急着写,先问清楚要拷到什么程度,范围决定代码量。 主线就是递归:基本类型直接返回,对象和数组新建一个,再逐个属性拷进去。循环引用靠 WeakMap 记录「原对象对应哪个副本」,再遇到同一个对象直接返回副本,这样环和共享引用都保住了。业务里我一般先用 structuredClone,它原生支持循环引用和 Map、Set、Date,只有碰到函数或者要保留类实例的原型时才自己写。
💬 面试官追问
structuredClone都有了,还要手写深拷贝吗?大部分场景不用了。但它碰到函数会抛
DataCloneError,类实例拷完原型丢了变成普通对象,getter也会被求值成普通属性。数据里有这些就得手写,或者用lodash的cloneDeep。JSON.parse(JSON.stringify({ a: undefined, d: new Date() }))结果是什么?a直接没了,d变成ISO格式的字符串,不再是Date。另外NaN、Infinity会变成null,有循环引用就抛Converting circular structure to JSON。为什么记录已拷贝对象用
WeakMap不用Map?键是源对象,
WeakMap不会阻止它被回收。其实单次克隆里用Map也不会真泄漏,函数结束整张表一起回收,WeakMap主要是语义更贴切,表被意外长期持有时也更安全。一棵上万层嵌套的树,递归深拷贝爆栈了,怎么办?
改成显式栈迭代:栈里放「源节点 + 目标容器」,每次弹出一个,把子节点压进去。层级极深的数据别用递归,调用栈深度一般也就一万层左右。
在
React里更新嵌套状态,要不要先deepClone一份?不要,只沿修改路径做浅拷贝,比如
{ ...state, user: { ...state.user, name } }。整棵深拷贝会让所有子对象引用都变,memo的引用比较全部失效,反而多渲染。嵌套深就上immer。
# 1 简洁版本
⚡ 30 秒速记
- 面试简版:
typeof obj !== 'object' || obj === null直接返回,否则按数组 / 对象新建容器,for...in+hasOwnProperty递归 JSON一行版:丢函数、undefined、Symbol,RegExp变{},Date变字符串,有环直接抛错- 进阶版:
WeakMap破环,new value.constructor()保留原型,Date/RegExp单独new for...in只拿可枚举的字符串键,Symbol键会丢,要全的话用Reflect.ownKeys
面试写简版深拷贝,十来行递归就够:基本类型原样返回,引用类型新建容器,逐个属性递归。 这一版只认普通对象和数组,Date 会被拷成空对象,碰到循环引用直接爆栈。进阶版补了三样:WeakMap 记住拷过的对象来破环,new value.constructor() 让副本保留原型,Date、RegExp 单独构造。写的时候我会先说清楚「这版支持哪些类型」,面试官更想听的是边界意识,不是分支堆得多。
简单版:
const newObj = JSON.parse(JSON.stringify(oldObj));
局限性:
- 他无法实现对函数 、RegExp等特殊对象的克隆
- 会抛弃对象的
constructor,所有的构造函数会指向Object - 对象有循环引用,会报错
面试简版
function deepClone(obj) {
  // 如果是 值类型 或 null,则直接return
  if(typeof obj !== 'object' || obj === null) {
    return obj
  }

  // 定义结果对象
  let copy = {}

  // 如果对象是数组,则定义结果数组
  if(obj instanceof Array) {
    copy = []
  }

  // 遍历对象的key
  for(let key in obj) {
      // 如果key是对象的自有属性
      if(obj.hasOwnProperty(key)) {
        // 递归调用深拷贝方法
        copy[key] = deepClone(obj[key])
      }
  }

  return copy
}
调用深拷贝方法,若属性为值类型,则直接返回;若属性为引用类型,则递归遍历。这就是我们在解这一类题时的核心的方法。
进阶版
- 解决拷贝循环引用问题
- 解决拷贝对应原型问题
// 递归拷贝 (类型判断)
function deepClone(value,hash = new WeakMap){ // 弱引用,不用map,weakMap更合适一点
  // null 和 undefiend 是不需要拷贝的
  if(value == null){ return value;}
  if(value instanceof RegExp) { return new RegExp(value) }
  if(value instanceof Date) { return new Date(value) }
  // 函数是不需要拷贝
  if(typeof value != 'object') return value;
  let obj = new value.constructor(); // [] {}
  // 说明是一个对象类型
  if(hash.get(value)){
    return hash.get(value)
  }
  hash.set(value,obj);
  for(let key in value){ // in 会遍历当前对象上的属性 和 __proto__指代的属性
    // 补拷贝 对象的__proto__上的属性
    if(value.hasOwnProperty(key)){
      // 如果值还有可能是对象 就继续拷贝
      obj[key] = deepClone(value[key],hash);
    }
  }
  return obj
  // 区分对象和数组 Object.prototype.toString.call
}
// test

var o = {};
o.x = o;
var o1 = deepClone(o); // 如果这个对象拷贝过了 就返回那个拷贝的结果就可以了
console.log(o1);
💬 面试官追问
简版深拷贝传一个
new Date()进去,出来是什么?一个空对象
{}。Date是对象,走进了copy = {}分支,可它的时间值存在内部槽里,for...in一个属性都遍历不到。要单独写if (obj instanceof Date) return new Date(obj)。两个字段指向同一个
user,简版拷完变成两个独立对象,算错吗?严格说对象图被改了:拷完之后改
a.user.name,b.user不再跟着变。用WeakMap存「源 → 副本」,第二次碰到同一个user直接返回第一次的副本,共享关系就保住了。进阶版用
new value.constructor(),有什么风险?构造函数可能要求必传参数,或者有副作用(发请求、计数),无参调用会出错。更稳的写法是
Object.create(Object.getPrototypeOf(value)),只接原型、不跑构造逻辑。对象有
Symbol键,拷完不见了,为什么?for...in和Object.keys都不遍历Symbol键。换成Reflect.ownKeys(obj),它返回所有自有键,包括Symbol和不可枚举的。为什么要加
hasOwnProperty判断?for...in会沿原型链遍历可枚举属性,不过滤的话,原型上加的方法会被拷成副本自己的属性。现在更推荐Object.hasOwn(obj, key),不怕对象自己覆盖了hasOwnProperty。
# 2 实现完整的深拷贝
⚡ 30 秒速记
- 用
Object.prototype.toString分类:可遍历的(Object/Array/Map/Set/Arguments)递归,不可遍历的(Date/RegExp/ 包装对象)各自重建 - 映射表存副本:
map.set(target, cloneTarget),命中返回副本;存true、命中返回target的话,副本会连回原对象 Map的键和值都要递归,Set要往cloneTarget.add,递归时把同一个map传下去RegExp用new RegExp(source, flags)重建,有状态匹配还要补lastIndex- 函数一般直接返回原引用;
toString+new Function重建会丢闭包,开了CSP还直接报错
完整版深拷贝的骨架是「类型分发 + 映射表」:先用 toString 判类型,能遍历的递归,不能遍历的按类型重建。 映射表要存「源对象 → 副本」,如果写成 map.set(target, true)、命中时返回 target,结果副本里的 target 指回了原对象,环没断干净。正确顺序是先建好 cloneTarget,马上 map.set(target, cloneTarget),再递归子属性。函数这块我不建议用正则拆函数体再 new Function,闭包变量全丢,页面开了 CSP 还会直接报错,返回原引用就行。
1. 简易版及问题
JSON.parse(JSON.stringify());
估计这个api能覆盖大多数的应用场景,没错,谈到深拷贝,我第一个想到的也是它。但是实际上,对于某些严格的场景来说,这个方法是有巨大的坑的。问题如下:
- 无法解决
循环引用的问题。举个例子:
const a = {val:2};
a.target = a;
拷贝
a会出现系统栈溢出,因为出现了无限递归的情况。
- 无法拷贝一些特殊的对象,诸如
RegExp, Date, Set, Map等 - 无法拷贝
函数(划重点)。
因此这个api先pass掉,我们重新写一个深拷贝,简易版如下:
const deepClone = (target) => {
  if (typeof target === 'object' && target !== null) {
    const cloneTarget = Array.isArray(target) ? []: {};
    for (let prop in target) {
      if (target.hasOwnProperty(prop)) {
          cloneTarget[prop] = deepClone(target[prop]);
      }
    }
    return cloneTarget;
  } else {
    return target;
  }
}
现在,我们以刚刚发现的三个问题为导向,一步步来完善、优化我们的深拷贝代码。
2. 解决循环引用
现在问题如下:
let obj = {val : 100};
obj.target = obj;

deepClone(obj);//报错: RangeError: Maximum call stack size exceeded
这就是循环引用。我们怎么来解决这个问题呢?
创建一个Map。记录下已经拷贝过的对象,如果说已经拷贝过,那直接返回它行了。
const isObject = (target) => (typeof target === 'object' || typeof target === 'function') && target !== null;

const deepClone = (target, map = new Map()) => {
  if(map.get(target))
    return target;


  if (isObject(target)) {
    map.set(target, true);
    const cloneTarget = Array.isArray(target) ? []: {};
    for (let prop in target) {
      if (target.hasOwnProperty(prop)) {
          cloneTarget[prop] = deepClone(target[prop],map);
      }
    }
    return cloneTarget;
  } else {
    return target;
  }
}
现在来试一试:
const a = {val:2};
a.target = a;
let newA = deepClone(a);
console.log(newA)//{ val: 2, target: { val: 2, target: [Circular] } }
好像是没有问题了, 拷贝也完成了。但还是有一个潜在的坑, 就是map 上的 key 和 map 构成了强引用关系,这是相当危险的。我给你解释一下与之相对的弱引用的概念你就明白了
在计算机程序设计中,弱引用与强引用相对,
被弱引用的对象可以在任何时候被回收,而对于强引用来说,只要这个强引用还在,那么对象无法被回收。拿上面的例子说,map 和 a一直是强引用的关系, 在程序结束之前,a 所占的内存空间一直不会被释放。
怎么解决这个问题?
很简单,让 map 的 key 和 map 构成弱引用即可。ES6给我们提供了这样的数据结构,它的名字叫WeakMap,它是一种特殊的Map, 其中的键是弱引用的。其键必须是对象,而值可以是任意的
稍微改造一下即可:
const deepClone = (target, map = new WeakMap()) => {
  //...
}
3. 拷贝特殊对象
可继续遍历
对于特殊的对象,我们使用以下方式来鉴别:
Object.prototype.toString.call(obj);
梳理一下对于可遍历对象会有什么结果:
["object Map"]
["object Set"]
["object Array"]
["object Object"]
["object Arguments"]
以这些不同的字符串为依据,我们就可以成功地鉴别这些对象。
const getType = Object.prototype.toString.call(obj);

const canTraverse = {
  '[object Map]': true,
  '[object Set]': true,
  '[object Array]': true,
  '[object Object]': true,
  '[object Arguments]': true,
};

const deepClone = (target, map = new Map()) => {
  if(!isObject(target))
    return target;
  let type = getType(target);
  let cloneTarget;
  if(!canTraverse[type]) {
    // 处理不能遍历的对象
    return;
  }else {
    // 这波操作相当关键,可以保证对象的原型不丢失!
    let ctor = target.prototype;
    cloneTarget = new ctor();
  }

  if(map.get(target))
    return target;
  map.put(target, true);

  if(type === mapTag) {
    //处理Map
    target.forEach((item, key) => {
      cloneTarget.set(deepClone(key), deepClone(item));
    })
  }

  if(type === setTag) {
    //处理Set
    target.forEach(item => {
      target.add(deepClone(item));
    })
  }

  // 处理数组和对象
  for (let prop in target) {
    if (target.hasOwnProperty(prop)) {
        cloneTarget[prop] = deepClone(target[prop]);
    }
  }
  return cloneTarget;
}
不可遍历的对象
const boolTag = '[object Boolean]';
const numberTag = '[object Number]';
const stringTag = '[object String]';
const dateTag = '[object Date]';
const errorTag = '[object Error]';
const regexpTag = '[object RegExp]';
const funcTag = '[object Function]';
对于不可遍历的对象,不同的对象有不同的处理。
const handleRegExp = (target) => {
  const { source, flags } = target;
  return new target.constructor(source, flags);
}

const handleFunc = (target) => {
  // 待会的重点部分
}

const handleNotTraverse = (target, tag) => {
  const Ctor = targe.constructor;
  switch(tag) {
    case boolTag:
    case numberTag:
    case stringTag:
    case errorTag:
    case dateTag:
      return new Ctor(target);
    case regexpTag:
      return handleRegExp(target);
    case funcTag:
      return handleFunc(target);
    default:
      return new Ctor(target);
  }
}
4. 拷贝函数
- 虽然函数也是对象,但是它过于特殊,我们单独把它拿出来拆解。
- 提到函数,在JS种有两种函数,一种是普通函数,另一种是箭头函数。每个普通函数都是
- Function的实例,而箭头函数不是任何类的实例,每次调用都是不一样的引用。那我们只需要
- 处理普通函数的情况,箭头函数直接返回它本身就好了。
那么如何来区分两者呢?
答案是: 利用原型。箭头函数是不存在原型的。
const handleFunc = (func) => {
  // 箭头函数直接返回自身
  if(!func.prototype) return func;
  const bodyReg = /(?<={)(.|\n)+(?=})/m;
  const paramReg = /(?<=\().+(?=\)\s+{)/;
  const funcString = func.toString();
  // 分别匹配 函数参数 和 函数体
  const param = paramReg.exec(funcString);
  const body = bodyReg.exec(funcString);
  if(!body) return null;
  if (param) {
    const paramArr = param[0].split(',');
    return new Function(...paramArr, body[0]);
  } else {
    return new Function(body[0]);
  }
}
5. 完整代码展示
const getType = obj => Object.prototype.toString.call(obj);

const isObject = (target) => (typeof target === 'object' || typeof target === 'function') && target !== null;

const canTraverse = {
  '[object Map]': true,
  '[object Set]': true,
  '[object Array]': true,
  '[object Object]': true,
  '[object Arguments]': true,
};
const mapTag = '[object Map]';
const setTag = '[object Set]';
const boolTag = '[object Boolean]';
const numberTag = '[object Number]';
const stringTag = '[object String]';
const symbolTag = '[object Symbol]';
const dateTag = '[object Date]';
const errorTag = '[object Error]';
const regexpTag = '[object RegExp]';
const funcTag = '[object Function]';

const handleRegExp = (target) => {
  const { source, flags } = target;
  return new target.constructor(source, flags);
}

const handleFunc = (func) => {
  // 箭头函数直接返回自身
  if(!func.prototype) return func;
  const bodyReg = /(?<={)(.|\n)+(?=})/m;
  const paramReg = /(?<=\().+(?=\)\s+{)/;
  const funcString = func.toString();
  // 分别匹配 函数参数 和 函数体
  const param = paramReg.exec(funcString);
  const body = bodyReg.exec(funcString);
  if(!body) return null;
  if (param) {
    const paramArr = param[0].split(',');
    return new Function(...paramArr, body[0]);
  } else {
    return new Function(body[0]);
  }
}

const handleNotTraverse = (target, tag) => {
  const Ctor = target.constructor;
  switch(tag) {
    case boolTag:
      return new Object(Boolean.prototype.valueOf.call(target));
    case numberTag:
      return new Object(Number.prototype.valueOf.call(target));
    case stringTag:
      return new Object(String.prototype.valueOf.call(target));
    case symbolTag:
      return new Object(Symbol.prototype.valueOf.call(target));
    case errorTag:
    case dateTag:
      return new Ctor(target);
    case regexpTag:
      return handleRegExp(target);
    case funcTag:
      return handleFunc(target);
    default:
      return new Ctor(target);
  }
}

const deepClone = (target, map = new WeakMap()) => {
  if(!isObject(target))
    return target;
  let type = getType(target);
  let cloneTarget;
  if(!canTraverse[type]) {
    // 处理不能遍历的对象
    return handleNotTraverse(target, type);
  }else {
    // 这波操作相当关键,可以保证对象的原型不丢失!
    let ctor = target.constructor;
    cloneTarget = new ctor();
  }

  if(map.get(target))
    return target;
  map.set(target, true);

  if(type === mapTag) {
    //处理Map
    target.forEach((item, key) => {
      cloneTarget.set(deepClone(key, map), deepClone(item, map));
    })
  }

  if(type === setTag) {
    //处理Set
    target.forEach(item => {
      cloneTarget.add(deepClone(item, map));
    })
  }

  // 处理数组和对象
  for (let prop in target) {
    if (target.hasOwnProperty(prop)) {
        cloneTarget[prop] = deepClone(target[prop], map);
    }
  }
  return cloneTarget;
}
💬 面试官追问
a.target = a拷完之后,clone.target === a是true,问题在哪?映射表里存的是
true,命中时返回了源对象。要先建副本再map.set(target, cloneTarget),命中时return map.get(target),这样拷完是clone.target === clone。克隆
Set后原来的Set多了元素,副本还是空的,哪行写错了?多半写成了
target.add(deepClone(item)),往源对象里加东西。应该是cloneTarget.add(deepClone(item, map)),还要把map传下去,不然Set里的环照样爆栈。为什么不建议用
new Function拷函数?函数体里引用的外层变量在新环境里找不到,一跑就是
ReferenceError;方法简写、async函数这些形态,正则也很难匹配对。页面CSP没开unsafe-eval时new Function直接抛错。函数通常不带状态,共享引用一般没问题。克隆一个
/a/g的正则,test结果跟原正则不一样,为什么?带
g或y标志的正则有lastIndex状态,重建出来lastIndex是0。要完全一致就补一句clone.lastIndex = target.lastIndex。要保留不可枚举属性和
getter,怎么写?用
Reflect.ownKeys拿所有键,再用Object.getOwnPropertyDescriptor逐个读描述符:数据属性递归拷value,访问器属性直接复制get/set,最后Object.defineProperty写到副本上。别去读getter的值,可能有副作用。
# 9 实现类的继承
⚡ 30 秒速记
- 手写就答寄生组合继承:
Parent.call(this, ...)拿实例属性,Object.create(Parent.prototype)接原型方法 - 别写
Child.prototype = Parent.prototype(父子共用一个原型,互相污染),也别写= new Parent()(父构造多跑一次,原型上多一份废属性) - 换了原型记得
Child.prototype.constructor = Child - 静态方法要另外接:
Object.setPrototypeOf(Child, Parent) - 新代码直接
class extends,它还能正确继承Array、Error这类内置类
手写继承我只写一种:寄生组合继承。 子构造函数里 Parent.call(this, name),每个实例拿到自己的一份属性;原型这边用 Object.create(Parent.prototype),只接原型链、不跑父构造函数;最后把 constructor 指回 Child。不用 new Parent() 当原型,是因为父构造函数会多跑一次,原型上还挂一份没用的实例属性。业务里早就是 class extends 了,class 还能正确继承 Array、Error 这种内置类,手写版做不到。
💬 面试官追问
寄生组合继承和
class extends完全等价吗?不完全。
class extends会把静态方法也继承过来(Object.getPrototypeOf(Child) === Parent),而且子类的this是父类构造出来的,所以能正确继承Array、Error;ES5写法Array.call(this)根本拿不到真数组。Parent上有个静态方法create,Child.create是undefined,怎么补?静态方法挂在构造函数本身上,原型链那套管不到它。补一句
Object.setPrototypeOf(Child, Parent),Child.create就能沿链找到。Object.create不能用的老环境怎么办?用一个空函数中转:
function F() {}; F.prototype = Parent.prototype; Child.prototype = new F()。这就是Object.create的polyfill,F里没逻辑,不会有副作用。拿
Error当父类手写继承,message和stack都是空的,为什么?Error.call(this, msg)不会往this上写东西,它直接返回一个新的Error对象。要么改用class MyError extends Error,要么手动this.message = msg,再调Error.captureStackTrace(this, MyError)(V8专有)。
# 1 实现类的继承-简版
⚡ 30 秒速记
- 三行骨架:
Parent.call(this, name)/Child.prototype = Object.create(Parent.prototype)/Child.prototype.constructor = Child - 子类方法要写在替换原型之后,写在前面会跟着旧原型一起被扔掉
- 子类同名方法会遮住父类的,想调父类版本用
Parent.prototype.say.call(this) - 示例
Child里先Parent.call(this, parent)再this.name = name,父类写的name马上被覆盖,演示时别被它绕晕
简版继承记住三行就够:构造函数里借父类、原型用 Object.create 接、constructor 改回来。 Parent.call(this, name) 负责实例属性,每个子实例一份;Object.create(Parent.prototype) 造一个以父原型为原型的空对象当子类原型,父子原型隔离开,子类加方法不会污染父类。有个顺序坑:子类的原型方法必须写在替换原型之后,不然先挂上去的方法会跟着旧原型一起丢掉。
类的继承在几年前是重点内容,有n种继承方式各有优劣,es6普及后越来越不重要,那么多种写法有点『回字有四样写法』的意思,如果还想深入理解的去看红宝书即可,我们目前只实现一种最理想的继承方式。
// 寄生组合继承
function Parent(name) {
  this.name = name
}
Parent.prototype.say = function() {
  console.log(this.name + ` say`);
}
Parent.prototype.play = function() {
  console.log(this.name + ` play`);
}

function Child(name, parent) {
  // 将父类的构造函数绑定在子类上
  Parent.call(this, parent)
  this.name = name
}

/**
 1. 这一步不用Child.prototype = Parent.prototype的原因是怕共享内存,修改父类原型对象就会影响子类
 2. 不用Child.prototype = new Parent()的原因是会调用2次父类的构造方法(另一次是call),会存在一份多余的父类实例属性
3. Object.create是创建了父类原型的副本,与父类原型完全隔离
*/
Child.prototype = Object.create(Parent.prototype);
Child.prototype.say = function() {
  console.log(this.name + ` say`);
}

// 注意记得把子类的构造指向子类本身
Child.prototype.constructor = Child;
// 测试
var parent = new Parent('parent');
parent.say()

var child = new Child('child');
child.say()
child.play(); // 继承父类的方法
💬 面试官追问
Child.prototype.say写在Object.create那行前面,子类调say走了父类版本,为什么?Child.prototype = Object.create(...)是整个替换,之前挂在旧原型上的say跟着旧对象丢了,实例只能沿链找到父类的say。把方法定义挪到替换之后。子类重写了
say,又想在里面先调父类的say,怎么写?Parent.prototype.say.call(this)。ES5没有super,只能显式拿父原型的方法再绑this;换成class就是一句super.say()。不修
constructor会出什么问题?child.constructor === Parent,方法照样能用,但有些代码靠obj.constructor新建同类对象,比如深拷贝里的new obj.constructor(),就会造出父类实例。修的时候最好用Object.defineProperty设成不可枚举,和原生保持一致。Child.prototype = Parent.prototype也能省一次父构造调用,为什么不行?父子用的是同一个原型对象,子类重写
say等于改了Parent.prototype.say,所有父类实例跟着变;parent instanceof Child也会变成true。
# 2 ES5实现继承-详细
⚡ 30 秒速记
- 只
call:拿到实例属性,原型方法拿不到 - 只原型链
Child.prototype = new Parent():方法有了,但数组这类引用属性被所有子实例共享 - 组合(
call+new Parent()):共享问题解决,父构造跑两次 Child.prototype = Parent.prototype:只跑一次,但父子原型是同一个对象,constructor也乱了- 最终版:
Object.create(Parent.prototype)+ 修constructor,就是寄生组合继承
这几种写法是一条演进线,每一步都在补上一步的坑,最后落到寄生组合继承。 call 继承只拿得到实例属性;原型链继承方法有了,可 play 数组挂在原型上,s1.play.push(4) 之后 s2 也看得到;组合继承两边都有,代价是父构造函数跑两次;直接共用原型省了一次调用,但父子原型成了同一个对象。最后用 Object.create 造一个隔离的中间原型,再修好 constructor,四个问题一起解决。面试按这条线讲,比背名字好记。
第一种方式是借助call实现继承
function Parent1(){
    this.name = 'parent1';
}
function Child1(){
    Parent1.call(this);
    this.type = 'child1'
}
console.log(new Child1);
这样写的时候子类虽然能够拿到父类的属性值,但是问题是父类中一旦存在方法那么子类无法继承。那么引出下面的方法
第二种方式借助原型链实现继承:
  function Parent2() {
    this.name = 'parent2';
    this.play = [1, 2, 3]
  }
  function Child2() {
    this.type = 'child2';
  }
  Child2.prototype = new Parent2();

  console.log(new Child2());
看似没有问题,父类的方法和属性都能够访问,但实际上有一个潜在的不足。举个例子:
  var s1 = new Child2();
  var s2 = new Child2();
  s1.play.push(4);
  console.log(s1.play, s2.play); // [1,2,3,4] [1,2,3,4]
明明我只改变了s1的play属性,为什么s2也跟着变了呢?很简单,因为两个实例使用的是同一个原型对象
第三种方式:将前两种组合:
function Parent3 () {
    this.name = 'parent3';
    this.play = [1, 2, 3];
  }
  function Child3() {
    Parent3.call(this);
    this.type = 'child3';
  }
  Child3.prototype = new Parent3();
  var s3 = new Child3();
  var s4 = new Child3();
  s3.play.push(4);
  console.log(s3.play, s4.play); // [1,2,3,4] [1,2,3]
之前的问题都得以解决。但是这里又徒增了一个新问题,那就是Parent3的构造函数会多执行了一次(
Child3.prototype = new Parent3();)。这是我们不愿看到的。那么如何解决这个问题?
第四种方式: 组合继承的优化1
  function Parent4 () {
    this.name = 'parent4';
    this.play = [1, 2, 3];
  }
  function Child4() {
    Parent4.call(this);
    this.type = 'child4';
  }
  Child4.prototype = Parent4.prototype;
这里让将父类原型对象直接给到子类,父类构造函数只执行一次,而且父类属性和方法均能访问,但是我们来测试一下
  var s3 = new Child4();
  var s4 = new Child4();
  console.log(s3)
子类实例的构造函数是Parent4,显然这是不对的,应该是Child4。
第五种方式(最推荐使用):优化2
  function Parent5 () {
    this.name = 'parent5';
    this.play = [1, 2, 3];
  }
  function Child5() {
    Parent5.call(this);
    this.type = 'child5';
  }
  Child5.prototype = Object.create(Parent5.prototype);
  Child5.prototype.constructor = Child5;
这是最推荐的一种方式,接近完美的继承。
💬 面试官追问
s1.play.push(4)会影响s2,s1.play = [9]却不会,为什么?push改的是原型上那个共享数组本身;s1.play = [9]是给s1自己加了一个同名属性,遮住了原型上的,s2读到的还是原型那份。组合继承父构造跑两次,除了慢还有什么实际问题?
原型上挂着一份没用的实例属性,
delete child.play之后还能读到原型上的[1, 2, 3],排查起来很迷惑。父构造函数要是有副作用,比如发埋点、注册全局监听,定义子类时就会多触发一次。怎么快速证明
Child4那种写法父子原型没隔离?执行
Child4.prototype.foo = 1,再看new Parent4().foo,输出1就说明是同一个对象。再打印new Child4().constructor,出来的是Parent4。Object.create(Parent.prototype)到底做了什么?新建一个空对象,把它的
[[Prototype]]指向Parent.prototype,不执行Parent。效果等价于function F() {}; F.prototype = Parent.prototype; return new F()。
# 10 实现Promise相关方法
⚡ 30 秒速记
- 静态组合方法看两件事:什么时候结束、失败怎么算
all全成功才成功、一个失败就失败;allSettled等全部落定、自己永不失败;race第一个落定的说了算;any(ES2021)第一个成功的说了算,全失败抛AggregateError- 每项先过
Promise.resolve,普通值和thenable统一处理;结果按输入下标写,不按完成顺序push - 空数组:
all/allSettled立即得到[],race永远pending,any立即拒绝 - 实例方法:
then必须返回新Promise,回调异步执行(原生走微任务)
手写 Promise 这组题,静态方法比的是「什么时候结束、失败怎么算」,实例方法比的是状态机和链式解析。 all 首个失败就短路,allSettled 不短路、每项给出 status,race 谁先落定用谁,any 谁先成功用谁。写的时候三个细节最容易丢分:每项先 Promise.resolve 一下,结果按下标存,空数组单独处理。还有个低级但常见的手滑:参数叫 promises,循环里就得写 promises[i],写成 promise[i] 直接 ReferenceError。
💬 面试官追问
Promise.any和Promise.race区别在哪?race第一个落定的赢,失败也算;any只看成功,第一个成功就返回,全部失败才以AggregateError拒绝,err.errors里是所有原因。多个镜像取最快可用的那个,用any。四个方法传空数组分别是什么结果?
all([])和allSettled([])立即以[]成功,race([])永远pending,any([])立即以AggregateError拒绝。手写时这四种都要对上。你写的
all只支持数组,传个Set进去就挂了,怎么改?原生接受任意可迭代对象,
Set没有length。开头先const list = Array.from(promises),后面都用list。手写
then用setTimeout异步执行回调,和原生差在哪?原生回调是微任务,
setTimeout是宏任务,和真Promise、定时器混用时打印顺序会不一样。想贴近原生就换成queueMicrotask。
# 1 实现Promise的resolve
⚡ 30 秒速记
- 三种入参:原生
Promise原样返回,thenable跟随它的状态,其他值包成成功态 - 「原样返回」严格说看
value.constructor === Promise,所以Promise.resolve(p) === p thenable判断:非null、是对象或函数、then是函数- 原生调
thenable.then是放在一个微任务里异步调,不是当场同步调 - 名字叫
resolve不代表一定成功:Promise.resolve(rejectedPromise)还是拒绝态
Promise.resolve 是把任意值「转成 Promise」,分三种情况:本来就是 Promise 原样返回,thenable 跟随它的结果,其他值包成成功态。 原生判断原样返回看的是 value.constructor === Promise,所以 Promise.resolve(p) === p 是 true。thenable 就是带 then 方法的对象,比如老版本 jQuery 的 Deferred,要调它的 then(resolve, reject) 去跟随结果。最容易被名字误导的一点:Promise.resolve(Promise.reject(1)) 得到的还是拒绝态。
实现 resolve 静态方法有三个要点:
- 传参为一个
Promise, 则直接返回它。 - 传参为一个
thenable对象,返回的Promise会跟随这个对象,采用它的最终状态作为自己的状态。 - 其他情况,直接返回以该值为成功状态的
promise对象。
Promise.resolve = (param) => {
  if(param instanceof Promise) return param;
  return new Promise((resolve, reject) => {
    if(param && param.then && typeof param.then === 'function') {
      // param 状态变为成功会调用resolve,将新 Promise 的状态变为成功,反之亦然
      param.then(resolve, reject);
    }else {
      resolve(param);
    }
  })
}
💬 面试官追问
Promise.resolve(Promise.reject(1))是成功还是失败?失败。传进去的已经是
Promise,直接原样返回那个拒绝态。resolve的意思是「用这个值来决定结果」,不是「一定成功」。传一个
{ then: 1 }进去,会被当成thenable吗?不会,
then不是函数,按普通值处理,结果是成功态、值就是这个对象本身。示例的判断里typeof param.then === 'function'这一步就是干这个的。第三方
thenable的then先调了resolve又调reject,结果是什么?只认第一次,后面的调用被忽略。手写版用
new Promise包住天然就有这层保护,因为Promise状态只能改一次。Promise.resolve(thenable)时,thenable.then是同步被调的吗?不是。规范要求原生排一个微任务去调
thenable.then,所以紧跟着的同步代码会先跑。手写版在执行器里直接调就成了同步,严格对齐要套一层queueMicrotask。class MyP extends Promise,Promise.resolve(new MyP(...))会原样返回吗?不会。它的
constructor是MyP不是Promise,会被包一层新的原生Promise;MyP.resolve(myp)才会原样返回。手写版用instanceof Promise判断,这里就和原生不一致。
# 2 实现 Promise.reject
⚡ 30 秒速记
- 实现就一行:
return new Promise((_, reject) => reject(reason)) - 参数不展开:传
Promise/thenable进去,拒绝原因就是那个对象本身 - 和
resolve不对称:resolve会跟随thenable,reject不会 - 习惯上传
Error实例,有stack好排查,但这是约定不是语法要求 - 没人
catch的拒绝:浏览器触发unhandledrejection,Node 15+默认直接让进程退出
Promise.reject 最简单:新建一个 Promise,立刻 reject(reason),参数原封不动当失败原因。 它和 Promise.resolve 不对称,resolve 碰到 thenable 会跟随,reject 不管传什么都不展开,传一个 Promise 进去,catch 拿到的就是那个 Promise 对象。写业务时我会要求拒绝原因用 Error 实例,有调用栈好排查。还有一点,没处理的拒绝从 Node 15 起默认会让进程崩掉,不只是打个警告。
Promise.reject 中传入的参数会作为一个 reason 原封不动地往下传, 实现如下:
Promise.reject = function (reason) {
    return new Promise((resolve, reject) => {
        reject(reason);
    });
}
💬 面试官追问
Promise.reject(Promise.resolve(1)).catch(e => console.log(e))打印什么?打印一个
Promise对象,不是1。reject不展开参数,传什么,原因就是什么。为什么建议
reject(new Error('x')),而不是reject('x')?字符串没有
stack,Sentry这类监控拿到的只有一句话,不知道从哪抛的。Error实例还能挂code、cause这些字段,下游好分类处理。Promise.reject(1)后面没有catch,会有什么后果?浏览器触发
unhandledrejection事件并在控制台报错;Node 15起默认--unhandled-rejections=throw,进程直接退出。以前Node只打警告,不少老服务升级后才炸出来。Promise.reject(err)和Promise.resolve().then(() => { throw err })有区别吗?最终都是拒绝态,但后者要多绕一个微任务才落定,
await两者的时机会差一拍。表达「直接给我一个失败」就用前者,语义清楚。
# 3 实现 Promise.prototype.finally
⚡ 30 秒速记
- 本质是
then的封装:成功失败都执行callback,然后把原值 / 原错误透传下去 callback不收参数,返回值也被忽略,除非它抛错或返回拒绝态- 回调返回
Promise会被等待:成功就继续透传原结果,失败就用新错误替换 - 实现:成功分支
Promise.resolve(cb()).then(() => value),失败分支.then(() => { throw reason }) - 原生
finally是ES2018加的;严格实现应该用this.constructor.resolve,别写死Promise
finally 可以理解成「不管成败都要做的收尾」,比如关 loading,而且做完不影响原来的结果。 实现就是一个 then:成功分支执行完回调,再把原值 return 出去;失败分支执行完回调,再把原错误 throw 出去。回调要用 Promise.resolve(callback()) 包一层,这样它返回 Promise 时会等它结束。唯一会改结果的情况是回调自己抛错或返回拒绝态,这时后面拿到的是新错误,原结果被覆盖。
前面的
promise不管成功还是失败,都会走到finally中,并且finally之后,还可以继续then(说明它还是一个then方法是关键),并且会将初始的promise值原封不动的传递给后面的then.
Promise.prototype.finally最大的作用
finally里的函数,无论如何都会执行,并会把前面的值原封不动传递给下一个then方法中- 如果
finally函数中有promise等异步任务,会等它们全部执行完毕,再结合之前的成功与否状态,返回值
Promise.prototype.finally六大情况用法
// 情况1
Promise.resolve(123).finally((data) => { // 这里传入的函数,无论如何都会执行
  console.log(data); // undefined
})

// 情况2 (这里,finally方法相当于做了中间处理,起一个过渡的作用)
Promise.resolve(123).finally((data) => {
  console.log(data); // undefined
}).then(data => {
  console.log(data); // 123
})

// 情况3 (这里只要reject,都会走到下一个then的err中)
Promise.reject(123).finally((data) => {
  console.log(data); // undefined
}).then(data => {
  console.log(data);
}, err => {
  console.log(err, 'err'); // 123 err
})

// 情况4 (一开始就成功之后,会等待finally里的promise执行完毕后,再把前面的data传递到下一个then中)
Promise.resolve(123).finally((data) => {
  console.log(data); // undefined
  return new Promise((resolve, reject) => {
    setTimeout(() => {
      resolve('ok');
    }, 3000)
  })
}).then(data => {
  console.log(data, 'success'); // 123 success
}, err => {
  console.log(err, 'err');
})

// 情况5 (虽然一开始成功,但是只要finally函数中的promise失败了,就会把其失败的值传递到下一个then的err中)
Promise.resolve(123).finally((data) => {
  console.log(data); // undefined
  return new Promise((resolve, reject) => {
    setTimeout(() => {
      reject('rejected');
    }, 3000)
  })
}).then(data => {
  console.log(data, 'success');
}, err => {
  console.log(err, 'err'); // rejected err
})

// 情况6 (虽然一开始失败,但是也要等finally中的promise执行完,才能把一开始的err传递到err的回调中)
Promise.reject(123).finally((data) => {
  console.log(data); // undefined
  return new Promise((resolve, reject) => {
    setTimeout(() => {
      resolve('resolve');
    }, 3000)
  })
}).then(data => {
  console.log(data, 'success');
}, err => {
  console.log(err, 'err'); // 123 err
})
源码实现
Promise.prototype.finally = function (callback) {
  return this.then((data) => {
    // 让函数执行 内部会调用方法,如果方法是promise,需要等待它完成
    // 如果当前promise执行时失败了,会把err传递到,err的回调函数中
    return Promise.resolve(callback()).then(() => data); // data 上一个promise的成功态
  }, err => {
    return Promise.resolve(callback()).then(() => {
      throw err; // 把之前的失败的err,抛出去
    });
  })
}
💬 面试官追问
Promise.resolve(1).finally(() => 2).then(v => console.log(v))打印几?打印
1。finally回调的返回值被忽略,这点和then完全不同,then(() => 2)会把值换成2。finally里关弹窗时抛了异常,原来的请求错误去哪了?被覆盖了,后面
catch拿到的是关弹窗那个异常。收尾逻辑自己用try...catch包住,别让它盖掉真正的业务错误。失败分支写成
Promise.resolve(cb()).then(() => err)会怎样?原来的拒绝被悄悄转成成功,
err被当成成功值交给下一个then。必须写() => { throw err }。回调返回一个三秒后才完成的
Promise,后面的then什么时候执行?等这三秒走完再执行,拿到的还是原值。所以
finally里别return耗时任务,比如上报日志就别把它的Promise返回出去,会拖住整条链。用
finally收尾,和then两个分支各写一遍,有啥区别?then(cleanup, cleanup)会把结果换成cleanup的返回值,失败也被吞成成功;finally自动透传原结果,不用自己return/throw。只是复位loading就用finally,收尾结果要参与业务判断才用then。
# 4 实现 Promise.all
⚡ 30 秒速记
- 返回新
Promise;结果按输入下标写result[i] = v,用独立计数器count === len判断完成 - 每项先
Promise.resolve(item),普通值也能参与 - 任何一项拒绝就立刻
reject,后面再落定的都不影响(状态只改一次) - 空数组立即
resolve([]) - 变量名对齐:参数叫
promises就写promises[i];短路不等于取消,其余请求还在跑
Promise.all 的手写要点是「按下标存结果、用计数器判完成、首个失败就短路」。 结果不能按完成顺序 push,不然先回来的库存接口会占掉价格的位置;用 result[i] = data 加一个 count,count === len 时再 resolve。用 result.length 判断也不行,result[2] 先赋值,长度立刻就是 3。还要记住,失败短路只是外层 Promise 先拒绝,已经发出去的请求不会停,真要取消得配合 AbortController。
对于 all 方法而言,需要完成下面的核心功能:
- 传入参数为一个空的可迭代对象,则直接进行
resolve。 - 如果参数中有一个
promise失败,那么Promise.all返回的promise对象失败。 - 在任何情况下,
Promise.all返回的promise的完成状态的结果都是一个数组
Promise.all = function(promises) {
  return new Promise((resolve, reject) => {
    let result = [];
    let index = 0;
    let len = promises.length;
    if(len === 0) {
      resolve(result);
      return;
    }

    for(let i = 0; i < len; i++) {
      // 为什么不直接 promise[i].then, 因为promise[i]可能不是一个promise
      Promise.resolve(promise[i]).then(data => {
        result[i] = data;
        index++;
        if(index === len) resolve(result);
      }).catch(err => {
        reject(err);
      })
    }
  })
}
💬 面试官追问
为什么不能用
result.length === len判断全部完成?数组按下标赋值会撑长度,第三项先回来时
result[2] = x,length立刻就是3,前两项还是空位。必须单独计数。三个请求里第一个失败了,另外两个还会发吗?
早就发了,
Promise创建时请求就已经出去了,all只是不再关心它们的结果。要真停掉,就给每个请求传同一个AbortController的signal,在catch里调abort()。一次要发
200个请求,直接Promise.all有什么问题?HTTP/1.1下浏览器同域名最多6个并发连接,剩下的排队,服务端也可能被打爆或限流。写个并发池,比如同时最多5个,跑完一个补一个,最后再汇总。页面上一个接口挂了就整页白屏,怎么改?
这是
all一个失败全体失败导致的。非核心接口换成allSettled分开处理,或者给单个请求.catch(() => fallback)兜底后再丢进all。
# 5 实现promise.allsettle
⚡ 30 秒速记
- 等所有项都落定再
resolve,自己永不拒绝;每项是{ status: 'fulfilled', value }或{ status: 'rejected', reason } - 上面的代码失败项写成了
value: err,原生字段名是reason,按原生习惯读会拿到undefined - 每项直接过
Promise.resolve;上面的代码isPromise读val.then,碰到null/undefined直接抛错 - 下标写结果 + 计数器;空数组立即得到
[] ES2020才有,老环境可以用all+ 每项.then(ok, fail)映射来模拟
allSettled 是「等所有人交卷再一起看成绩」,有人失败也不提前收卷。 实现和 all 很像,区别是失败分支不 reject 外层,而是记一条 { status: 'rejected', reason } 再计数。上面的代码这里有两处要改:失败项字段名写成了 value,原生是 reason;isPromise 里直接读 val.then,数组里有个 null 就抛错。最省事的写法是借 all:每项先映射成一个永不失败的 Promise,all 自然就不会短路。
MDN:
Promise.allSettled()方法返回一个在所有给定的promise都已经fulfilled或rejected后的promise,并带有一个对象数组,每个对象表示对应的promise`结果
当您有多个彼此不依赖的异步任务成功完成时,或者您总是想知道每个promise的结果时,通常使用它。
【译】
Promise.allSettled跟Promise.all类似, 其参数接受一个Promise的数组, 返回一个新的Promise, 唯一的不同在于, 其不会进行短路, 也就是说当Promise全部处理完成后我们可以拿到每个Promise的状态, 而不管其是否处理成功。
用法 | 测试用例
let fs = require('fs').promises;

let getName = fs.readFile('./name.txt', 'utf8'); // 读取文件成功
let getAge = fs.readFile('./age.txt', 'utf8');

Promise.allSettled([1, getName, getAge, 2]).then(data => {
    console.log(data);
});
// 输出结果
/*
    [
    { status: 'fulfilled', value: 1 },
    { status: 'fulfilled', value: 'zf' },
    { status: 'fulfilled', value: '11' },
    { status: 'fulfilled', value: 2 }
    ]
*/

let getName = fs.readFile('./name123.txt', 'utf8'); // 读取文件失败
let getAge = fs.readFile('./age.txt', 'utf8');
// 输出结果
/*
    [
    { status: 'fulfilled', value: 1 },
    {
      status: 'rejected',
      value: [Error: ENOENT: no such file or directory, open './name123.txt'] {
        errno: -2,
        code: 'ENOENT',
        syscall: 'open',
        path: './name123.txt'
      }
    },
    { status: 'fulfilled', value: '11' },
    { status: 'fulfilled', value: 2 }
  ]
*/
实现
function isPromise (val) {
  return typeof val.then === 'function'; // (123).then => undefined
}

Promise.allSettled = function(promises) {
  return new Promise((resolve, reject) => {
    let arr = [];
    let times = 0;
    const setData = (index, data) => {
      arr[index] = data;
      if (++times === promises.length) {
        resolve(arr);
      }
      console.log('times', times)
    }

    for (let i = 0; i < promises.length; i++) {
      let current = promises[i];
      if (isPromise(current)) {
        current.then((data) => {
          setData(i, { status: 'fulfilled', value: data });
        }, err => {
          setData(i, { status: 'rejected', value: err })
        })
      } else {
        setData(i, { status: 'fulfilled', value: current })
      }
    }
  })
}
💬 面试官追问
用
Promise.all怎么实现allSettled?每项先映射成永不失败的
Promise:Promise.resolve(p).then(value => ({ status: 'fulfilled', value }), reason => ({ status: 'rejected', reason })),再整体丢给all。每项都不会拒绝,all就不会短路。数组里混了
null,你的allSettled抛了Cannot read properties of null,怎么改?isPromise里null.then就炸了。干脆不判断,每项都Promise.resolve(item),普通值、null、thenable一视同仁。拿到
allSettled的结果后,怎么挑出失败项上报?results.filter(r => r.status === 'rejected').map(r => r.reason)。别看外层成功就以为都好了,allSettled的外层永远是成功的。结果顺序偶尔和输入对不上,代码里用的是
arr.push,为什么?push按完成先后排,网络快慢一变顺序就乱。循环里拿住下标i,写arr[i] = result。批量保存
20条记录,什么时候用allSettled而不是all?每条互相独立、要告诉用户「成功
18条、失败2条」时用allSettled。如果是事务性的,一条失败整批作废,就用all尽早报错。
# 6 实现 Promise.race
⚡ 30 秒速记
- 谁先落定就用谁,成功失败都算;后落定的被忽略(
Promise状态只改一次) - 每项
Promise.resolve(item).then(resolve, reject)就够了,示例里那些return不起作用,也不用手动停循环 - 空数组永远
pending,这是规范行为 - 典型用法是超时控制:
race([fetch(url), timeout(5000)]),但超时后请求还在跑,要配合AbortController - 要「第一个成功」用
Promise.any
race 就是赛跑,第一个冲线的决定结果,不管它是成功还是失败。 实现很短:遍历每一项,Promise.resolve(item).then(resolve, reject),外层 Promise 状态只能变一次,后到的自动被忽略,上面的代码里那些 return 其实没起作用。最常见的用途是给请求加超时,但要清楚 race 只是不等了,请求本身还在跑。真要取消,给 fetch 传 AbortSignal.timeout(5000) 更干净。
race 的实现相比之下就简单一些,只要有一个 promise 执行完,直接 resolve 并停止执行
Promise.race = function(promises) {
  return new Promise((resolve, reject) => {
    let len = promises.length;
    if(len === 0) return;
    for(let i = 0; i < len; i++) {
      Promise.resolve(promise[i]).then(data => {
        resolve(data);
        return;
      }).catch(err => {
        reject(err);
        return;
      })
    }
  })
}
💬 面试官追问
镜像
A先返回失败、B后返回成功,race结果是什么?失败。
race看的是先落定,不是先成功。要「第一个成功」就用Promise.any,全部失败它才拒绝。用
race做了五秒超时,提示弹了,服务端还是收到了上传,为什么?race只是让外层先拒绝,上传请求根本没被取消。给fetch传signal,超时分支里调controller.abort(),或者直接写fetch(url, { signal: AbortSignal.timeout(5000) })。超时用的
setTimeout,请求成功后要清掉吗?要。不清的话定时器还挂着,
Node里会拖住进程不退出,频繁调用还会堆积。在finally里clearTimeout(timer)。Promise.race([])一直没结果,是实现有问题吗?不是,规范就这么定的,没有参赛者就永远没人冲线。调用方自己判空,别指望它返回
undefined。race([cache, fetchData()]),其中cache是普通字符串,会怎样?普通值被
Promise.resolve包成已完成态,几乎必赢,fetchData的结果永远用不上。「先用缓存、再用网络更新」是另一种模式,别用race表达。
# 7 实现一个简版Promise
⚡ 30 秒速记
- 三要素:状态(
pending→resolved/rejected,只能变一次)、结果值、两个回调队列 then时还是pending就把回调存起来,等resolve/reject时挨个执行- 函数版没有回调队列,只能处理同步
resolve,异步resolve时then永远不执行 - 执行器要包
try...catch,同步抛错转成reject;示例的class版漏了这一步 - 简版
then不返回新Promise,没法链式;回调也是同步执行,和原生微任务时序不一样
简版 Promise 就是一个状态机加两个回调队列:状态只能从 pending 变一次,变的时候把之前存的回调挨个跑掉。 文中给了两版,函数版没有队列,resolve 放在 setTimeout 里调的话,先注册的 then 永远不会执行;class 版补了队列,但执行器没包 try...catch,构造时抛错会直接冒出去。两版的 then 都不返回新 Promise,链式调用要看下一节的详细版。面试写简版时,我会主动说清楚这些没覆盖。
// 使用
var promise = new Promise((resolve,reject) => {
    if (操作成功) {
        resolve(value)
    } else {
        reject(error)
    }
})
promise.then(function (value) {
    // success
},function (value) {
    // failure
})
function myPromise(constructor) {
    let self = this;
    self.status = "pending"   // 定义状态改变前的初始状态
    self.value = undefined;   // 定义状态为resolved的时候的状态
    self.reason = undefined;  // 定义状态为rejected的时候的状态
    function resolve(value) {
       if(self.status === "pending") {
          self.value = value;
          self.status = "resolved";
       }
    }
    function reject(reason) {
       if(self.status === "pending") {
          self.reason = reason;
          self.status = "rejected";
       }
    }
    // 捕获构造异常
    try {
       constructor(resolve,reject);
    } catch(e) {
       reject(e);
    }
}
// 添加 then 方法
myPromise.prototype.then = function(onFullfilled,onRejected) {
   let self = this;
   switch(self.status) {
      case "resolved":
        onFullfilled(self.value);
        break;
      case "rejected":
        onRejected(self.reason);
        break;
      default:
   }
}

var p = new myPromise(function(resolve,reject) {
    resolve(1)
});
p.then(function(x) {
    console.log(x) // 1
})
使用class实现
class MyPromise {
  constructor(fn) {
    this.resolvedCallbacks = [];
    this.rejectedCallbacks = [];

    this.state = 'PENDING';
    this.value = '';

    fn(this.resolve.bind(this), this.reject.bind(this));

  }

  resolve(value) {
    if (this.state === 'PENDING') {
      this.state = 'RESOLVED';
      this.value = value;

      this.resolvedCallbacks.map(cb => cb(value));
    }
  }

  reject(value) {
    if (this.state === 'PENDING') {
      this.state = 'REJECTED';
      this.value = value;

      this.rejectedCallbacks.map(cb => cb(value));
    }
  }

  then(onFulfilled, onRejected) {
    if (this.state === 'PENDING') {
      this.resolvedCallbacks.push(onFulfilled);
      this.rejectedCallbacks.push(onRejected);

    }

    if (this.state === 'RESOLVED') {
      onFulfilled(this.value);
    }

    if (this.state === 'REJECTED') {
      onRejected(this.value);
    }
  }
}
💬 面试官追问
函数版里
setTimeout(() => resolve(1)),then回调不执行,为什么?then调用时状态还是pending,switch走到default什么都没做,回调没被存下来。resolve后来改了状态,却没人可通知。要加回调数组,pending时push,resolve时forEach执行。resolve(1)之后又调reject(2),状态会变吗?不会。
resolve和reject都先判断if (state === 'pending'),第一次改完,后面的调用直接跳过。这个检查不能省。class版构造时fn里throw new Error('x'),会怎样?直接抛到外面,不走失败回调,因为这版没包
try...catch。改成try { fn(resolve, reject) } catch (e) { reject(e) }。同一个
pending的Promise被三个地方.then,为什么回调要用数组存?每个
.then都要收到结果。用单个变量存,后注册的会覆盖前面的,只有最后一个能收到。then改成return this,能支持链式吗?能链起来调,但没意义:第二个
then拿到的还是第一个Promise的值,第一个回调的返回值传不下去。正确做法是then返回一个新Promise,用回调返回值去resolve它。
# 8 Promise 实现-详细
⚡ 30 秒速记
- 状态机:
pending→resolved/rejected只变一次,pending时回调进队列 then返回新的promise2,回调返回值x交给resolutionProcedure决定promise2的状态resolutionProcedure:x === promise2抛TypeError;x是thenable就跟随,用called防重复;普通值直接resolve- 回调不是函数就给默认值透传:
v => v、r => { throw r };示例写的r => throw r是语法错误 - 回调必须异步执行;示例用
setTimeout(宏任务),原生是微任务,和定时器混用时顺序不同
详细版 Promise 的关键在 then:它返回一个新的 Promise,回调的返回值决定这个新 Promise 的结果,链式调用就是这么一路传下去的。 回调返回普通值,下一个 then 拿到这个值;返回 Promise 或 thenable,就等它落定再传;回调抛错就转成拒绝。这套判断就是 Promises/A+ 规范的 2.3 节,也就是代码里的 resolutionProcedure。上面的代码有个硬伤:r => throw r 跑不起来,throw 是语句不是表达式,必须写成 r => { throw r }。
- 可以把
Promise看成一个状态机。初始是pending状态,可以通过函数resolve和reject,将状态转变为resolved或者rejected状态,状态一旦改变就不能再次变化。 then函数会返回一个Promise实例,并且该返回值是一个新的实例而不是之前的实例。因为Promise规范规定除了pending状态,其他状态是不可以改变的,如果返回的是一个相同实例的话,多个then调用就失去意义了。- 对于
then来说,本质上可以把它看成是flatMap
// 三种状态
const PENDING = "pending";
const RESOLVED = "resolved";
const REJECTED = "rejected";
// promise 接收一个函数参数,该函数会立即执行
function MyPromise(fn) {
  let _this = this;
  _this.currentState = PENDING;
  _this.value = undefined;
  // 用于保存 then 中的回调,只有当 promise
  // 状态为 pending 时才会缓存,并且每个实例至多缓存一个
  _this.resolvedCallbacks = [];
  _this.rejectedCallbacks = [];

  _this.resolve = function (value) {
    if (value instanceof MyPromise) {
      // 如果 value 是个 Promise,递归执行
      return value.then(_this.resolve, _this.reject)
    }
    setTimeout(() => { // 异步执行,保证执行顺序
      if (_this.currentState === PENDING) {
        _this.currentState = RESOLVED;
        _this.value = value;
        _this.resolvedCallbacks.forEach(cb => cb());
      }
    })
  };

  _this.reject = function (reason) {
    setTimeout(() => { // 异步执行,保证执行顺序
      if (_this.currentState === PENDING) {
        _this.currentState = REJECTED;
        _this.value = reason;
        _this.rejectedCallbacks.forEach(cb => cb());
      }
    })
  }
  // 用于解决以下问题
  // new Promise(() => throw Error('error))
  try {
    fn(_this.resolve, _this.reject);
  } catch (e) {
    _this.reject(e);
  }
}

MyPromise.prototype.then = function (onResolved, onRejected) {
  var self = this;
  // 规范 2.2.7,then 必须返回一个新的 promise
  var promise2;
  // 规范 2.2.onResolved 和 onRejected 都为可选参数
  // 如果类型不是函数需要忽略,同时也实现了透传
  // Promise.resolve(4).then().then((value) => console.log(value))
  onResolved = typeof onResolved === 'function' ? onResolved : v => v;
  onRejected = typeof onRejected === 'function' ? onRejected : r => throw r;

  if (self.currentState === RESOLVED) {
    return (promise2 = new MyPromise(function (resolve, reject) {
      // 规范 2.2.4,保证 onFulfilled,onRjected 异步执行
      // 所以用了 setTimeout 包裹下
      setTimeout(function () {
        try {
          var x = onResolved(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (reason) {
          reject(reason);
        }
      });
    }));
  }

  if (self.currentState === REJECTED) {
    return (promise2 = new MyPromise(function (resolve, reject) {
      setTimeout(function () {
        // 异步执行onRejected
        try {
          var x = onRejected(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (reason) {
          reject(reason);
        }
      });
    }));
  }

  if (self.currentState === PENDING) {
    return (promise2 = new MyPromise(function (resolve, reject) {
      self.resolvedCallbacks.push(function () {
        // 考虑到可能会有报错,所以使用 try/catch 包裹
        try {
          var x = onResolved(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (r) {
          reject(r);
        }
      });

      self.rejectedCallbacks.push(function () {
        try {
          var x = onRejected(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (r) {
          reject(r);
        }
      });
    }));
  }
};
// 规范 2.3
function resolutionProcedure(promise2, x, resolve, reject) {
  // 规范 2.3.1,x 不能和 promise2 相同,避免循环引用
  if (promise2 === x) {
    return reject(new TypeError("Error"));
  }
  // 规范 2.3.2
  // 如果 x 为 Promise,状态为 pending 需要继续等待否则执行
  if (x instanceof MyPromise) {
    if (x.currentState === PENDING) {
      x.then(function (value) {
        // 再次调用该函数是为了确认 x resolve 的
        // 参数是什么类型,如果是基本类型就再次 resolve
        // 把值传给下个 then
        resolutionProcedure(promise2, value, resolve, reject);
      }, reject);
    } else {
      x.then(resolve, reject);
    }
    return;
  }
  // 规范 2.3.3.3.3
  // reject 或者 resolve 其中一个执行过得话,忽略其他的
  let called = false;
  // 规范 2.3.3,判断 x 是否为对象或者函数
  if (x !== null && (typeof x === "object" || typeof x === "function")) {
    // 规范 2.3.3.2,如果不能取出 then,就 reject
    try {
      // 规范 2.3.3.1
      let then = x.then;
      // 如果 then 是函数,调用 x.then
      if (typeof then === "function") {
        // 规范 2.3.3.3
        then.call(
          x,
          y => {
            if (called) return;
            called = true;
            // 规范 2.3.3.3.1
            resolutionProcedure(promise2, y, resolve, reject);
          },
          e => {
            if (called) return;
            called = true;
            reject(e);
          }
        );
      } else {
        // 规范 2.3.3.4
        resolve(x);
      }
    } catch (e) {
      if (called) return;
      called = true;
      reject(e);
    }
  } else {
    // 规范 2.3.4,x 为基本类型
    resolve(x);
  }
}
💬 面试官追问
Promise.resolve(4).then().then(v => console.log(v))为什么能打印4?then收到的不是函数时会换成默认的v => v,值原样往下传。失败方向的默认值是r => { throw r },拒绝也会一路透传到有catch的地方。then回调里return了promise2自己,会怎样?自己等自己,永远落定不了。规范要求直接以
TypeError拒绝,原生报Chaining cycle detected for promise,resolutionProcedure第一行查的就是这个。resolutionProcedure里那个called标记防的是什么?防第三方
thenable不守规矩,比如先调成功又调失败,或者调完回调再抛错。有了called,只认第一次,后面的全忽略。setTimeout打印1、p.then打印2,手写版和原生顺序一样吗?不一样。原生先
2后1,then回调是微任务,比定时器早。手写版也用setTimeout调度,就变成谁先注册谁先跑,先1后2。换成queueMicrotask就能对齐。then为什么要返回新Promise,不能return this?this已经落定了,状态改不了,第一个回调的返回值和抛出的错误就没地方放。每个then一个新Promise,链上每一环才能有自己的结果。
# 9 实现Promisify
⚡ 30 秒速记
- 把
(err, data)错误优先回调的函数,包成返回Promise的函数:末尾追加回调,有err就reject,否则resolve(data) - 上面的代码
reject(err)后没return,会接着跑resolve;状态虽然不变,但意图不清,加上return - 要保留
this:返回普通函数而不是箭头函数,里面写fn.call(this, ...args, cb) - 多个成功值(
(err, a, b))只能拿到第一个;Node的util.promisify靠util.promisify.custom处理这类特例 Node 10起有fs.promises,Node 14起能require('fs/promises'),别再promisifyAll(fs)
promisify 是一个高阶函数:把「最后一个参数传回调、回调第一个参数是错误」的老式 API,包成返回 Promise 的版本,方便 await。 实现就是返回一个新函数,里面 new Promise,调原函数时在参数末尾塞一个 (err, data) => err ? reject(err) : resolve(data)。上面的代码用的是箭头函数加 fn(...args),this 丢了,包 db.query 这种对象方法就会出错。现在 Node 里一般直接用 util.promisify 或者 fs.promises,手写主要考你理解「回调转 Promise」这一步。
const fs = require('fs')
const path = require('path')

// node中使用
// const fs = require('fs').promises 12.18版
// const promisify = require('util').promisify

// 包装node api promise化 典型的高级函数
const promisify = fn=>{
  return (...args)=>{
    return new Promise((resolve,reject)=>{
      fn(...args, (err,data)=>{
        if(err) {
          reject(err)
        }
        resolve(data)
      })
    })
  }
}

// const read = promisify(fs.readFile)

// read(path.join(__dirname, './promise.js'), 'utf8').then(d=>{
//   console.log(d)
// })

// promise化node所有api
const promisifyAll = target=>{
  Reflect.ownKeys(target).forEach(key=>{
    if(typeof target[key] === 'function') {
      target[key+'Async'] = promisify(target[key])
    }
  })
  return target
}

// promise化fs下的函数
const promisifyNew = promisifyAll(fs)

promisifyNew.readFileAsync(path.join(__dirname, './promise.js'), 'utf8').then(d=>{
  console.log(d)
})

module.exports = {
  promisify,
  promisifyAll
}
💬 面试官追问
包装
db.query后报Cannot read properties of undefined,为什么?promisify里fn(...args)是裸调用,this丢了。返回的函数用function写,内部fn.call(this, ...args, cb),调用时写db.queryAsync();或者包装前先db.query.bind(db)。回调是
(err, rows, fields),包完只拿到rows,怎么办?resolve只能传一个值。可以收剩余参数(err, ...results) => resolve(results),但返回形状变了,通用工具别擅自这么改,给这个API单独写一个返回{ rows, fields }的版本。setTimeout(cb, ms)能直接拿来promisify吗?不能,回调在第一个参数,也没有
err。Node里util.promisify(setTimeout)能用,是因为它挂了util.promisify.custom;浏览器里自己写const sleep = ms => new Promise(r => setTimeout(r, ms))。promisifyAll(fs)直接改了fs对象,有什么问题?原地往全局模块上加一堆
xxxAsync,别处require('fs')也会看到,键名还可能撞上已有属性;fs上的类(比如ReadStream)也会被包一遍。现在直接用fs.promises,不用这么折腾。原函数的回调被调了两次,
Promise会怎样?只认第一次,后面的
resolve/reject被静默忽略,不报错也不提示。这类问题 在Promise层看不出来,得去原函数里查回调为什么重复触发。
# 10 完整实现Promises/A+规范
⚡ 30 秒速记
- 三条硬规矩:状态只能从
pending变一次 /then必须返回新的promise2/ 回调返回值x要交给resolvePromise解析 pending时把回调塞进两个队列,resolve/reject时一次性全部执行,同一个实例挂多少个then都要触发resolvePromise:x === promise2直接TypeError;对象或函数先try里取一次then,是函数就当thenable递归展开,called锁住只认第一次- 回调必须异步执行,示例用
setTimeout是宏任务,原生是微任务,打印顺序会和原生不一样 - 判对象要写
x !== null && (typeof x === 'object' || typeof x === 'function');typeof x !== null永远为真,x是null时会去读null.then报错
Promises/A+ 的核心其实只有两块:then 的链式调用,和 resolvePromise 这个解析过程。 then 每次都返回一个新 Promise,上一个回调的返回值决定它是成功还是失败;pending 时先把回调存进队列,状态定了再统一执行。resolvePromise 要处理的是「返回值长得像 Promise」的情况:取 then 本身可能抛错,第三方 thenable 可能先成功又失败,所以要 try/catch 加 called 标记,只认第一次。写完我会直接跑 promises-aplus-tests,872 个用例比自己肉眼看靠谱得多。
/**
* Promises/A+规范 实现一个promise
* https://promisesaplus.com/
*/
const EMUM = {
PENDING: 'PENDING',
FULFILLED: 'FULFILLED',
REJECTED: 'REJECTED'
}
// x 返回值
// promise2 then的时候new的promise
// promise2的resolve, reject
const resolvePromise = (x, promise2, resolve, reject)=>{
// 解析promise的值解析promise2是成功还是失败 传递到下层then
if(x === promise2) {
reject(new TypeError('类型错误'))
}
// 这里的x如果是一个promise的话 可能是其他的promise,可能调用了成功 又调用了失败
// 防止resolve的时候 又throw err抛出异常到reject了
let called
// 如果x是promise 那么就采用他的状态
// 有then方法是promise
if(typeof x === 'object' && typeof x!== null || typeof x === 'function') {
// x是对象或函数
try {
let then = x.then // 缓存,不用多次取值
if(typeof then === 'function') {
// 是promise,调用then方法里面有this,需要传入this为x才能取到then方法里面的值this.value
then.call(x, y=>{// 成功
// y值可能也是一个promise 如resolve(new Promise()) 此时的y==new Promise()
// 递归解析y,直到拿到普通的值resolve(x出去)
if(called) return;
called = true;
resolvePromise(y, promise2, resolve, reject)
},r=>{// 一旦失败直接失败
if(called) return;
called = true;
reject(r)
})
} else {
// 普通对象不是promise
resolve(x)
}
} catch (e) {
// 对象取值可能报错,用defineProperty定义get 抛出异常
if(called) return;
called = true;
reject(e)
}
} else {
// x是普通值
resolve(x) // 直接成功
}
}
class myPromise {
constructor(executor) {
this.status = EMUM.PENDING // 当前状态
this.value = undefined // resolve接收值
this.reason = undefined // reject失败返回值
/**
* 同一个promise可以then多次(发布订阅模式)
* 调用then时 当前状态是等待态,需要将当前成功或失败的回调存放起来(订阅)
* 调用resolve时 将订阅函数进行执行(发布)
*/
// 成功队列
this.onResolvedCallbacks = []
// 失败队列
this.onRejectedCallbacks = []
const resolve = value =>{
// 如果value是一个promise,需要递归解析
// 如 myPromise.resolve(new myPromise()) 需要解析value
if(value instanceof myPromise) {
// 不停的解析 直到值不是promise
return value.then(resolve,reject)
}
if(this.status === EMUM.PENDING) {
this.status = EMUM.FULFILLED
this.value = value
this.onResolvedCallbacks.forEach(fn=>fn())
}
}
const reject = reason =>{
if(this.status === EMUM.PENDING) {
this.status = EMUM.REJECTED
this.reason = reason
this.onRejectedCallbacks.forEach(fn=>fn())
}
}
try {
executor(resolve,reject)
} catch(e) {
reject(e)
}
}
then(onFulFilled, onRejected) {
// 透传 处理默认不传的情况
// new Promise((resolve,reject)=>{
// resolve(1)
// }).then().then().then(d=>{})
// new Promise((resolve,reject)=>{
// resolve(1)
// }).then(v=>v).then(v=>v).then(d=>{})
// new Promise((resolve,reject)=>{
// reject(1)
// }).then().then().then(null, e=>{console.log(e)})
// new Promise((resolve,reject)=>{
// reject(1)
// }).then(null,e=>{throw e}).then(null,e=>{throw e}).then(null,e=>{console.log(e)})
onFulFilled = typeof onFulFilled === 'function' ? onFulFilled : v => v
onRejected = typeof onRejected === 'function' ? onRejected : err => {throw err}
// 调用then 创建一个新的promise
let promise2 = new myPromise((resolve,reject)=>{
// 根据value判断是resolve 还是reject value也可能是promise
if(this.status === EMUM.FULFILLED) {
setTimeout(() => {
try {
// 成功回调结果
let x = onFulFilled(this.value)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
}, 0);
}
if(this.status === EMUM.REJECTED) {
setTimeout(() => {
try {
let x = onRejected(this.reason)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
}, 0);
}
// 用户还未调用resolve或reject方法
if(this.status === EMUM.PENDING) {
this.onResolvedCallbacks.push(()=>{
try {
let x = onFulFilled(this.value)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
})
this.onRejectedCallbacks.push(()=>{
try {
let x = onRejected(this.reason)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
})
}
})
return promise2
}
catch(errCallback) {
// 等同于没有成功,把失败放进去而已
return this.then(null, errCallback)
}
// myPromise.resolve 具备等待功能的 如果参数的promise会等待promise解析完毕在向下执行
static resolve(val) {
return new myPromise((resolve,reject)=>{
resolve(val)
})
}
// myPromise.reject 直接将值返回
static reject(reason) {
return new myPromise((resolve,reject)=>{
reject(reason)
})
}
// finally传入的函数 无论成功或失败都执行
// Promise.reject(100).finally(()=>{console.log(1)}).then(d=>console.log('success',d)).catch(er=>console.log('faild',er))
// Promise.reject(100).finally(()=>new Promise()).then(d=>console.log(d)).catch(er=>)
finally(callback) {
return this.then((val)=>{
return myPromise.resolve(callback()).then(()=>val)
},(err)=>{
return myPromise.resolve(callback()).then(()=>{throw err})
})
}
// Promise.all
static all(values) {
return new myPromise((resolve,reject)=>{
let resultArr = []
let orderIndex = 0
const processResultByKey = (value,index)=>{
resultArr[index] = value
// 处理完全部
if(++orderIndex === values.length) {
resolve(resultArr) // 处理完成的结果返回去
}
}
for (let i = 0; i < values.length; i++) {
const value = values[i];
// 是promise
if(value && typeof value.then === 'function') {
value.then((val)=>{
processResultByKey(val,i)
},reject)
} else {
// 不是promise情况
processResultByKey(value,i)
}
}
})
}
static race(promises) {
// 采用最新成功或失败的作为结果
return new myPromise((resolve,reject)=>{
for (let i = 0; i < promises.length; i++) {
let val = promises[i]
if(val && typeof val.then === 'function') {
// 任何一个promise先调用resolve或reject就返回结果了 也就是返回执行最快的那个promise的结果
val.then(resolve,reject)
}else{
// 普通值
resolve(val)
}
}
})
}
}
/**
* =====测试用例-====
*/
// let promise1 = new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve('成功')
// }, 900);
// })
// promise1.then(val=>{
// console.log('success', val)
// },reason=>{
// console.log('fail', reason)
// })
/**
* then的使用方式 普通值意味不是promise
*
* 1、then中的回调有两个方法 成功或失败 他们的结果返回(普通值)会传递给外层的下一个then中
* 2、可以在成功或失败中抛出异常,走到下一次then的失败中
* 3、返回的是一个promsie,那么会用这个promise的状态作为结果,会用promise的结果向下传递
* 4、错误处理,会默认先找离自己最新的错误处理,找不到就向下查找,找打了就执行
*/
// read('./name.txt').then(data=>{
// return '123'
// }).then(data=>{
// }).then(null,err=>{
// })
// // .catch(err=>{ // catch就是没有成功的promise
// // })
/**
* promise.then实现原理:通过每次返回一个新的promise来实现(promise一旦成功就不能失败,失败就不能成功)
*
*/
// function read(data) {
// return new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve(new myPromise((resolve,reject)=>resolve(data)))
// }, 1000);
// })
// }
// let promise2 = read({name: 'poetry'}).then(data=>{
// return data
// }).then().then().then(data=>{
// console.log(data,'-data-')
// },(err)=>{
// console.log(err,'-err-')
// })
// finally测试
// myPromise
// .resolve(100)
// .finally(()=>{
// return new myPromise((resolve,reject)=>setTimeout(() => {
// resolve(100)
// }, 100))
// })
// .then(d=>console.log('finally success',d))
// .catch(er=>console.log(er, 'finally err'))
/**
* promise.all 测试
*
* myPromise.all 解决并发问题 多个异步并发获取最终的结果
*/
// myPromise.all([1,2,3,4,new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve('ok1')
// }, 1000);
// }),new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve('ok2')
// }, 1000);
// })]).then(d=>{
// console.log(d,'myPromise.all.resolve')
// }).catch(err=>{
// console.log(err,'myPromise.all.reject')
// })
// 实现promise中断请求
let promise = new Promise((resolve,reject)=>{
setTimeout(() => {
// 模拟接口调用 ajax调用超时
resolve('成功')
}, 10000);
})
function promiseWrap(promise) {
// 包装一个promise 可以控制原来的promise是成功 还是失败
let abort
let newPromsie = new myPromise((resolve,reject)=>{
abort = reject
})
// 只要控制newPromsie失败,就可以控制被包装的promise走向失败
// Promise.race 任何一个先成功或者失败 就可以获得结果
let p = myPromise.race([promise, newPromsie])
p.abort = abort
return p
}
let newPromise = promiseWrap(promise)
setTimeout(() => {
// 超过3秒超时
newPromise.abort('请求超时')
}, 3000);
newPromise.then(d=>{
console.log('d',d)
}).catch(err=>{
console.log('err',err)
})
// 使用promises-aplus-tests 测试写的promise是否规范
// 全局安装 cnpm i -g promises-aplus-tests
// 命令行执行 promises-aplus-tests promise.js
// 测试入口 产生延迟对象
myPromise.defer = myPromise.deferred = function () {
let dfd = {}
dfd.promise = new myPromise((resolve,reject)=>{
dfd.resolve = resolve
dfd.reject = reject
})
return dfd
}
// 延迟对象用户
// 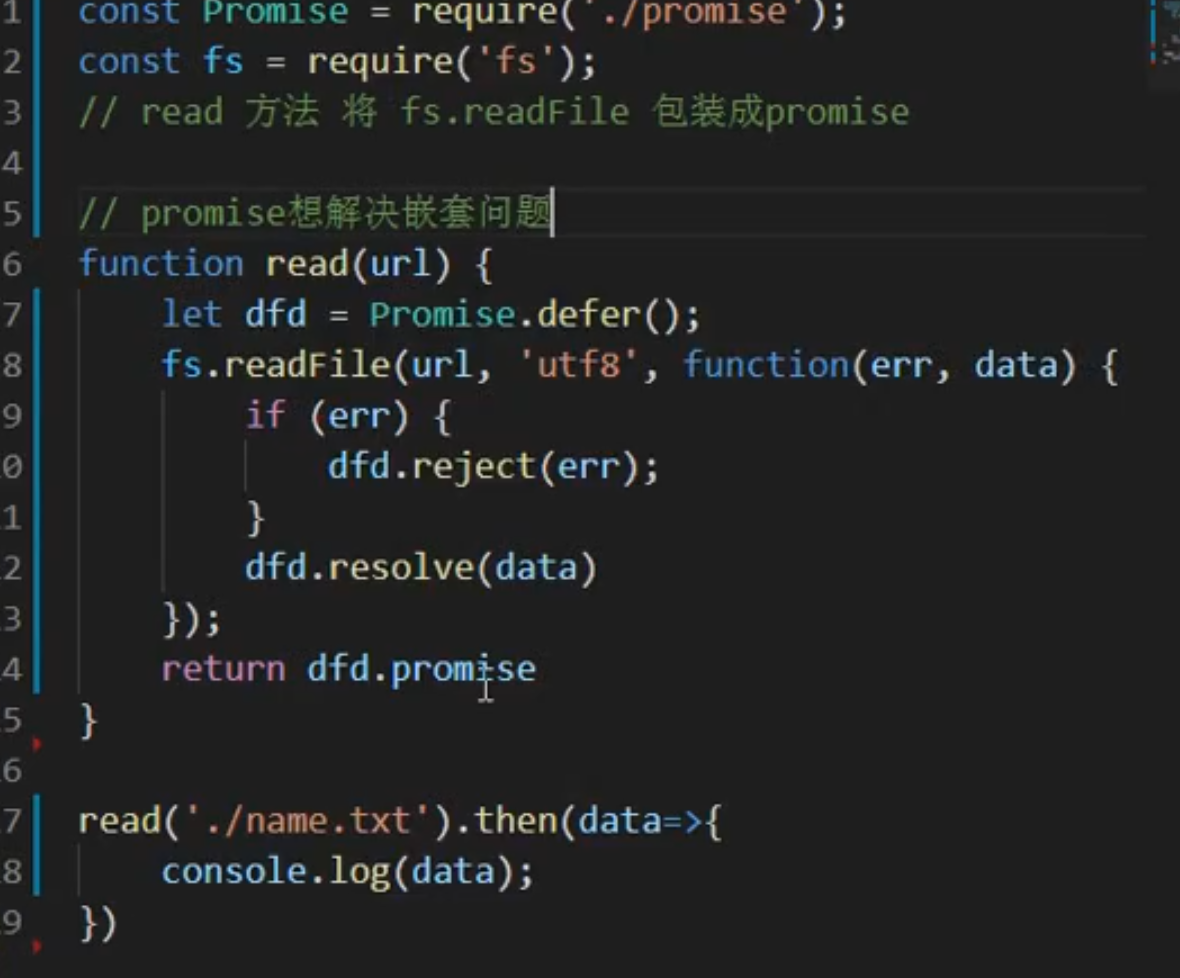
// promise解决嵌套问题
// function readData(url) {
// let dfd = myPromise.defer()
// fs.readFile(url, 'utf8', function (err,data) {
// if(err) {
// dfd.reject()
// }
// dfd.resolve(data)
// })
// return dfd.promise
// }
// readData().then(d=>{
// return d
// })
module.exports = myPromise
💬 面试官追问
then里return了promise2自己,会发生什么?自己等自己,永远不会结束。规范要求这种情况直接用
TypeError拒绝promise2,所以resolvePromise第一行就是if (x === promise2) return reject(new TypeError(...)),注意要return,不然后面还会接着去取x.then。called这个标记到底防什么?原生Promise自己不是已经状态不可逆了吗?防的是别人写的
thenable。比如某个库的then先调成功回调、又调失败回调、最后还throw,没有called就会重复递归解析。外层promise2状态不可逆只能保证最终结果不变,挡不住中间多余的递归和副作用。为什么非要
let then = x.then先存一份,直接x.then(...)不行吗?then可能是个getter,每读一次都可能有副作用、甚至抛错。规范要求只读一次,读的动作还得放在try里,抛错就reject。之后用then.call(x, ...)调,保证this还是x。同一个
p上挂三个then,结果只有最后一个执行了,先查哪?查
pending分支是不是用了赋值而不是push,比如写成this.onResolved = fn,后面的就把前面的覆盖了。要用数组存,resolve的时候forEach全跑一遍。跑过了
promises-aplus-tests,能直接替换原生Promise上线吗?不能。
A+只管then和解析过程,Promise.all、allSettled、finally这些都不在里面;执行时机上它用setTimeout,比原生微任务慢一拍,和await混用时顺序会乱。手写版拿来理解原理就够了,生产上别替换。
# 11 实现发布订阅模式
⚡ 30 秒速记
- 中间多了一个事件中心:发布者只管
emit事件名,订阅者只管on,双方互相不知道对方是谁 - 最小实现 = 一个
{ 事件名: [回调] }的map+on/emit/off,再补个once once用包装函数实现,包装函数上挂fn.l = 原回调,这样off(原回调)也能删掉它once转发参数要写callback(...args),写成callback(args)参数会被包成一个数组- 最常见的线上问题是只
on不off:组件反复挂载,同一事件触发好几次,闭包也释放不掉
发布订阅说白了就是一个「公告栏」:发布者往上贴消息,订阅者自己去登记关心哪类消息,两边不用认识。 实现就是一个对象按事件名存回调数组,on 往数组里加,emit 拿出来挨个执行,off 按函数引用删掉。好处是模块之间解耦,Vue 2 的 EventBus、Node 的 EventEmitter 都是这个思路。坏处是用多了没人知道一个事件到底谁在发、谁在听,排查起来很痛苦,所以我一般只拿它做跨模块的一次性通知,状态还是交给 store。
简介:
发布订阅者模式,一种对象间一对多的依赖关系,但一个对象的状态发生改变时,所依赖它的对象都将得到状态改变的通知。
主要的作用(优点):
- 广泛应用于异步编程中(替代了传递回调函数)
- 对象之间松散耦合的编写代码
缺点:
- 创建订阅者本身要消耗一定的时间和内存
- 多个发布者和订阅者嵌套一起的时候,程序难以跟踪维护
实现的思路:
- 创建一个对象(缓存列表)
on方法用来把回调函数fn都加到缓存列表中emit根据key值去执行对应缓存列表中的函数off方法可以根据key值取消订阅
class EventEmiter {
  constructor() {
    // 事件对象,存放订阅的名字和事件
    this._events = {}
  }
  // 订阅事件的方法
  on(eventName,callback) {
    if(!this._events) {
      this._events = {}
    }
    // 合并之前订阅的cb
    this._events[eventName] = [...(this._events[eventName] || []),callback]
  }
  // 触发事件的方法
  emit(eventName, ...args) {
    if(!this._events[eventName]) {
      return
    }
    // 遍历执行所有订阅的事件
    this._events[eventName].forEach(fn=>fn(...args))
  }
  off(eventName,cb) {
    if(!this._events[eventName]) {
      return
    }
    // 删除订阅的事件
    this._events[eventName] = this._events[eventName].filter(fn=>fn != cb && fn.l != cb)
  }
  // 绑定一次 触发后将绑定的移除掉 再次触发掉
  once(eventName,callback) {
    const one = (...args)=>{
      // 等callback执行完毕在删除
      callback(args)
      this.off(eventName,one)
    }
    one.l = callback // 自定义属性
    this.on(eventName,one)
  }
}
测试用例
let event = new EventEmiter()

let login1 = function(...args) {
  console.log('login success1', args)
}
let login2 = function(...args) {
  console.log('login success2', args)
}
// event.on('login',login1)
event.once('login',login2)
event.off('login',login1) // 解除订阅
event.emit('login', 1,2,3,4,5)
event.emit('login', 6,7,8,9)
event.emit('login', 10,11,12)
发布订阅者模式和观察者模式的区别?
- 发布/订阅模式是观察者模式的一种变形,两者区别在于,发布/订阅模式在观察者模式的基础上,在目标和观察者之间增加一个调度中心。
- 观察者模式是由具体目标调度,比如当事件触发,
Subject就会去调用观察者的方法,所以观察者模式的订阅者与发布者之间是存在依赖的。 - 发布/订阅模式由统一调度中心调用,因此发布者和订阅者不需要知道对方的存在。
💬 面试官追问
订单页每进一次,
WebSocket消息就多弹一次框,查哪里?查组件卸载时有没有
off,以及off传的是不是同一个函数引用。on('msg', () => {...})这种匿名函数是删不掉的,要先存成变量,卸载时off('msg', handler)。emit时某个回调里调用了off把自己删了,后面的回调会受影响吗?如果
off用filter生成新数组,forEach还在遍历旧数组,所以没事。但如果off改成splice原地删,就会跳过下一个回调。稳妥写法是emit时先拷贝一份:[...list].forEach(fn => fn(...args))。一个订阅者抛了异常,后面的订阅者就收不到了,怎么办?
同步
forEach遇到异常直接中断。埋点、日志这种互不相干的订阅,每个回调单独包try/catch,错误上报后继续往下发。如果业务要求一个失败就整体失败,那就别吞。once的回调里又同步emit了同一个事件,为什么执行了两次?包装函数如果先执行回调再
off,回调里再emit时包装函数还在列表里。改成先off再执行回调,once才是严格的一次。发布订阅和观察者模式,区别到底在哪?
观察者是目标对象自己存着观察者列表、自己去通知,双方直接依赖;发布订阅中间隔了个事件中心,发布者连有没有人订阅都不知道。前者像老师挨个通知家长,后者像在班级群里发公告。
# 12 实现观察者模式
⚡ 30 秒速记
- 被观察者(
Subject)自己存一份观察者列表,状态一变就挨个调observer.update(this) - 三个方法:
attach加 /detach删 /notify通知,观察者统一实现update - 和发布订阅的区别:没有中间的事件中心,目标直接持有观察者,耦合更紧
- 只写
attach不写detach,Subject活得久的话观察者永远释放不掉 Vue的响应式就是这个模型:Dep是被观察者,Watcher是观察者
观察者模式就是被观察者手里拿着一份名单,自己状态变了就挨个通知名单上的人。 比如学生是 Subject,家长和老师先 attach 进来,学生 setState('被欺负了') 时遍历名单调每个人的 update。它和发布订阅最大的区别是没有中间人,Subject 直接认识每个观察者,所以简单直接,但耦合更紧。工程上要补的是 detach,组件销毁时不移除,Subject 就一直拿着它的引用,内存涨上去还不好查。
观察者模式(基于发布订阅模式) 有观察者,也有被观察者
观察者需要放到被观察者中,被观察者的状态变化需要通知观察者 我变化了 内部也是基于发布订阅模式,收集观察者,状态变化后要主动通知观察者
class Subject { // 被观察者 学生
  constructor(name) {
    this.state = 'happy'
    this.observers = []; // 存储所有的观察者
  }
  // 收集所有的观察者
  attach(o){ // Subject. prototype. attch
    this.observers.push(o)
  }
  // 更新被观察者 状态的方法
  setState(newState) {
    this.state = newState; // 更新状态
    // this 指被观察者 学生
    this.observers.forEach(o => o.update(this)) // 通知观察者 更新它们的状态
  }
}

class Observer{ // 观察者 父母和老师
  constructor(name) {
    this.name = name
  }
  update(student) {
    console.log('当前' + this.name + '被通知了', '当前学生的状态是' + student.state)
  }
}

let student = new Subject('学生');

let parent = new Observer('父母');
let teacher = new Observer('老师');

// 被观察者存储观察者的前提,需要先接纳观察者
student.attach(parent);
student.attach(teacher);
student.setState('被欺负了');
💬 面试官追问
班级看板页面销毁了,老师对象还在
observers里,会怎样?只要
student还活着,老师对象和它闭包里的东西都不会被回收,切几次页面内存就上去了,还会对已销毁的组件调update。补一个detach(o),按引用filter掉,组件卸载时调用。一次导入一万条成绩,
setState调了一万次,面板也刷新一万次,怎么改?通知做批量:状态先改,用
queueMicrotask或Promise.resolve().then合并成一次notify。Vue的异步更新队列就是这么干的,同一个Watcher在一轮里只跑一次。某个观察者在
update里把自己detach了,会出什么问题?如果
detach用splice原地删,正在forEach的数组少了一项,下一个观察者会被跳过。notify时先拷贝一份[...this.observers]再遍历,本轮名单就固定了。setState传了和原来一样的值,要不要通知?看需求。纯展示的面板可以在
setState里先比一下Object.is(old, newState),相同就跳过;但如果有审计观察者要记每次操作,就别在Subject里统一过滤,把新旧值都传给update,让观察者自己判断。Vue 2的响应式里,谁是被观察者,谁是观察者?每个响应式属性对应一个
Dep,它是被观察者;Watcher(渲染、computed、watch)是观察者。getter里dep.depend()收集,setter里dep.notify()通知,和这里的attach/notify是一个意思。
# 13 实现单例模式
⚡ 30 秒速记
- 思路:闭包里存一个
instance,用Proxy的construct拦截new,有就直接返回 - 拦截器名是
construct,不是constructor;转发用Reflect.construct(target, args),第一个参数就是被代理的类 - 后面再
new传什么参数都没用,只有第一次的参数生效 - 前端更常用的单例其实是
ES Module直接export一个实例,模块只执行一次,天然单例 SSR里别把带用户状态的东西做成模块级单例,所有请求会共用一份
单例就是不管 new 多少次都拿到同一个对象,Proxy 版的做法是拦截构造过程,第一次真正创建,之后直接返回缓存。 核心就一个 construct 陷阱:
construct(target, args) { if (!instance) instance = Reflect.construct(target, args); return instance }
这样 new Single('A') === new Single('B') 是 true,但 B 这个参数会被悄悄忽略。实际项目里我很少这么写,ES Module 本身就有缓存,export default new Store() 就是单例,比 Proxy 好懂得多。
核心要点: 用闭包和
Proxy属性拦截
function proxy(func) {
    let instance;
    let handler = {
        constructor(target, args) {
            if(!instance) {
                instance = Reflect.constructor(fun, args);
            }
            return instance;
        }
    }
    return new Proxy(func, handler);
}
💬 面试官追问
handler里把陷阱写成了constructor,new出来的对象每次都不一样,为什么?Proxy不认constructor这个名字,相当于没拦截,每次都走原始构造函数。改成construct,里面用Reflect.construct(target, args);Reflect.constructor只是继承来的Object,调它拿不到实例。第一次
new Logger('info'),第二次new Logger('debug'),第二次的级别生效吗?不生效,第二次直接返回第一次的实例,
'debug'被吞了还不报错。要么约定只有第一次传参,后面传了就console.warn;要么按参数做多例缓存Map<key, instance>。Next.js服务端把用户会话客户端做成模块级单例,有什么问题?服务端进程是所有请求共用的,
A用户登录后的token会被B用户的请求读到,属于串号事故。带用户状态的对象必须按请求创建,只有无状态的东西,比如配置、数据库连接池,才适合做进程级单例。单元测试里上一个用例改了单例状态,下一个用例被污染,怎么办?
闭包里的
instance没法重置,测试之间就互相影响。更好的写法是导出工厂函数,生产代码里只调一次,测试里每个用例自己创建;或者在Jest里用jest.resetModules()让模块重新执行。Proxy单例、模块导出实例、工厂函数,怎么选?前端绝大多数场景直接模块导出实例就够了,最直观。必须保留
new XXX()这种调用方式时才用Proxy;需要控制生命周期、方便测试,用工厂函数。
# 14 实现Ajax
⚡ 30 秒速记
Ajax= 不刷新页面,用JS发请求拿数据,再局部更新DOM- 原生四步:
new XMLHttpRequest()→open(method, url)→ 监听onreadystatechange/onload→send(body) readyState走0 → 1 → 2 → 3 → 4,4才是请求结束,再看status- 名字里的
XML是历史遗留,现在返回的基本都是JSON - 现在新代码多用
fetch或axios,但XHR还是唯一能稳定拿上传进度的原生方案
Ajax 说白了就是页面不刷新,用 JS 在后台发个请求,拿到数据只改页面的一小块。 原生靠 XMLHttpRequest:创建实例、open 配方法和地址、绑回调、send 发出去,回调里等 readyState 变成 4 再根据 status 判断成败。名字里有 XML 是因为早年服务端回的是 XML,现在都是 JSON 了。面试让手写这个,主要看你清不清楚请求的几个阶段和错误怎么收口,不是真让你在项目里用它。
步骤
- 创建
XMLHttpRequest实例 - 发出 HTTP 请求
- 服务器返回 XML 格式的字符串
- JS 解析 XML,并更新局部页面
- 不过随着历史进程的推进,XML 已经被淘汰,取而代之的是 JSON。
了解了属性和方法之后,根据 AJAX 的步骤,手写最简单的 GET 请求。
💬 面试官追问
readyState和status有什么区别?readyState是XHR对象自己走到哪一步了,4表示请求结束;status是服务端返回的HTTP状态码。请求结束不等于成功,断网时readyState也会到4,只是status是0。open的第三个参数传false会怎样?变成同步请求,
send会卡住主线程直到响应回来,页面期间完全点不动。主线程上的同步XHR已经被标为废弃,控制台会警告,别用。已经有
fetch了,为什么还有人用XHR?fetch原生拿不到上传进度,XHR有xhr.upload.onprogress,大文件上传还离不开它。axios在浏览器里底层默认也是XHR,新版本才支持切到fetch适配器。fetch遇到404、500,会走catch吗?不会。
fetch只有网络层失败才reject,404照样resolve,要自己判断res.ok。这是从XHR迁过来最容易漏的地方。同一个请求要能中途取消,
XHR和fetch各怎么做?XHR直接xhr.abort();fetch要传AbortController的signal,取消时调controller.abort(),Promise会以AbortError拒绝。
# 1 原生实现
⚡ 30 秒速记
- 骨架:
new XMLHttpRequest()→open('GET', url)→ 绑onreadystatechange→send() - 回调里先判
readyState === 4,再判status >= 200 && status < 300,然后JSON.parse(xhr.responseText) - 变量名前后要一致:声明
xhr却写request.send(),直接ReferenceError,请求都发不出去 - 解析出来的数据要么传给回调,要么包成
Promise返回,不然等于白拿 - 生产版还要补:
onerror/ontimeout、POST的请求头和body、JSON.parse的异常
原生 Ajax 就四步:创建 XHR、open 配置、绑回调、send 发出去。 回调里等 readyState 到 4,再看 status 在 2xx 之间,就可以读 responseText 解析了。手写时最容易出的低级错是变量名前后不一致,声明叫 xhr,后面写成 request,跑起来直接报 request is not defined,请求都发不出去。拿到数据之后也要交出去,要么传个回调进来,要么包成 Promise 返回。
function ajax() {
  let xhr = new XMLHttpRequest() //实例化,以调用方法
  xhr.open('get', 'https://www.google.com')  //参数2,url。参数三:异步
  xhr.onreadystatechange = () => {  //每当 readyState 属性改变时,就会调用该函数。
    if (xhr.readyState === 4) {  //XMLHttpRequest 代理当前所处状态。
      if (xhr.status >= 200 && xhr.status < 300) {  //200-300请求成功
        let string = request.responseText
        //JSON.parse() 方法用来解析JSON字符串,构造由字符串描述的JavaScript值或对象
        let object = JSON.parse(string)
      }
    }
  }
  request.send() //用于实际发出 HTTP 请求。不带参数为GET请求
}
💬 面试官追问
控制台报
request is not defined,Network里一个请求都没有,为什么?声明的是
xhr,后面用了request,request.send()这行就抛ReferenceError,请求根本没发出去。统一成xhr.responseText和xhr.send()就好。接口返回
204,直接JSON.parse(xhr.responseText)会怎样?204落在成功区间,但响应体是空字符串,JSON.parse('')直接抛SyntaxError。要先判断responseText是不是空的,或者直接设xhr.responseType = 'json'让浏览器解析,失败时xhr.response是null。断网或者超时,页面一直转圈,要补什么?
补
xhr.onerror、xhr.ontimeout,再设xhr.timeout = 10000。断网时onreadystatechange也会走到readyState === 4,但status是0,如果只处理了成功分支,失败什么都不做,loading自然关不掉。改成
POST发JSON,要动哪几处?open('POST', url)之后加xhr.setRequestHeader('Content-Type', 'application/json'),send(JSON.stringify(data))。setRequestHeader必须在open之后、send之前调,顺序错了会抛错。跨域请求要带上
Cookie,前端要怎么设?设
xhr.withCredentials = true。服务端还得返回具体的Access-Control-Allow-Origin(不能是*)加Access-Control-Allow-Credentials: true,缺一样浏览器都不让读响应。
# 2 Promise实现
⚡ 30 秒速记
- 外面包一层
new Promise,2xx走resolve,其他走reject,调用方就能.then/await - 成功区间是
status >= 200 && status < 300,写成<= 300会把300也当成功 - 坑:
JSON.parse在onreadystatechange回调里抛错,不会自动变成reject,Promise会一直挂着 - 断网和超时其实也会走到
readyState === 4(status是0),会被reject,但分不出原因,最好单独绑onerror/ontimeout reject别传字符串,传Error带上status和url,方便排查
用 Promise 包 Ajax,就是把 XHR 的回调结果翻译成 resolve 和 reject,调用方就能写 await ajax(url) 了。 写的时候有两个坑:一是成功条件要写 < 300,写成 <= 300 会把 300 也算成功;二是 JSON.parse 放在异步回调里,解析失败抛的异常不在 executor 的同步执行范围内,Promise 接不住,就一直 pending,页面永远在 loading。我会把解析包进 try/catch,失败就 reject,reject 的时候传 Error 对象而不是字符串。
基于Promise封装Ajax
- 返回一个新的
Promise实例 - 创建
HMLHttpRequest异步对象 - 调用
open方法,打开url,与服务器建立链接(发送前的一些处理) - 监听
Ajax状态信息 - 如果
xhr.readyState == 4(表示服务器响应完成,可以获取使用服务器的响应了)xhr.status == 200,返回resolve状态xhr.status == 404,返回reject状态
xhr.readyState !== 4,把请求主体的信息基于send发送给服务器
function ajax(url) {
  return new Promise((resolve, reject) => {
    let xhr = new XMLHttpRequest()
    xhr.open('get', url)
    xhr.onreadystatechange = () => {
      if (xhr.readyState == 4) {
        if (xhr.status >= 200 && xhr.status <= 300) {
          resolve(JSON.parse(xhr.responseText))
        } else {
          reject('请求出错')
        }
      }
    }
    xhr.send()  //发送hppt请求
  })
}

let url = '/data.json'
ajax(url).then(res => console.log(res))
  .catch(reason => console.log(reason))
💬 面试官追问
接口返回了一个
HTML错误页,状态码是200,页面为什么一直转圈?JSON.parse抛了SyntaxError,但它是在onreadystatechange回调里抛的,Promise只自动捕获executor同步阶段的异常,所以既不resolve也不reject。改成try { resolve(JSON.parse(text)) } catch (e) { reject(e) }。断网时
.catch能执行吗?能,断网时
readyState也会到4,status是0,会走else分支reject。问题是超时、断网、500全是同一句话,分不清。单独绑onerror、ontimeout,reject时带上类型。搜索框快速输入,旧请求的结果覆盖了新结果,怎么改?
Promise本身没法取消,要在封装里把xhr暴露出去或接收一个AbortSignal,新请求发出前abort掉旧的。页面层再加个请求序号,只认最新那一次的结果,双保险。reject('请求出错')这种写法有什么问题?拿到的是字符串,没有调用栈,
Sentry这类监控里也看不出是哪个接口。改成reject(Object.assign(new Error('HTTP ' + xhr.status), { status: xhr.status, url }))。管理后台要上传进度和超时控制,
XHR封装和fetch怎么选?要上传进度就留
XHR,fetch原生拿不到。超时两边都能做,XHR用timeout属性,fetch用AbortSignal.timeout(10000)。普通JSON接口用fetch更简洁,但别忘了fetch遇到404不会reject。
# 15 实现JSONP方法
⚡ 30 秒速记
- 原理:
<script>的src不受同源策略限制,服务端返回一段callback(数据)的JS,浏览器执行时就把数据交给了全局函数 - 实现:挂
window[cbName]→ 拼src(带callback=cbName和参数)→ 插入script→ 回调里resolve并清理 - 只能
GET,拿不到状态码,必须服务端配合 - 上线要补:参数用
encodeURIComponent、回调名每次唯一、删掉window上的函数、onerror和超时 - 安全风险大:等于执行对方的任意脚本,能用
CORS就别用JSONP
JSONP 是钻了 <script> 标签能跨域加载的空子:前端先定义好一个全局函数,服务端把数据包成这个函数的调用返回来,脚本一执行,数据就到手了。 比如请求 ?callback=getData,服务端返回 getData({"list":[]})。最简版能跑通示例,但上线还要补几件事:参数要编码,回调名每次唯一,不然会互相覆盖,失败和超时要 reject,不然 Promise 永远不结束,用完还要删掉 window 上的函数。而且它本质是执行对方的脚本,对方被黑你就跟着被黑,现在基本都用 CORS 了,JSONP 只在对接老接口时见到。
利用
<script>标签不受跨域限制的特点,缺点是只能支持get请求
- 创建
script标签 - 设置
script标签的src属性,以问号传递参数,设置好回调函数callback名称 - 插入到
html文本中 - 调用回调函数,
res参数就是获取的数据
function jsonp({url,params,callback}) {
  return new Promise((resolve,reject)=>{
  let script = document.createElement('script')

    window[callback] = function (data) {
      resolve(data)
      document.body.removeChild(script)
    }
    var arr = []
    for(var key in params) {
      arr.push(`${key}=${params[key]}`)
    }
    script.type = 'text/javascript'
    script.src = `${url}?callback=${callback}&${arr.join('&')}`
    document.body.appendChild(script)
  })
}
// 测试用例
jsonp({
  url: 'http://suggest.taobao.com/sug',
  callback: 'getData',
  params: {
    q: 'iphone手机',
    code: 'utf-8'
  },
}).then(data=>{console.log(data)})
- 设置
CORS: Access-Control-Allow-Origin:* postMessage
💬 面试官追问
服务端直接返回
{"a":1},JSONP能拿到吗?拿不到。浏览器把它当
JS执行,一个裸对象字面量什么都不会调用,甚至会被当成代码块报语法错误。服务端必须读callback参数,返回getData({...})这种形式。搜索词是
iphone 手机&配件,服务端收到的q只有前半截,为什么?&没编码,被当成了参数分隔符。拼src时用new URLSearchParams(params).toString(),它会自动编码空格、&、中文。页面上同时发了好几个
JSONP,回调名都叫getData,会怎样?后一个会覆盖前一个的
window.getData,先回来的响应可能交给了错误的Promise,前面那个永远不结束。回调名加随机后缀,比如'jsonp_' + Date.now() + Math.random().toString(36).slice(2),用完delete window[name]。接口
404了,Promise一直pending,怎么兜底?绑
script.onerror直接reject,再加一个setTimeout超时reject。不管成功、失败还是超时,都要统一清掉script节点、全局函数和定时器。JSONP为什么现在基本不用了?它会把对方的响应当脚本执行,对方接口被篡改就能在你页面里跑任意代码;而且只能
GET、拿不到状态码。CORS是服务端用响应头明确授权,数据走正常的XHR/fetch,安全也规范,主流浏览器早就都支持了。
# 16 实现async/await
⚡ 30 秒速记
async/await≈Generator+ 自动执行器:yield当await用,执行器负责「等结果、塞回去、继续走」asyncToGenerator返回一个新函数,调用时apply(this, arguments)拿到迭代器,并返回一个Promisestep('next', val)推进;yield的值用Promise.resolve包一层,普通值也能等- 失败走
step('throw', err),异常从yield那行抛回去,生成器里的try/catch才能接住 gen[key](arg)要包try/catch,生成器里同步抛错就reject外层Promise;done时resolve(value)
async/await 可以看成 Generator 加一个自动执行器:yield 负责暂停,执行器负责等 Promise 完成后把结果塞回去,再调 next 继续。 asyncToGenerator 的核心就是那个 step 函数:调 gen.next(val),没结束就用 Promise.resolve(value).then 等结果,成功递归 step('next'),失败递归 step('throw'),结束了就 resolve 最终返回值。Babel 把 async 函数转成 ES5 时生成的 _asyncToGenerator 基本就是这段代码。现在浏览器都原生支持了,手写只是为了看懂原理。
分析
// generator生成器  生成迭代器iterator

// 默认这样写的类数组是不能被迭代的,缺少迭代方法
let likeArray = {'0': 1, '1': 2, '2': 3, '3': 4, length: 4}

// // 使用迭代器使得可以展开数组
// // Symbol有很多元编程方法,可以改js本身功能
// likeArray[Symbol.iterator] = function () {
//   // 迭代器是一个对象 对象中有next方法 每次调用next 都需要返回一个对象 {value,done}
//   let index = 0
//   return {
//     next: ()=>{
//       // 会自动调用这个方法
//       console.log('index',index)
//       return {
//         // this 指向likeArray
//         value: this[index],
//         done: index++ === this.length
//       }
//     }
//   }
// }
// let arr = [...likeArray]

// console.log('arr', arr)

// 使用生成器返回迭代器
// likeArray[Symbol.iterator] = function *() {
//   let index = 0
//   while (index != this.length) {
//     yield this[index++]
//   }
// }
// let arr = [...likeArray]

// console.log('arr', arr)


// 生成器 碰到yield就会暂停
// function *read(params) {
//   yield 1;
//   yield 2;
// }
// 生成器返回的是迭代器
// let it = read()
// console.log(it.next())
// console.log(it.next())
// console.log(it.next())

// 通过generator来优化promise(promise的缺点是不停的链式调用)
const fs = require('fs')
const path = require('path')
// const co = require('co') // 帮我们执行generator

const promisify = fn=>{
  return (...args)=>{
    return new Promise((resolve,reject)=>{
      fn(...args, (err,data)=>{
        if(err) {
          reject(err)
        }
        resolve(data)
      })
    })
  }
}

// promise化
let asyncReadFile = promisify(fs.readFile)

function * read() {
  let content1 = yield asyncReadFile(path.join(__dirname,'./data/name.txt'),'utf8')
  let content2 = yield asyncReadFile(path.join(__dirname,'./data/' + content1),'utf8')
  return content2
}

// 这样写太繁琐 需要借助co来实现
// let re = read()
// let {value,done} = re.next()
// value.then(data=>{
//   // 除了第一次传参没有意义外 剩下的传参都赋予了上一次的返回值
//   let {value,done} = re.next(data)
//   value.then(d=>{
//     let {value,done} = re.next(d)
//     console.log(value,done)
//   })
// }).catch(err=>{
//   re.throw(err) // 手动抛出错误 可以被try catch捕获
// })


// 实现co原理
function co(it) {// it 迭代器
  return new Promise((resolve,reject)=>{
    // 异步迭代 需要根据函数来实现
    function next(data) {
      // 递归得有中止条件
      let {value,done} = it.next(data)
      if(done) {
        resolve(value) // 直接让promise变成成功 用当前返回的结果
      } else {
        // Promise.resolve(value).then(data=>{
        //   next(data)
        // }).catch(err=>{
        //   reject(err)
        // })
        // 简写
        Promise.resolve(value).then(next,reject)
      }
    }
    // 首次调用
    next()
  })
}

co(read()).then(d=>{
  console.log(d)
}).catch(err=>{
  console.log(err,'--')
})
整体看一下结构
function asyncToGenerator(generatorFunc) {
    return function() {
      const gen = generatorFunc.apply(this, arguments)
      return new Promise((resolve, reject) => {
        function step(key, arg) {
          let generatorResult
          try {
            generatorResult = gen[key](arg)
          } catch (error) {
            return reject(error)
          }
          const { value, done } = generatorResult
          if (done) {
            return resolve(value)
          } else {
            return Promise.resolve(value).then(val => step('next', val), err => step('throw', err))
          }
        }
        step("next")
      })
    }
}
分析
function asyncToGenerator(generatorFunc) {
  // 返回的是一个新的函数
  return function() {

    // 先调用generator函数 生成迭代器
    // 对应 var gen = testG()
    const gen = generatorFunc.apply(this, arguments)

    // 返回一个promise 因为外部是用.then的方式 或者await的方式去使用这个函数的返回值的
    // var test = asyncToGenerator(testG)
    // test().then(res => console.log(res))
    return new Promise((resolve, reject) => {

      // 内部定义一个step函数 用来一步一步的跨过yield的阻碍
      // key有next和throw两种取值,分别对应了gen的next和throw方法
      // arg参数则是用来把promise resolve出来的值交给下一个yield
      function step(key, arg) {
        let generatorResult

        // 这个方法需要包裹在try catch中
        // 如果报错了 就把promise给reject掉 外部通过.catch可以获取到错误
        try {
          generatorResult = gen[key](arg)
        } catch (error) {
          return reject(error)
        }

        // gen.next() 得到的结果是一个 { value, done } 的结构
        const { value, done } = generatorResult

        if (done) {
          // 如果已经完成了 就直接resolve这个promise
          // 这个done是在最后一次调用next后才会为true
          // 以本文的例子来说 此时的结果是 { done: true, value: 'success' }
          // 这个value也就是generator函数最后的返回值
          return resolve(value)
        } else {
          // 除了最后结束的时候外,每次调用gen.next()
          // 其实是返回 { value: Promise, done: false } 的结构,
          // 这里要注意的是Promise.resolve可以接受一个promise为参数
          // 并且这个promise参数被resolve的时候,这个then才会被调用
          return Promise.resolve(
            // 这个value对应的是yield后面的promise
            value
          ).then(
            // value这个promise被resove的时候,就会执行next
            // 并且只要done不是true的时候 就会递归的往下解开promise
            // 对应gen.next().value.then(value => {
            //    gen.next(value).value.then(value2 => {
            //       gen.next()
            //
            //      // 此时done为true了 整个promise被resolve了
            //      // 最外部的test().then(res => console.log(res))的then就开始执行了
            //    })
            // })
            function onResolve(val) {
              step("next", val)
            },
            // 如果promise被reject了 就再次进入step函数
            // 不同的是,这次的try catch中调用的是gen.throw(err)
            // 那么自然就被catch到 然后把promise给reject掉啦
            function onReject(err) {
              step("throw", err)
            },
          )
        }
      }
      step("next")
    })
  }
}
💬 面试官追问
yield 42这种不是Promise的值,执行器为什么不报错?因为它用
Promise.resolve(value)包了一层,普通值会变成已成功的Promise,thenable也会被展开。要是直接写value.then(...),碰到42就报value.then is not a function。这和await 42的行为一致。读文件失败了,生成器里写的
try/catch想读备用文件,执行器要怎么配合?失败时调
gen.throw(err),异常会从对应的yield那一行抛出来,生成器自己的try/catch就能接住。如果执行器直接reject外层Promise,生成器里的降级逻辑根本没机会跑。为什么
gen[key](arg)外面要包try/catch?next和throw会恢复执行生成器里的代码,那段代码可能同步抛错,比如JSON.parse失败,或者throw进去的错误生成器里没接。不包的话异常会冒到then回调里,外层Promise拿不到。包装后的函数挂在对象上当方法用,
this.userId读到undefined,为什么?创建迭代器时没用
generatorFunc.apply(this, arguments),而是直接generatorFunc(),this和参数都丢了。另外返回的包装函数要用普通function,写成箭头函数this就绑死在外层了。这个执行器和原生
async/await完全等价吗?核心控制流一样,但细节不同:原生
await有引擎优化,V8从7.2起await一个原生Promise只多耗 1 个微任务,手写版走then会多几轮微任务,混在一起时打印顺序可能不同。原生还有更好的异步调用栈,调试体验也不一样。
# 17 基于Generator函数实现async/await原理
⚡ 30 秒速记
- 核心:
next()拿到{ value, done },value是Promise,等它完成后把结果传给下一次next(data) next(data)传进去的值会成为上一个yield表达式的返回值,第一次next传参没意义- 递归直到
done: true,这就是co库的原理 - 示例缺三样:没处理
reject、没把最终return值交出去、yield普通值会报错 - 补全版就是返回
Promise+Promise.resolve(value).then(next, err => it.throw(err))
Generator 能暂停,但自己不会继续走,这段代码就是写一个「自动按 next 的人」。 每次 next 拿到 yield 出来的 Promise,等它成功了,把结果作为参数再调 next(data),这个 data 就成了 let data = yield ... 左边那个变量的值,一直递归到 done 为 true。这个示例只写了顺利的情况:异步失败了没人管,生成器最后的 return data 也被 if (done) return 丢掉了,调用方拿不到结果。把它包成 Promise、失败时调 iterator.throw,就是上一题的 asyncToGenerator。
核心:传递给我一个
Generator函数,把函数中的内容基于Iterator迭代器的特点一步步的执行
function readFile(file) {
    return new Promise(resolve => {
        setTimeout(() => {
            resolve(file);
    }, 1000);
    })
};

function asyncFunc(generator) {
    const iterator = generator(); // 接下来要执行next
  // data为第一次执行之后的返回结果,用于传给第二次执行
  const next = (data) => {
        let { value, done } = iterator.next(data); // 第二次执行,并接收第一次的请求结果 data

    if (done) return; // 执行完毕(到第三次)直接返回
    // 第一次执行next时,yield返回的 promise实例 赋值给了 value
    value.then(data => {
      next(data); // 当第一次value 执行完毕且成功时,执行下一步(并把第一次的结果传递下一步)
    });
  }
  next();
};

asyncFunc(function* () {
    // 生成器函数:控制代码一步步执行
  let data = yield readFile('a.js'); // 等这一步骤执行执行成功之后,再往下走,没执行完的时候,直接返回
  data = yield readFile(data + 'b.js');
  return data;
})
💬 面试官追问
第二个
readFile失败了,会发生什么?只绑了
then的成功回调,失败没人处理,执行器就停在那,生成器永远不会往下走,控制台可能报一个Unhandled Promise Rejection。要加失败回调,调iterator.throw(err)把错误送回生成器。想
await asyncFunc(...)拿到最后的data,为什么是undefined?asyncFunc什么都没返回,done的时候return也把value丢了。改成返回new Promise,done时resolve(value)。let data = yield readFile('a.js'),data的值是yield后面那个Promise吗?不是。
yield表达式的值由下一次next(x)传进来的x决定,执行器把Promise的结果传进去,data才是文件内容。不传参直接next(),data就是undefined。生成器里加一行
yield 'cache',为什么报value.then is not a function?执行器假设每个
value都是Promise。改成Promise.resolve(value).then(next),普通值、Promise、thenable都能处理。页面关了想中止后面的读取,加个
cancelled标记就行了吗?只能做到不再调
next,生成器停在原地,但已经发出去的读文件、请求还会继续跑完。真要取消得让底层任务支持,比如fetch传AbortSignal,再配合it.return()让生成器走finally做清理。
# 18 实现ES6的const
⚡ 30 秒速记
ES5没有块级作用域,const只能模拟「不能重新赋值」这一点,挂到window或某个对象上- 做法:
Object.defineProperty(window, name, { get, set, configurable: false, enumerable: false }),set里抛TypeError - 属性名是变量就得写
window[data],写成window.data只会在window上多出一个叫data的属性 set里要无条件抛错,原生const赋同样的值也报错- 模拟不了:块级作用域、暂时性死区(
TDZ);const对象内部属性照样能改
ES5 没有块级作用域,所以 const 没法真正实现,只能用 Object.defineProperty 把变量挂到 window 上,拦住重新赋值。 set 里抛 TypeError,configurable: false 防 delete,enumerable: false 让它不出现在 for...in 里。有两个细节容易写错:属性名是变量,要写 window[data],写成 window.data 就成了字面量 data;set 里别判断新旧值是否相同,原生 const 是任何赋值都报错。另外别忘了,const 限制的是绑定不能改,const obj = {} 之后 obj.a = 1 完全合法。
由于ES5环境没有
block的概念,所以是无法百分百实现const,只能是挂载到某个对象下,要么是全局的window,要么就是自定义一个object来当容器
var __const = function __const (data, value) {
    window.data = value // 把要定义的data挂载到window下,并赋值value
    Object.defineProperty(window, data, { // 利用Object.defineProperty的能力劫持当前对象,并修改其属性描述符
      enumerable: false,
      configurable: false,
      get: function () {
        return value
      },
      set: function (data) {
        if (data !== value) { // 当要对当前属性进行赋值时,则抛出错误!
          throw new TypeError('Assignment to constant variable.')
        } else {
          return value
        }
      }
    })
  }
  __const('a', 10)
  console.log(a)
  delete a
  console.log(a)
  for (let item in window) { // 因为const定义的属性在global下也是不存在的,所以用到了enumerable: false来模拟这一功能
    if (item === 'a') { // 因为不可枚举,所以不执行
      console.log(window[item])
    }
  }
  a = 20 // 报错
Vue目前双向绑定的核心实现思路就是利用Object.defineProperty对get跟set进行劫持,监听用户对属性进行调用以及赋值时的具体情况,从而实现的双向绑定
💬 面试官追问
__const('a', 10)之后再执行a = 10,没报错,这对吗?不对。原生
const不管值一不一样,再赋值就是TypeError。set里如果写成if (data !== value)才抛,赋同值就漏过去了,应该无条件throw。const obj = { a: 1 }之后obj.a = 2能成功吗?能。
const只是不让obj指向别的对象,对象内部随便改。要让内部也不能改,用Object.freeze(obj),而且它只冻一层。这个模拟版和真正的
const差在哪?三点:没有块级作用域,
if里定义的外面也能读到;没有暂时性死区,原生const在声明前访问会报ReferenceError;它是window上的属性,原生const在全局声明也不会变成window.a。两个微前端都调了
__const('config', ...),会出什么问题?都往同一个
window上挂,第二个defineProperty会因为属性已经configurable: false直接抛TypeError。要隔离就把容器对象作为参数传进来,别写死window。Vue 2的响应式和这个有什么关系?用的是同一个
API:Object.defineProperty劫持get/set,只是Vue 2在set里不是报错而是通知更新。Vue 3换成了Proxy,能拦截新增属性和数组下标。
# 19 实现一个迭代器生成函数
⚡ 30 秒速记
- 迭代器 = 一个有
next()方法的对象,每次调用返回{ value, done } - 可迭代对象 = 有
[Symbol.iterator]()方法、调用后返回迭代器的对象,for...of、展开运算符、解构都靠它 ES6写法:function*生成器,调用后直接得到迭代器ES5写法:闭包存一个下标当游标,返回带next的对象- 分清两个概念:可迭代对象是数据源,迭代器是一次具体的遍历过程
这一节要搞清两个东西:迭代器是一个有 next() 方法的对象,可迭代对象是能通过 Symbol.iterator 生成迭代器的数据结构。 for...of 背后就是先调 obj[Symbol.iterator]() 拿到迭代器,再一直 next(),直到 done 为 true。所以「实现迭代器生成函数」就是写一个函数,返回能记住当前位置的 next。ES6 里 function* 一行搞定,面试官更想看的是用闭包手写的 ES5 版,看你懂不懂生成器背后在干什么。
💬 面试官追问
迭代器和可迭代对象,是一回事吗?
不是。数组是可迭代对象,
arr[Symbol.iterator]()返回的才是迭代器。一个数组可以生成很多个互不干扰的迭代器,每个迭代器自己记着走到哪了。怎么让一个普通对象能用
for...of?给它加
[Symbol.iterator],最省事的写法是生成器:obj[Symbol.iterator] = function* () { yield* Object.entries(this) }。不过一般直接for (const [k, v] of Object.entries(obj))就行,没必要改对象。for...of中途break,迭代器知道吗?知道。
break、return或抛错时,for...of会调迭代器的return()方法(如果有的话),生成器会借此执行finally里的清理代码。生成器返回的迭代器,为什么本身也能直接
for...of?生成器对象的
[Symbol.iterator]()返回的就是它自己,所以它既是迭代器又是可迭代对象。但它只能遍历一次,走完就一直done: true了。
# 1 ES6对迭代器的实现
⚡ 30 秒速记
- 有
Symbol.iterator就能被for...of遍历,这是ES6给各种集合定的统一接口 - 原生可迭代:
Array、String、Map、Set、TypedArray、arguments、NodeList;普通对象不行 for...of≈const it = obj[Symbol.iterator]()+ 循环it.next()直到done: true- 展开运算符
[...x]、数组解构、Array.from、Promise.all都走同一套协议 - 遍历对象用
Object.keys/Object.entries转一下,或者自己加Symbol.iterator
ES6 给所有集合定了一个统一的遍历接口:只要对象上有 Symbol.iterator 方法,调用它能拿到一个有 next() 的迭代器,就能被 for...of 遍历。 数组、字符串、Map、Set 这些原生都带了,所以能直接遍历;普通对象没有,for...of 一个对象会报 obj is not iterable。for...of 本质就是帮你反复调 next(),拿到 { value, done },done 为 true 就停。展开运算符、解构赋值也是同一套机制,所以对象也不能 [...obj]。
JS原生的集合类型数据结构,只有Array(数组)和Object(对象);而ES6中,又新增了Map和Set。四种数据结构各自有着自己特别的内部实现,但我们仍期待以同样的一套规则去遍历它们,所以ES6在推出新数据结构的同时也推出了一套统一的接口机制——迭代器(Iterator)。
ES6约定,任何数据结构只要具备Symbol.iterator属性(这个属性就是Iterator的具体实现,它本质上是当前数据结构默认的迭代器生成函数),就可以被遍历——准确地说,是被for...of...循环和迭代器的next方法遍历。 事实上,for...of...的背后正是对next方法的反复调用。
在ES6中,针对Array、Map、Set、String、TypedArray、函数的 arguments 对象、NodeList 对象这些原生的数据结构都可以通过for...of...进行遍历。原理都是一样的,此处我们拿最简单的数组进行举例,当我们用for...of...遍历数组时:
const arr = [1, 2, 3]
const len = arr.length
for(item of arr) {
   console.log(`当前元素是${item}`)
}
之所以能够按顺序一次一次地拿到数组里的每一个成员,是因为我们借助数组的
Symbol.iterator生成了它对应的迭代器对象,通过反复调用迭代器对象的next方法访问了数组成员,像这样:
const arr = [1, 2, 3]
// 通过调用iterator,拿到迭代器对象
const iterator = arr[Symbol.iterator]()

// 对迭代器对象执行next,就能逐个访问集合的成员
iterator.next()
iterator.next()
iterator.next()
丢进控制台,我们可以看到next每次会按顺序帮我们访问一个集合成员:
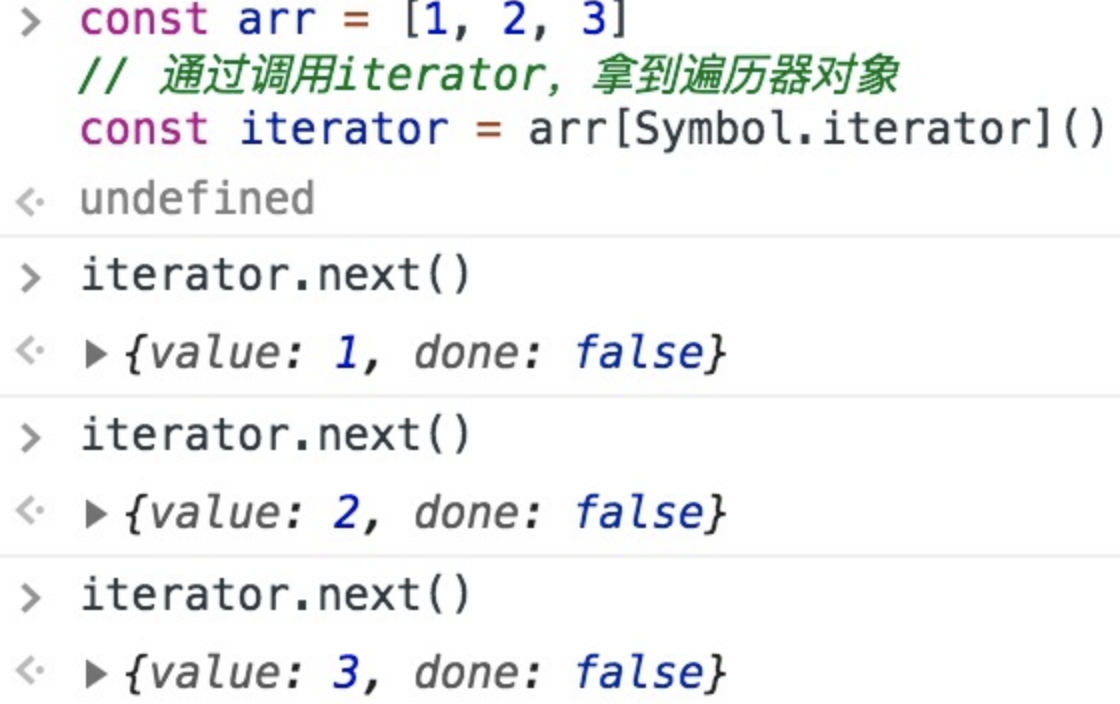
而
for...of...做的事情,基本等价于下面这通操作:
// 通过调用iterator,拿到迭代器对象
const iterator = arr[Symbol.iterator]()

// 初始化一个迭代结果
let now = { done: false }

// 循环往外迭代成员
while(!now.done) {
    now = iterator.next()
    if(!now.done) {
        console.log(`现在遍历到了${now.value}`)
    }
}
可以看出,
for...of...其实就是iterator循环调用换了种写法。在ES6中我们之所以能够开心地用for...of...遍历各种各种的集合,全靠迭代器模式在背后给力。
ps:此处推荐阅读迭代协议 (opens new window),相信大家读过后会对迭代器在ES6中的实现有更深的理解。
💬 面试官追问
for (const x of { a: 1 })为什么报not iterable?对象明明也存了数据。for...of只认Symbol.iterator,普通对象没有这个方法。对象的键没有天然的遍历语义(遍历键?值?键值对?),所以ES6没给它默认实现。用Object.entries(obj)转成数组再遍历。const [a, b] = new Set([1, 2])能成功吗?能,
a是1,b是2。数组解构走的是迭代协议,不是按下标取值,所以Set、Map、字符串、生成器都能解构。组件原来只收数组,现在要同时支持
Set和NodeList,还能用list.length和list[i]吗?Set没有length也不能下标访问,会直接出错。要么统一用for...of遍历,要么入口处Array.from(input)转一次,后面照旧当数组用。for...of和for...in有什么区别?for...of遍历迭代器给出的值,数组就是元素;for...in遍历可枚举的键名,包括原型链上的,数组得到的是字符串下标'0'、'1'。遍历数组别用for...in。手动模拟
for...of,最后一项老是漏掉,大概哪里写错了?多半是先判断了上一轮的
done,调完next()没再检查就退出了。正确顺序是:先const r = it.next(),r.done为true就break,否则处理r.value。
# 2 实现迭代器生成函数
⚡ 30 秒速记
- 迭代器生成函数 = 返回一个带
next()的对象,并且能记住当前遍历到哪 ES6:function*+yield,调用就得到迭代器ES5:闭包里存idx当游标,next()里idx < len就返回{ done: false, value: list[idx++] },否则{ done: true, value: undefined }- 每调一次生成函数就是一个新游标,两个迭代器互不干扰
- 示例创建时就缓存了
len,遍历过程中往数组里追加的元素读不到
迭代器生成函数说白了就是返回一个有 next 方法、而且记得「走到哪了」的对象。 ES6 直接写 function*,每个 yield 就是一次 next 的返回值。面试更想看 ES5 手写版:用闭包里的 idx 当游标,next() 每调一次,没越界就返回当前元素并 idx++,越界了返回 done: true。比如:
const it = iteratorGenerator(['a', 'b']); it.next() // {done: false, value: 'a'}
调三次后就一直是 {done: true, value: undefined}。
我们说迭代器对象全凭迭代器生成函数帮我们生成。在ES6中,实现一个迭代器生成函数并不是什么难事儿,因为ES6早帮我们考虑好了全套的解决方案,内置了贴心的生成器(Generator)供我们使用:
// 编写一个迭代器生成函数
function *iteratorGenerator() {
    yield '1号选手'
    yield '2号选手'
    yield '3号选手'
}

const iterator = iteratorGenerator()

iterator.next()
iterator.next()
iterator.next()
丢进控制台,不负众望:
写一个生成器函数并没有什么难度,但在面试的过程中,面试官往往对生成器这种语法糖背后的实现逻辑更感兴趣。下面我们要做的,不仅仅是写一个迭代器对象,而是用ES5去写一个能够生成迭代器对象的迭代器生成函数(解析在注释里):
// 定义生成器函数,入参是任意集合
function iteratorGenerator(list) {
    // idx记录当前访问的索引
    var idx = 0
    // len记录传入集合的长度
    var len = list.length
    return {
        // 自定义next方法
        next: function() {
            // 如果索引还没有超出集合长度,done为false
            var done = idx >= len
            // 如果done为false,则可以继续取值
            var value = !done ? list[idx++] : undefined

            // 将当前值与遍历是否完毕(done)返回
            return {
                done: done,
                value: value
            }
        }
    }
}

var iterator = iteratorGenerator(['1号选手', '2号选手', '3号选手'])
iterator.next()
iterator.next()
iterator.next()
此处为了记录每次遍历的位置,我们实现了一个闭包,借助自由变量来做我们的迭代过程中的“游标”。
运行一下我们自定义的迭代器,结果符合预期:
💬 面试官追问
遍历完了再调
next(),应该抛异常吗?不应该。迭代协议约定结束后一直返回
{ done: true, value: undefined },for...of就是靠done停下来的,抛异常会让所有消费方都得额外try/catch。轮播图每次点「下一张」都从第一张开始,代码哪里错了?
多半是每次点击都重新调了
iteratorGenerator(images),新闭包的idx又是0。迭代器要在组件里存一份,只在图片列表整体换掉时才重建。两个组件拿同一个数组,各调一次
iteratorGenerator,游标会互相影响吗?不会,每次调用都创建一个新闭包,各有各的
idx。只有两个组件共用同一个迭代器对象时,才会你一个我一个地抢着消费。用
ES5手写的这个,怎么让它也能被for...of用?给返回的对象加一个
[Symbol.iterator]() { return this },它就同时是可迭代对象了。不过Symbol本身是ES6的,纯ES5环境里也用不了for...of,这一步只在新环境有意义。这个手写版能完全替代
Generator吗?不能。它只是顺序取值的状态机,
Generator还能next(x)往里传值、throw()往里抛错、return()提前结束,函数体能在任意yield处暂停和恢复。Babel转Generator用的是regenerator-runtime,比这复杂得多。
# 20 实现ES6的extends
⚡ 30 秒速记
class A extends B其实建了两条原型链:A.prototype.__proto__ === B.prototype(实例方法)和A.__proto__ === B(静态方法)- 示例只做了后一条加
super调用:Object.setPrototypeOf(A, B)+Object.getPrototypeOf(A).call(this, name) - 漏了
Object.setPrototypeOf(A.prototype, B.prototype),所以B.prototype上的方法实例拿不到 setPrototypeOf写在构造函数里,每次new都执行一遍,应该放到外面只做一次- 和真
class的差别:class不能不用new调用、子类构造里super()之前不能用this、能正确继承Array这类内置对象
extends 做了两件事:实例原型链继承父类的方法,构造函数本身继承父类的静态方法,再加上构造时用 super 调父类初始化实例。 示例里 Object.setPrototypeOf(A, B) 只连上了构造函数这一层,Object.getPrototypeOf(A).call(this, name) 相当于 super(name),所以实例有 name、age,但 B.prototype 上的方法是拿不到的。补全版是这样:
Object.setPrototypeOf(A.prototype, B.prototype); Object.setPrototypeOf(A, B)
两行放在构造函数外面执行一次,构造函数里只留 B.call(this, name) 和 this.age = age。
function B(name){
  this.name = name;
};
function A(name,age){
  //1.将A的原型指向B
  Object.setPrototypeOf(A,B);
  //2.用A的实例作为this调用B,得到继承B之后的实例,这一步相当于调用super
  Object.getPrototypeOf(A).call(this, name)
  //3.将A原有的属性添加到新实例上
  this.age = age;
  //4.返回新实例对象
  return this;
};
var a = new A('poetry',22);
console.log(a);
💬 面试官追问
给
B.prototype加了sayName,new A()出来的实例却调不到,为什么?示例只连了
A→B这一条,没连A.prototype→B.prototype,实例查方法走的是后者。补一行Object.setPrototypeOf(A.prototype, B.prototype),或者老写法A.prototype = Object.create(B.prototype)再把constructor指回A。那
Object.setPrototypeOf(A, B)这一步有什么用?继承静态方法。比如
B.create = () => {},连上之后A.create也能用,class的extends也会做这一步。另外示例靠它才能用Object.getPrototypeOf(A)找到父类。setPrototypeOf写在构造函数里,有什么问题?每次
new A()都重新设置一遍原型,没必要;而且修改对象原型会让V8的优化失效,MDN也明确提示setPrototypeOf很慢。继承关系应该在定义完构造函数后设置一次。ES5这样模拟的继承,和class extends有什么本质区别?三点:
class构造函数不用new调用直接报错;子类里super()之前访问this会报错,因为实例是父类构造出来的;所以class MyArr extends Array能拿到正常的length行为,ES5用Array.call(this)做不到。Babel编译class extends用的是什么?_inherits里用Object.create(superClass.prototype)设subClass.prototype,再Object.setPrototypeOf(subClass, superClass);构造函数里用_createSuper调父类,本质就是上面说的两条链加一次父类调用。
# 21 实现Object.create
⚡ 30 秒速记
Object.create(proto)= 新建一个对象,它的原型(__proto__)指向proto- 经典
polyfill:空函数F,F.prototype = proto,返回new F() - 不会执行
proto的任何构造逻辑,也不复制属性,读属性是沿原型链找到的 - 简化版不支持
Object.create(null):F.prototype = null时new F()的原型会退回Object.prototype - 第二个参数(属性描述符)也没实现,原生用法是
Object.create(proto, { a: { value: 1 } })
Object.create(proto) 就是造一个空对象,让它的原型指向 proto。 老浏览器的 polyfill 用一个空构造函数 F,把 F.prototype 设成 proto,new F() 出来的对象原型就是 proto 了。新对象自己是空的,读属性时沿原型链去 proto 上找,所以它是继承不是复制。这个简化版有个容易忽略的坑:传 null 时,new 发现 prototype 不是对象,会退回用 Object.prototype,得到的根本不是纯净字典。
Object.create()方法创建一个新对象,使用现有的对象来提供新创建的对象的__proto__
// 模拟 Object.create

function create(proto) {
  function F() {}
  F.prototype = proto;

  return new F();
}
💬 面试官追问
const child = create(parent),child.role能读到,但Object.keys(child)是空的,复制失败了?没失败,本来就不复制。
role在原型parent上,child.hasOwnProperty('role')是false。之后给child.role赋值,会在child自己身上建一个同名属性,把原型上的遮住,parent不受影响。简化版
create(null),得到的对象有toString吗?有。
F.prototype = null时new F()的原型会被设成Object.prototype,所以toString、hasOwnProperty都在。要真正的无原型对象只能用原生Object.create(null),或者创建后Object.setPrototypeOf(obj, null)。为什么要用
Object.create(null)当字典?没有原型,就不会被
toString、constructor、__proto__这些键干扰,比如统计单词次数时遇到单词constructor也不会出错。现在更推荐直接用Map。create(42)原生会怎样,简化版呢?原生直接
TypeError,参数必须是对象或null。简化版不检查,F.prototype = 42被忽略,悄悄返回一个普通对象。补一句if (typeof proto !== 'object' && typeof proto !== 'function') throw new TypeError(...)。Object.create(B.prototype)和new B()当子类原型,差在哪?new B()会执行一遍B的构造函数,原型上会多出B初始化的实例属性,还可能有副作用;Object.create只建原型链,干净。这就是寄生组合继承用Object.create的原因。
# 22 实现Object.freeze
⚡ 30 秒速记
- 原生
Object.freeze:不能增、删、改属性,原型也不能改,但只冻一层 - 示例思路:
Object.seal禁增删 → 每个自有属性defineProperty设writable: false→ 递归,所以它其实是深冻结 - 漏洞:
for...in拿不到Symbol键和不可枚举属性;访问器属性设writable会抛错;循环引用会栈溢出 instanceof Object判断不可靠,Object.create(null)的对象会被跳过- 非严格模式下改冻结对象是静默失败,严格模式才抛
TypeError;验证用Object.isFrozen
原生 Object.freeze 让对象不能增删属性、不能改值、不能改原型,但只冻最外层,嵌套对象照样能改。 这段 myFreeze 先 seal 禁止增删,再把每个属性设成只读,还递归处理了子对象,所以它实现的其实是深冻结,比原生多做了一步。它的问题在细节:for...in 漏掉 Symbol 键,访问器属性被强行改成 writable 会直接抛错,有循环引用还会爆栈。我会用 Reflect.ownKeys 拿全部键,用 WeakSet 记已经处理过的对象。
Object.freeze冻结一个对象,让其不能再添加/删除属性,也不能修改该对象已有属性的可枚举性、可配置可写性,也不能修改已有属性的值和它的原型属性,最后返回一个和传入参数相同的对象
function myFreeze(obj){
  // 判断参数是否为Object类型,如果是就封闭对象,循环遍历对象。去掉原型属性,将其writable特性设置为false
  if(obj instanceof Object){
    Object.seal(obj);  // 封闭对象
    for(let key in obj){
      if(obj.hasOwnProperty(key)){
        Object.defineProperty(obj,key,{
          writable:false   // 设置只读
        })
        // 如果属性值依然为对象,要通过递归来进行进一步的冻结
        myFreeze(obj[key]);
      }
    }
  }
}
💬 面试官追问
冻结了
product,product.seller.name = 'X'还是改成功了,原生是这样吗?是的,原生只冻一层,
seller是另一个对象,没被冻。要深冻结就递归:Reflect.ownKeys(obj).forEach(k => typeof obj[k] === 'object' && obj[k] !== null && deepFreeze(obj[k])),再Object.freeze(obj)。对象里有
node.parent = node这种循环引用,递归冻结会怎样?无限递归,爆栈。加个
WeakSet,处理前先看seen.has(obj),有就直接返回。其实也可以用Object.isFrozen(obj)判断,已经冻过的跳过。对象有个
get total()访问器,跑myFreeze直接报错了,为什么?seal之后属性已经不可配置,再用defineProperty加writable: false等于要把访问器改成数据属性,不可配置的属性不允许这样改,抛TypeError。直接用原生Object.freeze,它会正确处理访问器,只把configurable设成false。Object.create(null)创建的字典,myFreeze为什么没冻上?它没有原型,
obj instanceof Object是false,直接被跳过了。判断改成obj !== null && (typeof obj === 'object' || typeof obj === 'function')。改了冻结对象的属性,代码没报错,是冻结失效了吗?
不一定。非严格模式下给只读属性赋值是静默失败,值其实没变;严格模式(
ES Module和class里默认就是)才会抛TypeError。用Object.isFrozen(obj)和打印值确认,别看有没有报错。
# 23 实现Object.is
⚡ 30 秒速记
Object.is和===几乎一样,只有两个例外:Object.is(NaN, NaN)是true,Object.is(+0, -0)是false- 实现:
x === y时只需区分正负零 →x !== 0 || 1 / x === 1 / y(1 / -0是-Infinity) x !== y时只需判断都是NaN→x !== x && y !== y- 对象比较的是引用,两个长得一样的对象也是
false React的useState、useMemo依赖比较用的就是Object.is
Object.is 和 === 基本一样,不做类型转换,只修了两个反直觉的地方:NaN 等于自己,+0 不等于 -0。 实现就围绕这两点:x === y 成立时,唯一要排除的是 +0 和 -0,用 1 / x 区分,正零得 Infinity,负零得 -Infinity;x === y 不成立时,唯一要放行的是两个都是 NaN,利用 NaN !== NaN 判断。日常最常碰到它的地方是 React,setState 传同一个值不重渲染,就是用 Object.is 比的。
Object.is不会转换被比较的两个值的类型,这点和===更为相似,他们之间也存在一些区别
NaN在===中是不相等的,而在Object.is中是相等的+0和-0在===中是相等的,而在Object.is中是不相等的
Object.is = function (x, y) {
  if (x === y) {
    // 当前情况下,只有一种情况是特殊的,即 +0 -0
    // 如果 x !== 0,则返回true
    // 如果 x === 0,则需要判断+0和-0,则可以直接使用 1/+0 === Infinity 和 1/-0 === -Infinity来进行判断
    return x !== 0 || 1 / x === 1 / y;
  }

  // x !== y 的情况下,只需要判断是否为NaN,如果x!==x,则说明x是NaN,同理y也一样
  // x和y同时为NaN时,返回true
  return x !== x && y !== y;
};
💬 面试官追问
有人把实现简化成
x === y || (x !== x && y !== y),对吗?漏了正负零。
+0 === -0是true,这个写法会返回true,但Object.is(+0, -0)应该是false。x === y分支里要加x !== 0 || 1 / x === 1 / y。React里setState一个新对象,字段全一样,为什么还是重渲染了?React用Object.is比较,对象比的是引用,新对象就是新引用。想避免要么别创建新对象,要么在子组件用memo自定义比较。-0在实际代码里会出现吗?会,比如
Math.round(-0.4)就是-0,-1 * 0也是。console.log有时显示成0,但Object.is(x, -0)能认出来,做坐标、方向判断时偶尔会踩到。Object.is、===、includes、indexOf判断NaN各是什么结果?Object.is(NaN, NaN)是true,NaN === NaN是false。[NaN].includes(NaN)是true(用的是SameValueZero),[NaN].indexOf(NaN)是-1(用的是===)。写
polyfill时直接Object.is = function...,有什么问题?会覆盖浏览器原生实现。先判断
if (typeof Object.is !== 'function')再装;写库的话最好导出一个独立的sameValue函数,别改全局。
# 24 实现一个compose函数
⚡ 30 秒速记
compose(f, g, h)(x)=f(g(h(x))),从右往左执行,右边函数的返回值作为左边的参数- 一行实现:
funcs.reduce((a, b) => (...args) => a(b(...args))) - 边界:没传函数返回
x => x,只传一个直接返回它 - 括号要数对:
(...args) => a(b(...args)),多一个少一个都是语法错误 - 要从左往右(
pipe):reduce改reduceRight,或者把a(b())换成b(a());Redux的applyMiddleware、Koa的洋葱模型都用到这个思路
compose 就是把多个函数串成一个,数据从右往左流:compose(f, g, h)(x) 等于 f(g(h(x)))。 实现用 reduce 一层层包:
const compose = (...fns) => fns.length === 0 ? x => x : fns.reduce((a, b) => (...args) => a(b(...args)))
只有最右边的函数能收多个参数,后面每一级只收上一级的一个返回值。还有一点,验证顺序别全用加法,1+4+3+2+1 顺序反了结果也一样是 11,要换成字符串拼接这种不满足交换律的例子。
组合多个函数,从右到左,比如:
compose(f, g, h)最终得到这个结果(...args) => f(g(h(...args))).
题目描述:实现一个 compose 函数
// 用法如下:
function fn1(x) {
  return x + 1;
}
function fn2(x) {
  return x + 2;
}
function fn3(x) {
  return x + 3;
}
function fn4(x) {
  return x + 4;
}
const a = compose(fn1, fn2, fn3, fn4);
console.log(a(1)); // 1+4+3+2+1=11
实现代码如下
function compose(...funcs) {
  if (!funcs.length) return (v) => v;

  if (funcs.length === 1) {
    return funcs[0]
  }

  return funcs.reduce((a, b) => {
    return (...args) => a(b(...args)))
  }
}
compose创建了一个从右向左执行的数据流。如果要实现从左到右的数据流,可以直接更改compose的部分代码即可实现
- 更换
Api接口:把reduce改为reduceRight - 交互包裹位置:把
a(b(...args))改为b(a(...args))
💬 面试官追问
compose(validate, normalize, readForm)执行顺序是什么?先
readForm,结果给normalize,再给validate,从右往左。团队如果习惯从左往右读,就用pipe,别让大家脑子里倒着想。拿几个加法函数测
compose,结果是11,能证明执行顺序对了吗?不能,加法顺序换了结果一样。换成
const a = s => s + 'a'、const b = s => s + 'b',compose(a, b)('')应该得到'ba',这才能看出顺序。中间有个函数返回
Promise,后面的函数收到的是Promise不是数据,怎么改?同步
compose不会等。改成异步版:fns.reduceRight((p, fn) => p.then(fn), Promise.resolve(x)),每一步then一下,整体返回Promise,调用方要await。compose()一个函数都不传,调用时传两个参数,会怎样?返回
x => x,只会把第一个参数原样返回,第二个丢了。compose本来就是单值管道,这个行为是合理的,Redux的compose也是这么写的。Redux里哪里用到了compose?applyMiddleware里用compose(...chain)(store.dispatch)把中间件一层层包到dispatch外面,最左边的中间件最先拿到action。还有compose(applyMiddleware(...), devTools)组合多个enhancer。
# 25 setTimeout与setInterval实现
⚡ 30 秒速记
- 两者可以互相模拟:递归
setTimeout模拟setInterval,setInterval跑一次就clearInterval模拟setTimeout - 定时器的时间只是「最早多久后进任务队列」,主线程忙的时候回调照样往后拖
setInterval不管回调里的异步有没有结束,到点就再触发,轮询请求可能叠在一起- 递归
setTimeout等上一次跑完才排下一次,实际间隔 = 回调耗时 + 设定时间,长时间会漂移 - 浏览器限制:嵌套超过 5 层最小
4ms,后台标签页至少1s一次,甚至更久
setTimeout 和 setInterval 能互相模拟,但面试真正想问的是:为什么大家喜欢用递归 setTimeout 代替 setInterval。 定时器只保证「到点后把回调放进任务队列」,不保证到点执行。setInterval 只管按周期触发,回调里发了个请求,下一次触发时上一个请求可能还没回来;递归 setTimeout 是等这一次跑完才安排下一次,天然不会重叠,轮询我基本都这么写。代价是间隔会加上回调本身的耗时,需要精确节拍的场景要自己用 Date.now() 校正。
💬 面试官追问
轮询接口要求「上次请求回来后再等
1s」,为什么不用setInterval?setInterval不知道请求什么时候结束,网络慢的时候会出现上一个没回来、下一个又发了,响应还可能乱序。递归setTimeout写在请求的finally里,等结束了再排下一次,这才是需求要的。setTimeout(fn, 0)是立刻执行吗?不是,最快也要等当前同步代码和所有微任务跑完,排在任务队列里等。嵌套层级超过 5 层后,浏览器还会把延迟提到至少
4ms。倒计时页面切到后台再切回来,时间对不上了,为什么?
浏览器会节流后台标签页的定时器,至少
1s才跑一次,Chrome长时间后台甚至一分钟一次。倒计时别靠累加次数算,每次用截止时间 - Date.now()重新算剩余时间。用
setInterval模拟setTimeout怎么写?const id = setInterval(() => { clearInterval(id); fn() }, t),第一次触发就清掉。先清再执行,这样fn抛错也不会留下一个一直跑的定时器。递归
setTimeout的定时器,组件卸载后还在跑,怎么回事?每一轮都会生成新的
timerId,清理时要清最新那个。用闭包或ref存最新的id,卸载时clearTimeout,再加一个stopped标记,防止正在进行的请求回来后又排了下一轮。
# 1 setTimeout 模拟实现 setInterval
⚡ 30 秒速记
- 思路:回调跑完再
setTimeout下一次 → 链式定时器,上一轮没结束下一轮不会开始 - 要点:闭包存最新的
timerId,再加一个stopped标记,防止取消后回调结束又续上一轮 setInterval只管按周期投任务,不等异步请求回来,网络慢时请求会叠在一起- 两种都不准时:延迟只是「最早什么时候能进队列」,主线程忙就得排队
- 易错:回调抛错会断链,用
try...finally保证续期;后台标签页里定时器会被节流到1s甚至更久
用 setTimeout 模拟 setInterval,就是让回调执行完之后再安排下一次,链式往下走。 好处是间隔从「上一轮做完」开始算,轮询接口时不会出现上一个请求还没回来、下一个又发出去的情况,setInterval 是不管你做没做完的。写的时候要注意两点:闭包里存的是最新那个 timerId,取消时清它;再加一个 stopped 标记,不然回调正在跑的时候点了取消,跑完又续上一轮。还有一点要说清楚,两种写法都保证不了准时,延迟只代表最早什么时候进任务队列。
题目描述: setInterval 用来实现循环定时调用 可能会存在一定的问题 能用 setTimeout 解决吗
实现代码如下:
function mySetInterval(fn, t) {
  let timerId = null;
  function interval() {
    fn();
    timerId = setTimeout(interval, t); // 递归调用
  }
  timerId = setTimeout(interval, t); // 首次调用
  return {
    // 利用闭包的特性 保存timerId
    cancel:() => {
      clearTimeout(timerId)
    }
  }
}
// 测试
var a = mySetInterval(()=>{
  console.log(111);
},1000)
var b = mySetInterval(() => {
  console.log(222)
}, 1000)

// 终止定时器
a.cancel()
b.cancel()
为什么要用
setTimeout模拟实现setInterval?setInterval的缺陷是什么?
setInterval(fn(), N);
上面这句代码的意思其实是
fn()将会在N秒之后被推入任务队列。在setInterval被推入任务队列时,如果在它前面有很多任务或者某个任务等待时间较长比如网络请求等,那么这个定时器的执行时间和我们预定它执行的时间可能并不一致
// 最常见的出现的就是,当我们需要使用 ajax 轮询服务器是否有新数据时,必定会有一些人会使用 setInterval,然而无论网络状况如何,它都会去一遍又一遍的发送请求,最后的间隔时间可能和原定的时间有很大的出入

// 做一个网络轮询,每一秒查询一次数据。
let startTime = new Date().getTime();
let count = 0;

setInterval(() => {
    let i = 0;
    while (i++ < 10000000); // 假设的网络延迟
    count++;
    console.log(
        "与原设定的间隔时差了:",
        new Date().getTime() - (startTime + count * 1000),
        "毫秒"
    );
}, 1000)

// 输出:
// 与原设定的间隔时差了: 567 毫秒
// 与原设定的间隔时差了: 552 毫秒
// 与原设定的间隔时差了: 563 毫秒
// 与原设定的间隔时差了: 554 毫秒(2次)
// 与原设定的间隔时差了: 564 毫秒
// 与原设定的间隔时差了: 602 毫秒
// 与原设定的间隔时差了: 573 毫秒
// 与原设定的间隔时差了: 633 毫秒
再次强调,定时器指定的时间间隔,表示的是何时将定时器的代码添加到消息队列,而不是何时执行代码。所以真正何时执行代码的时间是不能保证的,取决于何时被主线程的事件循环取到,并执行。
setInterval(function, N)
//即:每隔N秒把function事件推到消息队列中
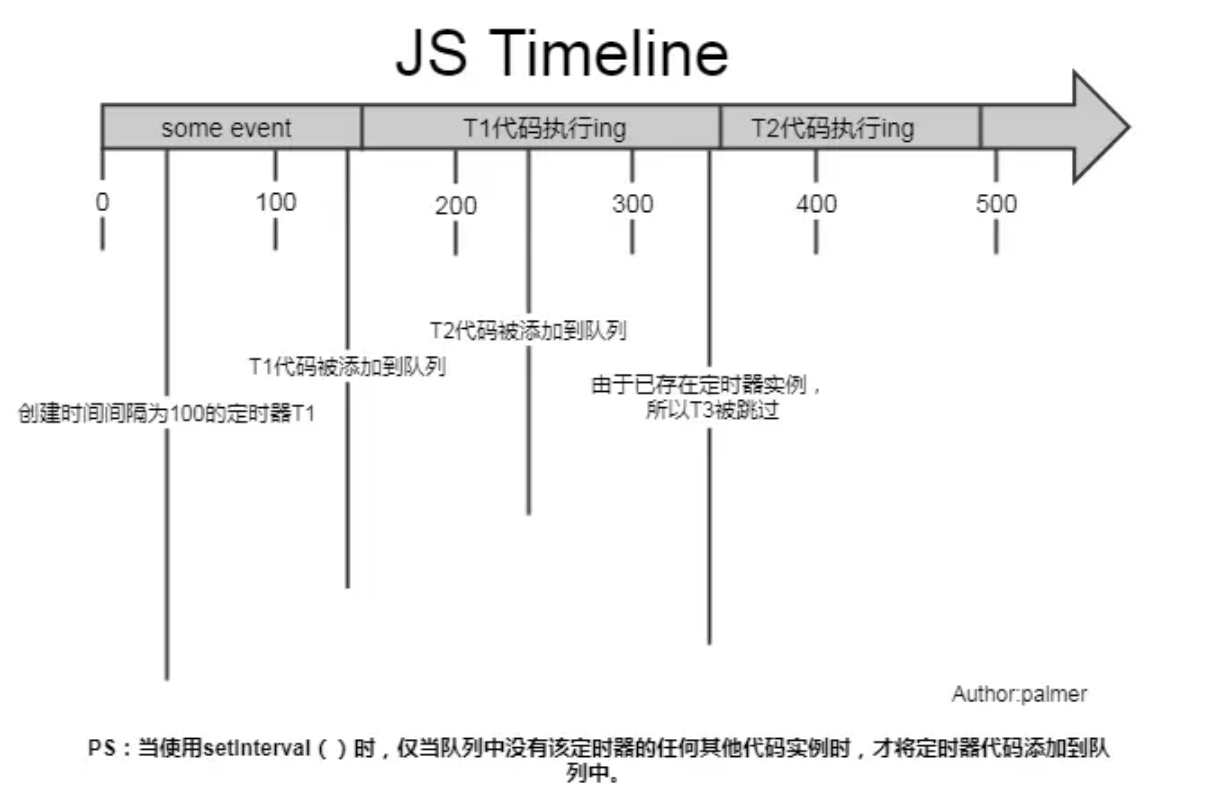
上图可见,
setInterval每隔100ms往队列中添加一个事件;100ms后,添加T1定时器代码至队列中,主线程中还有任务在执行,所以等待,some event执行结束后执行T1定时器代码;又过了100ms,T2定时器被添加到队列中,主线程还在执行T1代码,所以等待;又过了100ms,理论上又要往队列里推一个定时器代码,但由于此时T2还在队列中,所以T3不会被添加(T3被跳过),结果就是此时被跳过;这里我们可以看到,T1定时器执行结束后马上执行了 T2 代码,所以并没有达到定时器的效果
setInterval有两个缺点
- 使用
setInterval时,某些间隔会被跳过 - 可能多个定时器会连续执行
可以这么理解:每个
setTimeout产生的任务会直接push到任务队列中;而setInterval在每次把任务push到任务队列前,都要进行一下判断(看上次的任务是否仍在队列中)。因而我们一般用setTimeout模拟setInterval,来规避掉上面的缺点
💬 面试官追问
轮询接口要求「上次请求回来后再等
1s」,用setInterval有什么问题?setInterval不知道你的请求什么时候回来,接口一慢就会同时挂着好几个请求,返回顺序还可能乱。改成请求的finally里再setTimeout(poll, 1000),天然就是串行的。回调执行中途点了「停止」,结果过一会儿又开始跑了,为什么?
clearTimeout清的是当时存的那个timerId,可正在跑的回调结束时又setTimeout了一个新的。加一个let stopped = false,cancel()里置true,回调结尾续期前判断if (!stopped)。回调第三次抛了异常,之后再也没请求了,怎么回事?
fn()抛错,后面那行setTimeout根本没执行,链就断了。用try { fn() } finally { if (!stopped) timerId = setTimeout(interval, t) },异常照常上报,但调度不受影响;失败多了最好再加退避,别对着挂掉的接口一直打。后端要求失败后间隔逐步拉长,成功后恢复
1s,怎么改?这正是链式
setTimeout比setInterval好用的地方,每轮可以算一个新延迟:失败时delay = Math.min(delay * 2, 30000),成功时重置成1000,再setTimeout(poll, delay)。用户把页面切到后台,十分钟后回来发现轮询几乎停了,正常吗?
正常。浏览器会把后台标签页的定时器节流到至少
1s一次,Chrome对隐藏较久的页面还会进一步合并到大约一分钟一次。真要实时就监听visibilitychange,回到前台时立刻补拉一次。
# 2 setInterval 模拟实现 setTimeout
⚡ 30 秒速记
- 思路:开一个
setInterval,第一次触发时立刻clearInterval,再执行fn→ 只跑一次 - 先清再调:
fn抛错也不会被第二次触发 - 要把句柄交出去:
return timer或一个cancel(),不然外面没法提前取消 - 参数透传:
mySetTimeout(fn, t, ...args)里调fn(...args) - 这是练闭包和定时器的题,生产代码直接用
setTimeout
用 setInterval 模拟 setTimeout,就是让循环定时器第一次触发时把自己清掉,然后执行回调。 关键是顺序,回调里先 clearInterval(timer) 再调 fn(),这样就算 fn 抛错,定时器也已经停了,不会再触发第二次。另外要把 timer 返回出去,不然组件卸载时想取消都没办法,我会返回 timer 或者一个带 cancel 的对象。说白了这是道考闭包的练习题,真写业务没人这么绕。
function mySetTimeout(fn, t = 0, ...args) {
  if (typeof fn !== 'function') throw new TypeError('fn must be a function')
  const timer = setInterval(() => {
    clearInterval(timer) // 先清:fn 抛错也不会再触发
    fn(...args)
  }, t)
  return timer // 交给调用方,用 clearInterval(timer) 提前取消
}

const id = mySetTimeout((name) => console.log('hi', name), 500, 'Tom')
// 500ms 后输出:hi Tom
// clearInterval(id) // 在触发前调用则什么都不输出
除了「先清再调」,能当工具函数用还要做到三点:参数透传、返回句柄、入参校验。浏览器里 setTimeout 和 setInterval 共用同一个 id 池,所以返回的 timer 其实用 clearTimeout 也能清掉,但为了可读性,还是配对用 clearInterval。
💬 面试官追问
路由切换时想取消这个延时任务,但函数没返回值,会出什么事?
拿不到
timer就清不掉,回调会在页面销毁后照样执行,去改一个已经卸载的组件状态。补一句return timer,或者返回{ cancel: () => clearInterval(timer) },卸载时调一下。如果把
clearInterval挪到fn()后面,有什么区别?fn一抛错,clearInterval就执行不到了,下一个周期还会再触发,变成每隔t报一次错。先清再调,保证不管成功失败都只跑一次。延迟传
0,后面的代码马上读回调里设置的值,为什么读不到?延迟是
0也是异步,回调要等当前同步代码全部执行完、再轮到这个任务才会跑。mySetTimeout(() => x = 1, 0); console.log(x)打印的还是旧值,依赖同步结果就别套定时器。业务要给回调传
userId和pageNo,只收fn和t的签名够吗?不够。改成
(fn, t, ...args) => { const timer = setInterval(() => { clearInterval(timer); fn(...args) }, t); return timer },这样才和原生setTimeout的用法对齐。
// 测试
// mySetTimeout(()=>{
//   console.log(1);
// },1000)
💬 面试官追问
调用
mySetTimeout(fn, 1000)后主线程卡了3s,它会在第1s执行吗?不会。延迟只保证至少等
1s,到点了回调进队列,主线程被占着就只能排队,实际是卡完之后才执行。换成setInterval模拟也绕不过事件循环。搜索联想组件卸载时要取消延迟请求,你怎么补调用约定?
返回
timer,组件卸载时clearInterval(timer)。用React就写在useEffect的清理函数里,Vue写在onUnmounted里。有人把
fn传成了字符串,或者漏传了,封装层要不要管?要管。原生
setTimeout收字符串会当代码eval,这个行为本来就不该学,手写版直接if (typeof fn !== 'function') throw new TypeError(...),早点报错比静默不执行强。线上发现回调偶尔执行了两次,先查哪里?
单个实例先清后调,正常只会跑一次,所以先怀疑被调了两次:组件重复挂载、
React严格模式下effect跑两遍没清理、热更新留下了旧实例。给创建和触发都打上日志,对一下次数就清楚了。生产代码里有人坚持用这个
setInterval版本,你接受吗?不接受。原生
setTimeout语义就是「延迟执行一次」,取消、传参都现成,绕一层setInterval只会让看代码的人多想一步。面试写这个是为了看你懂不懂清除时机,不是推荐这么用。
# 26 实现Node的require方法
⚡ 30 秒速记
- 流程:解析路径 → 查缓存 → 新建
module并先放进缓存 → 读文件 → 包一层函数 → 执行 → 返回module.exports - 包装函数:
(function (exports, require, module, __filename, __dirname) { ... }),模块的「全局变量」都是这里传进来的参数 - 缓存键是解析后的绝对路径,同一文件只执行一次;
delete require.cache[key]可以强制重载 - 相对路径以当前模块所在目录为基准;裸模块名沿父目录逐层找
node_modules,后缀按.js→.json→.node补 - 循环依赖拿到的是对方「执行到一半」的
exports,所以缓存一定要在执行前写入
require 说白了就是:找到文件、包一层函数执行、把 module.exports 缓存起来返回。 路径先按调用方所在目录解析成绝对路径,这个路径同时是缓存键。读出来的源码会被包进一个带 exports、require、module、__filename、__dirname 五个参数的函数里,交给 vm.runInThisContext 编译执行,这就是为什么每个文件能直接用这几个变量、而且变量不会互相污染。有个细节很多人写错:缓存要在执行模块代码之前写入,不然 a、b 互相引用会无限递归,Node 自己就是先缓存再执行的,所以循环依赖时会拿到一个没导出完的半成品。
require 基本原理
require 查找路径
require和module.exports干的事情并不复杂,我们先假设有一个全局对象{},初始情况下是空的,当你require某个文件时,就将这个文件拿出来执行,如果这个文件里面存在module.exports,当运行到这行代码时将module.exports的值加入这个对象,键为对应的文件名,最终这个对象就长这样:
{
  "a.js": "hello world",
  "b.js": function add(){},
  "c.js": 2,
  "d.js": { num: 2 }
}
当你再次
require某个文件时,如果这个对象里面有对应的值,就直接返回给你,如果没有就重复前面的步骤,执行目标文件,然后将它的module.exports加入这个全局对象,并返回给调用者。这个全局对象其实就是我们经常听说的缓存。所以require和module.exports并没有什么黑魔法,就只是运行并获取目标文件的值,然后加入缓存,用的时候拿出来用就行
手写实现一个require
const path = require('path'); // 路径操作
const fs = require('fs'); // 文件读取
const vm = require('vm'); // 文件执行

// node模块化的实现
// node中是自带模块化机制的,每个文件就是一个单独的模块,并且它遵循的是CommonJS规范,也就是使用require的方式导入模块,通过module.export的方式导出模块。
// node模块的运行机制也很简单,其实就是在每一个模块外层包裹了一层函数,有了函数的包裹就可以实现代码间的作用域隔离

// require加载模块
// require依赖node中的fs模块来加载模块文件,fs.readFile读取到的是一个字符串。
// 在javascrpt中我们可以通过eval或者new Function的方式来将一个字符串转换成js代码来运行。

// eval
// const name = 'poetry';
// const str = 'const a = 123; console.log(name)';
// eval(str); // poetry;

// new Function
// new Function接收的是一个要执行的字符串,返回的是一个新的函数,调用这个新的函数字符串就会执行了。如果这个函数需要传递参数,可以在new Function的时候依次传入参数,最后传入的是要执行的字符串。比如这里传入参数b,要执行的字符串str
// const b = 3;
// const str = 'let a = 1; return a + b';
// const fun = new Function('b', str);
// console.log(fun(b, str)); // 4
// 可以看到eval和Function实例化都可以用来执行javascript字符串,似乎他们都可以来实现require模块加载。不过在node中并没有选用他们来实现模块化,原因也很简单因为他们都有一个致命的问题,就是都容易被不属于他们的变量所影响。
// 如下str字符串中并没有定义a,但是确可以使用上面定义的a变量,这显然是不对的,在模块化机制中,str字符串应该具有自身独立的运行空间,自身不存在的变量是不可以直接使用的
// const a = 1;
// const str = 'console.log(a)';
// eval(str);
// const func = new Function(str);
// func();

// node存在一个vm虚拟环境的概念,用来运行额外的js文件,他可以保证javascript执行的独立性,不会被外部所影响
// vm 内置模块
// 虽然我们在外部定义了hello,但是str是一个独立的模块,并不在村hello变量,所以会直接报错。
// 引入vm模块, 不需要安装,node 自建模块
// const vm = require('vm');
// const hello = 'poetry';
// const str = 'console.log(hello)';
// wm.runInThisContext(str); // 报错
// 所以node执行javascript模块时可以采用vm来实现。就可以保证模块的独立性了

// 分析实现步骤
// 1.导入相关模块,创建一个Require方法。
// 2.抽离通过Module._load方法,用于加载模块。
// 3.Module.resolveFilename 根据相对路径,转换成绝对路径。
// 4.缓存模块 Module._cache,同一个模块不要重复加载,提升性能。
// 5.创建模块 id: 保存的内容是 exports = {}相当于this。
// 6.利用tryModuleLoad(module, filename) 尝试加载模块。
// 7.Module._extensions使用读取文件。
// 8.Module.wrap: 把读取到的js包裹一个函数。
// 9.将拿到的字符串使用runInThisContext运行字符串。
// 10.让字符串执行并将this改编成exports

// 定义导入类,参数为模块路径
function Require(modulePath) {
    // 获取当前要加载的绝对路径
    let absPathname = path.resolve(__dirname, modulePath);

    // 自动给模块添加后缀名,实现省略后缀名加载模块,其实也就是如果文件没有后缀名的时候遍历一下所有的后缀名看一下文件是否存在
    // 获取所有后缀名
    const extNames = Object.keys(Module._extensions);
    let index = 0;
    // 存储原始文件路径
    const oldPath = absPathname;
    function findExt(absPathname) {
        if (index === extNames.length) {
            throw new Error('文件不存在');
        }
        try {
            fs.accessSync(absPathname);
            return absPathname;
        } catch(e) {
            const ext = extNames[index++];
            findExt(oldPath + ext);
        }
    }
    // 递归追加后缀名,判断文件是否存在
    absPathname = findExt(absPathname);

    // 从缓存中读取,如果存在,直接返回结果
    if (Module._cache[absPathname]) {
        return Module._cache[absPathname].exports;
    }

    // 创建模块,新建Module实例
    const module = new Module(absPathname);

    // 添加缓存
    Module._cache[absPathname] = module;

    // 加载当前模块
    tryModuleLoad(module);

    // 返回exports对象
    return module.exports;
}

// Module的实现很简单,就是给模块创建一个exports对象,tryModuleLoad执行的时候将内容加入到exports中,id就是模块的绝对路径
// 定义模块, 添加文件id标识和exports属性
function Module(id) {
    this.id = id;
    // 读取到的文件内容会放在exports中
    this.exports = {};
}

Module._cache = {};

// 我们给Module挂载静态属性wrapper,里面定义一下这个函数的字符串,wrapper是一个数组,数组的第一个元素就是函数的参数部分,其中有exports,module. Require,__dirname, __filename, 都是我们模块中常用的全局变量。注意这里传入的Require参数是我们自己定义的Require
// 第二个参数就是函数的结束部分。两部分都是字符串,使用的时候我们将他们包裹在模块的字符串外部就可以了
Module.wrapper = [
    "(function(exports, module, Require, __dirname, __filename) {",
    "})"
]

// _extensions用于针对不同的模块扩展名使用不同的加载方式,比如JSON和javascript加载方式肯定是不同的。JSON使用JSON.parse来运行。
// javascript使用vm.runInThisContext来运行,可以看到fs.readFileSync传入的是module.id也就是我们Module定义时候id存储的是模块的绝对路径,读取到的content是一个字符串,我们使用Module.wrapper来包裹一下就相当于在这个模块外部又包裹了一个函数,也就实现了私有作用域。
// 使用call来执行fn函数,第一个参数改变运行的this我们传入module.exports,后面的参数就是函数外面包裹参数exports, module, Require, __dirname, __filename
Module._extensions = {
    '.js'(module) {
        const content = fs.readFileSync(module.id, 'utf8');
        const fnStr = Module.wrapper[0] + content + Module.wrapper[1];
        const fn = vm.runInThisContext(fnStr);
        fn.call(module.exports, module.exports, module, Require,__filename,__dirname);
    },
    '.json'(module) {
        const json = fs.readFileSync(module.id, 'utf8');
        module.exports = JSON.parse(json); // 把文件的结果放在exports属性上
    }
}

// tryModuleLoad函数接收的是模块对象,通过path.extname来获取模块的后缀名,然后使用Module._extensions来加载模块
// 定义模块加载方法
function tryModuleLoad(module) {
    // 获取扩展名
    const extension = path.extname(module.id);
    // 通过后缀加载当前模块
    Module._extensions[extension](module);
}

// 至此Require加载机制我们基本就写完了,我们来重新看一下。Require加载模块的时候传入模块名称,在Require方法中使用path.resolve(__dirname, modulePath)获取到文件的绝对路径。然后通过new Module实例化的方式创建module对象,将模块的绝对路径存储在module的id属性中,在module中创建exports属性为一个json对象
// 使用tryModuleLoad方法去加载模块,tryModuleLoad中使用path.extname获取到文件的扩展名,然后根据扩展名来执行对应的模块加载机制
// 最终将加载到的模块挂载module.exports中。tryModuleLoad执行完毕之后module.exports已经存在了,直接返回就可以了


// 给模块添加缓存
// 添加缓存也比较简单,就是文件加载的时候将文件放入缓存中,再去加载模块时先看缓存中是否存在,如果存在直接使用,如果不存在再去重新,加载之后再放入缓存

// 测试
let json = Require('./test.json');
let test2 = Require('./test2.js');
console.log(json);
console.log(test2);
💬 面试官追问
a.js和b.js互相require,你的加载器执行完才写缓存,会怎样?a加载b,b又去加载a,缓存里没有就再执行一遍a,最后栈溢出。改成创建module后马上Module._cache[filename] = module,再执行代码,这样第二次请求直接拿到当前的exports,只是里面的字段可能还没赋完。为什么模块里写了
exports = { a: 1 },别人require进来是空对象?exports只是module.exports的一个引用参数,给它重新赋值只是改了局部变量的指向,最后返回的还是module.exports。要么exports.a = 1,要么module.exports = { a: 1 }。改了配置文件,不重启进程想让它生效,怎么办?
delete require.cache[require.resolve('./config')]再重新require。但已经拿到旧对象引用的模块不会自动更新,所以这招只适合开发期热重载,线上配置更新还是走专门的配置中心或重启。为什么用
vm.runInThisContext而不是eval?eval能读到加载器函数里的局部变量,模块代码会和加载器混在一起;vm.runInThisContext只在全局作用域里编译,再配合外层包装函数,作用域就干净了。但它不是沙箱,跑不可信代码照样能访问process。现在
Node项目都在用ESM了,require还能加载ESM模块吗?以前不行,会报
ERR_REQUIRE_ESM。Node 22.12和20.19起默认支持同步require一个ESM模块,前提是它没有顶层await;更老的版本只能用动态import()。
# 27 实现LRU淘汰算法
⚡ 30 秒速记
LRU= 最近最少使用:满了就淘汰最久没被碰过的那个- 读和写都算「使用」,都要把这个键挪到「最新」那一端
JS简版:Map保留插入顺序,命中就delete再set挪到队尾,淘汰取map.keys().next().value(队头最旧)- 面试官要底层结构就写哈希表 + 双向链表,
get/put都是O(1) - 落地场景:
Vue的keep-alive配max、接口结果缓存、图片缓存
LRU 就是容量满了淘汰最久没被访问的那条,JS 里用 Map 最省事。 因为 Map 记得插入顺序,我每次 get 命中或者 set 已有的键,都先 delete 再 set,它就被挪到最后,表示最新;超容量时用 keys().next().value 拿到第一个,也就是最旧的,删掉就行。这样读写都是 O(1)。如果面试官说别依赖 Map 的顺序,那就写经典的哈希表加双向链表:哈希表负责找节点,链表负责维护新旧顺序,头部放最新、尾部淘汰。
LRU 缓存算法是一个非常经典的算法,在很多面试中经常问道,不仅仅包括前端面试
LRU英文全称是Least Recently Used,英译过来就是”最近最少使用“的意思。LRU是一种常用的页面置换算法,选择最近最久未使用的页面予以淘汰。该算法赋予每个页面一个访问字段,用来记录一个页面自上次被访问以来所经历的时间t,当须淘汰一个页面时,选择现有页面中其t值最大的,即最近最少使用的页面予以淘汰
通俗的解释:
假如我们有一块内存,专门用来缓存我们最近发访问的网页,访问一个新网页,我们就会往内存中添加一个网页地址,随着网页的不断增加,内存存满了,这个时候我们就需要考虑删除一些网页了。这个时候我们找到内存中最早访问的那个网页地址,然后把它删掉。这一整个过程就可以称之为
LRU算法
上图就很好的解释了 LRU 算法在干嘛了,其实非常简单,无非就是我们往内存里面添加或者删除元素的时候,遵循最近最少使用原则
使用场景
LRU 算法使用的场景非常多,这里简单举几个例子即可:
- 我们操作系统底层的内存管理,其中就包括有
LRU算法 - 我们常见的缓存服务,比如
redis等等 - 比如浏览器的最近浏览记录存储
vue中的keep-alive组件使用了LRU算法
梳理实现 LRU 思路
- 特点分析:
- 我们需要一块有限的存储空间,因为无限的化就没必要使用
LRU算发删除数据了。 - 我们这块存储空间里面存储的数据需要是有序的,因为我们必须要顺序来删除数据,所以可以考虑使用
Array、Map数据结构来存储,不能使用Object,因为它是无序的。 - 我们能够删除或者添加以及获取到这块存储空间中的指定数据。
- 存储空间存满之后,在添加数据时,会自动删除时间最久远的那条数据。
- 我们需要一块有限的存储空间,因为无限的化就没必要使用
- 实现需求:
- 实现一个
LRUCache类型,用来充当存储空间 - 采用
Map数据结构存储数据,因为它的存取时间复杂度为O(1),数组为O(n) - 实现
get和set方法,用来获取和添加数据 - 我们的存储空间有长度限制,所以无需提供删除方法,存储满之后,自动删除最久远的那条数据
- 当使用
get获取数据后,该条数据需要更新到最前面
- 实现一个
具体实现
class LRUCache {
  constructor(length) {
    this.length = length; // 存储长度
    this.data = new Map(); // 存储数据
  }
  // 存储数据,通过键值对的方式
  set(key, value) {
    const data = this.data;

    // 有的话 删除 重建放到map最前面
    if (data.has(key)) {
      data.delete(key)
    }

    data.set(key, value);

    // 如果超出了容量,则需要删除最久的数据
    if (data.size > this.length) {
      // 删除map最老的数据
      const delKey = data.keys().next().value;
      data.delete(delKey);
    }
  }
  // 获取数据
  get(key) {
    const data = this.data;
    // 未找到
    if (!data.has(key)) {
      return null;
    }
    const value = data.get(key); // 获取元素
    data.delete(key); // 删除元素
    data.set(key, value); // 重新插入元素到map最前面

    return value // 返回获取的值
  }
}
var lruCache = new LRUCache(5);
set 方法:往map里面添加新数据,如果添加的数据存在了,则先删除该条数据,然后再添加。如果添加数据后超长了,则需要删除最久远的一条数据。data.keys().next().value便是获取最后一条数据的意思。get 方法:首先从map对象中拿出该条数据,然后删除该条数据,最后再重新插入该条数据,确保将该条数据移动到最前面
// 测试

// 存储数据 set:

lruCache.set('name', 'test');
lruCache.set('age', 10);
lruCache.set('sex', '男');
lruCache.set('height', 180);
lruCache.set('weight', '120');
console.log(lruCache);
继续插入数据,此时会超长,代码如下:
lruCache.set('grade', '100');
console.log(lruCache);
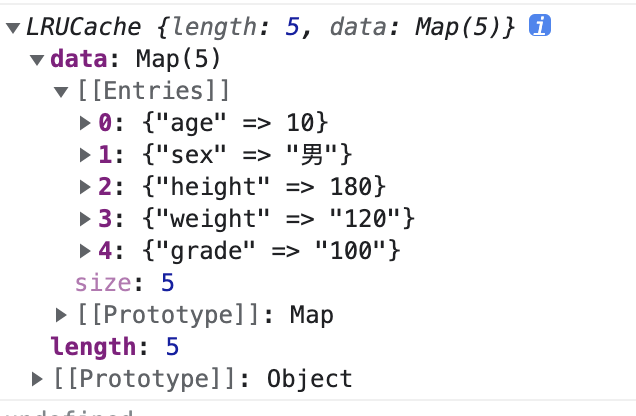
此时我们发现存储时间最久的 name 已经被移除了,新插入的数据变为了最前面的一个。
我们使用 get 获取数据,代码如下:
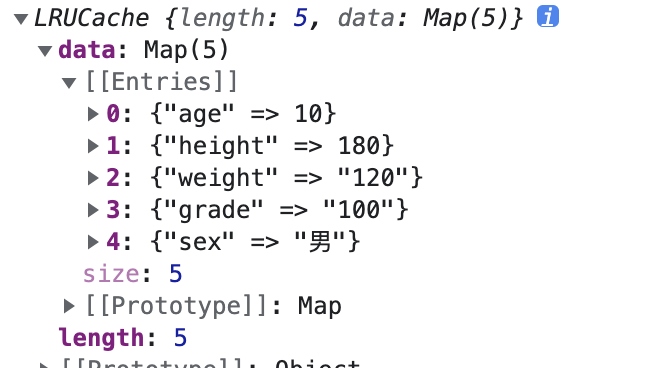
我们发现此时 sex 字段已经跑到最前面去了
总结
LRU算法其实逻辑非常的简单,明白了原理之后实现起来非常的简单。最主要的是我们需要使用什么数据结构来存储数据,因为map的存取非常快,所以我们采用了它,当然数组其实也可以实现的。还有一些小伙伴使用链表来实现LRU,这当然也是可以的。
💬 面试官追问
容量
2,set a、set b、get a、set c,淘汰的是谁?淘汰
b。get a让a变成最新的,此时顺序是b, a,再加c超容量,删队头的b。很多人答a,是忘了读也算使用。缓存的值本身可能就是
null,调用方用get(key) === null判断没命中,有什么坑?分不清「没缓存」和「缓存的就是
null」,有效缓存会被当成没命中,重复请求。我会让未命中返回undefined,或者干脆提供has(key),调用方先has再get。为什么不用数组记录访问顺序?
数组每次命中都要
indexOf找位置再splice挪动,都是O(n),缓存一大就慢。Map删除再插入是常数时间,链表移动节点也只是改几个指针。不让用
Map的顺序特性,你的双向链表怎么设计?放两个哨兵节点
head和tail,省掉边界判断;哈希表存key → node。命中就把节点摘下来插到head后面,超容量删tail.prev,同时删哈希表里的键,两边一定要同步删。线上热点数据还是被淘汰了,你怎么查?
先看是不是多个缓存实例,每个页面
new了一个自己的;再看读的时候是不是绕过了get,直接访问内部map;还有键类型不一致,'1'和1在Map里是两个键。
# 28 框架相关
# 1 将虚拟 Dom 转化为真实 Dom
⚡ 30 秒速记
- 递归三步:建节点 → 设属性 → 递归挂子节点
- 数字转字符串,字符串用
document.createTextNode;对象用document.createElement(vnode.tag) attrs用setAttribute只适合静态属性;value/checked要设DOM属性,onClick要addEventListener- 健壮性:
children可能缺省,null/false要跳过(对应JSX里的条件渲染) - 这只是首次渲染;后续更新靠
diff+patch,不是每次重建整棵树
虚拟 DOM 转真实 DOM 就是一个递归:根据 tag 建元素,把 attrs 设上,再把每个子节点递归渲染完挂进去。 文本节点单独处理,数字先转字符串,再 createTextNode。这个思路跑示例够了,但真写框架有几个地方要处理:children 没传就直接 forEach 会报错;null、false 这种条件渲染出来的值要跳过;value、checked 用 setAttribute 只改初始值,用户输入后就不同步了,要直接 dom.value = x;事件也不能当属性设,要 addEventListener。
{
  tag: 'DIV',
  attrs:{
  id:'app'
  },
  children: [
    {
      tag: 'SPAN',
      children: [
        { tag: 'A', children: [] }
      ]
    },
    {
      tag: 'SPAN',
      children: [
        { tag: 'A', children: [] },
        { tag: 'A', children: [] }
      ]
    }
  ]
}

把上面虚拟Dom转化成下方真实Dom

<div id="app">
  <span>
    <a></a>
  </span>
  <span>
    <a></a>
    <a></a>
  </span>
</div>
实现
// 真正的渲染函数
function _render(vnode) {
  // 如果是数字类型转化为字符串
  if (typeof vnode === "number") {
    vnode = String(vnode);
  }
  // 字符串类型直接就是文本节点
  if (typeof vnode === "string") {
    return document.createTextNode(vnode);
  }
  // 普通DOM
  const dom = document.createElement(vnode.tag);
  if (vnode.attrs) {
    // 遍历属性
    Object.keys(vnode.attrs).forEach((key) => {
      const value = vnode.attrs[key];
      dom.setAttribute(key, value);
    });
  }
  // 子数组进行递归操作
  vnode.children.forEach((child) => dom.appendChild(_render(child)));
  return dom;
}
💬 面试官追问
children里有null或者false,代码直接崩了,怎么处理?这些是
{show && <Child />}这种条件渲染的产物,应该什么都不渲染。递归入口加一句if (vnode == null || typeof vnode === 'boolean') return document.createComment('')或者在父级forEach时直接跳过。表单
attrs里传了value: 'abc',用户输入后再更新value,输入框没变,为什么?setAttribute('value', ...)改的是HTML特性,只决定默认值;输入框当前显示的是DOM属性el.value。表单状态类的要走属性赋值:el.value = 'abc'、el.checked = true。attrs里传了onClick: handler,点击没反应,怎么改?setAttribute('onclick', fn)会把函数转成字符串,根本不是你要的东西。约定以on开头的键走el.addEventListener(key.slice(2).toLowerCase(), handler),class和style也各自单独处理。评论树嵌套很深,递归报调用栈溢出,怎么办?
改成显式栈迭代,栈里存
[vnode, parentDom]对,一个个弹出来建节点再压子节点。真到这种深度一般先怀疑数据有问题,正常页面嵌套不会几千层。数据只改了一条文本,能不能直接再调一次
_render把整棵树换掉?小片段可以,大页面不行:整棵重建会丢掉输入框焦点、滚动位置和第三方组件状态,性能也差。这就是框架要做新旧虚拟树对比、只补变化部分的原因,列表还要靠
key找到对应节点。
# 2 实现事件总线结合Vue应用
⚡ 30 秒速记
- 事件总线 = 一个全局的发布订阅中心,组件之间不直接引用,都只跟它打交道
- 结构:
{ 事件名: [回调...] };on推入、emit遍历调用、off按函数引用删除、once包一层执行后自删 emit时先复制一份监听数组再遍历,回调里off自己才不会跳过别人- 版本差异:
Vue 2可以new Vue()当总线;Vue 3删了$on/$off/$once,要用mitt或自己写 - 坑:组件卸载不
off会重复触发、内存泄漏;事件一多数据流就看不清了
事件总线就是一个全局的发布订阅中心,A 组件 emit,B 组件 on,两边互不认识。 手写的话用一个对象按事件名存回调数组,on 往里推,emit 拿出来挨个调,off 按函数引用过滤掉,once 包一层,执行时先把自己删掉。在 Vue 2 里常见写法是 new Vue() 当总线,但 Vue 3 把实例上的 $on、$off 都删了,官方推荐用 mitt 这类小库。我用总线最在意的是解绑,组件销毁时一定要 off,不然来回进几次页面,一次 emit 能触发好几遍。
Event Bus(Vue、Flutter 等前端框架中有出镜)和Event Emitter(Node中有出镜)出场的“剧组”不同,但是它们都对应一个共同的角色——全局事件总线。
全局事件总线,严格来说不能说是观察者模式,而是发布-订阅模式。它在我们日常的业务开发中应用非常广。
如果只能选一道题,那这道题一定是
Event Bus/Event Emitter的代码实现——我都说这么清楚了,这个知识点到底要不要掌握、需要掌握到什么程度,就看各位自己的了。
在Vue中使用Event Bus来实现组件间的通讯
Event Bus/Event Emitter作为全局事件总线,它起到的是一个沟通桥梁的作用。我们可以把它理解为一个事件中心,我们所有事件的订阅/发布都不能由订阅方和发布方“私下沟通”,必须要委托这个事件中心帮我们实现。
在Vue中,有时候 A 组件和 B 组件中间隔了很远,看似没什么关系,但我们希望它们之间能够通信。这种情况下除了求助于 Vuex 之外,我们还可以通过 Event Bus 来实现我们的需求。
创建一个 Event Bus(本质上也是 Vue 实例)并导出:
const EventBus = new Vue()
export default EventBus
在主文件里引入EventBus,并挂载到全局:
import bus from 'EventBus的文件路径'
Vue.prototype.bus = bus
订阅事件:
// 这里func指someEvent这个事件的监听函数
this.bus.$on('someEvent', func)
发布(触发)事件:
// 这里params指someEvent这个事件被触发时回调函数接收的入参
this.bus.$emit('someEvent', params)
大家会发现,整个调用过程中,没有出现具体的发布者和订阅者(比如上面的
PrdPublisher和DeveloperObserver),全程只有bus这个东西一个人在疯狂刷存在感。这就是全局事件总线的特点——所有事件的发布/订阅操作,必须经由事件中心,禁止一切“私下交易”!
实现方式1
class EventEmitter {
  constructor() {
    // handlers是一个map,用于存储事件与回调之间的对应关系
    this.handlers = {}
  }

  // on方法用于安装事件监听器,它接受目标事件名和回调函数作为参数
  on(eventName, cb) {
    // 先检查一下目标事件名有没有对应的监听函数队列
    if (!this.handlers[eventName]) {
      // 如果没有,那么首先初始化一个监听函数队列
      this.handlers[eventName] = []
    }

    // 把回调函数推入目标事件的监听函数队列里去
    this.handlers[eventName].push(cb)
  }

  // emit方法用于触发目标事件,它接受事件名和监听函数入参作为参数
  emit(eventName, ...args) {
    // 检查目标事件是否有监听函数队列
    if (this.handlers[eventName]) {
      // 如果有,则逐个调用队列里的回调函数
      this.handlers[eventName].forEach((callback) => {
        callback(...args)
      })
    }
  }

  // 移除某个事件回调队列里的指定回调函数
  off(eventName, cb) {
    const callbacks = this.handlers[eventName]
    const index = callbacks.indexOf(cb)
    if (index !== -1) {
      callbacks.splice(index, 1)
    }
  }

  // 为事件注册单次监听器
  once(eventName, cb) {
    // 对回调函数进行包装,使其执行完毕自动被移除
    const wrapper = (...args) => {
      cb.apply(...args)
      this.off(eventName, wrapper)
    }
    this.on(eventName, wrapper)
  }
}
实现方式2
- 分析
on和once注册函数,存储起来emit时找到对应的函数,执行off找到对应函数,从存储中删除
- 注意
on绑定的事件可以连续执行,除非offonce绑定的函数emit一次即删除,也可以未执行而被off
class EventBus {
    /**
     * {
     *    'key1': [
     *        { fn: fn1, isOnce: false },
     *        { fn: fn2, isOnce: false },
     *        { fn: fn3, isOnce: true },
     *    ]
     *    'key2': [] // 有序
     *    'key3': []
     * }
     */
    constructor() {
        this.events = {}
    }

    on(type, fn, isOnce = false) {
        const events = this.events
        if (events[type] == null) {
            events[type] = [] // 初始化 key 的 fn 数组
        }
        events[type].push({ fn, isOnce })
    }

    once(type, fn) {
        this.on(type, fn, true)
    }

    off(type, fn) {
        if (!fn) {
            // 解绑所有 type 的函数
            this.events[type] = []
        } else {
            // 解绑单个 fn
            const fnList = this.events[type]
            if (fnList) {
                this.events[type] = fnList.filter(item => item.fn !== fn)
            }
        }
    }

    emit(type, ...args) {
        const fnList = this.events[type]
        if (fnList == null) return

        // 注意过滤后重新赋值
        this.events[type] = fnList.filter(item => {
            const { fn, isOnce } = item
            fn(...args)

            // once 执行一次就要被过滤掉
            if (!isOnce) return true
            return false
        })
    }
}
实现方式3:拆分保存 on 和 once 事件
// 拆分保存 on 和 once 事件

class EventBus {
    constructor() {
        this.events = {} // { key1: [fn1, fn2], key2: [fn1, fn2] }
        this.onceEvents = {}
    }

    on(type, fn) {
        const events = this.events
        if (events[type] == null) events[type] = []
        events[type].push(fn)
    }

    once(type, fn) {
        const onceEvents = this.onceEvents
        if (onceEvents[type] == null) onceEvents[type] = []
        onceEvents[type].push(fn)
    }

    off(type, fn) {
        if (!fn) {
            // 解绑所有事件
            this.events[type] = []
            this.onceEvents[type] = []
        } else {
            // 解绑单个事件
            const fnList = this.events[type]
            const onceFnList = this.onceEvents[type]
            if (fnList) {
                this.events[type] = fnList.filter(curFn => curFn !== fn)
            }
            if (onceFnList) {
                this.onceEvents[type] = onceFnList.filter(curFn => curFn !== fn)
            }
        }
    }

    emit(type, ...args) {
        const fnList = this.events[type]
        const onceFnList = this.onceEvents[type]

        if (fnList) {
            fnList.forEach(f => f(...args))
        }
        if (onceFnList) {
            onceFnList.forEach(f => f(...args))

            // once 执行一次就删除
            this.onceEvents[type] = []
        }
    }
}
// 测试
const e = new EventBus()

function fn1(a, b) { console.log('fn1', a, b) }
function fn2(a, b) { console.log('fn2', a, b) }
function fn3(a, b) { console.log('fn3', a, b) }

e.on('key1', fn1)
e.on('key1', fn2)
e.once('key1', fn3)
e.on('xxxxxx', fn3)

e.emit('key1', 10, 20) // 触发 fn1 fn2 fn3

e.off('key1', fn1)

e.emit('key1', 100, 200) // 触发 fn2
在日常的开发中,大家用到
EventBus/EventEmitter往往提供比这五个方法多的多的多的方法。但在面试过程中,如果大家能够完整地实现出这五个方法,已经非常可以说明问题了,因此这个EventBus希望大家可以熟练掌握。学有余力的同学,推荐阅读FaceBook推出的通用EventEmiiter库的源码 (opens new window),相信你会有更多收获。
💬 面试官追问
页面每次进入都
bus.$on('refresh', handler),来回切几次后一次刷新执行了好几遍,为什么?每次进入都多注册一个,离开时没解绑,监听器越攒越多。在
beforeDestroy(Vue 3是onUnmounted)里用同一个函数引用off掉,匿名函数是删不掉的,一定要先存成变量。once注册的回调第一次执行就抛错了,第二次emit它又执行了一遍,怎么改?如果包装函数先调回调再
off,回调一抛错,off就没执行到。改成包装函数里先this.off(name, wrapper)再调cb(...args),保证最多执行一次。一个回调在
emit过程中把自己off了,结果下一个回调没执行,为什么?遍历的是原数组,
off改了数组,后面的元素往前挪,循环下标就跳过了一个。emit里先const list = [...this.handlers[name]]拷一份再遍历。项目升级到
Vue 3,之前的this.$bus.$on全报错了,怎么迁移最省事?Vue 3移除了实例的事件接口。装个mitt,const bus = mitt()导出,on/off/emit的用法几乎一样,替换调用就行;顺便趁这个机会把能改成props或provide/inject的改掉。跨组件通信,事件总线和
Pinia怎么选?一次性的通知用总线,比如「登录成功了,大家刷新一下」;需要多个地方读同一份数据、要能追踪谁改了它,就放
Pinia。总线里传状态是我最不想看到的,出了问题根本不知道是谁emit的。
# 3 实现一个双向绑定
⚡ 30 秒速记
- 双向绑定 = 数据变了更新视图(劫持
set)+ 视图变了写回数据(监听输入事件) defineProperty版要补get和闭包里的值,不然读出来是undefined;初始化时还要主动渲染一次Proxy版的set必须返回true,写成return value遇到空字符串会在严格模式下抛TypeError- 监听
input而不是keyup:粘贴、语音输入、输入法上屏keyup都可能漏掉;中文输入用compositionend避开中间态 - 展示用户输入用
textContent,别用innerHTML,有XSS风险
双向绑定就两条线:数据变了改视图,靠劫持属性的 set;视图变了改数据,靠监听输入框事件。 两种写法都有细节要补齐。defineProperty 版只写 set 不写 get 的话,读 data.text 是 undefined,初始值也渲染不上去,要用闭包存值、补 get,挂载时先同步一次。Proxy 版的 set 要返回 true 表示成功,如果返回 value,赋空字符串就判为失败。另外事件我会用 input,keyup 漏掉粘贴和输入法;Vue 的 v-model 本质上就是 :value 加 @input 这么个语法糖。
defineProperty 版本
// 数据
const data = {
  text: 'default'
};
const input = document.getElementById('input');
const span = document.getElementById('span');
// 数据劫持
Object.defineProperty(data, 'text', {
  // 数据变化 --> 修改视图
  set(newVal) {
    input.value = newVal;
    span.innerHTML = newVal;
  }
});
// 视图更改 --> 数据变化
input.addEventListener('keyup', function(e) {
  data.text = e.target.value;
});
proxy 版本
// 数据
const data = {
  text: 'default'
};
const input = document.getElementById('input');
const span = document.getElementById('span');
// 数据劫持
const handler = {
  set(target, key, value) {
    target[key] = value;
    // 数据变化 --> 修改视图
    input.value = value;
    span.innerHTML = value;
    return value;
  }
};
const proxy = new Proxy(data, handler);

// 视图更改 --> 数据变化
input.addEventListener('keyup', function(e) {
  proxy.text = e.target.value;
});
💬 面试官追问
初始
data.text是default,输入框却是空的,读data.text还是undefined,为什么?defineProperty只定义了set,这个属性变成了只有写没有读的访问器,原来的值也丢了。用let value = data.text存起来,get() { return value },set里更新value,最后手动input.value = value渲染一次。Proxy版给proxy.text = ''偶尔抛TypeError,普通文本没事,怎么回事?set陷阱的返回值表示写入成功没有,如果写的是return value,空字符串是假值,严格模式下就抛错了。改成return Reflect.set(target, key, value),成功后再更新视图。用户直接粘贴或者用输入法输入中文,数据没同步或者同步了一堆拼音,怎么改?
换成监听
input事件,粘贴、拖放都能捕获。输入法组字阶段会触发input,用compositionstart置一个标记,compositionend时再写回数据,Vue的v-model就是这么处理的。v-model在Vue 2和Vue 3里展开成什么?Vue 2组件上是value属性加input事件;Vue 3改成modelValue加update:modelValue,还支持v-model:title绑多个。原生input上两个版本都是value加input事件。预览区用
span.innerHTML = value显示用户输入,安全同学说有问题,问题在哪?用户输入
<img src=x onerror=alert(1)>就会执行脚本。纯文本预览改成span.textContent = value;要支持富文本就得过DOMPurify这类白名单净化,自己写转义很容易漏。
# 4 实现一个简易的MVVM
⚡ 30 秒速记
- 三件套:
observe劫持数据、Dep收集依赖、compile解析模板并创建订阅 - 依赖收集时机:编译时把
Dep.target指向当前节点,读一次data[key]触发get,get里把target加进subs - 赋值 →
set→dep.notify()→ 每个订阅节点重新渲染 - 坑点:贪婪正则
(.*)一行多个插值会吞成一个;Dep.target单指针,嵌套求值会丢,要用栈 - 新赋值的对象要重新
observe;数组靠改写push/splice等变异方法才能感知
简易 MVVM 就三块:数据劫持、依赖收集、模板编译,靠 Dep.target 把它们串起来。 observe 用 defineProperty 改写每个属性,每个属性配一个 Dep;compile 遍历模板找到 {<span class="vp-brace-split" aria-hidden="true"></span>{ key }<span class="vp-brace-split" aria-hidden="true"></span>},把 Dep.target 指向当前节点,然后读一下 data[key],get 里就顺手把这个节点收进 subs;以后赋值走 set,notify 通知这些节点更新。这个简易版能演示原理,但要注意两点:正则用贪婪的 (.*),一个节点两个插值会匹配错;Dep.target 只是一个变量,嵌套求值时内层清空了外层就丢依赖,Vue 2 里是用 targetStack 解决的。
实现一个简易的
MVVM我会分为这么几步来:
- 首先我会定义一个类
Vue,这个类接收的是一个options,那么其中可能有需要挂载的根元素的id,也就是el属性;然后应该还有一个data属性,表示需要双向绑定的数据 - 其次我会定义一个
Dep类,这个类产生的实例对象中会定义一个subs数组用来存放所依赖这个属性的依赖,已经添加依赖的方法addSub,删除方法removeSub,还有一个notify方法用来遍历更新它subs中的所有依赖,同时Dep类有一个静态属性target它用来表示当前的观察者,当后续进行依赖收集的时候可以将它添加到dep.subs中。 - 然后设计一个
observe方法,这个方法接收的是传进来的data,也就是options.data,里面会遍历data中的每一个属性,并使用Object.defineProperty()来重写它的get和set,那么这里面呢可以使用new Dep()实例化一个dep对象,在get的时候调用其addSub方法添加当前的观察者Dep.target完成依赖收集,并且在set的时候调用dep.notify方法来通知每一个依赖它的观察者进行更新 - 完成这些之后,我们还需要一个
compile方法来将HTML模版和数据结合起来。在这个方法中首先传入的是一个node节点,然后遍历它的所有子级,判断是否有firstElmentChild,有的话则进行递归调用compile方法,没有firstElementChild的话且该child.innderHTML用正则匹配满足有/\{\{(.*)\}\}/项的话则表示有需要双向绑定的数据,那么就将用正则new Reg('\\{\\{\\s*' + key + '\\s*\\}\\}', 'gm')替换掉{<span class="vp-brace-split" aria-hidden="true"></span>{ msg }<span class="vp-brace-split" aria-hidden="true"></span>}是其为msg变量。 - 完成变量替换的同时,还需要将
Dep.target指向当前的这个child,且调用一下this.opt.data[key],也就是为了触发这个数据的get来对当前的child进行依赖收集,这样下次数据变化的时候就能通知child进行视图更新了,不过在最后要记得将Dep.target指为null哦(其实在Vue中是有一个targetStack栈用来存放target的指向的) - 那么最后我们只需要监听
document的DOMContentLoaded然后在回调函数中实例化这个Vue对象就可以了
coding:
需要注意的点:
childNodes会获取到所有的子节点以及文本节点(包括元素标签中的空白节点)firstElementChild表示获取元素的第一个字元素节点,以此来区分是不是元素节点,如果是的话则调用compile进行递归调用,否则用正则匹配- 这里面的正则真的不难,大家可以看一下
完整代码如下:
<!DOCTYPE html>
<html lang="en">
  <head>
    <meta charset="UTF-8" />
    <meta name="viewport" content="width=device-width, initial-scale=1.0" />
    <meta http-equiv="X-UA-Compatible" content="ie=edge" />
    <title>MVVM</title>
  </head>
  <body>
    <div id="app">
      <h3>姓名</h3>
      <p>{{name}}</p>
      <h3>年龄</h3>
      <p>{{age}}</p>
    </div>
  </body>
</html>
<script>
  document.addEventListener(
    "DOMContentLoaded",
    function () {
      let opt = { el: "#app", data: { name: "等待修改...", age: 20 } };
      let vm = new Vue(opt);
      setTimeout(() => {
        opt.data.name = "jing";
      }, 2000);
    },
    false
  );
  class Vue {
    constructor(opt) {
      this.opt = opt;
      this.observer(opt.data);
      let root = document.querySelector(opt.el);
      this.compile(root);
    }
    observer(data) {
      Object.keys(data).forEach((key) => {
        let obv = new Dep();
        data["_" + key] = data[key];

        Object.defineProperty(data, key, {
          get() {
            Dep.target && obv.addSubNode(Dep.target);
            return data["_" + key];
          },
          set(newVal) {
            obv.update(newVal);
            data["_" + key] = newVal;
          },
        });
      });
    }
    compile(node) {
      [].forEach.call(node.childNodes, (child) => {
        if (!child.firstElementChild && /\{\{(.*)\}\}/.test(child.innerHTML)) {
          let key = RegExp.$1.trim();
          child.innerHTML = child.innerHTML.replace(
            new RegExp("\\{\\{\\s*" + key + "\\s*\\}\\}", "gm"),
            this.opt.data[key]
          );
          Dep.target = child;
          this.opt.data[key];
          Dep.target = null;
        } else if (child.firstElementChild) this.compile(child);
      });
    }
  }

  class Dep {
    constructor() {
      this.subNode = [];
    }
    addSubNode(node) {
      this.subNode.push(node);
    }
    update(newVal) {
      this.subNode.forEach((node) => {
        node.innerHTML = newVal;
      });
    }
  }
</script>
简化版2
function update(){
  console.log('数据变化~~~ mock update view')
}
let obj = [1,2,3]
// 变异方法 push shift unshfit reverse sort splice pop
// Object.defineProperty
let oldProto = Array.prototype;
let proto = Object.create(oldProto); // 克隆了一分
['push','shift'].forEach(item=>{
  proto[item] = function(){
    update();
    oldProto[item].apply(this,arguments);
  }
})
function observer(value){ // proxy reflect
  if(Array.isArray(value)){
    // AOP
    return value.__proto__ = proto;
    // 重写 这个数组里的push shift unshfit reverse sort splice pop
  }
  if(typeof value !== 'object'){
    return value;
  }
  for(let key in value){
    defineReactive(value,key,value[key]);
  }
}
function defineReactive(obj,key,value){
  observer(value); // 如果是对象 继续增加getter和setter
  Object.defineProperty(obj,key,{
    get(){
        return value;
    },
    set(newValue){
        if(newValue !== value){
            observer(newValue);
            value = newValue;
            update();
        }
    }
  })
}
observer(obj);
// AOP
// obj.name = {n:200}; // 数据变了 需要更新视图 深度监控
// obj.name.n = 100;
obj.push(123);
obj.push(456);
console.log(obj);
💬 面试官追问
模板是
你好,{<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>},今年 {<span class="vp-brace-split" aria-hidden="true"></span>{age}<span class="vp-brace-split" aria-hidden="true"></span>},编译后只替换了一个还匹配错了,为什么?/\{\{(.*)\}\}/是贪婪匹配,会从第一个{<span class="vp-brace-split" aria-hidden="true"></span>{一路吃到最后一个}<span class="vp-brace-split" aria-hidden="true"></span>},拿到的键是name}<span class="vp-brace-split" aria-hidden="true"></span>},今年 {<span class="vp-brace-split" aria-hidden="true"></span>{age。改成非贪婪的全局匹配/\{\{\s*(.+?)\s*\}\}/g,存下原始文本,每个键都建依赖,变化时整段重新替换。把
detail整个换成新对象后,再改detail.price页面不更新,缺了哪一步?set里拿到新对象没有递归observe,新对象的属性都是普通属性,没有getter。set(newVal) { observe(newVal); val = newVal; dep.notify() },Vue 2的defineReactive就是这么干的。连续改十次数据,页面同步刷了十次,怎么优化?
通知时不直接更新,把观察者丢进一个按
id去重的队列,用Promise.resolve().then(flush)在微任务里统一跑一次。这就是Vue的nextTick批量更新,代价是改完数据马上读DOM拿到的是旧的。弹窗开关几次后,改一次名字更新了几十次,怎么查?
看对应属性
dep.subs的长度,大概率是每次打开都compile了一遍,又建了一批订阅,关闭时没removeSub。subs换成Set能防重复添加,但真正要做的是卸载时把订阅清掉。嵌套模板编译时,内层读完把
Dep.target设成null,外层后面的依赖全丢了,怎么修?用栈:进入求值
pushTarget(watcher),结束popTarget()恢复成上一个,而不是直接设null。pop放进finally,防止求值抛错把栈搞乱。
# 5 实现一个迷你版的vue
⚡ 30 秒速记
- 四个类:
Vue入口代理$data、Observer劫持、Dep存观察者、Compiler解析插值和指令 Watcher构造时Dep.target = this读一次属性完成收集,数据变了Dep.notify()→watcher.update()→ 回调改节点v-model两头:Watcher负责数据到输入框,input事件负责输入框到数据- 容易漏的点:
{<span class="vp-brace-split" aria-hidden="true"></span>{person.name}<span class="vp-brace-split" aria-hidden="true"></span>}要按点拆开逐层取值;update后要更新oldValue;依赖要能清理,不能只增不减 - 这就是
Vue 2响应式的缩小版;Vue 3换成了Proxy+effect
迷你 Vue 拆成四块:入口把 data 代理到实例上,Observer 把属性变成 getter / setter,Compiler 解析模板,Dep 和 Watcher 负责依赖和更新。 编译遇到 {<span class="vp-brace-split" aria-hidden="true"></span>{ msg }<span class="vp-brace-split" aria-hidden="true"></span>} 或 v-text,就为这个节点新建一个 Watcher,构造时把 Dep.target 指向自己再读一次 vm.msg,getter 就把它收进了 msg 的 Dep;之后 vm.msg = 'x' 触发 setter,notify 让每个 Watcher 拿新值调回调改 DOM。v-model 多一步,监听 input 事件写回 vm。这套和 Vue 2 的思路一致,只是没做批量更新和依赖清理。
入口
// js/vue.js
class Vue {
  constructor (options) {
    // 1. 通过属性保存选项的数据
    this.$options = options || {}
    this.$data = options.data || {}
    this.$el = typeof options.el === 'string' ? document.querySelector(options.el) : options.el
    // 2. 把data中的成员转换成getter和setter,注入到vue实例中
    this._proxyData(this.$data)
    // 3. 调用observer对象,监听数据的变化
    new Observer(this.$data)
    // 4. 调用compiler对象,解析指令和差值表达式
    new Compiler(this)
  }
  _proxyData (data) {
    // 遍历data中的所有属性
    Object.keys(data).forEach(key => {
      // 把data的属性注入到vue实例中
      Object.defineProperty(this, key, {
        enumerable: true,
        configurable: true,
        get () {
          return data[key]
        },
        set (newValue) {
          if (newValue === data[key]) {
            return
          }
          data[key] = newValue
        }
      })
    })
  }
}
实现Dep
class Dep {
  constructor () {
    // 存储所有的观察者
    this.subs = []
  }
  // 添加观察者
  addSub (sub) {
    if (sub && sub.update) {
      this.subs.push(sub)
    }
  }
  // 发送通知
  notify () {
    this.subs.forEach(sub => {
      sub.update()
    })
  }
}
实现watcher
class Watcher {
  constructor (vm, key, cb) {
    this.vm = vm
    // data中的属性名称
    this.key = key
    // 回调函数负责更新视图
    this.cb = cb

    // 把watcher对象记录到Dep类的静态属性target
    Dep.target = this
    // 触发get方法,在get方法中会调用addSub
    this.oldValue = vm[key]
    Dep.target = null
  }
  // 当数据发生变化的时候更新视图
  update () {
    let newValue = this.vm[this.key]
    if (this.oldValue === newValue) {
      return
    }
    this.cb(newValue)
  }
}
实现compiler
class Compiler {
  constructor (vm) {
    this.el = vm.$el
    this.vm = vm
    this.compile(this.el)
  }
  // 编译模板,处理文本节点和元素节点
  compile (el) {
    let childNodes = el.childNodes
    Array.from(childNodes).forEach(node => {
      // 处理文本节点
      if (this.isTextNode(node)) {
        this.compileText(node)
      } else if (this.isElementNode(node)) {
        // 处理元素节点
        this.compileElement(node)
      }

      // 判断node节点,是否有子节点,如果有子节点,要递归调用compile
      if (node.childNodes && node.childNodes.length) {
        this.compile(node)
      }
    })
  }
  // 编译元素节点,处理指令
  compileElement (node) {
    // console.log(node.attributes)
    // 遍历所有的属性节点
    Array.from(node.attributes).forEach(attr => {
      // 判断是否是指令
      let attrName = attr.name
      if (this.isDirective(attrName)) {
        // v-text --> text
        attrName = attrName.substr(2)
        let key = attr.value
        this.update(node, key, attrName)
      }
    })
  }

  update (node, key, attrName) {
    let updateFn = this[attrName + 'Updater']
    updateFn && updateFn.call(this, node, this.vm[key], key)
  }

  // 处理 v-text 指令
  textUpdater (node, value, key) {
    node.textContent = value
    new Watcher(this.vm, key, (newValue) => {
      node.textContent = newValue
    })
  }
  // v-model
  modelUpdater (node, value, key) {
    node.value = value
    new Watcher(this.vm, key, (newValue) => {
      node.value = newValue
    })
    // 双向绑定
    node.addEventListener('input', () => {
      this.vm[key] = node.value
    })
  }

  // 编译文本节点,处理差值表达式
  compileText (node) {
    // console.dir(node)
    // {{  msg }}
    let reg = /\{\{(.+?)\}\}/
    let value = node.textContent
    if (reg.test(value)) {
      let key = RegExp.$1.trim()
      node.textContent = value.replace(reg, this.vm[key])

      // 创建watcher对象,当数据改变更新视图
      new Watcher(this.vm, key, (newValue) => {
        node.textContent = newValue
      })
    }
  }
  // 判断元素属性是否是指令
  isDirective (attrName) {
    return attrName.startsWith('v-')
  }
  // 判断节点是否是文本节点
  isTextNode (node) {
    return node.nodeType === 3
  }
  // 判断节点是否是元素节点
  isElementNode (node) {
    return node.nodeType === 1
  }
}
实现Observer
class Observer {
  constructor (data) {
    this.walk(data)
  }
  walk (data) {
    // 1. 判断data是否是对象
    if (!data || typeof data !== 'object') {
      return
    }
    // 2. 遍历data对象的所有属性
    Object.keys(data).forEach(key => {
      this.defineReactive(data, key, data[key])
    })
  }
  defineReactive (obj, key, val) {
    let that = this
    // 负责收集依赖,并发送通知
    let dep = new Dep()
    // 如果val是对象,把val内部的属性转换成响应式数据
    this.walk(val)
    Object.defineProperty(obj, key, {
      enumerable: true,
      configurable: true,
      get () {
        // 收集依赖
        Dep.target && dep.addSub(Dep.target)
        return val
      },
      set (newValue) {
        if (newValue === val) {
          return
        }
        val = newValue
        that.walk(newValue)
        // 发送通知
        dep.notify()
      }
    })
  }
}
使用
<!DOCTYPE html>
<html lang="cn">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <meta http-equiv="X-UA-Compatible" content="ie=edge">
  <title>Mini Vue</title>
</head>
<body>
  <div id="app">
    <h1>差值表达式</h1>
    <h3>{{ msg }}</h3>
    <h3>{{ count }}</h3>
    <h1>v-text</h1>
    <div v-text="msg"></div>
    <h1>v-model</h1>
    <input type="text" v-model="msg">
    <input type="text" v-model="count">
  </div>
  <script src="./js/dep.js"></script>
  <script src="./js/watcher.js"></script>
  <script src="./js/compiler.js"></script>
  <script src="./js/observer.js"></script>
  <script src="./js/vue.js"></script>
  <script>
    let vm = new Vue({
      el: '#app',
      data: {
        msg: 'Hello Vue',
        count: 100,
        person: { name: 'zs' }
      }
    })
    console.log(vm.msg)
    // vm.msg = { test: 'Hello' }
    vm.test = 'abc'
  </script>
</body>
</html>
💬 面试官追问
模板写
{<span class="vp-brace-split" aria-hidden="true"></span>{person.name}<span class="vp-brace-split" aria-hidden="true"></span>},person是响应式的,页面却显示undefined,为什么?编译器拿整个字符串
'person.name'当键去读vm['person.name'],当然没有。按点拆开逐层取:key.split('.').reduce((o, k) => o?.[k], vm),逐层读的过程中每一层getter都会收集依赖。msg从A改成B再改回A,第二次没更新,查到oldValue一直是初始值,怎么修?update里比较完、调完回调要写一句this.oldValue = newValue,不然每次都拿初始值比,改回A就被当成「没变」跳过了。v-if切换后,Watcher不再读a了,改a还是会触发更新,缺了什么?缺依赖清理。每次求值前记下旧依赖,重新收集一轮,再把这轮没用到的
Dep里的自己删掉。Vue 2的Watcher有deps和newDeps两组就是干这个的。想加计算属性,
total依赖price和count,只在依赖变化时重算,怎么接?给计算属性一个惰性
Watcher,带dirty标记:依赖通知时只标脏不计算,读total时如果脏了再求值。还要让读total的视图Watcher也订阅到price和count,不然重算了视图也不知道。一个文本节点里有
{<span class="vp-brace-split" aria-hidden="true"></span>{count}<span class="vp-brace-split" aria-hidden="true"></span>} 件,{<span class="vp-brace-split" aria-hidden="true"></span>{status}<span class="vp-brace-split" aria-hidden="true"></span>},现在只建了一个Watcher,要上虚拟DOM吗?不用。保存原始文本,提取所有键,每个键都建
Watcher,任何一个变了就用当前数据把整段文本重新替换一遍。模板再复杂到有表达式、循环,才轮到真正的模板编译器。
# 6 实现Vue reactive响应式
⚡ 30 秒速记
- 每个属性一个
Dep:get里depend()收集当前Watcher,set里notify()让它们重跑 Watcher执行副作用前pushTarget、执行完popTarget,用栈支持嵌套Watcher- 要补的细节:
set跳过相同值、新对象再reactive一次、popTarget放进finally defineProperty管不了新增 / 删除属性和数组下标,Vue 2只能补Vue.set和数组方法改写Vue 3改成Proxy拦截 +WeakMap存依赖(target → key → Set<effect>),这些问题一并解决
这段 reactive 就是 Vue 2 响应式的最小版:每个属性一个 Dep,读的时候收集当前 Watcher,写的时候通知它们重跑。 Watcher 执行副作用前把自己压到 Dep.target,副作用里读到的属性就都记下了它,执行完再弹出来,用栈是为了嵌套的 Watcher 不会互相覆盖。要写得靠谱还得补几处:赋相同值不该通知;set 拿到新对象要再 reactive 一下;popTarget 要放 finally 里。至于新增属性、删属性、数组下标这些,defineProperty 天生管不了,这也是 Vue 3 换成 Proxy 的主要原因。
// Dep module
class Dep {
  static stack = []
  static target = null
  deps = null

  constructor() {
    this.deps = new Set()
  }

  depend() {
    if (Dep.target) {
      this.deps.add(Dep.target)
    }
  }

  notify() {
    this.deps.forEach(w => w.update())
  }

  static pushTarget(t) {
    if (this.target) {
      this.stack.push(this.target)
    }
    this.target = t
  }

  static popTarget() {
    this.target = this.stack.pop()
  }
}

// reactive
function reactive(o) {
  if (o && typeof o === 'object') {
    Object.keys(o).forEach(k => {
      defineReactive(o, k, o[k])
    })
  }
  return o
}

function defineReactive(obj, k, val) {
  let dep = new Dep()
  Object.defineProperty(obj, k, {
    get() {
      dep.depend()
      return val
    },
    set(newVal) {
      val = newVal
      dep.notify()
    }
  })
  if (val && typeof val === 'object') {
    reactive(val)
  }
}

// watcher
class Watcher {
  constructor(effect) {
    this.effect = effect
    this.update()
  }

  update() {
    Dep.pushTarget(this)
    this.value = this.effect()
    Dep.popTarget()
    return this.value
  }
}

// 测试代码
const data = reactive({
  msg: 'aaa'
})

new Watcher(() => {
  console.log('===> effect', data.msg);
})

setTimeout(() => {
  data.msg = 'hello'
}, 1000)
💬 面试官追问
Watcher里执行flag ? data.a : data.b,flag切到false后改a还在触发,用了Set为什么不行?Set只防同一个Watcher被重复添加,不会删掉上一轮留下的依赖。要在每次重跑前把自己从所有旧Dep里移除,再重新收集,Vue 3的effect每次执行前也会做这一步清理。data.user = { name: 'B' }之后改data.user.name,Watcher没反应,为什么?只有初始化时递归了,
set存新值时没有调reactive(newVal),新对象的name是普通属性。set里先if (newVal === val) return,再reactive(newVal),最后notify。某个副作用抛了异常,之后普通的读取也被收集进了这个
Watcher,怎么回事?update里popTarget()写在effect()后面,抛错就没执行到,Dep.target一直指着它。改成try { this.value = this.effect() } finally { Dep.popTarget() }。data.newKey = 1新增属性,页面不更新,Vue 2和Vue 3分别怎么办?Vue 2的defineProperty只能劫持已经存在的属性,新增要用Vue.set(obj, 'newKey', 1)或this.$set。Vue 3用Proxy拦的是整个对象,直接赋值就是响应式的,$set已经删了。对象被
defineProperty改完,JSON.stringify少了字段,为什么?defineProperty没写的描述符默认都是false,属性变成了不可枚举、不可配置,序列化和Object.keys都看不到它。要显式写enumerable: true, configurable: true。
# 7 实现模板字符串解析功能
⚡ 30 秒速记
- 递归写法:正则匹配第一个
{<span class="vp-brace-split" aria-hidden="true"></span>{key}<span class="vp-brace-split" aria-hidden="true"></span>}→ 替换成data[key]→ 递归,直到没有占位符 - 更好写法:一次全局替换
tpl.replace(/\{\{\s*(\w+)\s*\}\}/g, (_, k) => data[k] ?? ''),不递归 - 替换值一定要用函数传,字符串里有
$&、$1会被当成特殊替换模式 - 缺失字段用
??而不是||,否则0和false也被当成空 - 递归版有坑:数据里刚好含
{<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>}会无限递归栈溢出
模板解析就是找出所有 {<span class="vp-brace-split" aria-hidden="true"></span>{key}<span class="vp-brace-split" aria-hidden="true"></span>},换成 data 里对应的值。 每次替换第一个再递归也能跑,但我更推荐一次全局替换:template.replace(/\{\{\s*(\w+)\s*\}\}/g, (_, key) => data[key] ?? '')。这样有三个好处:只扫一遍字符串;替换值是通过函数返回的,不会被 $& 这类特殊符号坑;替换出来的内容不会被再次匹配,数据里恰好有 {<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>} 也不会死循环。缺失字段显示什么要和产品对齐,但一定用 ?? 判断,0 不能被吃掉。
let template = '我是{{name}},年龄{{age}},性别{{sex}}';
let data = {
  name: '姓名',
  age: 18
}
render(template, data); // 我是姓名,年龄18,性别undefined
function render(template, data) {
  const reg = /\{\{(\w+)\}\}/; // 模板字符串正则
  if (reg.test(template)) { // 判断模板里是否有模板字符串
    const name = reg.exec(template)[1]; // 查找当前模板里第一个模板字符串的字段
    template = template.replace(reg, data[name]); // 将第一个模板字符串渲染
    return render(template, data); // 递归的渲染并返回渲染后的结构
  }
  return template; // 如果模板没有模板字符串直接返回
}
💬 面试官追问
用户昵称是
$&,渲染出来变成了{<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>},数据明明取对了,为什么?replace的第二个参数是字符串时,$&代表匹配到的整段文本,$1代表第一个分组。改成传函数replace(reg, () => value),函数返回值会原样插入。某条数据的
name刚好是{<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>},页面直接卡死报栈溢出,为什么?递归版替换完又生成了一个
{<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>},下一轮继续命中,永远停不下来。一次全局替换只扫描原模板,替换进去的内容不会再被处理,自然就没这个问题。产品要求缺失字段显示空串,但
0和false要原样显示,怎么写?data[key] ?? '',只有null和undefined才走默认值。用data[key] || ''的话库存0就显示成空了,线上这种问题很常见。要支持
{<span class="vp-brace-split" aria-hidden="true"></span>{ user.name }<span class="vp-brace-split" aria-hidden="true"></span>}这种路径,同时禁止访问__proto__,怎么做?正则放宽成
/\{\{\s*([\w.]+)\s*\}\}/g,按点拆开逐层取值,每一层用Object.hasOwn(obj, k)判断是自有属性才往下走,__proto__、constructor直接拒绝。结果要插进
HTML,还需要做什么?按输出位置转义,至少把
<、>、&、"、'转成实体。模板引擎一般默认转义,要输出原始HTML得显式标注,比如Vue的v-html。
# 8 实现一下hash路由
⚡ 30 秒速记
- 原理:
#后面的内容变了不刷新页面、不发请求,浏览器触发hashchange,读location.hash渲染对应视图 - 首屏不会触发
hashchange,初始化时要主动执行一次 - 常见坑:在回调外面缓存
location.hash,每次读到的都是旧值 - 封装成类:保存绑定好的监听函数,提供
destroy()用removeEventListener解绑 - 对比
history模式:URL干净,但刷新深层路径要服务端回退到index.html,否则404
hash 路由靠的是一个特性:改 # 后面的部分,浏览器不刷新页面也不发请求,只会触发 hashchange 事件。 所以实现就是监听 hashchange,回调里读 location.hash.slice(1),根据值渲染对应内容。有两个容易漏的点:页面第一次打开不会触发 hashchange,要在初始化时自己跑一次;如果把 location.hash 缓存在回调外面,路由切了读到的还是第一次的值,必须在回调里重新读。跟 history 模式比,hash 不需要服务端配合,history 模式的地址好看,但服务端要把所有路径都回退到入口文件。
基础的html代码:
<html>
  <style>
    html, body {
      margin: 0;
      height: 100%;
    }
    ul {
      list-style: none;
      margin: 0;
      padding: 0;
      display: flex;
      justify-content: center;
    }
    .box {
      width: 100%;
      height: 100%;
      background-color: red;
    }
  </style>
  <body>
  <ul>
    <li>
      <a href="#red">红色</a>
    </li>
    <li>
      <a href="#green">绿色</a>
    </li>
    <li>
      <a href="#purple">紫色</a>
    </li>
  </ul>
  </body>
</html>
简单实现:
<script>
  const box = document.getElementsByClassName('box')[0];
  const hash = location.hash
  window.onhashchange = function (e) {
    const color = hash.slice(1)
    box.style.background = color
  }
</script>
封装成一个class:
<script>
  const box = document.getElementsByClassName('box')[0];
  const hash = location.hash
  class HashRouter {
    constructor (hashStr, cb) {
      this.hashStr = hashStr
      this.cb = cb
      this.watchHash()
      this.watch = this.watchHash.bind(this)
      window.addEventListener('hashchange', this.watch)
    }
    watchHash () {
      let hash = window.location.hash.slice(1)
      this.hashStr = hash
      this.cb(hash)
    }
  }
  new HashRouter('red', (color) => {
    box.style.background = color
  })
</script>
💬 面试官追问
从
#red切到#green,地址栏变了但背景还是红色,代码哪里有问题?const hash = location.hash写在回调外面,只在脚本执行时读了一次。回调里改成const color = location.hash.slice(1),每次事件触发都重新读。用户收藏了
/#purple直接打开,页面没渲染,为什么?hashchange只在变化时触发,首次加载不算变化。初始化时手动调一次渲染函数,封装成类时在构造函数里先调一次this.watchHash()就是这个目的。路由要支持
#/user/42?tab=orders,还要未匹配时进默认页,怎么改?先把
hash拆成路径和查询串,查询串交给new URLSearchParams(query);路径去匹配一张路由表,比如/user/:id转成正则提取参数,全部匹配失败就走*默认路由。history模式下调history.pushState,为什么监听的popstate没触发?pushState和replaceState不会触发popstate,只有用户点前进后退或者调history.back()才会。所以history路由要自己在push之后手动渲染,再监听popstate处理前进后退。部署后
history模式刷新/order/123返回404,hash模式没这问题,为什么?hash部分不会发给服务端,请求的永远是/;history模式刷新会真的请求/order/123,服务端没这个文件就404。Nginx加一句try_files $uri $uri/ /index.html;回退到入口。
# 9 实现redux中间件
⚡ 30 秒速记
- 中间件签名:
store => next => action => {},三层柯里化 applyMiddleware包装createStore:给每个中间件传{ getState, dispatch },再用compose串成新的dispatchcompose(f, g, h)(dispatch)=f(g(h(dispatch))),执行顺序是f先进入、h最后,像洋葱一样一层层往里再往外middlewareAPI.dispatch要写成(...args) => dispatch(...args),指向组合后的最终dispatch,中间件里再派发才会走完整链路- 手写易错:
compose里变量名前后写得不一致会直接报错;subscribe返回空函数就取消不了订阅
Redux 中间件就是对 dispatch 的层层包装,签名是 store => next => action,next 指向下一个中间件,最里面是原始的 dispatch。 applyMiddleware 先用原 createStore 建出 store,给每个中间件传一个 { getState, dispatch } 拿到中间那层函数,再用 compose 把它们串起来,传入原始 dispatch 得到新的 dispatch。有个细节常被问:传给中间件的 dispatch 是一个转发函数,指向最终组合好的那个,这样中间件里再 dispatch 会从头走一遍链;Redux 源码里甚至在组合完成前调用它会直接报错。
简单实现
function createStore(reducer) {
  let currentState
  let listeners = []

  function getState() {
    return currentState
  }

  function dispatch(action) {
    currentState = reducer(currentState, action)
    listeners.map(listener => {
      listener()
    })
    return action
  }

  function subscribe(cb) {
    listeners.push(cb)
    return () => {}
  }

  dispatch({type: 'ZZZZZZZZZZ'})

  return {
    getState,
    dispatch,
    subscribe
  }
}

// 应用实例如下:
function reducer(state = 0, action) {
  switch (action.type) {
    case 'ADD':
      return state + 1
    case 'MINUS':
      return state - 1
    default:
      return state
  }
}

const store = createStore(reducer)

console.log(store);
store.subscribe(() => {
  console.log('change');
})
console.log(store.getState());
console.log(store.dispatch({type: 'ADD'}));
console.log(store.getState());
2. 迷你版
export const createStore = (reducer,enhancer)=>{
	if(enhancer) {
		return enhancer(createStore)(reducer)
	}
	let currentState = {}
	let currentListeners = []

	const getState = ()=>currentState
	const subscribe = (listener)=>{
		currentListeners.push(listener)
	}
	const dispatch = action=>{
		currentState = reducer(currentState, action)
		currentListeners.forEach(v=>v())
		return action
	}
	dispatch({type:'@@INIT'})
	return {getState,subscribe,dispatch}
}

//中间件实现
export applyMiddleWare(...middlewares){
	return createStore=>...args=>{
		const store = createStore(...args)
		let dispatch = store.dispatch

		const midApi = {
			getState:store.getState,
			dispatch:...args=>dispatch(...args)
		}
		const middlewaresChain = middlewares.map(middleware=>middleware(midApi))
		dispatch = compose(...middlewaresChain)(store.dispatch)
		return {
			...store,
			dispatch
		}
	}

// fn1(fn2(fn3())) 把函数嵌套依次调用
export function compose(...funcs){
	if(funcs.length===0){
		return arg=>arg
	}
	if(funs.length===1){
		return funs[0]
	}
	return funcs.reduce((ret,item)=>(...args)=>ret(item(...args)))
}


//bindActionCreator实现

function bindActionCreator(creator,dispatch){
    return ...args=>dispatch(creator(...args))
}
function bindActionCreators(creators,didpatch){
    //let bound = {}
    //Object.keys(creators).forEach(v=>{
   //     let creator = creator[v]
     //   bound[v] = bindActionCreator(creator,dispatch)
    //})
    //return bound

    return Object.keys(creators).reduce((ret,item)=>{
	    ret[item] = bindActionCreator(creators[item],dispatch)
    	return ret
    },{})
}
💬 面试官追问
日志、异常、业务三个中间件依次传入,执行顺序是怎样的?
action进来先过日志,再过异常,再过业务,最后到reducer;next()返回后再反着出来,日志最后结束。写三个只打印进入和退出的中间件跑一下就能验证,输出是1进 2进 3进 3出 2出 1出。中间件里调
dispatch({ type: 'AUDIT' }),为什么不能直接用创建时的store.dispatch?原始的
store.dispatch不过中间件,日志、异步这些处理都会被绕过。用(...args) => dispatch(...args)闭包转发到最终变量,再派发才走完整链路;但要小心别无条件派发同类action,会死循环。页面卸载后订阅回调还在执行,这份
createStore要补什么?subscribe要返回真正的取消函数:return () => { listeners = listeners.filter(l => l !== cb) }。通知时最好遍历快照,回调里取消订阅才不会影响本轮。中间件里不调用
next(action)会怎样?这个
action就到此为止,后面的中间件和reducer都收不到,状态不会变。这是中间件拦截的能力,thunk处理函数类型的action就是这么干的,但普通中间件忘写next就是错误。现在新项目还要自己写
applyMiddleware吗?一般不用。
Redux Toolkit的configureStore默认就带了thunk和开发环境的检查中间件,要加自定义的写middleware: (getDefault) => getDefault().concat(logger)。手写这题是为了懂原理。
# 10 实现redux-thunk
⚡ 30 秒速记
- 一句话:
action是函数就执行它并传dispatch、getState;不是就next(action)往下传 - 函数
action被吃掉了,后面的中间件看不到它,只看得到它内部再派发的普通action thunk不管异步错误,请求失败要在函数里try/catch自己派发失败actionwithExtraArgument(api)可以注入第三个参数,方便替换API客户端和测试- 版本:
redux-thunk3.x改成命名导出import { thunk } from 'redux-thunk';RTK的configureStore已默认内置
redux-thunk 就几行:如果 action 是函数,就调用它并把 dispatch 和 getState 传进去;不是函数就 next(action) 交给下一个中间件。 有了它,你可以 dispatch 一个函数,在函数里先派发 loading,等请求回来再派发成功或失败,异步流程就能放进 action 里。要说清楚的是 thunk 本身不处理任何异步,它只是给了你一个能拿到 dispatch 的地方,请求失败、竞态这些都得自己在函数里处理。现在用 Redux Toolkit 的话 thunk 是默认带的,createAsyncThunk 还帮你生成了 pending / fulfilled / rejected 三个 action。
redux-thunk可以利用redux中间件让redux支持异步的action
// 如果 action 是个函数,就调用这个函数
// 如果 action 不是函数,就传给下一个中间件
// 发现 action 是函数就调用
const thunk = ({ dispatch, getState }) => (next) => (action) => {
  if (typeof action === 'function') {
    return action(dispatch, getState);
  }

  return next(action);
};
export default thunk
redux-thunk 的完整源码比题目里的多一个能力:注入额外参数。3.x 版本大致是这样:
function createThunkMiddleware(extraArgument) {
  return ({ dispatch, getState }) => (next) => (action) => {
    if (typeof action === 'function') {
      // 函数 action:执行并把返回值(常见是 Promise)交还给调用方
      return action(dispatch, getState, extraArgument)
    }
    return next(action) // 普通对象:交给下一个中间件
  }
}

export const thunk = createThunkMiddleware()
export const withExtraArgument = createThunkMiddleware
一个带错误处理的异步 action:
const fetchUser = (id) => async (dispatch, getState, { api }) => {
  dispatch({ type: 'user/loading' })
  try {
    const user = await api.getUser(id)
    dispatch({ type: 'user/success', payload: user })
  } catch (err) {
    dispatch({ type: 'user/fail', error: err.message })
  }
}

// 调用方可以 await,因为 thunk 把函数的返回值透传了
await store.dispatch(fetchUser(42))
注意 2.x 是默认导出 import thunk from 'redux-thunk',3.x 改成了命名导出,升级时这里会报错。用 Redux Toolkit 就不用手动装,configureStore 默认已经带上。
💬 面试官追问
thunk后面接了日志中间件,为什么只能看到普通action,看不到函数action?函数
action在thunk里直接被调用了,没有next,往后传不下去。日志里能看到的是函数内部再dispatch的那几个普通action,想看完整异步流程就把日志放在thunk前面,或者看那几个派发出来的action。搜索框连续输入,旧请求比新请求晚回来,把结果覆盖了,
thunk里怎么防?请求前生成一个
requestId存进state,响应回来时if (getState().search.requestId !== id) return丢弃旧结果。更彻底的是用AbortController把旧请求直接取消。请求失败了,页面一直停在
loading,thunk不会自动派发失败吗?不会,它只是
return action(dispatch, getState),连错误都不碰。函数里try { ... dispatch(success) } catch (e) { dispatch(fail(e)) },createAsyncThunk就是把这套模板帮你写好了。函数
action里想用API客户端,又不想每个文件都导入单例,怎么做?用
withExtraArgument:thunk.withExtraArgument({ api })(3.x是单独导出的withExtraArgument),函数签名变成(dispatch, getState, { api }),测试时塞一个假的api就行。购物车加一这种纯同步操作,也包成函数
action派发,有必要吗?没必要。同步、不依赖当前状态判断的直接
dispatch普通对象,日志和DevTools也能直接看到。函数action留给异步、需要getState判断或者要连续派发多个action的场景。
# 29 数组相关
# 1 实现forEach方法
⚡ 30 秒速记
- 遍历每个元素调用
callback.call(thisArg, item, index, array),三个参数一个都不能少 - 返回值永远是
undefined,不能链式调用 - 跳过稀疏数组的空槽:用
i in arr判断,不能用!== undefined - 长度在开始时就定死,遍历中追加的元素不会被访问
- 没法
break,要提前结束换for...of/some/every;也不会等async回调
手写 forEach 就是一个 for 循环,每个元素调一次 callback.call(thisArg, 当前值, 索引, 原数组),返回 undefined。 手写时最容易和原生对不上的几处:回调只传两个参数,少了原数组;给 context 默认值 window,在 Node 或 SSR 里直接报 window is not defined;不判断空槽,[1, , 3] 会多调一次。另外 callback 不是函数时原生是抛 TypeError,静默跳过会让调用方以为执行过了。面试我还会顺带说一句:forEach 不能 break,也不会等 await,这两个是最常见的误用。
Array.prototype.myForEach = function (callback, thisArg) {
  if (this == null) throw new TypeError('this is null or undefined')
  if (typeof callback !== 'function') throw new TypeError(callback + ' is not a function')
  const O = Object(this)        // 兼容类数组
  const len = O.length >>> 0     // 长度在开始时定死
  for (let i = 0; i < len; i++) {
    if (i in O) {                // 跳过空槽
      callback.call(thisArg, O[i], i, O)
    }
  }
  // 没有返回值,即 undefined
}

;[1, , 3].myForEach((v, i) => console.log(i, v))
// 0 1
// 2 3   (索引 1 是空槽,被跳过)
和原生对齐要注意四处:不给 thisArg 设 window 默认值(Node、SSR 里没有 window)、回调传齐三个参数、用 i in O 跳过空槽、callback 不是函数直接抛错。filter、map、some、every 的手写版都可以套这个骨架。
💬 面试官追问
[1, , 3].myForEach(cb)回调执行了三次,原生只执行两次,差在哪?原生会跳过空槽。循环里加
if (!(i in this)) continue,不能写this[i] !== undefined,因为[1, undefined, 3]的中间那个是真实存在的元素,原生会访问它。默认参数
context = window在SSR里报错,怎么改?去掉默认值,
callback.call(thisArg, ...)直接传undefined就行。严格模式下回调里的this就是undefined,非严格模式会自动变成全局对象,交给语言规则处理。在
forEach里写async回调去await请求,后面的代码为什么没等它们执行完?forEach不管回调返回什么,async函数返回的Promise被直接丢掉了。要串行用for...of加await,要并发用await Promise.all(arr.map(async item => ...))。遍历中途想跳出循环,
return为什么没用?return只是结束当前这次回调,下一个元素照样执行。要提前结束就换for...of加break,或者用some(返回true停)和every(返回false停)。回调执行到第
20项时往数组尾部push了数据,新数据会被遍历到吗?不会,长度在开始时就读好了,追加的超出了原长度。但如果删除了还没访问到的元素,原生会因为空槽检查跳过它;手写版要是没有
i in O这个检查,就会以undefined多调一次。
# 2 实现filter方法
⚡ 30 秒速记
- 遍历时调用
callback.call(thisArg, item, i, arr),返回真值就push进新数组,最后返回新数组 - 不改原数组,但新数组里的对象和原数组是同一个引用(浅拷贝)
- 空槽要跳过(
i in arr),否则谓词会拿到undefined - 两个常见坑:
context = window在Node里报错;let连续声明少写逗号,后面的newArr和i会变成隐式全局变量 - 只要满足条件的第一个就用
find,别filter完再取[0]
手写 filter 就是遍历一遍,谓词返回真值的元素 push 进新数组,最后返回新数组。 它不改原数组,但要提醒一句,新数组里放的还是原来的对象引用,改 newArr[0].name 原数组也跟着变。手写时有个容易看漏的坑:let len = this.length 后面如果换行没写逗号,newArr 和 i 就根本没被 let 声明,非严格模式下变成全局变量,严格模式直接报错。再加上别给 thisArg 默认 window、要跳过空槽,按原生语义写才算完整。
Array.prototype.myFilter=function(callback, context=window){

  let len = this.length
      newArr = [],
      i=0

  for(; i < len; i++){
    if(callback.apply(context, [this[i], i , this])){
      newArr.push(this[i]);
    }
  }
  return newArr;
}
💬 面试官追问
let len = this.length那一行后面换行接着写newArr = [],会发生什么?这里没有逗号,自动分号插入把它拆成了两条语句,
newArr = []和i = 0成了没声明的赋值。非严格模式下它们挂到全局对象上,严格模式下直接ReferenceError。权限列表
[a, , c]中间是空槽,谓词把undefined当成匿名项保留了,为什么?循环没判断索引是否存在,空槽读出来是
undefined传给了谓词。加if (!(i in this)) continue,原生filter就是跳过空槽的。筛选后改了结果里某个商品的价格,原列表的价格也变了,
filter不是不改原数组吗?它不改的是原数组本身,元素如果是对象,新旧数组里存的是同一个引用。要独立修改就在后面接
map(item => ({ ...item })),或者用structuredClone。想找第一个库存为
0的商品,写list.filter(x => x.stock === 0)[0],有什么问题?结果对,但
filter会把整个数组扫完再建一个新数组,只取第一个太浪费。用find,命中就返回,后面不再遍历。SSR时调用myFilter报window is not defined,最小改法是什么?把参数改成
(callback, thisArg),去掉默认值,callback.call(thisArg, ...)。thisArg不传就是undefined,交给严格模式规则决定回调里的this。
# 3 实现find方法
⚡ 30 秒速记
- 顺序遍历,谓词第一次返回真值就返回该元素,后面不再看(短路)
- 没找到返回
undefined;所以元素本身可能是undefined时,find分不清「没找到」和「找到了undefined」 - 判断的是回调返回值,不是元素真假:库存
0的商品照样能找到 - 和
forEach不同,find不跳过空槽,空槽也会以undefined传给回调 - 回调要传齐三个参数并支持
thisArg;ES2023起还有从后往前找的findLast
find 就是从前往后遍历,第一个让回调返回真值的元素直接返回,后面不再遍历;一个都没有就返回 undefined。 手写时要注意判断的是回调的返回值,不是元素本身,所以元素是 0 或空字符串照样能被找到。还有个和直觉相反的点:forEach、filter、map 都会跳过稀疏数组的空槽,但 find 和 findIndex 不跳,空槽会当成 undefined 传进回调。回调的第三个参数和 thisArg 也别漏。如果要从后往前找,现在可以直接用 findLast。
find接收一个方法作为参数,方法内部返回一个条件find会遍历所有的元素,执行你给定的带有条件返回值的函数- 符合该条件的元素会作为
find方法的返回值 - 如果遍历结束还没有符合该条件的元素,则返回
undefined
var users = [
  {id: 1, name: '张三'},
  {id: 2, name: '张三'},
  {id: 3, name: '张三'},
  {id: 4, name: '张三'}
]

Array.prototype.myFind = function (callback) {
  // var callback = function (item, index) { return item.id === 4 }
  for (var i = 0; i < this.length; i++) {
    if (callback(this[i], i)) {
      return this[i]
    }
  }
}

var ret = users.myFind(function (item, index) {
  return item.id === 2
})

console.log(ret)
💬 面试官追问
[1, , 3].find(x => x === undefined)返回什么?和filter一样吗?返回
undefined,而且回调确实在索引1上执行过。find不跳空槽,filter会跳,所以[1, , 3].filter(x => x === undefined)是空数组。手写find时不要加i in arr判断。[0, 1, 2].myFind(x => x === 0)返回0,调用方写if (result)判断找没找到,有什么问题?找到的元素本身是假值,
if会当成没找到。判断要写result !== undefined,元素可能是undefined时就改用findIndex。手写实现里也只能判断回调返回值,不能写成if (this[i] && callback(...))。数组里本来就可能有
undefined,怎么区分「没找到」和「找到的就是undefined」?用
findIndex,没找到是-1,找到了拿到下标再取值。这就是为什么有了find还需要findIndex。想找最后一个满足条件的订单,以前怎么写,现在怎么写?
以前是
[...arr].reverse().find(fn),会复制一份数组;ES2023起直接arr.findLast(fn),还有findLastIndex。老浏览器要配core-js垫片。类数组对象
{ 0: 'a', 1: 'b', length: 2 }能用myFind吗?能,
Array.prototype.myFind.call(obj, fn),只要实现里只用索引和length,不调用数组专属方法。原生find也是这么设计的,所以Array.prototype.find.call(arguments, fn)也能跑。
# 4 实现findIndex方法
⚡ 30 秒速记
- 和
find一样的遍历,命中返回索引i而不是元素 - 没找到必须返回
-1,循环后忘了写return -1,拿到的就是undefined - 和
find别混:find未命中是undefined,findIndex未命中是-1 - 判断存在要写
index !== -1,不能写if (index),命中第0项会被当成没找到 - 只是判断有没有用
some;要的是下标(后面要splice、替换)才用findIndex
findIndex 和 find 遍历方式一样,区别是命中时返回下标,没找到返回 -1。 手写最容易漏的是循环结束后的 return -1,漏了拿到的就是 undefined;用的时候最常见的坑是 if (arr.findIndex(fn)),命中第一项时返回 0,是假值,判断就反了,要写 !== -1。另外 findIndex 和 find 一样不跳空槽。
Array.prototype.myFindIndex = function (callback, thisArg) {
  if (typeof callback !== 'function') throw new TypeError(callback + ' is not a function')
  const len = this.length >>> 0
  for (let i = 0; i < len; i++) {
    // 和 find 一样不跳空槽,空槽当 undefined 传进去
    if (callback.call(thisArg, this[i], i, this)) return i
  }
  return -1 // 未命中必须返回 -1
}

const users = [{ id: 1 }, { id: 2 }, { id: 3 }]
console.log(users.myFindIndex((u) => u.id === 2)) // 1
console.log(users.myFindIndex((u) => u.id === 9)) // -1
console.log(users.myFindIndex((u) => u.id === 1)) // 0,判断存在要写 !== -1
find 和 findIndex 是一对:一个返回元素、未命中 undefined;一个返回下标、未命中 -1。数组里可能存了 undefined 时,只有 findIndex 能分清找没找到。
💬 面试官追问
if (users.findIndex(u => u.id === 1)),id为1的用户就在第一个,结果判断成没找到,为什么?命中第
0项返回0,0是假值。改成if (index !== -1),只是判断有没有的话直接用users.some(u => u.id === 1)更清楚。手写版忘了
return -1,调用方写index === -1判断,会怎样?永远不成立,未命中也被当成找到了,后面
arr[undefined]拿到undefined,或者splice(undefined, 1)把第0项删了。循环结束后补一句return -1。弹确认框前算好了要删的下标,用户点确认时列表已经刷新过了,结果删错了行,怎么修?
下标只在算出来的那一刻有效,列表一排序或者新增就变了。确认回调里按
id重新findIndex一次,或者干脆用filter(item => item.id !== id)按id删。只要第一个异常行的位置,同事先
filter再取下标,有什么问题?filter返回的是元素不是下标,而且要扫完整个数组。findIndex命中就停,十万行数据里异常在前面的话差距很明显。findIndex和indexOf怎么选?indexOf按===比较值,适合原始值数组;对象数组按条件找就用findIndex。还有一个差别:indexOf(NaN)永远是-1,findIndex(Number.isNaN)能找到。
# 5 实现map方法
⚡ 30 秒速记
- 每个元素调用回调,把返回值按同一个下标放进新数组,长度和原数组一样
- 回调参数:
(当前值, 索引, 原数组),支持thisArg;箭头函数的this绑不上 - 空槽保留:
[1, , 3].map(x => x * 2)结果是[2, , 6],回调只执行两次 - 用
push收集结果,空槽会变成真实的undefined;按下标赋值才对 map不负责过滤,回调不return就是undefined;要过滤先filter再map,或用flatMap
map 就是对每个元素调一次回调,把返回值放到新数组的同一个位置上,原数组不动。 所以新数组长度一定和原数组一样,回调不返回东西那个位置就是 undefined。手写时有个细节:原生 map 会保留空槽,[1, , 3].map(x => x * 2) 得到 [2, , 6],回调只跑两次;如果先 slice 再 push,空槽会被当成 undefined 也调一次回调,结果里也变成真实存在的值。我会写成 result[i] = callback.call(thisArg, arr[i], i, arr),并且用 i in arr 跳过空槽。
- 回调函数的参数有哪些,返回值如何处理
- 不修改原来的数组
Array.prototype.myMap = function(callback, context){
  // 转换类数组
  var arr = Array.prototype.slice.call(this),//由于是ES5所以就不用...展开符了
      mappedArr = [],
      i = 0;

  for (; i < arr.length; i++ ){
    // 把当前值、索引、当前数组返回去。调用的时候传到函数参数中 [1,2,3,4].map((curr,index,arr))
    mappedArr.push(callback.call(context, arr[i], i, this));
  }
  return mappedArr;
}
💬 面试官追问
数据清洗时回调里对无效数据不
return,结果数组里多了一堆undefined,为什么?map永远一对一,每个位置都会放回调的返回值,没return就是undefined。要过滤就arr.filter(isValid).map(transform),想一次遍历可以用flatMap,无效项返回[]。['1', '2', '3'].map(parseInt)为什么得到[1, NaN, NaN]?map会传三个参数,parseInt把第二个参数索引当成了进制:parseInt('2', 1)和parseInt('3', 2)都是NaN。写成map(Number)或map(s => parseInt(s, 10))。回调是箭头函数,传了
thisArg读this.rate还是undefined,为什么?箭头函数没有自己的
this,call改不了它,用的是定义时外层的this。要用thisArg就传普通函数,或者干脆闭包读外部变量,更直观。先
Array.prototype.slice.call(this)再遍历,这一步有什么用?把类数组转成真数组,顺便拿到一份快照,遍历中原数组被改了也不影响。但回调第三个参数传的还是
this,回调里看到的原对象和遍历的副本可能对不上,原生map是直接按索引读原对象的。map返回了新数组,是不是就不会影响原数据了?只是数组是新的,元素如果是对象,回调里
item.price = 0一样会改到原数据。要不可变就返回新对象:map(item => ({ ...item, price: 0 }))。
# 6 实现reduce方法
⚡ 30 秒速记
- 回调参数:
(累计值, 当前值, 索引, 原数组),每轮返回值成为下一轮的累计值 - 传了初始值从索引
0开始;没传就拿第一个元素当初始值,从下一个开始 - 判断有没有传初始值要用
arguments.length >= 2,写成initialValue ? ...会把0、''当成没传 - 空数组且没初始值 → 原生抛
TypeError,手写版别静默返回undefined - 也跳过空槽;没传初始值时要找第一个真实存在的元素,不是简单取
arr[0]
reduce 就是拿一个累计值,按顺序跟每个元素做运算,每一轮回调的返回值变成下一轮的累计值,最后返回它。 手写最关键的是判断有没有传初始值,如果写成 initialValue ? initialValue : arr[0],求和时传 0 会被当成没传,起点就错了,要用 arguments.length >= 2 判断。另外两个边界:空数组又没传初始值,原生会直接抛 TypeError,不是返回 undefined;稀疏数组要跳过空槽,没传初始值时从第一个真实存在的元素开始。业务里我的习惯是永远传初始值,省掉这些边界问题。
- 初始值不传怎么处理
- 回调函数的参数有哪些,返回值如何处理。
Array.prototype.myReduce = function (fn, initialValue) {
  if (typeof fn !== 'function') throw new TypeError(fn + ' is not a function')
  const O = Object(this)
  const len = O.length >>> 0
  let i = 0
  let acc

  if (arguments.length >= 2) {
    acc = initialValue // 0、''、false 都是合法初始值
  } else {
    while (i < len && !(i in O)) i++ // 跳过开头的空槽
    if (i >= len) throw new TypeError('Reduce of empty array with no initial value')
    acc = O[i++]
  }

  for (; i < len; i++) {
    if (i in O) acc = fn(acc, O[i], i, O) // 跳过空槽
  }
  return acc
}

console.log([1, 2, 3].myReduce((a, b) => a + b, 0)) // 6
console.log([{ n: 1 }, { n: 2 }].myReduce((s, o) => s + o.n, 0)) // 3,若用 initialValue ? ... 判断会得到 '[object Object]2'
console.log([, 2, 3].myReduce((a, b) => a + b))     // 5
判断初始值不能写成 initialValue ? initialValue : arr[0]:初始值是 0 时,它会把 arr[0] 当初始值、从索引 1 开始,[1, 2, 3].myReduce((a, b) => a + b, 0) 恰好还是 6,但换成 [10].myReduce((acc, x) => acc + x * 2, 0),原生得到 20,这种写法得到 10,差别就暴露出来了。
💬 面试官追问
手写版
reduce算订单总额,传了初始值0,结果成了[object Object]20,为什么?多半是用了
initialValue ? initialValue : arr[0],0是假值,被当成没传,于是拿第一个订单对象当累计值,对象加数字就变成了字符串拼接。改成const hasInit = arguments.length >= 2。[].reduce((a, b) => a + b)原生会怎样?手写版应该怎么做?抛
TypeError: Reduce of empty array with no initial value。手写版要对齐:没初始值又找不到任何元素就抛错。业务上求和就传0,别依赖默认行为。按状态分组时,第二轮开始累计值变成了
undefined,最可能哪里写错了?回调忘了
return acc。比如(acc, item) => { acc[item.status] = ...; },没返回值,下一轮拿到的就是undefined。用箭头函数可以写成(acc, item) => (acc[item.status] = ..., acc),不过可读性一般,老老实实写return。团队想把所有
map、filter都改成reduce统一风格,你同意吗?不同意。
reduce适合把一组数据折叠成一个值,比如求和、分组、转成对象;纯转换用map、筛选用filter一眼就看懂。全写成reduce要读完整个回调才知道在干什么,还容易漏return。用
reduce串行执行一组异步任务怎么写?tasks.reduce((p, task) => p.then(task), Promise.resolve()),累计值是一个Promise,每一轮接在上一个后面。现在更推荐for...of加await,可读性好得多。
# 7 实现every方法
⚡ 30 秒速记
every= 全部为真才true,碰到第一个假值立刻返回false(短路)- 回调收三个参数
(value, index, array),第二个参数thisArg绑定回调里的this - 空数组直接返回
true:「所有元素都满足」在没有元素时成立 - 原生会跳过稀疏数组的空槽,手写版要加
if (!(i in this)) continue - 别写
context = window默认值,Node/SSR下直接ReferenceError,默认就让它是undefined
every 就是「全员通过才算过」,循环里只要有一个回调返回假值,马上停下返回 false。 手写时我会先把 length 存下来,逐项用 callback.call(thisArg, this[i], i, this) 调用,遇到假值直接 return false,跑完再 return true。两个细节面试官爱问:空数组返回 true,这是数学上全称判断的空集语义,不是实现错了;原生实现会用 i in O 跳过空槽,[1, , 3].every(x => x > 0) 是 true。也别给 thisArg 设默认值 window,服务端没有 window。
遍历开始前记录长度,逐项检查属性是否存在,遇到假值立即短路。 这里使用独立函数,以免在全局修改数组原型;用 call 将数组或类数组作为接收者。
function myEvery(callback, thisArg) {
  'use strict'
  if (this == null) throw new TypeError('receiver is null or undefined')
  const object = Object(this)
  const rawLength = +object.length
  const length = Number.isNaN(rawLength) || rawLength <= 0
    ? 0 : Math.min(Math.floor(rawLength), Number.MAX_SAFE_INTEGER)
  if (typeof callback !== 'function') throw new TypeError('callback must be callable')
  for (let index = 0; index < length; index++) {
    if (index in object && !callback.call(thisArg, object[index], index, object)) return false
  }
  return true
}
console.log(myEvery.call([], value => value > 0)) // true
console.log(myEvery.call([1, , 3], value => value > 0)) // true
console.log(myEvery.call([1, -1, 3], value => value > 0)) // false
空槽被跳过,但原型链上存在的同索引属性仍可参与,因为检查使用 in。遍历中新增的尾部元素超出初始长度时不参与,尚未访问的元素被删除则可能跳过。回调抛错向外传播,不转成 false。
长度按非负整数范围处理,不能用位运算截成 32 位后声称等同原生。thisArg 默认 undefined,严格与非严格回调如何处理 this 由函数调用规则决定。异步回调返回 Promise 对象会被当成真值,因此该方法不是异步校验器。
💬 面试官追问
表单里一项都没填,
rules.every(check)返回了true,这是实现错了吗?没错,空数组的
every就该是true,原生也一样。产品要求至少填一项,就单独判list.length > 0 && list.every(check),别去改通用方法。规则有一万条,第二条就失败了,还想把所有失败原因都收集起来,能用
every吗?不能。
every的意义就是短路,你要全量诊断就该用filter(r => !r.check(v))拿到失败列表,再看长度。两个需求硬塞进一个every,最后不是性能差就是语义乱。回调返回了字符串
'false',every却当成通过了,为什么?every只看真假值,非空字符串'false'是真值。锅在规则配置层,让回调返回布尔值,或者显式写return v === true,通用方法里不要去猜字符串含义。!items.some(isInvalid)和items.every(isValid)有区别吗?当
isInvalid恰好表示isValid的否定、且回调没有改变判断的副作用时,两者逻辑等价;都能短路,空数组也都返回true。选哪个看业务怎么描述:「全部有效」写every,「不存在非法项」写!some,读代码的人不用在脑子里再翻译一遍。手写版里
thisArg要不要默认成globalThis?不要。原生的行为是不传就是
undefined,回调是非严格模式时引擎自己会换成全局对象,严格模式下就是undefined。你手动塞globalThis反而改变了严格模式下的语义。
# 8 实现some方法
⚡ 30 秒速记
some= 有一个为真就true,命中立刻返回;全部跑完都没命中才false- 和
every镜像:every遇假短路,some遇真短路 - 空数组返回
false:一个元素都没有,自然「不存在满足条件的」 - 贴近原生的三个细节:
i in O跳过空槽、开始前快照length、thisArg默认undefined - 回调抛错要原样往外抛,不能吞掉当成
false
some 就是「有一个就行」,回调第一次返回真值时直接 return true,跑完都没命中再返回 false。 它和 every 是一对镜像,空数组时 every 是 true、some 是 false,这个面试很爱问。手写版本我会补三处:用 i in O 跳过空槽,因为 [, , {stock: 1}] 原生只会调用一次回调;开始前把 length 存下来,遍历中 push 的元素不参与;thisArg 不传就是 undefined,别写 context = window。
Array.prototype.mySome=function(callback, context = window){
 			var len = this.length,
 			    flag=false,
           i = 0;

 			for(;i < len; i++){
				if(callback.apply(context, [this[i], i , this])){
					flag=true;
					break;
				}
 			}
 			return flag;
		}

		// var flag=arr.mySome((v,index,arr)=>v.num>=10,obj)
		// console.log(flag);
💬 面试官追问
[, , {stock: 1}].some(fn)原生只调了一次回调,你的手写版调了三次,差在哪?原生会先判断
i in O,空槽不存在这个属性就跳过。手写版只比下标,读空槽拿到undefined还照样调回调,加一行if (!(i in O)) continue就对齐了。回调里往数组
push了新元素,some会遍历到吗?不会。原生在开始时就把
length定下来了,新加的不参与本轮;但遍历中被删掉的索引会被i in O判掉,不会再调用。手写版先const len = O.length >>> 0就能对上。回调里接口报错,结果
some返回了false,你觉得合理吗?不合理,我会直接拦。「没有元素满足」和「判断过程挂了」是两回事,
some里别包try/catch,异常原样抛出去,调用方自己决定重试还是降级。业务里就判断一下有没有库存商品,有必要把原生语义全抄一遍吗?
看用途。要当
polyfill挂到Array.prototype上,就得把空槽、长度快照、thisArg都对齐,还要拿原生结果做对照测试;只是业务里用,直接list.some(i => i.stock > 0)就完了,别自己造轮子。那
find和some怎么选?只要一个是否存在的布尔值用
some;要拿到那个元素用find。注意find不跳过空槽,会把空槽当undefined传给回调,这点和some不一样。
# 9 实现数组扁平化flat方法
⚡ 30 秒速记
- 首选
arr.flat(Infinity)(ES2019),要控制层数就传数字,默认只拍一层 - 手写主线:遍历 → 是数组就递归展开,不是就
push;reduce + concat是同一思路的写法 - 嵌套很深用显式栈迭代,递归可能爆栈
JSON.stringify后删括号再split是坑:元素全变成字符串,示例里第二种正则/(\[\]))/g括号不配对,直接SyntaxError- 原生
flat会跳过空槽,while + some + concat每轮要扫一遍整个数组
扁平化的本质就一句话:遍历元素,是数组就继续往里拆,不是就收进结果。 生产代码直接用 arr.flat(Infinity);手写我一般给递归版,带一个 depth 参数,depth > 0 且是数组才继续拆,这样「拍平两层」也能覆盖。字符串替换那几种看着短,其实都是错的:[1, [2]] 处理完变成 ['1', '2'],类型丢了,元素里本身带逗号的字符串还会被切开。数据嵌套几千层时递归会爆栈,改成手动维护一个栈就行。
题目描述: 实现一个方法使多维数组变成一维数组
let ary = [1, [2, [3, [4, 5]]], 6];
let str = JSON.stringify(ary);
第0种处理:直接的调用
arr_flat = arr.flat(Infinity);
第一种处理
ary = str.replace(/(\[|\])/g, '').split(',');
第二种处理
str = str.replace(/(\[\]))/g, '');
str = '[' + str + ']';
ary = JSON.parse(str);
第三种处理:递归处理
let result = [];
let fn = function(arr) {
  for(let i = 0; i < arr.length; i++) {
    let item = arr[i];
    if (Array.isArray(arr[i])){
      fn(item);
    } else {
      result.push(item);
    }
  }
}
第四种处理:用 reduce 实现数组的 flat 方法
function flatten(ary) {
    return ary.reduce((pre, cur) => {
        return pre.concat(Array.isArray(cur) ? flatten(cur) : cur);
    }, []);
}
let ary = [1, 2, [3, 4], [5, [6, 7]]]
console.log(flatten(ary))
第五种处理:能用迭代的思路去实现
function flatten(arr) {
  if (!arr.length) return;
  while (arr.some((item) => Array.isArray(item))) {
    arr = [].concat(...arr);
  }
  return arr;
}
// console.log(flatten([1, 2, [1, [2, 3, [4, 5, [6]]]]]));
第六种处理:扩展运算符
while (ary.some(Array.isArray)) {
  ary = [].concat(...ary);
}
几种写法的真实效果对比:
const ary = [1, [2, [3, [4, 5]]], 6]

// 原生:ES2019 起支持,默认只拍一层
ary.flat()         // [1, 2, [3, [4, 5]], 6]
ary.flat(Infinity) // [1, 2, 3, 4, 5, 6]

// 字符串替换:类型全丢
JSON.stringify(ary).replace(/(\[|\])/g, '').split(',')
// ['1', '2', '3', '4', '5', '6']  ← 全是字符串

// 带深度的递归版
function flatten(arr, depth = 1) {
  const res = []
  for (const item of arr) {
    if (Array.isArray(item) && depth > 0) res.push(...flatten(item, depth - 1))
    else res.push(item)
  }
  return res
}
flatten(ary, Infinity) // [1, 2, 3, 4, 5, 6]

// 显式栈:不受递归深度限制
function flattenIter(arr) {
  const stack = [...arr], res = []
  while (stack.length) {
    const item = stack.pop()
    Array.isArray(item) ? stack.push(...item) : res.push(item)
  }
  return res.reverse()
}
示例「第二种处理」里的正则 /(\[\]))/g 多了一个右括号,引擎会直接抛 SyntaxError: Unmatched ')';即使改成 /(\[|\])/g 再 JSON.parse,也只适合元素是简单数字的情况。
💬 面试官追问
把数组
JSON.stringify后删掉方括号再按逗号切,有什么问题?它不是按结构处理,而是按文本处理。数字、
null、布尔值全变成字符串,'a,b'这种元素还会被切成两个,undefined和函数会变成null。需求从「完全拍平」改成「只拍平两层」,递归版怎么改?
加一个
depth参数:flatten(arr, depth = 1),遇到数组且depth > 0时调用flatten(item, depth - 1),否则原样push。这就是原生flat(depth)的语义。嵌套一万层的数据,递归版报
Maximum call stack size exceeded,怎么办?换成显式栈:
const stack = [...arr],每次pop出一个,是数组就stack.push(...item),不是就放进结果,最后reverse()。调用栈不再随深度增长。数组里引用了自己,比如
a.push(a),flat(Infinity)会怎样?会一直展开下去直到内存或栈撑不住。手写版可以在当前递归路径上用
Set记录正在处理的数组,碰到环就抛错;不要对所有见过的数组去重,同一个子数组出现在两个位置是合法的。reduce + concat和递归push哪个更好?递归
push更快。concat每一轮都新建一个数组并复制已有内容,数据量大时中间数组很多;reduce写法胜在一行能写完,面试展示思路没问题。
# 10 实现Array.isArray方法
⚡ 30 秒速记
- 原理:
Object.prototype.toString.call(v) === '[object Array]' - 为什么不用
instanceof Array:跨iframe的数组用的是另一个Array构造函数,会判成false - 必须借
Object.prototype上的toString,对象自己的toString可能被改写 - 能被伪造:
{ [Symbol.toStringTag]: 'Array' }也会返回[object Array],原生Array.isArray不会上当 - 现代环境直接用
Array.isArray,垫片要先if (!Array.isArray)再挂
手写 Array.isArray 就是借 Object.prototype.toString 拿到内部类型标签,跟 '[object Array]' 比一下。 为什么不用 instanceof?因为每个 iframe 都有自己的一套 Array,从子页面传上来的数组 instanceof Array 是 false,而 toString 看的是内部类型,不认构造函数。不过它也不完美,ES6 之后对象可以通过 Symbol.toStringTag 自定义标签,{ [Symbol.toStringTag]: 'Array' } 就能骗过它。所以这个写法讲原理可以,生产里还是直接用原生 Array.isArray。
Array.myIsArray = function(o) {
  // 调用顶级对象上的toString方法转成[object Array]形式
  return Object.prototype.toString.call(o) === '[object Array]';
};

console.log(Array.myIsArray([])); // true
💬 面试官追问
子
iframe传上来的数组,arr instanceof Array为什么是false?instanceof是沿原型链找当前页面的Array.prototype,子页面的数组原型是它自己那个Array.prototype,两个不是同一个对象。Array.isArray和toString方案都不依赖构造函数,所以能判对。arguments和{0: 'a', length: 1}应该返回true吗?不应该,它们是类数组,有索引和
length,但没有map、push这些方法。业务要的是「能遍历」就用Array.from先转一下,不要把类型判断改宽。有人能让
Object.prototype.toString.call(obj)返回[object Array]吗?能,给对象加
[Symbol.toStringTag]: 'Array'就行。原生Array.isArray走的是引擎内部的IsArray判断,不看这个标签,所以做校验边界一定用原生。为什么不直接调
o.toString()?数组自己的
toString返回的是'1,2,3',不是类型标签;而且对象可能重写了toString,null和undefined直接调还会报错。Object.prototype.toString.call(o)绕开了这些问题。Proxy包了一层的数组,Array.isArray认吗?认,
Array.isArray(new Proxy([], {}))是true,规范里IsArray会穿透Proxy看目标对象。toString方案在这里结果也是[object Array]。
# 11 实现Array.of方法
⚡ 30 秒速记
Array.of(...items):传几个参数就是几个元素,没有歧义- 解决的是
Array(3)的坑:单个数字参数会被当成长度,得到 3 个空槽;Array.of(3)是[3] - 手写:
[].slice.call(arguments),现代写法(...items) => items - 零参数是
[],显式传undefined是[undefined],参数个数要原样保留 - 原生还支持子类:
Array.of.call(MyArray, 1, 2)返回MyArray实例,简单手写版做不到
Array.of 就是把你传进来的参数原样排成一个数组,专门用来补 Array() 构造函数的坑。 Array(3) 会把 3 当成长度,得到 [ <3 empty items> ];Array(3, 4) 却又是 [3, 4],参数个数一变语义就变。Array.of 不管几个参数都当元素,Array.of(3) 就是 [3]。手写最简单的是 [].slice.call(arguments),现在我会直接写成剩余参数 function ArrayOf(...items) { return items },意图更清楚。
Array.of()方法用于将一组值,转换为数组
- 这个方法的主要目的,是弥补数组构造函数
Array()的不足。因为参数个数的不同,会导致Array()的行为有差异。 Array.of()基本上可以用来替代Array()或new Array(),并且不存在由于参数不同而导致的重载。它的行为非常统一
Array.of(3, 11, 8) // [3,11,8]
Array.of(3) // [3]
Array.of(3).length // 1
实现
function ArrayOf(){
  return [].slice.call(arguments);
}
💬 面试官追问
Array(3)和Array.of(3)结果有什么不同?Array(3)是长度3的稀疏数组,map都不会执行;Array.of(3)是[3],长度1。想要「长度为 3 且填满」写Array.from({ length: 3 }, (_, i) => i)。arguments和剩余参数,手写时选哪个?剩余参数。
...items本来就是真数组,不用借slice;箭头函数也没有自己的arguments,用剩余参数才写得出箭头版本。只有要兼容不转译的老环境才用arguments。ArrayOf()和ArrayOf(undefined)结果一样吗?不一样,一个是
[],一个是[undefined],长度不同。如果下游JSON.stringify后再比较,[undefined]会变成[null],排查缓存或比对逻辑时要注意这一层。原生
Array.of.call(MyArray, 1, 2)和你的手写版有什么差别?原生会把
this当构造函数,返回MyArray的实例,这样继承Array的子类调MyArray.of(1, 2)拿到的还是子类。slice版不管this是谁都返回普通数组。固定两个值的时候,还要写
Array.of(a, b)吗?不用,直接
[a, b]。Array.of的价值在参数个数动态、而且可能只有一个数字的场景,比如工具函数统一把参数转成数组。
# 12 数组去重方法汇总
⚡ 30 秒速记
- 基本值去重首选
[...new Set(arr)],O(n)、保留首次出现顺序、不改原数组 filter + indexOf:arr.indexOf(item) === index才是首次出现;示例代码写成arr.includes(item)恒为真,等于没去重- 双层循环 +
splice是O(n^2),还会改原数组,用==比较时1和'1'也会被当重复 - 特殊值:
Set把多个NaN合成一个;indexOf找不到NaN,用它过滤会把NaN全删掉 - 对象数组按字段去重用
Map记录key,别用普通对象('__proto__'、'toString'会撞上原型属性)
普通值数组去重我直接 [...new Set(arr)],一行搞定,还保留首次出现的顺序。 其他写法要能说出各自的坑:双层循环 O(n^2) 还改原数组;filter 要比的是 indexOf(item) === index,示例那个 includes(item) 对当前元素永远是 true,一个都删不掉;indexOf 内部用严格相等,NaN !== NaN,结果是所有 NaN 被全部过滤掉。对象数组 Set 管不了,它按引用比较,要按某个字段去重就用 Map 记 key,比如 new Map(list.map(i => [i.id, i]))。
首先:我知道多少种去重方式
1. 双层 for 循环
function distinct(arr) {
    for (let i=0, len=arr.length; i<len; i++) {
        for (let j=i+1; j<len; j++) {
            if (arr[i] == arr[j]) {
                arr.splice(j, 1);
                // splice 会改变数组长度,所以要将数组长度 len 和下标 j 减一
                len--;
                j--;
            }
        }
    }
    return arr;
}
思想: 双重
for循环是比较笨拙的方法,它实现的原理很简单:先定义一个包含原始数组第一个元素的数组,然后遍历原始数组,将原始数组中的每个元素与新数组中的每个元素进行比对,如果不重复则添加到新数组中,最后返回新数组;因为它的时间复杂度是O(n^2),如果数组长度很大,效率会很低
2. Array.filter() 加 indexOf/includes
function distinct(a, b) {
    let arr = a.concat(b);
    return arr.filter((item, index)=> {
        //return arr.indexOf(item) === index
        return arr.includes(item)
    })
}
思想: 利用
indexOf检测元素在数组中第一次出现的位置是否和元素现在的位置相等,如果不等则说明该元素是重复元素
3. ES6 中的 Set 去重
function distinct(array) {
   return Array.from(new Set(array));
}
思想: ES6 提供了新的数据结构 Set,Set 结构的一个特性就是成员值都是唯一的,没有重复的值。
4. reduce 实现对象数组去重复
var resources = [
    { name: "张三", age: "18" },
    { name: "张三", age: "19" },
    { name: "张三", age: "20" },
    { name: "李四", age: "19" },
    { name: "王五", age: "20" },
    { name: "赵六", age: "21" }
]
var temp = {};
resources = resources.reduce((prev, curv) => {
 // 如果临时对象中有这个名字,什么都不做
 if (temp[curv.name]) {

 }else {
    // 如果临时对象没有就把这个名字加进去,同时把当前的这个对象加入到prev中
    temp[curv.name] = true;
    prev.push(curv);
 }
 return prev
}, []);
console.log("结果", resources);
这种方法是利用高阶函数
reduce进行去重, 这里只需要注意initialValue得放一个空数组[],不然没法push
💬 面试官追问
arr.filter(item => arr.includes(item))为什么一个都没去掉?当前元素本来就在数组里,
includes恒为true。要判断「是不是第一次出现」,写(item, i) => arr.indexOf(item) === i。[NaN, NaN, 1]用indexOf过滤和用Set,结果各是什么?indexOf版是[1],NaN被全删了,因为indexOf(NaN)永远是-1;Set版是[NaN, 1]。Set用的是SameValueZero,NaN等于自己,0和-0也算同一个。两个字段完全相同的对象,
new Set(objects)能去掉吗?去不掉,
Set对对象比的是引用。要先定义「什么算重复」,比如按id或者name + age,然后用Map以这个key去重。按
name去重时有个用户名叫__proto__,结果这条被吞了,为什么?temp['__proto__']读到的是Object.prototype,真值,代码就以为已经存在。换成Map,或者Object.create(null)建一个没有原型的对象。十万条数据要去重,还要保留最后一次出现的那条,怎么写?
new Map(list.map(i => [i.id, i])),后面的同key会覆盖值,O(n)。注意覆盖不会改变key的位置,结果顺序还是首次出现的顺序;要按最后出现排就先delete再set。
# 13 对象数组如何去重
⚡ 30 秒速记
- 先定「什么算重复」:通常按
id这种唯一标识 - 示例
reduce每轮都acc.map+includes+ 展开新数组,整体O(n^2),几万条就卡 - 改成
Set记已出现的id:一次遍历,has/add都是O(1) - 保留首条还是末条要先问清:首条用
Set,末条用Map覆盖 - 组合键别直接拼字符串,
'a|b' + 'c'和'a' + 'b|c'会撞
对象数组去重的关键不是写法,而是先定义「什么算同一个对象」,通常就是按 id。 示例那个 reduce 能跑,但每一轮都要把累积结果 map 成 id 数组再 includes,还 [...acc, cur] 复制一遍,数据一多就是 O(n^2)。我一般写成一次遍历加一个 Set:seen.has(item.id) 就跳过,否则 add 再 push。产品如果要保留最新的一条,就换成 Map,后来的覆盖前面的。
根据每个对象的某一个具体属性来进行去重
const responseList = [
  { id: 1, a: 1 },
  { id: 2, a: 2 },
  { id: 3, a: 3 },
  { id: 1, a: 4 },
];
const result = responseList.reduce((acc, cur) => {
    const ids = acc.map(item => item.id);
    return ids.includes(cur.id) ? acc : [...acc, cur];
}, []);
console.log(result); // -> [ { id: 1, a: 1}, {id: 2, a: 2}, {id: 3, a: 3} ]
💬 面试官追问
同一个
id出现两次,产品要保留后面那条更新的,示例代码哪里不对?示例遇到重复就直接返回原累积数组,保留的是第一条。改成
Map:new Map(list.map(i => [i.id, i])).values(),后写的覆盖先写的。后台一次加载三万条,用示例那个
reduce去重页面卡住了,怎么改?每轮
acc.map和[...acc, cur]都在复制,三万条就是几亿次操作。换成const seen = new Set(),filter(i => !seen.has(i.id) && seen.add(i.id)),一趟就完。唯一键变成
shopId + orderNo,直接a + b拼起来可以吗?可能撞键,
'1' + '23'和'12' + '3'都是'123'。至少加一个两边字段里都不会出现的分隔符,或者用JSON.stringify([a, b])当key。有的
id是数字1,有的是字符串'1',去重结果不对,问题出在哪?Set和Map区分1和'1',普通对象的属性键却会把它们都变成'1'。这是上游数据契约的问题,应该在入口统一类型,去重函数别去猜。去重后还要按原顺序展示,
Map能保证吗?能,
Map按key第一次插入的顺序迭代。但重复set同一个key不会把它挪到末尾,这点要跟产品对清楚。
# 14 数组中的数据根据key去重
⚡ 30 秒速记
- 通用
dedup(data, getKey):把「怎么取key」交给调用方,去重逻辑只写一份 - 用普通对象存
key再Object.values返回,有两个坑:整数key会被重新排序,'__proto__'/'toString'撞原型属性 - 改用
Set记key+ 结果数组push:顺序稳定、没有原型问题 getKey返回对象时Set按引用比,两个内容相同的新对象去不掉- 保留首条 / 末条 / 合并,最好做成参数,不要写死在函数里
dedup 的思路是把「怎么取 key」抽成参数,调用方传 item => item.id,函数只负责按 key 去重。 如果用普通对象当字典再 Object.values,有个很隐蔽的坑:普通对象里像整数的 key 会按数字升序排,id 是 3, 1, 2 进来,出去就变成 1, 2, 3,顺序被打乱了。另外 '__proto__' 会读到原型对象,被当成已存在。我会用 const seen = new Set(),遍历时 seen.has(key) 就跳过,否则 add 并 push 原元素,顺序和语义都干净。
给定一个任意数组,实现一个通用函数,让数组中的数据根据 key 排重:
const dedup = (data, getKey = () => {} ) => {
  // todo
}
let data = [
  { id: 1, v: 1 },
  { id: 2, v: 2 },
  { id: 1, v: 1 },
];

// 以 id 作为排重 key,执行函数得到结果
// data = [
//   { id: 1, v: 1 },
//   { id: 2, v: 2 },
// ];
实现
const dedup = (data, getKey = () => { }) => {
    const dateMap = data.reduce((pre, cur) => {
        const key = getKey(cur)
        if (!pre[key]) {
            pre[key] = cur
        }
        return pre
    }, {})
    return Object.values(dateMap)
}
使用
let data = [
    { id: 1, v: 1 },
    { id: 2, v: 2 },
    { id: 1, v: 1 },
];
console.log(dedup(data, (item) => item.id))

// 以 id 作为排重 key,执行函数得到结果
// data = [
//   { id: 1, v: 1 },
//   { id: 2, v: 2 },
// ];
💬 面试官追问
用
Object.values(map)返回结果,为什么输出顺序和输入不一样?普通对象的整数键会按数字升序枚举,字符串键才按插入顺序。
id是数字时顺序必乱,用Set加结果数组,或者用Map再[...map.values()]。getKey返回的是'__proto__'或'toString',if (!pre[key])会怎样?都能读到继承来的属性,真值,这条数据就被当成重复丢掉了。
Map没有这个问题,非要用对象就Object.create(null)再配合Object.hasOwn判断。getKey写成item => ({ tenantId: item.t, id: item.id }),为什么去不掉?每次都返回一个新对象,
Set和Map按引用比较,永远不相等。getKey要返回原始值,比如item.t + ':' + item.id。getKey计算挺重的,你的实现会对每个元素调几次?只调一次,算出来就用。别在
filter里调一次、findIndex里又调一次,选择器有副作用或者开销大时结果会不稳定。有的场景要保留第一条,有的要最后一条,还有要合并的,怎么设计?
加一个冲突策略参数,比如
dedup(data, getKey, (oldItem, newItem) => newItem),默认保留旧的。getKey管「是不是同一个」,策略函数管「留哪个」,各自好测。
# 15 类数组转化为数组的方法
⚡ 30 秒速记
- 首选
Array.from(x)或[...x],意图最清楚 - 区别:展开运算符要求可迭代(
Symbol.iterator),Array.from类数组和可迭代都吃 {0: 'a', length: 1}这种纯类数组只能Array.from或Array.prototype.slice.call,展开会报不可迭代Array.apply(null, [5])得到的是长度5的空数组,不是[5];concat.apply还会把子数组拍平一层apply系列把元素当函数实参传,元素太多(十几万)会RangeError
类数组转数组,我默认用 Array.from,可迭代对象也可以直接 [...x]。 两者差别在于展开运算符走的是迭代协议,NodeList、arguments、Set 都可迭代所以没问题,但一个只有索引和 length 的普通对象展开会直接报 is not iterable,Array.from 却能转。slice.call 是 ES5 时代的写法,现在一般只在老代码里见到。Array.apply 和 concat.apply 别用:前者只有一个数字元素时会变成 Array(n),后者会把元素里的数组拍平一层,结果都不是你想要的。
const arrayLike=document.querySelectorAll('div')

// 1.扩展运算符
[...arrayLike]
// 2.Array.from
Array.from(arrayLike)
// 3.Array.prototype.slice
Array.prototype.slice.call(arrayLike)
// 4.Array.apply
Array.apply(null, arrayLike)
// 5.Array.prototype.concat
Array.prototype.concat.apply([], arrayLike)
💬 面试官追问
[...{0: 'a', length: 1}]为什么报错,Array.from却可以?展开运算符只认迭代协议,这个对象没有
Symbol.iterator。Array.from会先看有没有迭代器,没有就按length和索引去读,所以两种都能转。Array.apply(null, arrayLike)有什么坑?它是把元素当参数传给
Array构造函数。arrayLike只有一个数字时,比如[5],结果是长度5的空数组;元素太多还会超出参数上限报RangeError。把
NodeList转成数组后要map一下,怎么写最简洁?Array.from(nodeList, el => el.textContent),第二个参数就是映射函数,少生成一个中间数组。只遍历不变换的话,NodeList本身就有forEach,连转都不用转。工具函数后来还要接收生成器,
slice.call还能用吗?不能,生成器没有
length和索引,slice.call拿到的是空数组。Array.from两种都支持,但要注意生成器是一次性的,转完就被消费了,无限生成器会直接卡死。Array.prototype.concat.apply([], arguments)和Array.from(arguments)结果一定一样吗?不一定。
arguments里如果有数组,concat会把它展开一层,concat.apply([], [[1, 2], 3])得到[1, 2, 3],而Array.from是[[1, 2], 3]。
# 16 reduce用法汇总
⚡ 30 秒速记
reduce((acc, cur, i, arr) => 新acc, 初值):每轮返回值就是下一轮的acc,最后归并成一个值- 不传初值:第一个元素当
acc,从第二个开始;空数组不传初值直接TypeError - 初值决定结果类型:求和给
0,转对象给{},归组给new Map() - 常见用法:求和 / 最大值 / 数组转对象 / 计数 / 扁平 /
compose - 示例里求最大值有问题:参数叫
next却用了cur;初值0遇到全负数也会错
reduce 就是拿一个累加器把数组从头滚到尾,每轮回调的返回值会变成下一轮的累加器,最后得到一个值。 我写的时候几乎都会传初值,一是空数组不传会直接抛 Reduce of empty array with no initial value,二是初值决定了结果长什么样,求和给 0,转对象给 {}。示例里求最大值那行 (pre, next) => pre > cur ? pre : cur 直接会报 cur is not defined,而且初值给 0,数组全是负数就会返回 0,正确写法是 arr.reduce((a, b) => Math.max(a, b)),空数组单独处理。
语法
array.reduce(function(total, currentValue, currentIndex, arr), initialValue);
/*
  total: 必需。初始值, 或者计算结束后的返回值。
  currentValue: 必需。当前元素。
  currentIndex: 可选。当前元素的索引;
  arr: 可选。当前元素所属的数组对象。
  initialValue: 可选。传递给函数的初始值,相当于total的初始值。
*/
reduceRight()该方法用法与reduce()其实是相同的,只是遍历的顺序相反,它是从数组的最后一项开始,向前遍历到第一项
1. 数组求和
const arr = [12, 34, 23];
const sum = arr.reduce((total, num) => total + num);

// 设定初始值求和
const arr = [12, 34, 23];
const sum = arr.reduce((total, num) => total + num, 10);  // 以10为初始值求和


// 对象数组求和
var result = [
  { subject: 'math', score: 88 },
  { subject: 'chinese', score: 95 },
  { subject: 'english', score: 80 }
];
const sum = result.reduce((accumulator, cur) => accumulator + cur.score, 0);
const sum = result.reduce((accumulator, cur) => accumulator + cur.score, -10);  // 总分扣除10分
2. 数组最大值
const a = [23,123,342,12];
const max = a.reduce((pre,next)=>pre>cur?pre:cur,0); // 342
3. 数组转对象
var streams = [{name: '技术', id: 1}, {name: '设计', id: 2}];
var obj = streams.reduce((accumulator, cur) => {accumulator[cur.id] = cur; return accumulator;}, {});
4. 扁平一个二维数组
var arr = [[1, 2, 8], [3, 4, 9], [5, 6, 10]];
var res = arr.reduce((x, y) => x.concat(y), []);
5. 数组去重
实现的基本原理如下:

① 初始化一个空数组
② 将需要去重处理的数组中的第1项在初始化数组中查找,如果找不到(空数组中肯定找不到),就将该项添加到初始化数组中
③ 将需要去重处理的数组中的第2项在初始化数组中查找,如果找不到,就将该项继续添加到初始化数组中
④ ……
⑤ 将需要去重处理的数组中的第n项在初始化数组中查找,如果找不到,就将该项继续添加到初始化数组中
⑥ 将这个初始化数组返回
var newArr = arr.reduce(function (prev, cur) {
    prev.indexOf(cur) === -1 && prev.push(cur);
    return prev;
},[]);
6. 对象数组去重
const dedup = (data, getKey = () => { }) => {
    const dateMap = data.reduce((pre, cur) => {
        const key = getKey(cur)
        if (!pre[key]) {
            pre[key] = cur
        }
        return pre
    }, {})
    return Object.values(dateMap)
}
7. 求字符串中字母出现的次数
const str = 'sfhjasfjgfasjuwqrqadqeiqsajsdaiwqdaklldflas-cmxzmnha';

const res = str.split('').reduce((pre,next)=>{
 pre[next] ? pre[next]++ : pre[next] = 1
 return pre
},{})
// 结果
-: 1
a: 8
c: 1
d: 4
e: 1
f: 4
g: 1
h: 2
i: 2
j: 4
k: 1
l: 3
m: 2
n: 1
q: 5
r: 1
s: 6
u: 1
w: 2
x: 1
z: 1
8. compose函数
redux compose源码实现
function compose(...funs) {
    if (funs.length === 0) {
        return arg => arg;
    }
    if (funs.length === 1) {
       return funs[0];
    }
    return funs.reduce((a, b) => (...arg) => a(b(...arg)))
}
💬 面试官追问
[].reduce((a, b) => a + b)为什么报错,有数据时却正常?不传初值时,
reduce会拿第一个元素当累加器,空数组拿不到就抛TypeError。求和传0就完了,空数组返回0。[-3, -1, -7].reduce((a, b) => a > b ? a : b, 0)返回多少?返回
0,数组里根本没有这个数。初值不是随便给的,求最大值要么不传初值,要么给-Infinity。用
reduce加acc.concat(row.items)合并几十批数据,内存抖得厉害,为什么?concat每轮都新建数组并把已有内容复制一遍,批次越多中间数组越多。改成acc.push(...row.items); return acc,累加器是函数内部新建的,原地改没问题。compose(a, b, c)(x)是先执行a还是c?先执行
c,等价于a(b(c(x))),reduce((f, g) => (...args) => f(g(...args)))构造的是从右往左的组合。想要从左往右的管道就写pipe,用reduceRight或者把f和g对调。有人要把所有
for循环都改成reduce,你同意吗?不同意。
reduce没法中途break,需要「找到就停」的逻辑用some、find或for...of更直接;分支多的逻辑塞进reduce,累加器会变成一个谁都看不懂的状态包。
# 30 正则相关
# 1 实现千位分隔符
⚡ 30 秒速记
- 整数部分用正则
/\d(?=(\d{3})+$)/g替换成'$&,':后面还剩 3 的整数倍位数的数字后面插逗号 - 小数部分不参与分组,先
split('.')拆开再拼 - 有小数才拼
'.',否则123456789会输出'123,456,789.' - 生产直接用
Intl.NumberFormat/toLocaleString,能控制小数位和地区格式 toFixed是舍入不是截断,1.005.toFixed(2)还是'1.00'(二进制精度);超过2^53的金额要用字符串传
千分位的核心就是那个正则:从整数部分的右边往左数,每三位前面插一个逗号。 /\d(?=(\d{3})+$)/g 的意思是匹配一个数字,前提是它后面跟着 3 的整数倍个数字直到结尾,然后 '$&,' 在它后面补逗号。小数部分要拆出来单独拼。如果最后无条件拼 '.',整数会多出一个尾巴点,所以要写成 decimal ? grouped + '.' + decimal : grouped。实际项目里我直接用 num.toLocaleString('en-US', { maximumFractionDigits: 3 }),负数、小数位、地区差异都帮你处理了。
// 保留三位小数
parseToMoney(1234.56); // return '1,234.56'
parseToMoney(123456789); // return '123,456,789'
parseToMoney(1087654.321); // return '1,087,654.321'
function parseToMoney(num) {
  const n = Number(num)
  if (!Number.isFinite(n)) return '--'
  const [integer, decimal] = String(parseFloat(n.toFixed(3))).split('.')
  const grouped = integer.replace(/\d(?=(\d{3})+$)/g, '$&,')
  return decimal ? `${grouped}.${decimal}` : grouped
}

parseToMoney(1234.56)      // '1,234.56'
parseToMoney(123456789)    // '123,456,789',没有小数就不拼点
parseToMoney(-1087654.321) // '-1,087,654.321',负号不是数字,不影响分组

// 生产推荐
(1087654.321).toLocaleString('en-US', { maximumFractionDigits: 3 }) // '1,087,654.321'
new Intl.NumberFormat('de-DE').format(1234.5) // '1.234,5'
正则拆开看:\d 匹配一个数字,(?=(\d{3})+$) 是先行断言,要求它后面到结尾正好是 3、6、9... 位数字,满足才匹配,$& 代表匹配到的那个数字本身。注意 toFixed 受二进制精度影响,(1.005).toFixed(2) 是 '1.00' 而不是 '1.01',财务场景要用整数分或十进制库计算。
💬 面试官追问
parseToMoney(123456789)输出'123,456,789.',末尾的点哪来的?返回语句写死了
integer + '.' + ...,没有小数也拼了点。改成有小数才拼:return decimal ? integer + '.' + decimal : integer。1.9999经过这个函数显示成'2',产品说要显示'2.000',怎么办?toFixed(3)舍入后是'2.000',接着parseFloat把末尾的零吃掉了。要固定三位就别parseFloat,或者直接new Intl.NumberFormat('en-US', { minimumFractionDigits: 3 }).format(1.9999)。后端传过来一个
9007199254740993的金额,格式化后末位变了,是正则的问题吗?不是,数字一进
JS就超出了安全整数范围,精度在格式化之前已经丢了。大额金额要让后端传字符串或者以「分」为单位,前端拿字符串直接做分组。接口有时返回字符串
'1234.56',报num.toFixed is not a function,怎么兜底?入口先
const n = Number(num),再判断Number.isFinite(n),不合法就返回'--'之类的占位。null、空字符串会被Number转成0,金额场景要单独拦,不能显示成0。Intl.NumberFormat和手写正则,项目里怎么选?用户看的展示用
Intl.NumberFormat,德语区小数点是逗号、分组符是点,手写正则覆盖不了。手写只适合格式完全固定的场景,比如导出给机器读的报表。
# 2 判断是否是电话号码
⚡ 30 秒速记
- 原正则
/^1[34578]\d{9}$/过时了:16x、19x号段都会被误拦 - 现在常用宽松写法
/^1[3-9]\d{9}$/:1开头、11位数字 - 前端正则只拦明显输错,号码是不是真的、是不是本人,靠短信验证码
- 号段表会变,写死得越细越容易误伤新用户;服务端也要再校验一遍
- 国际号码、座机别塞进同一个正则,先按国家 / 类型分流
判断手机号就是 1 开头加 11 位数字,原来那个只认 3/4/5/7/8 第二位的正则已经过时了。 166、199 这些号段放出来好几年了,用老正则这些用户直接注册不了,还看不出原因。我现在一般写 /^1[3-9]\d{9}$/,只拦位数不对、混了字母这种明显错误。正则写得再细也证明不了号码真实存在,号码归属这件事交给短信验证码,前端校验的目标是少打扰用户,不是当门卫。
手机号格式初筛可以接受以 1 开头、第二位为 3 到 9 的 11 位数字。它不代表号码已分配、可达或属于当前用户;实际业务还要结合服务端校验、短信确认和频控。
function isPhone(tel) {
  const value = String(tel).replace(/[\s-]/g, '').replace(/^\+?86/, '') // 去空格、横线和区号
  return /^1[3-9]\d{9}$/.test(value)
}

isPhone('16612345678')     // true,仅表示通过格式初筛
isPhone('+86 138 1234 5678') // true
isPhone('1381234567')      // false,只有 10 位
isPhone('12345678901')     // false,第二位是 2
前端校验只负责拦截明显输错,短信验证可确认当前接收能力,但不等于完整身份认证,服务端必须再校验一次。
💬 面试官追问
用户输入
16612345678,号码是真的,为什么注册页提示格式错误?正则第二位只允许
[34578],6不在里面。换成/^1[3-9]\d{9}$/,这只是较宽松的格式初筛,不保证覆盖未来规则,也不代表号码已分配。安全同学要求严格按号段表校验,你怎么看?
不太赞成。号段表需要持续维护,前端一旦没更新就是真实用户流失;真正的安全靠短信验证码和服务端频控,格式校验只防手滑。
用户粘贴进来的是
138 1234 5678或者+86 13812345678,怎么处理?先规范化再校验:
value.replace(/[\s-]/g, '').replace(/^\+?86/, ''),然后用正则判断。规范化后的结果再提交,服务端存统一格式。线上有用户反馈收不到验证码,前端却提示格式错误,怎么查?
先看请求有没有发出去,没发就是前端正则拦的,拿脱敏号码看第二位;发出去了再看服务端校验和短信通道的错误码。前后端规则不一致是最常见的原因,要用同一份规则。
要支持国际手机号,还能用一个正则吗?
别硬写。各国号码长度和格式都不一样,一般让用户选国家区号,再用
libphonenumber-js这类库按国家校验和格式化,存E.164格式,比如+8613812345678。
# 3 验证是否是邮箱
⚡ 30 秒速记
- 邮箱结构:本地部分 +
@+ 域名 + 至少一个.后缀 - 原正则有硬伤:
(\.[a-zA-Z0-9_\-])+每段点号后只能跟一个字符,foo@example.com都过不了 - 修正:
/^[\w.+-]+@[\w-]+(\.[\w-]+)+$/,允许+、点号,后缀可以多个字符 - 正则只做基础格式过滤,邮箱是否存在、能否收信要靠验证邮件
- 别追求「完美邮箱正则」,越复杂越容易误拒合法地址
邮箱校验只要做到「有本地部分、有 @、有带点的域名」就够了,原来那个正则其实是坏的。 它的域名后缀写成 (\.[a-zA-Z0-9_\-])+,括号里只有一个字符,意思是「点加一个字符」重复多次,所以 a@b.c 能过,foo@example.com 反而过不了,因为 .com 后面多了两个字母。改成 (\.[\w-]+)+ 才对,本地部分顺便放开 + 和 .,dev+alert@example.com 这种别名邮箱很常见。正则只是挡手滑,真想确认邮箱有效就发验证邮件。
function isEmail(email) {
    var regx = /^[\w.+-]+@[\w-]+(\.[\w-]+)+$/;
    return regx.test(email);
}
这个正则最容易写错的是域名后缀那一段的量词位置,比如下面的 bad,最常见的邮箱都匹配不上:
const bad = /^([a-zA-Z0-9_\-])+@([a-zA-Z0-9_\-])+(\.[a-zA-Z0-9_\-])+$/
bad.test('foo@example.com') // false!
bad.test('a@b.c')           // true,只有后缀是单字符才能过

const good = /^[\w.+-]+@[\w-]+(\.[\w-]+)+$/
good.test('foo@example.com')       // true
good.test('dev+alert@example.com') // true
good.test('a@mail.example.co.uk')  // true
good.test('foo@example')           // false,没有后缀
good.test('foo@@example.com')      // false
(\.[a-zA-Z0-9_\-])+ 的意思是「点 + 一个字符」整体重复,.com 会被拆成 .c 再接 o,o 前面没有点就失败了;把 + 放进括号里写成 (\.[\w-]+)+ 才是「点 + 若干字符」重复。即便写对了,正则也只能过滤明显的格式错误,邮箱是否真实可用要靠验证邮件确认。
💬 面试官追问
foo@example.com用原正则测试返回false,为什么?(\.[a-zA-Z0-9_\-])+每组只吃「点加一个字符」,.com匹配完.c后剩下om没法匹配。量词应该放在字符集后面:(\.[\w-]+)+。用户输入
dev+alert@example.com被拒了,地址是能收信的,改哪里?本地部分的字符集没有
+,也没有点号。改成[\w.+-]+,Gmail的加号别名和first.last这种格式都能过。后端说只判断有没有
@就行,前端想写完整的RFC正则,你怎么选?都不选,取中间。只看
@会放过a@b这种明显错误;完整RFC正则又长又难维护,还会误拒。基础结构校验加验证邮件,最省心。注册转化突然掉了,日志里浏览器端大量「邮箱格式错误」,怎么查?
先把失败样本脱敏后按特征分类,看是不是集中在带
+、带点号、长后缀或首尾空格的地址,然后拿正则逐条复现。输入框提交前记得trim(),手机输入法经常带空格。要支持中文域名邮箱,比如
用户@例子.中国,这个正则行吗?不行,
\w只匹配ASCII字母数字下划线。要先确认业务是否真要支持国际化邮箱,要的话域名部分转成Punycode再校验,或者干脆放宽成「有@且域名带点」。
# 4 验证是否是身份证
⚡ 30 秒速记
- 原正则只看外形:
15位纯数字,或17位数字 + 末位数字 /X/x (^\d{18}$)那个分支是多余的,第三个分支已经覆盖了- 不校验地区码、出生日期、校验位,
18个1也能过 - 完整校验:前
17位乘权重求和mod 11,查表10X98765432得出末位 15位老证件早已停用,新系统一般只收18位;身份证属敏感数据,日志和埋点里不能出现明文
原来这个正则只检查长度和字符,18 个 1 都能通过,只能算最基础的格式提示。 真正的 18 位身份证有三层规则:前 6 位是地区码,7~14 位是出生日期,最后一位是校验码,由前 17 位按固定权重加权求和再 mod 11 查表得到,所以末位才会出现 X。前端我一般做到格式 + 日期合法 + 校验位,挡住绝大多数手误;是不是真人真证,得服务端调权威接口核验。
function isCardNo(number) {
    var regx = /(^\d{15}$)|(^\d{18}$)|(^\d{17}(\d|X|x)$)/;
    return regx.test(number);
}
💬 面试官追问
输入
111111111111111111校验通过了,业务说这不可能是真证件,为什么没拦住?正则只管长度和字符组成,不算校验位,也不看日期。加上校验位计算,这个号码的末位应该是
0而不是1,就能被拦下来。校验位怎么算?
前
17位分别乘权重[7, 9, 10, 5, 8, 4, 2, 1, 6, 3, 7, 9, 10, 5, 8, 4, 2],求和后% 11,用结果当下标去'10X98765432'里取字符,就是末位。产品说不再接受
15位,并且末位统一存大写X,怎么改?正则去掉
15位分支,提交前value.trim().toUpperCase()统一大小写再校验和存储。存量数据里的15位号码要另外评估迁移,别直接让老用户登录失败。风控想用一个正则把地区、日期、校验位全校验了,你同意吗?
不同意。日期要考虑闰年、校验位要做加权运算,正则写不出来也没法维护。拆成格式、日期、校验位三步,每步失败返回不同提示,测试也好写。
前端校验通过、服务端拒绝的投诉集中在末位是
X的用户,先查什么?先看两边对小写
x的处理是否一致,再看传输过程中有没有被转了大小写或截断。排查时只用脱敏样本,日志里不要打完整证件号。
# 5 用正则写一个根据name获取cookie中的值的方法
⚡ 30 秒速记
document.cookie拿到的是一整串'a=1; b=2',正则按name把值抠出来(^| )保证name前面是开头或空格,getCookie('id')不会误取user-id;([^;]*)取到分号前name是动态拼进正则的,含.、[这类元字符要先转义unescape已废弃,配合encodeURIComponent写入的值用decodeURIComponent解,并包try/catchHttpOnly的cookie脚本读不到,这不是正则的问题;登录凭证本来就该设HttpOnly
document.cookie 返回的是一个用分号加空格隔开的长字符串,这个正则就是按名字把对应的值截出来。 (^| ) 要求 name 前面是字符串开头或空格,所以找 id 不会从 user-id 中间匹配上;=([^;]*) 取等号后面直到分号的内容,最后一项没有分号也能匹配。我会改三处:name 拼进正则前先转义元字符;unescape 已经废弃,换成 decodeURIComponent;分隔符写成 (?:^|;\s*) 更稳。另外要知道 HttpOnly 的 cookie 在这串字符串里根本不存在,读不到先去看属性。
function getCookie(name) {
  var match = document.cookie.match(new RegExp('(^| )' + name + '=([^;]*)'));
  if (match) return unescape(match[2]);
}
- 获取页面上的
cookie可以使用document.cookie
这里获取到的是类似于这样的字符串:
'username=poetry; user-id=12345; user-roles=home, me, setting'
可以看到这么几个信息:
- 每一个cookie都是由
name=value这样的形式存储的 - 每一项的开头可能是一个空串
''(比如username的开头其实就是), 也可能是一个空字符串' '(比如user-id的开头就是) - 每一项用
";"来区分 - 如果某项中有多个值的时候,是用
","来连接的(比如user-roles的值) - 每一项的结尾可能是有
";"的(比如username的结尾),也可能是没有的(比如user-roles的结尾)
- 所以我们将这里的正则拆分一下:
'(^| )'表示的就是获取每一项的开头,因为我们知道如果^不是放在[]里的话就是表示开头匹配。所以这里(^| )的意思其实就被拆分为(^)表示的匹配username这种情况,它前面什么都没有是一个空串(你可以把(^)理解为^它后面还有一个隐藏的'');而|表示的就是或者是一个" "(为了匹配user-id开头的这种情况)+name+这没什么好说的=([^;]*)这里匹配的就是=后面的值了,比如poetry;刚刚说了^要是放在[]里的话就表示"除了^后面的内容都能匹配",也就是非的意思。所以这里([^;]*)表示的是除了";"这个字符串别的都匹配(*应该都知道什么意思吧,匹配0次或多次)- 有的大佬等号后面是这样写的
'=([^;]*)(;|$)',而最后为什么可以把'(;|$)'给省略呢?因为其实最后一个cookie项是没有';'的,所以它可以合并到=([^;]*)这一步。
- 最后获取到的
match其实是一个长度为4的数组。比如:
[
  "username=poetry;",
  "",
  "poetry",
  ";"
]
- 第0项:全量
- 第1项:开头
- 第2项:中间的值
- 第3项:结尾
所以我们是要拿第2项match[2]的值。
- 为了防止获取到的值是
%xxx这样的字符序列,需要用unescape()方法解码。
💬 面试官追问
调用
getCookie('id')时,页面上还有user-id=2,会不会取错?不会,
(^| )要求id前面是开头或空格,user-id里的id前面是-。不过它依赖分号后面有空格,写成(?:^|;\s*)就不依赖了。cookie名称是配置下发的,直接拼进new RegExp有什么风险?名字里有
.、+、[时会被当成正则语法,要么匹配错,要么直接抛异常。先name.replace(/[.*+?^${}()|[\]\\]/g, '\\$&')转义,或者干脆按'; '拆分后逐项比较名字。后端用
Set-Cookie下发了token,前端document.cookie里看不到,为什么?大概率设了
HttpOnly,脚本本来就读不到;再查Path、Domain是否匹配当前页面,以及Secure的cookie在http页面也不可见。这时候改正则没有任何意义。把
unescape直接全局换成decodeURIComponent,会出问题吗?可能会。历史值如果不是
encodeURIComponent写入的,比如带了单独的%,decodeURIComponent会抛URIError。替换时包一层try/catch,失败就返回原值。现在除了正则,还有别的方式读
cookie吗?有
Cookie Store API:await cookieStore.get('id'),异步、直接返回对象,只能在HTTPS下用。Chromium系很早就支持,Safari和Firefox是近两年才跟上,老浏览器还得保留字符串解析作降级。
# 31 函数柯里化相关
# 1 实现一个JS函数柯里化
⚡ 30 秒速记
- 柯里化:参数不够就返回新函数继续收,收够了才执行原函数 → 参数复用 + 延迟执行
- 判断「够了」的依据:
fn.length,或者手动传arity - 每次递归要返回绑定新参数数组的新函数,参数别放在共享闭包里改(示例里的「写法 2」就踩了这个坑)
fn.length不数默认参数之后的形参和剩余参数:function (a, b = 10, c) {}的length是1- 判断条件写
>=不要写===,多传一个参数就再也执行不了
柯里化就是把一个多参数函数变成可以分批传参的函数,参数凑够了才真正执行。 实现上我会用递归加闭包:curry(fn, args = []) 返回一个函数,每次调用把新参数和旧的拼成一个新数组,长度够 fn.length 就 fn.apply(this, all),不够就 return curry(fn, all)。关键是每一层都拿新数组,不要像示例里的「写法 2」那样把 args 放在外层闭包里一直改,那样第一次调用完参数没清空,第二次 add(3) 直接就拿旧参数执行了。用处嘛,比如 isType('String', val) 柯里化后得到 isString,前面的参数就复用了。
预先处理的思想,利用闭包的机制
- 柯里化的定义:接收一部分参数,返回一个函数接收剩余参数,接收足够参数后,执行原函数
- 函数柯里化的主要作用和特点就是
参数复用、提前返回和延迟执行
- 柯里化把多次传入的参数合并,柯里化是一个高阶函数
- 每次都返回一个新函数
- 每次入参都是一个
当柯里化函数接收到足够参数后,就会执行原函数,如何去确定何时达到足够的参数呢?
有两种思路:
- 通过函数的
length属性,获取函数的形参个数,形参的个数就是所需的参数个数 - 在调用柯里化工具函数时,手动指定所需的参数个数
将这两点结合一下,实现一个简单 curry 函数
通用版
// 写法1
function curry(fn, args) {
  var length = fn.length;
  var args = args || [];
  return function(){
    newArgs = args.concat(Array.prototype.slice.call(arguments));
    if (newArgs.length < length) {
        return curry.call(this,fn,newArgs);
    }else{
        return fn.apply(this,newArgs);
    }
  }
}
// 写法2 推荐
function curry(fn) {
    const fnArgsLength = fn.length // 传入函数的参数长度
    let args = [] // 收集传入的参数

    function calc(...newArgs) {
        // 积累参数保存到闭包中
        args = [
            ...args,
            ...newArgs
        ]
        // 积累的参数长度跟传入函数的参数长度对比
        if (args.length < fnArgsLength) {
            // 参数不够,返回函数
            return calc
        } else {
            // 参数够了,返回执行结果
            return fn.apply(this, args.slice(0, fnArgsLength)) // 传入超过fnArgsLength长度的参数没有意义
        }
    }

    // 返回一个函数
    return calc
}
// 写法3
// 分批传入参数
// redux 源码的compose也是用了类似柯里化的操作
const curry = (fn, arr = []) => {// arr就是我们要收集每次调用时传入的参数
  let len = fn.length; // 函数的长度,就是参数的个数

  return function(...args) {
    let newArgs = [...arr, ...args] // 收集每次传入的参数

    // 如果传入的参数个数等于我们指定的函数参数个数,就执行指定的真正函数
    if(newArgs.length === len) {
      return fn(...newArgs)
    } else {
      // 递归收集参数
      return curry(fn, newArgs)
    }
  }
}
// 测试
function multiFn(a, b, c) {
  return a * b * c;
}

var multi = curry(multiFn);

multi(2)(3)(4);
multi(2,3,4);
multi(2)(3,4);
multi(2,3)(4)
ES6写法
const curry = (fn, arr = []) => (...args) => (
  arg => arg.length === fn.length
    ? fn(...arg)
    : curry(fn, arg)
)([...arr, ...args])
// 测试
let curryTest=curry((a,b,c,d)=>a+b+c+d)
curryTest(1,2,3)(4) //返回10
curryTest(1,2)(4)(3) //返回10
curryTest(1,2)(3,4) //返回10
// 柯里化求值
// 指定的函数
function sum(a,b,c,d,e) {
  return a + b + c + d + e
}

// 传入指定的函数,执行一次
let newSum = curry(sum)

// 柯里化 每次入参都是一个参数
newSum(1)(2)(3)(4)(5)

// 偏函数
newSum(1)(2)(3,4,5)
// 柯里化简单应用
// 判断类型,参数多少个,就执行多少次收集
function isType(type, val) {
  return Object.prototype.toString.call(val) === `[object ${type}]`
}

let newType = curry(isType)

// 相当于把函数参数一个个传了,把第一次先缓存起来
let isString = newType('String')
let isNumber = newType('Number')

isString('hello world')
isNumber(999)
示例里的「写法 2」被标成推荐,但它的参数数组放在 curry 外层闭包里共享,同一个柯里化函数只能用一次:
// 写法 2 的问题
const add = curry((a, b) => a + b)
add(1)(2) // 3
add(3)(4) // TypeError: add(...) is not a function
// 原因:args 还残留 [1, 2],add(3) 时变成 [1, 2, 3],长度够了直接返回 3

// 推荐:每层都创建新数组,支持手动传 arity
function curry(fn, arity = fn.length, args = []) {
  return function (...rest) {
    const all = [...args, ...rest]
    return all.length >= arity
      ? fn.apply(this, all)
      : curry(fn, arity, all)
  }
}

const add2 = curry((a, b, c) => a + b + c)
add2(1)(2)(3) // 6
add2(1, 2)(3) // 6,可以分批
add2(4)(5)(6) // 15,多次复用互不影响
「写法 1」里的 newArgs 没有声明,非严格模式下会变成全局变量,严格模式下直接报错,也要补上 var / const。
💬 面试官追问
用示例里标「推荐」的写法 2,
add(1)(2)得到3,接着add(3)(4)报is not a function,为什么?args存在外层闭包里,第一次跑完没有清空,add(3)时args已经是[1, 2, 3],长度够了直接返回3,再调3(4)就报错。改成每层递归传新数组,互不共享。function query(a, b = 10, c) {}柯里化后传一个参数就执行了,为什么?fn.length只数到第一个带默认值的参数之前,这里是1;剩余参数...rest也不算。这种函数要显式传参数个数:curry(fn, 3)。判断条件写成
newArgs.length === len,调用multi(2, 3, 4, 5)会怎样?4永远不等于3,就一直返回函数,永远不执行。写成>=,多出来的参数截掉或者原样传给fn。柯里化、偏函数、
bind有什么区别?柯里化是一次只接一部分、直到凑够为止,能连续调用;偏函数是固定前几个参数、返回一个接收剩余参数的函数,一步到位;
bind是偏函数的一种实现,还能顺便绑定this,但它不会帮你判断参数够没够。实际项目里哪些地方用得上柯里化?
主要是需要复用前置参数的地方,比如
const logError = log('error')、const isString = isType('String'),或者lodash/fp和Ramda这类函数式库里配合compose用。普通业务代码里只调一次的函数没必要柯里化,反而更难读。
# 2 请实现一个 add 函数,满足以下功能
⚡ 30 秒速记
- 闭包收集所有参数,每次调用返回一个新函数,所以能无限链式调用
- 求值靠重写函数的
toString:函数被转成原始值时(alert、==、+、模板字符串)触发求和 add(1)本身还是函数:add(1) === 1是false,add(1) == 1是true- 更稳的做法是实现
Symbol.toPrimitive或valueOf;也可以约定空调用add(1)(2)()结束 - 参数里混进字符串,
reduce里的+会变拼接,add(1)('2')(3)得到'123'
这题的关键是:add 永远返回一个函数,所以能一直调下去,结果是在函数被转换成原始值的那一刻才算出来的。 每次调用把新参数和旧参数拼起来,再 return add(...all);同时给返回的函数重写 toString,返回 reduce 求和的结果。函数参与 ==、+、alert 或模板字符串时,引擎会尝试把它转成原始值,valueOf 返回的是函数本身不是原始值,于是继续调 toString,拿到数字。所以 add(1)(2) + 1 是 4,但 add(1)(2) === 3 是 false,console.log 打出来也是函数,这点要提前说清楚。
add(1); 			// 1
add(1)(2);  	// 3
add(1)(2)(3);// 6
add(1)(2, 3); // 6
add(1, 2)(3); // 6
add(1, 2, 3); // 6
function add(...args) {
  // 在内部声明一个函数,利用闭包的特性保存并收集所有的参数值
  let fn = function(...newArgs) {
   return add.apply(null, args.concat(newArgs))
  }

  // 利用toString隐式转换的特性,当最后执行时隐式转换,并计算最终的值返回
  fn.toString = function() {
    return args.reduce((total,curr)=> total + curr)
  }

  return fn
}
考点:
- 使用闭包, 同时要对JavaScript 的作用域链(原型链)有深入的理解
- 重写函数的
toSting()方法
// 测试,调用toString方法触发求值

add(1).toString(); 			// 1
add(1)(2).toString();  	// 3
add(1)(2)(3).toString();// 6
add(1)(2, 3).toString(); // 6
add(1, 2)(3).toString(); // 6
add(1, 2, 3).toString(); // 6
💬 面试官追问
测试写
expect(add(1)(2)).toBe(3)失败了,为什么注释里写的是3?add(1)(2)返回的是函数,严格相等不会做类型转换。要么断言Number(add(1)(2)),要么改需求,用空调用add(1)(2)()返回数字结束链条。只重写
toString够吗,还是要重写valueOf?够用,但不够明确。更推荐
fn[Symbol.toPrimitive] = () => sum,它优先级最高,Number()、+、模板字符串都会走它,不用依赖valueOf返回对象后再回退到toString这条路径。add(1)('2')(3)最后显示成123,是闭包出错了吗?闭包没问题,是
1 + '2'变成了字符串拼接。入口要么校验typeof n === 'number',要么Number(n)统一转换,同时处理NaN。想让
add(1)(2)()空调用直接返回结果,代码怎么改?在返回的函数里判断
newArgs.length === 0,是就返回args.reduce((a, b) => a + b, 0),否则继续return add(...args, ...newArgs)。这样返回值类型由是否传参决定,接口文档要写清楚。链条很长时,保存全部参数和只保存累计和,选哪个?
只求和就保存累计和,内存不随链长增长,每次也不用复制数组。要做延迟校验、重放或换归约规则,才需要保留全部参数。
# 3 实现 (5).add(3).minus(2) 功能
⚡ 30 秒速记
- 在
Number.prototype上挂add/minus,方法里用this.valueOf()拿到原始数字,返回新数字,所以能继续链式调用 - 必须写
(5).add(3):5.add里的点会被解析成小数点,报SyntaxError;5..add(3)也行 - 改内置原型是全局副作用:可能和别的库重名、出现在
for...in里,公共库禁止这么干 - 浮点问题照旧:
(0.1).add(0.2)是0.30000000000000004 - 不想污染原型:写一个
calc(5).add(3).minus(2).value()的包装对象
做法就是给 Number.prototype 加 add 和 minus 两个方法,每个都返回一个新的数字,数字又能调原型方法,链就串起来了。 方法里的 this 是数字的包装对象,用 this.valueOf() 或者 Number(this) 取原始值。写的时候必须给 5 加括号,不然 5. 会被当成小数点。这题能答出来不难,加分点在于说出它的问题:改内置原型会影响整个页面,Array.prototype.flatten 当年就因为 MooTools 改原型,逼得标准把名字改成了 flat。业务里想要链式写法,我会封装一个 calc(5).add(3).minus(2).value()。
例: 5 + 3 - 2,结果为 6
Number.prototype.add = function(n) {
  return this.valueOf() + n;
};
Number.prototype.minus = function(n) {
  return this.valueOf() - n;
};
实现add(1)(2) =3
// 题意的答案
const add = (num1) => (num2)=> num2 + num1;

// 整了一个加强版 可以无限链式调用 add(1)(2)(3)(4)(5)....
function add(x) {
  // 存储和
  let sum = x;

  // 函数调用会相加,然后每次都会返回这个函数本身
  let tmp = function (y) {
    sum = sum + y;
    return tmp;
  };

  // 对象的toString必须是一个方法 在方法中返回了这个和
  tmp.toString = () => sum
  return tmp;
}

alert(add(1)(2)(3)(4)(5))
无限链式调用实现的关键在于 对象的 toString 方法: 每个对象都有一个
toString()方法,当该对象被表示为一个文本值时,或者一个对象以预期的字符串方式引用时自动调用。
也就是我在调用很多次后,他们的结果会存在add函数中的sum变量上,当我alert的时候 add会自动调用 toString方法 打印出 sum, 也就是最终的结果
💬 面试官追问
同事写
5.add(3)报语法错误,是原型方法没挂上吗?不是,词法分析把
5.读成了小数,后面接add就不合法了。写(5).add(3)、5..add(3)或者5 .add(3)都行,但代码里别用这种写法,太难读。为什么说直接
Number.prototype.add = ...在公共库里不能用?全局所有数字都多了这个方法,和别的库同名就互相覆盖,而且直接赋值是可枚举的。真要挂,起码用
Object.defineProperty设成不可枚举,并先检查有没有同名;更好的办法是根本不改原型。(0.1).add(0.2).minus(0.3)能得到0吗?不能,结果是
5.551115123125783e-17,JS的Number是二进制浮点数。金额要用整数分计算,或者用decimal.js这类库。(5).add('3').minus(2)得到51,怎么回事?5 + '3'拼成了'53',减法又把它转回数字得51。方法入口要校验参数是有限数字,Number.isFinite(n)不过就抛错。产品就想要
(5).add(3)这种写法,架构组禁止改原型,怎么折中?封装一个计算器对象:
calc(5).add(3).minus(2).value(),每个方法返回this或新对象,最后value()取结果。语法多了一个入口和出口,但影响范围只在自己的代码里。
# 32 字符串相关
# 1 查找字符串中出现最多的字符和个数
⚡ 30 秒速记
- 首选一次遍历 +
Map计数,边计数边更新最大值,O(n) - 示例思路:
split('').sort().join('')把相同字符排到一起,再用/(\w)\1+/g找最长的一段 - 排序法的坑:
\1+要求至少连续两次,所有字符都只出现一次时返回空;\w只认字母数字下划线,中文和标点统计不到 - 并列最多时要先定规则:返回全部,还是返回最先出现的那个
- 有
emoji时用for...of遍历,按码点走;split('')会把它拆成两半
我会直接遍历一次,用 Map 记每个字符出现的次数,同时维护当前最大值,一趟就出结果。 示例的排序加正则挺巧妙:排完序相同字符挨在一起,(\w)\1+ 匹配同一个字符连续出现的一段,长度最长的就是答案。但它有几个硬伤:排序本身是 O(n log n);\1+ 要求至少重复一次,字符串里每个字符只出现一次就什么都匹配不到;\w 不认中文和标点。计数法没有这些问题,而且平局时可以按首次出现的位置决定返回谁。
例: abbcccddddd -> 字符最多的是d,出现了5次
let str = "abcabcabcbbccccc";
let num = 0;
let char = '';

 // 使其按照一定的次序排列
str = str.split('').sort().join('');
// "aaabbbbbcccccccc"

// 定义正则表达式
let re = /(\w)\1+/g;
str.replace(re,($0,$1) => {
    if(num < $0.length){
        num = $0.length;
        char = $1;
    }
});
console.log(`字符最多的是${char},出现了${num}次`);
💬 面试官追问
输入
'abc',每个字符都只出现一次,排序加正则那版返回什么?char是空字符串、num是0,因为/(\w)\1+/至少要两个相同字符才能匹配。改成/(\w)\1*/g,或者干脆换成计数法。输入是
'你好你',用\w的正则为什么统计不到?\w只匹配[A-Za-z0-9_],中文完全不在范围内。用Map计数就不关心字符类型,for (const ch of str) map.set(ch, (map.get(ch) || 0) + 1)。同一批数据有时返回
a、有时返回b,两者次数一样,怎么让结果稳定?只在次数严格大于时更新的话,平局结果取决于排序顺序。先跟产品定规则,比如返回所有最高频字符,或者返回最先出现的那个,计数时顺便记下首次位置。
字符串里有
emoji,split('')统计出来的结果很奇怪,为什么?split('')按UTF-16代码单元拆,一个emoji会被拆成两个代理项。用for...of或[...str]按码点遍历;带肤色、组合的emoji还要用Intl.Segmenter才能按用户看到的字符拆。要输出按频次排序的完整榜单,怎么做?
还是先
Map计数,再[...map].sort((a, b) => b[1] - a[1])。排序的是不同字符的条目,数量远小于文本长度,比排序整个字符串划算。
# 2 字符串查找
⚡ 30 秒速记
- 朴素匹配:外层枚举起点
i,内层逐个比a[j] === b[i + j],全对就返回i,都不对返回-1 - 外层上界是
b.length - a.length,再往后剩下的长度不够 - 别用
for...in遍历字符串,拿到的下标是字符串,成功返回'2'、失败返回-1,类型不一致 - 内层发现不匹配要立即停,不要继续比完
- 最坏
O(n * m);空模式串按indexOf的约定返回0;生产直接用indexOf/includes
这题考的是朴素字符串匹配:每个位置都当一次起点,往后逐个字符比,全部对上就返回这个起点。 手写有三个常见毛病:用 for...in 遍历出来的 i 是字符串,成功时返回的是 '2' 而不是 2;内层比到不相等时不停,白白多比;外层不限上界,起点离结尾太近也会去比。我会用普通 for 循环写,i 最多到 b.length - a.length,内层不等就跳出。复杂度最坏 O(n * m),面试官往下问可以提 KMP。
请使用最基本的遍历来实现判断字符串 a 是否被包含在字符串 b 中,并返回第一次出现的位置(找不到返回 -1)。
a='34';b='1234567'; // 返回 2
a='35';b='1234567'; // 返回 -1
a='355';b='12354355'; // 返回 5
isContain(a,b);
function isContain(a, b) {
  if (a.length === 0) return 0 // 和 indexOf 的约定一致
  for (let i = 0; i <= b.length - a.length; i++) { // 数字下标,限定上界
    let j = 0
    while (j < a.length && a[j] === b[i + j]) j++ // 不匹配立即停
    if (j === a.length) return i // 返回数字
  }
  return -1
}

isContain('34', '1234567')    // 2,是数字不是 '2'
isContain('35', '1234567')    // -1
isContain('355', '12354355')  // 5
isContain('', 'abc')          // 0,空串约定返回 0
这里不要用 for...in 遍历字符串:它枚举的是属性名,i 是字符串,返回值类型就和 -1 不一致;内层失配要立即停,外层起点也要限制上界。最坏情况下朴素匹配是 O(n * m),需要更好的性能时可以用 KMP(失配时利用已匹配前缀跳转,整体 O(n + m))。
💬 面试官追问
用
for...in遍历b,匹配成功时返回的是什么类型?是字符串,
for...in枚举的是属性名,'0'、'1'、'2'。就算算下标时用~~i临时转一下,return i返回的还是'2',调用方=== 2会判断失败。a是空字符串,你的函数应该返回什么?按
'abc'.indexOf('')的约定是0,空串在任何位置都算出现。不特判的话,有些写法会因为a[0]是undefined返回-1,所以开头单独处理if (a.length === 0) return 0。百万字符的正文里搜一个几千字符的关键词,朴素匹配有什么问题?
最坏要比
n * m次,比如正文全是'a'、关键词是'aaa...ab',每个起点都要比到最后一位才失败。要线性复杂度就用KMP,靠next数组让失配时不用回退正文指针。生产代码里你会自己写这个吗?
不会,直接
b.indexOf(a),要布尔值用b.includes(a)。引擎实现过的查找比手写双循环快,也不会有类型和边界问题。为什么不建议用
for...in遍历字符串或数组?for...in遍历的是可枚举属性,键是字符串,还会把原型链上被扩展的可枚举属性一起带出来。按下标遍历用普通for,按值遍历用for...of。
# 3 字符串最长的不重复子串
⚡ 30 秒速记
- 滑动窗口:
[left, right]始终是无重复的连续区间,右边界一路往前,左边界只在撞重复时跳 - 用
Map记每个字符最后出现的位置,撞重复就left = Math.max(left, last + 1) Math.max那一下不能省,'abba'第二个a会让左边界往回退,算出3- 子串要连续,
'pwwkew'答案是'wke','pwke'是子序列 slice + indexOf版能过,但每步都在窗口里线性找,最坏O(n²);Map版O(n)
这题就是滑动窗口:右指针一格一格往前扩,遇到窗口里已经有的字符,就把左指针挪到那个字符上次出现位置的后一位。 窗口里永远没有重复字符,每扩一次就拿窗口长度更新一下最大值。我会用 Map 记每个字符最后一次出现的下标,这样撞重复时左指针一步跳到位,整体 O(n)。最容易写错的是左指针回退:'abba' 走到第二个 a 时,上次的 a 已经在窗口外了,所以要写 left = Math.max(left, last + 1),保证左指针只往右走。
function lengthOfLongestSubstring(s) {
  const last = new Map()
  let left = 0, max = 0
  for (let right = 0; right < s.length; right++) {
    const ch = s[right]
    if (last.has(ch)) left = Math.max(left, last.get(ch) + 1) // 只许往右
    last.set(ch, right)
    max = Math.max(max, right - left + 1)
  }
  return max
}
lengthOfLongestSubstring('abba')   // 2
lengthOfLongestSubstring('pwwkew') // 3
题目描述
给定一个字符串 s ,请你找出其中不含有重复字符的 最长子串 的长度。


示例 1:

输入: s = "abcabcbb"
输出: 3
解释: 因为无重复字符的最长子串是 "abc",所以其长度为 3。

示例 2:

输入: s = "bbbbb"
输出: 1
解释: 因为无重复字符的最长子串是 "b",所以其长度为 1。

示例 3:

输入: s = "pwwkew"
输出: 3
解释: 因为无重复字符的最长子串是 "wke",所以其长度为 3。
     请注意,你的答案必须是 子串 的长度,"pwke" 是一个子序列,不是子串。

示例 4:

输入: s = ""
输出: 0
答案
const lengthOfLongestSubstring = function (s) {
  if (s.length === 0) {
    return 0;
  }

  let left = 0;
  let right = 1;
  let max = 0;
  while (right <= s.length) {
    let lr = s.slice(left, right);
    const index = lr.indexOf(s[right]);

    if (index > -1) {
      left = index + left + 1;
    } else {
      lr = s.slice(left, right + 1);
      max = Math.max(max, lr.length);
    }
    right++;
  }
  return max;
};
💬 面试官追问
白板上
'pwwkew'有人写了'pwke'、长度4,错在哪?'pwke'在原串里不连续,中间跳过了一个w,那是子序列。窗口必须是一段连续区间,撞到重复只能挪左边界,不能跳着拼。'abba'算出来是3,你第一眼看哪行?看左边界的更新。走到第二个
a时,上次的a在下标0,已经在窗口外了,直接left = 0 + 1会把左边界从2拉回1。改成Math.max(left, last + 1)就好。窗口用
slice加indexOf来找重复,有什么问题?每一步都新建一个窗口子串,再在里面线性找一遍,窗口长的时候最坏是
O(n²),还一直在分配字符串。还有个冷门坑:最后一轮s[right]是undefined,indexOf(undefined)会去找字符串"undefined",输入恰好含这个词就会算错。要求把最长的那个子串也返回,改哪里?
多记一个
start,每次max变大时start = left,最后s.slice(start, start + max)。长度相等不更新,返回的就是最早出现的那个。输入里有
emoji,长度算得不对,怎么回事?s[i]按UTF-16代码单元取,一个emoji占两个单元,会被拆成两半。要按用户看到的字符算,先[...s]拆成码点数组再跑窗口,组合emoji还得用Intl.Segmenter。
# 33 实现工具函数
# 1 对象扁平化
⚡ 30 秒速记
- 递归遍历,路径用
.拼成新键,碰到非对象就写进结果:{a:{b:{c:1}}}→{'a.b.c': 1} - 判断条件
val && typeof val === 'object':null不递归直接保留,数组也会被拆成b.0、b.1 - 空对象
{}、空数组[]这一版会直接消失,要保留得单独判断 - 循环引用会无限递归,嵌套很深会爆栈;生产里用显式栈 +
WeakSet - 原始键本身带
.时扁平结果不可逆,要还原就得转义或换分隔符
对象扁平化就是把一棵嵌套对象拍成一层,每个叶子值的键是它从根走下来的路径。 写法很直接:递归遍历,preKey 拼上当前键,值还是对象就继续往下,不是就写进结果。面试时我会顺手把边界说清楚:null 因为 val && 不成立会原样保留;数组也是对象,会被拆成 b.0 这种键,产品要数组整体保留就加一个 Array.isArray 判断;空对象没有叶子会直接丢掉。
objectFlat({ a: { b: 1, c: [1, { d: 2 }] }, e: null, f: {} })
// { 'a.b': 1, 'a.c.0': 1, 'a.c.1.d': 2, e: null }   注意 f 没了
function objectFlat(obj = {}) {
  const res = {}
  function flat(item, preKey = '') {
    Object.entries(item).forEach(([key, val]) => {
      const newKey = preKey ? `${preKey}.${key}` : key
      if (val && typeof val === 'object') {
        flat(val, newKey)
      } else {
        res[newKey] = val
      }
    })
  }
  flat(obj)
  return res
}

// 测试
const source = { a: { b: { c: 1, d: 2 }, e: 3 }, f: { g: 2 } }
console.log(objectFlat(source));
💬 面试官追问
{a: null, b: [1, {c: 2}]}会输出什么?{ a: null, 'b.0': 1, 'b.1.c': 2 }。null被val &&挡住没递归;数组也满足typeof === 'object',被按下标拆开了。那
{a: {b: 1}}和{'a.b': 1}扁平完一样,怎么办?这就是点号路径的天然冲突,扁平结果没法还原。要么约定键名不许带
.,要么拼路径时转义,要么干脆中间结果存路径数组['a.b'],最后再决定怎么序列化。空对象
f: {}不见了,后端说要保留,怎么改?递归前判断一下:
Object.keys(val).length === 0时直接res[newKey] = {},数组同理写[]。不加这句,空对象没有叶子,自然一个键都产不出来。插件生成的配置一扁平就卡死,先怀疑什么?
循环引用,比如子节点挂了个
parent指回祖先。用一个WeakSet记录当前递归链上的对象,遇到已经在链上的就跳过或抛错。注意只在链上判断,同一个对象被两处共享不算环,不能一刀切去重。只要读两三个固定字段,也要先整体扁平化吗?
不用,直接按路径取就行,比如
obj?.user?.profile?.name。扁平化会遍历整棵对象、造一堆键字符串,只有要统一枚举、上报全部叶子时才值得。
# 2 实现一个管理本地缓存过期的函数
⚡ 30 秒速记
- 思路:存的时候把
value、写入时间startTime、有效期expires一起JSON.stringify进localStorage,取的时候比时间 - 过期判断:
Date.now() - startTime > expires→ 删掉并返回空 localStorage自己没有过期机制,这是「读时惰性过期」,不读就一直占着空间- 手写常见三个坑:取不存在的键会
null.startTime直接报错;expires: 0被当成没设置;用false表示过期会和真实的false撞 - 有过期和没过期最好统一存同一种包装结构,返回类型才一致
localStorage 本身没有过期时间,所以要自己在存的时候带上写入时间和有效期,读的时候判断一下过没过期。 存的时候把 { value, startTime, expires } 整个序列化进去;读出来先 JSON.parse,如果 Date.now() - startTime > expires 就 removeItem 并返回空,没过期就返回 value。这是惰性过期,不去读它就不会被清掉,量大的话可以在启动时扫一遍清理。最容易漏的是:键不存在时 localStorage.getItem 返回 null,JSON.parse(null) 还是 null,接着读 item.startTime 直接抛错。我会写成下面这样:
const cache = {
  set(key, value, ttl) { // ttl 单位毫秒,不传表示永不过期
    localStorage.setItem(key, JSON.stringify({ value, expireAt: ttl == null ? null : Date.now() + ttl }))
  },
  get(key) {
    const raw = localStorage.getItem(key)
    if (raw == null) return undefined           // 未命中
    try {
      const { value, expireAt } = JSON.parse(raw)
      if (expireAt != null && Date.now() >= expireAt) {
        localStorage.removeItem(key)
        return undefined                         // 已过期
      }
      return value
    } catch { return undefined }                 // 脏数据
  },
}
cache.set('list', [1, 2], 5000)
cache.get('list') // 5 秒内是 [1, 2],之后是 undefined
封装一个可以设置过期时间的
localStorage存储函数
class Storage{
  constructor(name){
      this.name = 'storage';
  }
  //设置缓存
  setItem(params){
      let obj = {
          name:'', // 存入数据  属性
          value:'',// 属性值
          expires:"", // 过期时间
          startTime:new Date().getTime()//记录何时将值存入缓存,毫秒级
      }
      let options = {};
      //将obj和传进来的params合并
      Object.assign(options,obj,params);
      if(options.expires){
      //如果options.expires设置了的话
      //以options.name为key,options为值放进去
          localStorage.setItem(options.name,JSON.stringify(options));
      }else{
      //如果options.expires没有设置,就判断一下value的类型
          let type = Object.prototype.toString.call(options.value);
          //如果value是对象或者数组对象的类型,就先用JSON.stringify转一下,再存进去
          if(Object.prototype.toString.call(options.value) == '[object Object]'){
              options.value = JSON.stringify(options.value);
          }
          if(Object.prototype.toString.call(options.value) == '[object Array]'){
              options.value = JSON.stringify(options.value);
          }
          localStorage.setItem(options.name,options.value);
      }
  }
  //拿到缓存
  getItem(name){
      let item = localStorage.getItem(name);
      //先将拿到的试着进行json转为对象的形式
      try{
          item = JSON.parse(item);
      }catch(error){
      //如果不行就不是json的字符串,就直接返回
          item = item;
      }
      //如果有startTime的值,说明设置了失效时间
      if(item.startTime){
          let date = new Date().getTime();
          //何时将值取出减去刚存入的时间,与item.expires比较,如果大于就是过期了,如果小于或等于就还没过期
          if(date - item.startTime > item.expires){
          //缓存过期,清除缓存,返回false
              localStorage.removeItem(name);
              return false;
          }else{
          //缓存未过期,返回值
              return item.value;
          }
      }else{
      //如果没有设置失效时间,直接返回值
          return item;
      }
  }
  //移出缓存
  removeItem(name){
      localStorage.removeItem(name);
  }
  //移出全部缓存
  clear(){
      localStorage.clear();
  }
}
用法
let storage = new Storage();
storage.setItem({
  name:"name",
  value:"ppp"
})
下面我把值取出来
let value = storage.getItem('name');
console.log('我是value',value);
设置5秒过期
let storage = new Storage();
storage.setItem({
  name:"name",
  value:"ppp",
  expires: 5000
})
// 过期后再取出来会变为 false
let value = storage.getItem('name');
console.log('我是value',value);
💬 面试官追问
取一个从没存过的键,原来的
getItem会怎样?直接报错。
localStorage.getItem返回null,JSON.parse(null)也是null,下一行item.startTime就是TypeError。读之前先判raw == null。调用方传
expires: 0,结果缓存永远不过期,为什么?用
if (options.expires)判断有没有设置的话,0是假值,直接走了「无过期」分支。改成expires != null,并且约定好0到底是立即过期还是非法值,入口校验必须是有限的非负数字。后端下发的是绝对过期时间戳,还能用
date - startTime > expires吗?不能,一个是「已经过了多久」,一个是「几点过期」,单位一样但意思完全不同,混着比永远不会过期。我更习惯直接存
expireAt,判断Date.now() >= expireAt,相对时长在存的时候就换算掉。用户改了系统时间,缓存提前失效或者一直不失效,怎么看?
Date.now()取的是本机时间,用户能随便改,这个方案本来就只适合做体验层缓存。对时效要求严格的数据,过期要以服务端为准,比如接口返回里带版本号或服务端时间。能不能用这套封装存登录
token,到点自动登出?能做体验优化,但别当成安全手段。过期只是读的时候不给你,
token一直明文躺在localStorage里,页面上任何脚本都能读到。真正的失效要靠服务端,敏感凭证更适合放HttpOnly的Cookie。
# 3 实现lodash的chunk方法--数组按指定长度拆分
⚡ 30 秒速记
- 按
size步进遍历,每次arr.slice(i, i + size)推进结果;最后一段不够长也照样保留 slice越界不报错,['a','b','c','d']按3拆 →[['a','b','c'], ['d']]size为0时步长是0,死循环;要先判断,lodash对size < 1返回[]slice不改原数组,每组都是浅拷贝,用splice会把调用方的数据切没- 实际场景:批量请求按
50个一组发、长列表分批渲染
chunk 就是按固定长度切数组,循环每次跳 size 步,用 slice(i, i + size) 截一段放进结果。 slice 截到末尾不够长也不会报错,所以最后那组剩几个就是几个,不用额外处理。面试官最爱问的是 size 为 0:不做判断的话 i += 0 永远不动,页面直接卡死。lodash 的处理是先把 size 转成整数,小于 1 就返回空数组,我写的时候也会把这个判断放在最前面。
function chunk(arr, size = 1) {
  size = Math.floor(size)
  if (!Array.isArray(arr) || !(size >= 1)) return [] // 0、负数、NaN 都挡掉
  const res = []
  for (let i = 0; i < arr.length; i += size) res.push(arr.slice(i, i + size))
  return res
}
chunk(['a', 'b', 'c', 'd'], 3) // [['a','b','c'], ['d']]
chunk(['a', 'b'], 0)           // []
题目
/**
 * @param input
 * @param size
 * @returns {Array}
 */
_.chunk(['a', 'b', 'c', 'd'], 2)
// => [['a', 'b'], ['c', 'd']]

_.chunk(['a', 'b', 'c', 'd'], 3)
// => [['a', 'b', 'c'], ['d']]

_.chunk(['a', 'b', 'c', 'd'], 5)
// => [['a', 'b', 'c', 'd']]

_.chunk(['a', 'b', 'c', 'd'], 0)
// => []
实现
function chunk(arr, length) {
  let newArr = [];
  for (let i = 0; i < arr.length; i += length) {
    newArr.push(arr.slice(i, i + length));
  }
  return newArr;
}
💬 面试官追问
chunk(rows, 0)浏览器卡死了,为什么?循环步长是
size,为0时i永远等于0,i < arr.length一直成立,死循环。进循环前把0、负数、NaN都挡掉返回[]。能不能改成
splice一段段切,省点内存?我不会这么干。
splice会把调用方传进来的数组切空,别的地方还拿着这个引用就出事了。slice每组只是浅拷贝,元素本身没复制,内存其实多不了多少。十万个
id每50个一组发请求,最后几条老是漏,查哪?先在
chunk结果上断言:所有组拼回去长度和顺序都等于原数组。slice版本不会丢尾巴,断言过了就去看发送端,常见的是只处理了满50条的组,或者并发控制提前退出了。输入换成一个异步数据流,不是完整数组了,怎么分组?
用生成器边读边攒:攒满
size就yield一组,流结束后把剩下不满的也yield出去。这样不用一次性把所有数据放进内存,调用方改成for...of或for await...of消费。项目里就用一个
chunk,值得装lodash吗?单独引
lodash-es/chunk或lodash/chunk体积很小,没问题;为它全量引lodash就不值了。逻辑这么简单,手写加两个边界测试也完全可以。
# 4 手写深度比较isEqual
⚡ 30 秒速记
- 递归:两边有一个不是对象(或是
null)就直接===;同一个引用直接true - 先比键数量,不一样就
false;再逐个键递归比较 - 别漏了检查
obj2有没有这个键,否则{a: undefined}和{b: undefined}会被判相等 - 用
for...in会带上原型链上的可枚举属性,应该遍历Object.keys - 只适合普通对象和数组;
Date、RegExp、Map、Set、NaN、循环引用都要单独处理
深比较就是递归:值类型直接 ===,对象先比键的数量,再一个键一个键地往下比。 两个参数是同一个引用就直接返回 true,键数量不同直接 false,能提前退出就提前退出。有个容易被追问的点:如果只比 obj1[key] 和 obj2[key],不确认 obj2 真有这个键,{a: undefined} 和 {b: undefined} 会被判成相等。补一个 hasOwnProperty 就行。
function isEqual(a, b) {
  if (a === b) return true
  if (typeof a !== 'object' || typeof b !== 'object' || a === null || b === null) return Number.isNaN(a) && Number.isNaN(b)
  const ka = Object.keys(a), kb = Object.keys(b)
  if (ka.length !== kb.length || Array.isArray(a) !== Array.isArray(b)) return false
  return ka.every(k => Object.prototype.hasOwnProperty.call(b, k) && isEqual(a[k], b[k]))
}
isEqual({ a: undefined }, { b: undefined }) // false(不查 hasOwnProperty 会得到 true)
isEqual({ x: [1, { y: 2 }] }, { x: [1, { y: 2 }] }) // true
思路:深度比较两个对象,就是要深度比较对象的每一个元素。=> 递归
- 递归退出条件:
- 被比较的是两个值类型变量,直接用“===”判断
- 被比较的两个变量之一为
null,直接判断另一个元素是否也为null
- 提前结束递推:
- 两个变量
keys数量不同 - 传入的两个参数是同一个变量
- 两个变量
- 递推工作:深度比较每一个
key
function isEqual(obj1, obj2){
    //其中一个为值类型或null
    if(!isObject(obj1) || !isObject(obj2)){
        return obj1 === obj2;
    }

    //判断是否两个参数是同一个变量
    if(obj1 === obj2){
        return true;
    }

    //判断keys数是否相等
    const obj1Keys = Object.keys(obj1);
    const obj2Keys = Object.keys(obj2);
    if(obj1Keys.length !== obj2Keys.length){
        return false;
    }

    //深度比较每一个key
    for(let key in obj1){
        if(!isEqual(obj1[key], obj2[key])){
            return false;
        }
    }

    return true;
}
💬 面试官追问
不查自有属性的话,
{role: undefined}和{other: undefined}返回什么?返回
true。键数量都是1,循环里obj1.role和obj2.role都是undefined,===成立。补一句hasOwnProperty.call(obj2, key)就能挡住。isEqual(new Date(1), new Date(2))会得到什么?true,因为Date没有可枚举的自有键,两边Object.keys都是空数组。Date要比getTime(),RegExp比source和flags,Map、Set比条目,得按类型分支处理。为什么不直接
JSON.stringify(a) === JSON.stringify(b)?键的顺序不同结果就不同,
{a:1,b:2}和{b:2,a:1}会被判不等;undefined、函数会被吞掉,Date变字符串,循环引用直接抛错。数据完全受控、结构固定时可以凑合用,通用场景不行。接口响应对象里挂了
parent回指,深比较直接栈溢出,怎么修?加一个
WeakMap记录「a里的这个对象已经和b里的哪个对象配过对」,再遇到同一对就直接认为相等,不再往下走。如果a的对象之前配的是b里另一个对象,说明两边结构不一样,返回false。React组件每次渲染都对整个state做深比较,有什么问题?深比较的成本和数据规模成正比,
state一大每次渲染都要遍历一遍,可能比重新渲染还贵。更好的做法是不可变更新,让引用变化本身就表示数据变了,React.memo默认就是浅比较。
# 5 实现一个JSON.stringify
⚡ 30 秒速记
- 递归按类型拼字符串:基本类型直接转,字符串加引号,数组用
[],对象用{} undefined、函数、Symbol:在对象里整个属性跳过,在数组里变成null,顶层直接返回undefinedNaN、Infinity→null;Date走toJSON变成ISO字符串;有toJSON的对象先调它- 字符串要转义
"、\、换行等控制字符,直接拼引号会生成非法JSON - 循环引用原生会抛
TypeError,不是「被忽略」;手写版用WeakSet记录递归链来检测
手写 JSON.stringify 的核心是按类型递归:基本类型直接转字符串,字符串加引号,数组和对象分别拼方括号和花括号。 真正考的是那几个特殊值:undefined、函数和 Symbol 在对象里整条属性直接消失,在数组里变成 null,这样数组下标才不会错位;NaN 和 Infinity 也是 null。把 undefined 转成字符串 "undefined" 是不对的。还有一个常见误区,循环引用原生不是忽略,而是直接抛 TypeError: Converting circular structure to JSON。
function stringify(v, seen = new WeakSet()) {
  if (v === null) return 'null'
  if (typeof v === 'string') return JSON.stringify(v) // 偷懒处理转义,手写要自己转 " \ \n
  if (typeof v === 'number') return Number.isFinite(v) ? String(v) : 'null'
  if (typeof v === 'boolean') return String(v)
  if (typeof v !== 'object') return undefined          // undefined / function / symbol
  if (typeof v.toJSON === 'function') return stringify(v.toJSON(), seen)
  if (seen.has(v)) throw new TypeError('Converting circular structure to JSON')
  seen.add(v)
  const out = Array.isArray(v)
    ? '[' + v.map(x => stringify(x, seen) ?? 'null').join(',') + ']'
    : '{' + Object.keys(v).filter(k => stringify(v[k], seen) !== undefined)
        .map(k => JSON.stringify(k) + ':' + stringify(v[k], seen)).join(',') + '}'
  seen.delete(v) // 只防祖先回指,兄弟间共享同一对象是合法的
  return out
}
stringify({ b: undefined, c: [undefined, NaN], d: 'a"b' }) // {"c":[null,null],"d":"a\"b"}
JSON.stringify(value[, replacer [, space]]):
Boolean | Number| String类型会自动转换成对应的原始值。undefined、任意函数以及symbol,会被忽略(出现在非数组对象的属性值中时),或者被转换成null(出现在数组中时)。- 不可枚举的属性会被忽略如果一个对象的属性值通过某种间接的方式指回该对象本身,即循环引用,属性也会被忽略
- 如果一个对象的属性值通过某种间接的方式指回该对象本身,即循环引用,属性也会被忽略
function jsonStringify(obj) {
    let type = typeof obj;
    if (type !== "object") {
        if (/string|undefined|function/.test(type)) {
            obj = '"' + obj + '"';
        }
        return String(obj);
    } else {
        let json = []
        let arr = Array.isArray(obj)
        for (let k in obj) {
            let v = obj[k];
            let type = typeof v;
            if (/string|undefined|function/.test(type)) {
                v = '"' + v + '"';
            } else if (type === "object") {
                v = jsonStringify(v);
            }
            json.push((arr ? "" : '"' + k + '":') + String(v));
        }
        return (arr ? "[" : "{") + String(json) + (arr ? "]" : "}")
    }
}
jsonStringify({x : 5}) // "{"x":5}"
jsonStringify([1, "false", false]) // "[1,"false",false]"
jsonStringify({b: undefined}) // "{"b":"undefined"}"
💬 面试官追问
JSON.stringify({b: undefined, c: () => 1})结果是什么?'{}',两个属性都被跳过了。如果手写版输出{"b":"undefined","c":"() => 1"}就错了;换成数组[undefined]应该得到'[null]'。用户输入里有双引号和换行,直接
'"' + str + '"'会怎样?生成的字符串不是合法
JSON,JSON.parse一解析就报错。字符串必须转义"、\和\n、\t这些控制字符,\u0000到\u001f要写成\uXXXX。循环引用的对象传给原生
JSON.stringify会怎样?抛
TypeError,不是悄悄忽略。错误上报这类场景一般自己写个replacer,用WeakSet遇到见过的对象就返回'[Circular]'。JSON.stringify(new Date())为什么能得到一个时间字符串?因为
Date.prototype.toJSON存在,序列化时先调它,返回ISO格式字符串。任何对象只要实现了toJSON,序列化的就是它的返回值,手写版也要先检查这个。生产环境要不要用手写版替掉原生的?
不要。原生是引擎用
C++实现的,又快又完整,replacer、space、转义、BigInt抛错这些细节手写很难对齐。手写只是用来考察递归和对规范的理解。
# 6 实现一个JSON.parse
⚡ 30 秒速记
- 面试里的「手写」有两种:
eval('(' + text + ')')/new Function('return ' + text)(),本质都是把字符串当JS代码执行 - 加括号是因为
{开头会被当成代码块,不加括号eval('{"a":1}')会报语法错误 - 两者都能执行任意代码,外部输入绝对不能这么解析;
Function只是不访问局部作用域,一样不安全 eval比JSON宽松:单引号、尾逗号、undefined都能过,原生JSON.parse会报错- 真正的手写解析器是递归下降:按字符读,碰到
{、[、"、数字、true/false/null分别处理
用 eval 或 new Function 都能把 JSON 字符串变成对象,因为 JSON 大体上就是合法的 JS 表达式,但这两种都是在执行代码,不是在解析数据。 eval 要包一层括号,不然开头的 { 会被当成代码块。问题在于输入一旦被人改了,比如塞进 alert(document.cookie),它也会照样执行,new Function 只是拿不到局部变量,一样有 XSS 风险。所以生产环境只用 JSON.parse。面试官要是追问能不能不靠 eval 写,我会说递归下降的思路:维护一个下标逐字符读,看到 { 解析对象,[ 解析数组," 解析字符串,其余按数字或字面量处理。
eval('(' + '{"a":1}' + ')') // { a: 1 }
eval('(' + "{a:'x',}" + ')') // 也能过,JSON.parse 会报错
eval('(' + '(alert(1),{})' + ')') // 直接执行了 alert
JSON.parse(text[, reviver])
用来解析JSON字符串,构造由字符串描述的JavaScript值或对象。提供可选的reviver函数用以在返回之前对所得到的对象执行变换(操作)
第一种:直接调用 eval
function jsonParse(opt) {
return eval('(' + opt + ')');
}
jsonParse(jsonStringify({x : 5}))
// Object { x: 5}
jsonParse(jsonStringify([1, "false", false]))
// [1, "false", falsr]
jsonParse(jsonStringify({b: undefined}))
// Object { b: "undefined"}
避免在不必要的情况下使用
eval,eval()是一个危险的函数,他执行的代码拥有着执行者的权利。如果你用eval()运行的字符串代码被恶意方(不怀好意的人)操控修改,您最终可能会在您的网页/扩展程序的权限下,在用户计算机上运行恶意代码。它会执行JS代码,有XSS漏洞。
如果你只想记这个方法,就得对参数json做校验。
var rx_one = /^[\],:{}\s]*$/;
var rx_two = /\\(?:["\\\/bfnrt]|u[0-9a-fA-F]{4})/g;
var rx_three = /"[^"\\\n\r]*"|true|false|null|-?\d+(?:\.\d*)?(?:[eE][+\-]?\d+)?/g;
var rx_four = /(?:^|:|,)(?:\s*\[)+/g;
if (
rx_one.test(
json
.replace(rx_two, "@")
.replace(rx_three, "]")
.replace(rx_four, "")
)
) {
var obj = eval("(" +json + ")");
}
第二种:Function
核心:Function与eval有相同的字符串参数特性
var func = new Function(arg1, arg2, ..., functionBody);
在转换JSON的实际应用中,只需要这么做
var jsonStr = '{ "age": 20, "name": "jack" }'
var json = (new Function('return ' + jsonStr))();
eval与Function都有着动态编译js代码的作用,但是在实际的编程中并不推荐使用
不用 eval 的话,标准答案是递归下降解析器。核心就一个读指针 i,每个函数负责解析一种值并把 i 推到它后面:
function parse(text) {
let i = 0
const ws = () => { while (/\s/.test(text[i])) i++ }
function value() {
ws()
const ch = text[i]
if (ch === '{') return object()
if (ch === '[') return array()
if (ch === '"') return string()
if (text.startsWith('true', i)) { i += 4; return true }
if (text.startsWith('false', i)) { i += 5; return false }
if (text.startsWith('null', i)) { i += 4; return null }
return number()
}
function object() {
const obj = {}; i++; ws()
if (text[i] === '}') { i++; return obj }
while (true) {
ws(); const key = string(); ws()
if (text[i++] !== ':') throw new SyntaxError('缺少冒号,位置 ' + i)
obj[key] = value(); ws()
if (text[i] === ',') { i++; continue }
if (text[i++] === '}') return obj
throw new SyntaxError('对象没闭合,位置 ' + i)
}
}
function array() {
const arr = []; i++; ws()
if (text[i] === ']') { i++; return arr }
while (true) {
arr.push(value()); ws()
if (text[i] === ',') { i++; continue }
if (text[i++] === ']') return arr
throw new SyntaxError('数组没闭合,位置 ' + i)
}
}
function string() {
let s = ''; i++ // 跳过开头的 "
while (text[i] !== '"') {
if (i >= text.length) throw new SyntaxError('字符串没闭合')
if (text[i] === '\\') { // 简化:只处理常见转义
const map = { n: '\n', t: '\t', r: '\r', b: '\b', f: '\f', '"': '"', '\\': '\\', '/': '/' }
const e = text[++i]
if (e === 'u') { s += String.fromCharCode(parseInt(text.slice(i + 1, i + 5), 16)); i += 5; continue }
s += map[e]; i++; continue
}
s += text[i++]
}
i++
return s
}
function number() {
const m = /^-?(0|[1-9]\d*)(\.\d+)?([eE][+-]?\d+)?/.exec(text.slice(i))
if (!m) throw new SyntaxError('非法字符 ' + text[i] + ',位置 ' + i)
i += m[0].length
return Number(m[0])
}
const result = value(); ws()
if (i < text.length) throw new SyntaxError('多余内容,位置 ' + i)
return result
}
parse('{"a":[1,2,{"b":null}],"c":"x\\ny"}') // { a: [1, 2, { b: null }], c: 'x\ny' }
这个版本不会执行任何代码,单引号、尾逗号都会报错,行为和 JSON 规范一致。原生 JSON.parse 还支持第二个参数 reviver,它会自底向上遍历解析结果,对每个键值调用一次,返回 undefined 就删掉这个属性,常用来把日期字符串还原成 Date。
💬 面试官追问
为什么
eval解析JSON要在外面包一层括号?语句开头的
{会被当成代码块,eval('{"a":1}')直接语法错误。包上括号就强制按表达式解析,得到的才是对象字面量。new Function('return ' + text)比eval安全吗?不安全,只是作用域不同。
Function拿不到当前函数的局部变量,但全局对象、document.cookie照样能访问,输入里夹一段代码一样会执行。同一份配置手写解析能过,
JSON.parse却报错,大概率是什么?配置里用了
JSON不允许的写法,比如单引号、尾逗号、注释、undefined、没加引号的键。eval按JS语法所以全能过,该改的是生成配置的一方,不是把解析放宽。接口里的时间字段想直接拿到
Date对象,怎么做?用
reviver:JSON.parse(text, (k, v) => k.endsWith('At') ? new Date(v) : v)。它从最深层往外调用,返回undefined的属性会被删掉。后端返回一个超大整数
id,JSON.parse之后末尾几位变了,为什么?JSON.parse把数字转成Number,超过2^53 - 1就丢精度。最稳的是让后端把这类id以字符串返回;新一点的引擎在reviver第三个参数里能拿到原始文本context.source,可以自己转成BigInt。
# 7 解析 URL Params 为对象
⚡ 30 秒速记
- 手写流程:取
?后、#前那段 → 按&拆 → 每段按第一个=拆键值 →decodeURIComponent解码 - 重复键攒成数组,没有
=的键约定为true,a=应该是空字符串 - 几个坑:没有
?时exec(url)是null直接报错;split('=')会截断值里的=;001转数字丢前导零 - 表单编码里
+代表空格,decodeURIComponent不处理它;坏编码如%E5%ZZ会抛URIError - 现在直接用
new URL(url).searchParams/URLSearchParams,编码、+、重复键都处理好了
解析 URL 参数就是把 ? 后面那段按 & 切开,每一段按第一个 = 分成键和值,解码后放进对象,重复的键收集成数组。 用正则加 split 手写能跑示例,但边界不少:没有 ? 时正则匹配失败返回 null,取 [1] 直接报错;#hash 会被当成最后一个参数值的一部分;split('=') 会把 a=b=c 的值截成 b。数字自动转换我也不太建议,订单号 001 一转就成了 1。实际项目里我直接用 URLSearchParams:
function parseParam(url) {
const params = new URL(url, location.origin).searchParams // 相对地址也能解析
const res = Object.create(null) // 防 __proto__ 这类键
for (const [k, v] of params) { // 已经解码,+ 也转成了空格
res[k] = k in res ? [].concat(res[k], v) : v
}
return res
}
parseParam('/s?id=1&id=2&city=%E5%8C%97%E4%BA%AC&enabled#tab')
// { id: ['1', '2'], city: '北京', enabled: '' } 没有 = 时拿到的是空字符串
let url = 'http://www.domain.com/?user=anonymous&id=123&id=456&city=%E5%8C%97%E4%BA%AC&enabled';
parseParam(url)
/* 结果
{ user: 'anonymous',
id: [ 123, 456 ], // 重复出现的 key 要组装成数组,能被转成数字的就转成数字类型
city: '北京', // 中文需解码
enabled: true, // 未指定值得 key 约定为 true
}
*/
function parseParam(url) {
const paramsStr = /.+\?(.+)$/.exec(url)[1]; // 将 ? 后面的字符串取出来
const paramsArr = paramsStr.split('&'); // 将字符串以 & 分割后存到数组中
let paramsObj = {};
// 将 params 存到对象中
paramsArr.forEach(param => {
if (/=/.test(param)) { // 处理有 value 的参数
let [key, val] = param.split('='); // 分割 key 和 value
val = decodeURIComponent(val); // 解码
val = /^\d+$/.test(val) ? parseFloat(val) : val; // 判断是否转为数字
if (paramsObj.hasOwnProperty(key)) { // 如果对象有 key,则添加一个值
paramsObj[key] = [].concat(paramsObj[key], val);
} else { // 如果对象没有这个 key,创建 key 并设置值
paramsObj[key] = val;
}
} else { // 处理没有 value 的参数
paramsObj[param] = true;
}
})
return paramsObj;
}
💬 面试官追问
?coupon=A=B&id=001用split('=')加自动转数字来解析,有什么问题?split('=')只取前两段,coupon变成了'A';id被/^\d+$/转成数字1,前导零没了。按第一个=切,类型转换交给业务层按字段定义来做。传进来的
URL没有查询串,exec(url)[1]会怎样?/.+\?(.+)$/.exec(url)返回null,取[1]直接TypeError,页面就挂了。没匹配上要返回空对象;完整地址还要先把#后面的部分去掉。分享链接里
hello+world解析出来还是带加号,是解析错了吗?看来源。表单提交(
application/x-www-form-urlencoded)里+就是空格,URLSearchParams会帮你转;decodeURIComponent不管+,手写就要先replace(/\+/g, ' ')再解码。用户链接里有
%E5%ZZ这种坏编码,页面白屏了,为什么?decodeURIComponent遇到非法百分号序列会抛URIError,没有try/catch就一路冒上去。每个值单独包一层try,失败就保留原值或丢弃这一项。参数结果直接合并进普通对象,安全上要注意什么?
?__proto__[x]=1这类键可能污染原型。用Object.create(null)或Map存,或者只按白名单取需要的字段,别把整个结果Object.assign到业务对象上。
# 8 转化为驼峰命名
⚡ 30 秒速记
- 一行正则:
s.replace(/-(\w)/g, (_, c) => c.toUpperCase()),get-element-by-id→getElementById - 回调的第一个参数是整段匹配
-e,第二个起是分组,用分组比x.slice(1)更直观 - 边界:前导
-webkit-x会变WebkitX;foo--bar只吃掉一个-;结尾的name-会留着 \w只认ASCII字母数字和下划线,中文等字符不会被转- 反向转换:
s.replace(/[A-Z]/g, c => '-' + c.toLowerCase())
驼峰转换就是找到「连字符加后面一个字符」,把连字符去掉、字符变大写,用一次 replace 加回调就能搞定。 get-element-by-id 里的 -e、-b、-i 分别变成 E、B、I。我一般会用分组写法,回调里直接拿到那个字符,比回调里再 slice(1) 好读。面试时可以顺带说边界:前导连字符会把首字母也变大写,-webkit-transform 会得到 WebkitTransform,不过这恰好是 element.style 里厂商前缀的写法;连续两个 - 只会消费一个。
const camelize = s => s.replace(/-(\w)/g, (_, c) => c.toUpperCase())
camelize('get-element-by-id') // 'getElementById'
camelize('-webkit-transform') // 'WebkitTransform'
camelize('foo--bar') // 'foo-Bar'
const kebab = s => s.replace(/[A-Z]/g, c => '-' + c.toLowerCase())
kebab('getElementById') // 'get-element-by-id'
var s1 = "get-element-by-id"
// 转化为 getElementById
var f = function(s) {
return s.replace(/-\w/g, function(x) {
return x.slice(1).toUpperCase();
})
}
💬 面试官追问
replace回调里的参数分别是什么?第一个是整段匹配,比如
-e;接着是每个捕获分组;再后面是匹配位置和原字符串。所以写/-(\w)/g时,第二个参数直接就是要大写的字母。-webkit-transform转出来是WebkitTransform,对吗?看用在哪。
element.style.WebkitTransform是规范写法,没问题;但如果下游代码读的是webkitTransform,就要对前导连字符单独处理,比如先replace(/^-/, '')。foo--bar转出来是foo-Bar,怎么让它变成fooBar?正则改成
/-+(\w)/g,把连续的连字符一起吃掉。结尾多余的-也可以顺手用/-+$/去掉,规则要先跟需求对清楚。后端字段是
user-name,转成驼峰后提交时还要转回去,靠这对函数够吗?不保证可逆。
a-b-c和a-bC驼峰化后都是aBC,转回去只能得到一个。要无损来回映射,就保留原字段名或者维护一张显式映射表。键名里有中文或数字,比如
item-1-名称,会怎样?\w能匹配数字,-1会变成1(数字没有大小写);中文不属于\w,-名不匹配,连字符会保留。要支持更多字符就换成/-(\p{L}|\d)/gu这类Unicode属性写法。
# 9 实现一个函数判断数据类型
⚡ 30 秒速记
typeof能分清基本类型和函数,但null、数组、日期、正则全都是'object'Object.prototype.toString.call(x)返回[object Array]这种标签,截出中间那段转小写null要先单独判断,typeof null === 'object'是历史遗留问题- 跨
iframe时instanceof Array会失效,toString方案和Array.isArray不受影响 - 标签能被
Symbol.toStringTag改掉,类型判断不等于数据有效,比如new Date('bad')仍是'date'
判断类型我会组合两招:基本类型用 typeof,对象用 Object.prototype.toString.call 拿内部标签。 typeof 的问题是 null、数组、日期、正则全返回 'object';而 toString.call 会返回 [object Array]、[object Date] 这种标签,截一下中间部分就能区分。null 一定要先判,因为 typeof null 是 'object',这是 JS 第一版留下来的设计失误,一直没改。比 instanceof 好的地方在于跨 iframe 也准。
function getType(v) {
if (v === null) return 'null'
if (typeof v !== 'object') return typeof v // 'number' | 'string' | 'function' | 'bigint' ...
return Object.prototype.toString.call(v).slice(8, -1).toLowerCase()
}
getType([]) // 'array'
getType(new Map()) // 'map'
getType(/a/) // 'regexp'
getType(() => {}) // 'function'
function getType(obj) {
if (obj === null) return String(obj);
return typeof obj === 'object'
? Object.prototype.toString.call(obj).replace('[object ', '').replace(']', '').toLowerCase()
: typeof obj;
}
// 调用
getType(null); // -> null
getType(undefined); // -> undefined
getType({}); // -> object
getType([]); // -> array
getType(123); // -> number
getType(true); // -> boolean
getType('123'); // -> string
getType(/123/); // -> regexp
getType(new Date()); // -> date
💬 面试官追问
typeof null为什么是'object'?第一版
JS用低位标签存类型,对象的标签是0,null是全零的空指针,就被认成了对象。改了会破坏大量老代码,所以一直保留。为什么不用
instanceof Array?instanceof查的是原型链上有没有当前窗口的Array.prototype。数组如果来自另一个iframe,它的原型是那个窗口的Array,结果就是false。判断数组直接用Array.isArray最稳。getType(new Date('bad'))返回'date',但格式化出来是Invalid Date,怎么办?类型对,值无效,这是两件事。日期分支再加一句
!Number.isNaN(d.getTime())判断有效性,类型判断和业务校验分开做。别人传进来一个对象说自己是
Date,toString标签能信吗?不能全信。对象设置
[Symbol.toStringTag]: 'Date'后,toString.call就会返回[object Date]。安全相关的判断要看它能不能真正调用需要的方法,而不是只看标签。class实例new Person()用这个函数会返回什么?返回
'object',自定义类的标签默认就是Object。要拿到类名可以看v.constructor?.name,但它能被改,压缩后也可能变成单个字母。
# 10 对象数组列表转成树形结构(处理菜单)
⚡ 30 秒速记
- 两遍循环:第一遍按
id建索引Map,第二遍按parentId把节点挂到父节点children,O(n) - 别每个节点都去数组里找父节点,那是
O(n²) - 直接在原对象上加
children,同一份数据转两次子节点会重复;要先浅拷贝 - 父节点不存在时
temp[parentId].children直接报错,要决定是丢掉还是当根节点 - 遍历
temp对象的话,数字键会按升序排,接口给的顺序就丢了;按原数组顺序遍历
列表转树的标准做法是两遍循环:第一遍把所有节点按 id 放进一个 Map,第二遍看每个节点的 parentId,从 Map 里拿到父节点,挂到它的 children 上。 这样找父节点是 O(1),整体 O(n),比每个节点都扫一遍数组的 O(n²) 快得多。用普通对象当索引的写法有几个问题我会主动提:一是直接往原对象上加 children,同一份数据转两次就会重复挂;二是父节点不存在时 temp[parentId].children 直接报错;三是遍历 temp 对象时,数字键会被引擎按升序排,接口给的顺序就丢了。
function listToTree(list, rootId = 0) {
const map = new Map(list.map(n => [n.id, { ...n, children: [] }])) // 拷贝,不污染原数据
const roots = []
for (const item of list) { // 按原数组顺序,保证菜单顺序
const node = map.get(item.id)
const parent = map.get(item.parentId)
if (item.parentId === rootId || !parent) roots.push(node) // 找不到父节点就当根,按需求改
else parent.children.push(node)
}
return roots
}
listToTree([{ id: 1, parentId: 0 }, { id: 2, parentId: 1 }])
// [{ id: 1, parentId: 0, children: [{ id: 2, parentId: 1, children: [] }] }]
[
{
id: 1,
text: '节点1',
parentId: 0 //这里用0表示为顶级节点
},
{
id: 2,
text: '节点1_1',
parentId: 1 //通过这个字段来确定子父级
}
...
]
转成
[
{
id: 1,
text: '节点1',
parentId: 0,
children: [
{
id:2,
text: '节点1_1',
parentId:1
}
]
}
]
实现代码如下:
function listToTree(data) {
let temp = {};
let treeData = [];
for (let i = 0; i < data.length; i++) {
temp[data[i].id] = data[i];
}
for (let i in temp) {
if (+temp[i].parentId != 0) {
if (!temp[temp[i].parentId].children) {
temp[temp[i].parentId].children = [];
}
temp[temp[i].parentId].children.push(temp[i]);
} else {
treeData.push(temp[i]);
}
}
return treeData;
}
💬 面试官追问
为什么不在每个节点上遍历一遍数组找父节点?
那是
O(n²),几千个菜单节点就是几百万次比较。建一个id到节点的Map,找父节点变成O(1),整体O(n),代价只是多一份索引的内存。同一份菜单数据转两次,子菜单重复了,为什么?
在原对象上直接
push到children的话,第一次转完children已经有数据了,第二次接着往里加。建索引时用{ ...n, children: [] }拷一份,函数就没有副作用了。接口里有个节点的
parentId指向不存在的id,会怎样?执行
temp[parentId].children时temp[parentId]是undefined,直接报错,整个菜单都渲染不出来。先判断父节点在不在,不在就放到根上或者单独收集起来上报,跟产品约定好。菜单顺序和接口返回的顺序不一致,查哪?
看是不是遍历了以
id为键的普通对象。整数键在对象里会按数值升序枚举,接口的顺序就没了。按原数组顺序遍历,或者明确按sort字段排序。数据里出现
A的父是B、B的父又是A,会怎样?两个节点互相挂在对方的
children里,又都不是根,结果整组节点从树上消失了;递归渲染时如果能走进去还会无限循环。转换前做一次环检测,或者从根开始遍历时用Set记录访问过的节点。
# 11 树形结构转成列表(处理菜单)
⚡ 30 秒速记
- 深度优先遍历,把每个节点去掉
children后放进结果,children继续递归 push写在递归之后,得到的是子在前、父在后(后序);想要父在前就先push再递归delete item.children会改掉原树,其他组件拿着同一份数据就丢了子节点- 用
const { children, ...rest } = item生成新对象,不碰原数据 - 层级很深时递归可能爆栈,改成显式栈;要按层输出用队列做
BFS
树转列表就是深度优先遍历一遍,每个节点去掉 children 放进数组,有子节点就继续往下走。 有两个细节容易被追问:一是 res.push(item) 如果写在递归之后,所以输出是子节点在前、父节点在后,大多数场景要的是父在前,把 push 提到前面就行;二是用 delete item.children 会直接改原树,页面上其他地方用着这份数据,子菜单就突然没了。我会用解构拿到不含 children 的新对象。
function treeToList(tree, parentId = 0) {
const res = []
const dfs = (nodes, pid) => nodes.forEach(({ children, ...rest }) => {
res.push({ ...rest, parentId: pid }) // 先放父节点
if (children?.length) dfs(children, rest.id)
})
dfs(tree, parentId)
return res
}
treeToList([{ id: 1, children: [{ id: 2 }] }])
// [{ id: 1, parentId: 0 }, { id: 2, parentId: 1 }] 原树不变
[
{
id: 1,
text: '节点1',
parentId: 0,
children: [
{
id:2,
text: '节点1_1',
parentId:1
}
]
}
]
转成
[
{
id: 1,
text: '节点1',
parentId: 0 //这里用0表示为顶级节点
},
{
id: 2,
text: '节点1_1',
parentId: 1 //通过这个字段来确定子父级
}
...
]
实现代码如下:
function treeToList(data) {
let res = [];
const dfs = (tree) => {
tree.forEach((item) => {
if (item.children) {
dfs(item.children);
delete item.children;
}
res.push(item);
});
};
dfs(data);
return res;
}
💬 面试官追问
push写在递归后面,输出为什么是子节点在前、父节点在后?res.push(item)写在dfs(item.children)后面,是后序遍历,子树全部放完才轮到自己。挪到递归前面就变成先序,父在前。调用完
treeToList,另一个组件的树形菜单子节点全没了,为什么?delete item.children改的是原对象,所有引用这份数据的地方都受影响。用const { children, ...rest } = item生成新对象放进结果,原树不动。树有一万层,递归版直接栈溢出,怎么改?
换成显式栈:先把根节点逆序压栈,每次弹一个放进结果,再把它的
children逆序压进去,顺序就和先序递归一致。栈放在堆上,层数再深也不会爆。想按层级输出,先所有一级菜单再所有二级,怎么写?
用队列做广度优先:根节点入队,每次出队一个放进结果,再把它的子节点依次入队。和
DFS只是容器从栈换成队列。节点自己有
parentId,和嵌套关系对不上,以谁为准?先和后端约定。一般以嵌套结构为准,遍历时直接用父节点的
id覆盖子节点的parentId,不一致的情况记日志上报,别默默修掉后端的数据问题。
# 34 手写常见排序
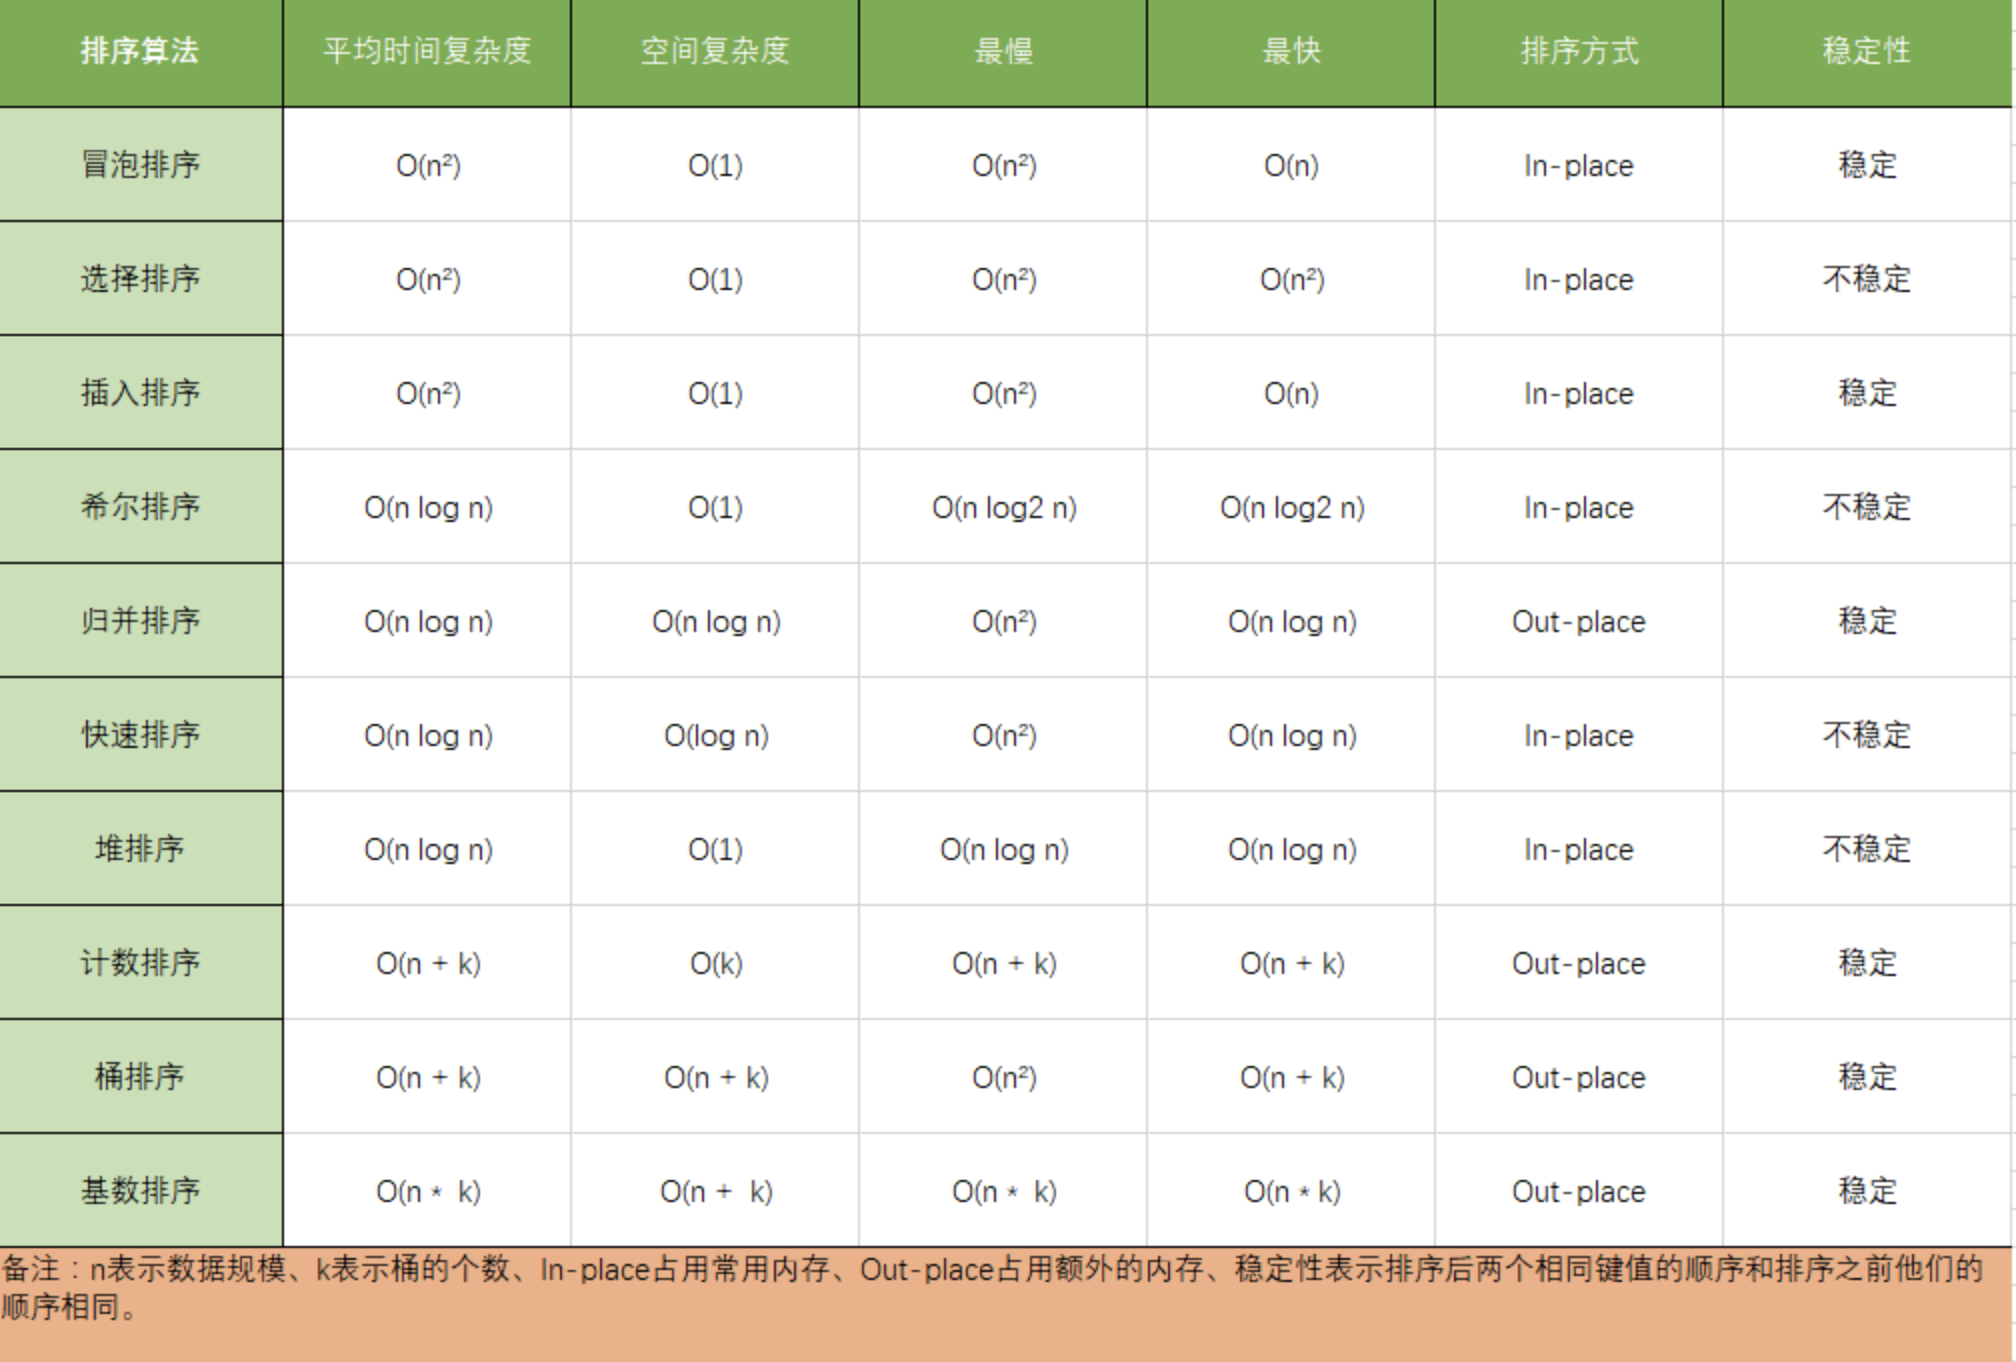
# 1 冒泡排序
⚡ 30 秒速记
- 相邻两两比较,前面大就交换,一轮下来最大值「冒」到末尾
- 每轮末尾多一个排好的,内层循环到
n - i - 1就够了 - 优化:加个
swapped标记,某轮一次都没换说明已经有序,直接退出,最好O(n) - 平均和最坏
O(n²),空间O(1);只在>时交换,所以是稳定排序 - 原地修改原数组,调用方不想被改就先
[...arr]
冒泡排序就是相邻两个比,前面的大就交换,一轮走完最大的那个就到了最后,像气泡往上冒一样。 每轮结束末尾就多一个确定位置的元素,所以内层循环只要到 n - i - 1。有个常见优化:如果某一轮一次交换都没发生,说明数组已经有序,可以直接结束,对已经排好的数组只要走一轮,O(n)。它是稳定排序,因为相等的元素不会交换。
function bubbleSort(arr) {
const a = [...arr] // 不改原数组
for (let i = 0; i < a.length - 1; i++) {
let swapped = false
for (let j = 0; j < a.length - 1 - i; j++) {
if (a[j] > a[j + 1]) {
[a[j], a[j + 1]] = [a[j + 1], a[j]]
swapped = true
}
}
if (!swapped) break // 这一轮没换,已经有序
}
return a
}
bubbleSort([3, 1, 2]) // [1, 2, 3]
冒泡排序的原理如下,从第一个元素开始,把当前元素和下一个索引元素进行比较。如果当前元素大,那么就交换位置,重复操作直到比较到最后一个元素,那么此时最后一个元素就是该数组中最大的数。下一轮重复以上操作,但是此时最后一个元素已经是最大数了,所以不需要再比较最后一个元素,只需要比较到
length - 1的位置。
function bubbleSort(list) {
var n = list.length;
if (!n) return [];
for (var i = 0; i < n; i++) {
// 注意这里需要 n - i - 1
for (var j = 0; j < n - i - 1; j++) {
if (list[j] > list[j + 1]) {
var temp = list[j + 1];
list[j + 1] = list[j];
list[j] = temp;
}
}
}
return list;
}
💬 面试官追问
数组本来就是有序的,不加优化的冒泡还要跑多少次比较?
还是完整的
n(n-1)/2次,因为它不管有没有交换都会跑完所有轮。加swapped标记,第一轮发现没交换就退出,只比n - 1次。冒泡排序是稳定的吗?改成
>=呢?用
>时相等元素不交换,是稳定的。改成>=相等的也会换位置,稳定性就没了,同分的用户可能顺序颠倒。排序后原来那个数组也变了,别的组件跟着乱了,为什么?
交换是直接写在传入的数组上的,原地修改,引用同一个数组的地方都会变。要么先拷贝一份再排,要么函数名和文档写明会改原数组。
数组里有
undefined和NaN,排完位置很奇怪,为什么?undefined和NaN跟任何数比较>都是false,永远不会被交换,就卡在原地。入口要么过滤掉,要么让调用方传比较函数,明确空值放前面还是后面。几万条数据前端排序用冒泡行吗?
不行,
O(n²)下几万条就是上亿次比较,主线程直接卡住。直接arr.sort((a, b) => a - b),V8用的是TimSort,O(n log n)而且稳定。
# 2 快速排序
⚡ 30 秒速记
- 分治:选一个基准,小的放左边、大的放右边,左右递归,最后拼起来
- 平均
O(n log n),最坏O(n²):基准每次都选到极值,或者大量重复值都挤到一边 - 「额外数组版」好写好讲但每层都新建数组,空间
O(n)起;原地分区版才是真正的工程实现 splice版会把基准从原数组删掉,改了调用方的数据;slice版不改,推荐后者- 优化:随机选基准 / 三路分区(
<、=、>)处理重复值;小数组切插入排序
快排的思路是分治:选一个基准值,比它小的放左边,大的放右边,再对左右两边递归,最后拼起来。 额外数组这种写法每层都新建 left、right 数组,特别好理解,面试手写够用,但它不是原地排序,额外空间不少。平均复杂度是 O(n log n),最坏会退化到 O(n²):比如有大量相同的值,代码把所有「不小于基准」的都放进 right,每次只排掉一个元素,递归深度变成 n,还可能栈溢出。解决办法是三路分区,把等于基准的单独放一组。
function quickSort(arr) {
if (arr.length <= 1) return arr
const pivot = arr[Math.floor(Math.random() * arr.length)] // 随机基准
const left = [], mid = [], right = []
for (const n of arr) (n < pivot ? left : n > pivot ? right : mid).push(n)
return [...quickSort(left), ...mid, ...quickSort(right)] // 三路,重复值不再递归
}
quickSort([3, 1, 3, 2, 3]) // [1, 2, 3, 3, 3]
思路分析
- 找到中间位置
midValue - 遍历数组,小于
midValue放在left,否则放在right - 继续递归,最后
concat拼接返回 - 使用
splice会修改原数组,使用slice不会修改原数组(推荐) - 一层遍历+二分的时间复杂度是
O(nlogn)
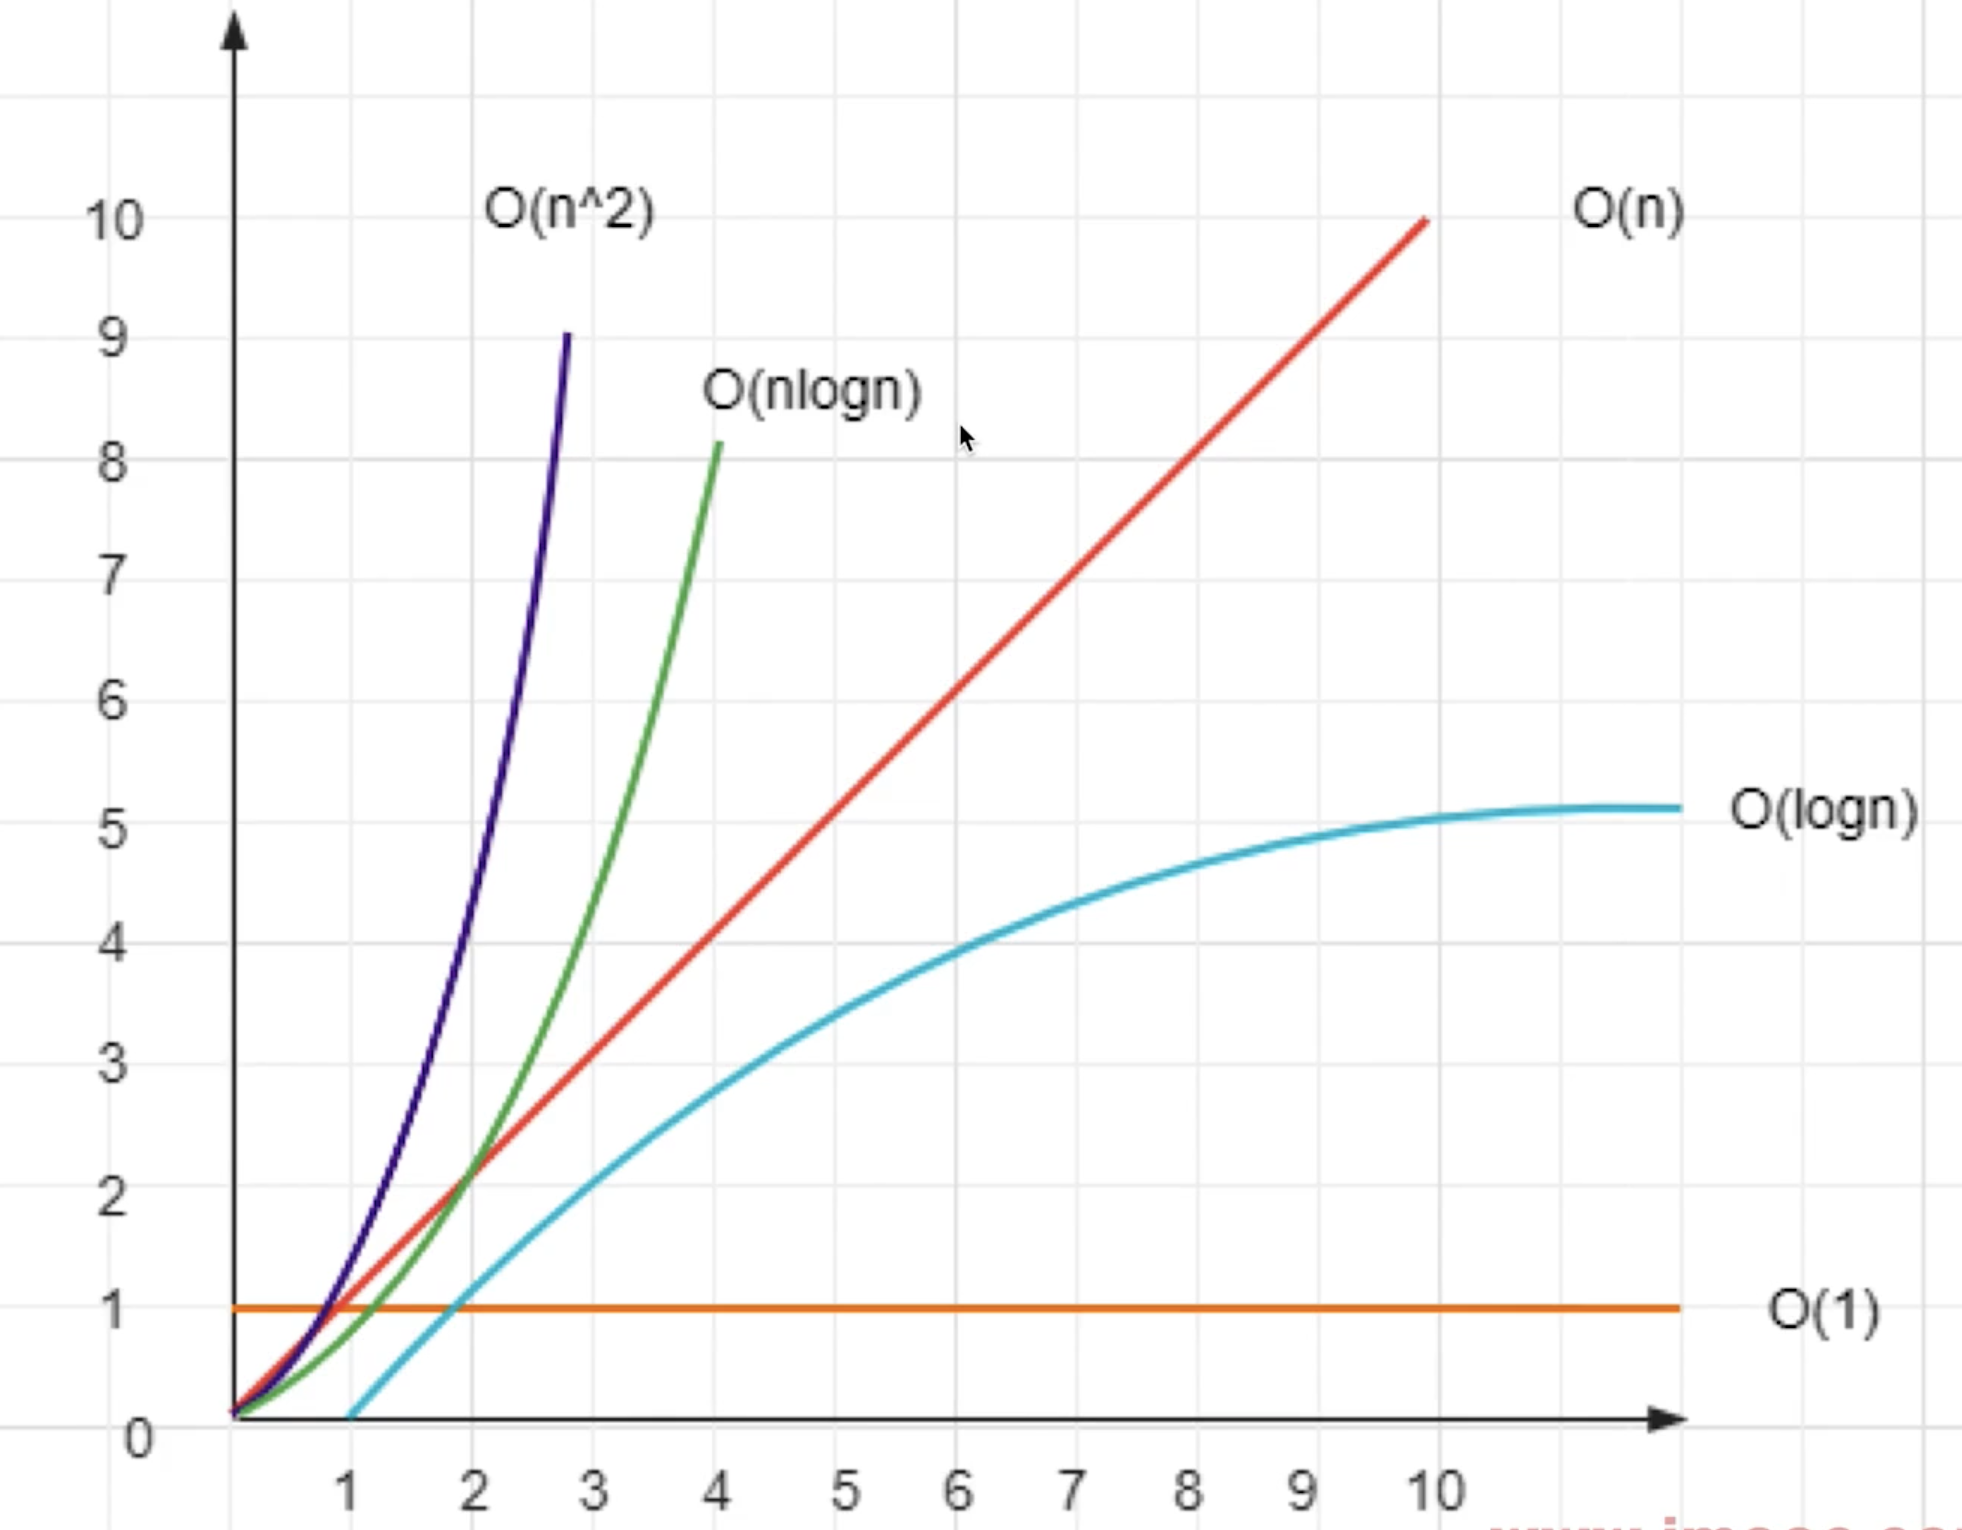
快速排序(使用 splice)
/**
* 快速排序(使用 splice)
* @param arr:number[] number arr
*/
function quickSort1(arr) {
const length = arr.length
if (length === 0) return arr
// 获取中间的数
const midIndex = Math.floor(length / 2)
const midValue = arr.splice(midIndex, 1)[0] // splice会修改原数组,传入开始位置和长度是1
const left = []
const right = []
// 注意:这里不用直接用 length ,而是用 arr.length 。因为 arr 已经被 splice 给修改了
for (let i = 0; i < arr.length; i++) {
const n = arr[i]
if (n < midValue) {
// 小于 midValue ,则放在 left
left.push(n)
} else {
// 大于 midValue ,则放在 right
right.push(n)
}
}
return quickSort1(left).concat([midValue], quickSort1(right))
}
快速排序(使用 slice)
/**
* 快速排序(使用 slice)
* @param arr number arr
*/
function quickSort2(arr) {
const length = arr.length
if (length === 0) return arr
// 获取中间的数
const midIndex = Math.floor(length / 2)
const midValue = arr.slice(midIndex, midIndex + 1)[0] // 使用slice不会修改原数组,传入开始位置和结束位置
const left = []
const right = []
for (let i = 0; i < length; i++) {
if (i !== midIndex) { // 这里要忽略掉midValue
const n = arr[i]
if (n < midValue) {
// 小于 midValue ,则放在 left
left.push(n)
} else {
// 大于 midValue ,则放在 right
right.push(n)
}
}
}
return quickSort2(left).concat([midValue], quickSort2(right))
}
// 功能测试
const arr1 = [1, 6, 2, 7, 3, 8, 4, 9, 5]
console.info(quickSort2(arr1))
// 性能测试
// 快速排序(使用 splice)
const arr1 = []
for (let i = 0; i < 10 * 10000; i++) {
arr1.push(Math.floor(Math.random() * 1000))
}
console.time('quickSort1')
quickSort1(arr1)
console.timeEnd('quickSort1') // 74ms
// 快速排序(使用 slice)
const arr2 = []
for (let i = 0; i < 10 * 10000; i++) {
arr2.push(Math.floor(Math.random() * 1000))
}
console.time('quickSort2')
quickSort2(arr2)
console.timeEnd('quickSort2') // 82ms
// 单独比较 splice 和 slice
const arr1 = []
for (let i = 0; i < 10 * 10000; i++) {
arr1.push(Math.floor(Math.random() * 1000))
}
console.time('splice')
arr1.splice(5 * 10000, 1)
console.timeEnd('splice') // 0.08ms
const arr2 = []
for (let i = 0; i < 10 * 10000; i++) {
arr2.push(Math.floor(Math.random() * 1000))
}
console.time('slice')
arr2.slice(5 * 10000, 5 * 10000 + 1)
console.timeEnd('slice') // 0.008ms
💬 面试官追问
十万个相同的分数用
quickSort2排,为什么栈溢出了?所有值都不小于基准,全进了
right,每层只少一个元素,递归深度十万层。改成三路分区,等于基准的单独放mid不再递归,重复值一层就处理完了。基准取中间位置,是不是就不会退化?
不会自动避免。取中间位置只是对已经有序的数组友好,碰上特别构造的数据或大量重复值还是会偏。常用的是随机选基准或者三数取中,再配合三路分区。
splice版和slice版选哪个?slice版。splice会把基准从传进来的数组里删掉,调用方的数据被改了。一个74ms一个82ms这种数是两组不同随机数各跑一次的结果,说明不了谁快。快排是稳定排序吗?
经典的原地分区快排不稳定,交换会打乱相等元素的顺序。按顺序
push到新数组的写法其实是稳定的,但代价就是额外空间。JS内置的sort用的是快排吗?现在不是。
V8从7.0(Chrome 70)开始改用TimSort,规范从ES2019起要求sort必须稳定。更早的V8对长数组用快排、短数组用插入排序,那时是不稳定的。
# 3 选择排序
⚡ 30 秒速记
- 每轮在未排序区间里找最小值的下标,跟区间第一个交换,已排序区间往后长一格
- 记下标不记值,因为最后要按位置交换
- 不管数据什么样都是
O(n²)次比较,但每轮最多交换一次,总交换O(n) - 不稳定:
[5a, 5b, 2]第一轮2和5a交换,5a跑到5b后面 - 内层循环从
j = i + 1开始就行,写成j = i只是多比一次自己
选择排序是每一轮从还没排的部分里挑出最小的,放到这部分的最前面。 所以外层 i 是已排序和未排序的分界线,内层用 minIndex 记住最小值的位置,扫完再和 i 交换一次。它的特点是比较次数固定 n(n-1)/2,数组本来有序也省不了;但交换次数很少,每轮最多一次。另外它不稳定:远距离交换会把相等元素的先后顺序打乱。
function selectSort(arr) {
for (let i = 0; i < arr.length - 1; i++) {
let min = i
for (let j = i + 1; j < arr.length; j++) if (arr[j] < arr[min]) min = j
if (min !== i) [arr[i], arr[min]] = [arr[min], arr[i]]
}
return arr
}
// 不稳定的例子:按 score 排 [{s:5,n:'a'},{s:5,n:'b'},{s:2,n:'c'}]
// 第一轮 c 和 a 交换 → c, b, a,a 跑到了 b 后面
function selectSort(arr) {
// 缓存数组长度
const len = arr.length;
// 定义 minIndex,缓存当前区间最小值的索引,注意是索引
let minIndex;
// i 是当前排序区间的起点
for (let i = 0; i < len - 1; i++) {
// 初始化 minIndex 为当前区间第一个元素
minIndex = i;
// i、j分别定义当前区间的上下界,i是左边界,j是右边界
for (let j = i; j < len; j++) {
// 若 j 处的数据项比当前最小值还要小,则更新最小值索引为 j
if (arr[j] < arr[minIndex]) {
minIndex = j;
}
}
// 如果 minIndex 对应元素不是目前的头部元素,则交换两者
if (minIndex !== i) {
[arr[i], arr[minIndex]] = [arr[minIndex], arr[i]];
}
}
return arr;
}
// console.log(selectSort([3, 6, 2, 4, 1]));
💬 面试官追问
同积分用户排完先后顺序乱了,选择排序的锅吗?
是。找到最小值后跟区间头部交换,中间隔着的元素不动,原来排在头部的那个就被甩到后面去了,可能越过和它相等的元素。需要稳定就换插入排序、归并,或者直接用内置
sort。数组已经有序,选择排序会快一点吗?
不会,每一轮都要扫完剩下的全部元素才知道谁最小,比较次数永远是
n(n-1)/2。这点不如冒泡加标记和插入排序,它们对有序数据是O(n)。每轮只交换一次,那十万条数据是不是也挺快?
交换少不代表比较少,十万条就是约
50亿次比较,照样卡死。少交换只在「写一次特别贵」的场景才有意义,比如写闪存。内层循环从
j = i改成j = i + 1,会有问题吗?没问题,
minIndex初始就是i,拿arr[i]和自己比不会改变结果。只是省一次比较,复杂度不变。字符串
'10'排到了'2'前面,是循环写错了吗?不是,两个字符串用
<比较是按字符编码逐位比的,'1'小于'2'。入口先统一转成数字,或者让调用方传比较函数。
# 4 插入排序
⚡ 30 秒速记
- 像摸扑克牌:左边是排好的手牌,每次拿下一张,从右往左找位置插进去
- 先用
target存下当前值,比它大的依次右移一格,空出的位置放target - 最好
O(n)(几乎有序),最坏O(n²)(逆序),空间O(1) - 稳定:条件是
>不是>=,相等的不移动 - 小数组和近乎有序的数据很快,
TimSort内部的小段就是用插入排序(二分插入)
插入排序就像打牌时理手牌:左边已经排好,每次拿右边下一张,从后往前找到合适位置插进去。 代码里先把当前元素存到 target,前面比它大的都往右挪一格,最后把 target 放进空出来的位置。它对几乎有序的数据特别快,每个元素只挪一两步,接近 O(n);完全逆序时每个都要挪到最前面,就是 O(n²)。条件写的是 >,相等元素不会移动,所以是稳定排序。
function insertSort(arr) {
for (let i = 1; i < arr.length; i++) {
const target = arr[i]
let j = i
while (j > 0 && arr[j - 1] > target) { // 用 > 保证稳定
arr[j] = arr[j - 1] // 右移,不是交换
j--
}
arr[j] = target
}
return arr
}
insertSort([3, 6, 2, 4, 1]) // [1, 2, 3, 4, 6]
function insertSort(arr) {
for (let i = 1; i < arr.length; i++) {
let j = i;
let target = arr[j];
while (j > 0 && arr[j - 1] > target) {
arr[j] = arr[j - 1];
j--;
}
arr[j] = target;
}
return arr;
}
// console.log(insertSort([3, 6, 2, 4, 1]));
💬 面试官追问
日志列表基本有序,每次只追加几条,用插入排序合适吗?
很合适。前面已经有序,新加的元素只要往前挪几步就到位,总代价接近
O(n)。这也是TimSort对小段用插入排序的原因。把条件里的
>改成>=会怎样?结果还是有序的,但相等元素也会被挪到前面,稳定性没了。同价格商品原本按上架时间排,改完顺序就乱了。
数组元素是
{ score: 10 }这样的对象,排完没变化,为什么?arr[j - 1] > target比的是两个对象,会先转成'[object Object]'再比,永远是false。要么传比较函数cmp(a, b) => a.score - b.score,要么先提取排序键。五十万条逆序数据,丢进
Worker用插入排序可以吗?Worker只是不卡页面,算法本身还是O(n²),五十万条要上千亿次操作,用户等不起。换O(n log n)的排序,或者交给服务端。为什么是「右移」而不是相邻交换?
交换每步要写两次,右移只写一次,最后再把
target放回去。结果一样,写操作少一半左右,复杂度都是O(n²)。
# 5 二分查找
⚡ 30 秒速记
- 前提:数组有序。每次看中间元素,目标大就去右半边,小就去左半边,
O(log n) - 区间约定要统一:闭区间
[start, end]就写while (start <= end),end初始为length - 1 - 缩区间一定是
mid + 1/mid - 1,写成mid会在两个元素时死循环 - 递归版能用,但迭代版更直观;
mid = start + ((end - start) >> 1) - 有重复值要找第一个出现位置:命中后先记下,继续往左找
二分查找的前提是数组有序,每次和中间元素比,目标更大就丢掉左半边,更小就丢掉右半边,一百万个元素最多比 20 次。 最容易写错的是区间约定:我习惯用闭区间,end 从 length - 1 开始,循环条件 start <= end,缩区间用 mid + 1 和 mid - 1。如果写成 start = mid,区间剩两个元素时 mid 算出来一直是同一个位置,就死循环了。递归写法也能跑,面试我更推荐迭代版。
function search(arr, target) {
let start = 0, end = arr.length - 1 // 闭区间
while (start <= end) {
const mid = start + ((end - start) >> 1)
if (arr[mid] === target) return mid
if (arr[mid] < target) start = mid + 1
else end = mid - 1
}
return -1
}
search([1, 3, 5, 7, 9], 7) // 3
search([1, 3, 5, 7, 9], 4) // -1
function search(arr, target, start, end) {
let targetIndex = -1;
let mid = Math.floor((start + end) / 2);
if (arr[mid] === target) {
targetIndex = mid;
return targetIndex;
}
if (start >= end) {
return targetIndex;
}
if (arr[mid] < target) {
return search(arr, target, mid + 1, end);
} else {
return search(arr, target, start, mid - 1);
}
}
// const dataArr = [1, 2, 3, 4, 5, 6, 7, 8, 9];
// const position = search(dataArr, 6, 0, dataArr.length - 1);
// if (position !== -1) {
// console.log(`目标元素在数组中的位置:${position}`);
// } else {
// console.log("目标元素不在数组中");
// }
💬 面试官追问
数组里有多个
5,要返回第一个5的位置,怎么改?命中后不急着返回,先记
ans = mid,再end = mid - 1继续往左找,循环结束返回ans。找最后一个就反过来收start,复杂度还是O(log n)。有人把递归改成
search(arr, target, mid, end),偶发卡死,为什么?区间没有严格缩小。剩两个元素时
mid等于start,下一轮还是同一个区间,无限递归下去。命中不了mid就必须排除它,写mid + 1。首次调用把
arr.length当end传进去,有什么问题?这个实现是闭区间,
end要能访问到。传length时mid可能取到越界下标,读到undefined,边界判断也会乱。闭区间传length - 1,要用左闭右开就整套改成while (start < end)和end = mid。(start + end) / 2在JS里会溢出吗?JS的数字是双精度浮点,数组下标范围内不会溢出,这是Java、C++里int的问题。但写成start + ((end - start) >> 1)是个好习惯,换语言也不出错。后端返回按字符串排序的编码,前端按数字二分,结果不对,为什么?
二分用的比较规则必须和排序时一样。字符串排序下
'10'在'2'前面,按数字比就不再是有序的了。要么按字符串比较来查,要么前端统一转换后重新排序。
# 35 算法数据结构
这一组收录 120 道高频核心题,不是按题号背答案,而是按「数据结构 → 解题套路 → 边界」复习。题目从链表、栈队列、哈希、树、二分、回溯、动态规划和双指针等主题中筛选后重新组织;外部仓库只用于核对选题覆盖范围,题面、讲解、实现与演示均由本站独立重写。示例实现以面试现场可讲清、可运行、可验证为目标,代码的每一行都附有说明。
# 1 实现一个单向链表
⚡ 30 秒速记
- 节点存
value和next,链表维护head、tail、size三个状态,任何操作完都要保持一致 - 头插、尾插(有
tail)O(1);按索引查、插、删都要先走到前驱,O(n) - 插入位置允许等于
size(尾插),查询和删除只能到size - 1 - 最容易漏:删掉最后一个节点要更新
tail;链表删空了head、tail都要是null - 用一个哨兵头节点
dummy可以去掉头部的特殊分支
单向链表难的不是写节点类,而是每次增删之后 head、tail、size 三个状态还对得上。 插入和删除都是先找到目标位置的前驱节点,再改两根指针。头部操作要单独处理,或者干脆加一个哨兵节点统一逻辑。最常见的错误是删除尾节点时忘了把 tail 指回前驱,之后再 append 就接到了一个已经不在链表里的节点上。
removeAt(index) {
if (index < 0 || index >= this.size) throw new RangeError('索引越界')
let removed
if (index === 0) {
removed = this.head
this.head = removed.next
if (this.size === 1) this.tail = null // 删空了
} else {
const prev = this.getNode(index - 1)
removed = prev.next
prev.next = removed.next
if (removed === this.tail) this.tail = prev // 删的是尾巴
}
this.size -= 1
return removed.value
}
# 题目与解题思路
实现支持追加、按索引插入、按索引删除、按索引读取和转数组的单向链表。关键是先找到目标位置的前驱节点,再一次性改好连接关系;任何修改完成后,head、tail、size 必须仍然互相一致。
class ListNode { // 定义单向链表节点
constructor(value, next = null) { // 接收节点值和后继节点
this.value = value // 保存当前节点的数据
this.next = next // 保存指向下一个节点的引用
} // 结束节点构造函数
} // 结束节点类
class SinglyLinkedList { // 定义单向链表
constructor() { // 初始化空链表
this.head = null // 头指针暂时没有节点
this.tail = null // 尾指针暂时没有节点
this.size = 0 // 空链表长度为零
} // 结束链表构造函数
getNode(index) { // 根据索引返回节点
if (index < 0 || index >= this.size) throw new RangeError('索引越界') // 拒绝非法查询位置
let current = this.head // 从头节点开始移动
for (let i = 0; i < index; i += 1) current = current.next // 前进到目标索引
return current // 返回找到的节点
} // 结束节点查询
append(value) { // 在链表尾部追加值
const node = new ListNode(value) // 创建新的尾节点
if (this.size === 0) this.head = node // 空链表时新节点也是头节点
else this.tail.next = node // 非空时让旧尾节点连接新节点
this.tail = node // 更新尾指针
this.size += 1 // 更新链表长度
return this // 返回链表以支持链式调用
} // 结束尾部追加
insert(index, value) { // 在指定索引前插入值
if (index < 0 || index > this.size) throw new RangeError('索引越界') // 插入位置可等于当前长度
if (index === this.size) return this.append(value) // 尾部插入复用追加逻辑
const node = new ListNode(value) // 创建待插入节点
if (index === 0) { // 单独处理头部插入
node.next = this.head // 新节点先连接旧头节点
this.head = node // 再把头指针切到新节点
this.size += 1 // 更新链表长度
return this // 返回修改后的链表
} // 结束头部插入分支
const previous = this.getNode(index - 1) // 找到插入位置的前驱节点
node.next = previous.next // 新节点连接原来的后继节点
previous.next = node // 前驱节点连接新节点
this.size += 1 // 更新链表长度
return this // 返回修改后的链表
} // 结束指定位置插入
remove(index) { // 删除并返回指定索引的值
if (index < 0 || index >= this.size) throw new RangeError('索引越界') // 删除位置不能等于长度
let removed = null // 保存即将移除的节点
if (index === 0) { // 单独处理头节点
removed = this.head // 记录旧头节点
this.head = this.head.next // 头指针移动到下一个节点
} else { // 处理中间或尾部节点
const previous = this.getNode(index - 1) // 找到目标节点的前驱
removed = previous.next // 记录目标节点
previous.next = removed.next // 前驱跨过目标节点连接其后继
if (index === this.size - 1) this.tail = previous // 删除尾节点时更新尾指针
} // 结束删除位置分支
this.size -= 1 // 更新链表长度
if (this.size === 0) this.tail = null // 链表清空时同步清空尾指针
removed.next = null // 断开被删节点与链表的连接
return removed.value // 返回被删除的数据
} // 结束删除方法
toArray() { // 把链表转换成数组便于验证
const result = [] // 创建结果数组
let current = this.head // 从头节点开始遍历
while (current) { // 只要当前节点存在就继续
result.push(current.value) // 收集当前节点的数据
current = current.next // 移动到下一个节点
} // 结束链表遍历
return result // 返回所有节点值
} // 结束数组转换
} // 结束链表类
# 复杂度、示例与易错点
append为O(1);getNode、中间插入和中间删除为O(n);额外空间为O(1)。- 示例:依次执行
append(1)、append(3)、insert(1, 2),toArray()应得到[1, 2, 3];再删除索引2,应返回3,且tail.value为2。 - 易错点:空链表第一次追加时要同时设置
head和tail;删掉唯一节点后也要同时清空两者。
💬 面试官追问
消息流只在头部插入,链表和数组哪个快?
链表头插只改两个引用,
O(1);数组unshift要把后面所有元素挪一位,O(n)。但链表按下标读是O(n),每个节点还多一个指针的内存。压测时尾部追加越来越慢,先查什么?
查有没有维护
tail。只有head的话每次追加都要从头走到尾,第n次追加就要走n步。加上tail,追加就是O(1)。删了尾节点之后再
append,新节点在遍历时找不到,为什么?删尾节点时没把
tail改成前驱,tail还指着已经被摘掉的旧节点,新节点接到了它后面。删除时判断一下removed === this.tail,是就让tail = prev。加个哨兵节点有什么好处?
让
head永远有一个前驱,插入删除头部就不用写index === 0的特殊分支,代码短而且不容易漏边界。真正的头节点是dummy.next。业务频繁按下标读取,还用链表吗?
不用。按下标读每次都是从头遍历,
O(n),高频随机访问用数组。JS里链表适合的场景很窄,比如LRU缓存这种手上已经拿着节点引用的情况。
# 2 用链表实现一个队列
⚡ 30 秒速记
- 先进先出:入队接在
tail后面,出队从head摘,两头各一个指针,都是O(1) - 出队到空时要把
tail也置成null,不然下次入队会接到旧节点上 - 为什么不用数组
shift():它要把剩下的元素都往前挪,大队列下是O(n) - 空队列
dequeue返回undefined还是抛错,二选一,但要统一 - 异步消费时
peek再dequeue不是原子操作,可能重复处理
队列就是先进先出,用链表实现时要同时拿着头和尾两个指针:入队接在尾巴后面,出队从头部摘下来,两个操作都是 O(1)。 为什么不直接用数组?push 加 shift 写起来简单,但 shift 每次要把后面的元素全部往前挪一格,几万条以上就能感觉到慢。链表版最容易漏的边界是:最后一个元素出队后,head 变成了 null,tail 也必须一起清掉,否则下次入队会接在那个已经出队的旧节点上,队列里就丢数据了。
const q = new LinkedQueue()
q.enqueue('A'); q.enqueue('B')
q.dequeue() // 'A'
q.dequeue() // 'B' 此时 head、tail 都是 null
q.dequeue() // undefined
q.enqueue('C'); q.peek() // 'C',如果没清 tail,这里会拿不到
# 题目与解题思路
实现 enqueue、dequeue、peek 和 isEmpty。入队时只操作尾部,出队时只操作头部;空队列读取统一返回 undefined,让调用方能显式判断。
class QueueNode { // 定义队列内部节点
constructor(value) { // 接收节点值
this.value = value // 保存当前值
this.next = null // 新节点默认没有后继
} // 结束节点构造函数
} // 结束节点类
class LinkedQueue { // 定义链式队列
constructor() { // 初始化空队列
this.head = null // 队头暂时为空
this.tail = null // 队尾暂时为空
this.size = 0 // 队列长度为零
} // 结束队列构造函数
enqueue(value) { // 把值加入队尾
const node = new QueueNode(value) // 创建新的队尾节点
if (this.tail) this.tail.next = node // 非空队列让旧尾连接新尾
else this.head = node // 空队列时新节点也是队头
this.tail = node // 更新队尾指针
this.size += 1 // 增加队列长度
return this.size // 返回入队后的长度
} // 结束入队方法
dequeue() { // 取出并删除队头
if (!this.head) return undefined // 空队列没有可取元素
const value = this.head.value // 先保存队头的值
this.head = this.head.next // 再把队头移到下一个节点
this.size -= 1 // 减少队列长度
if (this.size === 0) this.tail = null // 队列清空时同步清空队尾
return value // 返回最早入队的值
} // 结束出队方法
peek() { // 查看但不删除队头
return this.head ? this.head.value : undefined // 根据队头是否存在返回值
} // 结束查看队头
isEmpty() { // 判断队列是否为空
return this.size === 0 // 长度为零就表示空队列
} // 结束空队列判断
} // 结束队列类
# 复杂度、示例与易错点
- 入队、出队、查看队头均为
O(1),队列保存n个节点需要O(n)空间。 - 示例:依次入队
A、B,两次出队应依次得到A、B,第三次得到undefined。 - 易错点:不要用数组的
shift()模拟超长队列;不要把peek()与dequeue()分成跨异步流程的非原子消费。
💬 面试官追问
最后一个元素出队后没清
tail,会出什么问题?head是null,tail还指着旧节点。下次入队时代码看到tail存在,就把新节点接在旧节点后面,而head还是null,新数据从队头根本取不到。用数组
push加shift实现队列有什么问题?shift要把剩下的元素全部前移一位,是O(n),队列一长出队就慢。不想写链表也可以用数组加一个头指针下标,出队只移指针,攒够一定量再统一裁剪。两个异步消费者都先
peek()再dequeue(),为什么会重复处理?两步之间有
await的话,另一个消费者可能也peek到了同一个队头。单线程里把「取出」做成一步同步的dequeue,跨进程就要用支持确认机制的消息队列。空队列调用
dequeue,返回undefined还是抛错?都行,但要统一。通用容器一般返回
undefined,方便while ((x = q.dequeue()) !== undefined)这样轮询;如果空队列说明程序逻辑出错了,抛异常能更早发现问题。注意返回undefined时队列里就不能存undefined这个值。浏览器里要缓存几十万条埋点事件,直接用这个队列行吗?
操作是
O(1),但每条都是一个节点对象,内存会涨。还要加容量上限和溢出策略,比如丢最旧的,再配合定时批量上报和localStorage或IndexedDB做持久化。
# 3 反转单向链表
⚡ 30 秒速记
- 迭代三指针:
prev、cur、next,每轮「存后继 → 反转 → 两个指针前进」 - 第一步必须先
next = cur.next,否则改完指针剩下的链表就丢了 - 循环结束
cur是null,prev就是新头节点 - 时间
O(n);迭代空间O(1),递归版要O(n)调用栈,长链表可能爆栈 - 递归版别忘了
head.next = null,否则头两个节点成环
反转链表就是一路往前走,把每个节点的 next 改成指向前一个节点。 最容易错的地方是先改了 cur.next,结果后面的链表找不到了,所以每轮第一步一定是把后继存到 next 里,再反转,再把 prev 和 cur 往前挪。循环结束时 cur 走到了 null,prev 正好是原来的尾节点,也就是新的头。迭代版额外空间是 O(1),比递归版稳。
// 递归版:先反转后面的,再把自己接到后面
function reverseList(head) {
if (!head || !head.next) return head
const newHead = reverseList(head.next)
head.next.next = head // 让后一个节点指回自己
head.next = null // 断开原指向,不然成环
return newHead
}
// 1 → 2 → 3 → null 变成 3 → 2 → 1 → null
# 题目与解题思路
给定单向链表头节点,原地反转链表并返回新的头节点。循环不变量是:previous 指向已经反转好的部分,current 指向尚未处理部分的第一个节点。
function reverseList(head) { // 接收原链表头节点
let previous = null // 已反转部分最初为空
let current = head // 未处理部分最初从原头开始
while (current) { // 当前节点存在时继续反转
const next = current.next // 先保存原来的后继节点
current.next = previous // 让当前节点改为指向前驱
previous = current // 扩大已经反转好的部分
current = next // 移动到尚未处理的下一个节点
} // 结束全部节点的处理
return previous // 原尾节点现在成为新头节点
} // 结束链表反转函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(1)。 - 示例:
1 → 2 → 3 → null反转为3 → 2 → 1 → null;空链表仍返回null。 - 易错点:必须先保存
current.next;否则第一次改指针后就丢失剩余链表。
💬 面试官追问
都是
O(n),为什么更推荐迭代版?递归每个节点占一层调用栈,额外空间
O(n),链表有几万个节点就可能Maximum call stack size exceeded。迭代版只用三个变量。反转后遍历停不下来,先看哪?
看原来的头节点有没有指向
null。递归版漏掉head.next = null时,头两个节点会互相指着,形成环。迭代版第一轮cur.next = prev时prev就是null,天然没这问题。只反转第
left到第right个节点,思路怎么变?反转本身还是三指针,难点变成了接回去:先走到
left的前一个节点,记住它和区间原来的第一个节点,反转完区间后,前驱接新的区间头,原区间头接right后面的节点。用哨兵节点能省掉left = 1的特殊处理。每
k个一组反转,不足k个保持原样,怎么做?每次先往前数
k个,够就反转这一段并接回,不够就直接结束。本质是把「区间反转」循环套用,同样靠哨兵节点和记录每段的前驱。节点被
Object.freeze了,不能改next,怎么反转?只能新建节点:从头遍历,每个值都
new一个节点插到新链表的头部,遍历完就是反序的。额外空间变成O(n),能不能原地改是题目要先确认的约束。
# 4 找到环形链表的入环节点
⚡ 30 秒速记
- 两段式:快慢指针先相遇 → 证明有环;再派一个指针从头出发,两者同速走,再相遇就是入口
- 首次相遇点一般不是入口,直接返回是最常见的错
- 推导一句话:
a = k·c - b,从头走a步和从相遇点走a步会同时到入口 - 循环条件写
fast && fast.next,空链表、无环都返回null;时间O(n)、空间O(1)
这题就是 Floyd 判圈的第二阶段:先相遇,再从头追。 快指针一次两步、慢指针一次一步,有环就一定会在环里撞上。设头到入口 a、入口到相遇点 b、环长 c,快指针多走的正好是整数圈,能推出 a 等于「绕若干圈再减掉 b」。所以相遇后让一个指针回到头,两个都一步一步走,碰面的地方就是入口。不想推公式的话,面试时说清这个结论再画个图就够了。
# 题目与解题思路
先用速度差制造环内相遇,再利用距离关系定位入口。设头到入口距离为 a,入口到首次相遇点距离为 b,环长为 c,相遇时快指针比慢指针多走若干整环,因此可以推出从头与从相遇点同速前进会在入口相遇。
function detectCycleEntry(head) { // 接收链表头节点
let slow = head // 慢指针每轮走一步
let fast = head // 快指针每轮走两步
while (fast && fast.next) { // 快指针还能前进两步时继续
slow = slow.next // 慢指针前进一步
fast = fast.next.next // 快指针前进两步
if (slow !== fast) continue // 尚未相遇就进入下一轮
let finder = head // 新指针从链表头开始
while (finder !== slow) { // 两个指针未在入口相遇时继续
finder = finder.next // 头部指针前进一步
slow = slow.next // 相遇点指针也前进一步
} // 结束入口定位
return finder // 返回入环节点
} // 结束快慢指针扫描
return null // 快指针到达末尾说明没有环
} // 结束环入口检测函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(1)。 - 示例:
1 → 2 → 3 → 4且4.next = 2时返回值为2的节点;普通链表返回null。 - 易错点:首次相遇点通常不是入口;循环条件必须同时检查
fast和fast.next。
💬 面试官追问
只要判断有没有环,第二阶段还要写吗?
不用。快慢指针一相遇就
return true,fast走到null就是false,第二阶段只是为了找入口。用
Set存走过的节点不是更好写吗?好写,第一个重复出现的节点就是入口。代价是
O(n)额外空间,面试官一说「常量空间」,就只能用快慢指针。链表只有一个节点、
next指向自己,你的代码会出问题吗?不会。第一轮
slow和fast都回到这个节点,相遇;finder从头出发本来就等于slow,内层循环一次不走,直接返回它。首次相遇后直接把相遇点当入口返回,哪组数据能把它打挂?
1 → 2 → 3 → 4 → 5,5.next = 3。慢指针和快指针会在4相遇,入口其实是3。那求环的长度呢?
相遇后固定一个指针,另一个继续走,再回到相遇点走过的步数就是环长
c。
# 5 合并两个有序链表
⚡ 30 秒速记
- 哑节点
dummy省掉「新头是谁」的分支,tail永远指向已合并部分的末尾 - 每轮比较两个当前节点,小的接到
tail后面,对应指针后移 - 一条走完,另一条剩下的本身有序,
tail.next = left || right整段挂上 - 只改指针不新建节点,时间
O(m + n)、空间O(1);副作用是原链表被改了
合并两个有序链表其实就是归并排序里的 merge,只不过搬的是指针。 我习惯先建一个哑节点,这样第一次接谁和后面接谁走的是同一套逻辑,最后返回 dummy.next。比较时相等先取左边,能保证稳定。剩下没走完的那一段直接整段接上,不用再一个个比。要提醒一句,这个写法是复用原节点的,调用方如果还要用原来那两条链表,就得先复制。
# 题目与解题思路
给定两个按升序排列的单向链表,合并为一个升序链表。循环不变量是:dummy.next 到 tail 已经有序,且其中每个节点都不大于两条剩余链表的当前节点。
function mergeSortedLists(first, second) { // 接收两个升序链表的头节点
const dummy = { value: 0, next: null } // 创建不参与结果的哑节点
let tail = dummy // 结果尾指针最初指向哑节点
let left = first // 左侧工作指针从第一条链表开始
let right = second // 右侧工作指针从第二条链表开始
while (left && right) { // 两条链表都有剩余节点时比较
if (left.value <= right.value) { // 左侧值更小或相等时优先取左侧
tail.next = left // 把左侧节点接到结果尾部
left = left.next // 左侧指针向后移动
} else { // 右侧值更小时处理右侧
tail.next = right // 把右侧节点接到结果尾部
right = right.next // 右侧指针向后移动
} // 结束本轮大小判断
tail = tail.next // 结果尾指针移动到刚接入的节点
} // 结束双链表比较
tail.next = left || right // 直接接上尚未耗尽的有序部分
return dummy.next // 跳过哑节点返回真正头节点
} // 结束有序链表合并函数
# 复杂度、示例与易错点
- 时间复杂度
O(m + n),额外空间复杂度O(1)。 - 示例:
1 → 3 → 5与1 → 2 → 4合并后得到1 → 1 → 2 → 3 → 4 → 5。 - 易错点:这版会复用并改写原链表连接;如果调用方还要保留输入,必须复制节点。
💬 面试官追问
不用哑节点,代码会多出什么?
要先单独比一次两个头,决定结果的
head,还要处理某条为空的情况,分支多一倍。哑节点就是用一个多余对象换掉这些if。两边值相等时先取哪边,有区别吗?
只比数字看不出差别。如果节点上还挂着业务数据,比如按时间合并两份日志,先取左边能保住原来的相对顺序,这就是稳定性。
递归写法行不行?
行,
l1.next = merge(l1.next, l2)几行就写完。但递归深度等于两条长度之和,几万个节点就可能爆栈,迭代版更稳。要合并
k条有序链表,一条条往上合怎么样?不好,结果越合越长,前面的节点被反复扫描,总量接近
O(N·k)。用最小堆放每条的当前节点,或者两两分治合并,都是O(N log k)。
# 6 实现有效括号校验
⚡ 30 秒速记
- 左括号入栈,右括号必须和栈顶配对,配不上就是无效
- 右括号来了栈是空的 → 无效;扫完栈里还有剩 → 无效
- 用「右 → 左」的映射表,三种括号一套逻辑;时间
O(n)、空间O(n) - 坑:输入带普通字符时,不能把「不是右括号」一律当左括号压栈
括号匹配只关心最近一个还没闭合的左括号,这就是栈的后进先出。 扫到左括号压栈,扫到右括号就看栈顶是不是它的另一半,不是就直接返回 false。扫完之后栈必须是空的,"((" 这种就卡在这一步。我写的时候会用一个 { ')': '(' } 这样的映射表,三种括号不用写三套 if。还有个小剪枝:如果确定只有括号字符,长度是奇数可以直接判无效。
# 题目与解题思路
判断只包含圆括号、方括号和花括号的字符串是否有效。用映射记录“右括号 → 左括号”,这样扫描到右括号时只需比较一次栈顶。
function isValidBrackets(text) { // 接收待校验字符串
const pairs = { ')': '(', ']': '[', '}': '{' } // 建立右括号到左括号的映射
const stack = [] // 创建保存未闭合左括号的栈
for (const char of text) { // 从左到右扫描每个字符
if (!pairs[char]) { // 当前字符不是右括号时按左括号处理
stack.push(char) // 把左括号压入栈顶
continue // 继续扫描下一个字符
} // 结束左括号分支
if (stack.pop() !== pairs[char]) return false // 栈顶不匹配时立即判定无效
} // 结束字符串扫描
return stack.length === 0 // 没有剩余左括号才算完全匹配
} // 结束括号校验函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),最坏额外空间复杂度O(n)。 - 示例:
"([]{})"返回true,"([)]"和"(("返回false。 - 易错点:如果输入可能包含普通字符,不能把所有非右括号都当成左括号,应先限定字符集或显式跳过普通字符。
💬 面试官追问
数一数三种括号的数量相等,不就行了吗?
不行,
([)]数量完全对得上,但交叉闭合了。数量只能证明个数,证明不了嵌套顺序。"a(b)c"丢进你这版代码,会返回什么?会返回
false,因为a、b、c都被当成左括号压栈了,最后栈不空。要先判断是不是左括号,普通字符直接continue。只有圆括号一种,还需要栈吗?
不用,一个计数器就够:遇
(加一,遇)减一,中途小于0或最后不为0就无效,空间降到O(1)。如果要校验模板里的括号,引号里的括号不算,这版够吗?
不够。得加一个状态,进了字符串就忽略括号,还要处理转义的引号,这已经是写一个小词法扫描器了,不是单纯的栈题。
# 7 二叉树前序、中序和后序遍历
⚡ 30 秒速记
- 三种遍历是同一个递归,差别只在「什么时候记录根」
- 前序 = 根左右(进节点就记);中序 = 左根右(左边回来再记);后序 = 左右根(两边都回来才记)
- 二叉搜索树中序 = 升序;删目录、算子树大小用后序
- 递归栈
O(h),单支树会退化成O(n),深了就改显式栈
前中后序不是三套算法,是同一次深度优先遍历里访问根的时机不同。 我面试时会写一个递归函数,在进入节点、左子树返回、右子树返回这三个位置各 push 一次,三个结果一次全出来,面试官一看就明白区别在哪。实际用途也好记:二叉搜索树走中序是有序的,删除文件夹必须先删里面的东西再删自己,那就是后序。递归的问题是深度,退化成链表的树几万层就会栈溢出,这时要改成显式栈。
# 题目与解题思路
给定二叉树根节点,返回三种深度优先遍历结果。递归出口是空节点;每个非空节点只访问一次,收集位置决定遍历顺序。
function traverseBinaryTree(root) { // 接收二叉树根节点
const preorder = [] // 保存前序遍历结果
const inorder = [] // 保存中序遍历结果
const postorder = [] // 保存后序遍历结果
function visit(node) { // 定义递归访问函数
if (!node) return // 空节点直接结束当前分支
preorder.push(node.value) // 进入节点时收集得到前序
visit(node.left) // 递归处理左子树
inorder.push(node.value) // 左子树完成后收集得到中序
visit(node.right) // 递归处理右子树
postorder.push(node.value) // 两棵子树完成后收集得到后序
} // 结束递归访问函数
visit(root) // 从根节点开始遍历
return { preorder, inorder, postorder } // 返回三种遍历结果
} // 结束二叉树遍历函数
# 复杂度、示例与易错点
- 三种结果在一次遍历中生成,时间复杂度
O(n);递归栈为O(h),结果数组为O(n)。 - 示例:根为
1、左子为2、右子为3时,前序[1,2,3],中序[2,1,3],后序[2,3,1]。 - 易错点:极深单支树可能栈溢出,工程上可改用显式栈的迭代遍历。
💬 面试官追问
为什么二叉搜索树中序遍历出来就是升序?
左子树都比根小、右子树都比根大,左根右的顺序天然就是从小到大。反过来,验证一棵树是不是二叉搜索树,就看中序结果是不是严格递增。
删除一个目录,为什么要用后序?
目录不空删不掉,必须先把子文件、子目录都处理完,最后才删自己,这就是左右根。
单支树十万层,递归直接爆栈了,怎么改?
用数组模拟栈。前序最简单,弹出就记录,然后先压右再压左;中序是一路压左、弹出记录、转向右子树;后序可以按根右左做一遍再整体
reverse。只给前序和中序结果,能还原这棵树吗?
能,前提是值不重复。前序第一个是根,在中序里找到它,左边是左子树、右边是右子树,递归下去。只给前序和后序就还原不了唯一的树。
# 8 二叉树层序遍历
⚡ 30 秒速记
- 层序 = 广度优先,用队列,先进先出
- 每层开始先冻结
levelSize = 当前队列长度,只处理这一批,新入队的留给下一层 - 子节点非空才入队;结果是二维数组
[[1], [2, 3], [4]] shift()在大数组上会搬元素,用一个front索引当队头更稳
层序遍历就是 BFS,关键在每一层开始前先记下队列里有几个节点。 比如这一层有 2 个,就只出队 2 次,处理过程中压进去的子节点自然排在后面,属于下一层。不先冻结长度,层和层就混在一起了。我一般不用 queue.shift(),因为很多引擎上它要把后面的元素往前挪,节点多了会慢,换成一个递增的 front 下标就行。很多变种题都是这个框架:每层最大值、右视图、锯齿遍历,只改每层里收集什么。
# 题目与解题思路
给定二叉树根节点,返回按层分组的节点值。为了避免数组 shift() 的移动成本,使用索引模拟队头。
function levelOrder(root) { // 接收二叉树根节点
if (!root) return [] // 空树直接返回空结果
const queue = [root] // 把根节点加入待访问队列
let front = 0 // 用索引表示当前队头位置
const result = [] // 保存所有层的结果
while (front < queue.length) { // 队列仍有未处理节点时继续
const levelSize = queue.length - front // 冻结当前层的节点数量
const level = [] // 创建当前层结果数组
for (let i = 0; i < levelSize; i += 1) { // 只处理当前层已有节点
const node = queue[front] // 读取当前队头节点
front += 1 // 队头索引向后移动
level.push(node.value) // 收集当前节点值
if (node.left) queue.push(node.left) // 左子节点存在时加入下一层
if (node.right) queue.push(node.right) // 右子节点存在时加入下一层
} // 结束当前层处理
result.push(level) // 保存完整的一层
} // 结束全部层遍历
return result // 返回二维层序结果
} // 结束层序遍历函数
# 复杂度、示例与易错点
- 时间复杂度
O(n);队列和结果需要O(n)空间。 - 示例:
1的左右子节点为2、3,且2有左子4,结果是[[1], [2, 3], [4]]。 - 易错点:必须在进入内层循环前固定
levelSize,不能边入队边把下一层也算进当前层。
💬 面试官追问
内层循环直接写
i < queue.length会怎样?处理当前层时子节点也在往里加,长度一直在涨,下一层甚至下下层都会被算进当前层,分组就错了。
要做二叉树的右视图,怎么改?
框架不动,每层循环到最后一个节点,也就是
i === levelSize - 1时,把它的值收进结果。锯齿形遍历,一层从左到右、下一层从右到左呢?
还是正常按层收集,只是奇数层在放进结果前
reverse()一下,或者用unshift往前插。别去改入队顺序,那样容易乱。用深度优先也能按层分组吗?
能。递归时带上
depth,result[depth]不存在就建一个,再push进去。结果一样,只是空间换成了递归栈。
# 9 两数之和
⚡ 30 秒速记
- 暴力两层循环
O(n²);用Map记「值 → 下标」,找另一半降到均摊O(1) - 顺序是先查
target - value,再写入当前值,自己不会和自己配对 - 用
Map不用普通对象:判断存在用has,下标0不会被当成假值 - 数组已经有序就换首尾双指针,空间
O(1)
两数之和的思路是:一边扫,一边把见过的数存起来,扫到每个数就问一句「我的另一半来过没有」。 用 Map 存值到下标,查询是均摊 O(1),一遍扫完就是 O(n)。顺序很重要,要先查后存,不然 [3, 2, 4] 找 6 的时候,3 会和自己凑成一对。我还会主动问一句数组是不是有序的,有序的话首尾双指针更好,不用额外空间。
# 题目与解题思路
给定整数数组和目标值,返回和为目标值的两个不同元素索引。用 Map 保存已扫描数值及其索引,每个元素最多处理一次。
function twoSum(numbers, target) { // 接收整数数组和目标和
const seen = new Map() // 保存已经扫描过的数值及索引
for (let index = 0; index < numbers.length; index += 1) { // 从左到右扫描数组
const value = numbers[index] // 读取当前数值
const complement = target - value // 计算当前值需要的补数
if (seen.has(complement)) return [seen.get(complement), index] // 补数出现过就返回两个索引
seen.set(value, index) // 当前值未配对成功时再写入哈希表
} // 结束数组扫描
return [] // 不存在答案时返回空数组
} // 结束两数之和函数
# 复杂度、示例与易错点
- 时间复杂度均摊为
O(n),额外空间复杂度为O(n)。 - 示例:
[2, 7, 11, 15]、目标9返回[0, 1];[3, 3]、目标6也能返回两个不同索引。 - 易错点:不要先写入再查询,否则目标是当前值两倍时可能错误地重复使用同一索引。
💬 面试官追问
[3, 2, 4]、目标6,先存后查会返回什么?会返回
[0, 0],3存进去马上就查到了自己。先查后存才能得到正确的[1, 2]。数组已经排好序了,还用哈希表吗?
不用。左指针从头、右指针从尾,和小了左边右移,大了右边左移,时间
O(n)、空间O(1)。用普通对象
{}代替Map会踩什么坑?键会被转成字符串,还可能撞上
constructor这类原型属性;而且如果用if (seen[x])判断,下标0会被当成不存在。要返回所有和为目标的不重复数对呢?
一个下标映射不够用了。排序后用双指针,命中后左右都跳过重复值,这其实就是三数之和里的那段内层逻辑。
# 10 三数之和
⚡ 30 秒速记
- 先排序,把三重循环变成「固定一个数 + 双指针找另外两个」
- 和小了
left++,和大了right--,相等就收集 - 去重三处:固定值和前一个相同跳过;命中后左右指针都跳过相同值
- 剪枝:排序后固定值
> 0直接break(只适用于目标为0) - 用
[...numbers].sort((a, b) => a - b),别改调用方数组,也别忘了比较函数
三数之和的套路是排序加双指针,排序同时解决了「怎么找」和「怎么去重」两件事。 固定第一个数,剩下的区间里两个指针往中间收,和偏小左边走、偏大右边走,整体 O(n²)。去重要在三个位置做:固定值重复就跳过,找到一组后左右指针也各自跳过相同的值。很多人最后给结果套个 Set 去重,又慢又治标不治本。还有个细节,sort() 不传比较函数是按字符串排的,[-1, -4, 10] 会排错。
# 题目与解题思路
返回数组中所有和为零且不重复的三元组。先复制并排序,避免修改调用方数组;当固定值已经大于零时可以提前结束。
function threeSum(numbers) { // 接收待查找的整数数组
const sorted = [...numbers].sort((a, b) => a - b) // 复制并按数值升序排列
const result = [] // 保存不重复三元组
for (let i = 0; i < sorted.length - 2; i += 1) { // 固定三元组中的第一个数
if (sorted[i] > 0) break // 最小固定值已大于零时不可能再得到零
if (i > 0 && sorted[i] === sorted[i - 1]) continue // 跳过重复固定值
let left = i + 1 // 左指针从固定值右侧开始
let right = sorted.length - 1 // 右指针从数组末尾开始
while (left < right) { // 两个指针未相遇时继续搜索
const sum = sorted[i] + sorted[left] + sorted[right] // 计算当前三数之和
if (sum < 0) { // 当前和偏小时需要增大
left += 1 // 左指针右移取得更大值
continue // 进入下一轮比较
} // 结束偏小分支
if (sum > 0) { // 当前和偏大时需要减小
right -= 1 // 右指针左移取得更小值
continue // 进入下一轮比较
} // 结束偏大分支
result.push([sorted[i], sorted[left], sorted[right]]) // 收集一个合法三元组
left += 1 // 左指针越过当前命中位置
right -= 1 // 右指针越过当前命中位置
while (left < right && sorted[left] === sorted[left - 1]) left += 1 // 跳过重复左值
while (left < right && sorted[right] === sorted[right + 1]) right -= 1 // 跳过重复右值
} // 结束当前固定值的双指针搜索
} // 结束所有固定值扫描
return result // 返回全部不重复三元组
} // 结束三数之和函数
# 复杂度、示例与易错点
- 排序后双指针的时间复杂度为
O(n²),排序和结果之外的额外空间取决于排序实现。 - 示例:
[-1, 0, 1, 2, -1, -4]返回[[-1, -1, 2], [-1, 0, 1]]。 - 易错点:只给结果套
Set治标不治本;固定值、左值、右值三个层级都要按位置正确去重。
💬 面试官追问
固定值已经大于
0,为什么可以直接结束?数组是升序的,后面两个数只会更大,三个正数加起来不可能等于
0。这个剪枝依赖目标是0,换成别的目标就要删掉。sort()不写比较函数,会出什么问题?默认按字符串比较,
[10, 9, -1]会排成[-1, 10, 9],双指针的单调性直接没了,结果全乱。只在结果外面套一个
Set去重,行不行?数组放进
Set比的是引用,根本去不了重,得先转成字符串。就算转了,重复的搜索也已经做完了,白白浪费时间。四数之和怎么做?
再多套一层循环,固定两个数,剩下的照样双指针,
O(n³)。每一层固定值都要做去重,数值大时还要留意和超出安全整数。
# 11 无重复字符的最长子串
⚡ 30 秒速记
- 滑动窗口
[left, right],窗口里始终没有重复字符 Map记每个字符最后出现的下标,重复时left跳到旧位置+1left只能往右走:left = Math.max(left, last + 1),不写max会被abba打挂- 每个字符进窗口一次,时间
O(n) - 字符串下标按
UTF-16单元算,表情符号要先Array.from再处理
这题是滑动窗口:右边一直扩,遇到重复就把左边界直接跳到冲突字符上次出现位置的后一位。 不需要一格一格往前挪,也不用清空窗口,所以是线性的。用 Map 存每个字符最后一次出现的下标就行。最容易错的地方是左边界回退:旧记录可能已经在窗口外了,这时直接 left = last + 1 会把窗口拉回去,所以要和当前 left 取较大值。
# 题目与解题思路
返回字符串中不含重复字符的最长连续子串长度。窗口为 [left, right],lastSeen 保存每个字符最近一次出现的位置。
function lengthOfLongestSubstring(text) { // 接收待分析字符串
const lastSeen = new Map() // 保存每个字符最近出现的索引
let left = 0 // 初始化滑动窗口左边界
let best = 0 // 保存目前发现的最大长度
for (let right = 0; right < text.length; right += 1) { // 让右边界逐字符扩张
const char = text[right] // 读取新进入窗口的字符
if (lastSeen.has(char)) left = Math.max(left, lastSeen.get(char) + 1) // 重复时右移但绝不回退左边界
lastSeen.set(char, right) // 更新当前字符的最新位置
best = Math.max(best, right - left + 1) // 用当前窗口长度更新答案
} // 结束右边界扫描
return best // 返回最长无重复子串长度
} // 结束最长子串函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(k),k为窗口中不同字符数。 - 示例:
"abcabcbb"返回3,"bbbbb"返回1,空串返回0。 - 易错点:字符串索引按
UTF-16代码单元工作;若要把部分表情符号视为一个字符,应先用Array.from(text)转成码点序列。
💬 面试官追问
"abba"为什么很多人会算出3?扫到第二个
a时,a的旧位置是0,已经在窗口[2, 3]外面了。不取max的话left会退回1,窗口变成bba,长度3,其实答案是2。要返回最长子串本身,不是长度,怎么改?
更新
best的同时记一下start = left,最后text.slice(start, start + best),主逻辑不动。只有小写字母,还要用
Map吗?可以换成长度
26的数组,下标是charCodeAt(i) - 97,常数更小。Map胜在通用,中文、符号都能直接用。输入里有
😀,长度会算对吗?不会,一个
😀在UTF-16里占两个单元,text.length是2。先Array.from(text)按码点切;如果是带肤色、组合的表情,还要用Intl.Segmenter按用户看到的字符切。
# 12 全排列
⚡ 30 秒速记
- 回溯三件套:做选择 → 递归 → 撤销选择,必须成对出现
- 状态两个:
path记已选顺序,used[i]记哪个位置在当前路径里 - 路径满了要
push([...path])复制一份,直接push(path)最后全是空数组 - 结果有
n!个,总复杂度O(n × n!);有重复值要先排序再做同层去重
全排列可以看成一棵选择树:第一层从 n 个里挑一个,第二层从剩下的里挑,一直挑到叶子就是一个排列。 回溯就是在这棵树上走深度优先,下去之前做选择,回来之后把选择撤掉,好让兄弟分支看到干净的状态。used 数组标的是「当前这条路径用没用过」,回溯时要恢复。最常见的错是收集结果时直接 push(path),存的是同一个引用,回溯完全被清空了。
# 题目与解题思路
给定不含重复元素的数组,返回所有排列。used[i] 表示某个位置是否已进入当前路径,而不是该数值是否在所有分支中永久使用。
function permute(numbers) { // 接收不含重复值的数组
const result = [] // 保存所有完整排列
const path = [] // 保存当前递归路径
const used = Array(numbers.length).fill(false) // 标记当前路径已经使用的位置
function backtrack() { // 定义回溯搜索函数
if (path.length === numbers.length) { // 路径包含全部元素时得到一个答案
result.push([...path]) // 复制路径避免后续撤销修改已保存结果
return // 当前排列完成后返回上一层
} // 结束递归出口
for (let index = 0; index < numbers.length; index += 1) { // 尝试每个候选位置
if (used[index]) continue // 当前路径已使用的位置不能重复选择
used[index] = true // 标记当前位置已进入路径
path.push(numbers[index]) // 把当前数值加入路径
backtrack() // 递归填写下一个位置
path.pop() // 撤销刚才加入的数值
used[index] = false // 恢复位置供其他分支使用
} // 结束本层候选枚举
} // 结束回溯函数
backtrack() // 从空路径开始搜索
return result // 返回全部排列
} // 结束全排列函数
# 复杂度、示例与易错点
- 共有
n!个结果,生成和复制它们需要O(n × n!)时间与结果空间;递归辅助空间为O(n)。 - 示例:
[1, 2, 3]产生6个排列;空数组按组合数学约定产生一个空排列[[]]。 - 易错点:
result.push(path)会保存同一个数组引用,回溯结束后所有结果都可能变成空数组。
💬 面试官追问
result.push(path)不复制,最后结果长什么样?[1, 2, 3]会返回6个空数组[]。六次存的都是同一个path引用,回溯结束时它已经被pop空了。输入是
[1, 1, 2],怎么避免重复排列?先排序,同一层里如果
nums[i] === nums[i - 1]且!used[i - 1],就跳过。意思是相同的数在同一层只让第一个出场,结果是3个而不是6个。撤销时
path.pop()和used[i] = false,只写一个行不行?不行,它们管的是两件事。只
pop不恢复used,这个数在别的分支里就再也选不到了;只恢复used不pop,路径会越来越长。只要第
k个排列,也要全部生成吗?不用。
n个数时每个开头对应(n-1)!个排列,用k除以阶乘就能确定每一位,O(n²)搞定。
# 13 岛屿数量
⚡ 30 秒速记
- 本质是网格图的连通分量计数
- 外层逐格扫,遇到
'1'计数加一,然后把整座岛「淹掉」(改成'0') - 只算上下左右四个方向;对角线算不算相连要先问清
- 每格最多被淹一次,时间
O(mn);原地改会动输入,不能改就用visited - 递归版大陆地会爆栈,改显式栈或
BFS队列
岛屿数量问的是网格里有几块连在一起的陆地,套路是「看到陆地就数一,然后把整块淹掉」。 外层两重循环逐格扫,碰到 '1' 就说明发现了一座新岛,计数加一,再从这一格往四个方向 DFS,把相连的陆地全改成 '0',后面就不会重复数。每个格子最多被处理一次,所以是 O(mn)。要提醒两点:原地改会动调用方的网格;整片都是陆地时递归深度可能到 mn,这种数据要换成显式栈或队列。
# 题目与解题思路
二维网格中,"1" 表示陆地、"0" 表示水,只按上下左右连接。外层扫描负责发现新连通块,递归负责标记整块区域。
function countIslands(grid) { // 接收二维字符网格
if (grid.length === 0) return 0 // 空网格没有岛屿
const rows = grid.length // 记录网格行数
const columns = grid[0].length // 记录网格列数
let count = 0 // 保存已经发现的岛屿数量
function flood(row, column) { // 定义淹没一块连通陆地的函数
if (row < 0 || row >= rows || column < 0 || column >= columns) return // 越界时结束当前方向
if (grid[row][column] !== '1') return // 水域或已访问位置无需处理
grid[row][column] = '0' // 把当前陆地标记为已访问
flood(row - 1, column) // 继续搜索上方相邻位置
flood(row + 1, column) // 继续搜索下方相邻位置
flood(row, column - 1) // 继续搜索左侧相邻位置
flood(row, column + 1) // 继续搜索右侧相邻位置
} // 结束淹没函数
for (let row = 0; row < rows; row += 1) { // 逐行扫描网格
for (let column = 0; column < columns; column += 1) { // 逐列扫描当前行
if (grid[row][column] !== '1') continue // 非陆地位置直接跳过
count += 1 // 未访问陆地代表发现一座新岛
flood(row, column) // 标记这座岛的全部相连陆地
} // 结束当前行扫描
} // 结束整个网格扫描
return count // 返回连通分量数量
} // 结束岛屿计数函数
# 复杂度、示例与易错点
- 时间复杂度
O(mn);最坏递归栈为O(mn),原地标记不再额外创建访问矩阵。 - 示例:两块只在对角线接触的陆地按四方向规则应算两座岛。
- 易错点:这版会修改输入网格;超大连通区域还可能让递归爆栈,应改为显式栈或队列。
💬 面试官追问
对角线挨着也算一座岛,代码改哪?
方向从四个加到八个,多搜四个对角方向。同一张网格答案可能变少,这个规则要在动手前跟面试官确认。
1000 × 1000全是陆地,递归版会怎样?递归深度可能到百万级,
JS调用栈一般几千到一万多层就溢出了。换成显式栈的DFS,或者队列做BFS。调用方的网格不能改,怎么办?
开一个同样大小的
visited布尔数组,或者先深拷贝一份再原地淹。两种都是多O(mn)空间。用并查集做有什么好处?
单次计算没优势,代码还更长。它的价值在动态场景,比如陆地一块块加进来,每加一块就要报一次岛屿数,并查集合并接近
O(1),不用每次重扫。
# 14 爬楼梯
⚡ 30 秒速记
- 看最后一步:到第
n阶只能从n-1走一步或从n-2走两步 dp[n] = dp[n-1] + dp[n-2],就是斐波那契- 只依赖前两个值 → 两个变量滚动,空间
O(1) - 边界
n = 0算1还是0先和面试官对齐;n很大要BigInt或取模
动态规划先找最后一步:最后一步要么走一阶、要么走两阶,两类方案互不重叠,所以加起来就是总数。 写成式子是 dp[n] = dp[n-1] + dp[n-2],和斐波那契数列一样。直接递归会重复算大量子问题,是指数级的;从小往大递推就是 O(n)。因为每次只用到前两个值,数组都不用开,两个变量来回滚就行。开写前我会先确认 n = 0 怎么定义,题目不同约定也不同。
# 题目与解题思路
每次可以爬一阶或两阶,求到第 n 阶的不同方案数。把“到第几阶”作为状态,先明确 n = 1 和 n = 2 的初始值,再从小到大递推。
function climbStairs(stepCount) { // 接收目标台阶数
if (!Number.isInteger(stepCount) || stepCount < 0) throw new TypeError('台阶数必须是非负整数') // 校验输入契约
if (stepCount <= 1) return 1 // 零阶有一种不移动方案,一阶也只有一种方案
let previousTwo = 1 // 保存到第零阶的方案数
let previousOne = 1 // 保存到第一阶的方案数
for (let step = 2; step <= stepCount; step += 1) { // 从第二阶开始递推
const current = previousOne + previousTwo // 合并最后走一阶和两阶的方案
previousTwo = previousOne // 较旧状态向前滚动
previousOne = current // 保存当前阶方案供下一轮使用
} // 结束状态递推
return previousOne // 返回到目标台阶的方案数
} // 结束爬楼梯函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(1)。 - 示例:
n = 3时有1+1+1、1+2、2+1三种方案;本实现把n = 0定义为一种空方案。 - 易错点:题目对
n = 0的定义可能不同,面试前要先和面试官确认边界契约。
💬 面试官追问
直接写递归
f(n-1) + f(n-2),n = 45会怎样?会非常慢,调用次数是指数级,算到
45要二十多亿次调用。加个memo缓存或改成递推,就是O(n)。为什么方案数不是
2^n?每一步选一阶还是两阶不是独立的,总和必须正好是
n,走到最后可能只剩一阶,没法选两阶。合法序列受这个约束,数量就是斐波那契。一次能走一、二、三阶呢?
变成前三项之和
dp[n] = dp[n-1] + dp[n-2] + dp[n-3],边界补齐前三项,滚动变量从两个变成三个。某些台阶坏了不能踩,怎么改?
坏掉的那阶
dp[i] = 0,其他照旧递推。后面的台阶自然就不会从它转移过来。
# 15 零钱兑换
⚡ 30 秒速记
dp[i]= 凑出金额i最少要几枚,dp[0] = 0- 转移:
dp[i] = min(dp[i - coin] + 1),硬币能重复用,是完全背包 - 初始化用不可能的大值
amount + 1,最后还是它就返回-1 - 贪心挑最大面额不一定对:
[1, 3, 4]凑6,贪心3枚,最优2枚 - 时间
O(amount × k),金额很大时数组也跟着大
零钱兑换是完全背包求最小值:每个金额都从「减掉一枚硬币后的金额」转移过来,再加一枚。 金额从 1 递推到目标,对每个金额把所有面额都试一遍取最小。初始值我用 amount + 1 当哨兵,因为再怎么凑也不会超过 amount 枚,最后要是还等于它就是凑不出来。面试官很爱问为什么不能贪心,记住 [1, 3, 4] 凑 6 这个反例:贪心拿 4 + 1 + 1 是三枚,3 + 3 只要两枚。
# 题目与解题思路
给定不同面额硬币和目标金额,返回凑出目标所需的最少硬币数。把 amount + 1 当作哨兵,因为任何合法答案都不会超过使用 amount 枚面值一的硬币。
function coinChange(coins, amount) { // 接收硬币面额和目标金额
if (!Number.isInteger(amount) || amount < 0) return -1 // 非法目标金额直接判定无解
const dp = Array(amount + 1).fill(amount + 1) // 用不可能的大值初始化全部状态
dp[0] = 0 // 凑出零元不需要硬币
for (let current = 1; current <= amount; current += 1) { // 从小金额递推到目标金额
for (const coin of coins) { // 尝试把每种硬币作为最后一枚
if (coin <= 0 || coin > current) continue // 跳过非法面额和放不下的硬币
dp[current] = Math.min(dp[current], dp[current - coin] + 1) // 从前置金额转移最优解
} // 结束当前金额的硬币枚举
} // 结束所有金额状态递推
return dp[amount] > amount ? -1 : dp[amount] // 哨兵未被更新时返回无解
} // 结束零钱兑换函数
# 复杂度、示例与易错点
- 设硬币种数为
k,时间复杂度O(amount × k),空间复杂度O(amount)。 - 示例:硬币
[1, 2, 5]、金额11返回3,对应5 + 5 + 1;硬币[2]、金额3返回-1。 - 易错点:面额必须是正整数;零或负面额会破坏状态转移含义。
💬 面试官追问
每次先拿最大面额,为什么不对?
[1, 3, 4]凑6,贪心是4 + 1 + 1三枚,最优是3 + 3两枚。只有人民币这类特殊设计的币制,贪心才恰好是对的。改成问有多少种凑法,代码怎么变?
dp[i]改成方案数,dp[0] = 1,转移从取min变成累加。而且硬币要放外层循环、金额放内层,不然1 + 2和2 + 1会被当成两种。初始值填
Infinity和填amount + 1,有区别吗?结果一样,
Infinity + 1还是Infinity。amount + 1的好处是整数数组更省心,换到别的语言也不会溢出。金额是
10亿,这个解法还能用吗?不能,数组要开
10亿个,内存直接爆。这是伪多项式复杂度,通常只能先看面额的最大公约数能不能整除金额排除无解,或者换成搜索加剪枝。
# 16 最长递增子序列
⚡ 30 秒速记
- 朴素
DP:dp[i]= 以i结尾的最长长度,两层循环O(n²) - 优化:
tails[k]= 长度为k + 1的递增子序列里最小的结尾 - 新值比所有结尾都大就追加,否则二分找第一个
>= 它的位置替换 →O(n log n) tails的长度是答案,但内容不一定是真实的子序列- 非递减版本把二分条件改成找第一个
> 它的位置
优化版的核心直觉是:同样长度的递增子序列,结尾越小,后面越容易接上。 所以维护一个 tails 数组,存每种长度下能做到的最小结尾,它本身是递增的,可以二分。来一个新数,比末尾都大就让长度加一;否则找到第一个不小于它的位置换掉,长度不变但「潜力」变好了。面试时我会先讲 O(n²) 的 dp[i],再引出这个优化,比直接甩模板更有说服力。
# 题目与解题思路
给定整数数组,返回严格递增子序列的最大长度。对每个值在 tails 中查找第一个大于等于它的位置并替换;相等时替换而不扩展,保证“严格递增”。
function lengthOfLIS(numbers) { // 接收整数数组
const tails = [] // 保存各长度递增子序列的最小结尾
for (const value of numbers) { // 依次处理每个数值
let left = 0 // 二分区间左边界从零开始
let right = tails.length // 二分区间右边界使用右开形式
while (left < right) { // 区间仍有候选位置时继续
const middle = left + Math.floor((right - left) / 2) // 计算中间索引并避免边界相加
if (tails[middle] < value) left = middle + 1 // 中间结尾偏小时去右半区
else right = middle // 中间结尾可被替换时保留当前位置
} // 结束替换位置查找
tails[left] = value // 更新该长度下能取得的最小结尾
} // 结束所有数值处理
return tails.length // 最小结尾数组长度就是最长递增长度
} // 结束最长递增子序列函数
# 复杂度、示例与易错点
- 时间复杂度
O(n log n),额外空间复杂度O(n)。 - 示例:
[10, 9, 2, 5, 3, 7, 101, 18]返回4,一种答案是[2, 3, 7, 18]。 - 易错点:
tails的内容不保证是原数组中的那条最终子序列;若要还原路径,需要额外保存前驱与位置。
💬 面试官追问
把
tails里的数换小了,会不会把答案换坏?不会。替换不改变
tails的长度,只是让某个长度的结尾更小,后面的数更容易接上,可选范围只会变大。[3, 5, 1]跑完tails是什么?它是答案吗?是
[1, 5],长度2是对的,但1, 5在原数组里顺序是反的,不是一个合法子序列。要还原路径得额外记前驱下标。改成非递减,
[2, 2, 2]要返回3,怎么改?二分从找第一个
>= value改成找第一个> value,相等的值就能接在后面让长度增长。tails为什么一定是递增的,能二分?长度为
k + 1的递增子序列,去掉最后一个就是长度k的,它的结尾更小。所以更长的最小结尾一定大于更短的最小结尾。
# 17 二分查找
⚡ 30 秒速记
- 前提是单调:数组有序,或者「答案可不可行」随着值单调变化
- 先定区间语义再写代码:闭区间
[left, right]配left <= right、right = mid - 1 - 每次比较后都要把
mid排除掉,不然可能死循环 - 中点写
left + Math.floor((right - left) / 2) - 找第一个 / 最后一个位置:命中后先记答案,再继续往一侧收缩
二分查找难的不是思路,是边界,我的办法是先定好区间是闭的还是半开的,然后所有写法都跟着它走。 用闭区间 [left, right] 的话,区间非空的条件是 left <= right,比较完 mid 已经看过了,要 left = mid + 1 或 right = mid - 1 把它排除。左闭右开就是 left < right 配 right = mid。两套模板混着写,十有八九会死循环或者漏掉一个元素。更值得说的是二分不止能查数组,很多「最小的最大值」题都是对答案二分。
# 题目与解题思路
在升序数组中查找目标值并返回下标,不存在则返回 -1。每轮排除一半不可能的区间,空数组会自然跳过循环。
function binarySearch(numbers, target) { // 接收升序数组和目标值
let left = 0 // 初始化左闭边界
let right = numbers.length - 1 // 初始化右闭边界
while (left <= right) { // 闭区间非空时继续查找
const middle = left + Math.floor((right - left) / 2) // 计算中点并避免直接相加
if (numbers[middle] === target) return middle // 命中目标后立即返回下标
if (numbers[middle] < target) left = middle + 1 // 目标只可能位于右半区
else right = middle - 1 // 目标只可能位于左半区
} // 结束二分循环
return -1 // 搜索区间耗尽时返回未找到
} // 结束二分查找函数
# 复杂度、示例与易错点
- 时间复杂度
O(log n),空间复杂度O(1)。 - 示例:
binarySearch([1, 3, 5, 8], 5)返回2。 - 易错点:数组必须按比较规则有序;闭区间和左闭右开模板不能混写。
💬 面试官追问
[1, 2, 2, 2, 3]找2第一次出现的位置,怎么改?命中时不要直接返回,先记
ans = mid,再right = mid - 1继续往左找,循环结束返回ans,结果是1。闭区间写法里把
right = mid - 1写成right = mid,会怎样?left === right且目标比nums[mid]小时,mid一直等于left,区间缩不动,就死循环了。为什么不写
(left + right) / 2?JS里先要Math.floor取整,否则下标是小数;在Java、C++这种定长整数语言里,两数相加还可能溢出。差值写法哪都能用。什么情况下是对答案二分?
答案没法直接算,但「给定一个值能不能满足条件」是单调的。比如
D天内运完货物的最低运载能力,能力越大越能运完,就在能力范围上二分。
# 18 搜索旋转排序数组
⚡ 30 秒速记
- 旋转后数组被切成两段升序,从任意
mid切开,至少有一半是有序的 - 先看哪半有序:
nums[left] <= nums[mid]→ 左半有序,否则右半有序 - 目标落在有序那半的范围内就去那半,否则去另一半
- 范围判断一端带等号一端不带,
mid已经比过了 - 有重复值时
left、mid、right可能相等,只能缩边,最坏O(n)
旋转数组不是没序了,而是变成了两段有序,每次从中间切一刀,至少有一半是完整升序的。 所以每轮先判断哪半有序,再看目标在不在那半的范围里:在就收进去,不在就去另一半。有序那半的范围判断很好做,比较首尾就行,这是这题能保持 O(log n) 的原因。左半有序的判断要写 <=,因为 left === mid 时左半只有一个元素,也算有序。
# 题目与解题思路
给定由严格升序数组旋转得到的无重复数组,返回目标下标。若左端不大于中点,左半段有序;否则右半段有序。
function searchRotated(numbers, target) { // 接收旋转数组和目标值
let left = 0 // 初始化搜索左边界
let right = numbers.length - 1 // 初始化搜索右边界
while (left <= right) { // 搜索区间仍存在时继续
const middle = left + Math.floor((right - left) / 2) // 取得当前中点
if (numbers[middle] === target) return middle // 中点命中时返回
if (numbers[left] <= numbers[middle]) { // 判断左半段是否有序
if (numbers[left] <= target && target < numbers[middle]) right = middle - 1 // 目标位于左侧有序范围
else left = middle + 1 // 否则排除左半段
} else if (numbers[middle] < target && target <= numbers[right]) left = middle + 1 // 目标位于右侧有序范围
else right = middle - 1 // 否则排除右半段
} // 结束二分搜索
return -1 // 没有找到目标
} // 结束旋转数组搜索函数
# 复杂度、示例与易错点
- 时间复杂度
O(log n),空间复杂度O(1)。 - 示例:
searchRotated([4,5,6,7,0,1,2], 0)返回4。 - 易错点:范围判断一端包含等号、另一端不包含,避免重复保留中点。
💬 面试官追问
nums[left] <= nums[mid]写成<,哪组数据会出错?[3, 1]找1。left = mid = 0,3 < 3不成立,会误判成右半有序;再看3 < 1不成立,执行right = mid - 1,整个区间被丢掉,返回-1。有重复值,比如
[1, 0, 1, 1, 1],还能二分吗?left、mid、right都是1时分不清哪边有序,只能left++、right--各缩一格。最坏情况退化成O(n)。改成找旋转数组的最小值呢?
拿
mid和right比:nums[mid] > nums[right]说明最小值在右边,left = mid + 1;否则right = mid,用left < right循环,最后nums[left]就是最小值。为什么切开后一定有一半是有序的?
旋转点只有一个,它最多落在
mid的一侧,另一侧没被切断,就还是原来的升序。
# 19 实现一个最小栈
⚡ 30 秒速记
- 双栈:数据栈存值,最小栈同步存「到这一层为止的最小值」
- 压栈时
min(新值, 旧最小值)一起压;弹栈两个栈一起弹 getMin就是看最小栈栈顶,四个操作全是O(1)- 省空间版只在
<=当前最小时才压最小栈,等号不能漏
最小栈是拿空间换时间:多开一个栈,每一层都记下「截止这一层的最小值」。 压进一个数时,最小栈压入它和旧最小值中更小的那个;弹出时两个栈一起弹,弹完最小栈的栈顶自然回到上一个状态,不用重新找。这样 getMin 就是读一下栈顶,O(1)。也可以只在新值小于等于当前最小时才压最小栈省点空间,但等号一定要带上,重复的最小值少记一次,弹掉一个之后最小值就错了。
# 题目与解题思路
实现 push、pop、top 和 getMin。空栈读取统一返回 undefined,避免接口行为不一致。
class MinStack { // 定义支持最小值查询的栈
constructor() { // 初始化两个内部栈
this.values = [] // 保存真实入栈数据
this.minimums = [] // 保存每一层对应的最小值
} // 结束构造函数
push(value) { // 压入一个新值
const previous = this.getMin() // 读取压栈前的最小值
this.values.push(value) // 把数据压入普通栈
this.minimums.push(previous === undefined ? value : Math.min(previous, value)) // 保存新状态最小值
} // 结束压栈方法
pop() { // 弹出栈顶元素
if (!this.values.length) return undefined // 空栈不执行弹出
this.minimums.pop() // 同步移除最小值状态
return this.values.pop() // 返回真实栈顶值
} // 结束弹栈方法
top() { return this.values.at(-1) } // 返回栈顶但不修改栈
getMin() { return this.minimums.at(-1) } // 常数时间返回当前最小值
} // 结束最小栈类
# 复杂度、示例与易错点
- 四个操作时间复杂度均为
O(1),总体空间复杂度O(n)。 - 示例:依次压入
-2、0、-3,getMin()返回-3;弹出后返回-2。 - 易错点:新值等于当前最小值时也必须记录,否则弹出一个重复最小值后状态会出错。
💬 面试官追问
省空间版只在新值更小时才压最小栈,依次压
2、2、3,会出什么问题?第二个
2没进最小栈,弹出它时会顺手把最小栈里唯一的2也弹了,接着getMin就是空的。所以条件要写<=。为什么不在
getMin里遍历一遍找最小?那就变成
O(n)了,题目要求的是常数时间。一般的用法是getMin调得很频繁,遍历划不来。只用一个栈能做吗?
能,每次压栈存一个
[value, min]的元组,或者存和最小值的差值。本质还是每层带着一个最小值,只是放在一起了。空栈调
pop或getMin,该返回什么?看接口约定,返回
undefined或抛错都行,关键是四个方法行为一致,并且有测试覆盖空栈。
# 20 用两个栈实现队列
⚡ 30 秒速记
input栈只管收新元素,output栈只管出队- 只有
output空了,才把input整个倒过去,顺序一反转就是先进先出 - 每个元素最多进出两个栈各一次,出队均摊
O(1) - 坑:
output还有元素时就倒,新元素会插到旧元素前面
两个栈做队列靠的是「倒一次顺序就反过来」:栈是后进先出,倒到另一个栈里,最早进来的就到了栈顶。 入队永远压 input,出队从 output 弹,output 空了再把 input 一次性倒过去。这个「空了才倒」很关键,output 里还有旧元素时去倒,新元素就跑到旧元素前面了。单次出队可能要搬 n 个,但每个元素一辈子最多搬一次,摊下来每次操作还是 O(1)。
# 题目与解题思路
实现队列的 enqueue、dequeue、peek 和 isEmpty。抽出私有搬运方法,保证读取与删除共用同一套逻辑。
class QueueByStacks { // 定义由两个栈组成的队列
constructor() { // 初始化输入栈和输出栈
this.input = [] // 保存新加入的元素
this.output = [] // 保存已经反转顺序的元素
} // 结束构造函数
enqueue(value) { this.input.push(value) } // 把新元素压入输入栈
moveIfNeeded() { // 在需要时搬运元素
if (this.output.length) return // 输出栈非空时保留现有顺序
while (this.input.length) this.output.push(this.input.pop()) // 把输入栈全部反转到输出栈
} // 结束搬运方法
dequeue() { // 删除并返回队头
this.moveIfNeeded() // 确保输出栈准备好队头
return this.output.pop() // 输出栈顶就是最早入队元素
} // 结束出队方法
peek() { // 读取但不删除队头
this.moveIfNeeded() // 确保队头可读
return this.output.at(-1) // 返回输出栈顶
} // 结束读取方法
isEmpty() { return this.input.length + this.output.length === 0 } // 判断两个栈是否都为空
} // 结束队列类
# 复杂度、示例与易错点
- 入队
O(1),出队和读取队头均摊O(1),空间复杂度O(n)。 - 示例:依次入队
1、2,两次出队依次得到1、2。 - 易错点:输出栈不为空时不能继续搬运,否则新元素会跑到旧元素前面。
💬 面试官追问
入队
1、2,出队一次,再入队3,下次出队是谁?是
2。第一次出队时1、2倒进了output,弹出1;3进的是input,output里还有2,不触发搬运,直接弹出2。单次出队最坏是
O(n),凭什么说是O(1)?说的是均摊。每个元素只会被压进
input、搬到output、弹出各一次,n次操作总共O(n),平均下来每次常数。每次入队都把
output倒回input再压,有什么问题?结果是对的,但每次操作都在全量搬运,连续
n次操作就是O(n²)。反过来,用两个队列实现栈呢?
压栈时新元素进空队列,再把另一个队列的元素全部挪过来,新元素就排在最前面了。这样
push是O(n),pop是O(1)。
# 21 每日温度
⚡ 30 秒速记
- 典型单调栈:「下一个更大元素」类问题都这么做
- 栈里放的是还没等到更高温度的下标,不是温度
- 当前温度比栈顶高 → 一直弹,弹出的位置答案 = 当前下标 - 它的下标
- 栈里对应温度从底到顶不增;每个下标进出各一次,
O(n) - 「严格更高」:相等不弹
这是单调栈的标准题:栈里存一群「还在等更高温度」的天,新的一天来了,看它能帮栈顶的哪些天解决问题。 只要今天比栈顶那天热,就把栈顶弹出来,答案是两个下标的差,然后继续看新的栈顶。弹完再把今天压进去,等它自己的答案。最后还留在栈里的就是后面没有更热的天,答案保持默认的 0。虽然有两层循环,但每个下标只进栈一次、出栈一次,总体是线性的。
# 题目与解题思路
对每天温度返回还需等待多少天才会遇到更高温度。答案依赖位置距离,所以栈中存下标而不是温度值。
function dailyTemperatures(temperatures) { // 接收每日温度数组
const answer = Array(temperatures.length).fill(0) // 默认后续没有更高温度
const stack = [] // 保存尚未得到答案的下标
for (let index = 0; index < temperatures.length; index += 1) { // 从左到右扫描温度
while (stack.length && temperatures[index] > temperatures[stack.at(-1)]) { // 当前值能解决栈顶问题
const previous = stack.pop() // 取出等待更高温度的位置
answer[previous] = index - previous // 用下标差记录等待天数
} // 继续解决所有更低的栈顶温度
stack.push(index) // 当前下标等待未来更高温度
} // 结束温度扫描
return answer // 返回每一天的等待天数
} // 结束每日温度函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(n)。 - 示例:
[73,74,75,71,69,72,76,73]返回[1,1,4,2,1,1,0,0]。 - 易错点:题目要求“严格更高”,相等温度不能弹栈。
💬 面试官追问
while套在for里,为什么不是O(n²)?看每个下标的一生:它只被
push一次,最多被pop一次,所有while加起来最多弹n次,整体O(n)。栈里为什么存下标,不直接存温度?
答案是隔了几天,要用下标做减法。存了下标,温度随时能用
temperatures[i]查到,反过来就不行。[70, 70, 71],你的代码第一个70会得到几?得到
2。第二个70和栈顶相等不弹,直接压栈;到71时两个70都被弹出,分别是2和1。改成求下一个更大元素的值,而不是天数呢?
框架完全一样,弹出时写
answer[prev] = temperatures[i],没找到的默认值改成-1。如果数组是环形的,就把下标遍历两遍,用i % n取值。
# 22 前 K 个高频元素
⚡ 30 秒速记
- 第一步都一样:
Map统计频次 - 桶排序:频次最多是
n,开n + 1个桶,下标 = 频次,从高往低收够k个 →O(n) - 小顶堆:堆里只放
k个,比堆顶频次高就替换 →O(m log k),m是不同元素数 - 直接按频次
sort是O(m log m),面试能写但要说出更优解 - 同频顺序题目一般不保证,要稳定得自己定规则
前 K 个高频元素分两步:先统计每个数出现几次,再从频次里挑最大的 k 个。 挑的那一步有三种做法。最直接是按频次排序,O(m log m)。我更喜欢讲桶排序:频次不可能超过数组长度 n,就开 n + 1 个桶,下标就是频次,从最大的桶往下收,收满 k 个就停,整体 O(n)。如果 k 很小、数据又很多,用大小为 k 的小顶堆也很合适。JS 没有内置堆,手写的话面试官通常会接受你说思路。
# 题目与解题思路
返回数组中出现频率最高的 k 个元素。若 k 超过不同元素数,返回全部不同元素;同频元素的顺序不作保证。
function topKFrequent(numbers, k) { // 接收数字数组和目标数量
if (k <= 0) return [] // 非正数量没有结果
const counts = new Map() // 建立元素到频次的映射
for (const value of numbers) counts.set(value, (counts.get(value) || 0) + 1) // 一次遍历完成计数
const buckets = Array.from({ length: numbers.length + 1 }, () => []) // 以频次作为桶下标
for (const [value, count] of counts) buckets[count].push(value) // 把元素放进对应频次桶
const result = [] // 保存高频结果
for (let count = buckets.length - 1; count > 0; count -= 1) { // 从最高频率向下扫描
for (const value of buckets[count]) { // 读取当前频次的所有元素
result.push(value) // 把高频元素加入结果
if (result.length === Math.min(k, counts.size)) return result // 数量足够时立即返回
} // 结束当前频次桶处理
} // 结束全部桶扫描
return result // 空输入时返回空结果
} // 结束高频元素函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(n)。 - 示例:
topKFrequent([1,1,1,2,2,3], 2)返回包含1、2的数组。 - 易错点:同频时题目若要求稳定顺序,需要额外定义并实现排序规则。
💬 面试官追问
桶数组为什么是
n + 1长,不是n?一个元素最多出现
n次,要能访问下标n。下标0永远是空的,浪费一格换来写法简单。k只有10,但不同元素有几百万个,用哪个?用大小为
10的小顶堆。频次比堆顶大就替换堆顶,堆里始终是当前最高的10个,额外空间只有O(k),不用开n个桶。为什么用小顶堆而不是大顶堆?
小顶堆的堆顶是这
k个里最弱的,新来的只要和它比,赢了就把它踢掉。用大顶堆得把所有元素都放进去再取k次,空间是O(m)。数据是实时流进来的,要随时查前
10,还能用桶吗?不合适,每次查询都重新建桶太重。维护一份频次表,再配合一个能更新的堆或有序结构;数据量大到内存放不下,就要上
Count-Min Sketch这种近似统计。
# 23 实现 LRU 缓存
⚡ 30 秒速记
LRU= 最近最少使用,满了就淘汰最久没被访问的JS写法:Map保持插入顺序,访问就delete再set挪到最后,淘汰取keys().next().value- 标准写法:哈希表 + 双向链表,
get/put都是O(1) get和更新已有键都算一次使用,都要刷新顺序- 判断命中用
has,值本身可能是undefined或0
LRU 就是一个有容量的缓存,满了就把最长时间没用过的扔掉,关键是怎么在 O(1) 里知道谁最旧。 在 JS 里最省事的是用 Map,它会记住插入顺序,每次访问就先删再插,把这个键挪到最后,第一个键就是最旧的。面试官要是说「不许用 Map 的顺序」,就上哈希表加双向链表:哈希表负责 O(1) 找到节点,双向链表负责 O(1) 把节点挪到头部或者从尾部删掉。别忘了 put 一个已有的键也要刷新顺序。
# 题目与解题思路
实现固定容量的最近最少使用缓存。这里使用 Map 的有序特性;若面试要求不依赖语言容器内部顺序,应改为哈希表加双向链表。
class LRUCache { // 定义最近最少使用缓存
constructor(capacity) { // 接收最大容量
if (!Number.isInteger(capacity) || capacity <= 0) throw new TypeError('容量必须是正整数') // 校验容量
this.capacity = capacity // 保存容量上限
this.cache = new Map() // 用插入顺序记录使用新旧
} // 结束构造函数
get(key) { // 读取指定键
if (!this.cache.has(key)) return -1 // 未命中时返回约定值
const value = this.cache.get(key) // 保存命中的值
this.cache.delete(key) // 删除旧位置
this.cache.set(key, value) // 重新插入到最新位置
return value // 返回缓存值
} // 结束读取方法
put(key, value) { // 写入或更新键值
if (this.cache.has(key)) this.cache.delete(key) // 更新前移除旧位置
this.cache.set(key, value) // 把键写到最新位置
if (this.cache.size <= this.capacity) return // 未超容量时结束
const oldestKey = this.cache.keys().next().value // 取得最早插入的键
this.cache.delete(oldestKey) // 淘汰最久未使用项
} // 结束写入方法
} // 结束缓存类
# 复杂度、示例与易错点
- 平均
get、put都是O(1),空间复杂度O(capacity)。 - 示例:容量
2,写入1、2,读取1后再写入3,应淘汰键2。 - 易错点:更新已有键同样算最近使用,必须刷新顺序。
💬 面试官追问
容量
2,put(1)、put(2)、get(1)、put(3),淘汰谁?淘汰
2。get(1)把1挪到了最新的位置,最旧的变成了2。链表为什么必须是双向的?
删除或挪动一个节点要改它前一个节点的
next。单向链表找前驱得从头扫,就不是O(1)了。双向链表的实现,头尾都放哨兵节点有什么好处?
插入和删除永远有前驱和后继,不用判断是不是第一个、最后一个,和
null相关的边界问题基本就没了。缓存里存了
0或undefined,你的get会出什么问题?如果用
if (cache.get(key))判断命中,0和undefined都会被当成没命中。必须用cache.has(key)。LRU和LFU怎么选?LRU看最近什么时候用过,实现简单,但一次批量扫描就能把热点全冲掉;LFU看用了几次,抗扫描,但实现更复杂,还要处理老热点一直占着位置的问题。
# 24 实现 Trie 前缀树
⚡ 30 秒速记
Trie= 把公共前缀合成一条树路径,apple和app共用a→p→p- 节点两样东西:
children(字符 → 子节点)+isWord(这里是不是一个词的结尾) search要走到底且isWord === true;startsWith只要路径走得通- 三个操作都是
O(L),L是字符串长度,和词库大小无关 - 字符集固定小写可以用长度
26的数组,通用场景用Map
Trie 就是把一堆单词按前缀叠成一棵树,查一个词只要沿着字符一层层往下走。 打个比方,像查纸质字典先翻 a 再翻 ap。每个节点存一张「字符 → 子节点」的表,再加一个 isWord 标记。这个标记不能省:插入 apple 之后,app 这条路径是存在的,但它不是一个词,所以 search('app') 要返回 false,startsWith('app') 返回 true。我写的时候会抽一个 findNode,两个查询共用,区别只在最后看不看 isWord。
# 题目与解题思路
实现单词插入、完整单词查询和前缀查询。节点使用 Map,因此不局限于 26 个小写英文字母。
class TrieNode { // 定义前缀树节点
constructor() { // 初始化节点状态
this.children = new Map() // 保存字符到子节点的映射
this.isWord = false // 标记是否在此结束一个完整单词
} // 结束节点构造函数
} // 结束节点类
class Trie { // 定义前缀树
constructor() { this.root = new TrieNode() } // 创建不存字符的根节点
insert(word) { // 插入一个单词
let node = this.root // 从根节点开始
for (const character of word) { // 逐字符扩展路径
if (!node.children.has(character)) node.children.set(character, new TrieNode()) // 缺少分支时创建节点
node = node.children.get(character) // 移动到当前字符节点
} // 结束字符遍历
node.isWord = true // 标记完整单词终点
} // 结束插入方法
findNode(text) { // 查找一段文本对应的末端节点
let node = this.root // 从根节点开始查找
for (const character of text) { // 逐字符验证路径
if (!node.children.has(character)) return null // 任一字符缺失就判定不存在
node = node.children.get(character) // 移动到下一层节点
} // 结束路径查找
return node // 返回文本末端节点
} // 结束节点查找方法
search(word) { return this.findNode(word)?.isWord === true } // 判断完整单词是否存在
startsWith(prefix) { return this.findNode(prefix) !== null } // 判断前缀路径是否存在
} // 结束前缀树类
# 复杂度、示例与易错点
- 每次操作时间复杂度
O(L),L为字符串长度;空间取决于所有不同前缀节点数。 - 示例:插入
apple后,查询app为假,但前缀查询app为真。 - 易错点:空字符串是否算单词取决于是否允许插入它,本实现允许并在根节点标记。
💬 面试官追问
插入了
apple,search('app')返回了true,哪里写错了?多半是
search只判断了节点存在,没看isWord。正确写法是return this.findNode(word)?.isWord === true,路径存在只能说明它是某个词的前缀。搜索框要做联想,输入
ap列出所有候选词,怎么用Trie实现?先
findNode('ap')拿到前缀节点,再从它往下DFS,路过isWord的节点就把路径拼出来收集。候选多的话在节点上存个词频,DFS时只取前10个,或者直接在节点上缓存热门结果。删除一个单词怎么写?
先把终点的
isWord改成false,然后从尾巴往回清:一个节点没有子节点、自己也不是别的词的结尾,才能从父节点里删掉。直接删整条路径会把app删掉时连apple一起删了。用数组存子节点和用
Map存,怎么选?只有小写英文就用
new Array(26),charCodeAt(0) - 97当下标,访问快;但每个节点固定占26个槽,稀疏时浪费。有中文、大小写混合、emoji的场景直接用Map,按需分配。词库里有中文和
emoji,for...of遍历会不会出问题?for...of按码点遍历,'😀'不会被拆成两个代理项,比str[i]靠谱。但像👨👩👧这种组合emoji是多个码点拼的,用户眼里是一个字符,要按字素切就得用Intl.Segmenter,这得先和产品定好「一个字符」怎么算。
# 25 找到链表的中间节点
⚡ 30 秒速记
- 快指针一次两步,慢指针一次一步,快的到头时慢的刚好在中间
- 循环条件
while (fast && fast.next),少一个判断就会读null.next报错 - 偶数长度:
fast从head出发返回第二个中点,从head.next出发返回第一个 - 一次遍历、
O(1)空间,不用先数长度 - 同一套快慢指针还能判环、找入环点、找倒数第
k个
快慢指针靠速度差找中点:快的走完全程,慢的正好走一半。 就像两个人同时从起点出发,一个速度是另一个的两倍,快的到终点时慢的在半程。代码就三行循环,关键是条件写成 fast && fast.next,因为快指针下一步要跳两格,这两个都得存在。偶数长度有两个中点,1→2→3→4 按这个写法返回 3;题目要第一个中点就把 fast 初始化成 head.next。
# 题目与解题思路
返回单向链表中间节点;有两个中间节点时返回第二个。循环条件要同时保证快指针和它的后继存在。
function middleNode(head) { // 接收链表头节点
let slow = head // 慢指针从头节点出发
let fast = head // 快指针从头节点出发
while (fast && fast.next) { // 快指针还能安全走两步时继续
slow = slow.next // 慢指针前进一步
fast = fast.next.next // 快指针前进两步
} // 结束快慢指针移动
return slow // 返回中间节点或空值
} // 结束中间节点函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
1→2→3→4→5→6返回值为4的节点。 - 易错点:循环写成只判断
fast会在访问fast.next.next时出错。
💬 面试官追问
1→2→3→4我想拿到2而不是3,怎么改?把
fast初始化成head.next,其他不动。这样偶数长度时快指针提前一步到头,慢指针少走一步,停在第一个中点。归并排序拆链表就要这个版本,不然两个节点的链表会拆不开。循环条件只写
while (fast)会怎样?fast走到最后一个节点时fast.next是null,再执行fast.next.next直接抛TypeError。所以要fast && fast.next两个都判断。先遍历一遍求长度,再走
n / 2步,不也是O(n)吗?复杂度一样,都能过。快慢指针的好处是一次遍历、不用计数器,而且同一套思路能直接迁移到判环这类没法先求长度的题上,面试官更想看你会不会这个。
如果链表有环,这段代码会怎样?
fast永远到不了null,死循环。输入来源不可信的话,要么先用快慢指针判环(相遇就是有环),要么约定输入必须是无环链表。
# 26 删除链表倒数第 N 个节点
⚡ 30 秒速记
- 倒数第
n个 → 让快慢指针保持固定间隔,快的到尾时慢的就到位 - 加哑节点
dummy,删头节点也走slow.next = slow.next.next,不用特判 - 两个指针都从
dummy出发,快指针先走n + 1步,慢指针最终停在待删节点前一个 - 返回
dummy.next,不是head,头节点可能被删了 - 非法
n(<= 0或超过长度)要明确抛错或原样返回,别访问空指针
把「倒数第 n 个」转成「两个指针隔 n + 1 步一起走」。 快指针先走 n + 1 步,然后两个一起走,快指针走到 null 时,慢指针正好停在要删的节点前面,改一下它的 next 就删掉了。删节点本质是改前驱,所以我一定会加个哑节点:要删的刚好是头节点时,慢指针停在 dummy 上,操作完全一样。最后返回 dummy.next,很多人这里写成 head,删头节点的用例就挂了。
# 题目与解题思路
删除单向链表倒数第 n 个节点并返回新头节点。这里对非法 n 抛出异常,避免静默修改错误节点。
function removeNthFromEnd(head, n) { // 接收链表头和倒数位置
if (!Number.isInteger(n) || n <= 0) throw new RangeError('n 必须是正整数') // 校验位置参数
const dummy = { next: head } // 创建指向原头节点的哑节点
let fast = dummy // 快指针从哑节点出发
let slow = dummy // 慢指针从哑节点出发
for (let step = 0; step <= n; step += 1) { // 建立 n 加一的节点间隔
if (!fast) throw new RangeError('n 超出链表长度') // 长度不足时拒绝操作
fast = fast.next // 快指针前进一步
} // 结束间隔建立
while (fast) { // 快指针未到空节点时同步移动
fast = fast.next // 快指针继续前进
slow = slow.next // 慢指针保持固定间隔
} // 结束同步移动
slow.next = slow.next.next // 跳过待删除节点
return dummy.next // 返回可能变化的新头节点
} // 结束删除函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
1→2→3→4→5删除倒数第2个后得到1→2→3→5。 - 易错点:间隔是
n + 1个节点位置,因为慢指针必须停在待删节点前驱。
💬 面试官追问
[1]删倒数第1个,你的代码返回了[1],问题在哪?八成是最后
return head。头节点已经被跳过了,但head变量还指着它。要return dummy.next,这时是null。快指针为什么先走
n + 1步,不是n步?我们要慢指针停在待删节点的前驱上,比目标多隔一个位置。从
dummy出发走n + 1步,循环while (fast)结束时间隔刚好对上。也可以先走n步、循环改成while (fast.next),两套写法别混着用。n比链表长度还大,代码会发生什么?先走的那段循环里
fast会变成null,再读fast.next就报错。稳妥的写法是在循环里判断if (!fast) throw new RangeError(...),业务上也可以约定原样返回,关键是别静默删错节点。能不能不用哑节点?
能,但要单独处理:快指针先走
n步后如果已经是null,说明删的是头节点,直接返回head.next。多一个分支就多一个出错点,哑节点是更省心的写法。
# 27 判断对称二叉树
⚡ 30 秒速记
- 对称 = 左子树和右子树互为镜像,必须成对比较,不能各自遍历
- 镜像规则:外侧对外侧
left.left ↔ right.right,内侧对内侧left.right ↔ right.left - 两个都空 →
true;只有一个空 →false;值不同 →false - 空树算对称;递归最坏
O(n)栈,深树换队列迭代
对称树就是拿左右两棵子树当镜子互相照,比较时要交叉着比。 我会写一个 mirror(left, right),一次拿两个节点:都空就对称,一个空一个不空就不对称,值不同也不对称,都过了再递归比外侧 left.left 和 right.right、内侧 left.right 和 right.left。最常见的错是写成 left.left 对 right.left,那是在判断两棵树长得一样,不是镜像。
# 题目与解题思路
判断一棵二叉树是否关于根节点轴对称。空树按通常定义视为对称。
function isSymmetric(root) { // 接收二叉树根节点
function mirror(left, right) { // 成对判断两个节点是否镜像
if (!left && !right) return true // 两侧同时为空时对称
if (!left || !right) return false // 只有一侧为空时不对称
if (left.value !== right.value) return false // 节点值不同直接失败
return mirror(left.left, right.right) && mirror(left.right, right.left) // 交叉比较外侧和内侧子树
} // 结束镜像判断函数
return !root || mirror(root.left, root.right) // 空树对称,否则比较根的两棵子树
} // 结束对称树函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间最坏O(n)。 - 示例:根为
1,左右子树分别为2,3,4与2,4,3时返回真。 - 易错点:不能比较
left.left与right.left,那检查的是同向结构而不是镜像。
💬 面试官追问
判断两棵树完全相同,这段代码要改哪里?
只改递归那一行,变成同向比:
same(a.left, b.left) && same(a.right, b.right)。空值和值的判断原样保留。镜像和相同只差一个方向。不用递归,迭代怎么写?
用队列成对入队:先放
[root.left, root.right],每次取出一对按同样规则判断,然后按镜像顺序放入[l.left, r.right]和[l.right, r.left]。核心是「成对」,单个节点入队就没法比了。先中序遍历拿到数组,再判断数组是不是回文,行不行?
不行。不同结构的树可能得到同一个中序序列,比如
[1,2,2,null,2,null,2]的中序是回文,但树并不对称。结构信息被遍历丢掉了,必须按节点成对比。树退化成一条很长的链,递归会有什么问题?
深度上万时可能爆调用栈,
RangeError: Maximum call stack size exceeded。这时候换成显式队列,空间换到堆上就安全了。
# 28 二叉树最大深度
⚡ 30 秒速记
- 空节点深度
0,非空节点 =max(左深度, 右深度) + 1 - 后序思路:先拿到两个孩子的答案,再算自己
- 这里按节点数算,单节点是
1;按边数算单节点是0,先问清口径 DFS递归O(h)栈,BFS按层数也行- 最小深度不能照搬:只有一边孩子时不能取
min
最大深度就一句话:我的深度等于左右孩子里更深的那个再加一。 递归到空节点返回 0,往上一层层合成,整棵树遍历一次,O(n) 时间。我面试时会顺嘴确认一下口径,因为有的题按边数算,单节点答案就是 0。另一个容易被追问的是最小深度,它看起来只是把 max 换成 min,但一个节点只有左孩子时,右边那个 0 不是叶子,取 min 就错了。
# 题目与解题思路
返回从根节点到最远叶子节点所经过的节点数。递归分别计算左右深度,取较大值再加当前节点。
function maxDepth(root) { // 接收二叉树根节点
if (!root) return 0 // 空树没有节点所以深度为零
const leftDepth = maxDepth(root.left) // 递归计算左子树深度
const rightDepth = maxDepth(root.right) // 递归计算右子树深度
return Math.max(leftDepth, rightDepth) + 1 // 取较深子树并计入当前节点
} // 结束最大深度函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间为O(h)。 - 示例:只有根节点时返回
1,空树返回0。 - 易错点:题目若把深度定义为边数,单节点答案会变成
0,需要先确认口径。
💬 面试官追问
把
max换成min求最小深度,[1,2]返回了1,为什么不对?根只有左孩子,右边是空,
min(1, 0) + 1 = 1,但空不是叶子,最近的叶子是2,答案是2。要加判断:一边为空时只看另一边。用
BFS怎么写?队列逐层处理,每轮先记下
queue.length,把这一层全出队、孩子入队,处理完一层深度加一。求最小深度时BFS更划算,第一次遇到叶子就能直接返回。什么时候不该用递归写?
树可能极深,比如退化成几万层的链,
JS调用栈会爆。这时候用显式栈或者BFS队列,数据量再大也只是占堆内存。面试官说深度是边数,代码怎么改?
最省事的是外面包一层:空树按约定返回
-1或0,非空时maxDepth(root) - 1。改之前先确认空树怎么算,这个口径题目里经常没写。
# 29 验证二叉搜索树
⚡ 30 秒速记
BST的约束来自整条祖先路径,只比父子会漏掉跨层越界- 递归传
(lower, upper)区间:往左收紧上界,往右收紧下界 - 严格递增,等于边界也算非法
- 另一种解法:中序遍历必须严格递增,和上一个值比就行
- 节点值可能是
Infinity时别用数值哨兵,边界用null表示「没有」
验证 BST 的关键是每个节点都有一个从祖先传下来的合法区间,不只是比自己的父节点。 比如根是 5,右子树里某个节点是 3,它比自己的父节点 4 小,局部看没问题,但它在 5 的右边,就必须大于 5。所以我递归时带着 lower 和 upper:进左子树把上界改成当前值,进右子树把下界改成当前值,任何节点越界就返回 false。另一种写法是中序遍历,合法 BST 的中序一定严格递增。
# 题目与解题思路
判断二叉树是否满足左子树所有值小于根、右子树所有值大于根,且每棵子树也满足同样规则。
function isValidBST(root) { // 接收二叉树根节点
function validate(node, lower, upper) { // 校验节点是否落在祖先限定区间
if (!node) return true // 空子树天然满足约束
if (node.value <= lower || node.value >= upper) return false // 等于或越过边界均不合法
return validate(node.left, lower, node.value) && validate(node.right, node.value, upper) // 分别收紧左右子树边界
} // 结束递归校验函数
return validate(root, -Infinity, Infinity) // 根节点从无限区间开始校验
} // 结束搜索树验证函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间O(h)。 - 示例:
[5,1,4,null,null,3,6]不是 BST,因为值3落在根5的右子树。 - 易错点:只检查
node.left.value < node.value会漏掉跨层越界。
💬 面试官追问
只判断
node.left.value < node.value && node.right.value > node.value,哪种树会被误判?[5,1,4,null,null,3,6]这种:4的左孩子3比4小,局部合法,但3在根5的右子树里,应该大于5。局部比较只看一层,跨层约束全丢了。中序遍历的写法怎么做?
中序访问时维护一个
prev,每访问一个节点就检查node.value > prev,不满足直接返回false。不用存整个数组,O(h)空间就够。节点值里可能有
-Infinity,用-Infinity当初始下界会怎样?一个值就是
-Infinity的合法节点会被node.value <= lower判成非法。边界传null表示「无限制」,比较时先判断lower !== null,就不会和真实数据撞。业务里允许重复值,规则怎么调?
先定好重复值放哪边,比如统一放右边,那右子树的下界比较改成
<(允许等于),左子树仍然严格小于。不先约定这个,写出来的校验和插入逻辑对不上。
# 30 计算二叉树直径
⚡ 30 秒速记
- 直径 = 某个节点的「左深度 + 右深度」,取所有节点里的最大值
- 不一定经过根,可能整个在某棵子树里
- 递归函数返回「向下最长单侧深度」,全局变量记「拼起来的最大直径」
- 返回给父节点的是
max(left, right) + 1,不是left + right - 深度按节点数算时,
left + right刚好是边数
直径题要分清两件事:递归返回给父亲的是一条腿,全局答案是两条腿拼起来。 每个节点算出左右子树深度后,left + right 就是经过它的最长路径,拿去更新全局最大值;但往上返回时只能返回 max(left, right) + 1,因为父节点往下只能走一条路,路径不能分叉。很多人只算根节点的左右深度,碰到根的一边很浅、另一边子树里有一条很长路径的情况就错了。
# 题目与解题思路
返回二叉树任意两节点之间最长路径的边数。深度函数以节点数返回,左右深度相加恰好是经过当前节点的边数。
function diameterOfBinaryTree(root) { // 接收二叉树根节点
let diameter = 0 // 保存目前发现的最大直径
function depth(node) { // 计算节点向下的最大深度
if (!node) return 0 // 空节点向下深度为零
const left = depth(node.left) // 获取左子树深度
const right = depth(node.right) // 获取右子树深度
diameter = Math.max(diameter, left + right) // 用左右路径拼接候选直径
return Math.max(left, right) + 1 // 向父节点只返回较长的单侧路径
} // 结束深度函数
depth(root) // 遍历整棵树并更新答案
return diameter // 返回最大边数
} // 结束直径计算函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间O(h)。 - 示例:
1的左右为2、3,2的左右为4、5,直径为3条边。 - 易错点:直径不一定经过整棵树的根节点,不能只计算根的左右深度。
💬 面试官追问
只算根的左深度加右深度,什么样的树会算错?
根只有左孩子,左子树自己很宽,比如左子树里左右各挂一条长链。最长路径在左子树内部,根本不经过根,只看根就漏了。
为什么不直接返回
left + right给父节点?父节点往下延伸时只能选一边,如果把分叉的两条腿一起交上去,拼出来的就不是一条路径了。返回值和全局答案是两回事,这也是这题最想考的点。
题目改成返回节点数,怎么改?
非空树的节点数 = 边数
+ 1,最后return diameter + 1。空树要单独约定返回0,不然会多出一个。要把这条最长路径的两个端点找出来呢?
让递归除了深度再返回「最深那片叶子是谁」,更新
diameter时把左右两边的叶子记下来。还是一次后序遍历,只是返回值从数字变成对象。
# 31 求数组的所有子集
⚡ 30 秒速记
- 每个元素只有选/不选两种,一共
2^n个子集 - 回溯用
start只往后选,避免[1,2]和[2,1]重复出现 - 每进一个节点就收集一次,空集也算,不是到叶子才收
result.push([...path])必须复制,存引用最后全是空数组- 有重复元素:先排序,同一层跳过和前一个相同的值
子集题的回溯树上,每个节点本身就是一个答案。 所以进入 backtrack 第一件事就是把当前路径复制进结果,然后从 start 往后依次尝试加一个元素、递归、撤销。start 保证只往后选,这样 [1,2] 出现过就不会再出现 [2,1]。最容易犯的错是直接 push(path):path 是同一个数组,回溯完它被 pop 空了,结果里就是一堆 []。
# 题目与解题思路
给定互不相同的数组,返回所有子集。空集也必须包含在结果里,因此进入回溯函数时先记录路径。
function subsets(numbers) { // 接收不含重复值的数组
const result = [] // 保存全部子集
const path = [] // 保存当前选择路径
function backtrack(start) { // 从指定位置继续选择
result.push([...path]) // 复制当前路径作为一个子集
for (let index = start; index < numbers.length; index += 1) { // 枚举下一项
path.push(numbers[index]) // 做出选择
backtrack(index + 1) // 只从后续位置继续搜索
path.pop() // 撤销选择恢复现场
} // 结束候选枚举
} // 结束回溯函数
backtrack(0) // 从空路径开始搜索
return result // 返回所有子集
} // 结束子集函数
# 复杂度、示例与易错点
- 有
2^n个结果,时间和结果空间复杂度均至少为O(n × 2^n)。 - 示例:
[1,2]得到[]、[1]、[1,2]、[2]。 - 易错点:必须复制
path,直接保存同一数组引用会让最终结果全部相同。
💬 面试官追问
结果打印出来全是
[],哪里错了?result.push(path)存的是同一个数组的引用,回溯最后把它pop空了,所有元素一起变空。改成result.push([...path])或path.slice()。输入是
[1,2,2],怎么避免出现两个[1,2]?先排序,然后在
for循环里加if (i > start && nums[i] === nums[i - 1]) continue。注意是i > start,表示只跳过同一层的重复,下一层还是可以选第二个2。不用递归,有没有别的写法?
位掩码:从
0枚举到2^n - 1,第j位是1就选nums[j]。代码很短,但n超过30时1 << n会溢出,而且那时结果数量本身也爆了。只要长度为
k的子集怎么改?只在
path.length === k时收集并return。还能剪枝:剩下的元素不够凑满k个就不用往下走,即i <= n - (k - path.length)。
# 32 生成有效括号
⚡ 30 秒速记
- 边构造边剪枝,不是先生成全部排列再校验
- 能放
(的条件:left < n - 能放
)的条件:right < left,即前面还有没闭合的左括号 - 长度到
2n收集,结果个数是卡特兰数,n = 3有5个 - 字符串每次拼新的,不用手动撤销
生成括号就是在拼字符串的过程中把不合法的前缀提前掐掉。 状态只要记住用了几个左括号、几个右括号:左括号没用完就可以加 (;右括号用得比左括号少,说明还有没闭合的,才可以加 )。只要守住这两条,走到长度 2n 的一定合法,不用再校验。这里用的是字符串拼接,每层都是新字符串,不需要像数组那样 pop 回退。
# 题目与解题思路
给定括号对数 n,返回所有合法组合。搜索状态只需记录当前字符串和左右括号已使用数量。
function generateParenthesis(n) { // 接收括号对数
if (!Number.isInteger(n) || n < 0) return [] // 非法数量返回空结果
const result = [] // 保存所有合法组合
function backtrack(path, leftUsed, rightUsed) { // 构造一个合法前缀
if (path.length === n * 2) { // 长度满足时得到完整组合
result.push(path) // 保存不可变字符串结果
return // 结束当前分支
} // 结束完整结果判断
if (leftUsed < n) backtrack(`${path}(`, leftUsed + 1, rightUsed) // 左括号仍有余额时可以加入
if (rightUsed < leftUsed) backtrack(`${path})`, leftUsed, rightUsed + 1) // 有未闭合左括号时才能加入右括号
} // 结束回溯函数
backtrack('', 0, 0) // 从空字符串开始构造
return result // 返回全部合法括号
} // 结束括号生成函数
# 复杂度、示例与易错点
- 结果数量为卡特兰数,时间复杂度与输出规模成正比,递归深度
O(n)。 - 示例:
n = 2返回['(())', '()()']。 - 易错点:右括号条件是
rightUsed < leftUsed,而不是只检查rightUsed < n。
💬 面试官追问
右括号的条件写成
right < n,会出现什么结果?会生成
)(这种开头就不合法的串,因为它没保证每个前缀里右括号不多于左括号。正确条件是right < left。先生成
n个左括号和n个右括号的全排列再过滤,有什么问题?排列数是
C(2n, n)级别,n = 10就有十几万个候选,合法的只有16796个,绝大部分算力浪费在注定不合法的串上,还会有重复。n = 0应该返回什么?[''],空串是唯一的合法组合,和数学上卡特兰数C0 = 1对得上。返回[]也说得通,但要和调用方约定好。只要数量不要具体组合呢?
直接算卡特兰数
C(2n, n) / (n + 1),或者dp[i] = Σ dp[j] * dp[i - 1 - j]。不用生成字符串,O(n^2)就够。扩展到
()、[]、{}三种括号怎么办?光数个数不够了,要额外维护一个栈记录还没闭合的括号类型,加右括号时必须和栈顶匹配。状态从两个数字变成「剩余数量 + 栈」。
# 33 组合总和
⚡ 30 秒速记
- 数字可以重复用 → 递归传
index而不是index + 1 - 用
start只往后选,[2,2,3]不会再出现[3,2,2] - 先排序,当前值
> remaining直接break,后面更大的也不用试 remaining === 0时复制path收集- 候选里有
0或负数,递减终止条件就失效了,要在入口拦掉
组合总和用 start 管去重,用 remaining 管终点。 每层从 start 往后试,选了某个数后递归时还从这个下标开始,因为同一个数可以再用;remaining 减到 0 就收集一份。我会先复制一份数组再排序,这样遇到比剩余目标大的数就能直接 break,剪掉一大片分支,也不会改调用方传进来的数组。
# 题目与解题思路
给定互不相同的正整数候选数组和目标值,返回所有和为目标的组合。排序用于剪枝,不改变组合语义。
function combinationSum(candidates, target) { // 接收候选数和目标和
const numbers = [...candidates].sort((a, b) => a - b) // 复制并升序排列便于剪枝
const result = [] // 保存合法组合
const path = [] // 保存当前组合
function backtrack(start, remaining) { // 从指定位置凑剩余目标
if (remaining === 0) { // 恰好凑满目标
result.push([...path]) // 复制当前组合
return // 结束成功分支
} // 结束命中判断
for (let index = start; index < numbers.length; index += 1) { // 枚举不早于 start 的候选数
const value = numbers[index] // 读取当前候选值
if (value <= 0) throw new TypeError('候选数必须为正整数') // 防止无限重复选择零或负数
if (value > remaining) break // 后续值更大时停止本层搜索
path.push(value) // 选择当前候选数
backtrack(index, remaining - value) // 允许继续使用同一候选数
path.pop() // 撤销当前选择
} // 结束候选枚举
} // 结束回溯函数
backtrack(0, target) // 从全部候选数开始搜索
return result // 返回所有合法组合
} // 结束组合总和函数
# 复杂度、示例与易错点
- 复杂度与候选分支和目标值有关,最坏为指数级;递归深度最多约
target / min。 - 示例:候选
[2,3,6,7]、目标7得到[2,2,3]和[7]。 - 易错点:候选数必须为正数,否则“剩余目标递减”这一终止条件不成立。
💬 面试官追问
每个数字只能用一次,代码改哪?
递归改成
backtrack(index + 1, ...)。如果输入里还有重复值,比如[1,1,2],再加同层去重if (i > start && nums[i] === nums[i - 1]) continue,这就是「组合总和II」。候选数里混进了一个
0,会发生什么?选
0之后remaining不变,递归还从同一下标开始,就会无限选0,直到爆栈。所以循环里检测到非正数就直接抛错,防的就是这个。为什么要先复制再排序?
sort是原地排序,直接对candidates排会把调用方的数组顺序改掉,这种副作用排查起来很烦。[...candidates].sort((a, b) => a - b)多一点内存,换来没有副作用。只要有多少种组合,不要具体内容呢?
用完全背包
DP:dp[0] = 1,外层遍历数字、内层从小到大遍历金额,dp[j] += dp[j - num]。外层是数字就是组合数,顺序反过来算出来是排列数。
# 34 单词搜索
⚡ 30 秒速记
- 每个格子都当一次起点,匹配上就往上下左右
DFS - 走过的格子临时改成
null标记,回溯时恢复原字符 - 不管成功还是失败,返回前都要恢复现场
- 最坏
O(rows × columns × 3^L),第一步四个方向,之后最多三个 - 多个单词一起搜 → 建
Trie,一次DFS共享前缀
单词搜索就是网格上的回溯:一条路径不能重复用同一格,但这条路失败了,格子要还给别的路径。 我直接在 board 上把当前格改成 null 做标记,四个方向搜完再改回来,省掉一个 visited 数组。最容易出错的就是恢复现场:如果找到了就提前 return 而没改回来,下一个起点会看到被污染的网格。复杂度最坏是 O(rows × columns × 3^L),可以先比一下字符频次做个快速剪枝。
# 题目与解题思路
判断字符网格中是否存在一条上下左右相邻、且不重复使用格子的路径组成目标单词。空单词按本实现返回真。
function exist(board, word) { // 接收字符网格和目标单词
if (word.length === 0) return true // 空单词不需要占用格子
const rows = board.length // 保存网格行数
const columns = board[0]?.length || 0 // 安全读取列数
function search(row, column, index) { // 从指定格匹配单词当前位置
if (index === word.length) return true // 所有字符都已匹配
if (row < 0 || row >= rows || column < 0 || column >= columns) return false // 越界分支失败
if (board[row][column] !== word[index]) return false // 当前字符不匹配时失败
const original = board[row][column] // 保存当前字符以便恢复
board[row][column] = null // 临时标记当前路径已经使用此格
const found = search(row + 1, column, index + 1) || search(row - 1, column, index + 1) || search(row, column + 1, index + 1) || search(row, column - 1, index + 1) // 搜索四个相邻方向
board[row][column] = original // 回溯时恢复网格内容
return found // 返回当前起点能否完成匹配
} // 结束路径搜索函数
for (let row = 0; row < rows; row += 1) { // 枚举每一行
for (let column = 0; column < columns; column += 1) { // 枚举每一列
if (search(row, column, 0)) return true // 任一起点成功即可结束
} // 结束列枚举
} // 结束行枚举
return false // 所有起点都失败时返回假
} // 结束单词搜索函数
# 复杂度、示例与易错点
- 最坏时间复杂度约
O(rows × columns × 3^L),递归空间O(L)。 - 示例:网格
[['A','B'],['C','D']]中存在单词ABD。 - 易错点:成功或失败返回前都必须恢复现场,否则会污染后续起点。
💬 面试官追问
同一个
board连着调用两次exist,第二次结果不对,可能是什么原因?第一次搜索某条分支返回前没把格子恢复,
board里留下了null。要保证先board[r][c] = original再return found,成功分支也一样。用
visited数组和直接改board怎么选?改
board省O(rows × columns)空间,但会临时修改输入,多线程或调用方不允许改的场景不合适。visited更清晰,面试时两种都行,说清楚取舍就好。单词是
AAAAAAAB,网格全是A,跑得很慢,怎么优化?先统计频次:网格里没有
B,或者某个字符数量不够,直接返回false。还可以看单词首尾哪个字符在网格里更少,就把单词反过来从那头搜,分支会少很多。给一组单词,找出所有能在网格里搜到的,怎么做?
逐个调用
exist会重复走很多相同前缀。把单词建成Trie,DFS时沿着Trie节点往下走,到isWord就收集,一次遍历把所有单词搜完,这是「单词搜索II」的标准解法。
# 35 最大子数组和
⚡ 30 秒速记
Kadane:current= 以当前位置结尾的最大和,best= 全局最大- 转移:
current = max(x, current + x),前面累计是负数就从当前重新开始 - 初始化用
numbers[0],不能用0,全负数组会返回不存在的空子数组 O(n)时间、O(1)空间,数据流里也能实时算- 换个角度:最大子数组 = 当前前缀和 − 之前最小的前缀和
最大子数组和的思路是:前面累计的和如果是负数,只会拖后腿,直接扔掉从当前重新开始。 维护两个变量,current 是以当前元素结尾的最大和,每一步选「接在前面」还是「自己单开」,best 记录见过的最大 current。比如 [-2,1,-3,4,-1,2,1,-5,4],走到 4 时前面的累计已经是负的,就从 4 重新开始,最后得到 6。初始值要用第一个元素,不然全是负数时会返回 0。
# 题目与解题思路
返回非空整数数组中连续子数组的最大和。初始化为第一个元素,才能正确处理全负数组。
function maxSubArray(numbers) { // 接收非空整数数组
if (!numbers.length) throw new RangeError('数组不能为空') // 明确拒绝无答案输入
let current = numbers[0] // 保存必须以当前位置结尾的最大和
let best = numbers[0] // 保存遍历至今的全局最大和
for (let index = 1; index < numbers.length; index += 1) { // 从第二个元素开始递推
current = Math.max(numbers[index], current + numbers[index]) // 选择重新开始或接在旧区间后
best = Math.max(best, current) // 更新全局答案
} // 结束数组扫描
return best // 返回最大连续子数组和
} // 结束最大子数组函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[-2,1,-3,4,-1,2,1,-5,4]返回6,区间为[4,-1,2,1]。 - 易错点:不能把初始最大值设为
0,否则全负数组会得到不存在的空子数组。
💬 面试官追问
best初始化成0,输入[-3,-1,-2]返回什么?返回
0,但题目要求非空子数组,正确答案是-1。0对应的是空子数组,所以current和best都要从numbers[0]开始。要返回区间的起止下标,怎么改?
多维护一个
tempStart:每次「自己单开」时把它设成当前下标;best被更新时,把start = tempStart、end = i记下来。和前缀和是什么关系?
区间
[i, j]的和 =prefix[j + 1] - prefix[i],想让它最大,就是遍历时用当前前缀减去之前出现过的最小前缀。和Kadane是同一件事的两种写法。数据是一条源源不断的流,能实时给出答案吗?
能,
Kadane本来就是单次扫描,只要保存current和best两个数,每来一个数更新一次,不用存历史数据。
# 36 打家劫舍
⚡ 30 秒速记
- 每间房只有偷/不偷:
dp[i] = max(dp[i - 1], dp[i - 2] + nums[i]) - 只依赖前两项,滚动成
previousOne、previousTwo两个变量,O(1)空间 - 滚动顺序:先算
current,再previousTwo = previousOne,最后previousOne = current - 环形版本:拆成「不要第一间」「不要最后一间」两次线性,取大的
- 树形版本:每个节点返回「偷我 / 不偷我」两个值,后序合并
打家劫舍是最典型的相邻互斥 DP:到第 i 间时,要么不偷它继承前一间的最好结果,要么偷它再加上隔一间的最好结果。 因为只看前两项,不用开数组,两个变量滚着走就行。[2,7,9,3,1] 走一遍:2 → 7 → 11 → 11 → 12,选的是 2、9、1。写的时候注意更新顺序,先用旧值算出 current,再挪变量,顺序反了 previousTwo 会被提前覆盖。
# 题目与解题思路
给定每间房的非负金额,不能偷相邻房屋,求最大金额。空数组返回 0。
function rob(houses) { // 接收每间房屋的金额
let previousTwo = 0 // 保存处理到前两间房时的最优值
let previousOne = 0 // 保存处理到前一间房时的最优值
for (const money of houses) { // 依次考虑每间房屋
const current = Math.max(previousOne, previousTwo + money) // 比较跳过与选择当前房屋
previousTwo = previousOne // 向前滚动较旧状态
previousOne = current // 保存处理到当前房屋的最优值
} // 结束房屋扫描
return previousOne // 返回最终最大金额
} // 结束打家劫舍函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[2,7,9,3,1]返回12,选择2、9、1。 - 易错点:状态滚动顺序不能颠倒,否则
previousTwo会提前被当前结果覆盖。
💬 面试官追问
房子围成一圈,首尾也算相邻,怎么改?
首尾不能同时偷,就拆两次:算
nums.slice(1)和nums.slice(0, -1)的线性结果,取较大值。只有一间房时要特判,直接返回它。除了最大金额,还要知道偷了哪几间,怎么办?
滚动变量就不够了,要保留完整的
dp数组。最后从末尾往回推:dp[i] !== dp[i - 1]说明偷了第i间,跳到i - 2继续,否则看i - 1。房子是一棵二叉树,父子不能同时偷呢?
每个节点返回一个二元组
[偷, 不偷]:偷当前 = 当前值 + 两个孩子的「不偷」;不偷当前 = 每个孩子两种状态里取大的再相加。后序遍历一次就出结果。金额里有负数会怎样?
这个写法会自动跳过负数房,所有房都是负的就返回
0,相当于一间都不偷。要是业务规定至少偷一间,初始化和返回值都得改。
# 37 买卖股票的最佳时机
⚡ 30 秒速记
- 只能买一次卖一次,买必须在卖之前
- 扫一遍,维护「到昨天为止的最低价」,今天卖的利润 = 今天价 − 最低价
- 先算今天卖的利润,再用今天的价更新最低价,顺序别反
- 不能用全局最大减全局最小,最大值可能出现在最小值前面
- 多次交易 → 把所有上涨段累加;手续费、冷冻期 → 持有/空仓状态机
DP
一次交易只要边走边记两件事:之前的最低价,和目前最好的利润。 每到一天,假设今天卖,利润就是今天价格减之前最低价,拿去更新最好利润;然后再把今天的价格考虑进最低价里,给后面的日子当买入候选。[7,1,5,3,6,4] 在 1 买、6 卖,利润 5。全程都亏的话最好利润停在 0,表示不交易。
# 题目与解题思路
给定每日价格,求一次交易可得最大利润;无法盈利时返回 0。
function maxProfit(prices) { // 接收每日股票价格
let minimumPrice = Infinity // 保存当前日期之前的最低买入价
let bestProfit = 0 // 保存目前可得的最大非负利润
for (const price of prices) { // 按时间顺序扫描价格
bestProfit = Math.max(bestProfit, price - minimumPrice) // 假设今天卖出并更新利润
minimumPrice = Math.min(minimumPrice, price) // 把今天纳入未来买入候选
} // 结束价格扫描
return bestProfit // 返回最大利润
} // 结束股票利润函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[7,1,5,3,6,4]返回5,在1买入、6卖出。 - 易错点:不能用全局最大价减全局最小价,因为最大价可能出现在最小价之前。
💬 面试官追问
价格是
[9,8,1,2],有人直接用最大值减最小值,问题在哪?最大值
9在最小值1前面,相当于先卖后买,不合法,正确答案是1。必须按时间顺序扫,只拿当前价和它之前的最低价比。不限交易次数,怎么算?
只要明天比今天贵就算一笔:累加所有
prices[i] - prices[i - 1] > 0的差值。等价于每段上涨都吃到,O(n)就够。每笔交易有手续费
fee,怎么处理?用两个状态:
hold(手里有股票的最大收益)和cash(空仓的最大收益)。卖出时扣手续费:cash = max(cash, hold + price - fee),hold = max(hold, cash - price)。卖出后要冷冻一天才能再买呢?
多加一个冷冻状态:今天卖出的人明天只能进冷冻,冷冻完才回到可买入的空仓。三个状态滚动更新,还是
O(n)时间、O(1)空间。
# 38 盛最多水的容器
⚡ 30 秒速记
- 面积 = 较短那条线的高度 × 两线距离
- 左右指针从两端往里收,每次移动较短的那边
- 移动长边:宽度变小,高度还是被短边卡住,面积不可能变大
- 本质是排除法:短板和更近的任何线组合都不会更优,可以直接扔掉
- 不能排序,排序会打乱位置,宽度就没了
盛水容器的双指针靠的是排除法:当前短的那条边,已经不可能和别的线组合出更大的面积了。 两个指针从最两头开始,面积由短边决定。如果移动长边,宽度变小,高度最多还是短边,面积只会变小;只有移动短边,才有机会换到更高的线。所以每轮扔掉短边,O(n) 扫完。[1,8,6,2,5,4,8,3,7] 的答案是 49,是第二条线 8 和最后一条线 7 围出来的。
# 题目与解题思路
给定每个位置的高度,选择两条线与横轴组成容器,返回最大容量。
function maxArea(heights) { // 接收所有竖线高度
let left = 0 // 左指针从首条线开始
let right = heights.length - 1 // 右指针从末条线开始
let best = 0 // 保存目前最大面积
while (left < right) { // 至少还有两条不同竖线时继续
const height = Math.min(heights[left], heights[right]) // 容器高度由短板决定
best = Math.max(best, height * (right - left)) // 用当前高度和宽度更新面积
if (heights[left] <= heights[right]) left += 1 // 左边较短时舍弃左边
else right -= 1 // 右边较短时舍弃右边
} // 结束双指针收缩
return best // 返回最大容器面积
} // 结束最大面积函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[1,8,6,2,5,4,8,3,7]返回49。 - 易错点:移动的是较短边,不是随意移动,也不能把较高边当作容器高度。
💬 面试官追问
为什么可以放心扔掉短边,不会错过最优解吗?
短边和它中间任何一条线组合,宽度都比现在小,高度又不会超过短边自己,面积一定不比当前大。它所有可能的组合里,当前这个已经是最大的,算过了就可以丢。
两边一样高时,移哪边?
随便哪边都行。两边等高时,单独移哪一边,面积都不会超过当前值,要变大得两边都换掉,所以先移哪个不影响结果。写成
<=就是默认移左边。这题和接雨水看起来很像,区别在哪?
这题只挑两条线,求一个最大面积,中间的柱子不算;接雨水是每个位置上方都能存水,要把所有位置的水量加起来。
要返回是哪两条线,怎么改?
更新
best的时候顺便记下left和right两个下标,最后一起返回。
# 39 接雨水
⚡ 30 秒速记
- 每个位置的水量 =
min(左边最高, 右边最高) − 自己的高度 - 朴素做法:先算前缀最大和后缀最大两个数组,
O(n)空间 - 双指针:
leftMax <= rightMax时,左边位置的水量已经能确定,结算后左指针右移 - 先更新最大值再算差值,水量才不会是负数
- 单调栈是另一种
O(n)解法,按凹槽一层层结算
接雨水先想清楚一件事:每个位置能存多少水,取决于左边最高和右边最高里较矮的那个。 最直观的做法是先从左扫一遍得到每个位置的左侧最高,再从右扫一遍得到右侧最高,然后逐个加。双指针把这两个数组省掉了:如果左边目前最高的不超过右边目前最高的,那左指针这个位置的短板一定是 leftMax,右边更远处再高也没用,直接结算,然后左指针往里走。
# 题目与解题思路
给定非负柱高,计算下雨后能接住的总水量。每轮先更新两侧最高值,再结算较低一侧。
function trap(heights) { // 接收柱子高度数组
let left = 0 // 初始化左指针
let right = heights.length - 1 // 初始化右指针
let leftMax = 0 // 保存左侧扫描到的最高柱
let rightMax = 0 // 保存右侧扫描到的最高柱
let water = 0 // 累计雨水总量
while (left <= right) { // 两侧扫描区间未交错时继续
leftMax = Math.max(leftMax, heights[left]) // 更新左侧最高值
rightMax = Math.max(rightMax, heights[right]) // 更新右侧最高值
if (leftMax <= rightMax) { // 左侧短板已决定左位置水量
water += leftMax - heights[left] // 累加左位置可存水量
left += 1 // 左指针向内移动
} else { // 右侧短板已决定右位置水量
water += rightMax - heights[right] // 累加右位置可存水量
right -= 1 // 右指针向内移动
} // 结束短板分支
} // 结束双指针扫描
return water // 返回总雨水量
} // 结束接雨水函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[0,1,0,2,1,0,1,3,2,1,2,1]返回6。 - 易错点:要先更新最大值再计算差值,才能保证单个位置水量非负。
💬 面试官追问
leftMax <= rightMax时,凭什么不看右边更远的柱子就能结算左边?右边真实的最高值只会大于等于当前
rightMax,所以左边位置的短板一定是leftMax,右边再出现更高的柱子也改变不了结果。前后缀数组版本怎么写?
leftMax[i]从左往右递推,rightMax[i]从右往左递推,最后累加Math.min(leftMax[i], rightMax[i]) - heights[i]。好理解,就是多两个O(n)数组。单调栈怎么做?
栈里存下标,保持高度递减。遇到比栈顶高的柱子,弹出栈顶当凹槽底,新栈顶是左墙、当前柱子是右墙,水量 =
(min(左墙, 右墙) - 底) × 宽度。它是按横向一层层结算的,和双指针按竖列算是两个视角。数组有几百万个元素,选哪种?
双指针,
O(n)时间、O(1)额外空间。前缀数组和单调栈都要额外的O(n)内存,数据量大时差别就出来了。
# 40 移动零
⚡ 30 秒速记
- 读写双指针:
read扫全部,遇到非零就写到write位置 - 扫完后把
write往后的位置全补0 - 非零元素相对顺序不变,因为读和写都是从左往右
- 原地修改,
O(1)额外空间,filter会新建数组不符合要求 - 判断用
=== 0,别用!x,false、''不该被当成零
移动零可以理解成两步:先把非零元素按原顺序挤到前面,再把后面空出来的位置填成 0。 write 指向下一个非零元素该放的位置,read 从头扫到尾,每遇到一个非零就写到 write 上,write 往前挪一格。扫完以后 write 后面的都是旧数据,统一覆盖成 0。[0,1,0,3,12] 第一步变成 [1,3,12,3,12],补零后是 [1,3,12,0,0]。
# 题目与解题思路
原地把数组中的零移动到末尾,同时保持非零元素相对顺序。函数返回原数组,便于演示,但核心要求是原地修改。
function moveZeroes(numbers) { // 接收需要原地修改的数组
let write = 0 // 指向下一个非零元素写入位置
for (let read = 0; read < numbers.length; read += 1) { // 用读指针扫描整个数组
if (numbers[read] === 0) continue // 零元素留到第二阶段统一处理
numbers[write] = numbers[read] // 把非零元素稳定写到前部
write += 1 // 推进下一个写入位置
} // 结束非零元素收集
while (write < numbers.length) { // 覆盖剩余尾部位置
numbers[write] = 0 // 在尾部写入零
write += 1 // 推进尾部写指针
} // 结束尾部补零
return numbers // 返回同一个数组引用
} // 结束移动零函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[0,1,0,3,12]原地变为[1,3,12,0,0]。 - 易错点:判断必须使用严格数值比较,不能把
false、空字符串等其他假值当作零。
💬 面试官追问
直接
nums = nums.filter(x => x !== 0)再补零,为什么不行?filter返回新数组,函数里给nums重新赋值不会影响调用方手里的原数组,题目要原地改就不满足。而且多占O(n)内存。用交换代替两段写入,怎么写?有什么区别?
遇到非零就
[nums[write], nums[read]] = [nums[read], nums[write]],然后write++,一遍扫完不需要补零。零很少时交换版写入次数会多,零很多时补零版写得多,结果都一样。数组里有
false、'',用if (!nums[read]) continue会怎样?false和''也是假值,会被当成零跳过,然后被覆盖成0,数据就变了。要用nums[read] === 0严格比较。要把所有等于某个值的元素移到末尾呢?
把
=== 0抽成一个参数或者谓词函数shouldMove(x),补位的时候填那个值,其余逻辑不变。
# 41 相交链表
⚡ 30 秒速记
- 两个指针各走一遍
A + B和B + A,路程一样长,长度差被抵消 - 有交点 → 两个指针在交点相遇;没交点 → 同时走到
null,null === null退出循环 - 比较的是节点引用,不是节点值,值相同不代表是同一个节点
- 时间
O(m + n),空间O(1);用Set存一条链也行,但要O(m)空间
相交链表的套路是让两个指针互换跑道,走完自己的链表就去走对方的,这样两人走的总路程一样长。 假设 A 独有部分长 a、B 独有部分长 b、公共部分长 c,指针 A 走 a + c + b、指针 B 走 b + c + a,正好在交点碰头。没有交点时 c = 0,两个指针会同时变成 null,循环自然结束,返回 null。注意判断用 !== 比引用,值一样但不是同一个节点不算相交。
# 题目与解题思路
独立实现「相交链表」。让两个指针分别走完 A+B 与 B+A,用交换路径抵消两条链表的长度差。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function getIntersectionNode(headA, headB) { // 定义本题的核心实现
let pointerA = headA // 初始化当前步骤需要的状态
let pointerB = headB // 初始化当前步骤需要的状态
while (pointerA !== pointerB) { // 遍历仍需处理的候选状态
pointerA = pointerA ? pointerA.next : headB // 执行当前语句
pointerB = pointerB ? pointerB.next : headA // 执行当前语句
} // 结束当前代码块
return pointerA // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(m+n),空间 O(1)。
- 示例:A=4→1→8→4→5、B=5→6→1→8→4→5,返回值为 8 的同一个节点。
- 易错点:比较的是节点引用而不是节点值;无交点时两个指针最终会同时到达 null。
💬 面试官追问
两条链表没有交点,
while (pointerA !== pointerB)会死循环吗?不会。两个指针都走
m + n步后同时到null,null === null循环结束,返回null正好表示没交点。前提是切换跑道时写成pointerA ? pointerA.next : headB,让null也占一步。为什么不能比较
pointerA.value === pointerB.value?两条链表里可能各有一个值为
1的节点,但它们是不同的对象。相交指的是从某个节点开始共享同一块内存,所以必须比引用。用
Set怎么做?你会选哪种?先把
A的所有节点放进Set,再遍历B,第一个set.has(node)的就是交点。好写好懂,但多O(m)空间;面试要求O(1)空间就用双指针。还有别的
O(1)空间做法吗?先各自遍历求长度,让长的那条先走差值步,然后两个一起走,第一次相等的就是交点。和换跑道是同一个思路,只是把长度差显式算出来了。
# 42 回文链表
⚡ 30 秒速记
- 三步:快慢指针找中点 → 反转后半段 → 两头往中间逐个比
- 比较循环以后半段
right为准,奇数长度的中间节点自然被跳过 - 时间
O(n),空间O(1);转数组再双指针更好写,但要O(n)空间 - 这个做法会改坏原链表,业务要求不能动输入就比完再反转回去
回文链表的思路是:把后半段反转过来,这样就能从两头往中间同时比了。 先用快慢指针找到中点,再把从中点开始的后半段原地反转,然后一个指针从 head 走、一个从反转后的头走,值不一样就不是回文。循环以后半段为准,奇数长度时中间那个节点不影响结果。1→2→2→1 返回 true,1→2 返回 false。要注意这段代码把链表改了,调用方后面还要用就得复原。
# 题目与解题思路
独立实现「回文链表」。快慢指针找到中点,反转后半段,再从两端逐节点比较。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isPalindromeList(head) { // 定义本题的核心实现
let slow = head // 初始化当前步骤需要的状态
let fast = head // 初始化当前步骤需要的状态
while (fast && fast.next) { // 遍历仍需处理的候选状态
slow = slow.next // 执行当前语句
fast = fast.next.next // 执行当前语句
} // 结束当前代码块
let previous = null // 初始化当前步骤需要的状态
while (slow) { // 遍历仍需处理的候选状态
const next = slow.next // 初始化当前步骤需要的状态
slow.next = previous // 执行当前语句
previous = slow // 执行当前语句
slow = next // 执行当前语句
} // 结束当前代码块
for (let left = head, right = previous; right; left = left.next, right = right.next) { // 遍历仍需处理的候选状态
if (left.value !== right.value) return false // 检查当前分支条件
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:1→2→2→1 返回 true,1→2 返回 false。
- 易错点:奇数长度要跳过中间节点;若业务要求保持原链表,应在比较后把后半段复原。
💬 面试官追问
最简单的写法是什么?为什么面试官通常不满意?
遍历一遍把值放进数组,再用首尾双指针判断回文,几行就写完。但要
O(n)额外空间,题目一般会追问能不能O(1),那就得反转后半段。判断完以后,调用方发现链表变短了,为什么?
后半段被反转了,前半段最后一个节点的
next还指向原来的中间节点,可那个节点现在的next是null,从head遍历就只能走一半多一点。比完要再反转一次接回去。1→2→3→2→1奇数长度,中间的3会不会影响比较?不会。慢指针停在
3,反转后半段得到1→2→3,前半段从head走也是1→2→3,按right结束时中间节点是自己和自己比,一定相等。用递归能做到不改链表吗?
能:递归走到尾,回溯时和一个从头往后走的外部指针比较。不改结构,但递归栈是
O(n),长链表还可能爆栈,空间上并不比数组省。
# 43 移除链表中的指定元素
⚡ 30 秒速记
- 加哑节点
dummy,删头节点和删中间节点写法一样 current始终检查current.next:是目标就跳过,不是才往前走- 删除之后
current不动,因为新的current.next还没检查过 - 返回
dummy.next,头节点可能已被删 - 时间
O(n),空间O(1)
删除链表元素的标准做法是加一个哑节点,然后让 current 永远站在「待检查节点的前一个」位置。 单链表删节点只能改前驱的 next,所以要看的是 current.next:如果它是目标值,就 current.next = current.next.next 把它跳过去,current 原地不动;不是目标才 current = current.next。原地不动这一点很关键,像 1→6→6→2 删 6,删完第一个 6 如果马上往前走,第二个 6 就漏了。
# 题目与解题思路
独立实现「移除链表中的指定元素」。增加哑节点统一处理删除头节点和删除中间节点,current 始终检查自己的后继。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeElements(head, target) { // 定义本题的核心实现
const dummy = { next: head } // 初始化当前步骤需要的状态
let current = dummy // 初始化当前步骤需要的状态
while (current.next) { // 遍历仍需处理的候选状态
if (current.next.value === target) current.next = current.next.next // 检查当前分支条件
else current = current.next // 处理另一种分支
} // 结束当前代码块
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:1→2→6→3→6 删除 6 后得到 1→2→3。
- 易错点:删除后不能立刻推进 current,否则连续目标值会被漏掉。
💬 面试官追问
1→6→6→2删6,结果是1→6→2,哪里写错了?删完之后又执行了
current = current.next,跳过了紧跟着的第二个6。删除和前进要放在if / else两个分支里,删了就不前进。链表是
7→7→7,删7,你的代码返回什么?有哑节点的话三个都会被跳过,
dummy.next是null,返回空链表。没哑节点的写法得先用一个while把开头的目标值全删掉,很容易漏。递归怎么写?
head.next = removeElements(head.next, target),然后return head.value === target ? head.next : head。代码很短,但链表很长时递归深度等于链表长度,可能爆栈。要把被删掉的节点交给别的地方回收,怎么改?
跳过之前先
const removed = current.next保存,删完再把removed.next = null断开,避免它还挂着后面的链表,被别人误用或者导致整条链一起被引用住。
# 44 反转链表指定区间
⚡ 30 秒速记
- 套路:哑节点 + 头插法,找到区间前驱
before,把区间里的节点一个个摘下来插到before后面 current指向区间原来的第一个节点,它全程不动,最后自然变成区间尾- 循环
right - left次,每次三步:current.next = moved.next→moved.next = before.next→before.next = moved - 时间
O(n),空间O(1),一趟扫完 - 易错:
left/right从1开始数;left = 1时头节点会变,所以必须有哑节点
这题我会用哑节点加头插法,一趟扫完,不用先切出来反转再接回去。 先走 left - 1 步拿到区间前驱 before,current 是区间第一个节点。之后每轮把 current 后面那个节点摘下来,插到 before 后面,current 就一步步被推到区间末尾。比如 1→2→3→4→5 反转 [2,4]:第一轮变 1→3→2→4→5,第二轮变 1→4→3→2→5。哑节点是为了 left = 1 时不用单独处理头节点,返回 dummy.next 就行。
# 题目与解题思路
独立实现「反转链表指定区间」。用哑节点找到区间前驱,连续把区间内后继节点摘下并插到区间头部。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function reverseBetween(head, left, right) { // 定义本题的核心实现
const dummy = { next: head } // 初始化当前步骤需要的状态
let before = dummy // 初始化当前步骤需要的状态
for (let index = 1; index < left; index += 1) before = before.next // 遍历仍需处理的候选状态
const current = before.next // 初始化当前步骤需要的状态
for (let index = left; index < right; index += 1) { // 遍历仍需处理的候选状态
const moved = current.next // 初始化当前步骤需要的状态
current.next = moved.next // 执行当前语句
moved.next = before.next // 执行当前语句
before.next = moved // 执行当前语句
} // 结束当前代码块
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:1→2→3→4→5,反转 [2,4] 得到 1→4→3→2→5。
- 易错点:left 和 right 通常按 1 开始计数;头插时必须保留区间尾节点 current。
💬 面试官追问
为什么一定要哑节点,直接从
head开始找前驱不行吗?left = 1时区间前驱不存在,头节点会被换掉,不加哑节点就得写一段特判。const dummy = { next: head }之后所有情况都有前驱,最后统一return dummy.next。头插的三行顺序能换吗?比如先写
before.next = moved?不能。先改
before.next会丢掉原来区间头的引用,moved.next就接不回去了。记一个原则:先保存要断开的那条链(current.next = moved.next),再改指针。left === right或者链表只有一个节点,代码要不要特判?不用。第二个循环
index < right一次都不进,直接返回原链表。我面试时会主动跑一下这个用例,顺手证明边界是通的。另一种写法是把区间切下来反转再接回去,你怎么选?
切下来的写法要记住区间前驱、区间头、区间尾、区间后继四个指针,接回去的时候容易漏一个。头插法只要
before和current两个,代码短、出错面小,我一般直接写头插。如果
right超过了链表长度,现在的代码会怎样?moved会变成null,接着读moved.next直接报错。题目一般保证范围合法;真要上生产就在入口校验,或者在循环里遇到!current.next提前break。
# 45 排序链表
⚡ 30 秒速记
- 链表排序首选归并:快慢指针找中点 → 断开 → 递归排两半 → 合并两个有序链表
- 时间
O(n log n);递归版栈深O(log n),自底向上迭代版能做到O(1) - 断开靠
slow.next = null,忘了写左右两半还连着,递归停不下来 fast从head.next起步,两个节点时slow停在第一个,才能切成1 + 1- 合并时用
<=保证稳定;不选快排是因为链表没法随机访问,pivot选不好就退化到O(n²)
链表排序我会直接用归并,因为它只需要顺序访问,合并两个有序链表又是 O(1) 额外空间。 快慢指针找到中点后把 slow.next 置空,切成两条独立链表,各自递归排好再合并。这里最容易错的是 fast 的起点:如果 fast 也从 head 开始,两个节点的链表 slow 会停在第二个,左半边永远是两个节点,直接栈溢出。递归版栈深是 O(log n),面试官追问常数空间的话,再讲自底向上按 1、2、4… 步长合并的写法。
# 题目与解题思路
独立实现「排序链表」。用快慢指针二分链表,递归排序左右两半,再线性合并两个有序链表。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function mergeForList(left, right) { // 定义本题的核心实现
const dummy = { next: null } // 初始化当前步骤需要的状态
let tail = dummy // 初始化当前步骤需要的状态
while (left && right) { // 遍历仍需处理的候选状态
if (left.value <= right.value) { // 检查当前分支条件
tail.next = left // 执行当前语句
left = left.next // 执行当前语句
} else { // 进入当前逻辑分支
tail.next = right // 执行当前语句
right = right.next // 执行当前语句
} // 结束当前代码块
tail = tail.next // 执行当前语句
} // 结束当前代码块
tail.next = left ?? right // 执行当前语句
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
function sortList(head) { // 定义本题的核心实现
if (!head || !head.next) return head // 检查当前分支条件
let slow = head // 初始化当前步骤需要的状态
let fast = head.next // 初始化当前步骤需要的状态
while (fast && fast.next) { // 遍历仍需处理的候选状态
slow = slow.next // 执行当前语句
fast = fast.next.next // 执行当前语句
} // 结束当前代码块
const rightHead = slow.next // 初始化当前步骤需要的状态
slow.next = null // 执行当前语句
return mergeForList(sortList(head), sortList(rightHead)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n),递归栈 O(log n)。
- 示例:4→2→1→3 排序后得到 1→2→3→4。
- 易错点:切分时必须把 slow.next 置空,否则左右链表仍相连并导致无限递归。
💬 面试官追问
fast从head起步行不行?不行。
2→1这种两个节点的链表,slow会走到第二个节点,切完左边还是两个节点,递归无限下去。fast = head.next能保证偶数长度时slow停在前半段末尾。为什么不用快排?数组排序不是快排更快吗?
快排快是因为数组能随机访问、缓存友好,这两点链表都没有。链表上快排
pivot只能取头,遇到已经有序的输入就退化成O(n²);归并稳定在O(n log n),合并还不用额外数组。题目要求常数空间,递归版还算数吗?
严格说不算,递归栈是
O(log n)。要做到O(1)就自底向上:先按长度1两两合并,再按2、4翻倍,每轮切段、合并、接到尾部,代码长一些但没有递归。合并时写
<还是<=有区别吗?结果升序都对,区别在稳定性:
<=让值相等时左边的先出,原来的相对顺序不变。按对象某个字段排序时这点有用。偷懒的做法是把值倒进数组
sort完再写回去,面试能这么答吗?可以先说出来当对照,
O(n)额外空间、实现最短。但面试考的是链表上的分治,说完这个我会马上给归并版,不会只停在这。
# 46 链表表示的两数相加
⚡ 30 秒速记
- 链表是逆序存的数字,个位在表头,正好从低位往高位边走边加
- 每位:
sum = a + b + carry,写sum % 10,carry = Math.floor(sum / 10) - 循环条件写
left || right || carry,一条链短了补0,最后的进位也能写出去 - 哑节点 + 尾指针拼结果,时间和结果空间都是
O(max(m, n)) - 别把链表转成数字再相加,长度一过
15~16位就超出Number.MAX_SAFE_INTEGER
这题就是用链表模拟竖式加法,个位在表头,顺着两条链往下走、边加边进位就行。 每一位把两个节点的值和进位加起来,个位写进新节点,十位留给下一轮。我会把循环条件写成 left || right || carry,这样两条链不一样长、或者最后还剩一个进位,都在同一个循环里处理掉,不用在循环外补尾巴。比如 2→4→3 加 5→6→4,就是 342 + 465 = 807,结果 7→0→8。
# 题目与解题思路
独立实现「链表表示的两数相加」。从低位到高位同步遍历两条链表,把当前和的个位写入新节点并保存进位。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function addTwoNumbers(left, right) { // 定义本题的核心实现
const dummy = { next: null } // 初始化当前步骤需要的状态
let tail = dummy // 初始化当前步骤需要的状态
let carry = 0 // 初始化当前步骤需要的状态
while (left || right || carry) { // 遍历仍需处理的候选状态
const sum = (left?.value ?? 0) + (right?.value ?? 0) + carry // 初始化当前步骤需要的状态
carry = Math.floor(sum / 10) // 执行当前语句
tail.next = { value: sum % 10, next: null } // 执行当前语句
tail = tail.next // 执行当前语句
left = left?.next ?? null // 执行当前语句
right = right?.next ?? null // 执行当前语句
} // 结束当前代码块
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(max(m,n)),结果链表 O(max(m,n))。
- 示例:2→4→3 与 5→6→4 相加得到 7→0→8。
- 易错点:循环条件必须包含 carry,才能处理最后仍有进位的情况。
💬 面试官追问
直接把两条链表转成数字加完再拆回去,有什么问题?
位数一多就失真,超过
2^53 - 1的整数Number存不准,100位的链表算出来是错的。换BigInt能跑,但题目考的就是逐位进位,这么写等于绕过了题。9→9加1,你的循环最后会多一个节点吗?会,而且应该多。
99 + 1 = 100,结果是0→0→1,最后那个1就是靠循环条件里的carry写出来的。不带carry的写法这里会丢一位。如果数字是正序存的,表头是最高位呢?
从高位没法直接加。可以先把两条链反转、按这题做完再反转回去;不想改输入就用两个栈把值压进去,再从栈顶往外弹着加,结果用头插法建链。
为什么要新建节点,不直接改
left链表复用节点?复用能省空间,但会改掉调用方传进来的数据,而且两条链长短不一时逻辑更绕。面试我默认不改输入,除非面试官明确说允许原地修改。
# 47 合并 K 个升序链表
⚡ 30 秒速记
- 分治两两合并:每轮把链表数量减半,像归并排序的合并阶段
- 时间
O(N log k),N是所有节点总数,k是链表条数 - 另一种是小顶堆:堆里放每条链的当前头,每次弹最小,复杂度也是
O(N log k),JS没内置堆要手写 - 别逐条串行合并:
((l1 + l2) + l3) + …前面的结果被反复扫,最坏O(N·k) - 边界:空数组返回
null;奇数条时最后一条和null合并;数组里可能夹着null
合并 K 个有序链表我会用分治,两两合并,每轮链表数量减半,总共 log k 轮。 每一轮所有节点各被扫一遍,所以总时间是 O(N log k)。最容易被追问的是为什么不能一条一条往上合:第一条链的节点会在每次合并里被重新扫一遍,k 很大时就是 O(N·k)。另一个常见方案是小顶堆,复杂度一样,但 JS 没有现成的优先队列,面试里手写堆代码量大,我会先写分治,再口头讲堆的思路。
# 题目与解题思路
独立实现「合并 K 个升序链表」。把链表两两分组合并,像归并排序一样逐轮把链表数量减半。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function mergePair(left, right) { // 定义本题的核心实现
const dummy = { next: null } // 初始化当前步骤需要的状态
let tail = dummy // 初始化当前步骤需要的状态
while (left && right) { // 遍历仍需处理的候选状态
if (left.value <= right.value) { // 检查当前分支条件
tail.next = left // 执行当前语句
left = left.next // 执行当前语句
} else { // 进入当前逻辑分支
tail.next = right // 执行当前语句
right = right.next // 执行当前语句
} // 结束当前代码块
tail = tail.next // 执行当前语句
} // 结束当前代码块
tail.next = left ?? right // 执行当前语句
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
function mergeKLists(lists) { // 定义本题的核心实现
if (!lists.length) return null // 检查当前分支条件
let current = lists // 初始化当前步骤需要的状态
while (current.length > 1) { // 遍历仍需处理的候选状态
const next = [] // 初始化当前步骤需要的状态
for (let index = 0; index < current.length; index += 2) { // 遍历仍需处理的候选状态
next.push(mergePair(current[index], current[index + 1] ?? null)) // 执行当前语句
} // 结束当前代码块
current = next // 执行当前语句
} // 结束当前代码块
return current[0] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(N log k),递归/临时数组 O(log k)。
- 示例:[1→4→5,1→3→4,2→6] 合并为 1→1→2→3→4→4→5→6。
- 易错点:N 是全部节点数而不是单条链表长度;空列表和奇数条列表要单独覆盖。
💬 面试官追问
逐条合并和两两合并,复杂度到底差在哪?
逐条合并时,假设每条长
n,第i次合并要扫i·n个节点,加起来是O(n·k²),也就是O(N·k)。两两合并每轮扫一遍全部N个节点,只有log k轮。用小顶堆怎么写?跟分治怎么选?
先把每条链的头放进堆,每次弹出最小的接到结果尾部,再把它的
next放回堆。复杂度相同;链表是流式到来、或者要边合并边输出时堆更合适,一次性给全时分治代码更短。这份代码的空间复杂度是
O(log k)吗?不是。迭代版每轮新建了
next数组,第一轮长度是k/2,所以额外空间是O(k)。要压到O(1)可以原地写回lists[i],按步长1、2、4合并lists[i]和lists[i + step]。lists是[]或者[null, null],代码会挂吗?[]有开头的判断,返回null。[null, null]会走mergePair(null, null),while不进,tail.next = null,最后返回null,也没问题。k只有2或3的时候也要上分治吗?k很小时逐条合并和分治差不了多少,写哪个都行。但题目叫K个,面试官就是想听你讲log k,我还是写分治。
# 48 验证回文字符串
⚡ 30 秒速记
- 双指针从两头往中间走,遇到非字母数字就跳过,比较时统一转小写
- 时间
O(n),空间O(1);先用正则洗出新字符串再比较是O(n)空间 - 内层
while也要带left < right,不然全是标点的字符串会越界 /[a-z0-9]/i只认英文和数字,中文、带重音的字母都会被跳过,题目要求不同要换规则- 空串、全是标点都返回
true
最直接的写法是洗一遍字符串再和反转后的比,但更好的答案是双指针原地比较,空间 O(1)。 左右指针各自跳过空格和标点,停下来以后转小写比较,不相等就直接返回 false。内层跳过的循环一定要带上 left < right,不然 ",.!" 这种全是符号的输入,左指针会一路跑到右边去。另外 /[a-z0-9]/i 只覆盖 ASCII,如果产品里要支持中文或其他语言,可以换成 /[\p{L}\p{N}]/u,这点我会主动跟面试官确认。
# 题目与解题思路
独立实现「验证回文字符串」。左右指针跳过非字母数字字符,再按统一小写形式比较有效字符。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isPalindromeText(text) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = text.length - 1 // 初始化当前步骤需要的状态
const valid = character => /[a-z0-9]/i.test(character) // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
while (left < right && !valid(text[left])) left += 1 // 遍历仍需处理的候选状态
while (left < right && !valid(text[right])) right -= 1 // 遍历仍需处理的候选状态
if (text[left].toLowerCase() !== text[right].toLowerCase()) return false // 检查当前分支条件
left += 1 // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:A man, a plan, a canal: Panama 返回 true。
- 易错点:不能先用正则生成完整新字符串后仍声称空间 O(1);Unicode 范围需另行定义。
💬 面试官追问
一行写法
s.replace(/[^a-z0-9]/gi, '').toLowerCase()再比较反转,有什么不好?能过,可读性也好,但生成了两三个新字符串,空间
O(n)。面试官问「能不能O(1)空间」时就得换双指针,所以我会先报这个写法,再给双指针。内层
while里不写left < right会出什么事?输入全是标点时,
left会一直加到超过right甚至越界,text[left]变成undefined,接着调toLowerCase()就报错了。输入里有中文,比如「上海自来水来自海上」,现在的代码返回什么?
返回
true,但原因不对:中文全被当成标点跳过了,等于比较了一个空串。要支持中文就把判断换成/[\p{L}\p{N}]/u.test(ch)。那如果允许删掉一个字符再判断回文呢?
这是变形题。双指针遇到第一处不相等时,分别试跳过左边那个和跳过右边那个,剩下的区间再用普通回文判断,只要有一个成立就是
true,整体还是O(n)。
# 49 有序数组的平方
⚡ 30 秒速记
- 有序数组有负数,平方以后最大值一定在两端,中间最小
- 双指针从两头比平方,大的那个写到结果末尾,
write从后往前走 - 时间
O(n),结果数组O(n);直接平方再sort是O(n log n) - 从前往后写不行:最小值在中间某处,两端指针找不到它
JS里sort默认按字符串排,偷懒写法也要传(a, b) => a - b
平方以后数组变成两头大、中间小,所以我用双指针从两端往里收,每次把更大的那个平方写到结果数组的末尾。 这样一趟就排好了,O(n)。为什么从后往前写?因为两端只能告诉你谁最大,最小值在中间哪个位置并不知道。比如 [-4,-1,0,3,10],第一轮比 16 和 100,100 写到最后,右指针左移,以此类推,结果是 [0,1,9,16,100]。
# 题目与解题思路
独立实现「有序数组的平方」。平方后的最大值一定来自绝对值最大的两端,从结果数组末尾向前写。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function sortedSquares(numbers) { // 定义本题的核心实现
const result = new Array(numbers.length) // 初始化当前步骤需要的状态
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
for (let write = right; write >= 0; write -= 1) { // 遍历仍需处理的候选状态
const leftSquare = numbers[left] ** 2 // 初始化当前步骤需要的状态
const rightSquare = numbers[right] ** 2 // 初始化当前步骤需要的状态
if (leftSquare > rightSquare) { // 检查当前分支条件
result[write] = leftSquare // 执行当前语句
left += 1 // 执行当前语句
} else { // 进入当前逻辑分支
result[write] = rightSquare // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),结果空间 O(n)。
- 示例:[-4,-1,0,3,10] 得到 [0,1,9,16,100]。
- 易错点:比较的是绝对值;从头写会难以保持升序。
💬 面试官追问
直接
map平方再sort不就完了,为什么要双指针?那是
O(n log n),而且sort()不传比较函数会按字符串排,[9, 100]会排成[100, 9]。双指针用上了「原数组有序」这个条件,O(n)一趟搞定。能不能先找到正负分界点,再从中间往两边合并?
可以,本质也是合并两个有序序列,结果从小往大写。但要先找分界点,还要处理全正、全负的边界,比两端往里收啰嗦,我更倾向两端的写法。
两端平方相等的时候移哪边?
随便移一边都对,相等的值会在下一轮被写到前一位。代码里
leftSquare > rightSquare不成立就走else移右边,不用单独处理。要求原地修改、不能开结果数组,还能
O(n)吗?基本不行。从后往前写会覆盖还没比较的值,原地做只能平方后再原地排序,
O(n log n)。这种约束我会跟面试官确认,通常题目允许返回新数组。
# 50 有序数组的两数之和
⚡ 30 秒速记
- 数组升序 → 两端夹逼:和小了左指针右移,和大了右指针左移
- 时间
O(n),空间O(1),比哈希表省空间 - 为什么不会漏解:和太小时,当前
left配任何剩下的数都只会更小,这一行可以整行排除 - 返回下标看题目要求,这题常见是
1-based,记得+1 - 无序数组不能直接用,得先排序(下标会乱)或者改用哈希表
数组有序时我会用双指针从两头夹,和小了左边右移,和大了右边左移,O(n) 时间、O(1) 空间。 关键是能讲清为什么不会漏答案:如果 numbers[left] + numbers[right] 比目标小,那 left 和剩下任何一个数配都只会更小,因为 right 已经是最大的了,所以这个 left 可以直接丢掉,反过来同理。每一步排除一行或一列,最多走 n 步。普通无序的两数之和用哈希表更合适,这题给了有序条件,就该用上。
# 题目与解题思路
独立实现「有序数组的两数之和」。利用升序性质从两端夹逼:和太小移动左指针,和太大移动右指针。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function twoSumSorted(numbers, target) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const sum = numbers[left] + numbers[right] // 初始化当前步骤需要的状态
if (sum === target) return [left + 1, right + 1] // 检查当前分支条件
if (sum < target) left += 1 // 检查当前分支条件
else right -= 1 // 处理另一种分支
} // 结束当前代码块
return [] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,7,11,15]、target=9 返回 [1,2]。
- 易错点:题目若要求 1-based 下标,返回时需要加一;无序数组不能直接使用。
💬 面试官追问
怎么证明夹逼不会把正确答案跳过去?
想象一个
n×n的和矩阵,行是left、列是right。和小于目标时,left这一行剩下的格子都更小,整行排除;和大于目标时整列排除。答案所在的格子永远不会被排除掉。用哈希表也是
O(n),这题为什么还用双指针?哈希表要
O(n)额外空间,双指针是O(1)。数组本身有序时没理由多开一个Map,面试官给有序条件就是在等你用它。要返回所有和为
target的组合,而且数组有重复值呢?找到一组后不要
return,记录下来,然后left和right各自跳过和当前值相同的元素再继续。三数之和的去重就是这么做的。数组是无序的,先
sort再夹逼行吗?能找到值,但下标已经被打乱了。题目要原下标的话,要么排序前把
[value, index]绑在一起排,要么直接用哈希表一趟搞定。
# 51 长度最小的连续子数组
⚡ 30 秒速记
- 滑动窗口:右指针一直扩,和
>= target时记录长度,再收左指针直到不达标 - 每个元素最多进窗口一次、出窗口一次,时间
O(n),空间O(1) - 收缩要用
while不是if:一个大数进来可能让左边连着弹好几个 - 前提是全是正数:窗口变长和一定变大,才有单调性;有负数就要换前缀和 + 单调队列
- 没有满足的子数组返回
0,所以best初始化Infinity,最后判一下
这题是典型的滑动窗口:右边不断扩,一旦窗口和达标就记下长度,然后从左边缩,直到不达标再继续扩。 虽然是两层循环,但左右指针都只往前走,每个元素最多进出一次,所以是 O(n)。这个方法能成立靠的是数组全是正数,窗口变长和一定变大、变短一定变小,这个单调性让我可以放心地丢掉左边。如果有负数,丢掉左边可能反而让和变大,窗口就失效了,得用前缀和加单调队列。
# 题目与解题思路
独立实现「长度最小的连续子数组」。右指针扩张窗口直到和达标,再持续移动左指针压缩出当前最短长度。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minSubArrayLen(target, numbers) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let sum = 0 // 初始化当前步骤需要的状态
let best = Infinity // 初始化当前步骤需要的状态
for (let right = 0; right < numbers.length; right += 1) { // 遍历仍需处理的候选状态
sum += numbers[right] // 执行当前语句
while (sum >= target) { // 遍历仍需处理的候选状态
best = Math.min(best, right - left + 1) // 执行当前语句
sum -= numbers[left] // 执行当前语句
left += 1 // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return best === Infinity ? 0 : best // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:target=7、[2,3,1,2,4,3] 返回 2。
- 易错点:该滑动窗口依赖元素均为正数;包含负数时窗口和不再单调。
💬 面试官追问
里面那层收缩写成
if可以吗?不行。比如
target = 7、[1,1,1,7],右指针走到7时窗口和是10,要连续弹掉三个1才得到长度1。if只弹一次,答案会偏大。两层循环为什么复杂度还是
O(n)?看指针移动总次数:
right走n步,left也最多走n步,而且从不回退,合起来2n。不能光看嵌套层数判断复杂度。数组里有负数时还能用滑动窗口吗?
不能,窗口和不再随长度单调变化。要改成前缀和
pre[j] - pre[i] >= target,用单调递增队列维护候选i,还是O(n),就是LeetCode862 那道题。面试官要一个
O(n log n)的解法呢?前缀和 + 二分。正数保证前缀和严格递增,对每个
i二分找第一个满足pre[j] >= pre[i] + target的j。这个解法比窗口慢,但思路能迁移到其他题。
# 52 删除有序数组中的重复项
⚡ 30 秒速记
- 快慢指针:
read往前扫,write指向下一个该写的位置 - 有序数组里重复值是挨着的,只要和已写的最后一个
numbers[write - 1]比就够了 - 时间
O(n),空间O(1),返回的是新长度write - 长度之后的元素不用管,判题只看前
write个 - 变形:每个值最多留两个,把比较对象换成
numbers[write - 2]
这题用快慢指针原地覆盖:read 负责扫,write 负责写,遇到和已写部分最后一个不同的值,就写到 write 的位置。 因为数组有序,相同的值一定连在一起,所以只跟已写区的最后一个比就能去重。函数返回新长度,前 write 个就是去重结果,后面残留的旧值不用清。比如 [0,0,1,1,2] 跑完前三个是 [0,1,2],返回 3。
# 题目与解题思路
独立实现「删除有序数组中的重复项」。读指针扫描数组,遇到与已写末尾不同的值就写入慢指针位置。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeDuplicates(numbers) { // 定义本题的核心实现
if (!numbers.length) return 0 // 检查当前分支条件
let write = 1 // 初始化当前步骤需要的状态
for (let read = 1; read < numbers.length; read += 1) { // 遍历仍需处理的候选状态
if (numbers[read] === numbers[write - 1]) continue // 检查当前分支条件
numbers[write] = numbers[read] // 执行当前语句
write += 1 // 执行当前语句
} // 结束当前代码块
return write // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[0,0,1,1,2] 返回 3,前 3 项为 [0,1,2]。
- 易错点:函数返回的是新长度,长度之后的旧值不属于有效结果。
💬 面试官追问
为什么跟
numbers[write - 1]比,而不是跟numbers[read - 1]比?这题两种都对,因为有序数组里两者是一样的。但跟
write - 1比是更通用的写法,改成「最多保留k个」时只要换成write - k,跟read比就改不出来。每个元素最多保留两次怎么改?
write从2开始,条件换成numbers[read] !== numbers[write - 2]就写入。长度不足2时直接返回原长度。用
[...new Set(numbers)]不是更简单吗?简单,而且对无序数组也能用,但它新建了数组,不满足原地、
O(1)空间的要求,也没改到传进来的数组。题目要原地就只能用双指针。数组是无序的,还能这么去重吗?
不行,重复值不再挨着。要么先排序再用这套,
O(n log n);要么用Set记录见过的值,O(n)时间但要O(n)空间。
# 53 原地移除数组指定元素
⚡ 30 秒速记
- 快慢指针原地覆盖:
read扫全部,不等于target的才写到write - 时间
O(n),空间O(1),返回新长度,后面的残留值不用管 - 保留原顺序,非目标元素每个都要写一次
- 不要求顺序时可以拿末尾元素填坑,写入次数等于目标元素的个数,适合目标很少的情况
- 别在循环里
splice:每次删都要整体前移,最坏O(n²)
原地删元素我会用快慢指针,只把不等于目标的值往前搬,最后 write 就是新长度。 这样每个元素只看一次,O(n),不开额外数组。很多人第一反应是边遍历边 splice,但 splice 每删一个就要把后面的元素整体挪一位,目标值多的时候就是 O(n²),而且边删边遍历下标容易跳过元素。如果题目不要求保持顺序,还可以把末尾的元素拿过来填坑,目标很少时写入次数更少。
# 题目与解题思路
独立实现「原地移除数组指定元素」。读指针扫描,只有非目标值才写入慢指针所指位置。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeElement(numbers, target) { // 定义本题的核心实现
let write = 0 // 初始化当前步骤需要的状态
for (const value of numbers) { // 遍历仍需处理的候选状态
if (value === target) continue // 检查当前分支条件
numbers[write] = value // 执行当前语句
write += 1 // 执行当前语句
} // 结束当前代码块
return write // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[3,2,2,3] 移除 3 后返回长度 2,前缀为 [2,2]。
- 易错点:不要求保持尾部内容;若允许打乱顺序,也可用末尾元素覆盖以减少写入。
💬 面试官追问
for循环里遇到目标就splice(i, 1),有什么问题?两个问题:删完后面的元素前移,
i++会跳过一个,[3,3]删3会剩一个;而且每次splice是O(n),整体退化成O(n²)。要删也得倒序遍历,但复杂度还是不行。「用末尾元素填坑」具体怎么写?
i从头、n是当前长度,numbers[i] === target时numbers[i] = numbers[n - 1]; n--,i不动,因为换过来的值也要再检查;不是目标再i++。最后返回n。两种写法怎么选?
要保持顺序只能用快慢指针。不要求顺序、目标值很少时,填坑法写入次数少;目标值很多时两者差不多,我默认写快慢指针,好读。
业务代码里删数组元素,你也这么写吗?
一般不会,直接
list.filter(x => x !== target)返回新数组,配合React这类不可变数据也更安全。原地修改只在数据量很大、确实要省内存时才考虑。
# 54 原地反转字符串数组
⚡ 30 秒速记
- 左右指针交换,向中间收拢,循环条件
left < right - 时间
O(n),空间O(1),交换次数是n / 2 - 输入是字符数组,不是字符串:
JS字符串不可变,没法原地改 - 解构交换前面加分号,防止上一行没分号时被拼成函数调用
- 带
emoji的字符串按UTF-16码元反转会拆坏代理对,要先Array.from按码点拆
左右指针各从一头出发,交换后往中间走,相遇就停,O(n) 时间、O(1) 空间。 循环条件写 left < right,奇数长度时中间那个不用动,写成 <= 也不会错,只是多交换一次自己。要注意的是 JS 字符串不可变,所以题目给的是字符数组;如果真拿到的是字符串,只能先拆成数组,空间就是 O(n) 了。还有一个容易被忽略的点:"a😀".split('') 会把 emoji 拆成两个半个码元,反转后变乱码,要用 Array.from(str) 按码点拆。
# 题目与解题思路
独立实现「原地反转字符串数组」。左右指针交换字符并同时向中间移动。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function reverseCharacters(characters) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = characters.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
;[characters[left], characters[right]] = [characters[right], characters[left]] // 执行当前语句
left += 1 // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
return characters // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[h,e,l,l,o] 原地变为 [o,l,l,e,h]。
- 易错点:题目输入通常是字符数组而不是不可变字符串;循环条件是 left < right。
💬 面试官追问
如果传进来的是字符串,能原地反转吗?
不能,
JS字符串是不可变的,str[0] = 'x'静默失败。只能str.split('')或Array.from(str)转成数组再反转,空间变成O(n)。[...'a😀b'].reverse().join('')和'a😀b'.split('').reverse().join('')结果一样吗?不一样。
split('')按UTF-16码元拆,😀是两个码元,反转后顺序颠倒变成乱码;展开运算符按码点拆,emoji保持完整。组合型的表情(比如带肤色的)连码点也不够,要用Intl.Segmenter。解构交换前面为什么有个分号?
不写分号时,如果上一行没以分号结尾,
[会被当成上一个表达式的下标访问或者调用,ASI不会帮你断句。不写分号风格的项目里,以[或(开头的行都要加。用临时变量交换和解构交换,哪个好?
结果一样。解构更简洁,可读性好;在特别热的循环里临时变量会快一点点,但面试题里没必要纠结,写哪个都行。
# 55 两个数组的交集
⚡ 30 秒速记
- 第一个数组放进
Set,扫第二个数组,命中的放进结果Set去重 - 平均时间
O(m + n),空间O(m + n) - 结果要去重;要保留出现次数(交集 2 那道题)就换成计数
Map,命中一次减一 - 小数组建
Set更省空间 - 两个数组已经有序时,双指针不用额外哈希,空间
O(1)(不算结果)
两个数组求交集,我会把一个数组放进 Set,再扫另一个数组,命中的放进结果 Set,这样天然去重,平均 O(m + n)。 别写成 left.filter(x => right.includes(x)),includes 每次是线性查找,整体变成 O(m·n),还得自己去重。如果题目要求保留重复次数,比如 [1,2,2,1] 和 [2,2] 要返回 [2,2],就把 Set 换成计数 Map,命中一次计数减一。数组本来就有序的话,双指针更省空间。
# 题目与解题思路
独立实现「两个数组的交集」。把第一个数组放进 Set,再扫描第二个数组并把命中值写入结果 Set。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function intersection(left, right) { // 定义本题的核心实现
const candidates = new Set(left) // 初始化当前步骤需要的状态
const result = new Set() // 初始化当前步骤需要的状态
for (const value of right) { // 遍历仍需处理的候选状态
if (candidates.has(value)) result.add(value) // 检查当前分支条件
} // 结束当前代码块
return [...result] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 平均时间 O(m+n),空间 O(m+n)。
- 示例:[1,2,2,1] 与 [2,2] 的交集为 [2]。
- 易错点:交集结果要求去重;若要求保留出现次数,应改用频次 Map。
💬 面试官追问
left.filter(v => right.includes(v))这样写有什么问题?includes是线性扫描,复杂度是O(m·n),两个数组各10万就是100亿次比较。而且结果没去重,[1,2,2,1]会得到[2,2]。要求结果保留出现次数怎么改?
先对一个数组计数
Map,扫另一个数组时count > 0就放进结果并count--。[1,2,2,1]和[2,2]结果是[2,2]。一个数组
10条,另一个100万条,Set建在哪边?建在小的那边,空间只要
O(10),然后流式扫大数组。大数组如果在磁盘或者分批拉取,这样也不用一次全读进内存。数组元素是对象,比如
{ id: 1 },Set还能用吗?Set比较的是引用,两个内容相同的对象算不同的元素。要按id求交集就把id放进Set,new Set(left.map(item => item.id)),再按id过滤。
# 56 搜索插入位置
⚡ 30 秒速记
- 本质是
lower_bound:找第一个>= target的位置,找不到就是插入点 - 左闭右开
[0, n):right = n、while (left < right)、right = middle - 返回值可能等于
n(比所有数都大,插到末尾),所以right要初始化成n middle = left + Math.floor((right - left) / 2),其他语言防溢出- 区间写法要从初始化到收缩一以贯之,混用是死循环和越界的主要来源
搜索插入位置其实就是找第一个大于等于 target 的位置,我习惯用左闭右开区间来写。 right 初始化成数组长度 n,因为插入点可能在最末尾。循环里中间值比目标小,说明答案在右边,left = middle + 1;否则 middle 本身可能就是答案,right = middle 保留它。循环结束时 left === right,就是答案。我会强调一点:区间开闭定了以后,初始化、循环条件、收缩方式都要跟着它走,二分写错基本都是这几处混用了。
# 题目与解题思路
独立实现「搜索插入位置」。在左闭右开区间中寻找第一个大于等于 target 的位置,也就是 lower_bound。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function searchInsert(numbers, target) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
if (numbers[middle] < target) left = middle + 1 // 检查当前分支条件
else right = middle // 处理另一种分支
} // 结束当前代码块
return left // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log n),空间 O(1)。
- 示例:[1,3,5,6] 中查找 2 返回 1,查找 7 返回 4。
- 易错点:返回范围允许等于数组长度;区间语义必须从初始化到循环条件保持一致。
💬 面试官追问
right初始化成numbers.length - 1会怎样?target比所有数都大时,正确答案是n,但区间里根本没有n,最多返回n - 1。[1,3,5,6]找7会返回3,而不是4。左闭右开下,
right = middle - 1可以吗?不行。
numbers[middle] >= target时middle可能就是第一个满足条件的位置,middle - 1会把答案排除掉。左闭右开里right本身不在区间内,所以right = middle正好把middle排除出「待查」,又不丢答案。数组里有重复值,比如
[1,2,2,2,3]找2,返回哪个下标?返回
1,第一个2的位置。这就是lower_bound的语义;要找最后一个2,就找第一个> target的位置再减一。(left + right) >> 1这种写法在JS里有坑吗?有。位运算会把数转成
32位有符号整数,下标超过2^31会变负数。普通数组碰不到这个量级,但用Math.floor或者left + ((right - left) >> 1)更稳妥。
# 57 整数平方根
⚡ 30 秒速记
- 二分找最大的
x,满足x * x <= n,也就是「最后一个满足条件的位置」 - 区间
[1, n / 2],n >= 4时平方根不超过n / 2;n < 2直接返回n - 满足条件时记下
answer再往右找,不满足往左 - 防溢出:比较
middle <= n / middle而不是middle * middle <= n(Java、C++里会溢出) - 时间
O(log n);牛顿迭代收敛更快,可以作为加分项
整数平方根就是二分找最大的 x,让它的平方不超过 n。 搜索区间可以从 [1, n / 2] 开始,因为 n >= 4 时平方根一定不超过一半。每次 middle 的平方不超过 n,就先把它记成候选答案,再往右试更大的;超了就往左。比较时我会写 middle <= n / middle,JS 里数字是双精度,middle * middle 不太会溢出,但这个写法在 Java、C++ 里能避免整型溢出,面试官通常会问。
# 题目与解题思路
独立实现「整数平方根」。二分寻找最大的 x,使 x² 不超过给定非负整数。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function integerSqrt(value) { // 定义本题的核心实现
if (value < 2) return value // 检查当前分支条件
let left = 1 // 初始化当前步骤需要的状态
let right = Math.floor(value / 2) // 初始化当前步骤需要的状态
let answer = 1 // 初始化当前步骤需要的状态
while (left <= right) { // 遍历仍需处理的候选状态
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
if (middle <= value / middle) { // 检查当前分支条件
answer = middle // 执行当前语句
left = middle + 1 // 执行当前语句
} else right = middle - 1 // 执行当前语句
} // 结束当前代码块
return answer // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log n),空间 O(1)。
- 示例:sqrt(8) 向下取整返回 2,sqrt(9) 返回 3。
- 易错点:其他语言要防止 middle*middle 溢出,可比较 middle <= n/middle。
💬 面试官追问
在
JS里写middle * middle <= value会溢出吗?JS数字是64位浮点,不会像int那样回绕,但超过2^53就开始丢精度。题目范围一般是2^31 - 1以内,middle最多约46341,平方远没到2^53,这么写是安全的。为什么区间右端可以取
n / 2?n >= 4时(n/2)^2 = n^2/4 >= n,所以平方根不会超过n/2。n是2、3时Math.floor(n / 2) = 1,结果也是1,刚好对。0和1开头直接返回了。为什么不直接
Math.floor(Math.sqrt(n))?业务里我就这么写。面试考的是二分找边界;另外
Math.sqrt对非常大的数有浮点误差,比如2^53附近可能差1,严格场景要再校正一次。牛顿迭代怎么写?
x = n开始,反复x = Math.floor((x + Math.floor(n / x)) / 2),直到x * x <= n为止。收敛是二次的,比二分快,但要讲清停止条件,不然容易在两个值之间来回跳。
# 58 寻找旋转排序数组中的最小值
⚡ 30 秒速记
- 中点跟右端比:
numbers[middle] > numbers[right]说明最小值在右半边,left = middle + 1 - 否则
middle到right是升序的,最小值在middle或它左边,right = middle while (left < right),结束时left就是最小值的下标- 跟左端比不好用:没旋转的数组里中点大于左端,最小值却在最左边,判断不出来
- 有重复值时
numbers[middle] === numbers[right]只能right--,最坏退化成O(n)
旋转数组找最小值,我会拿中点和右端比,判断最小值在哪一半。 中点比右端大,说明断崖在中点右边,最小值一定在 middle + 1 之后;中点不比右端大,说明从中点到右端是连续升序的,最小值是 middle 自己或者在它左边,所以 right = middle,不能减一。为什么不和左端比?因为数组可能根本没旋转,中点大于左端时你分不清是「没旋转」还是「断崖在右边」。有重复元素时,中点等于右端就只能 right-- 一步步缩,最坏 O(n)。
# 题目与解题思路
独立实现「寻找旋转排序数组中的最小值」。比较中点与右端值,判断最小值落在包含中点的右半区还是左半区。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findRotatedMinimum(numbers) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
if (numbers[middle] > numbers[right]) left = middle + 1 // 检查当前分支条件
else right = middle // 处理另一种分支
} // 结束当前代码块
return numbers[left] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log n),空间 O(1)。
- 示例:[4,5,6,7,0,1,2] 返回 0。
- 易错点:该版本假设元素互不相同;允许重复时 middle 与 right 相等只能缩小 right。
💬 面试官追问
为什么是和
right比,不和left比?[1,2,3,4,5]没旋转,中点3比左端1大,最小值在左边;[3,4,5,1,2]中点5也比左端大,最小值却在右边。同一个比较结果对应两种情况,没法决定往哪走。和右端比就没有这个歧义。right = middle为什么不能写成middle - 1?numbers[middle] <= numbers[right]时middle可能就是最小值,比如[4,5,1,2,3]里middle = 2正好是1,减一就把答案扔了。数组有重复元素,比如
[2,2,2,0,2],代码会怎样?中点
2等于右端2,按现在的代码会right = middle,直接把右边那个0漏掉了。要改成相等时right--,这一步不会丢最小值,但全是重复值时最坏要O(n)。要找旋转数组里的某个
target呢?每次二分时,
left到middle和middle到right至少有一半是有序的。先判断哪半有序,再看target在不在这一半的范围里,在就往那边缩,不在就去另一半。
# 59 跳跃游戏
⚡ 30 秒速记
- 贪心:从左往右维护能到达的最远下标
farthest - 走到某个下标
index > farthest,说明断了,返回false farthest >= n - 1就能提前返回true- 时间
O(n),空间O(1);DP或DFS枚举跳法都是多余的 - 卡死的关键是值为
0的格子,[3,2,1,0,4]前面所有路都止步于下标3
这题不用枚举怎么跳,只要维护一个「目前最远能到哪」,从左往右扫一遍。 每到一个能到达的位置,就用 index + numbers[index] 更新最远距离;如果某个下标已经超过了最远距离,说明这里根本到不了,后面也就到不了,直接返回 false。能这么贪心是因为可达的位置是连续的一段:能到 5 就一定能到 0~5 里任意一格。比如 [3,2,1,0,4],前四个格子最远都只能到下标 3,那里是 0,走不出去。
# 题目与解题思路
独立实现「跳跃游戏」。从左到右维护当前能到达的最远位置,若索引超过最远位置就说明断裂。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function canJump(numbers) { // 定义本题的核心实现
let farthest = 0 // 初始化当前步骤需要的状态
for (let index = 0; index < numbers.length; index += 1) { // 遍历仍需处理的候选状态
if (index > farthest) return false // 检查当前分支条件
farthest = Math.max(farthest, index + numbers[index]) // 执行当前语句
if (farthest >= numbers.length - 1) return true // 检查当前分支条件
} // 结束当前代码块
return numbers.length <= 1 // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,3,1,1,4] 返回 true,[3,2,1,0,4] 返回 false。
- 易错点:不要真的枚举所有跳法;一旦 farthest 覆盖末尾即可提前成功。
💬 面试官追问
为什么不用回溯把所有跳法试一遍?
跳法是指数级的,
n稍大就超时。而且这题只问能不能到,不问怎么到,只要知道可达范围的边界就够了,这个范围一定是从0开始的连续区间。为什么能保证「能到最远」就能到中间每一格?
从起点往右,每一格都能跳
0到numbers[i]步之间的任意步数,所以到达farthest的路上经过的格子都能停下。可达集合永远是[0, farthest]这一整段。数组只有一个元素
[0],应该返回什么?true,起点就是终点。代码里第一轮farthest = 0 >= n - 1 = 0就返回了,不需要特判。用
DP写,dp[i]表示能不能到i,有什么问题?能写对,但每个
dp[i]要回看前面所有j,是O(n²)。贪心把「前面所有j能到多远」压成了一个变量farthest,所以是O(n)。
# 60 跳跃游戏 II
⚡ 30 秒速记
- 按「层」理解:当前跳数能覆盖
[start, boundary],扫这一层时算出下一层最远能到farthest - 扫到
boundary时说明这一层走完了,steps++,boundary = farthest - 循环只到
n - 2:走到最后一格不用再跳,多扫一格会多算一次 - 时间
O(n),空间O(1),相当于不建队列的BFS - 题目不保证可达时,要检查
farthest <= index卡住的情况,返回-1
最少跳跃次数可以当成 BFS 按层走:第一跳能覆盖的格子是一层,从这一层任意格子再跳一次能到的是下一层。 扫的时候一边用 index + numbers[index] 更新下一层最远能到哪,一边看是不是已经走到当前层的右边界 boundary,走到了就说明必须再跳一次,steps++,边界扩到 farthest。循环只到倒数第二格,因为最后一格是终点,到了就不用再跳了。比如 [2,3,1,1,4]:第一层到下标 2,下一层最远到 4,两跳。
# 题目与解题思路
独立实现「跳跃游戏 II」。按层扫描当前一步能覆盖的区间,到达区间末尾时增加跳数并扩展下一层边界。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minimumJumps(numbers) { // 定义本题的核心实现
let steps = 0 // 初始化当前步骤需要的状态
let boundary = 0 // 初始化当前步骤需要的状态
let farthest = 0 // 初始化当前步骤需要的状态
for (let index = 0; index < numbers.length - 1; index += 1) { // 遍历仍需处理的候选状态
farthest = Math.max(farthest, index + numbers[index]) // 执行当前语句
if (index !== boundary) continue // 检查当前分支条件
steps += 1 // 执行当前语句
boundary = farthest // 执行当前语句
} // 结束当前代码块
return steps // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,3,1,1,4] 最少跳 2 次。
- 易错点:循环只到倒数第二项;题目若不保证可达,需要检测边界无法继续扩张。
💬 面试官追问
循环为什么是
index < numbers.length - 1?如果扫到最后一格,而它恰好是当前层的边界,就会多加一次
steps。比如[0]只有一个元素应该返回0,扫到下标0会变成1。为什么每次都跳到最远不一定对,这个算法又为什么对?
每次直接跳
numbers[i]步可能错过更好的落脚点,比如[2,3,1,1,4]从下标0跳到2就要三跳。这个算法不是贪心选落脚点,是统计「第k跳能覆盖哪些格子」,所以等价于BFS的最短路。如果有的数组根本到不了终点,怎么改?
在
index === boundary时再判断一下:如果farthest <= index,说明下一层没法再往前扩了,返回-1。力扣上这题保证一定可达,所以标准写法里没有这句。DP写法dp[i] = min(dp[j] + 1)行不行?行,但每个
i要回看所有能跳到它的j,O(n²),n到10^4就开始吃力。贪心按层扫是O(n)。
# 61 无重叠区间
⚡ 30 秒速记
- 反过来想:最少删几个 = 总数 - 最多能保留几个互不重叠的区间
- 按右端点升序排,每次挑结束最早的,给后面留的空间最多
- 和上一个保留区间的
end比:start >= end就保留,否则删掉 - 端点相等不算重叠,
[1,2]和[2,3]能同时留 - 时间
O(n log n),主要花在排序;按左端点排也能做,但重叠时要保留右端点更小的那个
这题我会换个角度:最少删几个,等于总数减去最多能留下几个互不重叠的区间。 要留得多,就每次挑结束最早的那个,因为它占的时间最短,给后面的区间留下的空间最大。所以先按右端点排序,然后扫一遍,跟上一个保留区间的结束位置比,开始位置不早于它就留下,否则删掉。这题端点相等不算重叠,[1,2] 和 [2,3] 可以共存,条件写 interval[0] < end 才跳过。
# 题目与解题思路
独立实现「无重叠区间」。按结束位置升序排列,尽量保留结束最早的区间,其余重叠区间删除。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function eraseOverlapIntervals(intervals) { // 定义本题的核心实现
intervals.sort((left, right) => left[1] - right[1]) // 执行当前语句
let kept = 0 // 初始化当前步骤需要的状态
let end = -Infinity // 初始化当前步骤需要的状态
for (const interval of intervals) { // 遍历仍需处理的候选状态
if (interval[0] < end) continue // 检查当前分支条件
kept += 1 // 执行当前语句
end = interval[1] // 执行当前语句
} // 结束当前代码块
return intervals.length - kept // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n),排序外空间视实现而定。
- 示例:[[1,2],[2,3],[3,4],[1,3]] 最少删除 1 个。
- 易错点:判断重叠时相邻端点通常允许相等;空数组要返回 0。
💬 面试官追问
为什么按右端点排,按左端点排不行吗?
按左端点排直接贪心会出错:
[[1,10],[2,3],[4,5]],按左端点会先留[1,10],后面两个都被删掉;正确答案是删[1,10]留两个。按左端点也能做,但遇到重叠时要保留右端点更小的那个,本质还是在比结束时间。怎么说明「选结束最早的」一定最优?
交换论证:假设最优解第一个选的不是结束最早的区间
A,把它换成A,A结束得更早,不会和后面的冲突,数量不变。一路换下去就得到贪心的解。如果题目说端点相等也算重叠呢?
把条件改成
interval[0] <= end就跳过。这个细节我会先问清楚,和下一题射气球正好相反。这题和会议室安排有什么关系?
一模一样,就是「一个会议室最多能开几场会」。如果问的是「最少需要几间会议室」,那是另一类题,要按开始时间排序加小顶堆,或者把起止点拆开扫描。
# 62 用最少箭引爆气球
⚡ 30 秒速记
- 每支箭尽量多射:按右端点排序,箭射在当前气球的右端点
- 下一个气球的左端点
<= end就被这支箭顺带射爆,否则新开一支箭,end更新为它的右端点 - 端点相等也能射中,新开箭的条件是
start > end(和无重叠区间相反) - 时间
O(n log n);空数组返回0 - 排序别写
a[1] - b[1]:坐标范围到±2^31,Java相减会溢出,JS里没问题
射气球和无重叠区间是同一个模型,按右端点排序,箭就射在第一个气球的最右边,这样能顺带射中尽量多的气球。 往后扫,如果下一个气球的左端点没超过这个位置,它就已经被射爆了;超过了就得再来一支箭,射在新气球的右端点。这题和上一题最大的区别是边界:气球端点相碰也能一箭射穿,所以新箭的条件是 start > end。其实答案就是「最多有多少个两两不重叠的区间」,端点相碰算重叠。
# 题目与解题思路
独立实现「用最少箭引爆气球」。按右端点排序,在当前箭覆盖不到新区间时,于新区间右端点再射一箭。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findMinArrowShots(points) { // 定义本题的核心实现
if (!points.length) return 0 // 检查当前分支条件
points.sort((left, right) => left[1] - right[1]) // 执行当前语句
let arrows = 1 // 初始化当前步骤需要的状态
let end = points[0][1] // 初始化当前步骤需要的状态
for (let index = 1; index < points.length; index += 1) { // 遍历仍需处理的候选状态
if (points[index][0] <= end) continue // 检查当前分支条件
arrows += 1 // 执行当前语句
end = points[index][1] // 执行当前语句
} // 结束当前代码块
return arrows // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n),空间 O(1)(忽略排序)。
- 示例:[[10,16],[2,8],[1,6],[7,12]] 返回 2。
- 易错点:边界相等仍可由同一支箭命中,所以新箭条件是 start > end。
💬 面试官追问
箭为什么要射在右端点,射在中间不行吗?
射在右端点能尽量覆盖后面开始得晚的气球。比如
[1,6]和[5,8],射在6两个都中;射在3只中第一个,后面还得多一支。[[1,2],[2,3]]需要几支箭?1支,射在x = 2两个都中。所以判断条件是points[index][0] <= end时跳过,写成<会多算一支。这题和无重叠区间的代码差在哪?
核心一样,按右端点排序、扫一遍。差别只在端点相等:无重叠区间里相碰不算重叠,射气球里相碰算能一起射。射气球的答案就是那题里「最多能保留几个」,只是比较符号变了。
排序比较函数写
(a, b) => a[1] - b[1]有坑吗?JS里没有,数字是双精度,相减不会溢出。但Java里int相减遇到-2^31和2^31 - 1会溢出变号,要用Integer.compare。面试用其他语言写时要注意。
# 63 分发饼干
⚡ 30 秒速记
- 两边都升序排序,用最小的够用的饼干去满足当前胃口最小的孩子
- 饼干不够当前孩子就跳过这块饼干,够就满足一个,
child++ - 时间
O(n log n + m log m),主要在排序 sort一定要传(a, b) => a - b,默认按字符串排[10, 9]不会动- 别拿大饼干先喂小胃口,可能把唯一能喂饱大胃口的那块浪费了
这题的贪心是「小饼干先给小胃口」:两边都排好序,每块饼干从小到大试,能满足当前胃口最小的孩子就给他。 饼干不够就丢掉,因为它连胃口最小的都满足不了,给谁都没用。为什么不能随便分?比如胃口 [1,3]、饼干 [3,1],如果把 3 给了胃口 1 的孩子,剩下的 1 满足不了胃口 3,只能满足一个;按顺序配就是 1 配 1、3 配 3,两个都满足。
# 题目与解题思路
独立实现「分发饼干」。把孩子胃口和饼干尺寸都排序,用当前最小可满足饼干匹配当前孩子。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findContentChildren(greed, cookies) { // 定义本题的核心实现
greed.sort((left, right) => left - right) // 执行当前语句
cookies.sort((left, right) => left - right) // 执行当前语句
let child = 0 // 初始化当前步骤需要的状态
for (const cookie of cookies) { // 遍历仍需处理的候选状态
if (cookie < greed[child]) continue // 检查当前分支条件
child += 1 // 执行当前语句
if (child === greed.length) break // 检查当前分支条件
} // 结束当前代码块
return child // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n + m log m),空间取决于排序。
- 示例:胃口 [1,2,3]、饼干 [1,1] 最多满足 1 个孩子。
- 易错点:不要拿大饼干先满足小胃口,否则可能浪费唯一能满足大胃口的资源。
💬 面试官追问
为什么饼干满足不了当前孩子就可以直接丢掉?
当前孩子是剩下的里面胃口最小的,这块饼干连他都满足不了,也满足不了后面任何一个孩子,留着没用。
换个思路,大饼干先给大胃口行不行?
行,倒序遍历孩子,用当前最大的饼干去试胃口最大的孩子,满足就配对,不满足就跳过这个孩子。两种都对,只是一个从小往大、一个从大往小。
greed.sort()不传比较函数会怎样?默认按字符串比较,
[10, 9, 2]排出来是[10, 2, 9],后面的贪心就全乱了。数字排序一定要写(a, b) => a - b。函数里直接
sort了传进来的数组,有什么问题?会改掉调用方的数据,调用方可能还要用原顺序。面试里一般可以接受,业务代码里我会先拷一份,或者用
toSorted(ES2023,较新的浏览器和Node 20才支持)。
# 64 任务调度器
⚡ 30 秒速记
- 别模拟,直接算:答案 =
max(任务总数, (最高频次 - 1) × (n + 1) + 并列最高频的种类数) - 框架思路:最高频任务排成若干列,每列宽
n + 1,前max - 1列填满,最后一列只放并列最高频的那几种 - 空位被其他任务填满时没有空闲,答案就是
tasks.length AAABBB、n = 2→(3 - 1) × 3 + 2 = 8;n = 0时公式结果不会超过总数,直接返回总数- 时间
O(n),空间O(1),任务种类最多26种
这题不用真的去排队,按出现次数最多的任务搭一个框架,算一下框架长度就行。 比如 A 出现 3 次、冷却 2,那就是 A _ _ A _ _ A,前两段每段宽 3,最后再加上和 A 一样多的任务种类数。其他任务往空位里塞,塞不满就有空闲,塞满了还多出来,就说明根本不用等,答案就是任务总数。所以两者取大。面试我会先画这个格子再写公式,比直接背公式好讲得多。
# 题目与解题思路
独立实现「任务调度器」。用最高频任务构造间隔框架,再与任务总数比较取较大值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function leastInterval(tasks, cooldown) { // 定义本题的核心实现
const counts = new Map() // 初始化当前步骤需要的状态
for (const task of tasks) counts.set(task, (counts.get(task) ?? 0) + 1) // 遍历仍需处理的候选状态
const maximum = Math.max(0, ...counts.values()) // 初始化当前步骤需要的状态
let maximumKinds = 0 // 初始化当前步骤需要的状态
for (const count of counts.values()) { // 遍历仍需处理的候选状态
if (count === maximum) maximumKinds += 1 // 检查当前分支条件
} // 结束当前代码块
const frame = (maximum - 1) * (cooldown + 1) + maximumKinds // 初始化当前步骤需要的状态
return Math.max(tasks.length, frame) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)(字符种类固定)。
- 示例:AAABBB、冷却时间 2,最短执行长度为 8。
- 易错点:多个任务并列最高频时都要计入最后一列;任务足够多时答案就是总任务数。
💬 面试官追问
为什么任务足够多的时候答案就等于任务总数?
框架的空位都填满了,多出来的任务可以接在每一列后面,列变宽了只会让同一种任务离得更远,不会违反冷却,全程没有空闲。比如
AAABBBCCDD、n = 2,公式算出8,比总数10小,答案取10。最后一列为什么要加「并列最高频的种类数」,而不是加 1?
AAABBB里A和B都是3次,排出来是A B _ A B _ A B,最后一列A、B各剩一个,都得排上。只加1会少算,得到7。面试官要你把具体执行顺序也输出出来呢?
公式只给长度,要序列就得模拟:大顶堆按剩余次数取任务,用过的放进冷却队列,记上「第几刻能再用」,时间到了再放回堆。每轮取一次堆,
26种任务的话复杂度基本是O(总时长)。Math.max(0, ...counts.values())这里有什么隐患吗?这题种类最多
26,没问题。但展开运算符把每个值当参数传,换成几十万个值的数组可能直接爆调用栈(RangeError),通用代码里我会改成循环求最大值。
# 65 逆波兰表达式求值
⚡ 30 秒速记
- 数字压栈,遇到运算符弹两个算完再压回去,最后栈里只剩一个数就是结果
- 先弹出来的是右操作数:
["4", "2", "-"]是4 - 2,顺序反了减法除法全错 - 除法向零截断用
Math.trunc:Math.trunc(-7 / 2) = -3,Math.floor会得到-4 - 判断运算符用
Set查表,别用token[0] === '-',负数"-3"会被误判 - 时间
O(n),空间O(n)
逆波兰表达式就是把运算符写在两个数后面,好处是不用括号,一个栈从左扫到右就能算完。 遇到数字压栈,遇到运算符弹两个出来算,结果再压回去。这里最容易错的是弹出顺序:栈是后进先出,先弹出来的是右边那个数,所以要写 left - right、left / right。还有除法,题目要求向零截断,负数场景下 Math.floor 和 Math.trunc 结果不一样,得用 trunc。
# 题目与解题思路
独立实现「逆波兰表达式求值」。遇到数字压栈,遇到运算符弹出右操作数和左操作数,计算后把结果压回。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function evaluateRpn(tokens) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
const operators = new Set(['+', '-', '*', '/']) // 初始化当前步骤需要的状态
for (const token of tokens) { // 遍历仍需处理的候选状态
if (!operators.has(token)) { // 检查当前分支条件
stack.push(Number(token)) // 执行当前语句
continue // 结束或跳过当前循环步骤
} // 结束当前代码块
const right = stack.pop() // 初始化当前步骤需要的状态
const left = stack.pop() // 初始化当前步骤需要的状态
if (token === '+') stack.push(left + right) // 检查当前分支条件
if (token === '-') stack.push(left - right) // 检查当前分支条件
if (token === '*') stack.push(left * right) // 检查当前分支条件
if (token === '/') stack.push(Math.trunc(left / right)) // 检查当前分支条件
} // 结束当前代码块
return stack.pop() // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:[2,1,+,3,*] 返回 9。
- 易错点:减法和除法必须保持弹栈顺序;整数除法要向零截断。
💬 面试官追问
["4", "13", "5", "/", "+"]一步步怎么算?4、13、5依次进栈,遇到/弹出5(右)和13(左),Math.trunc(13 / 5) = 2压回;遇到+弹出2和4,得6。最后栈里只剩6。如果把
Math.trunc换成Math.floor,哪种输入会算错?结果是负数且除不尽的时候。
-7 / 2应该得-3,floor会给-4;正数两者一样,所以只测正数用例发现不了。输入是
["1", "+"]这种不合法的表达式,代码会怎样?right弹出1,left是undefined,undefined + 1得NaN,静默返回一个错的结果。生产代码要在弹栈前检查stack.length < 2就抛错,结束时也要确认栈里刚好剩一个数。平时写的是
(1 + 2) * 3这种中缀表达式,怎么转成后缀?用调度场算法:数字直接输出,运算符按优先级进出一个运算符栈,左括号入栈、右括号一直弹到左括号。
(1 + 2) * 3转完就是1 2 + 3 *,再丢给这题的函数算。除数是
0的时候JS会报错吗?不会,
1 / 0是Infinity,0 / 0是NaN,错误会一路传下去。真要拿去算用户输入,除法分支里要自己判right === 0抛错。
# 66 删除字符串中的相邻重复项
⚡ 30 秒速记
- 结果数组当栈:当前字符等于栈顶就弹出(消掉一对),否则压入
- 消完一对之后,栈顶和下一个字符可能又成对,栈天然能处理这种连锁消除
"abbaca"→ 消bb后aa相邻再消 →"ca"- 正则
/(.)\1/g替换一次不够,要循环到不变,最坏O(n²) - 时间
O(n),空间O(n);用for...of遍历,代理对字符(emoji)不会被拆开
这题用栈最顺:每来一个字符就和栈顶比,一样就一起消掉,不一样就压进去。 它的难点在于消除会连锁,abba 消掉 bb 之后两个 a 又挨在一起了。如果用正则或者 replace 做,得一遍遍替换到字符串不再变化,最坏是平方级。栈的好处是消完之后栈顶自动变成前一个字符,下一个字符直接跟它比,一次扫描就把连锁都处理了。
# 题目与解题思路
独立实现「删除字符串中的相邻重复项」。把结果数组当栈,当前字符与栈顶相同就弹出,否则压入。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeAdjacentDuplicates(text) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
for (const character of text) { // 遍历仍需处理的候选状态
if (stack.at(-1) === character) stack.pop() // 检查当前分支条件
else stack.push(character) // 处理另一种分支
} // 结束当前代码块
return stack.join('') // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:abbaca 最终得到 ca。
- 易错点:删除后可能产生新的相邻重复,因此不能只做一次正则替换。
💬 面试官追问
用
s.replace(/(.)\1/g, '')一行搞定,行不行?"abbaca"替换一次得到"aaca",aa是消除后才相邻的,一次替换看不到。要写成while循环替换到不变,"aaaa...b"这种输入会退化成O(n²)。为什么一次扫描就能处理连锁消除?
栈里存的永远是「到目前为止消不掉的字符」,消掉栈顶之后,新栈顶就是消除后的前一个邻居。下一个字符直接和它比,正好模拟了「消除后两边合拢」。
题目改成「
k个相同字符相邻才消除」呢?栈里存
[字符, 连续次数],同字符就把次数加一,到k就整个弹出。比如"deeedbbcccbdaa"、k = 3得到"aa",复杂度还是O(n)。把
for...of换成for (let i = 0; i < s.length; i++)有区别吗?纯英文没区别。遇到
emoji这类代理对字符,下标遍历会拆成两个半个字符,可能把两个不同emoji的同一半误消掉。for...of按码点遍历,不会拆。
# 67 用队列实现栈
⚡ 30 秒速记
- 只能用队列的操作:尾部入、头部出、看队头、取长度
- 单队列做法:新元素入队后,把它前面的
size - 1个元素依次出队再入队,新元素就转到队头 push是O(n),pop/top是O(1);也可以反过来让pop承担O(n)JS的Array.prototype.shift一般是O(n),题目里不讲究,工程里用头指针或环形缓冲区实现队列- 空栈
pop返回什么要先约定,这里会返回undefined
核心是每次 push 完把队列「转一圈」,让最新的元素到队头,这样队头就是栈顶。 比如队列里是 [1, 2],再 push(3) 变成 [1, 2, 3],然后把 1、2 依次从头取出塞回尾部,就成了 [3, 1, 2],pop 直接取队头就是 3。代价全压在 push 上,是 O(n)。另外要说一句,JS 数组的 shift 本身就会挪元素,这份代码真实复杂度更高,面试里讲清楚就行。
# 题目与解题思路
独立实现「用队列实现栈」。每次压入新元素后,把旧元素依次出队再入队,使新元素始终位于队头。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class StackWithQueue { // 定义本题的核心实现
queue = [] // 执行当前语句
push(value) { // 进入当前逻辑分支
this.queue.push(value) // 执行当前语句
for (let count = this.queue.length - 1; count > 0; count -= 1) this.queue.push(this.queue.shift()) // 遍历仍需处理的候选状态
} // 结束当前代码块
pop() { // 进入当前逻辑分支
return this.queue.shift() // 返回本题要求的结果
} // 结束当前代码块
top() { // 进入当前逻辑分支
return this.queue[0] // 返回本题要求的结果
} // 结束当前代码块
empty() { // 进入当前逻辑分支
return this.queue.length === 0 // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- push O(n),pop/top O(1),空间 O(n)。
- 示例:push(1)、push(2) 后 top() 和 pop() 都得到 2。
- 易错点:JavaScript 数组 shift 是 O(n),工程实现宜使用带头索引的真正队列。
💬 面试官追问
为什么转圈要转
size - 1次,而不是size次?转
size次等于新元素也被转到了队尾,转完队列和没转一样。只把它前面的旧元素搬过去,新元素才留在队头。两个队列和一个队列的写法,你选哪个?
一个队列就够了。两个队列是把旧元素倒进辅助队列再换名字,操作次数一样,只是多一个变量,没有实际收益。
反过来用栈实现队列,复杂度还是
O(n)吗?不用。两个栈,一个只进、一个只出,出栈为空时才把进栈整体倒过去。每个元素最多被倒一次,均摊下来每个操作
O(1),这点比队列实现栈好。真要在
JS里写个高性能队列,怎么避开shift?用数组加
head指针,出队只是head++,等head超过一半长度再slice一次回收空间。或者直接用固定容量的环形缓冲区,入队出队都是真O(1)。
# 68 简化 Unix 路径
⚡ 30 秒速记
- 按
/切开,栈里放有效目录:空串和.跳过,..弹一层,其他压栈 - 最后
'/' + stack.join('/'),根目录天然是/,尾斜杠和连续斜杠自然消失 - 根目录再
..还是根:空栈pop()返回undefined,JS里不报错正好省了判断 - 坑:
...、..a是合法目录名,只有恰好等于./..才特殊处理 - 时间
O(n),空间O(n)
这题就是用栈模拟 cd:普通目录名进栈,.. 退一层,. 和空串什么都不做。 切完之后连续斜杠会产生空字符串,直接跳过;/a/./b/../../c/ 走一遍是进 a、进 b、退 b、退 a、进 c,结果 /c。根目录上面再 .. 也只能停在根,JS 的空数组 pop() 不报错,正好不用特判,换成别的语言要自己判空。
# 题目与解题思路
独立实现「简化 Unix 路径」。按斜杠切分路径,用栈保存有效目录;点号忽略,双点号弹出一层。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function simplifyPath(pathname) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
for (const segment of pathname.split('/')) { // 遍历仍需处理的候选状态
if (!segment || segment === '.') continue // 检查当前分支条件
if (segment === '..') stack.pop() // 检查当前分支条件
else stack.push(segment) // 处理另一种分支
} // 结束当前代码块
return '/' + stack.join('/') // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:/a/./b/../../c/ 简化为 /c。
- 易错点:根目录以上的 .. 只能忽略;连续斜杠和尾斜杠不产生目录。
💬 面试官追问
/home/.../foo简化完是什么?/home/.../foo原样不变。...是一个普通目录名,很多人写成segment.startsWith('.')就跳过了,这是错的,只有完全等于.或..才特殊。/../和/结果一样吗?一样,都是
/。根目录没有上一层,..在空栈上pop什么也不做,最后拼出来只有一个/。Node里直接用path.posix.normalize可以吗?行为不完全一样:
normalize('/a/b/')会保留尾斜杠得到/a/b/,题目要/a/b;相对路径它会保留开头的..。真实业务用它没问题,刷题得按题意自己写。服务端拿用户传的文件名拼路径,简化完就安全了吗?
不够。
../../etc/passwd这种要先path.resolve(root, input),再检查结果是不是还以root + path.sep开头,不是就拒绝。只做字符串简化挡不住路径穿越。
# 69 颠倒字符串中的单词
⚡ 30 秒速记
trim()去掉首尾空格 →split(/\s+/)按任意连续空白切 → 反转单词顺序 →join(' ')- 反转的是单词顺序,不是每个单词内部的字母:
"the sky"→"sky the" - 正则别漏反斜杠:
/s+/是按字母s切,空白要写/\s+/ - 不能用
split(' '),连续空格会切出一堆空字符串 JS字符串不可变,「O(1)额外空间原地做」只在可变字符数组的语言里成立
这题一行就能写:s.trim().split(/\s+/).reverse().join(' '),难点全在空格处理上。 首尾空格靠 trim,中间多个空格靠正则 \s+ 当成一个分隔符。正则里的反斜杠千万别漏,写成 /s+/ 会按字母 s 切,"sass is" 会被切得乱七八糟。如果面试官追问不用额外空间,思路是先整体反转再逐个单词反转,但 JS 字符串改不了,只能转成数组做,空间还是 O(n)。
# 题目与解题思路
独立实现「颠倒字符串中的单词」。先按空白切出有效单词,再反转单词序列并用单个空格连接。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function reverseWords(text) { // 定义本题的核心实现
const words = text.trim().split(/\s+/) // \s+ 按任意连续空白切分
let left = 0 // 初始化当前步骤需要的状态
let right = words.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
;[words[left], words[right]] = [words[right], words[left]] // 执行当前语句
left += 1 // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
return words.join(' ') // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例: hello world 得到 world hello。
- 易错点:要压缩首尾及连续空格;不是反转每个单词内部字符。
正则里的反斜杠不能漏:/s+/ 匹配的是字母 s,不是空白。拿 "sass is" 试一下就能看出区别:
'sass is'.trim().split(/s+/) // ['', 'a', ' i', ''],按字母 s 切开了
'sass is'.trim().split(/\s+/) // ['sass', 'is'],这才对
不手写双指针的话,直接调 reverse() 更短:
function reverseWords(text) {
const words = text.trim().split(/\s+/) // \s 匹配空格、制表符、换行
return words.reverse().join(' ')
}
reverseWords(' hello world ') // 'world hello'
reverseWords('a good example') // 'example good a'
trim 负责首尾空格,\s+ 把中间任意多个空白当成一个分隔符,所以结果里单词之间只会有一个空格。手写双指针交换和直接调 reverse() 效果一样,面试里用哪个都行,关键是正则要写对。
💬 面试官追问
" hello world ".split(' ')会得到什么?["", "", "hello", "", "", "world", "", ""],连续空格之间全是空串,直接反转拼接会留下一堆多余空格。要么先trim再split(/\s+/),要么split(' ').filter(Boolean)。输入全是空格
" "呢?trim()之后是空串,"".split(/\s+/)得到[""],join回去还是"",结果正确。但如果你没trim直接切,会得到["", ""],拼出一个空格。不让用
split和reverse,怎么写?从右往左扫:跳过空格找到一个单词的右端,再往左找到左端,
slice出来放进结果数组,最后join(' ')。还是一次遍历O(n)。C++里能做到O(1)额外空间,思路是什么?先把整个字符数组反转,
"the sky"变成"yks eht",再把每个单词各自反转回来得到"sky eht"→"sky the",顺便用快慢指针压掉多余空格。JS里字符串不可变,这招要先转数组,意义不大。
# 70 下一个更大元素 I
⚡ 30 秒速记
- 单调栈:栈里从底到顶递减,新元素比栈顶大,就是栈顶元素的「下一个更大」
- 逆序扫:先把
<=当前值的都弹掉,剩下的栈顶就是答案,再把自己压进去 - 先对
nums2全算一遍存进Map,nums1只是查表,总共O(m + n) - 弹出用
<=而不是<,题目要的是严格更大 - 前提是元素互不相同;有重复值就得按下标存答案,不能按值当
Map的键
「下一个更大元素」这类题基本都是单调栈,每个元素最多进栈一次、出栈一次,所以是线性的。 逆序扫的时候,栈里存的是右边可能成为答案的候选,比当前值小的永远不会再是左边任何人的答案了,直接弹掉。弹完栈顶就是右边第一个更大的数,栈空就是 -1。nums1 是 nums2 的子集,所以先把 nums2 每个值的答案算好放进 Map,再查一遍就行。
# 题目与解题思路
独立实现「下一个更大元素 I」。逆序扫描基准数组,用单调递减栈找到每个值右侧第一个更大元素,再用 Map 查询。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function nextGreaterElement(query, base) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
const next = new Map() // 初始化当前步骤需要的状态
for (let index = base.length - 1; index >= 0; index -= 1) { // 遍历仍需处理的候选状态
while (stack.length && stack.at(-1) <= base[index]) stack.pop() // 遍历仍需处理的候选状态
next.set(base[index], stack.at(-1) ?? -1) // 执行当前语句
stack.push(base[index]) // 执行当前语句
} // 结束当前代码块
return query.map(value => next.get(value)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(m+n),空间 O(n)。
- 示例:nums1=[4,1,2]、nums2=[1,3,4,2] 得到 [-1,3,-1]。
- 易错点:该题版本假设元素唯一;有重复值时 Map 必须改为按下标记录。
💬 面试官追问
为什么比当前值小的候选可以直接扔掉?
当前值在它们左边且更大,往左看的时候会先看到当前值。它们既不比当前值大,又更远,以后不可能再是任何人的「右边第一个更大」。
双重循环暴力也能过,为什么非要单调栈?
暴力是
O(m × n),nums2有10⁴个元素就是上亿次比较。单调栈每个元素进出各一次,O(m + n),面试官问这题就是在考这个。能不能正序扫?
能。正序时栈里存「还没找到答案的数」,新来的数比栈顶大,就把栈顶弹出并记
next.set(栈顶, 当前值),一直弹到不比它小为止。最后留在栈里的都是-1。nums2里有重复值,这份代码会出什么问题?Map以值为键,后算的会覆盖先算的。比如[2, 3, 2, 1],逆序扫时先给下标2的2记-1,再给下标0的2记3,覆盖之后两个2查出来都是3。有重复值就让栈存下标,答案写进同长度的数组。
# 71 下一个更大元素 II
⚡ 30 秒速记
- 循环数组 = 把数组接一遍在后面,长度
2n,用下标i % n取值,不真复制 - 逆序从
2n - 1扫到0,第一圈只负责往栈里填「右边的候选」,第二圈(cursor < n)才写答案 - 单调栈规则不变:弹掉
<=当前值的,栈顶就是答案 - 最大值转一圈也找不到更大的,保持
-1;全相等[5, 5, 5]全是-1 - 时间
O(n),空间O(n)
循环数组的套路就是假装数组后面又接了一份,下标取模,这样每个元素往右看一圈的范围就都覆盖到了。 用 2n 的长度逆序扫,先扫的那一圈相当于把「绕回来之后的元素」提前压进栈,等扫到真正的前 n 个位置时,栈里已经有完整一圈的候选了,再写答案。比如 [1, 2, 1],最后那个 1 绕回去能看到开头的 2,所以是 2;2 是最大值,答案 -1。
# 题目与解题思路
独立实现「下一个更大元素 II」。把循环数组视为长度 2n 的序列逆序扫描,只在前 n 个位置写答案。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function nextGreaterCircular(numbers) { // 定义本题的核心实现
const result = new Array(numbers.length).fill(-1) // 初始化当前步骤需要的状态
const stack = [] // 初始化当前步骤需要的状态
for (let cursor = numbers.length * 2 - 1; cursor >= 0; cursor -= 1) { // 遍历仍需处理的候选状态
const index = cursor % numbers.length // 初始化当前步骤需要的状态
while (stack.length && stack.at(-1) <= numbers[index]) stack.pop() // 遍历仍需处理的候选状态
if (cursor < numbers.length) result[index] = stack.at(-1) ?? -1 // 检查当前分支条件
stack.push(numbers[index]) // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:[1,2,1] 得到 [2,-1,2]。
- 易错点:栈保存候选值或下标都可以,但不能真的复制大数组造成不必要内存。
💬 面试官追问
为什么扫
2n就够了,不用3n?每个元素往右最多看
n - 1个就转完一圈了,2n已经保证每个位置后面都跟着一整圈。再多扫只是重复已经弹掉或压过的候选。只在
cursor < n时写答案,去掉这个判断会错吗?不会错,只是多写一轮。逆序扫时
cursor < n那轮是最后处理的,会把第一轮的结果覆盖掉,留下的正好是对的。加判断是让意图更清楚。题目改成「要等几天才遇到更高温度」,循环版怎么改?
栈里存下标,答案写
(栈顶下标 - 当前下标 + n) % n。比如[3, 1, 2],2绕回去遇到3,距离是(0 - 2 + 3) % 3 = 1。[5, 4, 3, 2, 1]跑出来是什么?[-1, 5, 5, 5, 5]。除了5自己,其他数绕回去都能遇到开头的5。这组用例专门用来测有没有正确处理「绕回来」。
# 72 四数之和
⚡ 30 秒速记
- 排序 → 两层循环固定前两个数 → 剩下区间左右指针夹逼,和三数之和同一个套路
- 去重分三处:第一个数、第二个数各自跳过同层重复,指针只在找到一组答案之后才跳重复
- 常见错法:每轮都对
left做跳重复,会把「left和second值相同」的合法组合跳掉,[1,0,-1,0,-2,2]会少掉[-1,0,0,1] - 剪枝:最小的四个和都大于
target就break,当前最大和小于target就continue - 时间
O(n³);sort会改原数组,Java/C++里四数相加要防溢出
四数之和就是三数之和外面再套一层循环:排序后固定两个数,剩下两个用双指针找,整体 O(n³)。 真正难的是去重,原则是同一层循环里同一个值只用一次。前两层用 i > start && nums[i] === nums[i - 1] 跳过;双指针那层要在找到一组答案之后,再把左右指针跳过重复值。很多人在每一轮都跳 left 的重复,这样 left 刚好和第二个数相等时,合法组合会被跳过,连示例都会少一组。
# 题目与解题思路
独立实现「四数之和」。排序后固定前两个数,剩余区间用左右指针寻找目标和,并在各层跳过重复值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function fourSum(numbers, target) { // 定义本题的核心实现
numbers.sort((left, right) => left - right) // 执行当前语句
const result = [] // 初始化当前步骤需要的状态
for (let first = 0; first < numbers.length - 3; first += 1) { // 遍历仍需处理的候选状态
if (first && numbers[first] === numbers[first - 1]) continue // 检查当前分支条件
for (let second = first + 1; second < numbers.length - 2; second += 1) { // 遍历仍需处理的候选状态
if (second > first + 1 && numbers[second] === numbers[second - 1]) continue // 检查当前分支条件
let left = second + 1 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const sum = numbers[first] + numbers[second] + numbers[left] + numbers[right] // 初始化当前步骤需要的状态
if (sum < target) left += 1 // 和偏小,左指针右移
else if (sum > target) right -= 1 // 和偏大,右指针左移
else { // 找到一组答案
result.push([numbers[first], numbers[second], numbers[left], numbers[right]])
left += 1
right -= 1
// 只在找到答案之后跳过同值,刚用过的值不再用
while (left < right && numbers[left] === numbers[left - 1]) left += 1
while (left < right && numbers[right] === numbers[right + 1]) right -= 1
} // 结束当前代码块
} // 结束当前代码块
} // 结束当前代码块
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n³),排序外空间 O(1)。
- 示例:[1,0,-1,0,-2,2]、target=0 得到三组不重复四元组。
- 易错点:四个位置都必须不同;去重只在同一层跳过与前一个相同的选择。
双指针那层最容易写错的是跳重复的时机:如果每轮末尾都执行 while (numbers[left] === numbers[left - 1]) left++,那么某一轮只是 right 左移、left 没动时,left - 1 指向的可能是 second。second 和 left 值相同是完全合法的组合(比如两个 0),却会被当成重复跳过,fourSum([1, 0, -1, 0, -2, 2], 0) 会漏掉 [-1,0,0,1],fourSum([0, 1, 1, 5, 9], 7) 会返回空数组。所以三种情况要分开写,只在找到答案之后才跳重复,上面两组用例分别得到 [[-2,-1,1,2],[-2,0,0,2],[-1,0,0,1]] 和 [[0,1,1,5]]。这个写法和三数之和的标准写法一致,背一份就够了。
💬 面试官追问
每轮都跳
left重复的写法,跑[0, 1, 1, 5, 9]、target = 7会怎样?返回
[],正确结果是[[0, 1, 1, 5]]。第一轮和是11太大,right左移,但后面那句跳重复拿numbers[left]和numbers[left - 1]比,left - 1正好是second,两个都是1,left被跳过了。去重为什么只能在找到答案之后做?
跳重复的意思是「这个值刚刚已经作为答案用过了」。没找到答案时移动指针,前一个位置可能是
second甚至没参与比较,拿它判重就会误伤,和是不是重复值无关。target是负数,「四个最小值之和大于target就break」这个剪枝还成立吗?成立。数组已经排好序,
nums[i] + nums[i+1] + nums[i+2] + nums[i+3]是以i开头的最小和,它都比target大,后面只会更大,和正负无关。容易错的是写成nums[i] > target就break,负数时会剪掉[-4, -1, 0, 0]找-5这种答案。要是扩展成
k数之和呢?写成递归:
kSum(start, k, target),k === 2时走双指针,否则遍历第一个数、跳同层重复、递归kSum(i + 1, k - 1, target - nums[i])。复杂度O(n^(k-1))。JS里需要担心四个数相加溢出吗?题目范围是
±10⁹,四个加起来4 × 10⁹,远小于Number.MAX_SAFE_INTEGER,JS没问题。Java里int会溢出,要转成long再加。
# 73 数组中的第 K 个最大元素
⚡ 30 秒速记
- 小顶堆只留
k个数:堆顶是这k个里最小的,也就是当前的第k大 - 新数比堆顶大才换掉堆顶再下沉,比堆顶小直接丢,时间
O(n log k),空间O(k) - 另一条路是快速选择:平均
O(n),最坏O(n²),要随机选pivot - 第
k大是降序第k个,重复值也算:[3,2,3,1,2,4,5,5,6]、k = 4答案是4 - 数据量不大时
sort((a, b) => b - a)[k - 1]完全够用,别忘了传比较函数
我一般先说小顶堆:只维护 k 个最大的数,堆顶就是答案。 为什么是小顶堆不是大顶堆?因为我们要随时知道「这 k 个里最小的是谁」,新来的数只要比它大,就把它踢掉。这样复杂度是 O(n log k),k 很小的时候几乎是线性的,而且适合数据流。如果面试官要更快,就说快速选择,按 pivot 分区后只递归答案所在的一边,平均 O(n),但要随机化防退化。
# 题目与解题思路
独立实现「数组中的第 K 个最大元素」。维护容量为 k 的小顶堆,堆顶始终是当前前 k 大元素中最小的一个。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findKthLargest(numbers, k) { // 定义本题的核心实现
const heap = [] // 初始化当前步骤需要的状态
const siftUp = index => { // 初始化当前步骤需要的状态
while (index > 0) { // 遍历仍需处理的候选状态
const parent = Math.floor((index - 1) / 2) // 初始化当前步骤需要的状态
if (heap[parent] <= heap[index]) break // 检查当前分支条件
;[heap[parent], heap[index]] = [heap[index], heap[parent]] // 执行当前语句
index = parent // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
const siftDown = index => { // 初始化当前步骤需要的状态
while (index * 2 + 1 < heap.length) { // 遍历仍需处理的候选状态
let child = index * 2 + 1 // 初始化当前步骤需要的状态
if (child + 1 < heap.length && heap[child + 1] < heap[child]) child += 1 // 检查当前分支条件
if (heap[index] <= heap[child]) break // 检查当前分支条件
;[heap[index], heap[child]] = [heap[child], heap[index]] // 执行当前语句
index = child // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
for (const value of numbers) { // 遍历仍需处理的候选状态
if (heap.length < k) { // 检查当前分支条件
heap.push(value) // 执行当前语句
siftUp(heap.length - 1) // 执行当前语句
} else if (value > heap[0]) { // 进入当前逻辑分支
heap[0] = value // 执行当前语句
siftDown(0) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return heap[0] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log k),空间 O(k)。
- 示例:[3,2,1,5,6,4]、k=2 返回 5。
- 易错点:第 k 大不是排序后下标 k;k 必须位于 1 到数组长度之间。
💬 面试官追问
为什么用小顶堆,大顶堆不行吗?
大顶堆也行,但要把
n个全放进去再弹k - 1次,空间O(n)。小顶堆只存k个,堆顶就是门槛,比门槛小的直接丢,内存省得多,数据流场景只能用这个。快速选择最坏
O(n²),什么输入会触发?每次都选到最大或最小值当
pivot,比如对已排序数组固定选最后一个元素。随机选pivot后期望是O(n);大量重复值时还要用三路划分,不然也会退化。arr.sort()[arr.length - k]有什么问题?没传比较函数,默认按字符串排,
[10, 9, 2]会排成[10, 2, 9]。要写sort((a, b) => a - b),而且sort会改原数组,外面还在用的话先拷贝一份。前端什么场景真会用到
top-k?比如实时日志面板只显示耗时最长的
10个请求,数据源源不断进来,就是固定容量的小顶堆。全量排序每来一条都O(n log n),堆只要O(log 10)。
# 74 判断数组是否存在重复元素
⚡ 30 秒速记
- 边扫边用
Set记,遇到见过的立刻return true,平均O(n),空间O(n) - 一行版
new Set(arr).size !== arr.length更短,但一定会扫完全部元素,没有提前退出 Set用SameValueZero比较:NaN和NaN算重复,+0和-0也算重复- 对象按引用比较,两个长得一样的
{ id: 1 }不算重复,要按业务键比 - 不让用额外空间:排序后比相邻元素,
O(n log n),但会改原数组
最直接的就是用 Set 记录见过的值,扫到重复的马上返回。 平均 O(n),比双重循环的 O(n²) 好,比先排序的 O(n log n) 也好,而且不改原数组。要补一句 Set 的比较规则:它用 SameValueZero,NaN 会被认为等于 NaN,这和 === 不一样;对象比的是引用,所以接口返回的两条同 id 数据不会被判成重复,得自己提取 id 去比。
# 题目与解题思路
独立实现「判断数组是否存在重复元素」。扫描时用 Set 记录已出现值,当前值已存在就立即返回 true。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function containsDuplicate(numbers) { // 定义本题的核心实现
const seen = new Set() // 初始化当前步骤需要的状态
for (const value of numbers) { // 遍历仍需处理的候选状态
if (seen.has(value)) return true // 检查当前分支条件
seen.add(value) // 执行当前语句
} // 结束当前代码块
return false // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 平均时间 O(n),空间 O(n)。
- 示例:[1,2,3,1] 返回 true,[1,2,3,4] 返回 false。
- 易错点:Set 使用 SameValueZero,相同的 NaN 会被视为重复;对象按引用比较。
💬 面试官追问
[NaN, NaN]用Set判和用indexOf判,结果一样吗?不一样。
Set认为两个NaN相同,返回true;indexOf用===,NaN !== NaN,永远找不到。includes也是SameValueZero,和Set一致。列表里两条数据
id一样但对象不是同一个,怎么判重?按业务键判:
seen.has(item.id)。不要用JSON.stringify当键,属性顺序不同串就不同,还慢。面试官说不许用额外空间呢?
先
sort((a, b) => a - b)再看相邻两项是否相等,O(n log n)。但这会改掉调用方的数组,要先说清楚,或者先拷贝,那就又用了O(n)空间。变种:两个重复元素的下标差不能超过
k,怎么改?滑动窗口:
Set里只保留最近k个元素,下标超过k就把nums[i - k - 1]删掉。新元素在Set里就说明窗口内有重复,O(n)时间、O(k)空间。
# 75 数据流中的中位数
⚡ 30 秒速记
- 两个堆把数据劈两半:大顶堆
lower放较小的一半,小顶堆upper放较大的一半 - 约定
lower个数等于upper或者多一个,中位数只看两个堆顶 - 插入:先按和
lower堆顶比较决定进哪边,再把多出来的那边堆顶挪过去平衡 - 奇数取
lower[0],偶数取两堆顶平均;插入O(log n),查询O(1) JS没有内置堆,要手写siftUp/siftDown;值域很小(比如0~100)直接用计数数组更省事
数据流中位数的标准答案是两个堆:一个大顶堆装小的一半,一个小顶堆装大的一半,中位数就在两个堆顶之间。 每来一个数,先看它比小半边的最大值大还是小,放进对应的堆,然后看两边数量差,多了就把堆顶挪到另一边。这样两个堆顶永远是中间那一两个数,查询是 O(1)。为什么不每次排序?排序每次 O(n log n),插入有序数组也要挪元素 O(n),堆只要 O(log n)。
# 题目与解题思路
独立实现「数据流中的中位数」。用大顶堆保存较小一半、小顶堆保存较大一半,并维持数量差不超过一。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class MedianFinder { // 定义本题的核心实现
lower = [] // 执行当前语句
upper = [] // 执行当前语句
push(heap, value, compare) { // 进入当前逻辑分支
heap.push(value) // 执行当前语句
let index = heap.length - 1 // 初始化当前步骤需要的状态
while (index > 0) { // 遍历仍需处理的候选状态
const parent = Math.floor((index - 1) / 2) // 初始化当前步骤需要的状态
if (compare(heap[parent], heap[index])) break // 检查当前分支条件
;[heap[parent], heap[index]] = [heap[index], heap[parent]] // 执行当前语句
index = parent // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
pop(heap, compare) { // 进入当前逻辑分支
const root = heap[0] // 初始化当前步骤需要的状态
const tail = heap.pop() // 初始化当前步骤需要的状态
if (heap.length) { // 检查当前分支条件
heap[0] = tail // 执行当前语句
let index = 0 // 初始化当前步骤需要的状态
while (index * 2 + 1 < heap.length) { // 遍历仍需处理的候选状态
let child = index * 2 + 1 // 初始化当前步骤需要的状态
if (child + 1 < heap.length && !compare(heap[child], heap[child + 1])) child += 1 // 检查当前分支条件
if (compare(heap[index], heap[child])) break // 检查当前分支条件
;[heap[index], heap[child]] = [heap[child], heap[index]] // 执行当前语句
index = child // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return root // 返回本题要求的结果
} // 结束当前代码块
addNum(value) { // 进入当前逻辑分支
if (!this.lower.length || value <= this.lower[0]) this.push(this.lower, value, (left, right) => left >= right) // 检查当前分支条件
else this.push(this.upper, value, (left, right) => left <= right) // 处理另一种分支
if (this.lower.length > this.upper.length + 1) this.push(this.upper, this.pop(this.lower, (left, right) => left >= right), (left, right) => left <= right) // 检查当前分支条件
if (this.upper.length > this.lower.length) this.push(this.lower, this.pop(this.upper, (left, right) => left <= right), (left, right) => left >= right) // 检查当前分支条件
} // 结束当前代码块
findMedian() { // 进入当前逻辑分支
if (this.lower.length > this.upper.length) return this.lower[0] // 检查当前分支条件
return (this.lower[0] + this.upper[0]) / 2 // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 插入 O(log n),查询 O(1),空间 O(n)。
- 示例:依次加入 1、2 时中位数 1.5,再加入 3 后为 2。
- 易错点:偶数个元素要取两个堆顶平均值;每次插入后都要恢复两堆的大小与有序边界。
💬 面试官追问
插入
[5, 2, 8],两个堆分别是什么,中位数是多少?5进lower;2比5小也进lower,lower有两个、upper零个,把5挪到upper;8比lower堆顶2大,进upper,这时upper多了,把5挪回lower。最后lower = [5, 2]、upper = [8],中位数5。堆的
push/pop里传一个compare参数,是干嘛的?让一份堆代码同时当大顶堆和小顶堆用。大顶堆传
(a, b) => a >= b,小顶堆传(a, b) => a <= b,同一份siftUp/siftDown复用,出错的地方也只有一处。如果数据都在
0~100之间,还用堆吗?不用。开一个长度
101的计数数组,插入就是count[v]++,求中位数扫一遍101个格子,都是常数时间。99%在范围内的话,再给两端各加一个溢出计数就行。改成滑动窗口里的中位数,要从堆里删任意元素,怎么办?
堆删任意元素要先找到它,是
O(k)。常用延迟删除:用Map记「待删的值和次数」,等它浮到堆顶时再真正弹掉,同时用计数维护两边的「有效个数」来平衡。
# 76 O(1) 插入、删除和随机访问集合
⚡ 30 秒速记
- 数组负责随机取:
values[Math.floor(Math.random() * values.length)] Map记「值 → 数组下标」,负责O(1)判断存在和定位- 删除不挪元素:用最后一个元素覆盖要删的位置,更新它在
Map里的下标,再pop - 顺序有讲究:先
indexes.set(last, index)再indexes.delete(value),删的刚好是最后一个时也不会出错 - 为什么不只用
Set:Set没有下标,随机取要先转数组,O(n)
单靠一种结构做不到三个操作都 O(1),所以数组和 Map 搭配:数组管随机访问,Map 管查找。 插入就是数组末尾 push,Map 记下标。删除是难点,直接 splice 要挪后面所有元素,所以把末尾元素搬到要删的位置,再把末尾 pop 掉,数组顺序乱了没关系,集合本来就不讲顺序。搬完一定要同步改末尾元素在 Map 里的下标,漏了这一步下次删它就会删错位置。
# 题目与解题思路
独立实现「O(1) 插入、删除和随机访问集合」。数组负责随机访问,Map 保存值到数组下标;删除时用末元素覆盖待删位置。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class RandomizedSet { // 定义本题的核心实现
values = [] // 执行当前语句
indexes = new Map() // 执行当前语句
insert(value) { // 进入当前逻辑分支
if (this.indexes.has(value)) return false // 检查当前分支条件
this.indexes.set(value, this.values.length) // 执行当前语句
this.values.push(value) // 执行当前语句
return true // 返回本题要求的结果
} // 结束当前代码块
remove(value) { // 进入当前逻辑分支
if (!this.indexes.has(value)) return false // 检查当前分支条件
const index = this.indexes.get(value) // 初始化当前步骤需要的状态
const last = this.values.at(-1) // 初始化当前步骤需要的状态
this.values[index] = last // 执行当前语句
this.indexes.set(last, index) // 执行当前语句
this.values.pop() // 执行当前语句
this.indexes.delete(value) // 执行当前语句
return true // 返回本题要求的结果
} // 结束当前代码块
getRandom() { // 进入当前逻辑分支
return this.values[Math.floor(Math.random() * this.values.length)] // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 插入、删除、随机读取平均 O(1),空间 O(n)。
- 示例:insert(1)、insert(2)、remove(1) 后随机结果只能是 2。
- 易错点:覆盖后必须同步更新末元素的 Map 下标;空集合随机读取的契约要明确。
💬 面试官追问
要删的值刚好就是数组最后一个,这份代码会出问题吗?
不会。
last === value,覆盖是自己写自己,set(last, index)也是原样写回,接着pop和delete(value)把它删干净。但如果你把delete写在set前面,Map里就会留下一个已删除值的脏下标。为什么不用
splice(index, 1)删除?splice要把后面的元素往前挪,O(n),而且挪完之后所有后面元素在Map里的下标全错了,要一个个改。末尾覆盖只改一个下标。允许插入重复值呢?
Map的值从单个下标改成下标集合Map<value, Set<index>>。删除时从集合里随便取一个下标,用末尾元素覆盖,再把末尾元素的下标集合里旧下标换成新下标。空集合调用
getRandom()会返回什么?values.length是0,values[0]是undefined,不报错但调用方可能当成合法值。题目保证不会空着调用,自己封装工具时我会直接抛错,或者返回null并在类型上标出来。
# 77 Fisher-Yates 等概率打乱数组
⚡ 30 秒速记
- 从后往前,第
i位从[0, i]里等概率挑一个和它交换,挑完这一位就定了 - 随机范围必须包含
i自己:Math.floor(random() * (i + 1)),写成* i就成了Sattolo算法,元素永远不会留在原位 - 每种排列恰好对应一条选择路径,
n × (n-1) × … × 1 = n!,所以等概率 arr.sort(() => Math.random() - 0.5)不等概率,比较结果自相矛盾,结果依赖排序实现- 抽奖这种要公平的场景用
crypto.getRandomValues,Math.random不是密码学安全的
Fisher-Yates 的思路是像抽签一样:从剩下的牌里随机抽一张放到最后,再从剩下的里抽,直到抽完。 每一步都是在「还没确定的区间」里等概率选,所以 n 个位置的选法乘起来正好是 n! 种,一种排列对应一种走法,概率完全相等。随机下标一定要包含当前位置,不然元素不能留在原位,概率就偏了。还有常见的 sort 加随机比较器,看起来能打乱,其实不均匀,面试里提这个是加分项。
# 题目与解题思路
独立实现「Fisher-Yates 等概率打乱数组」。从末尾向前,为每个位置在未确定区间内等概率选择一个元素交换。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function shuffle(values, random = Math.random) { // 定义本题的核心实现
const result = [...values] // 初始化当前步骤需要的状态
for (let index = result.length - 1; index > 0; index -= 1) { // 遍历仍需处理的候选状态
const selected = Math.floor(random() * (index + 1)) // 初始化当前步骤需要的状态
;[result[index], result[selected]] = [result[selected], result[index]] // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),原地版空间 O(1)。
- 示例:[1,2,3] 的六种排列应具有相同理论概率。
- 易错点:随机下标必须包含当前位置;用 sort(() => Math.random()-0.5) 不等概率。
💬 面试官追问
sort(() => Math.random() - 0.5)到底哪里不均匀?排序算法假设比较结果是稳定一致的,随机比较器让
a < b、b < a同时成立,结果取决于算法怎么比较。V8从7.0起sort改用TimSort,打乱[1, 2, 3]跑几万次统计,各排列出现频率明显不一样。写成
Math.floor(random() * n),每次从整个数组里挑,为什么也不行?每一步都有
n种选法,总共n^n条路径,要平均分给n!种排列。n = 3时是27条分给6种,除不尽,必然有的排列多有的少。怎么写单测证明它是等概率的?
让函数接受注入的
random,比如shuffle(values, random = Math.random)。确定性测试传一个固定序列验证交换过程;统计测试对[1, 2, 3]跑60000次,每种排列应该在10000次左右,偏差超过几个百分点就有问题。抽奖页面要打乱名单,直接用
Math.random可以吗?涉及公平性我会换成
crypto.getRandomValues,Math.random的种子和序列都不是为安全设计的。另外随机数转下标别直接% (i + 1),有取模偏差,要拒绝采样把落在不整除区间的值丢掉重取。
# 78 LFU 缓存
⚡ 30 秒速记
- 先按访问次数淘汰,次数相同再淘汰最久没用的,等于「
LFU+ 同频次内LRU」 - 三个结构:
items(key→ 值和频次)、buckets(频次 → 一个Map,按插入顺序就是LRU顺序)、minimumFrequency - 访问一次:从旧频次桶删掉,进
频次 + 1的桶;旧桶空了且它正好是最小频次,最小频次+1 - 插入新
key:满了先淘汰最小频次桶里最老的那个(bucket.keys().next().value),再把最小频次重置为1 capacity = 0直接忽略写入;put已有的key也算一次访问
LFU 的难点是 O(1) 地找到「次数最少里最久没用的那个」,做法是按频次分桶,每个桶内部按 LRU 排队,再单独记一个最小频次。 JS 里 Map 保留插入顺序,删掉再 set 就挪到末尾,keys().next() 拿到的就是最老的,正好当 LRU 链表用。最小频次不用每次去找:访问只可能让它加一,插入新 key 一定把它重置为 1,两个时机维护好就行。
# 题目与解题思路
独立实现「LFU 缓存」。Map 定位节点,频次桶维护同频次内的 LRU 顺序,同时记录当前最小频次。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class LFUCache { // 定义本题的核心实现
constructor(capacity) { // 进入当前逻辑分支
this.capacity = capacity // 执行当前语句
this.minimumFrequency = 0 // 执行当前语句
this.items = new Map() // 执行当前语句
this.buckets = new Map() // 执行当前语句
} // 结束当前代码块
touch(key) { // 进入当前逻辑分支
const item = this.items.get(key) // 初始化当前步骤需要的状态
const bucket = this.buckets.get(item.frequency) // 初始化当前步骤需要的状态
bucket.delete(key) // 执行当前语句
if (!bucket.size) { // 检查当前分支条件
this.buckets.delete(item.frequency) // 执行当前语句
if (this.minimumFrequency === item.frequency) this.minimumFrequency += 1 // 检查当前分支条件
} // 结束当前代码块
item.frequency += 1 // 执行当前语句
if (!this.buckets.has(item.frequency)) this.buckets.set(item.frequency, new Map()) // 检查当前分支条件
this.buckets.get(item.frequency).set(key, true) // 执行当前语句
} // 结束当前代码块
get(key) { // 进入当前逻辑分支
const item = this.items.get(key) // 初始化当前步骤需要的状态
if (!item) return -1 // 检查当前分支条件
this.touch(key) // 执行当前语句
return item.value // 返回本题要求的结果
} // 结束当前代码块
put(key, value) { // 进入当前逻辑分支
if (!this.capacity) return // 检查当前分支条件
if (this.items.has(key)) { // 检查当前分支条件
this.items.get(key).value = value // 执行当前语句
this.touch(key) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
if (this.items.size === this.capacity) { // 检查当前分支条件
const bucket = this.buckets.get(this.minimumFrequency) // 初始化当前步骤需要的状态
const victim = bucket.keys().next().value // 初始化当前步骤需要的状态
bucket.delete(victim) // 执行当前语句
this.items.delete(victim) // 执行当前语句
} // 结束当前代码块
this.minimumFrequency = 1 // 执行当前语句
this.items.set(key, { value, frequency: 1 }) // 执行当前语句
if (!this.buckets.has(1)) this.buckets.set(1, new Map()) // 检查当前分支条件
this.buckets.get(1).set(key, true) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- get/put 平均 O(1),空间 O(capacity)。
- 示例:容量 2,put(1)、put(2)、get(1)、put(3) 应淘汰键 2。
- 易错点:容量为零直接忽略写入;同频次淘汰最久未使用者,提升频次后可能更新 minFreq。
💬 面试官追问
为什么插入新
key后可以直接把最小频次设成1?新
key的频次就是1,不可能有比它更小的。淘汰在设置之前做,用的还是旧的最小频次,所以顺序不能反。访问一个
key之后,最小频次什么时候要变?只有它原来所在的桶被清空、而且那个桶正好是最小频次的时候才
+1。它挪进了频次 + 1的桶,所以新的最小频次一定就是旧值加一,不用遍历。Map凭什么能当LRU链表用?规范保证
Map按插入顺序迭代,delete再set会把键挪到末尾,keys().next().value就是最早插入的。增删都是平均O(1),省得手写双向链表。LRU和LFU实际怎么选?大多数场景用
LRU,简单、对访问模式变化反应快。LFU的问题是曾经很热、后来没人用的key计数很高,会一直赖着不走;Redis的allkeys-lfu用的是带衰减的对数计数器,就是为了解决这个。这份代码淘汰后有个桶变空了没删,会有问题吗?
结果不会错,接着就把最小频次设成
1了,空桶不会被当成淘汰对象。只是buckets里留了个空Map,长期运行算轻微的内存浪费,顺手if (!bucket.size) this.buckets.delete(...)删掉更干净。
# 79 电话号码的字母组合
⚡ 30 秒速记
- 每一位数字是递归的一层,这一层在它对应的几个字母里挑一个,挑满
digits.length个就收集 - 空输入返回
[]而不是[''],开头要特判 - 时间
O(4^n × n):7、9各对应四个字母,拼接字符串还要O(n) path + letter每次生成新字符串,不需要手动撤销;用数组push/pop的话记得回溯- 也能迭代写:从
['']出发,每读一位数字就把现有结果和新字母做一次笛卡尔积
这题是最基础的回溯:数字的个数就是树的深度,每个数字对应的字母就是这一层的分支。 递归函数带着当前下标和拼好的字符串往下走,走到底就是一个组合。因为用的是字符串拼接,每层传下去的都是新字符串,不用写撤销那一步,代码很短。要注意空字符串的特判,不加的话空串长度是 0,一进递归 index === digits.length 就成立,会直接收集一个空串,返回 [''],题目要的是 []。
# 题目与解题思路
独立实现「电话号码的字母组合」。按数字位置回溯,每层选择该数字映射的一个字母,路径长度等于数字长度时收集。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function letterCombinations(digits) { // 定义本题的核心实现
if (!digits) return [] // 检查当前分支条件
const map = { 2: 'abc', 3: 'def', 4: 'ghi', 5: 'jkl', 6: 'mno', 7: 'pqrs', 8: 'tuv', 9: 'wxyz' } // 初始化当前步骤需要的状态
const result = [] // 初始化当前步骤需要的状态
const search = (index, path) => { // 初始化当前步骤需要的状态
if (index === digits.length) { // 检查当前分支条件
result.push(path) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (const letter of map[digits[index]]) search(index + 1, path + letter) // 遍历仍需处理的候选状态
} // 结束当前代码块
search(0, '') // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(4^n·n),递归栈 O(n)。
- 示例:输入 23 得到 ad、ae、af、bd、be、bf、cd、ce、cf。
- 易错点:空输入应返回空数组;数字 0 和 1 没有常规字母映射。
💬 面试官追问
输入
"23",递归树长什么样?第一层在
abc里选,第二层在def里选,3 × 3 = 9个叶子:ad、ae、af、bd……cf。深度是数字个数,宽度是每位的字母数。不用递归能写吗?
能,用
reduce做笛卡尔积:digits.split('').reduce((acc, d) => acc.flatMap(p => [...map[d]].map(c => p + c)), ['']),最后同样要特判空输入。输入里有
0或1会怎样?map['1']是undefined,for...of遍历undefined直接抛TypeError。题目保证只有2~9;自己封装的话要在入口校验,或者约定跳过这两个数字。输入
9位数字,结果有多少个?前端展示要注意什么?最多
4^9 = 262144个,一次性生成再渲染页面会卡。可以改成生成器function*,yield一个用一个,配合分页或虚拟列表。
# 80 组合
⚡ 30 秒速记
- 回溯模板:选一个数 → 递归 → 撤销;下一层从当前数
+1开始,只选更大的数,组合就不会重复 - 剪枝:还要选
k - path.length个,循环上界写成n - (k - path.length) + 1,后面不够选的分支直接不进 - 收集时必须
[...path]拷贝,不然所有结果都指向同一个数组,最后全是空的 - 时间
O(C(n, k) × k),递归深度O(k) - 边界:
k = 0返回[[]],k > n返回[],这份代码都能自然处理
组合和排列的区别是不讲顺序,所以只要规定「每次只选比上一个大的数」,就天然不会出现 [1, 2] 和 [2, 1] 这种重复。 递归函数带一个 start,从 start 往后选,选完递归到 value + 1,回来再撤销。剪枝是这题的加分点:比如 n = 4、k = 3,第一个数选 3 的话后面只剩 4,凑不够三个,循环上界提前算好就不用进去试了。
# 题目与解题思路
独立实现「组合」。回溯选择递增数字,下一层从当前数字加一开始,天然避免重复排列。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function combine(n, k) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const search = start => { // 初始化当前步骤需要的状态
if (path.length === k) { // 检查当前分支条件
result.push([...path]) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
const remaining = k - path.length // 初始化当前步骤需要的状态
for (let value = start; value <= n - remaining + 1; value += 1) { // 遍历仍需处理的候选状态
path.push(value) // 执行当前语句
search(value + 1) // 执行当前语句
path.pop() // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(1) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(C(n,k)·k),递归栈 O(k)。
- 示例:n=4、k=2 得到 6 个组合。
- 易错点:循环上界可根据还需选择的数量剪枝,否则会进入不可能完成的分支。
💬 面试官追问
n = 4、k = 2,剪枝后的循环上界分别是多少?第一层还要选
2个,上界4 - 2 + 1 = 3,第一个数只试1~3;第二层还要选1个,上界4。4当第一个数后面没东西可选,被剪掉了。收集结果时写
result.push(path)会怎样?result里每一项都是同一个path的引用,回溯结束时path被pop空了,最后得到6个[]。必须push([...path])拷一份。这题和「子集」是什么关系?
模板一模一样,子集是「每个节点都收集」,组合是「长度等于
k才收集」。把所有k从0到n的组合并起来就是全部子集。C(20, 10)有多大?还能用回溯吗?184756个,每个长度10,回溯能跑完。但如果只是要个数,直接用组合数公式算,没必要生成。
# 81 含重复元素的全排列
⚡ 30 秒速记
- 先排序让相同的数挨在一起,
used数组标记下标有没有在当前路径里 - 去重条件:
nums[i] === nums[i - 1] && !used[i - 1]就跳过,意思是同一层里这个值已经试过了 - 写成
used[i - 1]结果也对,只是剪在更深的层,多做很多无用搜索,不会剪掉合法选择 - 不排序这个条件就失效;不想排序可以每层开一个
Set记本层用过的值 - 最坏
O(n! × n),sort会改原数组
全排列去重的核心是「同一层不选相同的值」,排序之后用 !used[i - 1] 判断就行。 为什么是 !used?如果前一个相同的数没在用,说明它刚在这一层试过、已经撤销了,现在再选值相同的这个,生成的子树完全一样,跳过。如果前一个正在用,说明它在上层路径里,当前是往下一层选,合法。顺带纠正一个常见说法:条件写成 used[i - 1] 结果其实也是对的,相当于强制相同值按倒序使用,只是剪枝发生得晚、搜索量大很多。
# 题目与解题思路
独立实现「含重复元素的全排列」。先排序,回溯时用 used 标记下标,并跳过同层中前一个尚未使用的相同值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function permuteUnique(numbers) { // 定义本题的核心实现
numbers.sort((left, right) => left - right) // 执行当前语句
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const used = new Array(numbers.length).fill(false) // 初始化当前步骤需要的状态
const search = () => { // 初始化当前步骤需要的状态
if (path.length === numbers.length) { // 检查当前分支条件
result.push([...path]) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (let index = 0; index < numbers.length; index += 1) { // 遍历仍需处理的候选状态
if (used[index]) continue // 检查当前分支条件
if (index && numbers[index] === numbers[index - 1] && !used[index - 1]) continue // 检查当前分支条件
used[index] = true // 执行当前语句
path.push(numbers[index]) // 执行当前语句
search() // 执行当前语句
path.pop() // 执行当前语句
used[index] = false // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search() // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏时间 O(n!·n),空间 O(n)。
- 示例:[1,1,2] 得到三种不重复排列。
- 易错点:不排序去重条件就失效;推荐写 !used[index-1],写成 used[index-1] 结果也对,只是剪枝更晚、搜索量大很多。
去重条件写成 used[i - 1] 并不会剪掉合法选择,两种写法输出结果一样:
// 把条件里的 !used[index - 1] 换成 used[index - 1]
permuteUnique([1, 1, 2])
// 两种写法都返回 [[1,1,2], [1,2,1], [2,1,1]]
区别在于剪在哪一层:
!used[i - 1]:前一个相同值不在路径里,说明它刚在本层用过、已经撤销,当前这个就是同层重复,直接跳过。剪的是树靠上的分支,效率高。used[i - 1]:要求前一个相同值必须正在被使用,等于强制相同值按「从后往前」的顺序选。不满足这个顺序的分支要往下走好几层才被剪掉,最后结果一样,但搜索的节点多得多。
所以面试里推荐写 !used[i - 1],理由是剪枝更早,不是另一种写法会出错。要是被追问,能说出「两种都对,效率不同」反而是加分点。
💬 面试官追问
[1, 1, 2]不去重会得到几个排列?去重后几个?不去重是
3! = 6个,其中两两重复;去重后3个:[1,1,2]、[1,2,1]、[2,1,1]。!used[i - 1]改成used[i - 1],结果会错吗?不会错,我跑过
[1, 1, 2]两种写法都是3个。used[i - 1]是要求相同的值必须从后往前用,前面的分支要走到很深才发现走不通,效率低很多,所以还是用!used[i - 1]。不想改原数组的顺序,怎么去重?
每层循环里开一个
Set,这个值本层用过就跳过。不需要排序,代价是每层多一个Set,空间O(n²)。或者先[...nums].sort()拷一份再排。为什么必须先排序?
!used[i - 1]只比较相邻元素,相同的值必须挨在一起才能被识别。[1, 2, 1]不排序的话两个1不相邻,去重直接失效。
# 82 复原 IP 地址
⚡ 30 秒速记
- 回溯切四段,每段长度
1~3,切满四段且正好用完字符串才收集 - 每段立刻校验:长度大于
1且以0开头不合法,数值大于255不合法,两种情况都可以直接break - 长度剪枝:剩余字符数必须在
[剩余段数, 剩余段数 × 3]之间,总长度不在4~12直接返回[] "0"可以单独成段,"01"、"00"不行- 每段最多
3种切法、共4段,最多3^4 = 81条路径,复杂度是常数级
这题就是在字符串里插三个点,用回溯一段一段切,每切一段就检查合不合法,不合法立刻停。 一段合法要满足两点:不能有前导零(单独一个 0 可以),数值不超过 255。这两条一旦不满足,再往后多切一位只会更不合法,所以直接 break 而不是 continue。另外可以加长度剪枝,比如剩下 2 段却还有 7 个字符,怎么切都放不下,提前返回能省掉很多无效递归。
# 题目与解题思路
独立实现「复原 IP 地址」。回溯切出恰好四段,每段长度 1 到 3,并立即校验前导零与数值范围。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function restoreIpAddresses(text) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const parts = [] // 初始化当前步骤需要的状态
const search = start => { // 初始化当前步骤需要的状态
if (parts.length === 4) { // 检查当前分支条件
if (start === text.length) result.push(parts.join('.')) // 检查当前分支条件
return // 执行当前语句
} // 结束当前代码块
for (let end = start; end < Math.min(start + 3, text.length); end += 1) { // 遍历仍需处理的候选状态
const part = text.slice(start, end + 1) // 初始化当前步骤需要的状态
if (part.length > 1 && part[0] === '0') break // 检查当前分支条件
if (Number(part) > 255) break // 检查当前分支条件
parts.push(part) // 执行当前语句
search(end + 1) // 执行当前语句
parts.pop() // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(0) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 搜索空间有固定上界,额外空间 O(1)。
- 示例:25525511135 得到 255.255.11.135 和 255.255.111.35。
- 易错点:0 可以单独成段,01 不合法;剩余字符数应与剩余段数一起剪枝。
💬 面试官追问
"0000"和"010010"分别返回什么?"0000"只有"0.0.0.0"。"010010"有两个:"0.10.0.10"和"0.100.1.0",开头的0只能单独成段。遇到前导零或者大于
255,为什么是break不是continue?这一段再往后多取一位,前导零还在,数值只会更大,不可能变合法。
break直接结束这一层的循环,省掉后面的尝试。"1111111111111"这种13位的输入,代码会怎么跑?只靠每段的校验,会老老实实递归一遍才发现切不完。开头加
if (s.length < 4 || s.length > 12) return [],一次判断就结束。线上要校验用户输入的
IP,你会用这个回溯吗?不会,这题是「从数字串还原」,校验是另一回事。浏览器里用正则按段校验,
Node里直接net.isIPv4(str);IPv6规则复杂得多,别自己写。
# 83 分割回文串
⚡ 30 秒速记
- 回溯:从
start往后枚举切点,当前这段是回文才递归切剩下的,切到末尾收集一次 - 收集必须
[...path]拷贝,和所有回溯题一样 - 每次判断回文都要
O(n),可以先用DP预处理isPal[i][j] = s[i] === s[j] && (j - i < 2 || isPal[i + 1][j - 1]) - 最坏
"aaaa...a",每个切点都能切,2^(n-1)种方案,时间O(n × 2^n) - 只问「最少切几刀」就别回溯,那是另一道
DP题
这题是在字符串里选切点,每段都得是回文,用回溯枚举所有切法。 从当前位置开始,依次试长度 1、2、3 …… 的前缀,是回文就放进路径、递归处理后面的部分,回来再撤销。重复判断回文是主要开销,同一个子串会被反复检查,所以常见优化是先用 DP 把所有 [i, j] 是否回文算成一张表,回溯时直接查。最坏情况全是同一个字母,方案数是指数级的,这个没法优化,因为答案本身就这么多。
# 题目与解题思路
独立实现「分割回文串」。从当前位置枚举结束位置,只有当前片段为回文时才继续递归。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function partitionPalindrome(text) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const palindrome = value => value === [...value].reverse().join('') // 初始化当前步骤需要的状态
const search = start => { // 初始化当前步骤需要的状态
if (start === text.length) { // 检查当前分支条件
result.push([...path]) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (let end = start + 1; end <= text.length; end += 1) { // 遍历仍需处理的候选状态
const part = text.slice(start, end) // 初始化当前步骤需要的状态
if (!palindrome(part)) continue // 检查当前分支条件
path.push(part) // 执行当前语句
search(end) // 执行当前语句
path.pop() // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(0) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏时间 O(n·2^n),递归栈 O(n)。
- 示例:aab 得到 [a,a,b] 和 [aa,b]。
- 易错点:收集答案时必须复制 path;可预处理回文表减少重复判断。
💬 面试官追问
"aab"的递归过程是什么样的?从
0开始:切"a"是回文,递归剩下的"ab",得到["a", "a", "b"];切"aa"是回文,递归"b",得到["aa", "b"];切"aab"不是回文,跳过。一共两种。用
[...value].reverse().join('')判回文,有什么可改进的?每次都新建数组和字符串,
O(len)时间加O(len)内存。改成双指针从两头往中间比,不分配内存;再进一步就是预处理回文表,判断变成O(1)。回文表的
DP为什么要从下往上填?isPal[i][j]依赖isPal[i + 1][j - 1],也就是下一行的值。所以i要从n - 1往0倒着遍历,j从i往后,保证用到的时候已经算好了。题目改成「最少切几刀让每段都是回文」,还用回溯吗?
不用,回溯是指数级的。用
DP:cut[j]表示前j + 1个字符的最少刀数,枚举最后一段的起点i,[i, j]是回文就cut[j] = min(cut[j], cut[i - 1] + 1),O(n²)。
# 84 N 皇后
⚡ 30 秒速记
- 一行只放一个皇后 → 行冲突天然没有,只剩列和两条对角线要判
- 三个集合:
cols记列,row - col记主对角线(↘方向差值相同),row + col记副对角线(↙方向和相同) - 回溯三步走:放下 → 三个集合
add→ 递归下一行 → 三个集合delete,少撤一个就会漏解 row === n说明每行都放好了,这时才把board转成字符串存进结果- 复杂度:时间上界
O(n!),空间O(n);n = 4有 2 个解,n = 8有 92 个
N 皇后就是一行一行地试,每行挑一个不冲突的列放下,走不通就退回上一行换个位置。 因为是按行放的,同一行不可能有两个皇后,所以只要判断列和两条斜线。斜线有个小技巧:同一条 ↘ 斜线上 row - col 都相等,同一条 ↙ 斜线上 row + col 都相等,用三个 Set 就能 O(1) 判冲突,不用每次扫整个棋盘。写的时候最容易错的是回溯没撤干净,递归回来之后三个集合都要删掉当前这一格。
# 题目与解题思路
独立实现「N 皇后」。逐行放置皇后,用列、主对角线和副对角线集合 O(1) 判断冲突。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function solveNQueens(n) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const board = new Array(n).fill(-1) // 初始化当前步骤需要的状态
const columns = new Set() // 初始化当前步骤需要的状态
const diagonalsA = new Set() // 初始化当前步骤需要的状态
const diagonalsB = new Set() // 初始化当前步骤需要的状态
const search = row => { // 初始化当前步骤需要的状态
if (row === n) { // 检查当前分支条件
result.push(board.map(column => '.'.repeat(column) + 'Q' + '.'.repeat(n - column - 1))) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (let column = 0; column < n; column += 1) { // 遍历仍需处理的候选状态
if (columns.has(column) || diagonalsA.has(row - column) || diagonalsB.has(row + column)) continue // 检查当前分支条件
board[row] = column // 执行当前语句
columns.add(column) // 执行当前语句
diagonalsA.add(row - column) // 执行当前语句
diagonalsB.add(row + column) // 执行当前语句
search(row + 1) // 执行当前语句
columns.delete(column) // 执行当前语句
diagonalsA.delete(row - column) // 执行当前语句
diagonalsB.delete(row + column) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(0) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 上界 O(n!),空间 O(n)。
- 示例:n=4 有两种合法棋盘。
- 易错点:对角线可分别用 row-column 与 row+column 标识;回溯时三组状态都要撤销。
💬 面试官追问
row - col会出现负数,用数组代替Set怎么存?加个偏移量就行,
diag1[row - col + n - 1],下标范围是0到2n - 2,数组长度开2n - 1。数组比Set常数小一点,n大的时候能看出差别。只要求返回解的个数,不要棋盘,能怎么优化?
不用存
board,也不用拼字符串,到row === n时计数加一就行。再狠一点可以用位运算:三个整数当掩码,available = ~(cols | d1 | d2) & ((1 << n) - 1),每次取最低位p = available & -available,这是N皇后最快的写法。递归回来忘了
diagonalsB.delete,会出什么现象?不会报错,但后面的分支会被一条已经不存在的斜线挡住,结果是解变少了。
n = 4本来 2 个解,可能只剩 1 个甚至 0 个,这种问题 只看能不能跑是发现不了的,要拿已知解数对一下。n = 2和n = 3返回什么?空数组,这两个规模无解;
n = 1返回[['Q']]。面试时我会先跑这几个小值,再跑n = 4看是不是正好 2 个解。
# 85 解数独
⚡ 30 秒速记
- 按顺序找下一个空格,
1~9挨个试,行、列、九宫格都不冲突才填下去递归 - 递归返回
true就一路返回,返回false就把这格改回'.'换下一个数 - 某个空格
1~9全试过都不行 → 直接return false,让上一层换数 - 九宫格起点:
Math.floor(row / 3) * 3、Math.floor(col / 3) * 3 - 优化:三组
Set或位掩码代替每次扫27格;优先填候选最少的空格,难题上回溯次数能少很多
解数独就是标准回溯:找一个空格,从 1 到 9 试,合法就填上往下走,走到死胡同就擦掉换下一个数。 判合法要同时看这一行、这一列、所在的 3×3 宫,宫的起点用 Math.floor(row / 3) * 3 算。有个细节很多人漏掉:一个空格九个数都试完了还不行,要立刻返回 false,不能接着去找下一个空格,否则相当于跳过了这一格。基础版每次判断扫 27 格,想快一点就用三组集合记录已用数字,再加上「先填候选最少的格子」这个启发式。
# 题目与解题思路
独立实现「解数独」。找到下一个空格,尝试 1 到 9;候选同时满足行、列和九宫格约束才递归。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function solveSudoku(board) { // 定义本题的核心实现
const valid = (row, column, value) => { // 初始化当前步骤需要的状态
for (let index = 0; index < 9; index += 1) { // 遍历仍需处理的候选状态
if (board[row][index] === value || board[index][column] === value) return false // 检查当前分支条件
const boxRow = Math.floor(row / 3) * 3 + Math.floor(index / 3) // 初始化当前步骤需要的状态
const boxColumn = Math.floor(column / 3) * 3 + index % 3 // 初始化当前步骤需要的状态
if (board[boxRow][boxColumn] === value) return false // 检查当前分支条件
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
const search = () => { // 初始化当前步骤需要的状态
for (let row = 0; row < 9; row += 1) { // 遍历仍需处理的候选状态
for (let column = 0; column < 9; column += 1) { // 遍历仍需处理的候选状态
if (board[row][column] !== '.') continue // 检查当前分支条件
for (let value = 1; value <= 9; value += 1) { // 遍历仍需处理的候选状态
const token = String(value) // 初始化当前步骤需要的状态
if (!valid(row, column, token)) continue // 检查当前分支条件
board[row][column] = token // 执行当前语句
if (search()) return true // 检查当前分支条件
board[row][column] = '.' // 执行当前语句
} // 结束当前代码块
return false // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
search() // 执行当前语句
return board // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏指数级,空间最多 O(空格数)。
- 示例:标准 9×9 棋盘原地填充为唯一合法解。
- 易错点:找到完整解后要向上传递 true 提前停止;回溯必须把格子恢复为点。
💬 面试官追问
为什么九个数都试完以后要马上
return false,不能continue?这格填不了任何数,说明前面某一步填错了,必须回到上一层换数。
continue去找下一个空格的话,这格就一直空着,最后可能返回一个没填完的棋盘还说成功。valid每次都扫一遍行列宫,怎么提速?开
rows[9]、cols[9]、boxes[9]三组集合(或者9位的整数掩码),填数时add,回溯时delete,判断变成O(1)。宫的下标是Math.floor(r / 3) * 3 + Math.floor(c / 3)。有些难题跑好几秒,除了加集合还能怎么优化?
每次挑候选数最少的空格先填,也叫
MRV。候选只有一个的格子先定下来,等于把分支剪掉了,难题上效果很明显,比单纯优化valid管用。题目给的棋盘本身就有冲突,你的函数会怎样?
这版代码只检查新填的数,初始冲突发现不了,最后会返回
false但原棋盘没变。生产里我会先扫一遍校验初始盘面,有重复直接报错,别让它白跑一轮指数级搜索。这里存的是字符串
'5',valid里拿数字5去比会怎样?===永远不相等,所有冲突都判断不出来,会填出一个错的盘。代码里用String(value)转成token再比,就是为了和棋盘里的字符串类型对齐。
# 86 最长公共子序列
⚡ 30 秒速记
dp[i][j]=a前i个字符和b前j个字符的最长公共子序列长度- 字符相等 → 左上
+1;不等 →max(上, 左),意思是扔掉其中一个串的最后一个字符 - 多开一行一列表示空前缀,第
0行第0列全是0,不用特判 - 子序列不要求连续;要求连续的是最长公共子串,转移不一样
- 时间
O(mn),空间能压到O(min(m, n)),但压缩后没法回溯出具体序列
最长公共子序列的状态是两个前缀:dp[i][j] 表示第一个串前 i 个字符和第二个串前 j 个字符最多有多长的公共子序列。 看两个前缀的最后一个字符,相等就一起用上,长度是左上角加一;不相等就至少有一个字符用不上,取扔掉左边串最后一位和扔掉右边串最后一位里更大的那个。表格多开一行一列代表空串,边界自然是 0。比如 abcde 和 ace,最后填出来右下角是 3。
# 题目与解题思路
独立实现「最长公共子序列」。二维 DP 表示两个前缀的最长公共子序列长度,相等取左上加一,否则取上与左较大值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function longestCommonSubsequence(left, right) { // 定义本题的核心实现
const dp = Array.from({ length: left.length + 1 }, () => new Array(right.length + 1).fill(0)) // 初始化当前步骤需要的状态
for (let row = 1; row <= left.length; row += 1) { // 遍历仍需处理的候选状态
for (let column = 1; column <= right.length; column += 1) { // 遍历仍需处理的候选状态
if (left[row - 1] === right[column - 1]) dp[row][column] = dp[row - 1][column - 1] + 1 // 检查当前分支条件
else dp[row][column] = Math.max(dp[row - 1][column], dp[row][column - 1]) // 处理另一种分支
} // 结束当前代码块
} // 结束当前代码块
return dp[left.length][right.length] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(mn),可压缩为 O(n)。
- 示例:abcde 与 ace 的最长公共子序列长度为 3。
- 易错点:子序列不要求连续;行列要多开一格表达空前缀。
💬 面试官追问
面试官让你把具体的公共子序列打出来,怎么做?
保留完整二维表,从右下角往回走:字符相等就记下这个字符往左上走,不等就往值大的那边走,最后把收集的字符反转。所以要输出序列就别急着压成一维。
压成一维数组时,左上角的值去哪了?
会被同一行刚算出来的值覆盖掉,要用一个变量
prev在覆盖前先存下来:const temp = dp[j]; dp[j] = ... prev + 1 ...; prev = temp,每行开头把prev重置成0。如果题目改成最长公共子串呢?
子串要连续,字符相等时
dp[i][j] = dp[i-1][j-1] + 1,不等直接归0,答案是整张表的最大值,不是右下角。只改了一句,但意义完全不同。git diff这类文本比对和这题有关系吗?有,比对两份文件的行,本质就是找最长公共子序列,剩下的行就是增删。实际工具用的是
Myers算法,比O(mn)的DP快很多,但思路是一脉相承的。
# 87 编辑距离
⚡ 30 秒速记
dp[i][j]= 把source前i个字符变成target前j个字符的最少操作数- 字符相等 → 直接继承左上
dp[i-1][j-1],不花操作 - 不等 →
1 + min(上=删除, 左=插入, 左上=替换) - 首列
dp[i][0] = i(全删),首行dp[0][j] = j(全插) - 时间空间
O(mn),空间可压到一维;horse → ros答案是3
编辑距离就是问把一个字符串改成另一个,最少要几次增、删、改。 定义 dp[i][j] 是前 i 个字符变成前 j 个字符的最少步数。最后一位相同就不用动,直接等于左上角;不同就三选一:删掉 source 这一位看上面,给它补一个字符看左边,把它替换掉看左上,取最小再加一。边界别写错,变成空串要删 i 次,从空串变过来要插 j 次。拼写纠错、搜索的模糊匹配用的都是这个思路。
# 题目与解题思路
独立实现「编辑距离」。dp[i][j] 表示两个前缀的最少操作数,字符不同时从删除、插入、替换三种来源取最小值加一。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function editDistance(source, target) { // 定义本题的核心实现
const dp = Array.from({ length: source.length + 1 }, (_, row) => new Array(target.length + 1).fill(0).map((value, column) => row ? value : column)) // 初始化当前步骤需要的状态
for (let row = 1; row <= source.length; row += 1) { // 遍历仍需处理的候选状态
dp[row][0] = row // 执行当前语句
for (let column = 1; column <= target.length; column += 1) { // 遍历仍需处理的候选状态
if (source[row - 1] === target[column - 1]) dp[row][column] = dp[row - 1][column - 1] // 检查当前分支条件
else dp[row][column] = 1 + Math.min(dp[row - 1][column], dp[row][column - 1], dp[row - 1][column - 1]) // 处理另一种分支
} // 结束当前代码块
} // 结束当前代码块
return dp[source.length][target.length] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(mn)。
- 示例:horse 转换为 ros 的编辑距离为 3。
- 易错点:首行首列分别表示把字符串变为空串所需的连续删除或插入次数。
💬 面试官追问
为什么「上边」代表删除,「左边」代表插入?
dp[i-1][j]是source少一个字符时已经对齐了target前j位,所以多出来的那个source[i-1]删掉就行。dp[i][j-1]是已经对齐了target前j-1位,再插一个target[j-1]就补齐了。字符相等时,为什么不用再和删除、插入比一下取最小?
可以证明
dp[i-1][j-1]一定不大于另外两条路加一,所以直接取它就是最优。写成min三个也不会错,只是多算一点。搜索框要做「你是不是想搜某个词」,词库有十万个词,直接对每个词跑编辑距离行吗?
太慢了,每次输入要算十万次
O(mn)。一般只算距离不超过2的,可以提前终止:某一行最小值已经超过阈值就停;再配合按长度、首字母先过滤,或者上BK树这类结构。用一维数组压缩时要注意什么?
和最长公共子序列一样,左上角会被覆盖,要用变量
prev存住;每行开头dp[0]要设成i,别忘了这一步,不然首列边界就丢了。
# 88 不同路径
⚡ 30 秒速记
- 只能向右或向下 → 走到某格的路径数 = 上面格子 + 左边格子
- 第一行、第一列都只有
1种走法,所以一维数组初始化全1 - 一维滚动:
dp[col] += dp[col - 1],加号前的dp[col]是上一行(上方),dp[col - 1]是本行刚算的(左方) - 组合数解法:总共走
m + n - 2步,选m - 1步向下,C(m+n-2, m-1) - 时间
O(mn)、空间O(n);网格大了组合数会超Number.MAX_SAFE_INTEGER,换BigInt
不同路径就一句话:每个格子只能从上面或左边走过来,所以到这格的路径数等于上面加左边。 第一行和第一列只有一条路,全是 1。用一维数组滚动的话,dp[col] += dp[col - 1] 这一句很巧:加之前 dp[col] 还是上一行的值,也就是上方,dp[col - 1] 已经是本行更新过的,也就是左方。比如 3×7 的网格答案是 28。这题也能直接用组合数算,但数大了会溢出,DP 写起来更稳。
# 题目与解题思路
独立实现「不同路径」。一维 DP 从左到右累加,dp[column] 同时代表来自上方的路径数,更新后代表上方加左方。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function uniquePaths(rows, columns) { // 定义本题的核心实现
const dp = new Array(columns).fill(1) // 初始化当前步骤需要的状态
for (let row = 1; row < rows; row += 1) { // 遍历仍需处理的候选状态
for (let column = 1; column < columns; column += 1) { // 遍历仍需处理的候选状态
dp[column] += dp[column - 1] // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return dp[columns - 1] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(n)。
- 示例:3×7 网格共有 28 条不同路径。
- 易错点:第一行和第一列只有一种走法;组合公式可能溢出 Number 安全整数。
💬 面试官追问
能不能不用
DP,直接算出来?能。从左上到右下一共走
m + n - 2步,其中m - 1步向下,答案就是C(m+n-2, m-1)。边乘边除算,result = result * (n - 1 + i) / i,每一步都是整数,不会出现小数。组合数解法什么时候会算错?
结果超过
2^53 - 1之后Number就不精确了,比如m = n = 30左右就开始出问题。要么换BigInt,要么题目会让你对1e9 + 7取模。一维数组为什么从左往右更新,不能从右往左?
因为要的是「本行左边」的新值,从左往右算到
col时,dp[col - 1]已经是本行的结果。反过来扫,拿到的就是上一行的旧值,路径数会算少。空间还能再省吗?
可以让数组长度取
min(m, n),把短的那条边当列。再少就只有组合数公式了,O(1)空间。
# 89 带障碍物的不同路径
⚡ 30 秒速记
- 和不同路径一样是「上 + 左」,多一条:障碍格路径数直接置
0 - 一维数组:
dp[0]先看起点是不是障碍;遇到障碍dp[col] = 0,否则dp[col] += dp[col - 1] - 第一列不能整列初始化成
1:第一列某格有障碍,它下面全是0 - 起点或终点是障碍 → 直接
0 - 时间
O(mn)、空间O(n);3×3中间一个障碍答案是2
带障碍的版本只比普通版多一个判断:遇到障碍,这格的路径数清零,别的格子照样是上面加左边。 用一维数组扫的话,障碍格写成 0,普通格累加左边,col = 0 的时候不加,它只继承上方的值。这样第一列一旦碰到障碍,下面就一直是 0,不用单独处理。最常见的错是照搬普通版,把第一行第一列全初始化成 1,障碍后面那一段就多算了。
# 题目与解题思路
独立实现「带障碍物的不同路径」。一维 DP 扫描网格,障碍格清零,普通格累加左侧路径数。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function uniquePathsWithObstacles(grid) { // 定义本题的核心实现
const dp = new Array(grid[0].length).fill(0) // 初始化当前步骤需要的状态
dp[0] = grid[0][0] ? 0 : 1 // 执行当前语句
for (const row of grid) { // 遍历仍需处理的候选状态
for (let column = 0; column < row.length; column += 1) { // 遍历仍需处理的候选状态
if (row[column]) dp[column] = 0 // 检查当前分支条件
else if (column) dp[column] += dp[column - 1] // 处理另一种分支
} // 结束当前代码块
} // 结束当前代码块
return dp.at(-1) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(n)。
- 示例:3×3 中央有障碍时共有 2 条路径。
- 易错点:起点或终点是障碍时结果为零;障碍后同一行的状态不能沿用旧值。
💬 面试官追问
普通版第一行全填
1,这题为什么不行?第一行中间有个障碍的话,障碍右边那些格子根本到不了,应该是
0。所以这里只设dp[0],第一行其他格子靠「左边累加」自然算出来,障碍一清零后面就跟着是0。col = 0那一格为什么不写dp[0] += ...?第一列只能从上方来,左边没有格子。代码里
else if (col)就是在跳过这一格,它保留上一行的值,碰到障碍才会被清零。假设题目改成可以向右、向下、向右下三个方向走,怎么改?
多一个来源,
dp[i][j] = 上 + 左 + 左上。一维滚动就要像编辑距离那样,用一个变量把左上角存下来,不然会被覆盖。网格是
100×100,要求对1e9 + 7取模,你会怎么写?每次累加后
% MOD,比如dp[col] = (dp[col] + dp[col - 1]) % MOD。两个小于1e9 + 7的数相加不会超过安全整数,Number就够,乘法才需要考虑BigInt。
# 90 判断子序列
⚡ 30 秒速记
- 双指针:扫一遍长串,碰到和短串当前字符相等就把短串指针往前挪
- 短串指针走到头 → 是子序列;长串扫完还没走到头 → 不是
- 贪心为什么对:能匹配就尽早匹配,给后面留的空间只会更多
- 空串永远是任何串的子序列,要先返回
true - 时间
O(m + n)、空间O(1);海量查询时预处理长串,每次查询二分
判断子序列用双指针就够了:一个指针扫原串,一个指针指着待匹配串当前要找的字符,相等就往前走一步。 扫完原串,看待匹配指针是不是走到了末尾。为什么尽早匹配就对?因为早一点匹配上,后面剩下的字符只会更多,不会让结果变差。比如 abc 在 ahbgdc 里能依次找到 a、b、c,是子序列;axc 找不到 x,不是。注意空串要返回 true,循环外最后那句 return matched === candidate.length 正好兜住这个情况。
# 题目与解题思路
独立实现「判断子序列」。用一个指针扫描待匹配串,另一个指针扫描原串,字符相等时才推进待匹配指针。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isSubsequence(candidate, source) { // 定义本题的核心实现
let matched = 0 // 初始化当前步骤需要的状态
for (const character of source) { // 遍历仍需处理的候选状态
if (character === candidate[matched]) matched += 1 // 检查当前分支条件
if (matched === candidate.length) return true // 检查当前分支条件
} // 结束当前代码块
return matched === candidate.length // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(m+n),空间 O(1)。
- 示例:abc 是 ahbgdc 的子序列,axc 不是。
- 易错点:子序列保持相对顺序但不要求连续;空待匹配串永远是子序列。
💬 面试官追问
原串固定,有
10万个短串要逐个判断,怎么优化?先预处理原串,记下每个字符出现的所有下标,比如
pos['a'] = [0, 5, 9]。查询时对每个字符在下标数组里二分找第一个大于当前位置的,单次查询变成O(k log n),不用每次都扫原串。如果
candidate是空串,你这段代码返回什么?循环里第一次就满足
matched === candidate.length,返回true;原串也是空的话会走到最后那句,同样是true。行为对,但我面试时会主动说一句空串是子序列。这题和最长公共子序列有什么关系?
s是t的子序列,等价于LCS(s, t) === s.length。但那样是O(mn),双指针O(m + n)就够,没必要上DP。字符串里有
emoji,for...of和下标访问会不会对不上?会。
for...of按码点遍历,candidate[matched]按UTF-16码元取,emoji占两个码元就对不上了。要处理这种输入,先Array.from把两个串都转成码点数组再比。
# 91 不同的子序列数量
⚡ 30 秒速记
- 问的是
source里有多少种删法能得到target,是计数DP dp[j]= 当前扫过的source前缀能凑出target前j个字符的方案数dp[0] = 1:凑空串只有一种方法,就是什么都不选- 当前字符等于
target[j-1]→dp[j] += dp[j-1](用它 / 不用它两种情况相加) - 一维必须从右往左更新,不然同一个字符会被用两次;
rabbbit → rabbit答案是3
这题是在问 source 删掉若干字符后变成 target 有多少种删法。 dp[j] 表示到目前为止能凑出 target 前 j 个字符的方案数。每扫到一个 source 字符,如果它等于 target[j-1],就有两种选择:不用它,方案数是原来的 dp[j];用它来匹配第 j 位,方案数是 dp[j-1],两者加起来。dp[0] 一定是 1,不然后面全是 0。压成一维时要从右往左更新,和 0/1 背包是一个道理。
# 题目与解题思路
独立实现「不同的子序列数量」。dp[j] 表示当前源串前缀组成目标前 j 个字符的方案数,逆序更新避免重复使用当前字符。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function countDistinctSubsequences(source, target) { // 定义本题的核心实现
const dp = new Array(target.length + 1).fill(0) // 初始化当前步骤需要的状态
dp[0] = 1 // 执行当前语句
for (const sourceCharacter of source) { // 遍历仍需处理的候选状态
for (let index = target.length; index > 0; index -= 1) { // 遍历仍需处理的候选状态
if (sourceCharacter === target[index - 1]) dp[index] += dp[index - 1] // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
return dp[target.length] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(n)。
- 示例:rabbbit 组成 rabbit 有 3 种方式。
- 易错点:dp[0] 必须为 1;一维压缩时必须从右向左更新。
💬 面试官追问
一维数组从左往右更新会怎么样?
dp[j-1]已经被当前字符更新过了,相当于同一个字符既匹配了第j-1位又匹配了第j位。比如source = 'bb'、target = 'bb',正确答案是1,从左往右扫会算成3。为什么
dp[0]要初始化成1而不是0?它代表「凑出空串」的方案数,什么都不选就是一种。它是所有计数的源头,设成
0的话后面加来加去全是0。方案数很大会溢出,怎么处理?
题目一般会要求取模,每次累加
% (1e9 + 7)。如果不让取模又要精确结果,就换BigInt,代价是慢不少。能不能提前剪枝?
source剩下的长度不够凑target剩下的长度时,这部分肯定没方案。一个简单的判断是source.length < target.length直接返回0,也省掉一轮计算。
# 92 零钱兑换 II
⚡ 30 秒速记
- 完全背包求组合数:
dp[v]= 凑出金额v的组合数,dp[0] = 1 - 外层硬币、内层金额,金额正序 → 每种硬币可以用多次,且组合按硬币顺序只生成一次
- 外层金额、内层硬币 → 算出来的是排列数,
1+2和2+1被当成两种 - 转移:
dp[v] += dp[v - coin] - 时间
O(amount × n),空间O(amount);amount = 5, coins = [1, 2, 5]答案是4
零钱兑换 II 求的是组合数,关键是循环顺序:外层遍历硬币,内层遍历金额。 这样每处理完一种硬币,dp 里存的就是「只用前几种硬币」的组合数,1+2 和 2+1 都只会按「先 1 后 2」的顺序被数一次。金额从小到大正序扫,是因为同一种硬币可以用无限次,dp[v - coin] 里已经包含了用过这枚硬币的情况。要是两层循环反过来,算出来就是排列数,amount = 3, coins = [1, 2] 会从 2 变成 3。
# 题目与解题思路
独立实现「零钱兑换 II」。外层遍历硬币、内层正序遍历金额,让每种组合只按固定硬币顺序生成一次。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function coinChangeCombinations(amount, coins) { // 定义本题的核心实现
const dp = new Array(amount + 1).fill(0) // 初始化当前步骤需要的状态
dp[0] = 1 // 执行当前语句
for (const coin of coins) { // 遍历仍需处理的候选状态
for (let value = coin; value <= amount; value += 1) { // 遍历仍需处理的候选状态
dp[value] += dp[value - coin] // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return dp[amount] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(amount·n),空间 O(amount)。
- 示例:amount=5、coins=[1,2,5] 有 4 种组合。
- 易错点:外层与内层顺序决定统计组合还是排列;dp[0] 必须初始化为 1。
💬 面试官追问
把两层循环换过来,
amount = 3, coins = [1, 2]结果会变成多少?从
2变成3。组合是{1,1,1}、{1,2}两种;换顺序后1+2和2+1分别计数,就是爬楼梯那类排列问题了。每种硬币只能用一次,代码怎么改?
变成
0/1背包,内层金额改成倒序:for (let v = amount; v >= coin; v--)。倒序保证dp[v - coin]还是上一轮的值,这枚硬币不会被重复用。和零钱兑换
I有什么区别?I问最少几枚,dp[v] = Math.min(dp[v], dp[v - coin] + 1),初始化成Infinity,dp[0] = 0;II问有多少种组合,是累加,dp[0] = 1。一个求最值一个计数,初始化完全不同。amount = 0应该返回什么?返回
1,什么硬币都不拿也是一种凑法,dp[0] = 1直接就是答案。有人写成返回0,就和dp[0]的定义自相矛盾了。
# 93 使用最小花费爬楼梯
⚡ 30 秒速记
dp[i]= 到达第i级的最小花费,楼顶是下标n,不是最后一级n - 1- 可以从第
0或第1级起步 →dp[0] = dp[1] = 0 - 转移:
dp[i] = min(dp[i-1] + cost[i-1], dp[i-2] + cost[i-2]),踩上某级才付那级的钱 - 只依赖前两项 → 两个变量滚动,空间
O(1) [10, 15, 20]答案是15:从第1级起步,付15直接跨到楼顶
这题的坑在题意:楼顶在最后一级的上面,而且你踩在哪级台阶上就要付哪级的钱。 我定义 dp[i] 是到达第 i 级的最小花费,起点可以选第 0 或第 1 级,所以这两个都是 0。到第 i 级要么从 i-1 迈一步,付 cost[i-1],要么从 i-2 跨两步,付 cost[i-2],取小的那个。答案是 dp[n],不是 dp[n-1]。因为只依赖前两项,两个变量来回倒就够了。
# 题目与解题思路
独立实现「使用最小花费爬楼梯」。滚动保存到达前两级台阶的最低花费,当前状态取两种来源的较小值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minCostClimbingStairs(costs) { // 定义本题的核心实现
let twoBack = 0 // 初始化当前步骤需要的状态
let oneBack = 0 // 初始化当前步骤需要的状态
for (let level = 2; level <= costs.length; level += 1) { // 遍历仍需处理的候选状态
const current = Math.min(oneBack + costs[level - 1], twoBack + costs[level - 2]) // 初始化当前步骤需要的状态
twoBack = oneBack // 执行当前语句
oneBack = current // 执行当前语句
} // 结束当前代码块
return oneBack // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[10,15,20] 的最低花费为 15。
- 易错点:可以从第 0 或第 1 级起步,目标是楼顶而不是最后一阶本身。
💬 面试官追问
有人返回
dp[n-1],[10, 15, 20]会算出多少?会算出
10,那是到达最后一级台阶的花费,还没付这级的钱,也没上楼顶。正确答案是15,楼顶是下标n。另一种写法是
dp[i]表示「离开第i级」的花费,两种定义有什么区别?那样
dp[i] = cost[i] + min(dp[i-1], dp[i-2]),答案是min(dp[n-1], dp[n-2])。两种都对,关键是状态定义要和答案对得上,混着写就会差一级。假设可以一次跨
1~k级,怎么改?转移变成从前
k个状态里取最小,直接写是O(nk)。k大的话用单调队列维护窗口最小值,能降到O(n)。cost只有一个元素,你的代码返回什么?循环不执行,返回
0,因为从第1级起步就已经在楼顶了。题目一般保证长度至少为2,但我会提一下这个边界。
# 94 环形房屋打家劫舍
⚡ 30 秒速记
- 环形 = 第一间和最后一间不能同时偷
- 拆成两次线性打家劫舍:
[0, n-2]不含最后一间,[1, n-1]不含第一间,取较大值 - 线性部分:
cur = max(cur, prev + nums[i]),两个变量滚动 - 只有一间房要单独返回
nums[0],否则两个区间都是空的 - 传下标区间别
slice,空间保持O(1);[2, 3, 2]答案是3
环形版的难点只有一个:首尾相邻,不能同时偷,所以我把它拆成两个普通版本。 一次不考虑最后一间,一次不考虑第一间,两个结果取大的。这两种情况覆盖了所有合法方案,因为首尾至少有一间不偷。每个线性版本就是经典的「偷这间就加上前前间的结果,不偷就继承前一间」,两个变量滚动。要注意只有一间房时两个区间都是空的,得单独返回。区间我用起止下标传进去,不用 slice 复制数组。
# 题目与解题思路
独立实现「环形房屋打家劫舍」。首尾不能同时选择,把问题拆成不含首项与不含尾项的两个线性打家劫舍。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function robCircular(houses) { // 定义本题的核心实现
if (houses.length === 1) return houses[0] // 检查当前分支条件
const solve = (start, end) => { // 初始化当前步骤需要的状态
let previous = 0 // 初始化当前步骤需要的状态
let current = 0 // 初始化当前步骤需要的状态
for (let index = start; index < end; index += 1) { // 遍历仍需处理的候选状态
;[previous, current] = [current, Math.max(current, previous + houses[index])] // 执行当前语句
} // 结束当前代码块
return current // 返回本题要求的结果
} // 结束当前代码块
return Math.max(solve(0, houses.length - 1), solve(1, houses.length)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,3,2] 返回 3,[1,2,3,1] 返回 4。
- 易错点:单个房屋需要直接返回;切片会产生 O(n) 空间,可改为传索引区间。
💬 面试官追问
为什么拆成「不含首」和「不含尾」两种就能覆盖所有情况?
合法方案里首尾最多偷一个,要么首没偷,要么尾没偷,必然落进其中一个区间。两种情况有重叠(首尾都不偷)也没关系,求的是最大值,重复算不影响结果。
只有一间房时不特判会怎样?
solve(0, 0)和solve(1, 1)都是空区间,返回0,但正确答案是nums[0]。这个边界面试官很爱问。;[previous, current] = [current, ...]这种写法有什么要注意的?解构赋值右边先求值,所以
previous + houses[index]用的是旧的previous,逻辑是对的。行首那个分号是防止上一行没写分号时被拼成函数调用,不写分号的代码风格里要留着。要你同时返回偷了哪几间,怎么做?
滚动变量就不够了,要保留完整的
dp数组,从后往前看dp[i]是不是来自dp[i-2] + nums[i],是就记下第i间,跳到i-2。两个区间分别回溯,取结果大的那个。
# 95 二叉树打家劫舍
⚡ 30 秒速记
- 每个节点返回两个值
[不偷, 偷],后序遍历自底向上算 - 偷当前节点 → 两个孩子都不能偷:
node.val + left[0] + right[0] - 不偷当前节点 → 孩子偷不偷随意:
max(...left) + max(...right) - 隔层求和是错的,最优解可能跨层挑节点
- 时间
O(n)、递归栈O(h);树退化成链时h = n,可能爆栈
树形打家劫舍的关键是每个节点返回两个值:不偷它时子树的最大收益,和偷它时的最大收益。 偷当前节点,两个孩子都只能取「不偷」的值;不偷当前节点,孩子偷不偷各自取大的。用后序遍历,先拿到左右孩子的结果再算自己,每个节点只算一次,O(n)。很多人第一反应是奇数层和偶数层比谁大,这是错的,比如根偷了,下一层不偷,再下一层也可以选择不偷。
# 题目与解题思路
独立实现「二叉树打家劫舍」。后序遍历每个节点,同时返回“不偷当前节点”和“偷当前节点”两种最优值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function robTree(root) { // 定义本题的核心实现
const visit = node => { // 初始化当前步骤需要的状态
if (!node) return [0, 0] // 检查当前分支条件
const left = visit(node.left) // 初始化当前步骤需要的状态
const right = visit(node.right) // 初始化当前步骤需要的状态
const skip = Math.max(...left) + Math.max(...right) // 初始化当前步骤需要的状态
const take = node.value + left[0] + right[0] // 初始化当前步骤需要的状态
return [skip, take] // 返回本题要求的结果
} // 结束当前代码块
return Math.max(...visit(root)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[3,2,3,null,3,null,1] 的最大收益为 7。
- 易错点:不能只做奇偶层求和;最优选择取决于每棵子树的局部结构。
💬 面试官追问
为什么不能直接比较奇数层之和和偶数层之和?
最优方案不一定按层整齐分开。比如一条链
[4, 1, 1, 5](从上到下),偷4和5得9,它们隔了两层;按奇偶层算只能得到5或6。用
Map做记忆化的「偷爷爷还是偷孙子」写法,和返回两个值的写法比,哪个好?记忆化也是
O(n),但要额外的Map,而且每个节点要访问孙子,代码啰嗦。返回[不偷, 偷]一次后序就搞定,不需要额外存储,我会写这个。树有十万个节点、退化成一条链,会怎样?
递归深度十万,
JS引擎调用栈一般只能撑一万层上下(看引擎和栈帧大小),会抛RangeError: Maximum call stack size exceeded。要改成迭代后序遍历,用显式栈存节点和处理状态。偷某个节点时,为什么孩子要取
left[0]而不是0?孩子不偷,不代表孩子整棵子树都不偷,孙子那一层还能偷。
left[0]就是「左孩子不偷时左子树的最大值」,已经把孙子的情况算进去了。
# 96 买卖股票的最佳时机 II
⚡ 30 秒速记
- 不限交易次数 → 把所有相邻两天的上涨都吃掉:
profit += max(0, p[i] - p[i-1]) - 为什么对:任何一段
低买高卖的收益都等于中间每天涨幅之和 - 这只是算总收益,不代表真的每天都在买卖
DP写法:hold、cash两个状态,是带手续费、冷冻期那几个变种的通用模板- 时间
O(n)、空间O(1);[7, 1, 5, 3, 6, 4]答案是7
可以无限次交易时,答案就是把所有上涨的相邻两天的差价加起来。 原因很简单:比如第 1 天买、第 3 天卖,收益 p3 - p1 等于 (p2 - p1) + (p3 - p2),所以一段连续上涨拆成每天算结果一样,下跌的那天不碰就行。[7, 1, 5, 3, 6, 4] 吃掉 1→5 和 3→6 两段,正好 7。贪心写法最短,但我面试时会顺便说一下 hold / cash 两状态的 DP,因为加手续费、加冷冻期这些变种都得用它。
# 题目与解题思路
独立实现「买卖股票的最佳时机 II」。允许多次交易时累加所有相邻上涨差值,等价于每天结束都持有局部最优状态。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function maxProfitUnlimited(prices) { // 定义本题的核心实现
let profit = 0 // 初始化当前步骤需要的状态
for (let day = 1; day < prices.length; day += 1) { // 遍历仍需处理的候选状态
profit += Math.max(0, prices[day] - prices[day - 1]) // 执行当前语句
} // 结束当前代码块
return profit // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[7,1,5,3,6,4] 最大利润为 7。
- 易错点:同一天不能同时持有多份股票,但卖出后可再次买入;不需要寻找全局最低点。
💬 面试官追问
你这样每天都买卖,真实交易里行得通吗?
这个算法只是在算最大收益,不是交易方案。连续上涨的几天,每天卖了又买和第一天买最后一天卖收益一样,真要执行就合并成一次。
加上每笔交易手续费,贪心还能用吗?
不能直接用了,每天买卖一次会多扣好多次手续费。要换成
hold / cash状态机,卖出时扣fee,这就是第98题。用
DP写一下这题?cash = Math.max(cash, hold + p),hold = Math.max(hold, cash - p),初始hold = -prices[0]、cash = 0。这里两句顺序可以不在乎,因为同一天先卖再买对结果没影响。如果加个冷冻期,卖出后第二天不能买,怎么改?
买入时要用前天的
cash:hold = Math.max(hold, prevCash - p),所以要多存一个上一轮的cash。状态从两个变成三个也行:持有、刚卖出(冷冻中)、空仓可买。
# 97 最多两次买卖股票
⚡ 30 秒速记
- 四个状态:第一次买入后、第一次卖出后、第二次买入后、第二次卖出后的最大余额
b1 = max(b1, -p),s1 = max(s1, b1 + p),b2 = max(b2, s1 - p),s2 = max(s2, b2 + p)- 同一天按顺序更新没问题:同一天买了又卖收益是
0,不会让结果变大 - 只做一次或不做也包含在内:
s2 >= s1 >= 0 - 时间
O(n)、空间O(1);推广到k次就开k组buy / sell数组
最多两次交易,就是维护四个状态:第一次买入后、第一次卖出后、第二次买入后、第二次卖出后手里最多有多少钱。 每天按顺序更新这四个值,第一次买入是 -price,卖出是加 price,第二次买入要从第一次卖出后的钱里扣。有人担心同一天里先更新了 b1 又拿它去算 s1,其实没关系,同一天买了又卖收益是 0,不会凭空多赚。最后返回 s2,它已经包含了只交易一次和不交易的情况。
# 题目与解题思路
独立实现「最多两次买卖股票」。维护第一次买入、第一次卖出、第二次买入、第二次卖出四个状态并按天更新。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function maxProfitTwice(prices) { // 定义本题的核心实现
let firstBuy = -Infinity // 初始化当前步骤需要的状态
let firstSell = 0 // 初始化当前步骤需要的状态
let secondBuy = -Infinity // 初始化当前步骤需要的状态
let secondSell = 0 // 初始化当前步骤需要的状态
for (const price of prices) { // 遍历仍需处理的候选状态
firstBuy = Math.max(firstBuy, -price) // 执行当前语句
firstSell = Math.max(firstSell, firstBuy + price) // 执行当前语句
secondBuy = Math.max(secondBuy, firstSell - price) // 执行当前语句
secondSell = Math.max(secondSell, secondBuy + price) // 执行当前语句
} // 结束当前代码块
return secondSell // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[3,3,5,0,0,3,1,4] 最大利润为 6。
- 易错点:状态更新顺序要保持同一天转移语义一致;少于两次交易也应被允许。
💬 面试官追问
同一天里
b1刚更新完,s1就用了新值,为什么不算错?相当于允许同一天买了又卖,收益是
0,s1不会因此变大,所以结果和用旧值一样。用临时变量保存旧值也对,就是多几行。为什么返回
s2而不是max(s1, s2)?b2可以在s1那天立刻买,s2可以同一天卖,等于第二次交易是空操作,所以s2至少等于s1。直接返回s2就够了。推广到最多
k次交易,怎么写?开两个长度
k + 1的数组buy[j]、sell[j],每天对j = 1..k做buy[j] = max(buy[j], sell[j-1] - p)、sell[j] = max(sell[j], buy[j] + p)。k >= n / 2时等于不限次数,直接用贪心。还有一种思路是左右各扫一遍,是怎么回事?
left[i]是前i天一次交易的最大收益,right[i]是从第i天往后一次交易的最大收益,答案是max(left[i] + right[i])。也是O(n),但要O(n)空间,状态机写法更省。
# 98 含手续费的股票买卖
⚡ 30 秒速记
- 两个状态:
hold= 手里有股票时的最大余额,cash= 空仓时的最大余额 cash = max(cash, hold + p - fee),hold = max(hold, cash - p),手续费只在卖出时扣- 手续费只扣一次:买入扣或卖出扣都行,别两边都扣
- 更新
hold用旧cash最稳,不过这里用新cash也不会出错(同一天卖了又买只会亏fee) - 时间
O(n)、空间O(1);[1, 3, 2, 8, 4, 9], fee = 2答案是8
有手续费时贪心不好使了,要用两个状态:持有股票和不持有股票时,手里最多有多少钱。 每天更新一次:不持有的状态要么保持,要么今天把股票卖了,卖的时候扣一次手续费;持有的状态要么保持,要么今天用空仓的钱买入。最后返回 cash。比如 [1, 3, 2, 8, 4, 9] 加 fee = 2,最优是 1 买 8 卖赚 5,4 买 9 卖赚 3,合计 8;中间 3→2 那点小波动不值得为它多付一次手续费。
# 题目与解题思路
独立实现「含手续费的股票买卖」。维护持有与空仓两种状态,在卖出转移时统一扣除手续费。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function maxProfitWithFee(prices, fee) { // 定义本题的核心实现
let hold = -Infinity // 初始化当前步骤需要的状态
let cash = 0 // 初始化当前步骤需要的状态
for (const price of prices) { // 遍历仍需处理的候选状态
const previousCash = cash // 初始化当前步骤需要的状态
cash = Math.max(cash, hold + price - fee) // 执行当前语句
hold = Math.max(hold, previousCash - price) // 执行当前语句
} // 结束当前代码块
return cash // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[1,3,2,8,4,9]、fee=2 的最大利润为 8。
- 易错点:手续费只能扣一次;更新持有状态时要使用更新前的 cash。
💬 面试官追问
为什么
[1, 3, 2, 8]里1→3那段不单独卖?1→3赚2,扣完fee = 2等于白干,还不如一直拿到8。状态机会自己算出这个结果,不用手动判断哪段值得卖。代码里存了
previousCash,不存直接用新的cash会错吗?这题不会错。新的
cash如果是今天卖出得来的,再用它买入就是同一天卖了又买,白亏一次fee,hold不会因此变大。存旧值的写法语义更清楚,冷冻期那题就必须用旧值。hold初始化成-Infinity和-prices[0]有区别吗?结果一样。
-Infinity表示第一天之前不可能持有,第一轮会被cash - price更新成-prices[0]。注意-Infinity + price还是-Infinity,不会出现NaN。手续费放到买入时扣,代码怎么改?
hold = max(hold, cash - p - fee),cash = max(cash, hold + p)。两种放法结果一样,只要每笔交易只扣一次。
# 99 最长连续递增子序列
⚡ 30 秒速记
- 子序列要求连续 → 其实就是最长连续递增子数组
- 一个变量记「以当前位置结尾的递增长度」:比前一个大就
+1,否则重置为1 - 另一个变量记全局最大值
- 和
LIS别搞混:LIS不要求连续,要用O(n²)DP或O(n log n)的二分 - 时间
O(n)、空间O(1);空数组返回0,[1, 3, 5, 4, 7]答案是3
这题要求连续,所以扫一遍就够了:比前一个数大,当前长度加一;不大,就从 1 重新开始。 一边扫一边更新最大值,[1, 3, 5, 4, 7] 里 1, 3, 5 长度是 3,到 4 断开重置,4, 7 只有 2,答案是 3。注意「递增」是严格大于,相等也要断开。这题经常被拿来和最长递增子序列对比,那个不要求连续,就不能这么简单地重置了。
# 题目与解题思路
独立实现「最长连续递增子序列」。线性扫描并维护以当前位置结尾的连续递增长度,断开时重置为一。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findLengthOfLcis(numbers) { // 定义本题的核心实现
if (!numbers.length) return 0 // 检查当前分支条件
let current = 1 // 初始化当前步骤需要的状态
let best = 1 // 初始化当前步骤需要的状态
for (let index = 1; index < numbers.length; index += 1) { // 遍历仍需处理的候选状态
current = numbers[index] > numbers[index - 1] ? current + 1 : 1 // 执行当前语句
best = Math.max(best, current) // 执行当前语句
} // 结束当前代码块
return best // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[1,3,5,4,7] 的最长连续递增长度为 3。
- 易错点:它要求连续,不能使用普通 LIS 的二分尾数组替代题意。
💬 面试官追问
[2, 2, 2]答案是多少?1,严格递增,相等就断开。如果题目改成「非递减」,判断就换成>=,答案变成3。如果不要求连续,这段代码还能用吗?
不能,那是
LIS。[1, 3, 2, 4]用这段代码得2,正确答案是3(1, 3, 4或1, 2, 4)。LIS要用dp[i] = max(dp[j] + 1)或者贪心加二分。要返回那段子数组本身,怎么改?
重置时记下新起点
start = i,更新best时同时存bestStart = start,最后nums.slice(bestStart, bestStart + best)。空数组和只有一个元素,分别返回什么?
空数组
0,一个元素1。代码开头那句if (!numbers.length) return 0就是防止空数组返回1。
# 100 斐波那契数
⚡ 30 秒速记
- 朴素递归
fib(n - 1) + fib(n - 2)是O(2^n),同一个子问题被算了无数遍 - 记忆化或迭代 →
O(n);只保留前两项滚动 → 空间O(1) - 约定
F(0) = 0、F(1) = 1,F(10) = 55 F(78)之后超过Number.MAX_SAFE_INTEGER,要精确就用BigInt- 要求
O(log n):矩阵快速幂或快速倍增
斐波那契最直接的递归写法会重复算大量子问题,fib(40) 就要三亿多次调用,所以要么记忆化,要么从小往大迭代。 迭代只需要前两项,两个变量滚动就行,时间 O(n) 空间 O(1)。还有两个能加分的点:一是 Number 在 F(79) 就超过安全整数了,要精确结果得用 BigInt;二是题目要求 n 特别大并且取模时,可以用矩阵快速幂做到 O(log n)。
# 题目与解题思路
独立实现「斐波那契数」。只保留前两项滚动计算下一项,避免递归产生大量重复子问题。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function fibonacci(n) { // 定义本题的核心实现
if (n < 2) return n // 检查当前分支条件
let previous = 0 // 初始化当前步骤需要的状态
let current = 1 // 初始化当前步骤需要的状态
for (let index = 2; index <= n; index += 1) { // 遍历仍需处理的候选状态
;[previous, current] = [current, previous + current] // 执行当前语句
} // 结束当前代码块
return current // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:F(10)=55。
- 易错点:要明确 F(0)=0、F(1)=1;大 n 会超过 Number 安全整数,应使用 BigInt。
💬 面试官追问
朴素递归为什么这么慢,
fib(40)大概调用多少次?每次分两支,大量子问题重复计算,调用次数和结果本身同一个数量级,
fib(40)大约三亿次调用。加个memo数组,每个n只算一次就降到O(n)。fibonacci(100)用这段代码算对吗?不对,
F(79)开始超过2^53 - 1,后面的结果都是近似值。改成let previous = 0n, current = 1n,全程BigInt运算,返回值就是精确的。n是10^18,要求对1e9 + 7取模,怎么算?用矩阵
[[1, 1], [1, 0]]的n次方,快速幂O(log n)次矩阵乘法。注意中间两个接近1e9的数相乘会超安全整数,要用BigInt做乘法再取模。记忆化递归和迭代,你会选哪个?
迭代。记忆化也是
O(n),但递归深度是n,n上万就可能栈溢出,还多一个缓存数组。只在状态转移比较复杂、自顶向下更好写的时候才用记忆化。
# 101 二叉树最小深度
⚡ 30 秒速记
- 最小深度 = 根到最近叶子节点的节点数,叶子是左右孩子都为空
BFS按层走,第一个遇到的叶子所在层就是答案,可以提前返回- 递归坑:只有一边子树时不能取
min(0, 另一边),空的那边不是路径 - 正确递归:缺一边就取另一边
+1,两边都有才min(left, right) + 1 - 时间
O(n);BFS空间O(w)(最宽一层),递归O(h)
最小深度是从根走到最近一个叶子节点经过的节点数,我更倾向用 BFS,一层一层往下找,碰到第一个叶子就直接返回。 这样树很深但有个浅叶子时,不用把整棵树都遍历完。用递归也可以,但有个经典的坑:根只有右子树时,左边深度是 0,直接取 min 就得到 1,可根本身不是叶子。所以缺一边子树时要取另一边的深度加一。比如 [3, 9, 20, null, null, 15, 7],9 是叶子,答案是 2。
# 题目与解题思路
独立实现「二叉树最小深度」。层序遍历按层推进,第一次遇到叶子节点时当前层数就是最小深度。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minDepth(root) { // 定义本题的核心实现
if (!root) return 0 // 检查当前分支条件
const queue = [root] // 初始化当前步骤需要的状态
for (let depth = 1; queue.length; depth += 1) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
for (let count = 0; count < size; count += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
if (!node.left && !node.right) return depth // 检查当前分支条件
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[3,9,20,null,null,15,7] 的最小深度为 2。
- 易错点:递归时只有一个子树存在不能取 0 与其深度的最小值;叶子必须左右孩子都为空。
💬 面试官追问
[1, null, 2]你的递归写法返回几?正确答案是
2,根不是叶子。如果写成Math.min(left, right) + 1,左边空返回0,就会错算成1,要改成「一边为空就取另一边+1」。最大深度用
max就没这个问题,为什么最小深度有?空子树深度
0,取max时它天然输给另一边,不影响结果;取min时它反而赢了,相当于把不存在的路径当成了最短路径。queue.shift()有什么性能问题?数组
shift要把后面的元素都往前挪,最坏O(n),节点多时整体可能退化到O(n²)。用一个下标head往前走代替shift,或者每层新建一个数组。什么时候
DFS反而比BFS好?树很宽的时候,
BFS队列要装下整层节点,比如满二叉树最后一层有n / 2个。DFS只占O(h)的栈,内存更省,代价是不能提前返回。
# 102 判断平衡二叉树
⚡ 30 秒速记
- 平衡 = 每个节点左右子树高度差不超过
1,所有节点都要满足,不只是根 - 后序遍历:先拿左右子树高度,再判断自己
- 用
-1表示「已经不平衡」,一路往上传,直接短路 - 自顶向下每个节点都重新求高度 →
O(n²);后序一次遍历 →O(n) - 递归栈
O(h);空树算平衡
判断平衡二叉树,我会写自底向上的版本:后序遍历求高度,一旦发现左右子树高度差超过 1,就返回 -1 往上传。 上层看到 -1 不用再算,直接也返回 -1,这样整棵树只遍历一次,O(n)。很多人写的是对每个节点调一次求高度函数再递归判断左右子树,同一棵子树的高度被反复计算,退化成链时是 O(n²)。另外要注意,平衡是每个节点都要满足,不是只看根的左右两边。
# 题目与解题思路
独立实现「判断平衡二叉树」。后序遍历返回子树高度,发现任一子树高度差超过一就用 -1 向上短路。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isBalanced(root) { // 定义本题的核心实现
const height = node => { // 初始化当前步骤需要的状态
if (!node) return 0 // 检查当前分支条件
const left = height(node.left) // 初始化当前步骤需要的状态
if (left < 0) return -1 // 检查当前分支条件
const right = height(node.right) // 初始化当前步骤需要的状态
if (right < 0 || Math.abs(left - right) > 1) return -1 // 检查当前分支条件
return Math.max(left, right) + 1 // 返回本题要求的结果
} // 结束当前代码块
return height(root) >= 0 // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[3,9,20,null,null,15,7] 返回 true。
- 易错点:若每个节点都重新求高度会退化为 O(n²);平衡要求所有节点都满足。
💬 面试官追问
只判断根节点左右子树高度差不超过
1,有什么反例?比如根左边挂一条长度
3的左链,右边挂一条长度3的右链。根这里差值是0,但左孩子的左子树高2、右子树高0,已经不平衡了。自顶向下的写法为什么是
O(n²)?每个节点都要调一次
height,height本身要遍历整棵子树。树退化成链时,第一层算n个节点,第二层算n-1个,加起来就是O(n²)。为什么用
-1而不是另外返回一个布尔值?高度不会是负数,
-1正好当哨兵,一个返回值同时表达高度和是否平衡,代码短,还能提前短路。返回{ height, balanced }也行,只是啰嗦一点。代码里左子树返回
-1就不算右子树了,有必要吗?有,这就是短路。左边已经不平衡,结果已经确定是
false,再去遍历右子树纯属浪费。
# 103 翻转二叉树
⚡ 30 秒速记
- 每个节点交换左右孩子,整棵树就镜像了
- 递归:先翻左右子树再交换,或者先交换再翻,都对
- 迭代:
BFS或DFS用队列 / 栈,每弹出一个节点交换它的左右孩子 - 原地修改会改掉入参;要保留原树就递归创建新节点
- 时间
O(n)、空间O(h);[4, 2, 7, 1, 3, 6, 9]→[4, 7, 2, 9, 6, 3, 1]
翻转二叉树就是把每个节点的左右孩子交换一下,递归下去整棵树就成了镜像。 代码里先递归拿到翻转好的左右子树,再交换挂回去,先交换再递归也一样,前序后序都行。中序要小心,交换之后原来的右子树跑到左边了,第二次递归还得走左边,不然有一半翻了两次等于没翻。树特别深的话递归可能爆栈,可以改成 BFS,用队列一层层交换。
# 题目与解题思路
独立实现「翻转二叉树」。递归翻转左右子树,再交换当前节点的左右孩子。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function invertTree(root) { // 定义本题的核心实现
if (!root) return null // 检查当前分支条件
const left = invertTree(root.left) // 初始化当前步骤需要的状态
const right = invertTree(root.right) // 初始化当前步骤需要的状态
root.left = right // 执行当前语句
root.right = left // 执行当前语句
return root // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[4,2,7,1,3,6,9] 翻转为 [4,7,2,9,6,3,1]。
- 易错点:若必须保持原树,应创建新节点而不是原地交换引用。
💬 面试官追问
用中序遍历翻转会出什么问题?
先翻左子树,交换,再翻右子树,这时候右边其实是原来已经翻过的左子树,又翻回去了,原来的右子树一次都没翻。要用中序就写成
invert(left); swap; invert(left)。写成
root.left = invertTree(root.right); root.right = invertTree(root.left)对吗?不对,第一句把
root.left改掉了,第二句拿到的已经是新值,结果左右两边都是原来的右子树。要先用const left、const right把两个结果存下来再赋值。不能改原树,要返回一棵新的镜像树,怎么写?
return node && { value: node.value, left: mirror(node.right), right: mirror(node.left) },每个节点新建一个对象,原树不动,空间变成O(n)。前端哪里会用到这种树的递归处理?
比如菜单、组织架构、评论这类树形数据,要镜像布局、过滤节点或者转换字段,写法都和这题一样:处理当前节点,再递归处理
children。层级很深的数据也要考虑改成迭代,避免栈溢出。
# 104 判断两棵二叉树是否相同
⚡ 30 秒速记
- 两棵树一起往下走,每一步比三件事:是不是都空、是不是只有一个空、值是不是相等
- 都空 →
true;只空一个或值不同 →false;否则左对左、右对右继续比 - 结构也算在「相同」里:
[1,2]和[1,null,2]值一样,位置不同就不同 - 时间
O(n),递归栈O(h),树退化成链时h = n,特别深的树改成队列迭代
判断两棵树相同,就是两个指针同步递归,每一对节点都必须「同时空」或者「值相同且左右子树都相同」。 写的时候顺序很重要:先处理两个都为空,再处理只有一个为空,最后才比值,不然会对 null 取 .value 直接报错。很多人只比了值序列,比如把两棵树都前序遍历一下再比数组,这是错的,[1,2] 和 [1,null,2] 前序结果都是 [1,2],但一个 2 在左、一个 2 在右。这题本身不难,它常常是「子树判断」那题的子函数,所以要写得干净。
# 题目与解题思路
独立实现「判断两棵二叉树是否相同」。同步递归两个节点:同时为空为真,仅一个为空或值不同为假,再比较左右子树。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isSameTree(left, right) { // 定义本题的核心实现
if (!left && !right) return true // 检查当前分支条件
if (!left || !right) return false // 检查当前分支条件
if (left.value !== right.value) return false // 检查当前分支条件
return isSameTree(left.left, right.left) && isSameTree(left.right, right.right) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[1,2,3] 与 [1,2,3] 相同,[1,2] 与 [1,null,2] 不同。
- 易错点:不仅要比较节点值,还要比较空节点所在位置所表达的结构。
💬 面试官追问
能不能两棵树都
JSON.stringify一下,比字符串?节点是纯对象、没有循环引用、字段顺序一致时确实能跑,因为空位会被序列化成
null。但它要整棵树序列化完才开始比,不能在第一处差异就提前退出,节点上挂了parent指针还会直接循环引用报错,面试里我不会这么写。只用前序遍历的值数组比较行不行?
不行,丢了空节点信息就丢了结构。
[1,2](2 是左孩子)和[1,null,2](2 是右孩子)前序都是[1,2]。要用遍历结果比,必须把空位也记下来,比如1,2,#,#,#。树深到十万层,递归栈溢出了,怎么改?
换成显式队列,每次放进去一对节点
[a, b],取出来按同样三条规则判断,再把[a.left, b.left]、[a.right, b.right]推进去。逻辑完全不变,只是栈从调用栈搬到了堆上。如果要判断「镜像对称」,代码改哪里?
只改最后一行的配对方式:左对右、右对左,
isMirror(a.left, b.right) && isMirror(a.right, b.left)。判断一棵树是否对称,就是isMirror(root.left, root.right)。
# 105 二叉树路径总和
⚡ 30 秒速记
- 从根往下走,每走一个节点就把目标减掉当前值,到叶子时看剩下的是不是正好等于叶子值
- 判定只能在叶子做:中间节点「凑够了」不算,路径必须走到底
- 空树直接
false,哪怕target是0 - 有负数也照样成立,所以不能「和已经超过目标就剪枝」
- 时间
O(n),递归栈O(h)
这题就是带着「还差多少」往下递归,走到叶子的时候看差值是否刚好等于叶子的值。 关键是「根到叶」这个约束:如果在中间节点发现已经凑够就返回 true,遇到 5→4 后面还挂着孩子的情况就会误判。另一个坑是剪枝,节点值可能是负数,前面超了后面还可能减回来,所以不能提前剪。实现上我用 || 连接左右子树,左边找到了右边就不用再算了。
# 题目与解题思路
独立实现「二叉树路径总和」。沿根到叶路径递减目标值,在叶子节点检查剩余目标是否等于当前值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function hasPathSum(root, target) { // 定义本题的核心实现
if (!root) return false // 检查当前分支条件
if (!root.left && !root.right) return root.value === target // 检查当前分支条件
const remaining = target - root.value // 初始化当前步骤需要的状态
return hasPathSum(root.left, remaining) || hasPathSum(root.right, remaining) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:目标 22 在 5→4→11→2 路径上命中。
- 易错点:必须在叶子处判定,不能在中间节点提前命中;负数节点同样适用。
💬 面试官追问
树只有一个根节点
5,target也是5,返回什么?空树、target为0呢?第一个返回
true,根本身就是叶子。空树返回false,因为根本没有根到叶的路径,这一点很多人会写成target === 0就返回true。能不能在路径和大于
target的时候直接剪掉这棵子树?只有题目保证所有值都非负才行。默认题目允许负数,
10 → -3 → 5这种路径前面已经超了,后面还能回到目标值,剪了就漏解。要把所有满足条件的路径都打印出来,怎么改?
加一个
path数组做回溯:进入节点push,到叶子且命中时把[...path]存进结果,离开节点pop。一定要存拷贝,不然最后结果里全是同一个被清空的数组。路径不要求从根开始、也不要求到叶子结束,只要向下就行,怎么做?
用前缀和 +
Map:记录从根到当前节点的前缀和出现次数,查map.get(prefix - target)就是以当前节点结尾的路径数,回溯时次数减一。复杂度从暴力的O(n²)降到O(n)。
# 106 二叉树最近公共祖先
⚡ 30 秒速记
- 后序递归:先问左右子树「你那边找到
p或q没有」,再决定当前节点返回什么 - 当前节点就是
p或q→ 直接返回自己;左右都非空 → 当前节点就是最近公共祖先 - 只有一边非空 → 把那一边的结果往上传
- 比较的是节点引用,不是值;题目没保证两个节点都在树里时,要额外数命中次数
- 如果是二叉搜索树,按值大小往一边走就行,
O(h)
最近公共祖先用后序递归,每个节点汇总左右子树的查找结果:两边都找到了,说明 p 和 q 分在自己两侧,自己就是答案。 只有一边找到,就把那边的结果原样往上交,它可能是 p 或 q 本身,也可能是已经找到的祖先。当前节点自己就是 p 时直接返回,不用往下找,因为另一个节点要么在它下面(答案就是它),要么在别处(上层会判断)。这个写法默认两个节点一定存在,题目不保证的话要改。
# 题目与解题思路
独立实现「二叉树最近公共祖先」。后序递归:当前节点命中目标就返回自己,左右都返回非空时当前节点就是最近公共祖先。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function lowestCommonAncestor(root, first, second) { // 定义本题的核心实现
if (!root || root === first || root === second) return root // 检查当前分支条件
const left = lowestCommonAncestor(root.left, first, second) // 初始化当前步骤需要的状态
const right = lowestCommonAncestor(root.right, first, second) // 初始化当前步骤需要的状态
if (left && right) return root // 检查当前分支条件
return left ?? right // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:在 [3,5,1,6,2,0,8] 中,5 与 1 的最近公共祖先是 3。
- 易错点:比较节点引用而非值;若题目不保证两节点都存在,需要额外记录命中数量。
💬 面试官追问
p是q的祖先,比如5和它下面的4,代码还对吗?对。递归到
5时直接返回5,不会再往下找4,上层只看到一边非空,最终答案就是5,正好符合定义:节点可以是自己的祖先。如果
q根本不在树里,这段代码会返回什么?会返回
p,这是错的。要改成递归时统计命中数量,或者先各自查一次是否存在,最后命中数是2才返回结果,否则返回null。树里有重复的值,用
root.value === p.value比较有问题吗?有。两个不同的节点值都是
5时会提前命中错的那个。题目给的是节点引用,就用root === p比;只给了值的话,要先确认值唯一。换成二叉搜索树,还用这套递归吗?
不用。从根开始,两个值都比当前小就往左,都比当前大就往右,一大一小(或者等于其中一个)时当前节点就是答案。
O(h)时间,O(1)空间,写成while循环就行。节点上有
parent指针,有没有更直接的办法?有,转化成两条链表求相交点。从
p往上走一遍,把祖先都存进Set,再从q往上走,第一个在Set里的就是答案;不想用额外空间可以用双指针走到头再换另一条链的技巧。
# 107 二叉树右视图
⚡ 30 秒速记
- 层序遍历,每层最后一个出队的节点就是从右边看过去能看到的那个
- 不是一路沿着
right走:右子树短的那层,看到的是左子树的节点 - 用
size固定当前层的节点数,别边遍历边读变化的queue.length - 另一种写法:
DFS先右后左,depth === result.length时记录,代码更短 - 时间
O(n),层序空间O(w)(最宽一层),DFS空间O(h)
右视图就是每一层最右边那个节点,用层序遍历最直观,每层处理到最后一个节点时把值收进结果。 常见的错误理解是一直往 right 走,比如 [1,2,3,4] 里节点 4 挂在 2 的左边,右边那棵子树没有第三层,从右边看第三层能看到的就是 4。另外,queue.shift() 是 O(n) 的,题目里数据小无所谓,节点多的话我会用一个下标指针代替出队。
# 题目与解题思路
独立实现「二叉树右视图」。层序遍历每一层,把该层最后出队的节点值加入答案。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function rightSideView(root) { // 定义本题的核心实现
if (!root) return [] // 检查当前分支条件
const result = [] // 初始化当前步骤需要的状态
const queue = [root] // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
if (index === size - 1) result.push(node.value) // 检查当前分支条件
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[1,2,3,null,5,null,4] 的右视图为 [1,3,4]。
- 易错点:右视图不是简单沿 right 指针走,缺少右孩子时仍可能看到左子树节点。
💬 面试官追问
一直取
root.right往下走,为什么不对?给个反例。[1,2,3,4]:4是2的左孩子,3没有孩子。沿右指针只能拿到[1,3],正确答案是[1,3,4],第三层只有4,从右边看也能看到它。不用队列,用递归怎么写?
DFS先访问右子树再访问左子树,带着深度走:if (depth === result.length) result.push(node.value)。每层第一个被访问到的一定是最右边的节点,后面同层的都会被跳过。那左视图呢?
层序时取
index === 0,也就是每层第一个;DFS写法把访问顺序换成先左后右就行,判断条件不变。节点有几十万个,
queue.shift()会成问题吗?会。数组
shift要把后面元素整体前移,最坏整体退化到O(n²)。改成let head = 0,用queue[head++]取元素,按层处理时用levelEnd = queue.length标出这层的边界。
# 108 二叉搜索树第 K 小元素
⚡ 30 秒速记
- 二叉搜索树中序遍历(左 → 根 → 右)出来就是升序,数到第
k个就返回 - 用栈做迭代中序,可以数到
k就停,不用遍历整棵树 k从1开始计;k超过节点数要有明确处理(抛错或返回null)- 时间
O(h + k),空间O(h) - 树频繁增删又要频繁查第
k小 → 节点上维护子树大小,查询降到O(h)
二叉搜索树的中序遍历结果天然有序,所以第 k 小就是中序遍历到的第 k 个节点。 我会写迭代版,一路把左孩子压栈到底,弹出一个就把 k 减一,减到 0 就是答案,然后转到右子树继续。迭代的好处是能提前停,递归版要提前退出得靠外部变量或抛异常,写起来别扭。如果面试官追问「频繁查询怎么优化」,答案是给每个节点存一个左子树节点数,按大小直接决定往左还是往右走。
# 题目与解题思路
独立实现「二叉搜索树第 K 小元素」。二叉搜索树中序遍历天然升序,访问到第 k 个节点时返回。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function kthSmallest(root, k) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
let current = root // 初始化当前步骤需要的状态
while (current || stack.length) { // 遍历仍需处理的候选状态
while (current) { // 遍历仍需处理的候选状态
stack.push(current) // 执行当前语句
current = current.left // 执行当前语句
} // 结束当前代码块
current = stack.pop() // 执行当前语句
k -= 1 // 执行当前语句
if (k === 0) return current.value // 检查当前分支条件
current = current.right // 执行当前语句
} // 结束当前代码块
throw new RangeError('k 超出节点数量') // 执行当前语句
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(h+k),空间 O(h)。
- 示例:[3,1,4,null,2] 的第 1 小元素为 1。
- 易错点:k 按 1 开始;频繁查询可在节点上维护子树大小以降到 O(h)。
💬 面试官追问
先中序遍历存成数组,再取
arr[k - 1],有什么问题?能对,但不管
k多小都要遍历完整棵树、再开一个O(n)的数组。迭代中序在数到第k个时就停,k很小时只走O(h + k)个节点。树经常插入删除,同时每秒要查很多次第
k小,怎么优化?每个节点多存一个
leftCount(左子树节点数)。查询时k <= leftCount往左走,k === leftCount + 1就是当前节点,否则k -= leftCount + 1往右走,O(h)。插入删除时沿路径更新计数,配合平衡树才能保证h是log n。要求第
k大呢?反过来走中序:右 → 根 → 左,就是降序,同样数到第
k个返回。不用先算总数n再转换成第n - k + 1小。k给了0或者比节点总数还大,你的代码会怎样?k是0时第一次减完就变成负数,永远等不到0,最后走到循环外。所以入口先校验k >= 1,循环结束还没找到就抛RangeError,别静默返回undefined。
# 109 有序数组转换为平衡二叉搜索树
⚡ 30 秒速记
- 每次取区间中点当根,左半边递归建左子树,右半边递归建右子树
- 中点当根 → 左右两边节点数最多差
1,树自然高度平衡 - 答案不唯一:偶数长度时中点取偏左或偏右都对
- 区间用左右下标传,不要
slice切数组,否则每层都在拷贝 - 时间
O(n),递归栈O(log n)
有序数组转平衡二叉搜索树,就是反复「取中点当根」:中点左边都比它小,右边都比它大,天然满足 BST,两边节点数又几乎相等,所以树是平衡的。 写法是传 left 和 right 两个下标,left > right 时返回 null,中点用 left + Math.floor((right - left) / 2)。我不会用 slice 切数组,每层都拷贝一遍会把空间和时间都拉高。题目说答案不唯一,是因为偶数长度时中点偏左偏右都是合法答案,判题一般只检查是否平衡和有序。
# 题目与解题思路
独立实现「有序数组转换为平衡二叉搜索树」。每次选择区间中点作为根节点,递归构造左右半区。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function sortedArrayToBst(numbers, left = 0, right = numbers.length - 1) { // 定义本题的核心实现
if (left > right) return null // 检查当前分支条件
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
return { // 返回本题要求的结果
value: numbers[middle], // 执行当前语句
left: sortedArrayToBst(numbers, left, middle - 1), // 执行当前语句
right: sortedArrayToBst(numbers, middle + 1, right) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(log n)。
- 示例:[-10,-3,0,5,9] 可构造根为 0 的平衡 BST。
- 易错点:答案不唯一;中点选左或选右都可以,但区间必须严格缩小。
💬 面试官追问
用
numbers.slice(0, mid)递归传子数组,有什么问题?每层都在拷贝,总拷贝量是
O(n log n),还多了大量临时数组。结果是对的,但传下标就能做到O(n),面试里写下标版更好。中点为什么写
left + Math.floor((right - left) / 2),不直接写(left + right) / 2?在
Java、C++里left + right可能整数溢出,这是习惯写法。JS数字是双精度浮点,数组下标范围内不会溢出,但(left + right) / 2会得到小数,一定要Math.floor。输入换成有序链表,怎么做?
快慢指针找中点每层是
O(n),总体O(n log n)。更好的是按中序模拟:先数出长度,递归时先建左子树,再用链表当前节点建根、指针后移,再建右子树,整体O(n)。怎么验证你构造的树确实是平衡的?
写个后序递归返回高度,任何节点左右高度差超过
1就返回-1往上传;再做一次中序遍历,结果要和原数组完全一致。两个检查都过才算对。
# 110 二叉树展开为链表
⚡ 30 秒速记
- 展开顺序 = 前序遍历顺序(根 → 左 → 右),所有
left置空,用right串起来 - 逆前序(右 → 左 → 根)递归,
previous指向已经展开好的那段链表,接到当前节点right上 - 原地改指针,不新建节点
- 时间
O(n),递归栈O(h);要O(1)空间就用「左子树最右节点接右子树」的迭代法 - 易错:忘了
left = null,或者顺序写成了中序
这题要求原地把树改成按前序顺序串起来的单链表,我用逆前序遍历:先处理右子树、再左子树、最后当前节点,这样处理到某个节点时,它后面的链表已经全部接好了。 当前节点只要做两件事:right 指向 previous,left 置空,然后自己变成新的 previous。用正前序做的话,改 right 指针会把还没访问的右子树弄丢,得先把左右孩子存下来。如果面试官要求 O(1) 额外空间,就用迭代:有左子树时找到左子树的最右节点,把原来的右子树挂到它后面,再把左子树整体搬到右边。
# 题目与解题思路
独立实现「二叉树展开为链表」。逆前序遍历(右、左、根),用 previous 指向已展开部分并接到当前节点右侧。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function flattenTree(root) { // 定义本题的核心实现
let previous = null // 初始化当前步骤需要的状态
const visit = node => { // 初始化当前步骤需要的状态
if (!node) return // 检查当前分支条件
visit(node.right) // 执行当前语句
visit(node.left) // 执行当前语句
node.right = previous // 执行当前语句
node.left = null // 执行当前语句
previous = node // 执行当前语句
} // 结束当前代码块
visit(root) // 执行当前语句
return root // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[1,2,5,3,4,null,6] 展开为 1→2→3→4→5→6。
- 易错点:展开后所有 left 必须为空,节点顺序是前序遍历而不是中序。
💬 面试官追问
直接前序遍历,边遍历边改
right指针,为什么会出错?改完
node.right = node.left之后,原来的右子树就找不到了。要么先把左右孩子存到变量里,要么前序遍历时先把节点收集到数组,最后统一串起来,后者要O(n)额外空间。要求额外空间
O(1),不能递归,怎么做?从根开始循环:当前节点有左子树时,找到左子树最右边的节点,把
cur.right接到它的right上,再把cur.right = cur.left、cur.left = null,然后cur = cur.right。每个节点最多被访问常数次,整体O(n)。展开之后怎么快速验证结果对不对?
沿
right走一遍收集值,和原树前序遍历的结果比较,同时检查每个节点left都是null。只看值序列不检查left会漏掉没断干净的情况。那要展开成中序顺序的双向链表呢?
那是另一题,二叉搜索树转双向链表。中序遍历时维护
previous,执行previous.right = node、node.left = previous,left当前驱用,不再置空。
# 111 二叉树的所有根到叶路径
⚡ 30 秒速记
DFS+ 回溯:进节点push,到叶子就把路径拼成字符串收进结果,出节点pop- 只有叶子才算一条完整路径,中间节点不收
pop写在if/else之后,叶子和非叶子都要撤销自己- 时间
O(n·h):每到一个叶子要join一次长度为h的路径 - 也可以把路径字符串当参数往下传,不用回溯,但每层会产生新字符串
所有根到叶路径就是 DFS 加回溯:用一个 path 数组记录当前走过的节点,到叶子时 join 成字符串存起来,离开节点时把自己弹出去。 回溯最容易写漏的是 pop,它要放在叶子判断之后、不管是不是叶子都执行,不然下一条路径会带着上一条的残留。复杂度要说清楚:遍历是 O(n),但每个叶子都要拼一次长度为树高的字符串,所以是 O(n·h)。另一种写法是把字符串作为参数传下去,visit(node.left, path + '->' + node.value),天然不用回溯,代码更短。
# 题目与解题思路
独立实现「二叉树的所有根到叶路径」。深度优先维护当前路径,在叶子节点把路径序列化并收集。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function binaryTreePaths(root) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const visit = node => { // 初始化当前步骤需要的状态
if (!node) return // 检查当前分支条件
path.push(node.value) // 执行当前语句
if (!node.left && !node.right) result.push(path.join('->')) // 检查当前分支条件
else { // 处理另一种分支
visit(node.left) // 执行当前语句
visit(node.right) // 执行当前语句
} // 结束当前代码块
path.pop() // 执行当前语句
} // 结束当前代码块
visit(root) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n·h),递归栈 O(h)。
- 示例:[1,2,3,null,5] 得到 1→2→5 与 1→3。
- 易错点:只有叶子才形成完整路径;回溯时要移除当前节点。
💬 面试官追问
把
path.pop()放到else分支里面,会出什么问题?叶子节点
push进去后不会被弹出,下一条路径就会多出上一个叶子。比如[1,2,3]会得到1->2和1->2->3,第二条是错的。结果里存
path本身而不是path.join(),会怎样?存进去的都是同一个数组引用,遍历结束时它已经被
pop空了,结果全是空数组。要么存字符串,要么存[...path]拷贝。用字符串参数往下传的写法,和数组回溯比怎么选?
字符串是不可变的,
path + '->' + val每次生成新串,天然隔离不用回溯,代码少一半。数组回溯少了中间字符串,树很深、叶子很多时省一点内存。面试写字符串版更不容易出错。树深十万层,递归爆栈了,怎么改?
用显式栈,每个元素存
[node, pathString],出栈时判断是不是叶子,不是就把孩子连同新路径一起压栈。逻辑不变,调用栈换成了堆上的数组。
# 112 完全二叉树节点个数
⚡ 30 秒速记
- 完全二叉树:除最后一层都是满的,最后一层节点靠左排
- 一路向左数高度、一路向右数高度,相等 → 这棵子树是满二叉树,节点数直接
2^h - 1 - 不相等 →
1 +左子树个数+右子树个数,递归下去 - 每层只有一侧会继续深入,共
O(log n)层,每层算高度O(log n)→O(log² n) - 只对完全二叉树成立,普通二叉树老老实实
O(n)遍历
完全二叉树的节点数可以比 O(n) 更快,靠的是「满二叉树能直接用公式算」:从当前节点一路向左和一路向右各数一次高度,相等就说明是满的,返回 2 ** h - 1。 不相等就拆成左右两棵子树递归。为什么快:完全二叉树里左右子树至少有一棵是满的,满的那棵一次算完,只有另一棵会继续往下,所以递归只沿一条路径走 log n 层,每层算高度又是 log n,合起来 O(log² n)。这个优化前提是「完全」,换成普通二叉树就失效了。
# 题目与解题思路
独立实现「完全二叉树节点个数」。比较最左路径与最右路径高度,相等说明是满二叉树,可直接用 2^h-1 计算。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function countCompleteNodes(root) { // 定义本题的核心实现
if (!root) return 0 // 检查当前分支条件
let leftHeight = 0 // 初始化当前步骤需要的状态
let rightHeight = 0 // 初始化当前步骤需要的状态
for (let node = root; node; node = node.left) leftHeight += 1 // 遍历仍需处理的候选状态
for (let node = root; node; node = node.right) rightHeight += 1 // 遍历仍需处理的候选状态
if (leftHeight === rightHeight) return 2 ** leftHeight - 1 // 检查当前分支条件
return 1 + countCompleteNodes(root.left) + countCompleteNodes(root.right) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log² n),递归栈 O(log n)。
- 示例:[1,2,3,4,5,6] 返回 6。
- 易错点:该优化只适用于完全二叉树;普通二叉树必须完整遍历。
💬 面试官追问
为什么复杂度是
O(log² n),不是O(n)?每次递归里,左右子树至少有一棵是满二叉树,在下一层第一步就会被公式直接算掉,真正继续往下走的只有一条路径,共
log n层。每层数高度是O(log n),所以是log n × log n。普通二叉树套用这段代码,会算错吗?
会。比如根的左边一路有孩子、右边一路也有孩子,但中间缺了节点,左右高度一样,代码会当成满二叉树返回
2^h - 1,多算了。所以这个优化只在完全二叉树上成立。能不能再快一点,用二分?
可以。先算出树高
h,最后一层节点编号是0到2^(h-1) - 1,二分最后一层哪个编号存在,每次按编号的二进制位从根往下走O(h)去验证,复杂度同样是O(log² n),只是换了个思路,常数差不多。2 ** h - 1这里,h是从1还是0开始数?代码里只有根节点时
h是1,结果2 ** 1 - 1 = 1,对。如果你习惯根节点高度为0,公式就要写成2 ** (h + 1) - 1,两种都行,别混用。
# 113 判断一棵树是否为另一棵树的子树
⚡ 30 秒速记
- 遍历主树每个节点,把它当候选根,用「相同的树」判断整棵候选子树
- 值相同只是开始比较的条件,左右结构包括叶子下面的空位都得一样
- 子树是指某节点连同它所有后代,只匹配中间一段不算
- 暴力最坏
O(m·n);序列化(带空位标记和分隔符)+KMP能做到O(m + n) - 空子树算不算子树要先约定,代码里是返回
true
判断子树就是在主树里挨个找候选根,每个候选都跑一遍「两棵树是否相同」。 注意子树的定义是「某个节点和它的全部后代」,所以主树里 4 下面要是还多挂了一个孩子,就不算包含 [4,1,2]。暴力法最坏是 O(m·n),比如主树全是 1、子树也全是 1 只在最底下差一个节点,每个候选都要比到底。要优化可以把两棵树都按前序序列化,空节点写成 #,每个值前面加分隔符,再用 KMP 做字符串匹配,线性时间。
# 题目与解题思路
独立实现「判断一棵树是否为另一棵树的子树」。遍历主树的每个节点作为候选根,并用相同树判断比较完整结构。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isSubtree(root, candidate) { // 定义本题的核心实现
const same = (left, right) => { // 初始化当前步骤需要的状态
if (!left || !right) return left === right // 检查当前分支条件
return left.value === right.value && same(left.left, right.left) && same(left.right, right.right) // 返回本题要求的结果
} // 结束当前代码块
if (!candidate) return true // 检查当前分支条件
if (!root) return false // 检查当前分支条件
return same(root, candidate) || isSubtree(root.left, candidate) || isSubtree(root.right, candidate) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏时间 O(mn),递归栈 O(h)。
- 示例:主树 [3,4,5,1,2] 包含子树 [4,1,2]。
- 易错点:值相同只是候选开始,左右结构也必须完全一致;空子树语义要事先约定。
💬 面试官追问
主树
[3,4,5,1,2,null,null,0],4下面的2多挂了一个0,包含[4,1,2]吗?不包含。子树要连后代一起完全一致,候选根
4那棵多了一个0,same比到2的左孩子时一边是0一边是空,返回false。序列化后用
includes做字符串匹配,空节点和分隔符为什么都不能省?不写空节点会丢结构,前面「相同的树」那题就说过。不加分隔符会有串值问题,主树里的值
12序列化成12,子树值2序列化成2,会被当成匹配。写成,12,#,#和,2,#,#就不会误命中。最坏什么情况下暴力法会到
O(m·n)?主树和子树几乎全是相同的值,每个候选根都要比很深才发现不一样。比如主树是一条全是
1的长链,子树是1的短链再在最底下挂个2。candidate是null时返回true合理吗?看约定。数学上空树是任何树的子树,代码按这个处理;但业务里传空进来多半是调用方出错了,公共函数我更倾向于直接抛错或在文档里写清楚。
# 114 构造最大二叉树
⚡ 30 秒速记
- 区间里最大的数当根,最大值左边那段建左子树,右边那段建右子树,递归下去
- 按原数组位置切,不能排序
- 朴素写法每层都线性找最大值 → 有序数组时退化成
O(n²),递归栈O(n) - 单调递减栈一遍扫完
O(n):弹出比当前小的元素,最后弹出的那个挂成当前节点的左孩子,当前节点挂成栈顶的右孩子 - 区间用下标传,右边界开区间时注意
left >= right判空
构造最大二叉树就是按定义递归:找区间最大值当根,它左边的元素建左子树,右边的建右子树。 朴素写法每层都要扫一遍找最大值,数组本身有序时树退化成一条链,复杂度是 O(n²),递归也有 n 层。面试官一般会追问 O(n) 的做法,就是单调栈:从左到右扫,维护一个值递减的栈,当前数比栈顶大就一直弹,最后弹出的那个是它的左孩子;弹完之后如果栈里还有元素,当前数就是栈顶的右孩子。
# 题目与解题思路
独立实现「构造最大二叉树」。当前区间最大值作为根,最大值左右两侧分别递归构造左右子树。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function constructMaximumBinaryTree(numbers, left = 0, right = numbers.length) { // 定义本题的核心实现
if (left >= right) return null // 检查当前分支条件
let maximum = left // 初始化当前步骤需要的状态
for (let index = left + 1; index < right; index += 1) { // 遍历仍需处理的候选状态
if (numbers[index] > numbers[maximum]) maximum = index // 检查当前分支条件
} // 结束当前代码块
return { // 返回本题要求的结果
value: numbers[maximum], // 执行当前语句
left: constructMaximumBinaryTree(numbers, left, maximum), // 执行当前语句
right: constructMaximumBinaryTree(numbers, maximum + 1, right) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 朴素时间 O(n²),递归栈 O(n)。
- 示例:[3,2,1,6,0,5] 的根节点为 6。
- 易错点:严格按原数组相对位置切分;可用单调栈把构造优化为 O(n)。
💬 面试官追问
输入
[1,2,3,4,5]时,朴素递归是什么复杂度?每次最大值都在区间最右边,右边为空、左边只少一个元素,树退化成一条向左的链。扫描总量是
n + (n-1) + … + 1,也就是O(n²),递归深度n。单调栈版本能不能讲讲为什么是对的?
一个数的父节点,是它左右两侧「第一个比它大的数」里较小的那个。单调递减栈正好在入栈和出栈时分别确定这两个「第一个更大」,所以每个元素只进出栈一次就能连好指针,
O(n)。单调栈写法大概长什么样?
for (const v of nums) { const node = { value: v, left: null, right: null }; let last = null; while (stack.length && stack.at(-1).value < v) last = stack.pop(); node.left = last; if (stack.length) stack.at(-1).right = node; stack.push(node) },最后栈底就是根。数组里有重复值怎么办?
题目一般保证互不相同。有重复的话要约定取第一个还是最后一个最大值当根,朴素写法里
>和>=就对应这两种选择,单调栈里弹栈条件用<还是<=也要跟着对齐。
# 115 二叉搜索树中搜索节点
⚡ 30 秒速记
- 二叉搜索树:左子树都比根小,右子树都比根大 → 每次比较能排除一半的树
- 从根开始,目标小往左走,目标大往右走,相等就返回
- 迭代写法空间
O(1);递归也行,但链状树会递归n层 - 时间
O(h):平衡时O(log n),按顺序插入出来的链状树退化成O(n) - 重复值放左边还是右边是建树时的约定,查找要跟它保持一致
二叉搜索树查找就是从根往下走,比当前小往左、比当前大往右,相等就找到了,每一步都只剩一条路可走。 我习惯写成 while 循环,空间 O(1),代码也只有几行。复杂度要说成 O(h) 而不是 O(log n),因为 BST 本身不保证平衡,比如按 1,2,3,4,5 依次插入,树就是一条往右的链,查找退化成线性。真实项目里要稳定 O(log n) 得用红黑树、AVL 这种自平衡树。
# 题目与解题思路
独立实现「二叉搜索树中搜索节点」。利用左小右大的有序性,从根节点迭代选择唯一可能包含目标的子树。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function searchBst(root, target) { // 定义本题的核心实现
let current = root // 初始化当前步骤需要的状态
while (current) { // 遍历仍需处理的候选状态
if (current.value === target) return current // 检查当前分支条件
current = target < current.value ? current.left : current.right // 执行当前语句
} // 结束当前代码块
return null // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(h),空间 O(1)。
- 示例:[4,2,7,1,3] 中搜索 2 返回以 2 为根的子树。
- 易错点:退化链状 BST 的高度可能为 n;重复值放哪一侧必须由树的契约决定。
💬 面试官追问
为什么说复杂度是
O(h),不直接说O(log n)?BST不保证平衡。数据按升序插入就会变成一条链,h = n,查找退化成O(n)。只有平衡树才能保证h在log n级别。递归和迭代写法,你选哪个?
这题我选迭代,每一步只往一个方向走,本来就是尾递归形态,写成循环一样清楚,还避免了链状树把调用栈撑爆。
JS引擎基本没实现尾调用优化,别指望递归自动变循环。要找「小于等于
target的最大值」,代码怎么改?往下走的时候记录候选:当前值
<= target就记下来再往右走试试能不能更大,否则往左走。走到底时记录的最后一个候选就是答案,还是O(h)。树里允许重复值,查找结果可能不对吗?
如果建树时约定重复值放右边,查找时等于就返回第一个碰到的,没问题;但要找「所有等于
target的节点」就得继续往右子树找。插入和查找用的约定不一致才会出问题。
# 116 向二叉搜索树插入节点
⚡ 30 秒速记
- 和查找一样按大小往下走,走到空位就把新节点挂上去
- 新节点永远挂成叶子,不需要调整已有结构
- 空树直接返回新节点当根,所以函数要返回
root,调用方要用返回值 - 重复值是忽略、计数还是固定放一侧,事先定好
- 时间
O(h);连续按顺序插入会变成链,要稳定性能用自平衡树
往二叉搜索树里插入,就是按查找的路线往下走,走到某个节点该去的那边是空的,就把新节点挂在那里。 新节点一定是叶子,不用动别的节点,这也是 BST 插入简单的原因。有两个细节:空树时新节点就是根,所以函数必须返回根,调用方写成 root = insertIntoBst(root, 5);重复值要有约定,代码里 value < current.value 不成立就走右边,等于是放右边。
# 题目与解题思路
独立实现「向二叉搜索树插入节点」。沿比较结果向左或向右查找空位置,再把新节点连接到最后一个非空父节点。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function insertIntoBst(root, value) { // 定义本题的核心实现
const node = { value, left: null, right: null } // 初始化当前步骤需要的状态
if (!root) return node // 检查当前分支条件
let current = root // 初始化当前步骤需要的状态
while (true) { // 遍历仍需处理的候选状态
const side = value < current.value ? 'left' : 'right' // 初始化当前步骤需要的状态
if (!current[side]) { // 检查当前分支条件
current[side] = node // 执行当前语句
return root // 返回本题要求的结果
} // 结束当前代码块
current = current[side] // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(h),空间 O(1)。
- 示例:向 [4,2,7,1,3] 插入 5,成为节点 7 的左孩子。
- 易错点:空树插入应返回新根;重复值是忽略、计数还是固定放一侧必须明确。
💬 面试官追问
调用方写
insertIntoBst(root, 5)不接返回值,什么时候会出问题?root是null的时候。函数内部新建了节点并返回,但外面的root还是null,插入等于没做。所以要求调用方root = insertIntoBst(root, 5)。依次插入
1,2,3,4,5,树会变成什么样?一条全往右的链,每次插入都要走到底,插入和查找都退化成
O(n)。数据有序时可以先打乱,工程上直接用红黑树或者AVL,插入后通过旋转维持平衡。递归版插入怎么写?
if (!root) return { value, left: null, right: null },然后按大小root.left = insert(root.left, value)或root.right = insert(root.right, value),最后返回root。写法更短,但每层都会重新赋值一次指针。插入一个已经存在的值,你怎么处理?
三种都合理:直接忽略、节点上加
count计数、固定放到右子树。我倾向计数,树结构不变,统计个数也方便;放右子树的话,查找和删除也得按同样规则处理。
# 117 N 叉树层序遍历
⚡ 30 秒速记
- 和二叉树层序一样用队列,只是孩子从
left/right变成children数组 - 每层开始前先用
size记下当前层节点数,循环size次,新加入的孩子留到下一层 children可能是空数组或者干脆没有,用node.children ?? []兜底- 时间
O(n),空间O(w),w是最宽一层的节点数 queue.push(...children)在孩子数量极多时可能参数过多报错,稳妥写法是for循环push
N 叉树层序遍历和二叉树一个套路:队列 + 每层固定 size,区别只是把左右孩子换成遍历 children 数组。 固定 size 是这题的核心,因为处理当前层的时候会不断往队尾加孩子,如果循环条件写成 index < queue.length,下一层的节点也会被混进当前层。children 字段在很多数据里可能缺省,要用 ?? [] 兜一下。实际项目里遍历组织架构树、菜单树按层展示,就是这段代码。
# 题目与解题思路
独立实现「N 叉树层序遍历」。队列按层保存节点,每轮先固定当前层长度,再把全部孩子加入队尾。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function levelOrderNary(root) { // 定义本题的核心实现
if (!root) return [] // 检查当前分支条件
const result = [] // 初始化当前步骤需要的状态
const queue = [root] // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
const level = [] // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
level.push(node.value) // 执行当前语句
queue.push(...(node.children ?? [])) // 执行当前语句
} // 结束当前代码块
result.push(level) // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:根 1 的孩子为 3、2、4,节点 3 的孩子为 5、6,结果为 [[1],[3,2,4],[5,6]]。
- 易错点:children 可能为空数组或缺省;不能在本层循环中使用动态变化的 queue.length 作为边界。
💬 面试官追问
把
for循环条件写成index < queue.length,结果会怎样?queue.length在循环里一直在变:前面在shift,后面在push孩子,层与层的边界就乱了,可能把下一层的节点混进当前层。所以每层开始先const size = queue.length定住。一个节点有几十万个孩子,
queue.push(...node.children)有风险吗?有。展开运算符会把每个元素当成一个参数传进去,参数太多会抛
RangeError。换成for (const c of node.children) queue.push(c)就没这个问题。能用
DFS实现层序结果吗?能。递归时带上
depth,if (!result[depth]) result[depth] = [],再把值放进result[depth]。按先序访问孩子,同一层内顺序依然是从左到右。组织架构树要按层渲染,后端返回的是扁平的
id/parentId列表,怎么办?先用一个
Map把扁平列表组装成树,O(n);或者直接按parentId分组,从根id开始一层层取。先建树再层序是最清楚的写法。
# 118 二叉树每层平均值
⚡ 30 秒速记
- 层序遍历,每层累加节点值,这一层结束时
sum / size存进结果 - 分母用这一层开始时固定下来的
size,不能用一直在变的queue.length sum在每层开始时重置成0,放在外层会把上一层的和带进来- 时间
O(n),空间O(w) - 平均值可能是小数(
14.5),判题一般允许1e-5误差
每层平均值就是层序遍历加一个累加器:每层开始时定住 size、把 sum 清零,处理完这一层就把 sum / size 推进结果。 容易写错的有两处,一是分母用了 queue.length,那时候队列里已经是下一层的节点了;二是 sum 定义在 while 外面没有重置。DFS 也能做,维护每层的和与个数两个数组,最后统一相除,适合不想用队列的情况。
# 题目与解题思路
独立实现「二叉树每层平均值」。层序遍历时统计当前层节点数与总和,层结束后写入平均值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function averageOfLevels(root) { // 定义本题的核心实现
if (!root) return [] // 检查当前分支条件
const result = [] // 初始化当前步骤需要的状态
const queue = [root] // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
let sum = 0 // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
sum += node.value // 执行当前语句
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
result.push(sum / size) // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[3,9,20,null,null,15,7] 得到 [3,14.5,11]。
- 易错点:分母必须用本层固定 size,而不是加入下一层节点后变化的队列长度。
💬 面试官追问
把
result.push(sum / size)写成sum / queue.length,对[3,9,20,null,null,15,7]会输出什么?第一层处理完时队列里是
9和20,长度是2,会算成3 / 2 = 1.5,正确应该是3。分母必须是本层固定的size。节点值很大,比如每个都接近
2^31,一层有几万个,会溢出吗?JS数字是双精度浮点,2^31乘以几万大约在10^14量级,没超过Number.MAX_SAFE_INTEGER(约9×10^15),整数和是精确的。Java里用int累加就会溢出,要用long。用
DFS怎么写?维护
sums和counts两个数组,递归时带depth,进入节点就sums[depth] += value、counts[depth] += 1,最后sums.map((s, i) => s / counts[i])。结果要保留两位小数显示,在算法里直接
toFixed(2)行吗?不建议。
toFixed返回的是字符串,还会带来舍入误差,算法层返回数字,展示层再格式化。判题系统一般按浮点误差比对,提前转字符串反而会判错。
# 119 二叉树最底层最左边的值
⚡ 30 秒速记
- 层序遍历,每层第一个出队的节点记下来,最后一层记下的就是答案
- 另一种写法:每层先放右孩子再放左孩子,整个遍历最后一个出队的节点就是答案
- 「最左」指树结构上的位置,不是值最小
- 一上来就读
root.value,空树会报错,入口要先判空 - 时间
O(n),空间O(w);DFS写法记录第一次到达新深度的节点
找最底层最左边的值,用层序遍历每层记一下第一个出队的节点,遍历结束时记住的那个就属于最后一层。 还有一个更短的技巧:入队时先右后左,那么整棵树最后一个出队的节点就是最底层最左的,连层都不用分。要注意「最左」是位置不是数值,[2,1,3] 答案是 1 只是碰巧也最小。代码里 answer = root.value 在空树时会直接抛错,题目保证非空才能这么写。
# 题目与解题思路
独立实现「二叉树最底层最左边的值」。层序遍历每层时记录第一个出队节点,最后一层记录即为答案。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findBottomLeftValue(root) { // 定义本题的核心实现
const queue = [root] // 初始化当前步骤需要的状态
let answer = root.value // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
if (index === 0) answer = node.value // 检查当前分支条件
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
return answer // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[2,1,3] 返回 1。
- 易错点:“最左”按树的结构定义,不是数值最小;根节点存在时答案一定可得。
💬 面试官追问
「先右后左入队,最后一个出队就是答案」,为什么成立?
层序遍历是一层一层出队的,最后出队的一定在最底层;同一层里又是从右往左出,所以最后一个就是最左边的。整棵树遍历完,拿最后那个节点的值就行。
用
DFS怎么做?带着深度先左后右递归,
if (depth > maxDepth) { maxDepth = depth; answer = node.value }。先左后右保证每一层第一次被到达时就是最左节点,后面同层的不会再更新。[1,2,3,null,null,5],最底层最左边是哪个?是
5。最底层只有5这一个节点,它挂在3的左边,虽然整体在树的右半边,但它是这一层最左的。只盯着左子树找会答成2。传进来一棵空树,这段代码会怎样?
let answer = root.value直接抛TypeError。题目保证非空就算了,写成公共函数的话要先if (!root) return null或者抛一个语义清楚的错误。
# 120 只出现一次的数字
⚡ 30 秒速记
- 异或三条性质:
x ^ x = 0、x ^ 0 = x、满足交换律和结合律 - 所有数异或一遍,成对的全抵消成
0,剩下的就是只出现一次的那个 - 时间
O(n),空间O(1),比Map计数省空间 - 前提是其他数都恰好出现两次;别的都出现三次或有两个只出现一次的,是另外的解法
JS位运算会先转成32位有符号整数,小数和超过2^31的数会算错
这题的关键是异或:相同的数异或得 0,任何数异或 0 还是它自己,而且异或顺序无所谓,所以把整个数组异或一遍,成对出现的都抵消了,剩下的就是答案。 比如 [4,1,2,1,2],可以看成 4 ^ (1 ^ 1) ^ (2 ^ 2) = 4 ^ 0 ^ 0 = 4。它比 Map 计数好在只用一个变量。但前提很严格:其他数必须恰好出现两次。还有个 JS 特有的坑,位运算会把数转成 32 位整数,2.5 会被截成 2,2 ** 32 会变成 0。
# 题目与解题思路
独立实现「只出现一次的数字」。利用 x XOR x 等于零、x XOR 0 等于 x,把全部元素异或后留下唯一值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function singleNumber(numbers) { // 定义本题的核心实现
let result = 0 // 初始化当前步骤需要的状态
for (const value of numbers) result ^= value // 遍历仍需处理的候选状态
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[4,1,2,1,2] 返回 4。
- 易错点:该结论依赖其余元素恰好出现两次;JavaScript 位运算会转换为 32 位有符号整数。
💬 面试官追问
数组里有
2.5或者2 ** 32这样的数,结果还对吗?不对。
JS的^会先把操作数转成32位有符号整数,2.5变成2,2 ** 32变成0,结果就乱了。这种输入老老实实用Map计数,或者用Set进出抵消。其他数都出现三次,只有一个出现一次,怎么做?
按位统计:对
32个二进制位,分别数所有数在这一位上1的个数,对3取余,余下的就是答案在这一位的值。时间O(32n),空间O(1)。有两个数只出现一次,其他都出现两次呢?
先全部异或得到
a ^ b,它一定不为0,取最低位的1:const bit = xor & -xor。按这一位是0还是1把数组分成两组,a和b一定在不同组,每组各自异或就分别得到a和b。传入空数组会返回什么?
返回
0,但0本身也可能是合法答案,调用方分不清。题目保证有解就无所谓,写成工具函数的话,空数组直接抛错更安全。
# 36 综合
# 1 实现一个 sleep 函数,比如 sleep(1000) 意味着等待1000毫秒
⚡ 30 秒速记
const sleep = ms => new Promise(r => setTimeout(r, ms)),配合await sleep(1000)用- 它不阻塞主线程,
await只是暂停当前这个async函数,点击、渲染照常进行 - 只保证「至少」等这么久:主线程忙、后台标签页节流、嵌套计时器的
4ms下限都会让它更晚 - 延迟上限是
2^31 - 1毫秒(约24.8天),超过会溢出,几乎立刻触发 Node 16+可以直接用import { setTimeout } from 'node:timers/promises',还支持AbortSignal取消
sleep 就是用 Promise 包一层 setTimeout,到时间调用 resolve,配合 await 用起来像同步代码里的「等一会儿」。 但它和别的语言里的 sleep 不是一回事,它不会卡住主线程,只是把当前 async 函数后面的代码推迟执行,这期间页面照样能点、能渲染。时间也只是下限,主线程在跑长任务、页面切到后台被节流,都会让它晚于 1000ms 才回来。实际项目里我会给它加上取消能力,比如接收一个 AbortSignal,组件卸载时清掉定时器。
// 使用 promise来实现 sleep
const sleep = (time) => {
return new Promise(resolve => setTimeout(resolve, time))
}
sleep(1000).then(() => {
// 这里写你的骚操作
})
💬 面试官追问
await sleep(1000)期间用户点按钮,点击事件会被处理吗?会。
sleep只是挂了个定时器,await让出了当前函数的执行,主线程是空闲的,事件循环会正常处理点击和渲染。等定时器到点,回调进任务队列,resolve之后await后面的代码才在微任务里接着跑。要真正同步地卡住线程,有办法吗?
在
Worker或Node里可以用Atomics.wait(new Int32Array(new SharedArrayBuffer(4)), 0, 0, 1000),浏览器主线程不允许调用它。用while (Date.now() < end) {}忙等也能卡住,但会占满CPU,页面直接冻住,线上绝不这么写。组件卸载后
sleep回来了,还去setState,怎么改?给
sleep加取消:接收signal,监听abort事件时clearTimeout并reject一个AbortError。组件里用AbortController,在useEffect的清理函数里调controller.abort()。有人写
sleep(30 * 24 * 3600 * 1000)想等 30 天,会怎样?浏览器和
Node都把延迟存成32位有符号整数,超过2147483647毫秒会溢出,回调几乎立刻执行,Node还会打一条TimeoutOverflowWarning。长时间的定时任务应该交给服务端调度,前端最多分段setTimeout。单测里怎么测用了
sleep的代码,不想真等一秒?用假计时器,比如
vi.useFakeTimers()或jest.useFakeTimers(),再await vi.advanceTimersByTimeAsync(1000)把时间往前拨。别断言「恰好1000ms恢复」,真实计时器只保证不早于这个时间。
# 2 给定两个数组,写一个方法来计算它们的交集
⚡ 30 秒速记
- 先问清语义:集合交集(结果去重)还是多重集交集(
[1,2,2,1]和[2,2]得[2,2],按最小出现次数) filter + indexOf写法是O(n·m),而且第一个数组有几个重复就保留几个,不看第二个数组有几个- 集合交集:
const set = new Set(b); [...new Set(a)].filter(x => set.has(x)),O(n + m) - 多重集交集:
Map记第二个数组每个值的次数,命中一次减一 indexOf找不到NaN;includes和Set用的是SameValueZero,能匹配NaN
交集这题先别急着写,先问清楚要不要去重、重复元素按几次算,不同语义答案不一样。 最顺手的 arr1.filter(item => arr2.indexOf(item) > -1) 有两个问题:一是复杂度 O(n·m),数据大了很慢;二是它只看「第二个数组里有没有」,[2,2,2] 和 [2] 也会返回三个 2。题目示例是按最小出现次数算的,所以我会用 Map 统计第二个数组的次数,遍历第一个数组时有剩余次数才放进结果并减一。顺带说一句,函数名别起成 union,那是并集,这里做的是交集。
例如:给定 nums1 = [1, 2, 2, 1],nums2 = [2, 2],返回 [2, 2]。
function union (arr1, arr2) {
return arr1.filter(item => {
return arr2.indexOf(item) > - 1;
})
}
const a = [1, 2, 2, 1];
const b = [2, 3, 2];
console.log(union(a, b)); // [2, 2]
💬 面试官追问
用
filter + indexOf算[2,2,2]和[2]的交集,结果对吗?返回
[2,2,2]。如果业务要的是多重集交集,正确答案是[2],因为indexOf只判断存不存在,不会消耗次数。改成Map计数:if (count.get(x) > 0) { res.push(x); count.set(x, count.get(x) - 1) }。两个数组都有十万个元素,
filter + indexOf为什么慢?每个元素都调用一次
indexOf线性扫描第二个数组,最坏是10^5 × 10^5 = 10^10次比较。先把第二个数组建成Set或Map,查询变成O(1),总体O(n + m)。数组里有
NaN,交集结果漏了,为什么?indexOf用的是===,NaN === NaN是false,永远找不到。换成includes或Set,它们用SameValueZero比较,NaN能匹配上。元素是对象,内容一样但不是同一个引用,怎么求交集?
Set和indexOf都只认引用,内容相同的两个对象不算相等。要按业务主键比,比如先把第二个数组建成new Set(b.map(u => u.id)),再a.filter(u => ids.has(u.id))。两个数组都已经排好序,内存又很紧,怎么做?
双指针:两边各一个下标,值小的那边前进,相等就收进结果、两边都前进。时间
O(n + m),除了结果不需要额外空间,多重集语义天然成立。
# 3 异步并发数限制
⚡ 30 秒速记
- 并发池:同时最多
count个任务在跑,完成一个就补一个,直到全部发出去 - 经典写法:
Promise.resolve().then()延迟调用iterateFunc,doingTasks满了就Promise.race等任意一个完成再补位 - 结果按输入顺序:任务按顺序存进
tasks,最后Promise.all(tasks) - 限的是「同时在跑的数量」,不是「每秒几个」,要限速得用令牌桶这类方案
- 坑:清理只挂在
then上,失败时不会从doingTasks移除、一个失败整批失败;工程里可以直接用p-limit
并发数限制就是维护一个大小为 count 的执行池:池子没满就继续发任务,满了就用 Promise.race 等其中任意一个完成,腾出位置再补下一个。 这段代码有个关键点是 Promise.resolve().then(() => iterateFunc(...)),不直接调用,是因为 iterateFunc 一调用请求就发出去了,要把「发起」控制在调度节奏里。这种写法的坑在出错时:清理只挂在 then 上,任务失败时不会从池子移除,race 还会把错误直接抛出去,整个 limit 失败。我自己写会用 async + while 的 worker 模式,开 count 个 worker 各自从共享下标里取任务,代码更好读。
/**
* 关键点
* 1. new promise 一经创建,立即执行
* 2. 使用 Promise.resolve().then 可以把任务加到微任务队列,防止立即执行迭代方法
* 3. 微任务处理过程中,产生的新的微任务,会在同一事件循环内,追加到微任务队列里
* 4. 使用 race 在某个任务完成时,继续添加任务,保持任务按照最大并发数进行执行
* 5. 任务完成后,需要从 doingTasks 中移出
*/
function limit(count, array, iterateFunc) {
const tasks = []
const doingTasks = []
let i = 0
const enqueue = () => {
if (i === array.length) {
return Promise.resolve()
}
const task = Promise.resolve().then(() => iterateFunc(array[i++]))
tasks.push(task)
const doing = task.then(() => doingTasks.splice(doingTasks.indexOf(doing), 1))
doingTasks.push(doing)
const res = doingTasks.length >= count ? Promise.race(doingTasks) : Promise.resolve()
return res.then(enqueue)
};
return enqueue().then(() => Promise.all(tasks))
}
// test
const timeout = i => new Promise(resolve => setTimeout(() => resolve(i), i))
limit(2, [1000, 1000, 1000, 1000], timeout).then((res) => {
console.log(res)
})
💬 面试官追问
上传页用
limit(2, files, upload),有人以为是「每秒最多传两个」,对吗?不对。它限的是同一时刻最多两个在跑,一个传完立刻补下一个,小文件一秒内可能启动十几个。接口要按频率限制,就得用令牌桶或固定窗口,和并发池是两回事。
为什么不直接
array.map(iterateFunc)拿到所有Promise再分批等?iterateFunc一调用请求就已经发出去了,map一跑完所有请求同时在飞,并发限制形同虚设。必须把「调用」本身推迟到池子有空位的时候。其中一个任务
reject了,这段代码会怎样?doing也跟着reject,splice不会执行,任务一直留在doingTasks;Promise.race拿到这个失败直接抛出,enqueue链中断,limit整体reject。已经发出去的请求不会被取消,还在继续跑。要所有任务都跑完,成功失败都收集,怎么改?
每个任务包一层:
task.then(v => ({ status: 'fulfilled', value: v }), e => ({ status: 'rejected', reason: e })),池子清理挂在包装后的Promise上,最后用Promise.allSettled(tasks)。这样单个失败既不会卡住调度,也能拿到完整结果。换成
worker写法大概怎么写?let i = 0; const run = async () => { while (i < array.length) { const idx = i++; results[idx] = await iterateFunc(array[idx]) } }; await Promise.all(Array.from({ length: count }, run))。idx同步取走,不会重复,结果按下标写回,顺序天然对得上。
# 4 异步串行 | 异步并行
⚡ 30 秒速记
- 先把回调版
asyncAdd包成promiseAdd,后面才能用then/await串 - 串行:
reduce从Promise.resolve(0)开始一路then,n个数就要等n次,10个数约5s - 并行:每轮两两相加、
Promise.all等这一轮,结果再递归,轮数是log₂n,10个数4轮约2s - 两种都遵守「每次加法都走
asyncAdd」,别把结果拿回本地用+汇总,那就跑题了 - 坑:
parallelSum()不传参会无限递归,奇数个时args[i + 1] || 0补零
这题考的是两件事:先把回调函数 promisify,再分别用 reduce 串一条 Promise 链、用 Promise.all 做树形归并。 串行好理解,上一个和算完才能加下一个,10 个数就是 10 次 500ms,差不多 5 秒。并行像淘汰赛,第一轮 5 组同时算,第二轮 3 组,再 2 组、1 组,一共 4 轮,2 秒出结果。我写的时候会补一个空参数的终止条件,原来的代码 parallelSum() 会一直递归下去,页面直接挂住。
// 字节面试题,实现一个异步加法
function asyncAdd(a, b, callback) {
setTimeout(function () {
callback(null, a + b);
}, 500);
}
// 解决方案
// 1. promisify
const promiseAdd = (a, b) => new Promise((resolve, reject) => {
asyncAdd(a, b, (err, res) => {
if (err) {
reject(err)
} else {
resolve(res)
}
})
})
// 2. 串行处理
async function serialSum(...args) {
return args.reduce((task, now) => task.then(res => promiseAdd(res, now)), Promise.resolve(0))
}
// 3. 并行处理
async function parallelSum(...args) {
if (args.length === 1) return args[0]
const tasks = []
for (let i = 0; i < args.length; i += 2) {
tasks.push(promiseAdd(args[i], args[i + 1] || 0))
}
const results = await Promise.all(tasks)
return parallelSum(...results)
}
// 测试
(async () => {
console.log('Running...');
const res1 = await serialSum(1, 2, 3, 4, 5, 8, 9, 10, 11, 12)
console.log(res1)
const res2 = await parallelSum(1, 2, 3, 4, 5, 8, 9, 10, 11, 12)
console.log(res2)
console.log('Done');
})()
💬 面试官追问
同事把每个数都
promiseAdd(0, n)后Promise.all,再本地reduce相加,算对了吗?数字是对的,题意错了。题目要的是每一步加法都走异步接口,最后那次本地
+等于绕过了约束。真要并行,就得像树形那样一轮轮两两调用promiseAdd。parallelSum()一个参数都不传,会发生什么?args.length是0,不进length === 1的出口,Promise.all([])返回[],又调parallelSum(),无限循环。因为是async不会爆栈,但会一直占着微任务队列。开头补一句if (!args.length) return 0就行。数字变成
10万个,后端限制同时最多50次加法,parallelSum还能直接用吗?不能,第一轮就会同时发
5万个请求。每一轮的数对要丢进并发池,50个一批地跑,跑完一轮再进下一轮;或者干脆改成50条串行链各自累加,最后再两两合并。中间某次
asyncAdd回调报错了,两种写法表现有什么不同?串行版那一步
reject后,后面的then都跳过,直接进catch。并行版Promise.all快速失败,但同一轮里其他setTimeout照样会跑完,只是结果没人要了。什么时候反而该选串行?
后一步依赖前一步结果,或者下游明确不让并发,比如每次累加都要写同一条账本记录。纯算和、彼此独立,就用并行。
# 5 实现有并行限制的 Promise 调度器
⚡ 30 秒速记
- 三件套:任务队列
queue+ 运行计数runCounts+ 上限maxCount - 队列里存的是「返回
Promise的函数」,不是Promise,否则一push就开跑了 - 启动先拉满
limit个,任意一个结束就runCounts--再补一个,像银行只开两个窗口叫号 1000/500/300/400两并发 → 输出2 3 1 4,500ms出2、800ms出3、1000ms出1、1200ms出4- 易错:释放名额只写在
then里,任务reject就永远占着坑,要放finally
并发调度器说白了就是叫号:只开 limit 个窗口,走一个补一个。 关键是 add 只把「创建 Promise 的函数」入队,真正执行推迟到 request 里,这样才控制得住启动时机。每个任务结束时 runCounts-- 再调一次 request,空出来的名额马上被下一个占上,所以输出是 2 3 1 4。这种写法最大的坑是失败分支:只在 then 里释放,某个任务 reject 了名额就漏掉,跑着跑着调度器就卡死,我会改成 finally。
request() {
if (!this.queue.length || this.runCounts >= this.maxCount) return
this.runCounts++
this.queue.shift()()
.catch(err => console.error(err))
.finally(() => { this.runCounts--; this.request() }) // 成功失败都释放
}
题目描述:JS 实现一个带并发限制的异步调度器 Scheduler,保证同时运行的任务最多有两个
addTask(1000,"1");
addTask(500,"2");
addTask(300,"3");
addTask(400,"4");
的输出顺序是:2 3 1 4
整个的完整执行流程:
一开始1、2两个任务开始执行
500ms时,2任务执行完毕,输出2,任务3开始执行
800ms时,3任务执行完毕,输出3,任务4开始执行
1000ms时,1任务执行完毕,输出1,此时只剩下4任务在执行
1200ms时,4任务执行完毕,输出4
实现代码如下:
class Scheduler {
constructor(limit) {
this.queue = [];
this.maxCount = limit;
this.runCounts = 0;
}
add(time, order) {
const promiseCreator = () => {
return new Promise((resolve, reject) => {
setTimeout(() => {
console.log(order);
resolve();
}, time);
});
};
this.queue.push(promiseCreator);
}
taskStart() {
for (let i = 0; i < this.maxCount; i++) {
this.request();
}
}
request() {
if (!this.queue || !this.queue.length || this.runCounts >= this.maxCount) {
return;
}
this.runCounts++;
this.queue
.shift()()
.then(() => {
this.runCounts--;
this.request();
});
}
}
const scheduler = new Scheduler(2);
const addTask = (time, order) => {
scheduler.add(time, order);
};
addTask(1000, "1");
addTask(500, "2");
addTask(300, "3");
addTask(400, "4");
scheduler.taskStart();
💬 面试官追问
某个任务
reject了,只在then里释放名额,后面的任务还会跑吗?会少一个并发名额。
then不执行,runCounts不减也不补位,limit是2的话就只剩一条线在跑,再失败一次就全停了,还附带一个未处理的rejection。释放逻辑挪到finally。调用
add的地方想拿到这个任务自己的结果,接口怎么改?add返回一个新的Promise,把它的resolve/reject和任务函数一起塞进队列,任务真正跑完时再结算。写法大概是queue.push({ fn, resolve, reject }),调用方就能await scheduler.add(fn)。能不能直接传
fetch(url)进去,而不是() => fetch(url)?不行,
fetch(url)一写出来请求就发了,调度器再怎么排队都晚了。必须传函数,让调度器决定什么时候调用它。任务完成顺序是
2 3 1 4,但业务要按提交顺序1 2 3 4拿结果,改执行顺序吗?不改执行,改收集。入队时记下标,完成时写
results[i],全部结束再返回。别为了顺序把并发砍成串行,那就失去意义了。接口限流
2个,直接Promise.all(urls.map(fetch))有什么问题?map那一下50个请求全发出去了,Promise.all只负责等,不负责控制启动。要限流就得用这种调度器,或者p-limit这类库。
# 6 图片懒加载
⚡ 30 秒速记
- 思路:先放占位图,真实地址放
data-src,进视口再赋给src - 判断可见:
rect.top < 视口高 && rect.bottom > 0,只看顶边或底边在不在视口里的话,超长图会漏判 - 手写版要监听
load+scroll并节流;每次滚动都getBoundingClientRect会触发布局,图多了很卡 - 现在首选
IntersectionObserver,进视口加载后unobserve,rootMargin控制提前量 - 普通场景直接
<img loading="lazy">;别忘了写width/height或aspect-ratio防跳动
懒加载就是图片快露脸了才去下载,先给个占位图,进视口再把 data-src 换到 src。 手写版用 scroll 加 getBoundingClientRect 算,能用但有两个问题:一个是只判断顶边或底边在视口里,比屏幕还高的长图滚到中间会被判成不可见;另一个是滚动时反复读布局,图一多主线程就忙。现在我一般用 IntersectionObserver,浏览器帮你算交叉,回调里换地址、unobserve 就完了。文章页这种简单场景,loading="lazy" 一个属性就够。
const io = new IntersectionObserver(entries => {
entries.forEach(e => {
if (!e.isIntersecting) return
e.target.src = e.target.dataset.src
io.unobserve(e.target) // 加载过的不再观察
})
}, { rootMargin: '300px 0px' }) // 提前 300px 开始加载
document.querySelectorAll('img[data-src]').forEach(img => io.observe(img))
// <img src="default.png" data-src="https://xxxx/real.png">
function isVisible(el) {
const position = el.getBoundingClientRect()
const windowHeight = document.documentElement.clientHeight
// 顶部边缘可见
const topVisible = position.top > 0 && position.top < windowHeight;
// 底部边缘可见
const bottomVisible = position.bottom < windowHeight && position.bottom > 0;
return topVisible || bottomVisible;
}
function imageLazyLoad() {
const images = document.querySelectorAll('img')
for (let img of images) {
const realSrc = img.dataset.src
if (!realSrc) continue
if (isVisible(img)) {
img.src = realSrc
img.dataset.src = ''
}
}
}
// 测试
window.addEventListener('load', imageLazyLoad)
window.addEventListener('scroll', imageLazyLoad)
// or
window.addEventListener('scroll', throttle(imageLazyLoad, 1000))
💬 面试官追问
一张比屏幕还高的长图,滚到中间时整屏都是它,
isVisible却返回false,为什么?这时候顶边在视口上面、底边在视口下面,两个条件都不满足。判断要改成区间有交集:
rect.top < windowHeight && rect.bottom > 0。列表放在一个自己滚动的
div里,滚动时图片一张都不加载,漏了什么?监听的是
window的scroll,内部容器滚动不会冒泡到window。要么监听容器自己的scroll,并以容器的矩形做比较;用IntersectionObserver的话把root设成这个容器。线上反馈有些图滚到眼前还是占位图,刷新又好了,先怀疑哪儿?
先看网络面板那张图有没有发请求、是不是失败了。如果赋值
src的同时就清空了data-src,加载失败后再也没机会重试。我会在onload里再清标记,onerror里保留地址做一次重试。直接全站加
loading="lazy"行不行?文章页、商品详情这类普通场景完全可以,零代码。要精确控制提前量、要埋曝光点、或者在复杂滚动容器里,就还得用
IntersectionObserver。首屏那张主图别加,加了反而拖慢LCP。图片加载完列表一直往下跳,用户点错商品,怎么治?
懒加载只管什么时候下载,不管占位。给
img写死width/height,或者容器用aspect-ratio: 1 / 1,浏览器提前留好位置,CLS就下来了。
# 7 实现 getValue/setValue 函数来获取path对应的值
⚡ 30 秒速记
- 核心两步:先把路径解析成数组,再逐层取 / 逐层建
- 解析:
'a[0].b.c'→['a', '0', 'b', 'c'],正则把[0]换成.0再split('.') getValue:中途遇到null/undefined立刻返回默认值,?.思路一样setValue:中间缺容器就补,下一段是数字建数组、否则建对象- 坑:只
split('.')处理不了[0];Proxy递归搜同名字段不是按路径取值;外部路径要拦__proto__
这题其实就是手写 lodash 的 get / set,难点在路径解析,不在取值。 先把 a[0].b.c 规范成 ['a', '0', 'b', 'c'],然后一层层往下走,任何一层拿到 null 或 undefined 就返回默认值。set 反过来,路上缺什么就补什么,下一段是数字就补数组,不是就补对象。只按点号切的话,a[0] 会被当成一个键,示例跑不出 3;至于 Proxy 按名字全树搜索的写法,重名字段拿到哪个全看遍历顺序,不建议用。
// 示例
var object = { a: [{ b: { c: 3 } }] }; // path: 'a[0].b.c'
var array = [{ a: { b: [1] } }]; // path: '[0].a.b[0]'
function getValue(target, valuePath, defaultValue) {}
console.log(getValue(object, "a[0].b.c", 0)); // 输出3
console.log(getValue(array, "[0].a.b[0]", 12)); // 输出 1
console.log(getValue(array, "[0].a.b[0].c", 12)); // 输出 12
实现
function parsePath(path) {
// 'a[0].b.c' -> ['a', '0', 'b', 'c'],'[0].a.b[0]' -> ['0', 'a', 'b', '0']
return path.replace(/\[(\d+)\]/g, '.$1').split('.').filter(Boolean)
}
function getValue(target, path, defaultValue) {
let cur = target
for (const key of parsePath(path)) {
if (cur == null) return defaultValue // null 或 undefined 都停
cur = cur[key]
}
return cur === undefined ? defaultValue : cur
}
function setValue(target, path, value) {
const keys = parsePath(path)
let cur = target
keys.forEach((key, i) => {
if (['__proto__', 'constructor', 'prototype'].includes(key)) throw new Error('非法路径')
if (i === keys.length - 1) { cur[key] = value; return }
if (cur[key] == null || typeof cur[key] !== 'object') {
cur[key] = /^\d+$/.test(keys[i + 1]) ? [] : {} // 下一段是数字就建数组
}
cur = cur[key]
})
return target
}
getValue({ a: [{ b: { c: 3 } }] }, 'a[0].b.c', 0) // 3
getValue([{ a: { b: [1] } }], '[0].a.b[0]', 12) // 1
getValue([{ a: { b: [1] } }], '[0].a.b[0].c', 12) // 12
setValue({}, 'users[1].name', 'A') // { users: [ <empty>, { name: 'A' } ] }
关键点:路径解析独立出来,[0] 和点号都能认;set 时按下一段决定补数组还是对象;拦掉 __proto__ 这类路径,防止原型污染。真实项目里直接用 lodash.get / lodash.set 就行,它还处理了 a['b.c'] 这种带引号的键。
使用promise来实现
创建 enhancedObject 函数
const enhancedObject = (target) =>
new Proxy(target, {
get(target, property) {
if (property in target) {
return target[property];
} else {
return searchFor(property, target); //实际使用时要对value值进行复位
}
},
});
let value = null;
function searchFor(property, target) {
for (const key of Object.keys(target)) {
if (typeof target[key] === "object") {
searchFor(property, target[key]);
} else if (typeof target[property] !== "undefined") {
value = target[property];
break;
}
}
return value;
}
使用 enhancedObject 函数
const data = enhancedObject({
user: {
name: "test",
settings: {
theme: "dark",
},
},
});
console.log(data.user.settings.theme); // dark
console.log(data.theme); // dark
以上代码运行后,控制台会输出以下代码:
dark
dark
通过观察以上的输出结果可知,使用
enhancedObject函数处理过的对象,我们就可以方便地访问普通对象内部的深层属性。
💬 面试官追问
getValue(object, 'a[0].b.c')只用split('.')切路径,为什么拿不到3?切出来第一段是
'a[0]',对象上没有叫这个名字的键,直接返回默认值。先path.replace(/\[(\d+)\]/g, '.$1')把下标转成点号,再切,记得过滤掉开头[0]产生的空串。对象里
b: undefined真实存在,和路径不存在怎么区分?只看取到的值是
undefined区分不了。要区分就在每一层用Object.hasOwn(cur, key)或key in cur判断,看业务要的是「值为空给默认值」还是「键不存在才给默认值」。setValue(data, 'users[2].name', 'A'),users还不存在,建数组还是对象?看下一段:
'2'是非负整数,所以users建成数组,users[2]下一段是name,建对象。结果是[ , , { name: 'A' } ],前两个是空槽,业务不接受稀疏数组就得提前校验。路径来自接口参数,有人传
__proto__.isAdmin,会怎样?逐层写下去就把
Object.prototype污染了,之后所有对象都有isAdmin: true。解析完直接拒绝__proto__、constructor、prototype这几段,能上白名单就上白名单。用
Proxy写data.theme自动深搜,比写路径方便,为什么不推荐?两个模块都有
theme时,拿到哪个看遍历顺序,调用方没法确定。searchFor还用了全局变量value存结果,上一次的值会串到下一次查询里。按路径取值语义是确定的,这点比方便重要。
# 8 创建10个标签,点击的时候弹出来对应的序号
⚡ 30 秒速记
- 关键在
let:每轮循环都是新的i绑定,回调闭包各拿各的 - 换成
var就只有一个i,点击时循环早结束了,全弹10 var时代的解法:IIFE传参,或者把序号存到dataset.index上- 回调用普通函数时
this= 当前a;e.preventDefault()阻止链接跳转 - 工程写法:容器查一次、
DocumentFragment批量插、父元素事件委托
这题考的是闭包和块级作用域:let 在 for 里每一轮都会生成一个新的 i,所以每个点击回调记住的是自己那一轮的值。 如果写成 var,整个函数只有一个 i,等你去点的时候循环早跑完了,读到的都是 10。老代码里的解法是用立即执行函数把 i 当参数传进去。实际项目里我更倾向事件委托:把序号写到 data-index 上,只在父容器绑一个监听,节点再多也不用一个个绑。
for (var i = 0; i < 3; i++) setTimeout(() => console.log(i)) // 3 3 3
for (let i = 0; i < 3; i++) setTimeout(() => console.log(i)) // 0 1 2
var a
for(let i=0;i<10;i++){
a=document.createElement('a')
a.innerHTML=i+'<br>'
a.addEventListener('click',function(e){
console.log(this) //this为当前点击的<a>
e.preventDefault() //如果调用这个方法,默认事件行为将不再触发。
//例如,在执行这个方法后,如果点击一个链接(a标签),浏览器不会跳转到新的 URL 去了。我们可以用 event.isDefaultPrevented() 来确定这个方法是否(在那个事件对象上)被调用过了。
alert(i)
})
const d=document.querySelector('div')
d.appendChild(a) //append向一个已存在的元素追加该元素。
}
💬 面试官追问
改成
var i后,this还是当前标签,序号却全是10,为什么?this看的是事件派发时谁触发的回调,跟循环变量无关;i是闭包读的,var只有一份,点击时已经变成10。两件事各管各的。不让用
let,怎么修?用
IIFE:(function (j) { a.onclick = () => alert(j) })(i),每次调用都有自己的j。或者a.dataset.index = i,回调里读this.dataset.index,连闭包都不需要。标签从
10个变成接口返回的5000个,还每个单独绑监听吗?不绑了,在父容器上绑一个,
e.target.closest('a[data-index]')找到被点的那个再读序号。增删节点也不用管监听器的挂载和卸载。标签里加了个图标,埋点里的
e.target有时是a有时是svg,怎么稳定拿序号?e.target是最里层被点中的元素。单独绑定就用e.currentTarget,它永远是绑监听的那个a;委托的话用closest往上找。这里用
a标签合适吗?只是弹个序号,没有跳转,语义上该是
<button type="button">。用a还得preventDefault,没写href时键盘也聚焦不到,等于自己模拟按钮行为。
# 9 版本号排序的方法
⚡ 30 秒速记
- 思路:按
.拆段,从左往右逐段按数字比,第一段不同就分出大小 - 降序写
s2 - s1;字符串相减会隐式转数字,'302' - '1'是301 - 一边先比完:可以让段数多的排前面,但
4.3和4.3.0是否相等要自己定规则(常见做法缺的段补0) sort不会删元素,6个版本排完还是6个:4.3.5, 4.3.4.5, 4.2, 2.3.3, 0.302.1, 0.1.1- 带
-alpha/-beta的语义化版本别手写,用semver.compare
版本号不能直接按字符串排,'0.302.1' 和 '0.1.1' 按字典序比会出错,要拆成段逐段按数字比。 从第一段开始,相同就看下一段,不同就直接返回差值,降序就是 s2 - s1。有一边先比完的情况要定个规矩,可以让段数多的排前面,我更习惯把缺的段当 0,这样 1.0 和 1.0.0 算相等。排完的结果是 4.3.5, 4.3.4.5, 4.2, 2.3.3, 0.302.1, 0.1.1,6 个一个不少。
const cmp = (a, b) => {
const x = a.split('.'), y = b.split('.')
for (let i = 0; i < Math.max(x.length, y.length); i++) {
const d = (+y[i] || 0) - (+x[i] || 0) // 缺的段当 0
if (d) return d
}
return 0
}
['0.1.1', '2.3.3', '0.302.1', '4.2', '4.3.5', '4.3.4.5'].sort(cmp)
// ['4.3.5', '4.3.4.5', '4.2', '2.3.3', '0.302.1', '0.1.1']
题目描述:有一组版本号如下 ['0.1.1', '2.3.3', '0.302.1', '4.2', '4.3.5', '4.3.4.5']。现在需要对其进行排序,排序的结果为 ['4.3.5','4.3.4.5','2.3.3','0.302.1','0.1.1']
arr.sort((a, b) => {
let i = 0;
const arr1 = a.split(".");
const arr2 = b.split(".");
while (true) {
const s1 = arr1[i];
const s2 = arr2[i];
i++;
if (s1 === undefined || s2 === undefined) {
return arr2.length - arr1.length;
}
if (s1 === s2) continue;
return s2 - s1;
}
});
console.log(arr);
💬 面试官追问
为什么不能直接
arr.sort()或者用字符串比较?字符串是逐字符比的,
'10.0'会排在'9.0'前面(升序时),因为'1' < '9'。每段必须转成数字再比。1.01和1.1先比字符串、不等再相减,结果是什么?'01' === '1'是false,走到s2 - s1,1 - 1得0,直接返回相等,后面的段都不比了。正好碰对了,但逻辑是靠运气,统一先转数字再比才稳。某段数字特别长,超过
Number.MAX_SAFE_INTEGER怎么办?转数字会丢精度,不同的版本可能比成相等。改成按字符串比:去掉前导零,先比长度,长度一样再比字典序。
列表里混进了空串、
1..2这种脏数据,排序结果每次不一样,怎么回事?脏段转出来是
NaN,比较器返回NaN,sort的契约被破坏,结果就不稳定。排序前先用/^\d+(\.\d+)*$/校验,不合格的单独处理。要支持
1.0.0-beta.2这种版本,还用这个比较器吗?不用。
semver规定预发布版本小于正式版,beta.2和beta.10还得按段比,构建元数据+build不参与比较。规则一多就直接上semver库。
# 10 请实现 DOM2JSON 一个函数,可以把一个 DOM 节点输出 JSON 的格式
⚡ 30 秒速记
- 本质是递归遍历
DOM树:当前节点 →{ tag, children },子节点递归后塞进children - 用
children只遍历元素节点;childNodes会带上换行产生的文本节点,结果里多出tag: undefined - 字段名按题目要求写
tag,别顺手写成name - 要导出文字和属性就按
nodeType分支,属性从attributes转成对象 - 嵌套特别深时递归会爆栈,改显式栈迭代
这题就是一棵树转成另一棵树,递归最自然:每个节点记下 tagName,再把子节点挨个转换后放进 children。 容易踩的是用 childNodes,HTML 里的换行和缩进会变成文本节点,结果里冒出一堆没有标签名的节点。按题意遍历 children 就行,它只包含元素节点;字段名也要和题目一致叫 tag。
function dom2Json(el) {
return {
tag: el.tagName,
children: [...el.children].map(dom2Json), // 只要元素节点
}
}
<div>
<span>
<a></a>
</span>
<span>
<a></a>
<a></a>
</span>
</div>
把上面dom结构转成下面的JSON格式
{
tag: 'DIV',
children: [
{
tag: 'SPAN',
children: [
{ tag: 'A', children: [] }
]
},
{
tag: 'SPAN',
children: [
{ tag: 'A', children: [] },
{ tag: 'A', children: [] }
]
}
]
}
实现代码如下:
function dom2Json(domtree) {
let obj = {};
obj.name = domtree.tagName;
obj.children = [];
domtree.childNodes.forEach((child) => obj.children.push(dom2Json(child)));
return obj;
}
💬 面试官追问
用
childNodes遍历格式化过的HTML,为什么多出几个空节点?换行和缩进在
DOM里是文本节点,nodeType === 3,没有tagName。只要元素树就用children,或者过滤nodeType === 1。富文本导出要保留文字,换成
children不就丢了吗?对,
children会把文本全扔掉。这时要按节点类型分:元素输出{ tag, attrs, children },文本输出{ type: 'text', content },再决定纯空白的文本要不要保留。还要记录
<input disabled data-id="7">上的属性,怎么取?Object.fromEntries([...el.attributes].map(a => [a.name, a.value]))。注意disabled这种布尔属性值是空串,回放时别当成false。页面有上万层嵌套,跑起来报
Maximum call stack size exceeded,怎么改?换成显式栈:栈里放「源节点 + 它对应的
JSON对象」,弹出一个就创建子对象挂上去,再把子节点压栈。深度就不受调用栈限制了,内存占用还是一样多。反过来要把这份
JSON还原成DOM,怎么写?也是递归:
document.createElement(node.tag),挂属性,子节点递归后appendChild。属性来自外部数据的话,on开头的事件属性要过滤,别直接塞进页面。
# 11 分片思想解决大数据量渲染问题
⚡ 30 秒速记
- 思路:大任务拆小批,每帧
requestAnimationFrame插20条,主线程有空隙响应交互 - 每批先拼进
DocumentFragment再一次appendChild,减少插入次数 - 分片只解决「一次性卡死」,最终节点数一个没少,
10万个li照样吃内存、滚动卡 - 条数固定不等于耗时固定,复杂卡片要按时间预算切(每帧跑够
8ms就让出) - 数据量大或结构复杂直接上虚拟列表,只渲染视口内那几十条
分片渲染就是把一口气插 10 万条的长任务,拆成每帧插 20 条的小任务,让浏览器在批次之间能处理点击、滚动和绘制。 用 requestAnimationFrame 是因为它跟着屏幕刷新走,每帧干一小份活,不会掉帧到白屏。但它只是把卡顿摊开了,最后页面上还是 10 万个节点,内存、布局、滚动的成本都在。所以这招适合结构简单、量没那么夸张的列表;真到百万级或者每条都是复杂卡片,我会直接用虚拟列表。
function renderChunk(start) {
if (start >= total) return
requestAnimationFrame(() => {
const frag = document.createDocumentFragment()
for (let i = start; i < Math.min(start + 20, total); i++) {
const li = document.createElement('li')
li.textContent = i
frag.appendChild(li)
}
ul.appendChild(frag) // 一批只插一次
renderChunk(start + 20)
})
}
题目描述: 渲染百万条结构简单的大数据时 怎么使用分片思想优化渲染
let ul = document.getElementById("container");
// 插入十万条数据
let total = 100000;
// 一次插入 20 条
let once = 20;
//总页数
let page = total / once;
//每条记录的索引
let index = 0;
//循环加载数据
function loop(curTotal, curIndex) {
if (curTotal <= 0) {
return false;
}
//每页多少条
let pageCount = Math.min(curTotal, once);
window.requestAnimationFrame(function () {
for (let i = 0; i < pageCount; i++) {
let li = document.createElement("li");
li.innerText = curIndex + i + " : " + ~~(Math.random() * total);
ul.appendChild(li);
}
loop(curTotal - pageCount, curIndex + pageCount);
});
}
loop(total, index);
扩展思考:对于大数据量的简单 dom 结构渲染可以用分片思想解决 如果是复杂的 dom 结构渲染如何处理?
这时候就需要使用虚拟列表了,虚拟列表和虚拟表格在日常项目使用还是很多的
💬 面试官追问
分片之后首屏不卡了,但全部加载完滚动还是很卡,为什么?
分片只是把创建节点的时间摊到了很多帧里,最终
10万个DOM节点一个都没少。滚动时的布局和绘制成本还在,这种量级就该换虚拟列表。每帧固定插
20条,低端机还是掉帧,怎么调?条数固定不等于耗时固定。改成按时间预算切:循环里
performance.now()计时,超过8ms就停,剩下的留给下一帧。分片渲染到一半用户换了搜索词,旧数据还在往列表里追加,怎么办?
每次渲染发一个任务
id,回调开头判断id还是不是当前的,不是就直接退出;同时保存requestAnimationFrame的返回值,换词时cancelAnimationFrame掉。requestAnimationFrame和setTimeout(fn, 0)拆批,有什么区别?requestAnimationFrame跟刷新率对齐,一帧一批,插完紧接着渲染;setTimeout不管帧,可能一帧里塞好几批,也可能空几帧。另外requestAnimationFrame在后台标签页会暂停,setTimeout不会。聊天记录是不定高、带图片的,用虚拟列表难在哪?
高度没法提前知道,只能先估一个高度,渲染后测量真实高度缓存起来,图片加载完还要再修正,同时保持滚动位置不跳。比定高列表复杂一截,一般直接用
react-virtuoso这类现成库。
# 12 实现一个add方法完成两个大数相加
⚡ 30 秒速记
- 超过
Number.MAX_SAFE_INTEGER(2^53 - 1)的整数用Number算会丢精度,所以按字符串逐位算 - 先
padStart补齐长度,从末位往前:当前位 =(a + b + 进位) % 10,进位 =Math.floor(sum / 10) - 循环完还有进位,前面再补一个
1 - 每位结果
push到数组最后reverse().join(''),比反复在字符串头部拼接省 - 现代环境一行搞定:
(BigInt(a) + BigInt(b)).toString(),但要从字符串构造
大数相加就是把小学竖式搬到代码里:两个数当字符串,从个位开始逐位相加,满十进一。 之所以不能直接 Number(a) + Number(b),是因为 JS 的数字是双精度浮点,超过 2^53 - 1 的整数就表示不准了。先用 padStart 把短的补零对齐,从右往左算,每位取 % 10,进位留给下一位,最后别忘了最高位的进位。面试时写完我会顺嘴提一句 BigInt,生产里能用就用它。
9007199254740993 + 0 // 9007199254740992,已经错了
add('999', '1') // '1000'
(BigInt('9007199254740993') + 1n).toString() // '9007199254740994'
// 题目
let a = "9007199254740991";
let b = "1234567899999999999";
function add(a ,b){
//...
}
实现代码如下:
function add(a ,b){
//取两个数字的最大长度
let maxLength = Math.max(a.length, b.length);
//用0去补齐长度
a = a.padStart(maxLength , 0);//"0009007199254740991"
b = b.padStart(maxLength , 0);//"1234567899999999999"
//定义加法过程中需要用到的变量
let t = 0;
let f = 0; //"进位"
let sum = "";
for(let i=maxLength-1 ; i>=0 ; i--){
t = parseInt(a[i]) + parseInt(b[i]) + f;
f = Math.floor(t/10);
sum = t%10 + sum;
}
if(f!==0){
sum = '' + f + sum;
}
return sum;
}
💬 面试官追问
为什么不能直接把字符串转成数字相加?
JS只有一种Number,是64位浮点,能精确表示的整数上限是2^53 - 1。题目里的1234567899999999999早超了,转完就已经不是原来的数。调用方传的是数字
12345678901234567890而不是字符串,能算对吗?算不对,数字在传进来之前就丢精度了,函数里再转字符串也救不回来。接口要约定只收字符串,最好入口就
/^\d+$/校验,不合格直接抛错。两个数都有上百万位,
sum = digit + sum这种拼法有什么问题?每次在头部拼接都可能生成新字符串,位数一多就有大量拷贝。改成每位
push进数组,最后reverse().join('')。要支持负数,比如
-120加35,在这个基础上怎么扩展?先拆符号。同号就复用加法再带上符号;异号要比绝对值大小,用大的减小的写一个大数减法(逐位借位),符号跟大的走。
已经有
BigInt了,还需要手写吗?业务里能用就用
BigInt,注意它不能和Number混算,JSON.stringify也会直接报错,传给后端要先toString()。手写主要是面试考进位思路,或者带小数的金额场景(BigInt只管整数)。
# 13 怎么在制定数据源里面生成一个长度为 n 的不重复随机数组 能有几种方法 时间复杂度多少(字节)
⚡ 30 秒速记
- 本质是「无放回随机抽样」:从
m个里不重复地抽n个 - 查重法:
includes判重,O(n²)还不止,越接近抽满重试越多;撞重复只能i--重抽,写成break结果会不足n个 - 标记法:哈希记已抽下标,
n远小于m时期望O(n);结果里要放testArray[ran],别push(ran)放成下标 - 交换法(部分
Fisher-Yates):抽中的和未抽区末尾互换,严格O(n),复制数组另算O(m),首选 splice版不是O(n):每次删除要搬移后面的元素,最坏O(n·m)
这题本质是无放回随机抽样,我首选交换法,也就是 Fisher-Yates 洗牌只洗前 n 步。 每次在还没抽过的区间里随机挑一个,把它和区间末尾交换,区间缩小一格,这样抽 n 次就是 n 次,不会重试,每个元素概率也一样。另外几种写法各有坑:查重法撞到重复要 i-- 继续抽,一 break 就跳出循环,结果长度不够;标记法记的是下标,结果里别把下标当元素放进去;splice 版看着是 O(n),其实每次 splice 都要搬移数组,不算 O(n)。
function sample(arr, n) {
if (n > arr.length) throw new Error('n 超过数据源长度')
const a = [...arr], res = []
for (let i = 0; i < n; i++) {
const end = a.length - 1 - i
const r = Math.floor(Math.random() * (end + 1)) // [0, end] 里随机
res.push(a[r])
;[a[r], a[end]] = [a[end], a[r]] // 抽中的换到末尾,不再参与
}
return res
}
第一版 时间复杂度为 O(n^2)
function getTenNum(testArray, n) {
let result = [];
for (let i = 0; i < n; ++i) {
const random = Math.floor(Math.random() * testArray.length);
const cur = testArray[random];
if (result.includes(cur)) {
i--;
break;
}
result.push(cur);
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 10);
第二版 标记法 / 自定义属性法 时间复杂度为 O(n)
function getTenNum(testArray, n) {
let hash = {};
let result = [];
let ranNum = n;
while (ranNum > 0) {
const ran = Math.floor(Math.random() * testArray.length);
if (!hash[ran]) {
hash[ran] = true;
result.push(ran);
ranNum--;
}
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 10);
第三版 交换法 时间复杂度为 O(n)
function getTenNum(testArray, n) {
const cloneArr = [...testArray];
let result = [];
for (let i = 0; i < n; i++) {
debugger;
const ran = Math.floor(Math.random() * (cloneArr.length - i));
result.push(cloneArr[ran]);
cloneArr[ran] = cloneArr[cloneArr.length - i - 1];
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 14);
值得一提的是操作数组的时候使用交换法 这种思路在算法里面很常见
最终版 边遍历边删除 时间复杂度为 O(n)
function getTenNum(testArray, n) {
const cloneArr = [...testArray];
let result = [];
for (let i = 0; i < n; ++i) {
const random = Math.floor(Math.random() * cloneArr.length);
const cur = cloneArr[random];
result.push(cur);
cloneArr.splice(random, 1);
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 14);
💬 面试官追问
第一版从
14个里抽10个,经常不够10个,哪里错了?命中重复时写的是
i--; break,break直接跳出整个for,后面不抽了。改成continue才是重抽;不过越抽到后面重复越多,循环次数不稳定。从一百万条里只抽
10条,交换法还要复制一百万的数组吗?不划算。
n远小于m时用标记法,Set记已抽下标,碰撞概率很低,期望接近O(n),额外空间只有O(n)。想要严格O(n)又不复制,可以用Map记录被交换过的位置,做「稀疏版」Fisher-Yates。有人说
splice版是O(n),你怎么回?循环是
n次,但splice从中间删元素要把后面的全往前挪,单次是O(m)。抽的比例一高,总成本就是O(n·m),换交换法就没有搬移。数据源里本身有重复值,比如两个
5,结果算「不重复」吗?看需求定义。按下标抽,两个
5都可能被抽中;要求值唯一,就得先[...new Set(arr)]去重,再确认去重后的数量够n。抽奖要求公平,
Math.random()够吗?做
UI随机展示够了。涉及奖品、金额,最好在服务端抽,前端可以用crypto.getRandomValues,Math.random()不是密码学安全的,结果也不该由用户的浏览器决定。
# 14 查找数组公共前缀(美团)
⚡ 30 秒速记
- 横向扫描:拿第一个串当候选,逐字符加长前缀,所有串都
startsWith才继续 - 也可以纵向:按位置
i比每个串的第i个字符,碰到不同或越界就停 - 复杂度
O(S),S是所有字符总数;每轮slice再startsWith也能做,直接比字符更省分配 - 边界:空数组要先判,否则
strs[0].length直接报错;有空串结果就是"" - 加分:先排序只比首尾两个串也行,但排序是
O(n log n),没必要
我一般用纵向扫描:以第一个字符串为基准,一位一位比,某个位置上有任何一个串对不上,前面那段就是答案。 还有一种写法是每次截一个更长的前缀,再看所有串是不是都以它开头,思路一样,只是每轮都 slice 出新字符串,稍微浪费一点。复杂度都是所有字符的总数。边界要注意空数组,strs[0] 是 undefined,一读 .length 就报错,开头补一句 if (!strs.length) return ''。
function lcp(strs) {
if (!strs.length) return ''
const first = strs[0]
for (let i = 0; i < first.length; i++) {
if (strs.some(s => s[i] !== first[i])) return first.slice(0, i)
}
return first
}
lcp(['flower', 'flow', 'flight']) // 'fl'
lcp(['dog', 'racecar', 'car']) // ''
题目描述
编写一个函数来查找字符串数组中的最长公共前缀。
如果不存在公共前缀,返回空字符串 ""。
示例 1:
输入:strs = ["flower","flow","flight"]
输出:"fl"
示例 2:
输入:strs = ["dog","racecar","car"]
输出:""
解释:输入不存在公共前缀。
答案
const longestCommonPrefix = function (strs) {
const str = strs[0];
let index = 0;
while (index < str.length) {
const strCur = str.slice(0, index + 1);
for (let i = 0; i < strs.length; i++) {
if (!strs[i] || !strs[i].startsWith(strCur)) {
return str.slice(0, index);
}
}
index++;
}
return str;
};
💬 面试官追问
传入
[]会怎样?strs[0]是undefined,读.length直接抛TypeError。开头if (!strs.length) return ''。数组里有一个空字符串,产品说应该忽略它,怎么处理?
按算法定义,有空串公共前缀就是
"",代码没错。产品要忽略就在调用前filter(Boolean),别改算法本身,不然别的调用方会被坑。字符串里有
emoji,按slice截会出问题吗?会。
emoji在UTF-16里通常占两个码元,前缀刚好截在中间就成了乱码。要按用户看到的字符比,先用Intl.Segmenter或至少[...str]拆开再比。「先排序只比首尾两个」为什么成立?
字典序排好后,第一个和最后一个差异最大,它俩的公共前缀一定也是中间所有串的公共前缀。代码短,但排序是
O(n log n)还改了原数组,纯求前缀没必要。输入是十万条数据的流,一条一条来,怎么算?
维护一个当前前缀,每来一条就和它比,把前缀缩短到公共部分,缩成空串就可以提前结束,不用把数据全攒起来。
# 15 判断括号字符串是否有效(小米)
⚡ 30 秒速记
- 经典栈题:左括号入栈,右括号就弹栈顶看配不配
- 遍历完栈必须为空,不然有没闭合的左括号,比如
"(()" - 一上来就是右括号:栈空
pop()得undefined,映射不上,返回false - 长度为奇数直接
false,算个小剪枝 - 只计数不行,
"([)]"数量对但顺序错,必须用栈
括号匹配是栈的标准用法:后打开的括号必须先闭合,正好是后进先出。 遍历字符串,遇到左括号就压栈,遇到右括号就弹出栈顶,看是不是对应的那一种,不是就直接 false。最后栈里还有东西,说明有左括号没闭合,也是 false。很多人第一反应是数数量,"([)]" 这种交叉的情况就会漏掉,所以必须用栈。时间 O(n),空间最坏 O(n)。
const isValid = s => {
const pair = { ')': '(', ']': '[', '}': '{' }
const stack = []
for (const c of s) {
if (!pair[c]) stack.push(c) // 左括号入栈
else if (stack.pop() !== pair[c]) return false
}
return stack.length === 0
}
isValid('()[]{}') // true
isValid('([)]') // false
题目描述
给定一个只包括 '(',')','{','}','[',']' 的字符串 s ,判断字符串是否有效。
有效字符串需满足:
- 左括号必须用相同类型的右括号闭合。
- 左括号必须以正确的顺序闭合。
示例 1:
输入:s = "()"
输出:true
示例 2:
输入:s = "()[]{}"
输出:true
示例 3:
输入:s = "(]"
输出:false
答案
const isValid = function (s) {
if (s.length % 2 === 1) {
return false;
}
const regObj = {
"{": "}",
"(": ")",
"[": "]",
};
let stack = [];
for (let i = 0; i < s.length; i++) {
if (s[i] === "{" || s[i] === "(" || s[i] === "[") {
stack.push(s[i]);
} else {
const cur = stack.pop();
if (s[i] !== regObj[cur]) {
return false;
}
}
}
if (stack.length) {
return false;
}
return true;
};
💬 面试官追问
"([)]"左右括号数量都一样,为什么不算有效?扫到
)时栈顶是[,不是(,顺序错了。有效不只看数量,还要求最近打开的先关,这正是要用栈的原因。输入是
")"时,代码会不会报错?不会。栈空时
pop()返回undefined,regObj[undefined]也是undefined,和)不等,直接返回false。不过长度是奇数,在第一行就已经返回了。字符串里混着普通字母,比如
"a(b)c",现在的代码能用吗?不能,
else分支把所有非左括号都当右括号处理,字母会触发弹栈然后失败。要么只处理六种括号、其余跳过;要是还要忽略字符串字面量和注释里的括号,那就是写词法分析了。想告诉用户第几个字符出错了,怎么改?
栈里存下标而不是字符,失败时返回当前下标;遍历完栈不空,栈顶的下标就是那个没闭合的左括号位置。
用正则反复删
()、[]、{}直到删不动,行不行?短字符串能用,但每轮都生成新字符串,深层嵌套要删很多轮,最坏
O(n²)。栈一遍扫完,还能报出错位置,没理由不用栈。
# 16 实现一个padStart()或padEnd()的polyfil
⚡ 30 秒速记
padStart(targetLength, padString = ' '):在开头补到目标长度,padEnd补在末尾- 原长度 ≥ 目标长度、或
padString是空串,直接返回原串 - 正确做法:缺口
diff,padString.repeat(Math.ceil(diff / len)).slice(0, diff)再拼上去 - 别逐字符往前插,多字符填充串顺序会反:
'x'补到6位、填'abc'会得到'bacbax',原生是'abcabx' - 真要做
polyfill:先判断原生是否存在,用Object.defineProperty挂成不可枚举
padStart 的规则是:先算还差几个字符,把填充串重复到够长,从头截出这么多,拼到原字符串前面。 比如 'x'.padStart(4, 'ab'),差 3 个,ab 重复成 abab 截前 3 位 aba,结果 abax。常见的错法是一个字符一个字符往前插,填充串只有一两个字符时看不出问题,换成 'abc' 就反了,'YYYY-MM-DD' 的日期例子也跑不对。目标长度不合法或者是 0 时也别抛错,原生是直接返回原串。所以我会用 repeat + slice 的写法。
String.prototype.padStart 和 String.prototype.padEnd是ES8中新增的方法,允许将空字符串或其他字符串添加到原始字符串的开头或结尾。我们先看下使用语法:
String.padStart(targetLength,[padString])
用法:
'x'.padStart(4, 'ab') // 'abax'
'x'.padEnd(5, 'ab') // 'xabab'
// 1. 若是输入的目标长度小于字符串原本的长度则返回字符串本身
'xxx'.padStart(2, 's') // 'xxx'
// 2. 第二个参数的默认值为 " ",长度是为1的
// 3. 而此参数可能是个不确定长度的字符串,若是要填充的内容达到了目标长度,则将不要的部分截取
'xxx'.padStart(5, 'sss') // ssxxx
// 4. 可用来处理日期、金额格式化问题
'12'.padStart(10, 'YYYY-MM-DD') // "YYYY-MM-12"
'09-12'.padStart(10, 'YYYY-MM-DD') // "YYYY-09-12"
polyfill实现:
if (!String.prototype.padStart) {
Object.defineProperty(String.prototype, 'padStart', {
configurable: true,
writable: true,
enumerable: false, // 不出现在 for...in 里
value: function (targetLength, padString = ' ') {
const str = String(this)
const len = Math.trunc(Number(targetLength)) || 0
const pad = String(padString)
if (len <= str.length || pad === '') return str
const diff = len - str.length
// 重复到够长,再从头截 diff 个
return pad.repeat(Math.ceil(diff / pad.length)).slice(0, diff) + str
},
})
}
'x'.padStart(4, 'ab') // 'abax'
'x'.padStart(6, 'abc') // 'abcabx'
'12'.padStart(10, 'YYYY-MM-DD') // 'YYYY-MM-12'
'abc'.padStart(2) // 'abc'
padEnd 只差最后一行:return str + pad.repeat(...).slice(0, diff)。
注意不要把填充串逐字符插到最前面:每插一个就把前一个往后推,多字符填充串的顺序会被打乱,'YYYY-MM-DD' 那个例子会得到 '-MM-YYYY12'。用「先把填充串拼够长再整体拼接」的思路,顺序天然是对的,也不用双层循环。
💬 面试官追问
逐字符往前插的写法,
'x'补到6位、填'abc',得到什么?每次把一个字符插到最前面,先后插
a b c a b,结果是'bacbax',原生是'abcabx'。单字符填充串测不出这个问题,测试用例一定要带多字符的。'a'.padStart(5, '')返回什么?原生返回
'a',填充串为空就不补了。手写版要在入口判断padString.length === 0直接返回,不然用repeat的写法会除以0。targetLen传0、负数或者'5'这种字符串呢?原生会先转成整数,小于等于原长度就返回原串,
'5'也能当5用。手写版要是用!targetLen判断后直接抛错,就和原生行为不一致了。挂到
String.prototype上,有什么要注意的?先判断
if (!String.prototype.padStart),别覆盖原生实现;用Object.defineProperty挂成enumerable: false,否则for...in遍历字符串对象时会把它带出来。工程里直接引core-js更省事。padStart实际用在哪?补零最常见:
String(9).padStart(2, '0')得'09',日期、时间、订单号都这么补;还有银行卡打码last4.padStart(16, '*')。
# 17 设计一个方法提取对象中所有value大于2的键值对并返回最新的对象
⚡ 30 秒速记
- 一行写法:
Object.fromEntries(Object.entries(obj).filter(([, v]) => v > 2)) - 不改原对象,返回新对象;
Object.entries是ES2017,Object.fromEntries是ES2019 Object.entries只拿自身、可枚举的字符串键,Symbol键和继承属性会被跳过v > 2是宽松比较:'4'会被转成数字留下来,只要数值就加typeof v === 'number'- 老环境没有
fromEntries就reduce或for...in+hasOwnProperty
最简洁的写法是对象转数组、过滤、再转回对象:Object.entries 拆成键值对,filter 留下值大于 2 的,Object.fromEntries 拼回去。 好处是不改原对象,过滤条件集中在一处。要注意 > 会做隐式转换,字符串 '4' 也会被留下,null > 2 是 false,接口数据不干净的时候最好显式判断类型。另外 Object.entries 拿不到 Symbol 键,一般业务对象无所谓,真要的话用 Reflect.ownKeys。
const foo = obj => Object.fromEntries(
Object.entries(obj).filter(([, v]) => typeof v === 'number' && v > 2)
)
foo({ a: 1, b: 3, c: '4', d: 5 }) // { b: 3, d: 5 }
实现:
var obj = { a: 1, b: 3, c: 4 }
foo(obj) // { b: 3, c: 4 }
方法有很多种,这里提供一种比较简洁的写法,用到了ES10的Object.fromEntries():
var obj = { a: 1, b: 3, c: 4 }
function foo (obj) {
return Object.fromEntries(
Object.entries(obj).filter(([key, value]) => value > 2)
)
}
var obj2 = foo(obj) // { b: 3, c: 4 }
console.log(obj2)
// ES8中 Object.entries()的作用:
var obj = { a: 1, b: 2 }
var entries = Object.entries(obj); // [['a', 1], ['b', 2]]
// ES10中 Object.fromEntries()的作用:
Object.fromEntries(entries); // { a: 1, b: 2 }
💬 面试官追问
对象是
{ a: 3, b: '4', c: null },按value > 2过滤会留下哪些?留下
a和b。'4' > 2会先把'4'转成4,null转成0不满足。只想要数字字段就加typeof v === 'number'。不能用
Object.fromEntries,怎么写?Object.keys(obj).reduce((acc, k) => (obj[k] > 2 && (acc[k] = obj[k]), acc), {}),或者直接for...in配Object.hasOwn。性能还更好一点,少了两个中间数组。需求改成嵌套对象也要递归过滤,原方案能直接扩吗?
不能,它只看第一层。要递归:值是普通对象就往下处理,处理完是空对象就删掉这个分支,数组要单独判断保持结构。可能有循环引用的话,用
WeakSet记一下访问过的对象。结果里少了一个
Symbol键,是漏了吗?是
Object.entries的既定行为,它只返回自身可枚举的字符串键。需要Symbol就用Reflect.ownKeys(obj)遍历。用
result[key] = value手写赋值,键里有__proto__会怎样?普通对象上
result['__proto__'] = x会触发原型设置器,改的是原型而不是加一个属性。Object.fromEntries是定义数据属性,不受影响;手写的话用Object.create(null)当结果对象。
# 18 实现一个拖拽
⚡ 30 秒速记
- 三个事件:
mousedown记偏移、mousemove跟着动、mouseup解绑 - 偏移量 = 鼠标坐标 − 元素左上角,移动时
left = clientX - 偏移,拖起来不会跳 mousemove/mouseup要绑在document上,鼠标甩出元素也能接着拖、能松手- 边界:
0到视口宽 - 元素宽之间夹住 - 现代写法:
Pointer Events+setPointerCapture,一套代码兼容鼠标和触屏;动画用transform
拖拽就三步:按下时记住鼠标点在元素的哪个位置,移动时用鼠标坐标减掉这个偏移设成 left / top,松开时把监听解掉。 偏移量是为了不让元素一按下就把左上角跳到鼠标位置。移动和松开要绑在 document 上,鼠标移太快甩出元素也不会断。最容易漏的是把 mouseup 绑在 box 上,在元素外面松手就收不到,方块会一直粘着鼠标。现在我会直接用 pointer 事件,鼠标和手指一套代码。
box.addEventListener('pointerdown', e => {
const rect = box.getBoundingClientRect()
const dx = e.clientX - rect.left, dy = e.clientY - rect.top
box.setPointerCapture(e.pointerId) // 指针移出元素也继续收事件
const move = ev => {
box.style.left = ev.clientX - dx + 'px'
box.style.top = ev.clientY - dy + 'px'
}
const up = () => box.removeEventListener('pointermove', move)
box.addEventListener('pointermove', move)
box.addEventListener('pointerup', up, { once: true })
})
<style>
html, body {
margin: 0;
height: 100%;
}
#box {
width: 100px;
height: 100px;
background-color: red;
position: absolute;
top: 100px;
left: 100px;
}
</style>
<div id="box"></div>
window.onload = function () {
var box = document.getElementById('box');
box.onmousedown = function (ev) {
var oEvent = ev || window.event; // 兼容火狐,火狐下没有window.event
var distanceX = oEvent.clientX - box.offsetLeft; // 鼠标到可视区左边的距离 - box到页面左边的距离
var distanceY = oEvent.clientY - box.offsetTop;
document.onmousemove = function (ev) {
var oEvent = ev || window.event;
var left = oEvent.clientX - distanceX;
var top = oEvent.clientY - distanceY;
if (left <= 0) {
left = 0;
} else if (left >= document.documentElement.clientWidth - box.offsetWidth) {
left = document.documentElement.clientWidth - box.offsetWidth;
}
if (top <= 0) {
top = 0;
} else if (top >= document.documentElement.clientHeight - box.offsetHeight) {
top = document.documentElement.clientHeight - box.offsetHeight;
}
box.style.left = left + 'px';
box.style.top = top + 'px';
}
box.onmouseup = function () {
document.onmousemove = null;
box.onmouseup = null;
}
}
}
💬 面试官追问
在方块外面松开鼠标,方块还跟着鼠标走,为什么?
mouseup如果绑在box上,鼠标在外面松开时box收不到,document.onmousemove一直没被清掉。mouseup也绑到document,或者用setPointerCapture。页面滚动之后再拖,鼠标和方块错开一截,哪里错了?
clientX是相对视口的,offsetLeft是相对定位父元素的,页面滚了两者就不在一个坐标系里。偏移量用getBoundingClientRect()算,都是视口坐标;最终写left时再按容器位置和滚动量换算回去。手机上拖不动,或者一拖整个页面在滚,怎么办?
mouse事件在移动端不可靠,换pointer事件;再给元素加touch-action: none,不然浏览器会把手势当成滚动抢走。拖动时一直改
left/top,复杂页面卡,改transform一定更好吗?大多数时候更好,
transform不触发布局,只走合成。配合requestAnimationFrame每帧只写一次。但松手后要把位移换算成真实位置存下来,碰撞检测也要基于同一套坐标。组件卸载时用户正好在拖,会有什么问题?
绑在
document上的监听没解,回调里还在操作已经卸载的节点,轻则报错重则泄漏。卸载时统一调一次清理函数,pointercancel和窗口blur也走同一个清理。
# 19 基于Promise.all实现Ajax的串行和并行
⚡ 30 秒速记
- 并行:请求互不依赖,
Promise.all([...])一起发,全部成功按原顺序返回,任一失败整体reject - 串行:后一个要等前一个,
await一个个来,或reduce串then Promise.all只管「等」,不管「启动」;tasks.map(t => t())那一刻请求全发出去了- 限并发:开
pool个工作线程,每个跑完一个就去取下一个,结果按results[oldIndex]存 - 要每一项的成功失败都看到,用
Promise.allSettled
并行就是互不依赖的请求一起发、Promise.all 一起等;串行是后一个依赖前一个的结果,只能一个接一个 await。 题目后半段的重点是限并发:直接 Promise.all(tasks.map(t => t())) 会一次性把所有请求发出去,Promise.all 只负责等结果,控制不了启动。createRequest 的做法是开 pool 个工作循环,每个循环跑完一个任务就去公共队列再取一个,结果按原始下标写回,所以最终顺序和任务数组一致。要注意的是一个任务失败只会让外层 Promise.all 先失败,其他循环还会继续发请求。
基于Promise.all实现Ajax的串行和并行
- 串行:请求是异步的,需要等待上一个请求成功,才能执行下一个请求
- 并行:同时发送多个请求「
HTTP请求可以同时进行,但是JS的操作都是一步步的来的,因为JS是单线程」,等待所有请求都成功,我们再去做什么事情?
Promise.all([
axios.get('/user/list'),
axios.get('/user/list'),
axios.get('/user/list')
]).then(results => {
console.log(results);
}).catch(reason => {
});
Promise.all并发限制及async-pool的应用
并发限制指的是,每个时刻并发执行的promise数量是固定的,最终的执行结果还是保持与原来的
const delay = function delay(interval) {
return new Promise((resolve, reject) => {
setTimeout(() => {
// if (interval === 1003) reject('xxx');
resolve(interval);
}, interval);
});
};
let tasks = [() => {
return delay(1000);
}, () => {
return delay(1003);
}, () => {
return delay(1005);
}, () => {
return delay(1002);
}, () => {
return delay(1004);
}, () => {
return delay(1006);
}];
/* Promise.all(tasks.map(task => task())).then(results => {
console.log(results);
}); */
let results = [];
asyncPool(2, tasks, (task, next) => {
task().then(result => {
results.push(result);
next();
});
}, () => {
console.log(results);
});
const delay = function delay(interval) {
return new Promise((resolve, reject) => {
setTimeout(() => {
resolve(interval);
}, interval);
});
};
let tasks = [() => {
return delay(1000);
}, () => {
return delay(1003);
}, () => {
return delay(1005);
}, () => {
return delay(1002);
}, () => {
return delay(1004);
}, () => {
return delay(1006);
}];
JS实现Ajax并发请求控制的两大解决方案
tasks:数组,数组包含很多方法,每一个方法执行就是发送一个请求「基于Promise管理」
function createRequest(tasks, pool) {
pool = pool || 5;
let results = [],
together = new Array(pool).fill(null),
index = 0;
together = together.map(() => {
return new Promise((resolve, reject) => {
const run = function run() {
if (index >= tasks.length) {
resolve();
return;
};
let old_index = index,
task = tasks[index++];
task().then(result => {
results[old_index] = result;
run();
}).catch(reason => {
reject(reason);
});
};
run();
});
});
return Promise.all(together).then(() => results);
}
/* createRequest(tasks, 2).then(results => {
// 都成功,整体才是成功,按顺序存储结果
console.log('成功-->', results);
}).catch(reason => {
// 只要有也给失败,整体就是失败
console.log('失败-->', reason);
}); */
function createRequest(tasks, pool, callback) {
if (typeof pool === "function") {
callback = pool;
pool = 5;
}
if (typeof pool !== "number") pool = 5;
if (typeof callback !== "function") callback = function () {};
//------
class TaskQueue {
running = 0;
queue = [];
results = [];
pushTask(task) {
let self = this;
self.queue.push(task);
self.next();
}
next() {
let self = this;
while (self.running < pool && self.queue.length) {
self.running++;
let task = self.queue.shift();
task().then(result => {
self.results.push(result);
}).finally(() => {
self.running--;
self.next();
});
}
if (self.running === 0) callback(self.results);
}
}
let TQ = new TaskQueue;
tasks.forEach(task => TQ.pushTask(task));
}
createRequest(tasks, 2, results => {
console.log(results);
});
💬 面试官追问
先查商品再用
shopId查店铺,同事把两个请求放进Promise.all,问题在哪?第二个请求依赖第一个的返回值,并行发的时候
shopId还没拿到。有依赖的只能串:const p = await getGoods(); await getShop(p.shopId)。并发池里用
results.push(result)收结果,会有什么问题?push记录的是完成顺序,慢的请求就排到后面了,和任务数组对不上。取任务时记下oldIndex,完成后results[oldIndex] = result,createRequest就是这么做的。池子开
3个,一个请求失败了外面已经进catch,网络面板还在发请求,为什么?reject只结束了那一个工作循环,另外两个还在run()里取任务。要加一个共享的停止标记,失败后其他循环取任务前先检查;已经发出去的请求要真停,得给axios传AbortController的signal。批量保存要展示每一项成功还是失败,用
Promise.all合适吗?不合适,它拿到第一个失败就
reject,其他结果都拿不到。用Promise.allSettled,每项返回{ status, value | reason },再自己统计有没有失败。Promise.all、allSettled、race、any怎么选?全部要成功用
all;每项结果都要看用allSettled;谁先结束算谁(比如超时控制)用race;只要有一个成功就行(比如多个CDN备选)用any。
# 20 修改嵌套层级很深对象的 key
⚡ 30 秒速记
- 题目限制不能递归,正经解法是显式栈:栈里放「源对象 + 目标对象」,弹一个处理一层
JSON.stringify+replace(/_/g, '')最短,但值里的下划线也会被删,"user_name"变成"username"- 序列化法还会丢
undefined、函数、Date变字符串,只适合纯JSON数据 - 数组要单独判断,索引不改名,只遍历里面的元素
- 改名后可能撞键:
a_b和ab同时存在,后写的覆盖先写的
不让递归,就用一个栈自己模拟调用栈:每次弹出一个对象,把它这一层的键改名,遇到子对象再压进栈。 JSON.stringify 加正则最省事,但它是对整段文本做替换,分不清键和值,值里带下划线的数据会被悄悄改掉,只有确认值里不会有下划线时才能用。递归写法正好违反题目要求,而且遇到 null 会报错。显式栈版本代码稍长,但只改键、不碰值,嵌套多深都不怕爆栈。
// 有一个嵌套层次很深的对象,key 都是 a_b 形式 ,需要改成 ab 的形式,注意不能用递归。
const a = {
a_y: {
a_z: {
y_x: 6
},
b_c: 1
}
}
// {
// ay: {
// az: {
// yx: 6
// },
// bc: 1
// }
// }
方法1:序列化 JSON.stringify + 正则匹配
const regularExpress = (obj) => {
try {
const str = JSON.stringify(obj).replace(/_/g, "");
return JSON.parse(str);
} catch (error) {
return obj;
}
};;
方法2:递归
const recursion = (obj) => {
const keys = Object.keys(obj);
keys.forEach((key) => {
const newKey = key.replace(/_/g, "");
obj[newKey] = recursion(obj[key]);
delete obj[key];
});
return obj;
};
方法3:显式栈(满足不能递归的要求)
function renameKeys(obj) {
const isObj = v => v !== null && typeof v === 'object'
if (!isObj(obj)) return obj
const root = Array.isArray(obj) ? [] : {}
const stack = [[obj, root]] // [源, 目标]
while (stack.length) {
const [src, dst] = stack.pop()
for (const key of Object.keys(src)) {
const val = src[key]
// 数组索引不改名,对象的键去掉下划线
const newKey = Array.isArray(src) ? key : key.replace(/_/g, '')
if (isObj(val)) {
dst[newKey] = Array.isArray(val) ? [] : {}
stack.push([val, dst[newKey]])
} else {
dst[newKey] = val
}
}
}
return root
}
renameKeys({ a_y: { a_z: { y_x: 6 }, b_c: 1, tag: 'user_name' } })
// { ay: { az: { yx: 6 }, bc: 1, tag: 'user_name' } } 值里的下划线没动
几个点:栈在堆内存里,深度几万层也不会爆栈;新建对象而不是在原对象上 delete,不会修改调用方传入的数据;数组单独处理,保持数组结构。真实项目里如果要处理 Date、Map 或循环引用,再加类型判断和一个 WeakMap 记录已访问的对象。
💬 面试官追问
用
JSON.stringify(obj).replace(/_/g, ''),结果"user_name"这个值也变了,为什么?正则作用在整段
JSON文本上,键和值都是字符串,它分不出来。想用这招,正则至少要限定成只匹配键:/"(\w+)":/g,但嵌套引号、转义一多还是容易出错,不如遍历。不能递归,怎么遍历深层对象?
用数组当栈,放
[源对象, 新对象]。弹出一对,遍历源对象的键,值是对象就新建一个空容器挂到新对象上,再把这一对压栈;值是普通类型就直接赋值。对象里有数组,数组元素里还有
sku_id,要注意什么?数组的索引
0、1不需要改名,但元素要继续处理。先Array.isArray分流,新容器建数组,不然结果就不是数组了。原对象里同时有
a_b和ab,转换后少了一个字段,怎么处理?两个都会变成
ab,后写的覆盖先写的。转换前检测目标键是否已存在,记下完整路径,按业务规则报错或者保留原键,别静默覆盖。递归版遇到
{ a_b: null }会怎样?recursion(null)里调Object.keys(null),直接抛TypeError。要先判断typeof v === 'object' && v !== null才往下走。


